> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide/tutorial-how-to-finetune-llama-3-and-use-in-ollama.md).
# チュートリアル: Llama-3をファインチューニングしてOllamaで使う方法
Ollama上でローカル実行するカスタマイズ済みの個人アシスタント(ChatGPTのようなもの)を作成するための初心者向けガイド
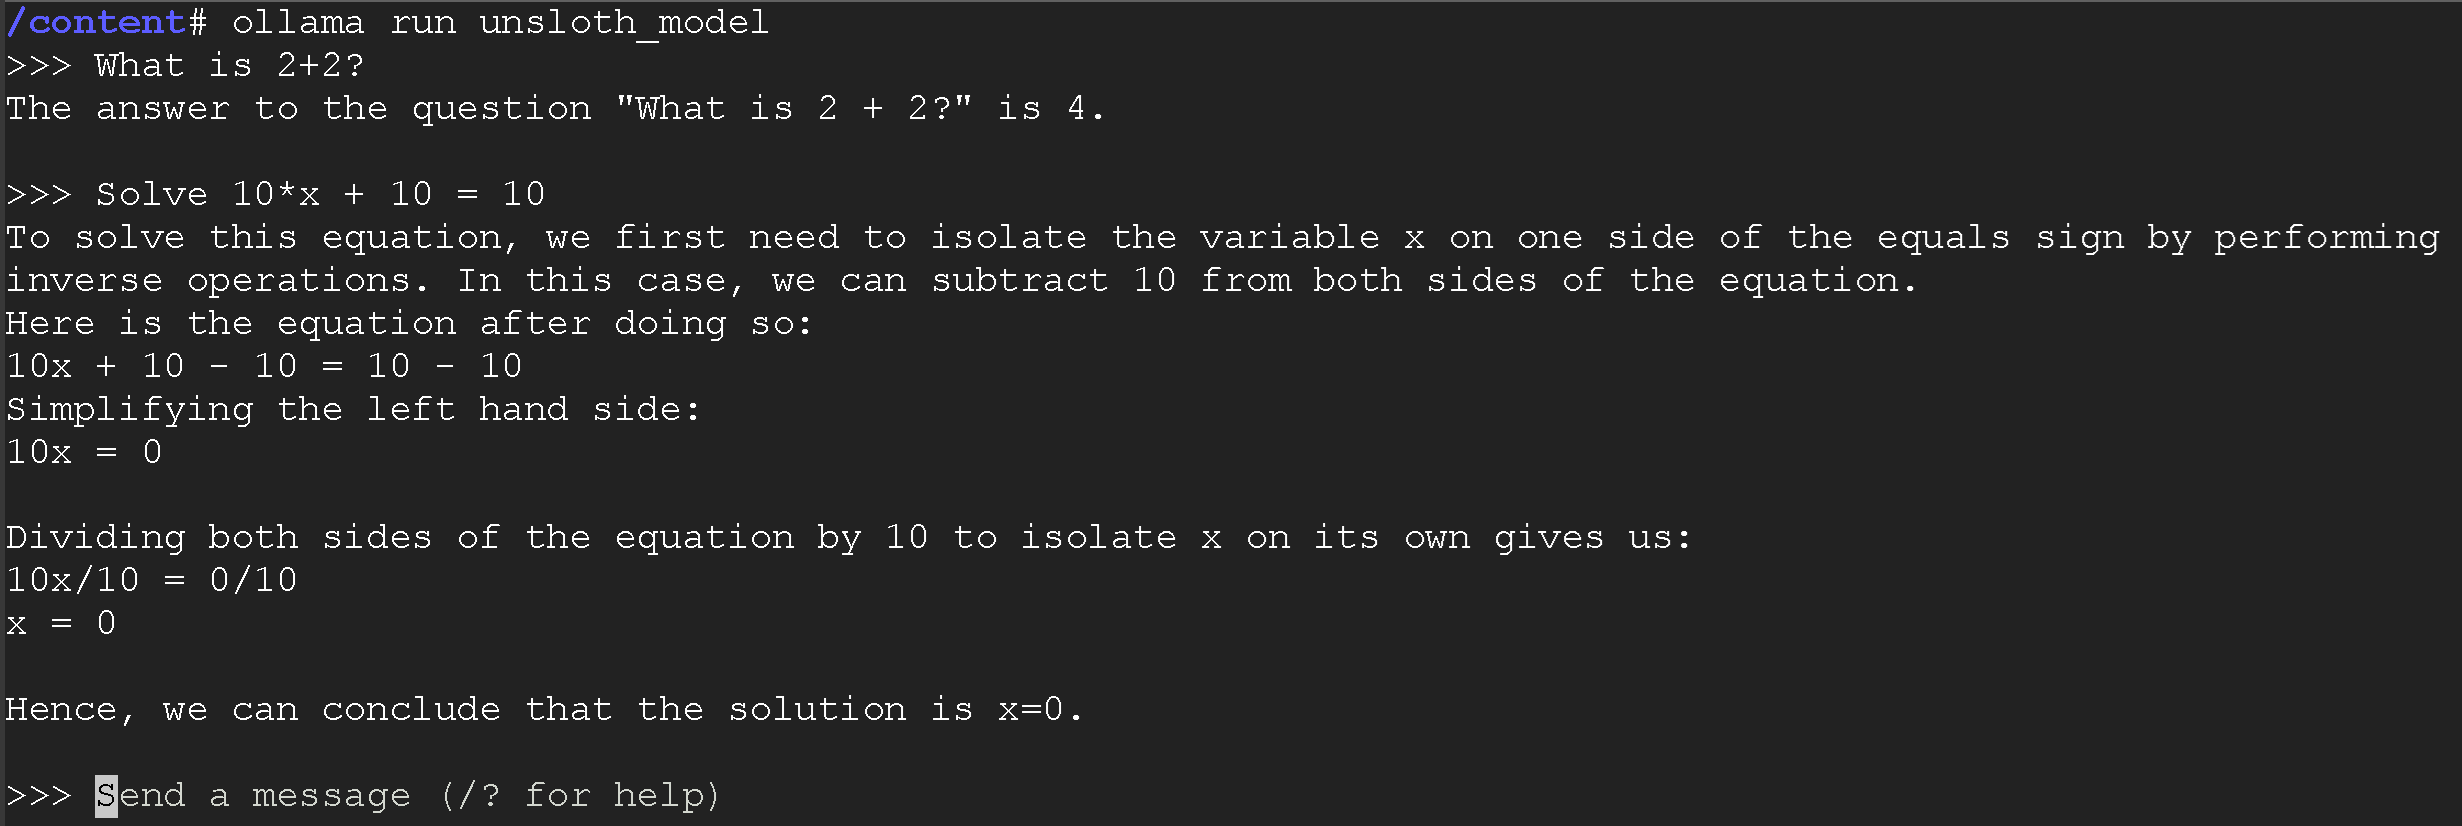
このチュートリアルの終わりまでに、あなたはカスタムチャットボットを **Llama-3をファインチューニングして** を [**Unsloth**](https://github.com/unslothai/unsloth) 無料で作成します。ローカルでは [**Ollama**](https://github.com/ollama/ollama) を使ってPC上で、または無料のGPUインスタンス上で [**Google Colab**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb)経由で実行できます。下のようにチャットボットと対話できるようになります:
 **Unsloth** によりファインチューニングがはるかに簡単になり、ファインチューニング済みモデルを自動的に **Ollama** へ、統合された自動 `Modelfile` 作成機能付きでエクスポートできます!助けが必要なら、Discordサーバーに参加できます:
{% hint style="warning" %}
**コードをコピーまたは保存したい場合は、すべてが私たちの** [**Ollama Colabノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb)**に用意されています。そこで直接使ってもいいですし、ローカル環境向けに調整しても構いません:** [**https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3\_(8B)-Ollama.ipynb**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb)
{% endhint %}
## 1. Unslothとは?
[Unsloth](https://github.com/unslothai/unsloth) により、Llama-3、Mistral、Phi-3、GemmaのようなLLMのファインチューニングが2倍高速になり、メモリ使用量を70%削減し、精度低下もありません!このチュートリアルでは、無料GPUを提供するGoogle Colabを使用します。以下から無料ノートブックにアクセスできます:
* [Ollama Llama-3 Alpaca](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb) (今回使用するノートブック)
* [CSV/Excel Ollamaガイド](https://colab.research.google.com/drive/1VYkncZMfGFkeCEgN2IzbZIKEDkyQuJAS?usp=sharing)
#### ***Googleアカウントにログインしておく必要もあります!***
 ## 2. Ollamaとは?
[Ollama ](https://github.com/ollama/ollama)自分のコンピュータ上で言語モデルを手早く簡単に実行できるようにしてくれます!Llama-3のような言語モデルをバックグラウンドで実行するプログラムを静かに起動します。突然言語モデルに質問したくなったら、Ollamaにリクエストを送るだけで、すぐに結果を返してくれます!今回は推論エンジンとしてOllamaを使います!
 ## 3. Unslothをインストール
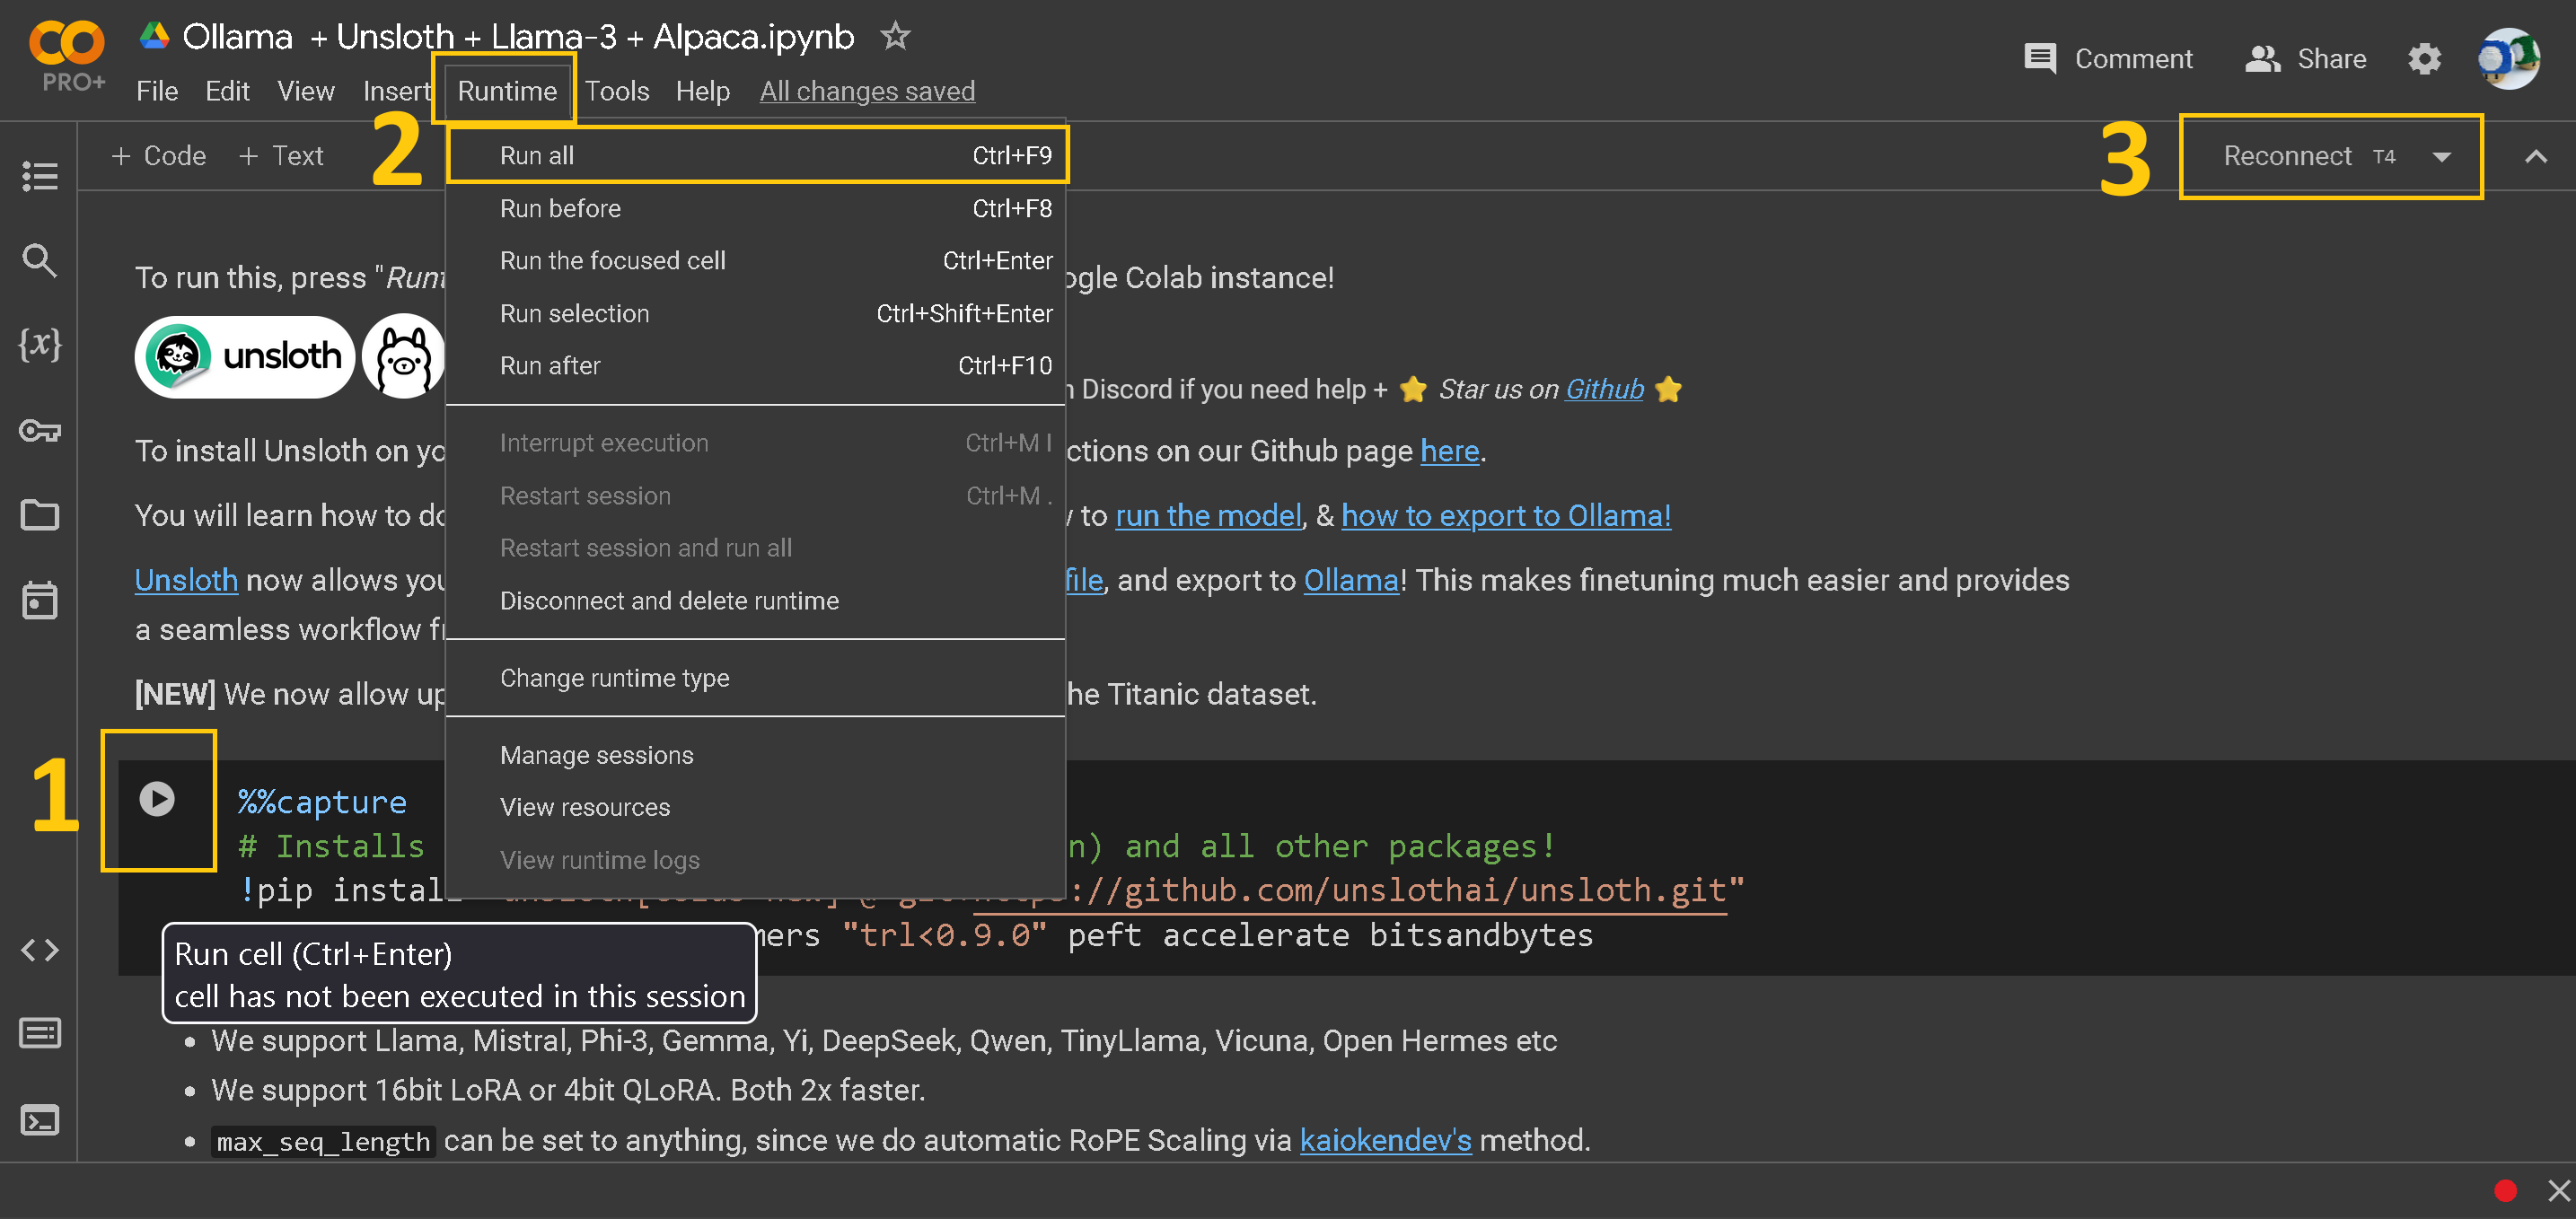 Colabノートブックを使ったことがない場合の、ノートブック自体の簡単な入門:
1. **各「セル」の再生ボタン。** これをクリックしてそのセルのコードを実行します。どのセルも飛ばしてはいけませんし、すべてのセルを時系列順に実行する必要があります。エラーが出た場合は、実行していなかったセルをもう一度実行してください。再生ボタンをクリックしたくない場合は、CTRL + ENTERを押しても構いません。
2. **上部ツールバーのRuntimeボタン。** このボタンを使って「Run all」を押せば、ノートブック全体を一気に実行することもできます。カスタマイズ手順はすべて飛ばされますが、最初の試行としては良いかもしれません。
3. **Connect / Reconnect T4ボタン。** ここをクリックすると、より詳細なシステム統計を確認できます。
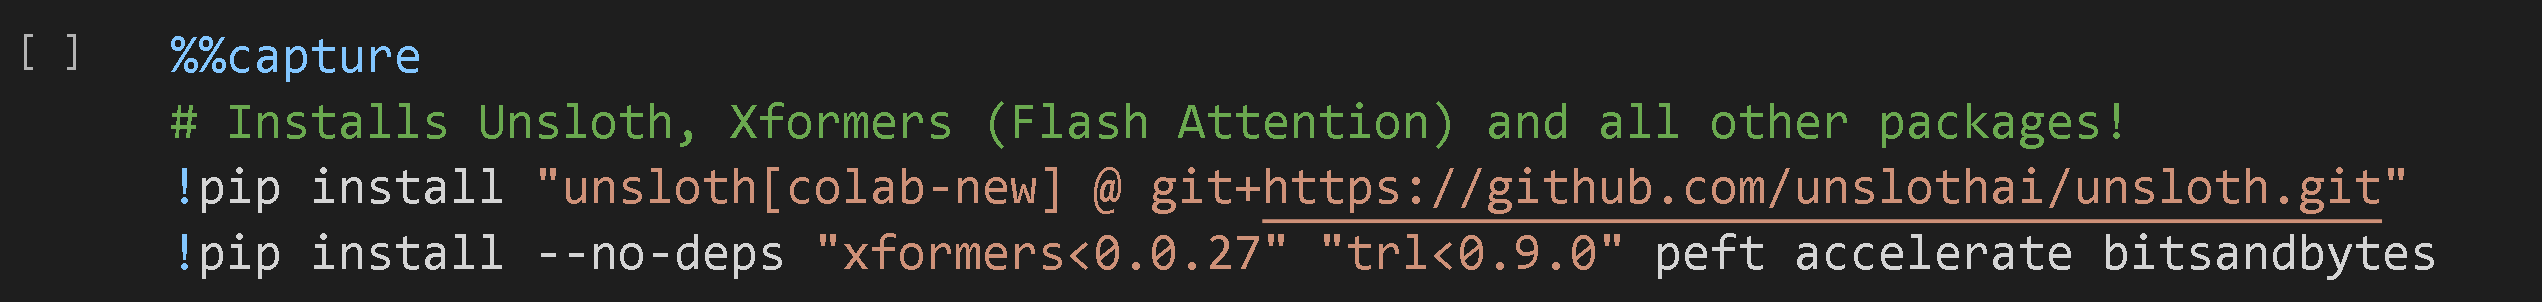
最初のインストールセルは次のようになります:\[ ] の中のPLAYボタンをクリックすることを忘れないでください。オープンソースのGithubパッケージを取得し、いくつかの他のパッケージもインストールします。
 ## 4. ファインチューニングするモデルを選ぶ
では、ファインチューニング用のモデルを選びましょう!デフォルトでは、Meta / Facebook のLlama-3を選んでいます。これはなんと15兆の「トークン」で学習されています。トークンは英単語1語のようなものだと考えてください。これは約35万冊分の分厚い百科事典に相当します!他の人気モデルには、Mistral、Phi-3(GPT-4の出力を使って学習)、そしてGoogleのGemma(13兆トークン!)があります。
Unslothはこれらのモデルなどにも対応しています!実際、Hugging Faceのモデルハブからモデル名を入力するだけで動作するか確認できます。動作しない場合はエラーにします。
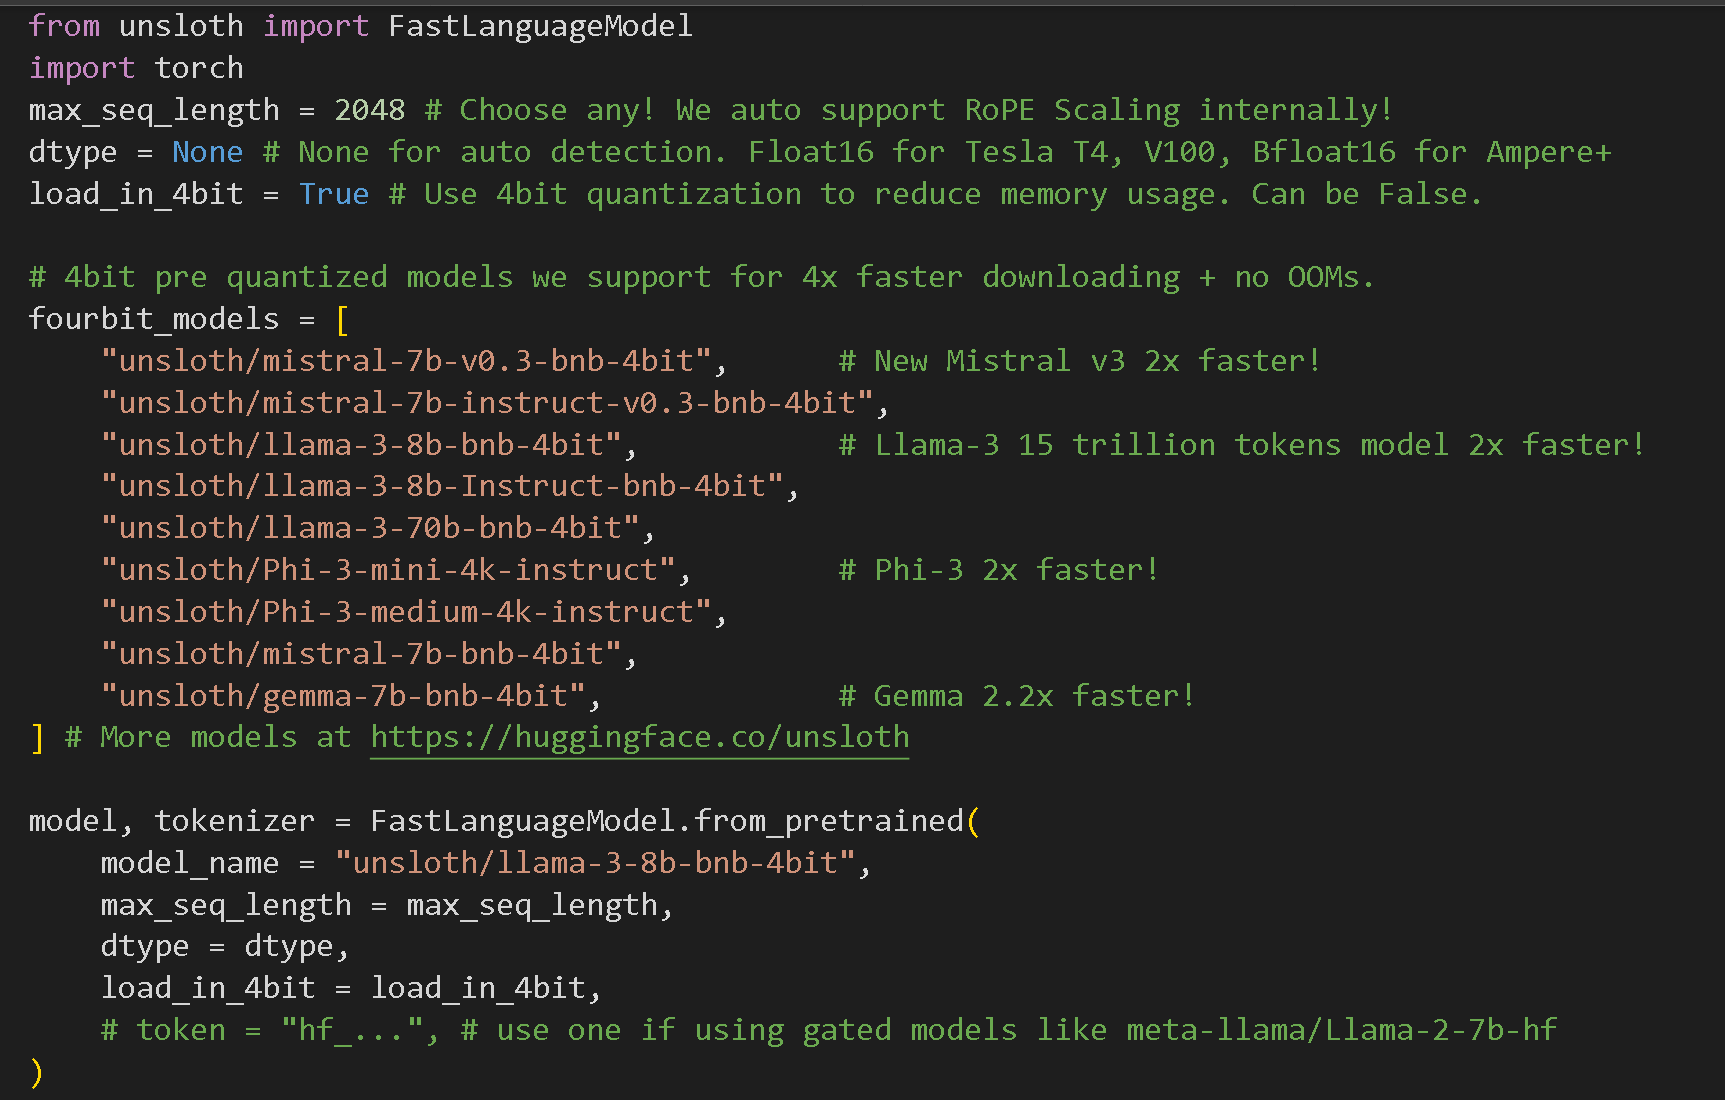 切り替えられる設定があと3つあります:
1. ```python
max_seq_length = 2048
```
これはモデルのコンテキスト長を決めます。たとえばGeminiは100万以上のコンテキスト長がありますが、Llama-3は8192のコンテキスト長です。任意の数を選べますが、テスト目的では2048に設定することを推奨します。Unslothは非常に長いコンテキストのファインチューニングもサポートしており、最高クラスより4倍長いコンテキスト長を提供できることを示しています。
2. ```python
dtype = None
```
Noneのままにしてください。ただし、新しいGPUでは torch.float16 または torch.bfloat16 を選ぶこともできます。
3. ```python
load_in_4bit = True
```
4ビット量子化でファインチューニングを行います。これによりメモリ使用量が4分の1になり、実際に無料の16GBメモリGPUでファインチューニングできるようになります。4ビット量子化は本質的に重みを限られた数値の集合に変換してメモリ使用量を減らします。その欠点として、精度が1〜2%低下します。H100のような大きなGPUで、そのわずかな追加精度が欲しい場合はFalseに設定してください。
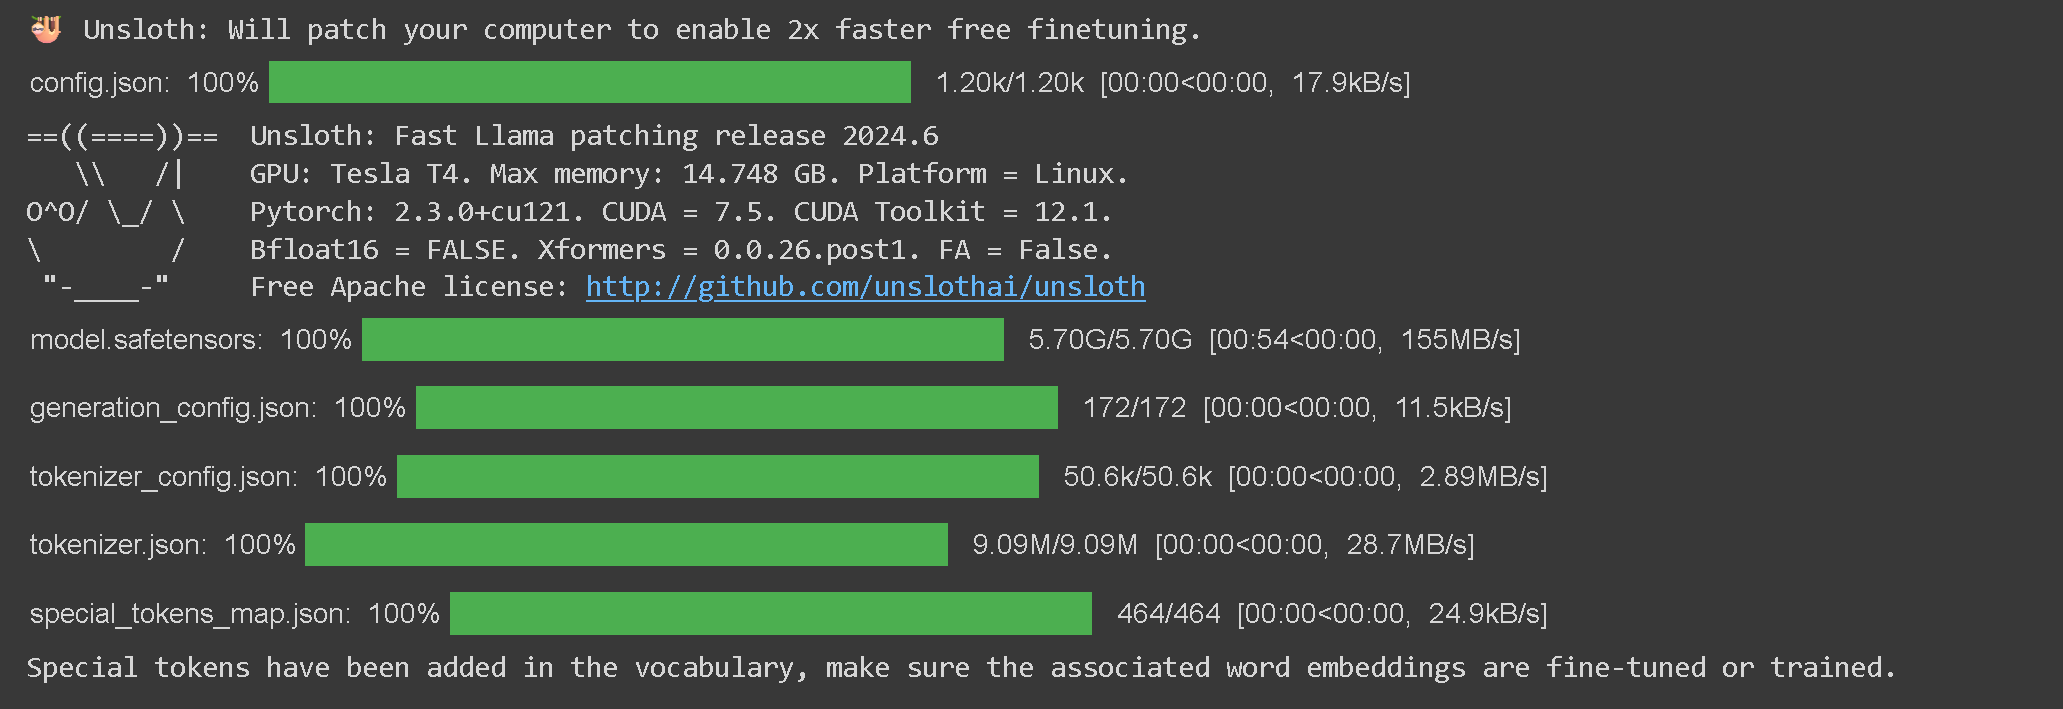 このセルを実行すると、Unslothのバージョン、使用しているモデル、GPUのメモリ容量、その他いくつかの統計情報が表示されます。今は気にしなくて大丈夫です。
## 5. ファインチューニングのパラメータ
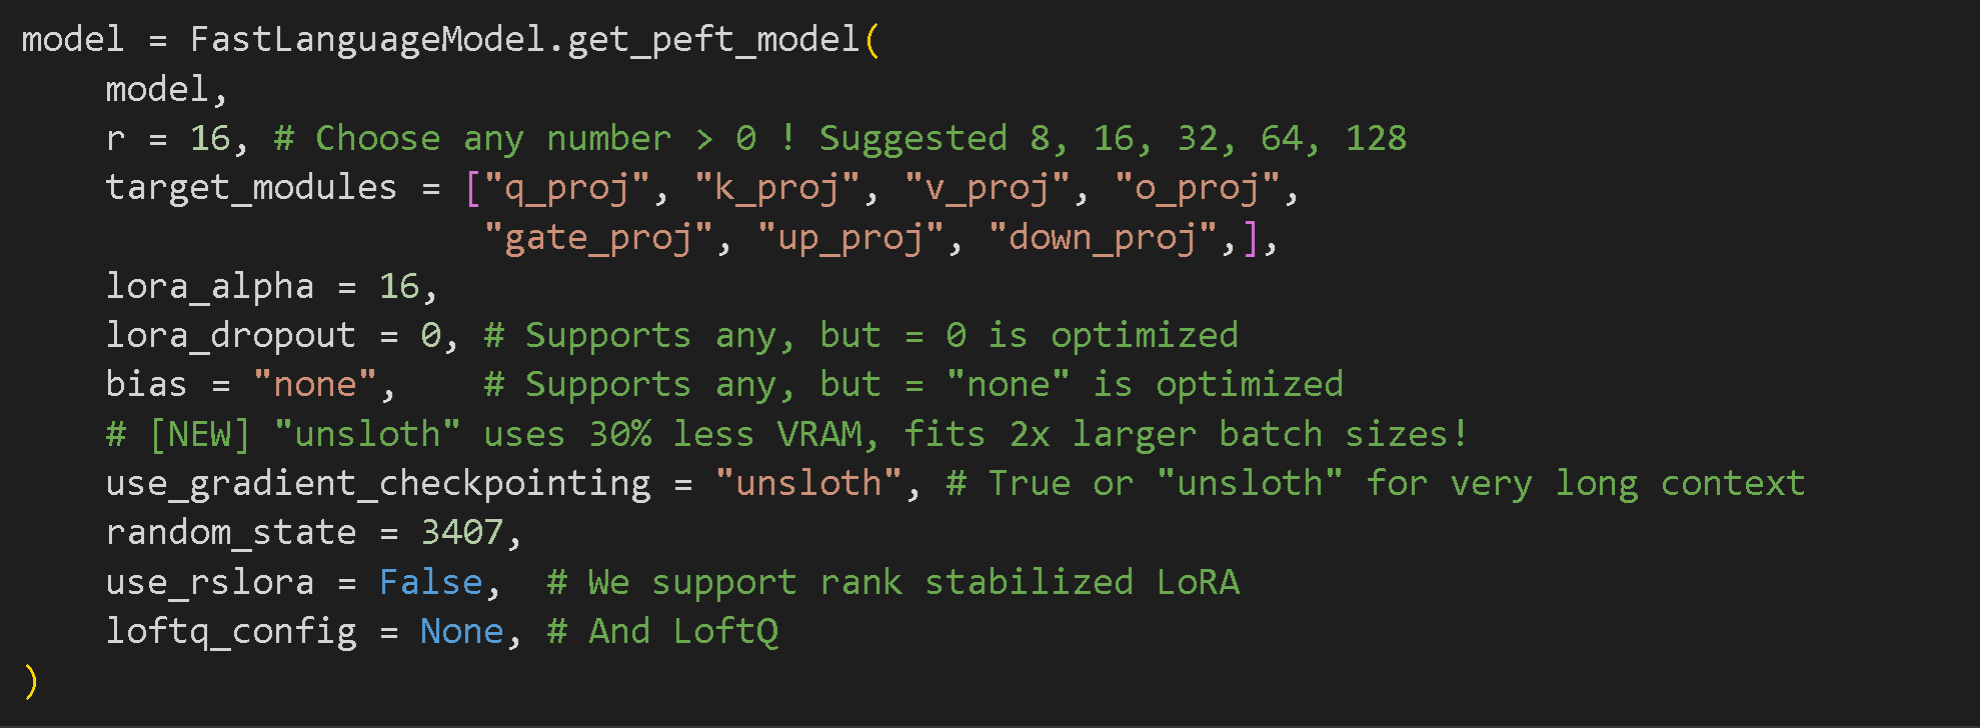 ではファインチューニングをカスタマイズするために、上の数値を編集できますが、すでにかなり妥当な数値を選んでいるので無視しても構いません。
これらの数値を変更する目的は精度を上げることですが、同時に **過学習を抑えること**も必要です。過学習とは、言語モデルにデータセットを丸暗記させてしまい、新しい未知の質問に答えられなくなることです。最終モデルには、見たことのない質問に答えてほしく、丸暗記はしてほしくありません。
1. ```python
r = 16, # 0より大きい任意の数を選択! 推奨値は 8, 16, 32, 64, 128
```
ファインチューニング処理のランクです。数値が大きいほどメモリを多く使い、遅くなりますが、難しいタスクでは精度を上げられます。通常は8(高速ファインチューニング向け)から128までの数を推奨します。数値が大きすぎると過学習を起こし、モデルの品質を損なうことがあります。
2. ```python
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",],
```
すべてのモジュールをファインチューニング対象に選びます。いくつか外せばメモリ使用量を減らし、学習を速くできますが、強くおすすめしません。すべてのモジュールでそのまま学習してください!
3. ```python
lora_alpha = 16,
```
ファインチューニングのスケーリング係数です。数値が大きいほどデータセットからより多くを学習しますが、過学習を招く可能性があります。これはランクと同じにすることを推奨します `r`、またはその2倍にしてください。
4. ```python
lora_dropout = 0, # 任意の値に対応していますが、= 0 が最適化されています
```
高速学習のために0のままにしてください!過学習は減らせますが、それほどではありません。
5. ```python
bias = "none", # 任意の値に対応していますが、= "none" が最適化されています
```
より高速で過学習の少ない学習のために0のままにしてください!
6. ```python
use_gradient_checkpointing = "unsloth", # 非常に長いコンテキストでは True または "unsloth"
```
オプションには `True`, `False` そして `"unsloth"`があります。推奨は `"unsloth"` です。さらに30%メモリ使用量を削減し、非常に長いコンテキストのファインチューニングをサポートするからです。詳細はこちらをご覧ください: で詳細を確認できます。
7. ```python
random_state = 3407,
```
決定論的な実行を判定するための数値です。学習とファインチューニングには乱数が必要なので、この数値を設定すると実験を再現可能にできます。
8. ```python
use_rslora = False, # ランク安定化LoRAをサポートしています
```
を設定する高度な機能 `lora_alpha = 16` を自動的に。必要ならこれを使えます!
9. ```python
loftq_config = None, # そしてLoftQ
```
LoRA行列を重みの上位r個の特異ベクトルで初期化する高度な機能です。精度をある程度改善できますが、開始時のメモリ使用量が爆発的に増えることがあります。
## 6. Alpacaデータセット
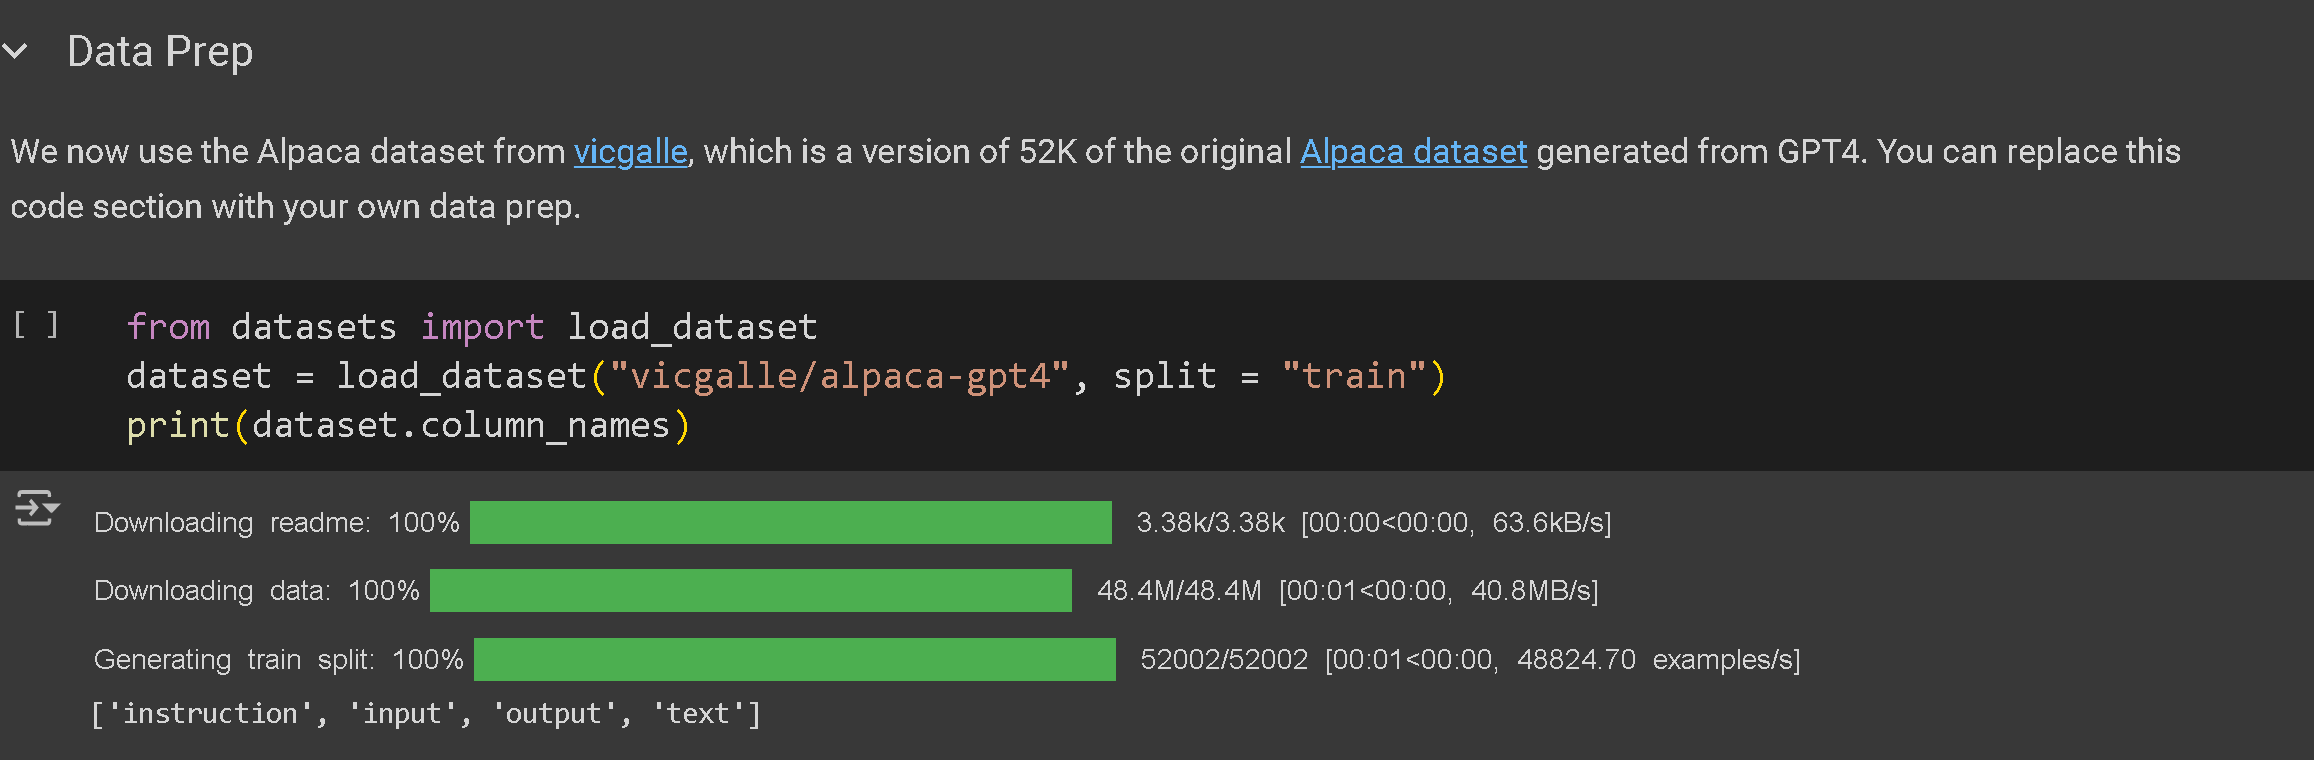 ここでは、GPT-4自身を呼び出して作成されたAlpacaデータセットを使います。これは52,000件の指示と出力のリストで、Llama-1のリリース時にとても人気がありました。ベースLLMのファインチューニングをChatGPT自体に匹敵するものにしたからです。
GPT4版のAlpacaデータセットはこちらからアクセスできます: 。古い最初のバージョンのデータセットはこちらです: 。以下にデータセットの例を示します:
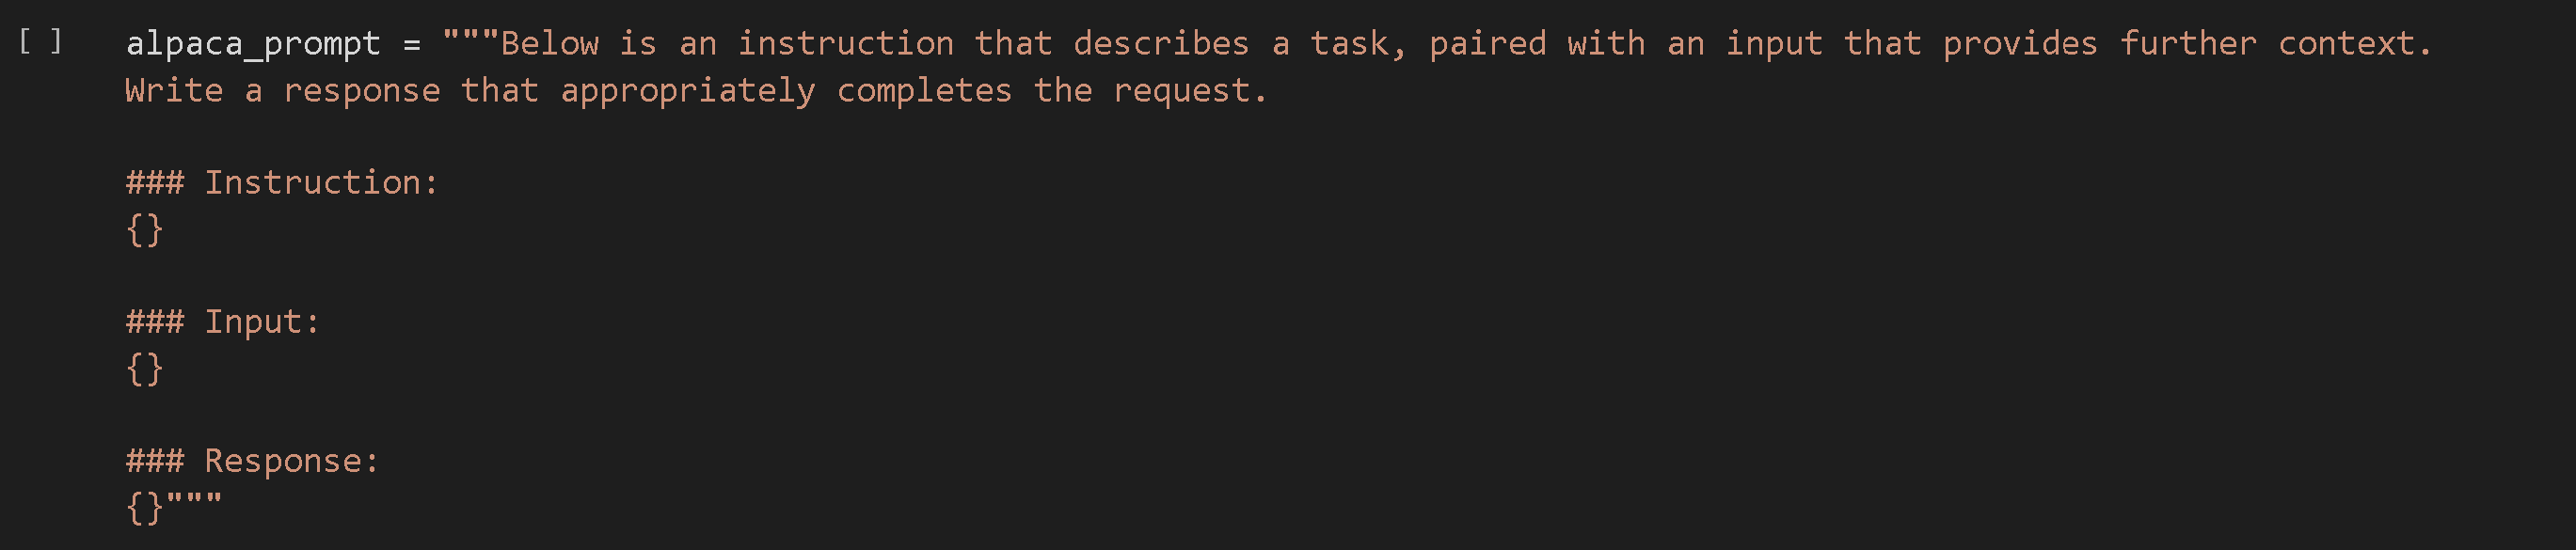
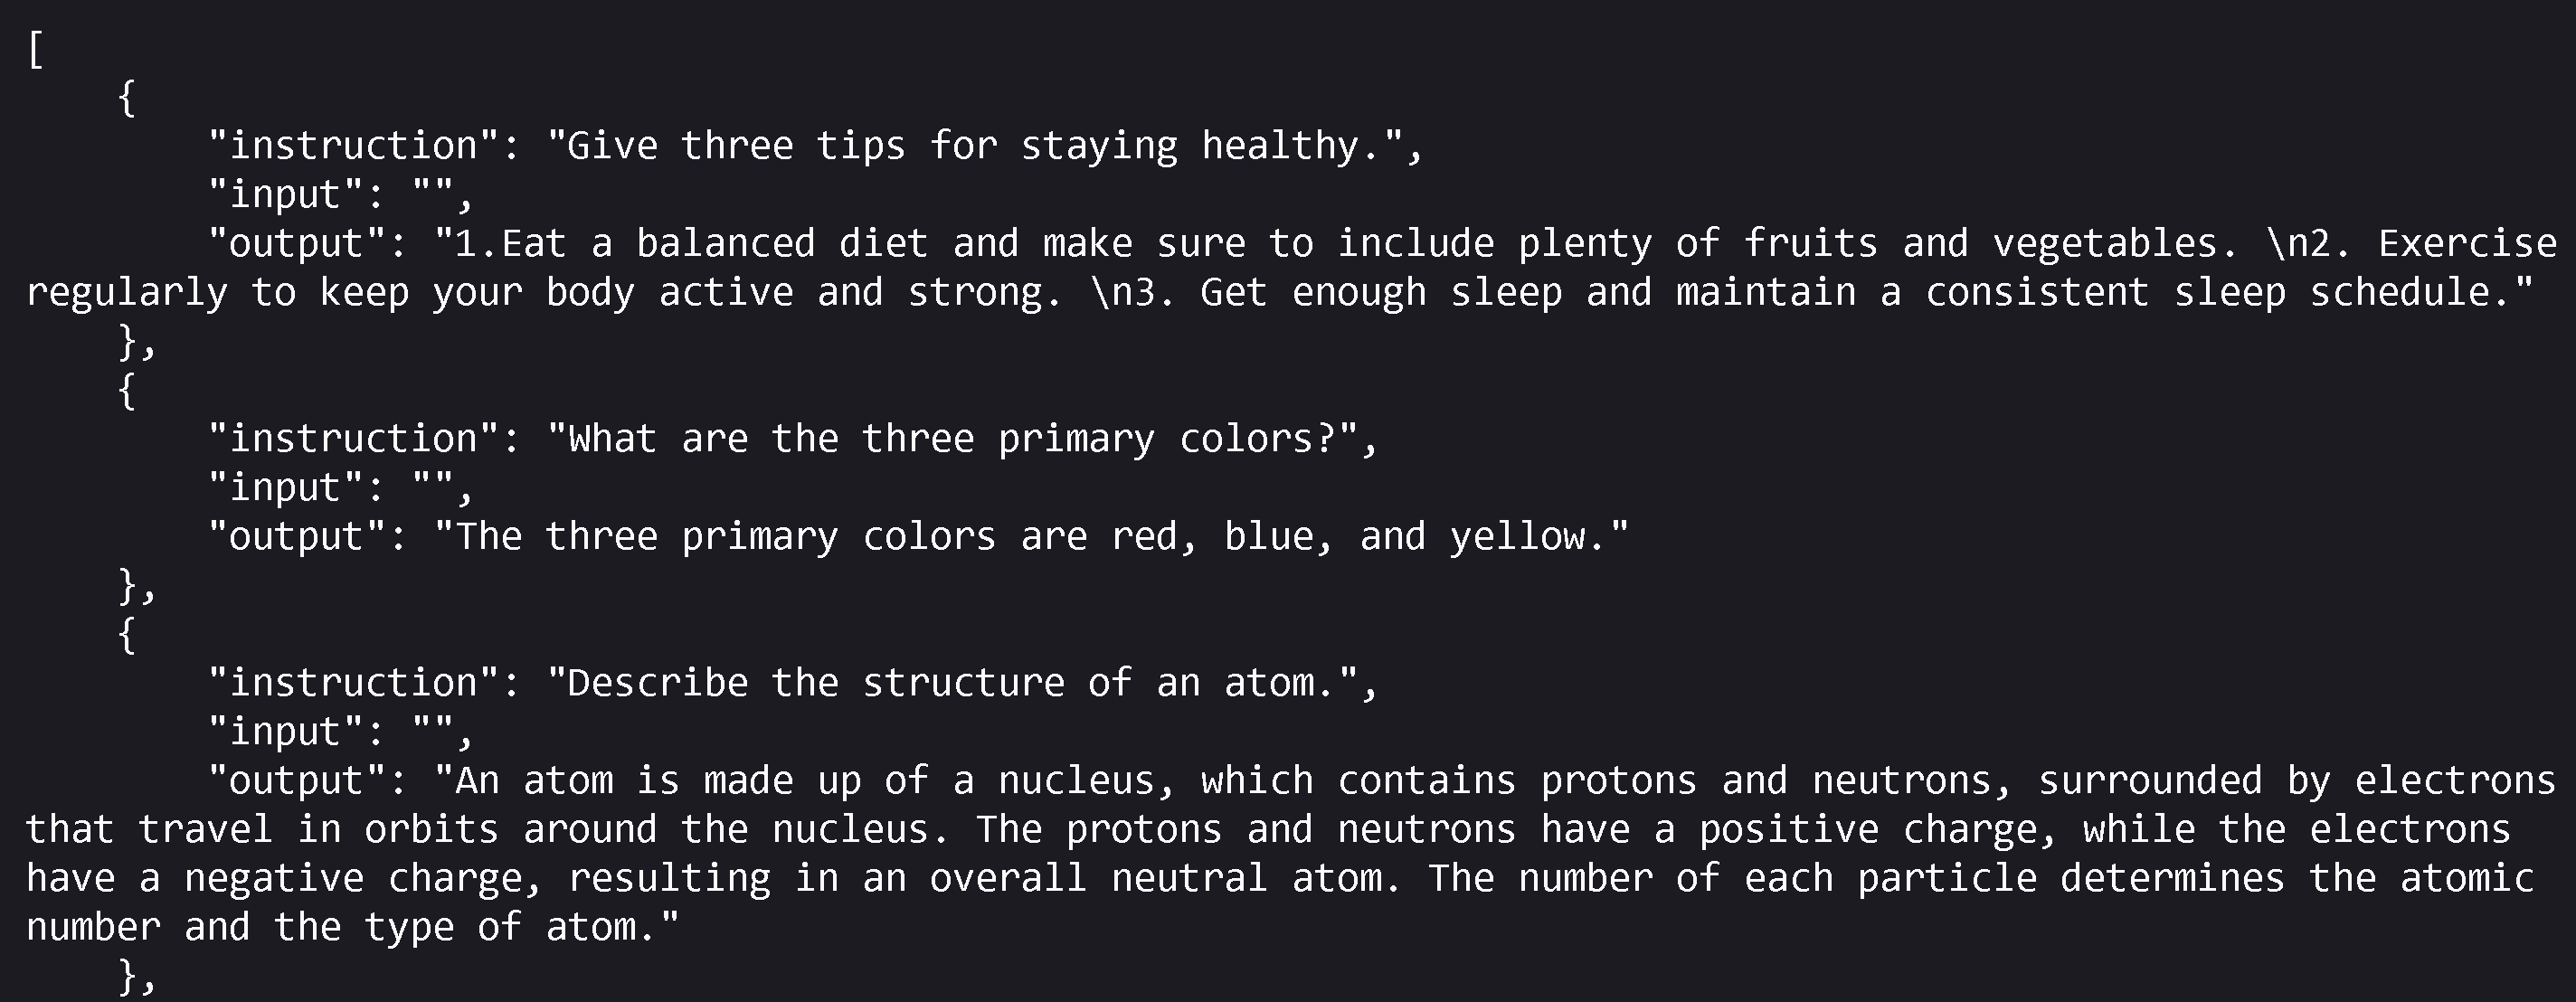 各行に3つの列、つまり指示、入力、出力があることがわかります。私たちは基本的に各行を下のような1つの大きなプロンプトにまとめます。これを使って言語モデルをファインチューニングし、ChatGPTにとても近いものにしました。この処理を **教師あり指示ファインチューニング**.
 ## 7. ファインチューニングのための複数列
ただし大きな問題は、ChatGPTスタイルのアシスタントでは1つの指示 / 1つのプロンプトしか許可されず、複数列 / 複数入力は使えないことです。たとえばChatGPTでは、複数のプロンプトではなく1つのプロンプトだけを送信する必要があることがわかります。
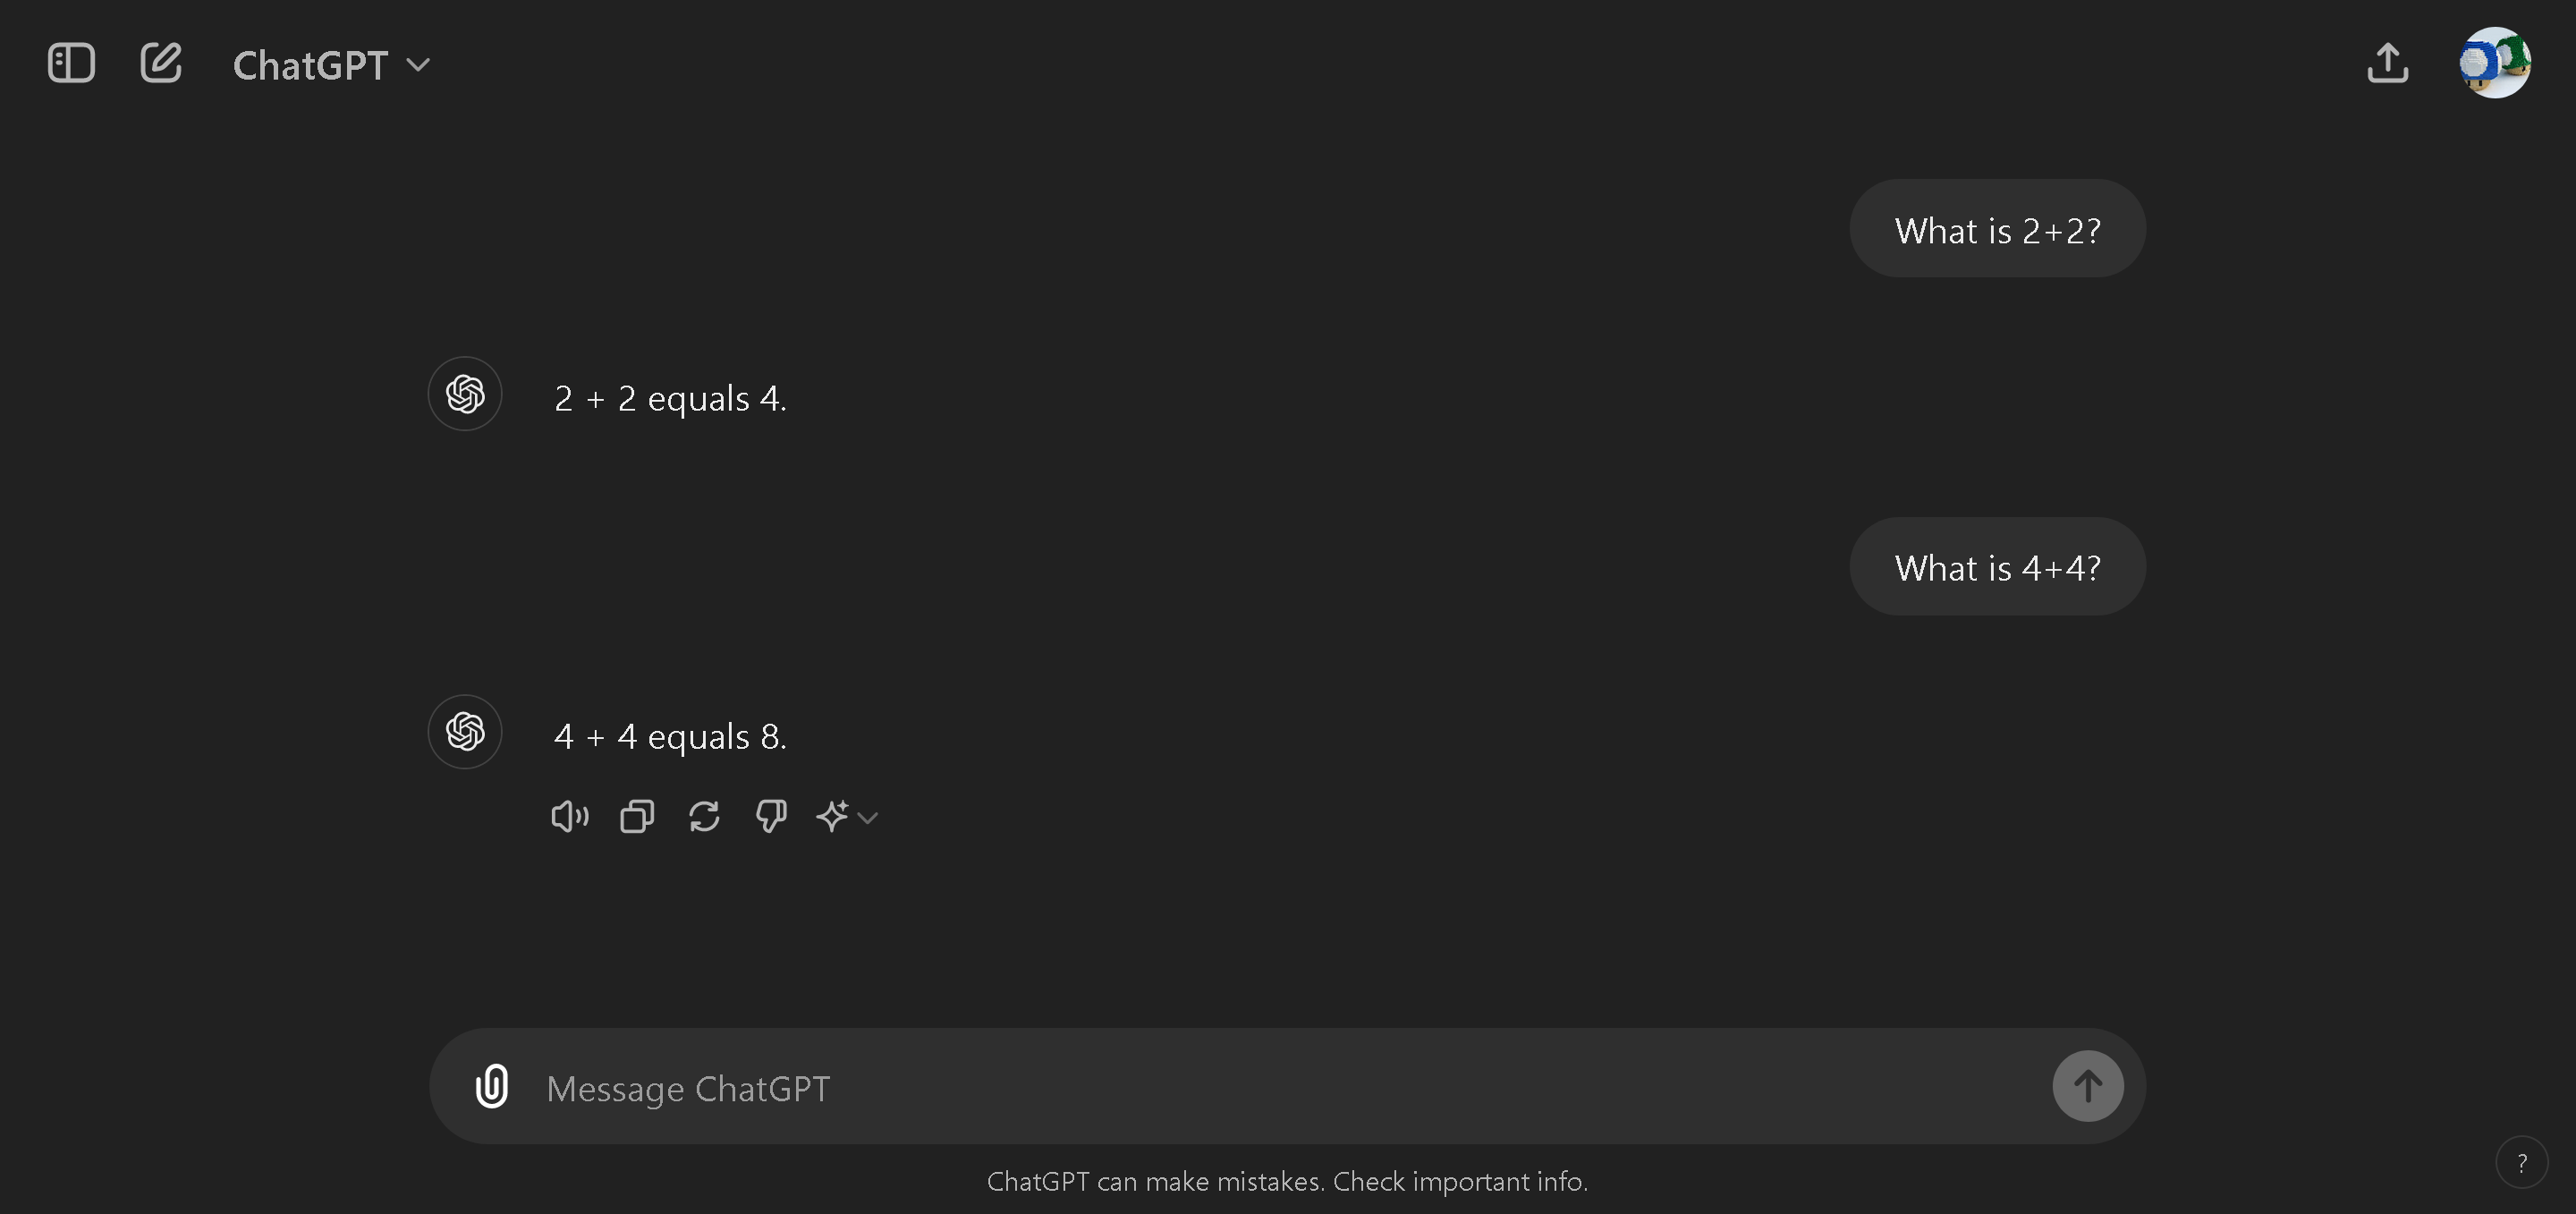 つまり、実際にファインチューニングを機能させるには、複数列を1つの大きなプロンプトに「まとめる」必要があるということです!
たとえば、非常に有名なタイタニックデータセットには非常に多くの列があります。あなたの仕事は、年齢、乗客クラス、運賃などに基づいて、乗客が生存したか死亡したかを予測することでした。これをそのままChatGPTに渡すことはできませんが、これらの情報を1つの大きなプロンプトに「まとめる」必要があります。
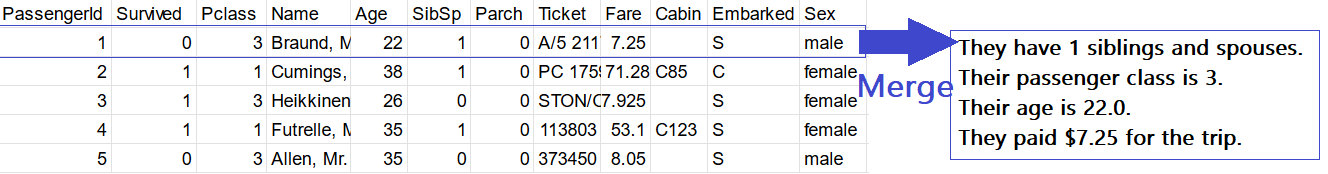 たとえば、乗客に関するすべての情報を含む「まとめた」単一プロンプトでChatGPTに質問すれば、その乗客が死亡したか生存したかを推測・予測させることができます。
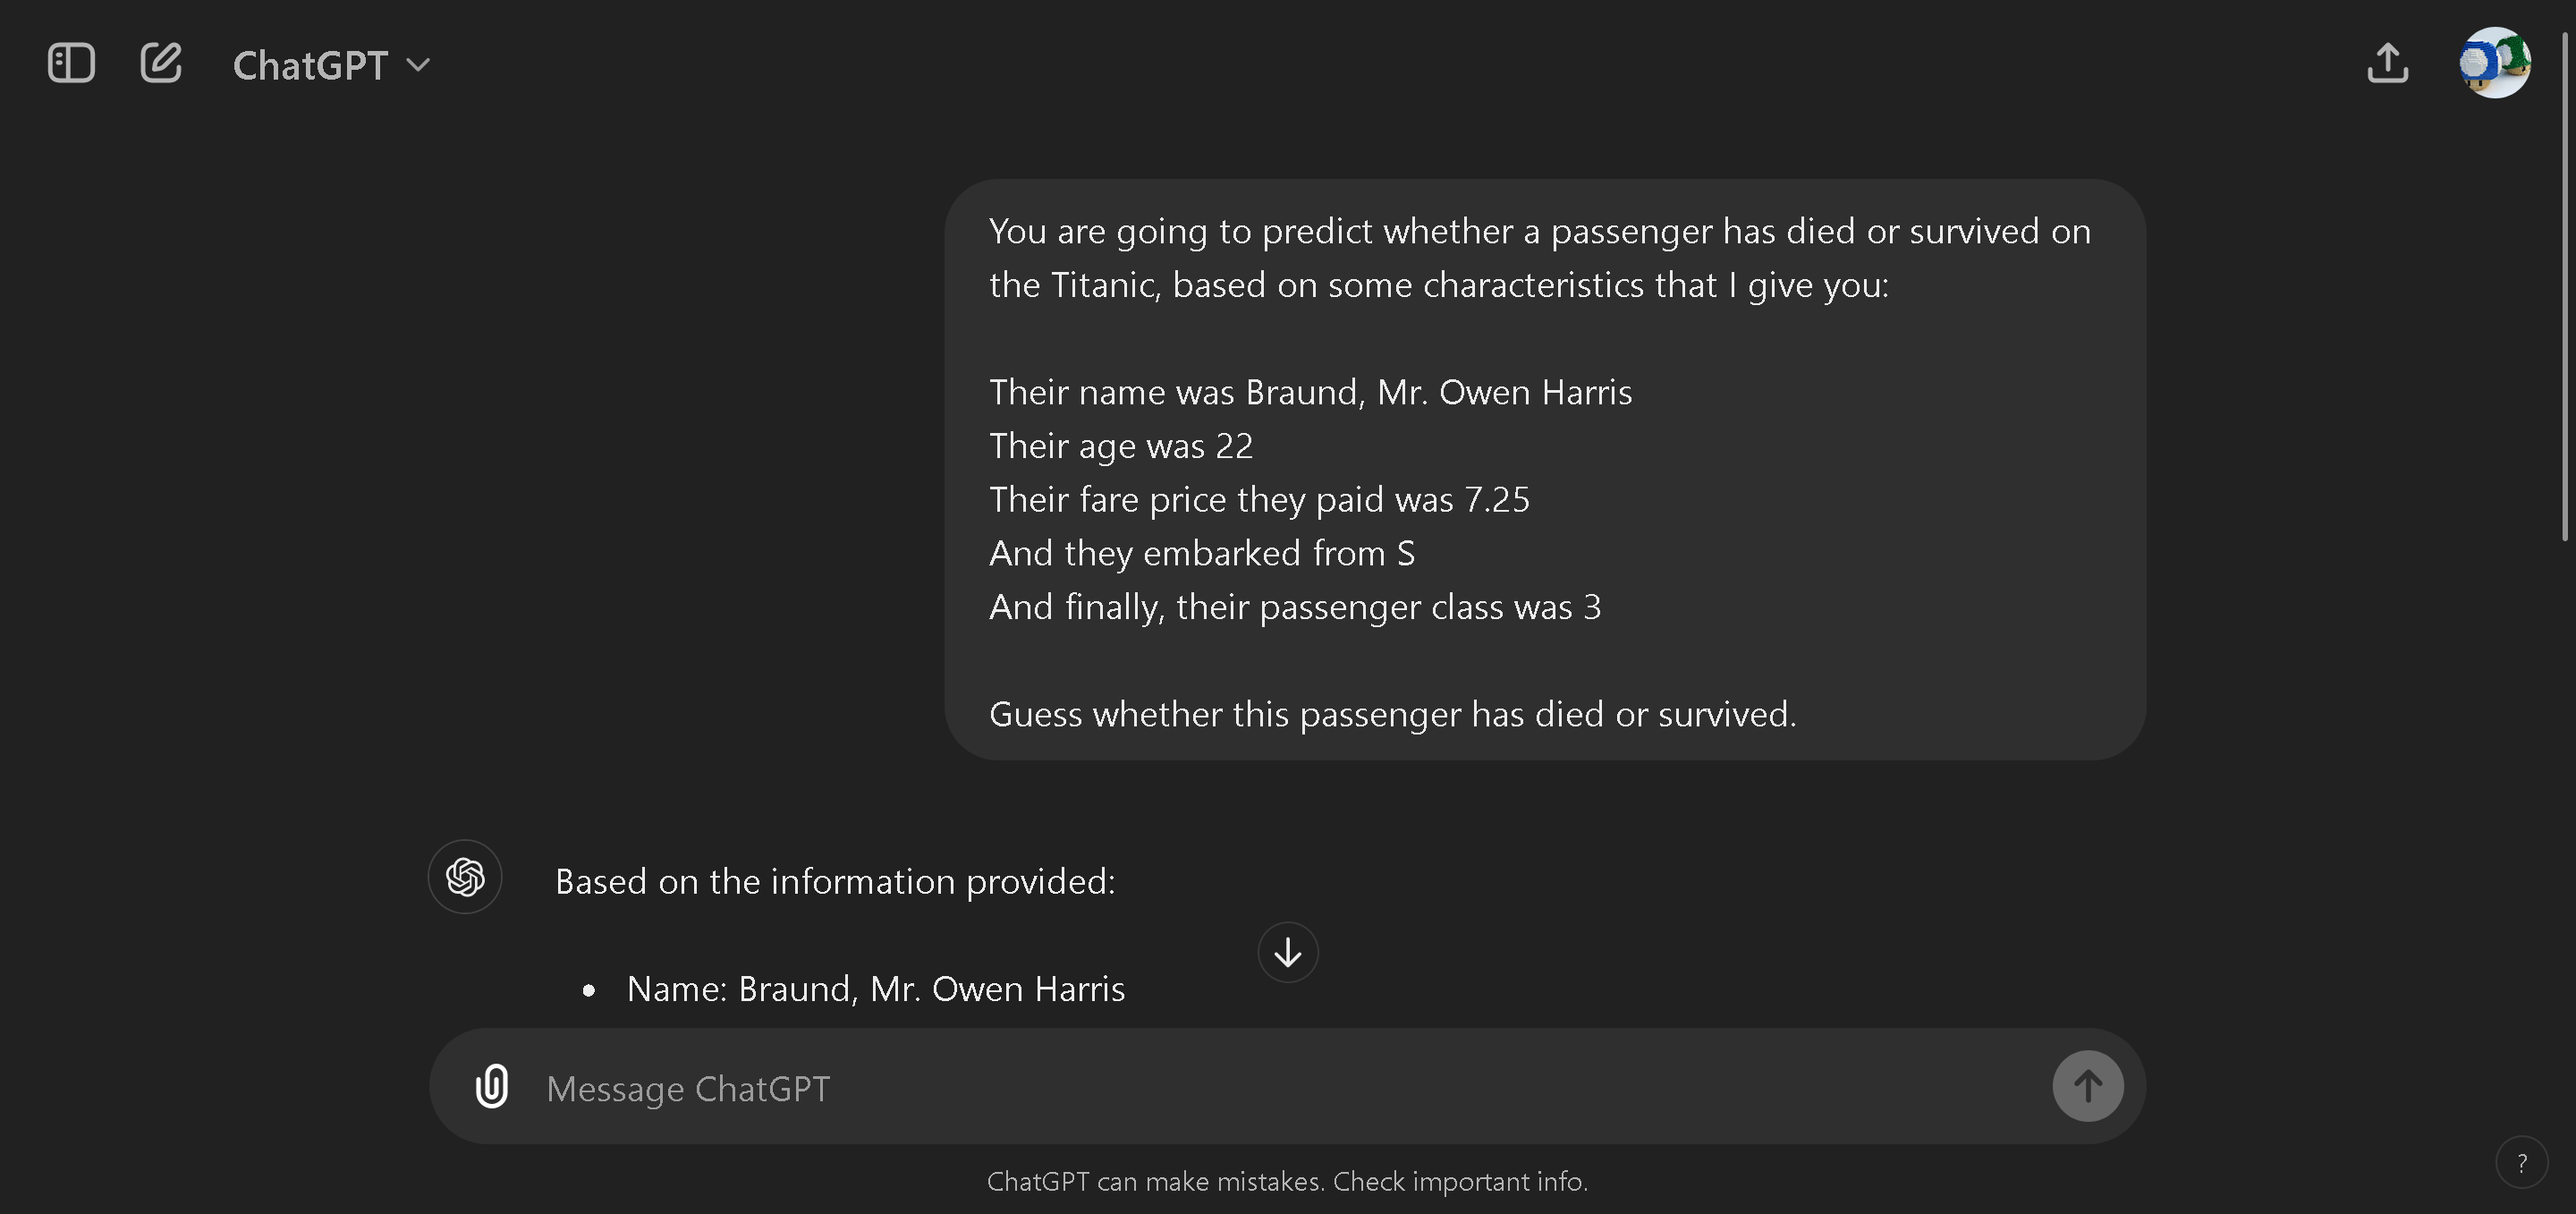 他のファインチューニングライブラリでは、すべての列を1つのプロンプトにまとめるなど、ファインチューニング用にデータセットを手動で準備する必要があります。Unslothでは、次の関数を提供するだけです `to_sharegpt` これだけで一気にやってくれます!
タイタニックのファインチューニングノートブックにアクセスするか、CSVまたはExcelファイルをアップロードしたい場合は、こちらへ:
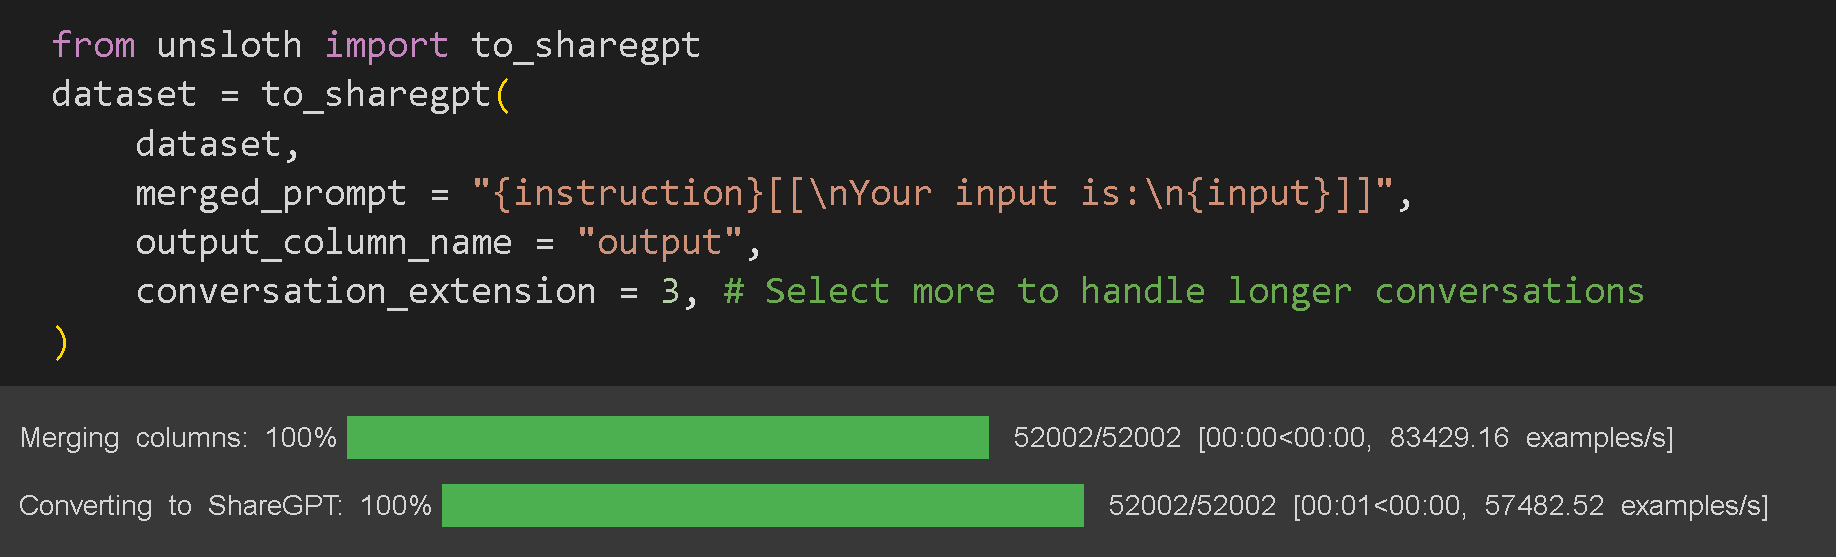 ここからは少し複雑になります。多くのカスタマイズを許可しているためですが、いくつかポイントがあります:
* すべての列を波かっこで囲む必要があります `{}`。これは実際のCSV / Excelファイル内の列名です。
* オプションのテキスト要素は `[[]]`で囲む必要があります。たとえば「input」列が空の場合、結合関数はそのテキストを表示せず、これを飛ばします。これは欠損値のあるデータセットに便利です。
* 出力またはターゲット / 予測列を `output_column_name`で選択します。Alpacaデータセットでは、これは `output`.
たとえばタイタニックデータセットでは、下のような大きな結合プロンプト形式を作れます。ここでは各列 / 各テキスト片がオプションになります。
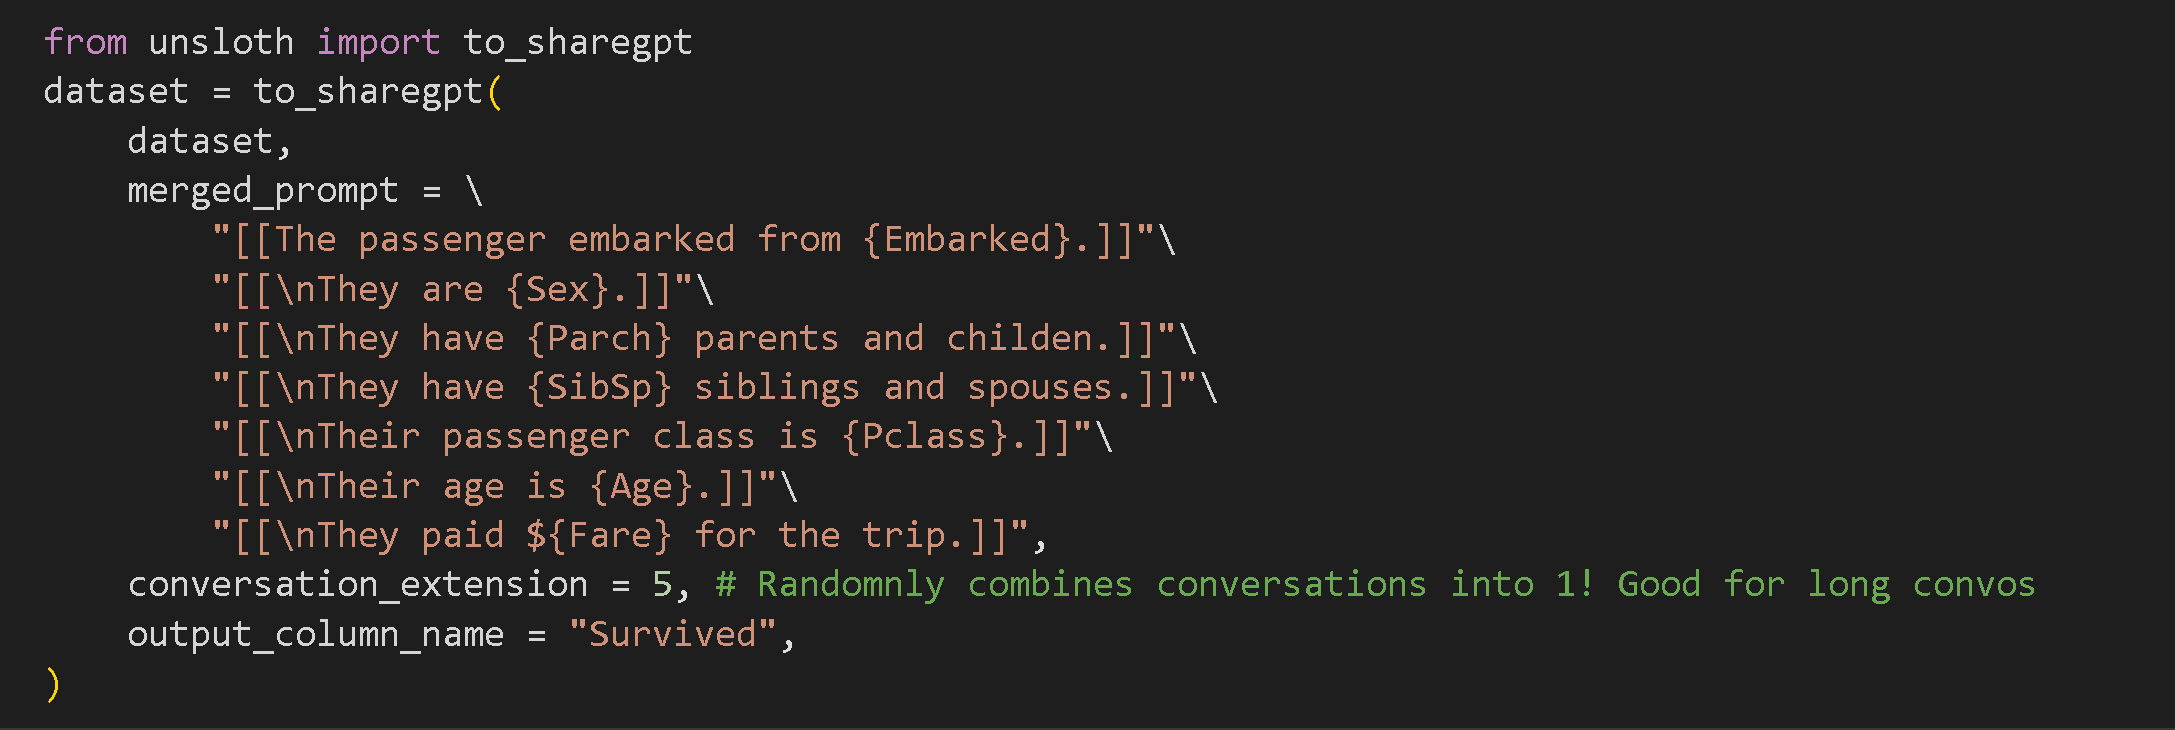 たとえば、データセットがこのように見え、欠損データがたくさんあるとします:
| 乗船地 | 年齢 | 運賃 |
| --- | -- | ---- |
| S | 23 | |
| | 18 | 7.25 |
すると、結果が次のようになるのは望みません:
1. 乗客はSから乗船しました。年齢は23歳です。運賃は **EMPTY**.
2. 乗客は **EMPTY**から乗船しました。年齢は18歳です。運賃は$7.25です。
代わりに、 `[[]]`を使って列をオプションとして囲めば、この情報を完全に除外できます。
1. \[\[乗客はSから乗船しました。]] \[\[年齢は23歳です。]] \[\[運賃は **EMPTY**.]]
2. \[\[乗客は **EMPTY**から乗船しました。]] \[\[年齢は18歳です。]] \[\[運賃は$7.25です。]]
は次のようになります:
1. 乗客はSから乗船しました。年齢は23歳です。
2. 年齢は18歳です。運賃は$7.25です。
## 8. マルチターン会話
気づかなかったかもしれませんが、Alpacaデータセットは1ターンのみです。一方で、ChatGPTを使うと対話形式で複数ターン会話ができました。たとえば、左側が私たちの求めるものですが、右側のAlpacaデータセットは単発の会話しか提供しません。ファインチューニングした言語モデルには、ChatGPTのように複数ターン会話をどうやって行うかを何とか学んでほしいのです。
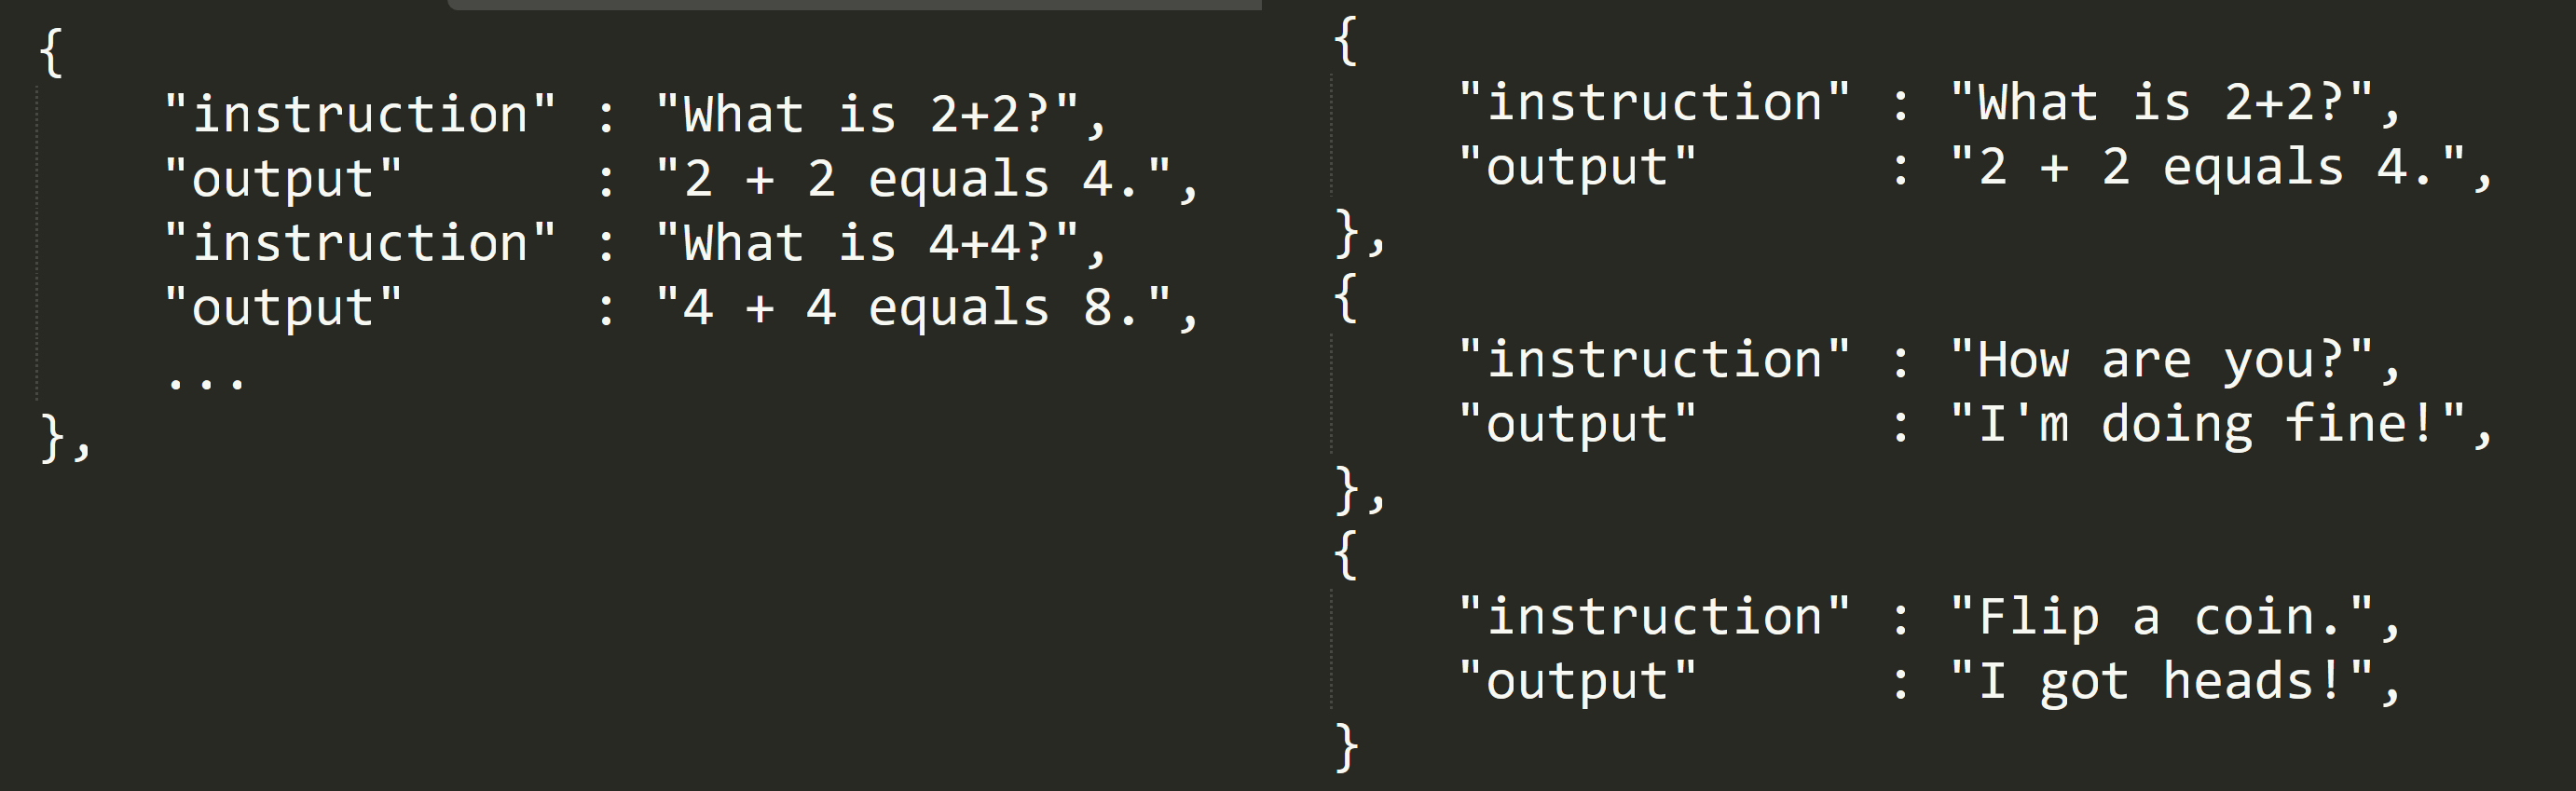 そこで私たちは `conversation_extension` パラメータを導入しました。これは単一ターンのデータセットからランダムな行をいくつか選び、1つの会話にまとめるものです!たとえば3に設定すると、3行をランダムに選んで1つにまとめます!長くしすぎると学習は遅くなりますが、チャットボットと最終的なファインチューニングの品質はかなり良くなる可能性があります!
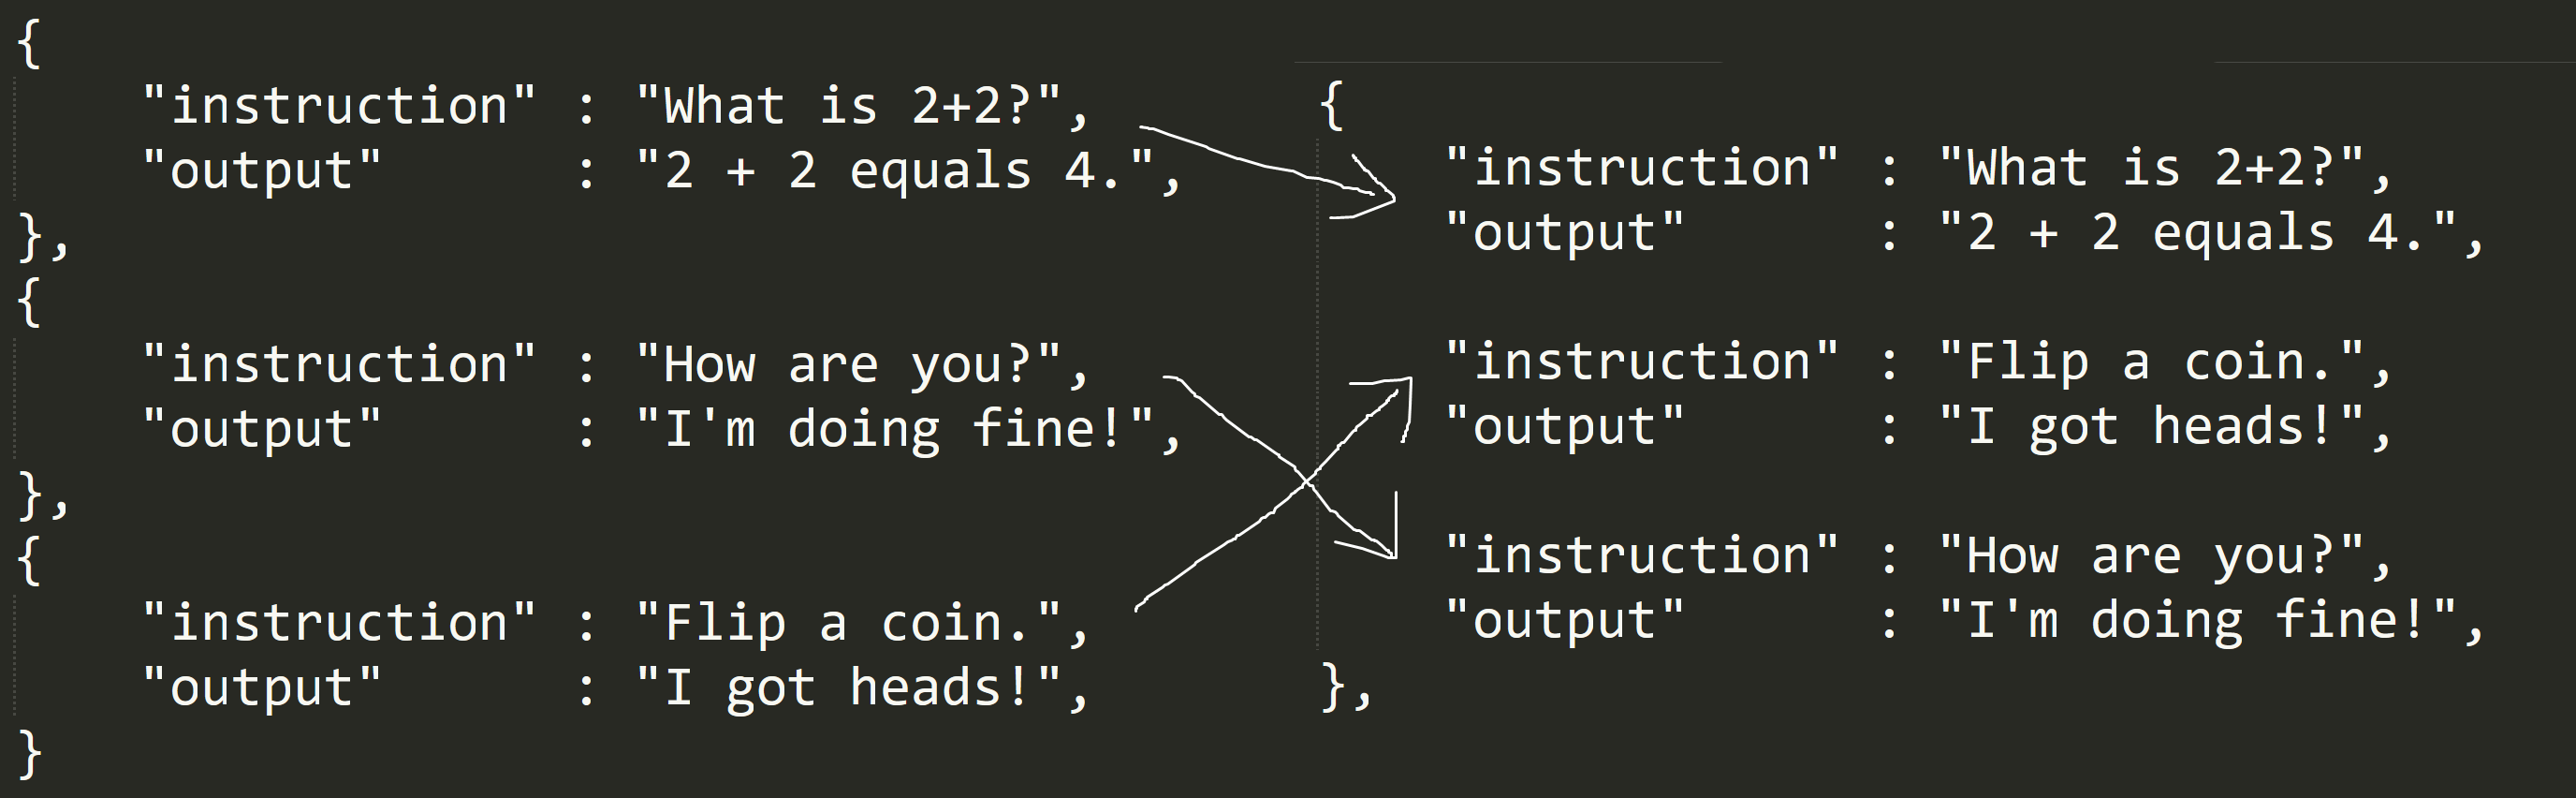 その後、 `output_column_name` を予測 / 出力列に設定します。Alpacaデータセットでは出力列になります。
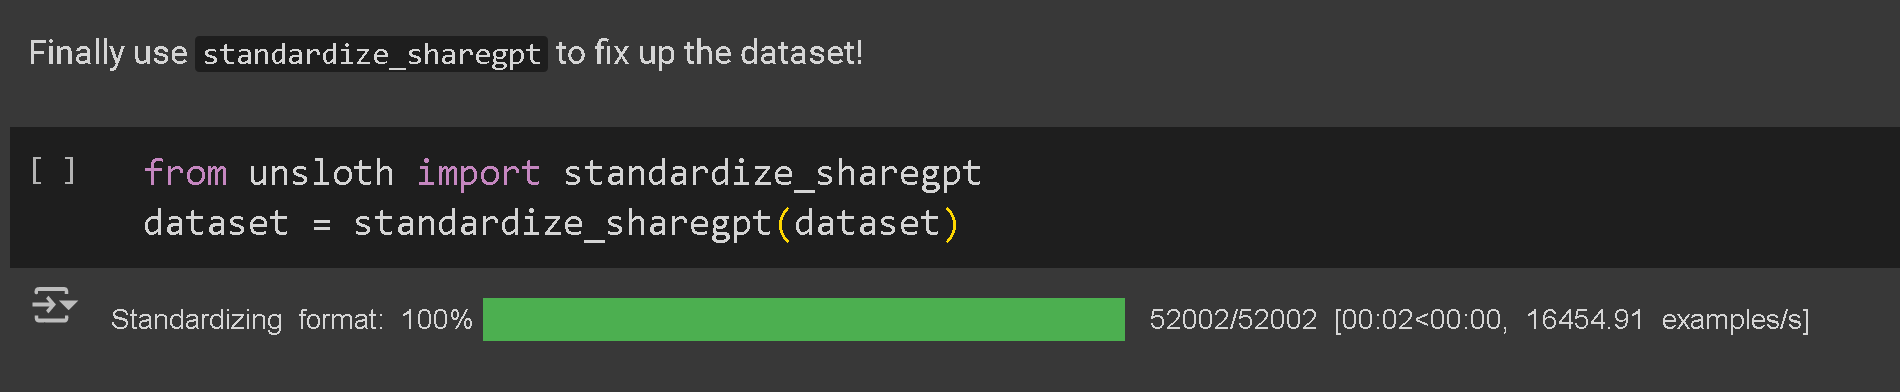
次に `standardize_sharegpt` 関数を使って、ファインチューニングに適した正しい形式にデータセットを整えます!これは必ず呼び出してください!
 ## 9. カスタマイズ可能なチャットテンプレート
これで、ファインチューニング自体のチャットテンプレートを指定できます。非常に有名なAlpaca形式は次のとおりです:
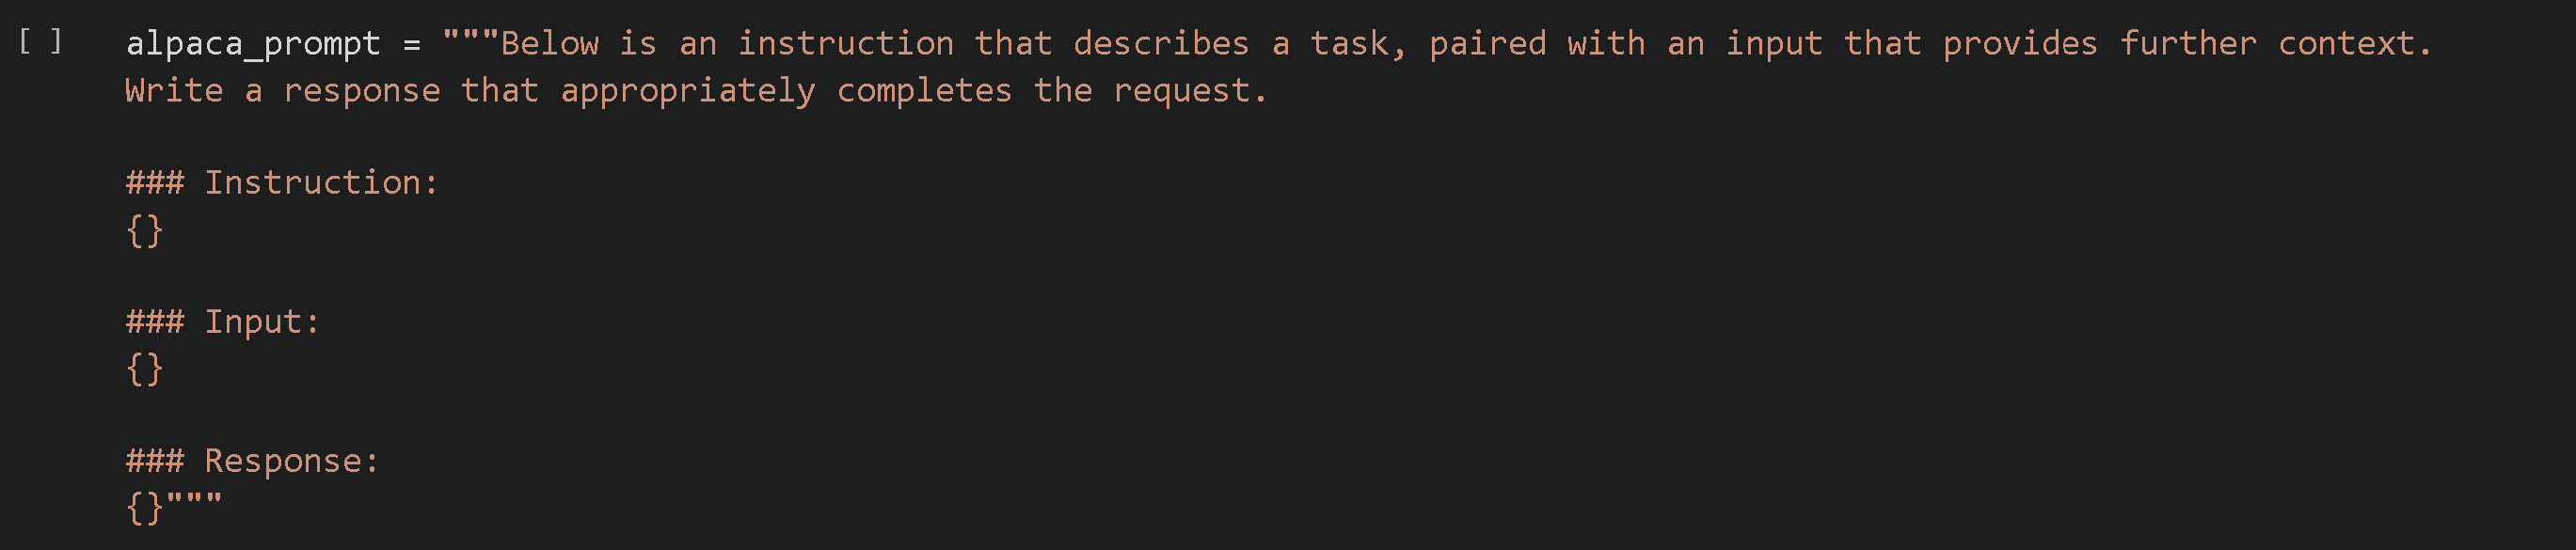 でも、ChatGPTスタイルのファインチューニングには1つのプロンプトしか必要ないので、これは悪いアイデアだと言いましたよね?Unslothを使ってすべてのデータセット列を1つに結合できたので、以下のようなスタイルのチャットテンプレートを、1つの入力列(instruction)と1つの出力で実質的に作成できます:
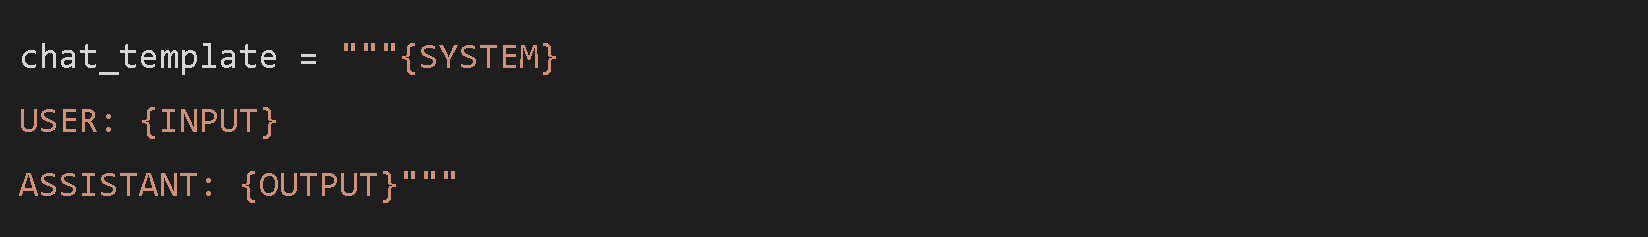
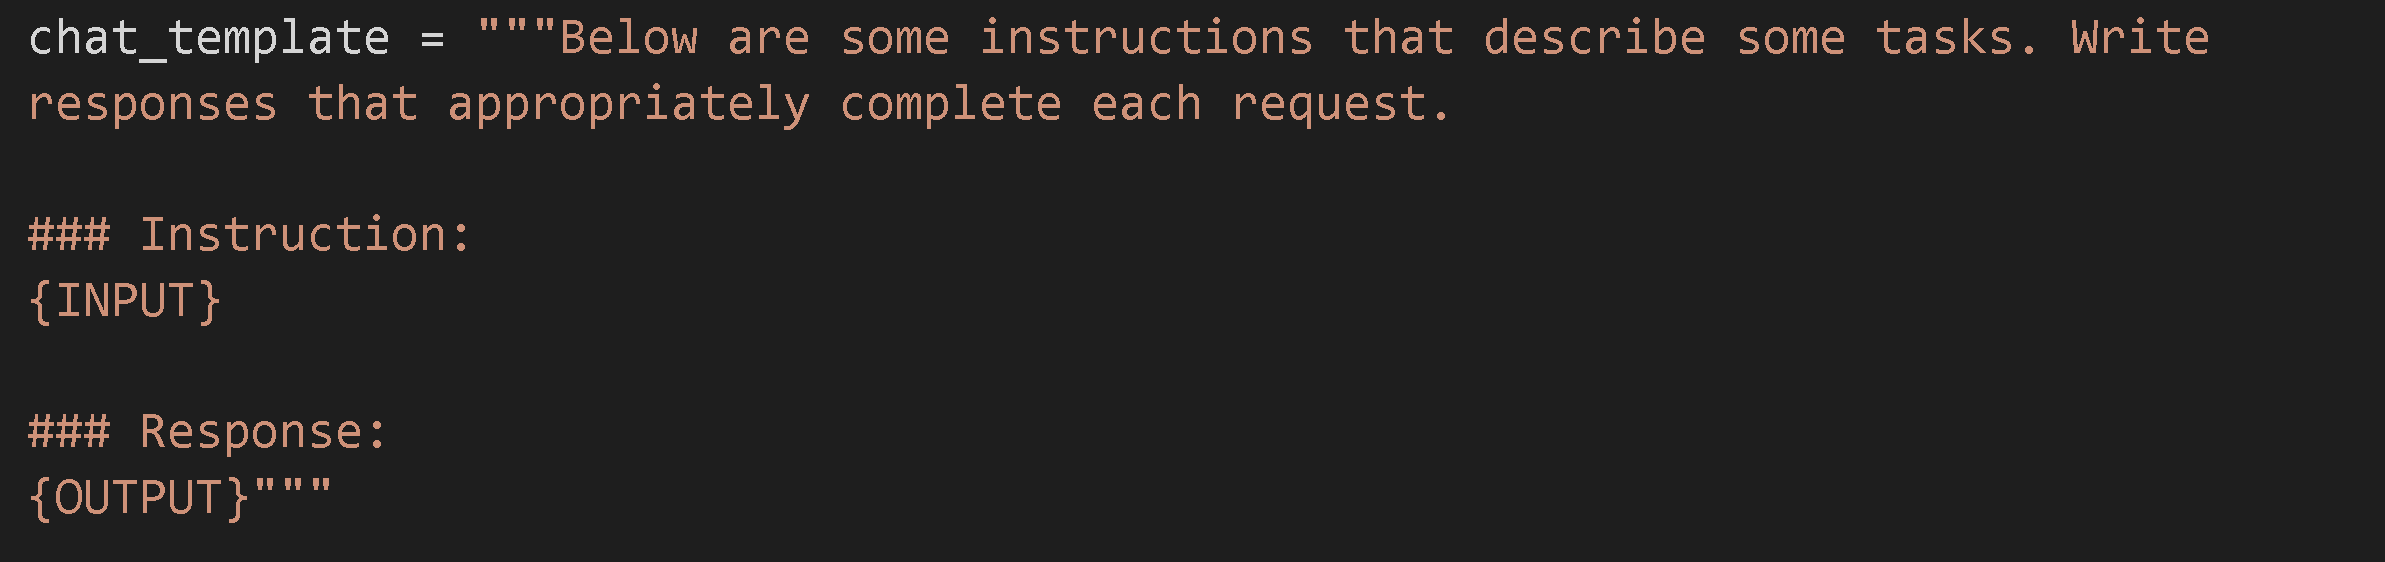 必要なのは、 `{INPUT}` フィールドを指示用に、そして `{OUTPUT}` フィールドをモデルの出力用に置くことだけです。実際には任意の `{SYSTEM}` フィールドも許可しており、ChatGPTのようにシステムプロンプトをカスタマイズするのに便利です。たとえば、以下はチャットテンプレートをカスタマイズできるかっこいい例です:
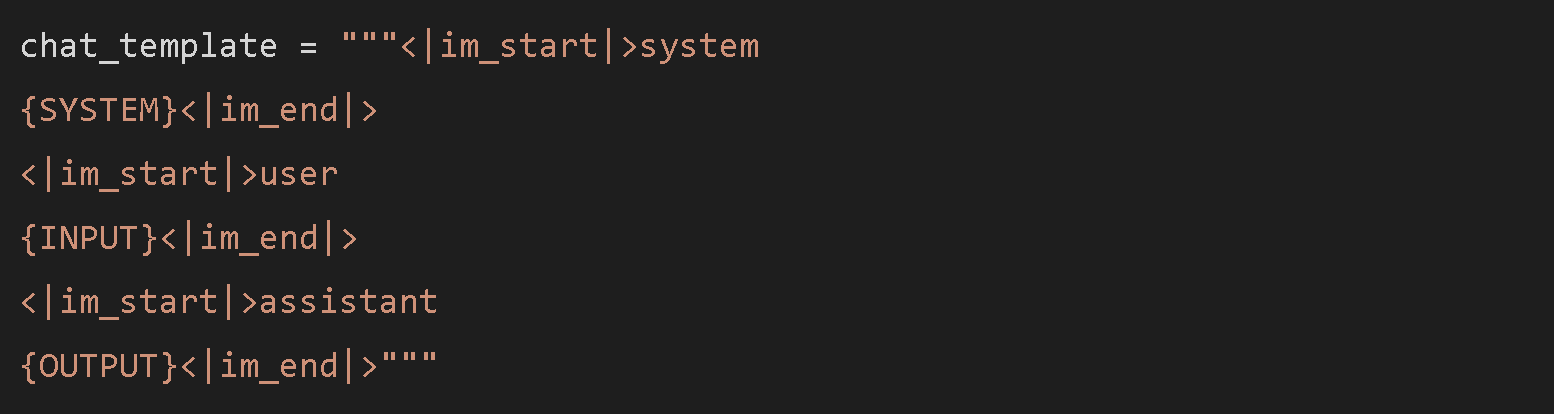
 OpenAIモデルで使われるChatML形式では:
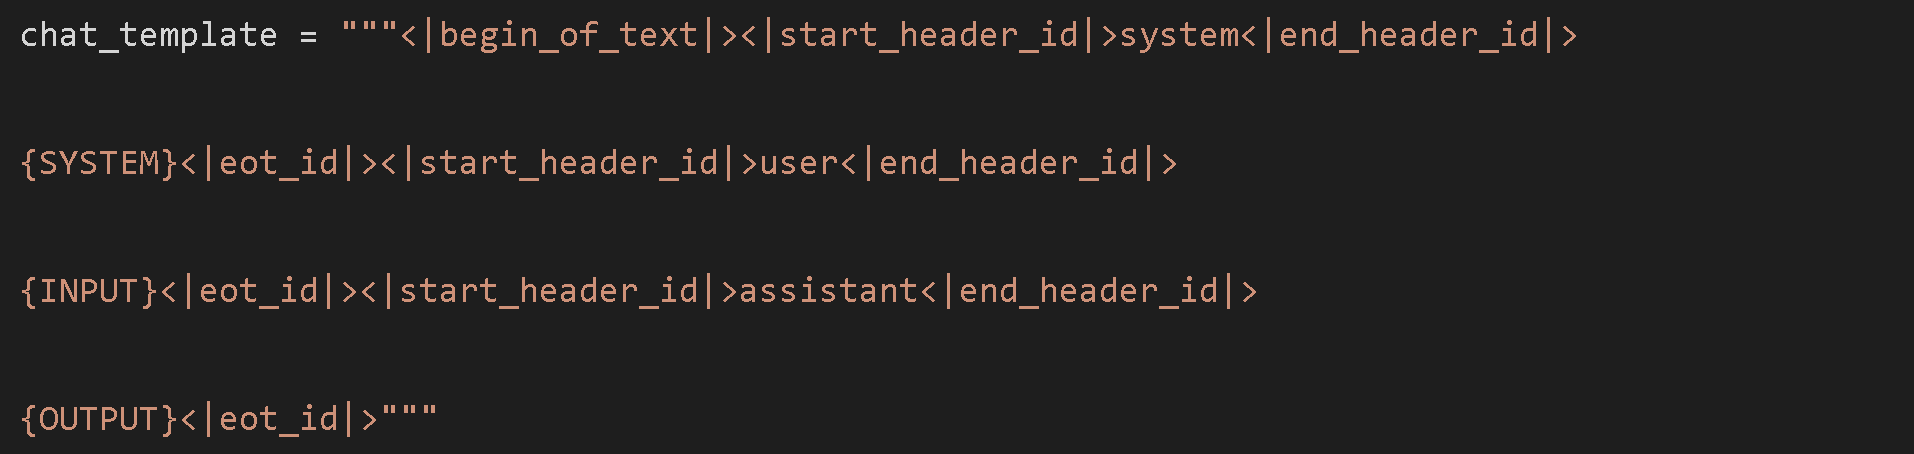
 または、Llama-3テンプレート自体を使うこともできます(これはLlama-3のinstruct版を使うことでのみ機能します):実際には任意の `{SYSTEM}` フィールドも許可しており、ChatGPTのようにシステムプロンプトをカスタマイズするのに便利です。
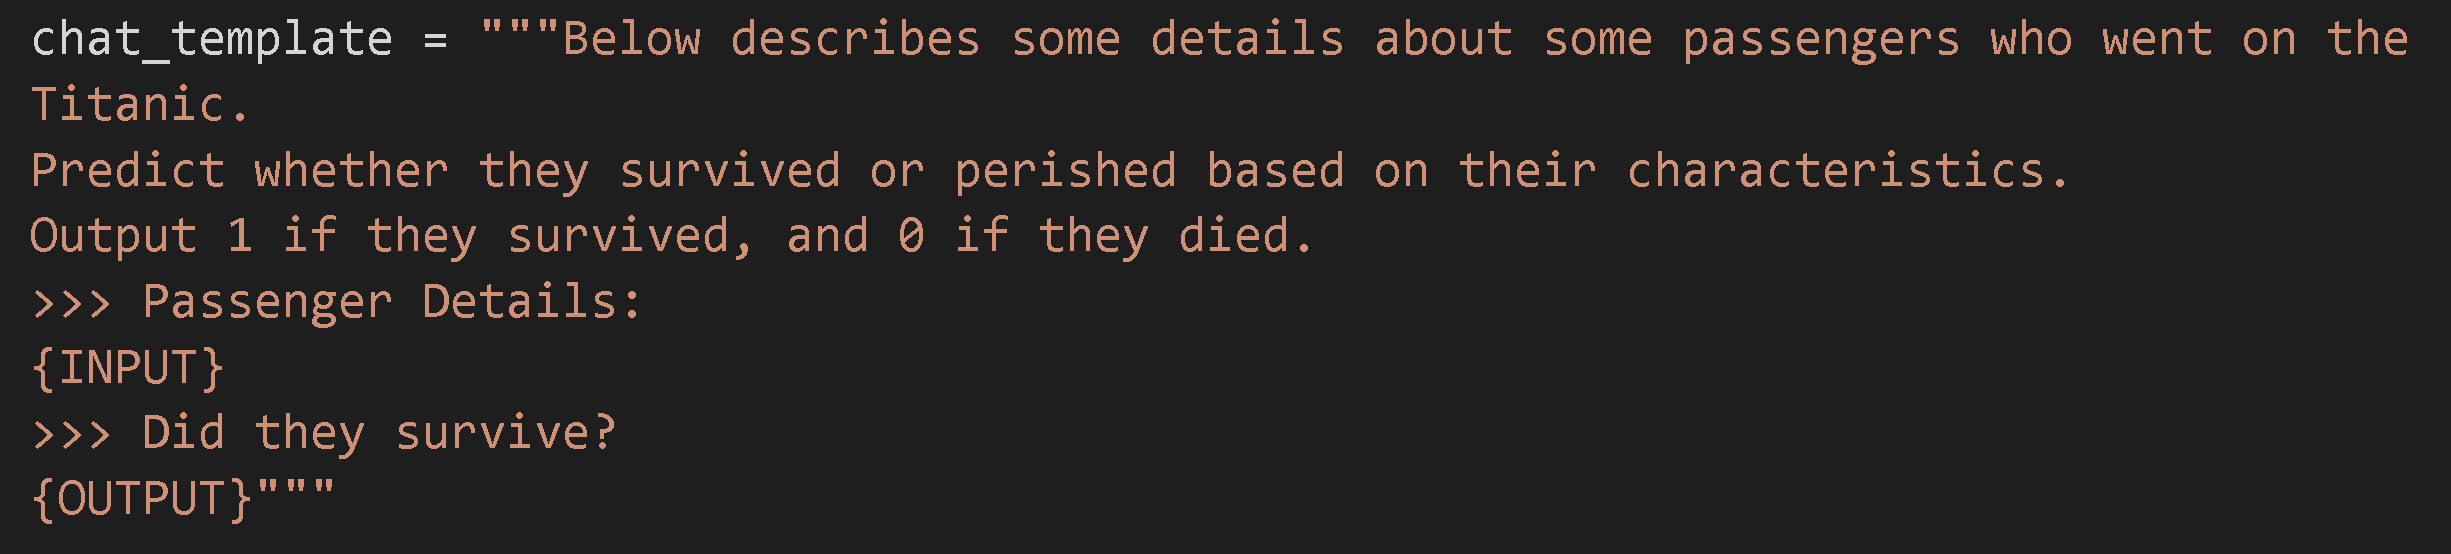
 あるいは、CSVやExcelのアップロードを含むこのColabノートブックで、乗客が死亡したか生存したかを予測する必要があったタイタニック予測タスクでは:
 ## 10. モデルの学習
ではモデルを学習しましょう!通常は、より長くファインチューニングしたい場合や大きなバッチサイズで学習したい場合を除いて、以下は編集しないことをおすすめします。
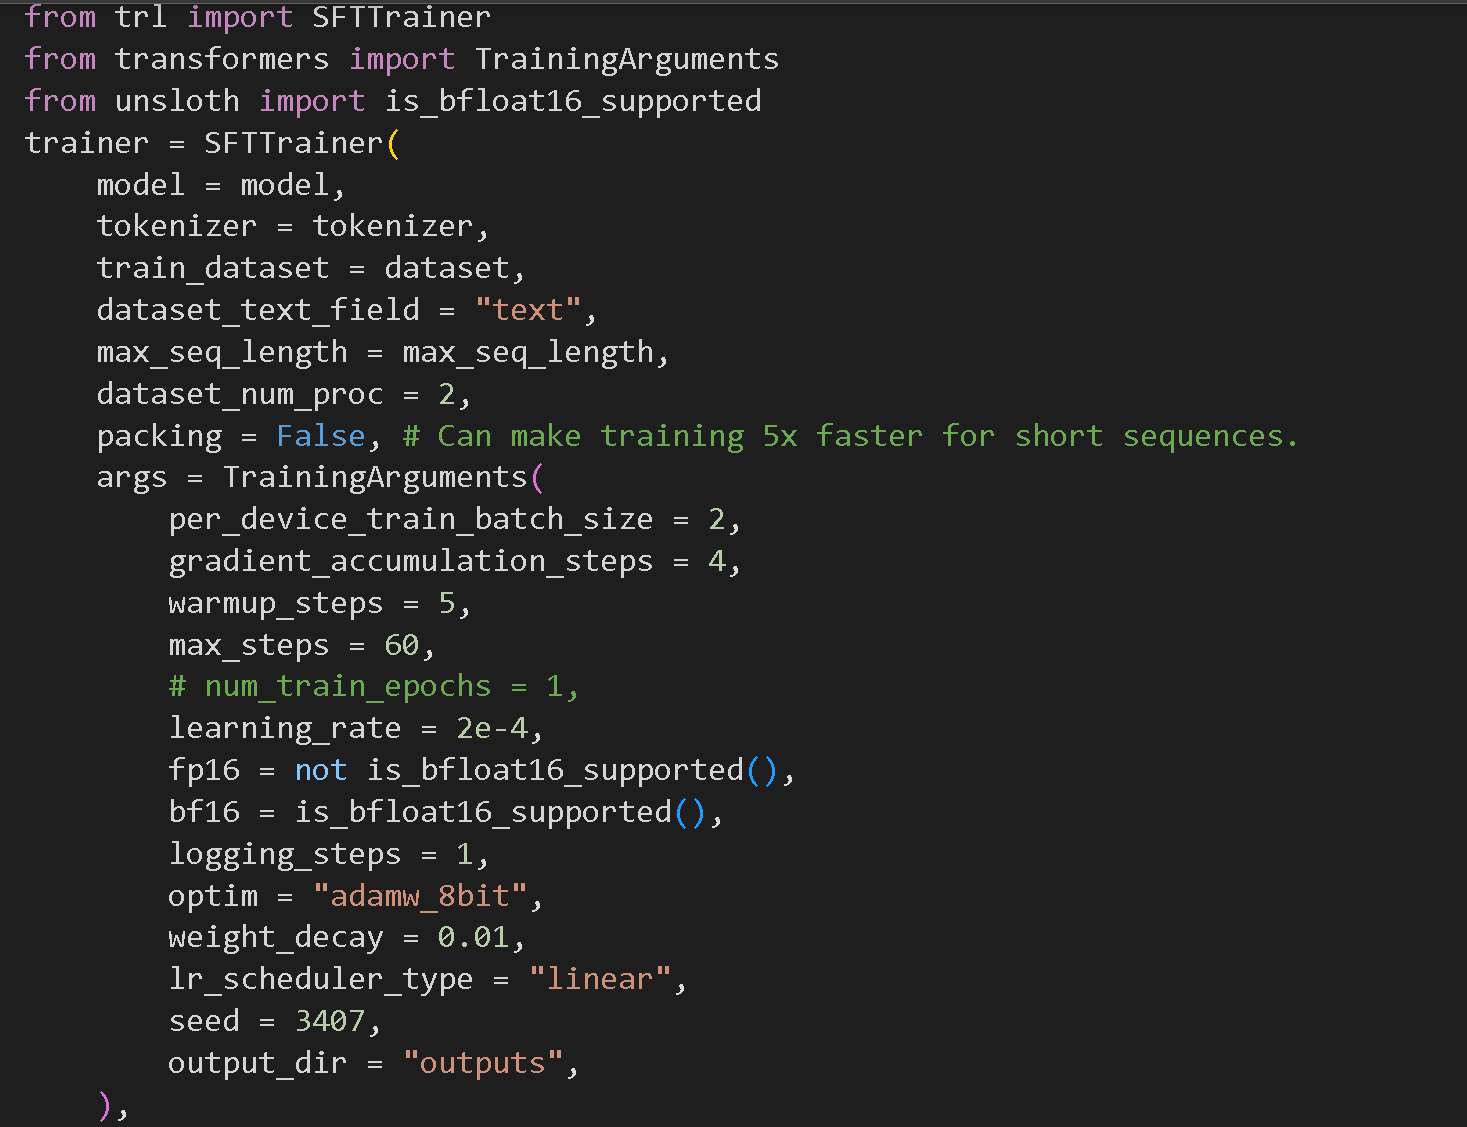 通常は上のパラメータを変更することはおすすめしませんが、いくつか補足すると:
1. ```python
per_device_train_batch_size = 2,
```
GPUのメモリをもっと活用したいならバッチサイズを増やしてください。また、学習をより滑らかにし、過学習しにくくするためにも増やせます。ですが、パディングの問題で学習が実際には遅くなるかもしれないので、通常はおすすめしません。代わりに、私たちは通常 `gradient_accumulation_steps` を増やすことをお願いしています。
2. ```python
gradient_accumulation_steps = 4,
```
バッチサイズそのものを増やすのと同等ですが、メモリ消費には影響しません!学習損失の曲線をより滑らかにしたい場合は、これを増やすことを通常おすすめします。
3. ```python
max_steps = 60, # num_train_epochs = 1,
```
学習を速くするためにステップ数を60に設定しています。数時間かかるフル学習を行う場合は、代わりに `max_steps`をコメントアウトし、代わりに `num_train_epochs = 1`を使ってください。1に設定すると、データセットを1回完全に通過することを意味します。通常は1〜3回の通過を推奨し、それ以上はおすすめしません。さもないとファインチューニングが過学習します。
4. ```python
learning_rate = 2e-4,
```
学習率を下げると、ファインチューニングは遅くなりますが、より高い精度に収束しやすくなります。通常は試す値として 2e-4、1e-4、5e-5、2e-5 を推奨します。
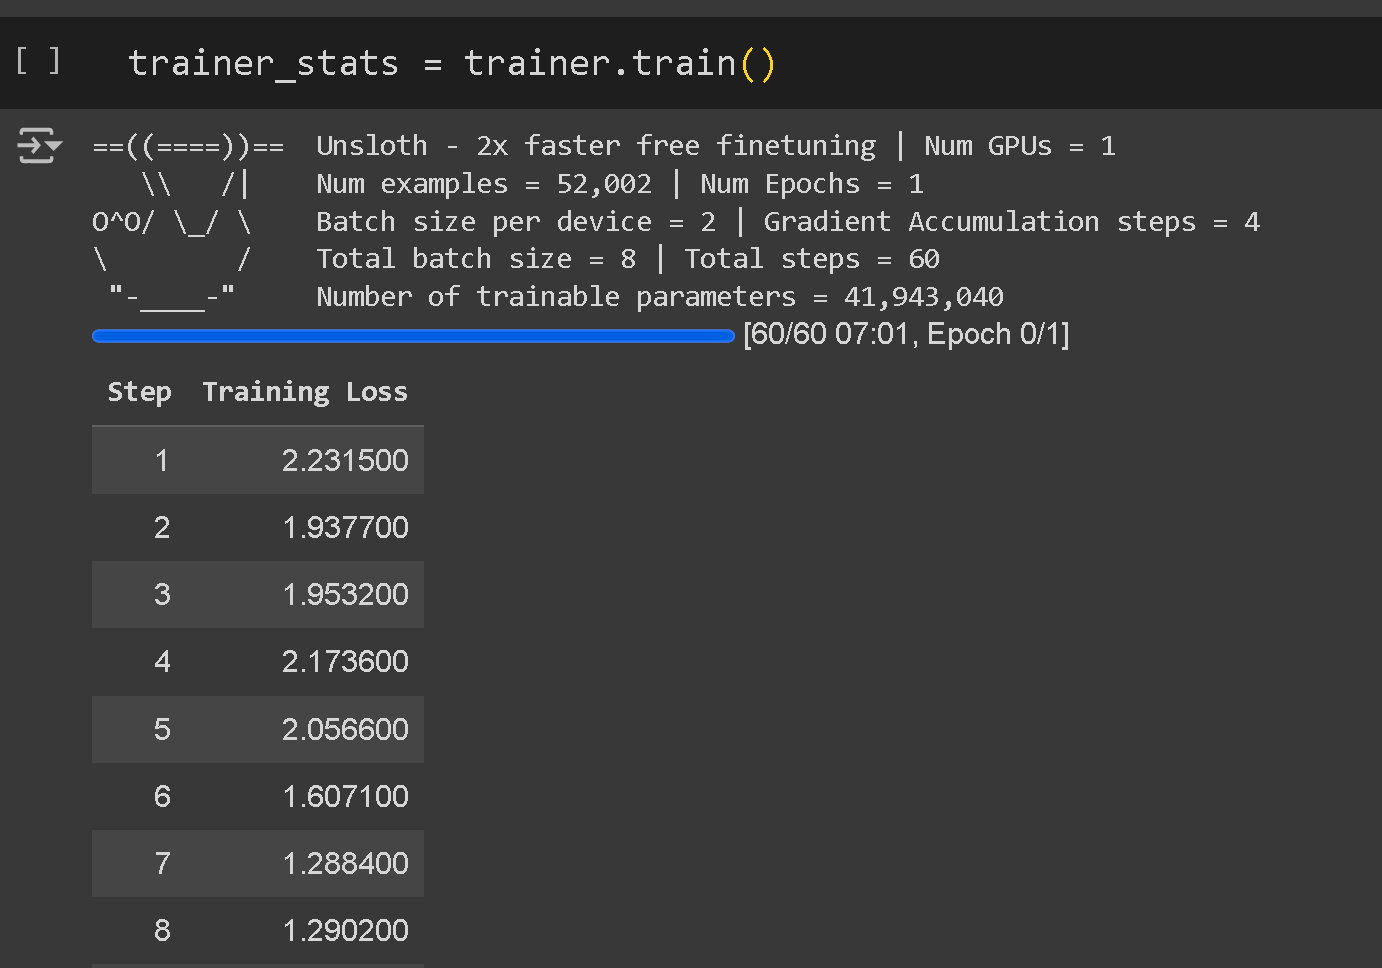 学習中に数値のログが表示されます。これは学習損失で、モデルがデータセットからどれだけうまく学んでいるかを示します。多くの場合、損失が0.5〜1.0あたりなら良い兆候ですが、データセットとタスクによって異なります。損失が下がらない場合は、設定を調整する必要があるかもしれません。損失が0になる場合は過学習の可能性があるので、検証も確認することが重要です。
## 11. 推論 / モデルの実行
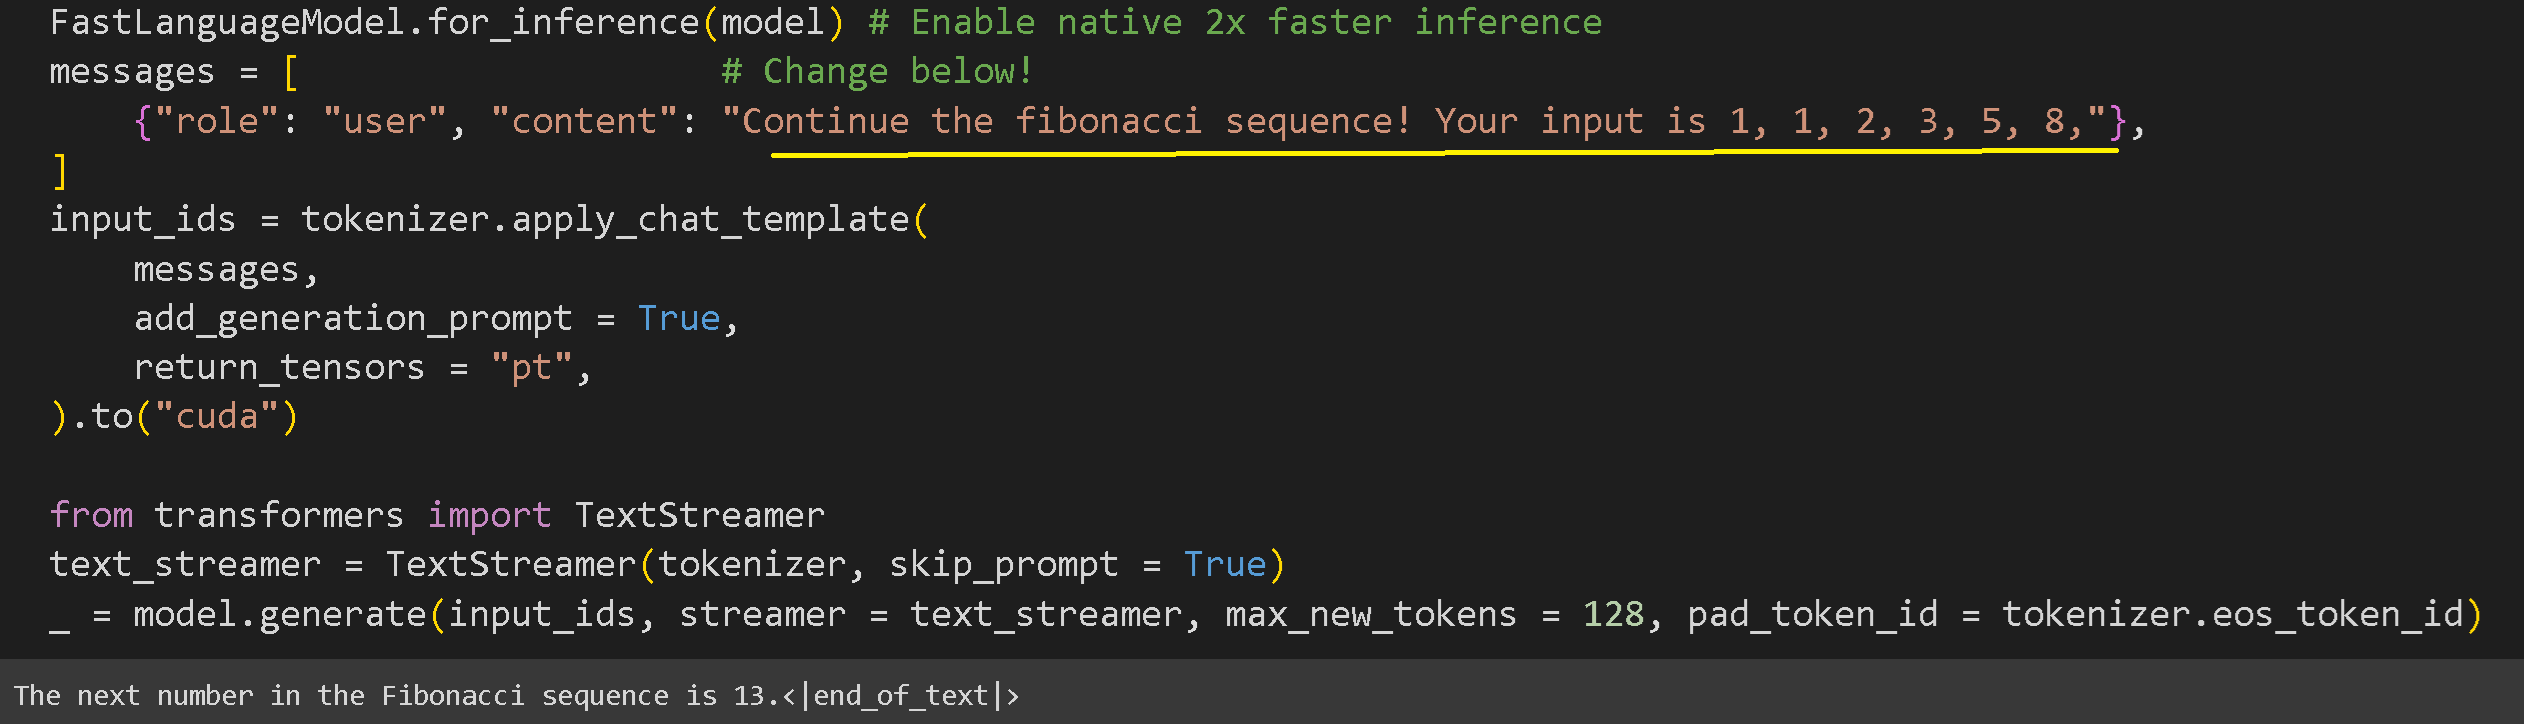 では、学習が完了した後にモデルを実行してみましょう!黄色の下線が引かれた部分は編集できます!実際、マルチターンチャットボットを作成したので、下のように過去の会話を見ていたかのようにモデルを呼び出すこともできます:
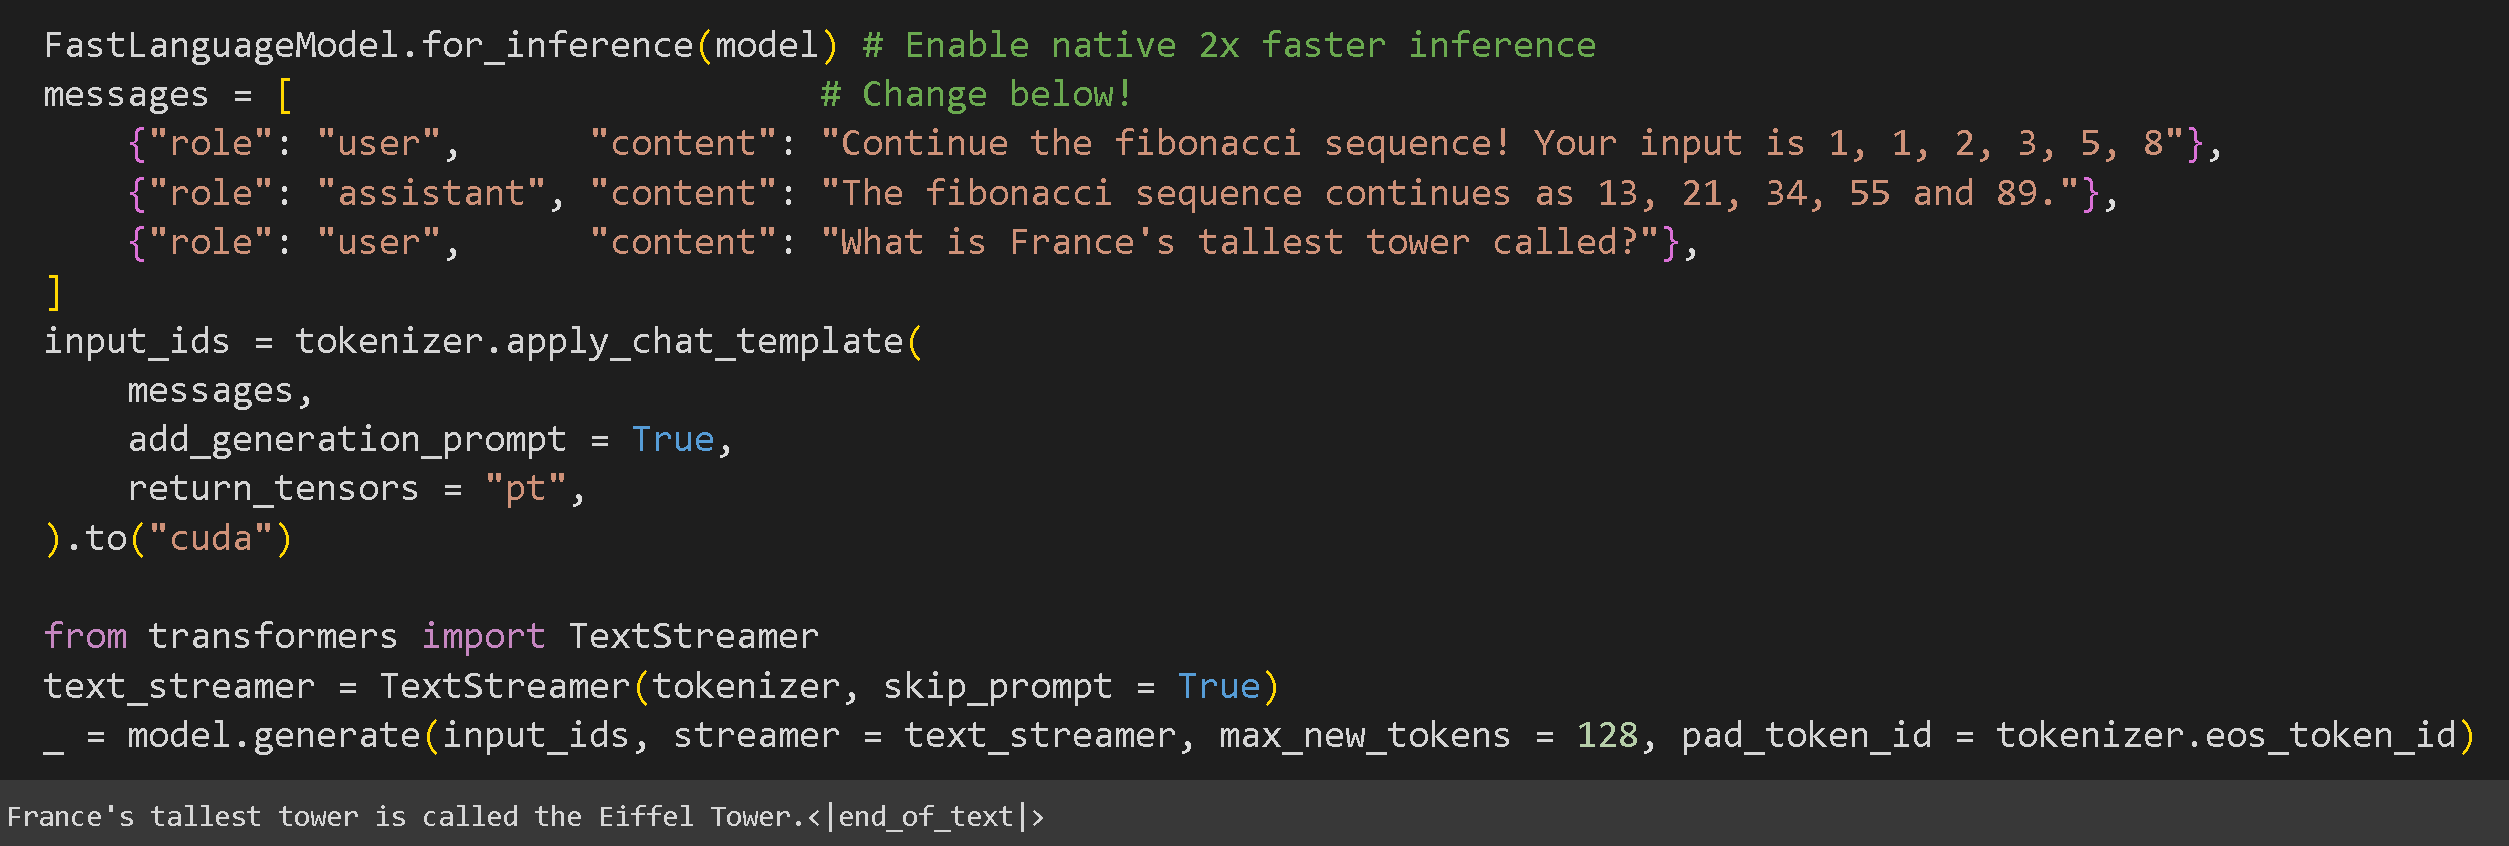 Unsloth自体が **2倍高速な推論** もネイティブに提供しているので、 `FastLanguageModel.for_inference(model)`を呼び出すのを忘れないでください。より長い応答を出したい場合は、 `max_new_tokens = 128` を256や1024のようなより大きな数に設定してください。結果を待つ時間も長くなることに注意してください!
## 12. モデルの保存
ファインチューニング済みモデルは、下のようなLoRAアダプタと呼ばれる100MBの小さなファイルとして保存できます。モデルをアップロードしたい場合は、代わりにHugging Face Hubへプッシュすることもできます!Hugging Faceトークンは そしてトークンを追加してください!
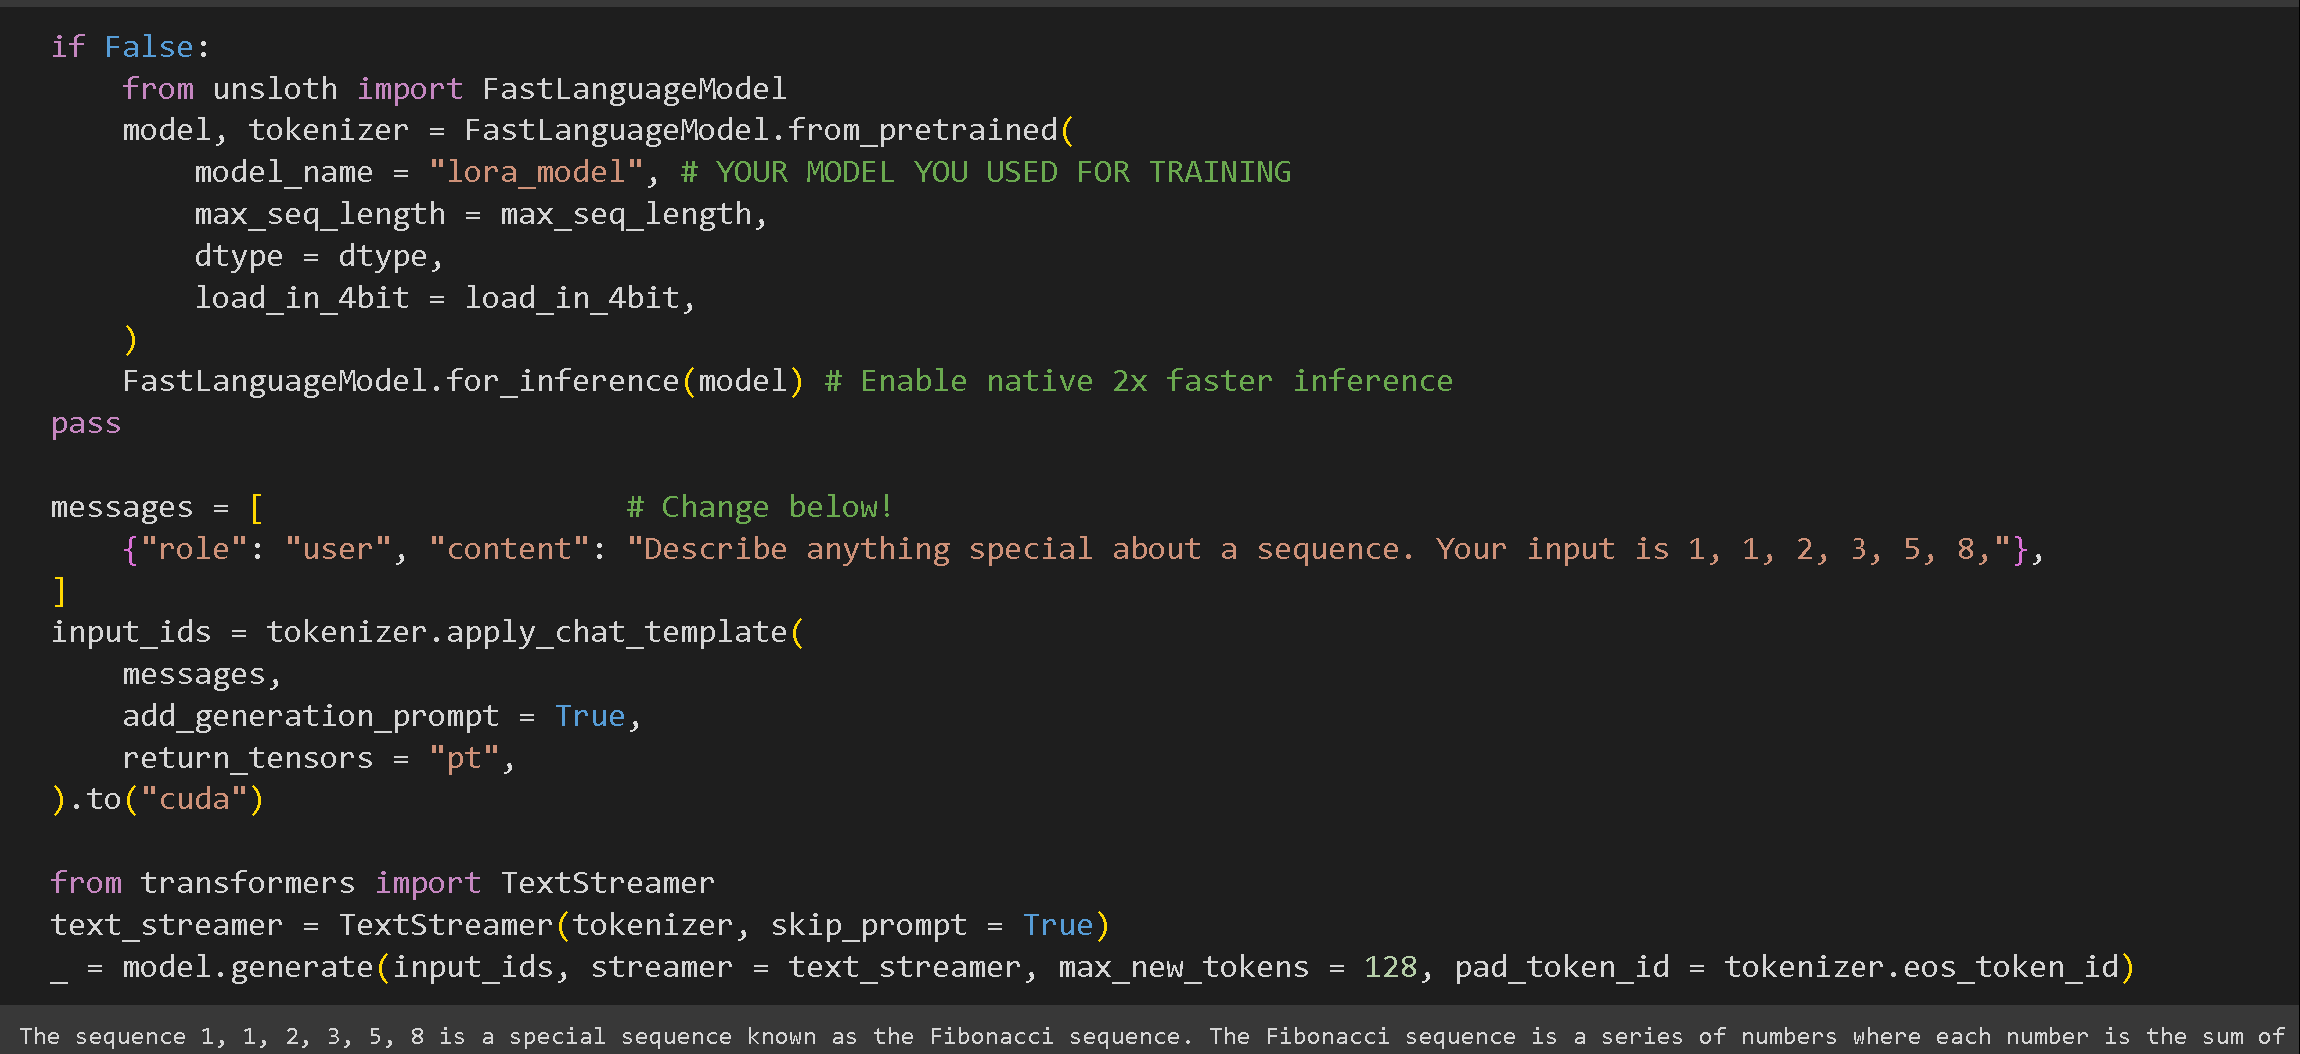
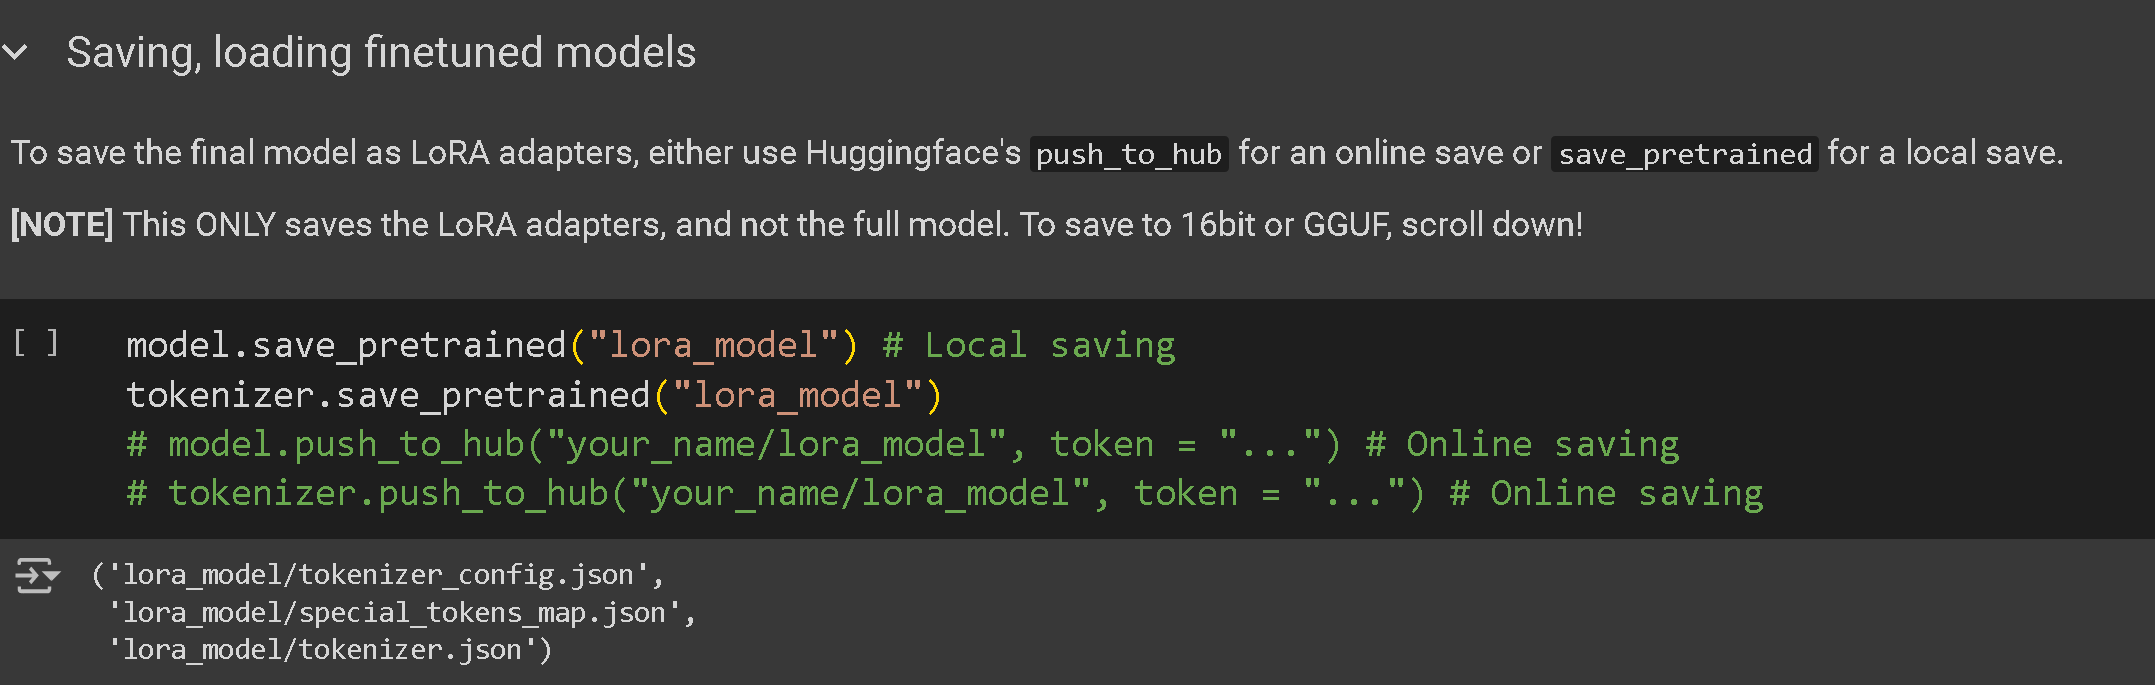 モデルを保存したあと、もう一度 Unsloth を使ってモデル自体を実行できます! `FastLanguageModel` をもう一度使って推論を呼び出しましょう!
 ## 13. Ollamaへのエクスポート
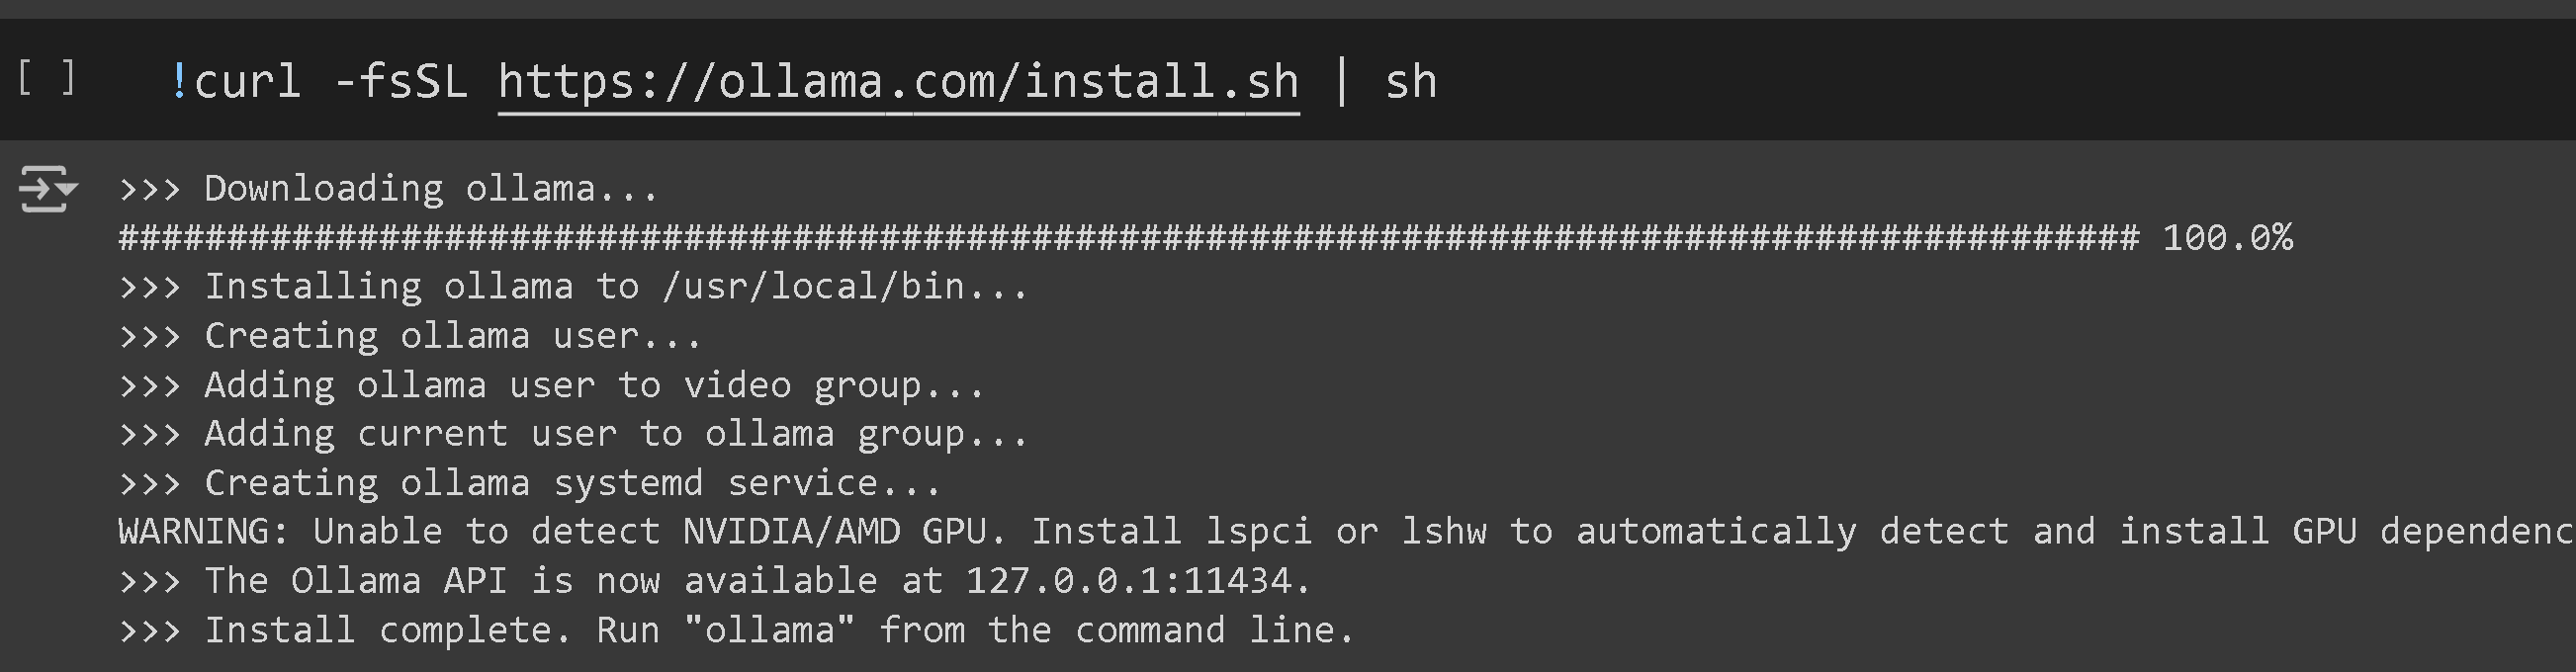
最後に、ファインチューニングしたモデルを Ollama 自体へエクスポートできます!まず Colab ノートブックに Ollama をインストールする必要があります:
 その後、以下のようにファインチューニング済みモデルを llama.cpp の GGUF 形式へエクスポートします:
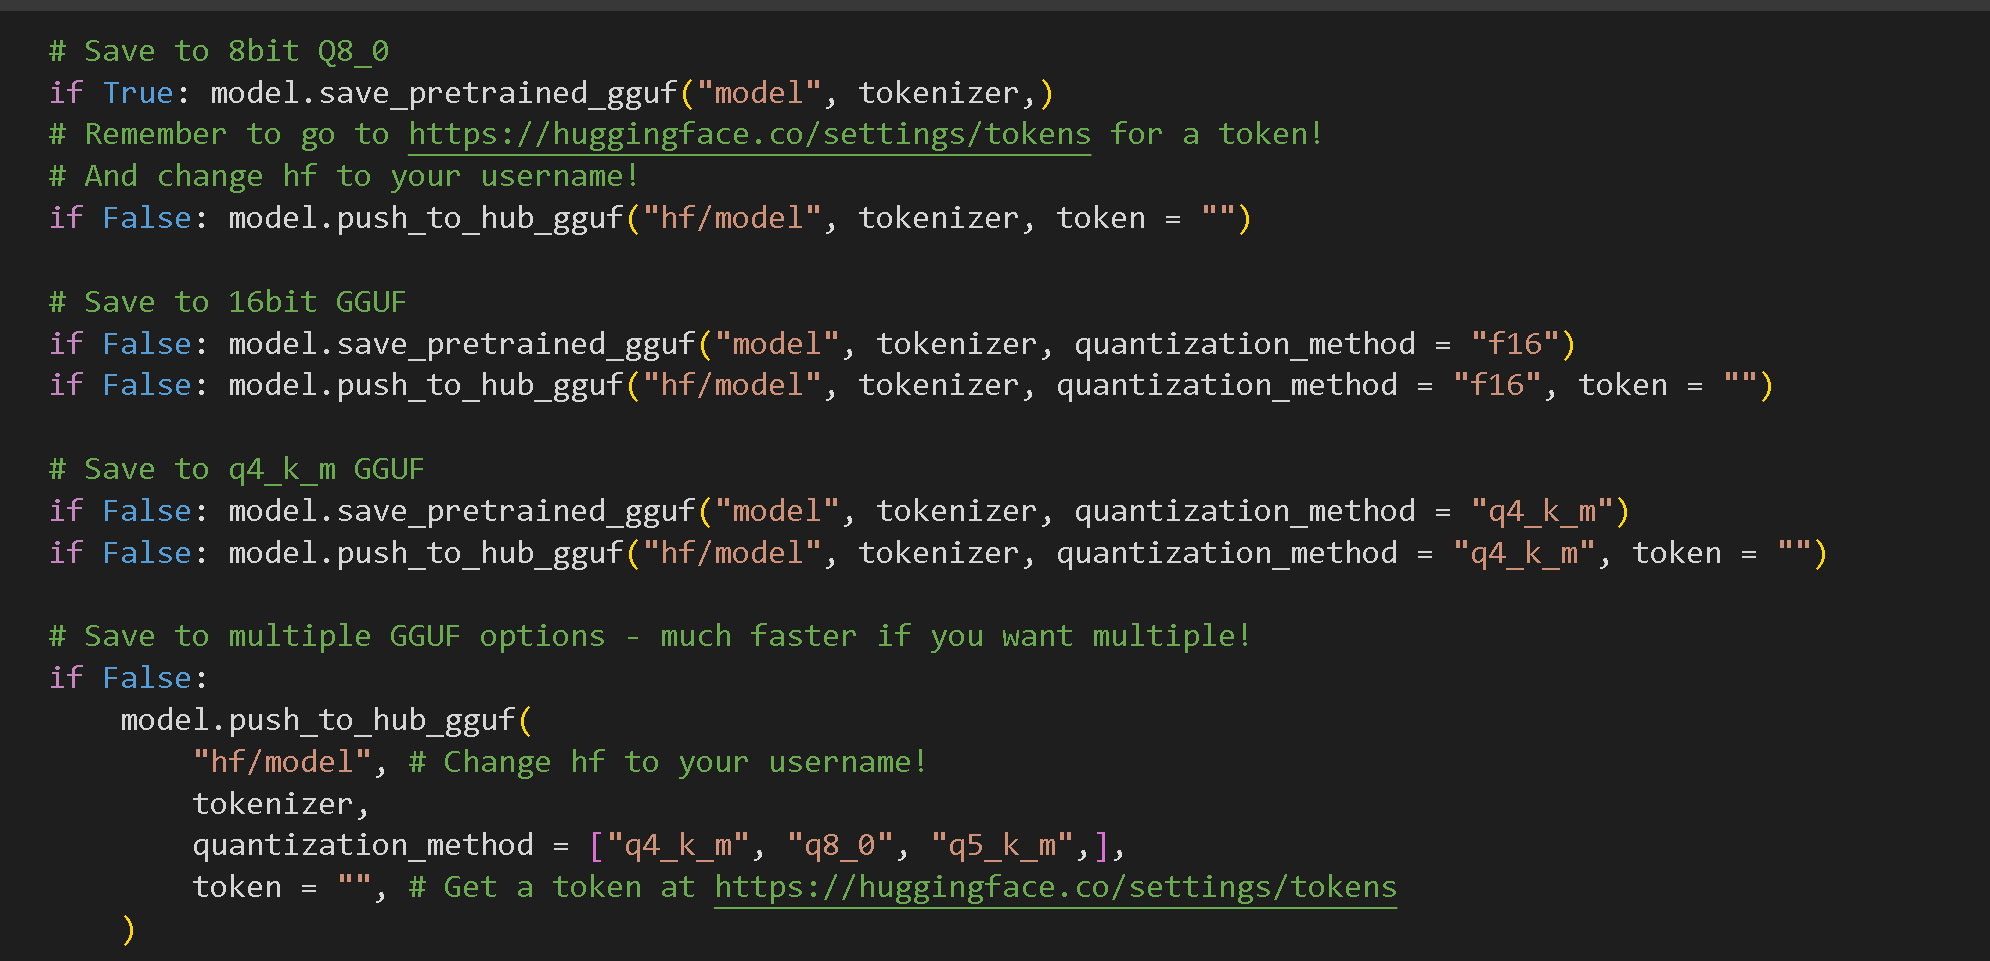 変換の注意 `False` を `True` を 1 行目に対して設定し、すべての行を `True`に変更しないでください。さもないと、かなり長い時間待つことになります!通常は最初の行を `True`に設定することをおすすめします。そうすれば、ファインチューニング済みモデルを次の形式へ素早くエクスポートできます `Q8_0` 形式(8ビット量子化)。また、量子化手法の一覧全体へエクスポートすることもできます。人気のあるものの一つは `q4_k_m`.
こちらへアクセスして GGUF についてさらに学んでください。GGUF へのエクスポート方法について、手動の手順もこちらにあります:
以下のような長いテキストの一覧が表示されますが、5〜10 分ほどお待ちください!!
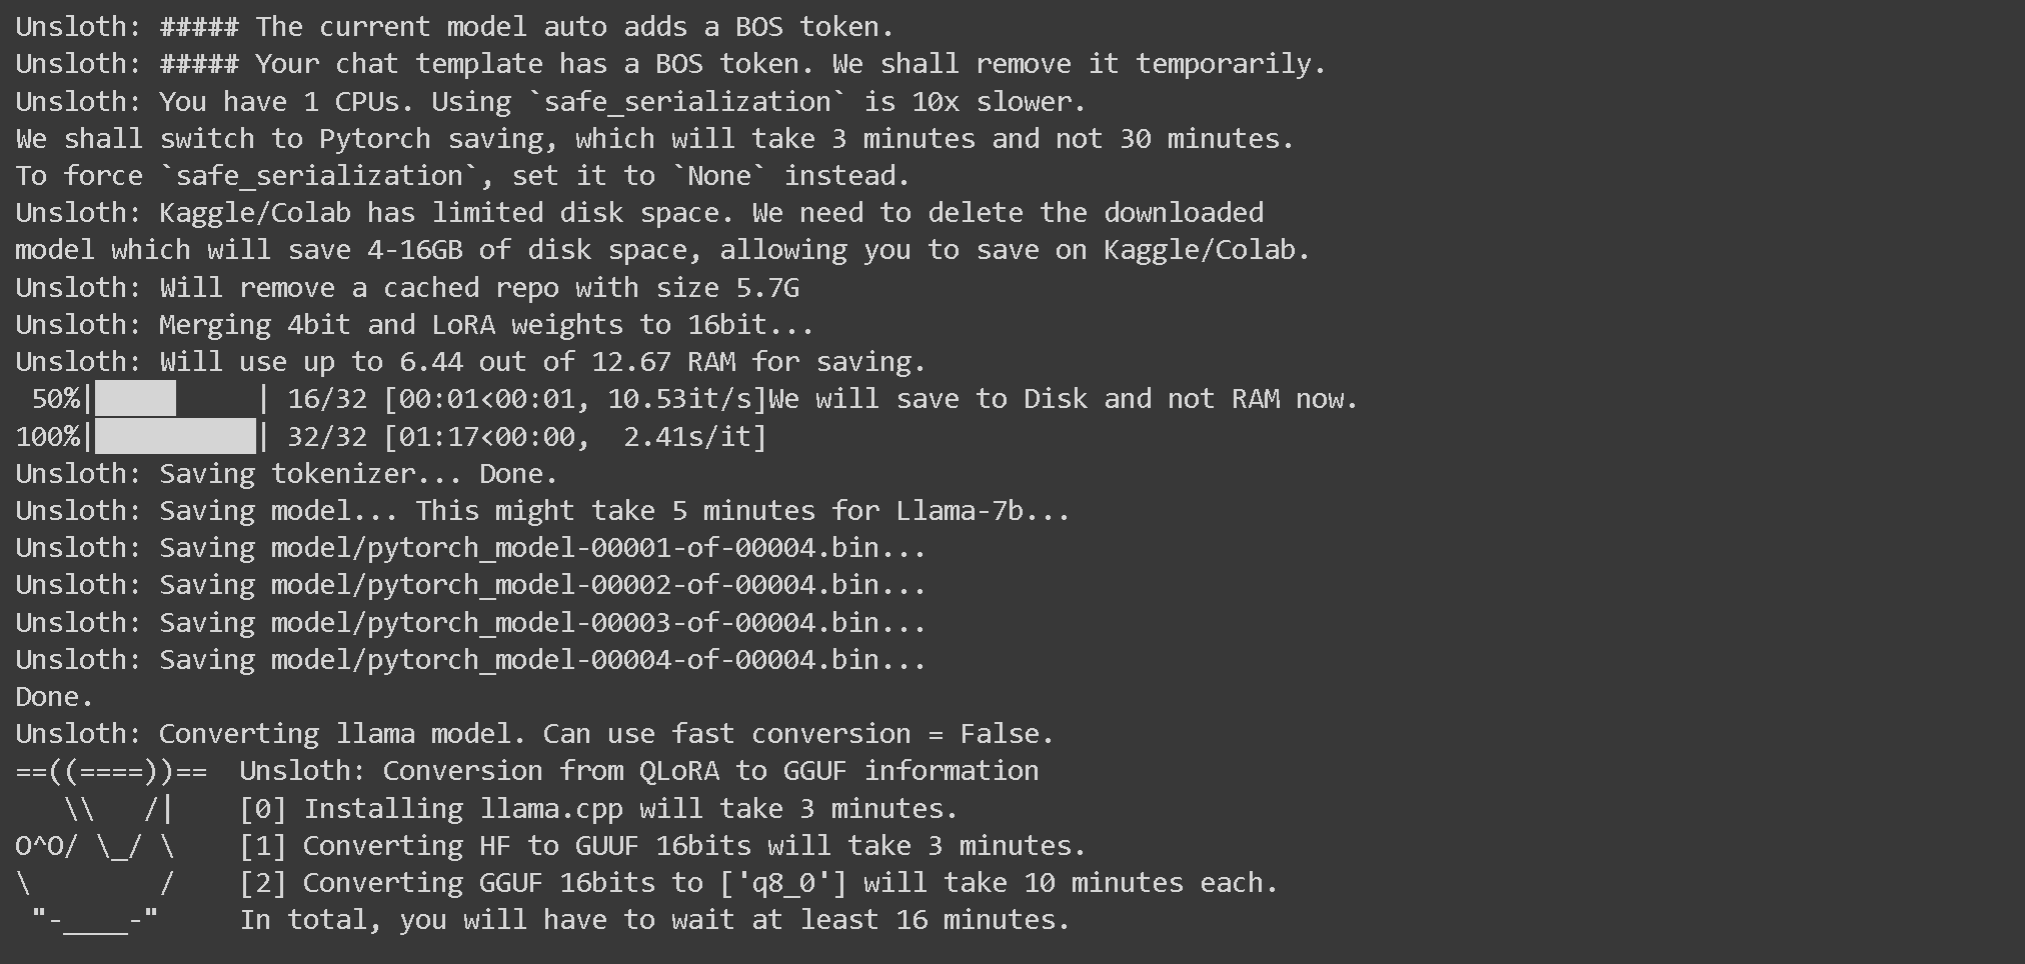 そして最後の最後には、以下のようになります:
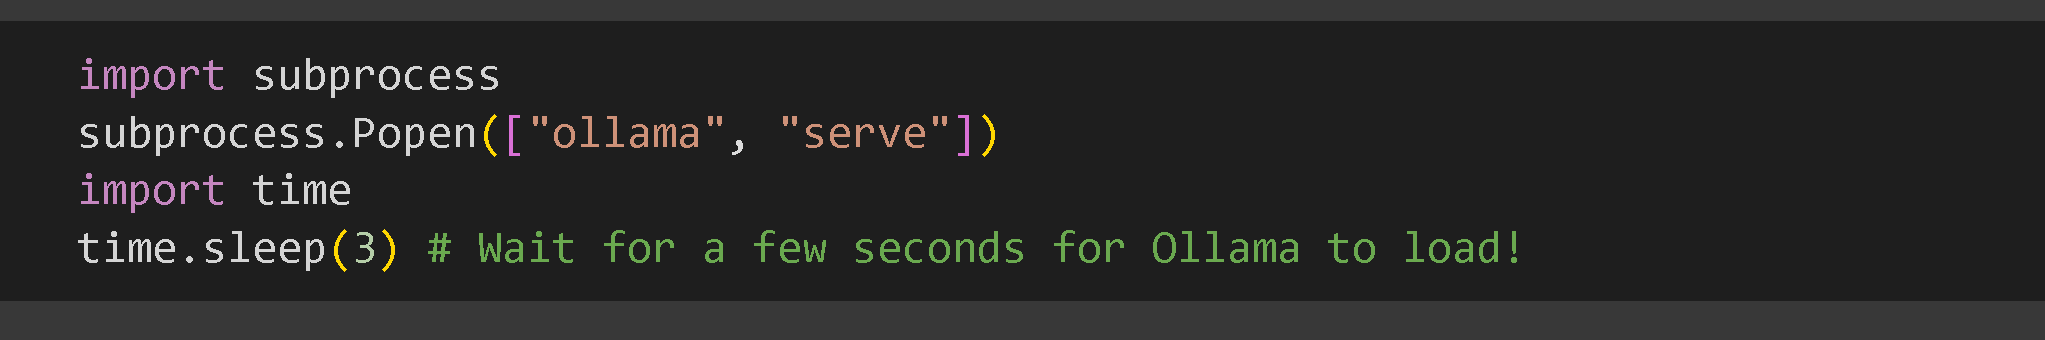
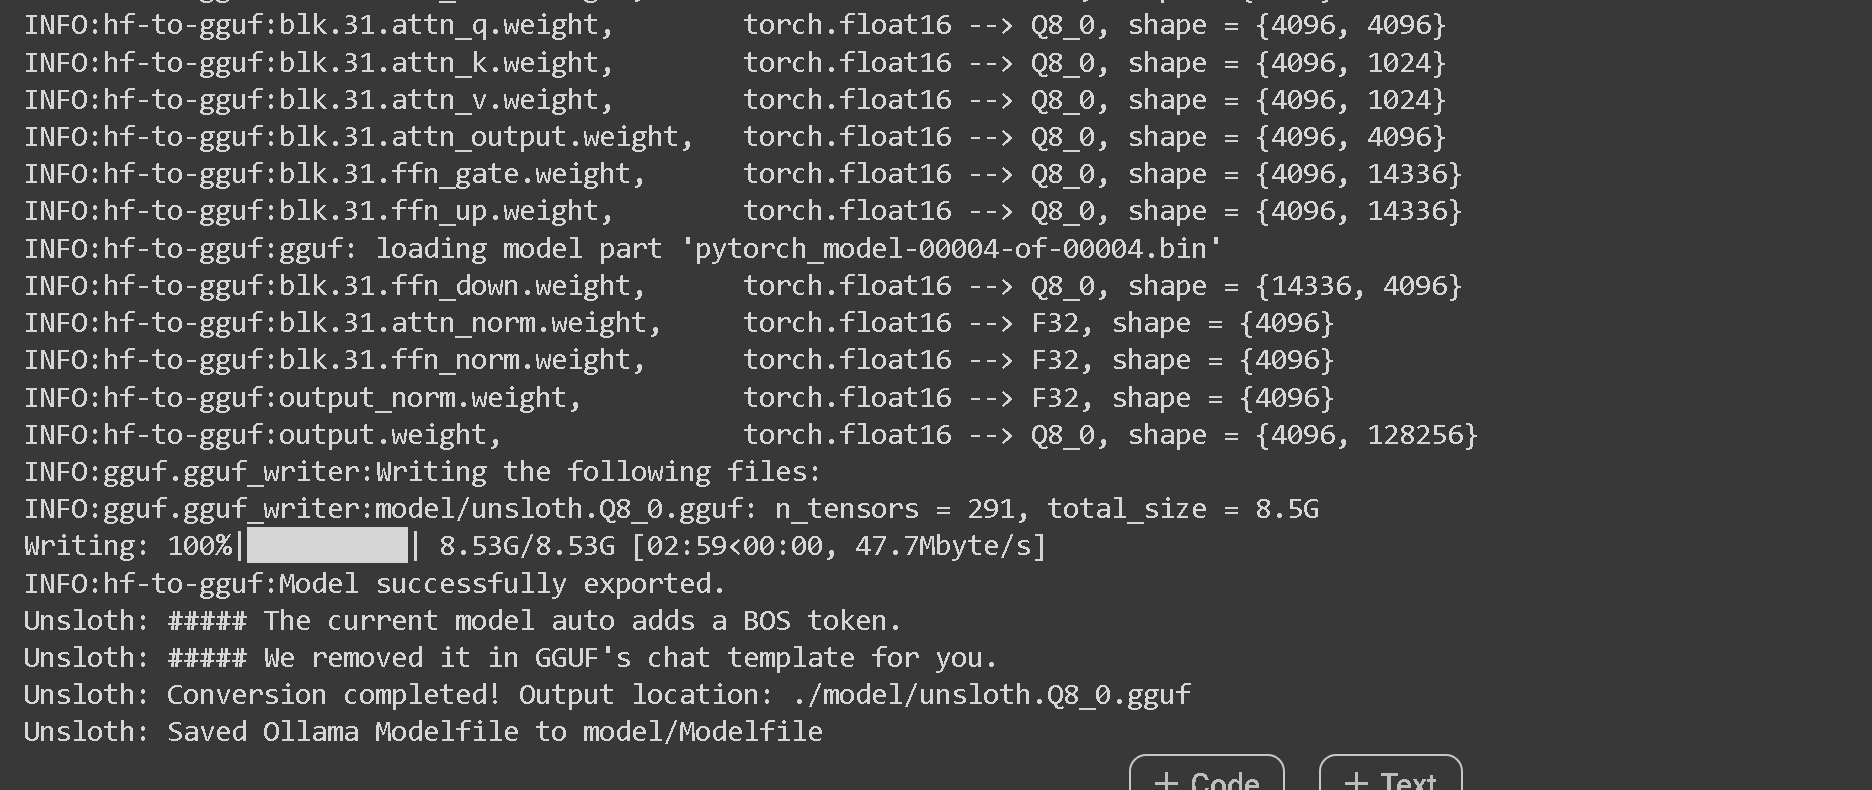 次に、Ollama 自体をバックグラウンドで実行する必要があります。そこで `subprocess` を使います。Colab は非同期呼び出しを好まないためですが、通常は `ollama serve` をターミナル / コマンドプロンプトで実行するだけです。
 ## 14. 自動 `Modelfile` 作成
Unsloth が提供するトリックは、私たちが自動的に `Modelfile` を作成することです。これは Ollama に必要なものです!これは設定の一覧であり、ファインチューニング時に使ったチャットテンプレートも含まれます!さらに、 `Modelfile` が以下のように生成されたものを表示することもできます:
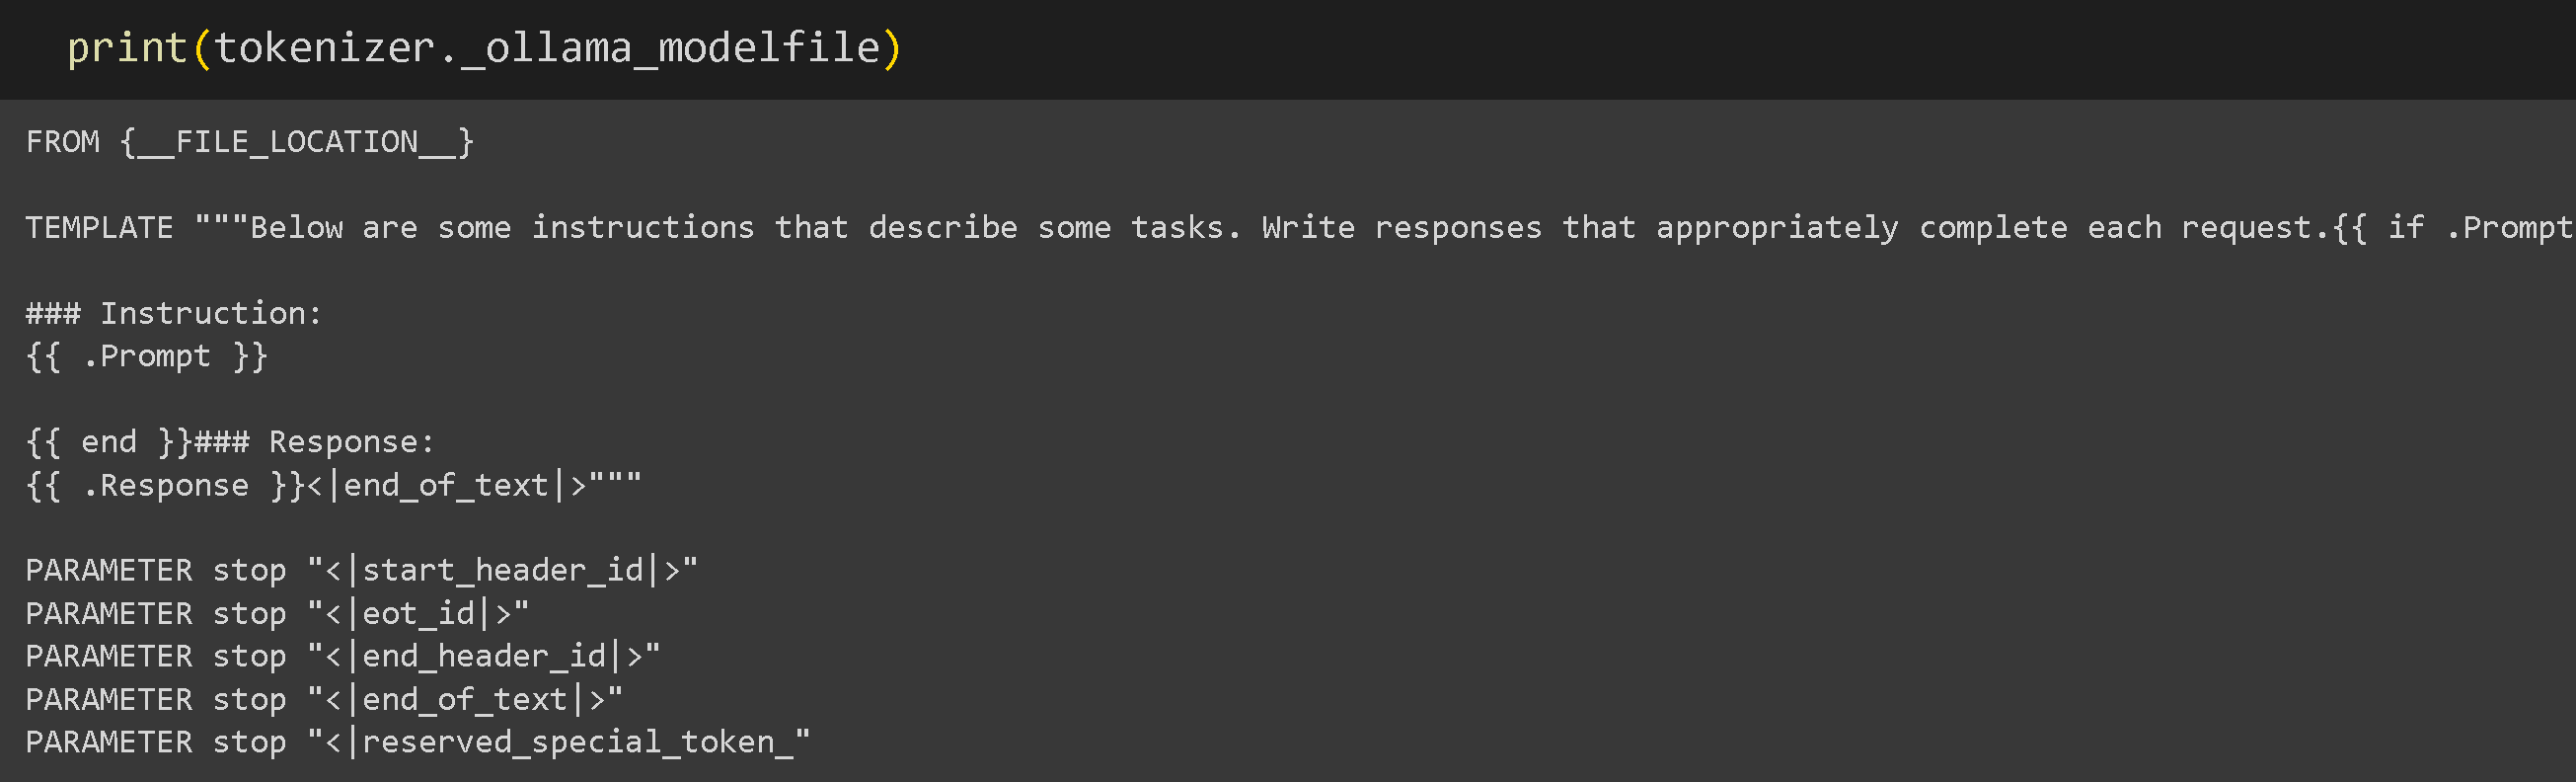 その後、 `Modelfile`
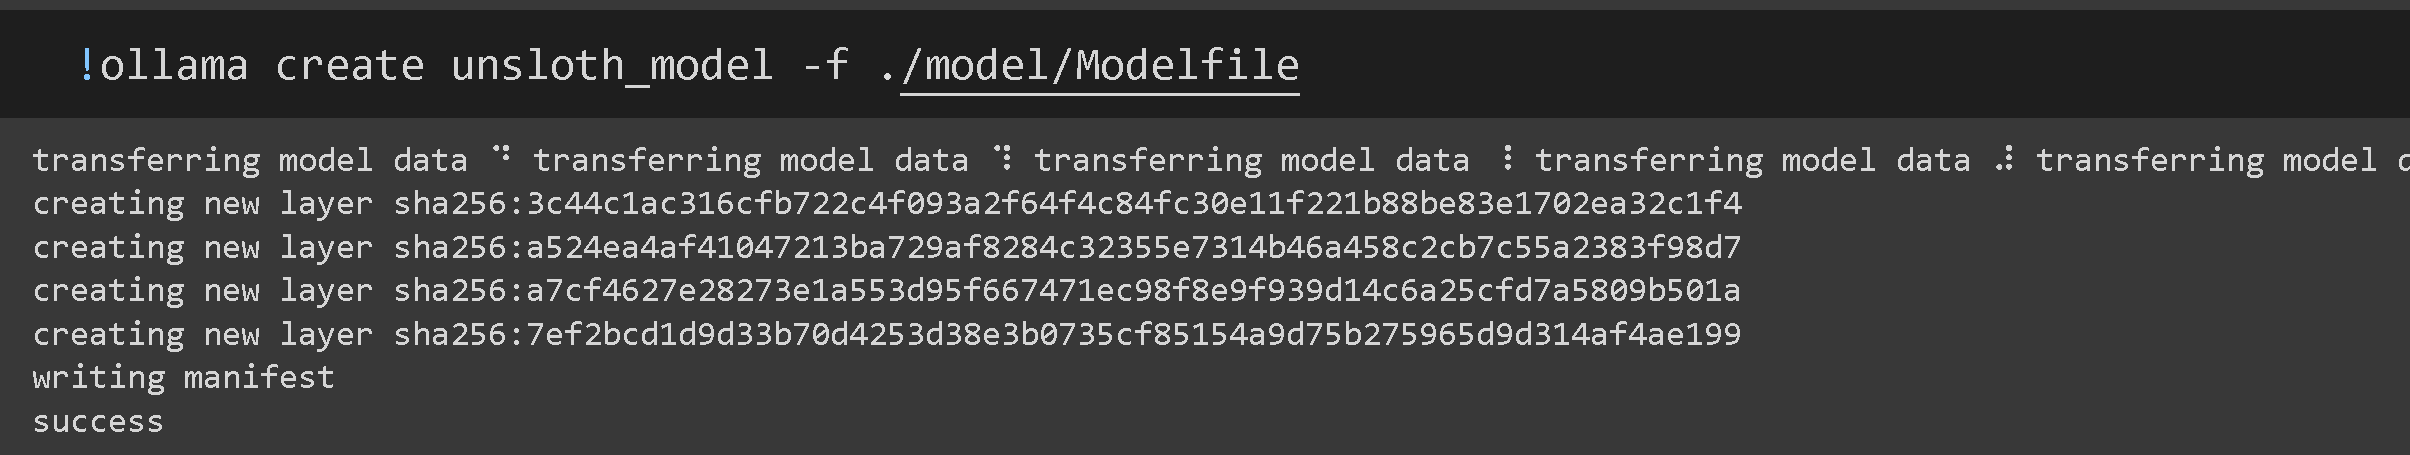 ## 15. Ollama推論
を使って、Ollama 互換のモデルを作成するよう Ollama に依頼します。これは、あなた自身のローカルマシン上、または無料の Colab ノートブック上でバックグラウンド実行されている Ollama サーバー自体を呼び出して推論したい場合にも使えます。黄色の下線部分は編集できます。
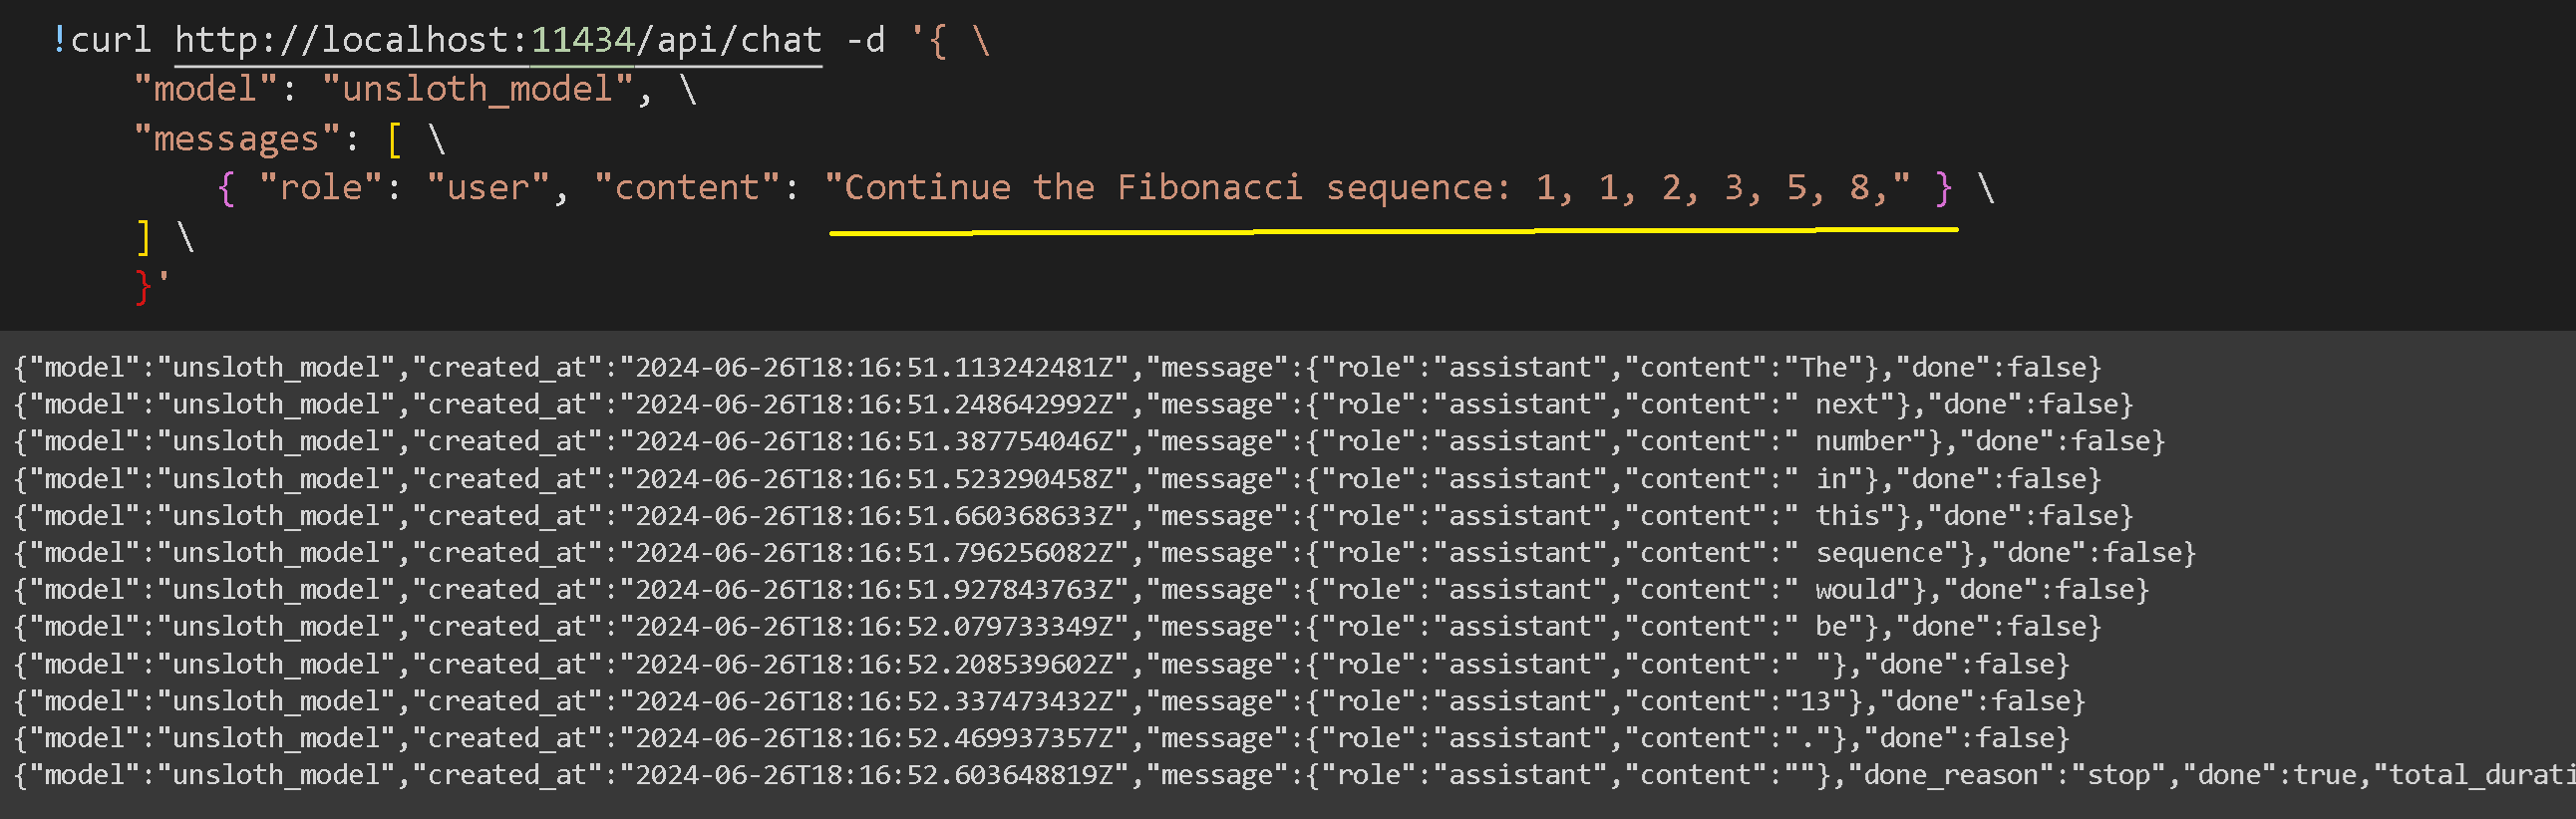 ## 16. 対話型ChatGPTスタイル
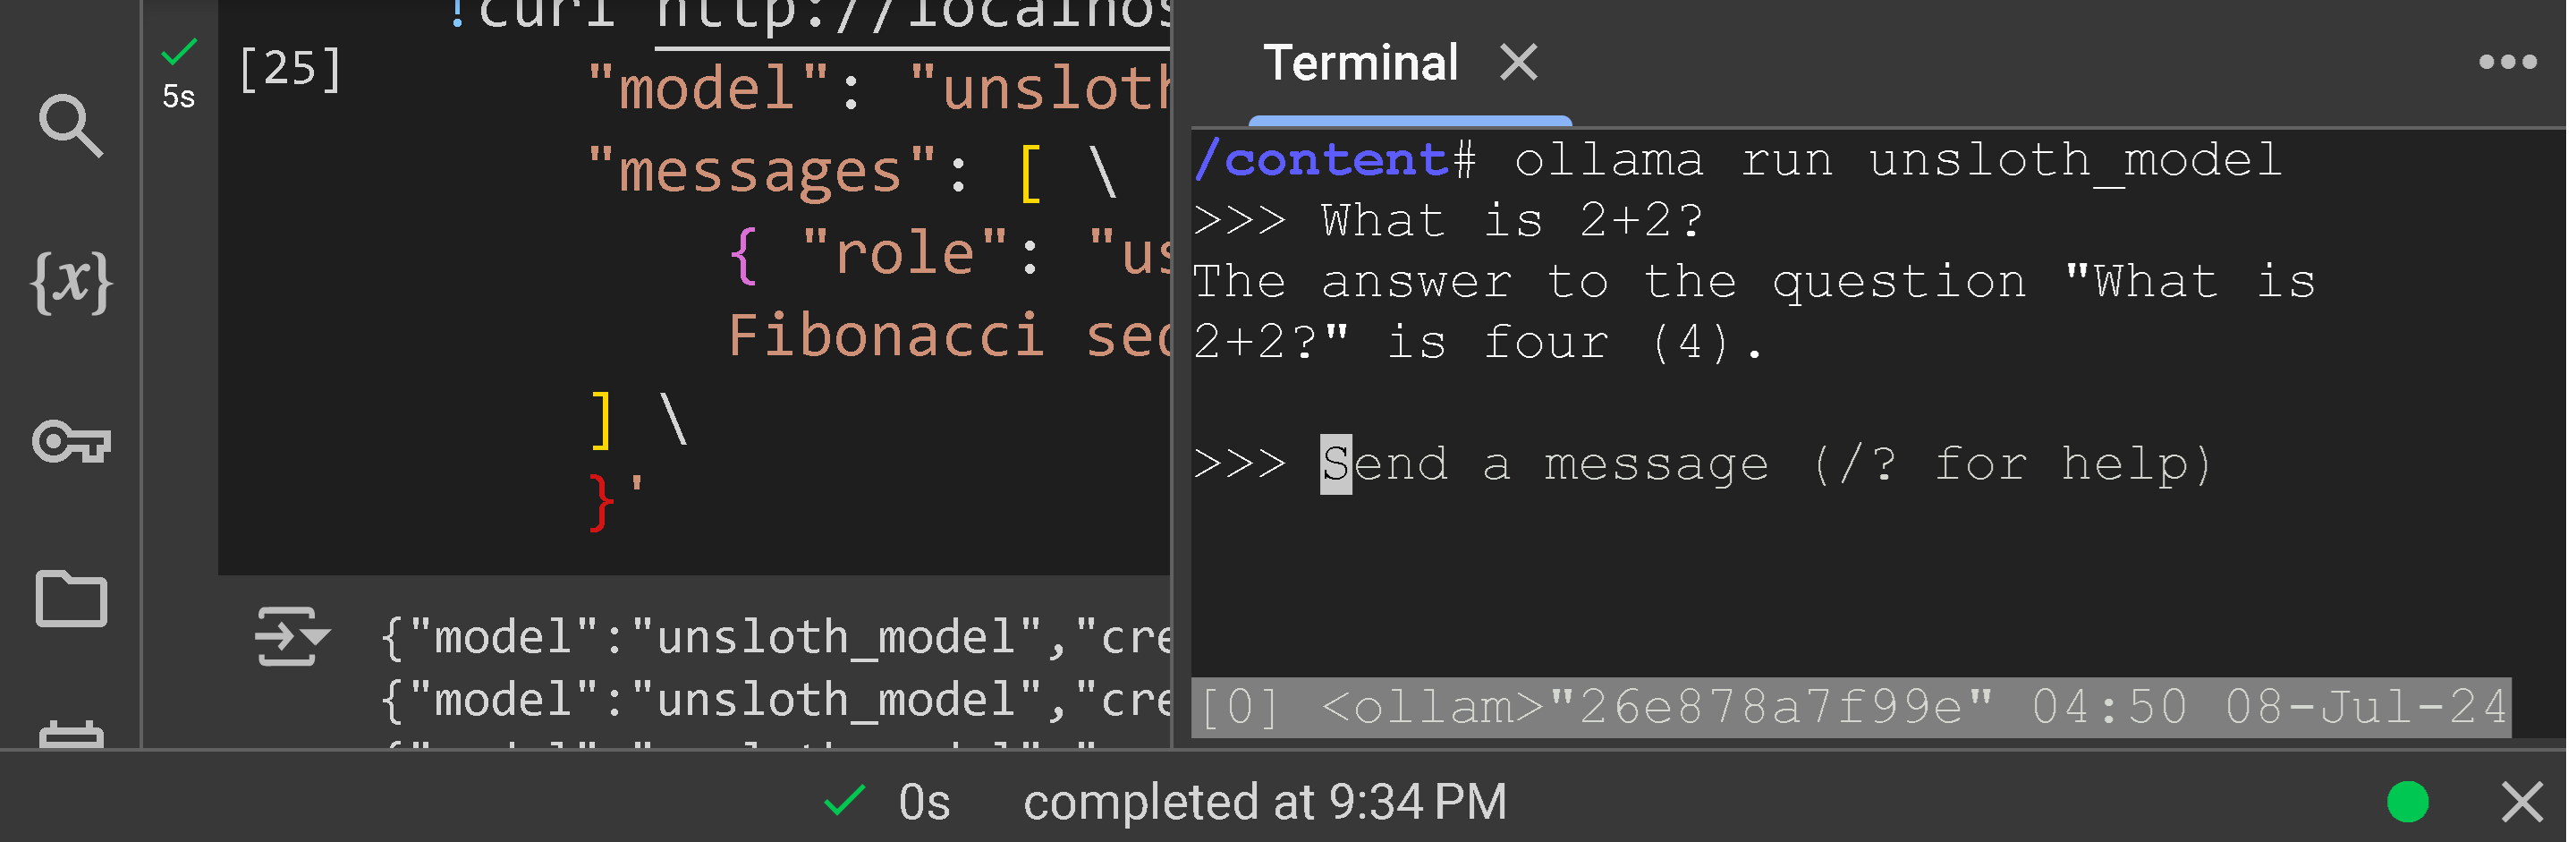
でも、ファインチューニング済みモデルをChatGPTのように実際に動かすには、もう少し必要です!まずターミナルアイコンをクリックし するとターミナルがポップアップします。左側のサイドバーにあります。
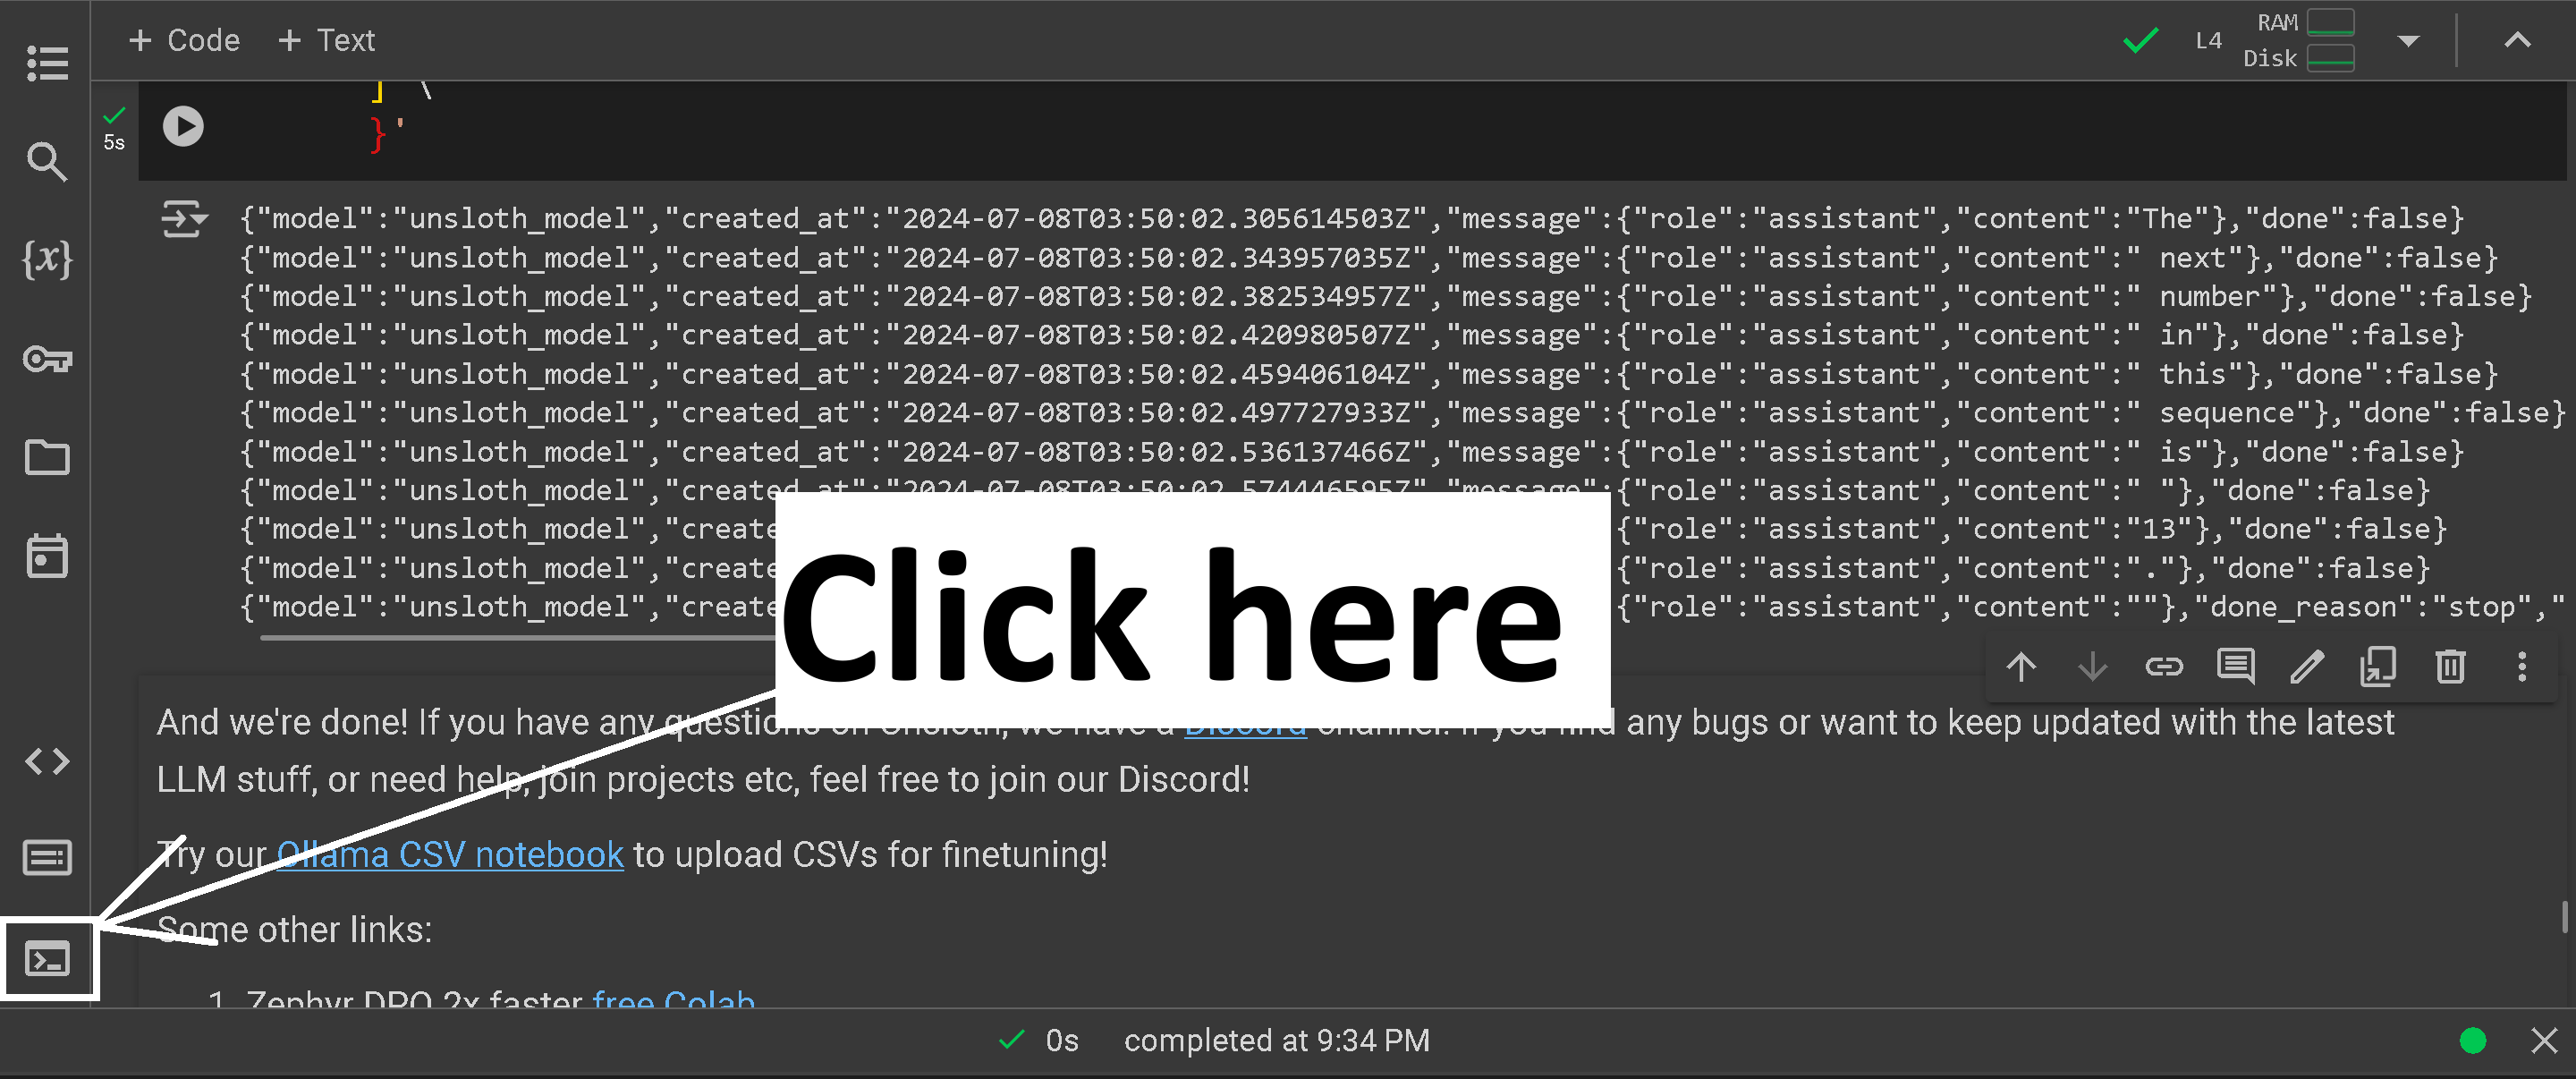 その後、ターミナルウィンドウの奇妙な出力を消すために、ENTERを2回押す必要があるかもしれません。数秒待ってから `ollama run unsloth_model` と入力し、ENTERを押してください。
 最後に、実際のChatGPTのようにファインチューニング済みモデルと対話できます!CTRL + Dでシステムを終了し、ENTERでチャットボットと会話してください!
 ## やりました!
言語モデルのファインチューニングに成功し、Unslothで2倍高速かつVRAMを70%削減してOllamaへエクスポートできました!しかもこれらすべてがGoogle Colabノートブックで無料です!
報酬モデリング、継続事前学習、vLLMやGGUFへのエクスポート、テキスト補完、ファインチューニングのヒントとコツについてもっと学びたいなら、私たちの [Github](https://github.com/unslothai/unsloth#-finetune-for-free).
ファインチューニングで助けが必要なら、Discordサーバーにも参加できます [ここ](https://discord.gg/unsloth)。Ollamaの助けが必要なら、彼らのサーバーにも参加できます [ここ](https://discord.gg/ollama).
そして最後に、ここまで読んでついてきてくださったことに感謝します!この内容が、言語モデルのファインチューニングの裏側にある仕組みを理解する助けになっていれば幸いです。お役に立てたなら嬉しいです!
Alpacaデータセットの例にアクセスするには [ここ](https://colab.research.google.com/drive/1WZDi7APtQ9VsvOrQSSC5DDtxq159j8iZ?usp=sharing)をクリックしてください。CSV / Excelのファインチューニングガイドは [ここ](https://colab.research.google.com/drive/1VYkncZMfGFkeCEgN2IzbZIKEDkyQuJAS?usp=sharing).
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide/tutorial-how-to-finetune-llama-3-and-use-in-ollama.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.