> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md).
# gpt-oss Reinforcement Learning
Sie können jetzt OpenAI trainieren [gpt-oss](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune.md) mit RL und GRPO über [Unsloth](https://github.com/unslothai/unsloth). Unsloth bietet jetzt die **schnellste Inferenz** (3x schneller), **geringste VRAM-Nutzung** (50 % weniger) und **längsten Kontext** (8x länger) für gpt-oss RL im Vergleich zu jeder Implementierung - ohne Genauigkeitsverlust.\
\
Da Reinforcement Learning (RL) auf gpt-oss noch nicht mit vLLM kompatibel ist, mussten wir den Inferenzcode von Transformers-Code umschreiben, um 3x schnellere Inferenz für gpt-oss bei \~21 Token/s zu liefern. Für BF16 erreicht Unsloth außerdem die schnellste Inferenz (\~30 Token/s), insbesondere im Verhältnis zum VRAM-Verbrauch, und benötigt 50 % weniger VRAM als jede andere RL-Implementierung. Wir planen, unsere [50%-Gewichtsteilungsfunktion](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md) sobald vLLM mit RL kompatibel wird.
* **Kostenloses Notebook:** [**gpt-oss-20b GRPO-Colab-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb)\
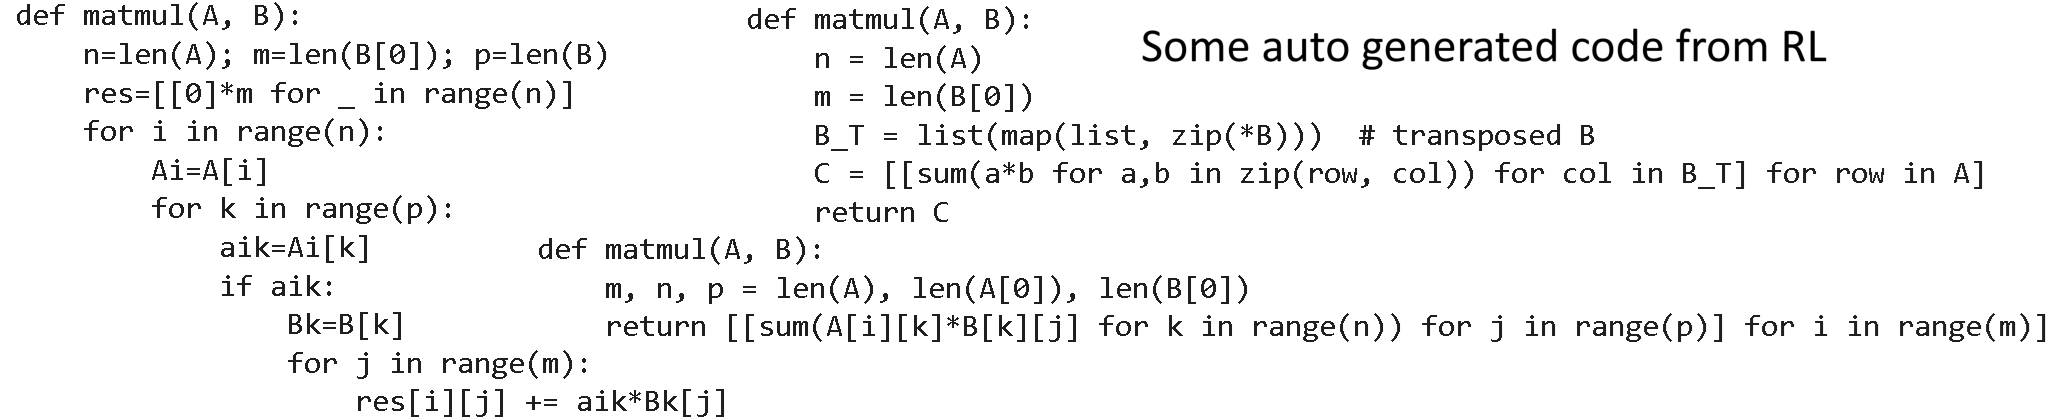
Dieses Notebook erstellt automatisch **schnellere Matrixmultiplikations-Kernel** und verwendet 4 neue Unsloth-Belohnungsfunktionen. Außerdem zeigen wir, wie man [Reward-Hacking entgegenwirkt](#can-we-counter-reward-hacking) was eine der größten Herausforderungen von RL ist.\\\\
Mit Unsloth können Sie gpt-oss-20b mit GRPO auf 15 GB VRAM trainieren und zwar für **kostenlosen** auf Colab. Wir haben Embedding-Offloading eingeführt, das den Verbrauch ebenfalls um 1 GB reduziert, über `offload_embeddings`. Unsloths neue Inferenz läuft schneller auf **any** GPUs einschließlich A100, H100 und alten T4s. gpt-oss-120b passt problemlos auf eine GPU mit 120 GB VRAM.
Unsloth ist das einzige Framework, das 4-Bit-RL für gpt-oss unterstützt. Alle Leistungsgewinne sind auf Unsloths einzigartige [Gewichtsteilung](/docs/de/loslegen/reinforcement-learning-rl-guide.md#what-unsloth-offers-for-rl), [Flex Attention](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md), [Standby](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md#unsloth-standby) und benutzerdefinierten Kernel zurückzuführen.
{% hint style="warning" %}
Erinnerung: **Flash Attention 3 (FA3) ist** [**für gpt-oss ungeeignet**](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support) **Trainings-** da es derzeit den Backward-Pass für Attention Sinks nicht unterstützt, was **falsche Trainingsverluste**. Wenn Sie **nicht** Unsloth verwenden, kann FA3 aktiviert sein durch Standard, also prüfen Sie bitte doppelt, dass es nicht verwendet wird!\
\
Das Deaktivieren von FA3 führt auch zu **O(N^2)** Speicherverbrauch, daher ist Unsloth das einzige RL-Framework, das **O(N)** Speicherverbrauch für gpt-oss über unsere Flex-Attention-Implementierung bietet.
{% endhint %}
## ⚡Inferenz deutlich schneller machen
Inferenz ist beim RL-Training entscheidend, da wir sie benötigen, um Kandidatenlösungen zu erzeugen, bevor wir eine Belohnungsfunktion maximieren ([sehen Sie hier](/docs/de/loslegen/reinforcement-learning-rl-guide.md) für eine detailliertere Erklärung). Um die schnellste Inferenzgeschwindigkeit für gpt-oss ohne vLLM zu erreichen, haben wir den Inferenzcode von Transformers neu geschrieben und viele Innovationen integriert, darunter benutzerdefinierte Algorithmen wie Unsloths [Flex Attention](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support), unter Verwendung spezieller Flags innerhalb von `torch.compile` (wie Combo-Kernel). Unser neuer Inferenzcode für gpt-oss wurde gegen eine bereits optimierte Baseline bewertet (2x schneller als natives Transformers).
vLLM unterstützt RL für gpt-oss nicht, da es keine BF16-Trainings- und LoRA-Unterstützung für gpt-oss bietet. Ohne Unsloth funktioniert nur Training mit voller Präzision in BF16, wodurch der Speicherverbrauch **800 %+ höher**. Die meisten Frameworks aktivieren FA3 (Flash Attention 3) standardmäßig (was den VRAM-Verbrauch reduziert und die Geschwindigkeit erhöht) **aber dies führt zu falschem Trainingsverlust**. Siehe [Issue 1797](https://github.com/Dao-AILab/flash-attention/issues/1797) im FA3-Repository. Sie müssen FA3 jedoch deaktivieren, da sonst das Training mit langem Kontext verhindert wird, weil FA3 O(N)-Speicherverbrauch nutzt, während naive Attention mit O(N^2)-Verbrauch explodiert. Um Attention Sinks differenzierbar zu machen, haben wir [Unsloth Flex Attention](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md).
Wir haben die gpt-oss-RL-Inferenz durch Benchmarking von BitsandBytes 4-Bit evaluiert und außerdem separate Tests für BF16 durchgeführt. Unsloths 4-Bit-Inferenz ist \~4x schneller, und BF16 ist ebenfalls effizienter, insbesondere beim VRAM-Verbrauch.
Das Beste an Unsloths gpt-oss-RL ist, dass es auf jeder GPU funktioniert, sogar auf solchen, die BF16 nicht unterstützen. Unsere kostenlosen gpt-oss-20b-Colab-Notebooks verwenden ältere 15-GB-T4-GPUs, daher funktionieren die Inferenzbeispiele gut!
## 🛠️ Probleme und Eigenheiten von gpt-oss Flex Attention
Wir mussten unsere Implementierung für Attention Sinks ändern, da [hier beschrieben](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) damit die Generierung mit Linkspadding funktioniert. Wir mussten den LogSumExp-Wert abrufen und die Sigmoid-Aktivierung anwenden, um die Attention-Gewichte wie unten zu verändern:
$$
A(X) = \sigma \bigg( \frac{1}{\sqrt{d}}QK^T \bigg)V \\
A(X) = \frac{\exp{\frac{1}{\sqrt{d}}QK^T}}{\sum{\exp{\frac{1}{\sqrt{d}}QK^T}}}V \\
\text{LSE} = \log{\sum{\exp{\frac{1}{\sqrt{d}}QK^T}}} \\
A\_{sinks}(X) = A(X) \odot \sigma (\text{LSE} - \text{sinks})
$$
Das Maskieren mit Linkspadding während der Inferenz war in gpt-oss ebenfalls ein kniffliges Problem. Wir stellten fest, dass wir nicht nur das KV-Cache-Prefill während der Token-Generierung berücksichtigen mussten, sondern auch eine jeweils unterschiedliche Anzahl an Pad-Token in jedem Prompt bei Batch-Generierungen, was die Art und Weise verändern würde, wie wir die Blockmaske speichern müssen. Ein Beispiel dafür ist unten zu sehen:
**Normale kausale Maske:**
```
k0 k1 k2 k3 k4 <-- Schlüssel
q0 X
q1 X X
q2 X X X
q3 X X X X
q4 X X X X X <-- letzte Abfragereihe (am wichtigsten für das Decoding)
```
**Für die Inferenz im allgemeinen Fall (Decoding)**
```
k0 k1 k2 k3 k4
q0
q1
q2
q3
q4 X X X X X
```
**Wenn wir naiv dieselbe Maskierungsstrategie verwenden, schlägt das fehl:**
```
k0 k1 k2 k3 k4
q0
q1
q2
q3
q4 X (beachten Sie, dass q4 q_idx=0 hat, da dies die erste Abfrage im aktuellen Setup ist)
```
Bei der Generierung (Decoding-Phase) interessiert uns normalerweise nur die letzte Zeile der Attention-Matrix, da es nur ein Abfrage-Token gibt, das auf alle vorherigen Schlüssel-Tokens achtet. Wenn wir die kausale Maske naiv anwenden (`q_idx ≥ k_idx`), schlägt dies fehl, da unsere einzelne Abfrage den Index 0 hat, während es n\_k Schlüssel-Tokens gibt. Um das zu beheben, brauchen wir einen Offset bei der Maskenerstellung, um zu entscheiden, welchen Tokens Aufmerksamkeit geschenkt wird. Aber ein naiver Ansatz ist langsam, da sich die Offsets bei jedem Schritt ändern und dadurch eine Regeneration von Maske und Kernel erzwungen wird. Wir haben das mit Cache- und Compile-Optimierungen gelöst.
Der schwierigere Teil ist die Batch-Generierung. Sequenzen unterscheiden sich in der Länge, daher verkompliziert Padding die Maskenerstellung. Flex Attention hatte viele [Herausforderungen](https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665) und dynamische Masken sind knifflig. Schlimmer noch: Wenn es nicht kompiliert wird, fällt es auf Eager Attention zurück, was langsam und speicherintensiv ist (quadratisch statt linear in der Sequenzlänge).
> *Zitat von* [*https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665*](https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665)
>
> Sie müssen dies mit \_compile=True aufrufen. Wir bilden Ihre Blockmaske im Wesentlichen über eine vollständige Q\_LEN x KV\_LEN-Matrix ab, um die Blockmaske zu erzeugen. Ohne Compile müssen wir das gesamte Ding materialisieren, und das kann bei langen Sequenzen zu OOMs führen.
>
> Außerdem müssen Sie ausführen `flex_attention = torch.compile(flex_attention)`. Ohne Compile fällt flex auf eine nicht-gefusete Eager-Implementierung zurück, die sich hervorragend zum Debuggen eignet, aber viel langsamer ist und die vollständige Score-Matrix materialisiert.
Letztlich muss die Maske dynamisch Prefill und Decoding mit dem KV-Cache, Batch- und Padding-Tokens pro Sequenz handhaben, kompilierfreundlich bleiben und Sliding Windows unterstützen. `torch.compile` freundlich bleiben und Sliding Windows unterstützen.
### 🔍 Untersuchung von Flash Attention
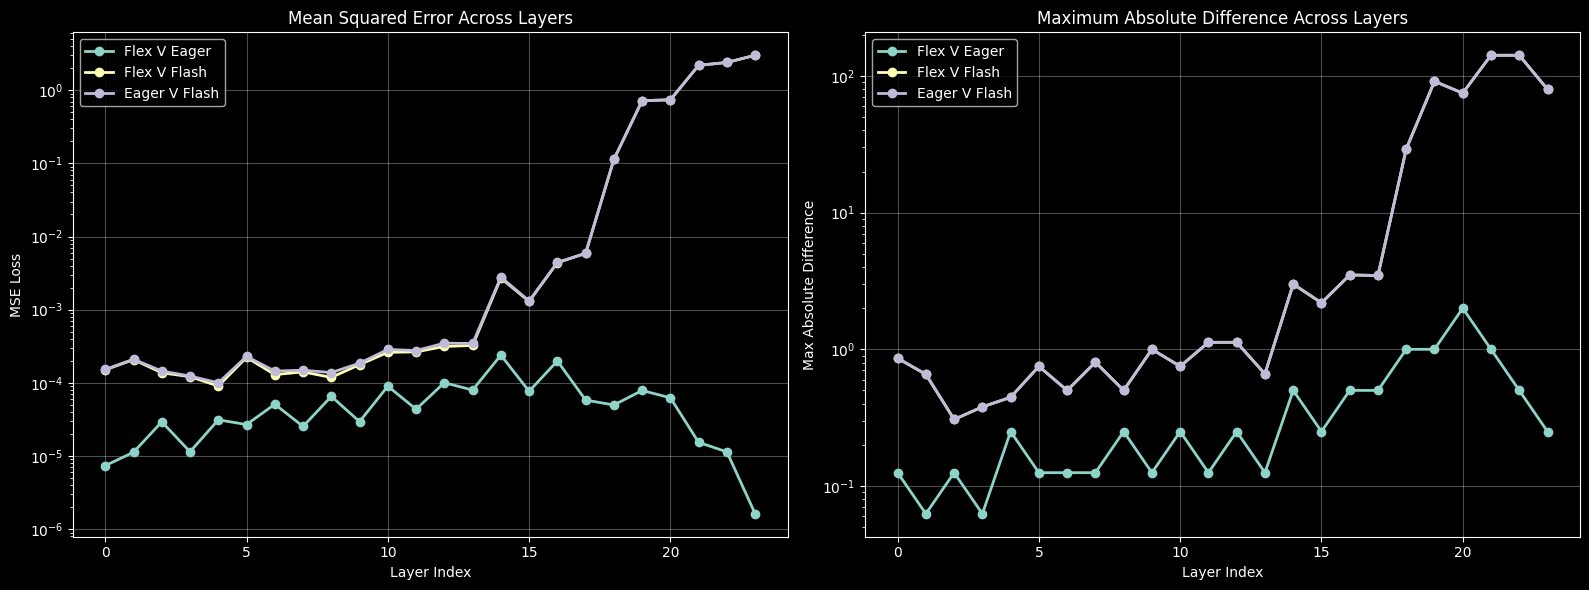
Ein weiterer interessanter Ansatz, den wir untersucht haben, war die Integration von Flash Attention. Ihre Vorteile sind weithin anerkannt, aber eine Einschränkung ist, dass sie Attention Sinks während des Backward-Passes für gpt-oss nicht unterstützt. Um dies zu umgehen, haben wir den Attention-Mechanismus so umstrukturiert, dass er ausschließlich auf dem Attention-Output und den LogSumExp-Werten arbeitet, die FlashAttention problemlos bereitstellt. Angesichts dieser Vorteile schien es naheliegend, es zu versuchen.
Wir begannen jedoch bald, Probleme zu bemerken. Während sich die ersten paar Schichten wie erwartet verhielten, lieferten die späteren Schichten, insbesondere die Schichten 18 bis 24, Ausgaben, die erheblich von der Eager-Mode-Implementierung in transformers abwichen. Wichtig ist, dass diese Abweichung nicht auf Fehlerakkumulation zurückgeführt werden kann, da die Eingaben für jede Methode auf jeder Schicht identisch sind. Zur weiteren Validierung haben wir die Ergebnisse auch mit Unsloth verglichen **FlexAttention**.
Dies erfordert weitere Untersuchungen dazu, warum nur die letzten paar Schichten einen so drastischen Unterschied zwischen der Flash-Attention-Implementierung und den anderen zeigen.
{% hint style="danger" %}
**Flash Attention 3 unterstützt den Backward-Pass für Attention Sinks nicht**
FA3 ist bei den meisten Trainingspaketen oft standardmäßig aktiviert (nicht bei Unsloth), aber das ist für gpt-oss falsch. Die Verwendung von FA3 macht den Trainingsverlust vollständig falsch, da FA3 keine gpt-oss-Backward-Pässe für Attention Sinks unterstützt. Viele Menschen sind sich dessen noch immer nicht bewusst, also seien Sie bitte vorsichtig!
{% endhint %}
## ⚠️ Können wir Reward-Hacking entgegenwirken?
Das ultimative Ziel von RL ist es, einen bestimmten Reward zu maximieren (sagen wir Geschwindigkeit, Umsatz, eine Metrik). Aber RL kann **mogeln.** Wenn der RL-Algorithmus einen Trick lernt oder etwas ausnutzt, um den Reward zu erhöhen, ohne am Ende tatsächlich die Aufgabe zu erledigen, nennt man das "**Reward-Hacking**".
Es ist der Grund, warum Modelle lernen, Unit-Tests zu ändern, um Coding-Challenges zu bestehen, und das sind kritische Hindernisse für den Einsatz in der realen Welt. Einige weitere gute Beispiele stammen von [Wikipedia](https://en.wikipedia.org/wiki/Reward_hacking).
In unserem [kostenlosen gpt-oss-RL-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) zeigen wir, wie man Reward-Hacking in einem Codegenerierungs-Setting entgegenwirken kann, und demonstrieren greifbare Lösungen für häufige Fehlermuster. Wir sahen, wie das Modell die Timing-Funktion bearbeitete, Aufgaben an andere Bibliotheken auslagerte, die Ergebnisse zwischenspeicherte und offen schummelte. Nach dem Gegensteuern ist das Ergebnis, dass unser Modell tatsächlich optimierte Matrixmultiplikations-Kernel erzeugt, nicht clevere Tricks.
## :trophy:Reward-Hacking
Einige gängige Beispiele für Reward-Hacking während RL sind:
#### Faulheit
RL lernt, Numpy, Torch und andere Bibliotheken zu verwenden, die optimierte CUDA-Kernels aufrufen. Wir können den RL-Algorithmus davon abhalten, optimierten Code aufzurufen, indem wir prüfen, ob der generierte Code andere nicht standardmäßige Python-Bibliotheken importiert.
#### Caching & Schummeln
RL lernt, das Ergebnis der Ausgabe zwischenzuspeichern, und RL lernt, das tatsächliche Ergebnis zu finden, indem es Python-Globale Variablen untersucht.
Wir können den RL-Algorithmus davon abhalten, zwischengespeicherte Daten zu verwenden, indem wir den Cache mit einer großen falschen Matrix leeren. Außerdem müssen wir sorgfältig mit mehreren Schleifen und Durchläufen benchmarken.
#### Schummeln
RL lernt, die Timing-Funktion so zu bearbeiten, dass sie 0 Zeit als verstrichen ausgibt. Wir können den RL-Algorithmus davon abhalten, globale oder zwischengespeicherte Variablen zu verwenden, indem wir seine `lokalen` und `globalen`. Wir werden außerdem `exec` verwenden, um die Funktion zu erstellen, daher müssen wir die Ausgabe in einem leeren Dict speichern. Wir erlauben außerdem keinen Zugriff auf globale Variablen über `types.FunctionType(f.__code__, {})`\\\\
## Tutorial: So trainieren Sie gpt-oss mit RL
LLMs haben oft Schwierigkeiten mit Aufgaben, die komplexe Umgebungen beinhalten. Durch die Anwendung von [Reinforcement Learning](/docs/de/loslegen/reinforcement-learning-rl-guide.md) (RL) und das Entwerfen eines benutzerdefinierten [Belohnungsfunktion](/docs/de/loslegen/reinforcement-learning-rl-guide.md#reward-functions-verifiers), können diese Herausforderungen überwunden werden.
RL kann für Aufgaben wie automatisierte Kernel- oder Strategienerstellung angepasst werden. Dieses Tutorial zeigt, wie man **gpt-oss** mit [**GRPO**](/docs/de/loslegen/reinforcement-learning-rl-guide.md#from-rlhf-ppo-to-grpo-and-rlvr) und Unsloth einsetzt, um 2048 autonom zu schlagen.
Unsere Notebooks enthalten bereits Schritt-für-Schritt-Anleitungen, wie man den gesamten Prozess durchläuft.
| [2048-Notebook](https://colab.research.google.com/github/openai/gpt-oss/blob/main/examples/reinforcement-fine-tuning.ipynb) (Offizielles OpenAI-Beispiel) | [Notebook zur Kernel-Generierung](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) |
| --------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------- |
**Was Sie erstellen werden:**
* Trainieren Sie gpt-oss-20b so, dass das Modell 2048 automatisch gewinnen kann
* Erstellen Sie eine minimale 2048-Umgebung, mit der das Modell interagieren kann
* Definieren Sie **Belohnungsfunktionen** die:
1. Prüfen, ob die erzeugte Strategie kompiliert und läuft,
2. Reward-Hacking verhindern (externe Imports verbieten), und
3. echten Spielerfolg belohnen
* Führen Sie die Inferenz aus und exportieren Sie das Modell (MXFP4 4-Bit oder zusammengeführtes FP16)
{% hint style="info" %}
**Hardware:** Das 2048-Beispiel läuft auf einem kostenlosen Colab-T4, aber das Training wird langsam sein. A100/H100 ist viel schneller. 4-Bit-Laden + LoRA ermöglicht es, ein 20B-Modell in moderaten VRAM zu packen
{% endhint %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.