> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/install/google-colab.md).
# Google Colab
Pour installer et exécuter Unsloth sur Google Colab, suivez les étapes ci-dessous :
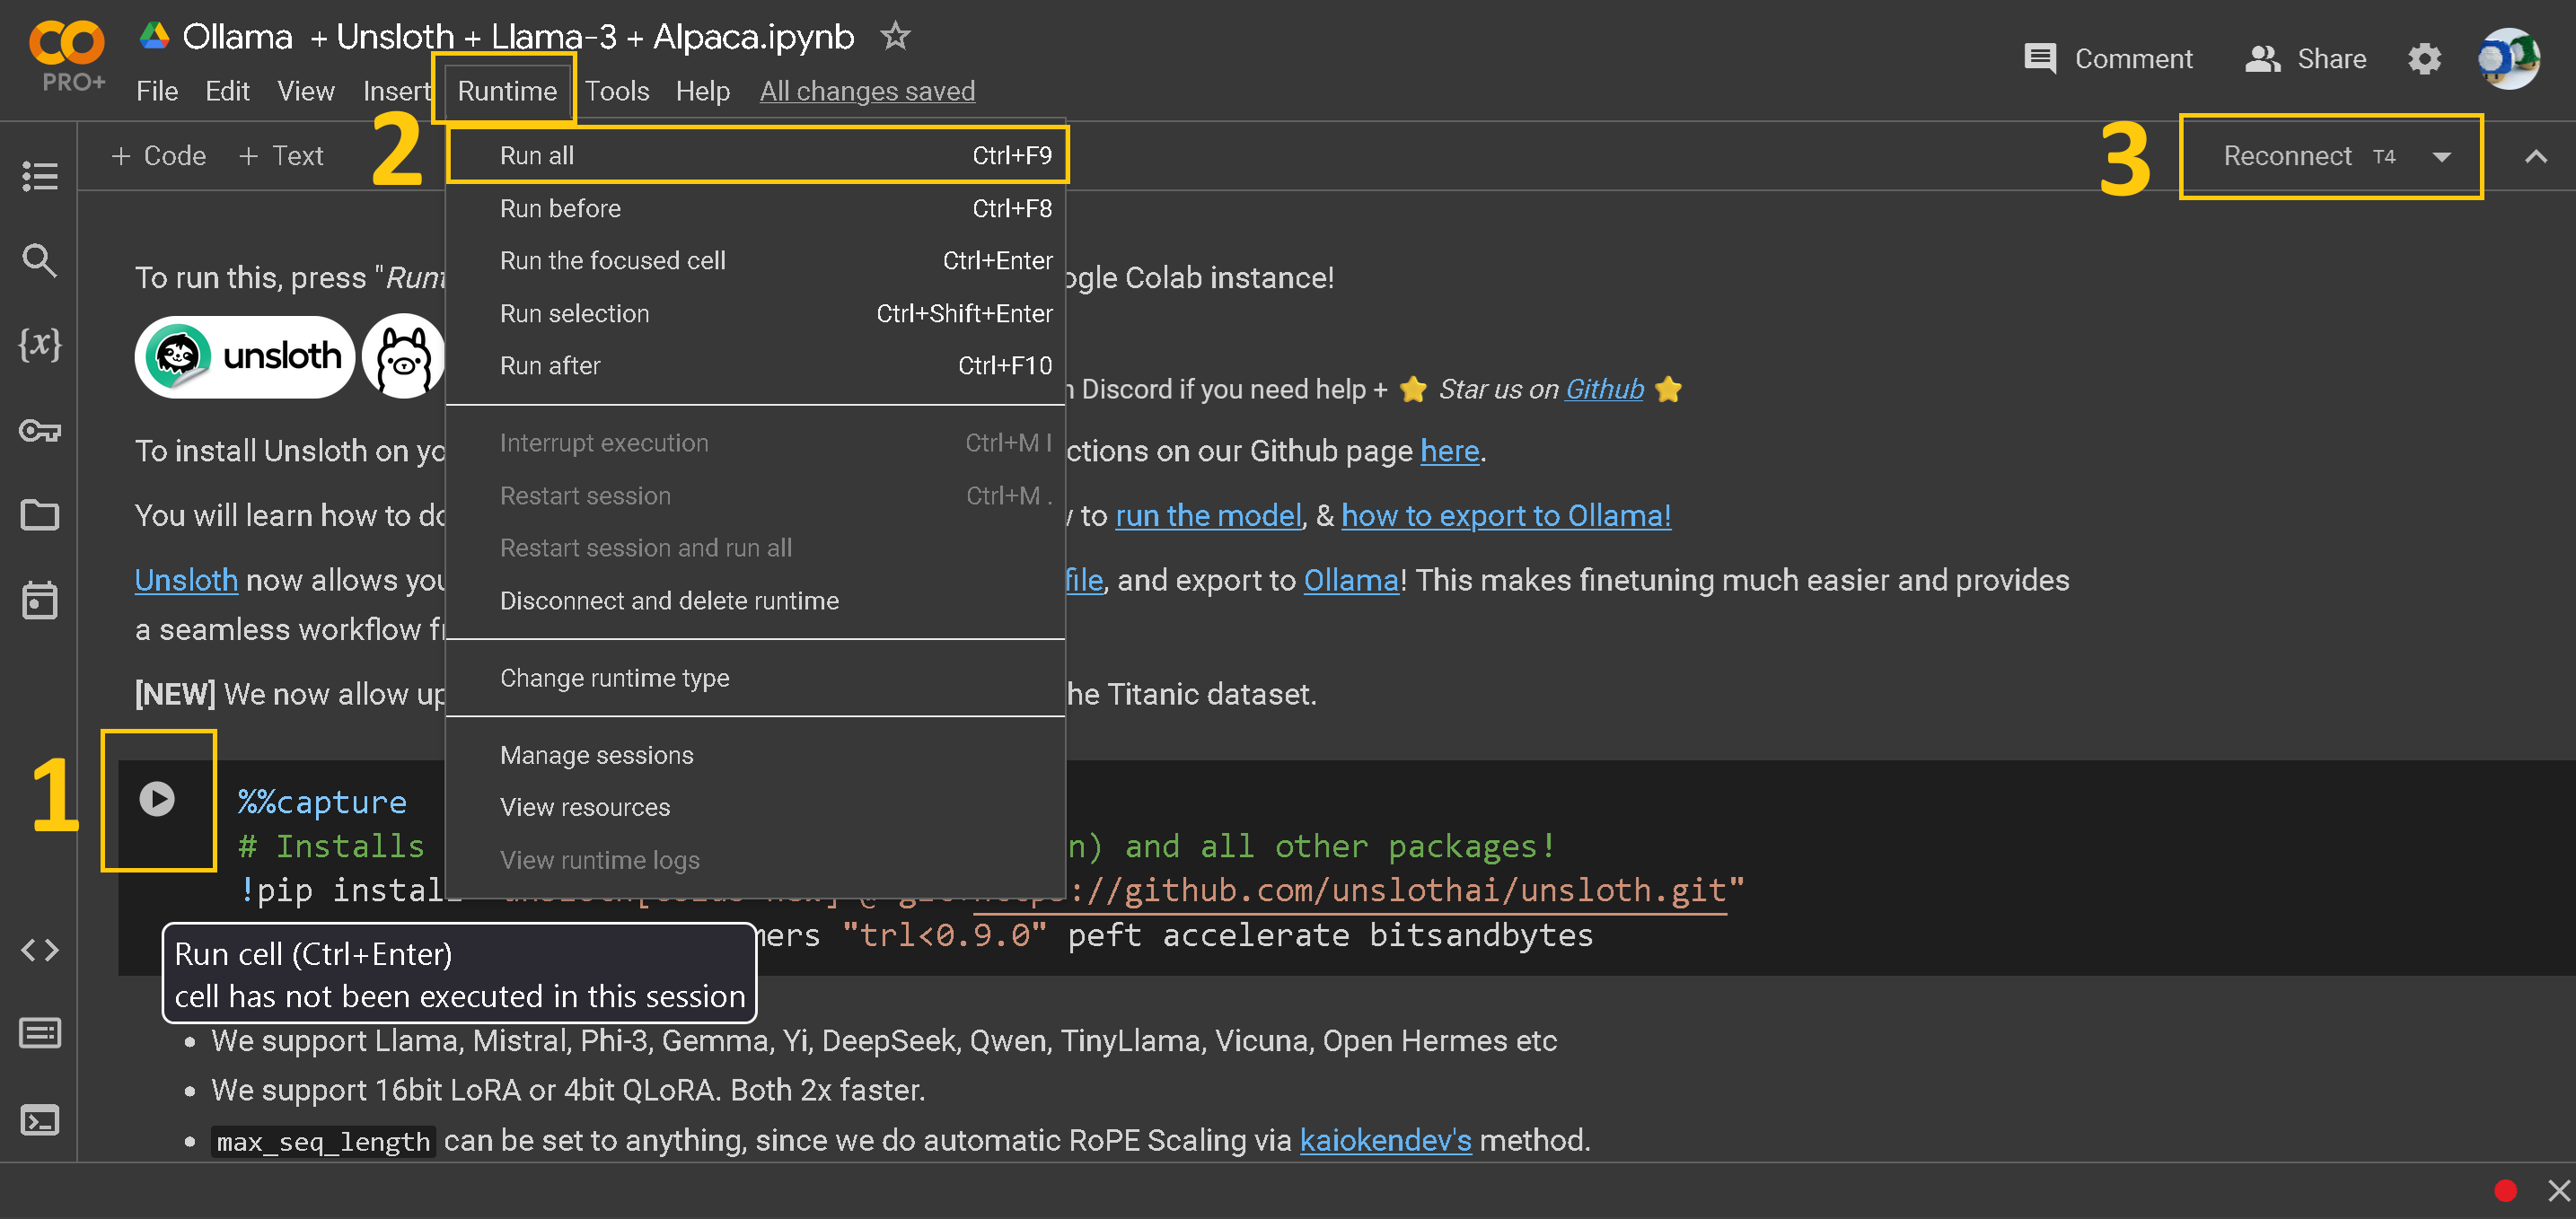
Si vous n'avez jamais utilisé un notebook Colab, voici un bref aperçu du notebook lui-même :
1. **Bouton Lecture sur chaque « cellule ».** Cliquez dessus pour exécuter le code de cette cellule. Vous ne devez sauter aucune cellule et vous devez exécuter chaque cellule dans l'ordre chronologique. Si vous rencontrez des erreurs, relancez simplement la cellule que vous n'avez pas exécutée. Une autre option consiste à cliquer sur CTRL + ENTER si vous ne voulez pas cliquer sur le bouton Lecture.
2. **Bouton Runtime dans la barre d'outils supérieure.** Vous pouvez aussi utiliser ce bouton et cliquer sur « Run all » pour exécuter tout le notebook en une seule fois. Cela ignorera toutes les étapes de personnalisation, mais c'est un bon premier essai.
3. **Bouton Connecter / Reconnecter T4.** Le T4 est le GPU gratuit fourni par Google. Il est assez puissant !
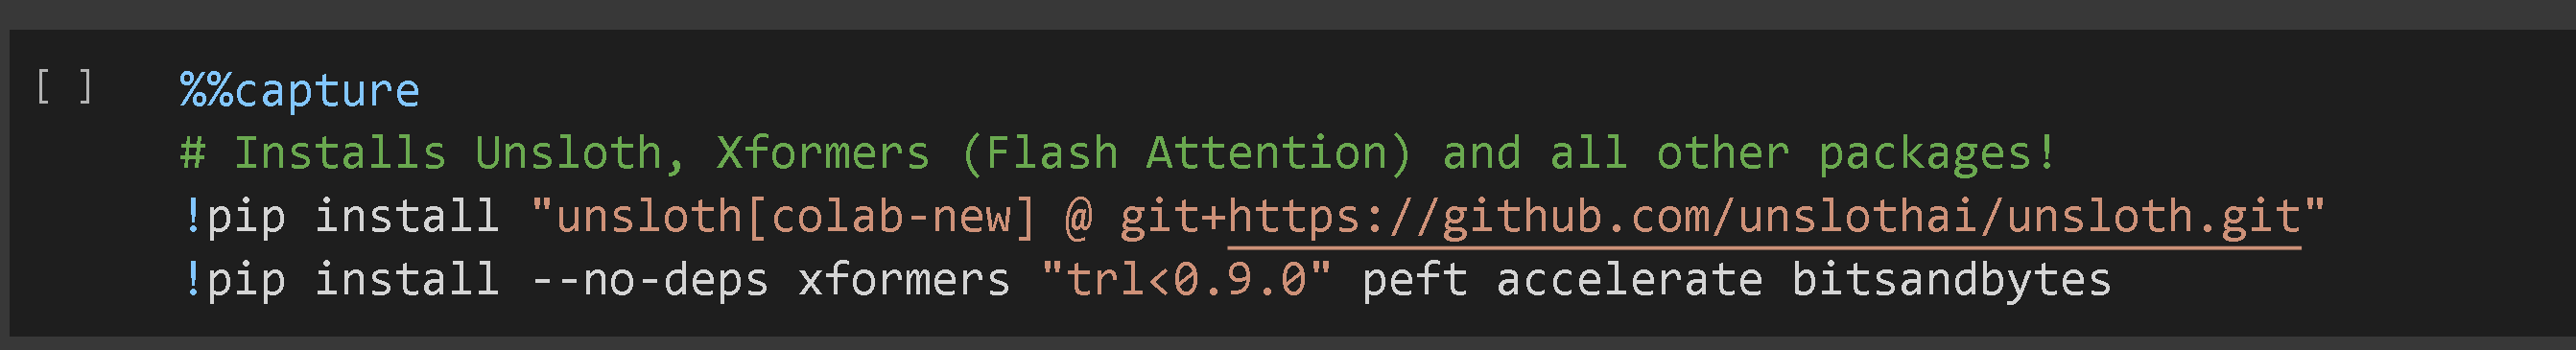
La première cellule d'installation ressemble à ceci : n'oubliez pas de cliquer sur le bouton LECTURE dans les crochets \[ ]. Nous récupérons notre paquet GitHub open source et installons quelques autres paquets.
### Code d'exemple Colab
Exemple de code Unsloth pour ajuster finement gpt-oss-20b :
```python
from unsloth import FastLanguageModel, FastModel
import torch
from trl import SFTTrainer, SFTConfig
from datasets import load_dataset
max_seq_length = 2048 # Prend en charge le RoPE Scaling en interne, donc choisissez n’importe quelle valeur !
# Obtenir le jeu de données LAION
url = "https://huggingface.co/datasets/laion/OIG/resolve/main/unified_chip2.jsonl"
dataset = load_dataset("json", data_files = {"train" : url}, split = "train")
# Modèles préquantifiés en 4 bits que nous prenons en charge pour un téléchargement 4x plus rapide + sans OOM.
fourbit_models = [
"unsloth/gpt-oss-20b-unsloth-bnb-4bit", #ou choisissez n'importe quel modèle
] # Plus de modèles sur https://huggingface.co/unsloth
model, tokenizer = FastModel.from_pretrained(
model_name = "unsloth/gpt-oss-20b",
max_seq_length = 2048, # Choisissez n’importe quelle valeur pour un long contexte !
load_in_4bit = True, # Quantification 4 bits. False = LoRA 16 bits.
load_in_8bit = False, # Quantification 8 bits
load_in_16bit = False, # [NOUVEAU !] LoRA en 16 bits
full_finetuning = False, # À utiliser pour un fine-tuning complet.
# token = "hf_...", # utilisez-en un si vous utilisez des modèles protégés
)
# Effectuer le patching du modèle et ajouter des poids LoRA rapides
model = FastLanguageModel.get_peft_model(
model,
r = 16,
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",],
lora_alpha = 16,
lora_dropout = 0, # Prend en charge toutes les valeurs, mais = 0 est optimisé
bias = "none", # Prend en charge toutes les valeurs, mais = "none" est optimisé
# [NOUVEAU] « unsloth » utilise 30 % de VRAM en moins, permet des tailles de lot 2x plus grandes !
use_gradient_checkpointing = "unsloth", # True ou "unsloth" pour un contexte très long
random_state = 3407,
max_seq_length = max_seq_length,
use_rslora = False, # Nous prenons en charge LoRA avec stabilisation du rang
loftq_config = None, # Et LoftQ
)
trainer = SFTTrainer(
model = model,
train_dataset = dataset,
tokenizer = tokenizer,
args = SFTConfig(
max_seq_length = max_seq_length,
per_device_train_batch_size = 2,
gradient_accumulation_steps = 4,
warmup_steps = 10,
max_steps = 60,
logging_steps = 1,
output_dir = "outputs",
optim = "adamw_8bit",
seed = 3407,
),
)
trainer.train()
# Rendez-vous sur https://docs.unsloth.ai pour des conseils avancés comme
# (1) Enregistrement en GGUF / fusion en 16 bits pour vLLM
# (2) Poursuivre l'entraînement à partir d'un adaptateur LoRA enregistré
# (3) Ajout d'une boucle d'évaluation / OOMs
# (4) Modèles de conversation personnalisés
```
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/commencer/install/google-colab.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.