> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/install/amd.md).
# Guide pour le fine-tuning de LLM sur GPU AMD avec Unsloth
Découvrez comment fine-tuner de grands modèles de langage (LLM) sur GPU AMD avec Unsloth.
Affinez les LLM jusqu’à 2× plus vite avec \~70 % de mémoire en moins sur du matériel AMD, sans NVIDIA requise. Unsloth prend en charge les AMD Radeon RDNA 3/3.5/4 (séries RX 6000–9000) sous Windows et Linux, ainsi que les GPU de centre de données, y compris le MI300X (192 Go).
{% stepper %}
{% step %}
#### **Installateur en une ligne**
Pour installer Unsloth sur AMD, le plus simple est de télécharger notre [Application de bureau](/docs/fr/desktop.md).
Télécharger pour WindowsTélécharger pour Linux\
\
Pour une installation manuelle :
**Linux :**
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
**Windows (PowerShell) :**
```powershell
irm https://unsloth.ai/install.ps1 | iex
```
Les étapes manuelles ci-dessous s’adressent aux utilisateurs qui souhaitent installer la bibliothèque Python Unsloth sur AMD avec les dépendances requises.
{% endstep %}
{% step %}
#### **Créer un nouvel environnement isolé (facultatif)**
Les étapes ci-dessous concernent Linux. Sous Windows, utilisez l’application Desktop ou l’installateur PowerShell ci-dessus : ils installent pour vous la version Windows de PyTorch d’AMD.
Pour ne pas casser les paquets système, créez un environnement isolé. Pensez à vérifier votre version de Python ! Elle pourrait être `python3`, `python3.12`, `python3.13` etc. Python 3.10 à 3.13 fonctionne.
{% code overflow="wrap" %}
```bash
apt update && apt install python3.13-venv -y
python3.13 -m venv unsloth_env
source unsloth_env/bin/activate
pip install uv
```
{% endcode %}
{% endstep %}
{% step %}
#### **Installer PyTorch**
PyPI ne propose que la version NVIDIA (CUDA) de PyTorch, alors installez d’abord la version ROCm depuis l’index PyTorch qui correspond à votre version ROCm. Vérifiez-la avec `amd-smi version` (la `version ROCm :` ligne), puis :
{% code overflow="wrap" %}
```bash
uv pip install "torch<2.15" torchvision torchaudio \
--index-url https://download.pytorch.org/whl/rocm7.2 --upgrade --force-reinstall
```
{% endcode %}
Modifiez `rocm7.2` à votre version ROCm. Les balises d’index disponibles sont `rocm6.0` à `rocm6.4` et `rocm7.0` à `rocm7.2`. ROCm 6.5 à 6.9 utilise `rocm6.4`, et ROCm 7.3 ou plus récent utilise `rocm7.2`. ROCm 6.0 ou plus récent est requis.
Ou laissez cette commande choisir la balise pour vous :
{% code overflow="wrap" %}
```bash
ROCM_VER="$(amd-smi version 2>/dev/null | sed -n 's/.*ROCm version: \([0-9]*\.[0-9]*\).*/\1/p' | head -n 1)"
[ -n "$ROCM_VER" ] || ROCM_VER="$(cut -d. -f1,2 /opt/rocm/.info/version 2>/dev/null)"
case "$ROCM_VER" in
6.[0-4]|7.[0-2]) ROCM_TAG="rocm$ROCM_VER" ;;
6.*) ROCM_TAG="rocm6.4" ;;
*) ROCM_TAG="rocm7.2" ;;
esac
echo "ROCm ${ROCM_VER:-unknown}: using $ROCM_TAG"
uv pip install "torch<2.15" torchvision torchaudio \
--index-url "https://download.pytorch.org/whl/$ROCM_TAG" --upgrade --force-reinstall
```
{% endcode %}
{% endstep %}
{% step %}
#### **Installer Unsloth**
Unsloth sur PyPI dépend de `torch`, donc une installation simple peut remplacer le PyTorch ROCm que vous venez d’installer par celui de CUDA depuis PyPI. Pour éviter cela, figez votre PyTorch installé et installez avec `uv pip` (pas un simple `pip`):
{% code overflow="wrap" %}
```bash
uv pip freeze | grep -E '^(torch|torchvision|torchaudio)==' > torch-pins.txt
echo "triton ; sys_platform == 'never'" >> torch-pins.txt
echo "xformers ; sys_platform == 'never'" >> torch-pins.txt
uv pip install "unsloth[amd]" --overrides torch-pins.txt
```
{% endcode %}
`torch-pins.txt` doit contenir une `ligne torch==...+rocm...` Les deux dernières lignes empêchent l’installation de la version PyPI de `triton` d’être installé par-dessus le Triton fourni avec votre PyTorch, et ignorent la version PyPI de `xformers`, qui est compilée uniquement pour les GPU NVIDIA.
**Mise à jour d'Unsloth**
Mettez à niveau Unsloth uniquement, avec les mêmes verrous :
{% code overflow="wrap" %}
```bash
uv pip install --upgrade-package unsloth --upgrade-package unsloth-zoo "unsloth[amd]" --overrides torch-pins.txt
```
{% endcode %}
N’exécutez pas `uv pip install -U unsloth` ou `--force-reinstall` sans les verrous : les deux résolvent à nouveau PyTorch depuis PyPI et remplacent votre version ROCm par celle de CUDA. Si cela s’est déjà produit, `import unsloth` signale un GPU AMD mais aucun accélérateur HIP utilisable : relancez l’étape PyTorch ci-dessus, puis celle-ci.
{% endstep %}
{% step %}
#### **Commencez à affiner avec Unsloth !**
Et voilà. Essayez quelques exemples dans notre [**Notebooks Unsloth**](/docs/fr/commencer/unsloth-notebooks.md) page !
Vous pouvez consulter nos [d’ajustement fin](/docs/fr/commencer/fine-tuning-llms-guide.md) ou [l’apprentissage par renforcement](/docs/fr/commencer/reinforcement-learning-rl-guide.md) guides dédiés. Voici aussi un bref exemple :
**1. Définir les variables d’environnement**
{% code overflow="wrap" %}
```bash
export HF_HUB_DISABLE_XET=1 # Corrige les problèmes de téléchargement HuggingFace sur AMD
```
{% endcode %}
**2. Charger et configurer le modèle**
{% code overflow="wrap" %}
```python
from unsloth import FastModel
model, tokenizer = FastModel.from_pretrained(
model_name = "unsloth/gemma-4-26b-a4b-it",
max_seq_length = 2048,
load_in_4bit = True,
)
model = FastModel.get_peft_model(
model,
r = 16,
lora_alpha = 16,
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj"],
)
```
{% endcode %}
**3. Entraîner**
{% code overflow="wrap" %}
```python
from trl import SFTTrainer, SFTConfig
trainer = SFTTrainer(
model = model,
tokenizer = tokenizer,
train_dataset = dataset,
formatting_func = formatting_func,
args = SFTConfig(
per_device_train_batch_size = 1,
gradient_accumulation_steps = 4,
max_steps = 60,
output_dir = "outputs",
report_to = "none",
),
)
trainer_stats = trainer.train()
```
{% endcode %}
***Remarque :** Flash Attention 2 n’est pas installé par défaut sur les GPU AMD, donc Unsloth utilise à la place l’attention SDPA intégrée de PyTorch. L’avertissement peut être ignoré sans risque.*
{% endstep %}
{% endstepper %}
### :1234: Apprentissage par renforcement sur GPU AMD
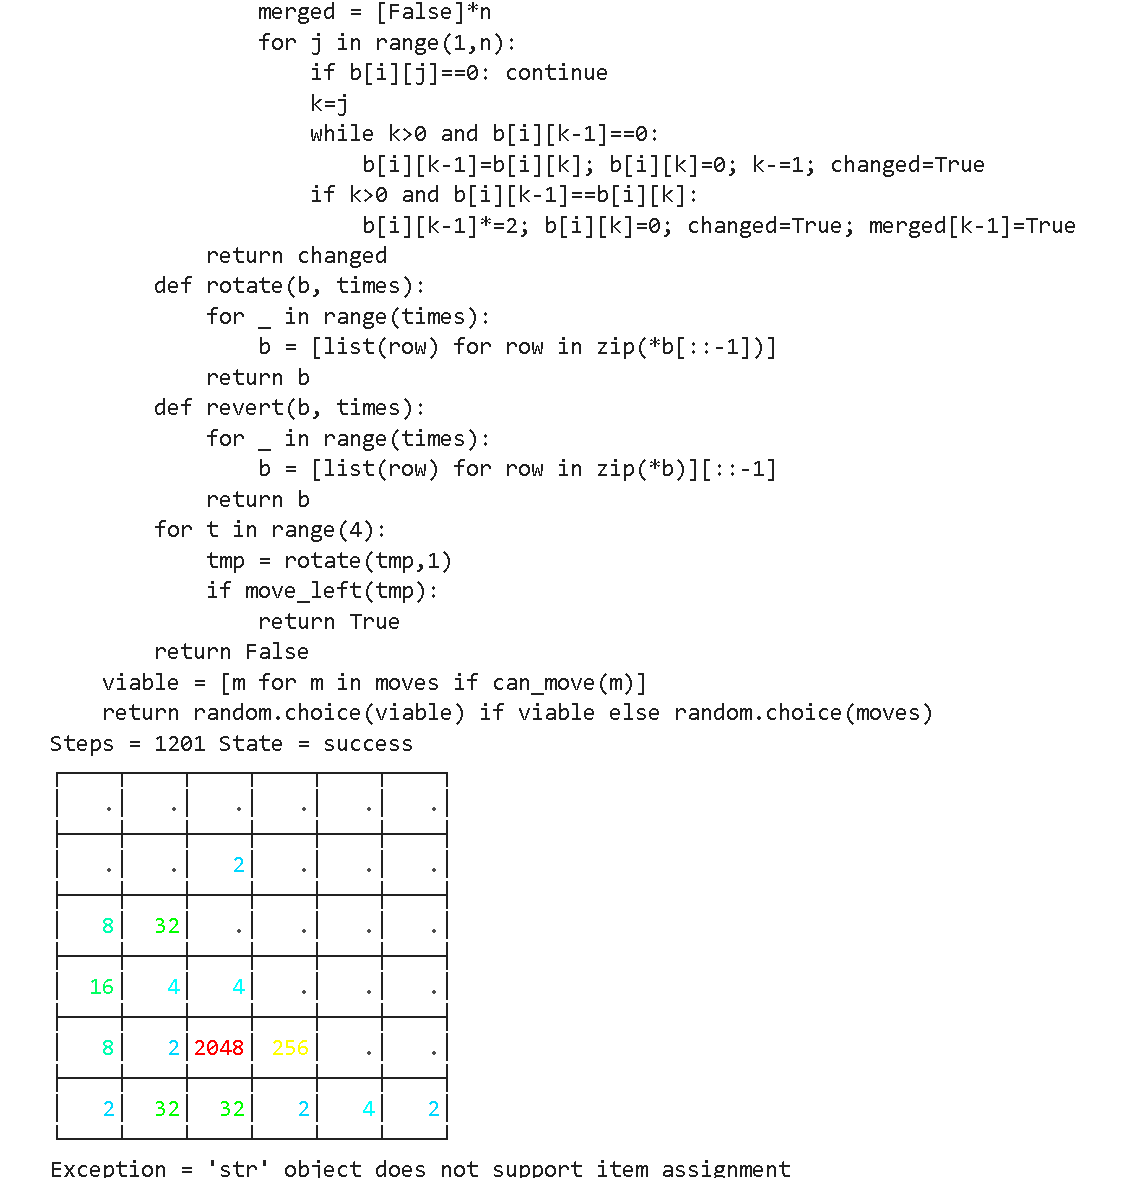
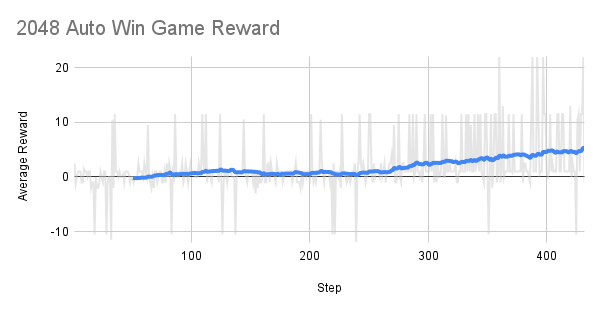
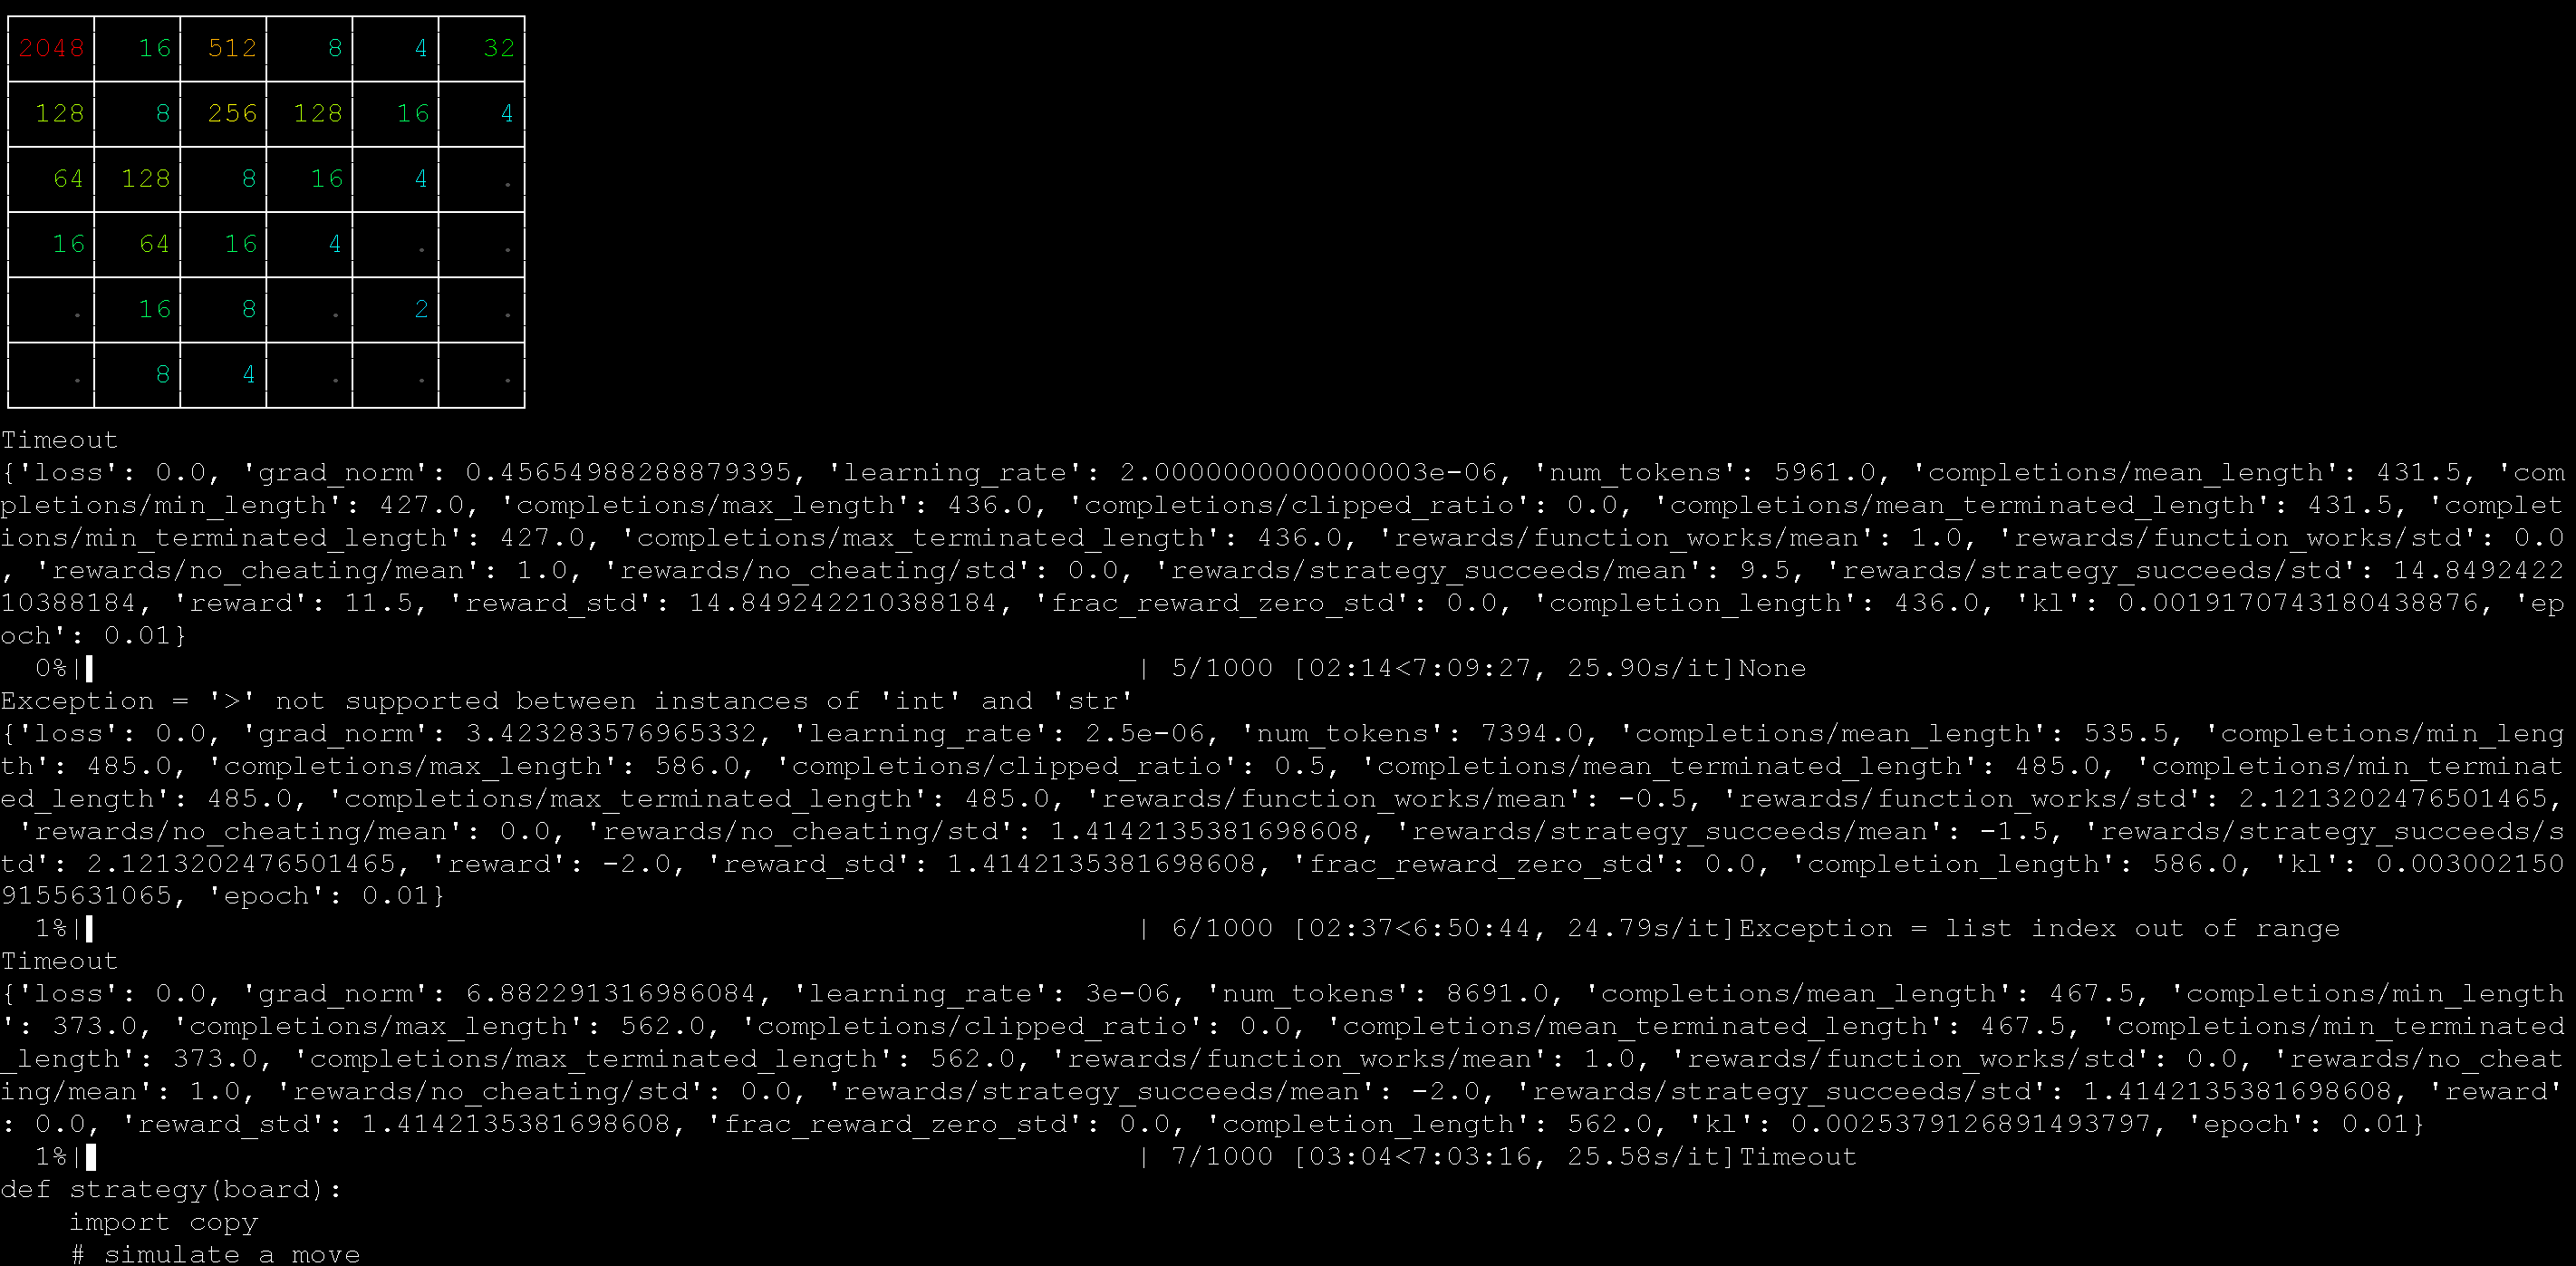
Vous pouvez utiliser notre :ledger:[gpt-oss RL auto win 2048](https://github.com/unslothai/notebooks/blob/main/nb/AMD-gpt_oss_\(20B\)_Reinforcement_Learning_2048_Game_BF16.ipynb) exemple sur un GPU MI300X (192 Go). L’objectif est de jouer automatiquement au jeu 2048 et de le gagner avec l’apprentissage par renforcement. Le LLM (gpt-oss 20b) élabore automatiquement une stratégie pour gagner au jeu 2048, et nous calculons une récompense élevée pour les stratégies gagnantes, et une faible récompense pour les stratégies perdantes.
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
La récompense au fil du temps augmente après environ 300 étapes environ !
L’objectif de l’apprentissage par renforcement est de maximiser la récompense moyenne pour gagner au jeu 2048.
{% endcolumn %}
{% endcolumns %}
Nous avons utilisé une machine AMD MI300X (192 Go) pour exécuter l’exemple de RL 2048 avec Unsloth, et cela a très bien fonctionné !
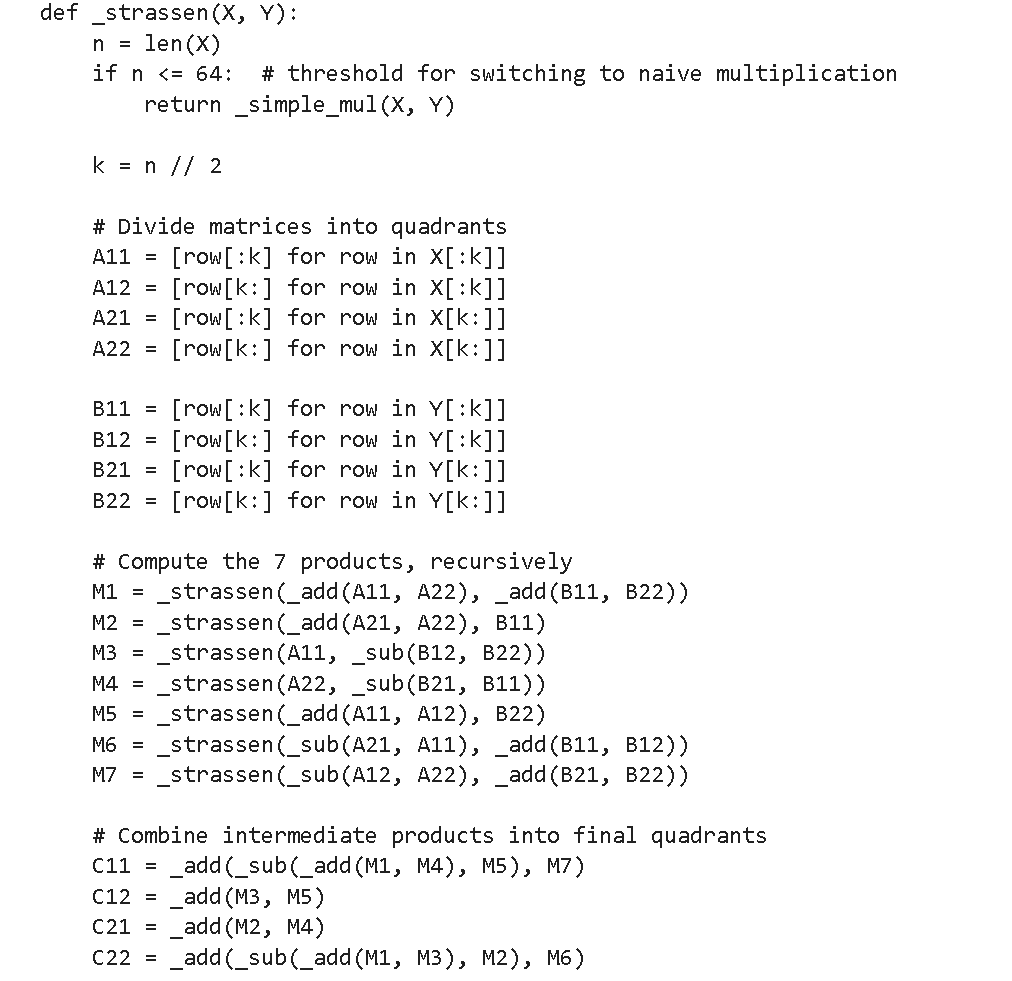
Vous pouvez aussi utiliser notre :ledger:[bloc-notes RL de génération automatique de noyaux](https://github.com/unslothai/notebooks/blob/main/nb/AMD-gpt_oss_\(20B\)_GRPO_BF16.ipynb) également avec gpt-oss pour créer automatiquement des noyaux de multiplication matricielle en Python. Le bloc-notes déploie aussi plusieurs méthodes pour contrer le reward hacking.
{% columns %}
{% column width="50%" %}
L’invite que nous avons utilisée pour créer automatiquement ces noyaux était :
{% code overflow="wrap" %}
````
Créez une nouvelle fonction rapide de multiplication matricielle en utilisant uniquement du code Python natif.
On vous donne une liste de listes de nombres.
Affichez votre nouvelle fonction entre des backticks en utilisant le format ci-dessous :
```
python
def matmul(A, B):
return ...
```
````
{% endcode %}
{% endcolumn %}
{% column width="50%" %}
Le processus de RL apprend par exemple à appliquer l’algorithme de Strassen pour accélérer la multiplication matricielle en Python.
{% endcolumn %}
{% endcolumns %}
### :books:Bloc-notes AMD gratuits en un clic
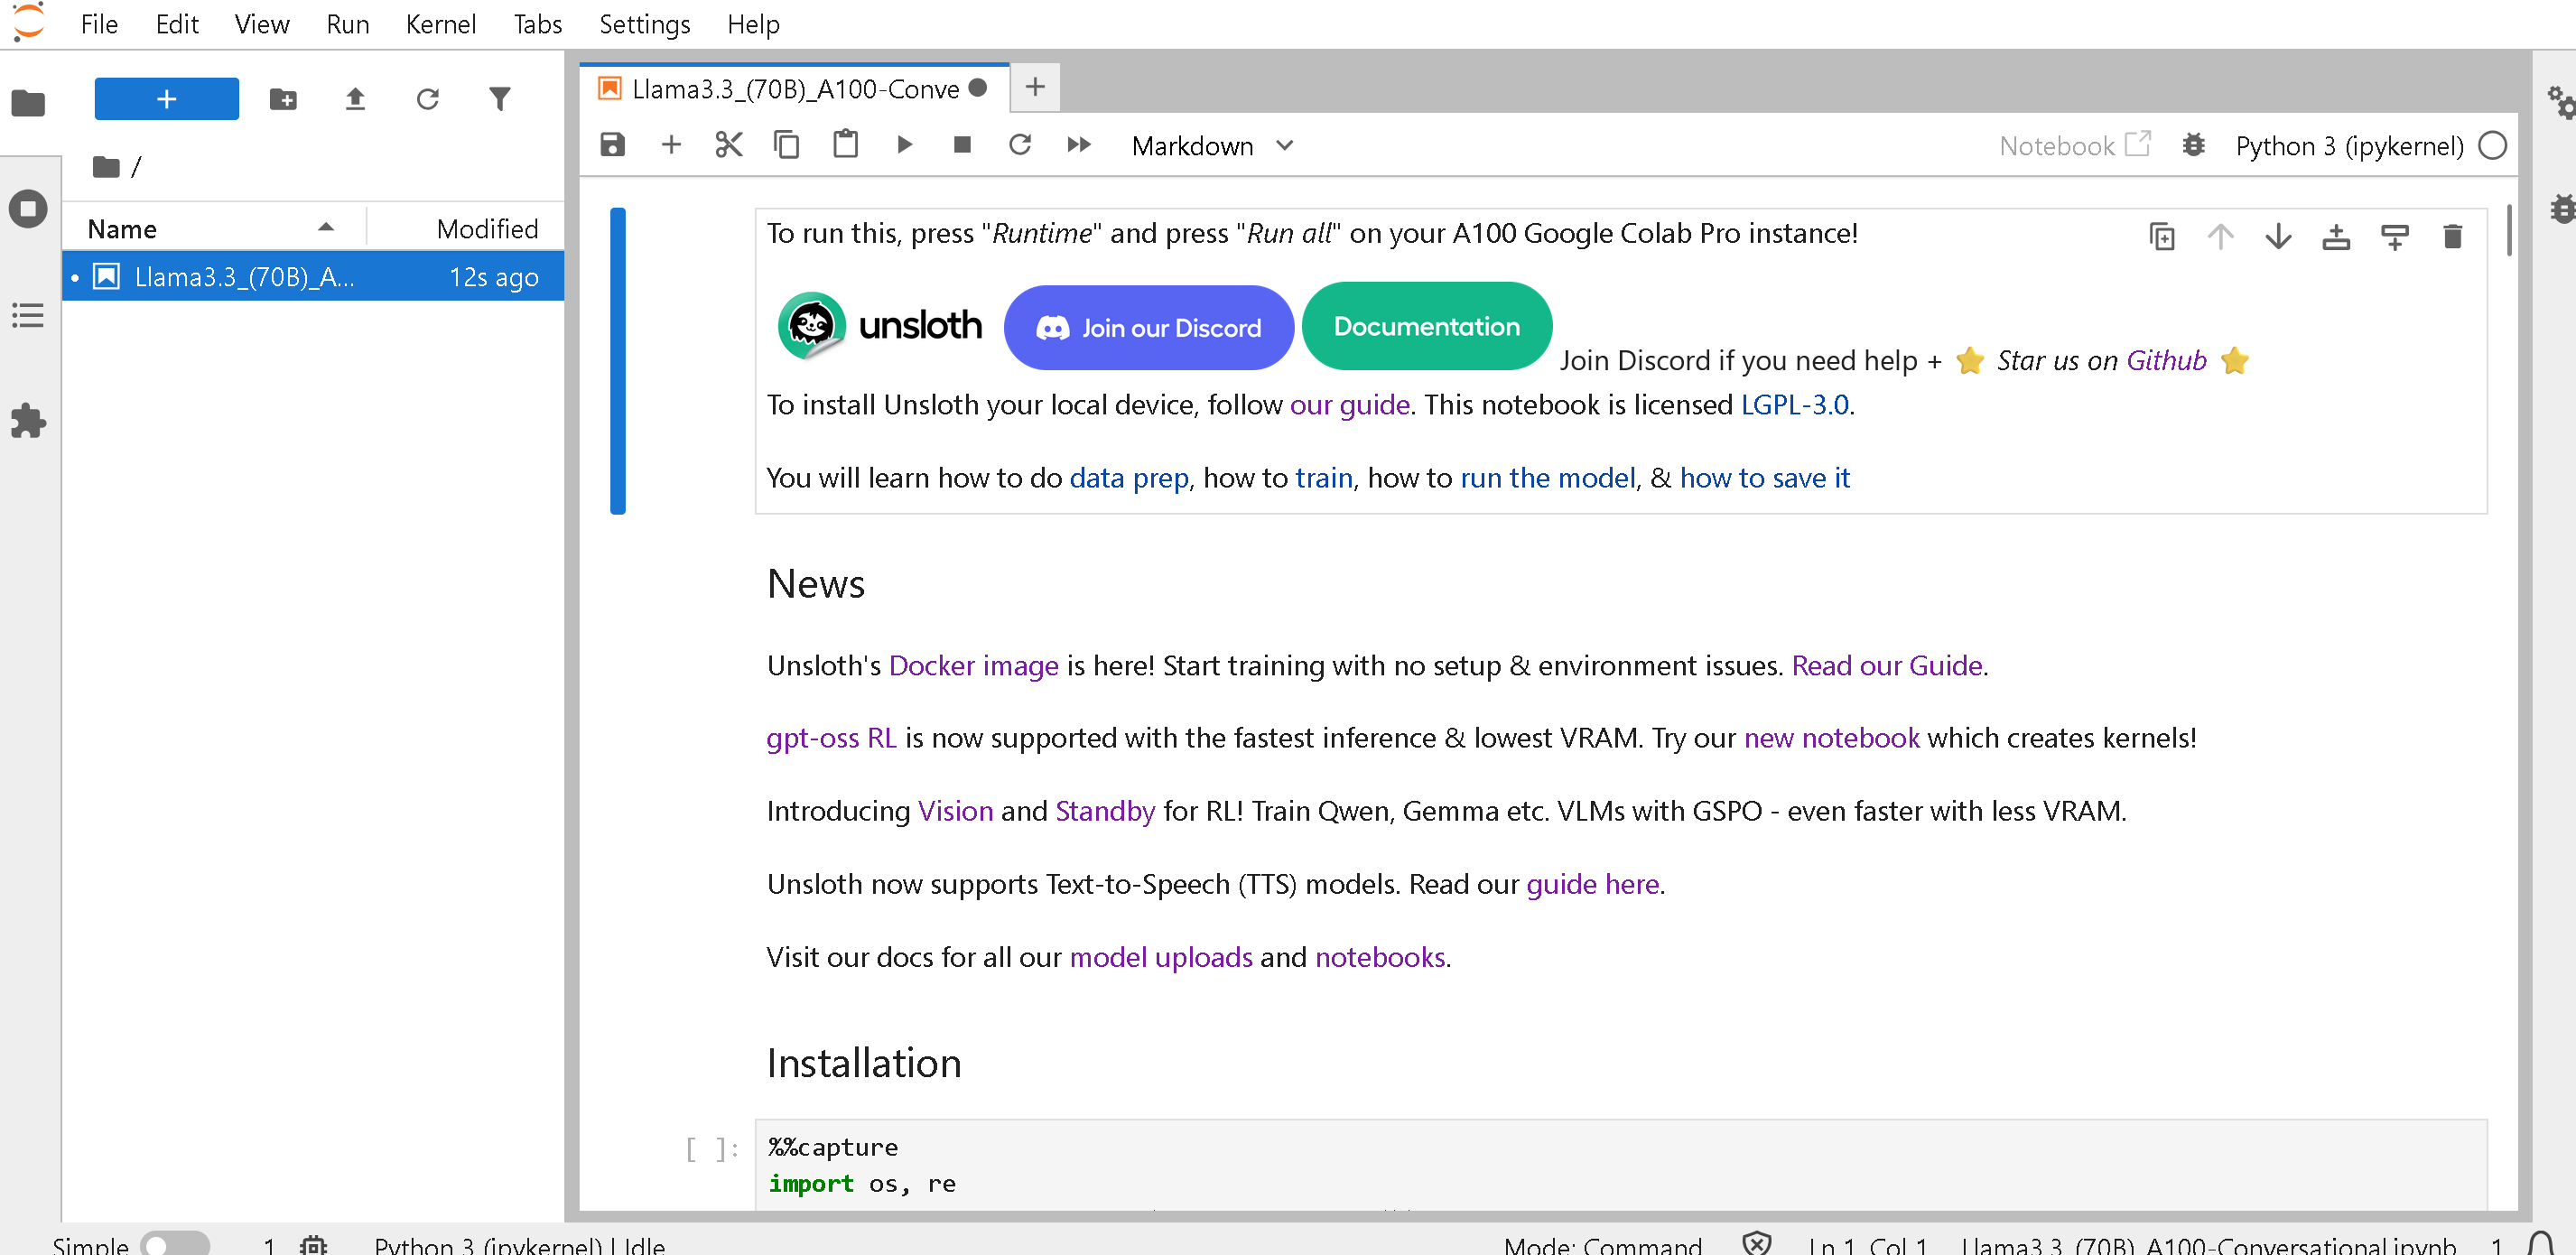
AMD propose des blocs-notes en un clic équipés de **GPU MI300X gratuits avec 192 Go de VRAM** via son Dev Cloud. Entraînez de grands modèles entièrement gratuitement (aucune inscription ni carte bancaire requise) :
* [Qwen3 (32B)](https://amd-ai-academy.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(32B\)_A100-Reasoning-Conversational.ipynb)
* [Llama 3.3 (70B)](https://amd-ai-academy.com/github/unslothai/notebooks/blob/main/nb/AMD-Llama3.3_\(70B\)_A100-Conversational.ipynb)
* [Qwen3 (14B)](https://amd-ai-academy.com/github/unslothai/notebooks/blob/main/nb/AMD-Qwen3_\(14B\)-Reasoning-Conversational.ipynb)
* [Mistral v0.3 (7B)](https://amd-ai-academy.com/github/unslothai/notebooks/blob/main/nb/AMD-Mistral_v0.3_\(7B\)-Alpaca.ipynb)
* [GPT OSS MXFP4 (20B)](https://amd-ai-academy.com/github/unslothai/notebooks/blob/main/nb/AMD-GPT_OSS_MXFP4_\(20B\)-Inference.ipynb) - Inférence
* [Gemma4 (E2B)](https://amd-ai-academy.com/github/unslothai/notebooks/blob/main/nb/Gemma4_\(E2B\)_Reinforcement_Learning_Sudoku_Game.ipynb) - Sudoku en RL
* Unsloth Studio
{% embed url="" %}
Vous pouvez utiliser n’importe quel notebook Unsloth en ajoutant au début dans [Notebooks Unsloth](/docs/fr/commencer/unsloth-notebooks.md) en changeant le lien de \
à
{% columns %}
{% column width="33.33333333333333%" %}
{% endcolumn %}
{% column width="66.66666666666667%" %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/commencer/install/amd.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.