> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/grundlagen/multi-gpu-training-with-unsloth/ddp.md).
# Multi-GPU-Feinabstimmung mit Distributed Data Parallel (DDP)
Erfahren Sie, wie Sie mit der Unsloth-CLI auf mehreren GPUs mit Distributed Data Parallel (DDP) trainieren!
Nehmen wir an, wir haben mehrere GPUs und wollen ein Modell mit all diesen feinabstimmen! Dafür ist die naheliegendste Strategie, Distributed Data Parallel (DDP) zu verwenden, wobei auf jedem GPU-Gerät eine Kopie des Modells erstellt wird, die während des Trainings jeweils unterschiedliche Stichproben aus dem Datensatz erhält und ihre Beiträge zu den Gewichtsaktualisierungen pro Optimizer-Schritt zusammenführt.
Warum würden wir das tun wollen? Nun, je mehr GPUs wir in den Trainingsprozess einbeziehen, desto mehr Samples trainieren unsere Modelle pro Schritt, wodurch jeder Gradienten-Update stabiler wird und unser Trainingsdurchsatz mit jeder hinzugefügten GPU dramatisch steigt.
Hier ist eine Schritt-für-Schritt-Anleitung, wie du das mit der Befehlszeilenschnittstelle (CLI) von Unsloth machst!
**Hinweis:** Unsloth DDP funktioniert mit jedem deiner Trainingsskripte, nicht nur über unsere CLI! Mehr dazu unten.
#### Unsloth aus dem Quellcode installieren
Wir klonen Unsloth von GitHub und installieren es. Bitte erwäge die Verwendung einer [virtuelle Umgebung](https://docs.python.org/3/tutorial/venv.html); wir verwenden gern `uv venv –python 3.12 && source .venv/bin/activate`, aber jedes Tool zur Erstellung virtueller Umgebungen ist geeignet.
```bash
git clone https://github.com/unslothai/unsloth.git
cd unsloth
pip install .
```
#### Zielmodell und Datensatz für das Finetuning auswählen
In dieser Demo werden wir [Qwen/Qwen3-8B](https://huggingface.co/Qwen/Qwen3-8B) auf der [yahma/alpaca-cleaned](https://huggingface.co/datasets/yahma/alpaca-cleaned) Chat-Datensatz. Dies ist eine Supervised Fine-Tuning (SFT)-Arbeitslast, die häufig verwendet wird, wenn man versucht, ein Basismodell an einen gewünschten Gesprächsstil anzupassen oder die Leistung des Modells bei einer nachgelagerten Aufgabe zu verbessern.
### Nutze die Unsloth-CLI!
Zuerst werfen wir einen Blick auf die in die CLI integrierte Hilfenachricht (wir haben hier aus Kürzungsgründen an verschiedenen Stellen „...“ verwendet):
{% code expandable="true" %}
```bash
$ python unsloth-cli.py --help
Verwendung: unsloth-cli.py [-h] [--model_name MODEL_NAME] [--max_seq_length MAX_SEQ_LENGTH] [--dtype DTYPE]
[--load_in_4bit] [--dataset DATASET] [--r R] [--lora_alpha LORA_ALPHA]
[--lora_dropout LORA_DROPOUT] [--bias BIAS]
[--use_gradient_checkpointing USE_GRADIENT_CHECKPOINTING]
…
🦥 Feinabstimme dein LLM schneller mit unsloth!
Optionen:
-h, --help diese Hilfenachricht anzeigen und beenden
🤖 Modelloptionen:
--model_name MODEL_NAME
Zu ladender Modellname
--max_seq_length MAX_SEQ_LENGTH
Maximale Sequenzlänge, Standard ist 2048. Wir unterstützen RoPE Scaling automatisch
intern!
…
🧠 LoRA-Optionen:
Diese Optionen werden verwendet, um das LoRA-Modell zu konfigurieren.
--r R Rang für das LoRA-Modell, Standard ist 16. (häufige Werte: 8, 16, 32, 64, 128)
--lora_alpha LORA_ALPHA
LoRA-Alpha-Parameter, Standard ist 16. (häufige Werte: 8, 16, 32, 64, 128)
…
🎓 Trainingsoptionen:
--per_device_train_batch_size PER_DEVICE_TRAIN_BATCH_SIZE
Batchgröße pro Gerät während des Trainings, Standard ist 2.
--per_device_eval_batch_size PER_DEVICE_EVAL_BATCH_SIZE
Batchgröße pro Gerät während der Auswertung, Standard ist 4.
--gradient_accumulation_steps GRADIENT_ACCUMULATION_STEPS
Anzahl der Gradientenakkumulationsschritte, Standard ist 4.
…
```
{% endcode %}
Das sollte dir einen Eindruck davon geben, welche Optionen du an die CLI übergeben kannst, um dein Modell zu trainieren!
Für das Multi-GPU-Training (in diesem Fall DDP) verwenden wir den [torchrun](https://docs.pytorch.org/docs/stable/elastic/run.html) Launcher, der es dir ermöglicht, mehrere verteilte Trainingsprozesse in Single-Node- oder Multi-Node-Setups zu starten. In unserem Fall konzentrieren wir uns auf den Single-Node-Fall (also eine Maschine) mit zwei H100-GPUs.
Werfen wir auch einen Blick auf den Status unserer GPUs mit dem `nvidia-smi` Befehlszeilentool:
{% code expandable="true" %}
```bash
$ nvidia-smi
Mon Nov 24 12:53:00 2025
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05 Treiberversion: 580.95.05 CUDA-Version: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU Name Persistenz-M | Bus-Id Disp.A | Flüchtige unkorrigierte ECC |
| Lüfter Temp Perf Leistung:Nutzung/Limit | Speichernutzung | GPU-Auslastung Berechnungsmodus |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA H100 80GB HBM3 Ein | 00000000:04:00.0 Aus | 0 |
| N/A 32C P0 69W / 700W | 0MiB / 81559MiB | 0% Standard |
| | | Deaktiviert |
+-----------------------------------------+------------------------+----------------------+
| 1 NVIDIA H100 80GB HBM3 Ein | 00000000:05:00.0 Aus | 0 |
| N/A 30C P0 68W / 700W | 0MiB / 81559MiB | 0% Standard |
| | | Deaktiviert |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| Prozesse: |
| GPU GI CI PID Type Prozessname GPU-Speicher |
| ID ID Nutzung |
|=========================================================================================|
| Keine laufenden Prozesse gefunden |
+-----------------------------------------------------------------------------------------+
```
{% endcode %}
Großartig! Wie erwartet haben wir zwei H100-GPUs. Beide liegen bei 0 MiB Speichernutzung, da wir derzeit nichts trainieren und auch kein Modell im Speicher geladen haben.
Um deinen Trainingslauf zu starten, führe einen Befehl wie den folgenden aus:
{% code expandable="true" %}
```bash
# erforderlich:
# --model_name
# --dataset
# optional; probiere diese aus:
# --learning_rate, --max_seq_length, --per_device_train_batch_size, --gradient_accumulation_steps, --max_steps
# um das Modell am Ende des Trainings zu speichern:
# --save_model
torchrun --nproc_per_node=2 unsloth-cli.py \
--model_name=Qwen/Qwen3-8B \
--dataset=yahma/alpaca-cleaned \
--learning_rate=2e-5 \
--max_seq_length=2048 \
--per_device_train_batch_size=1 \
--gradient_accumulation_steps=4 \
--max_steps=1000 \
--save_model
```
{% endcode %}
Wenn du mehr GPUs hast, kannst du `--nproc_per_node` entsprechend anpassen, um sie zu nutzen.
**Hinweis:** Du kannst den `torchrun` Launcher mit jedem deiner Unsloth-Trainingsskripte verwenden, einschließlich der [Skripte](https://github.com/unslothai/notebooks/tree/main/python_scripts) die aus unseren kostenlosen Colab-Notebooks konvertiert wurden, und DDP wird beim Training mit >1 GPU automatisch aktiviert!
Noch einmal ein Blick auf `nvidia-smi` während das Training läuft:
{% code expandable="true" %}
```bash
$ nvidia-smi
Mon Nov 24 12:58:42 2025
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05 Treiberversion: 580.95.05 CUDA-Version: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU Name Persistenz-M | Bus-Id Disp.A | Flüchtige unkorrigierte ECC |
| Lüfter Temp Perf Leistung:Nutzung/Limit | Speichernutzung | GPU-Auslastung Berechnungsmodus |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA H100 80GB HBM3 Ein | 00000000:04:00.0 Aus | 0 |
| N/A 38C P0 193W / 700W | 18903MiB / 81559MiB | 25% Standard |
| | | Deaktiviert |
+-----------------------------------------+------------------------+----------------------+
| 1 NVIDIA H100 80GB HBM3 Ein | 00000000:05:00.0 Aus | 0 |
| N/A 37C P0 199W / 700W | 18905MiB / 81559MiB | 28% Standard |
| | | Deaktiviert |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| Prozesse: |
| GPU GI CI PID Type Prozessname GPU-Speicher |
| ID ID Nutzung |
|=========================================================================================|
| 0 N/A N/A 4935 C ...und/unsloth/.venv/bin/python3 18256MiB |
| 0 N/A N/A 4936 C ...und/unsloth/.venv/bin/python3 630MiB |
| 1 N/A N/A 4935 C ...und/unsloth/.venv/bin/python3 630MiB |
| 1 N/A N/A 4936 C ...und/unsloth/.venv/bin/python3 18258MiB |
+-----------------------------------------------------------------------------------------+
```
{% endcode %}
Wir sehen, dass beide GPUs nun jeweils etwa 19 GB VRAM pro H100-GPU verwenden!
Wenn wir die Trainingsprotokolle ansehen, sehen wir, dass wir mit einer Rate von etwa 1,1 Iterationen/s trainieren können. Diese Trainingsgeschwindigkeit bleibt auch dann etwa konstant, wenn wir weitere GPUs hinzufügen, sodass unser Trainingsdurchsatz mit der Anzahl der GPUs etwa linear steigt!
### Trainingsmetriken
Wir haben einige kurze LoRA-Feinabstimmungen mit Rang 16 auf [unsloth/Llama-3.2-1B-Instruct](https://huggingface.co/unsloth/Llama-3.2-1B-Instruct) auf der [yahma/alpaca-cleaned](https://huggingface.co/datasets/yahma/alpaca-cleaned) Datensatz durchgeführt, um den verbesserten Trainingsdurchsatz bei Verwendung von DDP-Training mit mehreren GPUs zu demonstrieren.
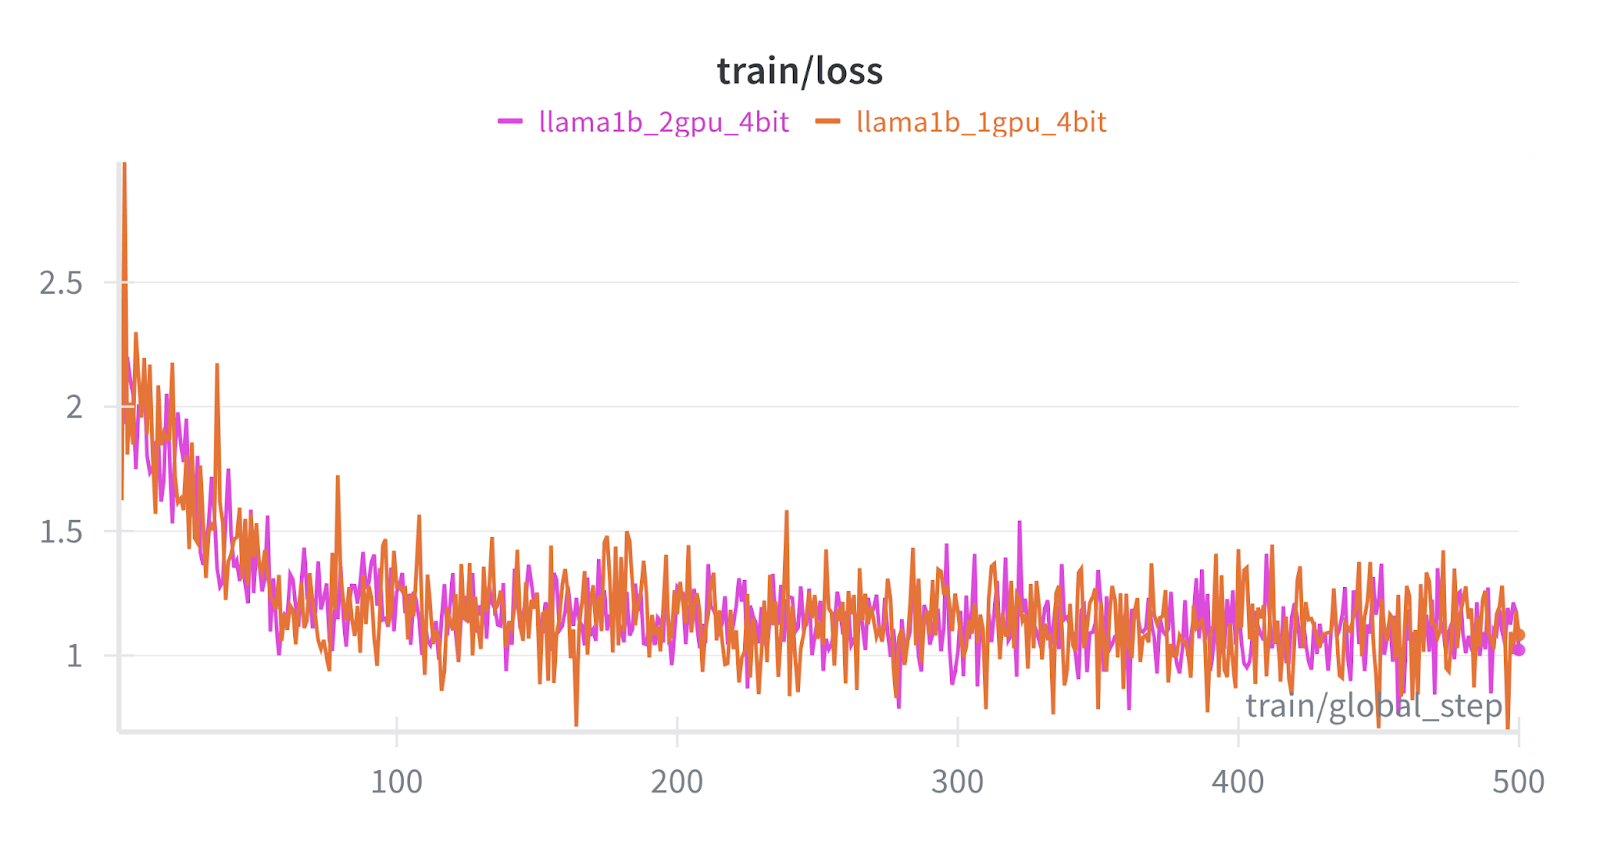
Die obige Abbildung vergleicht den Trainingsverlust zwischen zwei Llama-3.2-1B-Instruct-LoRA-Feinabstimmungen über 500 Trainingsschritte hinweg, mit Single-GPU-Training (pink) gegenüber Multi-GPU-DDP-Training (blau).
Beachte, dass die Verlustkurven in ihrer Skala und ihrem Trend übereinstimmen, sich ansonsten aber ein *wenig* unterscheiden, da *die Multi-GPU-Trainingsprozesse pro Schritt doppelt so viele Trainingsdaten*verarbeiten. Dadurch ergibt sich eine etwas andere Trainingskurve mit geringerer Variabilität von Schritt zu Schritt.
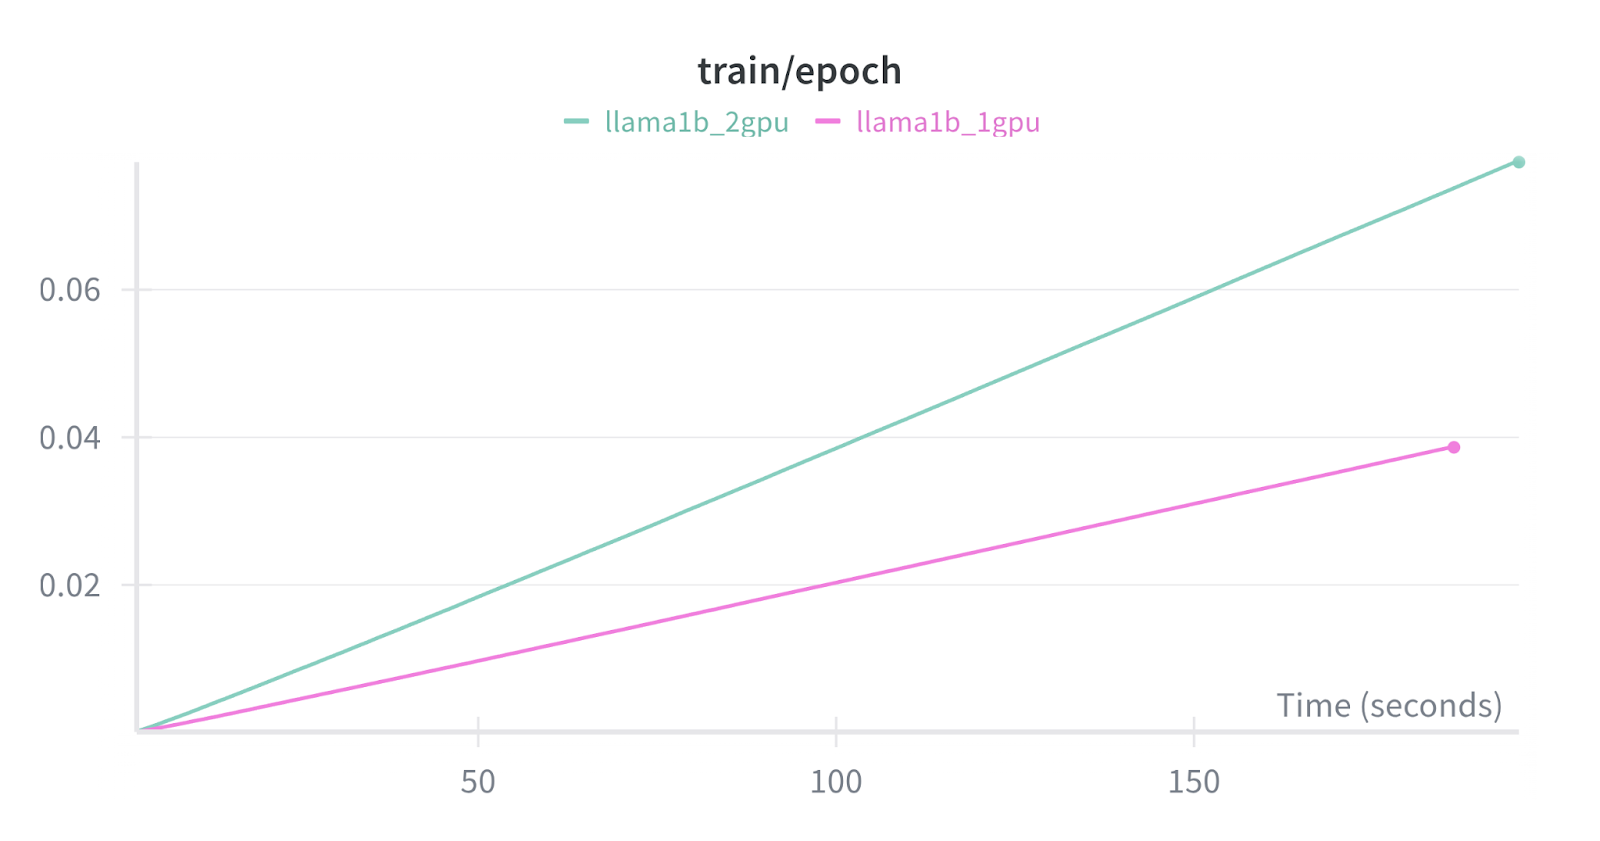
Die obige Abbildung zeigt den Trainingsfortschritt für dieselben beiden Feinabstimmungen.
Beachte, dass das Multi-GPU-DDP-Training eine Epoche der Trainingsdaten in halb so vielen Schritten durchläuft wie das Single-GPU-Training. Das liegt daran, dass jede GPU pro Schritt einen eigenen Batch (mit der Größe `per_device_train_batch_size`) verarbeiten kann. Allerdings ist das Timing pro Schritt beim DDP-Training aufgrund der verteilten Kommunikation für die Modellgewicht-Updates etwas langsamer. Wenn du die Anzahl der GPUs erhöhst, wird der Trainingsdurchsatz weiterhin etwa linear steigen (allerdings mit einer kleinen, aber zunehmenden Strafe für die verteilte Kommunikation).
Dieselben Verläufe bei Verlust und Trainings-Epochenfortschritt gelten auch für QLoRA-Feinabstimmungen, bei denen wir die Basismodelle in 4-Bit-Präzision geladen haben, um zusätzlich GPU-Speicher zu sparen. Das ist besonders nützlich für das Training großer Modelle auf begrenztem GPU-VRAM:
Vergleich des Trainingsverlusts zwischen zwei Llama-3.2-1B-Instruct-QLoRA-Feinabstimmungen über 500 Trainingsschritte hinweg, mit Single-GPU-Training (orange) gegenüber Multi-GPU-DDP-Training (violett).
Vergleich des Trainingsfortschritts für dieselben beiden Feinabstimmungen.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/grundlagen/multi-gpu-training-with-unsloth/ddp.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.