> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/tutorial-how-to-fine-tune-gpt-oss.md).
# チュートリアル: gpt-ossをファインチューニングする方法
OpenAI gpt-ossをUnslothでローカルに学習する方法をステップごとに学びましょう。
このスクリーンショット付きガイドでは、独自のカスタム gpt-oss モデルをファインチューニングする方法を、次のいずれかで学べます [ローカルで](#local-gpt-oss-fine-tuning) 自分のマシンで [Unsloth](https://github.com/unslothai/unsloth) または無料で次を使って [Google Colab](#colab-gpt-oss-fine-tuning)。セットアップから学習済みモデルの実行と保存まで、全体の手順を案内します。
{% hint style="success" %}
[**8月28日更新**](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support)**:** QLoRAでファインチューニングした gpt-oss モデルを、llama.cpp、vLLM、HF などへエクスポート/保存できるようになりました。
また、以下も導入しました [Unsloth Flex Attention](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support) これにより可能になるのは **>8×長いコンテキスト長**, **>50%少ないVRAM使用量** そして **>1.5×高速な学習** すべての実装と比較して。 [詳しくはこちら](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support)
{% endhint %}
> **クイックスタート:** 以下を使って gpt-oss-20b を無料でファインチューニングできます: [Colabノートブック](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-Fine-tuning.ipynb)
Unsloth による gpt-oss のファインチューニングは、他のすべての FA2 実装と比べて、学習を1.5倍高速化し、VRAM使用量を70%削減し、コンテキスト長を10倍に拡張できます。しかも精度低下はありません。
* **QLoRAの要件:** gpt-oss-20b = 14GB VRAM • gpt-oss-120b = 65GB VRAM.
* **BF16 LoRAの要件:** gpt-oss-20b = 44GB VRAM • gpt-oss-120b = 210GB VRAM.
ローカルガイドColabガイド
## 🌐 Colabでの gpt-oss ファインチューニング
このセクションでは、Google Colab を使った gpt-oss のファインチューニングを扱います [ノートブック](/docs/jp/meru/unsloth-notebooks.md)。gpt-oss のノートブックをお気に入りのコードエディタに保存して使うこともでき、以下の [ローカル gpt-oss ガイド](#local-gpt-oss-fine-tuning).
{% stepper %}
{% step %}
#### Unsloth をインストール(Colab内)
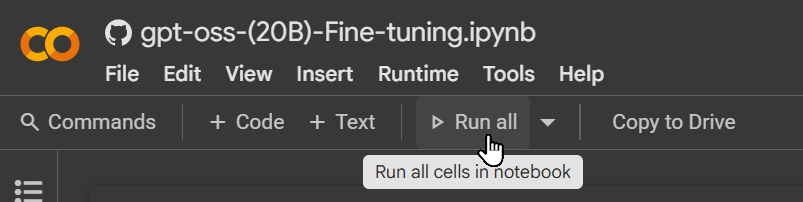
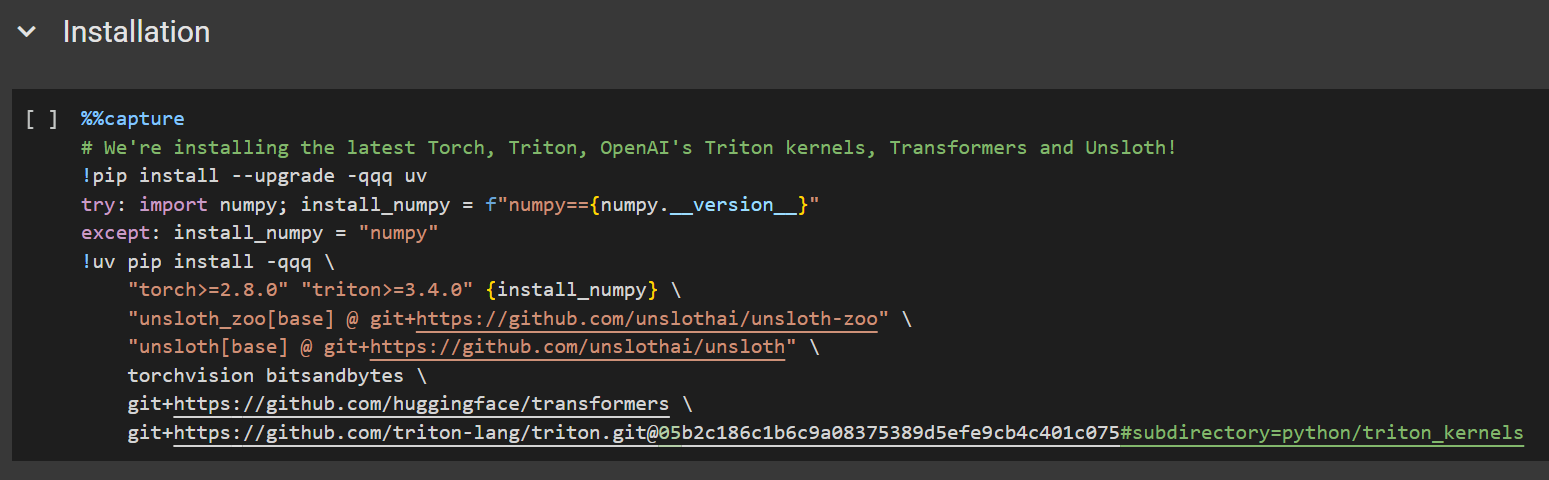
Colabでは、セルを **上から下へ**に似ています。 **すべて実行** を最初に行ってください。最初のセルは Unsloth(および関連依存関係)をインストールし、GPU/メモリ情報を表示します。セルでエラーが出た場合は、再実行するだけで大丈夫です。
 {% endstep %}
{% step %}
#### gpt-oss と推論エフォートの設定
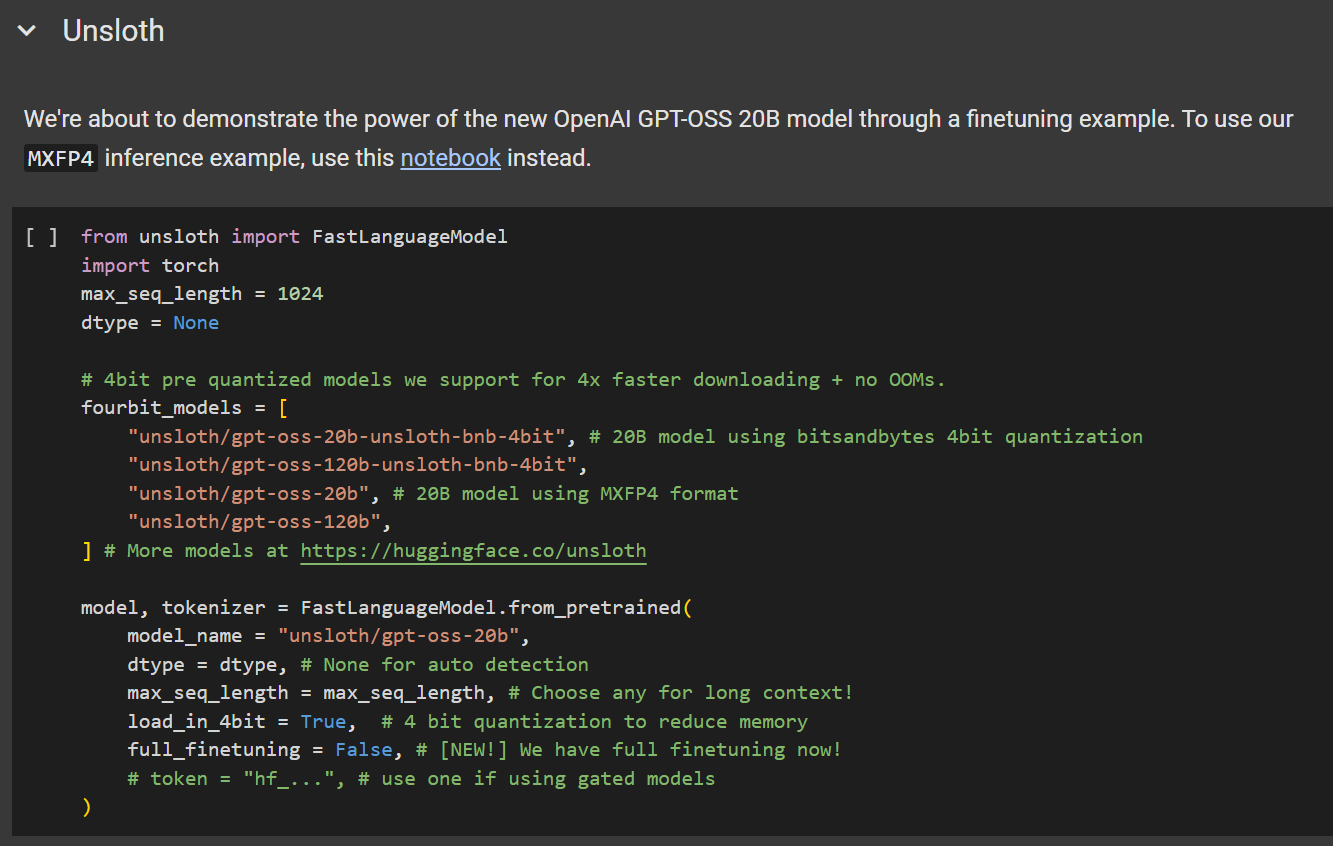
次を読み込みます **`gpt-oss-20b`** Unsloth の [線形化版](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune.md#making-efficient-gpt-oss-fine-tuning-work) (他のバージョンでは動作しないため)。
以下のパラメータを設定してください:
* `max_seq_length = 1024`
* 迅速なテストや初期実験に推奨されます。
* `load_in_4bit = True`
* 次を使います: `False` LoRA 学習用(注: これを `False` に設定すると、少なくとも 43GB の VRAM が必要になります)。あなたは ***必ず*** 次も設定する必要があります **`model_name = "unsloth/gpt-oss-20b-BF16"`**
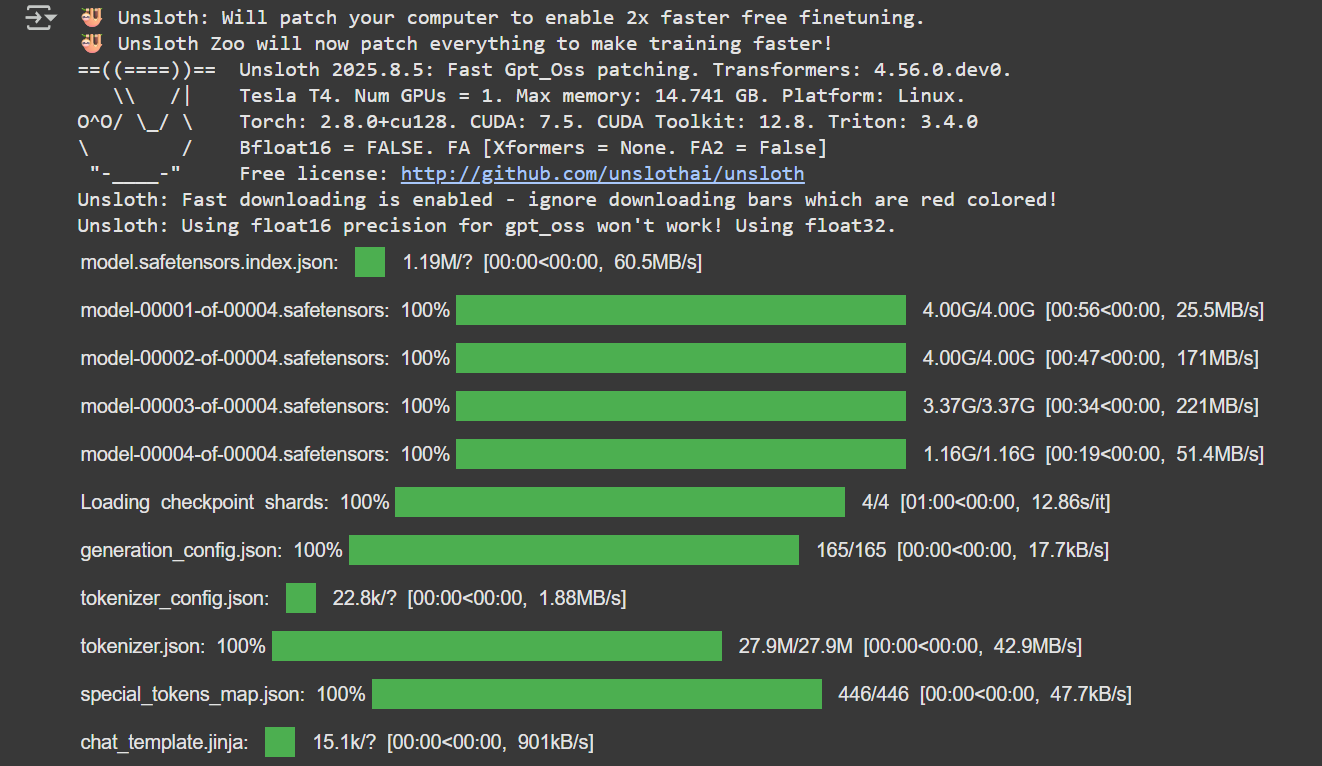
 以下の例に似た出力が表示されるはずです。注: 私たちは明示的に次を変更します `dtype` を `float32` 正しい学習動作を確保するためです。
 {% endstep %}
{% step %}
#### ファインチューニングのハイパーパラメータ(LoRA)
ここで学習ハイパーパラメータを調整しましょう。いつ、どのように、何を調整するかをより深く知りたい場合は、以下をご覧ください [詳細ハイパーパラメータガイド](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
{% hint style="info" %}
避けるために [過学習](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting)、学習損失を監視し、これらの値を高くしすぎないようにしてください。
{% endhint %}
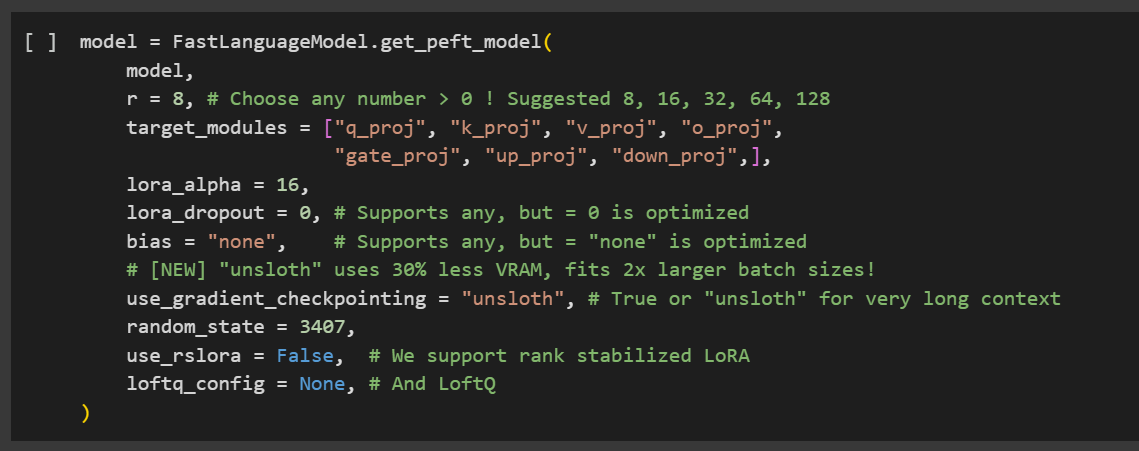
このステップでは、パラメータ効率の高いファインチューニングのために LoRA アダプターを追加します。学習するのはモデルのパラメータの約 1% だけなので、処理は大幅に効率化されます。
 {% endstep %}
{% step %}
#### 推論を試す
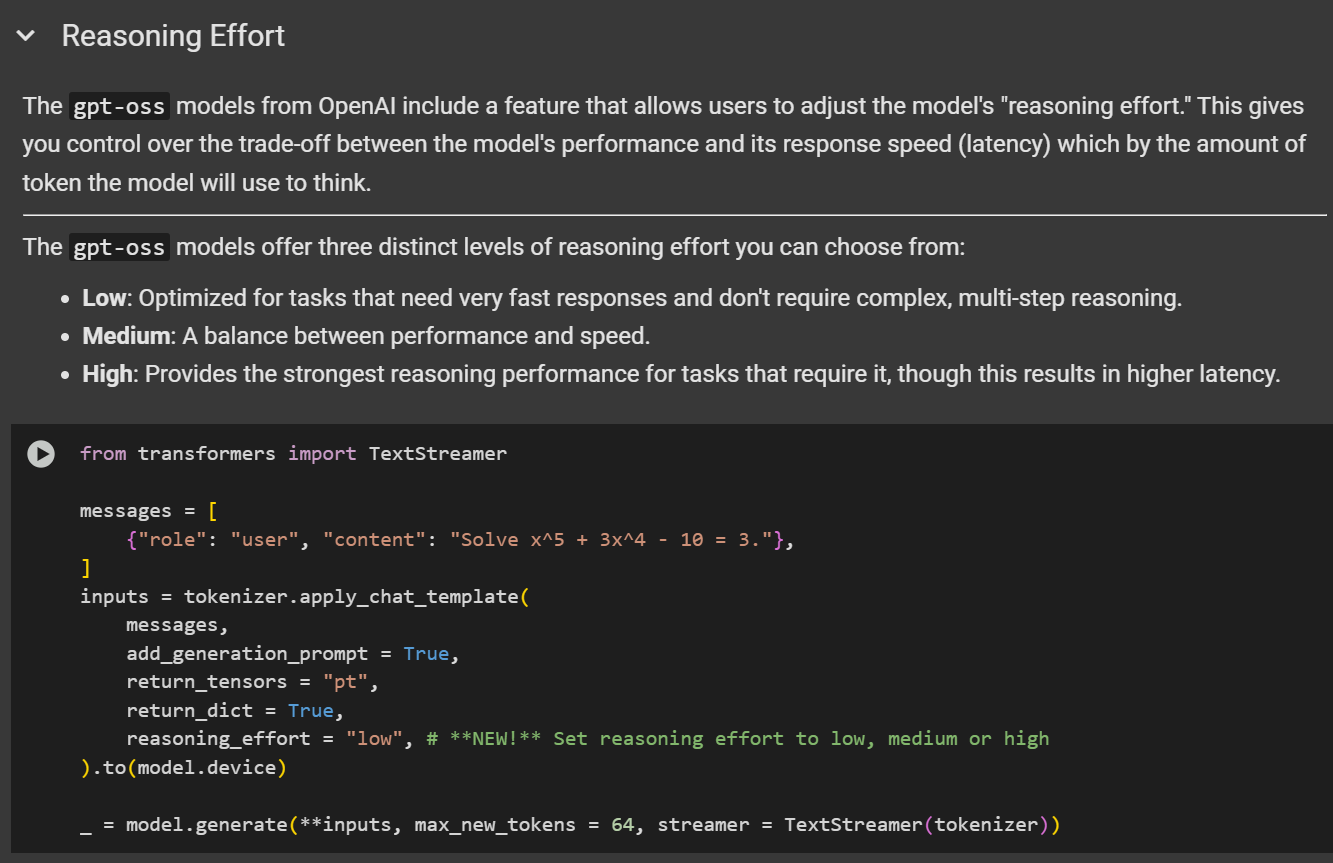
ノートブックには *「推論エフォート」* というセクションがあり、Colab で動作する gpt-oss の推論をデモしています。このステップはスキップできますが、ファインチューニング完了後には後でモデルを実行する必要があります。
 {% endstep %}
{% step %}
#### データ準備
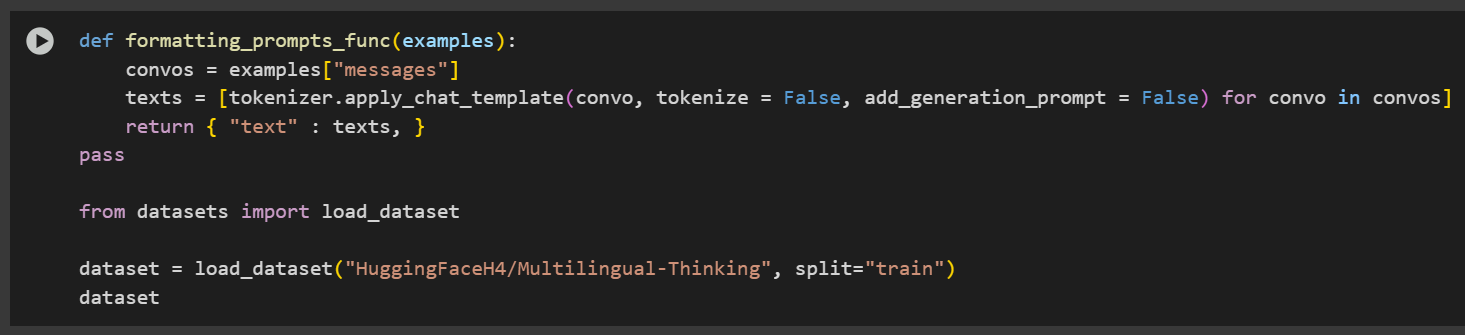
この例では、 [`HuggingFaceH4/Multilingual-Thinking`](https://huggingface.co/datasets/HuggingFaceH4/Multilingual-Thinking)を使用します。このデータセットには、英語から 4 つの追加言語に翻訳されたユーザー質問に基づく chain-of-thought 推論例が含まれています。
これは、OpenAI のファインチューニング cookbook で参照されているのと同じデータセットです。
多言語データセットを使う目的は、モデルが複数言語にまたがる推論パターンを学習し、汎化できるようにすることです。
 gpt-oss には、モデルがどれだけ推論を行うかを制御する推論エフォートシステムがあります。デフォルトでは、推論エフォートは次に設定されています `低`、ただし次を `reasoning_effort` パラメータを `低`, `中` または `高`.
例:
```python
tokenizer.apply_chat_template(
text,
tokenize = False,
add_generation_prompt = False,
reasoning_effort = "medium",
)
```
データセットを整形するため、gpt-oss プロンプトのカスタマイズ版を適用します:
```python
from unsloth.chat_templates import standardize_sharegpt
dataset = standardize_sharegpt(dataset)
dataset = dataset.map(formatting_prompts_func, batched = True,)
```
最初の例を表示して、データセットを確認してみましょう:
```notebook-python
print(dataset[0]['text'])
```
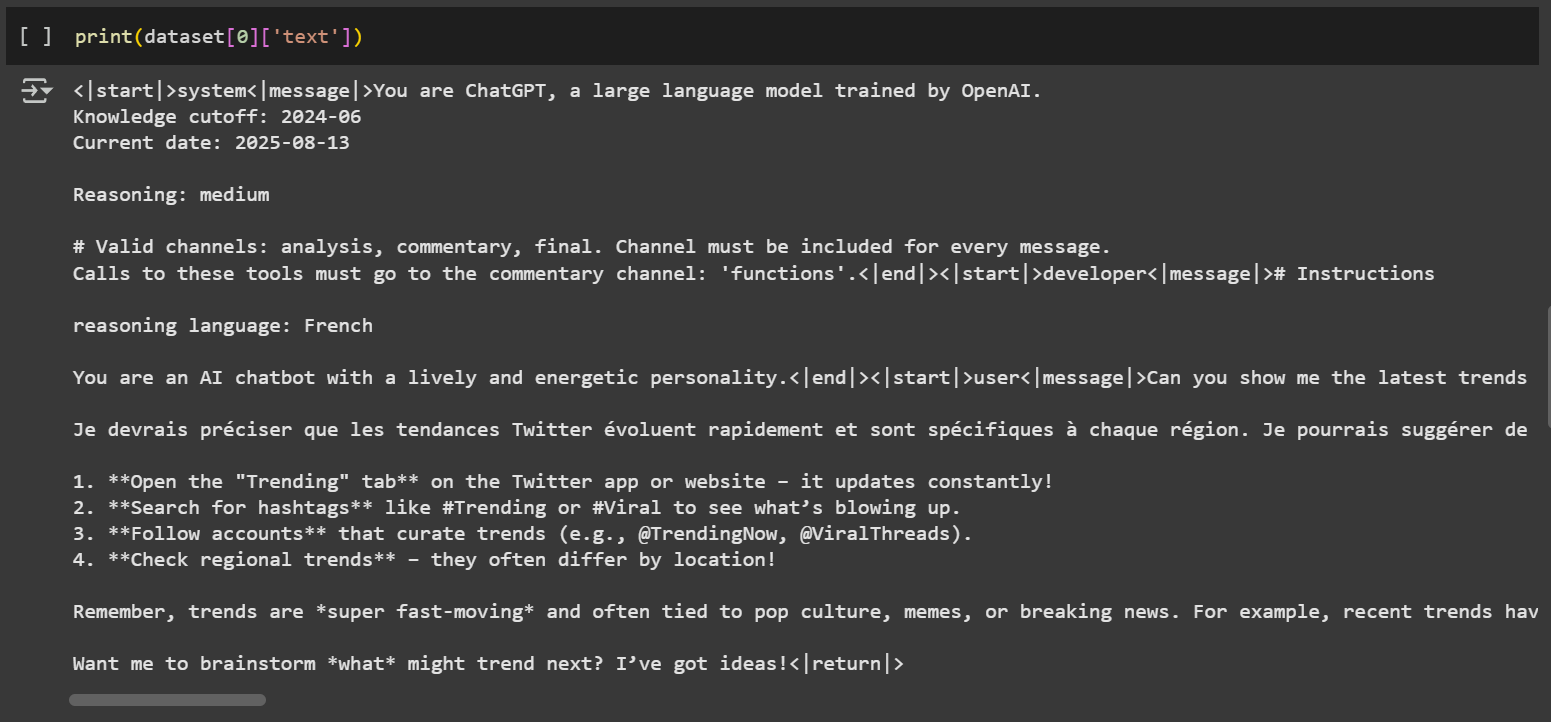 gpt-oss のユニークな特徴の一つは、次を使用していることです [**OpenAI Harmony形式**](https://github.com/openai/harmony)**,** これにより、構造化された会話、推論出力、ツール呼び出しをサポートします。この形式には次のようなタグが含まれます `<|start|>` , `<|message|>` と `<|return|>` .
{% hint style="info" %}
🦥 Unsloth はチャットテンプレートを正しい状態に修正します。こちらの [ツイート](https://x.com/danielhanchen/status/1953901104150065544) でテンプレート修正の技術的詳細をご覧ください。
{% endhint %}
プロンプトや構成は、ご自身のデータセットやユースケースに合わせて自由に調整してください。詳しいガイダンスは、以下をご覧ください [データセットガイド](/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md).
{% endstep %}
{% step %}
#### モデルを学習
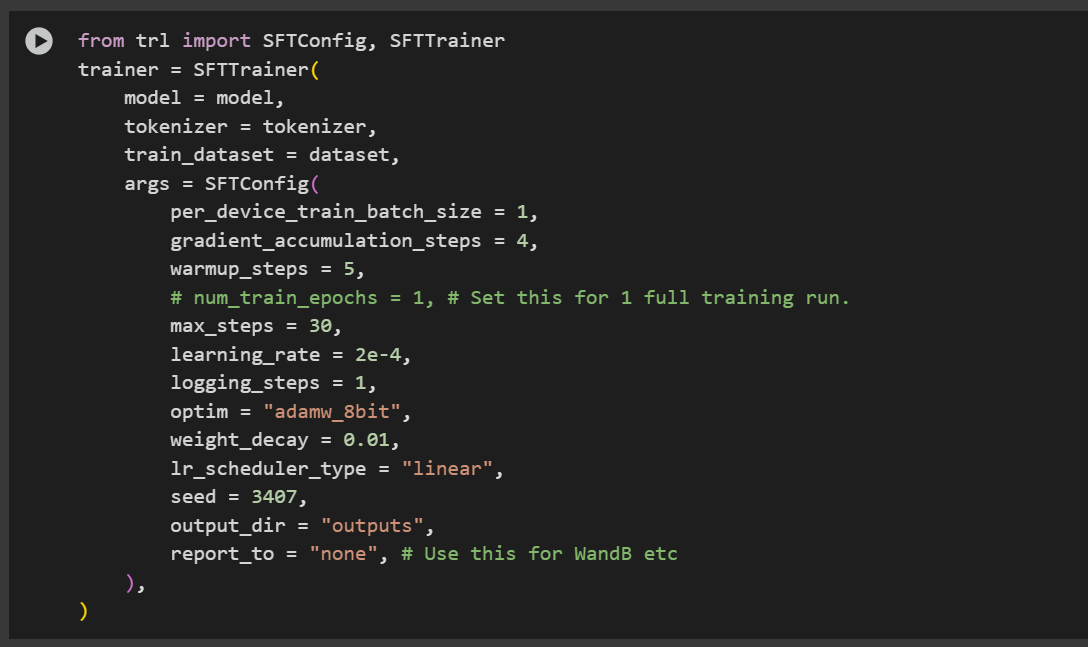
最適な結果が得られるよう、学習ハイパーパラメータはあらかじめ選定済みです。ただし、特定のユースケースに応じて変更できます。以下をご参照ください [ハイパーパラメータガイド](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
この例では、処理を高速化するために 60 ステップ学習します。完全な学習実行を行うには、次を設定してください `num_train_epochs=1` ステップ制限を無効にするには、次を設定してください `max_steps=None`.
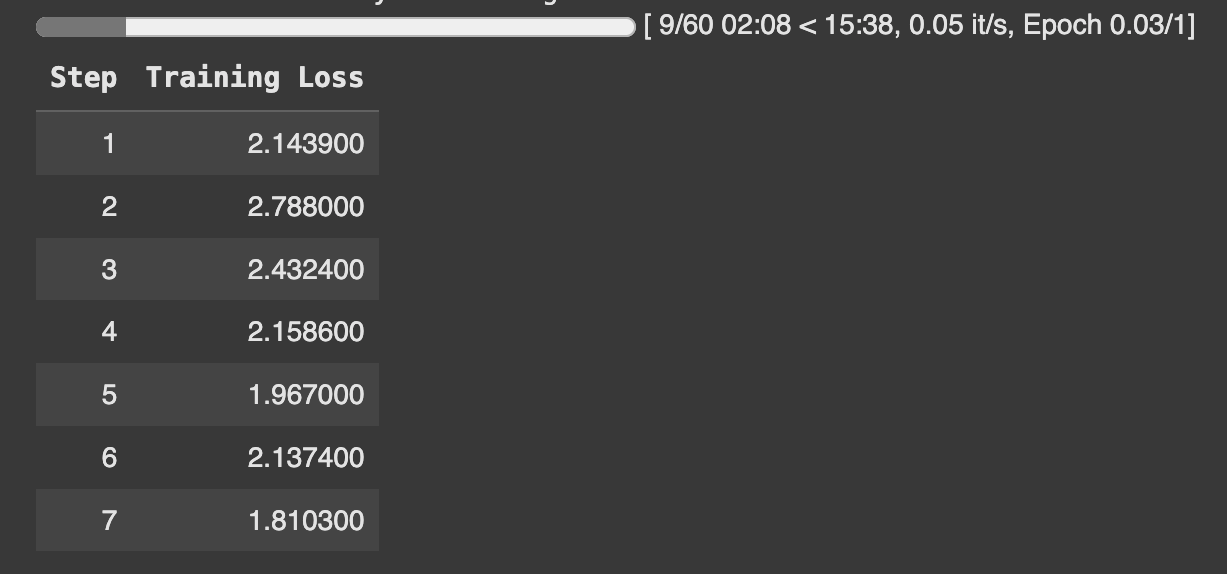
 学習中は、損失が時間とともに減少していることを確認するために監視してください。これにより、学習プロセスが正しく機能していることが確認できます。
 {% endstep %}
{% step %}
#### 推論: 学習済みモデルを実行
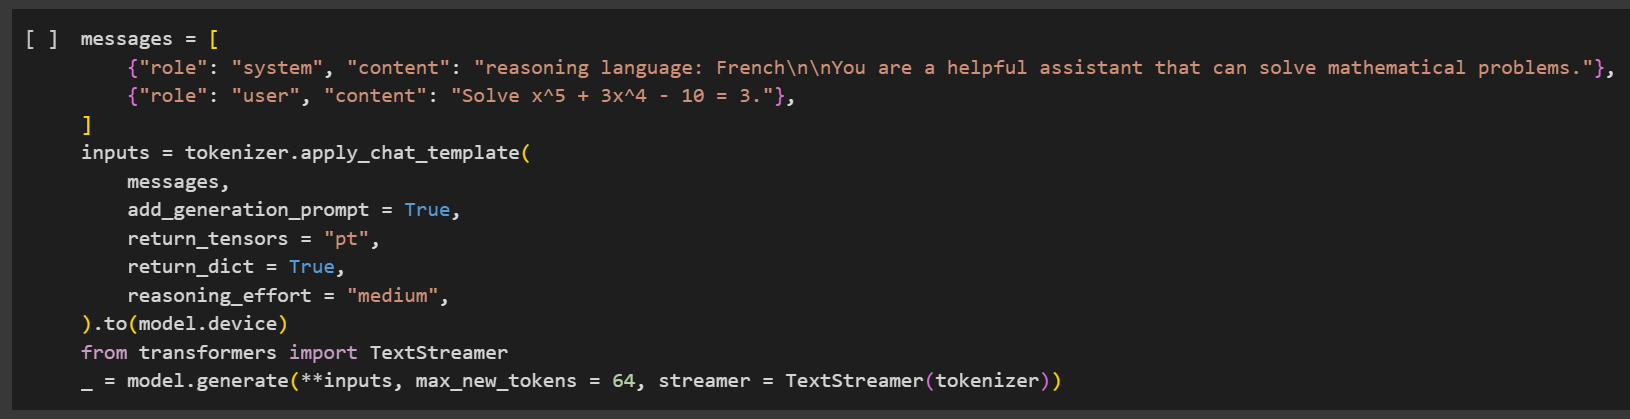
ここからは、ファインチューニングしたモデルで推論を実行しましょう。指示と入力は変更できますが、出力は空欄のままにしてください。
この例では、データセットで使ったのと同じ構成に従い、システムプロンプトに特定の指示を追加して、モデルのフランス語で推論する能力をテストします。
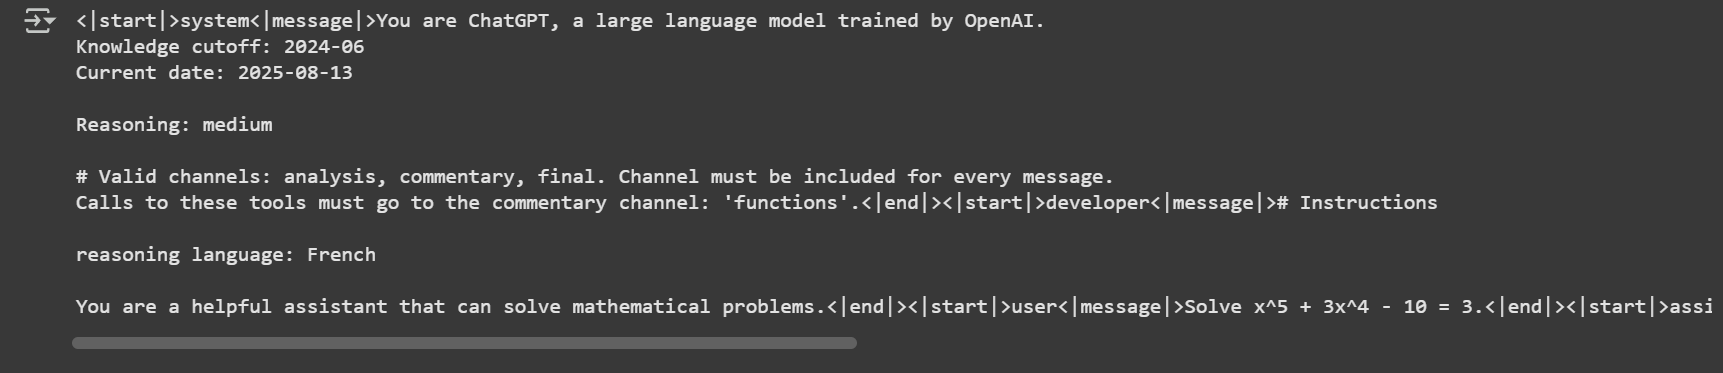
 次のような出力になるはずです:
 {% endstep %}
{% step %}
#### モデルを保存/エクスポート
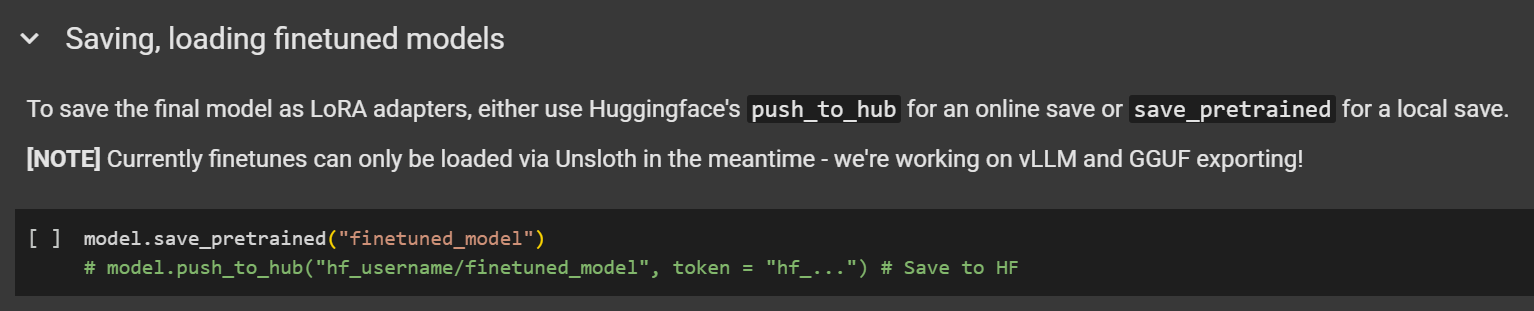
ファインチューニングしたモデルを保存するには、次のどちらでもエクスポートできます **bf16形式、** 当社の **MXFP4 のオンデマンド逆量子化** ベースモデルを次を使って `save_method="merged_16bit"`またはネイティブの **MXFP4** Safetensors 形式で次を使って `save_method="mxfp4"` .
その **MXFP4** ネイティブのマージ形式は、 **bf16 形式**と比べて大幅な性能向上を提供します: ディスク容量を最大 75% 削減し、VRAM 消費を 50% 減らし、マージを 5〜10 倍高速化し、 **GGUF** への変換をはるかに高速にします。
{% hint style="success" %}
新機能: QLoRA でファインチューニングしたモデルの GGUF への保存またはマージが、他のフレームワーク(例: Hugging Face、GGUF 対応の llama.cpp)での利用向けにサポートされました。
{% endhint %}
gpt-oss モデルのファインチューニング後、次の形式にマージできます **MXFP4** を次のコマンドで:
```python
model.save_pretrained_merged(save_directory, tokenizer, save_method="mxfp4)
```
モデルをマージして、そのまま Hugging Face Hub にプッシュしたい場合は:
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token= hf_token, save_method="mxfp4")
```
#### :sparkles: Llama.cpp への保存
1. 最新の `llama.cpp` を [GitHubこちら](https://github.com/ggml-org/llama.cpp)。以下のビルド手順に従うこともできます。変更してください `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` GPUがない場合、またはCPU推論のみを使いたい場合は。
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. 次を変換します **MXFP4** マージ済みモデル:
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned-mxfp4.gguf
```
3. 量子化済みモデルで推論を実行します:
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-mxfp4.gguf \\
--jinja -ngl 99 --threads -1 --ctx-size 16384 \\
--temp 1.0 --top-p 1.0 --top-k 0 \\
-p "生命と宇宙の意味は"
```
 {% endstep %}
{% endstepper %}
## 🖥️ ローカルでの gpt-oss ファインチューニング
この章では、ローカルデバイス上での gpt-oss のファインチューニングを扱います。 **gpt-oss-20b** ファインチューニングは 14GB の VRAM だけでも動作しますが、安定して信頼できる学習実行を確保するため、少なくとも 16GB の VRAM を用意することを推奨します。
{% hint style="info" %}
Colab [ノートブック](/docs/jp/meru/unsloth-notebooks.md) の要素をダウンロードまたは取り入れて、ローカル環境で使いやすくすることを推奨します。
{% endhint %}
{% stepper %}
{% step %}
#### Unsloth をローカルにインストール
お使いのデバイスが [Unsloth 対応であることを確認してください](/docs/jp/meru/fine-tuning-for-beginners/unsloth-requirements.md) また、以下の詳細な [インストールガイド](/docs/jp/meru/install.md).
**を使って Unsloth をインストールすることもできます** [**Docker イメージ**](https://unsloth.ai/docs/models/qwen3-coder-next)**.**
注意: `pip install unsloth` は、この設定では動作しません。最新の PyTorch、Triton、および関連パッケージを使う必要があるためです。次の特定のコマンドを使って Unsloth をインストールしてください:
```python
# 最新の Torch、Triton、OpenAI の Triton カーネル、Transformers、Unsloth をインストールしています!
!pip install --upgrade -qqq uv
try: import numpy; install_numpy = f"numpy=={numpy.__version__}"
except: install_numpy = "numpy"
!uv pip install -qqq \
"torch>=2.8.0" "triton>=3.4.0" {install_numpy} \\
"unsloth_zoo[base] @ git+https://github.com/unslothai/unsloth-zoo" \
"unsloth[base] @ git+https://github.com/unslothai/unsloth" \
torchvision bitsandbytes \\
git+https://github.com/huggingface/transformers \\
git+https://github.com/triton-lang/triton.git@05b2c186c1b6c9a08375389d5efe9cb4c401c075#subdirectory=python/triton_kernels
```
{% endstep %}
{% step %}
#### gpt-oss と推論エフォートの設定
次を読み込みます **`gpt-oss-20b`** Unsloth の [線形化版](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune.md#making-efficient-gpt-oss-fine-tuning-work) (他のバージョンでは QLoRA ファインチューニングが動作しないため)。以下のパラメータを設定してください:
* `max_seq_length = 2048`
* 迅速なテストや初期実験に推奨されます。
* `load_in_4bit = True`
* 次を使います: `False` LoRA 学習用(注: これを `False` に設定すると、少なくとも 43GB の VRAM が必要になります)。あなたは ***必ず*** 次も設定する必要があります **`model_name = "unsloth/gpt-oss-20b-BF16"`**
from unsloth import FastLanguageModel
import torch
max_seq_length = 1024
dtype = None

# 4bit 事前量子化モデル。4倍高速なダウンロード + OOMなしを実現できます。
fourbit_models = [
    "unsloth/gpt-oss-20b-unsloth-bnb-4bit", # 20Bモデルを bitsandbytes 4bit 量子化で使用
    "unsloth/gpt-oss-120b-unsloth-bnb-4bit",
    "unsloth/gpt-oss-20b", # MXFP4 形式を使う 20B モデル
    "unsloth/gpt-oss-120b",
] # 他のモデルは https://huggingface.co/unsloth で確認できます

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/gpt-oss-20b",
    dtype = dtype, # 自動検出の場合は None
    max_seq_length = max_seq_length, # 長いコンテキスト用に任意の値を選べます!
    load_in_4bit = True,  # メモリ削減のための 4bit 量子化
    full_finetuning = False, # [NEW!] いまはフルファインチューニングも可能です!
    # token = "hf_...", # ゲート付きモデルを使う場合は1つ使用してください
)
以下の例に似た出力が表示されるはずです。注: 私たちは明示的に次を変更します `dtype` を `float32` 正しい学習動作を確保するためです。
{% endstep %}
{% step %}
#### ファインチューニングのハイパーパラメータ(LoRA)
ここで学習ハイパーパラメータを調整しましょう。いつ、どのように、何を調整するかをより深く知りたい場合は、以下をご覧ください [詳細ハイパーパラメータガイド](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
{% hint style="info" %}
避けるために [過学習](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting)、学習損失を監視し、これらの値を高くしすぎないようにしてください。
{% endhint %}
このステップでは、パラメータ効率の高いファインチューニングのために LoRA アダプターを追加します。学習するのはモデルのパラメータの約 1% だけなので、処理は大幅に効率化されます。
```python
model = FastLanguageModel.get_peft_model(
model,
r = 8, # 0 より大きい任意の数を選べます!推奨: 8, 16, 32, 64, 128
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",],
lora_alpha = 16,
lora_dropout = 0, # 任意の値に対応していますが、= 0 が最適化されています
bias = "none", # 任意の値に対応していますが、= "none" が最適化されています
# [NEW] "unsloth" は VRAM を 30% 少なく使用し、2倍大きいバッチサイズに対応します!
use_gradient_checkpointing = "unsloth", # 非常に長いコンテキストでは True または "unsloth"
random_state = 3407,
use_rslora = False, # ランク安定化LoRAをサポートしています
loftq_config = None, # そしてLoftQ
)
```
{% endstep %}
{% step %}
#### データ準備
この例では、 [`HuggingFaceH4/Multilingual-Thinking`](https://huggingface.co/datasets/HuggingFaceH4/Multilingual-Thinking)を使用します。このデータセットには、英語から 4 つの追加言語に翻訳されたユーザー質問に基づく chain-of-thought 推論例が含まれています。
これは、OpenAI のファインチューニング cookbook で参照されているのと同じデータセットです。多言語データセットを使う目的は、モデルが複数言語にまたがる推論パターンを学習し、汎化できるようにすることです。
```python
def formatting_prompts_func(examples):
convos = examples["messages"]
texts = [tokenizer.apply_chat_template(convo, tokenize = False, add_generation_prompt = False) for convo in convos]
return { "text" : texts, }
pass
from datasets import load_dataset
dataset = load_dataset("HuggingFaceH4/Multilingual-Thinking", split="train")
dataset
```
gpt-oss には、モデルがどれだけ推論を行うかを制御する推論エフォートシステムがあります。デフォルトでは、推論エフォートは次に設定されています `低`、ただし次を `reasoning_effort` パラメータを `低`, `中` または `高`.
例:
```python
tokenizer.apply_chat_template(
text,
tokenize = False,
add_generation_prompt = False,
reasoning_effort = "medium",
)
```
データセットを整形するため、gpt-oss プロンプトのカスタマイズ版を適用します:
```python
from unsloth.chat_templates import standardize_sharegpt
dataset = standardize_sharegpt(dataset)
dataset = dataset.map(formatting_prompts_func, batched = True,)
```
最初の例を表示して、データセットを確認してみましょう:
```notebook-python
print(dataset[0]['text'])
```
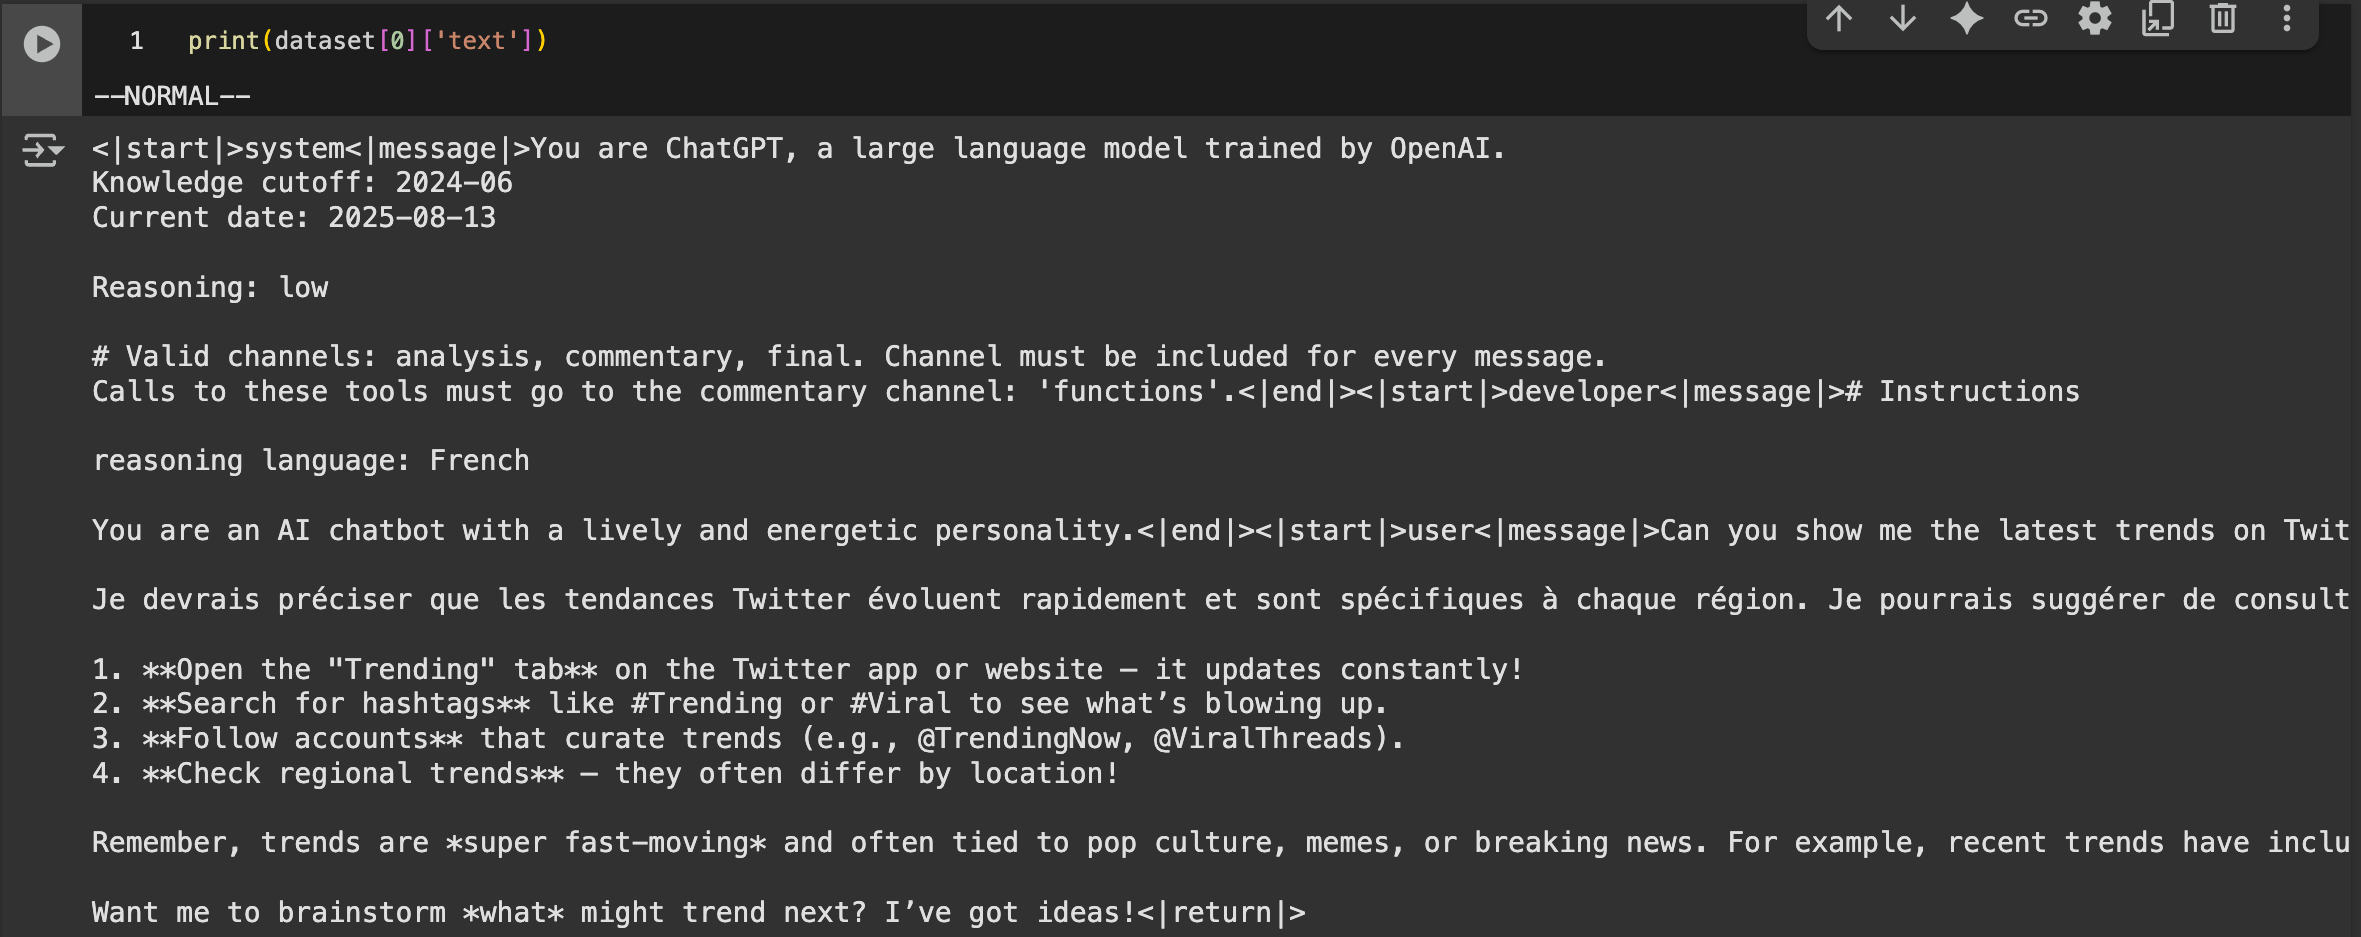 gpt-oss のユニークな特徴の一つは、次を使用していることです [**OpenAI Harmony形式**](https://github.com/openai/harmony)**,** これにより、構造化された会話、推論出力、ツール呼び出しをサポートします。この形式には次のようなタグが含まれます `<|start|>` , `<|message|>` と `<|return|>` .
{% hint style="info" %}
🦥 Unsloth はチャットテンプレートを正しい状態に修正します。こちらの [ツイート](https://x.com/danielhanchen/status/1953901104150065544) でテンプレート修正の技術的詳細をご覧ください。
{% endhint %}
プロンプトや構成は、ご自身のデータセットやユースケースに合わせて自由に調整してください。詳しいガイダンスは、以下をご覧ください [データセットガイド](/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md).
{% endstep %}
{% step %}
#### モデルを学習
最適な結果が得られるよう、学習ハイパーパラメータはあらかじめ選定済みです。ただし、特定のユースケースに応じて変更できます。以下をご参照ください [ハイパーパラメータガイド](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
この例では、処理を高速化するために 60 ステップ学習します。完全な学習実行を行うには、次を設定してください `num_train_epochs=1` ステップ制限を無効にするには、次を設定してください `max_steps=None`.
```python
from trl import SFTConfig, SFTTrainer
trainer = SFTTrainer(
model = model,
tokenizer = tokenizer,
train_dataset = dataset,
args = SFTConfig(
per_device_train_batch_size = 1,
gradient_accumulation_steps = 4,
warmup_steps = 5,
# num_train_epochs = 1, # 1 回の完全学習ならこれを設定。
max_steps = 30,
learning_rate = 2e-4,
logging_steps = 1,
optim = "adamw_8bit",
weight_decay = 0.01,
lr_scheduler_type = "linear",
seed = 3407,
output_dir = "outputs",
report_to = "none", # WandBなどに使う
),
)
```
学習中は、損失が時間とともに減少していることを確認するために監視してください。これにより、学習プロセスが正しく機能していることが確認できます。
{% endstep %}
{% step %}
#### 推論: 学習済みモデルを実行
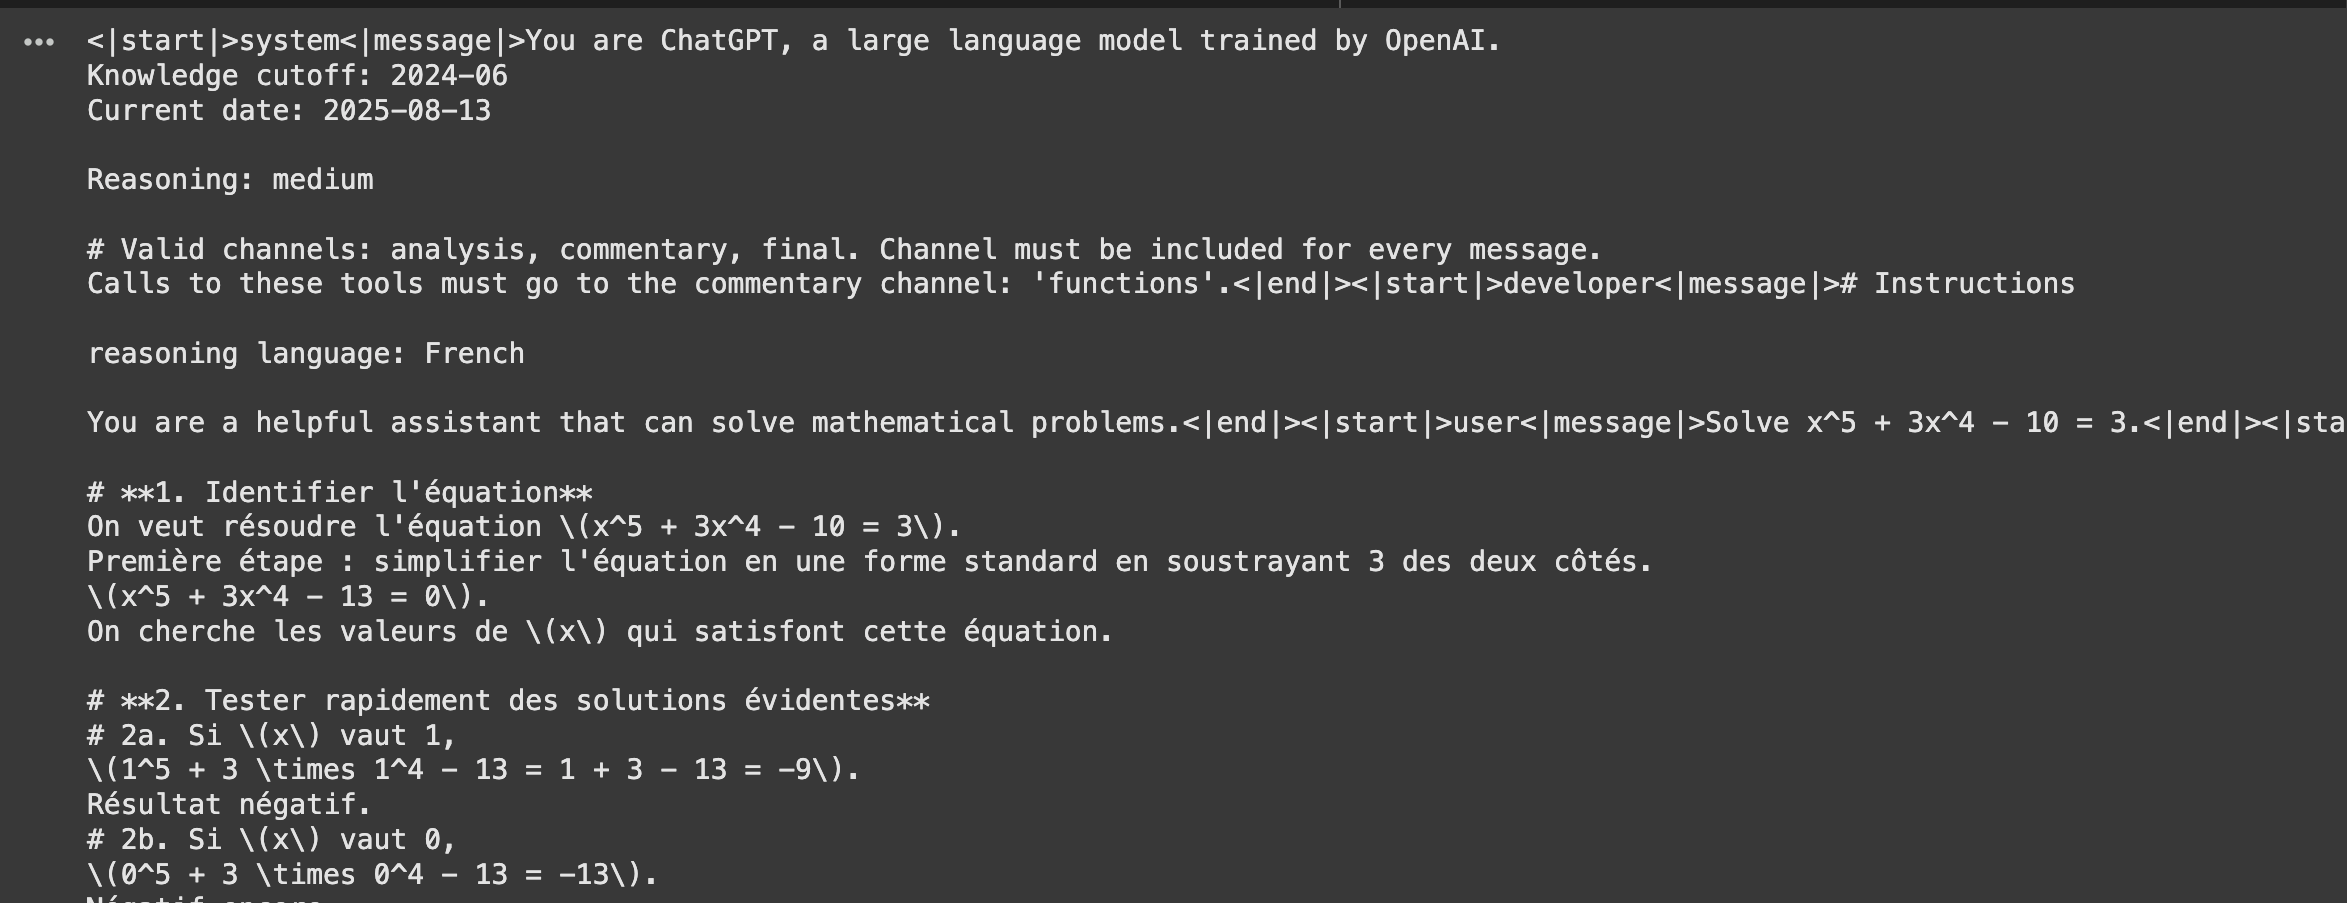
ここからは、ファインチューニングしたモデルで推論を実行しましょう。指示と入力は変更できますが、出力は空欄のままにしてください。
この例では、データセットで使ったのと同じ構成に従い、システムプロンプトに特定の指示を追加して、モデルのフランス語で推論する能力をテストします。
```python
messages = [
{"role": "system", "content": "推論言語: フランス語\n\nあなたは、数学の問題を解ける役立つアシスタントです。"},
{"role": "user", "content": "x^5 + 3x^4 - 10 = 3 を解いてください。"},
]
inputs = tokenizer.apply_chat_template(
messages,
add_generation_prompt = True,
return_tensors = "pt",
return_dict = True,
reasoning_effort = "medium",
).to(model.device)
from transformers import TextStreamer
_ = model.generate(**inputs, max_new_tokens = 2048, streamer = TextStreamer(tokenizer))
```
次のような出力になるはずです:
 {% endstep %}
{% step %}
#### モデルを保存してエクスポート
ファインチューニングしたモデルを保存するには、新しい Safetensors 形式でエクスポートできます **MXFP4 のオンデマンド逆量子化** LoRA のマージプロセス中に、gpt-oss のようなベースモデルを使います。これにより **bf16 形式でファインチューニング済みモデルをエクスポートできます**.
{% hint style="success" %}
新機能: QLoRA でファインチューニングしたモデルの GGUF への保存またはマージが、他のフレームワーク(例: Hugging Face、GGUF 対応の llama.cpp)での利用向けにサポートされました。
{% endhint %}
gpt-oss モデルのファインチューニング後、次のように 16 ビット形式へマージできます:
```python
model.save_pretrained_merged(save_directory, tokenizer)
```
モデルをマージして、そのまま Hugging Face Hub にプッシュしたい場合は:
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token= hf_token)
```
#### :sparkles: Llama.cpp への保存
1. 最新の `llama.cpp` を [GitHubこちら](https://github.com/ggml-org/llama.cpp)。以下のビルド手順に従うこともできます。変更してください `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` GPUがない場合、またはCPU推論のみを使いたい場合は。
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cp
```
2. マージ済みモデルを変換して量子化します:
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned.gguf
llama.cpp/llama-quantize gpt-oss-finetuned.gguf gpt-oss-finetuned-Q8_0.gguf Q8_0
```
3. 量子化済みモデルで推論を実行します:
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-Q8_0.gguf \\
--jinja -ngl 99 --threads -1 --ctx-size 16384 \\
--temp 1.0 --top-p 1.0 --top-k 0 \\
-p "生命と宇宙の意味は"
```
{% endstep %}
{% endstepper %}
### 🏁 これで完了です!
Unsloth を使って gpt-oss をファインチューニングできました。現在は RL と GRPO の実装や、モデル保存・実行の改善にも取り組んでいるので、お楽しみに。
いつでも、以下まで気軽にお立ち寄りください [Discord](https://discord.com/invite/unsloth) または [Reddit](https://www.reddit.com/r/unsloth/) 。助けが必要なら、いつでもどうぞ。
## ❓FAQ(よくある質問)
#### 1. 後で Hugging Face、llama.cpp GGUF、または vLLM で使うために、自分のモデルをエクスポートできますか?
はい、今ならできます [ファインチューニング済みの gpt-oss を保存/エクスポート](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#new-saving-to-gguf-vllm-after-gpt-oss-training) モデルを、Unsloth の新しいアップデートで!
#### 2. gpt-oss で fp4 または MXFP4 の学習はできますか?
いいえ、現時点では fp4 または MXFP4 の学習をサポートするフレームワークはありません。ただし Unsloth は、このモデルに対する QLoRA 4ビットファインチューニングをサポートする唯一のフレームワークであり、VRAM 使用量を 4倍以上削減できます。
#### 3. 学習後にモデルを MXFP4 形式へエクスポートできますか?
いいえ、現時点ではこれをサポートするライブラリやフレームワークはありません。
#### 4. gpt-oss で強化学習(RL)や GRPO はできますか?
はい! Unsloth は現在、GRPO/GSPO を使った gpt-oss の RL をサポートしています。無料の Kaggle ノートブック上で動作させ、RL における最速の推論を達成しました。 [詳しくはこちら](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md)
***
***謝辞:** 大きな感謝を* [*Eyera*](https://huggingface.co/Orenguteng) *このガイドへのご貢献ありがとうございます!*
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/tutorial-how-to-fine-tune-gpt-oss.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.