> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md).
# gpt-oss強化学習
OpenAIを今すぐ学習できるようになりました [gpt-oss](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune.md) RLとGRPOを使って、 [Unsloth](https://github.com/unslothai/unsloth)。Unslothは現在、 **最速の推論** (3倍高速), **最小のVRAM使用量** (50%削減)と **最長コンテキスト** gpt-oss RLでは、どの実装よりも最長のコンテキスト(8倍長い)を、精度低下なしで実現しています。\
\
gpt-oss上の強化学習(RL)はまだvLLMに対応していないため、gpt-oss向けに約21トークン/秒で3倍高速な推論を実現するには、Transformersの推論コードを書き直す必要がありました。BF16では、UnslothはVRAM使用量の面でも最速の推論(約30トークン/秒)を達成しており、特に他のどのRL実装よりもVRAMを50%少なく使います。私たちは、 [50%の重み共有機能](/docs/jp/meru/reinforcement-learning-rl-guide/memory-efficient-rl.md) vLLMがRLに対応したら実装する予定です。
* **無料ノートブック:** [**gpt-oss-20b GRPO Colabノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb)\
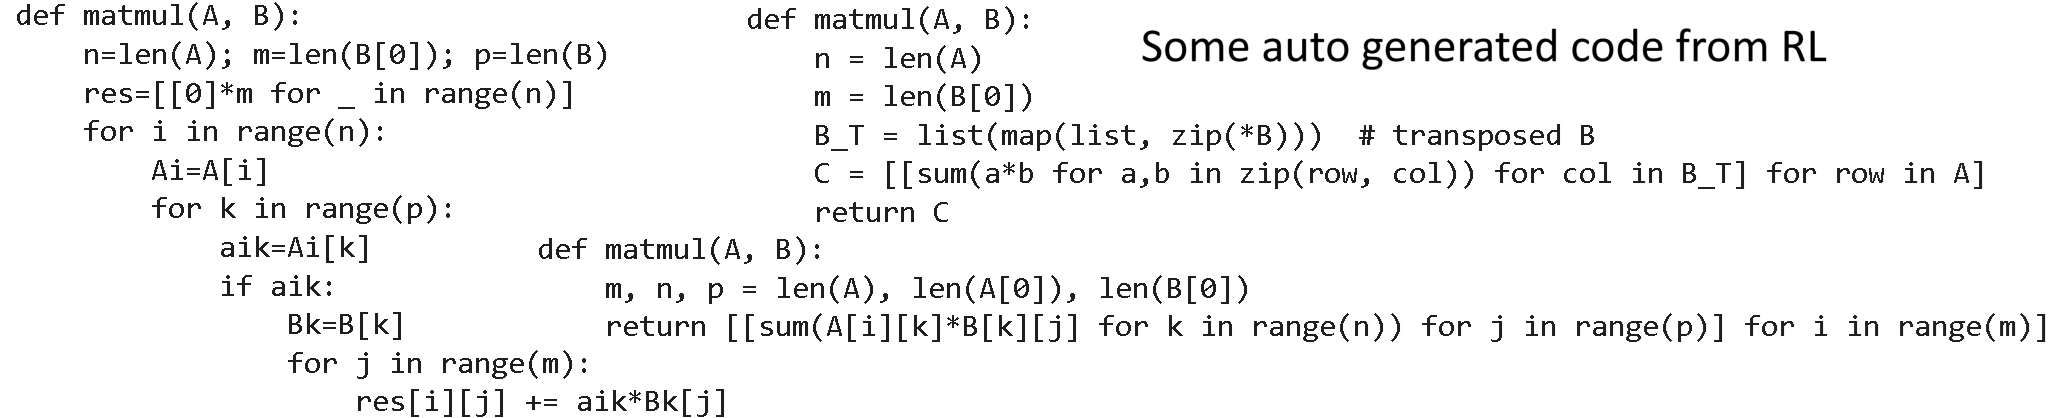
このノートブックは自動的に **より高速な行列積カーネルを生成し** 、4つの新しいUnsloth報酬関数を使用します。また、 [報酬ハッキングを防ぐ](#can-we-counter-reward-hacking) これはRLにおける最大の課題の1つです。\\\\
Unslothを使えば、gpt-oss-20bを15GBのVRAMでGRPO学習でき、さらに **無料の** Colabでも実行できます。私たちはembedding offloadingを導入し、さらに1GB使用量を削減しました。これは `offload_embeddings`。Unlothの新しい推論は、 **any** A100、H100、古いT4を含むGPUでより高速に動作します。gpt-oss-120bは120GB VRAMのGPUに余裕で収まります。
Unslothはgpt-ossの4bit RLをサポートする唯一のフレームワークです。性能向上はすべて、Unsloth独自の [重み共有](/docs/jp/meru/reinforcement-learning-rl-guide.md#what-unsloth-offers-for-rl), [Flex Attention](/docs/jp/meru/reinforcement-learning-rl-guide/memory-efficient-rl.md), [スタンバイ](/docs/jp/meru/reinforcement-learning-rl-guide/memory-efficient-rl.md#unsloth-standby) とカスタムカーネルによるものです。
{% hint style="warning" %}
注意: **Flash Attention 3(FA3)は** [**gpt-ossには不適切です**](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support) **学習の** 。現在、attention sinksのバックワードパスをサポートしていないため、 **誤った学習損失が発生します**。もし **しません** Unslothを使っている場合、FA3は defaultによって有効になっているかもしれないので、使用されていないことを必ず確認してください!\
\
FA3を無効にすると **O(N^2)** のメモリ使用量も発生するため、Unslothは **O(N)** のメモリ使用量をgpt-oss向けに、独自のFlex attention実装で提供する唯一のRLフレームワークです。
{% endhint %}
## ⚡推論を大幅に高速化
推論はRL学習において重要です。というのも、何らかの報酬関数を最大化する前に、候補解を生成する必要があるからです([こちらを参照](/docs/jp/meru/reinforcement-learning-rl-guide.md) 詳しい説明について)。それを実現するために、vLLMなしでgpt-ossの最速推論速度を達成すべく、私たちはTransformersの推論コードを書き直し、Unslothのようなカスタムアルゴリズムを含む多くの革新を統合しました [Flex Attention](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support)。さらに、 `torch.compile` (combo kernelsのような)内部の特別なフラグを使用しています。gpt-oss向けの新しい推論コードは、すでに最適化済みのベースライン(ネイティブなTransformersより2倍高速)と比較評価しました。
vLLMはgpt-oss向けのBF16学習とLoRAサポートがないため、gpt-ossのRLをサポートしていません。Unslothなしでは、フル精度のBF16による学習しか動作せず、 メモリ使用量は **800%以上増加します**。ほとんどのフレームワークはデフォルトでFA3(Flash Attention 3)を有効にします(これによりVRAM使用量が減り、速度が向上します) **が、これにより学習損失が誤ってしまいます**。参照 [Issue 1797](https://github.com/Dao-AILab/flash-attention/issues/1797) FA3リポジトリ内のものです。ただし、FA3はO(N)のメモリ使用量である一方、素朴なattentionはO(N^2)で膨れ上がるため、長文脈学習を妨げないようにFA3は無効化する必要があります。そこで、attention sinksを微分可能にするために、私たちは [Unsloth Flex Attention](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md).
私たちはBitsandBytesの4bitとベンチマークしてgpt-oss RL推論を評価し、BF16についても別途テストを行いました。Unslothの4bit推論は約4倍高速で、BF16も特にVRAM使用量の面でより効率的です。
Unslothのgpt-oss RLの最も優れた点は、BF16をサポートしないGPUでも含め、どんなGPUでも動作することです。無料のgpt-oss-20b Colabノートブックは古い15GBのT4 GPUを使用しているため、推論例もうまく動作します!
## 🛠️ gpt-ossのFlex Attentionの問題点と癖
attention sinks用の実装を変更する必要がありました。 [ここで説明しています](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) 生成を左パディングでも動作させるためです。logsumexpを取得し、sigmoid活性化を適用して、以下のようにattention重みを変更する必要がありました:
$$
A(X) = \sigma \bigg( \frac{1}{\sqrt{d}}QK^T \bigg)V \\
A(X) = \frac{\exp{\frac{1}{\sqrt{d}}QK^T}}{\sum{\exp{\frac{1}{\sqrt{d}}QK^T}}}V \\
\text{LSE} = \log{\sum{\exp{\frac{1}{\sqrt{d}}QK^T}}} \\
A\_{sinks}(X) = A(X) \odot \sigma (\text{LSE} - \text{sinks})
$$
推論時の左パディングのマスキングも、gpt-ossでは対処が難しい問題でした。トークン生成中のKV Cache prefillを考慮するだけでなく、バッチ生成では各プロンプトごとの固有のパディングトークン数も考慮する必要があり、それによってblock maskの保存方法も変わることが分かりました。そのような例は以下に示します:
**通常の因果マスク:**
```
k0 k1 k2 k3 k4 <-- keys
q0 X
q1 X X
q2 X X X
q3 X X X X
q4 X X X X X <-- 最後のクエリ行(デコードで最も重要)
```
**一般的な推論の場合(デコード)**
```
k0 k1 k2 k3 k4
q0
q1
q2
q3
q4 X X X X X
```
**同じマスキング戦略をそのまま使うと、失敗します:**
```
k0 k1 k2 k3 k4
q0
q1
q2
q3
q4 X (q4のq_idxは0です。これは現在の設定で最初のクエリだからです)
```
生成(デコード段階)では、通常attention行列の最後の行だけを気にします。これは、1つのクエリトークンがそれ以前のすべてのキー・トークンに注意を向けるからです。因果マスクをそのまま適用すると(`q_idx ≥ k_idx`)、単一のクエリはインデックス0なのに対し、n\_k個のキー・トークンがあるため失敗します。これを修正するには、どのトークンに注意を向けるかを決めるため、マスク作成にオフセットが必要です。しかし、オフセットは各ステップで変わるため、素朴な方法ではマスクとカーネルの再生成が必要になり遅いです。私たちはこれをキャッシュとコンパイルの最適化で解決しました。
より難しいのはバッチ生成です。シーケンスの長さが異なるため、パディングがマスク作成を複雑にします。Flex Attentionには多くの [課題](https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665) があり、動的マスクは扱いが難しいです。さらに、コンパイルされていない場合はeager attentionにフォールバックし、これは遅くメモリを大量に消費します(シーケンス長に対して二次 vs. 線形)。
> *引用元:* [*https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665*](https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665)
>
> これを\_compile=Trueで呼び出す必要があります。block maskを生成するために、基本的には完全なQ\_LEN x KV\_LEN行列にblock maskをマッピングします。コンパイルなしでは、この全体を実体化する必要があり、長いシーケンスではOOMの原因になります。
>
> また、 `flex_attention = torch.compile(flex_attention)`を実行する必要があります。コンパイルなしでは、flexは非融合のeager実装にフォールバックし、デバッグには便利ですが、はるかに遅く、スコア行列全体を実体化します。
最終的に、マスクはKV Cacheを使ったprefillとdecodeを動的に処理し、シーケンスごとのバッチとパディングトークンに対応し、 `torch.compile` 使いやすく、スライディングウィンドウをサポートする必要があります。
### 🔍 Flash Attentionの調査
私たちが検討したもう1つの興味深い方向性は、Flash Attentionの統合でした。その利点は広く知られていますが、1つの制約として、gpt-ossのバックワードパス中のattention sinksをサポートしていません。これを回避するため、FlashAttentionが容易に提供するattention出力とlogsumexp値だけで動作するようにattention機構を再構成しました。これらの利点を考えると、試してみるのは当然の選択に思えました。
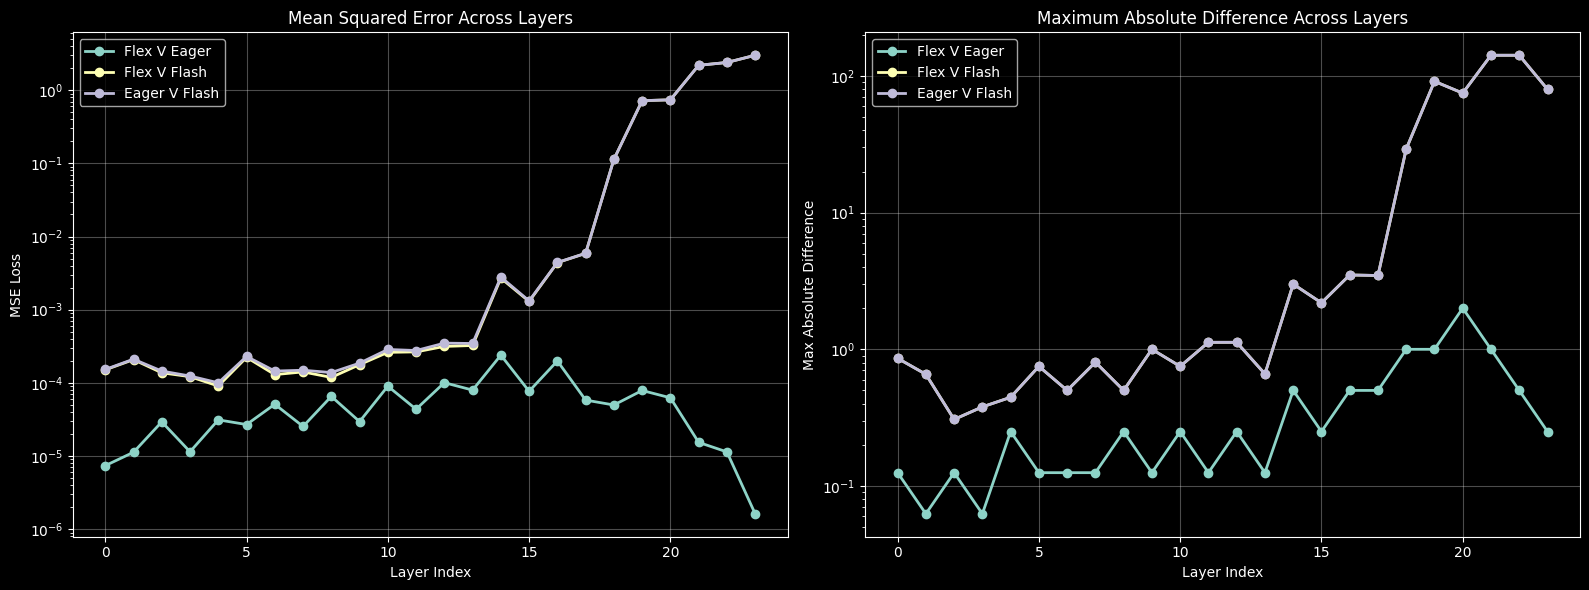
しかし、すぐに問題が見え始めました。最初の数層は期待通りでしたが、後半の層、特に18層から24層では、transformersのeagerモード実装と大きく異なる出力が生成されました。重要なのは、この差異は誤差の蓄積によるものではないということです。各層で両手法への入力は毎回同一だからです。さらなる検証のため、結果をUnslothとも比較しました **FlexAttention**.
なぜ最後の数層だけが、Flash Attention実装と他の実装との間でこれほど大きな差を示すのか、さらなる調査が必要です。
{% hint style="danger" %}
**Flash Attention 3はattention sinksのバックワードパスをサポートしていません**
FA3は多くの学習パッケージ(Unsloth以外)でデフォルトで有効になっていることが多いですが、gpt-ossではこれは誤りです。FA3はgpt-ossのattention sinksに対するバックワードパスをサポートしていないため、FA3を使うと学習損失が完全に誤ったものになります。まだこれを知らない人が多いので、ご注意ください!
{% endhint %}
## ⚠️ 報酬ハッキングに対抗できるのか?
RLの最終目標は、何らかの報酬(たとえば速度、収益、何らかの指標)を最大化することです。しかしRLは **ごまかすことができます。** RLアルゴリズムが、最後に実際のタスクを行わずに報酬を増やすために何らかの手口や抜け穴を学習した場合、これは「**報酬ハッキング**".
そのため、モデルはコーディング課題に合格するために単体テストを改変するよう学習してしまい、これは実運用への重大な障害になります。ほかの良い例としては、 [Wikipedia](https://en.wikipedia.org/wiki/Reward_hacking).
私たちの [無料の gpt-oss RLノートブック](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) コード生成の環境で報酬ハッキングにどう対抗するかを探り、よくあるエラーのパターンに対する具体的な解決策を示します。モデルが計測用の関数を書き換えたり、他のライブラリに処理を委ねたり、結果をキャッシュしたり、あからさまにごまかしたりする様子を見ました。対策後の結果として、私たちのモデルは巧妙なごまかしではなく、本当に最適化された行列積カーネルを生成します。
## :trophy:報酬ハッキング
RL中の報酬ハッキングの一般的な例には次のようなものがあります:
#### 怠惰
RLはNumpy、Torchなどのライブラリを使うことを学習し、それらが最適化されたCUDAカーネルを呼び出します。生成されたコードが他の標準外Pythonライブラリをimportしているかを確認することで、RLアルゴリズムが最適化済みコードを呼び出すのを止められます。
#### キャッシュと不正
RLは出力結果をキャッシュすることを学習し、さらにPythonのグローバル変数を調べて実際の出力を見つけることも学習します。
大きな偽の行列でキャッシュを消去することで、RLアルゴリズムがキャッシュされたデータを使うのを止められます。また、複数回のループと試行で慎重にベンチマークする必要もあります。
#### 不正
RLは、経過時間を0と出力するように計測関数を編集することを学習します。RLアルゴリズムがグローバル変数やキャッシュ済み変数を使うのを、次のように制限することで止められます: `ローカル変数` そして `グローバル変数`。また、次を使います `exec` 関数を作成するため、出力を空のdictに保存する必要があります。また、次を通じたグローバル変数へのアクセスも禁止します: `types.FunctionType(f.__code__, {})`\\\\
## チュートリアル:RLでgpt-ossを学習する方法
LLMは複雑な環境を伴うタスクで苦戦することがよくあります。しかし、 [強化学習](/docs/jp/meru/reinforcement-learning-rl-guide.md) (RL)を適用し、カスタムの [報酬関数](/docs/jp/meru/reinforcement-learning-rl-guide.md#reward-functions-verifiers)を設計すれば、これらの課題は克服できます。
RLは自動カーネル生成や戦略作成などのタスクに適応できます。このチュートリアルでは、 **gpt-oss** を [**GRPO**](/docs/jp/meru/reinforcement-learning-rl-guide.md#from-rlhf-ppo-to-grpo-and-rlvr) とUnslothを使って2048を自律的に打ち負かす方法を示します。
私たちのノートブックには、プロセス全体を進めるための手順がすでに含まれています。
| [2048ノートブック](https://colab.research.google.com/github/openai/gpt-oss/blob/main/examples/reinforcement-fine-tuning.ipynb) (OpenAI公式の例) | [カーネル生成ノートブック](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) |
| ------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------- |
**作成するもの:**
* モデルが2048で自動的に勝てるようにgpt-oss-20bを学習する
* モデルが操作できる最小限の2048環境を作成する
* 定義する **報酬関数** :
1. 生成された戦略がコンパイルされ実行できることを確認し、
2. 報酬ハッキングを防ぎ(外部インポートを禁止し)、
3. 実際のゲームの成功に報酬を与える
* 推論を実行し、モデルをエクスポートする(MXFP4 4ビットまたはマージ済みFP16)
{% hint style="info" %}
**ハードウェア:** 2048の例は無料のColab T4で動きますが、学習は遅くなります。A100/H100ならはるかに高速です。4ビット読み込み+LoRAを使えば、20Bモデルを控えめなVRAMに収められます
{% endhint %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.