> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md).
# 長文コンテキストのgpt-oss学習
OpenAI gpt-oss の学習向けに、Unsloth Flex Attention サポートを導入できることをうれしく思います。これにより **>8×長いコンテキスト長**, **>50%少ないVRAM使用量** そして **>1.5倍高速な学習(精度低下なし)** Flash Attention 3(FA3)を使用するものを含むすべての実装と比べて。Unsloth Flex Attention により、以下を使った学習が可能になります: **60K のコンテキスト長** 80GB VRAM の H100 GPU 上で BF16 LoRA により。さらに:
* 次のことができます: [今すぐエクスポート/保存](#new-saving-to-gguf-vllm-after-gpt-oss-training) QLoRA でファインチューニングした gpt-oss モデルを llama.cpp、vLLM、Ollama、または HF に
* 私たちは [**gpt-oss の学習を修正**](#bug-fixes-for-gpt-oss) **損失が無限大へ発散すること** float16 GPU(T4 Colab など)上で
* 私たちは [gpt-oss 実装を修正](#bug-fixes-for-gpt-oss) Unsloth とは無関係な問題、とりわけ以下を確実にすること `swiglu_limit = 7.0` が transformers での MXFP4 推論中に正しく適用されること
## 🦥Unsloth Flex Attention サポートの導入
Unsloth の Flex Attention サポートにより、80GB VRAM の H100 1台で QLoRA なら最大 81K のコンテキスト長、BF16 LoRA なら 60K のコンテキスト長まで対応できます!これらの改善は **両方の** gpt-oss-20b と **gpt-oss-120b**!使用するコンテキスト長が長いほど、Unsloth Flex Attention から得られる効果は大きくなります:
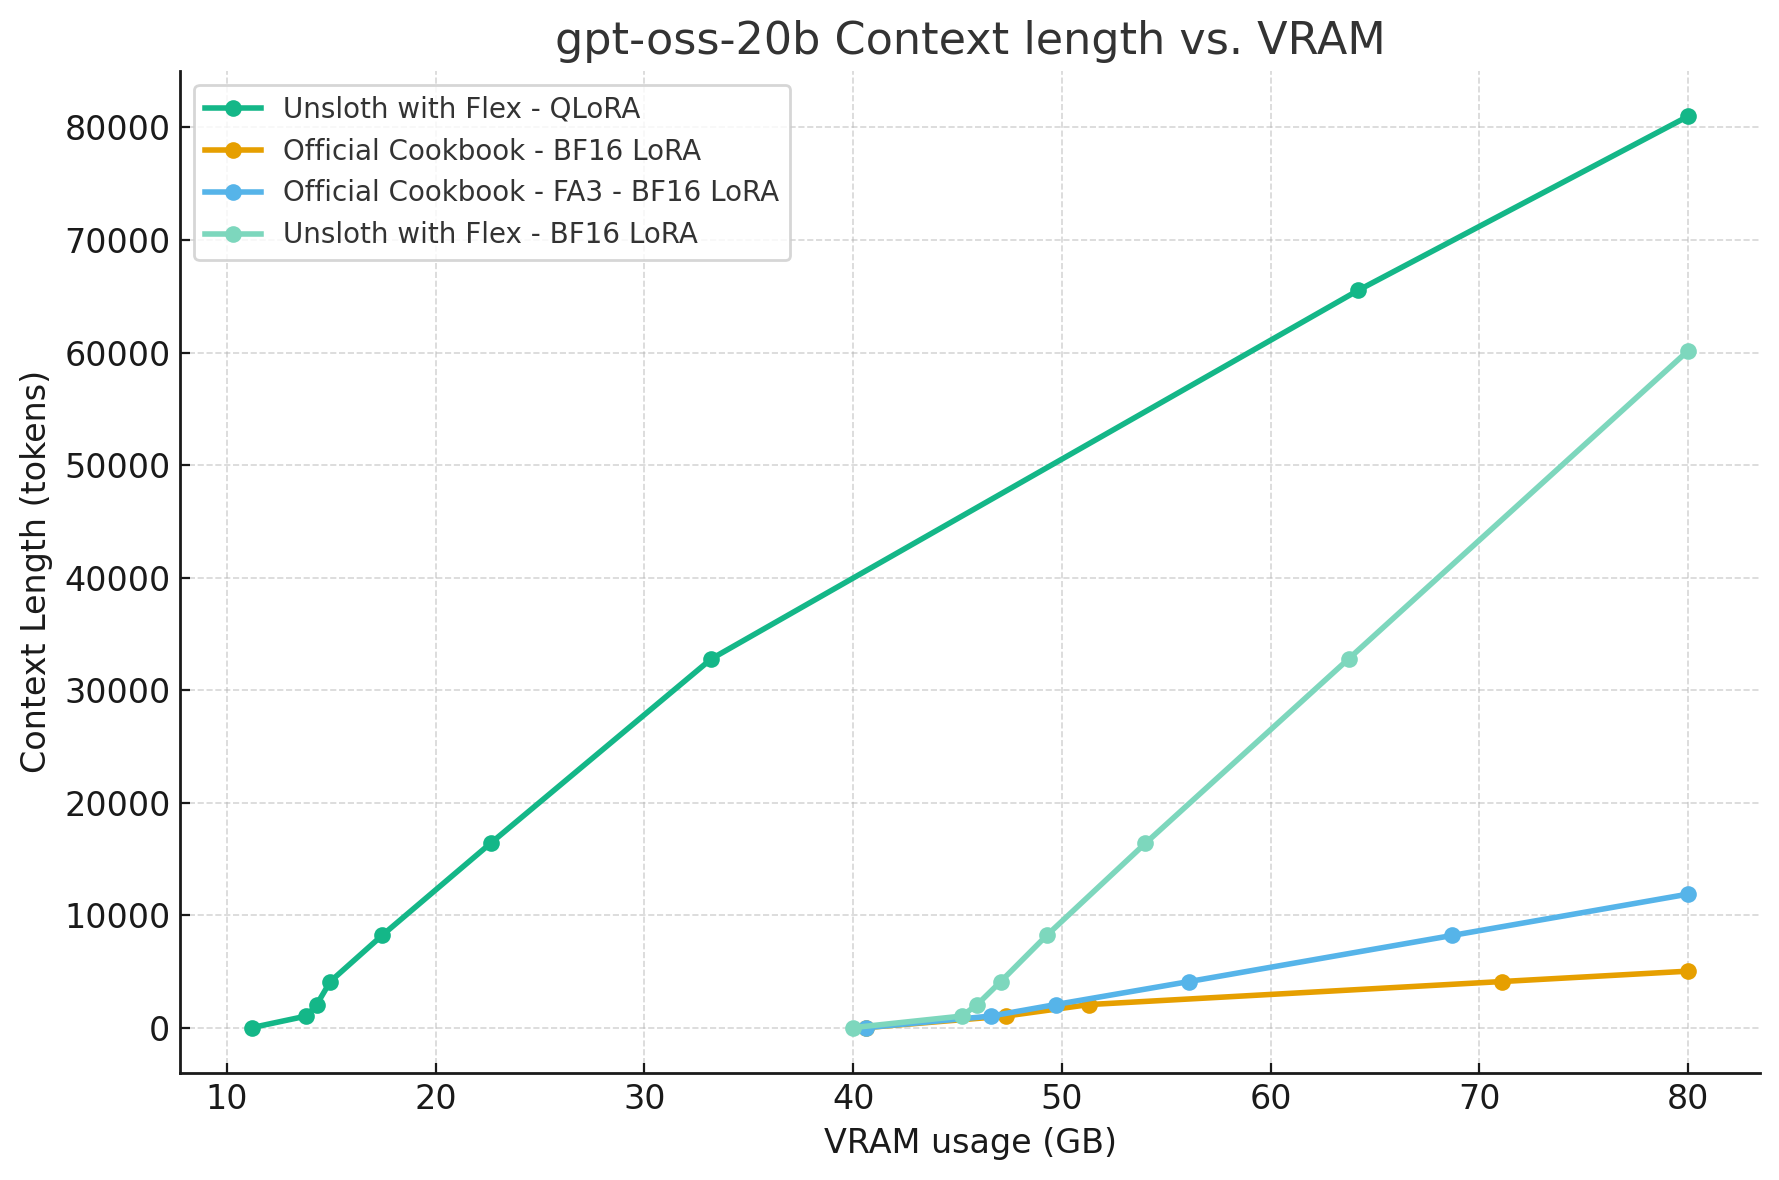 比較すると、Unsloth 以外の実装はすべて 80GB GPU でのコンテキスト長が最大 9K で、FA3 を使っても 15K までしか到達できません。しかし、 **FA3 はアテンションシンクの backward pass をサポートしていないため、gpt-oss の学習には適していません**。そのため、以前 gpt-oss の学習で FA3 を使っていた場合は、以下をおすすめします **使わない** 今のところです。したがって、80GB VRAM で Unsloth なしで得られる最大コンテキスト長は約 9K です。
Unsloth Flex Attention を使った学習では少なくとも 1.3倍の高速化が得られ、コンテキスト長が長くなるほど効果は大きくなり、最大で 2倍高速になります。Flex Attention はコンテキストに応じてスケールするため、長いシーケンスほど VRAM と学習時間の両方でより大きな削減が得られます。 [ここで説明しています](#unsloths-flex-attention-implementation).
Rohan Pandey 氏の [Flex Attention 実装](https://x.com/khoomeik/status/1955693558914310608)に心から感謝します。これが Unsloth の Flex Attention 実装の開発に直接インスピレーションを与えました。
## :dark\_sunglasses: アテンションシンク
OpenAI の GPT OSS モデルは **スライディングウィンドウアテンションとフルアテンションの交互パターンを使用しています**、スライディングウィンドウアテンション、という具合です(SWA、FA、SWA、FA など)。各スライディングウィンドウが注目するのは **128 トークン** (現在のトークンを含む)ため、計算量は大幅に削減されます。ただし、スライディングウィンドウが小さいため、長文脈の検索や推論は実質的に使いものになりません。多くの研究機関はこれをスライディングウィンドウを 2048 または 4096 トークンに拡大することで解決しています。
OpenAI が活用したのは **アテンションシンク** Efficient Streaming Language Models with Attention Sinks [という論文の](https://arxiv.org/abs/2309.17453) です。この論文は、小さなスライディングウィンドウを使ってもよいが、最初のトークンにグローバルアテンションを追加しなければならないことを示しています! 論文では下にわかりやすい図が示されています:
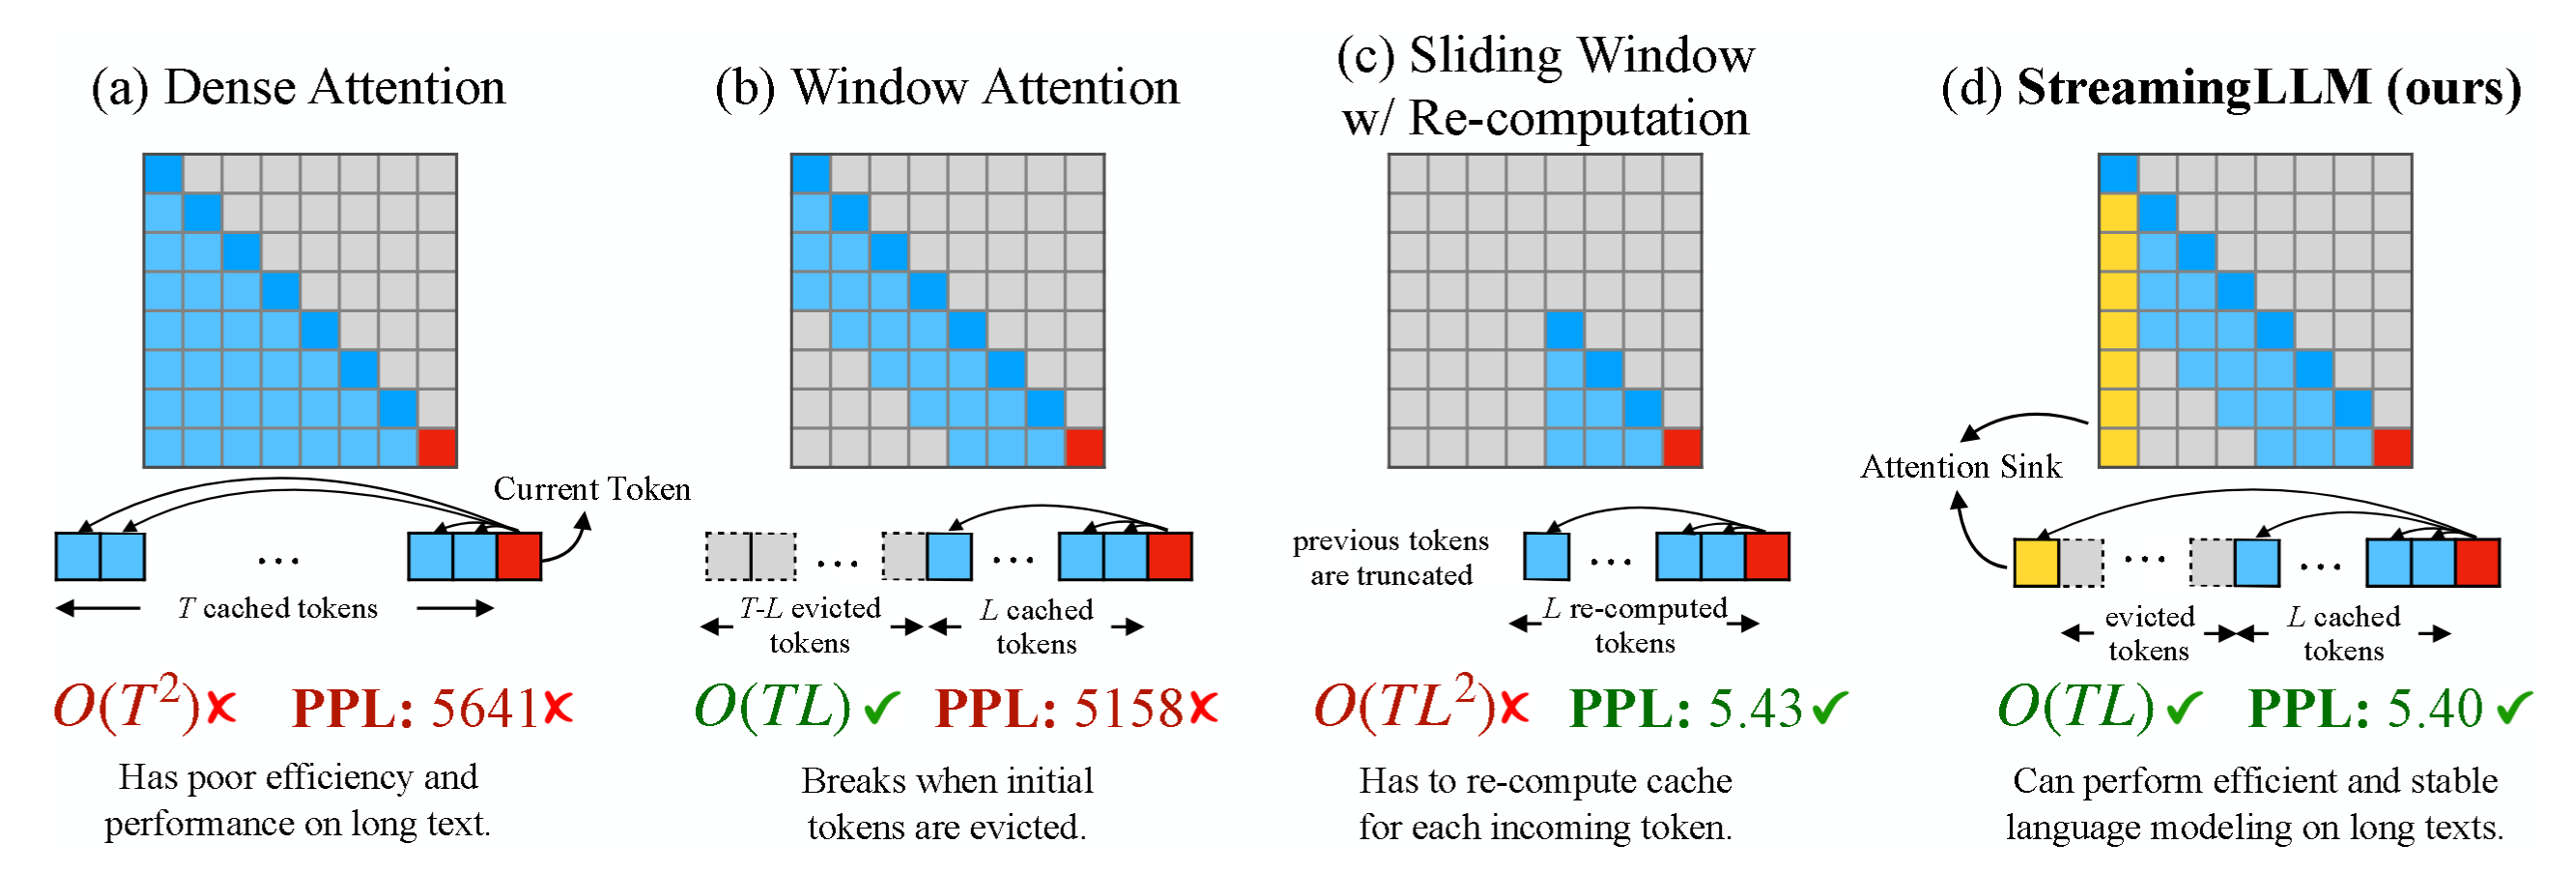 論文は、 **アテンション機構が最初の数トークン(1〜4)にかなり大きな重みを割り当てているようだ**と示しています。これらをスライディングウィンドウ処理中に取り除くと、こうした「重要な」最初の数トークンが消えてしまい、長文脈の検索性能が悪化します。
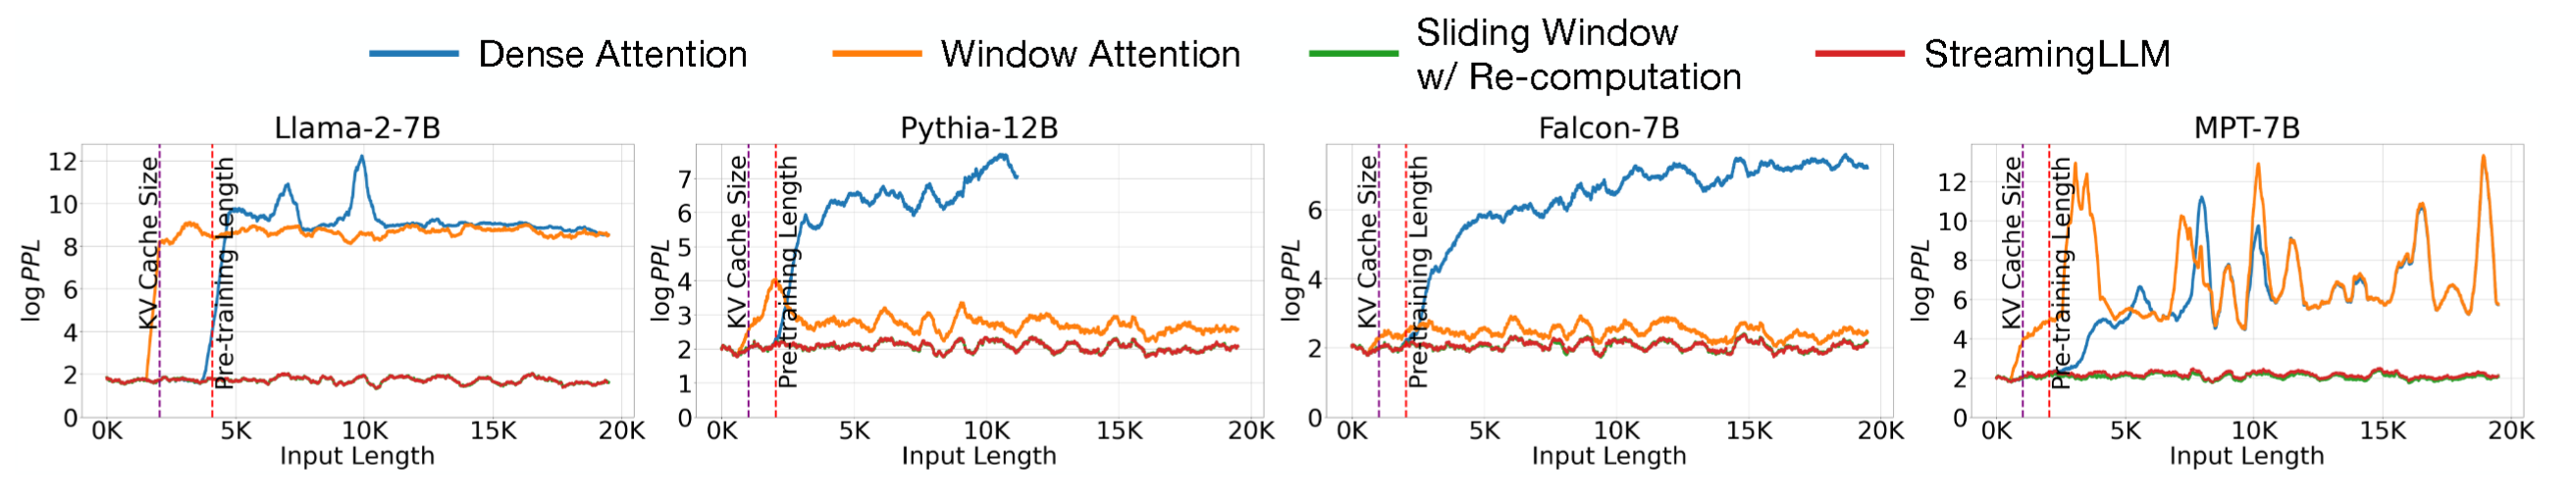
対数パープレキシティ(高いほど悪い)をプロットし、事前学習済みモデルの設定コンテキスト長を超えて長文脈推論を行うと、パープレキシティが急上昇するのがわかります(よくありません)。しかし、赤線(Attention Sinks を使用)は低いままで、これは非常に良いことです!
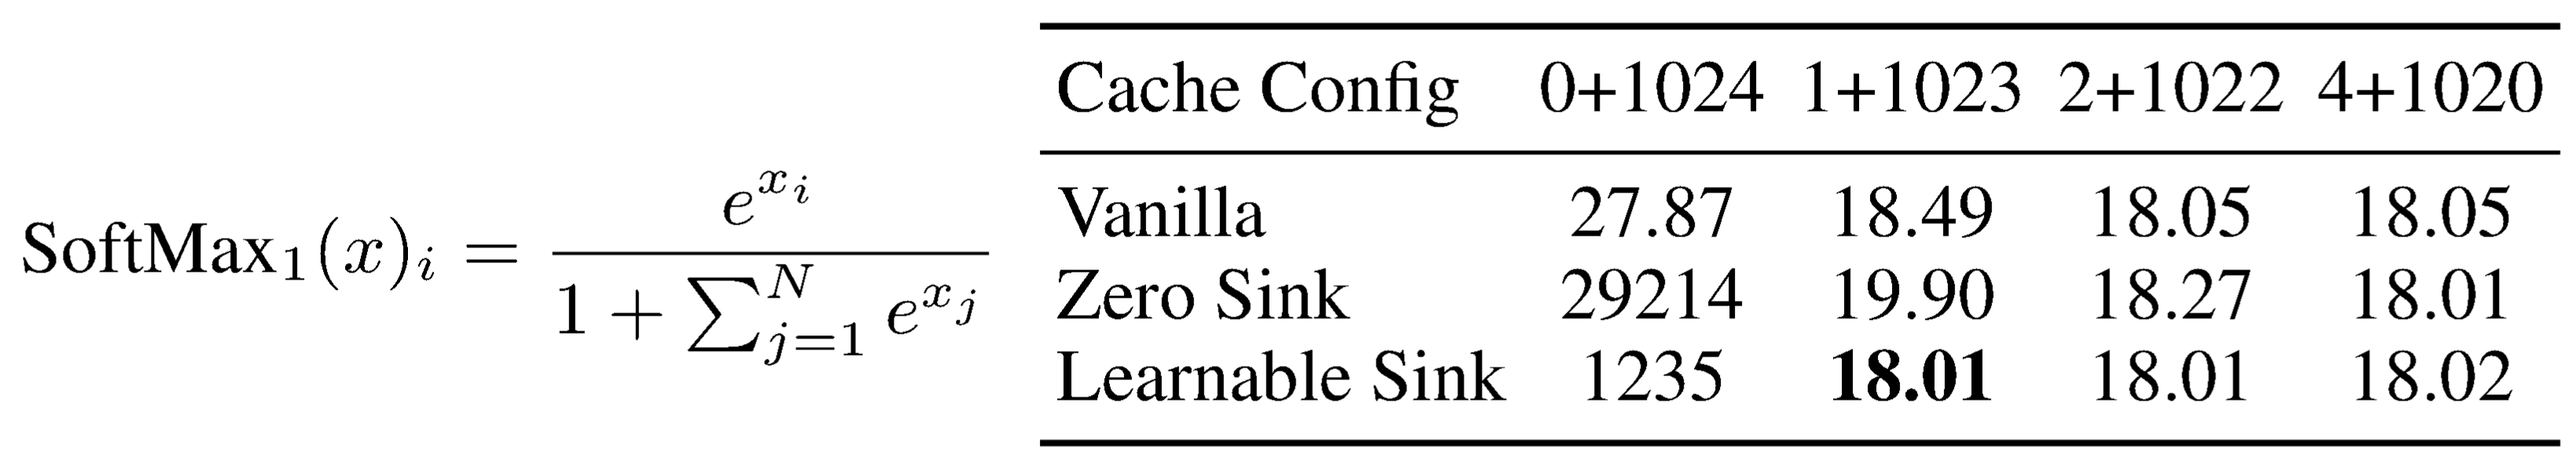
 この論文ではまた、 [Attention Is Off By One 手法](https://www.evanmiller.org/attention-is-off-by-one.html) が部分的には機能するものの、より低いパープレキシティを得るには追加のシンクトークンをいくつか加える必要があることも示しています。 **学習可能なシンクトークンを 1 つ追加するだけで、驚くほどうまくいくことが論文で示されています! そしてそれが、OpenAI が GPT-OSS で行ったことです!**
 ## :triangular\_ruler:Unsloth の Flex Attention 実装
Flex Attention は、アテンション機構に対して実務者に 2 つのカスタマイズ経路を提供するため、非常に強力です。つまり **1つは** と **スコア修飾子(f)**.
その **1つは** は softmax 演算の前にアテンションロジットを編集でき、 **スコア修飾子(f)** は必要ない操作をスキップできます(たとえば、スライディングウィンドウアテンションは最後の 128 トークンしか見ません)。
**ポイントは、Flex Attention が任意のスコア修飾子とマスキング関数を備えた高速な自動生成 Triton カーネルを提供することです!**
\sigma\bigg(s\times\bold{f}(QK^T+\bold{M})\bigg)
つまり、Flex Attention を使ってアテンションシンクを実装できるということです! 単一のアテンションシンクの実装は、 [OpenAI の元の GPT-OSS リポジトリ](#implementations-for-sink-attention) と HuggingFace の transformers 実装の両方にあります。
```python
combined_logits = torch.cat([attn_weights, sinks], dim=-1)
probs = F.softmax(combined_logits, dim=-1)
scores = probs[..., :-1]
```
上記は、シンクを `Q @ K.T` の最後に連結し、softmax を取り、シンクトークンだった最後の列を取り除いていることを示しています。
以下の可視化ユーティリティを使うと [Flex Attention の GitHub リポジトリ](https://github.com/meta-pytorch/attention-gym)、これを可視化できます。シーケンス長が 16、スライディングウィンドウが 5 だと仮定します。左は最後のシンク列(デフォルト実装)、右はシンク位置を index 0 に移動した場合(私たちの実装)です。
{% columns %}
{% column %}
***シンク位置が末尾(デフォルト)***
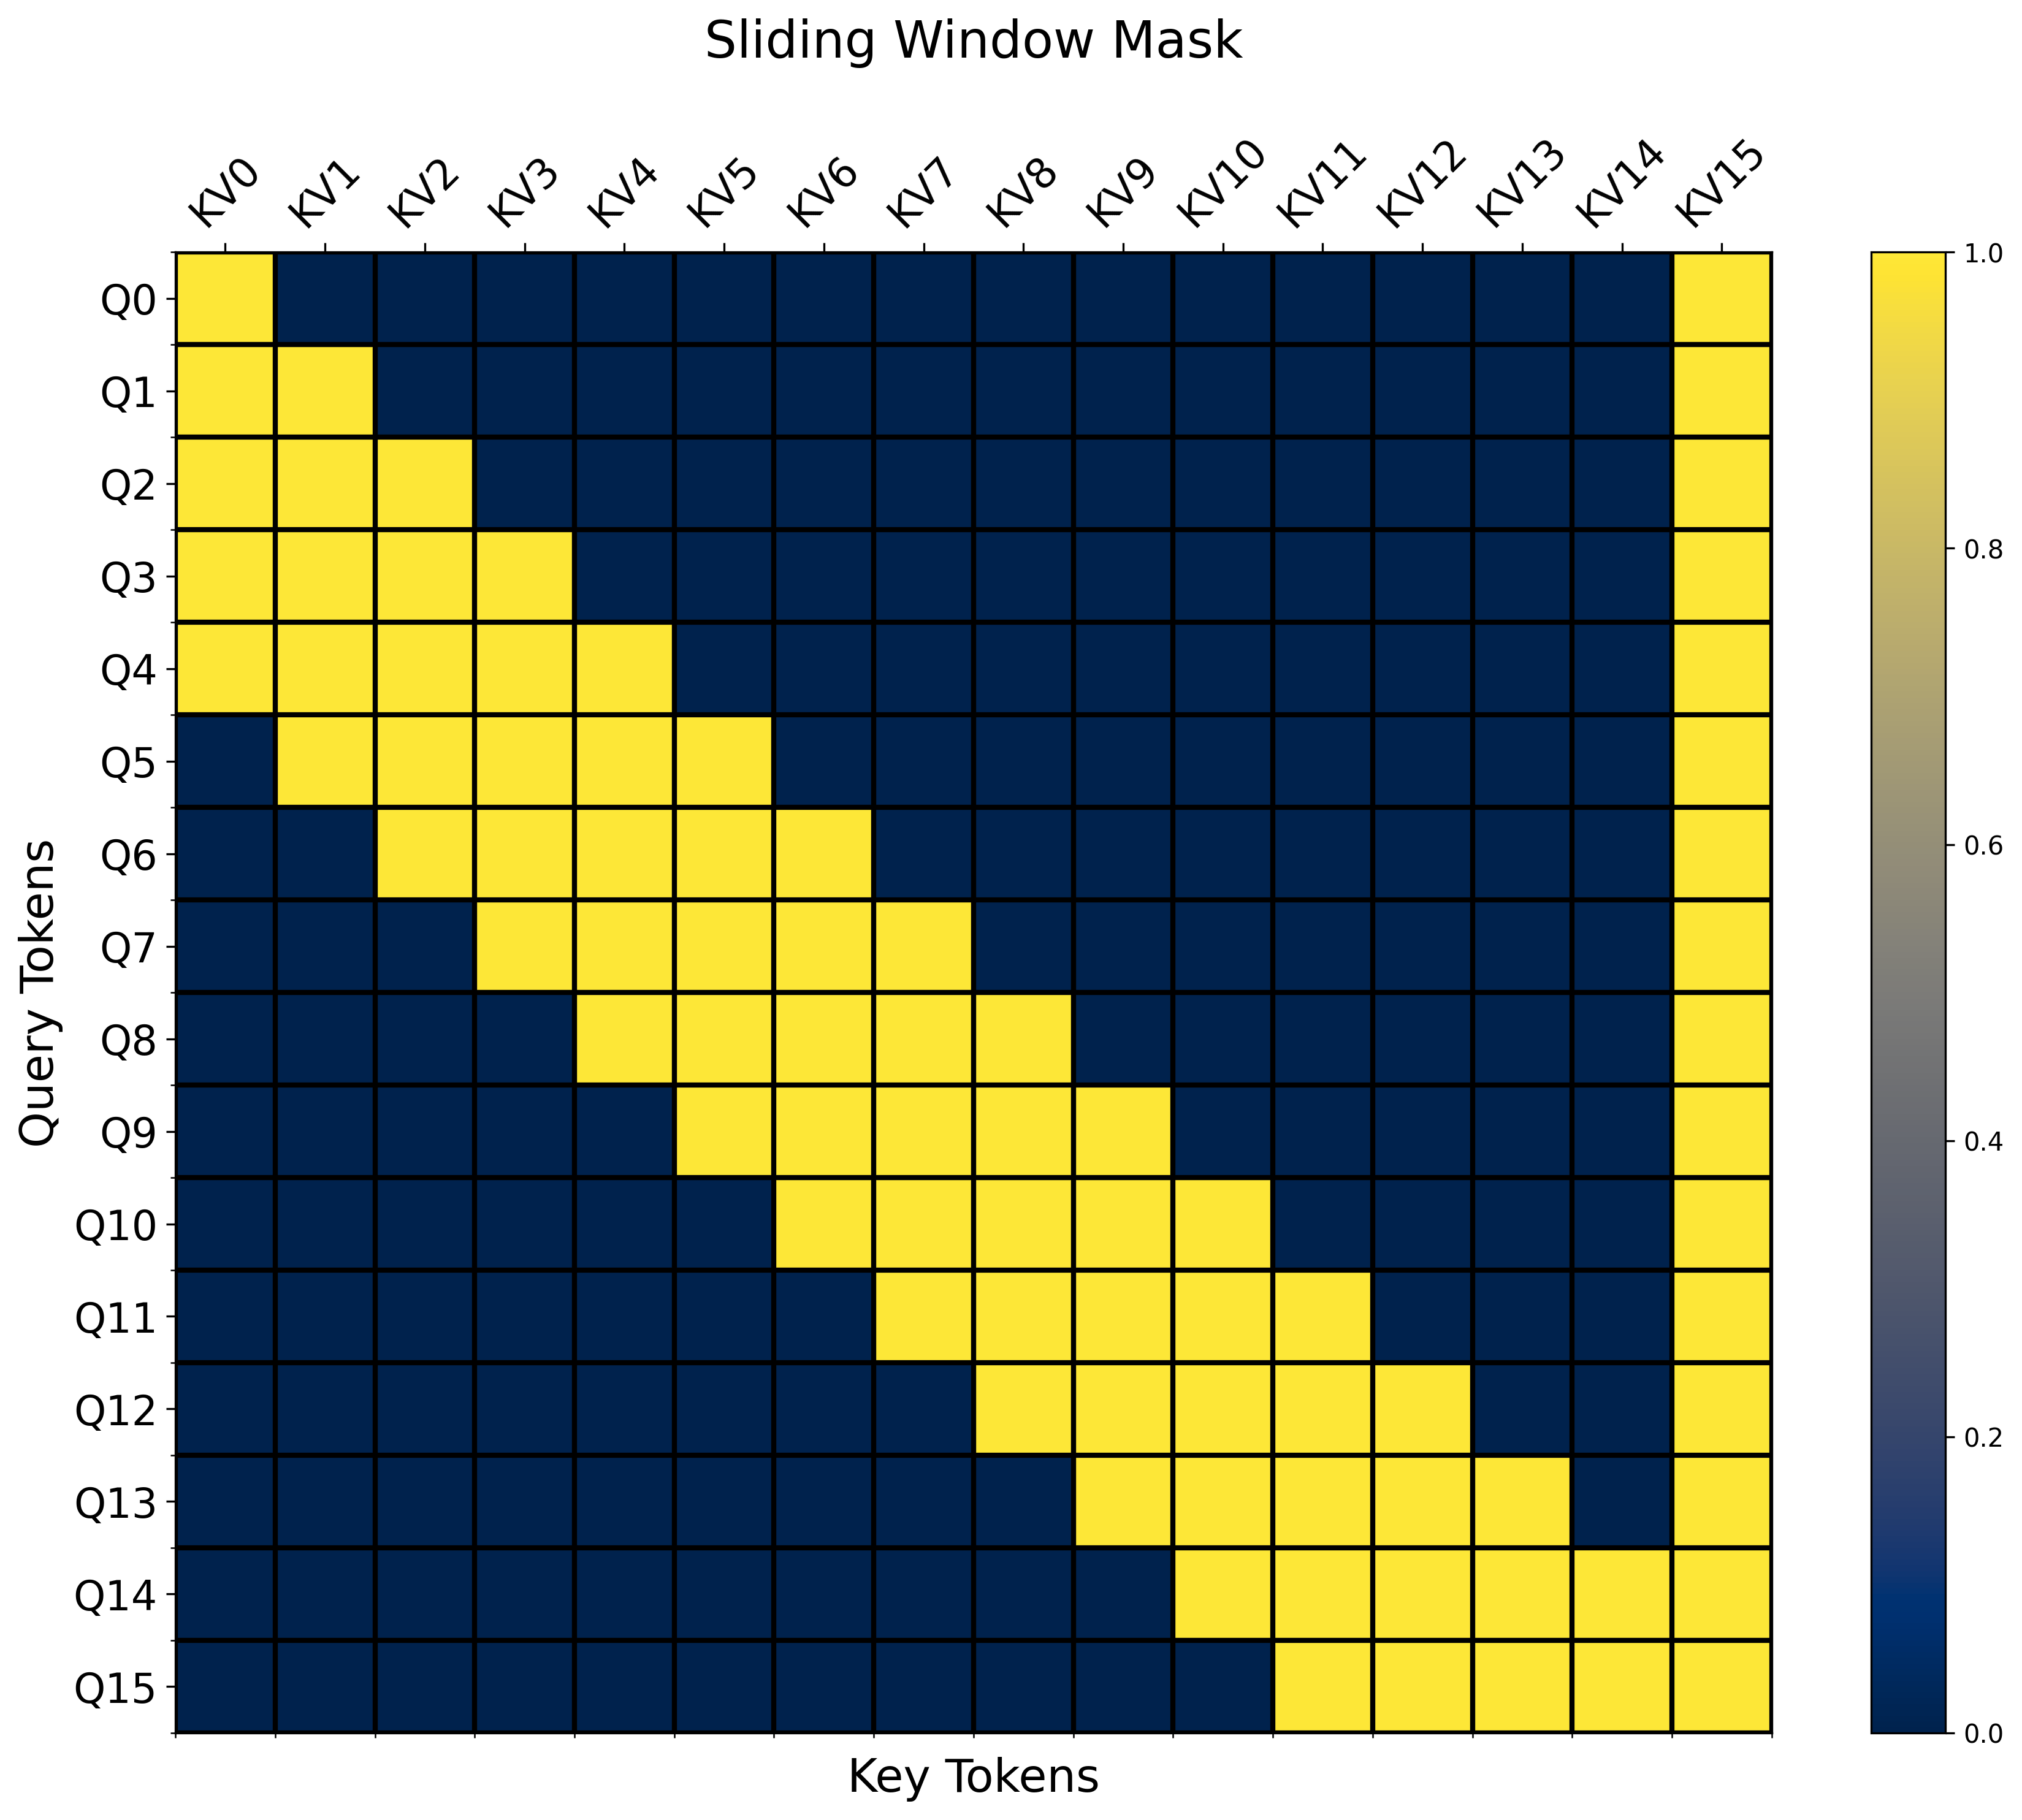 {% endcolumn %}
{% column %}
***シンク位置を index 0 に移動***
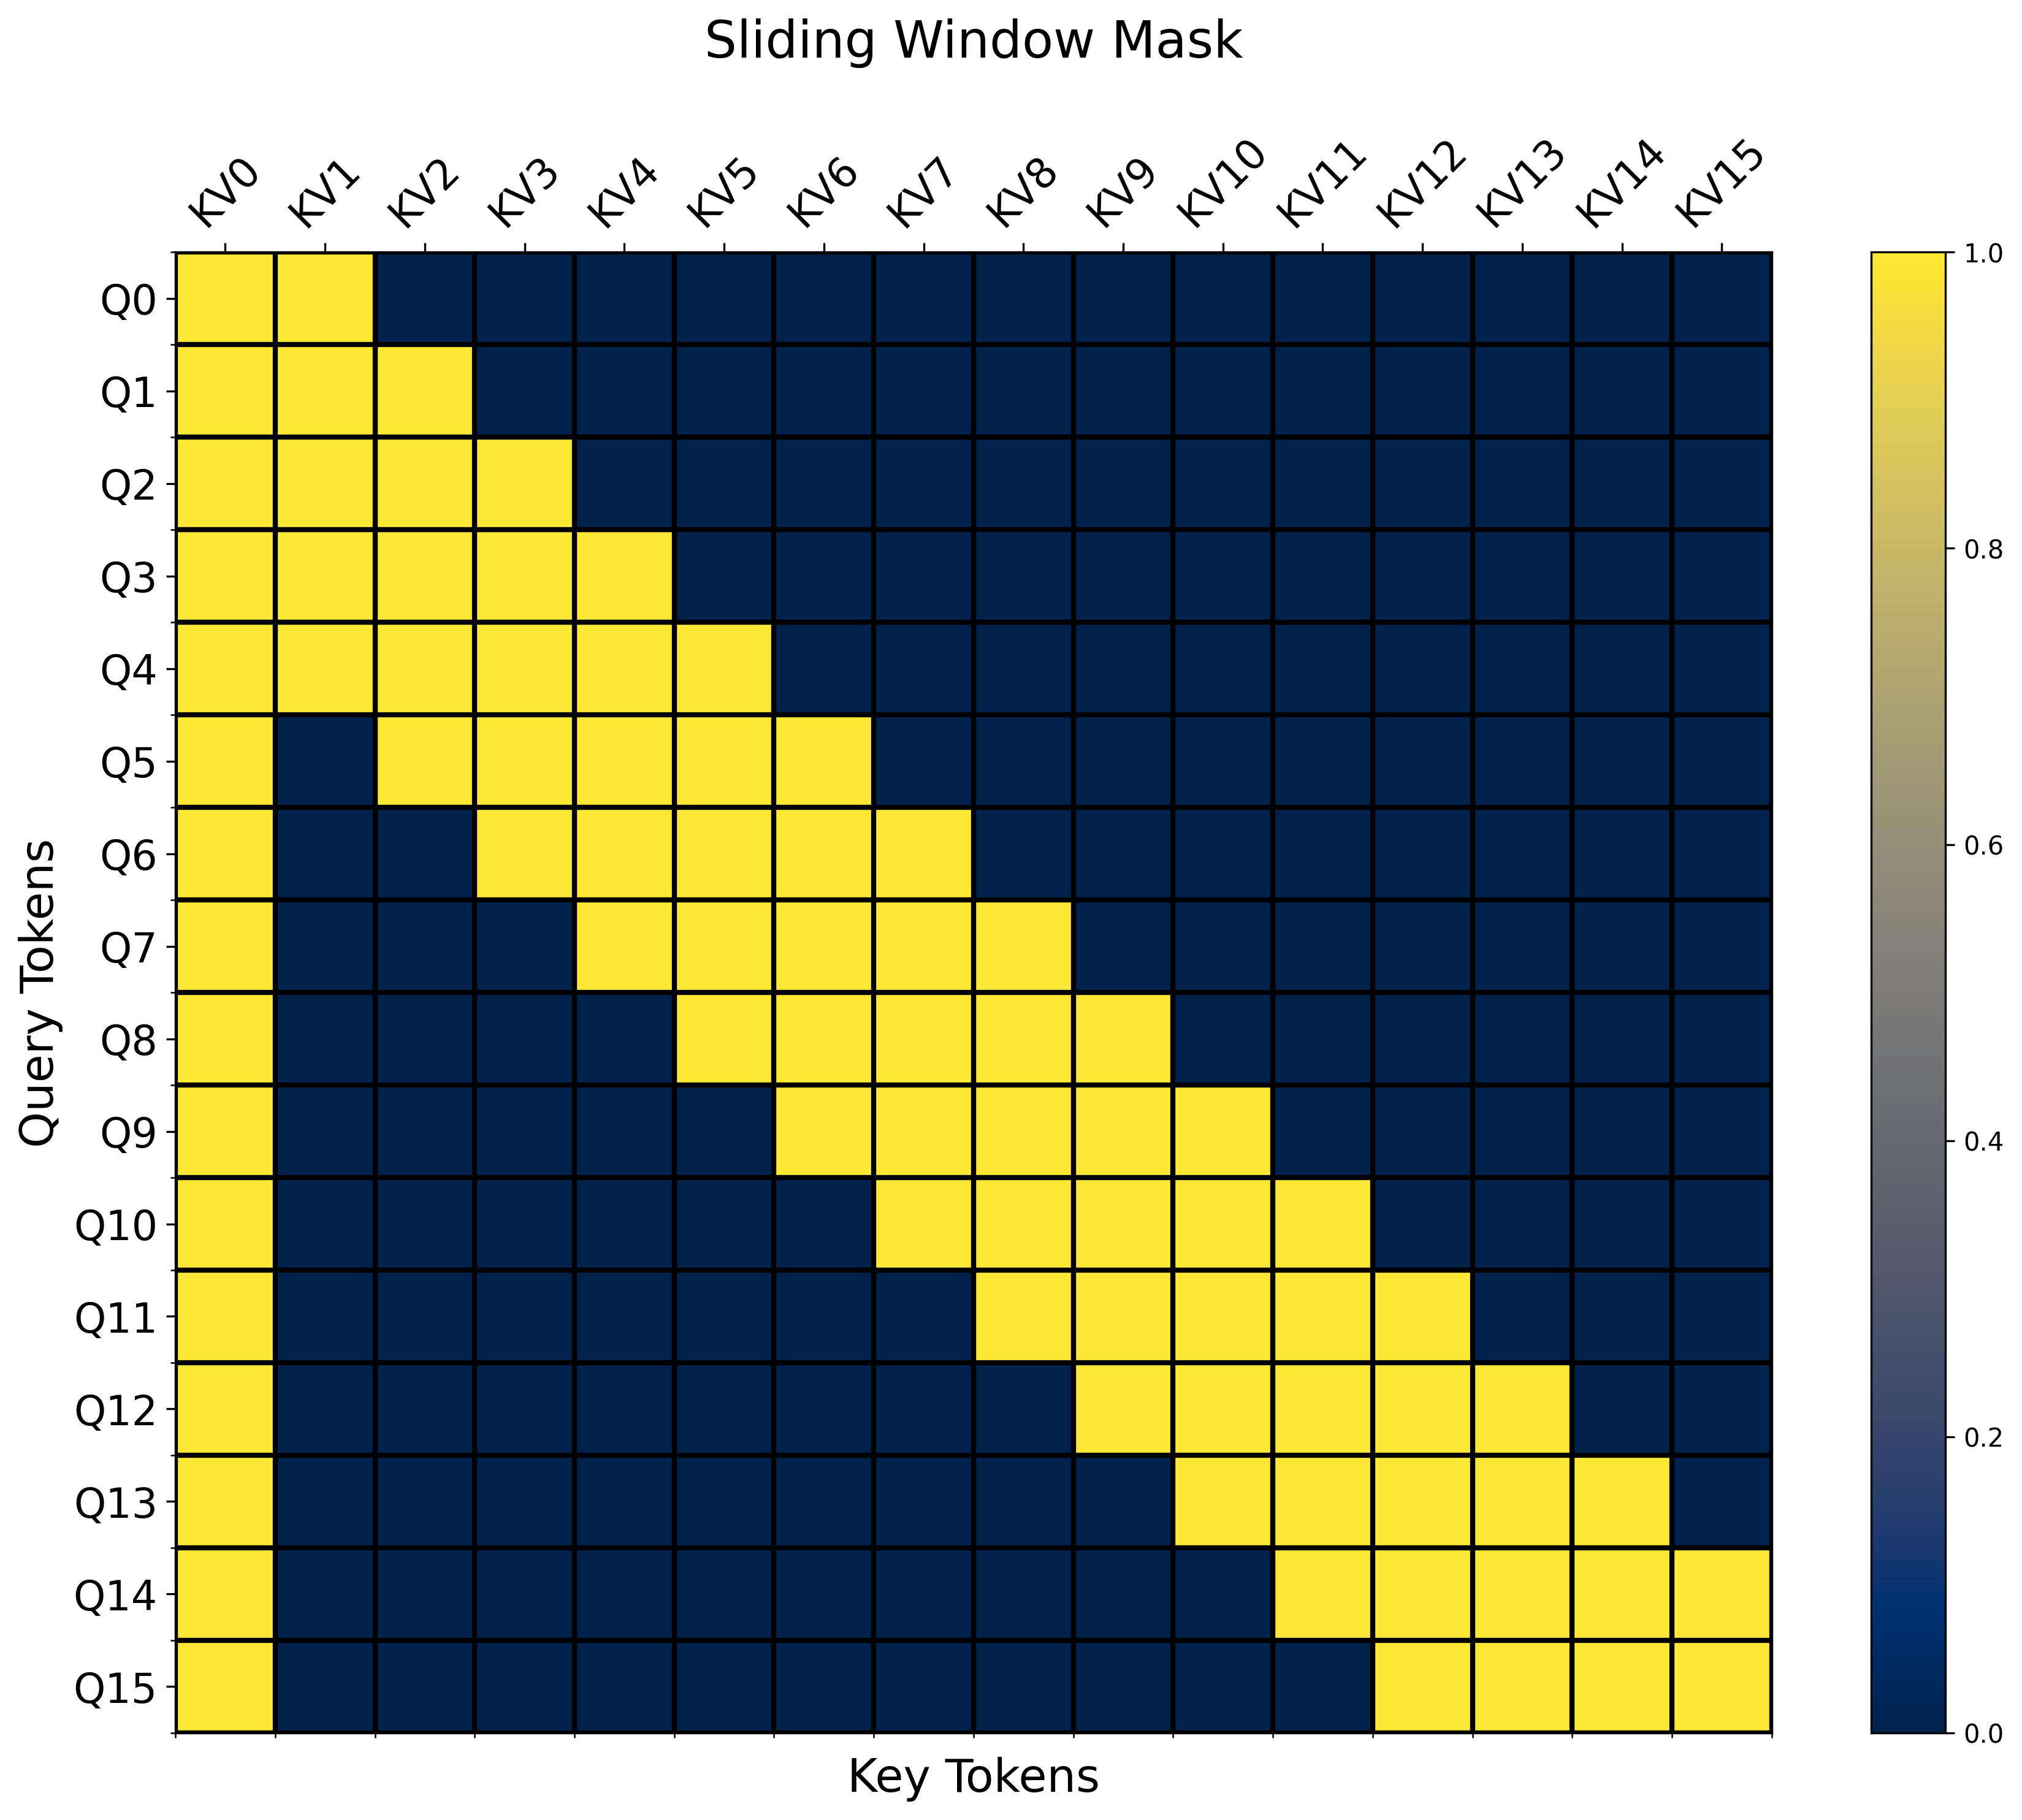 {% endcolumn %}
{% endcolumns %}
**興味深い発見**:公式の Flex Attention スライディングウィンドウ実装では、ウィンドウサイズを最後のトークン数として扱います **+1** 。これは現在のトークンを含むためです。HuggingFace と GPT OSS の実装は厳密には最後の N 個のトークンだけを見ます。つまり、以下は そして :
{% code overflow="wrap" %}
```python
def sliding_window_causal(b, h, q_idx, kv_idx):
causal_mask = q_idx >= kv_idx
window_mask = q_idx - kv_idx <= SLIDING_WINDOW
return causal_mask & window_mask
```
{% endcode %}
{% columns %}
{% column %}
デフォルトの Flex Attention(3+1 トークン)
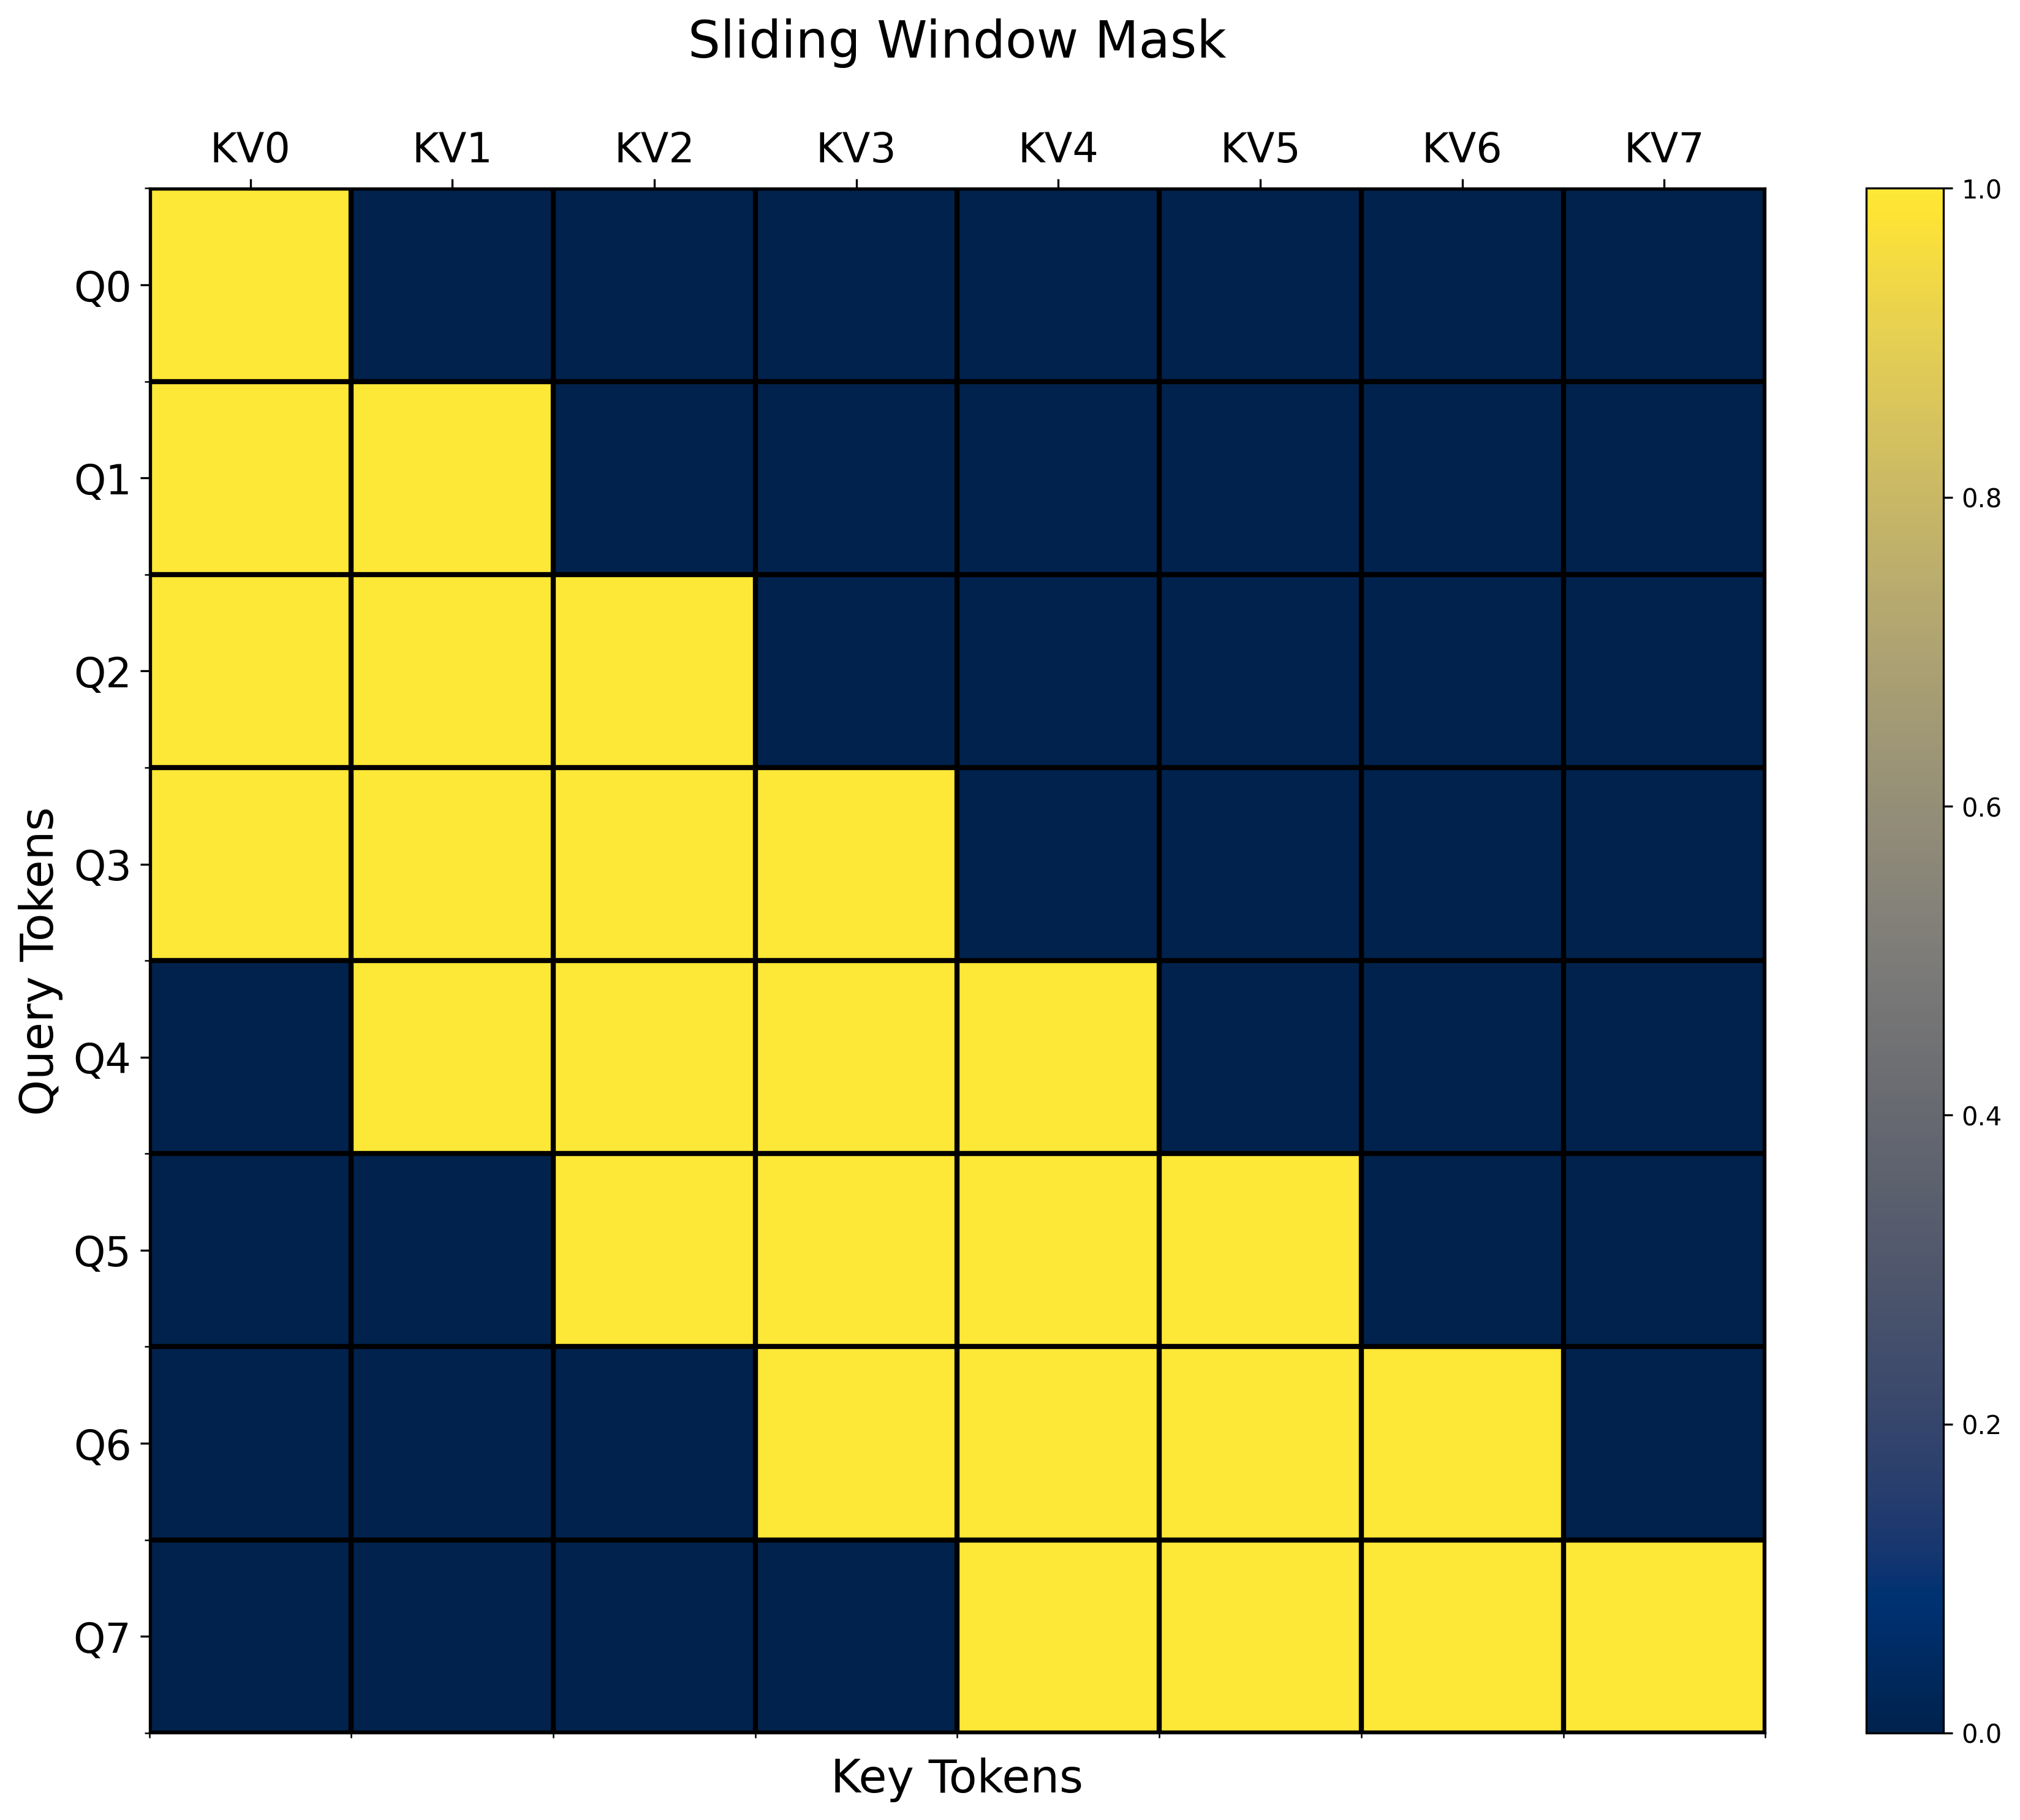 {% endcolumn %}
{% column %}
HuggingFace、GPT-OSS(3+0 トークン)
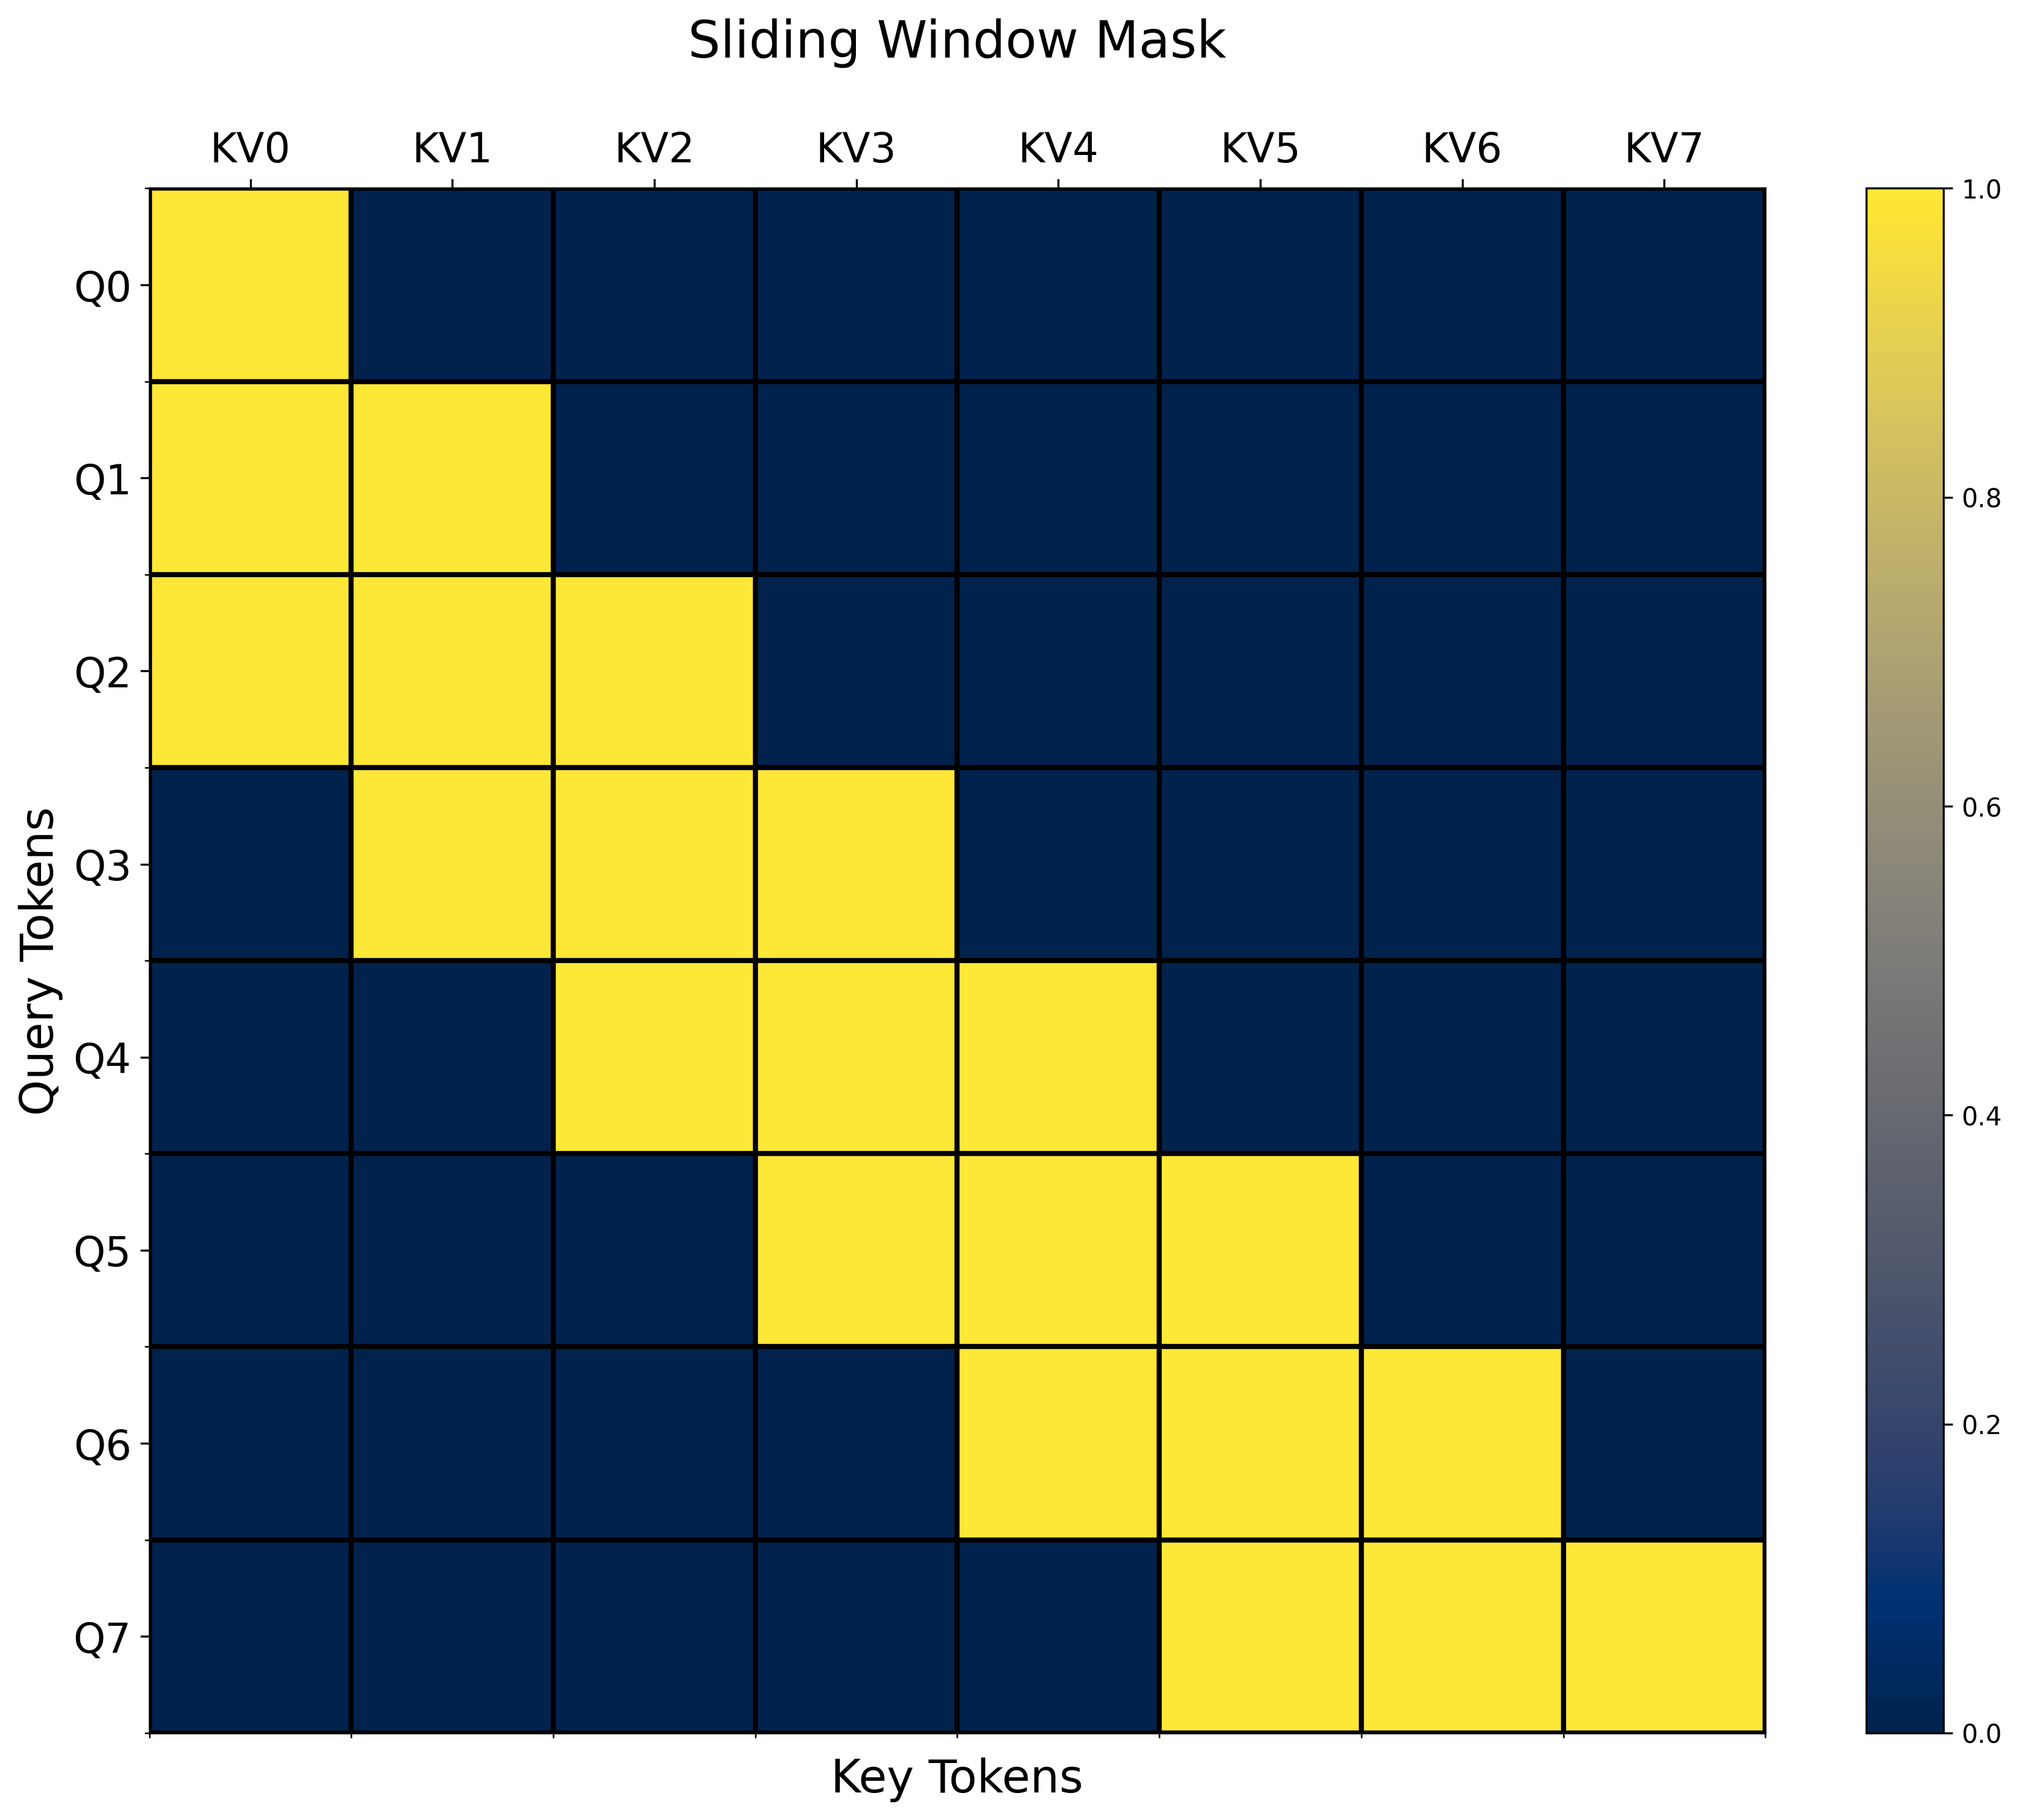 {% endcolumn %}
{% endcolumns %}
ここで最後の N トークンを見るのか N+1 トークンを見るのかについても、OpenAI の公式 GPT-OSS 実装で確認しました:
```python
mask = torch.triu(Q.new_full((n_tokens, n_tokens), -float("inf")), diagonal=1)
if sliding_window > 0:
mask += torch.tril(
mask.new_full((n_tokens, n_tokens), -float("inf")), diagonal=-sliding_window
)
```
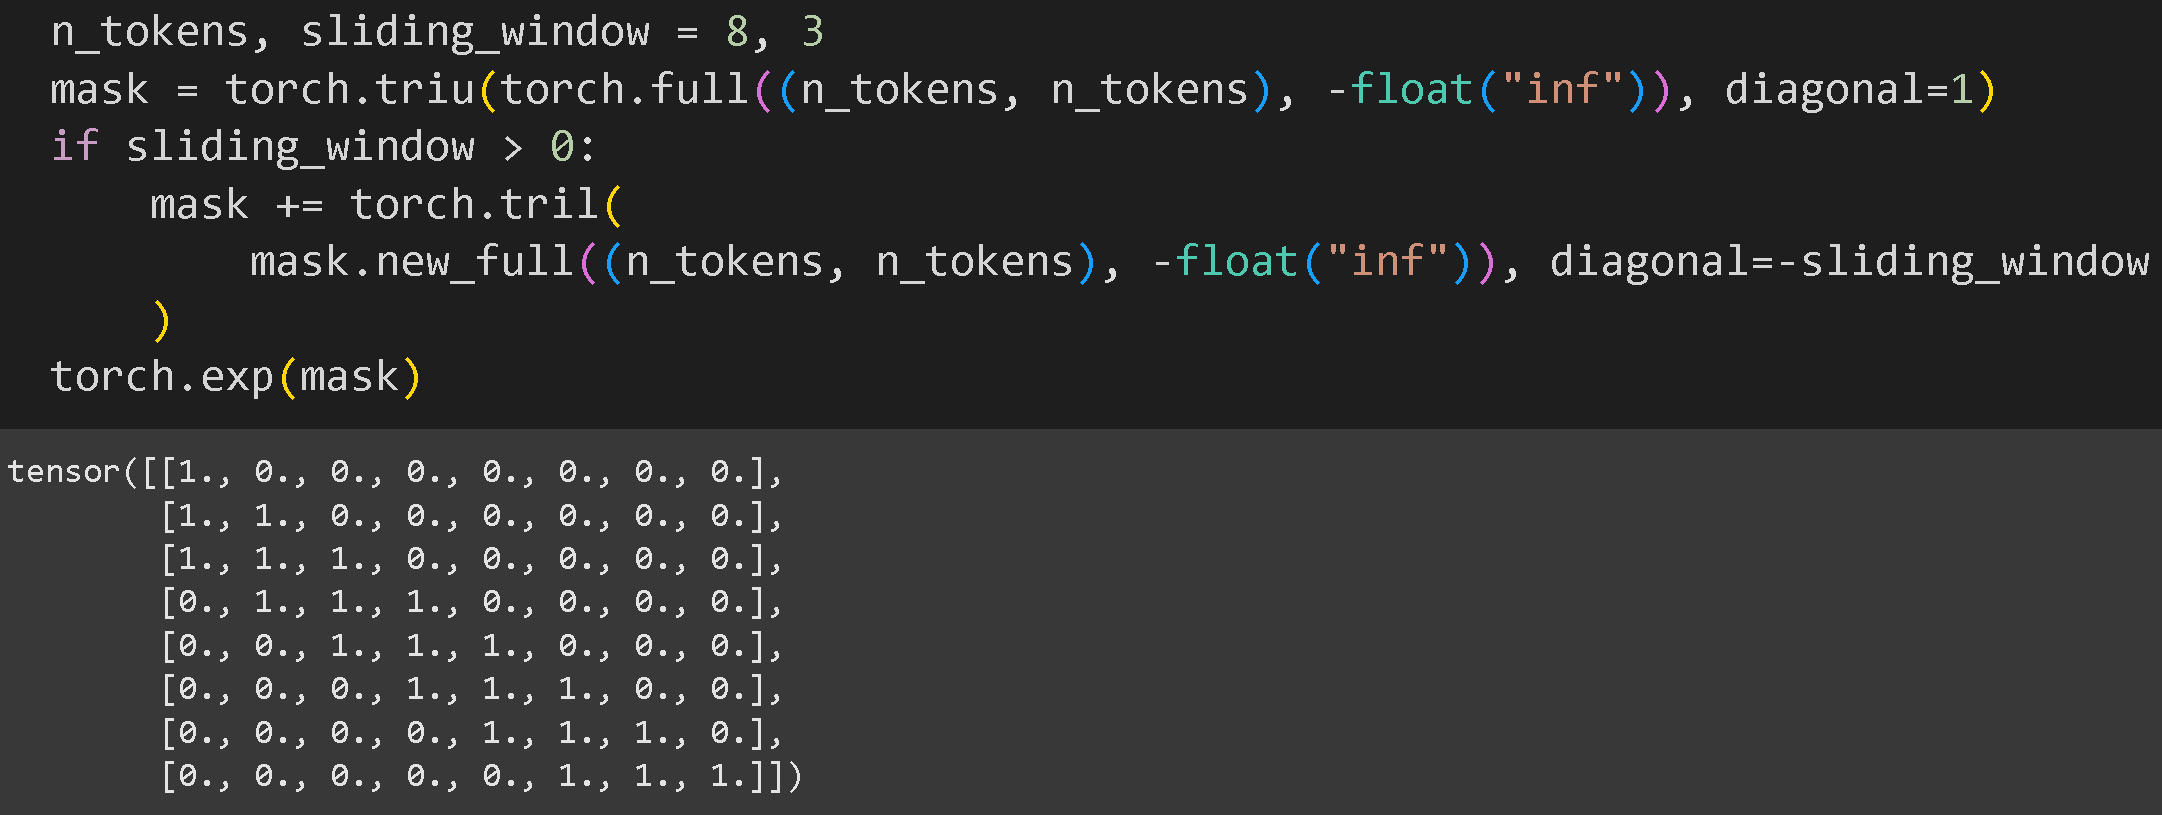 そして、最後の 3 トークンのみが注目されている(3+1 ではない)ことがわかります! つまり、以下を使う代わりに `<= SLIDING_WINDOW`には、 `< SLIDING_WINDOW` (つまり、等号を含めず、未満を使うということです)。
```python
def sliding_window_causal(b, h, q_idx, kv_idx):
causal_mask = q_idx >= kv_idx
window_mask = q_idx - kv_idx <= SLIDING_WINDOW # デフォルトの Flex Attention
window_mask = q_idx - kv_idx < SLIDING_WINDOW # GPT-OSS 版
return causal_mask & window_mask
```
また、シンクトークンの index を先頭に移動したため、正しく index するには q\_idx に 1 を加える必要があります:
```python
def causal_mask_with_sink(batch, head, q_idx, kv_idx):
"""
0 1 2 3 0 1 2 3
0 X X 1 X
1 X X X 2 X X
2 X X X X 3 X X X
"""
# 先頭の列がシンクトークンなので (q_idx + 1) を加える
causal_mask = (q_idx + 1) >= kv_idx
sink_first_column = kv_idx == 0
return causal_mask | sink_first_column
```
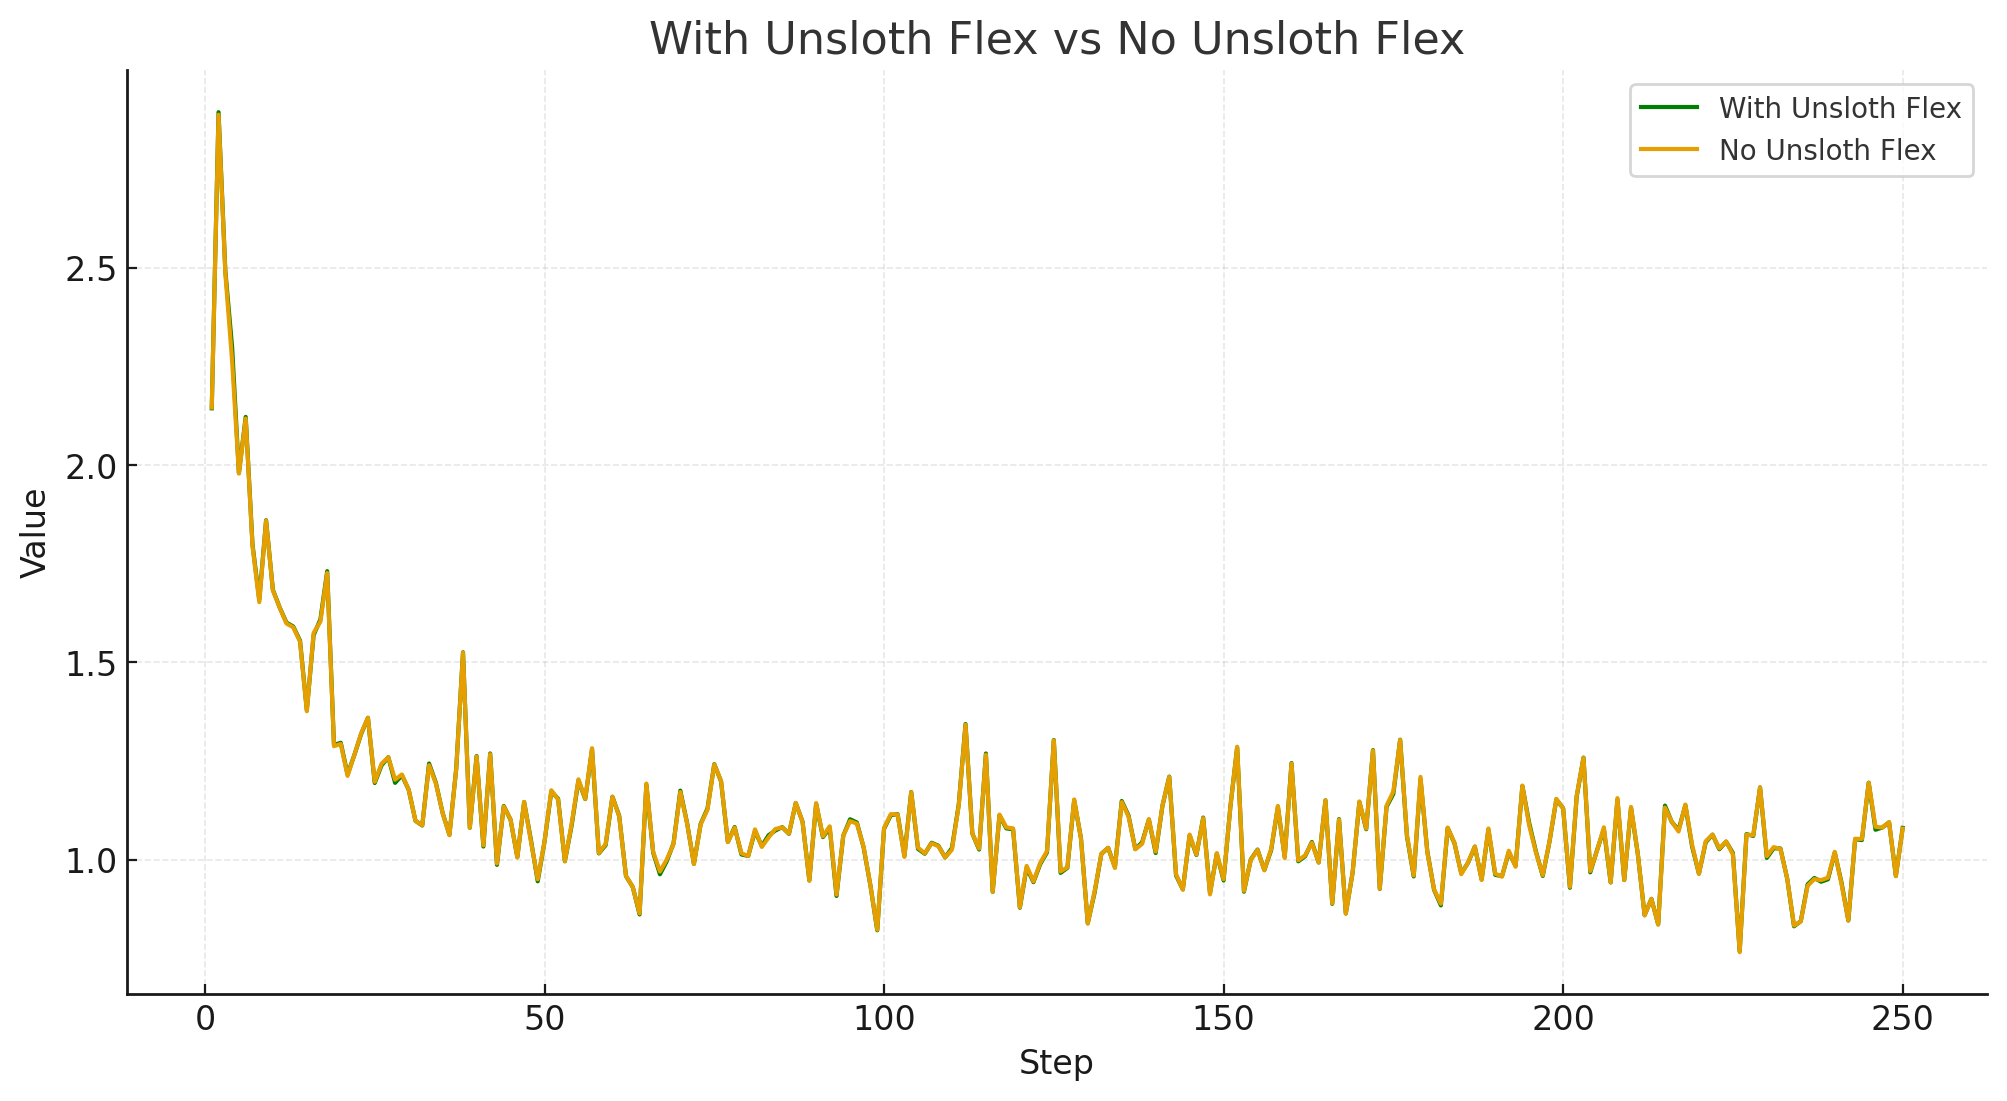
index 0 の実装を確認するため、学習損失が標準の Hugging Face 実行(Unsloth Flex Attention なし)と一貫していることを、以下のグラフで確認しました:
 ## :scroll: アテンションシンクの数式的導出
K と V をパディングせずにアテンションシンクを計算する別の方法があります。まず softmax 演算が行うことに注目します。ここではひとまず、シンク付きの第2版をスカラーとして扱いたいので:\\
$$
A(x) = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \\
A\_{sink}(x) = \frac{\exp(x\_i)}{\exp{(s)}+ \sum{\exp{(x\_i)}}}
$$
Flex Attention から logsumexp を以下で取得できます `return_lse = True` 、そのため以下のようにします:
$$
A(x) = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \\
\frac{\exp(x\_i)}{\exp{(s)}+ \sum{\exp{(x\_i)}}} = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \frac{\sum{\exp{(x\_i)}}}{\exp{(s)}+ \sum{\exp{(x\_i)}}} \\
\text{LSE}(x) = \text{logsumexp}(x) = \log{\sum\exp(x\_i)} \\
\exp{(\text{LSE}(x))} = \exp{\big(\log{\sum\exp(x\_i)}\big)} = \sum\exp(x\_i)
$$
これでアテンションのシンク版を簡単に導出できます。ただし、この手順はゼロパディング方式よりやや誤差が大きいことがわかったため、引き続き元の方式をデフォルトにしています。
## 💾**新機能: gpt-oss 学習後に GGUF、vLLM へ保存**
現在、gpt-oss を QLoRA でファインチューニングし、モデルを直接保存、エクスポート、またはマージして **llama.cpp**, **vLLM**、または **HF** に出力できます。Unsloth だけに限りません。無料ノートブックも近日公開予定です。
以前は、QLoRA でファインチューニングした gpt-oss モデルは Unsloth 内でしか実行できませんでした。私たちは、次をマージできる機能を導入することで、その制限を取り除きました。 **MXFP4** **ネイティブ形式** を使用して `save_method="mxfp4"` そして **MXFP4 のオンデマンド逆量子化** gpt-oss のようなベースモデルに対して、以下を可能にします **を使って、ファインチューニング済みモデルを bf16 形式でエクスポートする** `save_method="merged_16bit"` .
その **MXFP4** ネイティブマージ形式は、次と比べて大幅な性能向上を提供します **bf16 形式**:ディスク容量を最大 75% 削減し、VRAM 使用量を 50% 削減し、マージを 5〜10倍高速化し、以下への変換を大幅に高速化します **GGUF** 形式。
gpt-oss モデルをファインチューニングした後、これを **MXFP4** 形式へ次の方法で:
```python
model.save_pretrained_merged(save_directory, tokenizer, save_method="mxfp4")
```
モデルをマージして Hugging Face Hub にプッシュしたい場合は、次を使用してください:
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token=hf_token, save_method="mxfp4")
```
マージ済みモデルで推論を実行するには、vLLM や Llama.cpp などを使用できます。OpenAI は次を推奨しています [推論設定](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune.md#recommended-settings) 両モデルに対して: `temperature=1.0`, `top_p=1.0`, `top_k=0`
#### :sparkles: Llama.cpp に保存
1. 最新の `llama.cpp` を [GitHubこちら](https://github.com/ggml-org/llama.cpp)。以下のビルド手順に従うこともできます。変更してください `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` GPUがない場合、またはCPU推論のみを使いたい場合は。
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. 次を変換します **MXFP4** マージ済みモデル:
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned-mxfp4.gguf
```
3. 量子化モデルで推論を実行します:
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-mxfp4.gguf \
--jinja -ngl 99 --threads -1 --ctx-size 16384 \
--temp 1.0 --top-p 1.0 --top-k 0 \
-p "人生と宇宙の意味は"
```
✨ SGLang に保存
1. SGLang をソースからビルドします:\\
```bash
# ソースからビルド
git clone https://github.com/sgl-project/sglang
cd sglang
pip3 install pip --upgrade
pip3 install -e "python[all]"
# ROCm 6.3
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/rocm6.3
git clone https://github.com/triton-lang/triton
cd python/triton_kernels
pip3 install .
# hopper
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu126
pip3 install sgl-kernel==0.3.2
# blackwell cu128
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu128
pip3 install https://github.com/sgl-project/whl/releases/download/v0.3.2/sgl_kernel-0.3.2+cu128-cp39-abi3-manylinux2014_x86_64.whl
# blackwell cu129
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu129
pip3 install https://github.com/sgl-project/whl/releases/download/v0.3.2/sgl_kernel-0.3.2-cp39-abi3-manylinux2014_x86_64.whl
```
2. SGLang サーバーを起動します:\\
```bash
python3 -m sglang.launch_server --model-path ./gpt-oss-finetuned-merged/
```
3. 推論を実行します:\\
```python
import requests
from sglang.utils import print_highlight
url = f"http://localhost:8000/v1/chat/completions"
data = {
"model": "gpt-oss-finetuned-merged",
"messages": [{"role": "user", "content": "フランスの首都はどこですか?"}],
}
response = requests.post(url, json=data)
print_highlight(response.json())
```
### :diamonds:gpt-oss を直接ファインチューニング
ネイティブ MXFP4 量子化形式の読み込みを可能にするパッチを実装することで、gpt-oss モデルを直接ファインチューニングするサポートも追加しました。これにより、'openai/gpt-oss' モデルを 24GB 未満の VRAM で読み込み、QLoRA でファインチューニングできます。次のようにモデルを読み込むだけです:
```python
model, tokenizer = FastLanguageModel.from_pretrained(
# model_name = "unsloth/gpt-oss-20b-BF16",
model_name = "unsloth/gpt-oss-20b",
dtype = dtype, # 自動検出の場合は None
max_seq_length = max_seq_length, # 長いコンテキスト用に任意の値を選べます!
load_in_4bit = True, # メモリ削減のための 4bit 量子化
full_finetuning = False, # [NEW!] いまはフルファインチューニングも可能です!
# token = "hf_...", # ゲート付きモデルを使う場合は1つ使用してください
)
```
Peft 層を次を使って追加し `FastLanguageModel.get_peft_model` Peft モデルに対して SFT ファインチューニングを実行します。
## 🐛gpt-oss のバグ修正
私たちは [最近 Hugging Face と協力して](https://github.com/huggingface/transformers/pull/40197) OpenAI のカーネルを使用し、さらに以下が正しく適用されることを保証することで、推論の問題を解決しました `swiglu_limit = 7.0` が MXFP4 推論中に正しく適用されること。
ユーザーからのフィードバックをもとに、長時間の QLoRA 学習(60 ステップ超)では次が起こりうることがわかりました **損失が発散し、最終的にエラーで停止すること**。この問題は BF16 をサポートせず、代わりに F16 にフォールバックするデバイス(例:T4 GPU)でのみ発生しました。重要なのは、A100 や H100 GPU 上の QLoRA 学習や、f16 GPU 上の LoRA 学習には影響しなかったことです。
**綿密な調査の結果、F16 に制限された GPU を含むすべての GPU 構成で学習損失の挙動を揃えることができました**。これが原因で以前問題が起きていた場合は、新しい更新版の gpt-oss ノートブックの利用をおすすめします!
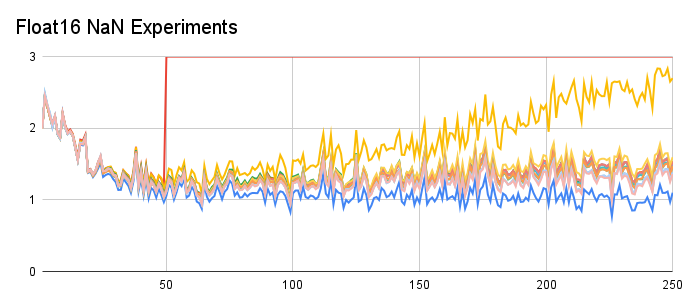 float16 の学習損失曲線を bfloat16 マシン(青線)と同等にするために、何度も何度も実験を行う必要がありました。結果として、以下がわかりました:
1. **純粋な float16 は 50 ステップ目で無限大に発散します**
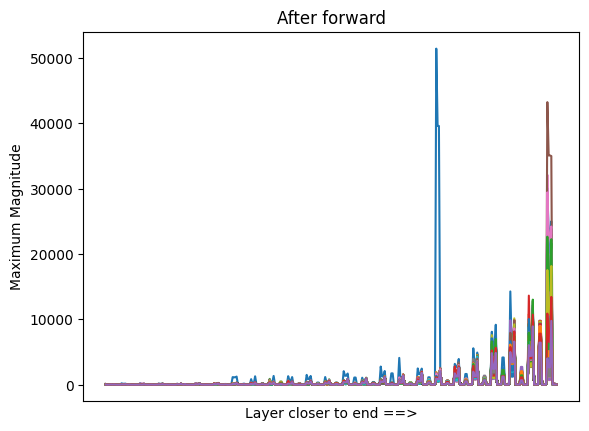
2. **MoE のダウンプロジェクションに非常に大きな外れ値があることがわかりました**
3. **アクティベーションは bfloat16 または float32 で保存しなければなりません**
**以下は GPT OSS 20B のアクティベーションの絶対値で、いくつかが本当に急激にスパイクしています。float16 の最大範囲は 65504 なので、float16 マシンではオーバーフローします。**
**これは Unsloth で修正したため、すべての float16 学習がそのまま動作します!**
 ## :1234: シンクアテンションの実装
OpenAI のシンクトークン実装は [ここにあります](https://github.com/openai/gpt-oss/blob/main/gpt_oss/torch/model.py)。以下に示します:
{% code fullWidth="false" %}
```python
def sdpa(Q, K, V, S, sm_scale, sliding_window=0):
# sliding_window == 0 はスライディングウィンドウなしを意味します
n_tokens, n_heads, q_mult, d_head = Q.shape
assert K.shape == (n_tokens, n_heads, d_head)
assert V.shape == (n_tokens, n_heads, d_head)
K = K[:, :, None, :].expand(-1, -1, q_mult, -1)
V = V[:, :, None, :].expand(-1, -1, q_mult, -1)
S = S.reshape(n_heads, q_mult, 1, 1).expand(-1, -1, n_tokens, -1)
mask = torch.triu(Q.new_full((n_tokens, n_tokens), -float("inf")), diagonal=1)
if sliding_window > 0:
mask += torch.tril(
mask.new_full((n_tokens, n_tokens), -float("inf")), diagonal=-sliding_window
)
QK = torch.einsum("qhmd,khmd->hmqk", Q, K) * sm_scale
QK += mask[None, None, :, :]
QK = torch.cat([QK, S], dim=-1)
W = torch.softmax(QK, dim=-1)
W = W[..., :-1]
attn = torch.einsum("hmqk,khmd->qhmd", W, V)
return attn.reshape(n_tokens, -1)
```
{% endcode %}
HuggingFace transformers の実装は [ここにあります](https://github.com/huggingface/transformers/blob/main/src/transformers/models/gpt_oss/modeling_gpt_oss.py)。以下にも示します:
{% code fullWidth="false" %}
```python
def eager_attention_forward(
module: nn.Module,
query: torch.Tensor,
key: torch.Tensor,
value: torch.Tensor,
attention_mask: Optional[torch.Tensor],
scaling: float,
dropout: float = 0.0,
**kwargs,
):
key_states = repeat_kv(key, module.num_key_value_groups)
value_states = repeat_kv(value, module.num_key_value_groups)
attn_weights = torch.matmul(query, key_states.transpose(2, 3)) * scaling
if attention_mask is not None:
causal_mask = attention_mask[:, :, :, : key_states.shape[-2]]
attn_weights = attn_weights + causal_mask
sinks = module.sinks.reshape(1, -1, 1, 1).expand(query.shape[0], -1, query.shape[-2], -1)
combined_logits = torch.cat([attn_weights, sinks], dim=-1)
# これは元の実装にはなく、結果にわずかに影響しますが、BF16/FP16 でのオーバーフローを防ぎます
# bsz>1 で学習する場合は最大値をクリップします。
combined_logits = combined_logits - combined_logits.max(dim=-1, keepdim=True).values
probs = F.softmax(combined_logits, dim=-1, dtype=combined_logits.dtype)
scores = probs[..., :-1] # ここでシンクを除去します
attn_weights = nn.functional.dropout(scores, p=dropout, training=module.training)
attn_output = torch.matmul(attn_weights, value_states)
attn_output = attn_output.transpose(1, 2).contiguous()
return attn_output, attn_weights
```
{% endcode %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.