> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/multi-gpu-training-with-unsloth/ddp.md).
# Fine-tuning multi-GPU avec Distributed Data Parallel (DDP)
Découvrez comment utiliser l'interface de ligne de commande Unsloth pour entraîner sur plusieurs GPU avec Distributed Data Parallel (DDP) !
Supposons que nous ayons plusieurs GPU et que nous voulions affiner un modèle en les utilisant tous ! Pour ce faire, la stratégie la plus simple consiste à utiliser le Distributed Data Parallel (DDP), qui crée une copie du modèle sur chaque GPU, alimente chaque copie avec des échantillons distincts du jeu de données pendant l'entraînement et agrège leurs contributions aux mises à jour des poids à chaque étape de l'optimiseur.
Pourquoi voudrions-nous faire cela ? Eh bien, à mesure que nous ajoutons davantage de GPU au processus d'entraînement, nous augmentons le nombre d'échantillons sur lesquels nos modèles s'entraînent par étape, ce qui rend chaque mise à jour du gradient plus stable et accroît considérablement notre débit d'entraînement à chaque GPU ajouté.
Voici un guide étape par étape pour y parvenir en utilisant l'interface en ligne de commande (CLI) d'Unsloth !
**Remarque :** Le DDP d'Unsloth fonctionne avec n'importe lequel de vos scripts d'entraînement, pas seulement via notre CLI ! Plus de détails ci-dessous.
#### Installer Unsloth depuis les sources
Nous allons cloner Unsloth depuis GitHub et l'installer. Veuillez envisager d'utiliser un [environnement virtuel](https://docs.python.org/3/tutorial/venv.html); nous aimons utiliser `uv venv –python 3.12 && source .venv/bin/activate`, mais n'importe quel outil de création d'environnement virtuel fera l'affaire.
```bash
git clone https://github.com/unslothai/unsloth.git
cd unsloth
pip install .
```
#### Choisir le modèle cible et le jeu de données pour le fine-tuning
Dans cette démo, nous allons affiner [Qwen/Qwen3-8B](https://huggingface.co/Qwen/Qwen3-8B) sur la [yahma/alpaca-cleaned](https://huggingface.co/datasets/yahma/alpaca-cleaned) jeu de données de chat. Il s'agit d'une tâche de fine-tuning supervisé (SFT), couramment utilisée lorsqu'on cherche à adapter un modèle de base à un style conversationnel souhaité ou à améliorer les performances du modèle sur une tâche en aval.
### Utilisez la CLI d'Unsloth !
Tout d'abord, examinons le message d'aide intégré à la CLI (nous avons abrégé ici avec « ... » à plusieurs endroits pour plus de concision) :
{% code expandable="true" %}
```bash
$ python unsloth-cli.py --help
utilisation : unsloth-cli.py [-h] [--model_name MODEL_NAME] [--max_seq_length MAX_SEQ_LENGTH] [--dtype DTYPE]
[--load_in_4bit] [--dataset DATASET] [--r R] [--lora_alpha LORA_ALPHA]
[--lora_dropout LORA_DROPOUT] [--bias BIAS]
[--use_gradient_checkpointing USE_GRADIENT_CHECKPOINTING]
…
🦥 Affinez votre LLM plus rapidement avec Unsloth !
options :
-h, --help afficher ce message d'aide et quitter
🤖 Options du modèle :
--model_name MODEL_NAME
Nom du modèle à charger
--max_seq_length MAX_SEQ_LENGTH
Longueur maximale de séquence, la valeur par défaut est 2048. Nous prenons automatiquement en charge le RoPE Scaling
en interne !
…
🧠 Options LoRA :
Ces options servent à configurer le modèle LoRA.
--r R Rang pour le modèle LoRA, la valeur par défaut est 16. (valeurs courantes : 8, 16, 32, 64, 128)
--lora_alpha LORA_ALPHA
Paramètre alpha LoRA, la valeur par défaut est 16. (valeurs courantes : 8, 16, 32, 64, 128)
…
🎓 Options d'entraînement :
--per_device_train_batch_size PER_DEVICE_TRAIN_BATCH_SIZE
Taille de lot par appareil pendant l'entraînement, la valeur par défaut est 2.
--per_device_eval_batch_size PER_DEVICE_EVAL_BATCH_SIZE
Taille de lot par appareil pendant l'évaluation, la valeur par défaut est 4.
--gradient_accumulation_steps GRADIENT_ACCUMULATION_STEPS
Nombre d'étapes d'accumulation de gradient, la valeur par défaut est 4.
…
```
{% endcode %}
Cela devrait vous donner une idée des options que vous pouvez transmettre à la CLI pour entraîner votre modèle !
Pour l'entraînement multi-GPU (DDP dans ce cas), nous utiliserons le [torchrun](https://docs.pytorch.org/docs/stable/elastic/run.html) lanceur, qui vous permet de lancer plusieurs processus d'entraînement distribués sur un seul nœud ou sur plusieurs nœuds. Dans notre cas, nous nous concentrerons sur le cas à un seul nœud (c.-à-d. une seule machine) avec deux GPU H100.
Examinons également l'état de nos GPU en utilisant l'outil en ligne de commande `nvidia-smi` :
{% code expandable="true" %}
```bash
$ nvidia-smi
Mon Nov 24 12:53:00 2025
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05 Driver Version: 580.95.05 CUDA Version: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU Name Persistence-M | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA H100 80GB HBM3 On | 00000000:04:00.0 Off | 0 |
| N/A 32C P0 69W / 700W | 0MiB / 81559MiB | 0% Default |
| | | Disabled |
+-----------------------------------------+------------------------+----------------------+
| 1 NVIDIA H100 80GB HBM3 On | 00000000:05:00.0 Off | 0 |
| N/A 30C P0 68W / 700W | 0MiB / 81559MiB | 0% Default |
| | | Disabled |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| Processus : |
| GPU GI CI PID Type Nom du processus Mémoire GPU |
| ID ID Utilisation |
|=========================================================================================|
| Aucun processus en cours trouvé |
+-----------------------------------------------------------------------------------------+
```
{% endcode %}
Génial ! Nous avons bien deux GPU H100, comme prévu. Les deux affichent une utilisation mémoire de 0 MiB, car nous n'entraînons actuellement rien et aucun modèle n'est chargé en mémoire.
Pour lancer votre entraînement, exécutez une commande comme la suivante :
{% code expandable="true" %}
```bash
# requis :
# --model_name
# --dataset
# facultatif ; faites des essais avec ceux-ci :
# --learning_rate, --max_seq_length, --per_device_train_batch_size, --gradient_accumulation_steps, --max_steps
# pour enregistrer le modèle à la fin de l'entraînement :
# --save_model
torchrun --nproc_per_node=2 unsloth-cli.py \
--model_name=Qwen/Qwen3-8B \
--dataset=yahma/alpaca-cleaned \
--learning_rate=2e-5 \
--max_seq_length=2048 \
--per_device_train_batch_size=1 \
--gradient_accumulation_steps=4 \
--max_steps=1000 \
--save_model
```
{% endcode %}
Si vous avez plus de GPU, vous pouvez définir `--nproc_per_node` en conséquence pour les utiliser.
**Remarque :** Vous pouvez utiliser le `torchrun` lanceur avec n'importe lequel de vos scripts d'entraînement Unsloth, y compris les [scripts](https://github.com/unslothai/notebooks/tree/main/python_scripts) convertis depuis nos notebooks Colab gratuits, et le DDP sera automatiquement activé lors de l'entraînement avec plus d'un GPU !
En regardant à nouveau `nvidia-smi` pendant que l'entraînement est en cours :
{% code expandable="true" %}
```bash
$ nvidia-smi
Mon Nov 24 12:58:42 2025
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05 Driver Version: 580.95.05 CUDA Version: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU Name Persistence-M | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA H100 80GB HBM3 On | 00000000:04:00.0 Off | 0 |
| N/A 38C P0 193W / 700W | 18903MiB / 81559MiB | 25% Default |
| | | Disabled |
+-----------------------------------------+------------------------+----------------------+
| 1 NVIDIA H100 80GB HBM3 On | 00000000:05:00.0 Off | 0 |
| N/A 37C P0 199W / 700W | 18905MiB / 81559MiB | 28% Default |
| | | Disabled |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| Processus : |
| GPU GI CI PID Type Nom du processus Mémoire GPU |
| ID ID Utilisation |
|=========================================================================================|
| 0 N/A N/A 4935 C ...und/unsloth/.venv/bin/python3 18256MiB |
| 0 N/A N/A 4936 C ...und/unsloth/.venv/bin/python3 630MiB |
| 1 N/A N/A 4935 C ...und/unsloth/.venv/bin/python3 630MiB |
| 1 N/A N/A 4936 C ...und/unsloth/.venv/bin/python3 18258MiB |
+-----------------------------------------------------------------------------------------+
```
{% endcode %}
Nous pouvons voir que les deux GPU utilisent désormais environ 19 Go de VRAM par GPU H100 !
En examinant les journaux d'entraînement, nous voyons que nous sommes capables d'entraîner à un rythme d'environ 1,1 itérations/s. Cette vitesse d'entraînement reste à peu près constante même lorsque nous ajoutons davantage de GPU, donc notre débit d'entraînement augmente à peu près linéairement avec le nombre de GPU !
### Métriques d'entraînement
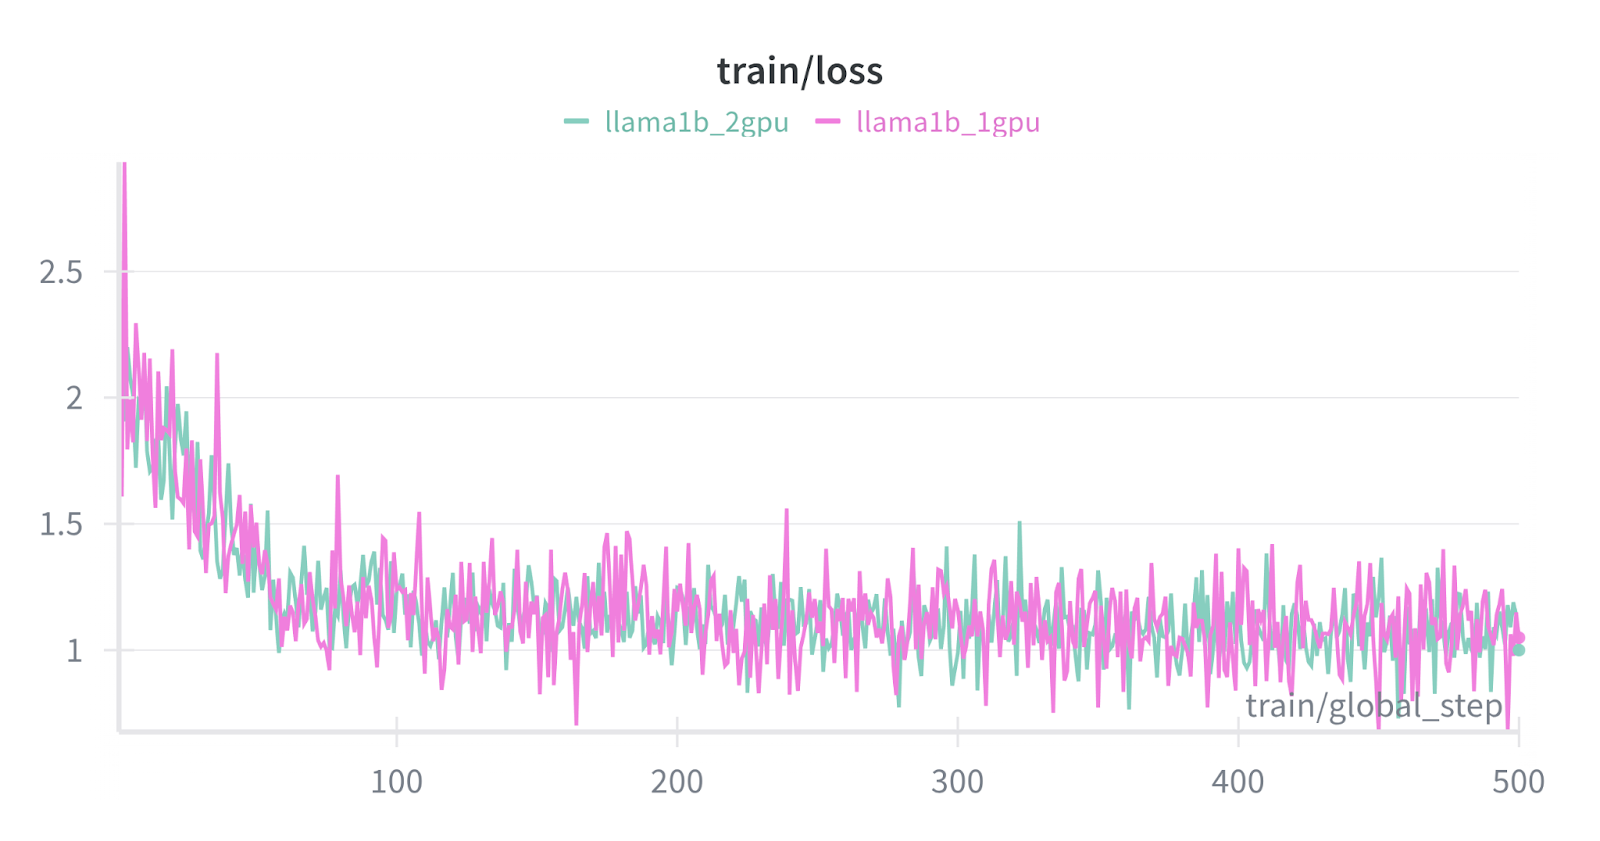
Nous avons réalisé quelques fine-tunings LoRA courts de rang 16 sur [unsloth/Llama-3.2-1B-Instruct](https://huggingface.co/unsloth/Llama-3.2-1B-Instruct) sur la [yahma/alpaca-cleaned](https://huggingface.co/datasets/yahma/alpaca-cleaned) jeu de données afin de démontrer l'amélioration du débit d'entraînement lors de l'utilisation de l'entraînement DDP avec plusieurs GPU.
La figure ci-dessus compare la perte d'entraînement entre deux fine-tunings LoRA de Llama-3.2-1B-Instruct sur 500 étapes d'entraînement, avec un entraînement sur un seul GPU (rose) contre un entraînement DDP multi-GPU (bleu).
Notez que les courbes de perte correspondent en échelle et en tendance, mais sont autrement *un peu* différentes, car *les processus d'entraînement multi-GPU traitent deux fois plus de données d'entraînement par étape*. Cela se traduit par une courbe d'entraînement légèrement différente, avec moins de variabilité d'une étape à l'autre.
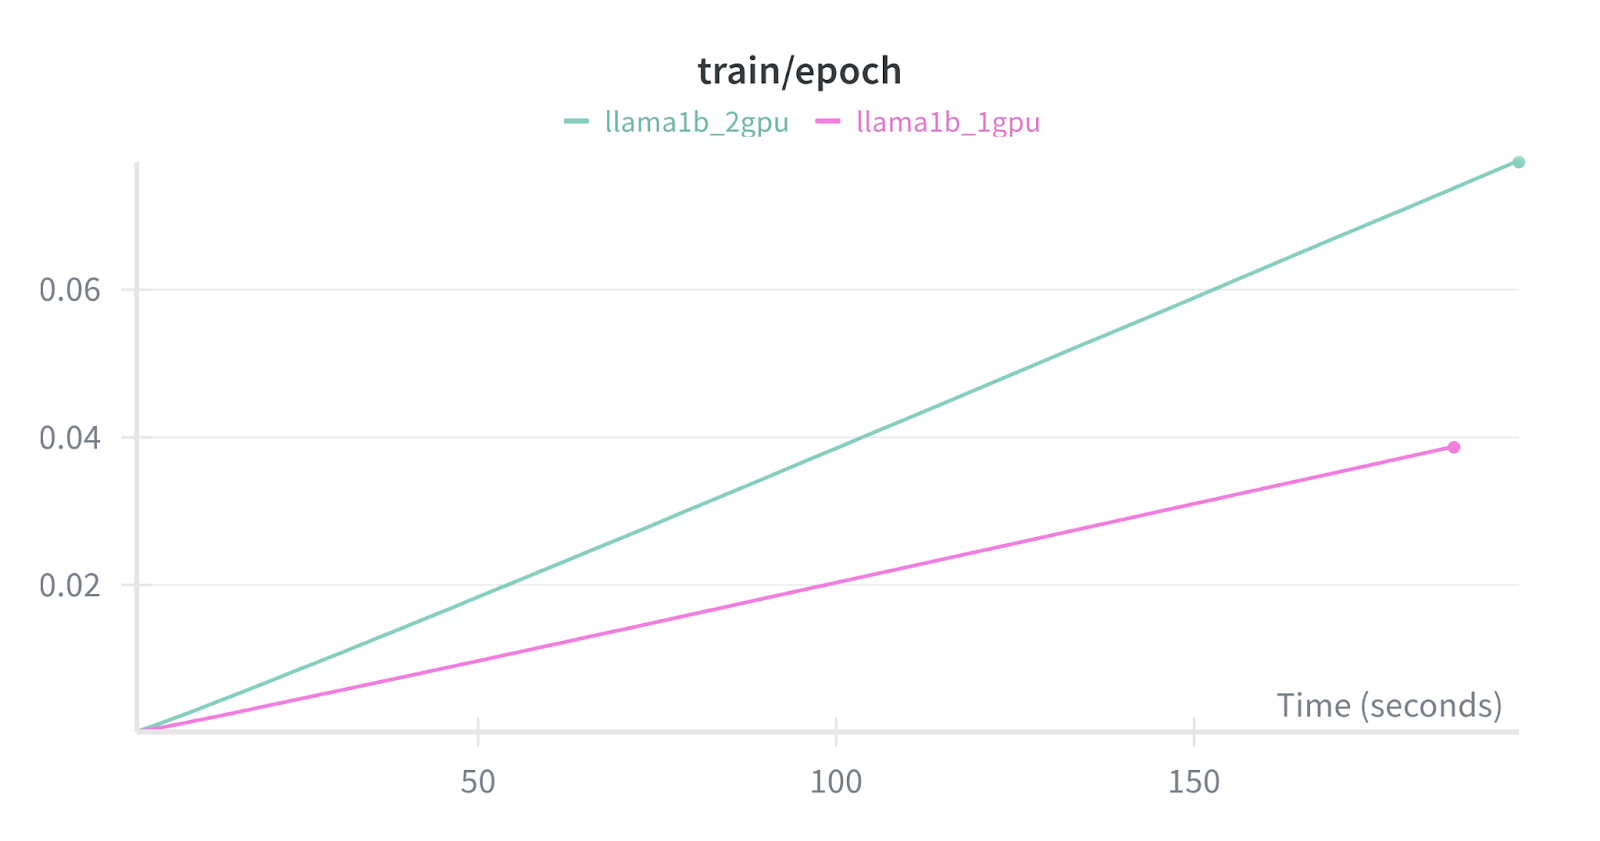
La figure ci-dessus trace la progression de l'entraînement pour les mêmes deux fine-tunings.
Notez que l'entraînement DDP multi-GPU progresse à travers une époque des données d'entraînement en deux fois moins d'étapes que l'entraînement sur un seul GPU. Cela est dû au fait que chaque GPU peut traiter un lot distinct (de taille `per_device_train_batch_size`) à chaque étape. Cependant, le temps par étape pour l'entraînement DDP est légèrement plus long en raison de la communication distribuée pour les mises à jour des poids du modèle. À mesure que vous augmentez le nombre de GPU, le débit d'entraînement continuera d'augmenter à peu près linéairement (mais avec une pénalité distribuée faible, mais croissante, pour les communications).
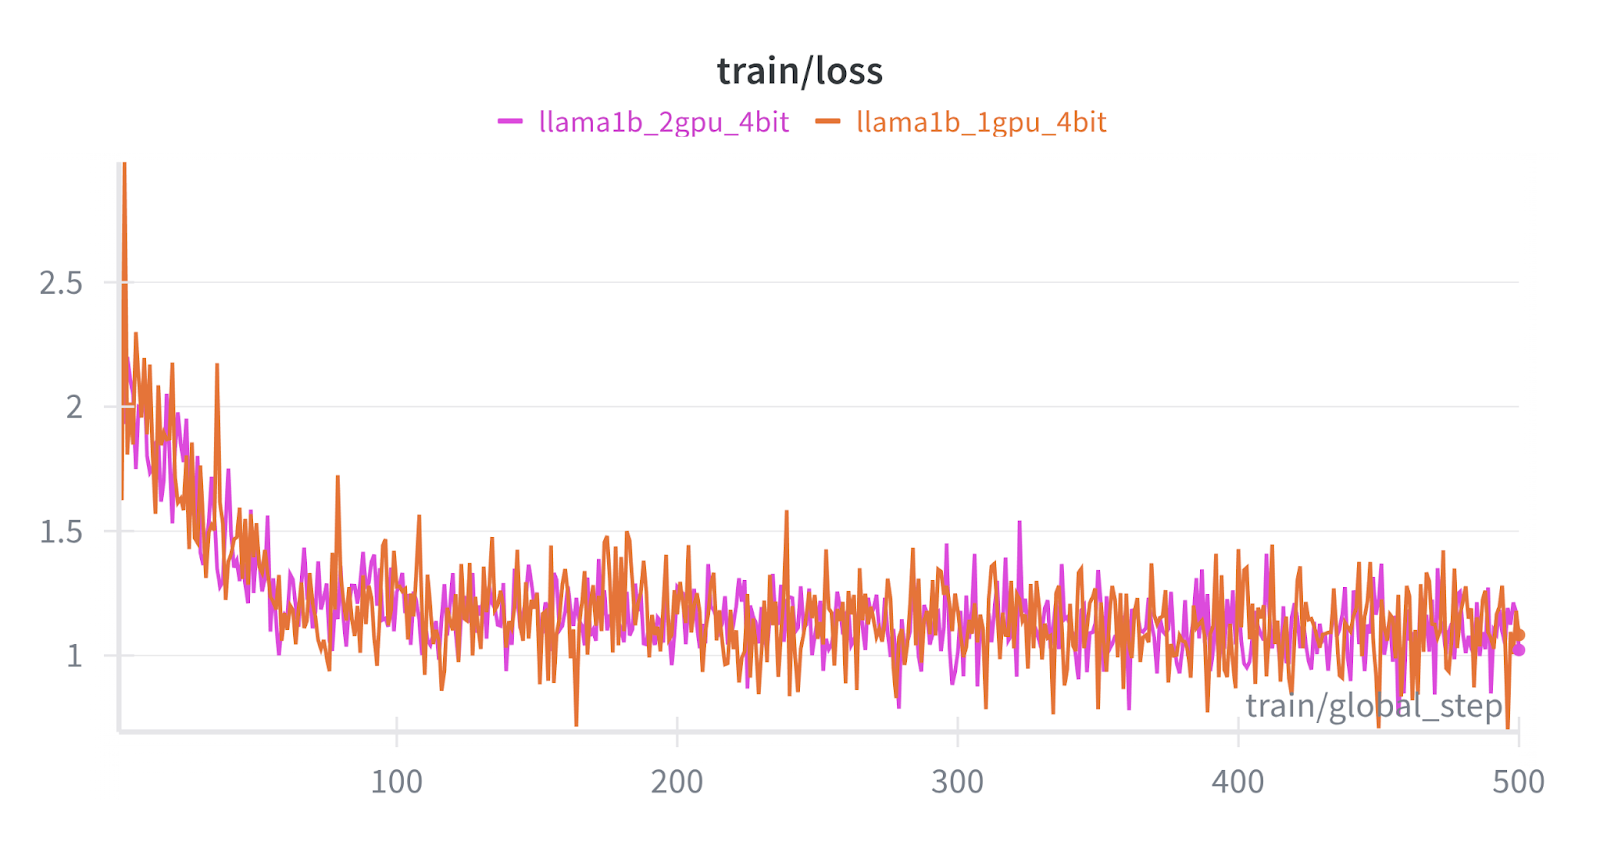
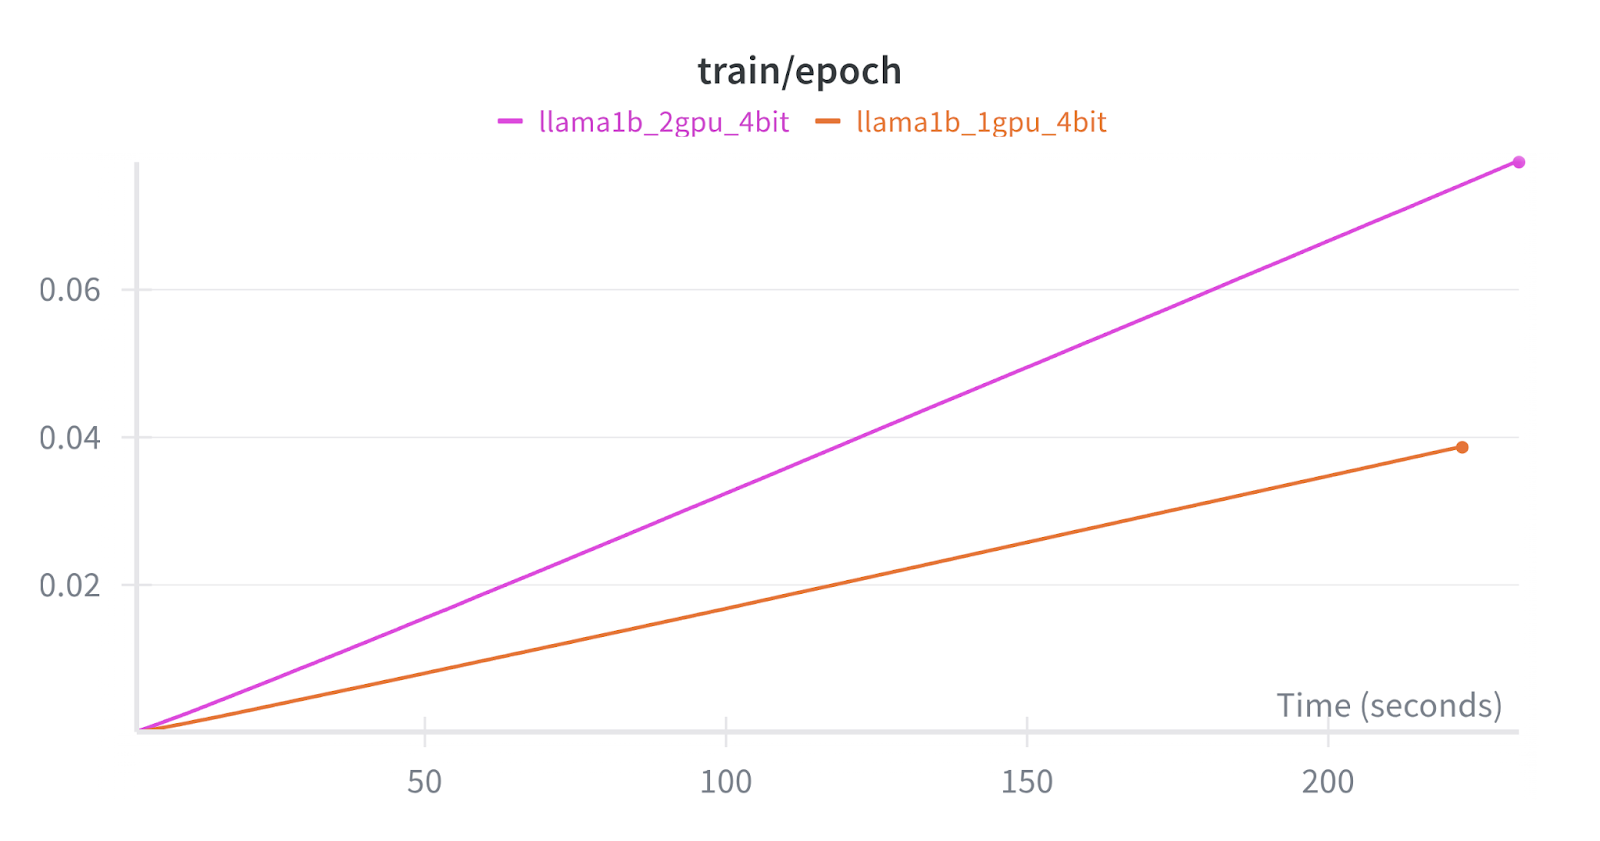
Ces mêmes comportements de perte et de progression de l'époque d'entraînement s'appliquent aux fine-tunings QLoRA, dans lesquels nous avons chargé les modèles de base en précision 4 bits afin d'économiser de la mémoire GPU supplémentaire. Cela est particulièrement utile pour entraîner de grands modèles avec des quantités limitées de VRAM GPU :
Comparaison de la perte d'entraînement entre deux fine-tunings QLoRA de Llama-3.2-1B-Instruct sur 500 étapes d'entraînement, avec un entraînement sur un seul GPU (orange) contre un entraînement DDP multi-GPU (violet).
Comparaison de la progression de l'entraînement pour les mêmes deux fine-tunings.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/notions-de-base/multi-gpu-training-with-unsloth/ddp.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.