> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/qwen3.5/fine-tune.md).
# Guide de fine-tuning Qwen3.5
Découvrez comment fine-tuner les LLM Qwen3.5 avec Unsloth.
Vous pouvez maintenant fine-tuner [Qwen3.5](/docs/fr/modeles/qwen3.5.md) la famille de modèles (0.8B, 2B, 4B, 9B, 27B, 35B‑A3B, 122B‑A10B) avec [**Unsloth**](https://github.com/unslothai/unsloth). La prise en charge inclut à la fois [vision](/docs/fr/modeles/qwen3.5/fine-tune.md#vision-fine-tuning), le texte et [RL](#reinforcement-learning-rl) le fine-tuning. **Qwen3.5‑35B‑A3B** - le LoRA bf16 fonctionne sur **74 Go de VRAM.**
* Unsloth fait entraîner Qwen3.5 **1,5× plus vite** et utilise **50 % de VRAM en moins** que les configurations FA2.
* Utilisation de la VRAM pour le LoRA bf16 de Qwen3.5 : **0,8B**: 3 Go • **2B**: 5 Go • **4B**: 10 Go • **9B**: 22 Go • **27B**: 56 Go
* Ajustement fin **0,8B**, **2B** et **4B** LoRA bf16 via notre **gratuits** **notebooks Google Colab**:
| [Qwen3.5-**0,8B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(0_8B\)_Vision.ipynb) | [Qwen3.5-**2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(2B\)_Vision.ipynb) | [Qwen3.5-**4B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision.ipynb) | [Qwen3.5-4B **GRPO**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) |
| --------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------- |
* Si vous voulez **préserver la capacité** capacité, vous pouvez mélanger des exemples de style raisonnement avec des réponses directes (conservez au minimum 75 % de raisonnement). Sinon, vous pouvez l’émettre entièrement.
* **Le fine-tuning complet (FFT)** fonctionne aussi. Notez qu’il utilisera 4 fois plus de VRAM.
* Qwen3.5 est puissant pour le fine-tuning multilingue, car il prend en charge 201 langues.
* Après l'ajustement fin, vous pouvez exporter vers [GGUF](#saving-export-your-fine-tuned-model) (pour llama.cpp/Ollama/etc.) ou [vLLM](#saving-export-your-fine-tuned-model)
* [Apprentissage par renforcement](/docs/fr/commencer/reinforcement-learning-rl-guide.md) (RL) pour Qwen3.5 [RL pour VLM](/docs/fr/commencer/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) fonctionne aussi via l’inférence Unsloth.
* Nous avons **A100** notebooks Colab pour [Qwen3.5‑27B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen_3_5_27B_A100\(80GB\).ipynb) et [Qwen3.5‑35B‑A3B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_MoE.ipynb).
Si vous êtes sur une version plus ancienne (ou si vous fine-tunez localement), mettez d’abord à jour :
{% columns %}
{% column width="50%" %}
Unsloth Studio :
{% code expandable="true" %}
```bash
mise à jour d'Unsloth Studio
```
{% endcode %}
{% endcolumn %}
{% column width="50%" %}
Unsloth code-based :
```bash
pip install --upgrade --force-reinstall --no-cache-dir unsloth unsloth_zoo
```
{% endcolumn %}
{% endcolumns %}
{% hint style="warning" %}
**Veuillez utiliser `transformers v5` pour Qwen3.5. Les versions plus anciennes ne fonctionneront pas. Unsloth utilise désormais automatiquement transformers v5 par défaut (sauf pour les environnements Colab).**
Si l’entraînement semble **plus lent que d’habitude**, c’est parce que Qwen3.5 utilise des noyaux Triton Mamba personnalisés. La compilation de ces noyaux peut prendre plus de temps que la normale, surtout sur les GPU T4.
Il n’est pas recommandé d’effectuer un entraînement QLoRA (4 bits) sur les modèles Qwen3.5, MoE ou denses, en raison de différences de quantification plus élevées que la normale.
{% endhint %}
### Fine-tuning MoE (35B, 122B)
Pour les modèles MoE comme **Qwen3.5‑35B‑A3B / 122B‑A10B / 397B‑A17B**:
* Vous pouvez utiliser notre [Qwen3.5‑35B‑A3B (A100)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_MoE.ipynb) notebook d’affinage
* Compatible avec notre récente accélération d’environ 12× [mise à jour d’entraînement MoE](/docs/fr/notions-de-base/faster-moe.md) avec >35 % de VRAM en moins et un contexte \~6× plus long
* **Mieux vaut utiliser des configurations bf16 (par ex. LoRA ou fine-tuning complet)** (le MoE QLoRA 4 bits n’est pas recommandé en raison des limites de BitsandBytes).
* Les noyaux MoE d’Unsloth sont activés par défaut et peuvent utiliser différents backends ; vous pouvez basculer avec `UNSLOTH_MOE_BACKEND`.
* Le fine-tuning de la couche routeuse est désactivé par défaut pour des raisons de stabilité.
* Qwen3.5‑122B‑A10B - le LoRA bf16 fonctionne sur 256 Go de VRAM. Si vous utilisez plusieurs GPU, ajoutez `device_map = "balanced"` ou suivez notre [guide multiGPU](/docs/fr/notions-de-base/multi-gpu-training-with-unsloth.md).
### Démarrage rapide
#### 🦥 Guide d’Unsloth Studio
Qwen3.5 peut être exécuté et affiné dans [Unsloth Studio](/docs/fr/nouveau/studio.md), notre nouvelle interface web open source pour l'IA locale. Avec Unsloth Studio, vous pouvez exécuter des modèles localement sur **macOS, Windows**, Linux et :
{% columns %}
{% column %}
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally) et des modèles safetensor
* [**Auto-réparation** appel d’outils](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) + **recherche web**
* [**exécution de code**](/docs/fr/nouveau/studio.md#run-models-locally) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence CPU + GPU rapide via llama.cpp
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% stepper %}
{% step %}
#### Installer Unsloth
Exécutez dans votre terminal :
**MacOS, Linux, WSL :**
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
**Windows PowerShell :**
```bash
irm https://unsloth.ai/install.ps1 | iex
```
{% hint style="success" %}
**L'installation sera rapide et prendra environ 1 à 2 minutes.**
{% endhint %}
{% endstep %}
{% step %}
#### Lancer Unsloth
**MacOS, Linux, WSL et Windows :**
```bash
unsloth studio -H 0.0.0.0 -p 8888
```
**Puis ouvrez `http://localhost:8888` dans votre navigateur.**
{% endstep %}
{% step %}
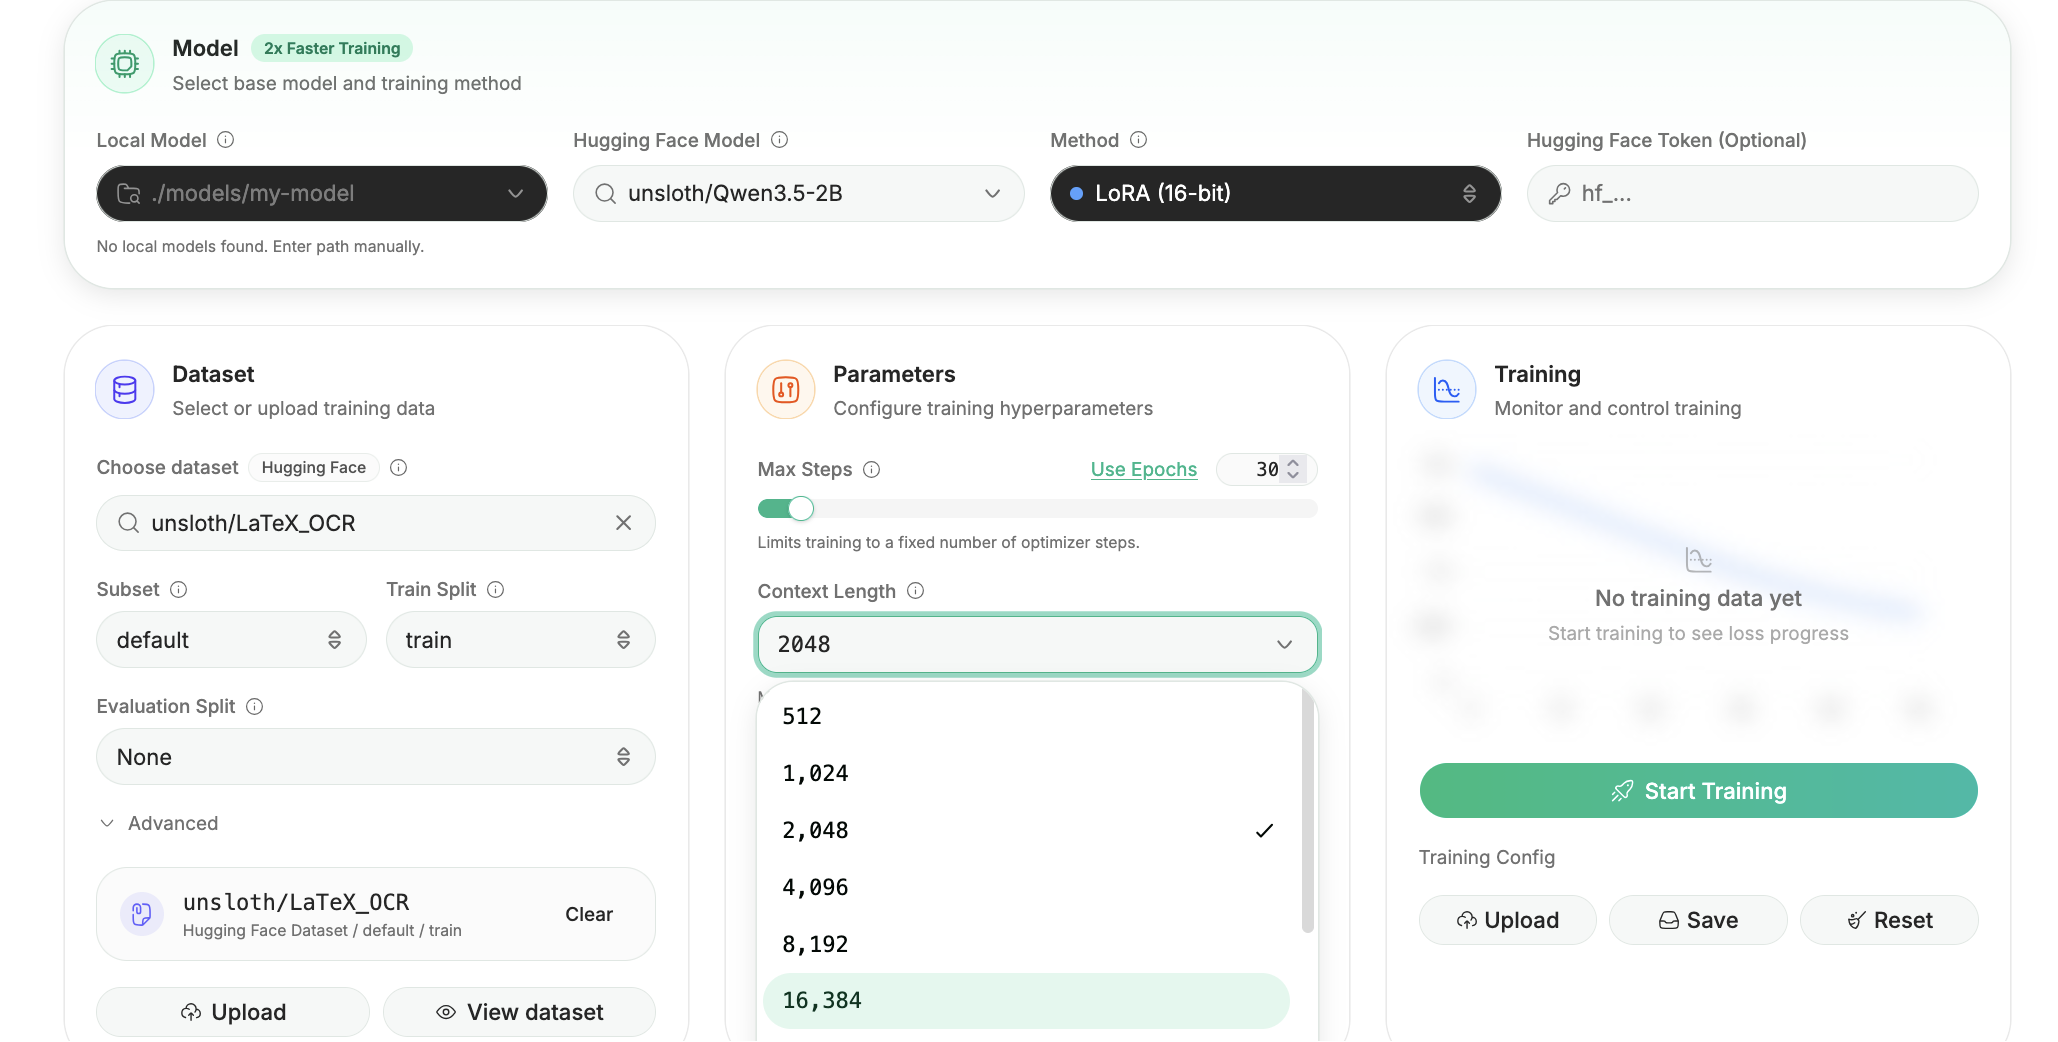
#### Entraîner Qwen3.5
Au premier lancement, vous devrez créer un mot de passe pour sécuriser votre compte et vous reconnecter plus tard. Vous verrez ensuite un bref assistant d'intégration pour choisir un modèle, un jeu de données et des paramètres de base. Vous pouvez le passer à tout moment.
Recherchez Qwen3.5 dans la barre de recherche et sélectionnez le modèle et le jeu de données souhaités. Ensuite, ajustez vos hyperparamètres et la longueur de contexte comme vous le souhaitez.
{% endstep %}
{% step %}
#### Surveiller la progression de l'entraînement
Après avoir cliqué sur démarrer l'entraînement, vous pourrez surveiller et observer la progression de l'entraînement du modèle. La perte d'entraînement devrait diminuer régulièrement.\
Une fois terminé, le modèle sera automatiquement enregistré.
{% endstep %}
{% step %}
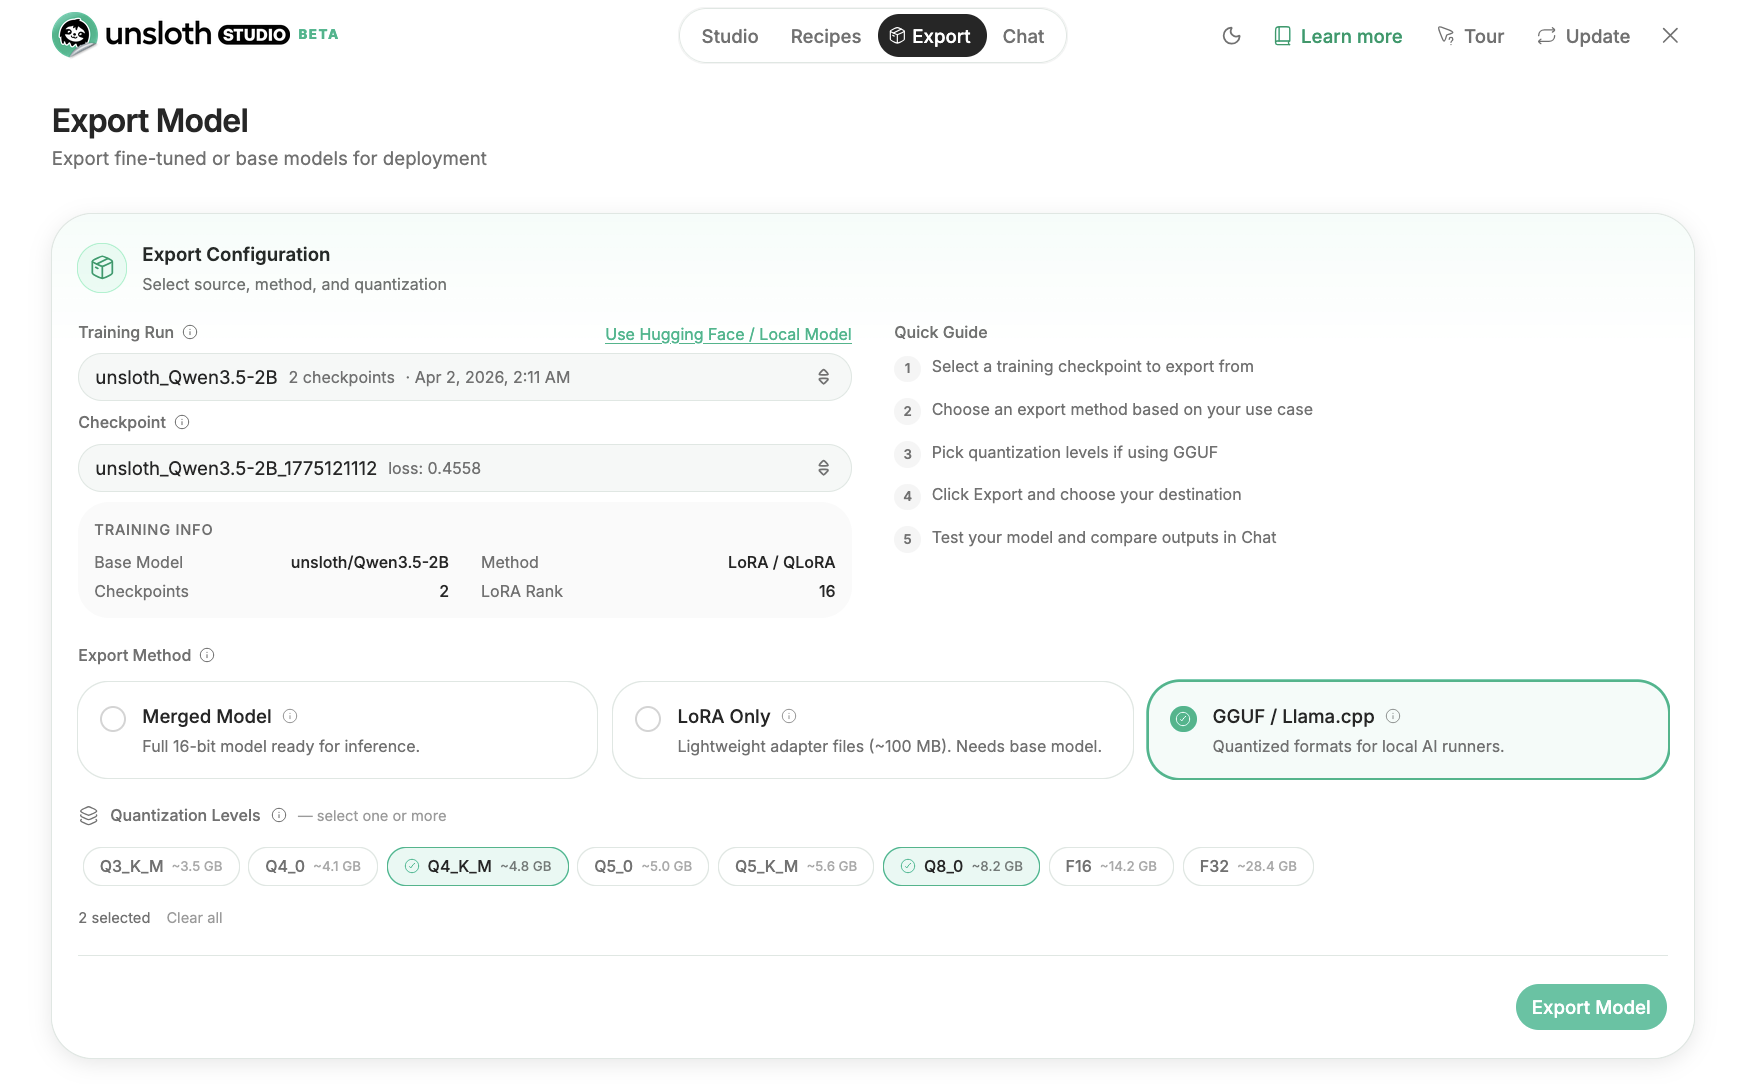
#### Exporter votre modèle ajusté finement
Une fois terminé, Unsloth Studio vous permet d'exporter le modèle aux formats GGUF, safetensor, etc.
{% endstep %}
{% endstepper %}
#### Guide Unsloth Core (code-based) :
Voici une recette SFT minimale (fonctionne pour le fine-tuning « texte uniquement »). Voir aussi notre [d'ajustement fin vision](/docs/fr/notions-de-base/vision-fine-tuning.md) section.
{% hint style="info" %}
Qwen3.5 est un « modèle de langage causal avec encodeur de vision » (c’est un VLM unifié), donc assurez-vous d’avoir installées les dépendances vision habituelles (`torchvision`, `pillow`) si nécessaire, et gardez Transformers à jour. Utilisez la dernière version de Transformers pour Qwen3.5.
**Si vous souhaitez faire** [**GRPO**](/docs/fr/commencer/reinforcement-learning-rl-guide.md)**, cela fonctionne dans Unsloth si vous désactivez l'inférence rapide vLLM et utilisez à la place l'inférence Unsloth. Suivez nos exemples de notebooks** [**de RL vision**](/docs/fr/commencer/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) **.**
{% endhint %}
{% code expandable="true" %}
```python
from unsloth import FastLanguageModel
import torch
from datasets import load_dataset
from trl import SFTTrainer, SFTConfig
max_seq_length = 2048 # commencez petit ; augmentez ensuite une fois que cela fonctionne
# Jeu de données d’exemple (remplacez-le par le vôtre). Nécessite une colonne "text".
url = "https://huggingface.co/datasets/laion/OIG/resolve/main/unified_chip2.jsonl"
dataset = load_dataset("json", data_files={"train": url}, split="train")
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "Qwen/Qwen3.5-27B",
max_seq_length = max_seq_length,
load_in_4bit = False, # le MoE QLoRA n’est pas recommandé, le dense 27B est correct
load_in_16bit = True, # LoRA bf16/16 bits
full_finetuning = False,
)
model = FastLanguageModel.get_peft_model(
model,
r = 16,
target_modules = [
"q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",
],
lora_alpha = 16,
lora_dropout = 0,
bias = "none",
# le checkpointing "unsloth" est destiné aux contextes très longs + moins de VRAM
use_gradient_checkpointing = "unsloth",
random_state = 3407,
max_seq_length = max_seq_length,
)
trainer = SFTTrainer(
model = model,
train_dataset = dataset,
tokenizer = tokenizer,
args = SFTConfig(
max_seq_length = max_seq_length,
per_device_train_batch_size = 1,
gradient_accumulation_steps = 4,
warmup_steps = 10,
max_steps = 100,
logging_steps = 1,
output_dir = "outputs_qwen35",
optim = "adamw_8bit",
seed = 3407,
dataset_num_proc = 1,
),
)
trainer.train()
```
{% endcode %}
{% hint style="info" %}
Si vous êtes en OOM :
* Réduisez `per_device_train_batch_size` à **1** et/ou réduisez `max_seq_length`.
* Conservez `use_`[`gradient_checkpointing`](/docs/fr/blog/500k-context-length-fine-tuning.md#unsloth-gradient-checkpointing-enhancements)`="unsloth"` activé (il est conçu pour réduire l'utilisation de VRAM et étendre la longueur du contexte).
{% endhint %}
**Exemple de chargeur pour MoE (LoRA bf16) :**
```python
import os
import torch
from unsloth import FastModel
model, tokenizer = FastModel.from_pretrained(
model_name = "unsloth/Qwen3.5-35B-A3B",
max_seq_length = 2048,
load_in_4bit = False, # le MoE QLoRA n’est pas recommandé, le dense 27B est correct
load_in_16bit = True, # LoRA bf16/16 bits
full_finetuning = False,
)
```
Une fois chargé, vous attacherez des adaptateurs LoRA et entraînerez de façon similaire à l'exemple SFT ci-dessus.
### Fine-tuning vision
Unsloth prend en charge [d'ajustement fin vision](/docs/fr/notions-de-base/vision-fine-tuning.md) les modèles Qwen3.5 multimodaux. Utilisez les notebooks Qwen3.5 ci-dessous et remplacez les noms de modèles respectifs par le modèle Qwen3.5 souhaité.
| [Qwen3.5-**0,8B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(0_8B\)_Vision.ipynb) | [Qwen3.5-**2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(2B\)_Vision.ipynb) | [Qwen3.5-**4B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision.ipynb) | Qwen3.5-**9B** |
| --------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | -------------- |
* [notebook RL Qwen3-VL GRPO/GSPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) (changez le nom du modèle en Qwen3.5-4B etc.)
**Désactiver la vision / le fine-tuning texte uniquement :**
Pour fine-tuner des modèles de vision, nous vous permettons désormais de sélectionner quelles parties du modèle fine-tuner. Vous pouvez choisir de n’ajuster que les couches de vision, ou les couches de langage, ou les couches d’attention / MLP ! Nous les activons toutes par défaut !
{% code expandable="true" %}
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = True, # False si vous n'ajustez pas finement les couches de vision
finetune_language_layers = True, # False si vous n'ajustez pas finement les couches de langage
finetune_attention_modules = True, # False si vous n'ajustez pas finement les couches d'attention
finetune_mlp_modules = True, # False si vous n'ajustez pas finement les couches MLP
r = 16, # plus la valeur est grande, plus la précision est élevée, mais il peut y avoir surapprentissage
lora_alpha = 16, # alpha recommandé = r au minimum
lora_dropout = 0,
bias = "none",
random_state = 3407,
use_rslora = False, # Nous prenons en charge LoRA stabilisée en rang
loftq_config = None, # Et LoftQ
target_modules = "all-linear", # Optionnel maintenant ! Peut spécifier une liste si nécessaire
modules_to_save=[
"lm_head",
"embed_tokens",
],
)
```
{% endcode %}
Afin de fine-tuner ou d’entraîner Qwen3.5 avec plusieurs images, consultez notre [**guide vision multi-images**](/docs/fr/notions-de-base/vision-fine-tuning.md#multi-image-training)**.**
### Apprentissage par renforcement (RL)
Vous pouvez désormais entraîner Qwen3.5 avec du RL, du GSPO, du GRPO, etc. avec [notre notebook gratuit](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb):
{% embed url="" %}
Vous pouvez exécuter le RL de Qwen3.5 avec Unsloth même s’il n’est pas pris en charge par vLLM, en définissant `fast_inference=False` lors du chargement du modèle :
```python
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Qwen3.5-4B",
fast_inference=False,
)
```
### Sauvegarde / export du modèle ajusté finement
Vous pouvez consulter nos guides spécifiques d'inférence / de déploiement pour [Unsloth Studio](/docs/fr/nouveau/studio/export.md), [llama.cpp](/docs/fr/notions-de-base/inference-and-deployment/saving-to-gguf.md), [vLLM](/docs/fr/notions-de-base/inference-and-deployment/vllm-guide.md), [llama-server](/docs/fr/notions-de-base/inference-and-deployment/llama-server-and-openai-endpoint.md), [Ollama](/docs/fr/notions-de-base/inference-and-deployment/saving-to-ollama.md).
#### Enregistrer au format GGUF
Unsloth prend en charge l'enregistrement direct au format GGUF :
```python
model.save_pretrained_gguf("directory", tokenizer, quantization_method = "q4_k_m")
model.save_pretrained_gguf("directory", tokenizer, quantization_method = "q8_0")
model.save_pretrained_gguf("directory", tokenizer, quantization_method = "f16")
```
Ou envoyer les GGUF sur Hugging Face :
```python
model.push_to_hub_gguf("hf_username/directory", tokenizer, quantization_method = "q4_k_m")
model.push_to_hub_gguf("hf_username/directory", tokenizer, quantization_method = "q8_0")
```
Si le modèle exporté se comporte moins bien dans un autre environnement d'exécution, Unsloth signale la cause la plus fréquente : **mauvais gabarit de chat / jeton EOS au moment de l'inférence** (vous devez utiliser le même gabarit de chat que celui avec lequel vous avez entraîné le modèle).
#### Enregistrer pour vLLM
{% hint style="warning" %}
version de vLLM `0.16.0` ne prend pas en charge Qwen3.5. Attendez jusqu’à `0.170` ou essayez la version Nightly.
{% endhint %}
Pour enregistrer en 16 bits pour vLLM, utilisez :
{% code overflow="wrap" %}
```python
model.save_pretrained_merged("finetuned_model", tokenizer, save_method = "merged_16bit")
## OU pour téléverser sur Hugging Face :
model.push_to_hub_merged("hf/model", tokenizer, save_method = "merged_16bit", token = "")
```
{% endcode %}
Pour enregistrer uniquement les adaptateurs LoRA, utilisez soit :
```python
model.save_pretrained("finetuned_lora")
tokenizer.save_pretrained("finetuned_lora")
```
Ou utilisez notre fonction intégrée :
{% code overflow="wrap" %}
```python
model.save_pretrained_merged("finetuned_model", tokenizer, save_method = "lora")
## OU pour téléverser sur Hugging Face
model.push_to_hub_merged("hf/model", tokenizer, save_method = "lora", token = "")
```
{% endcode %}
Pour plus de détails, consultez nos guides d'inférence :
{% columns %}
{% column width="50%" %}
{% content-ref url="/pages/44b6f06033c7dbf3b6521a33337058e295acc604" %}
[Inférence et déploiement](/docs/fr/notions-de-base/inference-and-deployment.md)
{% endcontent-ref %}
{% content-ref url="/pages/0ce33fc68eed069d43cdcfb76b9793ce71c64c1f" %}
[GGUF & llama.cpp](/docs/fr/notions-de-base/inference-and-deployment/saving-to-gguf.md)
{% endcontent-ref %}
{% endcolumn %}
{% column width="50%" %}
{% content-ref url="/pages/817a1275219e1e8d86fe100d223ac4b0862ab3a1" %}
[Model Export](/docs/fr/nouveau/studio/export.md)
{% endcontent-ref %}
{% content-ref url="/pages/682151c53afcf1f6d611eb29ad62b7182b5187ea" %}
[vLLM](/docs/fr/notions-de-base/inference-and-deployment/vllm-guide.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/qwen3.5/fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.