> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/lora-hyperparameters-guide.md).

# LoRA 微调超参数指南

逐步学习最佳的 LLM 微调设置——LoRA rank 和 alpha、epoch、batch size + 梯度累积、QLoRA 与 LoRA、目标模块等。

LoRA 超参数是可调设置，用于控制低秩适应 [微调](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide.md) LLMs。由于有许多选择（例如学习率和轮数）以及无数种组合，选对数值对于准确度、稳定性、质量以及减少幻觉都至关重要。做好了以后， **LoRA 可以达到完整微调的性能** 同时使用的 VRAM 减少 4 倍。

你将基于数百篇研究论文和实验的洞见，学习这些参数的最佳实践，并了解它们如何影响模型。 **虽然我们建议使用 Unsloth 的默认值**，但理解这些概念会让你完全掌控。\
\
目标是通过调整超参数数值来提高准确度，同时抵消 [**过拟合或欠拟合**](#overfitting-poor-generalization-too-specialized)。过拟合发生在模型记住训练数据时，这会损害其泛化到新的、未见过输入的能力。目标是得到一个泛化良好的模型，而不是一个只会死记硬背的模型。

{% columns %}
{% column %}

#### :question:但什么是 LoRA？

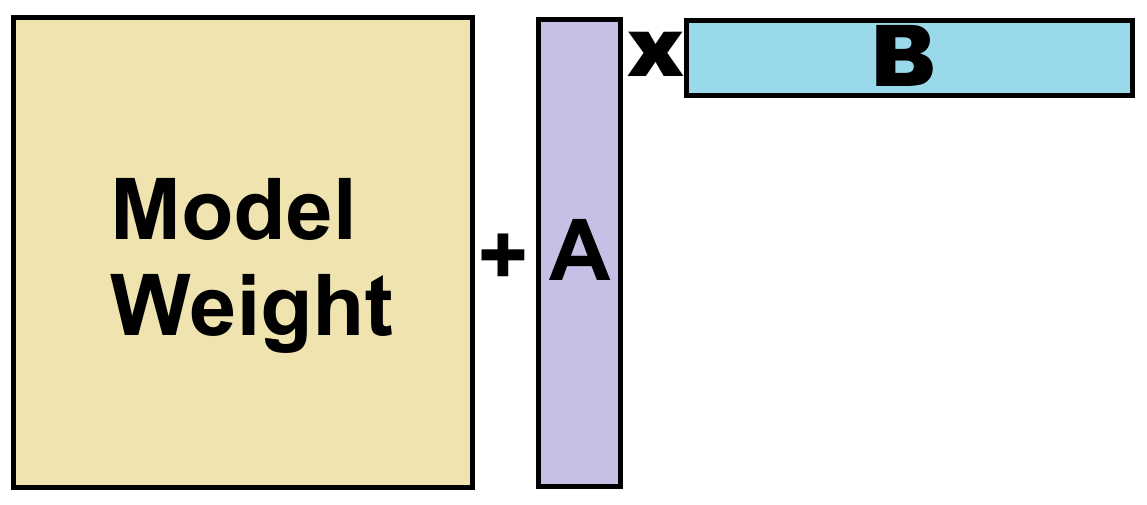
在 LLM 中，我们有模型权重。Llama 70B 有 700 亿个参数。我们不会去更改全部 700 亿个参数，而是为每个权重添加薄矩阵 A 和 B，并优化它们。这意味着我们只优化 1% 的权重。
{% endcolumn %}

{% column %}

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-715b6260aae497f160d7f9a1019bcfa472675dcf%2Fimage%20(7)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>我们不是优化模型权重（黄色部分），而是优化 2 个稀疏矩阵 A 和 B。</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

## :1234: 关键微调超参数

### **学习率**

定义模型权重在每个训练步骤中调整的幅度。

* **更高的学习率**：会带来更快的初始收敛，但如果设置得过高，训练可能会变得不稳定，甚至无法找到最优最小值。
* **更低的学习率**：会带来更稳定、更精确的训练，但可能需要更多轮数才能收敛，从而增加总训练时间。虽然较低的学习率通常被认为会导致欠拟合，但实际上它们也可能导致 **过拟合** ，甚至让模型无法学习。
* **典型范围**: `2e-4` （0.0002）到 `5e-6` (0.000005).\
  :green\_square: ***对于普通 LoRA/QLoRA 微调***, *我们建议* **`2e-4`** *作为起点。*\
  :blue\_square: ***对于强化学习** （DPO、GRPO 等），我们建议* **`5e-6` .**\
  :white\_large\_square: ***对于完整微调，** 较低的学习率通常更合适。*

### **轮数**

模型完整看到整个训练数据集的次数。

* **更多轮数：** 可以帮助模型学得更好，但轮数过多会导致它 **记住训练数据**，从而损害其在新任务上的表现。
* **更少轮数：** 会减少训练时间并可防止过拟合，但如果轮数不足以让模型学到数据集的底层模式，就可能导致模型训练不足。
* **推荐：** 1-3 轮。对于大多数基于指令的数据集，训练超过 3 轮的收益会递减，并增加过拟合风险。

### **LoRA 或 QLoRA**

LoRA 使用 16 位精度，而 QLoRA 是一种 4 位微调方法。

* **LoRA：** 16 位微调。它稍微更快一些，也稍微更准确一些，但会消耗明显更多的 VRAM（比 QLoRA 多 4 倍）。推荐用于 16 位环境以及对最高准确度有要求的场景。
* **QLoRA：** 4 位微调。稍慢一些，准确度也略低一些，但使用的 VRAM 少得多（少 4 倍）。\
  :sloth: *在 Unsloth 中，70B LLaMA 使用 QLoRA 可在 <48GB VRAM 中运行 -* [*更多细节见此*](https://unsloth.ai/blog/llama3-3)*.*

### 超参数与建议：

<table><thead><tr><th width="154.39678955078125">超参数</th><th width="383.6192626953125">功能</th><th>推荐设置</th></tr></thead><tbody><tr><td><strong>LoRA 秩</strong> (<code>r</code>)</td><td>控制 LoRA 适配器矩阵中可训练参数的数量。更高的秩会增加模型容量，但也会增加内存使用。</td><td>8、16、32、64、128<br><br>选择 16 或 32</td></tr><tr><td><strong>LoRA Alpha</strong> (<code>lora_alpha</code>)</td><td>按秩（<code>r</code>).</td><td><code>r</code> （标准）或 <code>r * 2</code> ）来缩放微调调整的强度。（常见经验法则）。 <a href="#lora-alpha-and-rank-relationship">更多细节见此</a>.</td></tr><tr><td><strong>LoRA Dropout</strong></td><td>一种正则化技术，在训练期间随机将一部分 LoRA 激活置零，以防止过拟合。 <strong>不是特别有用</strong>，所以我们默认将其设为 0。</td><td>0（默认）到 0.1</td></tr><tr><td><strong>权重衰减</strong></td><td>一种对大权重进行惩罚的正则项，可防止过拟合并提升泛化能力。不要使用太大的数值！</td><td>0.01（推荐）- 0.1</td></tr><tr><td><strong>预热步数</strong></td><td>在训练开始阶段逐渐提高学习率。</td><td>总步数的 5-10%</td></tr><tr><td><strong>调度器类型</strong></td><td>在训练过程中动态调整学习率。</td><td><code>线性</code> 或 <code>余弦</code></td></tr><tr><td><strong>种子（<code>random_state</code>)</strong></td><td>一个固定的数值，用于确保结果可复现。</td><td>任意整数（例如， <code>42</code>, <code>3407</code>)</td></tr><tr><td><strong>目标模块</strong></td><td><p>指定你想将 LoRA 适配器应用到模型的哪些部分——注意力、MLP，或者两者都用。</p><p><br>注意力： <code>q_proj, k_proj, v_proj, o_proj</code><br><br>MLP： <code>gate_proj, up_proj, down_proj</code></p></td><td>建议针对所有主要线性层： <code>q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj</code>.</td></tr></tbody></table>

## :deciduous\_tree: 梯度累积与批量大小等价性

### 有效批量大小

正确配置批量大小对于在训练稳定性与 GPU VRAM 限制之间取得平衡至关重要。这由两个参数共同管理，它们的乘积是 **有效批量大小**.\
\
**有效批量大小** = `batch_size * gradient_accumulation_steps`

* 一个 **更大的有效批量大小** 通常会带来更平滑、更稳定的训练。
* 一个 **更小的有效批量大小** 可能会引入更多方差。

虽然每个任务都不同，但以下配置是获得稳定的 **有效批量大小** 16 的有效批量大小，这对现代 GPU 上的大多数微调任务都很有效。

| 参数                                       | 描述                                                                                                                                   | 推荐设置                              |
| ---------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------ | --------------------------------- |
| **批次大小** (`batch_size`)                  | <p>在一张 GPU 上进行一次前向/反向传播时处理的样本数。<br><br><strong>VRAM 占用的主要驱动因素</strong>。更高的数值可以提高硬件利用率并加快训练，但前提是它们能放进显存。</p>                          | 2                                 |
| **梯度累积** (`gradient_accumulation_steps`) | <p>在进行一次模型权重更新之前要处理的微批次数。<br><br><strong>训练时间的主要驱动因素。</strong> 允许模拟更大的 <code>batch\_size</code> 以节省 VRAM。更高的数值会增加每个 epoch 的训练时间。</p> | 8                                 |
| **有效批量大小** （计算得出）                        | 用于每次梯度更新的真实批量大小。它会直接影响训练稳定性、质量以及最终模型表现。                                                                                              | <p>4 到 16<br>推荐：16（来自 2 \* 8）</p> |

### VRAM 与性能的权衡

假设你希望每个训练步骤使用 32 个样本的数据。那么你可以使用以下任一配置：

* `batch_size = 32, gradient_accumulation_steps = 1`
* `batch_size = 16, gradient_accumulation_steps = 2`
* `batch_size = 8, gradient_accumulation_steps = 4`
* `batch_size = 4, gradient_accumulation_steps = 8`
* `batch_size = 2, gradient_accumulation_steps = 16`
* `batch_size = 1, gradient_accumulation_steps = 32`

虽然这些配置对模型的权重更新来说是等价的，但它们对硬件的要求却大不相同。

第一种配置（`batch_size = 32`）会使用 **最多的 VRAM** ，并且很可能在大多数 GPU 上失败。最后一种配置（`batch_size = 1`）会使用 **最少的 VRAM，** 但代价是训练会稍微更&#x6162;**.** 为避免 OOM（内存溢出）错误，通常应优先设置更小的 `batch_size` 并增加 `gradient_accumulation_steps` 以达到你的目标 **有效批量大小**.

### :sloth: Unsloth 梯度累积修复

梯度累积和批量大小 <mark style="color:绿色;">**在 Unsloth 中现在完全等价**</mark> ，这是由于我们对梯度累积进行了 bug 修复。我们针对梯度累积实施了特定的 bug 修复，解决了一个常见问题：这两种方法过去不会产生相同的结果。这在更广泛的社区中一直是个已知挑战，但对 Unsloth 用户来说，这两种方法现在可以互换。

[阅读我们的博客文章](https://unsloth.ai/blog/gradient) 了解更多细节。

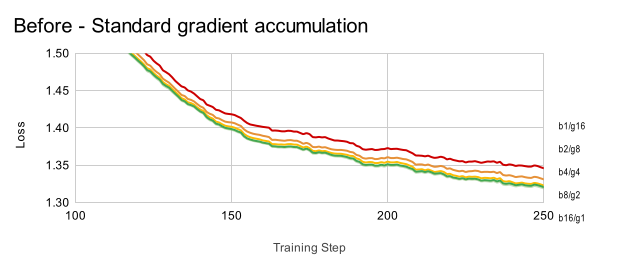
在我们修复之前，组合 `batch_size` 和 `gradient_accumulation_steps` 得到相同 **有效批量大小** （即， `batch_size × gradient_accumulation_steps = 16`）并不会产生等价的训练行为。例如，像 `b1/g16`, `b2/g8`, `b4/g4`, `b8/g2`，以及 `b16/g1` 都具有 **有效批量大小** 16，但如图所示，在使用标准梯度累积时，损失曲线并未对齐：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-66eb907fd9ce38ab29dacef82794d0525057aeb4%2FBefore_-_Standard_gradient_accumulation_UQOFkUggudXuV9dzrh8MA.svg?alt=media" alt=""><figcaption><p>（之前 - 标准梯度累积）</p></figcaption></figure>

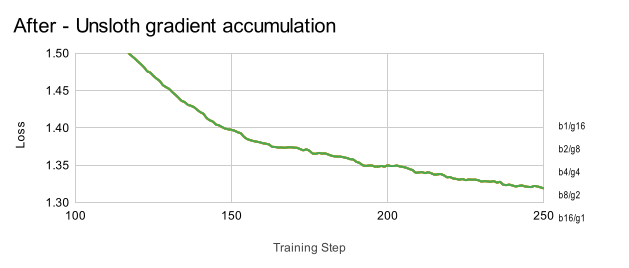
应用我们的修复后，损失曲线现在能够正确对齐，不管 **有效批量大小** 16 是如何实现的：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-61f7c60412a2a39584f75cce5dca41e3e35eb7f2%2FAfter_-_Unsloth_gradient_accumulation_6Y4pJdJF0vruzradUpymY.svg?alt=media" alt=""><figcaption><p>（之后 - 🦥 <mark style="color:绿色;">Unsloth 梯度累积</mark>)</p></figcaption></figure>

## 🦥 **Unsloth 中的 LoRA 超参数**

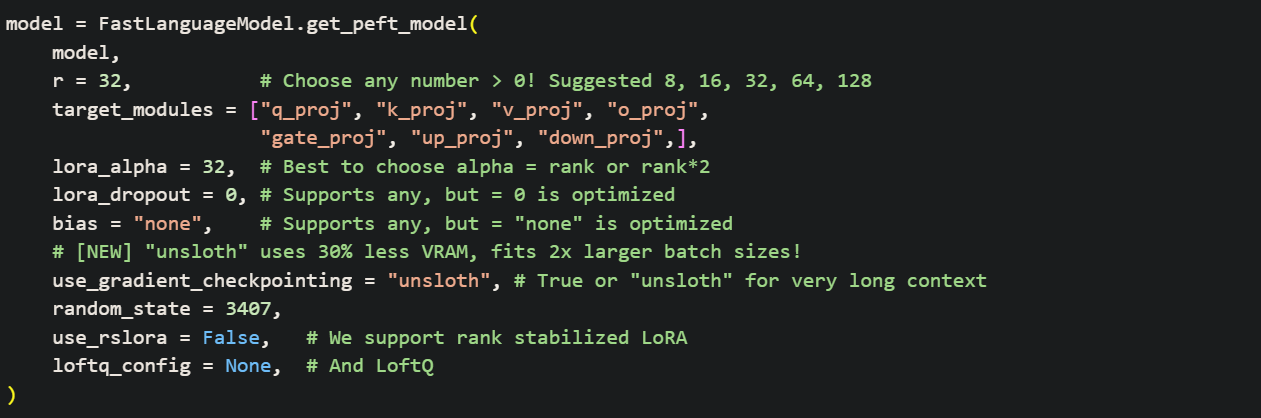
以下展示的是标准配置。 **虽然 Unsloth 提供了优化后的默认值**，但理解这些参数是手动调优的关键。

<div data-full-width="false"><figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-9843f8cc26aac6445236250f5c32394186eace59%2Fnotebook_parameter_screenshott.png?alt=media" alt=""><figcaption></figcaption></figure></div>

1. ```python
   r = 16, # 选择任何大于 0 的数！建议 8、16、32、64、128
   ```

   秩（`r`）用于微调过程。更高的秩会占用更多内存并且更慢，但能在复杂任务上提高准确度。我们建议使用 8 或 16 这样的秩（用于快速微调），最高可到 128。使用过大的秩可能会导致过拟合并损害模型质量。\\
2. ```python
   target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj"，"up_proj"，"down_proj"，]
   ```

   为了获得最佳性能， <mark style="background-color:blue;">**LoRA 应应用于所有主要线性层**</mark>. [研究表明](#lora-target-modules-and-qlora-vs-lora) 定位所有主要层对于达到完整微调的性能至关重要。虽然可以移除某些模块以减少内存使用，但我们强烈不建议这样做，因为节省非常有限，而对保持最高质量更为重要。\\
3. ```python
   lora_alpha = 16,
   ```

   一个缩放因子，用于控制微调调整的强度。将其设为秩（`r`）是一个可靠的基线。一个流行且有效的经验法则是将其设为秩的两倍（`r * 2`），这样会让模型学习得更积极，因为会给予 LoRA 更新更高的权重。 [更多细节见此](#lora-alpha-and-rank-relationship)。\\
4. ```python
   lora_dropout = 0, # 支持任意值，但 = 0 时经过优化
   ```

   一种有助于 [防止过拟合](#overfitting-poor-generalization-too-specialized) ，方法是在每个训练步骤中随机将一部分 LoRA 激活置零。 [最新研究表明](https://arxiv.org/abs/2410.09692) 对于 **短训练过程** （这在微调中很常见）， `lora_dropout` 可能不是一个可靠的正则化器。\
   🦥 *当* `lora_dropout = 0`*时，Unsloth 的内部代码可以优化训练，从而略微加快速度，但如果你怀疑存在过拟合，我们建议使用非零值。*\\\\
5. ```python
   bias = "none",    # 支持任意值，但 = "none" 时经过优化
   ```

   将其保持为 `“none”` 以获得更快的训练和更少的内存使用。此设置会避免训练线性层中的偏置项，这会增加可训练参数，但几乎没有实际收益。\\
6. ```python
   use_gradient_checkpointing = "unsloth", # 对于超长上下文可设为 True 或 “unsloth”
   ```

   可选项有 `真`, `假`，以及 `"unsloth"`。\
   🦥 *我们建议* `"unsloth"` *它可额外减少 30% 的内存使用，并支持极长上下文的微调。你可以在以下内容中了解更多：* [*我们关于长上下文训练的博客文章*](https://unsloth.ai/blog/long-context)*.*\\\\
7. ```python
   random_state = 3407,
   ```

   用于确保确定性、可复现运行的种子。训练涉及随机数，因此设置固定种子对于保持实验一致性至关重要。\\
8. ```python
   use_rslora = False,  # 我们支持秩稳定 LoRA
   ```

   一项实现以下功能的高级特性 [**秩稳定 LoRA**](https://arxiv.org/abs/2312.03732)。如果设置为 `真`，有效缩放将变为 `lora_alpha / sqrt(r)` 而不是标准的 `lora_alpha / r`。这有时可以提高稳定性，尤其是在较高秩时。 [更多细节见此](#lora-alpha-and-rank-relationship)。\\
9. ```python
   loftq_config = None, # 以及 LoftQ
   ```

   一种高级技术，如以下工作所提出： [**LoftQ**](https://arxiv.org/abs/2310.08659)，使用预训练权重中排名前 'r' 的奇异向量初始化 LoRA 矩阵。这可以提高准确度，但可能会在训练开始时造成显著的内存峰值。

### **验证 LoRA 权重更新：**

在验证 **LoRA** 适配器权重在微调后已更新时，避免使用 **np.allclose()** 进行比较。此方法可能会错过细微但有意义的变化，尤其是在 **LoRA A**，其初始化为较小的高斯值。在宽松的数值容差下，这些变化可能不会被视为显著。感谢 [贡献者](https://github.com/unslothai/unsloth/issues/3035) 对本节的贡献。

为了可靠地确认权重更新，我们建议：

* 使用 **校验和或哈希比较** （例如 MD5）
* 计算 **绝对差值之和** ，比较张量之间
* 检查 t**ensor 统计信息** （例如，均值、方差）并手动检查
* 或者使用 **np.array\_equal()** 如果预期完全相等

## :triangular\_ruler:LoRA Alpha 与秩的关系

{% hint style="success" %}
最好将 `lora_alpha = 2 * lora_rank` 或 `lora_alpha = lora_rank`
{% endhint %}

{% columns %}
{% column width="50%" %}
$$
\hat{W} = W + \frac{\alpha}{\text{rank}} \times AB
$$

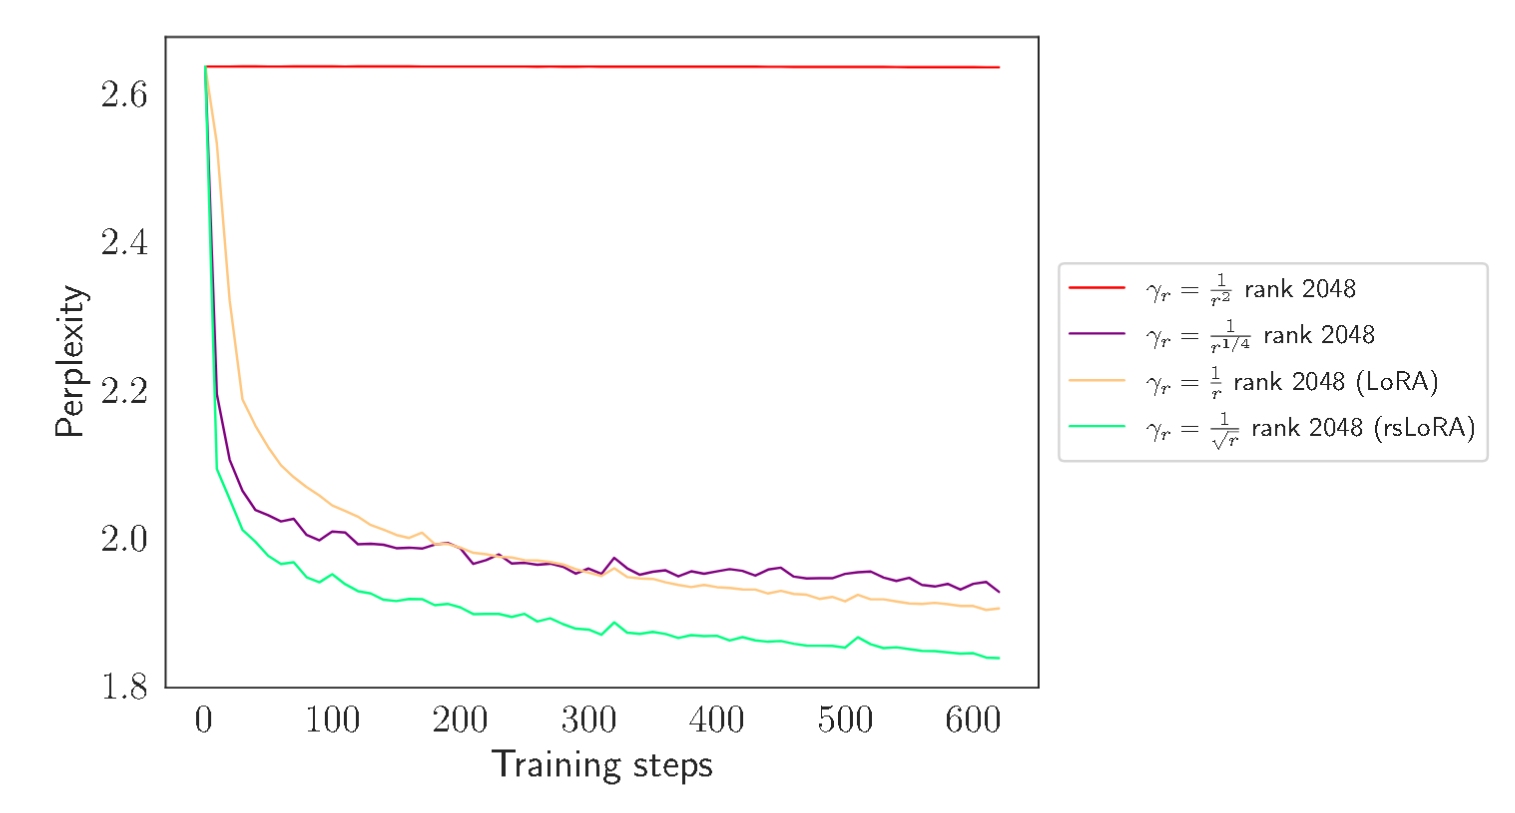
<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8e4f60c002f22e8ca9c534b48323e9e77e4b5ea6%2Fimage.png?alt=media" alt=""><figcaption><p>rsLoRA 还有其他缩放选项。sqrt(r) 是最佳选择。</p></figcaption></figure>

$$
\hat{W}\_{\text{rslora}} = W + \frac{\alpha}{\sqrt{\text{rank}}} \times AB
$$
{% endcolumn %}

{% column %}
左侧是 LoRA 的公式。我们需要用 alpha 除以秩来缩放这两个薄矩阵 A 和 B。 <mark style="background-color:blue;">**这意味着我们应将 alpha/rank 至少保持为 1**</mark>.

根据 [rsLoRA（秩稳定 LoRA）论文](https://arxiv.org/abs/2312.03732)，我们应当改为用秩的平方根来缩放 alpha。虽然还有其他选项，但从理论上这才是最优的。左侧图展示了其他秩及其困惑度（越低越好）。要启用此功能，请设置 `use_rslora = True` 在 Unsloth 中。

我们的建议是将 <mark style="background-color:green;">**alpha 设为与秩相等，或者至少是秩的 2 倍。**</mark> 这意味着 alpha/rank = 1 或 2。
{% endcolumn %}
{% endcolumns %}

## :dart: LoRA 目标模块以及 QLoRA 与 LoRA

{% hint style="success" %}
使用：\
`target_modules = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj",]` 以同时针对 **MLP** 和 **注意力** 层，以提高准确度。

**QLoRA 使用 4 位精度**，使 VRAM 使用量减少超过 75%。

**LoRA（16 位）** 稍微更准确，也更快。
{% endhint %}

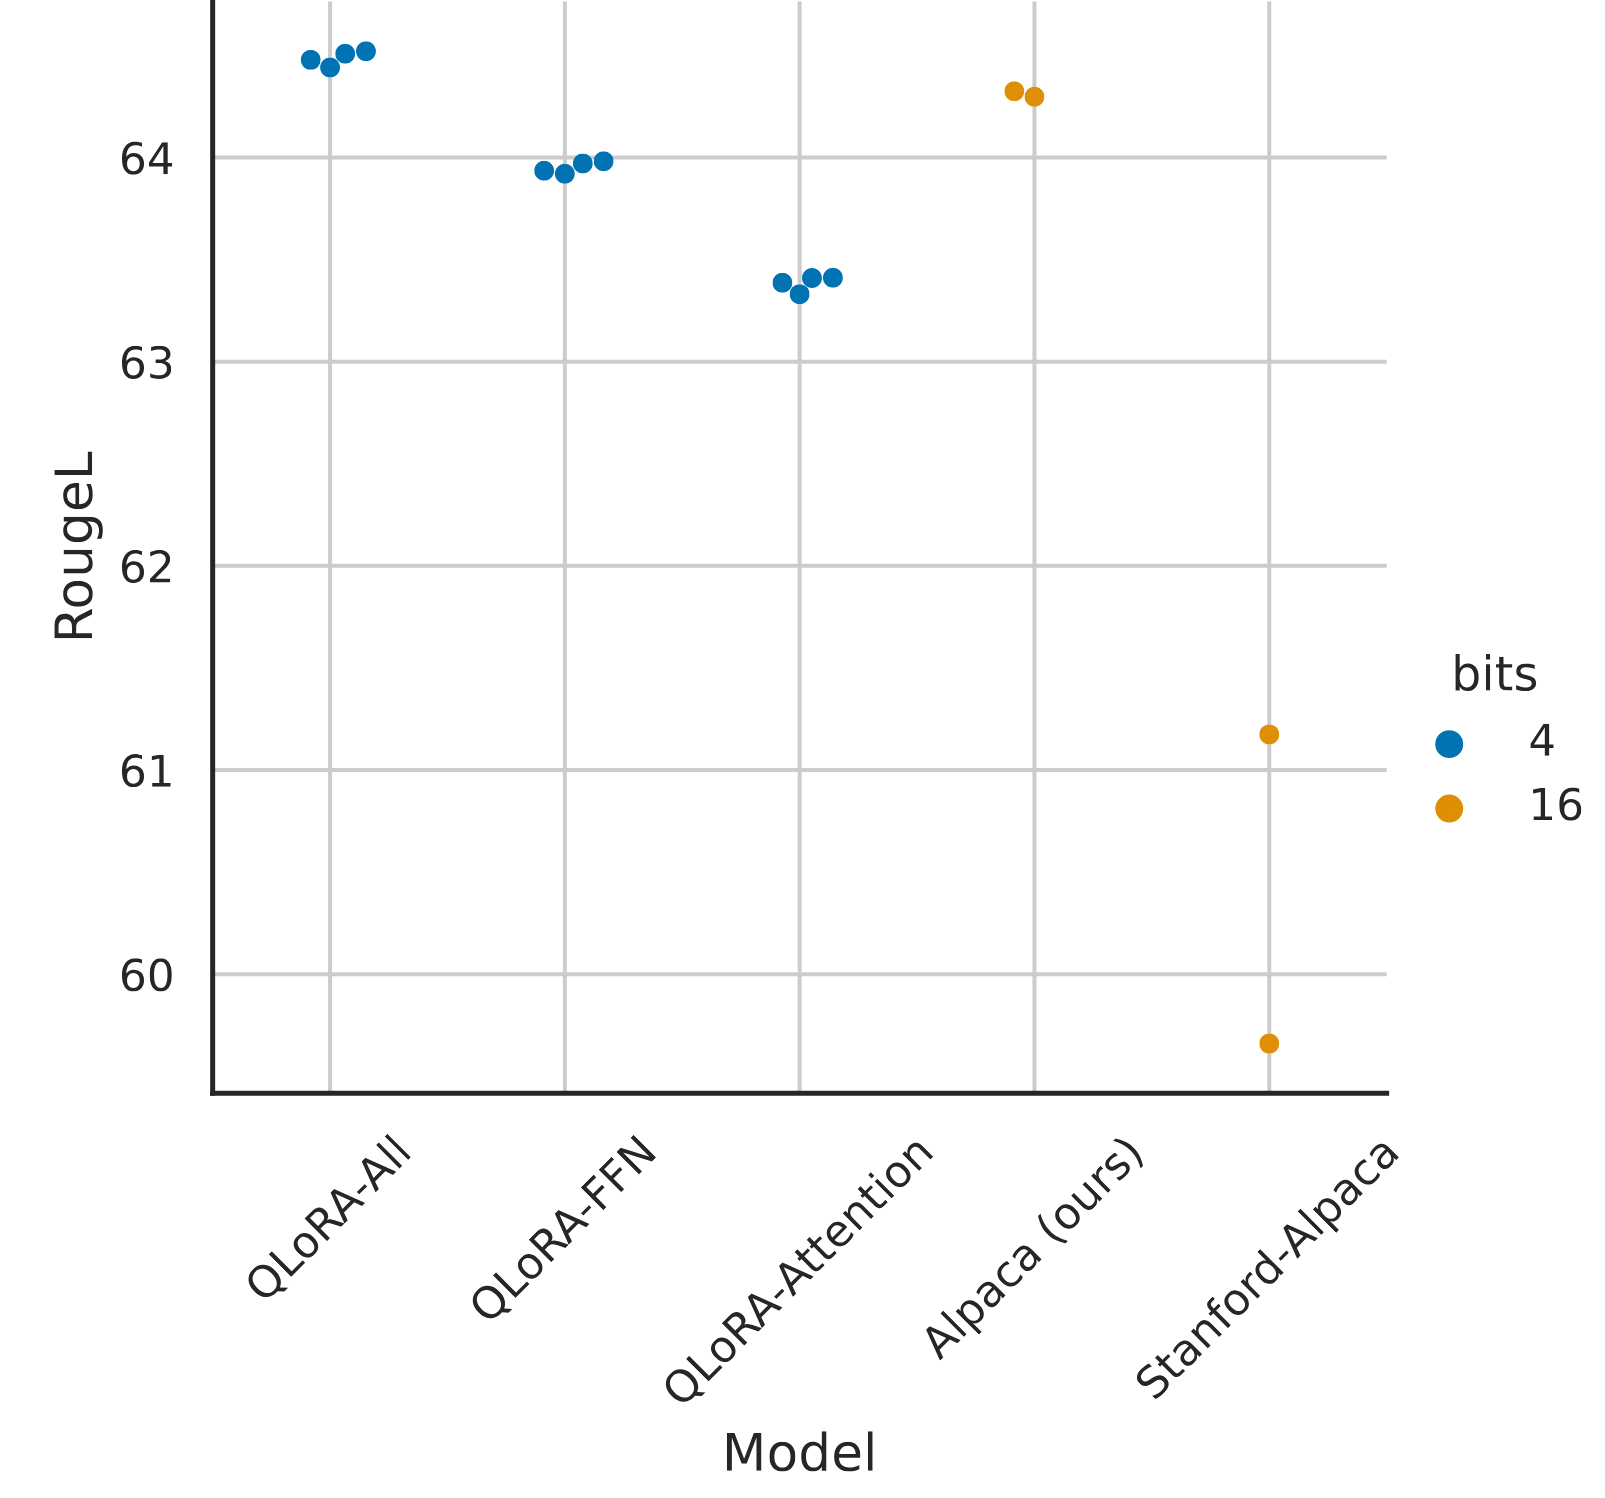
根据经验实验以及原始论文等研究文献 [QLoRA 论文](https://arxiv.org/pdf/2305.14314)，最好将 LoRA 同时应用于注意力层和 MLP 层。

{% columns %}
{% column %}

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-16bef8165ccace21d0533f1941b8268a165c6a37%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
该图展示了不同目标模块配置下的 RougeL 分数（越高越好），比较了 LoRA 与 QLoRA。

前 3 个点显示：

1. **QLoRA-All：** 将 LoRA 应用于所有 FFN/MLP 和注意力层。\
   :fire: *这在整体上表现最好。*
2. **QLoRA-FFN**：仅在 FFN 上应用 LoRA。\
   等同于： `gate_proj`, `up_proj`, `down_proj。`
3. **QLoRA-Attention**：仅将 LoRA 应用于注意力层。\
   等同于： `q_proj`, `k_proj`, `v_proj`, `o_proj`.
   {% endcolumn %}
   {% endcolumns %}

## :sunglasses: 仅在补全内容上训练，屏蔽输入

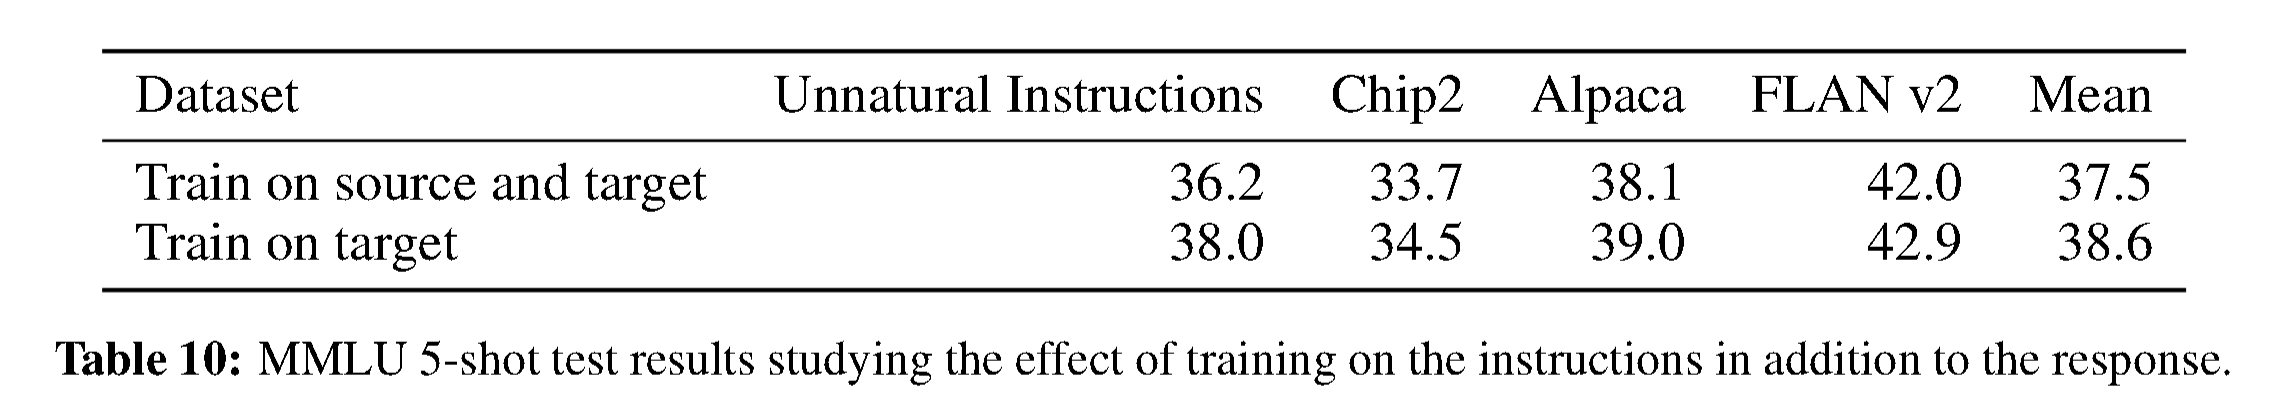
“ [QLoRA 论文](https://arxiv.org/pdf/2305.14314) 表明屏蔽输入并 **仅在补全内容上训练** （输出或助手消息）可以进一步 **提高准确度** 几个百分点（*1%*）。下面演示在 Unsloth 中如何实现：

{% columns %}
{% column %}
**不是** 仅在补全内容上训练：

**用户：** <mark style="background-color:green;">你好，2+2 等于多少？</mark>\
**助手：** <mark style="background-color:green;">答案是 4。</mark>\
**用户：** <mark style="background-color:green;">你好，3+3 等于多少？</mark>\
**助手：** <mark style="background-color:green;">答案是 6。</mark>
{% endcolumn %}

{% column %}
**训练** 仅在补全内容上：

**用户：** ~~你好，2+2 等于多少？~~\
**助手：** <mark style="background-color:green;">答案是 4。</mark>\
**用户：** ~~你好，3+3 等于多少？~~\
**助手：** <mark style="background-color:green;">答案是 6</mark><mark style="background-color:green;">**.**</mark>
{% endcolumn %}
{% endcolumns %}

QLoRA 论文指出 **仅在补全内容上训练** 可以显著提高准确度，尤其是多轮对话微调！我们在以下内容中这样做： [这里的对话笔记本](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(1B_and_3B\)-Conversational.ipynb).

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e73b480d1db1dd3d52dd0d4a7e24caff6a54be0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

为启用 **在补全内容上训练** 在 Unsloth 中，你需要定义指令部分和助手部分。 :sloth: *我们计划未来进一步为你自动化这一过程！*

对于 Llama 3、3.1、3.2、3.3 和 4 模型，你可以按如下方式定义这些部分：

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
)
```

对于 Gemma 2、3、3n 模型，你可以按如下方式定义这些部分：

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<start_of_turn>user\n",
    response_part = "<start_of_turn>model\n",
)
```

## &#x20;:mag\_right:仅对视觉模型、VLM 训练助手回复

对于语言模型，我们可以使用 `from unsloth.chat_templates import train_on_responses_only` 如前所述。对于视觉模型，请将额外参数作为 `UnslothVisionDataCollator` 的一部分，就像之前一样！

{% code overflow="wrap" %}

```python
class UnslothVisionDataCollator:
def __init__(
    self,
    ...
    # from unsloth.chat_templates import train_on_responses_only
    # trainer = train_on_responses_only(
    #     trainer,
    #     instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    #     response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    # )
    train_on_responses_only = False, # 对于 LLM 来说等同于 train_on_responses_only
    instruction_part = None, # 等同于 train_on_responses_only(instruction_part = ...)
    response_part    = None, # 等同于 train_on_responses_only(response_part = ...)
    force_match      = True, # 也匹配换行符！
)
```

{% endcode %}

例如，针对 Llama 3.2 Vision：

```python
UnslothVisionDataCollator(
    model, tokenizer,
    ...
    train_on_responses_only = True,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    ...
)
```

## :key: **避免过拟合与欠拟合**

### **过拟合** （泛化能力差/过于专门化）

模型记住了训练数据，包括其中的统计噪声，因此无法泛化到未见过的数据。

{% hint style="success" %}
如果你的训练损失降到 0.2 以下，你的模型很可能 **过拟合** ——这意味着它在未见任务上的表现可能会很差。

一个简单的技巧是 LoRA alpha 缩放——只需将每个 LoRA 矩阵的 alpha 值乘以 0.5。这实际上会降低微调的影响。

**这与合并/平均权重密切相关。**\
你可以取原始基础（或 instruct）模型，加入 LoRA 权重，然后将结果除以 2。这样你就得到了一个平均模型——其功能上等同于将 `alpha` 减半。
{% endhint %}

**解决方案：**

* **调整学习率：** 较高的学习率通常会导致过拟合，尤其是在较短的训练过程中。对于更长时间的训练，更高的学习率可能更有效。最好同时尝试两者，看看哪个效果最好。
* **减少训练轮数**。在 1、2 或 3 个 epoch 后停止训练。
* **增加** `weight_decay`。一个 `0.01` 或 `0.1` 是一个不错的起点。
* **增加** `lora_dropout`。使用类似 `0.1` 来增加正则化。
* **增加 batch size 或梯度累积步数**.
* **数据集扩充** - 通过将开源数据集与您的数据集合并或拼接来扩大数据集。选择质量更高的数据集。
* **评估早停** - 启用评估，并在评估损失连续几步上升时停止。
* **LoRA Alpha 缩放** - 在训练后和推理期间降低 alpha 的比例——这会让微调效果不那么明显。
* **权重平均** - 直接将原始 instruct 模型与微调模型相加，然后将权重除以 2。

### **欠拟合** （过于通用）

模型无法捕捉训练数据中的底层模式，通常是由于复杂度不足或训练时长不够。

**解决方案：**

* **调整学习率：** 如果当前学习率太低，提高它可能会加快收敛，尤其适用于短训练过程。对于更长的训练，则尝试降低学习率。测试两种方法，看看哪种效果最好。
* **增加训练轮数：** 训练更多轮，但要监控验证损失以避免过拟合。
* **提高 LoRA Rank** (`r`）和 alpha：Rank 至少应等于 alpha 的数值，而且对于更小的模型/更复杂的数据集，rank 应该更大；通常介于 4 到 64 之间。
* **使用更贴合领域的数据集**：确保训练数据高质量，并且与目标任务直接相关。
* **将 batch size 降到 1**。这将使模型更新得更积极。

{% hint style="success" %}
微调没有唯一“最佳”的方法，只有最佳实践。实验是找到适合你特定需求的方案的关键。我们的 notebook 会根据大量论文研究和我们的实验自动设置最优参数，为你提供一个很好的起点。祝你微调愉快！
{% endhint %}

***致谢：** 衷心感谢* [*Eyera*](https://huggingface.co/Orenguteng) *为本指南做出的贡献！*


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/lora-hyperparameters-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.