> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/tutorial-how-to-finetune-llama-3-and-use-in-ollama.md).

# 教程：如何微调 Llama-3 并在 Ollama 中使用

面向初学者的指南，用于创建可在 Ollama 上本地运行的个性化个人助手（类似 ChatGPT）

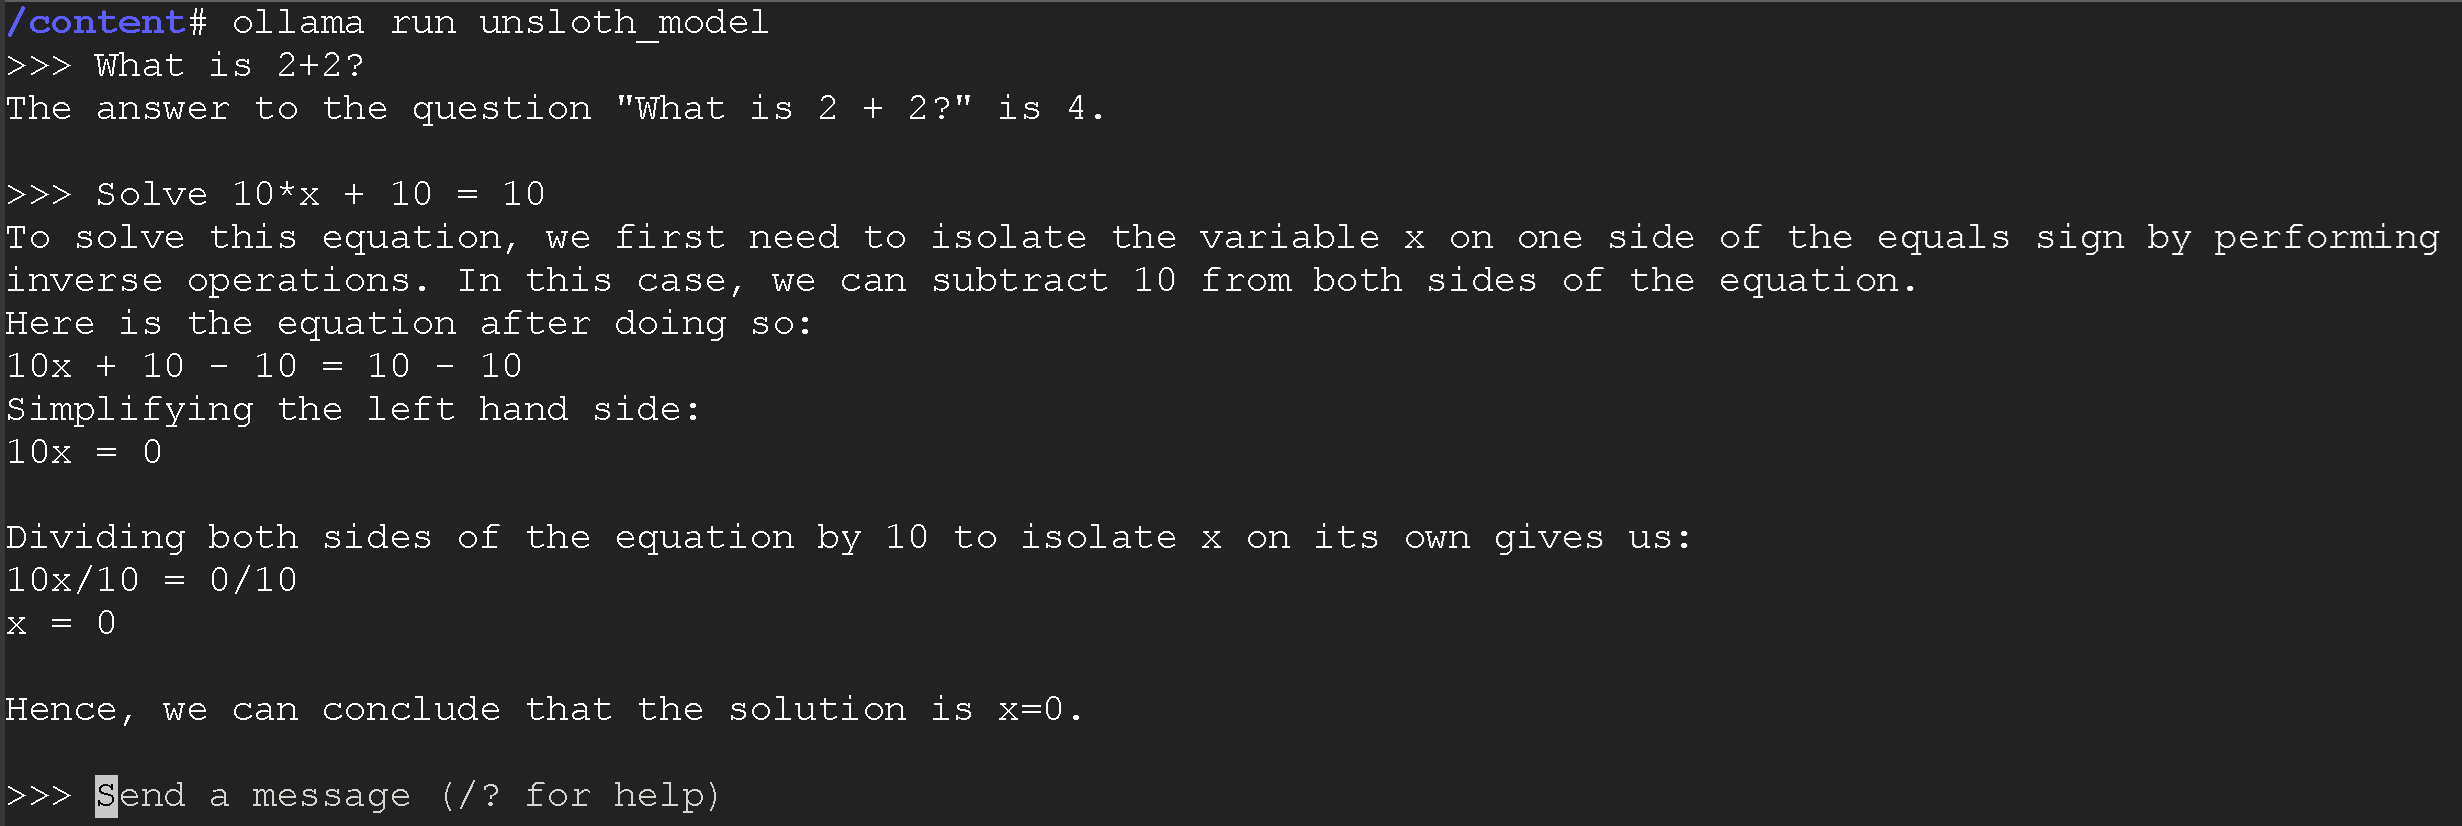
在本教程结束时，你将通过……创建一个自定义聊天机器人 **微调 Llama-3** 替换为 [**Unsloth**](https://github.com/unslothai/unsloth) 免费使用。它可以通过……在本地运行 [**Ollama**](https://github.com/ollama/ollama) 在你的电脑上，或通过……在免费的 GPU 实例中运行 [**Google Colab**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb)。你将能够像下面这样与聊天机器人进行交互：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cf9aed2029e54afbb65889b480134e6d5e1cf3a7%2FAssistant%20example.png?alt=media" alt=""><figcaption></figcaption></figure>

**Unsloth** 使微调变得容易得多，并且可以自动将微调后的模型导出到 **Ollama** 带有集成的自动 `Modelfile` 创建！如果你需要帮助，可以加入我们的 Discord 服务器： <https://discord.com/invite/unsloth>

{% hint style="warning" %}
**如果你想复制或保存代码，所有内容都可在我们的** [**Ollama Colab 笔记本**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb)**。你可以直接在那里使用，也可以将其调整为你的本地环境：** [**https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3\_(8B)-Ollama.ipynb**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb)
{% endhint %}

## 1. 什么是 Unsloth？

[Unsloth](https://github.com/unslothai/unsloth) 使对 Llama-3、Mistral、Phi-3 和 Gemma 等大语言模型的微调速度提升 2 倍，内存占用减少 70%，且准确率没有下降！本教程中我们将使用 Google Colab，它提供免费的 GPU。你可以在下面访问我们的免费笔记本：

* [Ollama Llama-3 Alpaca](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3_\(8B\)-Ollama.ipynb) （我们将使用的笔记本）
* [CSV/Excel Ollama 指南](https://colab.research.google.com/drive/1VYkncZMfGFkeCEgN2IzbZIKEDkyQuJAS?usp=sharing)

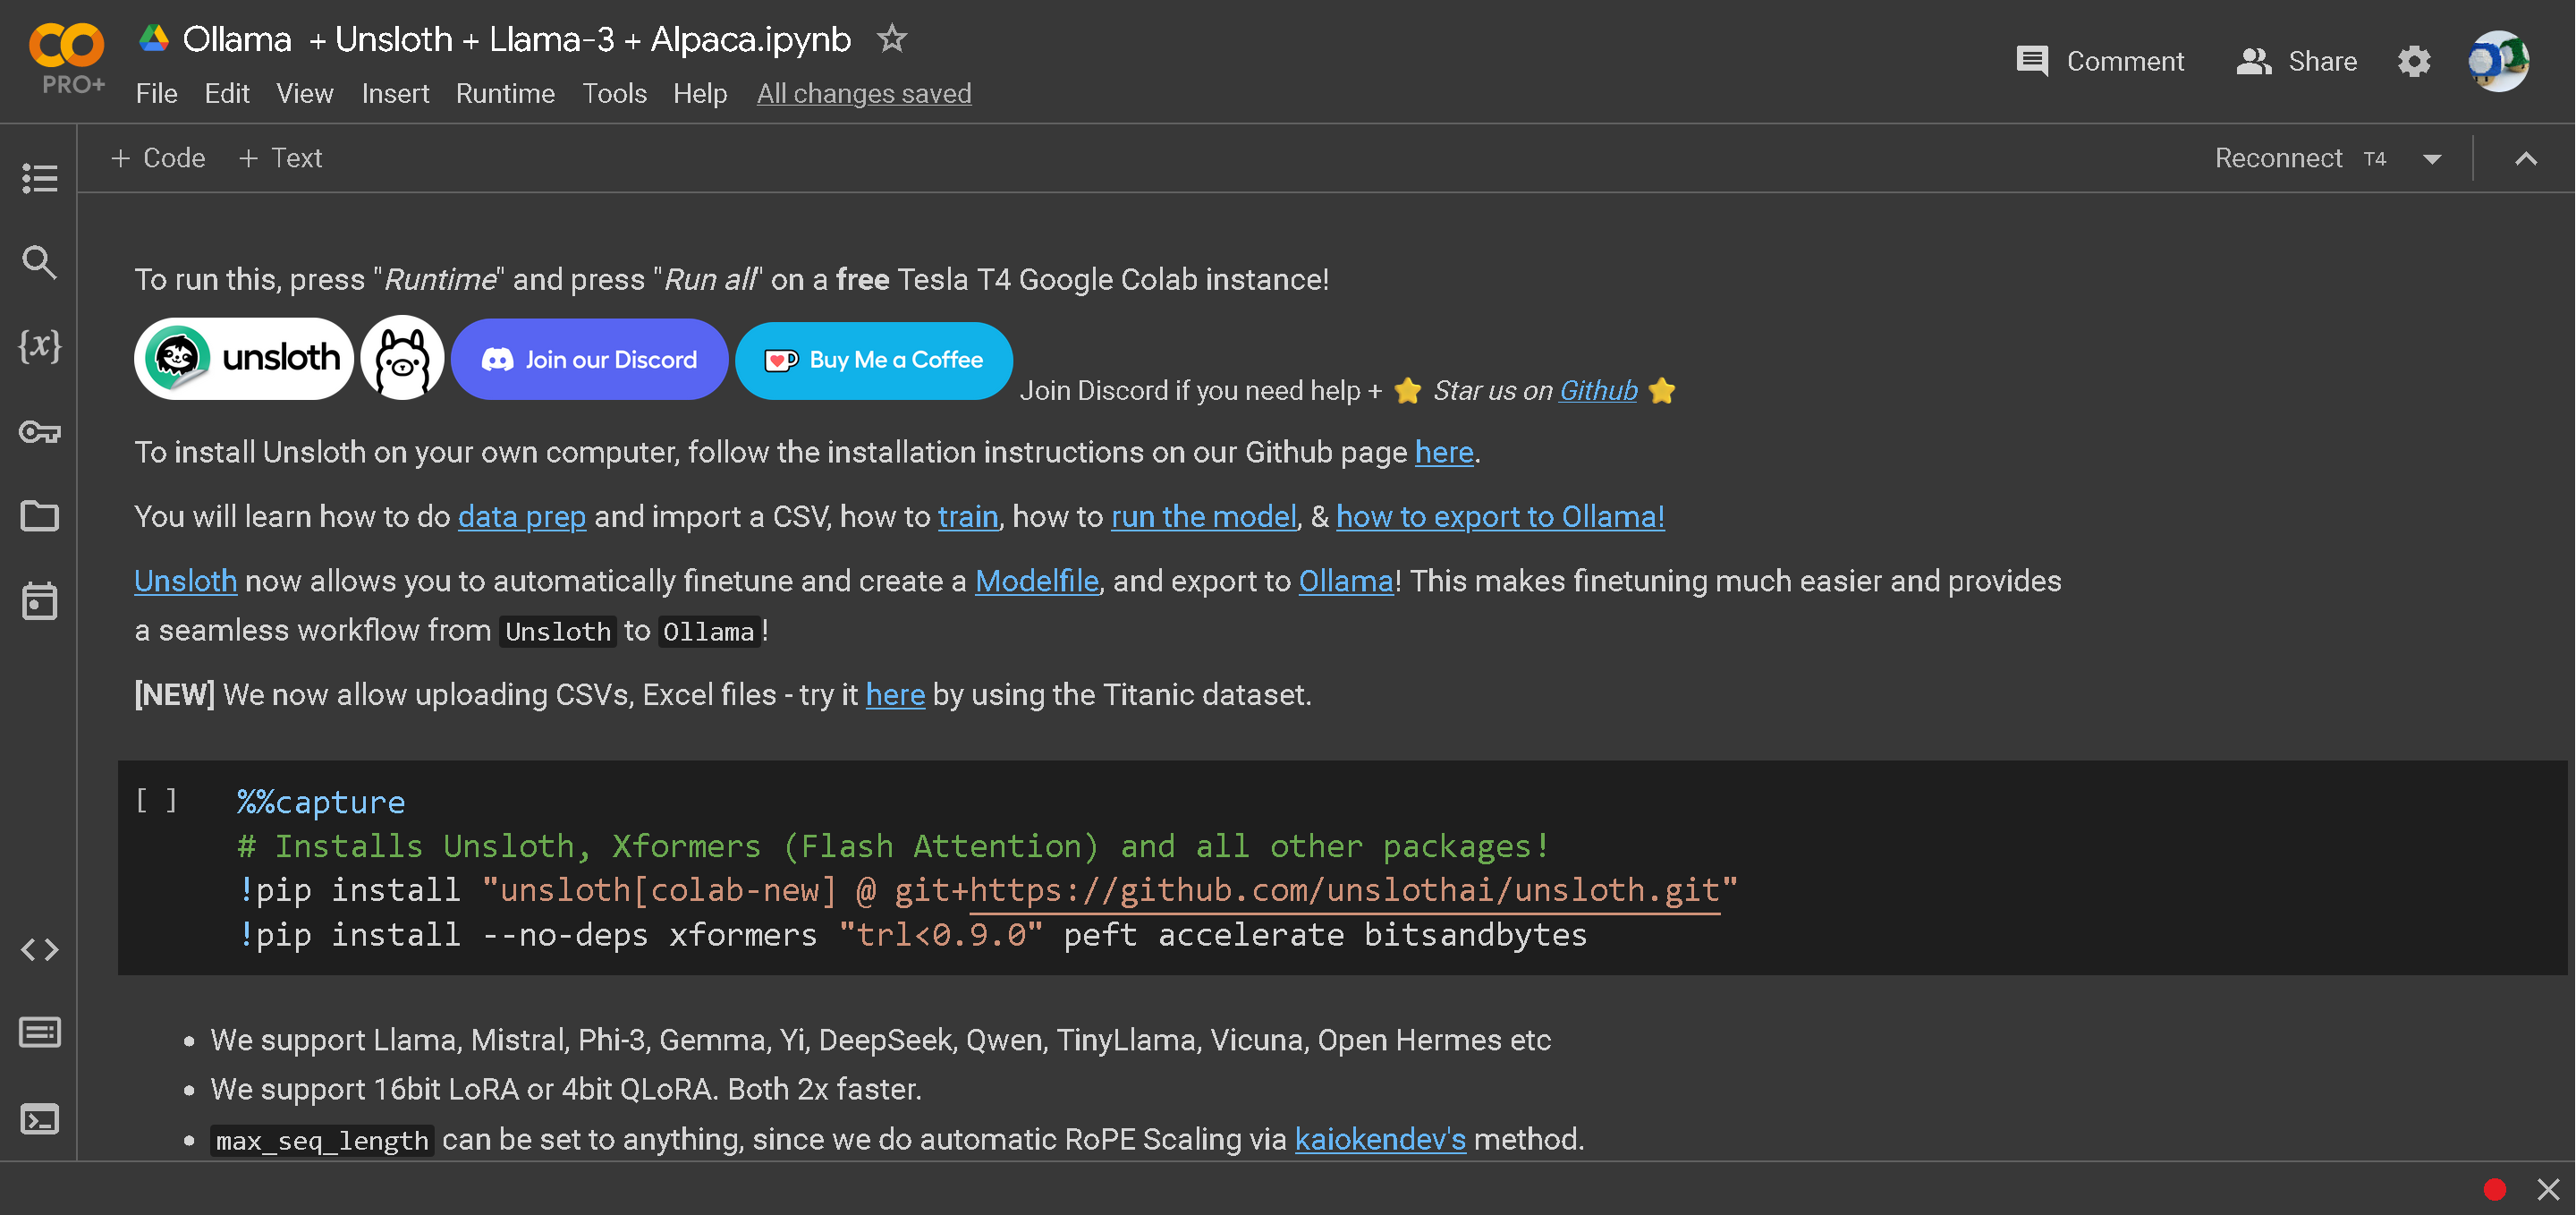
#### ***你还需要登录你的 Google 账号！***

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-bca149bda83c2192982b136cfeb096999c469a2e%2FColab%20Screen.png?alt=media" alt=""><figcaption></figcaption></figure>

## 2. 什么是 Ollama？

[Ollama ](https://github.com/ollama/ollama)让你能够以快速而简单的方式在自己的电脑上运行语言模型！它会静默启动一个程序，在后台运行像 Llama-3 这样的语言模型。如果你突然想向语言模型提问，只需向 Ollama 提交请求，它就会快速把结果返回给你！我们将把 Ollama 作为推理引擎！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-fd25844766001d93ed0949fc8f57957f49b1e6e5%2FOllama.png?alt=media" alt=""><figcaption></figcaption></figure>

## 3. 安装 Unsloth

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-4d1b1778f3c8bde62a40130d7b4395b8bb1ce90f%2FColab%20Options.png?alt=media" alt=""><figcaption></figcaption></figure>

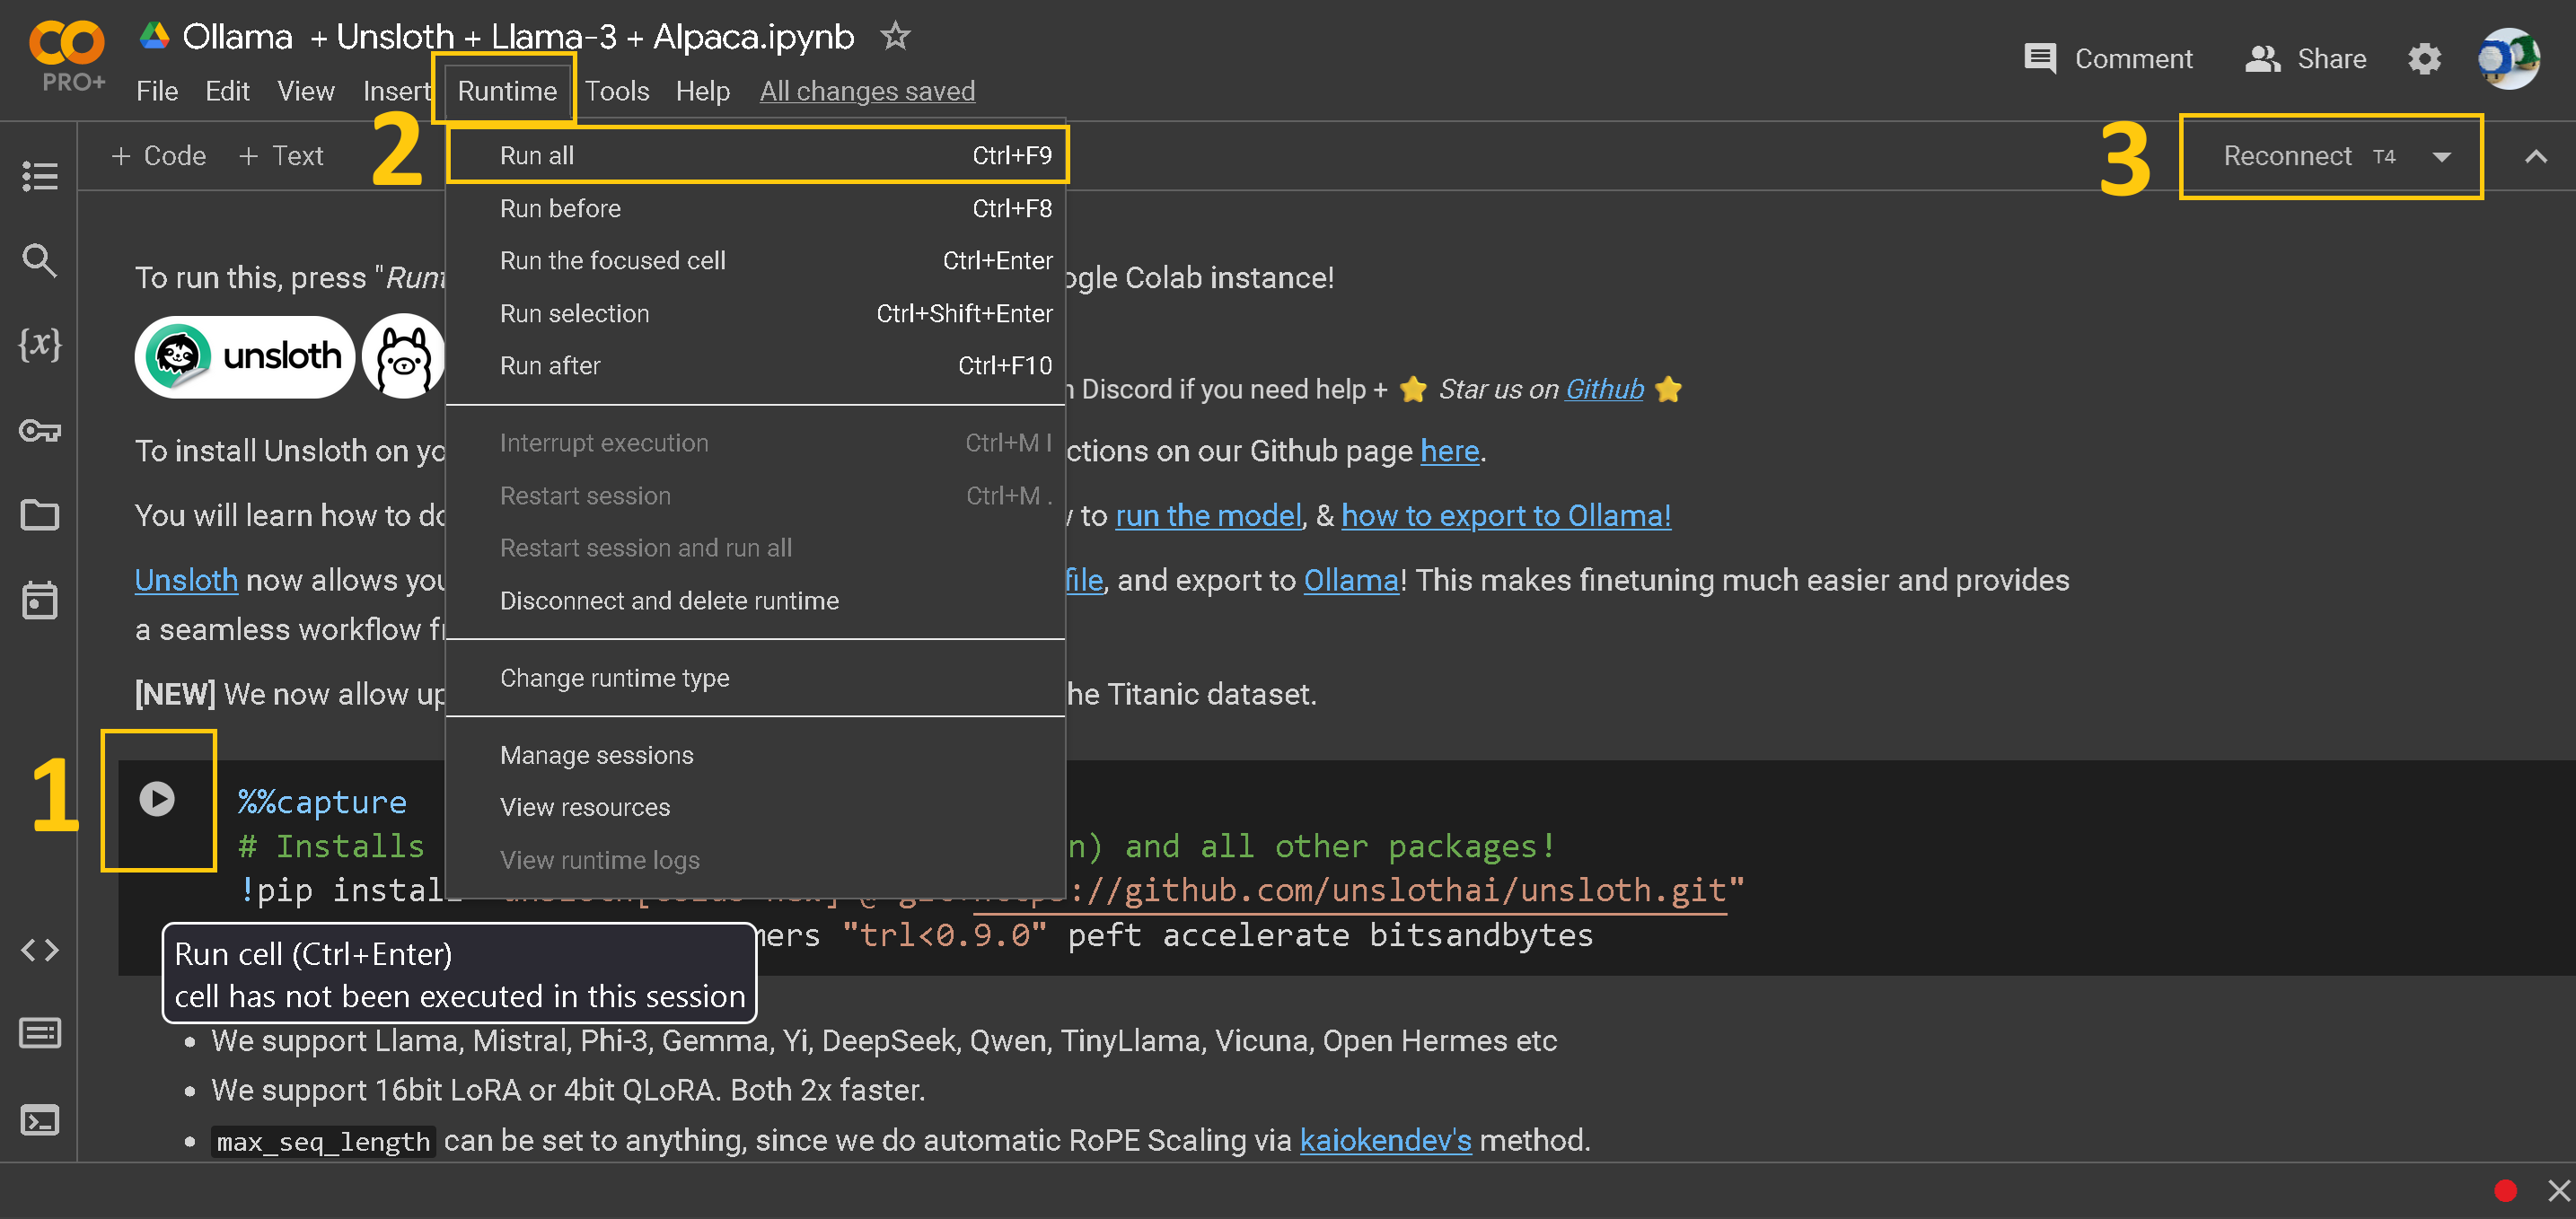
如果你从未使用过 Colab 笔记本，先快速了解一下笔记本本身：

1. **每个“单元”旁边的播放按钮。** 点击它即可运行该单元的代码。你不能跳过任何单元，并且必须按顺序运行每个单元。如果遇到任何错误，只需重新运行之前未运行的单元。另一个选择是如果你不想点击播放按钮，可以按 CTRL + ENTER。
2. **顶部工具栏中的运行时按钮。** 你也可以使用这个按钮并点击“全部运行”，一次性运行整个笔记本。这会跳过所有自定义步骤，作为第一次尝试也不错。
3. **连接 / 重新连接 T4 按钮。** 你可以在这里查看更多高级系统统计信息。

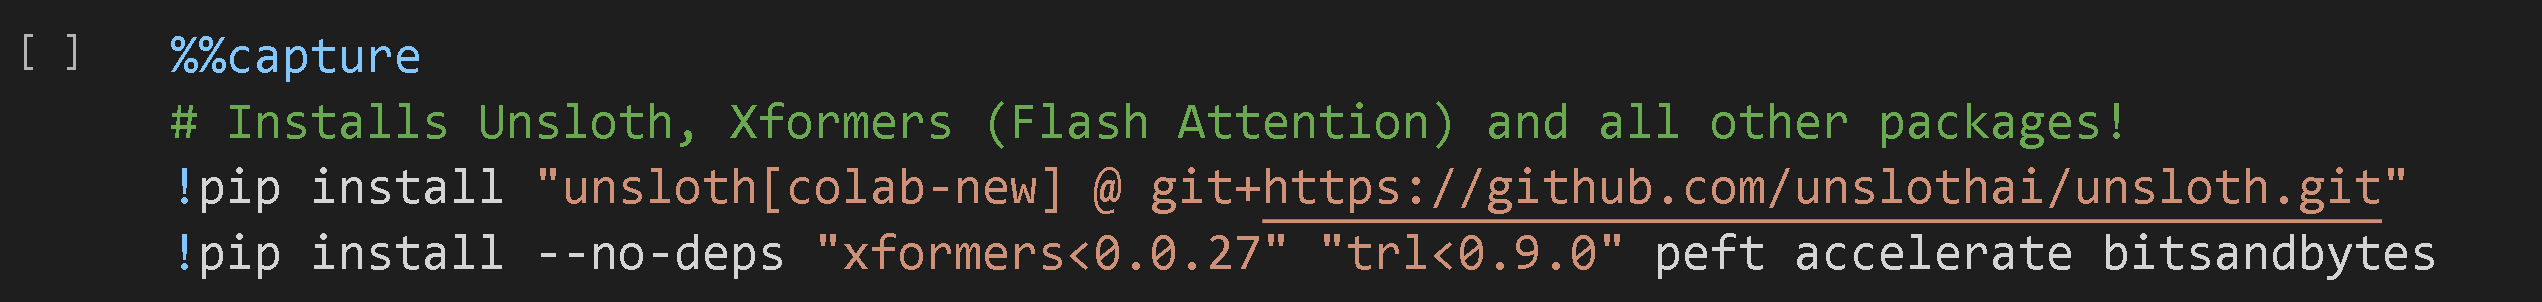
第一个安装单元如下所示：记得点击方括号 \[ ] 中的 PLAY 按钮。我们会获取开源的 GitHub 包，并安装其他一些包。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-3ae88d2cf9ba1c59b13d701864750ac311a60426%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 4. 选择要微调的模型

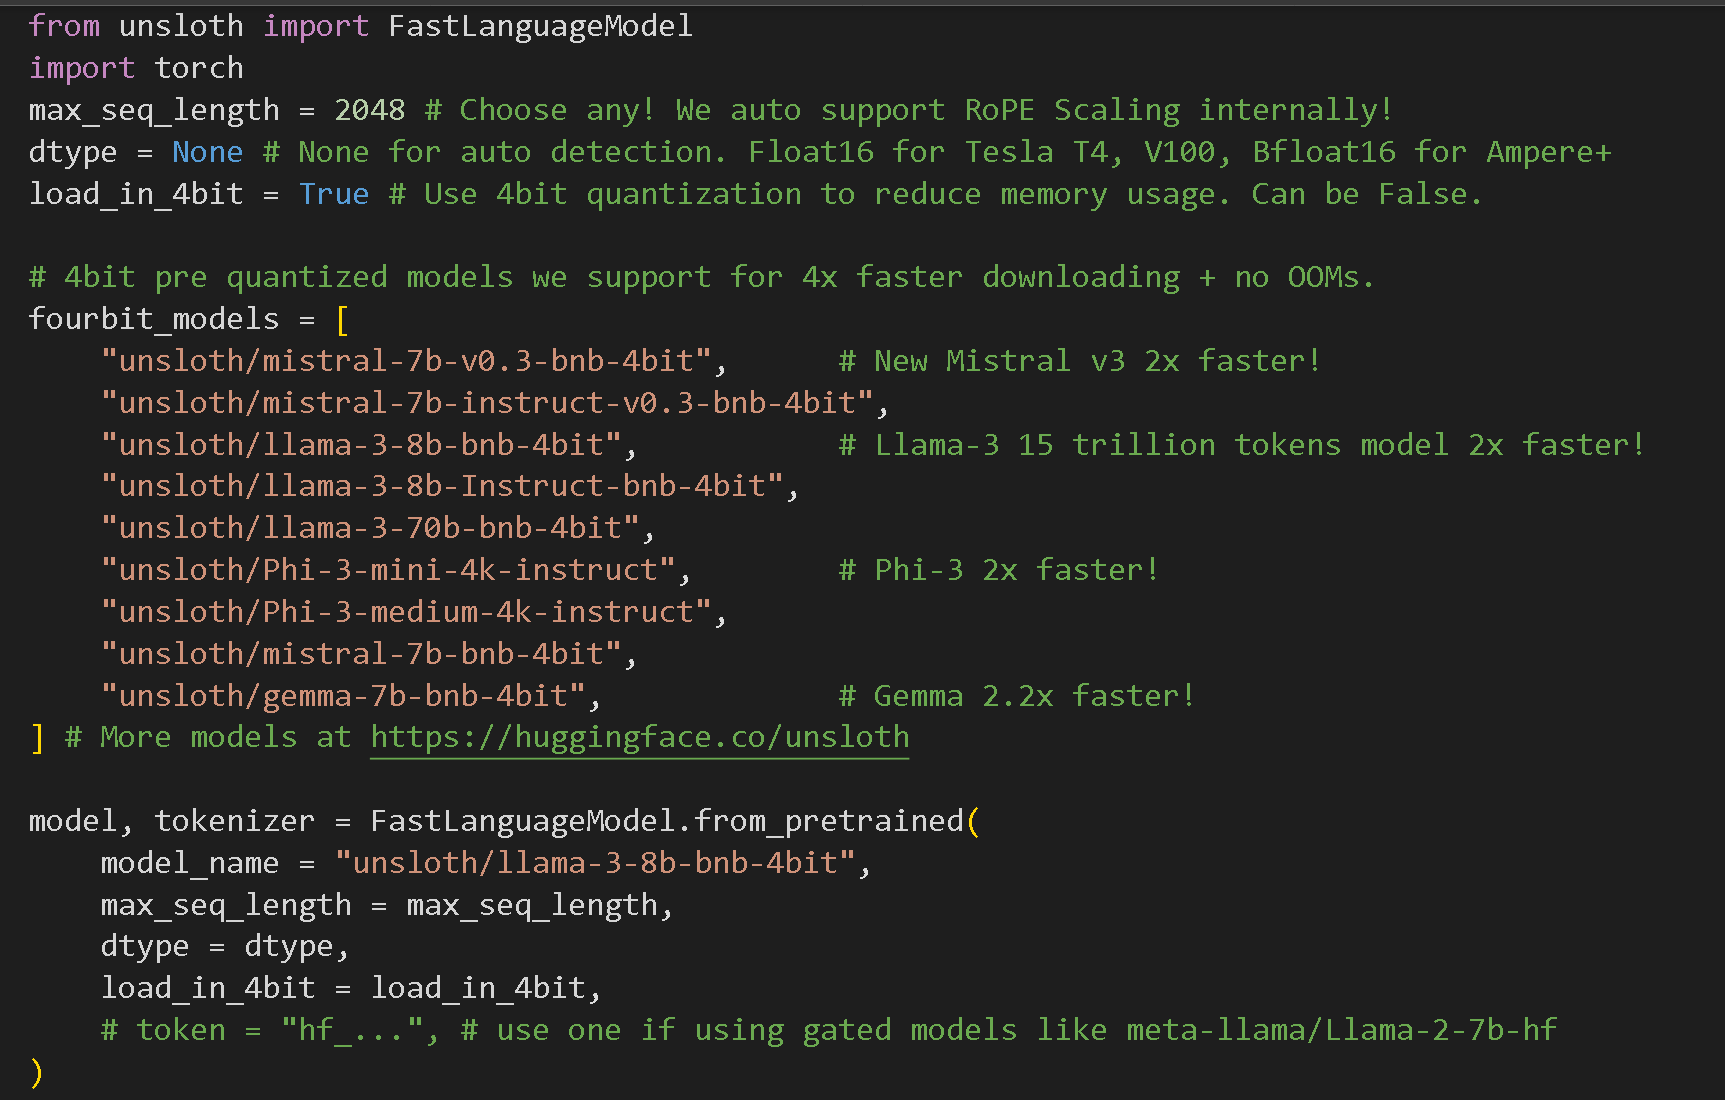
现在让我们选择一个用于微调的模型！我们默认使用来自 Meta / Facebook 的 Llama-3，它是在惊人的 15 万亿个“token”上训练的。可以把一个 token 想成一个英文单词。那大约相当于 35 万本厚厚百科全书的内容！其他热门模型包括 Mistral、Phi-3（使用 GPT-4 输出训练）以及 Google 的 Gemma（13 万亿个 token！）。

Unsloth 支持这些模型以及更多！实际上，只需输入 Hugging Face 模型库中的某个模型名，看看它是否可用！如果不可用，我们会报错。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-4fb10a1ce3e457310c11f74ca5b6347ad556fab0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

还有 3 个你可以切换的其他设置：

1. ```python
   max_seq_length = 2048
   ```

   这决定了模型的上下文长度。例如 Gemini 的上下文长度超过 100 万，而 Llama-3 的上下文长度为 8192。我们允许你选择任意数值——但我们建议在测试时设为 2048。Unsloth 也支持超长上下文微调，并且我们展示过它可以提供比最佳方案长 4 倍的上下文长度。
2. ```python
   dtype = None
   ```

   保持为 None 即可，但对于较新的 GPU，你可以选择 torch.float16 或 torch.bfloat16。
3. ```python
   load_in_4bit = True
   ```

   我们使用 4 位量化进行微调。这会将内存使用量减少 4 倍，使我们实际上能够在免费的 16GB 显存 GPU 上进行微调。4 位量化本质上是将权重转换为一组有限的数值，以减少内存占用。其缺点是准确率会下降 1%–2%。如果你想获得那一点点额外准确率，在 H100 这类更大的 GPU 上可以将其设为 False。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a44ac84348a2c5973dd542866c4c6727a00b3744%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

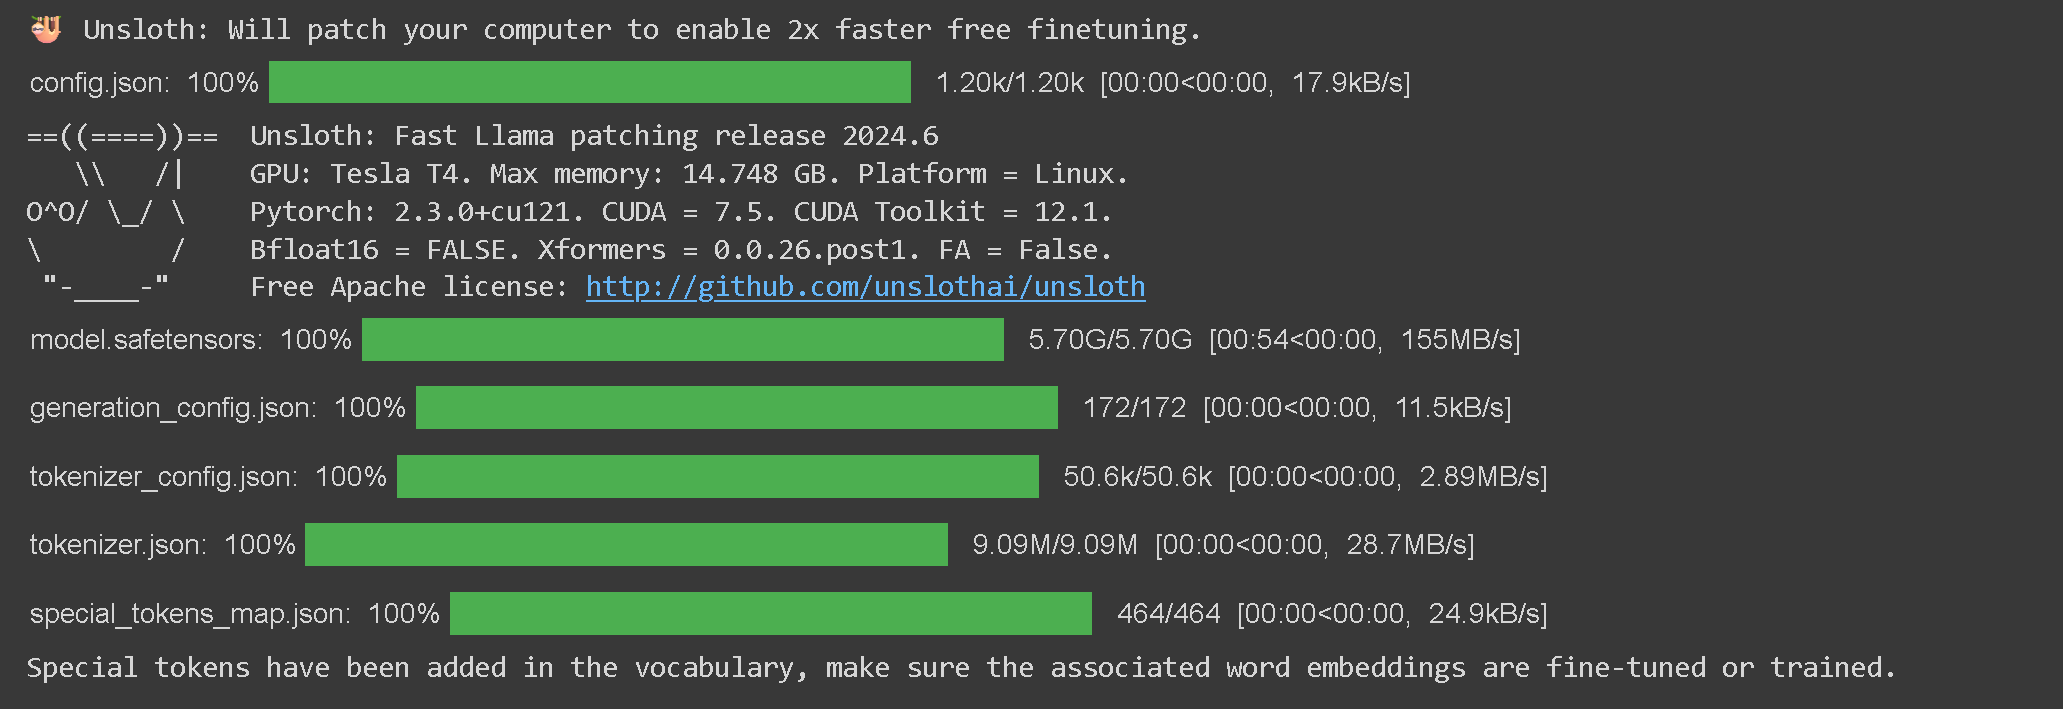
如果你运行该单元，会看到一些打印信息，包括 Unsloth 版本、你正在使用的模型、GPU 有多少内存以及其他一些统计信息。现在先忽略这些。

## 5. 微调参数
<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-495edc79c5353f0f47c1eea58df045631bfef1e0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

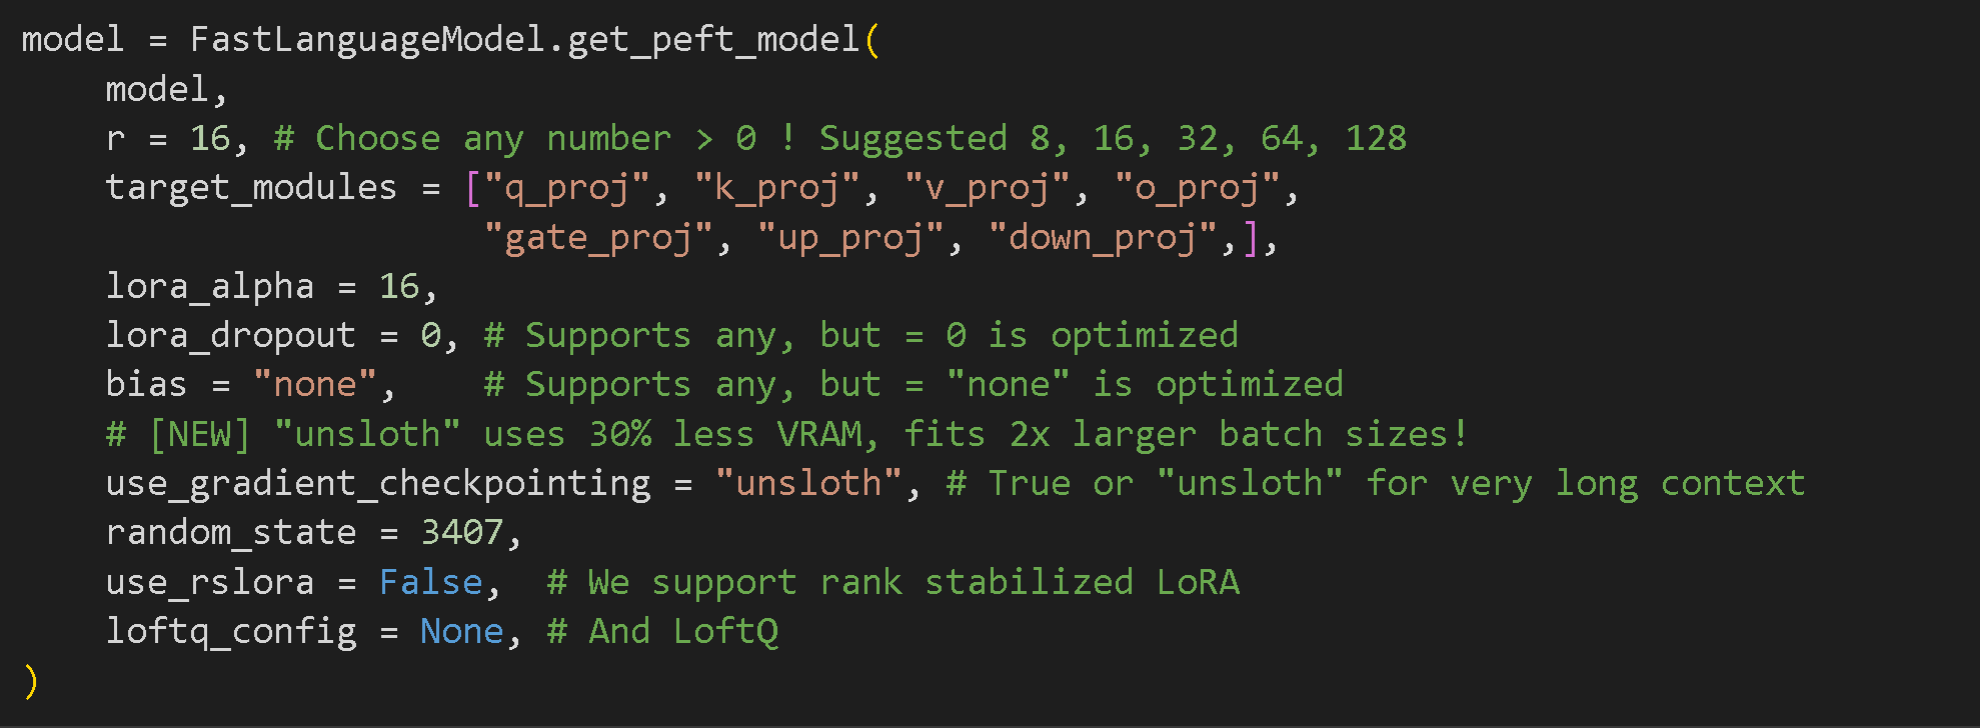
现在要自定义你的微调，你可以修改上面的数字，但也可以忽略它，因为我们已经选择了相当合理的数值。

目标是通过修改这些数字来提高准确率，同时还要 **抑制过拟合**。过拟合是指你让语言模型死记硬背一个数据集，导致它无法回答新的问题。我们希望最终模型能够回答未见过的问题，而不是进行记忆背诵。

1. ```python
   r = 16, # 选择任意大于 0 的数！建议 8、16、32、64、128
   ```

   微调过程的秩（rank）。数字越大，占用内存越多、速度越慢，但在更难的任务上可能提高准确率。我们通常建议使用 8（用于快速微调）之类的数值，最高可到 128。数值过大可能导致过拟合，损害模型质量。
2. ```python
   target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj"，"up_proj"，"down_proj"，]
   ```

   我们选择所有模块进行微调。你可以删除其中一些以减少内存占用并加快训练，但我们非常不建议这样做。直接训练所有模块就好！
3. ```python
   lora_alpha = 16,
   ```

   微调的缩放因子。数值越大，微调会从你的数据集中学到更多内容，但也可能促进过拟合。我们建议将其设为与 rank 相同 `r`，或者将其加倍。
4. ```python
   lora_dropout = 0，# 支持任意值，但 = 0 已做优化
   ```

   保持为 0 以加快训练！可以减少过拟合，但效果不大。
5. ```python
   bias = "none"，    # 支持任意值，但 = "none" 已做优化
   ```

   保持为 0，以获得更快且更不易过拟合的训练！
6. ```python
   use_gradient_checkpointing = "unsloth"，# 对于超长上下文可设为 True 或 "unsloth"
   ```

   可选项包括 `真`, `假` 和 `"unsloth"`。我们建议 `"unsloth"` 因为我们还能额外减少 30% 的内存占用，并支持超长上下文微调。你可以在这里了解更多： <https://unsloth.ai/blog/long-context> 以了解更多细节。
7. ```python
   random_state = 3407,
   ```

   用于确定可重复运行的数值。训练和微调需要随机数，因此设置这个数值可以让实验可复现。
8. ```python
   use_rslora = False，# 我们支持 rank stabilized LoRA
   ```

   用于设置……的高级功能 `lora_alpha = 16` 自动完成。若你愿意，可以使用它！
9. ```python
   loftq_config = None，# 以及 LoftQ
   ```

   用于将 LoRA 矩阵初始化为权重中前 r 个奇异向量的高级功能。可以在一定程度上提高准确率，但会在开始时让内存占用暴涨。

## 6. Alpaca 数据集

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1d66d8714e44d90513dd87b9356eec67886ab3f7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

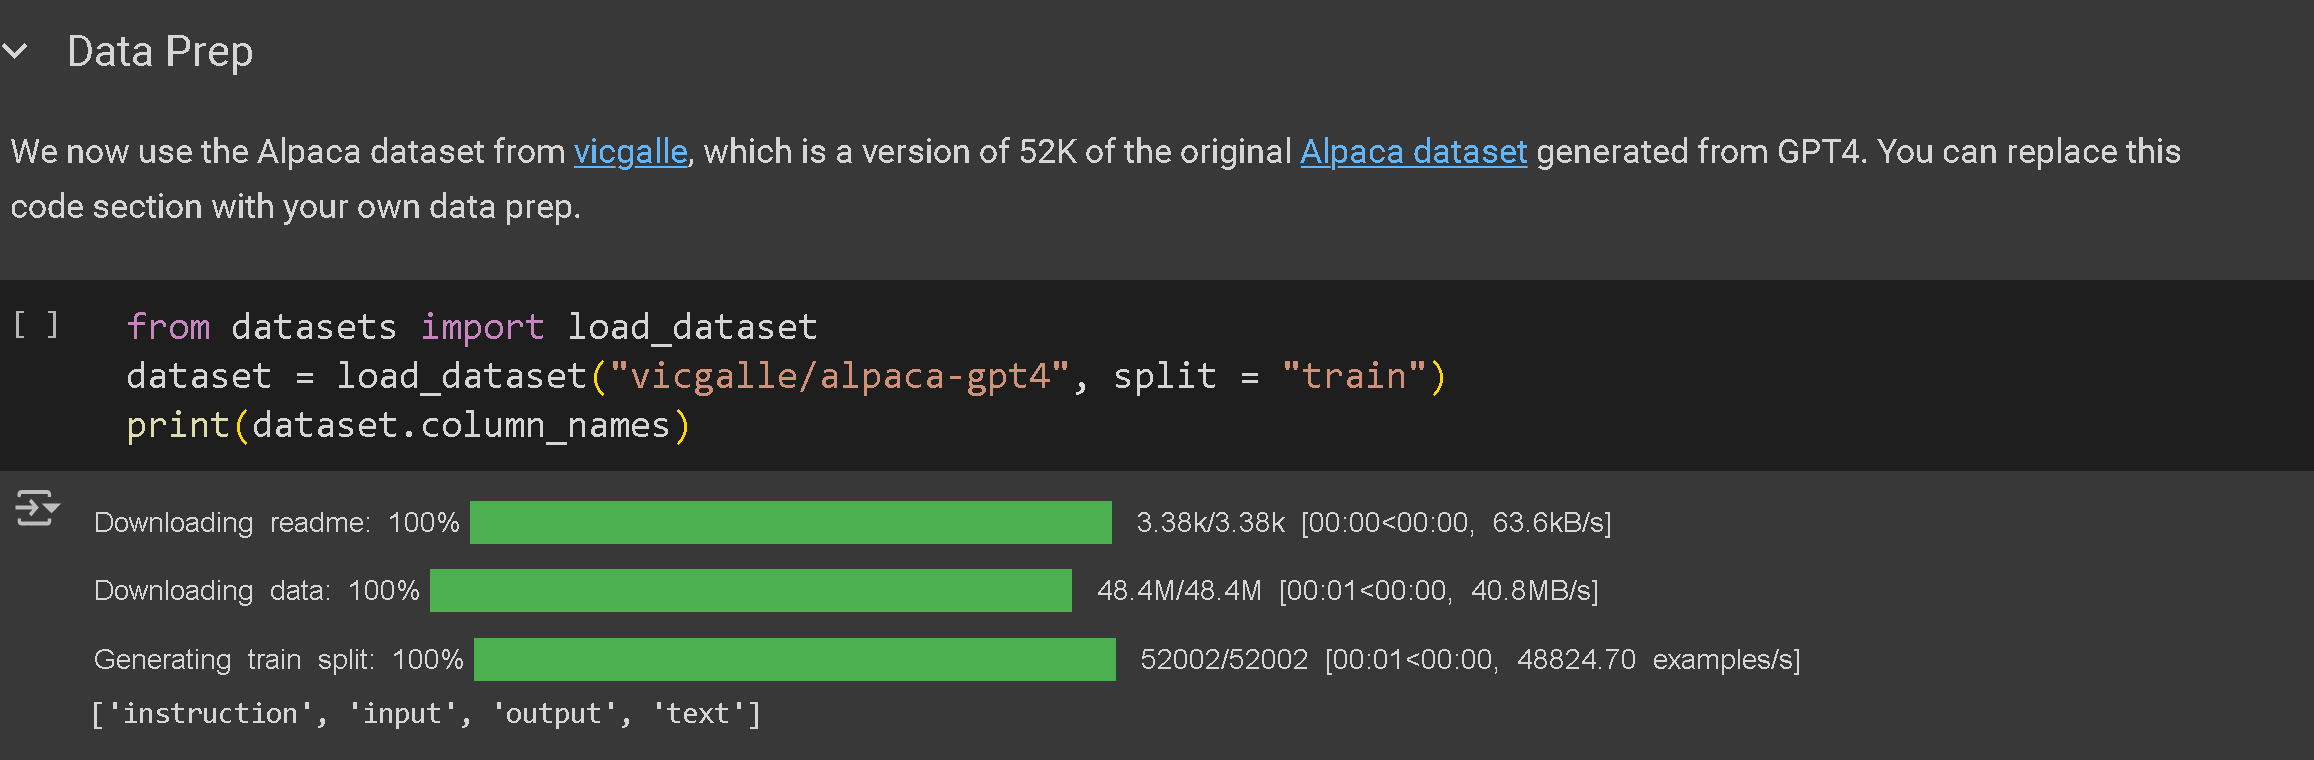
我们现在将使用通过调用 GPT-4 本身生成的 Alpaca 数据集。它包含 52,000 条指令和输出，在 Llama-1 发布时非常流行，因为它让对基础 LLM 的微调足以与 ChatGPT 本身相媲美。

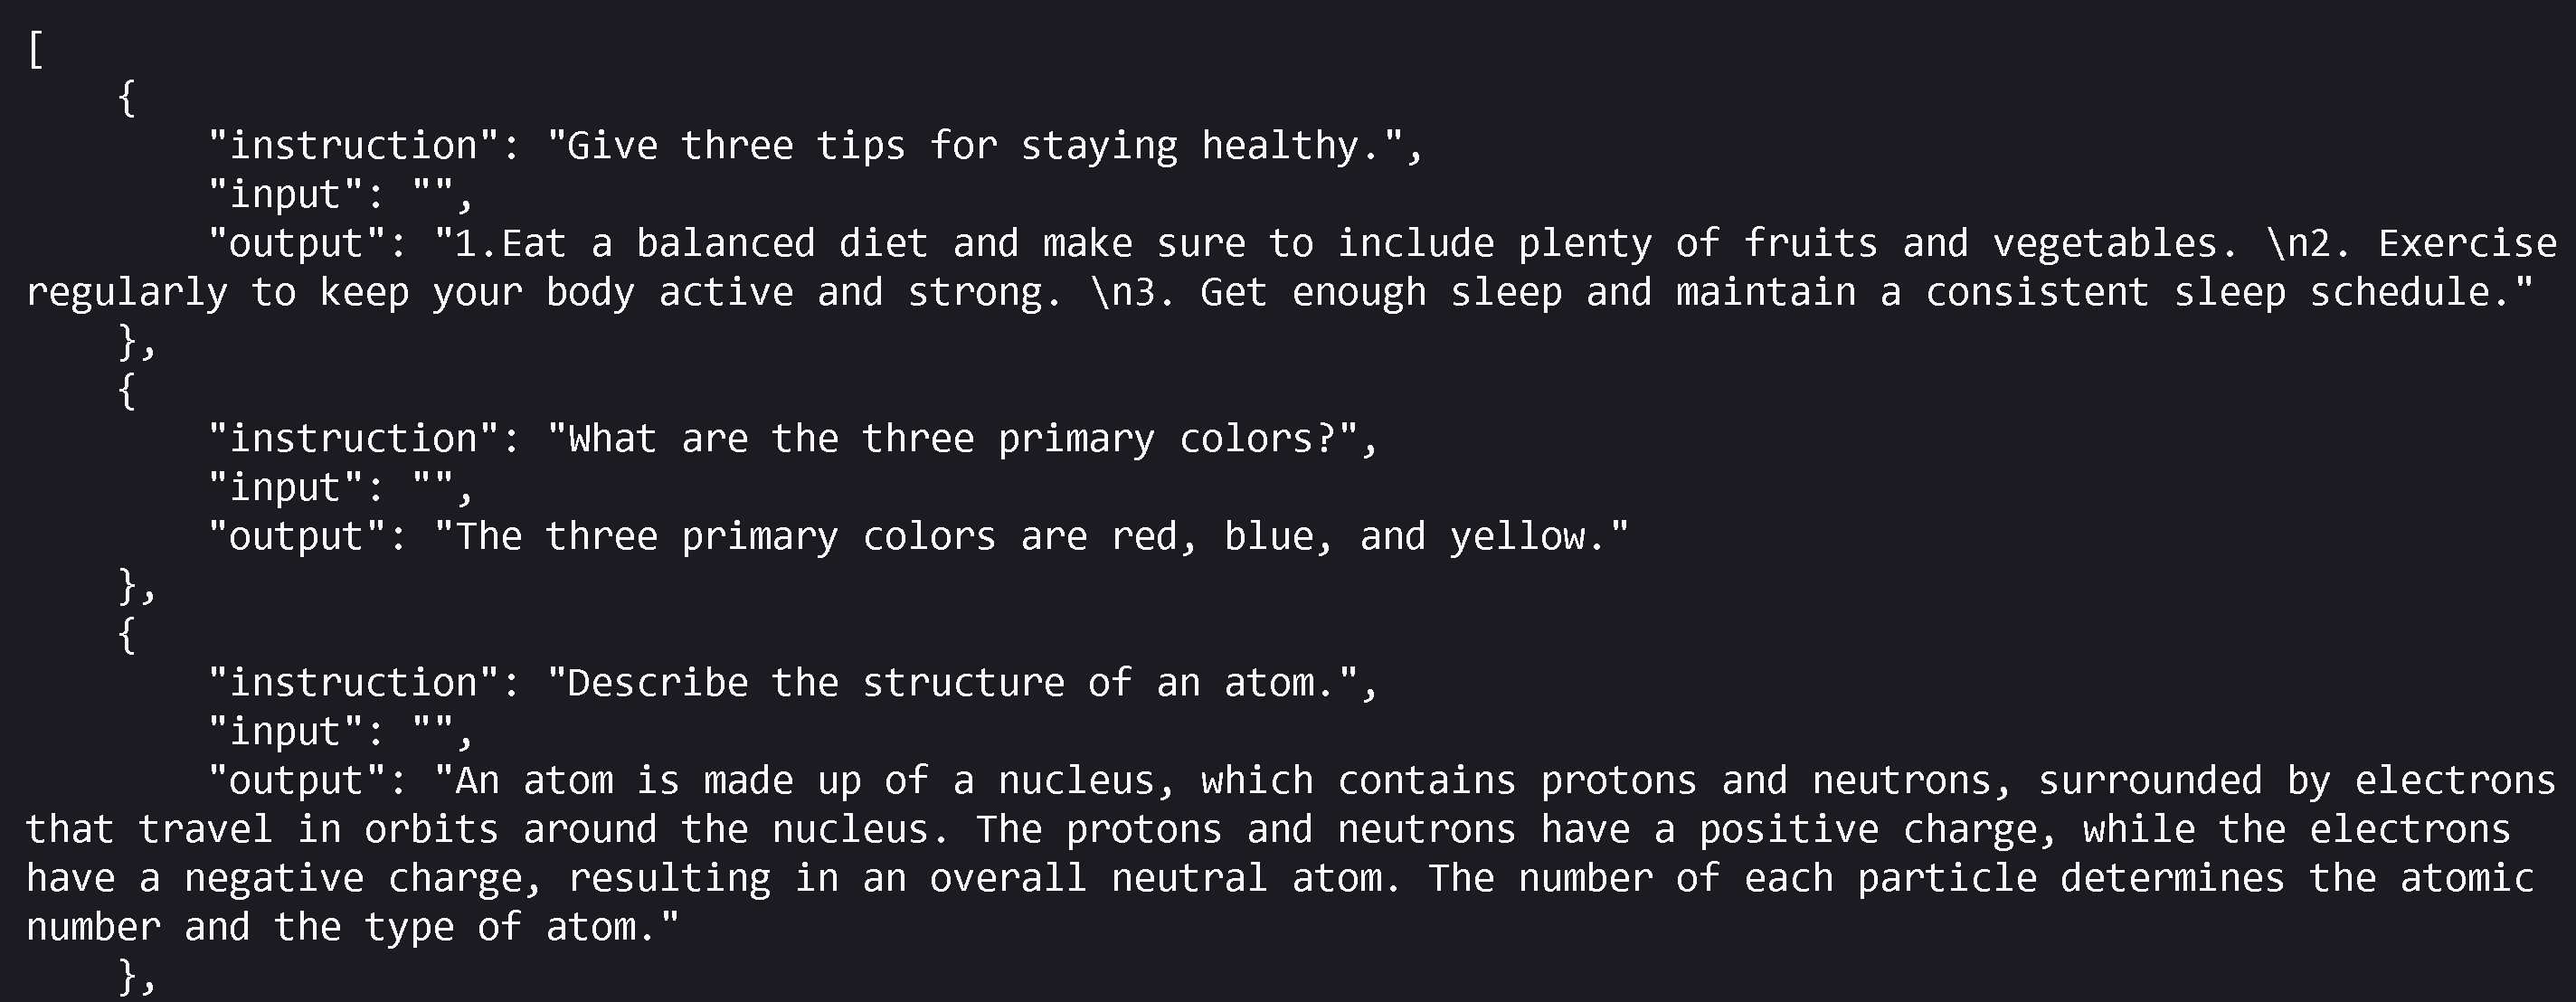
你可以在这里访问 Alpaca 数据集的 GPT-4 版本： <https://huggingface.co/datasets/vicgalle/alpaca-gpt4>。该数据集更早的第一个版本在这里： <https://github.com/tatsu-lab/stanford_alpaca>。下面展示了该数据集的一些示例：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-0dde50e386e7b245d3e8a57e10a4a81755b3769a%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

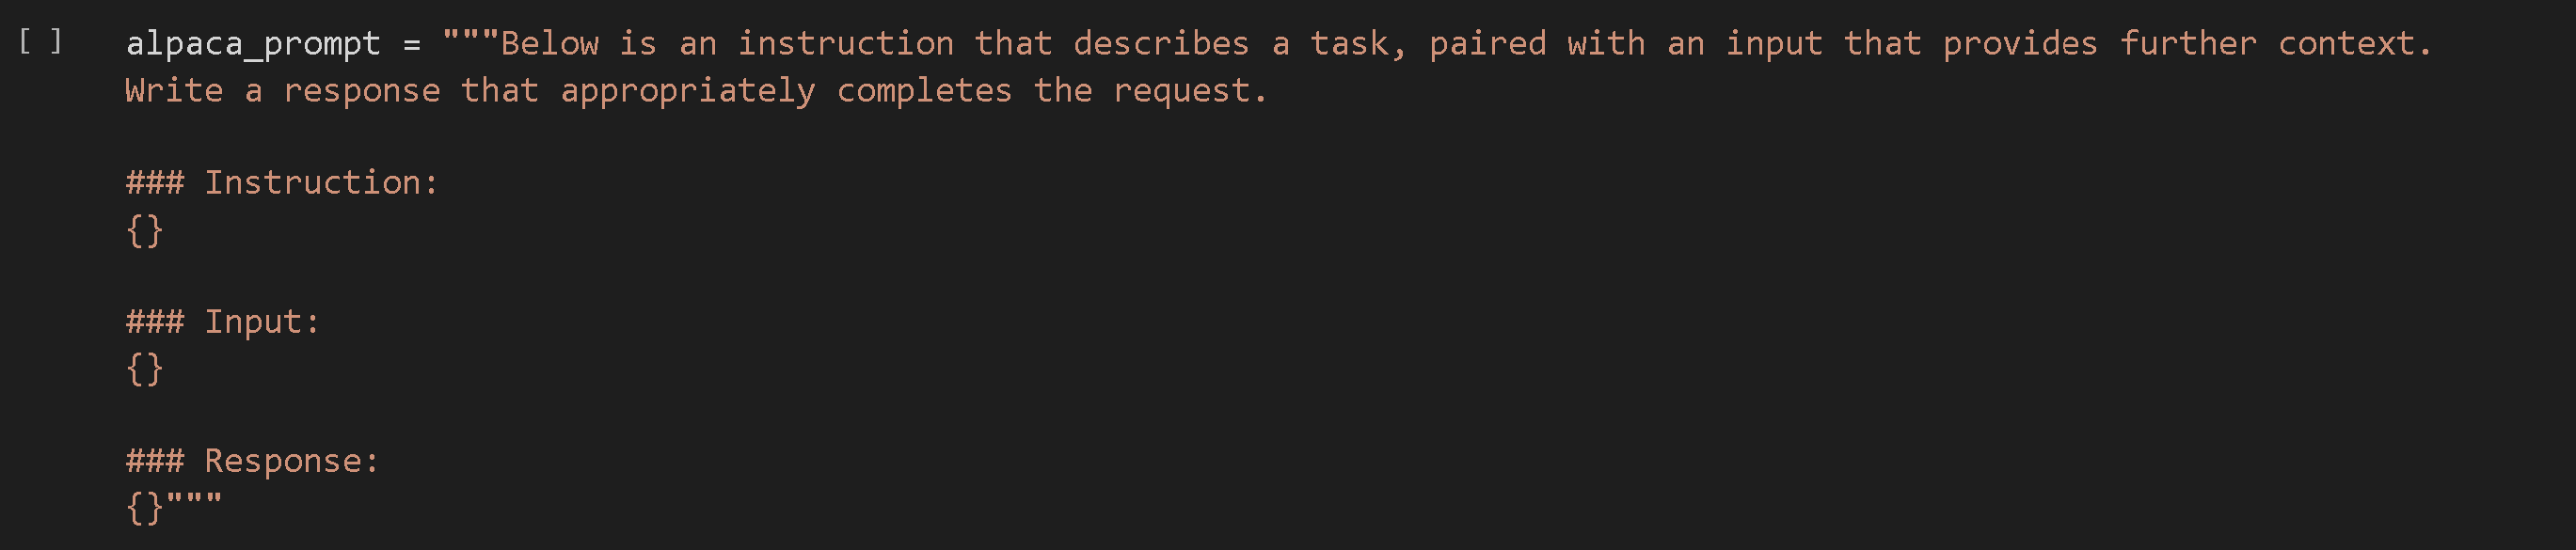
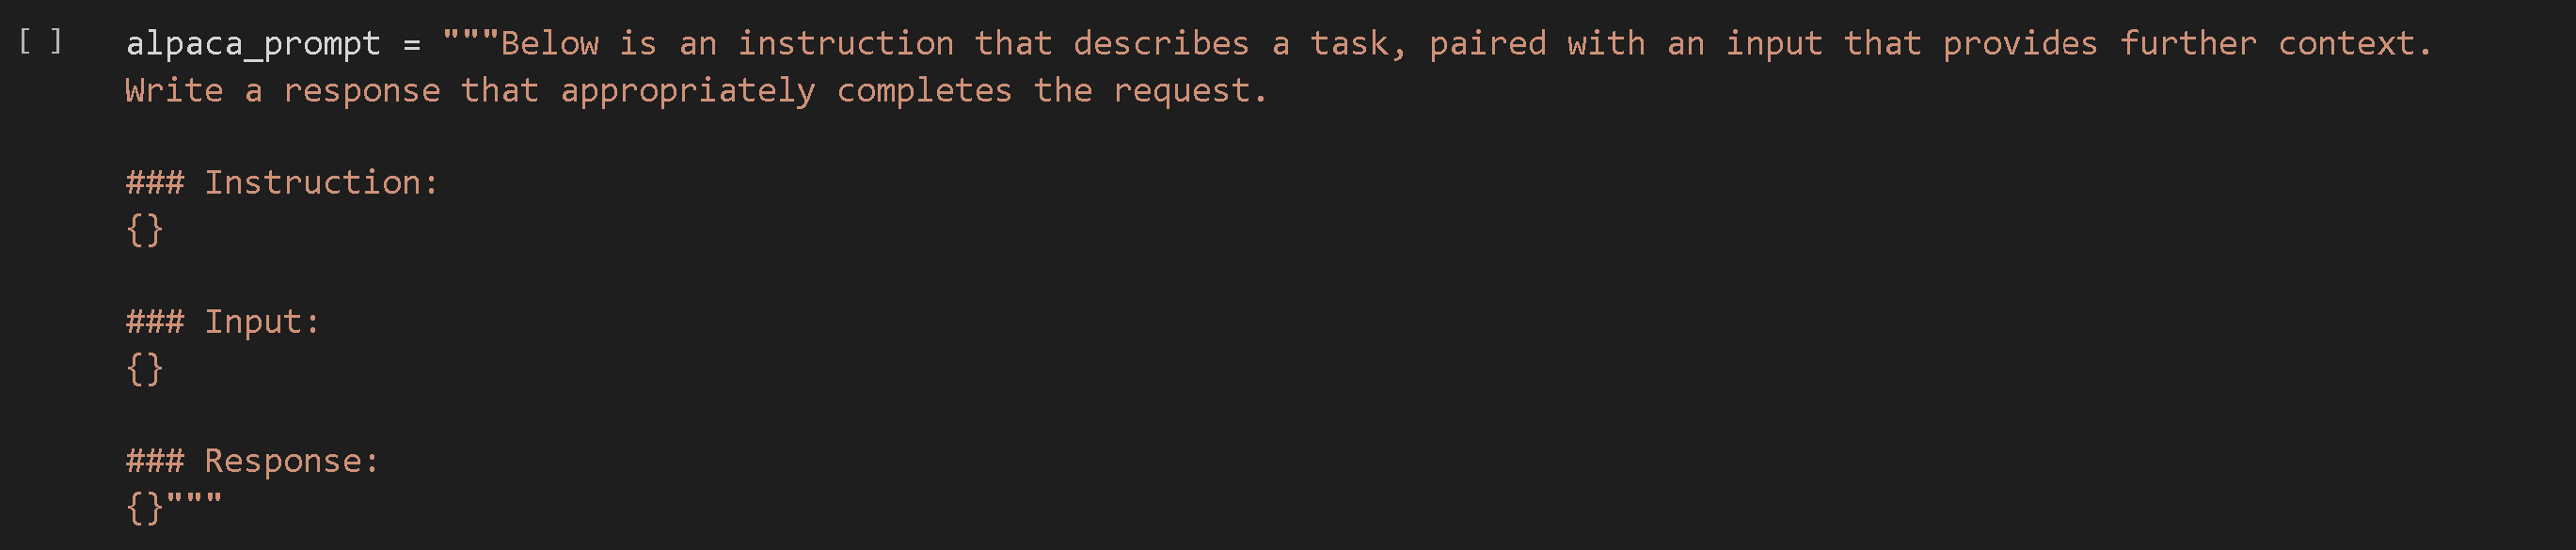
你可以看到每一行有 3 列——instruction、input 和 output。我们本质上把每一行合并成如下所示的一个大提示词。然后我们用它来微调语言模型，这使它变得非常像 ChatGPT。我们把这个过程称为 **监督式指令微调**.
<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8b3663c5d80adcb935ff77661500f08e13c9af2d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 7. 用于微调的多列

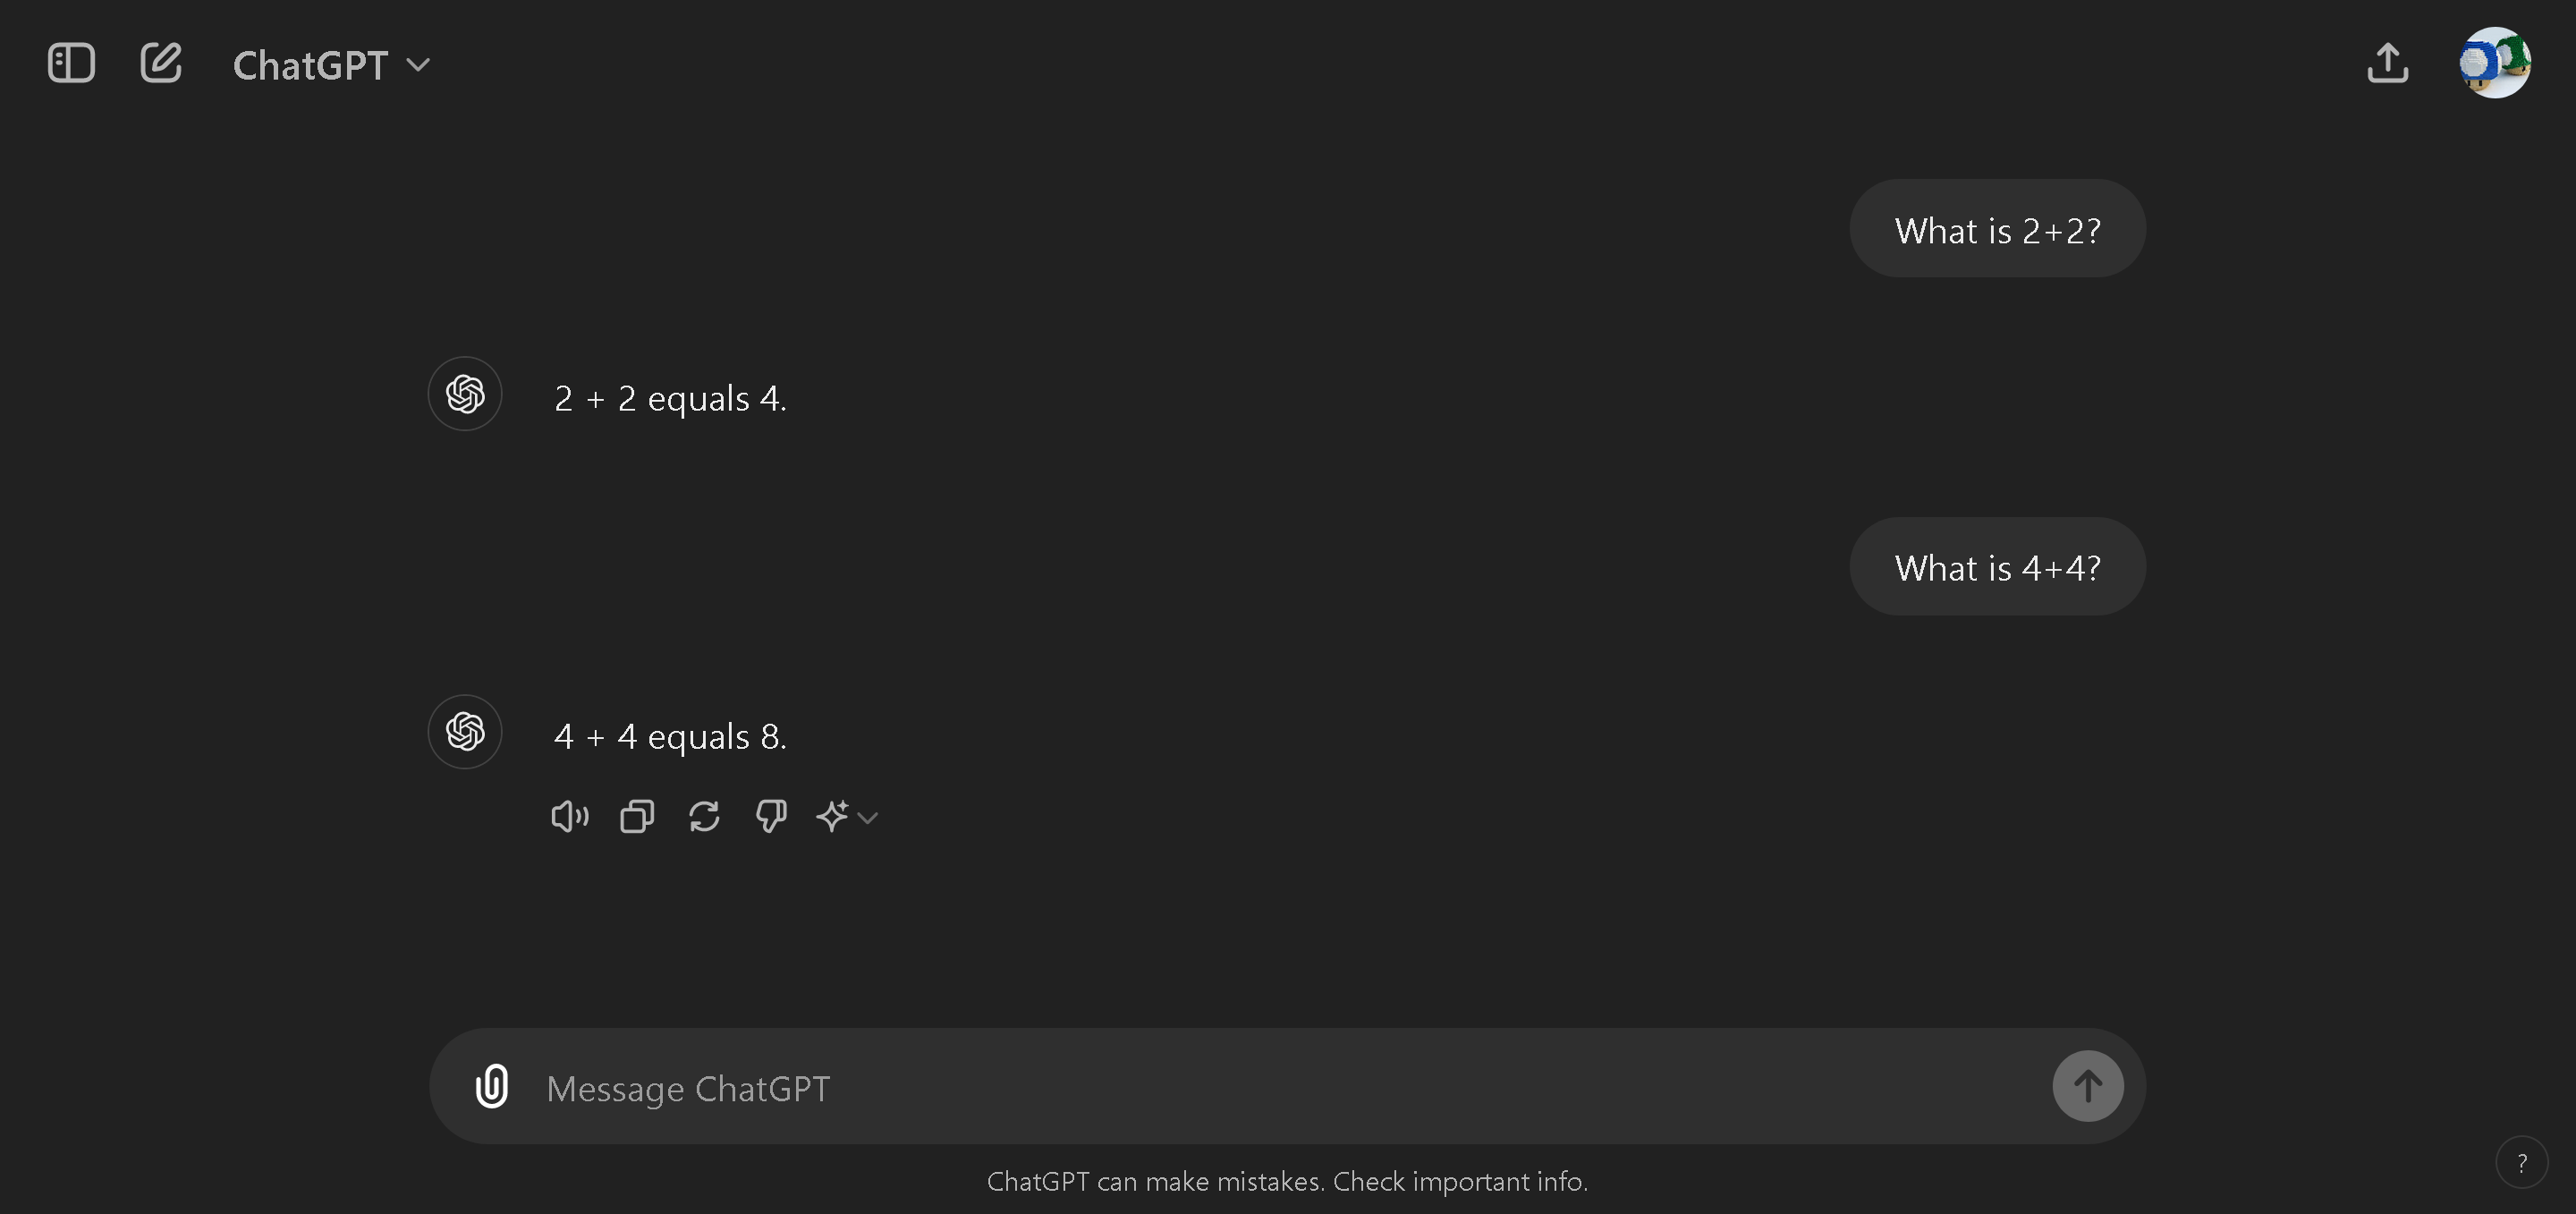
但对于 ChatGPT 风格的助手，一个大问题是我们只允许 1 条指令 / 1 个提示词，而不能有多列 / 多个输入。例如在 ChatGPT 中，你可以看到我们必须提交 1 个提示词，而不是多个提示词。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-d90162c2685ced871f4151369aadcaee40a9c54f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

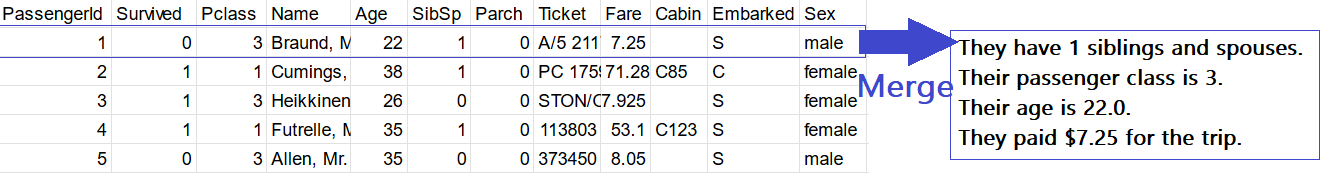
这本质上意味着，为了让微调真正生效，我们必须把多列“合并”成 1 个大提示词！

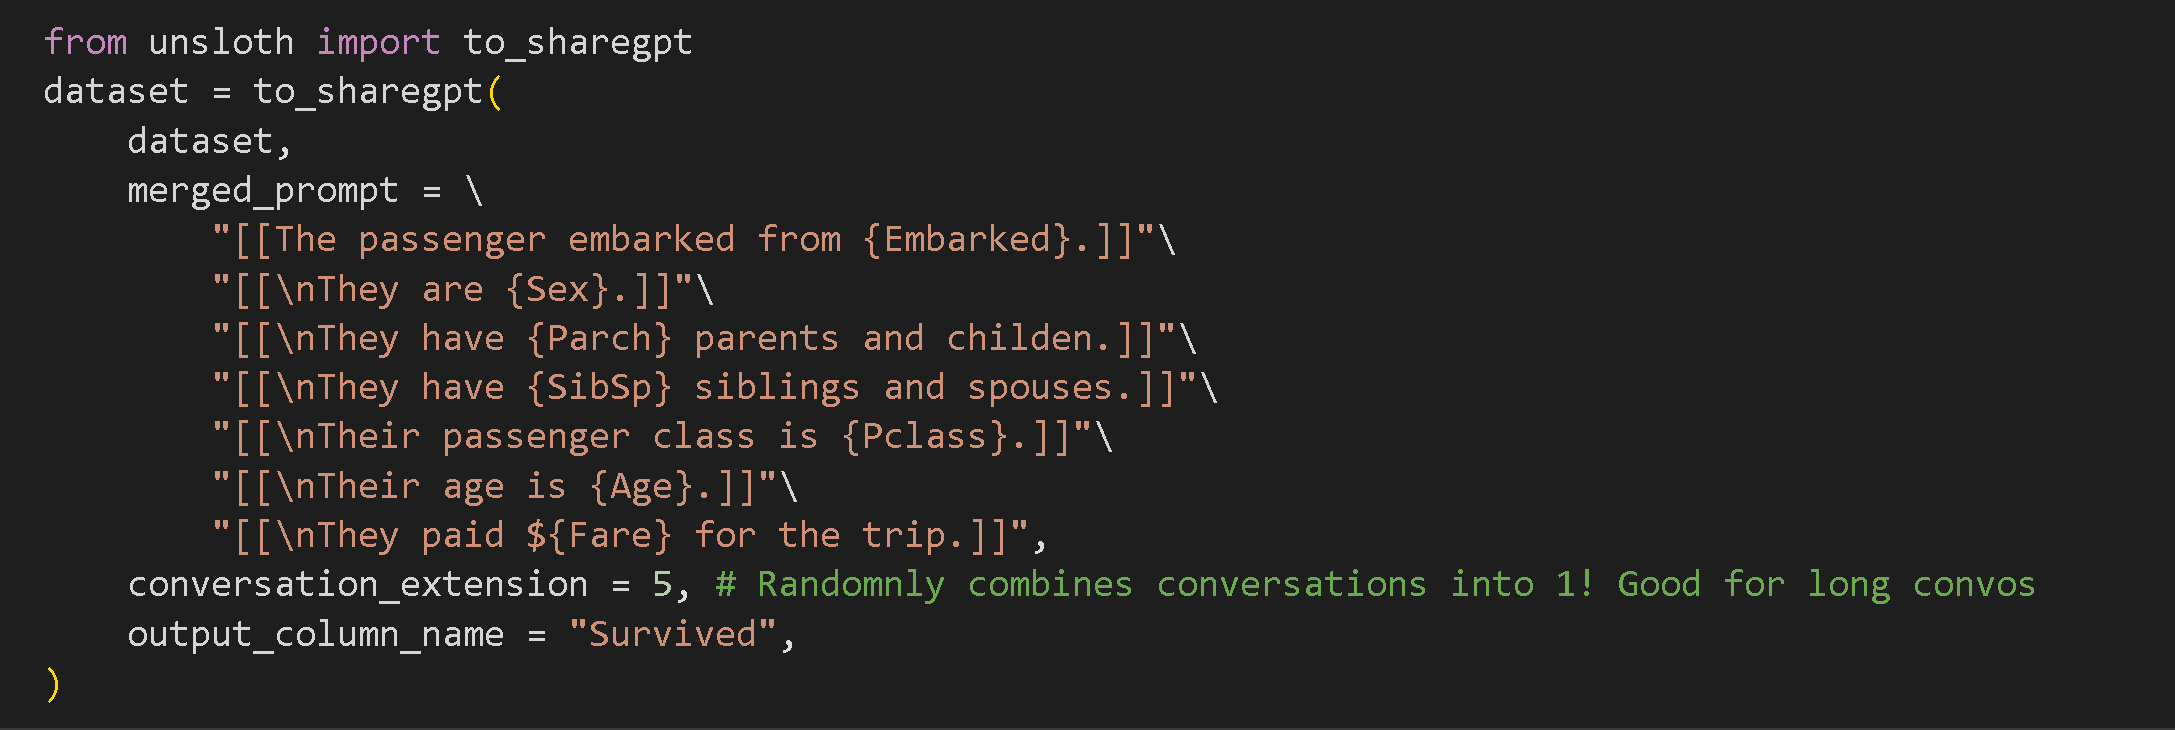
例如，著名的 Titanic（泰坦尼克号）数据集有很多很多列。你的任务是根据年龄、乘客舱位、票价等信息预测乘客是生还还是死亡。我们不能直接把这些信息输入到 ChatGPT 中，而是必须把这些信息“合并”成 1 个大提示词。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a2df04874bfc879182cb66c789341d49700227ea%2FMerge.png?alt=media" alt=""><figcaption></figcaption></figure>

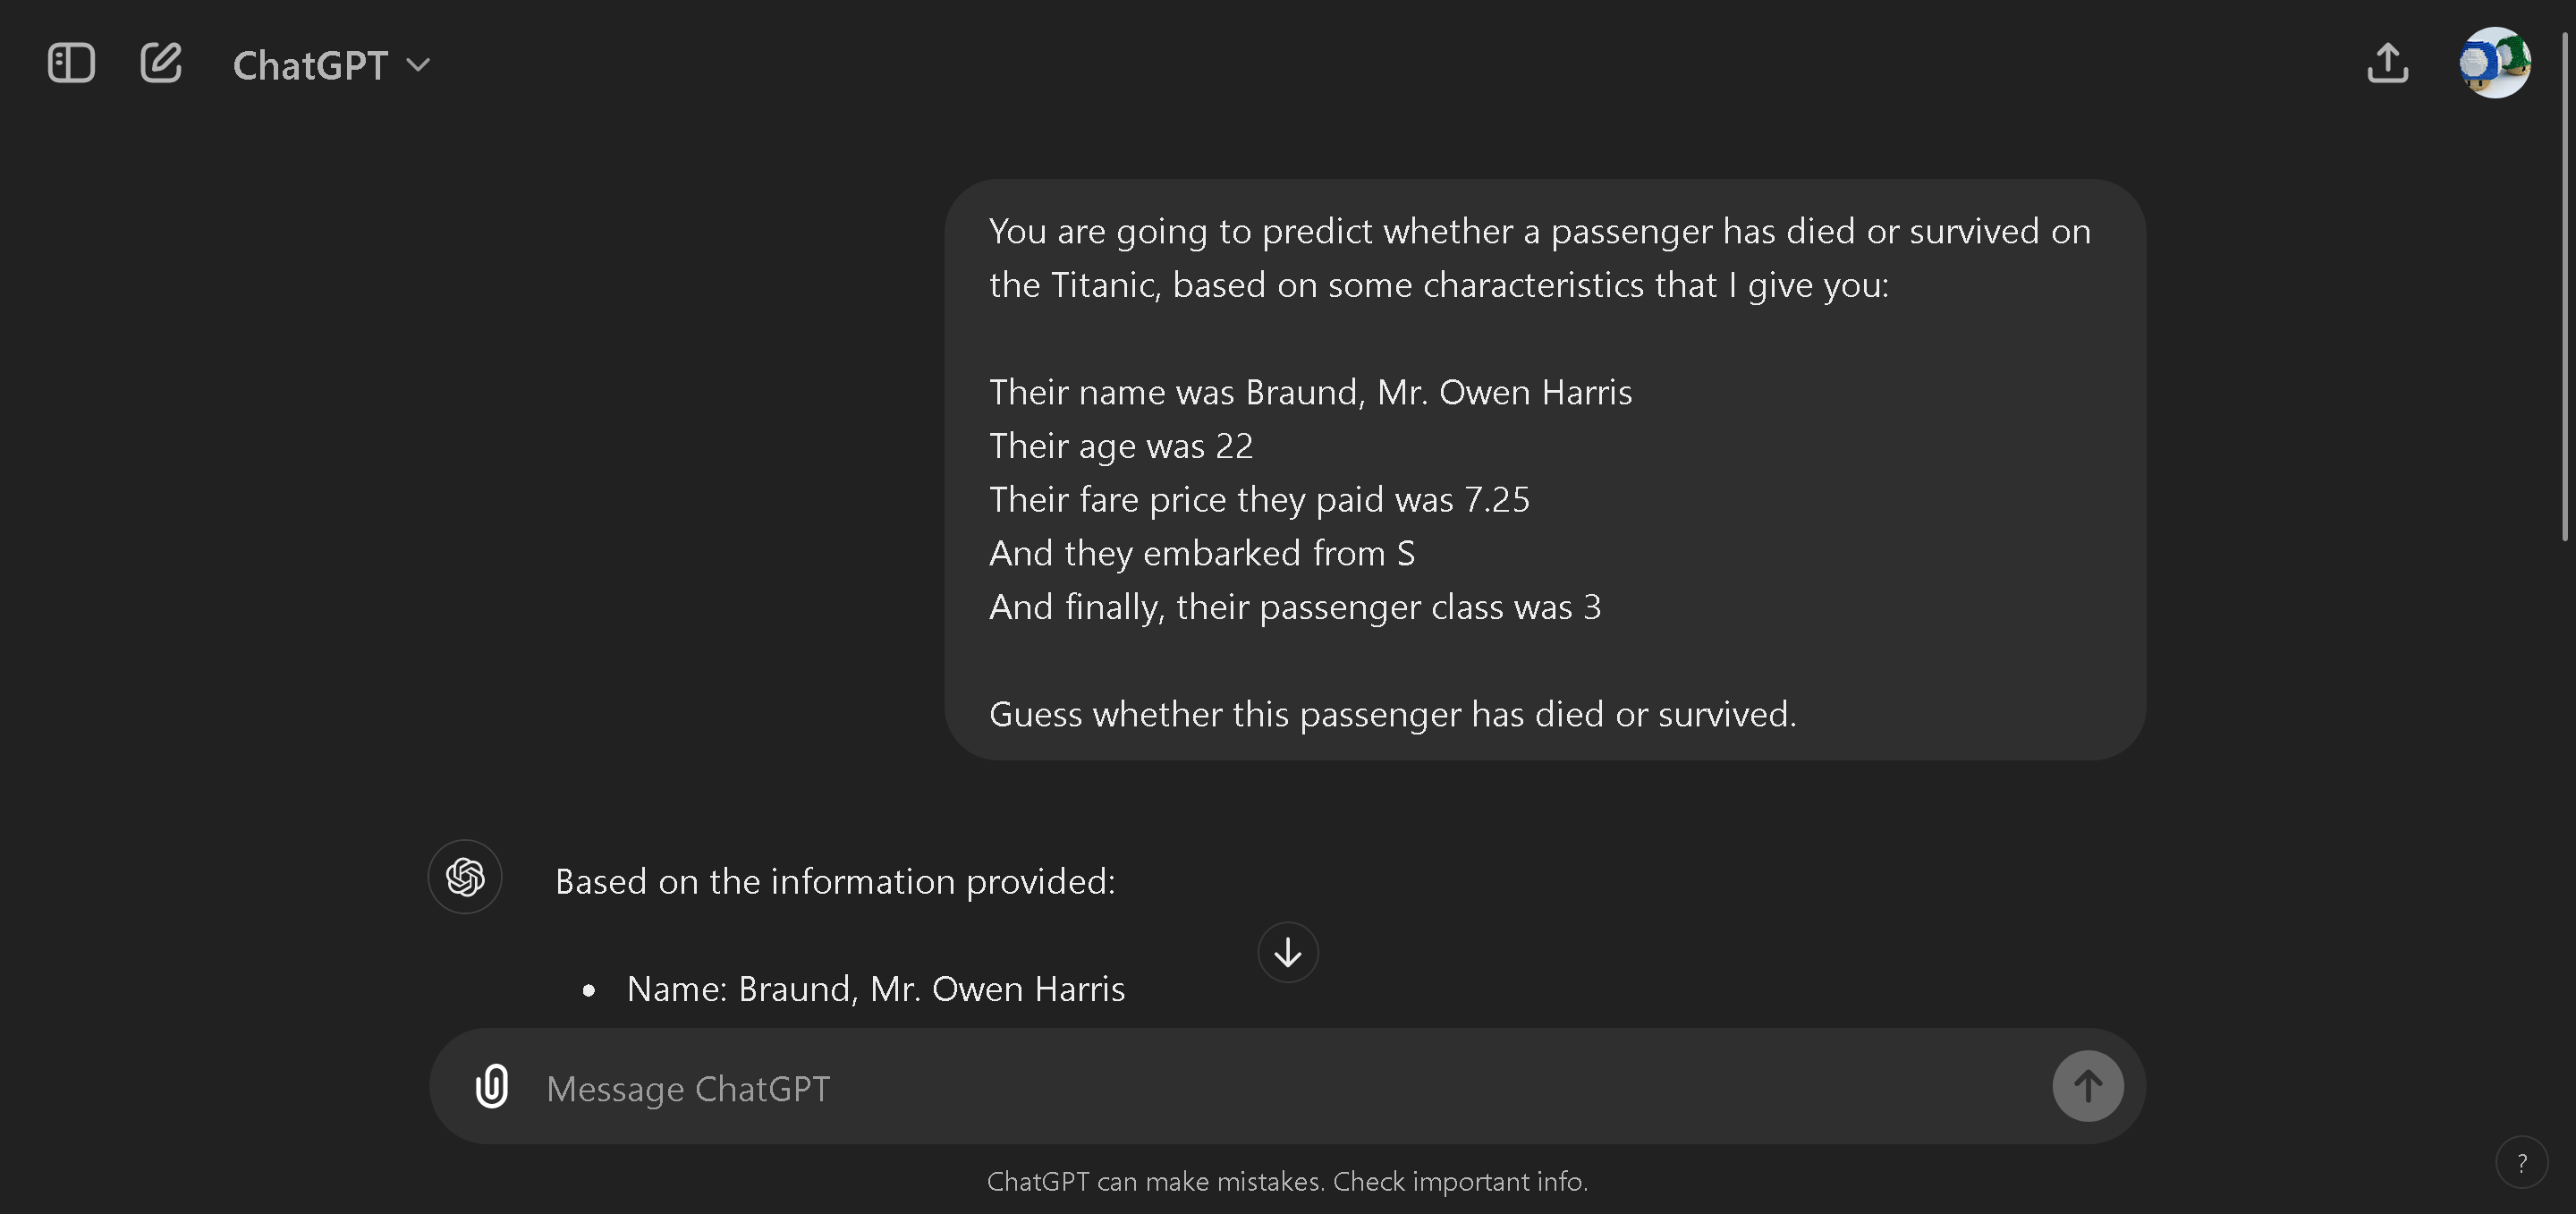
例如，如果我们用包含该乘客全部信息的“合并后”的单一提示词来询问 ChatGPT，就可以让它猜测或预测该乘客是死亡还是生还。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b3da2b36afe37469cd3962f37186e758871864a5%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

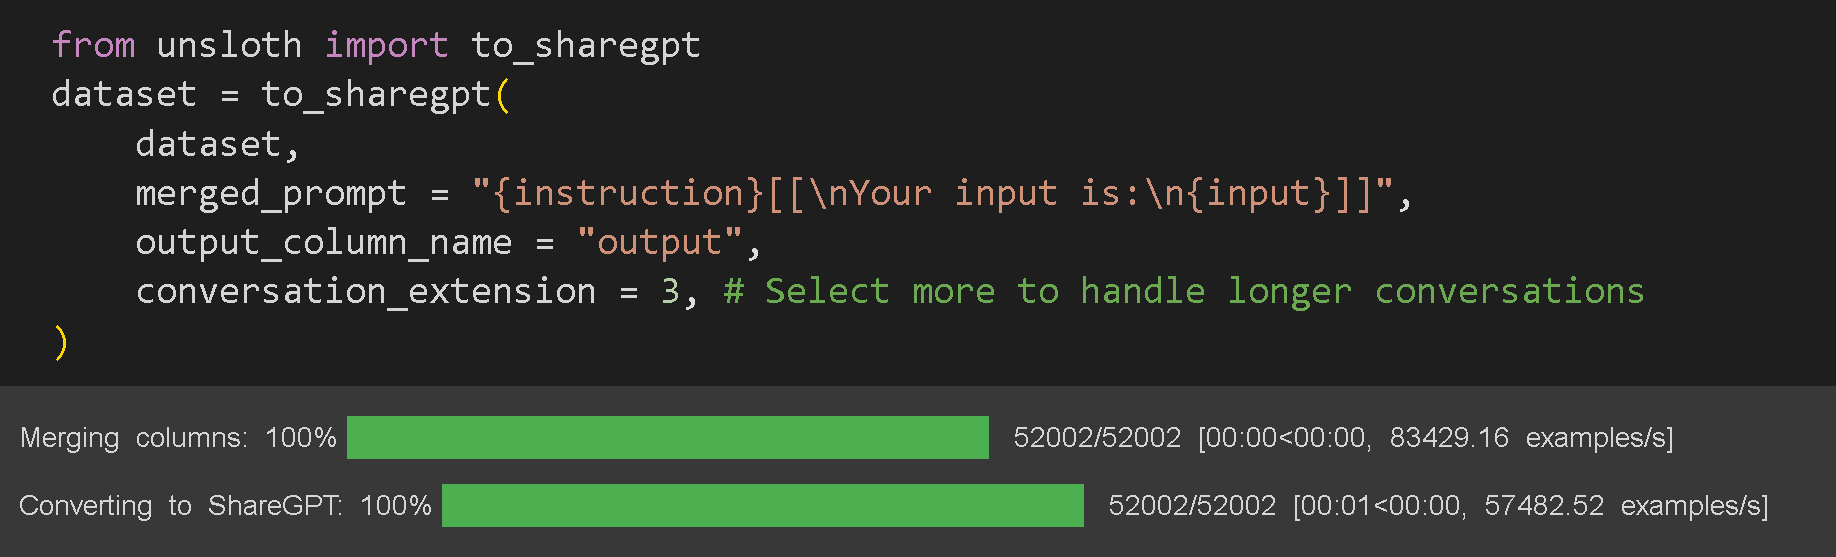
其他微调库要求你手动准备用于微调的数据集，把所有列合并成 1 个提示词。在 Unsloth 中，我们只需提供一个名为 `to_sharegpt` 的函数，一次完成！

要访问 Titanic 微调笔记本，或者如果你想上传 CSV 或 Excel 文件，请到这里： <https://colab.research.google.com/drive/1VYkncZMfGFkeCEgN2IzbZIKEDkyQuJAS?usp=sharing>

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-62b94dc44f2e343020d31de575f52eb22be4b0fc%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

现在这会稍微复杂一些，因为我们允许大量自定义，但有几点需要注意：

* 你必须将所有列用花括号括起来 `{}`。这些就是实际 CSV / Excel 文件中的列名。
* 可选的文本组件必须包裹在 `[[]]`中。例如，如果列“input”为空，合并函数就不会显示这段文本并会跳过它。这对存在缺失值的数据集很有用。
* 在……中选择输出或目标 / 预测列 `output_column_name`。对于 Alpaca 数据集，这将是 `output`.

例如在 Titanic 数据集中，我们可以创建如下所示的大型合并提示词格式，其中每一列 / 每一段文本都可以变为可选。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e6228cf6e5c0bb4e4b45e6f3e045910d567c33d2%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

例如，假设数据集像下面这样，且有很多缺失数据：

| 登船港口 | 年龄 | 票价   |
| ---- | -- | ---- |
| S    | 23 |      |
|      | 18 | 7.25 |

那么，我们不希望结果变成：

1. 这位乘客从 S 登船。年龄是 23。票价是 **空白**.
2. 这位乘客从 **空白**。年龄是 18。票价是 7.25 美元。

相反，通过使用……可选地包裹列 `[[]]`，我们可以完全排除这些信息。

1. \[\[这位乘客从 S 登船。]] \[\[年龄是 23。]] \[\[票价是 **空白**.]]
2. \[\[这位乘客从 **空白**。]] \[\[年龄是 18。]] \[\[票价是 7.25 美元。]]

变成：

1. 这位乘客从 S 登船。年龄是 23。
2. 年龄是 18。票价是 7.25 美元。

## 8. 多轮对话

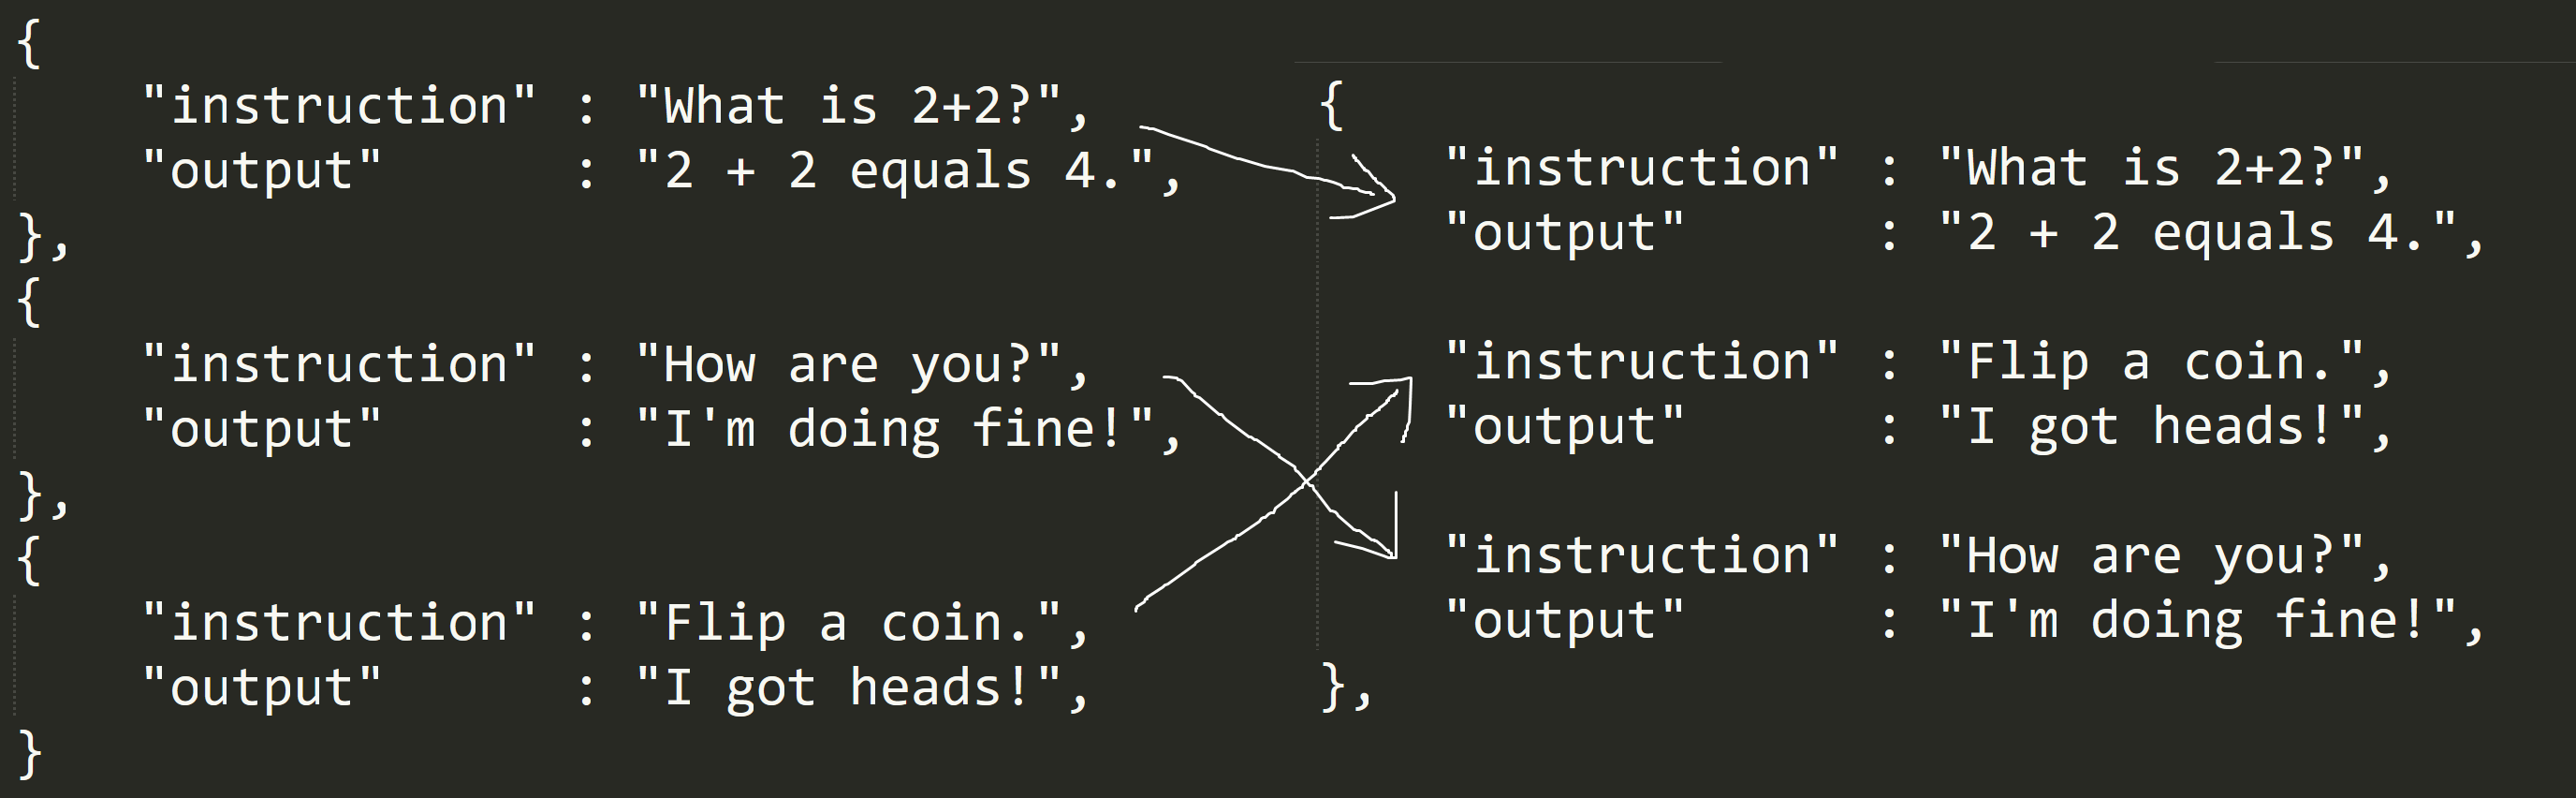
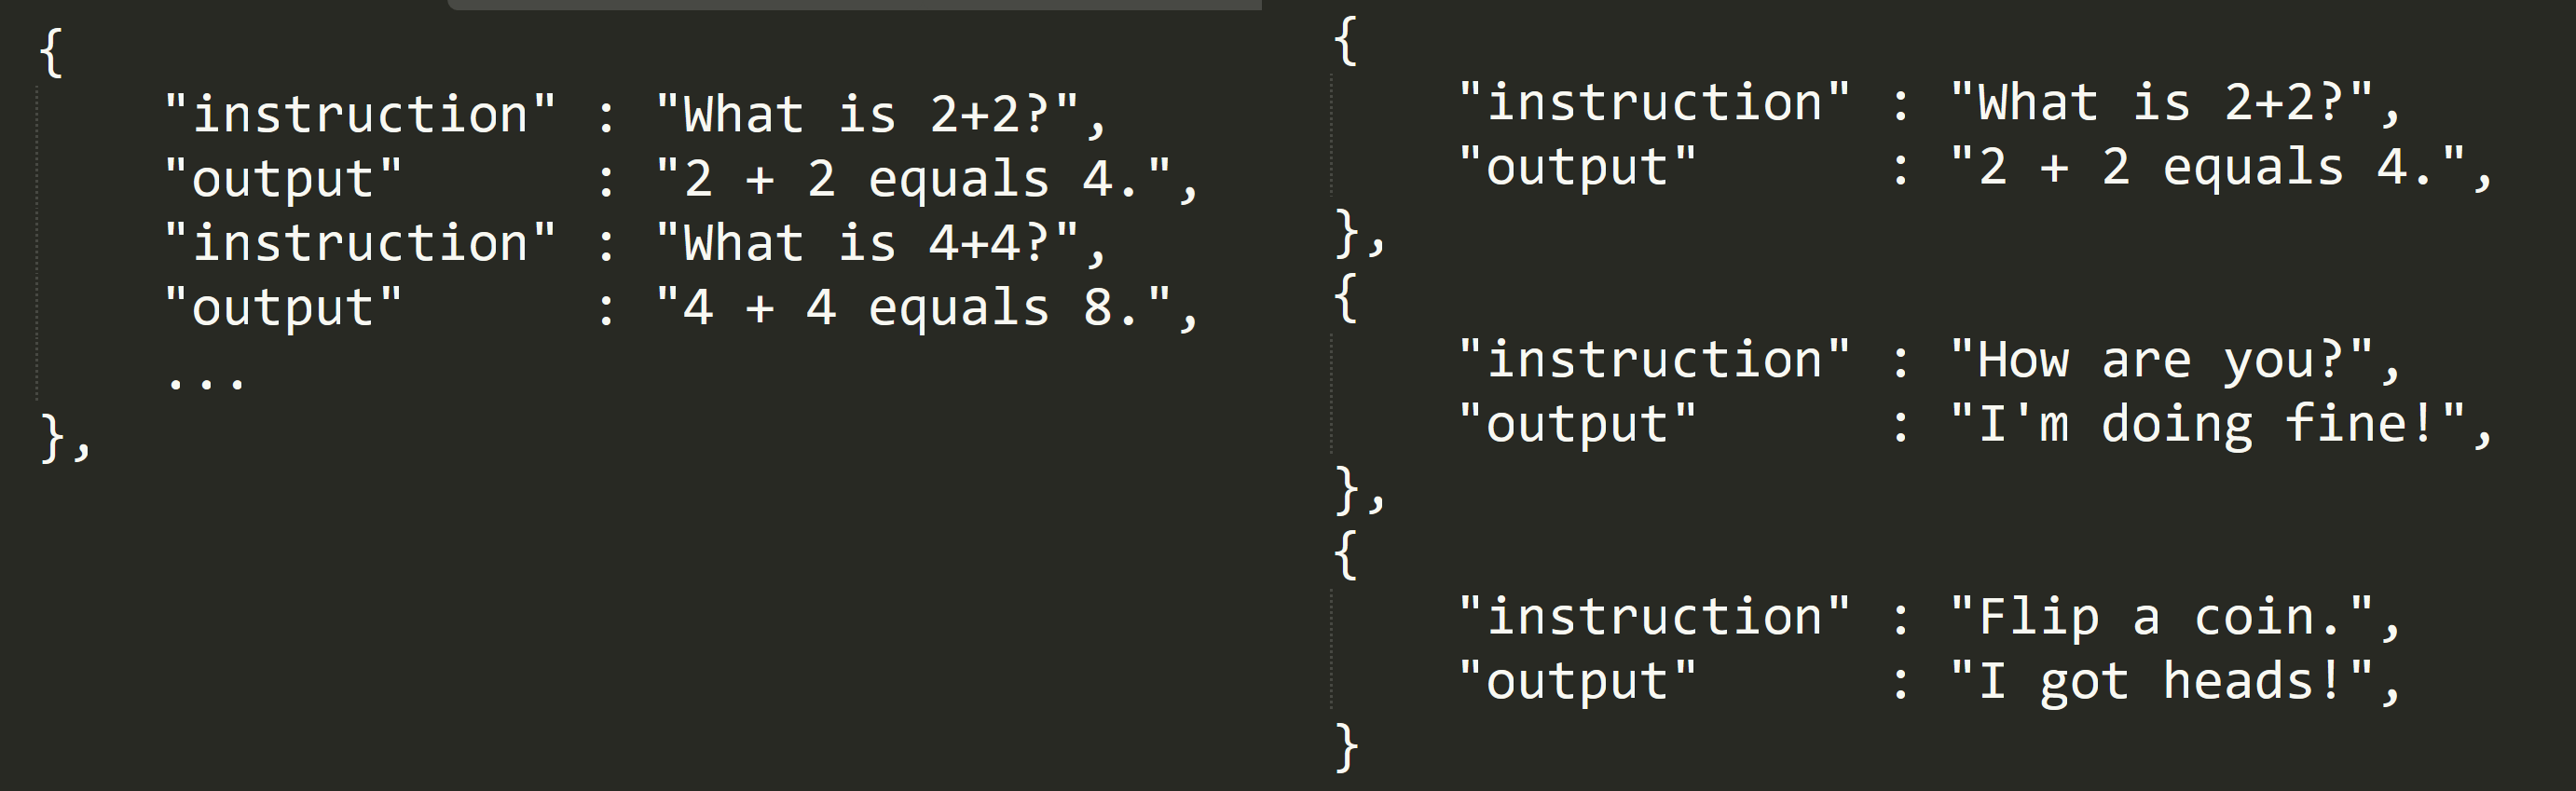
如果你没注意到，一个问题是 Alpaca 数据集是单轮的，而记得 ChatGPT 是交互式的，你可以和它多轮对话。例如，左边是我们想要的，而右边的 Alpaca 数据集只提供单一对话。我们希望微调后的语言模型能以某种方式学会像 ChatGPT 一样进行多轮对话。
<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2a65cd74ddd03a6bcbbc9827d9d034e4879a8e6a%2Fdiff.png?alt=media" alt=""><figcaption></figcaption></figure>

因此我们引入了 `conversation_extension` 参数，它本质上会从你的单轮数据集中随机选取一些行，并将它们合并成 1 段对话！例如，如果你把它设为 3，我们会随机选择 3 行并将它们合并为 1 段！设置得太长会使训练变慢，但可能让你的聊天机器人和最终微调效果更好！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2b1b3494b260f1102942d86143a885225c6a06f2%2Fcombine.png?alt=media" alt=""><figcaption></figcaption></figure>

然后将 `output_column_name` 设置为预测 / 输出列。对于 Alpaca 数据集来说，就是 output 列。

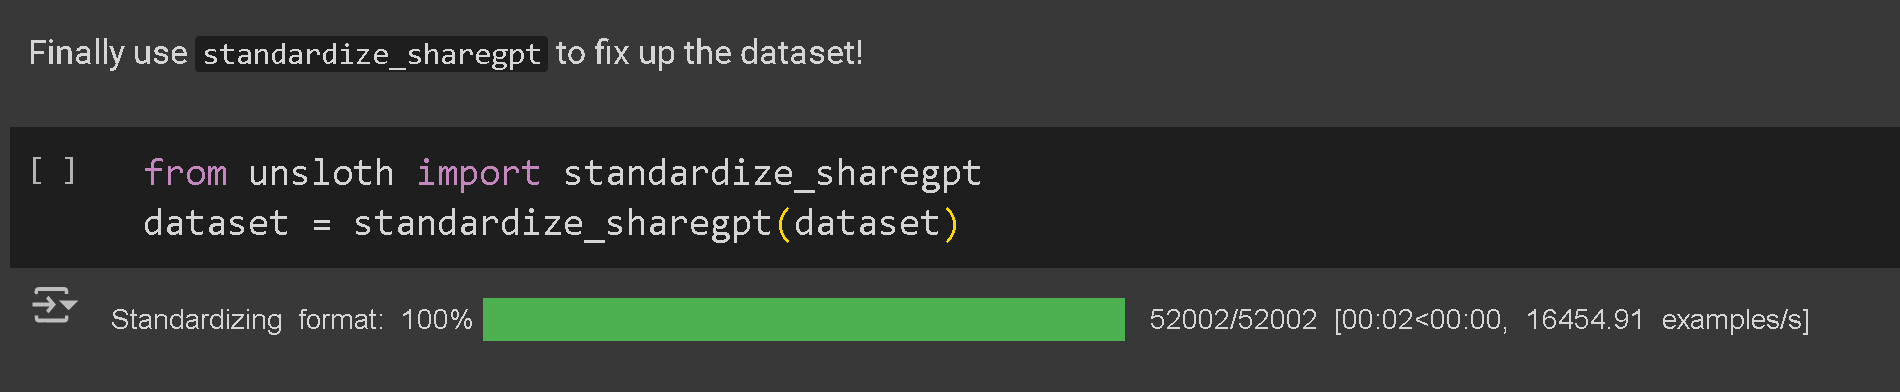
然后我们使用 `standardize_sharegpt` 函数把数据集整理成适合微调的正确格式！一定要调用这个！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7bf83bf802191bda9e417bbe45afa181e7f24f38%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 9. 可自定义聊天模板

现在我们可以为微调本身指定聊天模板。下面是非常著名的 Alpaca 格式：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-59737e6dcb09fed15487d5a57c69f07cb40bb8e7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

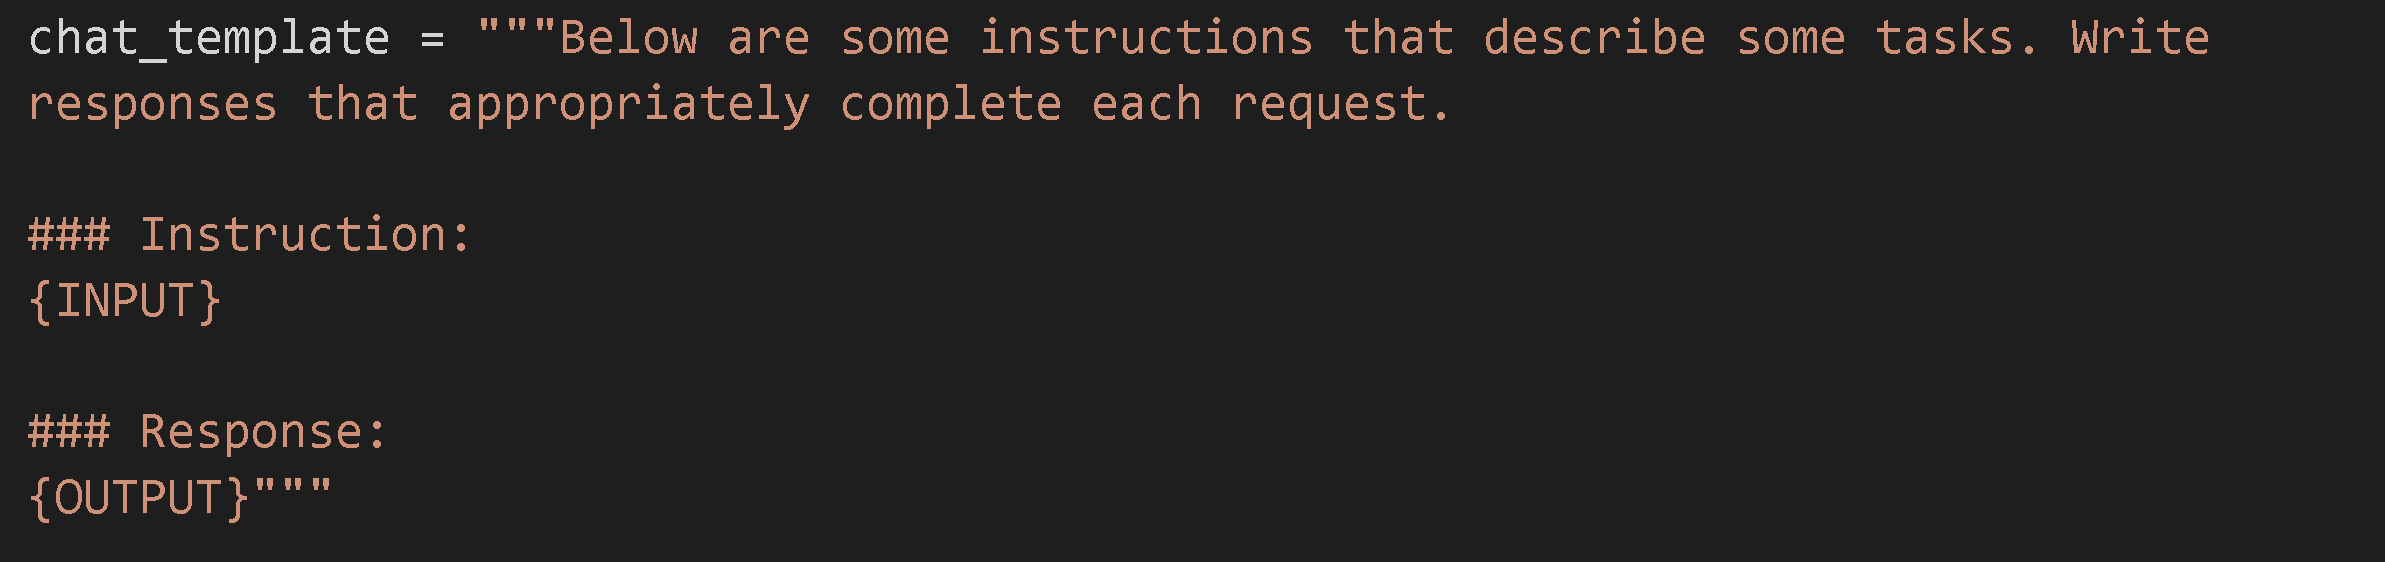
但还记得我们说过这是个坏主意吗，因为 ChatGPT 风格的微调只需要 1 个提示词？既然我们已经通过 Unsloth 成功把所有数据集列合并为 1 个，我们实际上就可以创建如下这种聊天模板，只包含 1 个输入列（instruction）和 1 个输出：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-d54582ae98c396d51bfb85628b46c54f2517d030%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

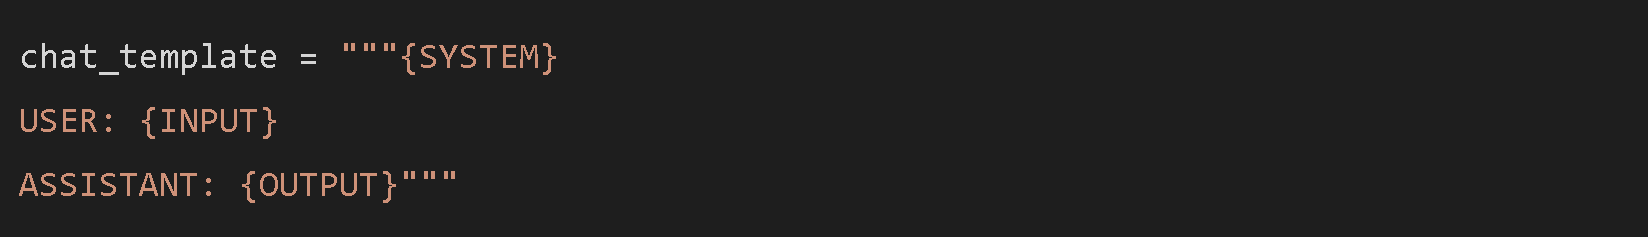
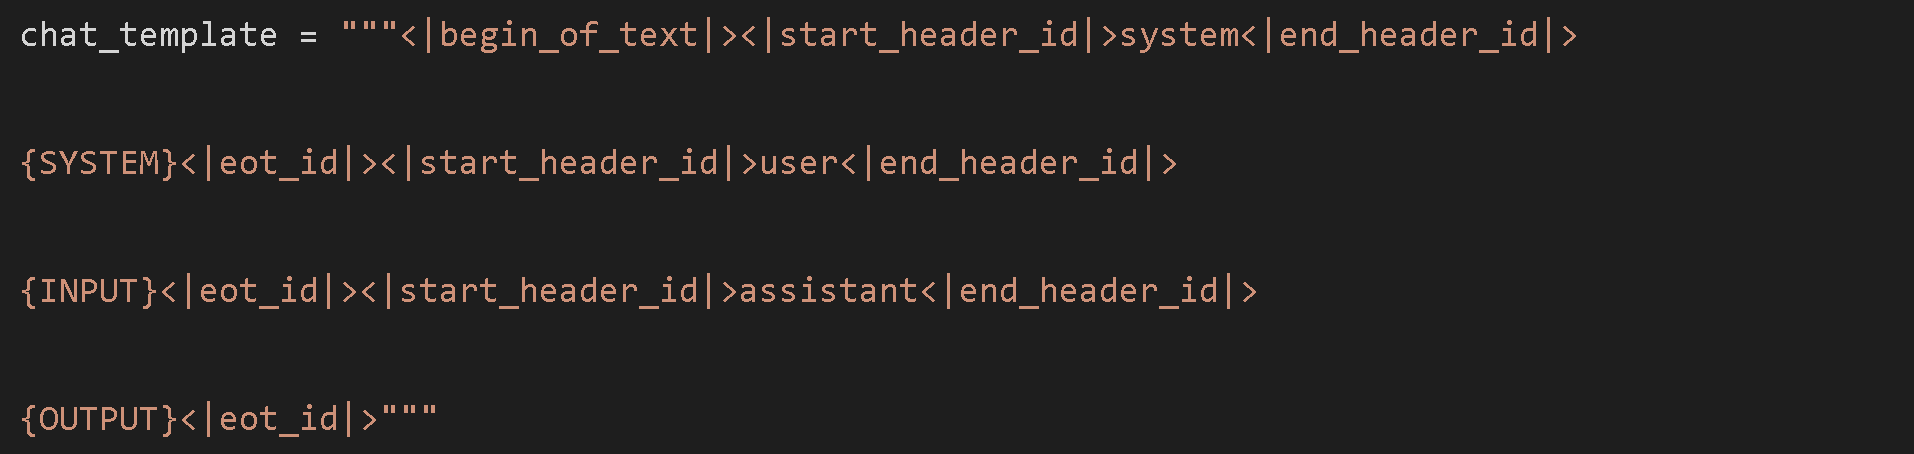
我们只要求你必须放入一个 `{INPUT}` 用于指令的字段，以及一个 `{OUTPUT}` 作为模型输出的字段。实际上我们也允许一个可选的 `{SYSTEM}` 字段，这对于像 ChatGPT 一样自定义系统提示很有用。例如，下面是一些很酷的示例，你可以把聊天模板自定义成：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cc455dc380d3d44ef136e485754964159dc773d8%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

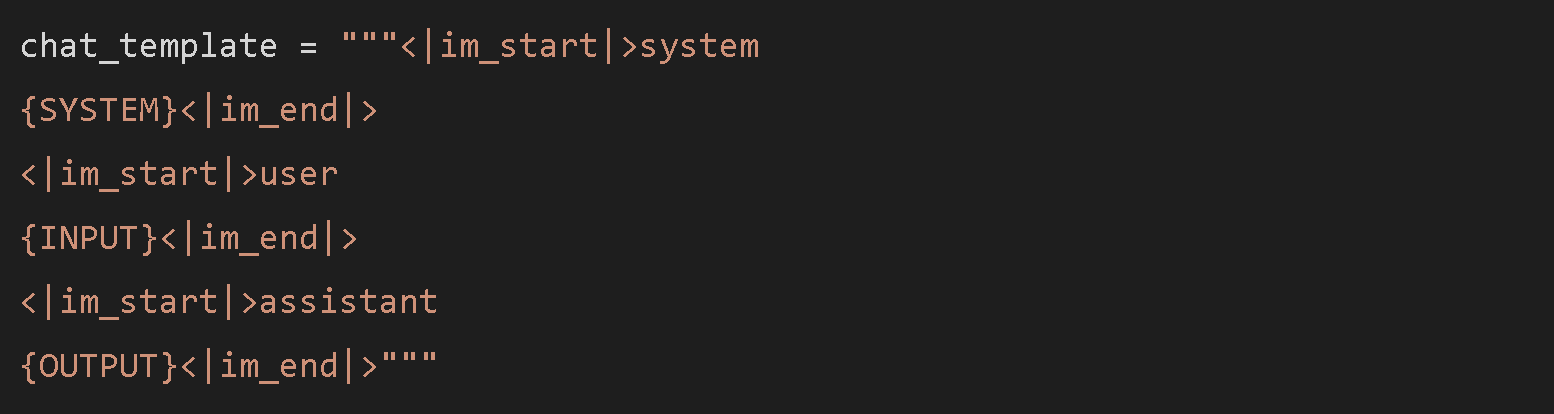
对于 OpenAI 模型中使用的 ChatML 格式：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-15bfca9cfadf10d54b4d3f66e3050044317d62c5%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

或者你也可以直接使用 Llama-3 模板本身（它只能通过使用 Llama-3 的 instruct 版本来工作）：实际上我们也允许一个可选的 `{SYSTEM}` 字段，这对于像 ChatGPT 一样自定义系统提示很有用。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-80a2ed4de2ca323ac192c513cac65e9e8bf475db%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

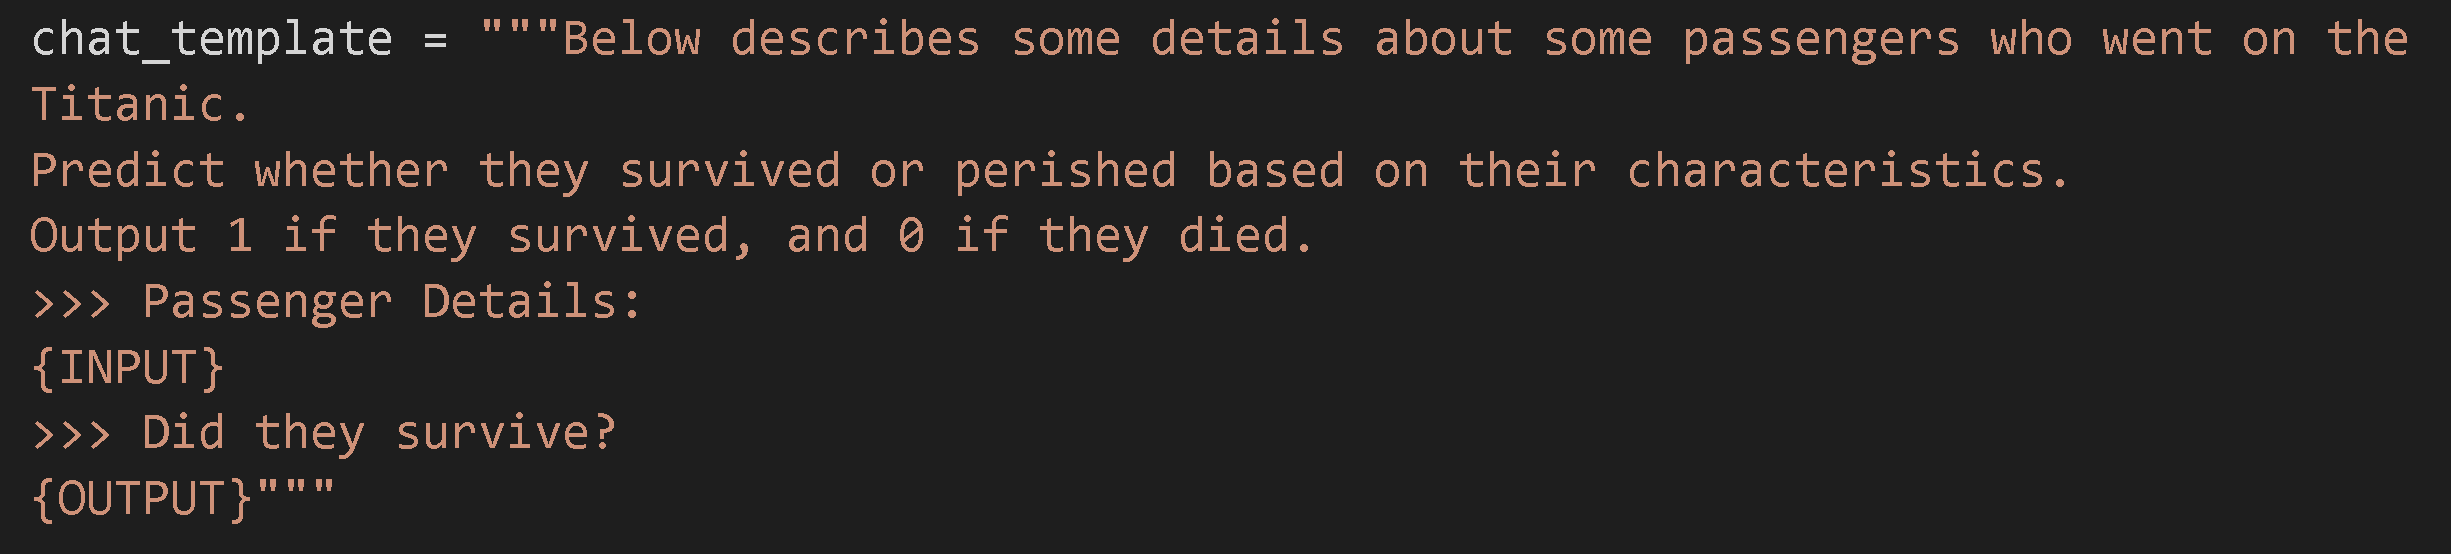
或者在 Titanic 预测任务中，你需要在这个包含 CSV 和 Excel 上传功能的 Colab 笔记本里预测乘客是死亡还是生还： <https://colab.research.google.com/drive/1VYkncZMfGFkeCEgN2IzbZIKEDkyQuJAS?usp=sharing>

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-20911ab305c1a10e85859c703157b80175141eb1%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 10. 训练模型

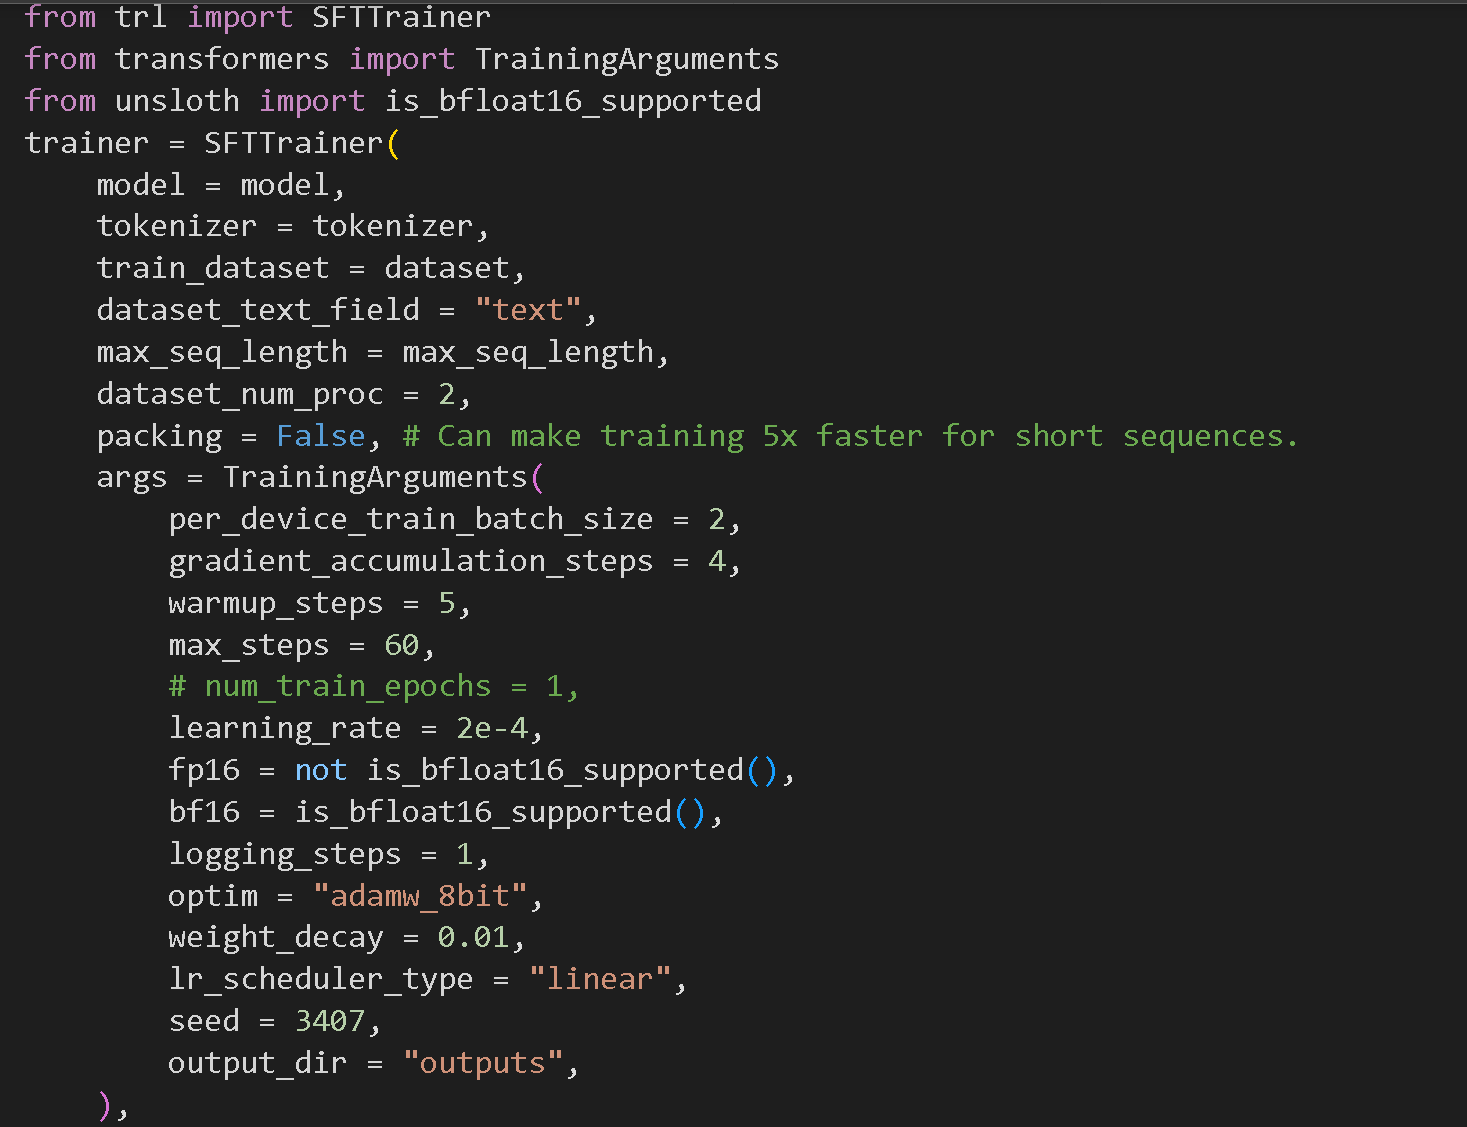
现在让我们来训练模型！我们通常建议不要修改下面的内容，除非你想进行更长步数的微调，或者想使用更大的 batch size 进行训练。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-f55503cea4d84b5885d0bcea0563fd716a0d2ed6%2Fimage%20(43).png?alt=media" alt=""><figcaption></figcaption></figure>

我们通常不建议更改上面的参数，但下面解释其中一些：

1. ```python
   per_device_train_batch_size = 2，
   ```

   如果你想更多地利用 GPU 内存，可以增大 batch size。增大它也会让训练更平滑，并使过程不那么容易过拟合。我们通常不建议这样做，因为由于 padding 问题，这实际上可能会让训练更慢。我们通常会建议你改为增加 `gradient_accumulation_steps` 这只是对数据集进行更多次遍历。
2. ```python
   gradient_accumulation_steps = 4,
   ```

   这相当于增大上面的 batch size，但不会影响内存占用！如果你想要更平滑的训练损失曲线，我们通常建议大家增大这个值。
3. ```python
   max_steps = 60，# num_train_epochs = 1，
   ```

   我们将 steps 设为 60 以加快训练。对于可能耗时数小时的完整训练，改为注释掉 `max_steps`，并将其替换为 `num_train_epochs = 1`。将其设为 1 表示对数据集完整遍历 1 次。我们通常建议遍历 1 到 3 次，不要更多，否则你的微调会过拟合。
4. ```python
   learning_rate = 2e-4,
   ```

   如果你想让微调过程更慢，可以降低学习率，但也更有可能收敛到更高精度的结果。我们通常建议尝试 2e-4、1e-4、5e-5、2e-5 这些数值。
<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-feb9b0f5763d41cecaec9a3a9cd227ad918f0ca7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

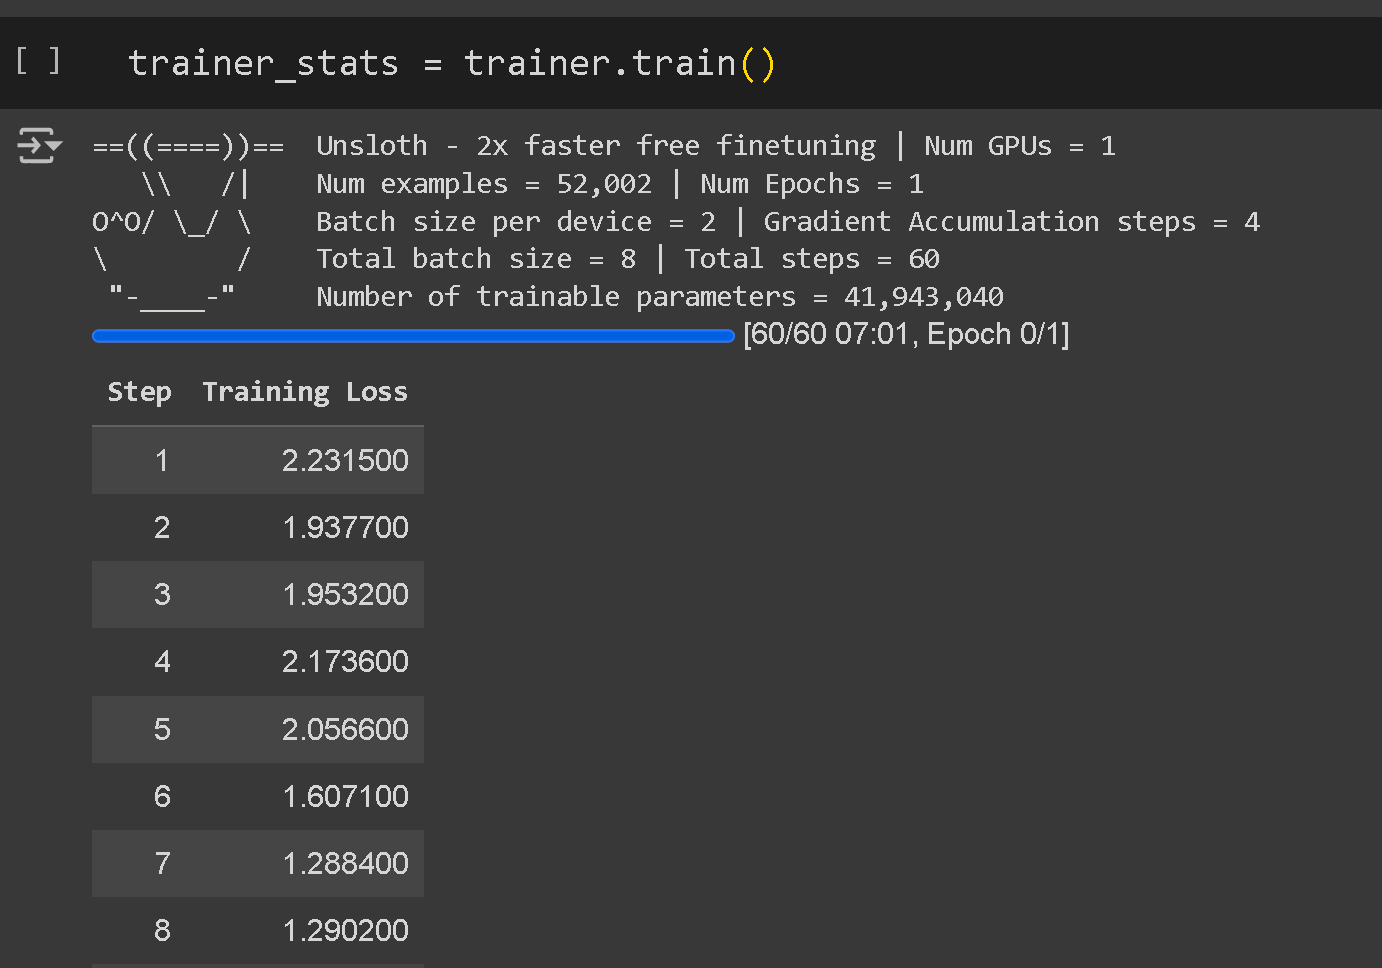
训练期间你会看到一串数字日志。这是训练损失，表示模型从你的数据集中学习得有多好。对于很多情况来说，损失值在 0.5 到 1.0 左右通常是个好迹象，但这取决于你的数据集和任务。如果损失没有下降，你可能需要调整设置。如果损失降到 0，那可能意味着过拟合，所以也要检查验证集。

## 11. 推理 / 运行模型

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-f2d5f23fa62ec89e06bf20fea433f9a1e42a2fe3%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

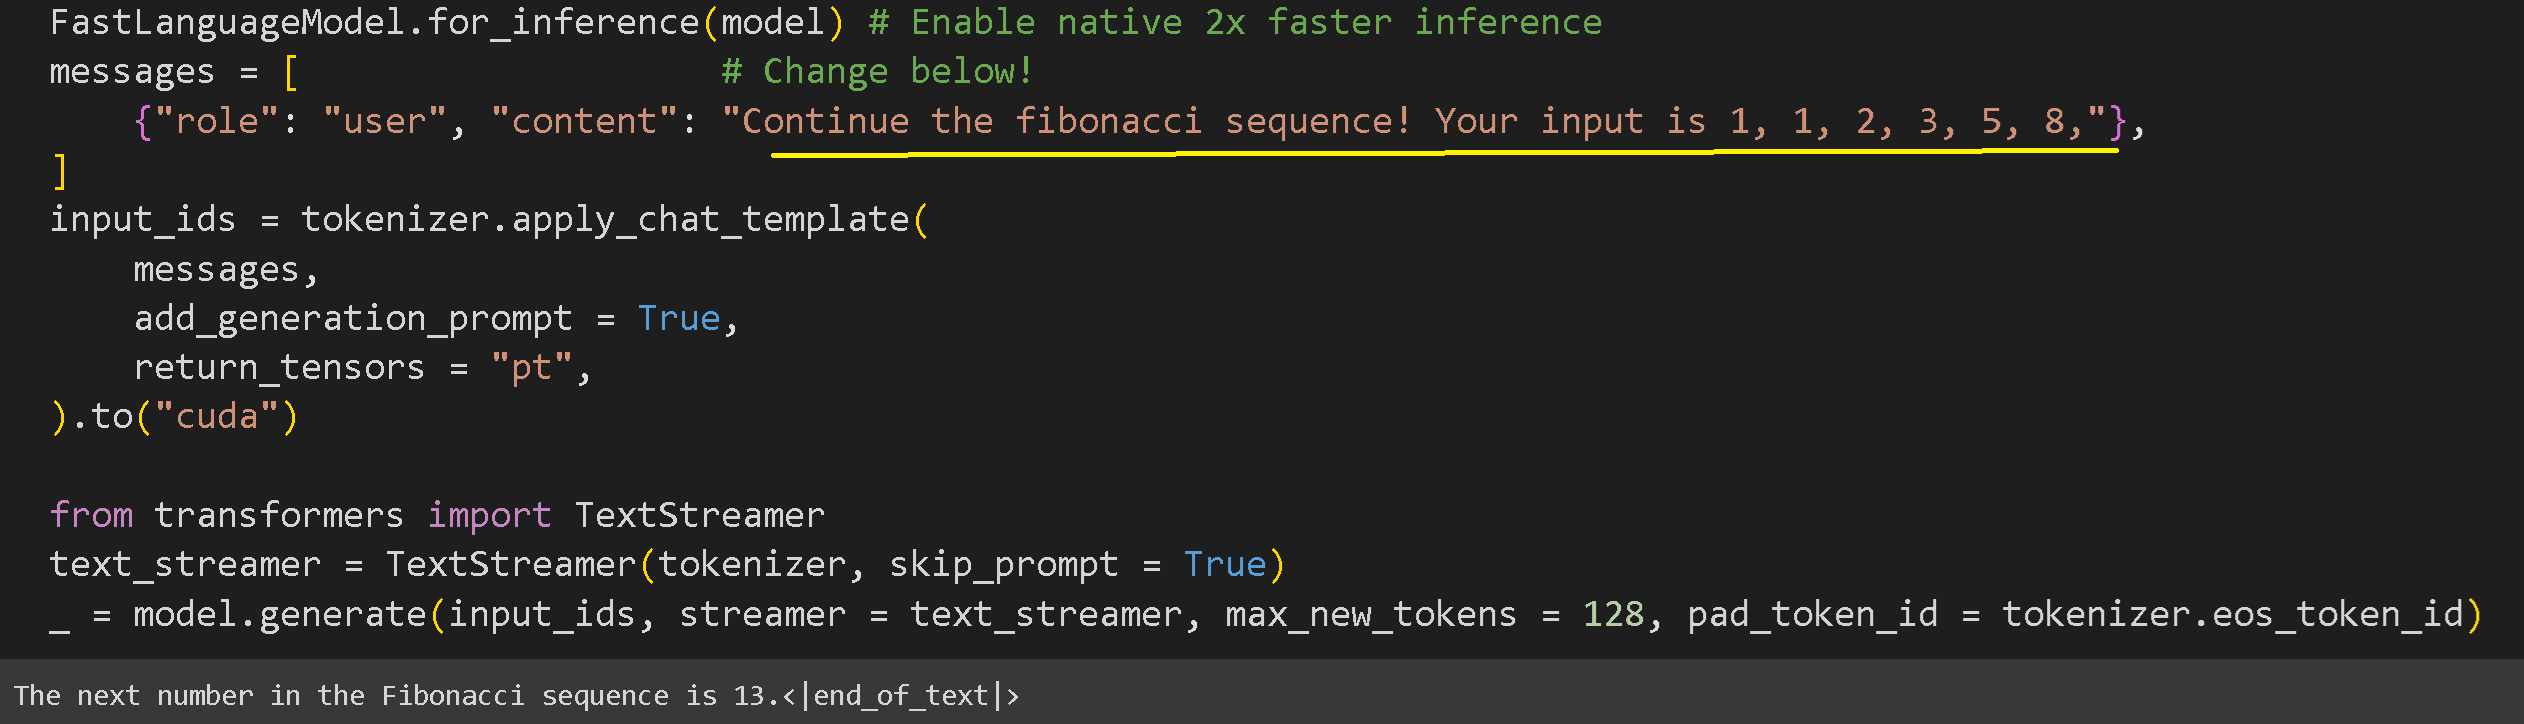
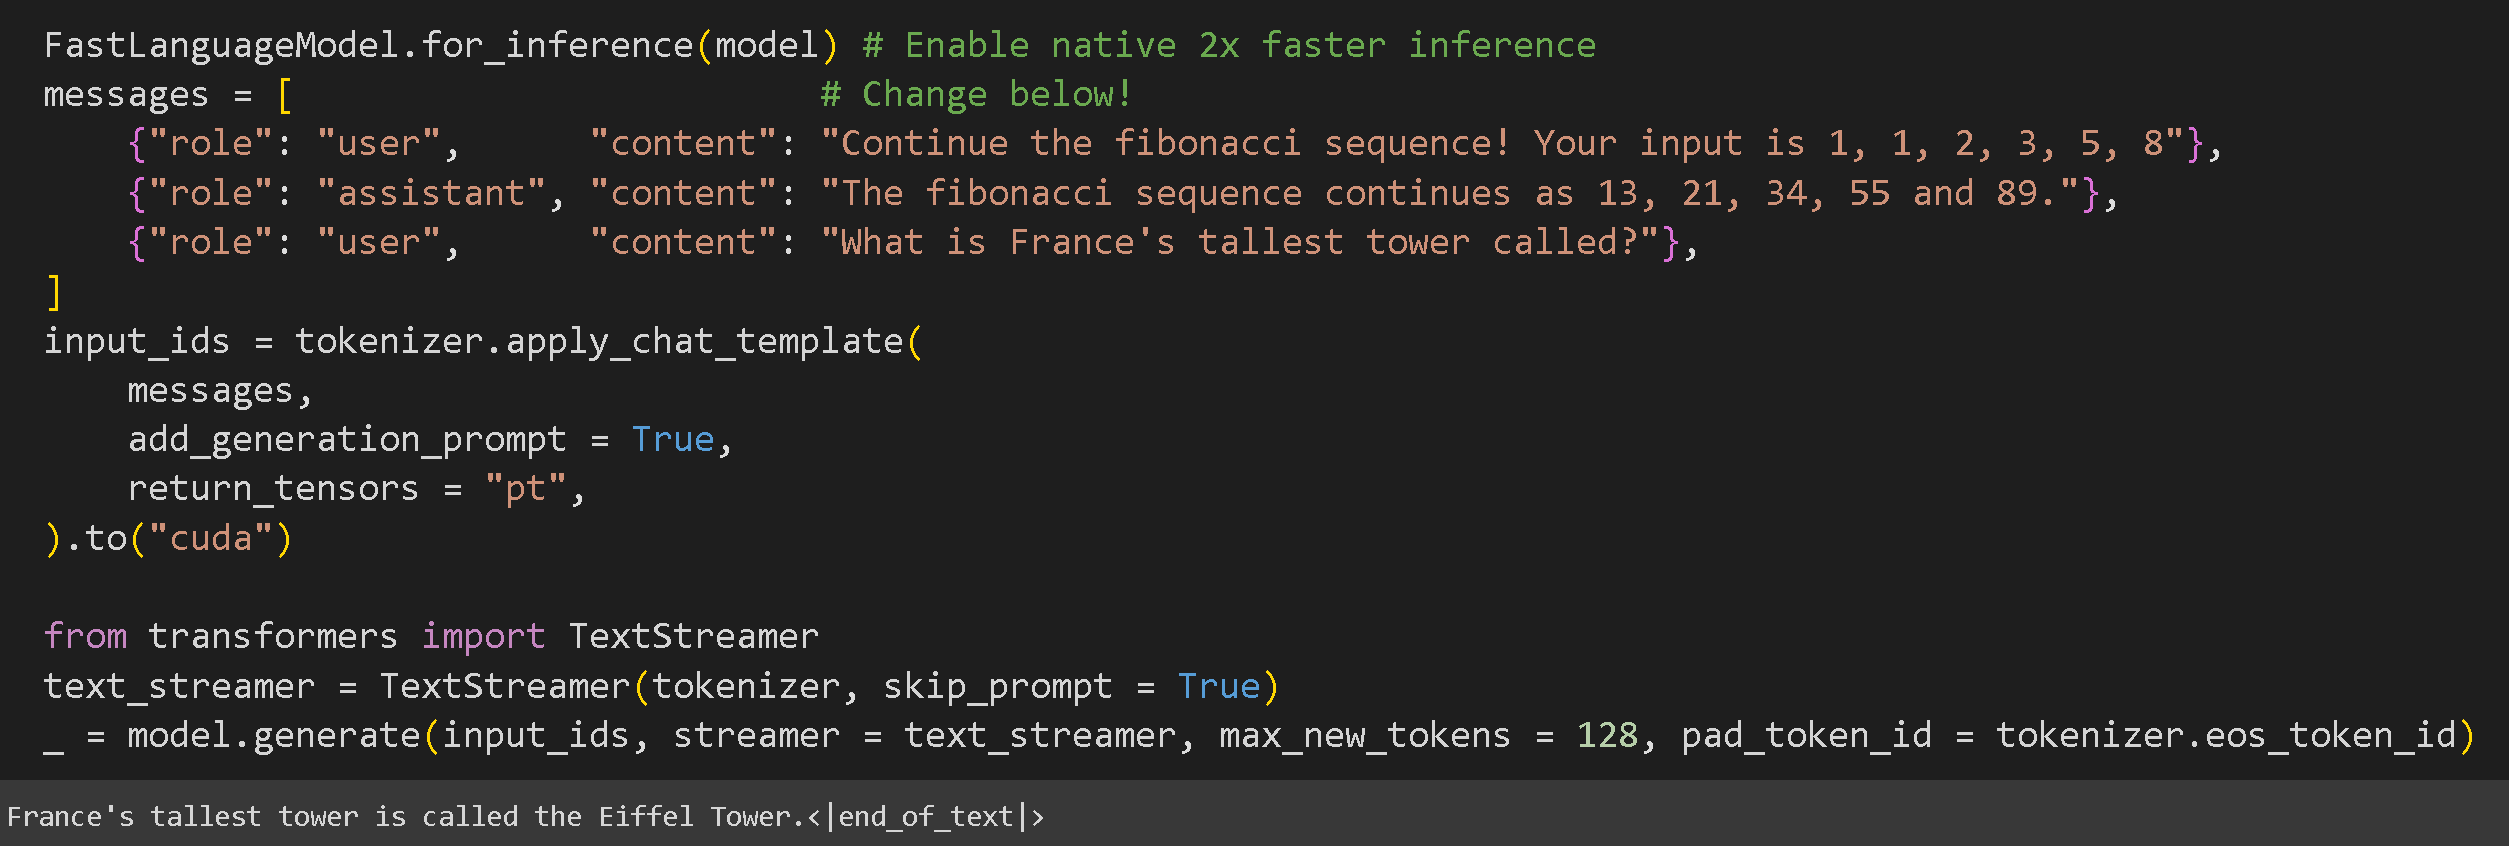
现在让我们在完成训练后运行模型！你可以编辑黄色下划线部分！实际上，由于我们创建了一个多轮聊天机器人，我们现在也可以像下面这样调用模型，仿佛它看到了之前的一些对话：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cdf5d779635901dce7793df92531dbf3caf0fb0a%2Fimage%20(47).png?alt=media" alt=""><figcaption></figcaption></figure>

提醒一下，Unsloth 本身也提供 **2 倍更快的推理** 的原生支持，所以一定不要忘记调用 `FastLanguageModel.for_inference(model)`。如果你想让模型输出更长的回复，请将 `max_new_tokens = 128` 设为更大的数值，例如 256 或 1024。注意你也需要等待更长时间才能得到结果！

## 12. 保存模型

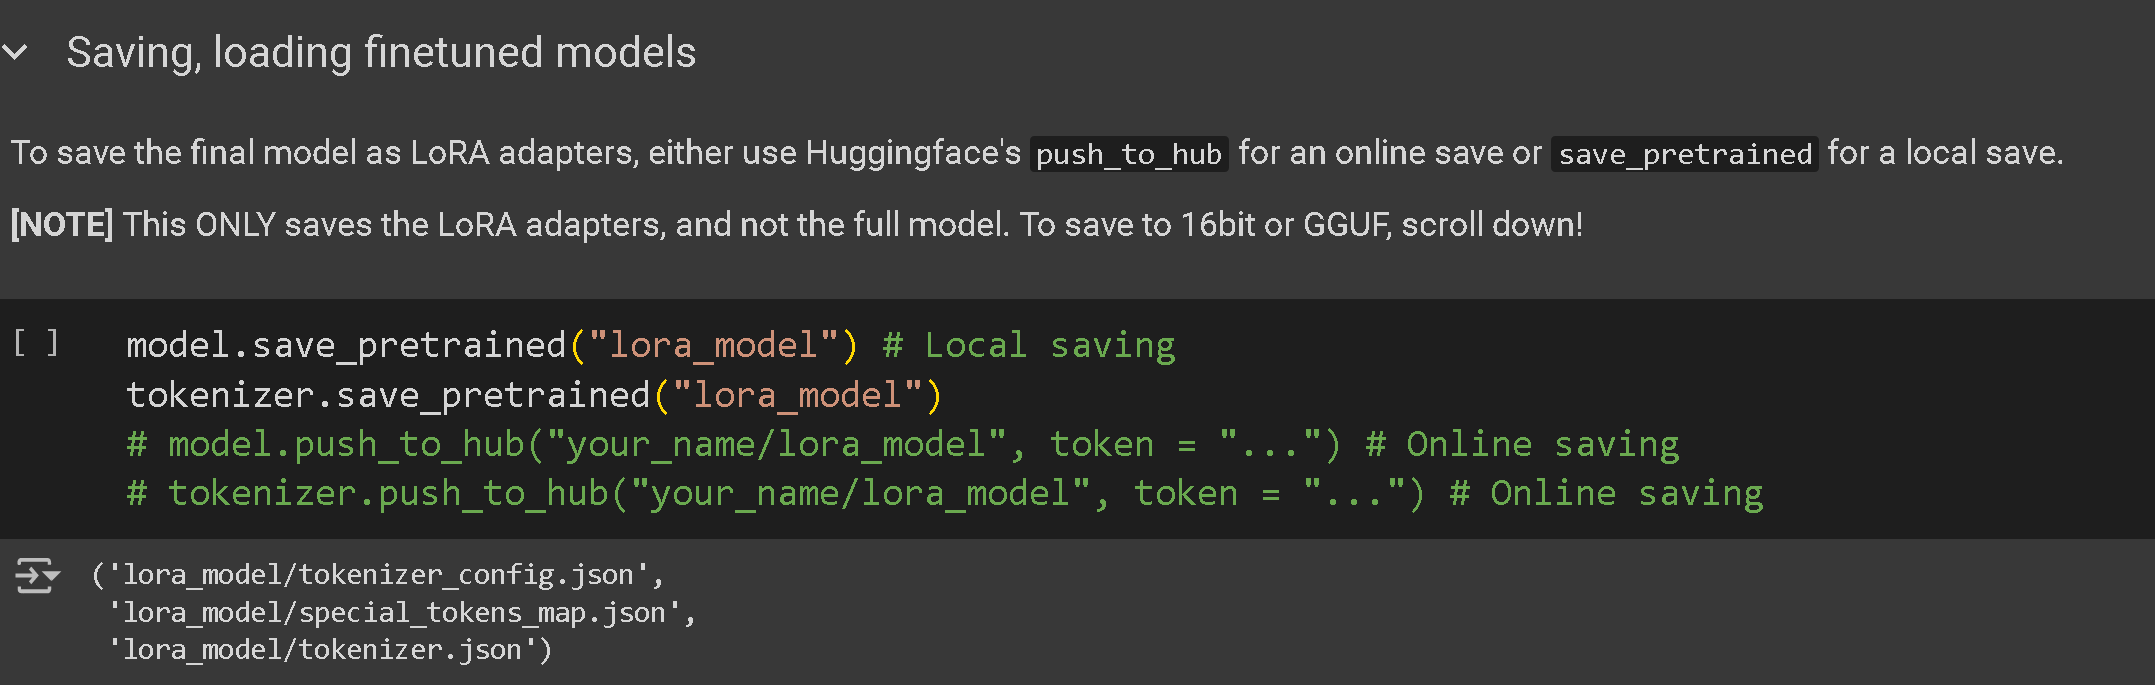
现在我们可以像下面这样把微调后的模型保存为一个名为 LoRA adapter 的 100MB 小文件。如果你想上传模型，也可以改为推送到 Hugging Face Hub！记得通过……获取 Hugging Face token <https://huggingface.co/settings/tokens> 并添加您的 token！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8c577103f7c4fe883cabaf35c8437307c6501686%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

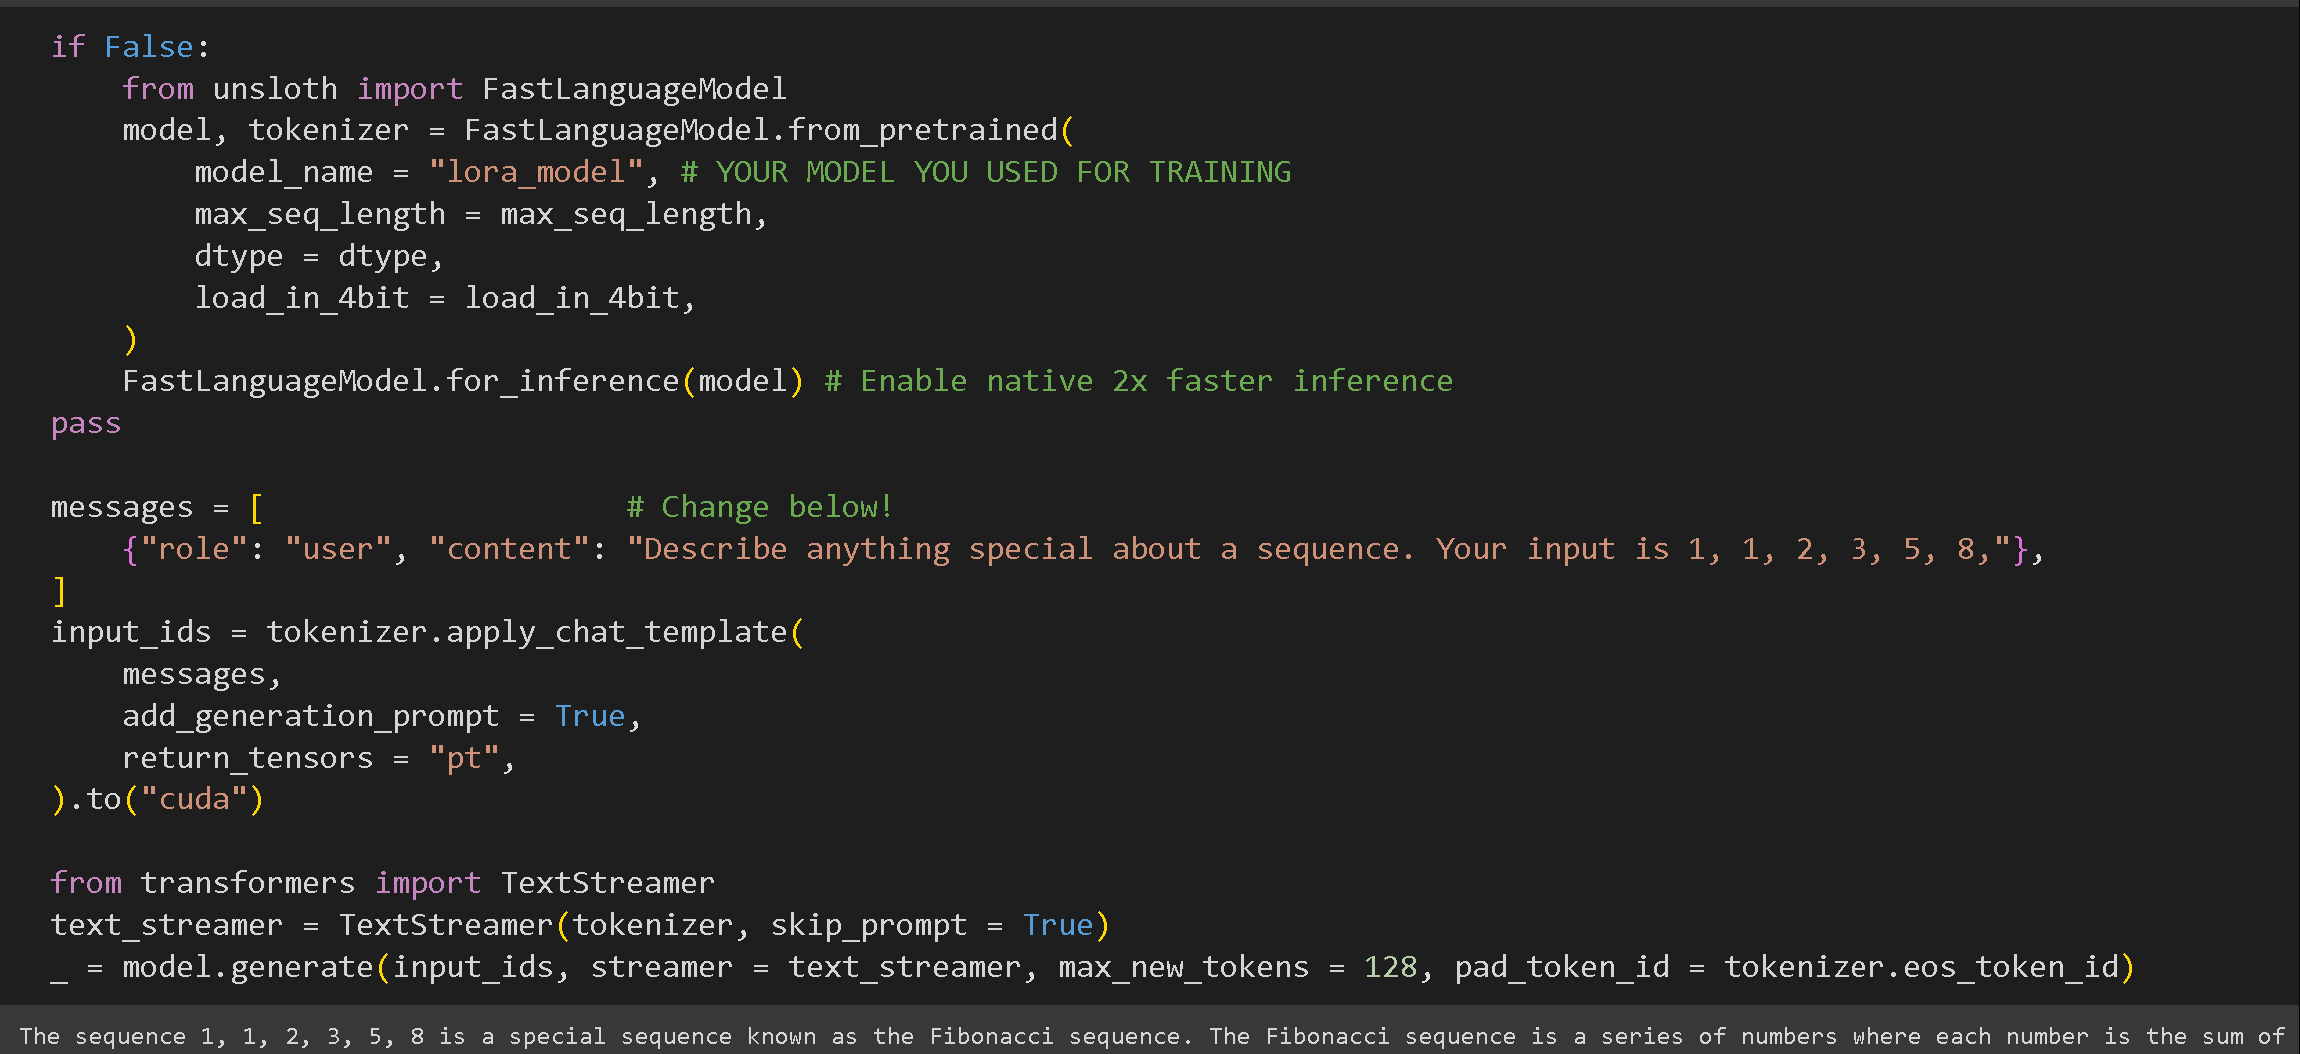
保存模型后，我们又可以使用 Unsloth 来运行模型本身！使用 `FastLanguageModel` 再次调用它进行推理！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1a1be852ca551240bdce47cf99e6ccd7d31c1326%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 13. 导出到 Ollama

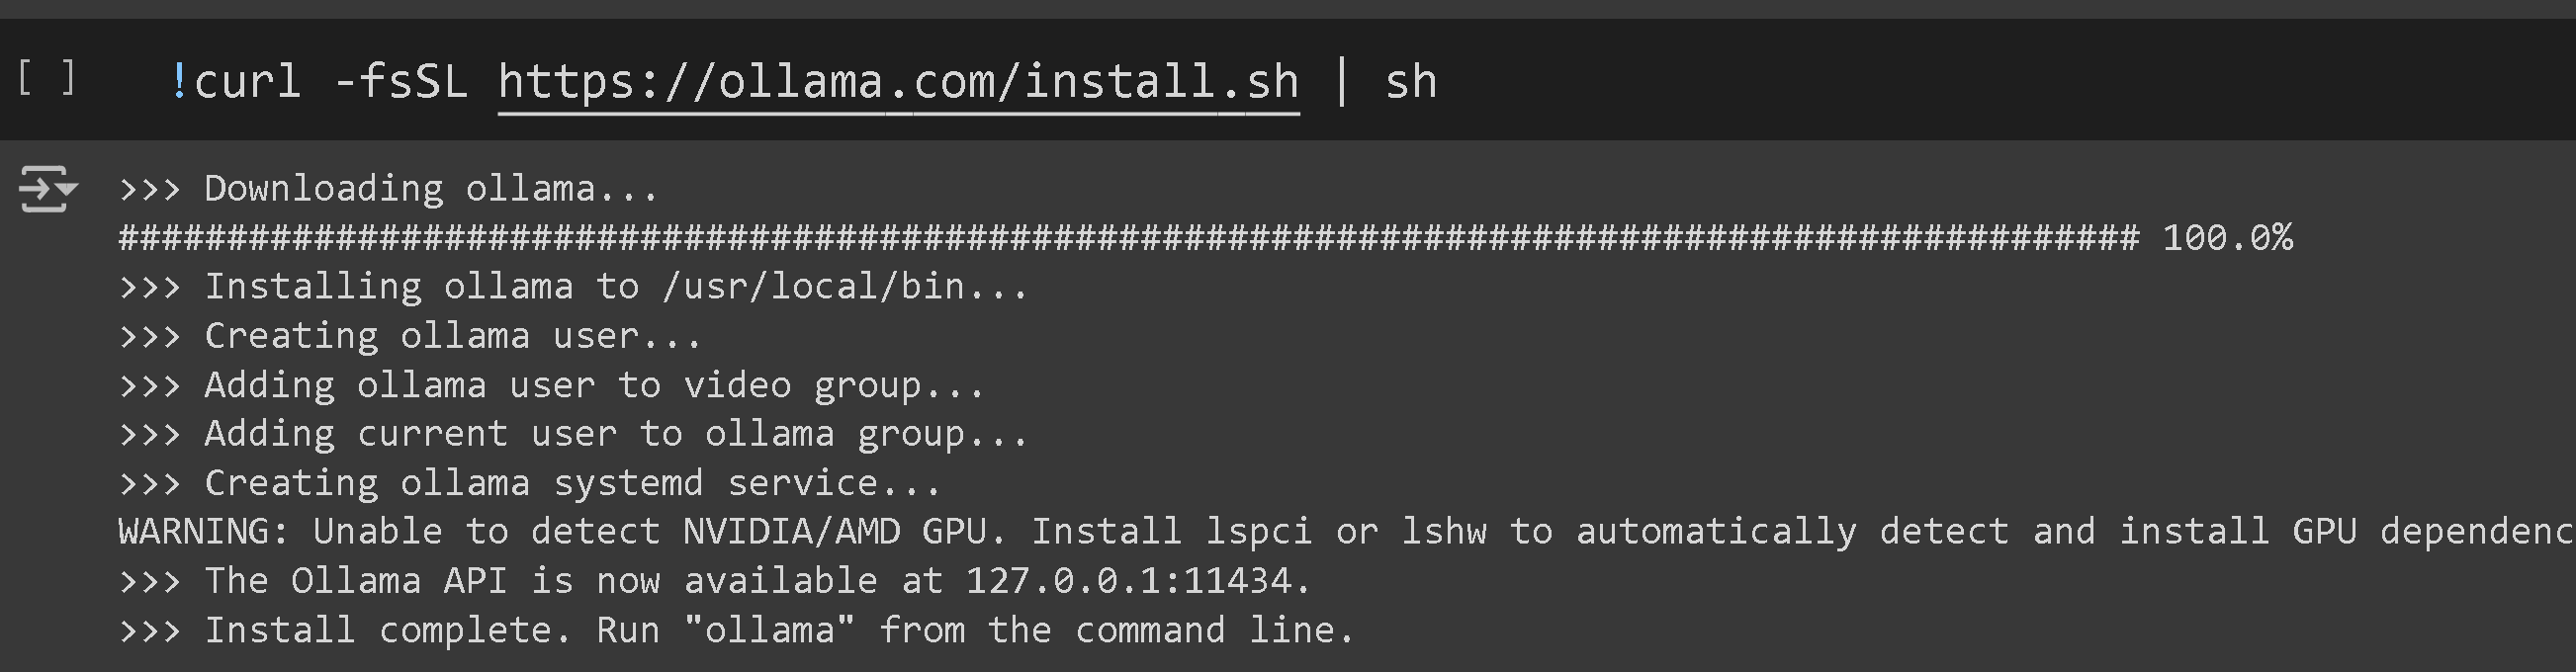
最后，我们可以将微调后的模型导出到 Ollama！首先，我们必须在 Colab 笔记本中安装 Ollama：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-24f9429ed4a8b3a630dc8f68dcf81555da0a80ee%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

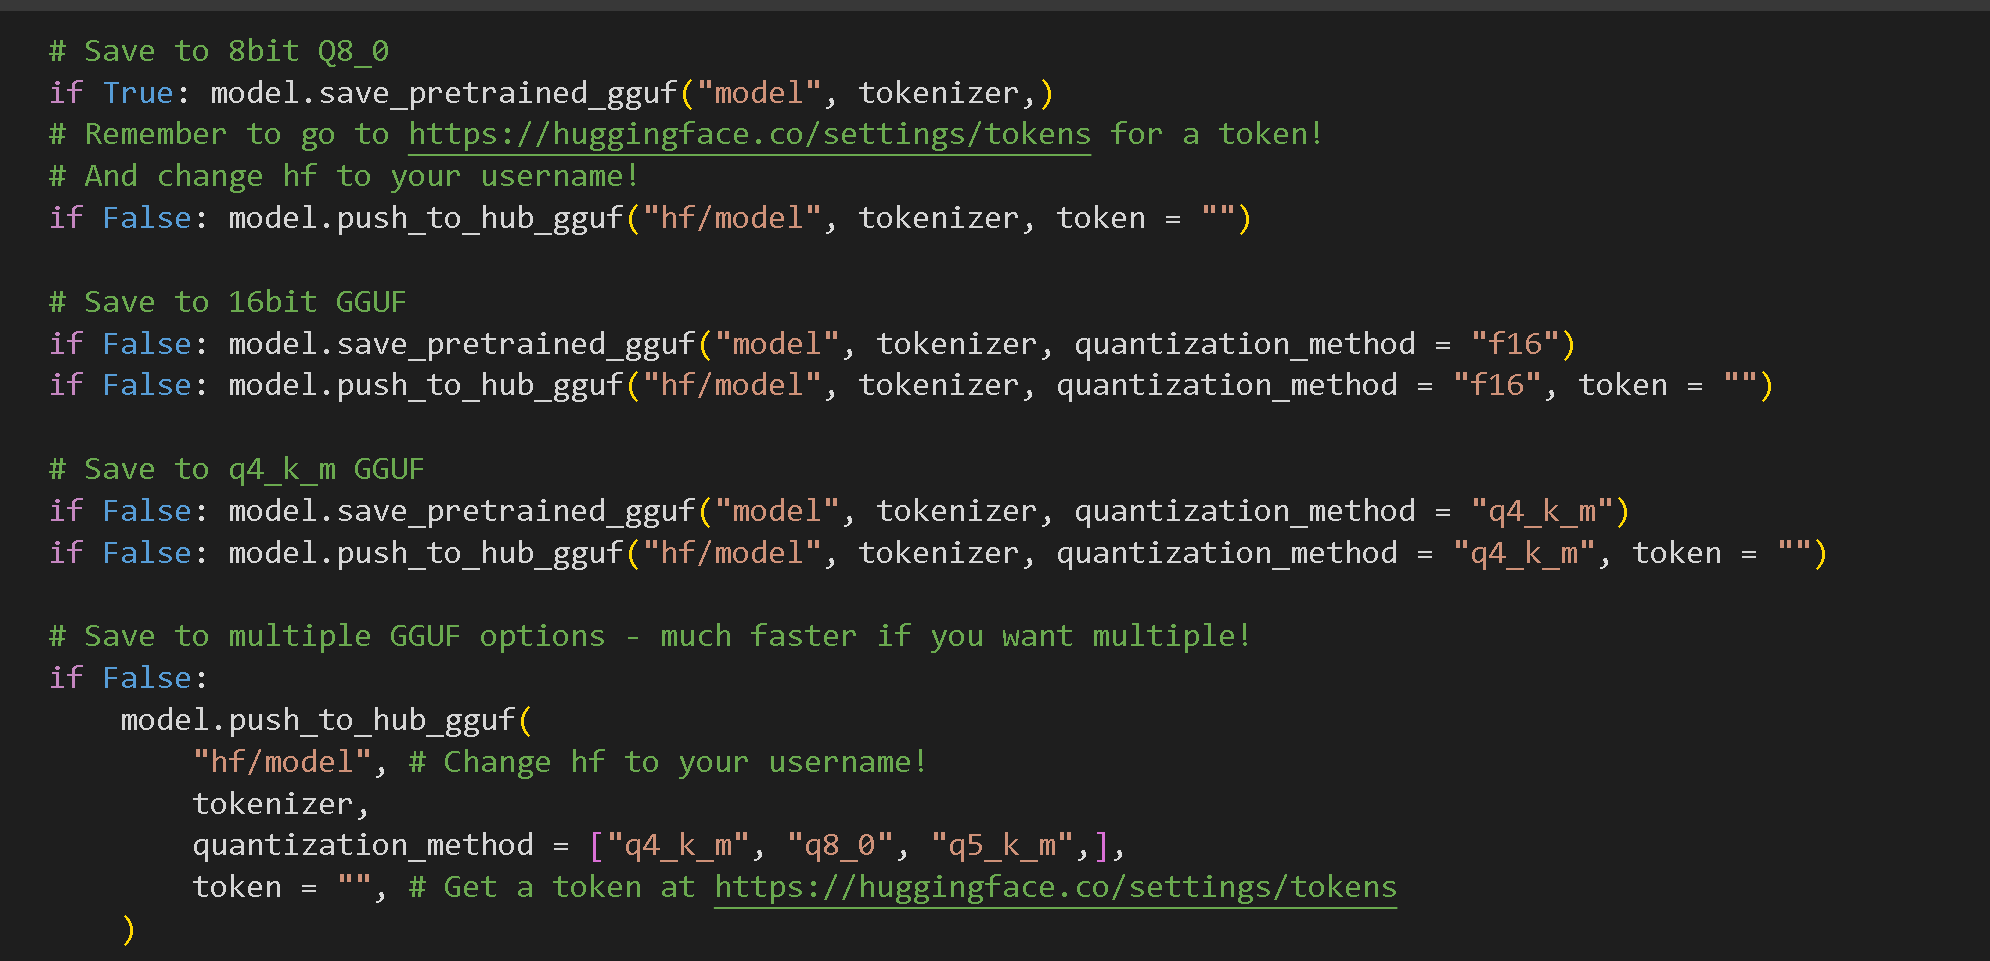
然后我们将微调后的模型导出为 llama.cpp 的 GGUF 格式，如下所示：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-56991ea7e2685bb9905af9baf2f3f685123dcdd8%2Fimage%20(52).png?alt=media" alt=""><figcaption></figcaption></figure>

提醒转换 `假` 改为 `真` 为 1 行，而不是把每一行都改成 `真`，否则您会等待很长时间！我们通常建议将第一行设为 `真`，这样我们就能快速将微调后的模型导出为 `Q8_0` 格式（8 位量化）。我们也允许您导出为一整套量化方法，其中一种很受欢迎的是 `q4_k_m`.

前往 <https://github.com/ggml-org/llama.cpp> 了解更多关于 GGUF 的信息。如果您愿意，我们这里也提供了一些手动导出到 GGUF 的说明： <https://github.com/unslothai/unsloth/wiki#manually-saving-to-gguf>

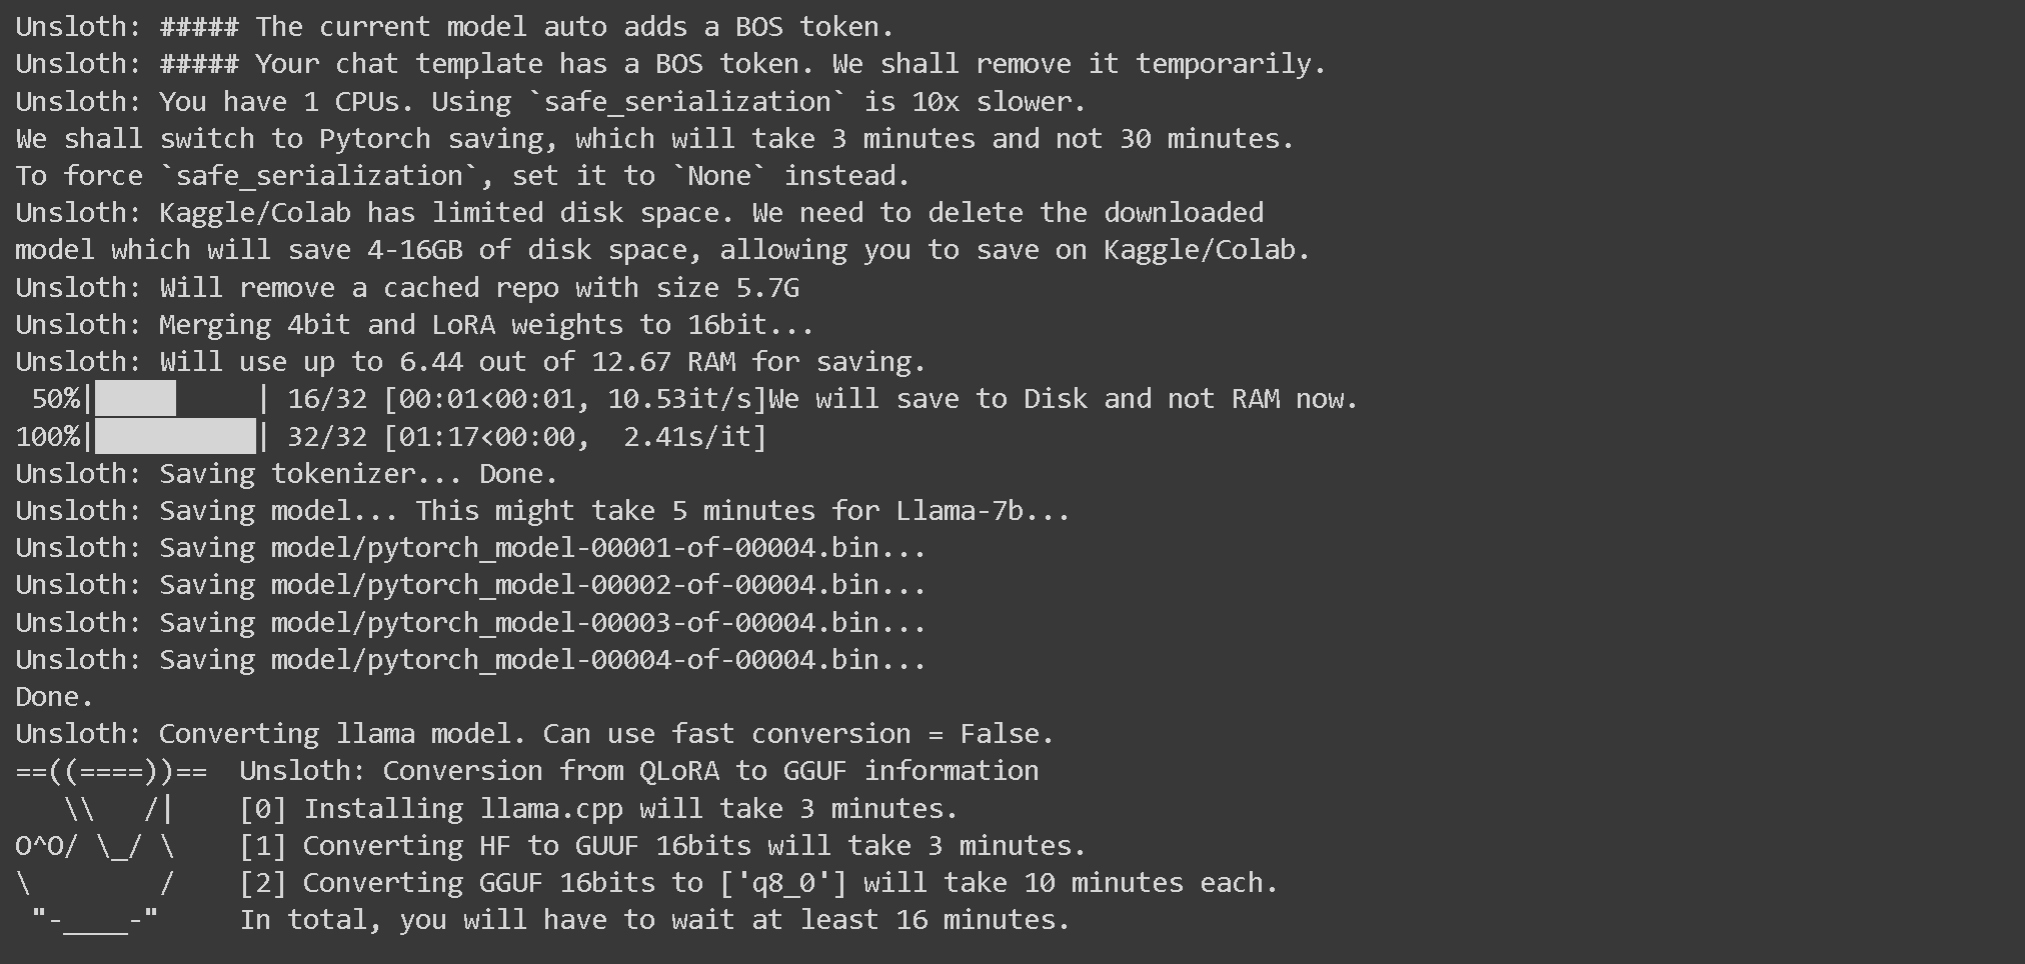
您会看到如下所示的一长串文本——请等待 5 到 10 分钟！！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-271b392fdafd0e7d01c525d7a11a97ee5c34b713%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

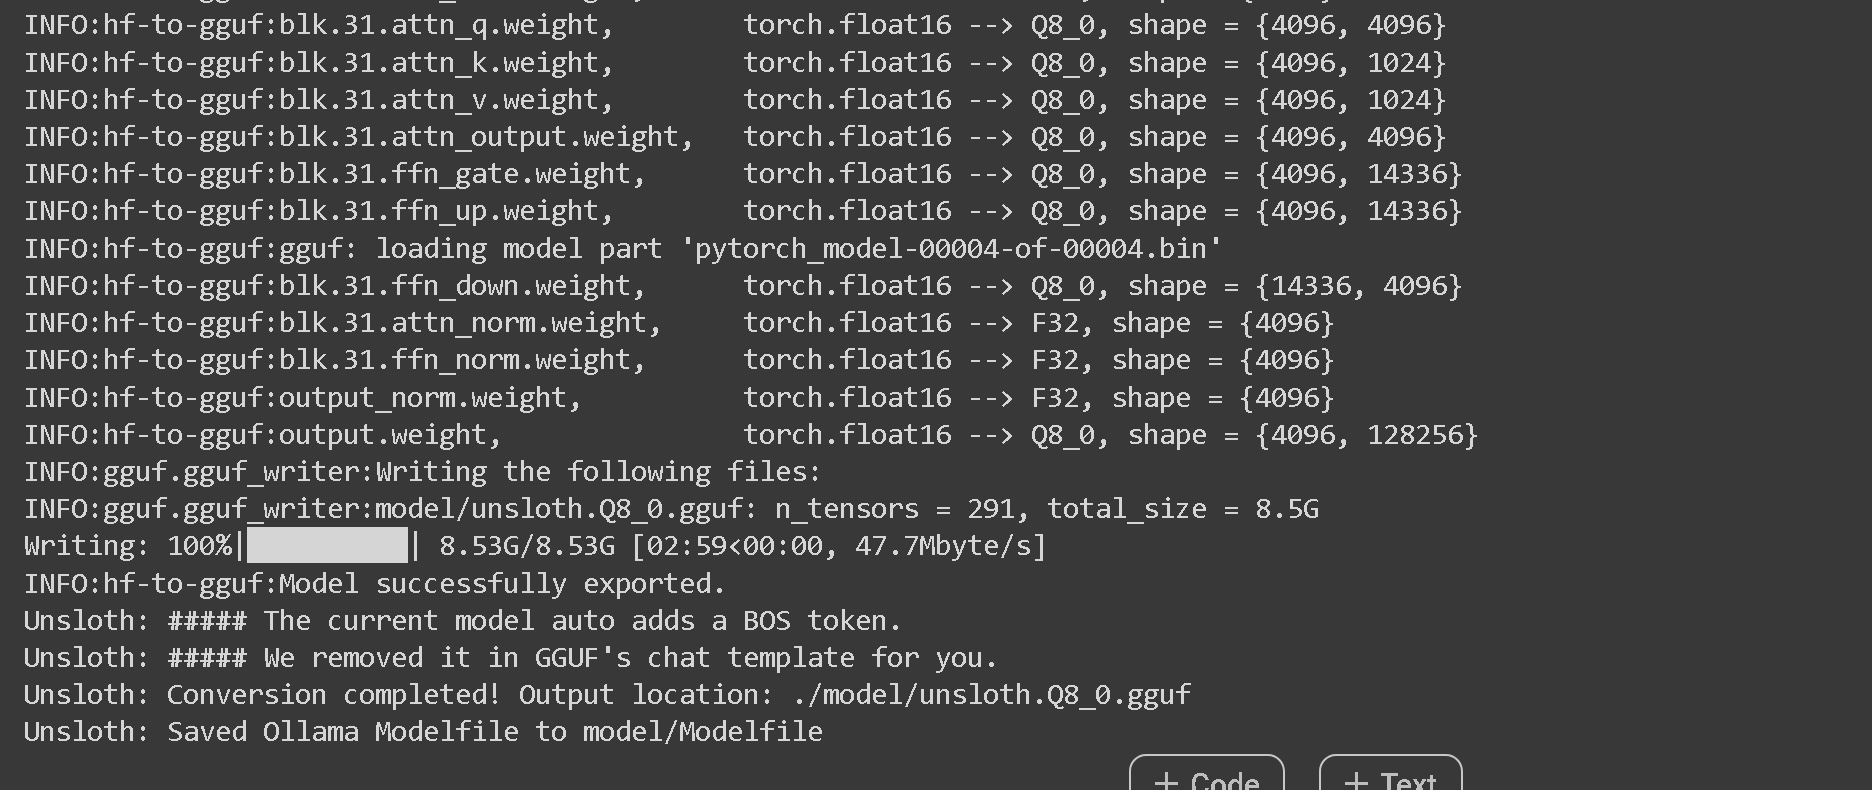
最后在最末尾时，它会像下面这样：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a554bd388fd0394dd8cdef85fd9d208bfd7feee7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

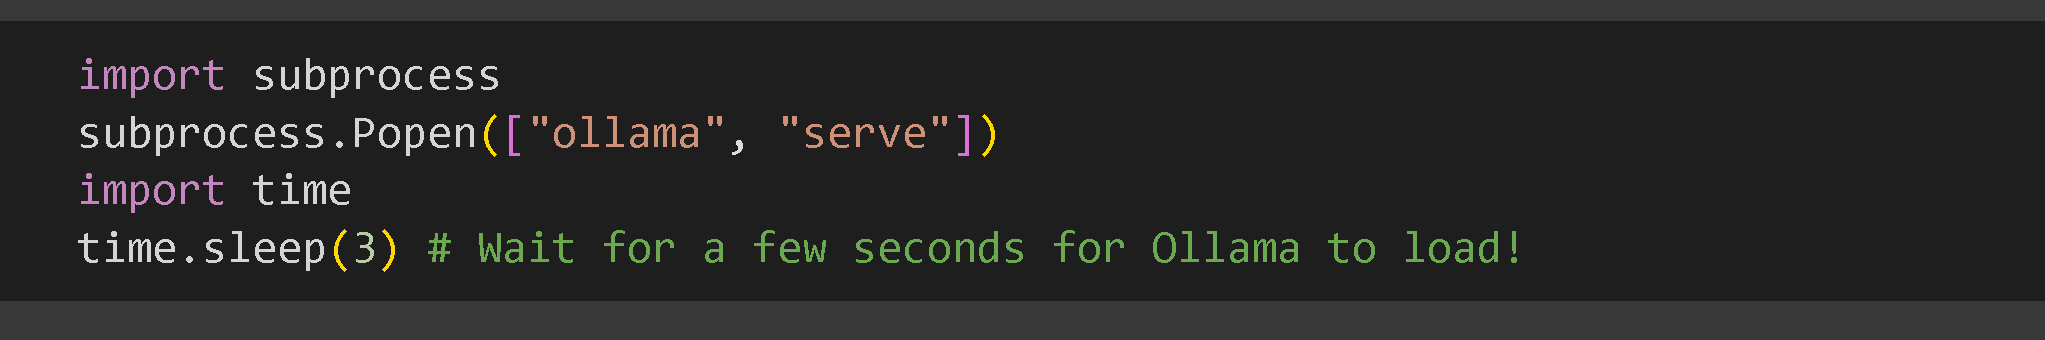
然后，我们必须在后台运行 Ollama 本身。我们使用 `subprocess` 因为 Colab 不喜欢异步调用，但通常只需在 `ollama serve` 终端 / 命令提示符中运行即可。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e431609dfc5c742f0b5ab2388dbbd0d8e15c7670%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 14. 自动 `Modelfile` 创建

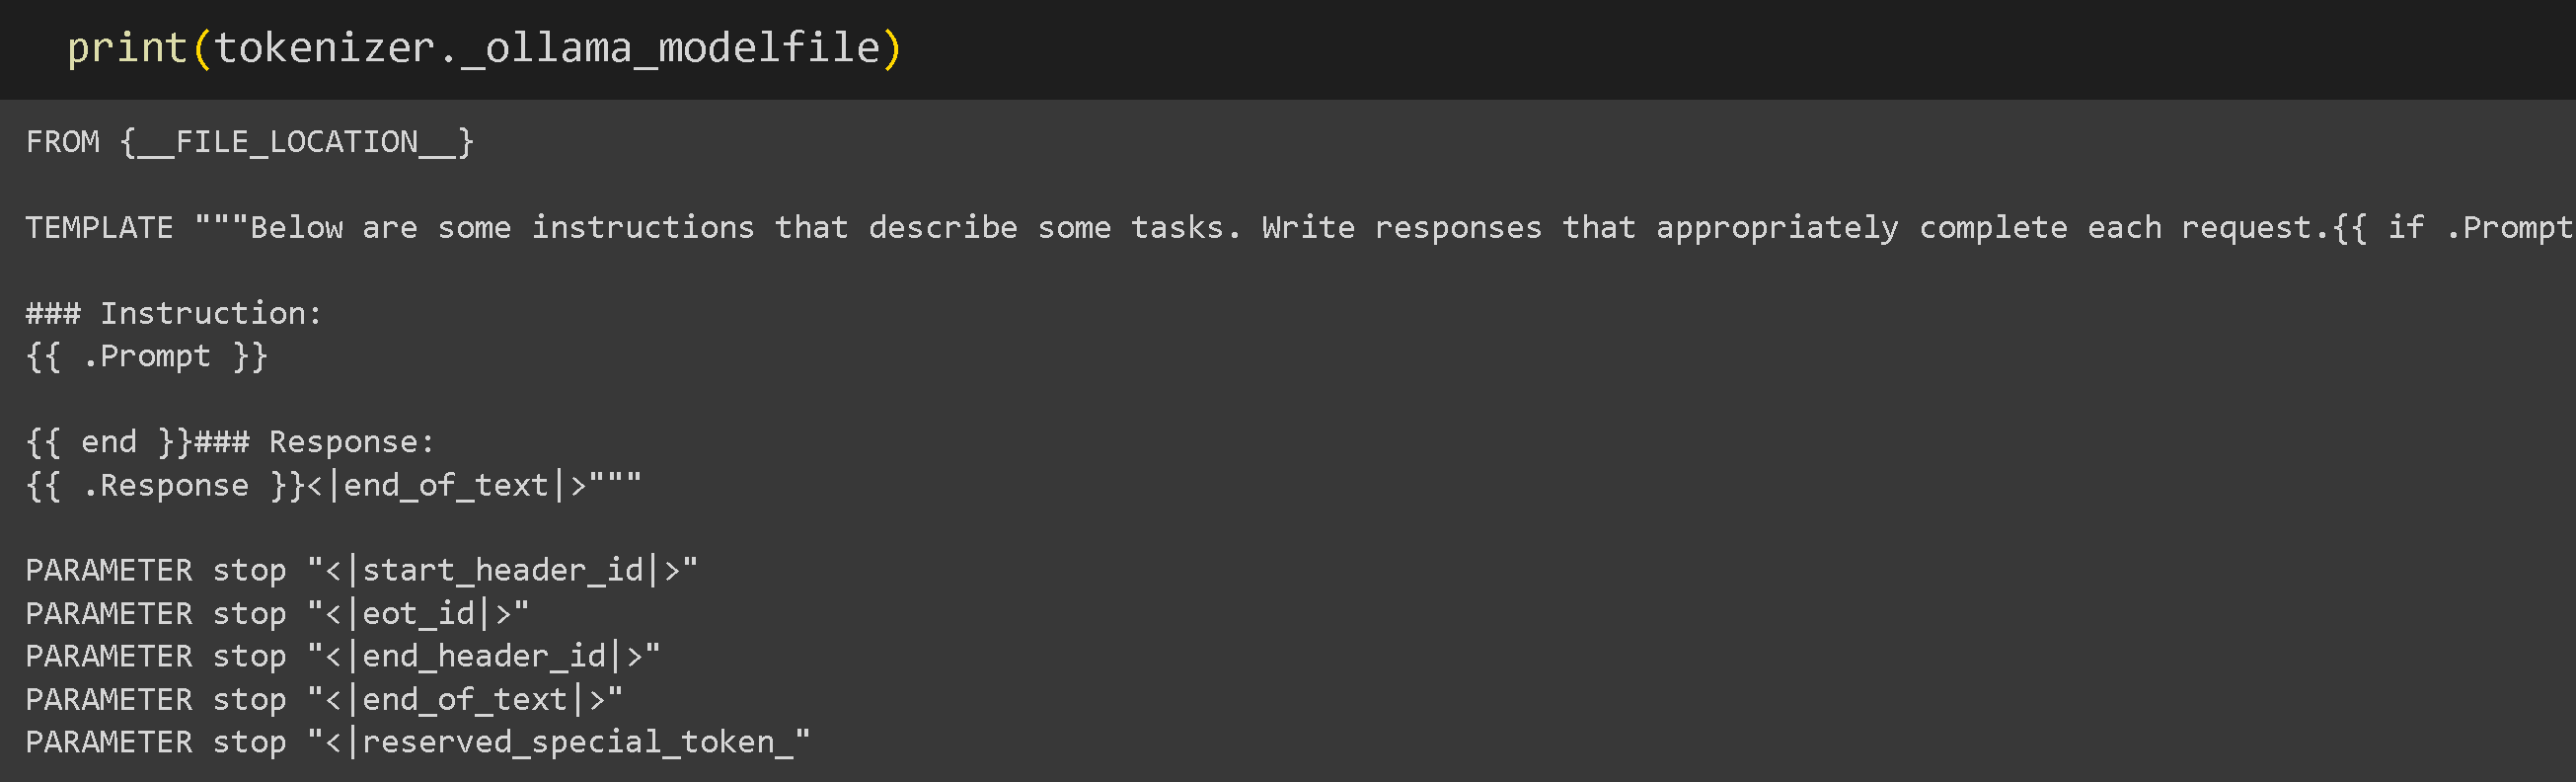
Unsloth 提供的技巧是，我们会自动创建一个 `Modelfile` ，这是 Ollama 所必需的！这只是一组设置，并包含我们在微调过程中使用的聊天模板！您还可以像下面这样打印 `Modelfile` 生成的内容：

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-6945ba10a2e25cfc198848c0e863001375c32c4c%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

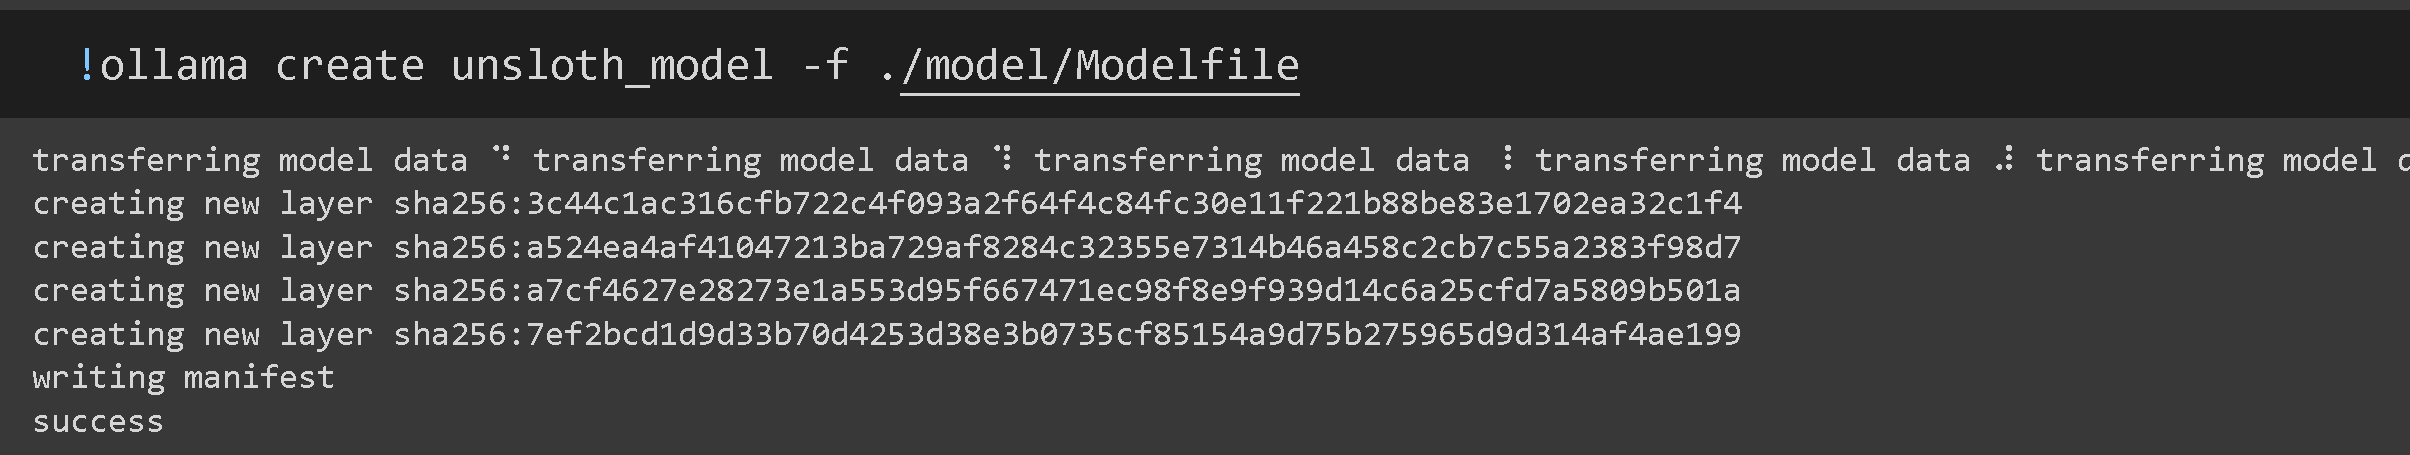
然后我们使用 `Modelfile`

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-d431a64613b39d913d1780c22cde37edc6564272%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 15. Ollama 推理

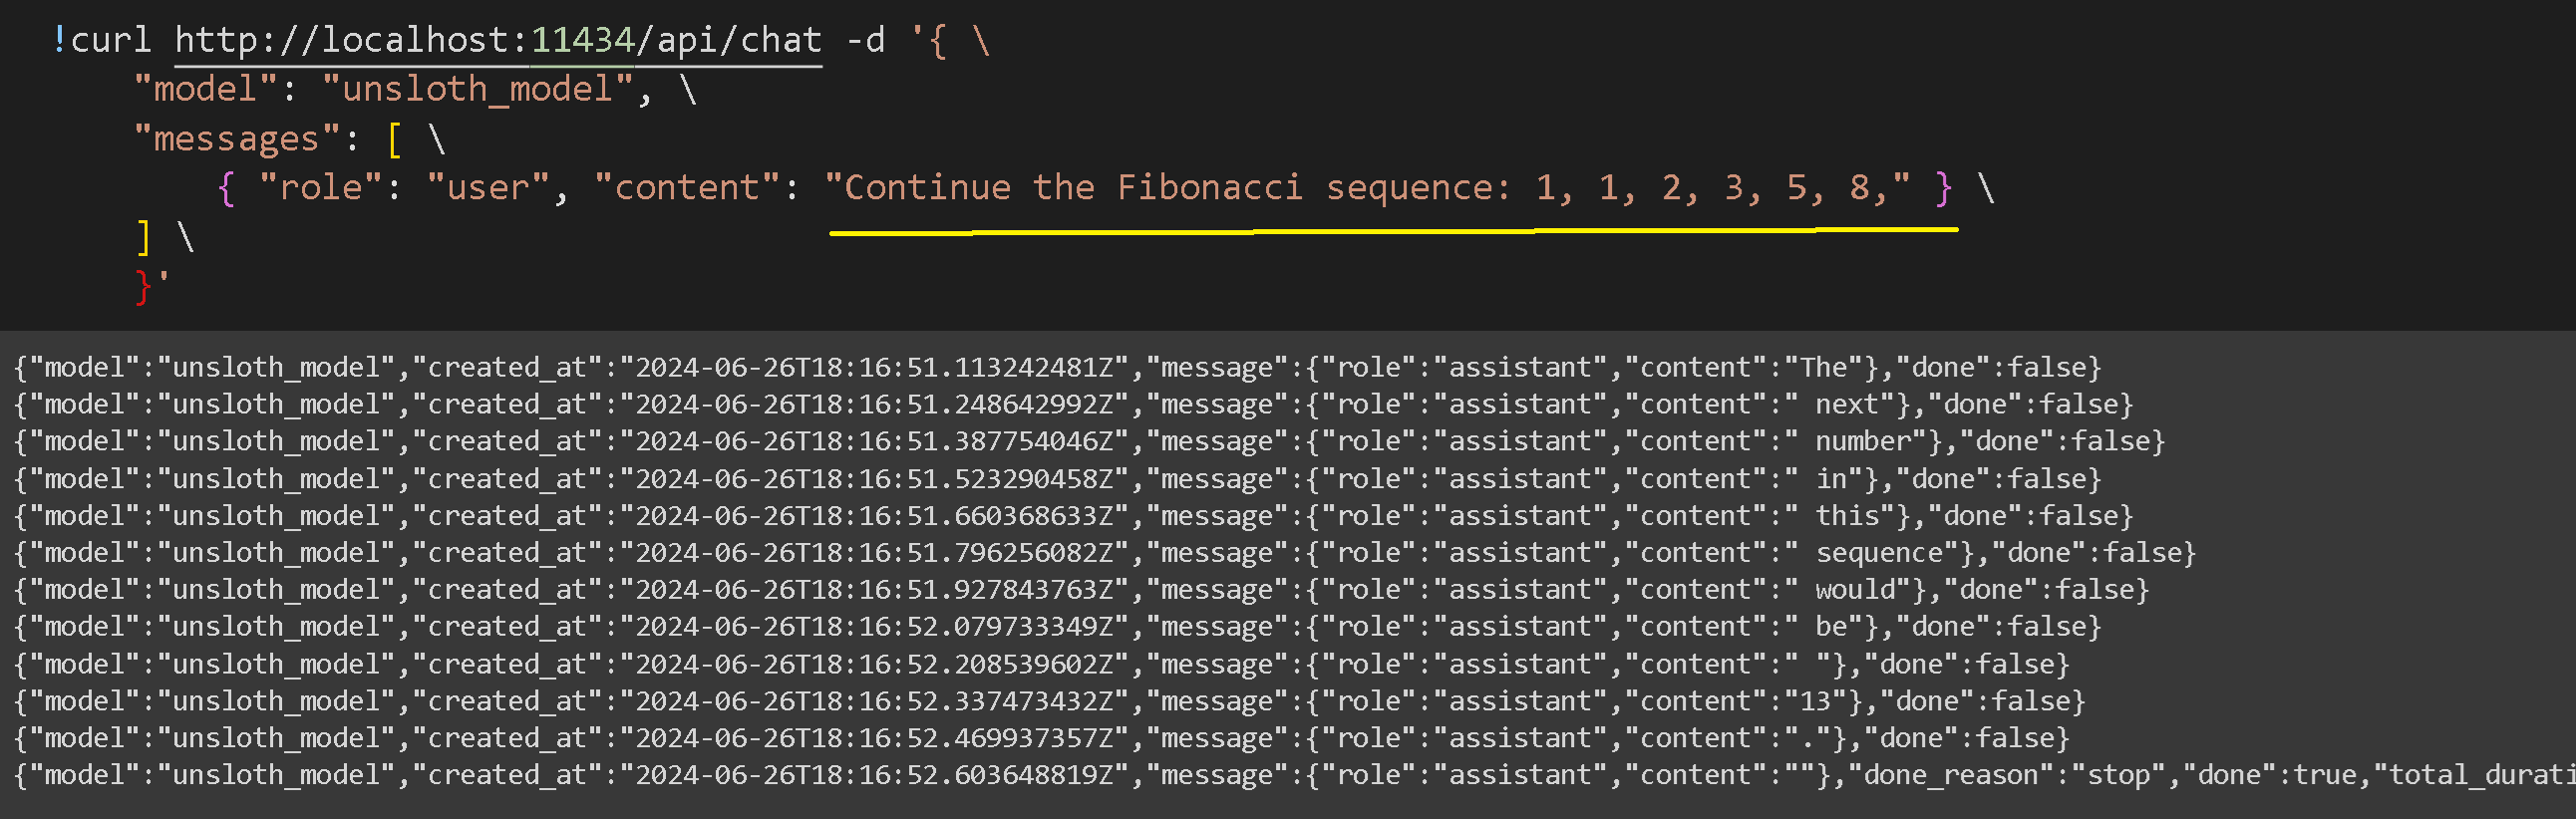
来让 Ollama 创建一个兼容的模型，如果您想直接调用正在您本地机器上 / 免费 Colab 笔记本后台运行的 Ollama 服务器，现在就可以这样做。记得您可以编辑黄色下划线部分。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-49b93efa192fdd741f3ac8484cef8c3fd7415283%2FInference.png?alt=media" alt=""><figcaption></figcaption></figure>

## 16. 交互式 ChatGPT 风格

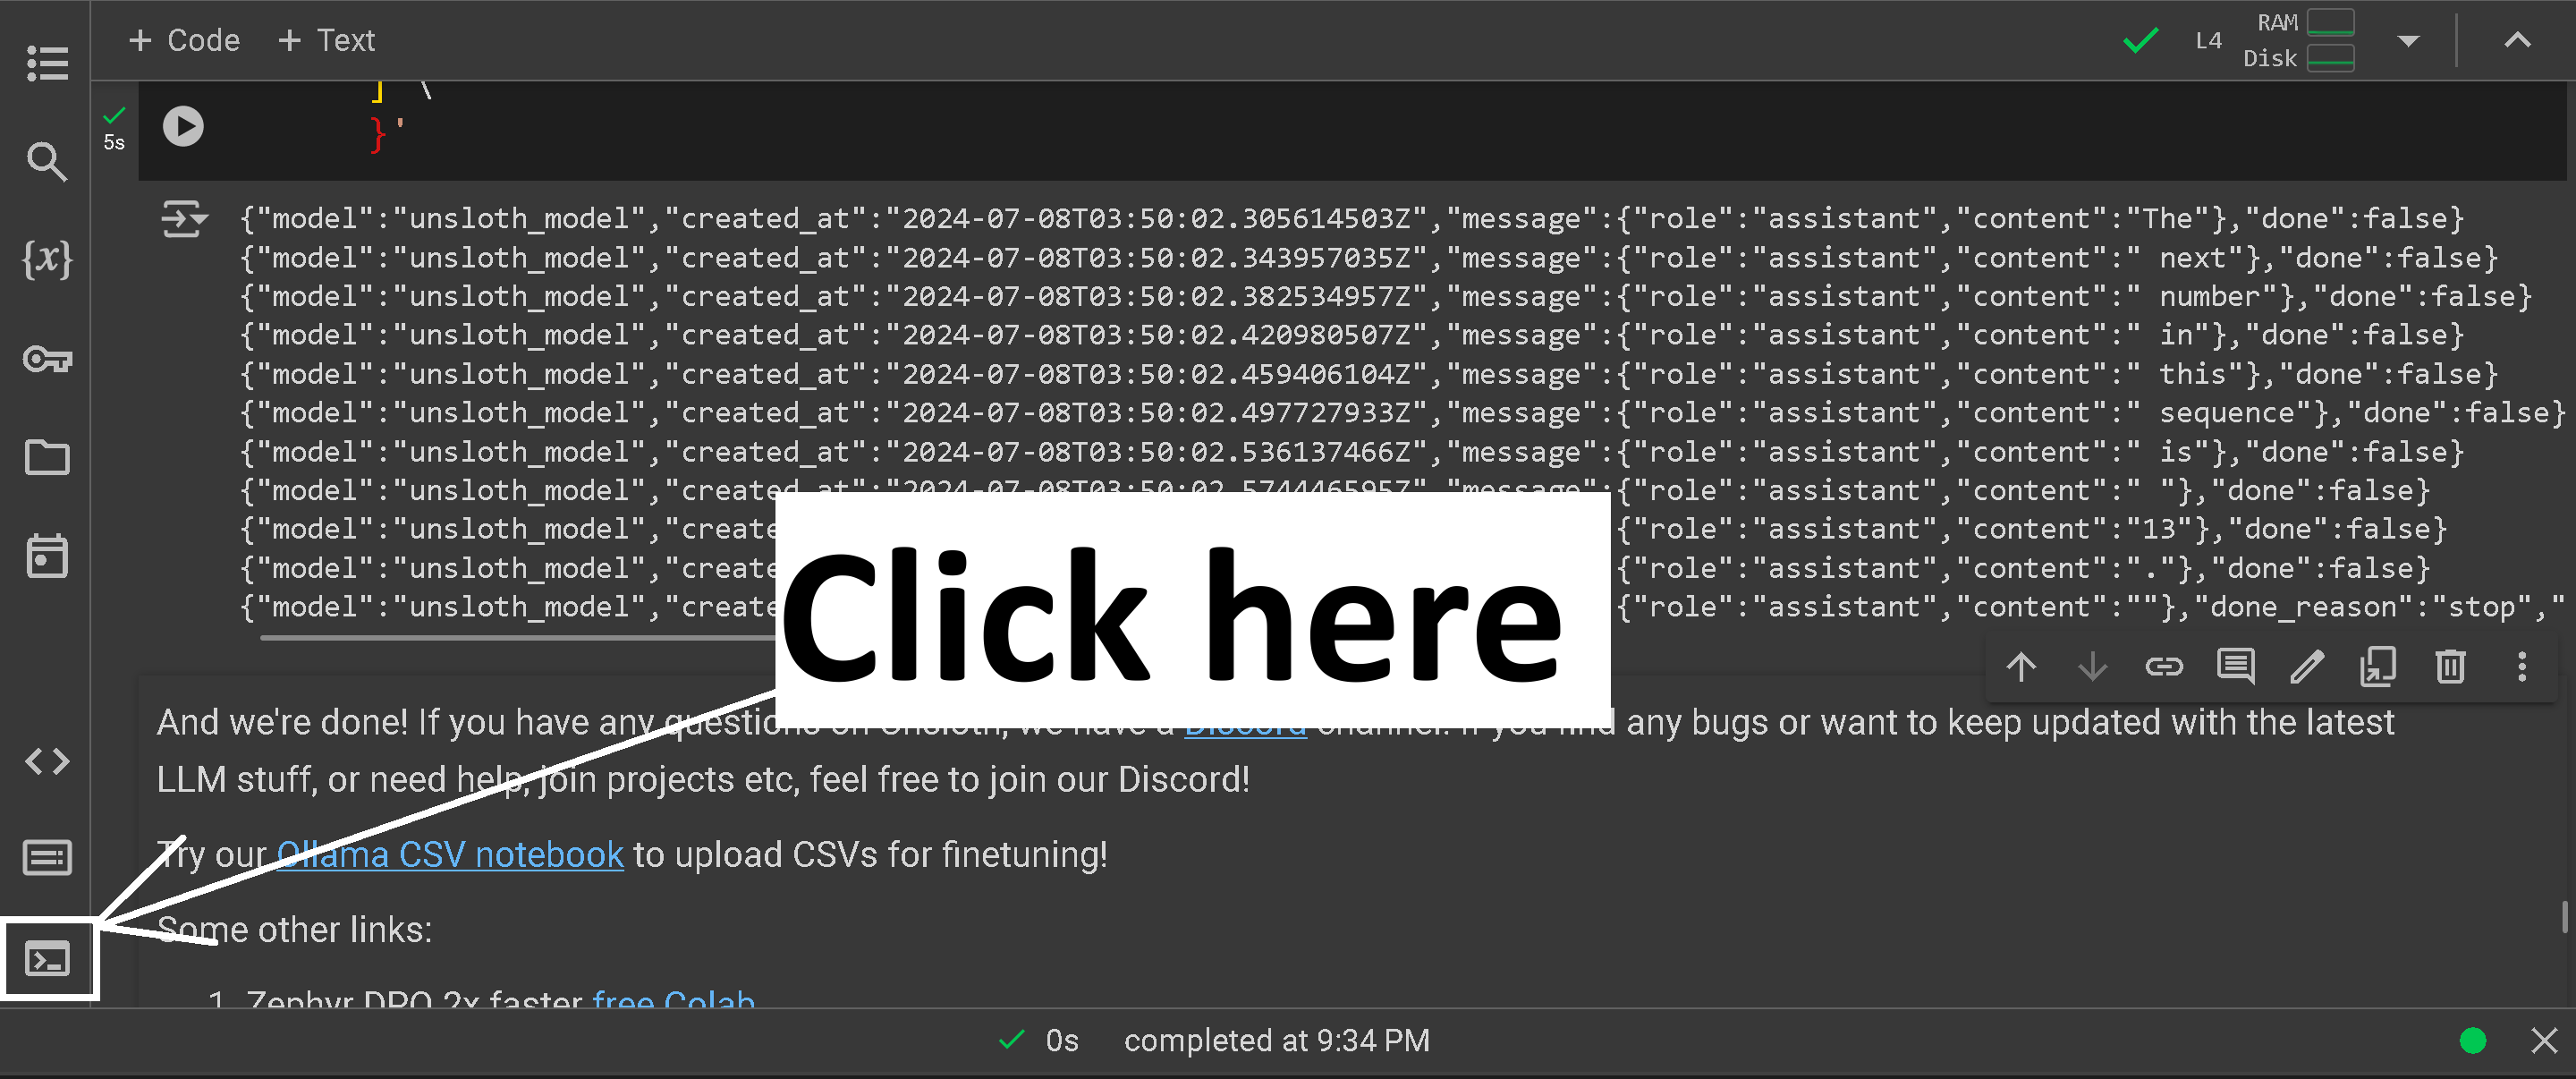
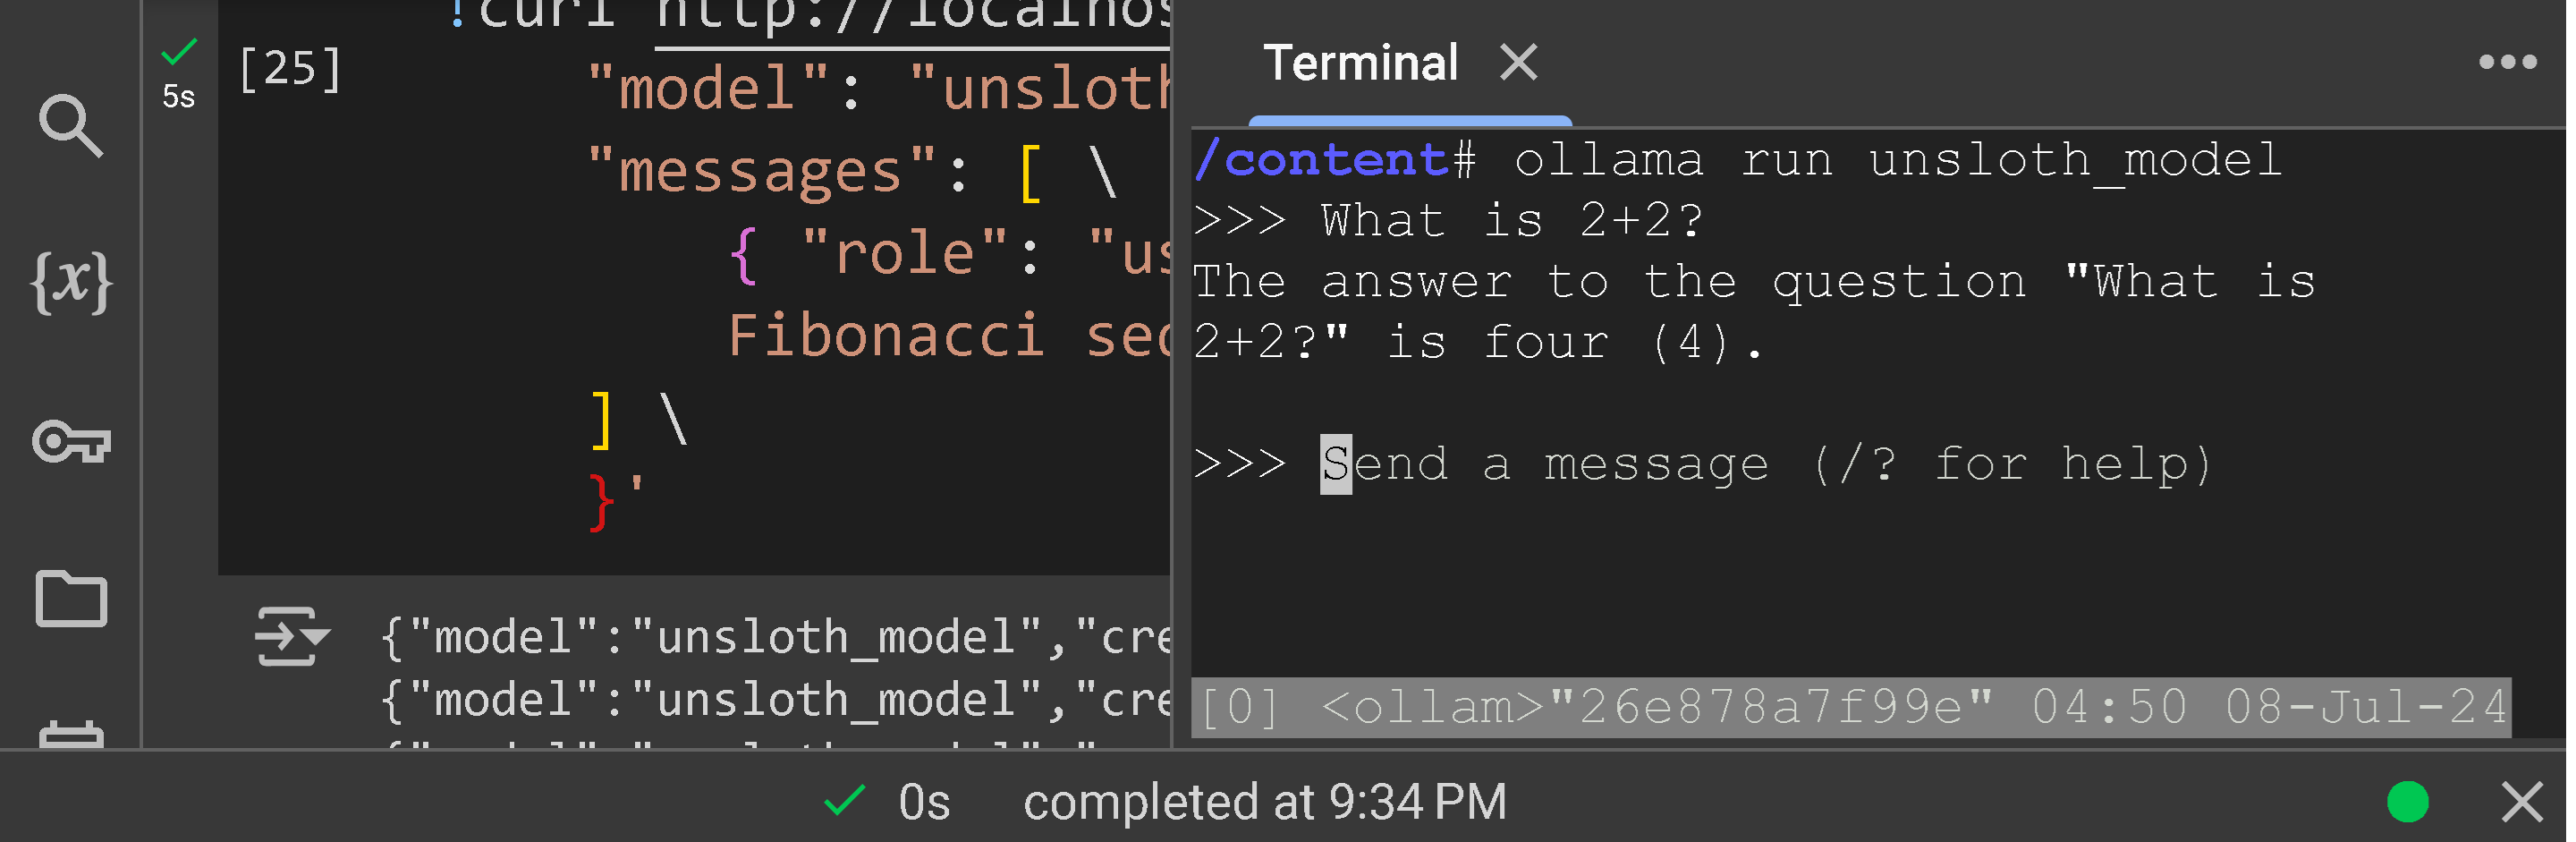
但要真正像 ChatGPT 一样运行微调后的模型，我们还需要多做一点！先点击终端图标![](https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-9c24108bc5152f946a7afab054974890318d2c02%2Fimage.png?alt=media) ，终端窗口就会弹出。它在左侧边栏。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2239315eff2820bf9f224975f0b184d51bd89cb7%2FWhere_Terminal.png?alt=media" alt=""><figcaption></figcaption></figure>

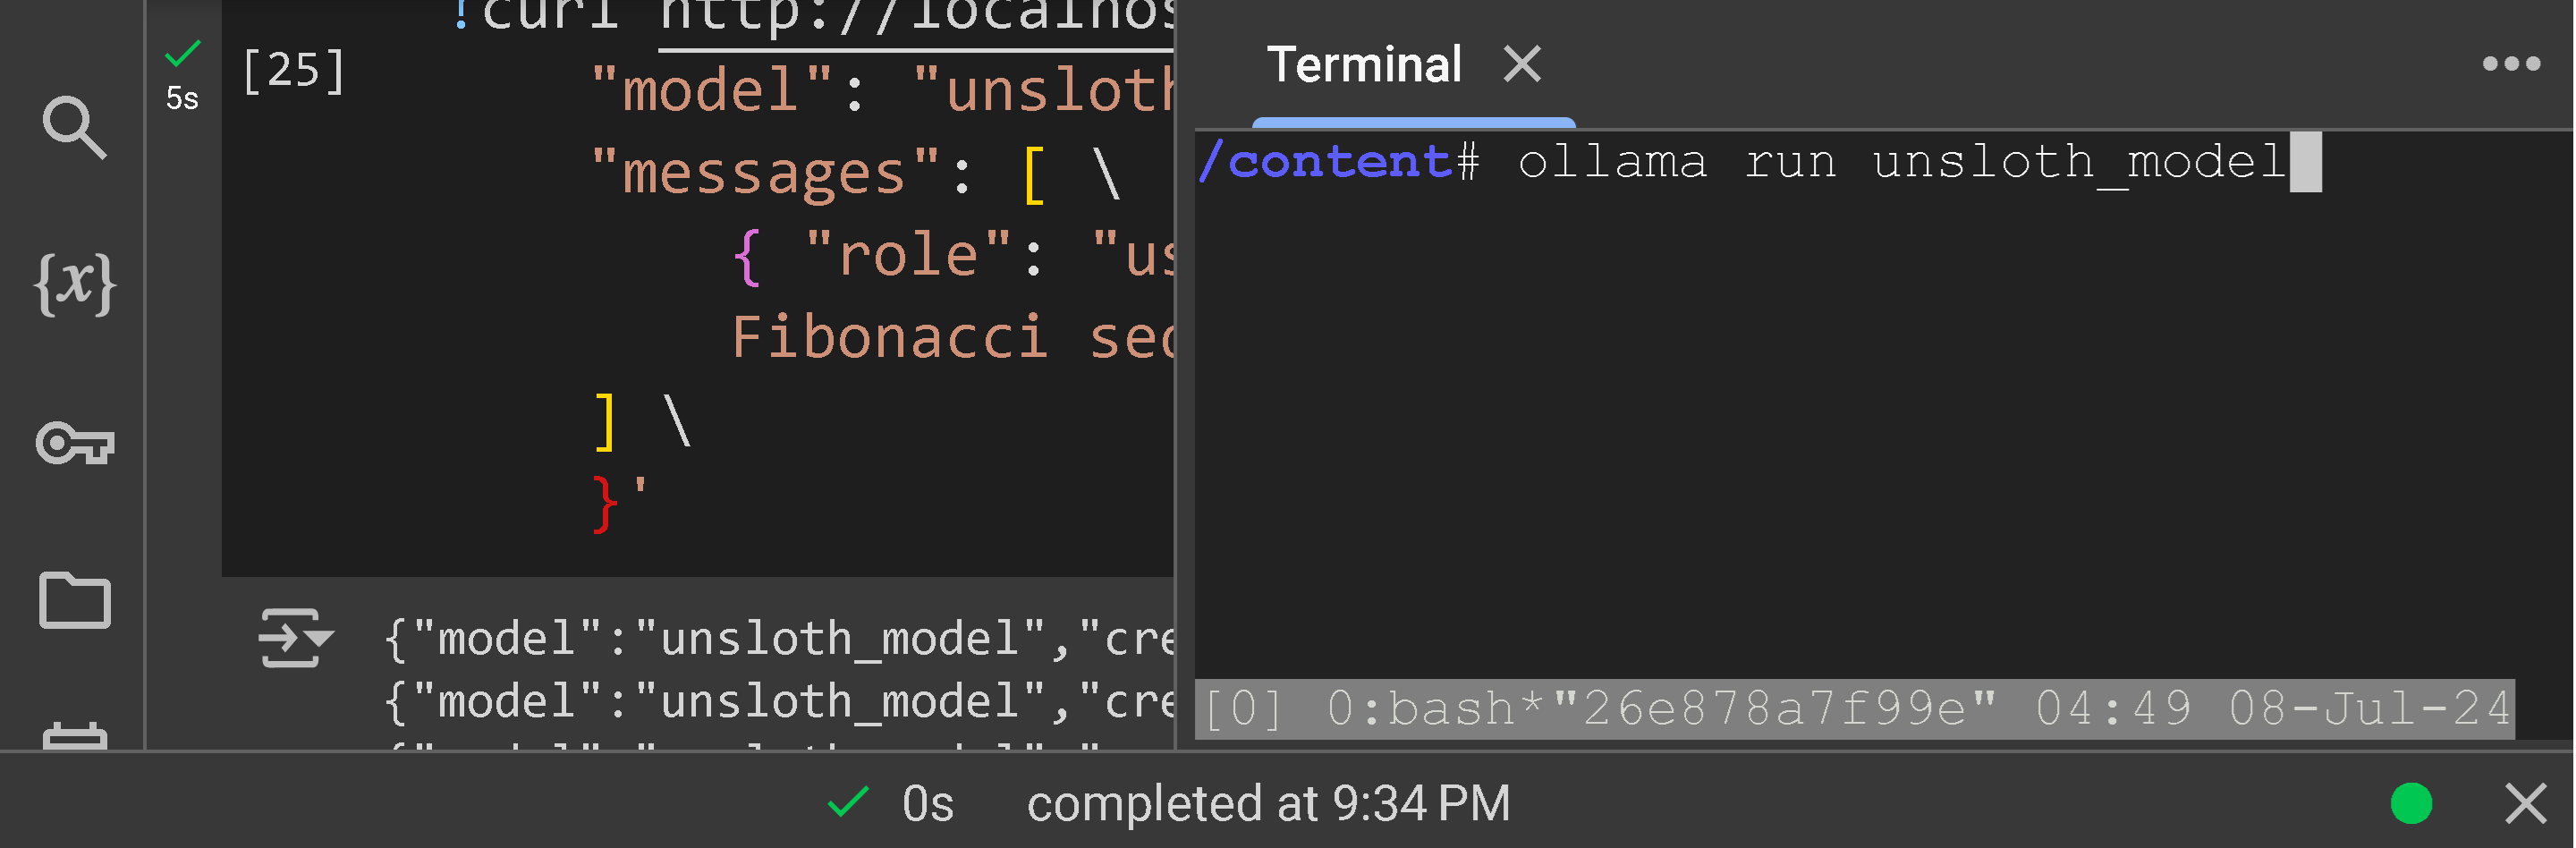
然后，你可能需要按两次 ENTER 来清除终端窗口中的一些奇怪输出。等待几秒钟，然后输入 `ollama run unsloth_model` 然后按 ENTER。
<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e83ac484e4257eacad1c7d033811d2ece59a444c%2FTerminal_Type.png?alt=media" alt=""><figcaption></figcaption></figure>

最后，你就可以像真正的 ChatGPT 一样与微调后的模型交互了！按 CTRL + D 退出系统，然后按 ENTER 与聊天机器人对话！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-120703475091e1ce74a38a05949ae51af0a36f72%2FAssistant.png?alt=media" alt=""><figcaption></figcaption></figure>

## 你成功了！

你已经成功微调了一个语言模型，并使用 Unsloth 以 2 倍速度提升、减少 70% VRAM 的方式将其导出到 Ollama！而且这一切都可在 Google Colab 笔记本中免费完成！

如果你想学习如何进行奖励建模、继续预训练、导出到 vLLM 或 GGUF、进行文本补全，或了解更多微调技巧，请前往我们的 [Github](https://github.com/unslothai/unsloth#-finetune-for-free).

如果你在微调方面需要任何帮助，也可以加入我们的 Discord 服务器 [这里](https://discord.gg/unsloth)。如果你想获得关于 Ollama 的帮助，也可以加入他们的服务器 [这里](https://discord.gg/ollama).

最后，感谢你阅读并坚持到这里！我们希望这能让你理解语言模型微调背后的一些基本原理和细节，也希望这对你有帮助！

要访问我们的 Alpaca 数据集示例，请点击 [这里](https://colab.research.google.com/drive/1WZDi7APtQ9VsvOrQSSC5DDtxq159j8iZ?usp=sharing)，我们的 CSV / Excel 微调指南是 [这里](https://colab.research.google.com/drive/1VYkncZMfGFkeCEgN2IzbZIKEDkyQuJAS?usp=sharing).


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/tutorial-how-to-finetune-llama-3-and-use-in-ollama.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.