> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide.md).

# LLM 微调指南

学习微调的所有基础知识和最佳实践。适合初学者。

## 1. 什么是微调？

微调 / 训练 / 后训练模型可以定制其行为、增强并注入知识，并针对特定领域和任务优化性能。例如：

* OpenAI 的 **GPT-5** 经过后训练，以改进指令遵循和有帮助的聊天行为。
* 标准的后训练方法称为监督微调（SFT）。其他方法包括偏好优化（DPO、ORPO）、蒸馏以及 [强化学习（RL）](/docs/zh/kuai-su-kai-shi/reinforcement-learning-rl-guide.md) （GRPO、GSPO），其中“智能体”通过与环境交互并接收 **反馈** 以 **奖励** 或 **惩罚**.

通过 [Unsloth](https://github.com/unslothai/unsloth)，你可以在 Colab、Kaggle 上免费进行微调或 RL，或者仅用 3GB VRAM 在本地，通过使用我们的 [笔记本](https://docs.unsloth.ai/get-started/unsloth-notebooks)。通过在数据集上对预训练模型进行微调，你可以：

* **更新并学习新知识**：注入并学习新的领域特定信息。
* **定制行为**：调整模型的语气、个性或回复风格。
* **针对任务优化**：提升特定用例的准确性和相关性。

**微调或 RL 的示例用例**:

* 使 LLM 能够预测某个标题是对公司产生正面还是负面影响。
* 可使用历史客户交互获得更准确且更个性化的回复。
* 在法律文本上微调 LLM，用于合同分析、案例法研究和合规。

你可以把微调后的模型看作一个专门设计来更有效、更高效地完成特定任务的专用智能体。 **微调可以复现 RAG 的所有能力**，但反过来不行。

{% columns %}
{% column %}

#### :question:什么是 LoRA/QLoRA？

在 LLM 中，我们有模型权重。Llama 70B 有 700 亿个数字。我们不去修改全部 700 亿个数字，而是向每个权重添加稀疏矩阵 A 和 B，并优化它们。这意味着我们只优化 1% 的权重。LoRA 是原始模型为未量化的 16 位，而 QLoRA 则量化到 4 位以节省 75% 的显存。
{% endcolumn %}

{% column %}

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-715b6260aae497f160d7f9a1019bcfa472675dcf%2Fimage%20(7)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>我们不是优化模型权重（黄色部分），而是优化 2 个稀疏矩阵 A 和 B。</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

#### 微调误解：

你可能听说过微调不会让模型学习新知识，或者 RAG 的效果比微调更好。那是 **false**。你可以通过微调和 RL 训练一个专门的代码模型，而 RAG 无法改变模型权重，只是在推理时补充模型所看到的内容。阅读更多常见问题 + 误解 [这里](https://unsloth.ai/docs/zh/kuai-su-kai-shi/pages/23f746d97a493793f0cf778956c3d1e708c15940#fine-tuning-vs.-rag-whats-the-difference):

{% content-ref url="/pages/23f746d97a493793f0cf778956c3d1e708c15940" %}
[常见问题 + 微调适合我吗？](/docs/zh/kuai-su-kai-shi/fine-tuning-for-beginners/faq-+-is-fine-tuning-right-for-me.md)
{% endcontent-ref %}

> [**介绍 Unsloth Studio：** ](/docs/zh/xin/studio.md) 我们新的开源网页 UI，用于训练和运行模型。这意味着你现在可以用无代码方式微调模型，并拥有可观测性和自动数据集创建功能。

<div data-with-frame="true"><figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FxV1PO5DbF3ksB51nE2Tw%2Fmore%20cropped%20ui%20for%20homepage.png?alt=media&amp;token=f75942c9-3d8d-4b59-8ba2-1a4a38de1b86" alt="" width="563"><figcaption></figcaption></figure></div>

## 2. 选择合适的模型 + 方法

如果你是初学者，最好从像 Llama 3.1（8B）这样的小型指令模型开始，再从那里进行尝试。你还需要在普通微调、RL、QLoRA 或 LoRA 训练之间做出选择：

* **强化学习（RL）** 用于在你需要模型通过使用环境和奖励函数而不是标注数据来擅长某种特定行为（例如工具调用）时。我们有几个 [notebook 示例](/docs/zh/kuai-su-kai-shi/unsloth-notebooks.md#grpo-reasoning-rl-notebooks)，但对大多数用例来说，标准 SFT 就足够了。
* **LoRA** 是一种参数高效训练方法，通常会冻结基础模型的权重，并训练一小组新增的低秩适配器权重（16 位精度）。
* **QLoRA** 将 LoRA 与 4 位精度结合，以最少的资源处理超大模型。
* Unsloth 还支持全量微调（FFT）和预训练，这些都需要更多资源，但 FFT 通常并非必要。正确使用时，LoRA 可以达到与 FFT 相当的效果。
* Unsloth **各种类型的模型**: [文本转语音](/docs/zh/ji-chu-zhi-shi/text-to-speech-tts-fine-tuning.md), [嵌入](/docs/zh/ji-chu-zhi-shi/embedding-finetuning.md)、GRPO、RL、 [视觉](/docs/zh/ji-chu-zhi-shi/vision-fine-tuning.md)、多模态等。

{% hint style="info" %}
研究表明， **训练和部署使用相同精度** 有助于保持准确性。这意味着如果你想用 4 位部署，就用 4 位训练；反之亦然。
{% endhint %}

我们建议从 QLoRA 开始，因为它是训练模型最易上手且最有效的方法之一。我们的 [动态 4 位](https://unsloth.ai/blog/dynamic-4bit) 量化方案使得 QLoRA 相比 LoRA 的准确率损失如今已在很大程度上得到弥补。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cfc51c261e6d24df3aa967d9b9a482313465cbc1%2Fmodel%20name%20change.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

你可以通过将模型名称与 Hugging Face 上的模型名称匹配来更改为你喜欢的任意模型，例如“`unsloth/llama-3.1-8b-unsloth-bnb-4bit`'.

我们建议从 **指令模型**开始，因为它们允许使用对话式聊天模板（ChatML、ShareGPT 等）直接进行微调，并且相比 **基础模型** （其使用 Alpaca、Vicuna 等）需要更少的数据。了解更多关于 [指令模型和基础模型的差异，请见此处](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/what-model-should-i-use.md#instruct-or-base-model).

* 以 **`unsloth-bnb-4bit`** 结尾的模型名称表示它们是 [**Unsloth 动态 4 位**](https://unsloth.ai/blog/dynamic-4bit) **量化版本**。这些模型比标准的 BitsAndBytes 4 位模型占用略多的 VRAM，但准确率显著更高。
* 如果模型名称仅以 **`bnb-4bit`**&#x7ED3;尾，而不包含“unsloth”，则表示它是标准的 BitsAndBytes 4 位量化。
* 带有 **无后缀** 的模型处于其原始的 **16 位或 8 位格式**。虽然它们是来自官方模型创建者的原始模型，但我们有时会加入重要修复——例如聊天模板或分词器修复。因此，在可用时，建议使用我们的版本。

还有其他可以切换的设置：

* **`max_seq_length = 2048`** – 控制上下文长度。虽然 Llama-3 支持 8192，但我们测试时推荐 2048。Unsloth 支持 4 倍更长的上下文微调。
* **`dtype = None`** – 默认为 None；新款 GPU 请使用 `torch.float16` 或 `torch.bfloat16` 。
* **`load_in_4bit = True`** – 启用 4 位量化，使微调时显存使用减少 4 倍。关闭它会启用 16 位 LoRA 微调。你也可以使用 `load_in_16bit = True`
* 要启用全量微调（FFT），请设置 `full_finetuning = True`。要进行 8 位微调，请设置 `load_in_8bit = True`.
* **注意：** 一次只能设置一种训练方法为 `真` 。

{% hint style="info" %}
一个常见错误是直接跳到全量微调（FFT），这会非常消耗算力。先从 LoRA 或 QLoRA 开始测试；如果在那上面都不行，那么在 FFT 上几乎肯定也不行。而且如果 LoRA 失败，不要以为 FFT 会神奇地修复它。
{% endhint %}

你也可以进行 [文本转语音（TTS）](/docs/zh/ji-chu-zhi-shi/text-to-speech-tts-fine-tuning.md), [推理（GRPO）](/docs/zh/kuai-su-kai-shi/reinforcement-learning-rl-guide.md), [视觉](/docs/zh/ji-chu-zhi-shi/vision-fine-tuning.md), [RL](/docs/zh/kuai-su-kai-shi/reinforcement-learning-rl-guide/preference-dpo-orpo-and-kto.md) （GRPO、DPO）， [继续预训练](/docs/zh/ji-chu-zhi-shi/continued-pretraining.md)、文本补全以及 Unsloth 的其他训练方法。

{% columns %}
{% column %}
阅读我们的模型选择指南：

{% content-ref url="/pages/fb27a5a49eec8190a033600d7b4f8f78f333f7a9" %}
[What Model Should I Use?](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/what-model-should-i-use.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
针对各个模型的单独教程：

{% content-ref url="/pages/8d4117b244a368b8f80b1a9d079fa31360c8e823" %}
[Complete LLM Directory](/docs/zh/mo-xing/tutorials.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

## 3. 你的数据集

对于 LLM 来说，数据集是可用于训练模型的数据集合。为了让文本数据对训练有用，它需要采用可以被分词的格式。

* 你通常需要创建一个包含 2 列的数据集——问题和答案。质量和数量在很大程度上会影响微调的最终结果，因此把这部分做好至关重要。
* 你可以 [合成生成数据](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/datasets-guide.md#synthetic-data-generation) 并使用 ChatGPT 或本地 LLM 将数据集结构化（为 QA 对）。
* 你也可以使用我们新的合成数据集 notebook，它会自动解析文档（PDF、视频等），生成 QA 对，并使用 Llama 3.2 等本地模型自动清洗数据。 [在这里访问 notebook。](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Meta_Synthetic_Data_Llama3_2_\(3B\).ipynb)
* 微调可以从现有文档库中学习并持续扩展其知识库，但仅仅把数据一股脑倒进去效果不会那么好。为了获得最佳效果，请整理出结构良好的数据集，最好是问答对。这会提升学习、理解和回复准确性。
* 不过，情况并不总是如此，例如如果你在为代码微调一个 LLM，那么直接倒入所有代码数据其实可以让模型获得显著的性能提升，甚至不需要结构化格式。所以这真的取决于你的使用场景。

***阅读更多关于创建数据集的内容：***

{% content-ref url="/pages/e3d8f41874867d09291eadcea96a34bf92b096a7" %}
[数据集指南](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/datasets-guide.md)
{% endcontent-ref %}

在我们大多数 notebook 示例中，我们使用 [Alpaca 数据集](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset) ，不过像 Vision 这样的其他 notebook 会使用不同的数据集，而且答案输出中也可能需要图片。

### 4. 理解训练超参数

学习如何选择合适的 [超参数](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/lora-hyperparameters-guide.md) ，借助研究和真实世界实验中的最佳实践——并理解每一项如何影响模型性能。

**关于超参数如何影响训练的完整指南，请参见：**

{% content-ref url="/pages/0c67f9d3a44c115b4fda319de5774cc3513ea3a3" %}
[Hyperparameters Guide](/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide/lora-hyperparameters-guide.md)
{% endcontent-ref %}

## 5. 安装 + 要求

你可以通过两种主要方式使用 Unsloth：我们的免费 notebook，或者本地使用。

### Unsloth Notebooks

我们建议初学者先使用我们预制的 [笔记本](/docs/zh/kuai-su-kai-shi/unsloth-notebooks.md) ，因为这是以引导步骤入门的最简单方式。之后你可以导出 notebook 在本地使用。

Unsloth 为以下内容提供逐步 notebook： [文本转语音](/docs/zh/ji-chu-zhi-shi/text-to-speech-tts-fine-tuning.md), [嵌入](/docs/zh/ji-chu-zhi-shi/embedding-finetuning.md)、GRPO、RL、 [视觉](/docs/zh/ji-chu-zhi-shi/vision-fine-tuning.md)、多模态、不同用例等。

### 本地安装

你也可以通过以下方式在本地安装 Unsloth： [Docker](/docs/zh/kuai-su-kai-shi/install/docker.md) 或 `pip install unsloth` （在 Linux、WSL 或 [Windows](/docs/zh/kuai-su-kai-shi/install/windows-installation.md)下）。此外，具体取决于你使用的模型，你还需要足够的 VRAM 和资源。

安装 Unsloth 需要 Windows 或 Linux 设备。安装后，你可以复制粘贴我们的 notebook，并在你自己的本地环境中使用。参见：

{% columns %}
{% column %}
{% content-ref url="/pages/fad5753068629237f814fd7a2737bf5277187b58" %}
[Unsloth 要求](/docs/zh/kuai-su-kai-shi/fine-tuning-for-beginners/unsloth-requirements.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
{% content-ref url="/pages/32a7ce415cf3da2e50fd777381735610343fea45" %}
[Installation](/docs/zh/kuai-su-kai-shi/install.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

## 6. 训练 + 评估

一切设置好后，就该开始训练了！如果有什么不起作用，记住你随时可以更改超参数、数据集等。

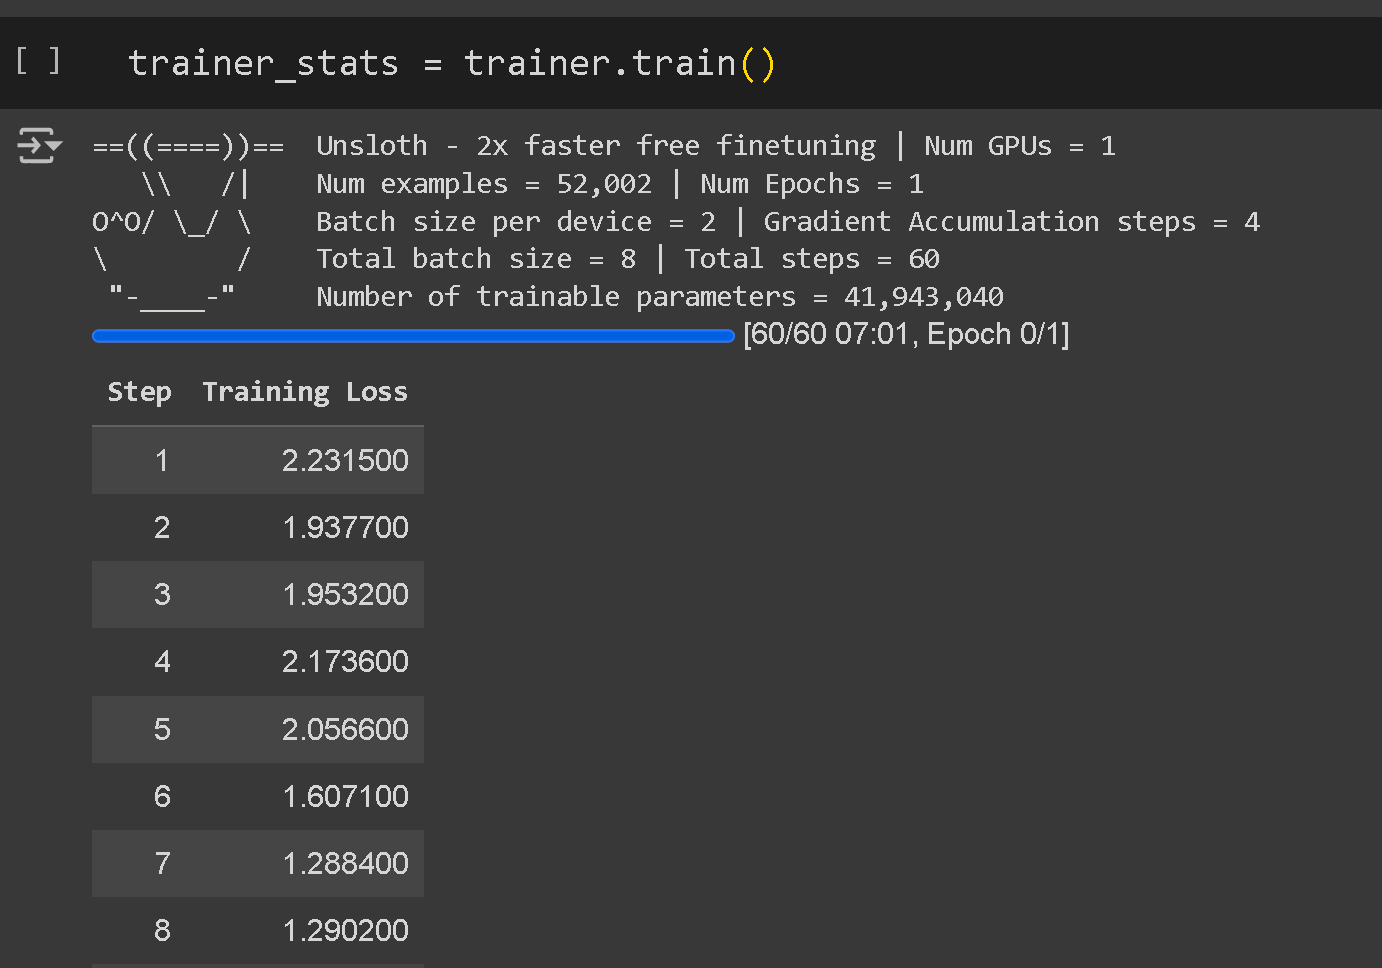
训练期间你会看到一串数字日志。这是训练损失，表示模型从你的数据集中学习得有多好。对于很多情况来说，损失值在 0.5 到 1.0 左右通常是个好迹象，但这取决于你的数据集和任务。如果损失没有下降，你可能需要调整设置。如果损失降到 0，那可能意味着过拟合，所以也要检查验证集。

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-feb9b0f5763d41cecaec9a3a9cd227ad918f0ca7%2Fimage.png?alt=media" alt="" width="375"><figcaption><p>训练损失会以数值形式显示</p></figcaption></figure>

通常我们建议保持默认设置，除非你需要更长的训练时间或更大的批次大小。

* **`per_device_train_batch_size = 2`** – 增大可提升 GPU 利用率，但要注意由于填充导致训练变慢。相反，请增大 `gradient_accumulation_steps` 以获得更平滑的训练。
* **`gradient_accumulation_steps = 4`** – 在不增加显存占用的情况下模拟更大的批次大小。
* **`max_steps = 60`** – 加快训练。对于完整运行，请替换为 `num_train_epochs = 1` （推荐 1–3 个 epoch 以避免过拟合）。
* **`learning_rate = 2e-4`** – 更低则微调更慢但更精确。可以尝试像 `1e-4`, `5e-5`，或者 `2e-5`.

#### 评估

为了进行评估，你可以通过直接与模型聊天来手动评估，看看它是否符合你的喜好。你也可以为 Unsloth 启用评估，但请注意这可能会很耗时，具体取决于数据集大小。要加快评估，你可以：减小评估数据集大小，或设置 `evaluation_steps = 100`.

用于测试时，你也可以取训练数据的 20% 用于测试。如果你已经用了全部训练数据，那么就必须手动评估。你也可以使用自动评估工具，但请记住，自动化工具可能无法与你的评估标准完全一致。

## 7. 运行 + 部署模型

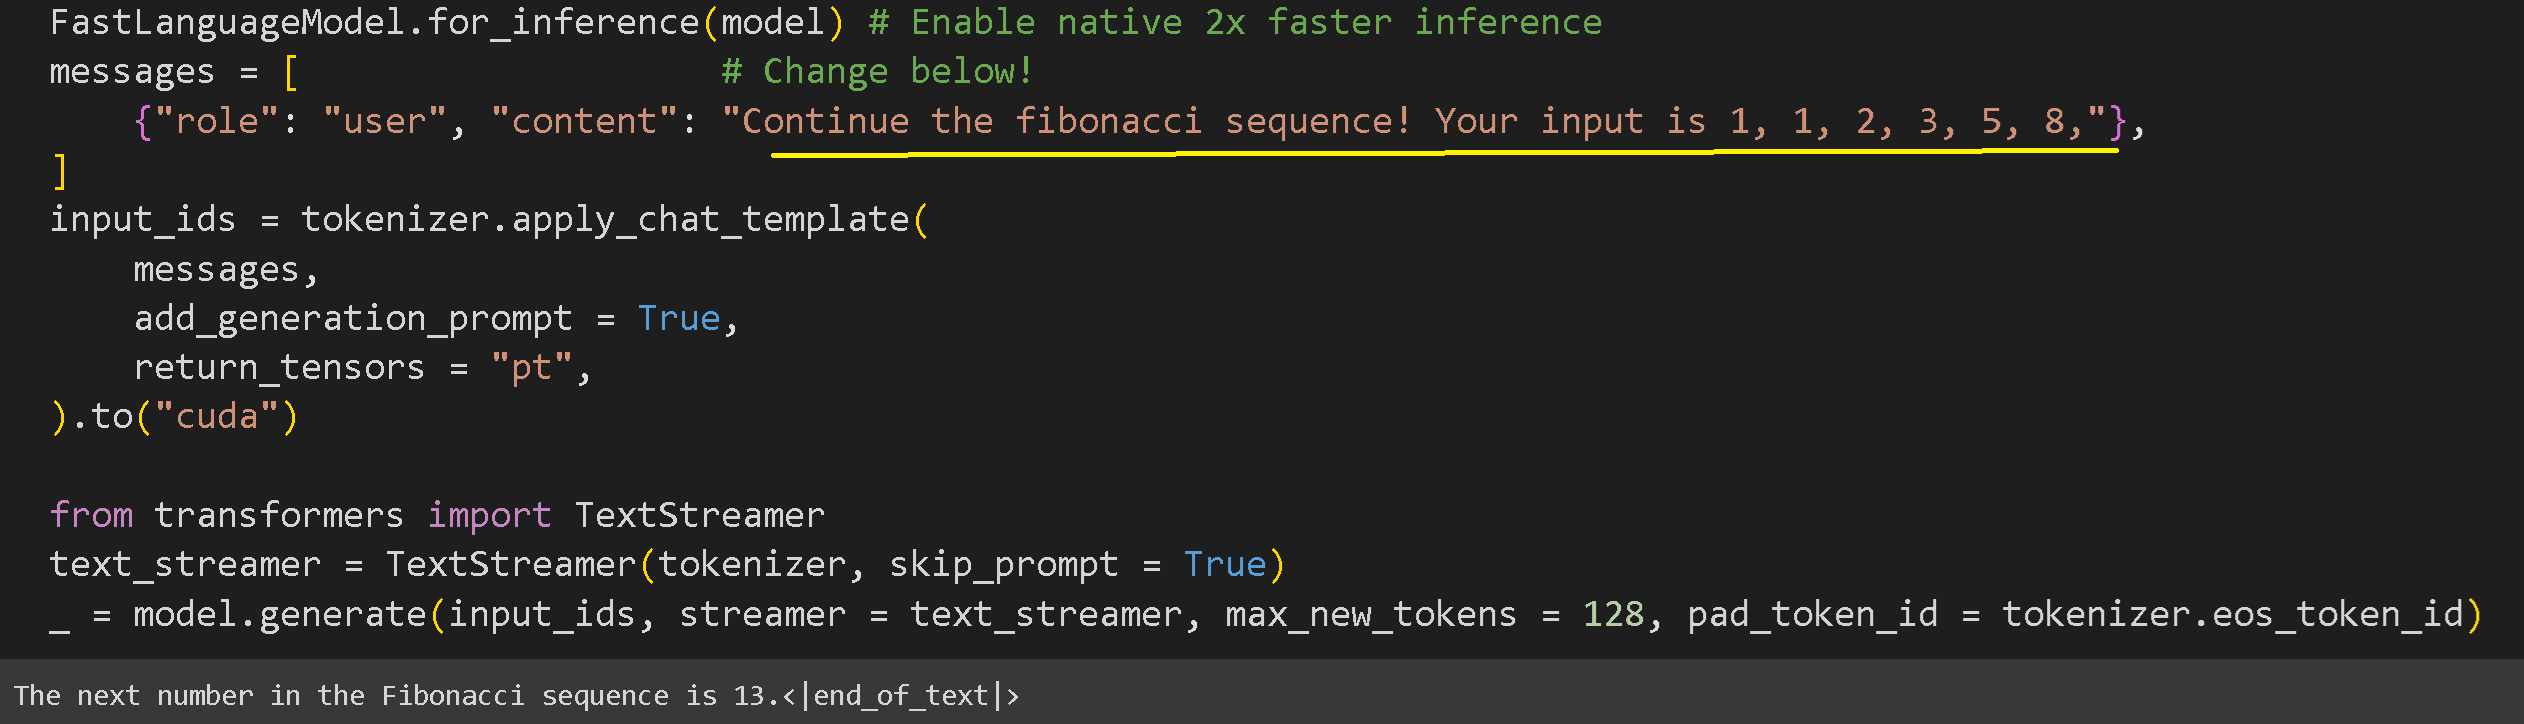
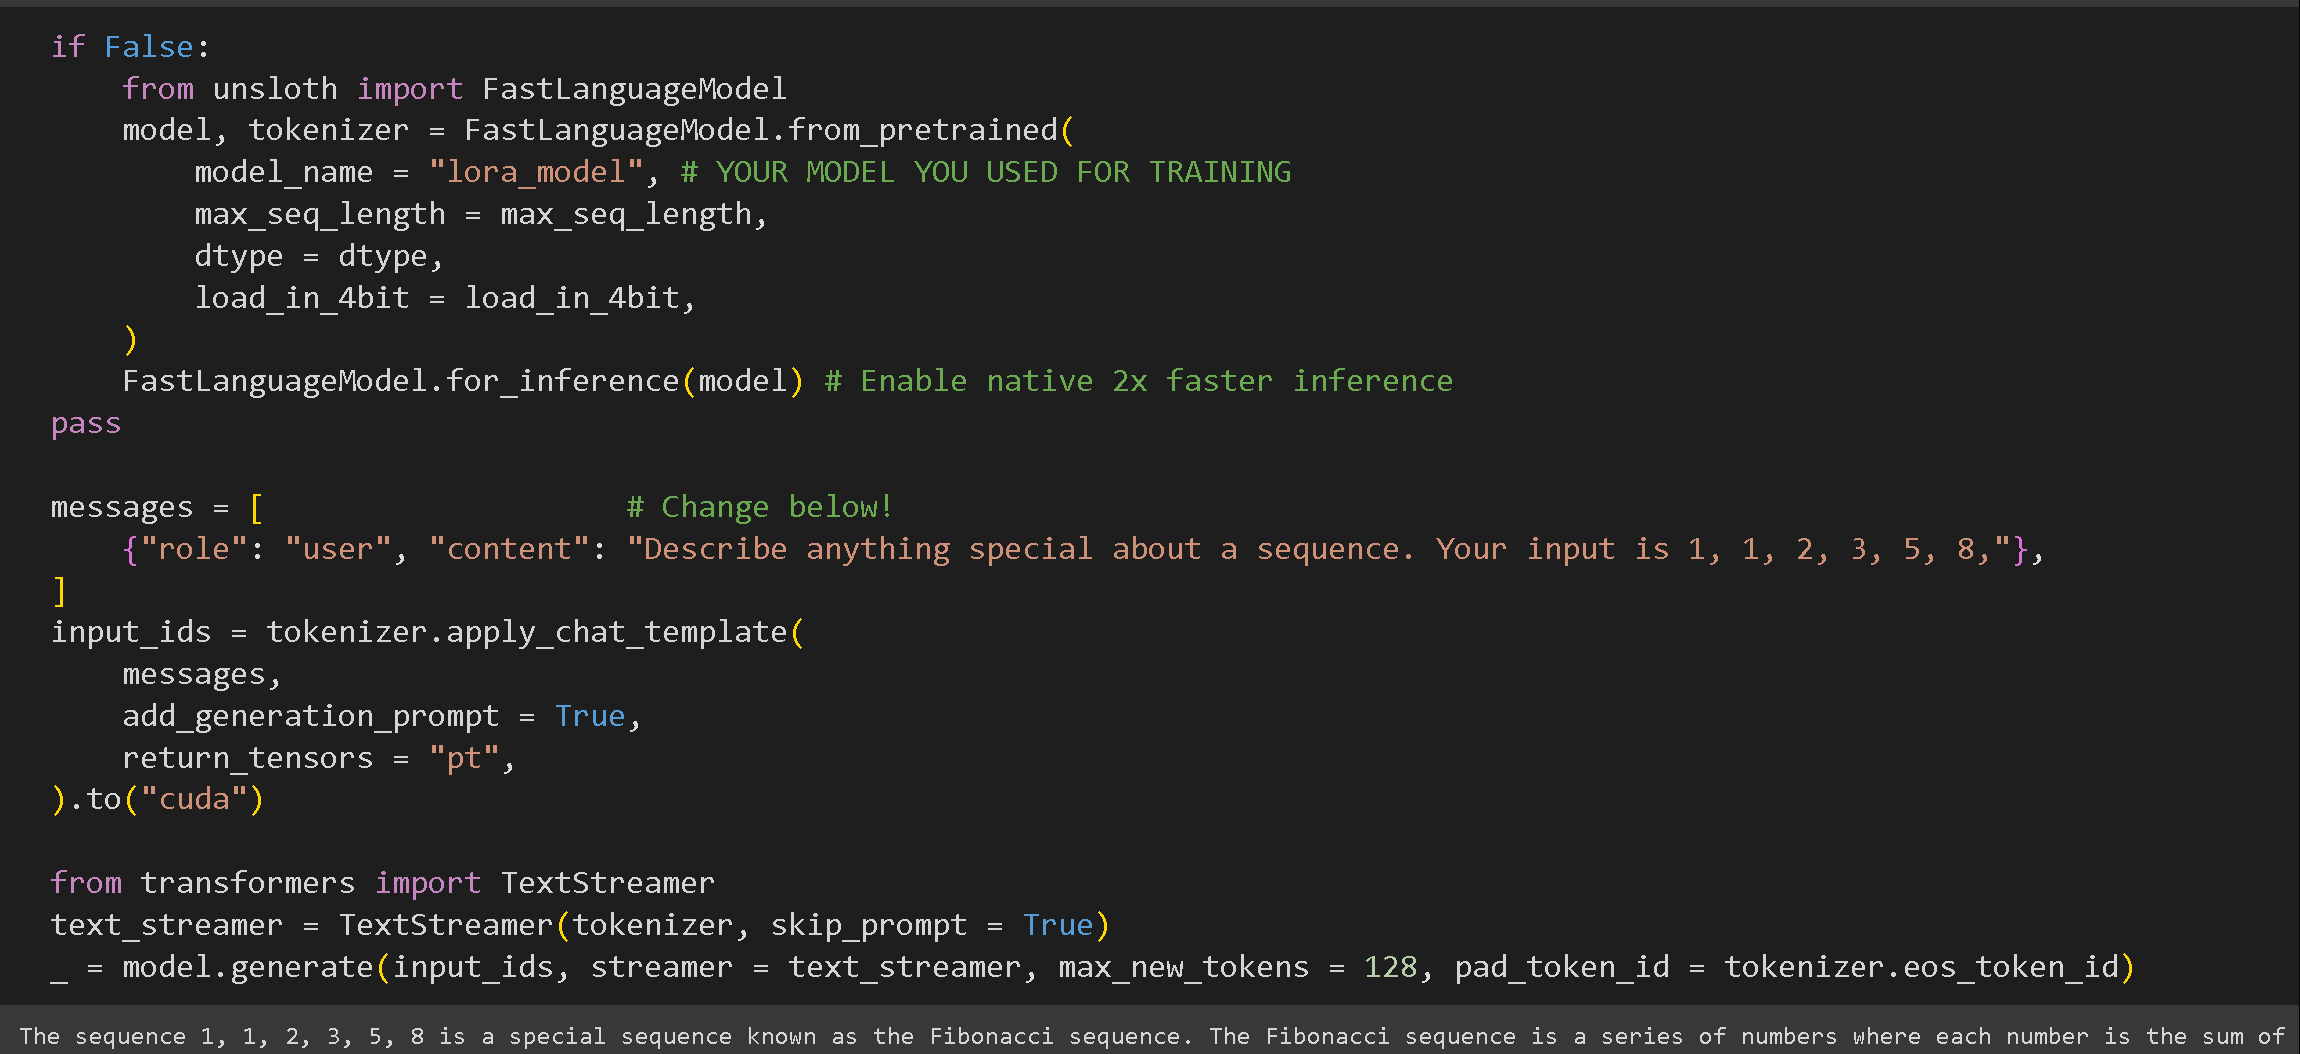
现在让我们在完成训练后运行模型！你可以编辑黄色下划线部分！实际上，由于我们创建了一个多轮聊天机器人，我们现在也可以像下面这样调用模型，仿佛它看到了之前的一些对话：

<div><figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-f2d5f23fa62ec89e06bf20fea433f9a1e42a2fe3%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cdf5d779635901dce7793df92531dbf3caf0fb0a%2Fimage%20(47).png?alt=media" alt=""><figcaption></figcaption></figure></div>

提醒一下，Unsloth 本身也提供 **2 倍更快的推理** 的原生支持，所以一定不要忘记调用 `FastLanguageModel.for_inference(model)`。如果你想让模型输出更长的回复，请将 `max_new_tokens = 128` 设为更大的数值，例如 256 或 1024。注意你也需要等待更长时间才能得到结果！

### 保存 + 部署

如果要在所需的推理引擎中保存和部署模型，例如 Ollama、vLLM、Open WebUI，你需要在基础模型之上使用 LoRA 适配器。我们为每个框架都准备了专门指南：

{% content-ref url="/pages/9a72670992feb75def412a693565c84a88c8a266" %}
[推理与部署](/docs/zh/ji-chu-zhi-shi/inference-and-deployment.md)
{% endcontent-ref %}

{% columns %}
{% column %}
如果你是在单个设备上运行推理（如笔记本电脑或 Mac），请使用 llama.cpp 将其转换为 GGUF 格式，以便在 Ollama、llama.cpp、LM Studio 等中使用：

{% content-ref url="/pages/b83d88f106d75c3396c46f5342fb401501910093" %}
[GGUF & llama.cpp](/docs/zh/ji-chu-zhi-shi/inference-and-deployment/saving-to-gguf.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
如果你要为企业或多用户推理部署 LLM，采用 FP8、AWQ，请使用 vLLM：

{% content-ref url="/pages/9f0e22d200c9105481e4854b8473aba99ca44835" %}
[vLLM](/docs/zh/ji-chu-zhi-shi/inference-and-deployment/vllm-guide.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

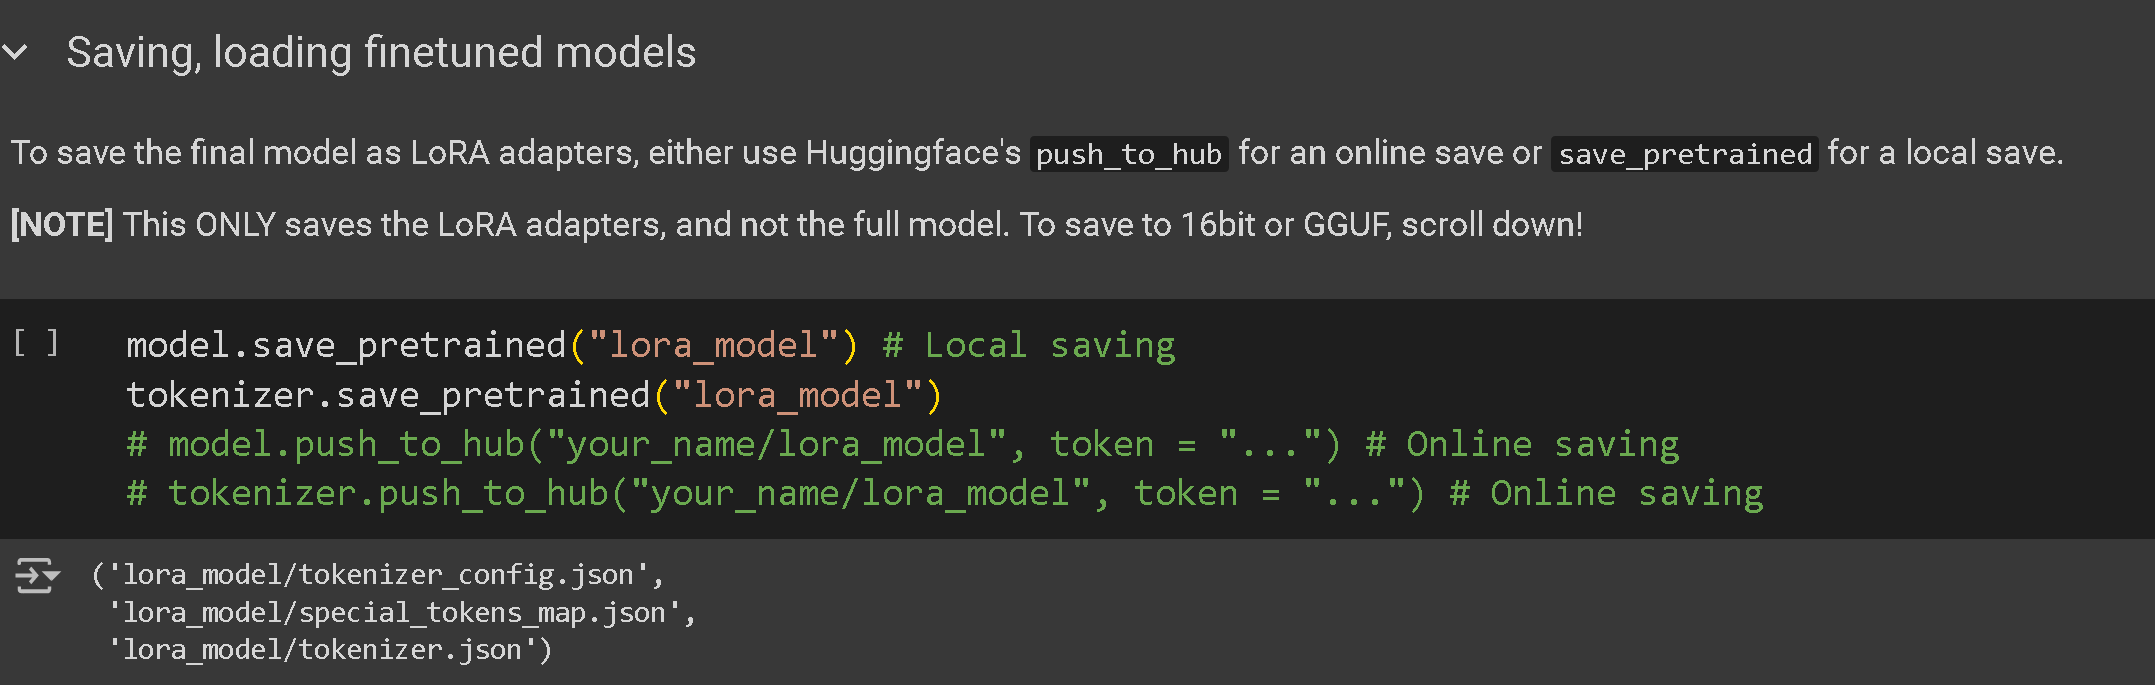
现在我们可以把微调后的模型保存成一个名为 LoRA 适配器的小型 100MB 文件，如下所示。如果你愿意，也可以改为推送到 Hugging Face Hub！记得获取一个 Hugging Face [令牌](https://huggingface.co/settings/tokens) 并添加您的 token！

<div><figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8c577103f7c4fe883cabaf35c8437307c6501686%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1a1be852ca551240bdce47cf99e6ccd7d31c1326%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>

保存模型后，我们又可以使用 Unsloth 来运行模型本身！使用 `FastLanguageModel` 再次调用它进行推理！

## 8. 我们完成了！

你已经成功使用 Unsloth 微调了一个语言模型，并将其导出到你想要的推理引擎！

想了解更多微调技巧和窍门，请前往我们的博客，那里提供了极高的教育价值： <https://unsloth.ai/blog/>

如果你在微调方面需要任何帮助，也欢迎加入我们的 Discord 服务器 [这里](https://discord.gg/unsloth) 或 [Reddit r/unsloth](https://www.reddit.com/r/unsloth/)。感谢阅读，希望这对你有帮助！

<figure><img src="https://2657992854-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-69482ba90d417f7bf98dddaf83795cdd3eb20efc%2Fsloth%20sparkling%20square.png?alt=media" alt="" width="188"><figcaption></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/zh/kuai-su-kai-shi/fine-tuning-llms-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.