> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/amd.md).

# Entraînez et exécutez des modèles sur des GPU AMD avec Unsloth

Unsloth prend désormais officiellement en charge le matériel AMD, ce qui facilite l’exécution, l’entraînement, le fine-tuning, le RL et le déploiement de modèles localement sur des GPU AMD. Entièrement open source, [Unsloth](/docs/fr/desktop.md) fonctionne sous Windows, WSL et Linux, et prend en charge RDNA 1–4, les GPU Radeon RX série 9000 et 7000, les GPU de centre de données Instinct MI350 et MI300, Vulkan, les systèmes Ryzen AI Max propulsés par Strix Halo, et plus encore.

Nous avons collaboré avec [AMD](https://www.amd.com/en/developer/resources/technical-articles/2026/train-and-run-models-on-amd-gpus-with-unsloth.html) et notre communauté afin de permettre un entraînement jusqu’à 2x plus rapide et consommant 70 % de VRAM en moins pour tous les modèles, sans perte de précision. Si vous n’avez pas de GPU, Unsloth prend toujours en charge l’inférence native AMD pour [Qwen3.6](/docs/fr/modeles/qwen3.6.md), [Gemma 4](/docs/fr/modeles/gemma-4.md), DeepSeek-V4, GLM 5.2, DiffusionGemma, Kimi K2.7 et d’autres modèles.

<a href="/docs/fr/notions-de-base/amd.md#installing-unsloth-on-amd" class="button primary" data-icon="bolt">Démarrage rapide</a><a href="/docs/fr/notions-de-base/amd.md#id-2x-faster-training-and-50-more-accurate-tool-calls" class="button secondary" data-icon="star">Fonctionnalités</a><a href="https://github.com/unslothai/unsloth" class="button secondary" data-icon="github">GitHub</a>

{% hint style="success" %}
**Mise à jour du 18 sept. :** Ajouté **Prise en charge de RDNA 1, 2, Gorgon Halo, Vulkan** + correction de la non-détection des GPU sur les GPU AMD.\
Meilleure correction automatique et meilleure détection des échecs RDNA4, HIP / ROCm.
{% endhint %}

Pour installer Unsloth sur AMD, le moyen le plus simple est de télécharger notre [application de bureau](/docs/fr/desktop.md).

<a href="https://unsloth.ai/download/windows" class="button secondary" data-icon="windows">Télécharger pour Windows</a><a href="https://unsloth.ai/download/windows" class="button secondary" data-icon="linux">Télécharger pour Linux</a>\
\
Pour une installation manuelle :

**macOS, Linux, WSL :**

{% code overflow="wrap" expandable="true" %}

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

{% endcode %}

**Windows PowerShell :**

<pre class="language-powershell" data-overflow="wrap"><code class="lang-powershell"><strong>irm https://unsloth.ai/install.ps1 | iex 
</strong></code></pre>

### ⭐ Fonctionnalités

Unsloth prend en charge à la fois l’inférence et l’entraînement pour AMD, donc si vous n’avez pas de GPU et seulement un CPU, vous pouvez quand même exécuter des modèles avec Unsloth. En utilisant Unsloth, vous obtenez :

* [**Correction des appels d’outils**](/docs/fr/nouveau/studio/chat.md#auto-healing-tool-calling) **pour l’inférence afin d’augmenter la précision de 50 %**, gratuit et illimité [recherche web](/docs/fr/nouveau/studio/chat.md#advanced-web-search), canevas HTML, [**déploiement HTTPS sécurisé**](#unsloth-on-phones-and-remote-https-tunneling) via Cloudflare et [exécution de code](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) tout fonctionne.
* **Entraînez des modèles Gemma 4 dans 8 Go de VRAM** ou Qwen3.5 dans 3 Go de VRAM. Les kernels Triton, les algorithmes mathématiques et les astuces mémoire permettent d’utiliser 70 % de VRAM en moins sur AMD, sans perte de précision.
* Jusqu’à **80 % de VRAM en moins pour** [**l’apprentissage par renforcement**](/docs/fr/commencer/reinforcement-learning-rl-guide/grpo-long-context.md) comme GRPO. Et le partage des poids avec vLLM pour économiser 50 % d’utilisation mémoire.
* Prise en charge optimisée de **RDNA 3** et des GPU plus récents ainsi que des GPU de niveau centre de données. Strix Halo est également optimisé pour Linux, WSL et Windows.

{% columns %}
{% column %}

* [**Connectez**](/docs/fr/integrations/unsloth-start.md) **vos modèles locaux à n’importe quel framework d’agent**: [Claude Code](/docs/fr/notions-de-base/claude-code.md), [Codex](/docs/fr/notions-de-base/codex.md), [Hermes](/docs/fr/integrations/hermes-agent.md), [OpenClaw](/docs/fr/integrations/openclaw.md) et plus encore.
* Prise en charge de l’inférence et de l’entraînement pour presque **tous les modèles**, y compris les plus récents [DeepSeek-V4](/docs/fr/modeles/deepseek-v4.md), [GLM-5.2](/docs/fr/modeles/glm-5.2.md), [Kimi-K2.7](/docs/fr/modeles/kimi-k2.7-code.md), [MiniMax M3](/docs/fr/modeles/minimax-m3.md), [DiffusionGemma](/docs/fr/modeles/diffusiongemma.md), [Inkling](/docs/fr/modeles/inkling.md) et plus encore !
* Prise en charge multi-GPU AMD + suivi de la VRAM/RAM. `llama.cpp` Des versions précompilées ROCm sont fournies quotidiennement, pour que vous obteniez toujours les dernières mises à jour des modèles !
  {% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fszoidwwj70dLm5vBjpmL%2Fdiffusiongemma.gif?alt=media&amp;token=8ce359fd-f92c-4cf8-a491-06b04c505cb7" alt="" width="375"><figcaption><p>DiffusionGemma exécuté sur des GPU AMD</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

### ⚡Démarrage rapide

Unsloth installe automatiquement les meilleures versions ROCm pour PyTorch, les versions précompilées de llama.cpp, bitsandbytes, les kernels optimisés pour ROCm et Triton. Nous fournissons également ensemble nos optimisations et correctifs AMD. Vous pouvez lire notre guide plus [détaillé ici](#guide-to-using-unsloth-on-amd) pour plus de détails.

Nous avons rendu l’installation d’Unsloth fluide pour les utilisateurs de Windows et WSL - mais nous recommandons généralement d’utiliser Linux directement, car il offrira la prise en charge la plus large. Unsloth prend en charge macOS, Linux, [Windows](/docs/fr/commencer/install/windows-installation.md), [NVIDIA](/docs/fr/commencer/install/pip-install.md), les configurations Intel et CPU. Voir : [Prérequis Unsloth](/docs/fr/commencer/fine-tuning-for-beginners/unsloth-requirements.md). La mise à jour se fait avec les mêmes commandes !

**macOS, Linux, WSL :**

{% code overflow="wrap" %}

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

{% endcode %}

**Windows PowerShell :**

{% code overflow="wrap" %}

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% endcode %}

{% columns %}
{% column %}
Unsloth installera automatiquement ROCm, PyTorch, des versions précompilées personnalisées de llama.cpp et plus encore !

#### Accéder à Unsloth à distance

Nous avons également activé [le tunneling HTTPS Cloudflare](#unsloth-on-phones-and-remote-https-tunneling) gratuitement - afin que vous puissiez accéder à Unsloth en toute sécurité via HTTPS à distance.
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsnKMaYneotmsSaEvA2mU%2Finstall%201.png?alt=media&amp;token=bbfba550-a47e-4273-80f5-a21bfc44717c" alt=""><figcaption><p>Installer Unsloth sur des machines Windows AMD</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

#### :inbox\_tray: Installer les notebooks Unsloth et pip install

Si vous voulez des notebooks Unsloth simples, consultez le [AMD](/docs/fr/commencer/install/amd.md) guide d’installation général. Assurez-vous de lire[AMD](/docs/fr/commencer/install/amd.md) le guide d’installation ! Après l’avoir suivi pour installer PyTorch et ROCm, faites alors :

{% code overflow="wrap" %}

```bash
uv pip install unsloth[amd]
```

{% endcode %}

#### :play\_pause:Démarrage d’Unsloth

{% columns %}
{% column width="58.333333333333336%" %}
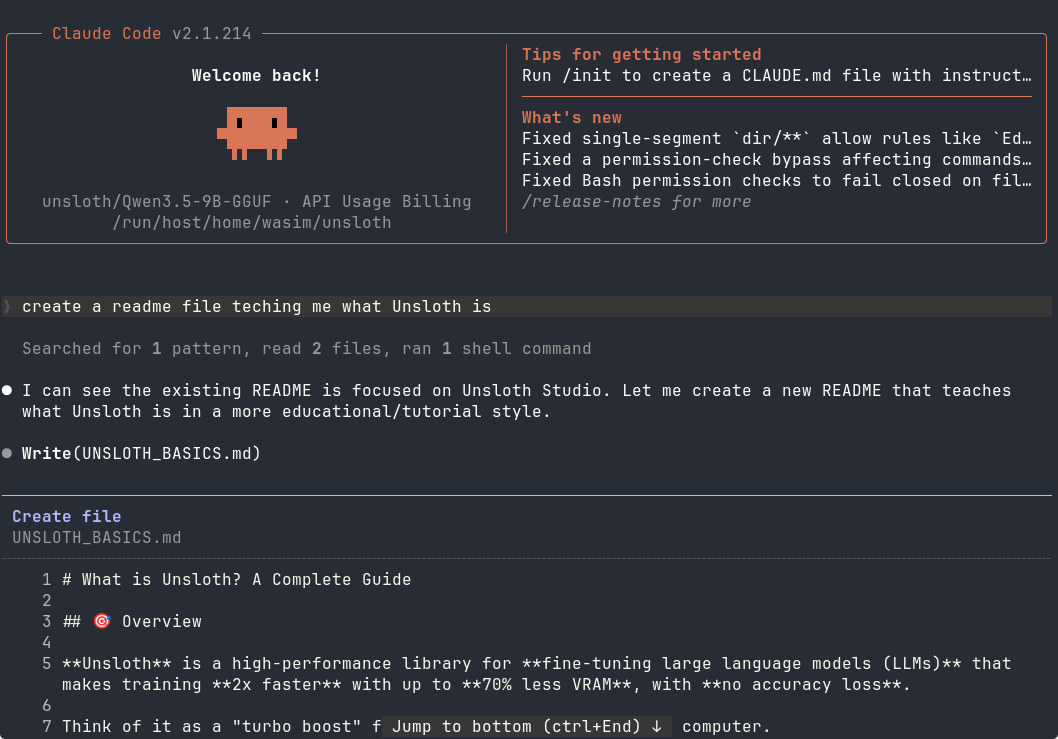
[Démarrage d’Unsloth](/docs/fr/integrations/unsloth-start.md) vous permet de connecter [Claude Code](/docs/fr/notions-de-base/claude-code.md), [Codex](/docs/fr/notions-de-base/codex.md) et d’autres agents à des modèles locaux via la `unsloth start` commande.&#x20;

Démarrez Unsloth, ouvrez le dossier de votre projet et exécutez :

{% code overflow="wrap" %}

```bash
unsloth start claude --model \\
    unsloth/gemma-4-E2B-it-GGUF:UD-Q4_K_XL
```

{% endcode %}

Remplacez `claude` par n’importe quel agent ci-dessous :
{% endcolumn %}

{% column width="41.666666666666664%" %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FpXE6kCHjh8qOEaggf94M%2FScreenshot_20260718_122426.png?alt=media&amp;token=a59e4c8c-efdb-451b-b1f8-621955564f6d" alt="" width="563"><figcaption><p>Claude Code s’exécutant localement avec Qwen3.5.</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

| Agent                                                              | Commande                 |
| ------------------------------------------------------------------ | ------------------------ |
| <i class="fa-claude">:claude:</i> Claude Code                      | `unsloth start claude`   |
| <i class="fa-openai">:openai:</i> OpenAI Codex                     | `unsloth start codex`    |
| <i class="fa-caduceus">:caduceus:</i> Agent Hermes                 | `unsloth start hermes`   |
| <i class="fa-lobster">:lobster:</i> OpenClaw                       | `unsloth start openclaw` |
| <i class="fa-rectangle-vertical">:rectangle-vertical:</i> OpenCode | `unsloth start opencode` |

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fs6AKlSRUrfdwYDIZpcjN%2Fimage(6).png?alt=media&amp;token=d8042094-2df1-4737-b806-08a77e45e105" alt=""><figcaption><p>Toutes les instances Claude sont isolées</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FahmAqUZMFFI3VouqwIYf%2Fimage(5).png?alt=media&amp;token=0dd84f49-16cf-4799-a1d3-e6cbbe105115" alt=""><figcaption><p>Codex exécutant unsloth/gemma-4-E2B-it dynamic 4bit</p></figcaption></figure></div>

### :bar\_chart: Analyse AMD

Nous avons transféré bon nombre de nos optimisations réalisées pour les GPU non AMD afin de faire briller les GPU AMD ! Faire fonctionner l’entraînement AMD sur des appareils Windows et garantir la compatibilité avec presque tous les appareils AMD a demandé beaucoup de travail, mais nous sommes satisfaits de l’état actuel. Nous travaillons encore activement à rendre les GPU AMD encore meilleurs ! Vous trouverez ci-dessous quelques analyses/benchmarks que nous avons effectués sur un AMD MI300X.

#### Apprentissage par renforcement : LoRA et QLoRA plus précis

Pendant le RL sur AMD, Unsloth prend en charge **le partage des poids** avec vLLM, comme introduit dans [RL économe en mémoire](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md). Nous **réduisons de moitié l’utilisation mémoire** en accédant directement à l’allocation du modèle par vLLM.

Pendant LoRA et QLoRA, nous ne faisons pas non plus de fusion et de défusion des poids LoRA comme ci-dessous :

$$
W = W + sAB \\
\text{inference} = XW \\
W = W - sAB
$$

Ce qui précède pose problème car **les flottants IEEE ne sont pas associatifs à cause de l’arrondi**. Lorsque W est en BF16, cela provoque de subtiles différences lors de la soustraction, comme le font d’autres moteurs RL. Cela signifie, dans le monde IEEE :

$$
W \ne(W + sAB) - (sAB)
$$

Et lorsque W est en bfloat16 avec peu de bits de mantisse, il **arrondit les petits nombres à zéro**. Comme A et B sont en float32 pendant LoRA, cela signifie que W peut dériver au fil du temps après fusion et défusion. Unsloth utilise directement le chemin LoRA de vLLM, donc nous évitons cela. Les poids de base ne sont jamais modifiés et ne dériveront jamais.

#### Apprentissage par renforcement plus rapide

{% columns %}
{% column %}
Nous avons comparé d’autres configurations avec FA2 et vLLM co-localisés. Les deux utilisent vLLM pour la génération ; Unsloth transfère une plus grande partie de l’étape vers la génération tout en rendant l’entraînement environ 2x plus rapide.

Les trois benchmarks sont reproductibles : mêmes graines, mêmes budgets de jetons, et les\r courbes de perte correspondent entre les deux piles.
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F31TQsJ8fBG7Vts7u37J8%2Fchart_grpo_combined.png?alt=media&amp;token=719e2729-839e-4287-aa00-5e3b77e1ad7b" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

#### Entraînement plus rapide et plus économe en mémoire

Sur le SFT LoRA de Llama-3.1-8B (batch 2 x grad-accum 4 x 2048 = 16 384 jetons/étape, packé), Unsloth entraîne à 2,07 s/étape contre 2,87 s/étape pour TRL + FA2, et atteint un pic à 18,3 Go contre 24,3 Go. C’est 1,39x plus rapide et 1,33x moins de mémoire utilisée, sans changement de précision. Nous prévoyons d’améliorer encore cela !

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F1YySU2nLYyKoSyXh8lsi%2Fchart_llama8b_vram_over_time.png?alt=media&amp;token=526b2488-315e-487b-8baa-ee71d5e1408a" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FJQH7QTamM7zuK45NNnZY%2Fchart_llama8b_sft_efficiency.png?alt=media&amp;token=81388e0a-e9ca-433d-9cca-1b32f406043b" alt=""><figcaption></figcaption></figure></div>

Les économies de mémoire ne se limitent pas à un pic plus bas, elles se maintiennent pendant toute l’exécution.\r En échantillonnant la VRAM allouée toutes les 0,1 s, Unsloth reste stable et bas tout au long du processus,\r tandis que d’autres configurations + FA2 montent en flèche vers 22,8 Go à presque chaque étape et prennent plus de temps à\r terminer (75 s contre 56 s pour les mêmes 25 étapes).

### :sparkles:Matériel AMD pris en charge

La prise en charge AMD d’Unsloth se concentre sur les GPU grand public, workstation et de centre de données populaires. La prise en charge de l’entraînement, d’Unsloth Studio et de l’inférence GGUF/llama.cpp peut varier selon l’architecture, donc le tableau ci-dessous sépare la prise en charge optimisée des chemins de compatibilité.

<table><thead><tr><th>Architecture</th><th>Série</th><th width="159">gfx</th><th>Prise en charge</th><th>Plateforme</th></tr></thead><tbody><tr><td>RDNA 4</td><td>Série Radeon™ RX 9000</td><td>gfx1200, gfx1201</td><td>Complète</td><td>Windows + WSL + Linux</td></tr><tr><td>RDNA 3.5</td><td>Ryzen AI 300 / Ryzen AI MAX (Strix Halo)</td><td>gfx1150, gfx1151, gfx1152</td><td>Complète</td><td>Windows + WSL + Linux</td></tr><tr><td>RDNA 3</td><td>Série Radeon™ RX 7000</td><td>gfx1100, gfx1101, gfx1102</td><td>Complète</td><td>Windows + WSL + Linux</td></tr><tr><td>RDNA 2</td><td>Série Radeon™ RX 6000</td><td>gfx1030, gfx1031, gfx1032, gfx1034</td><td>Complète</td><td>Windows + WSL + Linux</td></tr><tr><td>RDNA 1</td><td>Série Radeon™ RX 5000</td><td>gfx1010, gfx1012</td><td>Inférence Vulkan</td><td>Windows + WSL + Linux</td></tr><tr><td>CDNA 4</td><td>GPU de série Instinct™ MI350</td><td>gfx950</td><td>Complète</td><td>Linux uniquement</td></tr><tr><td>CDNA 3</td><td>GPU de série Instinct™ MI300</td><td>gfx940, gfx941, gfx942</td><td>Complète</td><td>Linux uniquement</td></tr><tr><td>CDNA 2</td><td>GPU de série Instinct™ MI200</td><td>gfx90a</td><td>Complète</td><td>Linux uniquement</td></tr><tr><td>CDNA 1</td><td>GPU de série Instinct™ MI100</td><td>gfx908</td><td>Complète</td><td>Linux uniquement</td></tr></tbody></table>

Nous travaillons activement à prendre en charge davantage de GPU AMD, cependant les plus anciens n’ont malheureusement pas le support matériel requis pour que nous puissions les prendre en charge.

### :desktop: Guide d’utilisation d’Unsloth sur AMD

Après l’installation, vous pouvez ouvrir Unsloth Studio dans votre navigateur. De là, vous pouvez exécuter et affiner automatiquement des LLM locaux sur du matériel AMD. Voir ci-dessous pour des instructions d’installation détaillées :

{% columns %}
{% column width="50%" %} <a href="/docs/fr/commencer/install/amd.md" class="button primary">Guide d’installation AMD</a><a href="/docs/fr/nouveau/studio/install.md" class="button primary">Installer Unsloth Studio</a>

Sélectionnez votre modèle, votre jeu de données et vos paramètres d’entraînement pour commencer. Par exemple, vous pouvez lancer un fine-tuning QLoRA 4 bits sur Gemma 4 12B avec une longueur de contexte d’environ 16k, un rang LoRA de 16, un taux d’apprentissage de 0.0002 et 30 étapes maximum.
{% endcolumn %}

{% column width="50%" %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F2GbvLBqN03qsvh5N9Uq1%2Fft%20studio.png?alt=media&amp;token=71fd643b-32f1-4f7f-8183-1e1fa97e80c0" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% columns %}
{% column %}
L’écran de fine-tuning d’Unsloth Studio est entièrement personnalisable, vous permettant de configurer votre modèle, votre jeu de données et vos paramètres d’entraînement. Pendant l’entraînement, Unsloth suit la progression en temps réel, y compris la perte, l’utilisation de la RAM et de la VRAM, ainsi que la prise en charge du multi-GPU. Une fois l’entraînement commencé, vous verrez la progression affichée en temps réel.

Après l’entraînement, vous pouvez consulter votre historique pour voir les sessions d’entraînement passées et actives. Sélectionnez l’un de vos modèles affinés pour voir les journaux d’entraînement passés :
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhATsVSzX50cDHFtnfRAN%2Fimage.png?alt=media&amp;token=ce89695a-1579-4ae5-8423-e3ddace69f8e" alt="" width="563"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

<div align="left"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fxm20hpZ7TK1y3xrzN6vp%2Fimage.png?alt=media&amp;token=77d9959c-4415-4f49-9413-684e83a3f4b8" alt="" width="563"><figcaption></figcaption></figure></div>

{% columns %}
{% column %}
Une fois l’entraînement terminé, exportez votre modèle en tant que GGUF, safetensors de modèle fusionné, ou adaptateur LoRA pour un déploiement avec Hugging Face, llama.cpp, vLLM ou Unsloth. Pour les exports GGUF, Unsloth utilise des versions précompilées ROCm de llama.cpp adaptées à votre architecture gfx, avec une compilation depuis les sources comme solution de secours lorsqu’aucune version précompilée n’est disponible. Une fois l’export terminé, vous verrez « Export terminé avec succès ». Vous pouvez également pousser votre modèle directement vers le Hugging Face Hub.
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FDVdUSCq0apPcx5mU2AYq%2Fimage.png?alt=media&amp;token=481db1ed-bae7-44c5-976e-2f5e85f886b6" alt="" width="563"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% columns %}
{% column %}
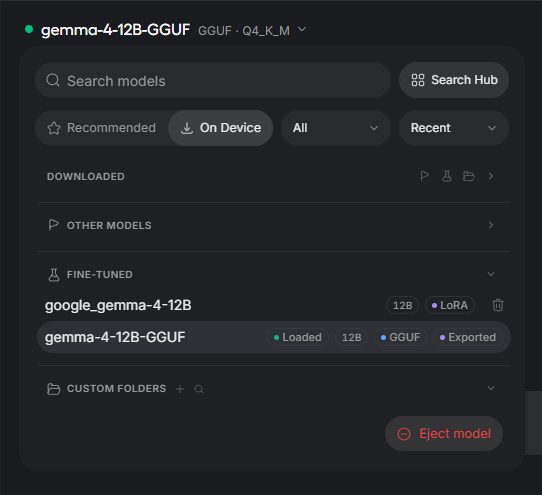
Exportez votre modèle dans le format de votre choix et déployez-le partout. Après l’exportation, chargez votre modèle affiné depuis la section Fine-tuned du menu déroulant des modèles dans New Chat ou Recents.

Sélectionnez votre modèle affiné dans le menu déroulant et discutez directement avec lui dans Unsloth. Vous pouvez désormais utiliser vos modèles entraînés ou téléchargés dans New Chat, Recents ou Projects. Activez les options think, code et search pour une meilleure expérience, et consultez le [chat d’Unsloth Studio](https://unsloth.ai/docs/new/studio/chat) dans la documentation pour plus de détails.
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FRcgOQ8zbfLAYhypopa0V%2Fimage.png?alt=media&amp;token=393d9bb3-1eb7-4171-9dd3-ef0377a176d5" alt="" width="407"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

Et enfin, vous pouvez discuter avec votre nouveau modèle finement ajusté directement dans Unsloth !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FCGaDuaOaNNzd6NrtpnD5%2Funsloth%20studio%20chat%20screenshot.png?alt=media&amp;token=d179749f-f027-4ab4-8082-f1c87b8a59be" alt=""><figcaption></figcaption></figure>

Vous pouvez également surveiller le débit et les jetons générés / s dans le terminal, comme dans les journaux vLLM. Vous verrez `"gen_tok_s"` qui correspond aux jetons / s et `"prompt_tok_s"` qui correspond au traitement du prompt.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F0wOZYG4Y72hZInt9BBjk%2Fthroughput.png?alt=media&amp;token=102dcc3a-75e6-4b7e-9631-4cd3115f7df9" alt=""><figcaption></figcaption></figure>

### :mobile\_phone:Unsloth sur téléphone et tunneling HTTPS à distance

Nous avons ajouté **gratuit** des tunnels HTTPS Cloudflare pour Unsloth (similaires à LM Link), afin que vous puissiez discuter / entraîner à distance des modèles avec Unsloth sur votre téléphone (iPhone, Android - n’importe quel téléphone !) via un lien ou n’importe quel autre ordinateur ! Cela fonctionne sur les appareils Mac, Linux, WSL et Windows.

* Entraînez et affinez depuis votre téléphone / **à distance avec des journaux de perte d’entraînement en direct** - annulez ou réentraînez !
* Discutez dans le navigateur depuis n’importe où avec appel d’outils et diffusion en direct.
* Véritable **canevas HTML interactif** des sorties directement sur votre téléphone - jouez à des jeux créés par des LLM !

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FfuLfgQ7m7gB5IK8fZdDo%2Fphone%20inference.png?alt=media&amp;token=a7aec44c-02b8-483d-ab5b-7268f802a3e9" alt="" width="188"><figcaption><p>Discutez à distance !</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FlmeAQLZAFGGy21rDmBUn%2Fphone%20thinking.png?alt=media&amp;token=6f0fe9a6-c849-4ff0-bd7d-dea8dbffd222" alt="" width="188"><figcaption><p>Inférence en direct + appel d’outils</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FEQWneGD6ncfYTe6NugtO%2Fphone%20training%20logs.png?alt=media&amp;token=1c830286-f6bc-472c-8915-3f45daadb0a9" alt="" width="188"><figcaption><p>Journaux d’entraînement à distance !</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fz1JnnGZmO5aWy57dK1w1%2Fphone%20flappy%20bird.png?alt=media&amp;token=b31fd81d-eb97-4c55-a93c-1e5f5742557a" alt="" width="188"><figcaption><p>Exécutez du HTML en direct sur le téléphone</p></figcaption></figure></div>

Pour le configurer, d’abord dans le terminal après avoir installé Unsloth, tapez `unsloth studio --secure` . Définissez un mot de passe afin qu’aucune personne non autorisée ne puisse accéder au lien HTTPS !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FQfRsJGUWXMCGYczt1G0K%2Fsecure%20login%20password.png?alt=media&amp;token=23f3976b-4e23-49da-a95c-e32fb53952f0" alt=""><figcaption></figcaption></figure>

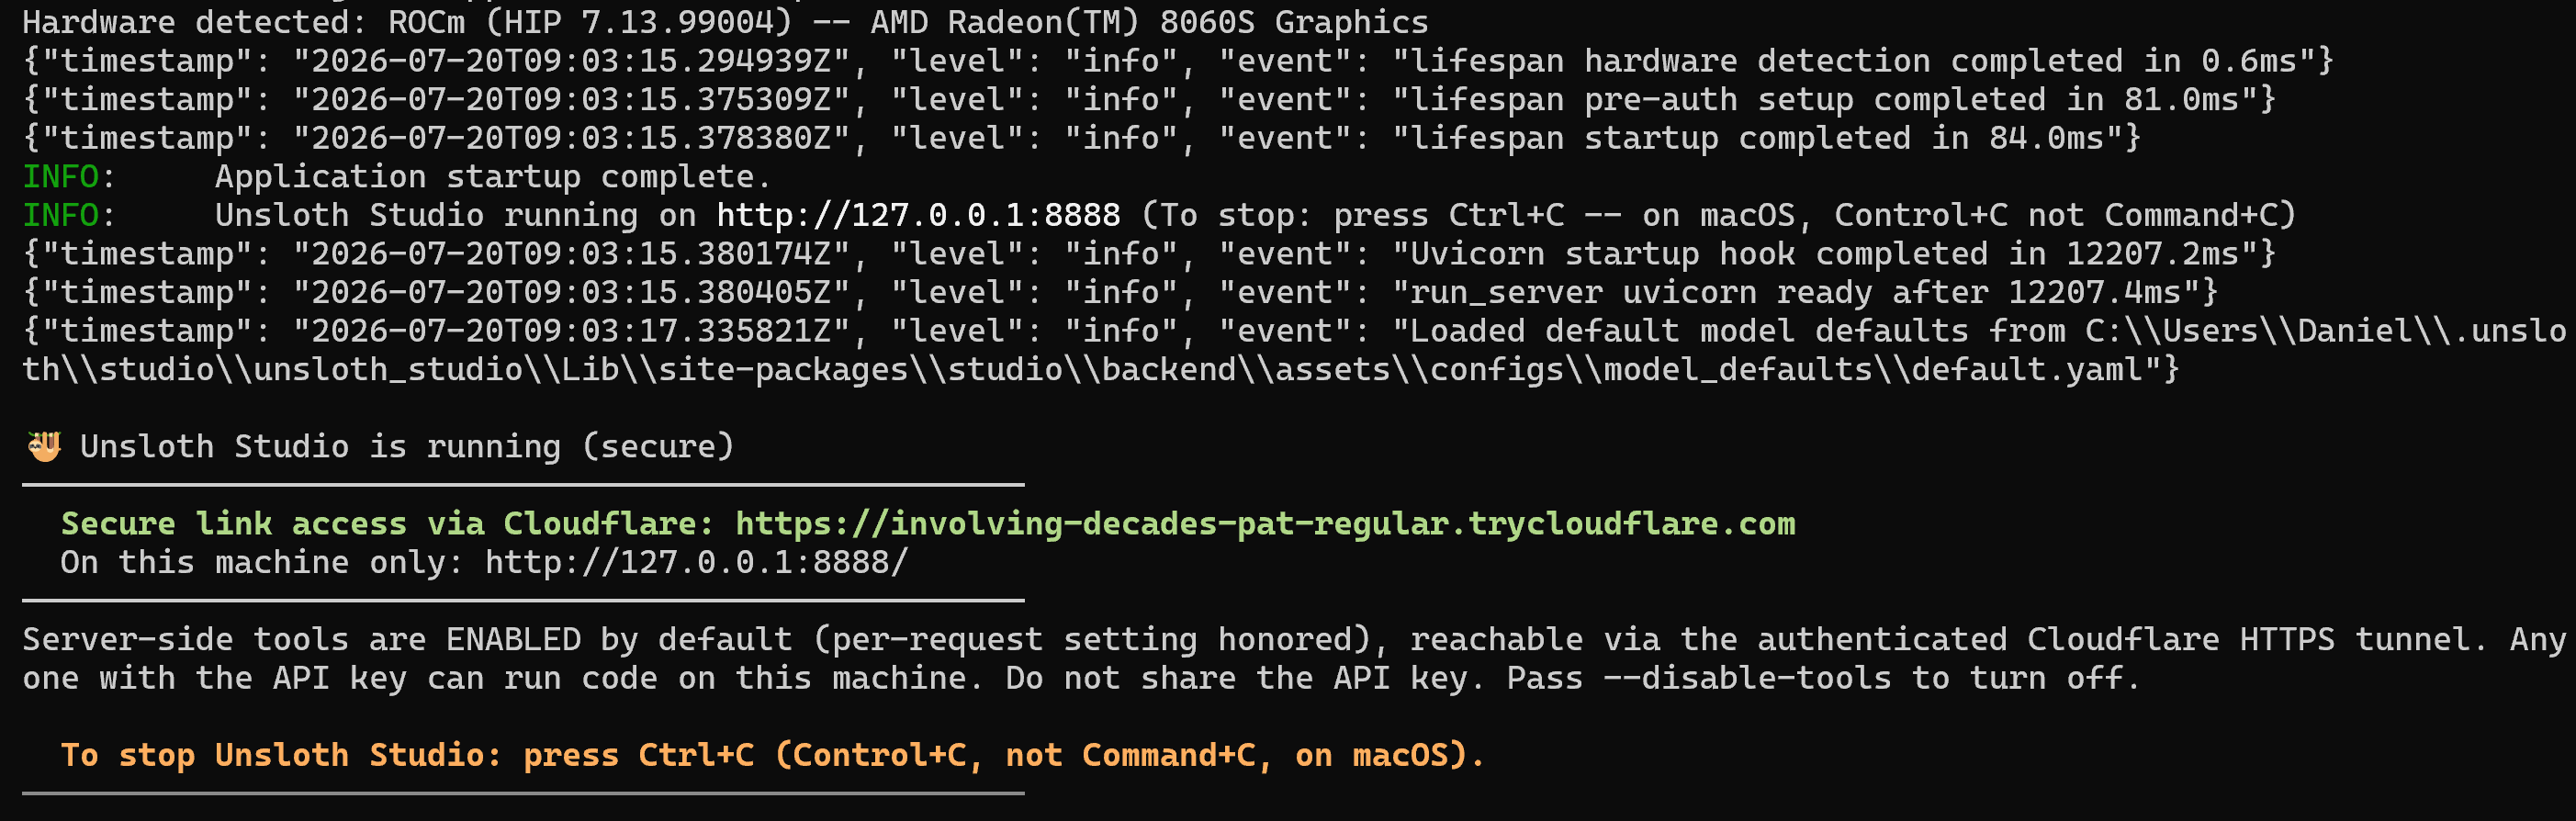
Ensuite, dans les journaux - utilisez le <mark style="color:$success;">**lien Cloudflare vert**</mark> et saisissez-le sur notre téléphone ou sur n’importe quel appareil distant !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F5UifJGPRo0GfSbm8UeAG%2Fsecure%20terminal%20link.png?alt=media&amp;token=8da77481-a380-4f26-af9f-c31342992d41" alt=""><figcaption></figcaption></figure>

Et voilà, vous y êtes ! Vous pouvez toujours surveiller / annuler le lien HTTPS servi en direct en faisant CTRL+C dans le terminal où Unsloth Studio a été lancé !

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FDYsI12Qy2lN1TuNu8HrJ%2Fphone%20model%20select.png?alt=media&amp;token=05891101-47cd-430b-9a76-698ccca60246" alt="" width="188"><figcaption><p>Modifier les paramètres d’inférence</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fi9RMJOuSJCZ0eTGr4iIJ%2Fphone%20extra%20optios.png?alt=media&amp;token=5fa1d410-9d5d-4964-8d51-c1f3e82ac213" alt="" width="188"><figcaption><p>Modifier temp, top_p, longueur de ctx</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FgNBUBdVsZ08XfJtDv5Ux%2Fphone%20canvas.png?alt=media&amp;token=207ff0e7-9653-4181-9344-6fab86bc2b9a" alt="" width="188"><figcaption><p>Le canevas rend automatiquement le HTML !</p></figcaption></figure></div>

### :question:Comment la prise en charge AMD a été intégrée à Unsloth

Les kernels personnalisés d’Unsloth ont été portés sur AMD en étroite collaboration avec l’équipe AMD. Cela a nécessité des modifications dans l’installateur, la détection du matériel, l’orientation d’exécution, la surveillance et la sélection des ressources précompilées.

* **Kernels ROCm :** Ports HIP/Triton ajustés pour RDNA et CDNA, avec des correctifs de précision, de performance et de stabilité spécifiques à l’architecture. ([#2520](https://github.com/unslothai/unsloth/pull/2520))
* **Entraînement 4 bits :** Prise en charge QLoRA basée sur bitsandbytes pour les GPU Radeon et CDNA. ([#3748](https://github.com/unslothai/unsloth/pull/3748))
* **Configuration automatique :** détection robuste des GPU AMD et installation de la bonne roue PyTorch ROCm, y compris des mécanismes de réparation et de protection de la plateforme. ([#4770](https://github.com/unslothai/unsloth/pull/4770))
* **Windows et Strix Halo :** installation native de ROCm sous Windows, correctifs de compatibilité à l’exécution, signalement de la mémoire unifiée et prise en charge de WSL. ([#5301](https://github.com/unslothai/unsloth/pull/5301), [#6227](https://github.com/unslothai/unsloth/pull/6227))
* **Inférence ROCm :** versions précompilées de llama.cpp spécifiques à l’architecture, solution de secours par compilation depuis les sources, détection de la VRAM AMD et surveillance. ([#5172](https://github.com/unslothai/unsloth/pull/5172))

### :clock1: Travaux futurs

Un grand merci à l’équipe AMD pour avoir collaboré avec nous afin de faire fonctionner AMD au mieux ! Les priorités à venir incluent :

* Poursuite du développement et de l’échange avec l’équipe AMD.
* Extension du CI/CD matériel-backend à l’aide du matériel AMD Strix Halo et Radeon Lab.
* Prise en charge des nouvelles cartes GPU AMD et des nouvelles architectures lors de leur lancement.
* Des conseils plus clairs sur le multi-GPU : l’entraînement distribué AMD est actuellement réservé à Linux. Sous Linux, ROCm utilise RCCL, donc l’entraînement distribué fonctionne. Sous Windows, AMD ROCm ne fournit pas encore de backend collectif GPU, avec une prise en charge GLOO/CPU uniquement à partir de [TheRock #5694](https://github.com/ROCm/TheRock/pull/5694), utilisez Linux si vous prévoyez de faire de l’entraînement multi-GPU AMD.
* Autres optimisations de vitesse par rapport à la pile ROCm.

### :love\_letter: Merci à AMD pour cette collaboration !

Un grand merci à l’équipe AMD et à notre incroyable communauté Unsloth pour avoir collaboré avec nous sur cette version. Nous remercions Strahinja Stamenkovic, Filip Jankovic, Iswarya Alex, Yue Yuan Bill He, Eda Zhou, Mahdi Ghodsi, Guruprasad et toute l’équipe AMD pour avoir collaboré afin que la prise en charge d’AMD fonctionne parfaitement avec Unsloth ! Un énorme merci également aux membres de la communauté : Nate, UBER6, AiwendilOfMirk..., Gene, Jimster480, VELICAN, Vintheboy, archmaker, BichonFriseMax, Calandracas, Chigoma333, Edd, electroglyph, jslowbell, mk 27B UD-, Satyam, snapcast3r, TotoMC pour les tests et le débogage avec nous.

Un moyen simple d’utiliser Unsloth sur AMD est via [AMD Developer Cloud](https://www.amd.com/en/developer/resources/cloud-access/amd-developer-cloud.html), avec des notebooks en un clic alimentés par des GPU MI300X avec 192 Go de VRAM. AMD offre également des crédits gratuits via le [AMD AI Developer Program](https://www.amd.com/en/developer/ai-dev-program.html). Pour exécuter un notebook Unsloth, utilisez n’importe quel notebook AMD de [unslothai/notebooks](https://github.com/unslothai/notebooks) et remplacez le domaine GitHub par l’URL AMD Developer Cloud, puisque les chemins des notebooks sont les mêmes.

Besoin d’aide ou envie de partager vos retours ? Vous pouvez rejoindre notre [Discord](https://discord.com/invite/unsloth), lire la [documentation AMD](https://unsloth.ai/docs/get-started/install/amd), ouvrir une issue ou une PR sur [GitHub](https://github.com/unslothai/unsloth/issues), ou publier sur notre [Reddit r/unsloth](https://www.reddit.com/r/unsloth/).


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://unsloth.ai/docs/fr/notions-de-base/amd.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.