> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/tutorials/qwen3.6.md).

# Qwen3.6

新しいQwen3.6-27Bと35B-A3Bモデルをローカルで実行しましょう！

Qwen3.6は、Alibabaの新しいマルチモーダルなハイブリッド思考モデル群で、以下を含みます： **Qwen3.6-27B** と **35B-A3B**。そのサイズに対して最高クラスの性能を発揮し、201言語で256Kコンテキストをサポートします。エージェント型コーディング、画像、チャットタスクに優れています。Qwen3.6-27Bは **18GB RAM** の環境で動作し、35B-A3Bは **22GB**。現在、モデルを次の環境で実行・学習できます： [Unsloth Desktop](#unsloth-guide).

{% hint style="success" %}
**7月10日：** 新しいものをリリースしました [**NVFP4** 量子化](#nvfp4) Qwen3.6をGPU上で2.5倍高速に実行するためのものです。

[**Qwen3.6 MTPが登場**](#mtp-guide)**!** MTPにより、精度を損なうことなく1.4〜2.2倍高速な推論が可能です。MTPは次の環境で直接実行できます： [Unsloth Studio](#unsloth-studio-mtp-guide)。私たちは以下を実施しました [Qwen3.6 GGUFベンチマーク](#unsloth-gguf-benchmarks) 最適な量子化版を選ぶための参考にしてください。
{% endhint %}

<a href="#qwen3.6-inference-tutorials" class="button primary">Qwen3.6チュートリアルを実行</a><a href="#mtp-guide" class="button primary">MTPガイド</a>

{% columns %}
{% column %}
Qwen3.6 GGUFはUnslothを使用して [Dynamic 2.0](/docs/jp/ji-chu/dynamic-3.0-ggufs.md) 最先端の量子化性能を実現しています。そのため、量子化版は実世界のユースケースデータセットで調整され、重要な層はアップキャストされています。 *デイ0アクセスを提供してくれたQwenに感謝します。*

* **開発者ロール対応** Codex、OpenCodeなど向けに：\
  当社のアップロードは現在、 `開発者ロール` エージェント型コーディングツール向けに対応しています。
* **ツール呼び出し:** 同様に [Qwen3.5](/docs/jp/moderu/qwen3.5.md)、ネストされたオブジェクトの解析を改善し、ツール呼び出しの成功率を向上させました。
  {% endcolumn %}

{% column %}

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FTbH2CrUTG2TWwgOP74GF%2FGemma%204%20example.gif?alt=media&amp;token=56409d06-3735-4531-97c0-af9968371a26" alt=""><figcaption><p>Qwen3.6が次で動作中： <a href="#unsloth-studio-guide">Unsloth Studio</a>.</p></figcaption></figure></div>
{% endcolumn %}
{% endcolumns %}

### :gear: 使用ガイド

**表: 推論ハードウェア要件** （単位 = 合計メモリ：RAM + VRAM、または統合メモリ）

<table><thead><tr><th>Qwen3.6</th><th>3ビット</th><th>4ビット</th><th width="128">6ビット</th><th>8ビット</th><th>BF16</th></tr></thead><tbody><tr><td><strong>27B</strong></td><td>15 GB</td><td>18 GB</td><td>24 GB</td><td>30 GB</td><td>55 GB</td></tr><tr><td><strong>35B-A3B</strong></td><td>17GB</td><td>23 GB</td><td>30 GB</td><td>38 GB</td><td>70 GB</td></tr></tbody></table>

{% hint style="success" %}
最適なパフォーマンスを得るには、利用可能な合計メモリ（VRAM + システムRAM）が、ダウンロードする量子化モデルファイルのサイズを上回っていることを確認してください。上回っていない場合でも、SSD/HDDオフロード経由で実行できますが、推論は遅くなります。
{% endhint %}

**Qwen3.6を学習させるには、以前の** [**Qwen3.5ファインチューニングガイド**](/docs/jp/moderu/qwen3.5/fine-tune.md)**.**

### 推奨設定

* **最大コンテキストウィンドウ：** `262,144` （YaRN により 1M まで拡張可能）
* `presence_penalty = 0.0 から 2.0` デフォルトではオフですが、繰り返しを減らすためにこれを使えます。ただし、より高い値を使うと **性能がわずかに低下する可能性があります**
* **十分な出力長**: `32,768` ほとんどのクエリでのトークン

{% hint style="info" %}
意味不明な出力になる場合、コンテキスト長が低すぎる可能性があります。あるいは次を使ってみてください： `--cache-type-k bf16 --cache-type-v bf16` これで改善するかもしれません。
{% endhint %}

Qwen3.6はハイブリッド推論であるため、思考モードと非思考モードでは設定が異なります：

#### 思考モード:

{% hint style="success" %}
Qwen3.6には現在、 [思考の保持](#turn-on-off-thinking--preserve-thinking).
{% endhint %}

| 一般タスク                       | 精密なコーディングタスク（例：WebDev）      |
| --------------------------- | --------------------------- |
| temperature = 1.0           | temperature = 0.6           |
| top\_p = 0.95               | top\_p = 0.95               |
| top\_k = 20                 | top\_k = 20                 |
| min\_p = 0.0                | min\_p = 0.0                |
| presence\_penalty = 0.0     | presence\_penalty = 0.0     |
| repeat\_penalty = 無効または 1.0 | repeat\_penalty = 無効または 1.0 |

{% columns %}
{% column %}
一般タスク向け思考モード：

{% code overflow="wrap" %}

```bash
temperature=1.0, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0
```

{% endcode %}
{% endcolumn %}

{% column %}
精密なコーディングタスク向け思考モード：

{% code overflow="wrap" %}

```bash
temperature=0.6, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0
```

{% endcode %}
{% endcolumn %}
{% endcolumns %}

#### Instruct（非思考）モード設定：

| 一般タスク                       |
| --------------------------- |
| temperature = 0.7           |
| top\_p = 0.8                |
| top\_k = 20                 |
| min\_p = 0.0                |
| presence\_penalty = 1.5     |
| repeat\_penalty = 無効または 1.0 |

{% hint style="warning" %}
〜を [思考／推論を無効化するには](#how-to-enable-or-disable-reasoning-and-thinking)、次を使用してください `--chat-template-kwargs '{"enable_thinking":false}'`

〜を使っている場合 **Windows** PowerShellを使っている場合は、次を使用します: `--chat-template-kwargs "{\"enable_thinking\":false}"`

『true』と『false』は同様に使用できます。
{% endhint %}

一般タスク向けInstruct（非思考）：

{% code overflow="wrap" %}

```bash
temperature=0.7, top_p=0.8, top_k=20, min_p=0.0, presence_penalty=1.5, repetition_penalty=1.0
```

{% endcode %}

## Qwen3.6推論チュートリアル：

ここではDynamic 4-bitを使用します `UD-Q4_K_XL` 推論ワークロード向けのGGUFバリアントです。下をクリックして、各モデルの手順に移動してください：

<a href="#unsloth-studio-guide" class="button primary">Unsloth Desktopで実行</a><a href="#llama.cpp-guide" class="button secondary">llama.cppで実行</a><a href="#mtp-guide" class="button primary">MTPガイド</a><a href="#nvfp4" class="button secondary">NVFP4 ガイド</a>

{% hint style="warning" %}
CUDA 13.2は使用しないでください。意味不明な出力が得られる可能性があります。CUDA 13.2未満、またはCUDA 13.3を使用してください。
{% endhint %}

### 🦥 Unslothガイド

Qwen3.6とQwen3.6 MTPは現在、次で実行できます： [Unsloth Desktop、](/docs/jp/desktop.md) ローカルAI向けの新しいオープンソースUIです。Unsloth Studioを使うと、モデルをローカルで **MacOS、Windows**、Linux、および：

{% columns %}
{% column %}

* 検索、ダウンロード、 [GGUFを実行](/docs/jp/shii/studio.md#run-models-locally) および safetensor モデル
* [**自己修復** ツール呼び出し](/docs/jp/shii/studio.md#execute-code--heal-tool-calling) + **web検索**
* [**コード実行**](/docs/jp/shii/studio.md#run-models-locally) （Python、Bash）
* [自動推論](https://unsloth.ai/docs/desktop#feature-deep-dive) パラメータ調整（temp、top-pなど）
* llama.cppによる高速なCPU + GPU推論
* [LLMを学習](/docs/jp/shii/studio.md#no-code-training) VRAMを70%削減しながら2倍高速
  {% endcolumn %}

{% column %}

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKoonE97b0H3RioMwVohd%2Fstudio%20new%20ui.gif?alt=media&amp;token=e37f2839-914e-48b8-8c81-2dac3ade9408" alt=""><figcaption></figcaption></figure></div>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}

#### Unslothをインストール

始める最も簡単な方法は、 [Unsloth Desktopアプリ](/docs/jp/desktop.md)をダウンロードすることです。 [macOS](/docs/jp/meru/install/mac.md), [Windows](/docs/jp/meru/install/windows-installation.md)と [Linux](/docs/jp/meru/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Unslothをダウンロード</a>

* <i class="fa-apple">:apple:</i> [macOS用をダウンロード](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Windows用をダウンロード](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Linux用をダウンロード](https://unsloth.ai/download/linux)

または、手動でインストールしたい場合：

**MacOS、Linux、WSL：**

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

**Windows PowerShell：**

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% hint style="success" %}
**インストールはすぐに完了し、およそ20秒〜1分かかります。**
{% endhint %}
{% endstep %}

{% step %}

#### Unsloth を起動

**MacOS、Linux、WSL、Windows:**

```bash
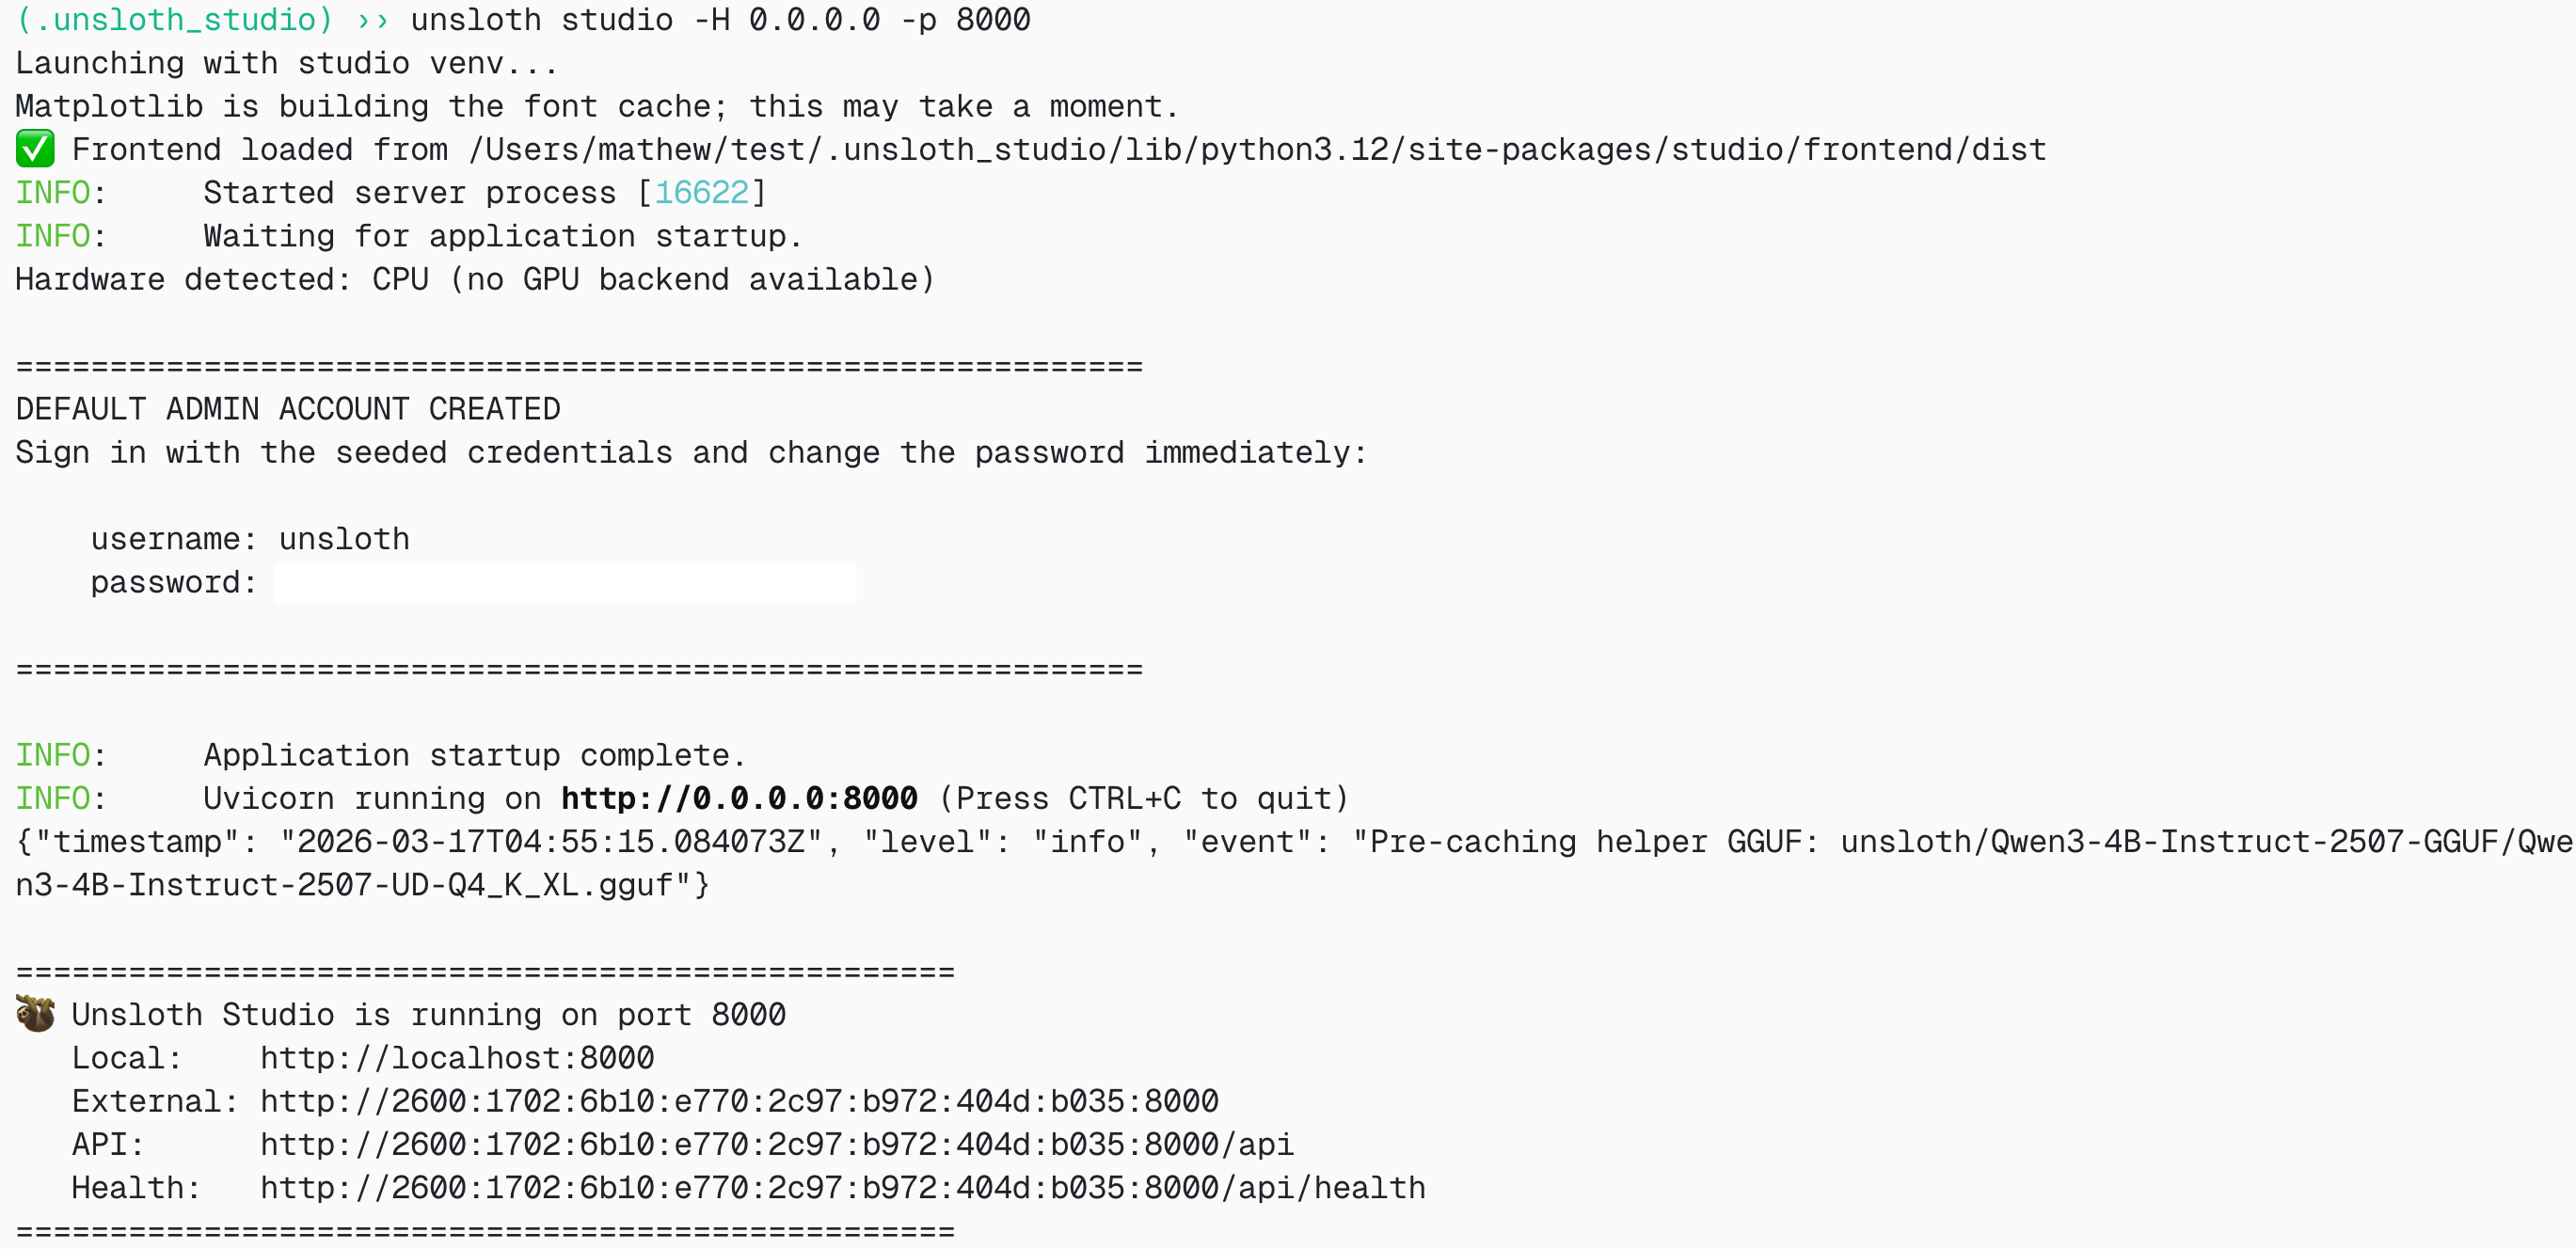
unsloth studio -H 0.0.0.0 -p 8888
```

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fd1yMMNa65Ccz50Ke0E7r%2FScreenshot%202026-03-17%20at%2012.32.38%E2%80%AFAM.png?alt=media&amp;token=9369cfe7-35b1-4955-b8cb-42f7ecb43780" alt="" width="375"><figcaption></figcaption></figure></div>

その後、次を開きます `http://127.0.0.1:8888` （またはお使いのURL）をブラウザで開いてください。

**HTTPS と Cloudflare で Unsloth を安全に起動**

**新機能！** Unslothでは現在、無料のCloudflareトンネルを通じてHTTPSでUnslothを起動する安全な方法を提供しています。以下を使用してください（Windows、Mac、Linuxで動作します）：

```bash
unsloth studio --secure
```

{% endstep %}

{% step %}

#### Qwen3.6またはQwen3.6 MTPを検索してダウンロード

初回起動時には、アカウントを保護するためのパスワードを作成し、後で再度サインインする必要があります。次に [Unsloth Chat](/docs/jp/shii/studio/chat.md) タブを開き、検索バーでQwen3.6またはQwen3.6 MTPを検索して、必要なモデルと量子化版をダウンロードしてください。

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FT6uAnOeF7OU9cuiE8JR5%2FScreenshot%202026-04-16%20at%208.59.33%E2%80%AFAM.png?alt=media&amp;token=6977f7b6-aff7-494b-84b5-ad737125da31" alt="" width="375"><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}

#### Qwen3.6を実行

Unsloth Studio を使用する場合、推論パラメータは自動設定されますが、手動で変更することもできます。コンテキスト長、チャットテンプレート、その他の設定も編集できます。

詳細は、 [Unsloth Studio 推論ガイド](/docs/jp/shii/studio/chat.md)。以下では、2ビットのQwen3.6 GGUFが30回以上のツール呼び出しを行い、20サイトを検索し、Pythonコードを実行しました：

{% embed url="<https://cdn-uploads.huggingface.co/production/uploads/62ecdc18b72a69615d6bd857/9lqVQm1qDX3elt6Uan5Vm.mp4>" %}
{% endstep %}
{% endstepper %}

### ⚡ MTPガイド

MTP（Multi Token Prediction）による投機的デコードにより、Qwen3.6のようなモデルは **約1.4〜2.2倍高速な生成を実現し、&#x20;**<mark style="background-color:$success;">**精度は変わりません**</mark>。これにより、Qwen3.6 27Bと35B-A3Bは **1.4倍超の高速化** を元のベースラインに対して達成でき、ローカルモデルで特に有用です。

UnslothのQwen3.6 MTP GGUFはもはや実験段階ではなく、llama.cppにもMTPサポートが統合されました。次で直接実行できます： [Unsloth StudioのUI](#unsloth-studio-guide) またはllama.cpp経由で。 **Qwen3.6 27B MTPは現在、RTX 6000 GPU上で生成160 tokens/s、Qwen3.6 35B-A3Bは240 tokens/sで動作します。** 詳細なツール呼び出しの方法は [#mtp-benchmarks](#mtp-benchmarks "mention").

Unsloth Studioは、特定のハードウェア（Mac、CPU、GPUなど）向けに最適化された理想的なMTP設定を自動で設定します。後から変更することもできます。

{% hint style="info" %}
**MTPは標準のGGUFよりもわずかに多くのVRAMを使用するため**、約1GBの追加RAM/VRAM余裕を見込んでください。
{% endhint %}

<a href="#unsloth-studio-mtp-guide" class="button primary">Unsloth Studio で実行</a><a href="#llama.cpp-mtp-guide" class="button secondary">llama.cppで実行</a><a href="#nvfp4" class="button secondary">NVFP4を実行</a>

| [Qwen3.6-27B-MTP-GGUF](https://huggingface.co/unsloth/Qwen3.6-27B-MTP-GGUF) | [Qwen3.6-35B-A3B-MTP-GGUF](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MTP-GGUF) |
| --------------------------------------------------------------------------- | ----------------------------------------------------------------------------------- |

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FMYn1g7MDeVRAUa6i2oOk%2Fthroughput%20mpt.png?alt=media&amp;token=aff44c0a-3cc3-493e-b6b4-e3279dfb90c1" alt=""><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F4CvUpxr0xdxCR1lTGUbS%2Fmtp%20benchmarks%20landscape.png?alt=media&amp;token=d6579f47-a196-408b-a013-329e09705251" alt=""><figcaption></figcaption></figure></div>

実際には、MTPは将来の複数トークンを予測し、その後メインモデルがそれらのトークンを並列で検証します。これにより、生成時に必要な順伝播回数が減り、出力が高速になります。 **私たちが見つけたのは `--spec-draft-n-max 2` が、ほとんどの環境で最もよく機能します。** **ただし、 `2` が最適だと決めつけないでください。性能はハードウェアに依存します。次の値を試して `1` から `6` 、あなたのシステムで最も速いものを使ってください。**

また、 [MTP GGUFもアップロードしました](https://huggingface.co/unsloth/models?search=mtp) の [**Qwen3.5**](/docs/jp/moderu/qwen3.5.md) **モデルファミリー** を対象にしています: 0.8B、2B、4B、9B、27B、35B-A3B、122B-A10B、397B-A17Bを含みます。Llama.cppはMTP性能を継続的に改善しているため、今後さらに高速になると期待できます!

**表: MTPのハードウェア要件** （単位 = 合計メモリ：RAM + VRAM、または統合メモリ）

<table><thead><tr><th>Qwen3.6</th><th>3ビット</th><th>4ビット</th><th width="128">6ビット</th><th>8ビット</th><th>BF16</th></tr></thead><tbody><tr><td><strong>27B</strong></td><td>16 GB</td><td>19 GB</td><td>25 GB</td><td>31 GB</td><td>56 GB</td></tr><tr><td><strong>35B-A3B</strong></td><td>18 GB</td><td>24 GB</td><td>31 GB</td><td>39 GB</td><td>71 GB</td></tr></tbody></table>

#### 🦥 Unsloth Studio MTPガイド

Unsloth Studioは、特定のハードウェア（Mac、CPU、GPUなど）向けに最適化された理想的なMTP設定を自動で設定します。後から変更することもできます。

{% stepper %}
{% step %}

#### Unslothをインストール

ターミナルで実行:

**MacOS、Linux、WSL：**

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

**Windows PowerShell：**

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% endstep %}

{% step %}

#### Unsloth を起動

**MacOS、Linux、WSL、Windows:**

```bash
unsloth studio -H 127.0.0.1 -p 8888
```

その後、次を開きます `http://127.0.0.1:8888` （またはお使いのURL）をブラウザで開いてください。
{% endstep %}

{% step %}

#### Qwen3.6 MTPを検索してダウンロード

初回起動時には、アカウントを保護するためのパスワードを作成し、後で再度サインインする必要があります。次に [Unsloth Chat](/docs/jp/shii/studio/chat.md) タブを開き、検索バーでQwen3.6 MTPを検索して、必要なモデルと量子化版をダウンロードしてください。

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F2zQdtdNf0CRBrnTOXBZa%2FScreenshot%202026-05-16%20at%207.10.39%E2%80%AFPM.png?alt=media&amp;token=d1f2e482-5cb7-4e41-97ed-f2905a81f262" alt="" width="375"><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}

#### Qwen3.6 MTPを実行

Unsloth Studio を使用する場合、推論パラメータは自動設定されますが、手動で変更することもできます。コンテキスト長、チャットテンプレート、その他の設定も編集できます。

詳細は、 [Unsloth Studio 推論ガイド](/docs/jp/shii/studio/chat.md)。以下では、2ビットのQwen3.6 MTP GGUFが10回以上のツール呼び出しを行い、10件のサイトを検索し、Pythonコードを実行しました:

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsERzR65n4jc1UtuSHozZ%2Fwedefrwfwe.gif?alt=media&amp;token=e303ed9e-0d90-456d-8d57-874a06803903" alt=""><figcaption></figcaption></figure></div>
{% endstep %}
{% endstepper %}

#### 🦙 Llama.cpp MTPガイド

{% stepper %}
{% step %}
最新バージョンをインストールしてください `llama.cpp` を [**GitHubからこちらで取得**](https://github.com/ggml-org/llama.cpp/pull/22673)。以下のビルド手順に従うこともできます。 `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` に変更してください。GPUがない場合、またはCPU推論だけを使いたい場合です。 **Apple Mac / Metalデバイスの場合**、 `-DGGML_CUDA=OFF` を設定し、そのまま通常どおり続行してください。Metalサポートはデフォルトで有効です。

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
を直接使ってモデルを読み込みたい場合は、 `llama.cpp` モデルを直接読み込むには、以下を実行できます: (:`Q4_K_XL`)は量子化タイプです。Hugging Face経由でもダウンロードできます（3番）。これは次に似ています `ollama run` に似ています。 `export LLAMA_CACHE="folder"` を使うと `llama.cpp` 特定の場所に保存するためです。このモデルの最大コンテキスト長は256Kです。

各モデルについて、以下のコマンドのいずれかに従ってください:

<a href="#mtp-qwen3.6-27b" class="button primary">27B MTP</a><a href="#mtp-qwen3.6-35b-a3b" class="button primary">35-A3B MTP</a>

#### MTP Qwen3.6-27B：

**思考モード:**

{% hint style="info" %}
Qwen3.6の新しい [Preserved Thinking](#thinking-enable-disable--preserve-thinking).
{% endhint %}

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-MTP-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/Qwen3.6-27B-MTP-GGUF:UD-Q4_K_XL \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.00 \
    --spec-type draft-mtp --spec-draft-n-max 2
```

正確なコーディングタスクでは、次を変更してください: `temperature=0.6`

**非思考モード：**

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-MTP-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-27B-MTP-GGUF:UD-Q4_K_XL \
    --temp 0.7 \\
    --top-p 0.8 \
    --top-k 20 \
    --presence-penalty 1.5 \
    --min-p 0.00 \
    --spec-type draft-mtp --spec-draft-n-max 2 \
    --chat-template-kwargs '{"enable_thinking":false}'
```

#### MTP Qwen3.6-35B-A3B：

**思考モード:**

{% hint style="info" %}
Qwen3.6の新しい [Preserved Thinking](#thinking-enable-disable--preserve-thinking).
{% endhint %}

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-MTP-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/Qwen3.6-35B-A3B-MTP-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.00 \
    --spec-type draft-mtp --spec-draft-n-max 2
```

正確なコーディングタスクでは、次を変更してください: `temperature=0.6`

**非思考モード：**

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-MTP-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-35B-A3B-MTP-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \
    --top-k 20 \
    --presence-penalty 1.5 \
    --min-p 0.00 \
    --spec-type draft-mtp --spec-draft-n-max 2 \
    --chat-template-kwargs '{"enable_thinking":false}'
```

{% endstep %}

{% step %}
また、以下のコードで手動ダウンロードすることもできます（ `pip install huggingface_hub`）。Q4\_K\_Mや、次のような他の量子化版を選べます `UD-Q4_K_XL` 。少なくとも2ビットの動的量子化を使うことを推奨します `UD-Q2_K_XL` 。サイズと精度のバランスを取るためです。ダウンロードが止まる場合は、こちらを参照してください: [Hugging Face Hub、XET のデバッグ](/docs/jp/ji-chu/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/Qwen3.6-35B-A3B-MTP-GGUF \\
    --local-dir unsloth/Qwen3.6-35B-A3B-MTP-GGUF \\
    --include "*mmproj-F16*" \
    --include "*UD-Q4_K_XL*" # Dynamic 2bitの場合は "*UD-Q2_K_XL*" を使用
```

{% endstep %}

{% step %}
次に、会話モードでモデルを実行します:

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Qwen3.6-35B-A3B-MTP-GGUF/Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \\
    --mmproj unsloth/Qwen3.6-35B-A3B-MTP-GGUF/mmproj-F16.gguf \\
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.00 \
    --top-k 20 \
    --spec-type draft-mtp --spec-draft-n-max 2
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 🍎 MLX動的量子化版

MacOSデバイス向けに、Qwen3.6の動的4bitおよび8bit量子化版もアップロードしました！MLXの量子化アルゴリズムはまだ進化中であり、改善できる箇所は積極的に磨き込んでいます。

すべてのMLXモデルを次で実行できます： [Unsloth Studio](#unsloth-studio-guide)!

**Qwen3.6-27B MLX：**

| [3ビット](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-3bit) | [4ビット](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-4bit) | [MXFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-MXFP4) | [NVFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-NVFP4) | [6ビット](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-6bit) | [8ビット](https://huggingface.co/unsloth/Qwen3.6-27B-MLX-8bit) |
| -------------------------------------------------------------- | -------------------------------------------------------------- | ---------------------------------------------------------------- | ---------------------------------------------------------------- | -------------------------------------------------------------- | ----------------------------------------------------------- |

**Qwen3.6-35B-A3B MLX：**

| [3ビット](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-UD-MLX-3bit) | [4ビット](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-UD-MLX-4bit) | [8ビット](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MLX-8bit) |
| ------------------------------------------------------------------ | ------------------------------------------------------------------ | --------------------------------------------------------------- |

試すには次を使用してください：

{% code overflow="wrap" %}

```bash
curl -fsSL https://raw.githubusercontent.com/unslothai/unsloth/refs/heads/main/scripts/install_qwen3_6_mlx.sh | sh
source ~/.unsloth/unsloth_qwen3_6_mlx/bin/activate
python -m mlx_vlm.chat --model unsloth/Qwen3.6-27B-UD-MLX-4bit
```

{% endcode %}

Qwen3.6-27BのKLダイバージェンス（KLD）とパープレキシティ（PPL）のスコアは以下を参照してください（低いほど良い）：

| モデル                                                              | 平均KLD  | KLD中央値 | PPL   | KLDのP90 | KLDのP99.9 | サイズ     |
| ---------------------------------------------------------------- | ------ | ------ | ----- | ------- | --------- | ------- |
| [8ビット](https://huggingface.co/unsloth/Qwen3.6-27B-MLX-8bit)      | 0.0028 | 0.0003 | 4.812 | 0.0019  | 0.192     | 34.7 GB |
| [6ビット](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-6bit)   | 0.0037 | 0.0007 | 4.809 | 0.0032  | 0.343     | 30.5 GB |
| [4ビット](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-4bit)   | 0.0227 | 0.0053 | 4.821 | 0.0293  | 2.339     | 26.2 GB |
| [NVFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-NVFP4) | 0.0325 | 0.0087 | 4.843 | 0.0466  | 3.693     | 26.2 GB |
| [MXFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-MXFP4) | 0.0479 | 0.0153 | 4.902 | 0.0769  | 4.035     | 25.6 GB |
| [3ビット](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-3bit)   | 0.0734 | 0.0223 | 4.976 | 0.1261  | 5.529     | 24.1 GB |

### ⚡️NVFP4

**2026年7月10日：** 新しいものをリリースします [動的NVFP4 Qwen3.6量子化版](/docs/jp/ji-chu/dynamic-3.0-ggufs/nvfp4.md) が約〜で動作します**2.5倍高速** で、 **より高い性能** および同等のファイルサイズです。Qwen3.6-27B NVFP4 を実行すると **2.5倍高速** を **24GB VRAM** 、Qwen3.6-35B-A3B は **1.7倍高速** を **32GB VRAM**です。また **FP8 KV キャッシュのキャリブレーション** 2倍長いコンテキスト長に対応するためです！NVFP4 には RTX 50X、DGX Spark（参照 [#dgx-spark-with-nvfp4-quants](#dgx-spark-with-nvfp4-quants "mention")）、B200、B300 GPU でも利用できます。旧世代 GPU では、私たちの GGUF がうまく動作します！

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F8zM7cg0Xgo2pAlop1iPW%2F01_qwen36_combined_throughput.png?alt=media&amp;token=23131a96-4c41-42d7-aa16-5bfb21bb44a3" alt=""><figcaption></figcaption></figure>

すべてのベンチマークは1x B200、128同時実行で行っています。より高い同時実行数では35Bを17,561 tokens/sまで引き上げられます。35B-A3BのNVFP4版も2種類リリースします：

* [Qwen3.6-35B-A3B-NVFP4-Fast](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4-Fast) 完全な W4A4 量子化で、1.79倍高速
* [Qwen3.6-35B-A3B-NVFP4](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4) こちらは少し大きいですが、より高精度で 1.56倍高速です

精度ベンチマークでは、FP8、BF16、NVIDIA の NVFP4、そして私たちの NVFP4 に対して MMLU-Pro、AIME 2025、GPQA を実施しました。私たちの高速量子化は、すべての項目で同様の結果を示しています:

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFhOUUUlRBj3dafGnmvhK%2F03_qwen36_combined_accuracy(7).png?alt=media&amp;token=9178447f-d5ae-4489-9bdc-73b2b7b1631b" alt=""><figcaption></figcaption></figure>

<table><thead><tr><th width="372.5999755859375">Qwen3.6-35B-A3B</th><th>Qwen3.6-27B</th></tr></thead><tbody><tr><td><a href="https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4">Qwen3.6-35B-A3B-NVFP4</a> （1.56倍高速）</td><td><a href="https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4">Qwen3.6-27B-NVFP4</a> （2.5倍高速）</td></tr><tr><td><a href="https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4-Fast">Qwen3.6-35B-A3B-NVFP4-Fast</a> （1.79倍高速）</td><td></td></tr></tbody></table>

**MTP テンソルも追加の高速化のために、量子化に直接組み込まれています。** 精度向上は、Qwen3.6 のチャットテンプレートとデータセットキャリブレーションの改善によるものです。コード生成とツール呼び出しの一貫性を向上させ、ループやその他報告されている問題を減らすために、以前のチャットテンプレート更新を活用しています。私たちのキャリブレーションでは、UltraChat と並んで、コード生成、ツール呼び出し、チャット向けに最適化したデータセットを組み合わせて使用しています。

デコード速度（1人あたりのトークン数）では、27B で 1.03倍高速、35B で 1.17倍および 1.22倍高速です。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FR3X2O3iOBhjMS1ekX7zO%2F03_qwen36_combined_decode.png?alt=media&amp;token=a8b34056-7178-4e0d-851b-9467fa0ba2f6" alt=""><figcaption></figcaption></figure>

### NVFP4 ベンチマーク

NVFP4 は 4-bit 重みと行列積を Blackwell Tensor Core 上で直接実行します。私たちの Qwen3.6 NVFP4 量子化は W4A4 を使用するため、実際に FP4 Tensor Core を使っており、W4A16 を使う NVIDIA のものよりデコードが高速です。精度維持のために層を動的に量子化しており、FP8 と BF16 との比較を含むすべての量子化に対して MMLU-Pro、AIME 2025、GPQA を実施しました。

**Qwen3.6-27B NVFP4 精度ベンチマーク**

| 提供元     | MMLU-Pro |  GPQA | AIME 2025 |
| ------- | -------: | ----: | --------: |
| Unsloth |    86.25 | 86.34 |     93.12 |
| NVIDIA  |    85.96 | 86.87 |     93.12 |
| FP8     |    86.11 | 86.87 |     93.75 |
| BF16    |    85.96 | 88.13 |     93.33 |

**Qwen3.6-35B-A3B NVFP4 精度ベンチマーク**

| 提供元              | MMLU-Pro |  GPQA | AIME 2025 |
| ---------------- | -------: | ----: | --------: |
| Unsloth          |    85.85 | 86.74 |     92.29 |
| **Unsloth Fast** |    85.58 | 87.75 |     91.67 |
| NVIDIA           |    85.60 | 87.12 |     91.88 |
| FP8              |    85.75 | 86.74 |     93.12 |
| BF16             |    85.75 | 86.36 |     92.50 |

すべてのベンチマークの出力長も確認しましたが、互いに同等でした。したがって、新しい NVFP4 量子化は、量子化の目的を損なうほど長く考えることはありません！（つまり 2倍速いが 2倍長く考えるなら、意味がありません）

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FjG1C3y6GVWvnorRfmnIF%2Fqwen36_combined_output_length_reordered_estimated_no_footnote.png?alt=media&amp;token=2aa2d784-c082-476e-895a-4bea77385956" alt=""><figcaption></figcaption></figure>

### Marlin vs Flashinfer vs cutlass vs cute-DSL

Marlin カーネルは W4A4 をうまくサポートしていないことも判明しました。これを有効にすると 2.5倍の性能低下を引き起こします。そのため CUTLASS、Flashinfer-TRTLLM、または Cute-DSL（vLLM で自動有効化）を使用してください！また、DGX Spark をお持ちの場合は、こちらを参照してください [#dgx-spark-serving](#dgx-spark-serving "mention") を使用する必要があります `--moe-backend flashinfer_b12x` さもないと推論速度が 2.5倍遅くなります。

**そのためバックエンドは設定しないでください。vLLM が自動的に最適なものを選択します。**

| モデル             | 方式    | バックエンド              | デコード tok/s | スループット tok/s |
| --------------- | ----- | ------------------- | ---------- | ------------ |
| nvidia 27B      | W4A16 | marlin (auto)       | 115.6      | 2,403        |
| unsloth 27B     | W4A4  | marlin              | 105.6      | 2,127        |
| unsloth 27B     | W4A4  | cutlass             | 113.5      | 6,681        |
| unsloth 27B     | W4A4  | flashinfer\_trtllm  | 112.6      | 6,158        |
| unsloth 27B     | W4A4  | **cute-DSL (auto)** | 125.9      | **6,863**    |
| nvidia 35B-A3B  | W4A4  | marlin (auto)       | 240.8      | 8,721        |
| unsloth 35B-A3B | W4A4  | marlin              | 215.8      | 8,619        |
| unsloth 35B-A3B | W4A4  | cutlass             | 158.3      | 11,017       |
| unsloth 35B-A3B | W4A4  | **cute-DSL (auto)** | 295.2      | **15,636**   |

#### **vLLM:**

NVFP4 量子化を実行するには、以下で Qwen3.6-27B を実行するコマンドを参照してください [vLLM](/docs/jp/ji-chu/inference-and-deployment/vllm-guide.md) と [SGLang](/docs/jp/ji-chu/inference-and-deployment/sglang-guide.md) （モデル名は `Qwen3.6-35-A3B-NVFP4`）。また、MoEバックエンドは選択しないでください。vLLMに選ばせてください。たとえばMarlinは2.5倍遅くなります！参照： [#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl](#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl "mention")DGX Spark をお持ちの場合は、こちらを参照してください [#dgx-spark-serving](#dgx-spark-serving "mention") を使用する必要があります `--moe-backend flashinfer_b12x` さもないと推論速度が大幅に低下します。

別の venv に vLLM をインストールするには:

{% code overflow="wrap" expandable="true" %}

```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \\
    --torch-backend=auto
```

{% endcode %}

では、35B Fast バリアントを提供するには:

```shell
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
```

変更 `unsloth/Qwen3.6-35B-A3B-NVFP4-Fast` を NVFP4 量子化名に追加してください！

MTP / speculative decoding（より高速なデコードですが、スループットはやや低下します）を有効にするには、次を使用します:

```bash
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
    --speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
```

Torchcodec の問題が発生した場合は、以下を実行してから vllm を再起動してください。

{% code overflow="wrap" expandable="true" %}

```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```

{% endcode %}

### **NVFP4量子化版を使ったDGX Spark**

DGX Spark に正しいカーネルがあることを確認するには（そうしないと **2倍遅い推論**となります）、まず確認してください:

{% code overflow="wrap" expandable="true" %}

```bash
python -c "
import torch; from vllm.utils.flashinfer import has_flashinfer_b12x_gemm as g, has_flashinfer_b12x_moe as m
cap = torch.cuda.get_device_capability(); print('cap', cap, '| b12x gemm', g(), '| b12x moe', m()); assert cap[0] == 12 and g() and m(), 'b12x unavailable: serving would degrade to marlin W4A16'"
```

{% endcode %}

これはエラーにならないはずです。もしエラーになる場合は、vllm を更新するか、次で再インストールしてください:

{% code overflow="wrap" expandable="true" %}

```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \\
    --torch-backend=auto
```

{% endcode %}

では、DGX Spark で vLLM を使って提供するには:

{% code overflow="wrap" expandable="true" %}

```shellscript
export CUTE_DSL_ARCH=sm_121a
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast --moe-backend flashinfer_b12x
```

{% endcode %}

Torchcodec の問題が発生した場合は、以下を実行してから vllm を再起動してください。

{% code overflow="wrap" expandable="true" %}

```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```

{% endcode %}

#### **SGLang:**

```bash
python -m sglang.launch_server --model-path unsloth/Qwen3.6-27B-NVFP4 --speculative-algorithm NEXTN \\
     --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
```

### 🦙 Llama.cpp ガイド

このガイドではDynamic 4-bitを使用します。これは24GB RAM / Macデバイスで、次の環境での高速推論に非常によく機能します [llama.cpp](https://llama.cpphttps/github.com/ggml-org/llama.cpp)。モデルはF16の完全精度でも約72GBしかないため、性能についてあまり心配する必要はありません。 [GGUFコレクションをご覧ください](https://huggingface.co/collections/unsloth/qwen36).

<a href="#qwen3.6-27b" class="button primary">27B</a><a href="#qwen3.6-35b-a3b" class="button primary">35-A3B</a>

{% stepper %}
{% step %}
最新のものを入手 `llama.cpp` **を** [**GitHubからこちらで取得**](https://github.com/ggml-org/llama.cpp)。以下のビルド手順に従うこともできます。 `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` に変更してください。GPUがない場合、またはCPU推論だけを使いたい場合です。 **Apple Mac / Metalデバイスの場合**、 `-DGGML_CUDA=OFF` を設定し、そのまま通常どおり続行してください。Metalサポートはデフォルトで有効です。

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
を直接使ってモデルを読み込みたい場合は、 `llama.cpp` モデルを直接読み込むには、以下を実行できます: (:`Q4_K_XL`)は量子化タイプです。Hugging Face経由でもダウンロードできます（3番）。これは次に似ています `ollama run` に似ています。 `export LLAMA_CACHE="folder"` を使うと `llama.cpp` 特定の場所に保存するためです。このモデルの最大コンテキスト長は256Kです。

各モデルについて、以下のコマンドのいずれかに従ってください:

<a href="#qwen3.6-27b" class="button primary">27B</a><a href="#qwen3.6-35b-a3b" class="button primary">35-A3B</a>

#### Qwen3.6-27B：

**思考モード:**

{% hint style="info" %}
Qwen3.6の新しい [Preserved Thinking](#thinking-enable-disable--preserve-thinking).
{% endhint %}

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/Qwen3.6-27B-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.00
```

正確なコーディングタスクでは、次を変更してください: `temperature=0.6`

**非思考モード：**

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-27B-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \
    --top-k 20 \
    --presence-penalty 1.5 \
    --min-p 0.00 \
    --chat-template-kwargs '{"enable_thinking":false}'
```

#### Qwen3.6-35B-A3B：

**思考モード:**

{% hint style="info" %}
Qwen3.6の新しい [Preserved Thinking](#thinking-enable-disable--preserve-thinking).
{% endhint %}

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.00
```

正確なコーディングタスクでは、次を変更してください: `temperature=0.6`

**非思考モード：**

一般タスク：

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \
    --top-k 20 \
    --presence-penalty 1.5 \
    --min-p 0.00 \
    --chat-template-kwargs '{"enable_thinking":false}'
```

{% endstep %}

{% step %}
また、以下のコードで手動ダウンロードすることもできます（ `pip install huggingface_hub`）。Q4\_K\_Mや、次のような他の量子化版を選べます `UD-Q4_K_XL` 。少なくとも2ビットの動的量子化を使うことを推奨します `UD-Q2_K_XL` 。サイズと精度のバランスを取るためです。ダウンロードが止まる場合は、こちらを参照してください: [Hugging Face Hub、XET のデバッグ](/docs/jp/ji-chu/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/Qwen3.6-35B-A3B-GGUF \\
    --local-dir unsloth/Qwen3.6-35B-A3B-GGUF \\
    --include "*mmproj-F16*" \
    --include "*UD-Q4_K_XL*" # Dynamic 2bitの場合は "*UD-Q2_K_XL*" を使用
```

{% endstep %}

{% step %}
次に、会話モードでモデルを実行します:

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Qwen3.6-35B-A3B-GGUF/Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \\
    --mmproj unsloth/Qwen3.6-35B-A3B-GGUF/mmproj-F16.gguf \\
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.00 \
    --top-k 20
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 💡 思考：有効化/無効化 + 思考の保持

Qwen3.6には以下もあります： **思考の保持** これは前回の会話の思考の痕跡を残します。使用トークン数は増えますが、会話を継続する際の精度が向上する可能性があります。Unsloth Studioには、Qwen3.6向けに『Think』と『Preserved Thinking』のトグルがあります：

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKoonE97b0H3RioMwVohd%2Fstudio%20new%20ui.gif?alt=media&amp;token=e37f2839-914e-48b8-8c81-2dac3ade9408" alt="" width="563"><figcaption><p>Unsloth StudioにはデフォルトでThinkトグルがあり、新たに <a href="#preserved-thinking">Preserved Thinking</a> トグル</p></figcaption></figure></div>

有効にするには **思考を保持** llama.cppでは（'true'または'false'に変更して） '`preserve_thinking`' の代わりに '`enable_thinking`' または '`disable_thinking`'.

{% code expandable="true" %}

```bash
--chat-template-kwargs '{"preserve_thinking":true}'
```

{% endcode %}

通常の思考では、下記のコマンドに従って llama.cpp で思考を有効/無効にできます。次の '`true`』と『`false`』を同じ意味で使えます。

<table data-full-width="false"><thead><tr><th width="197.76666259765625">llama-serverのOS：</th><th>思考を有効にする</th><th>思考を無効にする</th></tr></thead><tbody><tr><td>Linux、MacOS、WSL：</td><td><pre data-overflow="wrap"><code>--chat-template-kwargs '{"enable_thinking":true}'
</code></pre></td><td><pre data-overflow="wrap"><code>--chat-template-kwargs '{"enable_thinking":false}'
</code></pre></td></tr><tr><td>Windows / PowerShell：</td><td><pre data-overflow="wrap"><code>--chat-template-kwargs "{\"enable_thinking\":true}"
</code></pre></td><td><pre data-overflow="wrap"><code>--chat-template-kwargs "{\"enable_thinking\":false}"
</code></pre></td></tr></tbody></table>

例として、Qwen3.6-35B-A3Bで思考の保持を有効にするには（デフォルトでは有効です）：

```bash
./llama.cpp/llama-server \\
    --model unsloth/Qwen3.6-35B-A3B-GGUF/Qwen3.6-35B-A3B-BF16.gguf \\
    --alias "unsloth/Qwen3.6-35B-A3B-GGUF" \\
    --temp 0.6 \\
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.00 \
    --port 8001 \
    --chat-template-kwargs '{"preserve_thinking":true}'
```

そしてPythonでは：

```python
from openai import OpenAI
import json
openai_client = OpenAI(
    base_url = "http://127.0.0.1:8001/v1",
    api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
    model = "unsloth/Qwen3.6-35B-A3B-GGUF",
    messages = [{"role": "user", "content": "2+2 は何ですか？"},],
)
print(completion.choices[0].message.content)
print(completion.choices[0].message.reasoning_content)
```

### 👨‍💻 OpenAI Codex & Claude Code <a href="#claude-codex" id="claude-codex"></a>

ローカルのコーディングエージェントワークロード経由でモデルを実行するには、 [ガイドに従ってください](#claude-codex)。次を使用してください： `llama-server` 今設定したものを使い、モデル名を、それが次で報告する正確なIDに設定してください： `GET /v1/models` (その `--alias` 上の値、たとえば： `unsloth/Qwen3.6-35B-A3B-GGUF`）。正しいQwen3.6のパラメータと使用手順に従ってください。

{% columns %}
{% column %}
{% content-ref url="/pages/ee610b22aa43d29d8415fd27eb7de15ba88f7385" %}
[Claude Code](/docs/jp/ji-chu/api/claude-code.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
{% content-ref url="/pages/c87896ff7159620f4c01bb39fe9df1fd1a55274e" %}
[OpenAI Codex](/docs/jp/ji-chu/api/codex.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

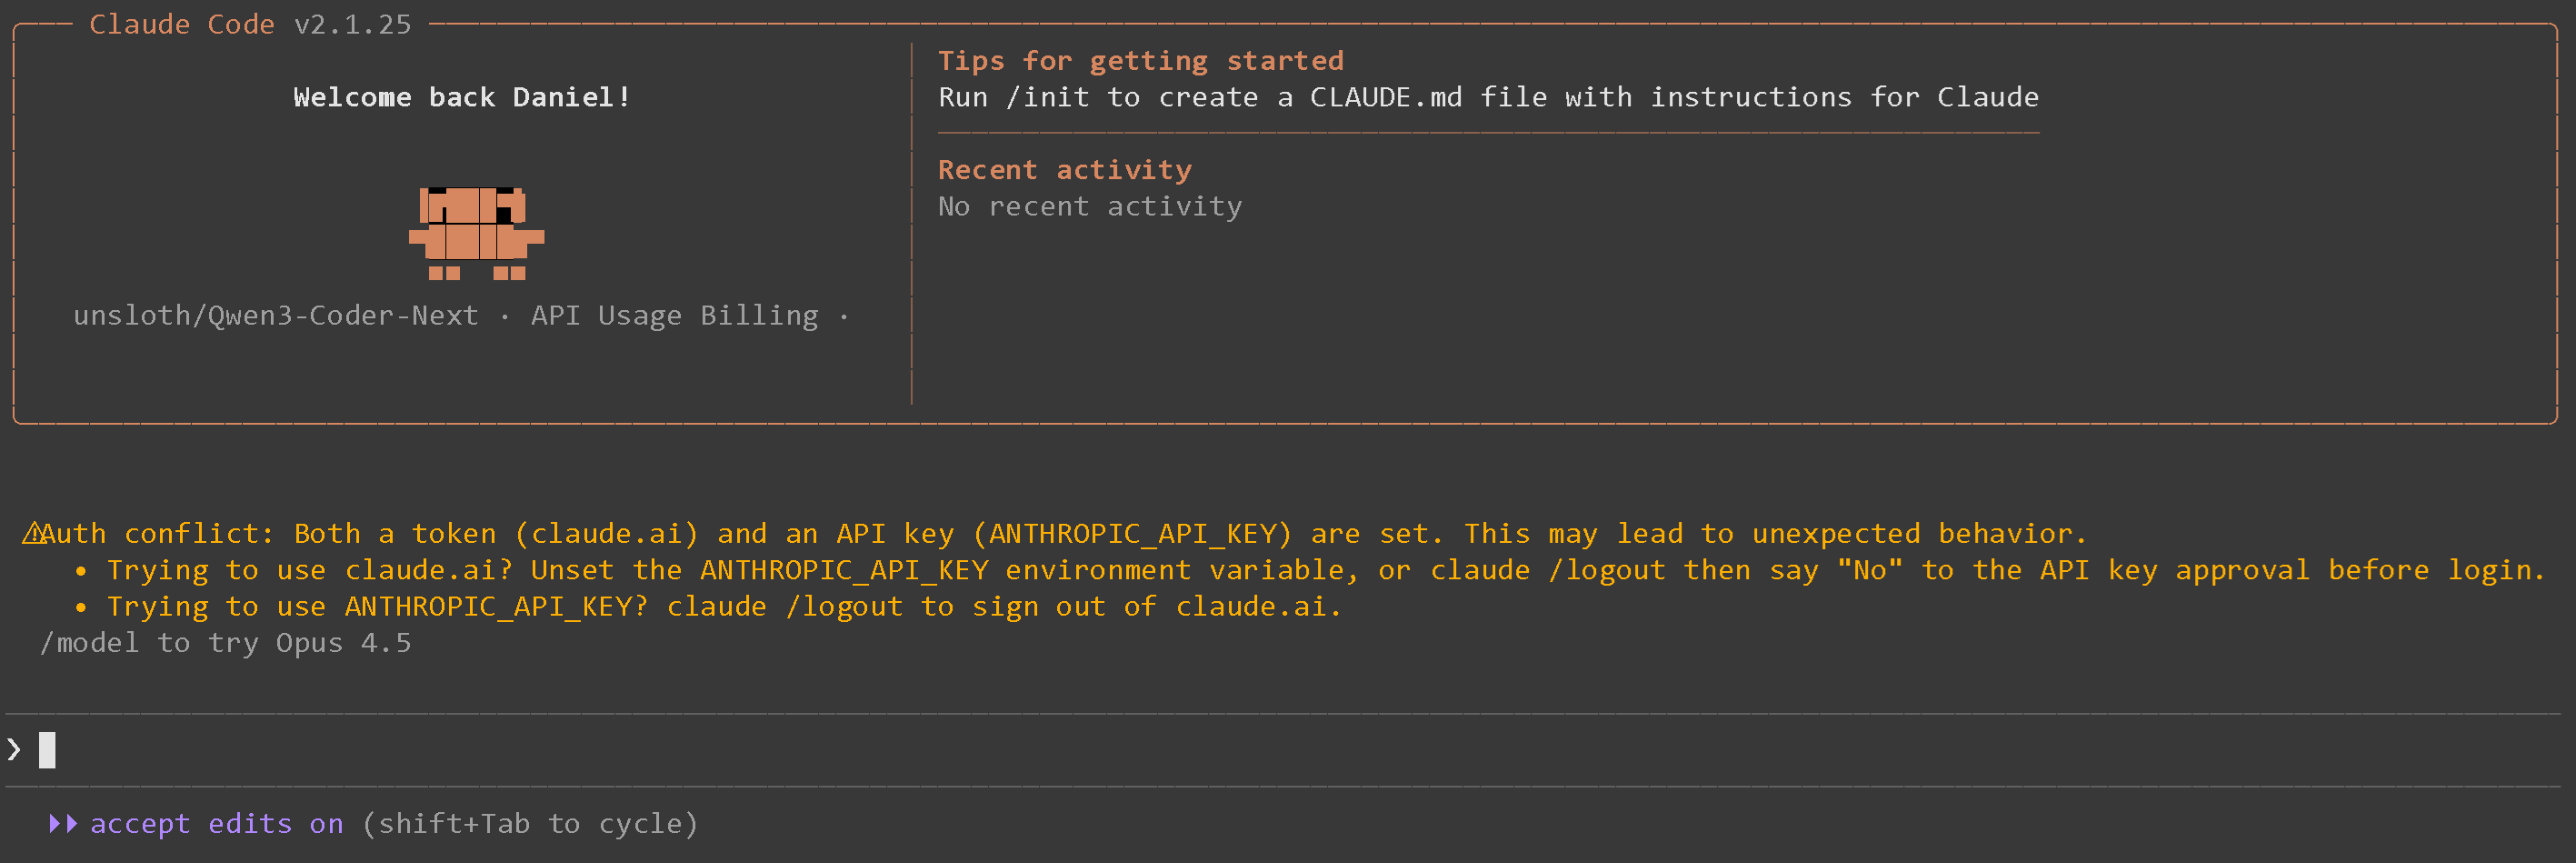
たとえばClaude Codeの手順に従うと、次のようになります：

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fup2DMSMPjNR8BM9pgR0v%2Fimage.png?alt=media&amp;token=152e9ee0-2491-4379-af18-8fca0789b19d" alt="" width="563"><figcaption></figcaption></figure></div>

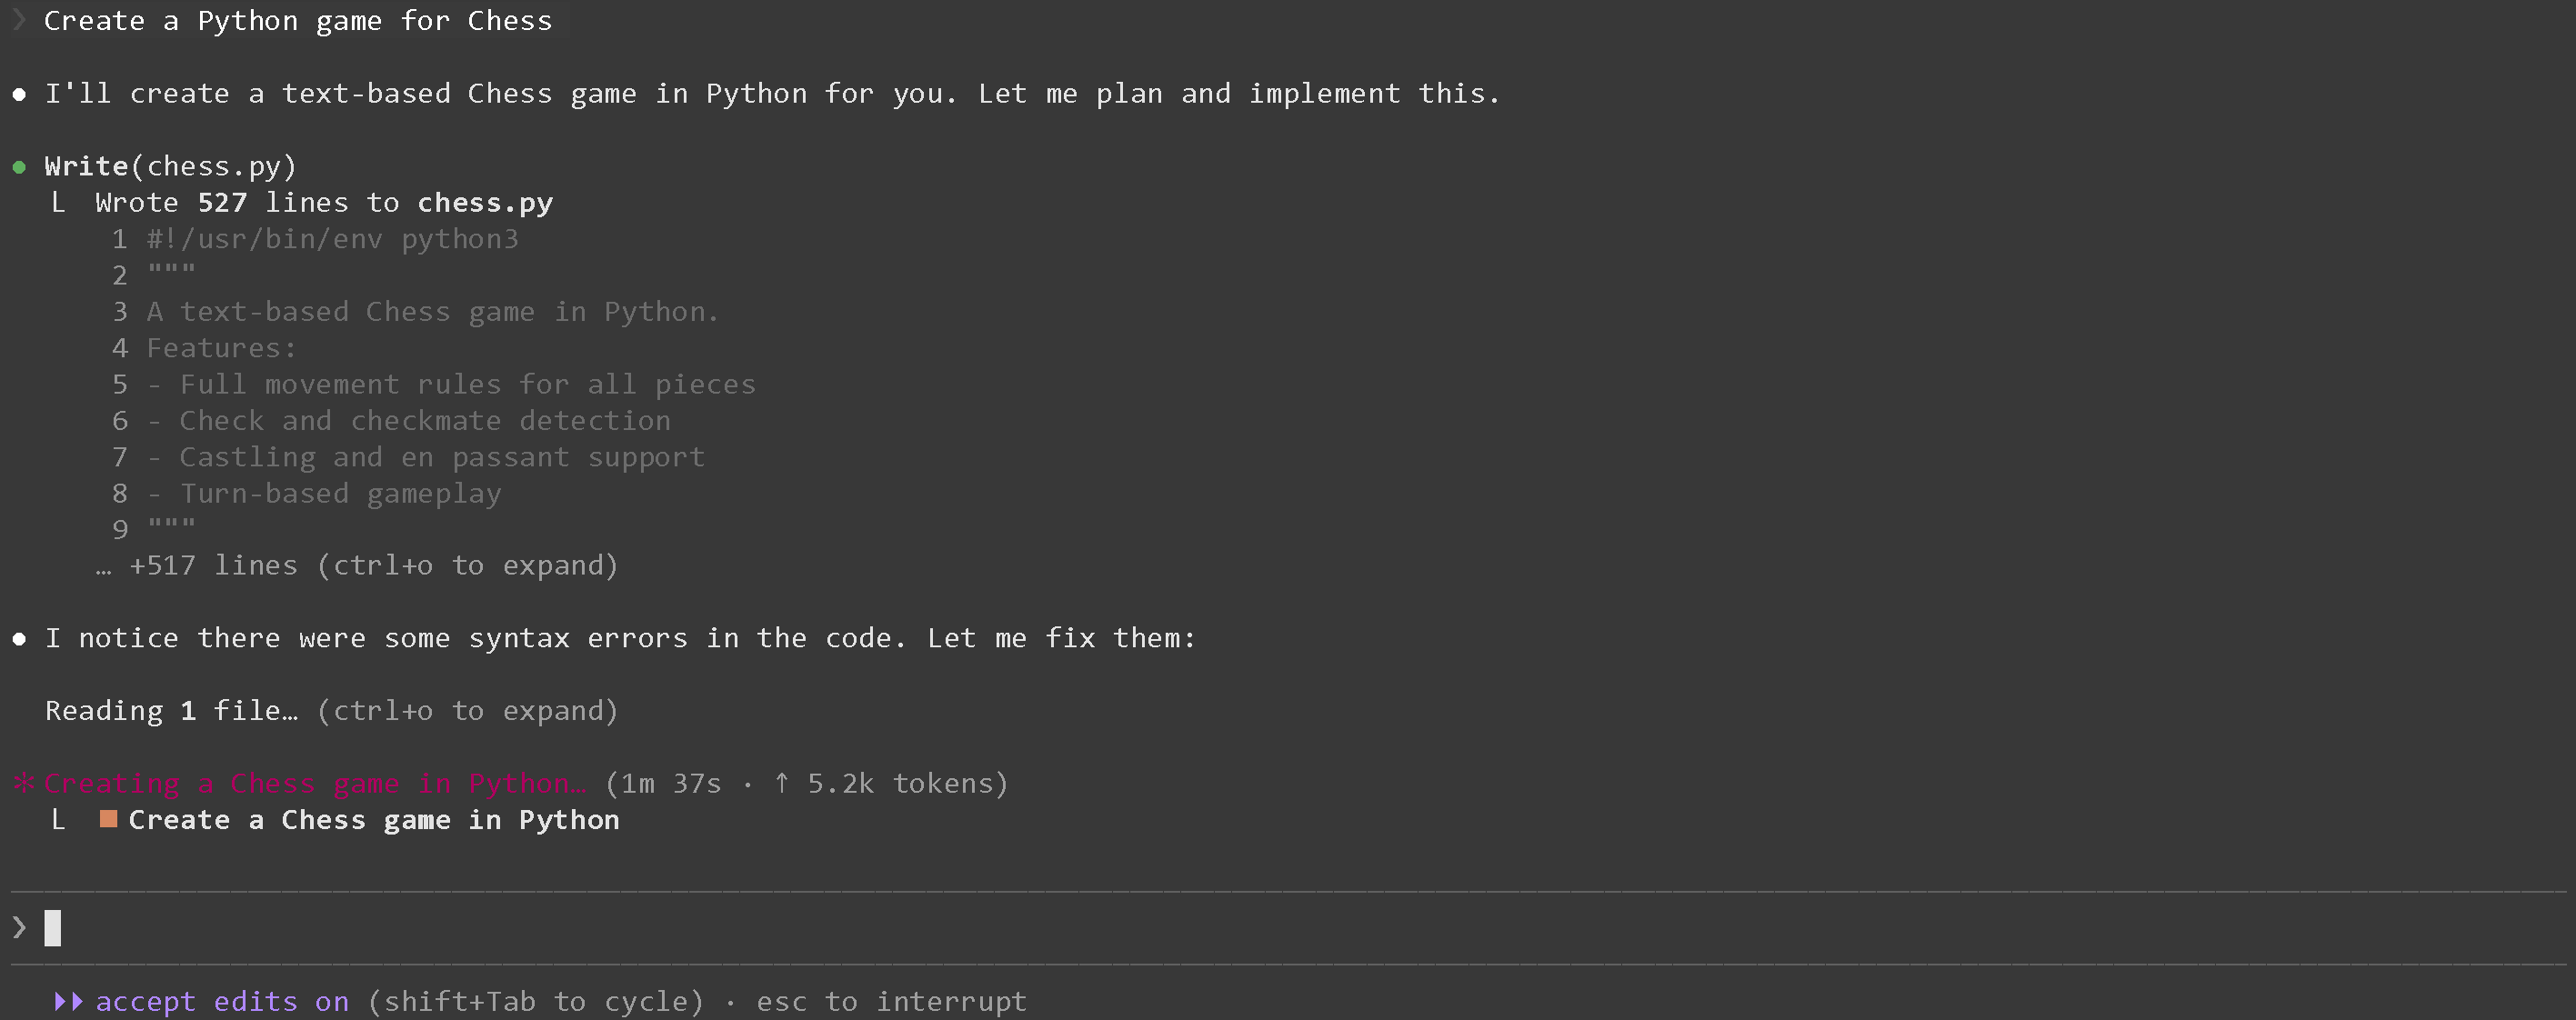
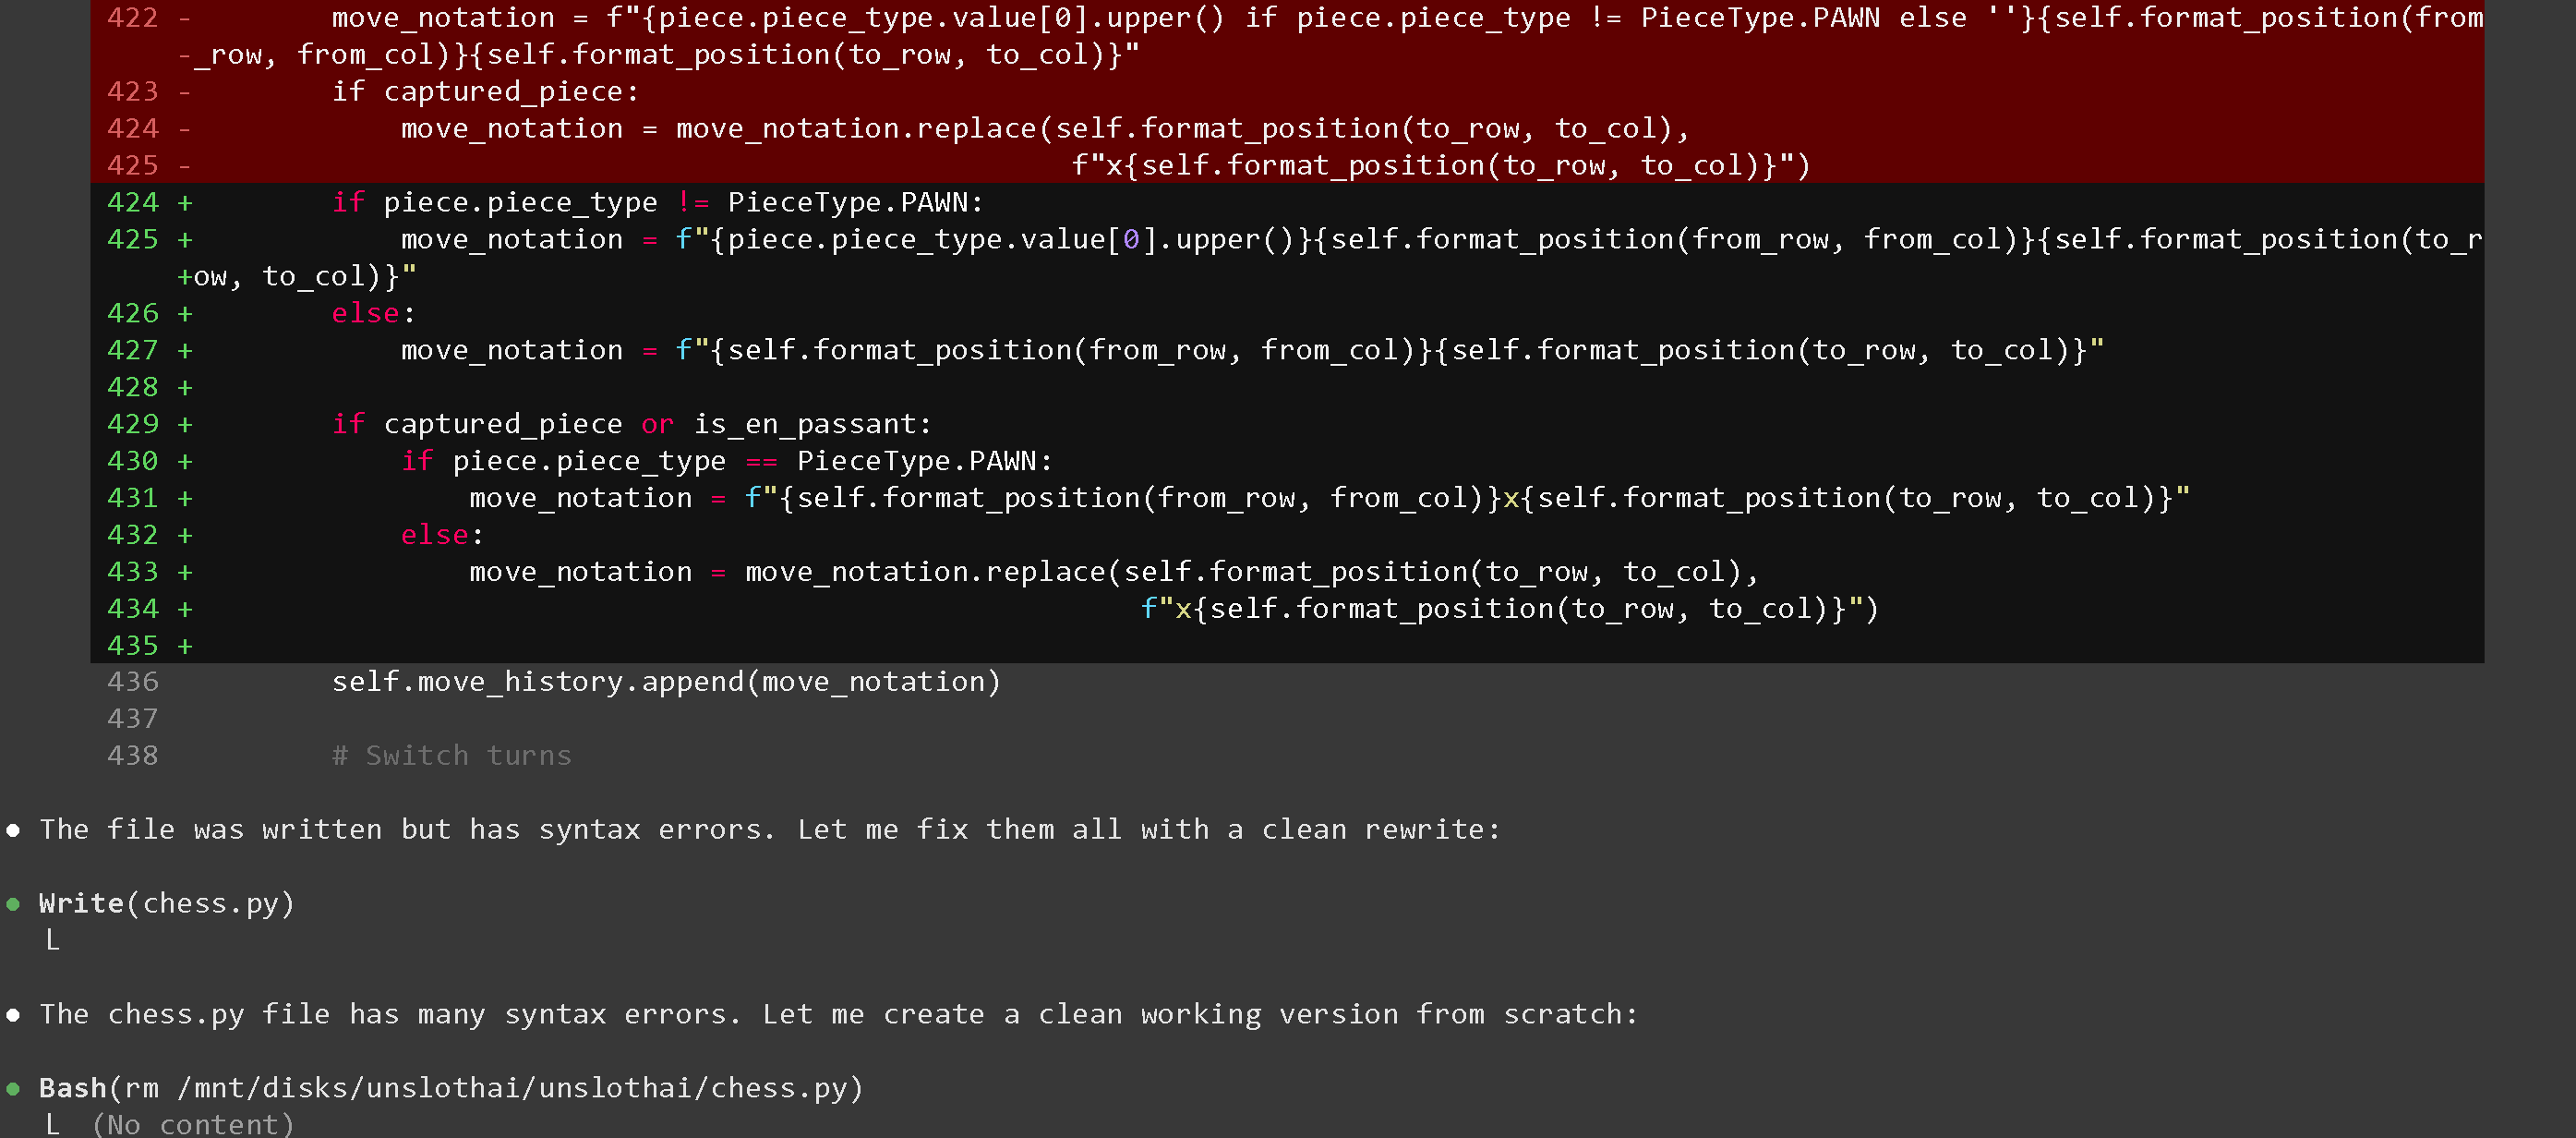
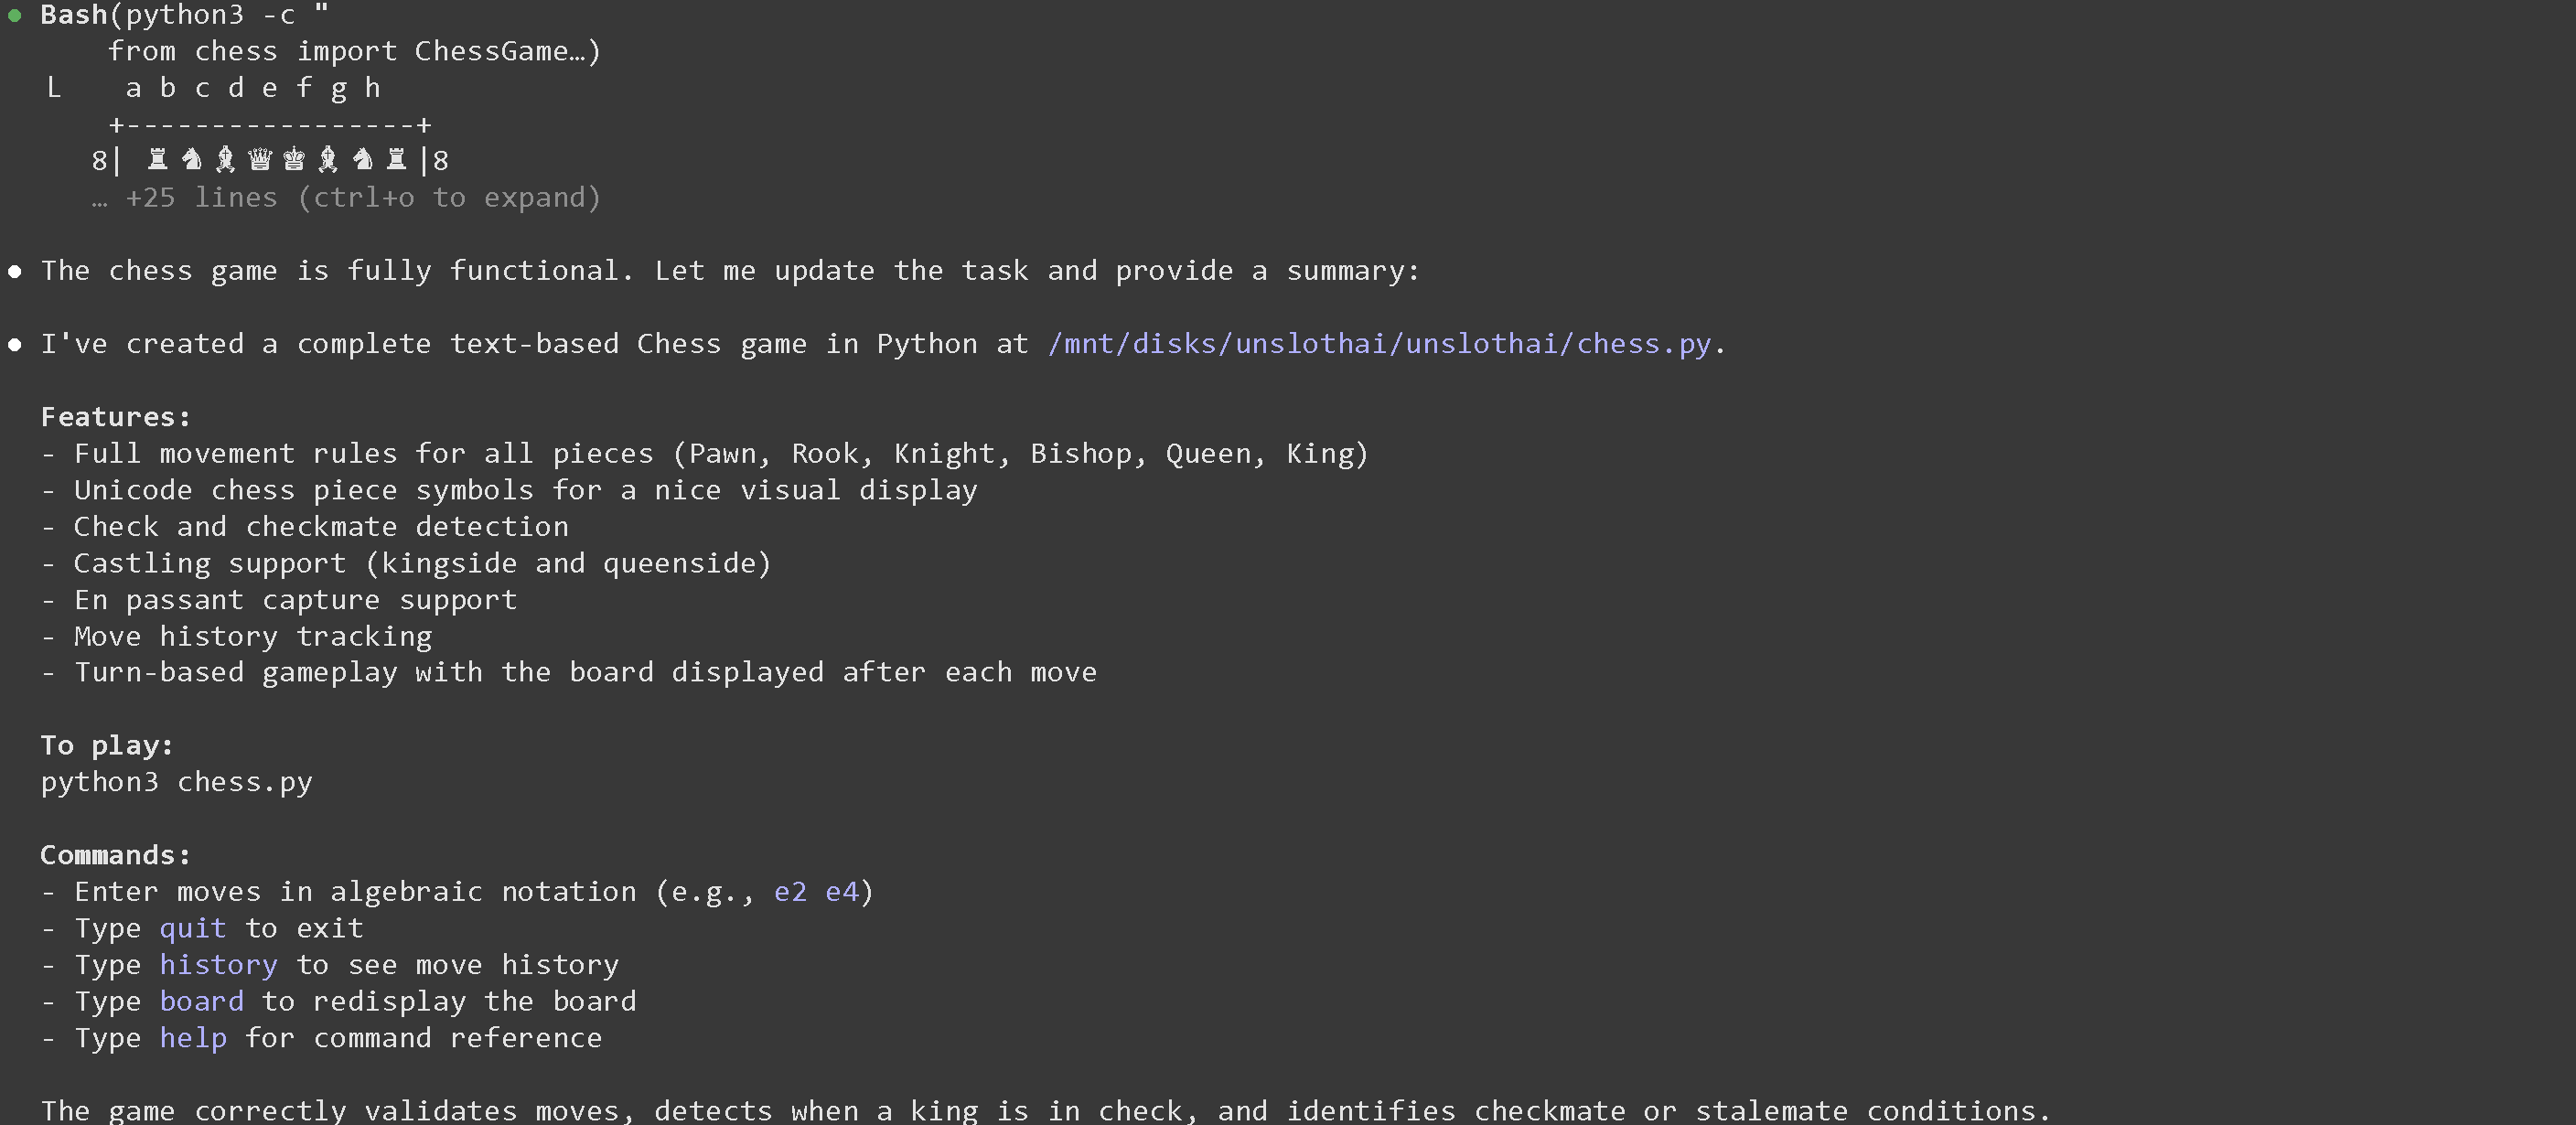
その後、次のように頼めます： `チェスのPythonゲームを作成して` :

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F9TfMAoKSdMpb8OHKNnHH%2Fimage.png?alt=media&amp;token=771df3aa-91ab-4c1e-8676-1830058001ca" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWP3lI5mQW2EHB79qqgDz%2Fimage.png?alt=media&amp;token=55cf3189-e100-419c-a615-024b45948284" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fn8DZddDODQZGCP8giKYY%2Fimage.png?alt=media&amp;token=996c8cb9-d199-4045-90f0-408690e02667" alt="" width="563"><figcaption></figcaption></figure></div>

## 📊 ベンチマーク

### Unsloth GGUF ベンチマーク

各プロバイダにわたるQwen3.6-35-A3B GGUFの平均KLダイバージェンスベンチマークを実施し、最適な量子化版を選べるようにしました。

* KLダイバージェンスにより、ほぼすべてのUnsloth GGUFがSOTAのパレートフロンティア上に位置します
* KLDは、量子化モデルが元のBF16出力分布にどれだけ一致しているかを示し、保持された精度を示します。
* これにより、Unslothは22サイズ中21で最高性能となります
* Dynamicレイヤーをより多くするために更新されたのはQ6\_Kのみで、私たちは新しい `UD-IQ4_NL_XL` 量子化版

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHq98A18pHA2ePwlInrFG%2Fqwen36_mean_q6k_corrected_arrow_pareto_fixed.png?alt=media&amp;token=a5190c8a-4d04-4d4d-be94-dd15214e6687" alt=""><figcaption><p>35B-A3B - KLDベンチマーク（低いほど良い）</p></figcaption></figure></div>

### MTPベンチマーク

27Bと35B MoE向けに作成した新しい量子化版をベンチマークしました。一般に、DenseモデルはMTPで大幅に高速化され（1.4〜2倍）、MoEモデルはそれより控えめです（1.15〜1.25倍）。

これにより、Qwen3.6 27BはUD-Q2\_K\_XLで生成140 tokens/s、Qwen3.6 35B-A3Bは生成220 tokens/sを実現できます！スループット数値にはノイズがあるものもあるため、ある量子化版が他より遅いと単純に判断しないでください。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7TXuBDYfDH3BlQEoSkNf%2FQwen36_mtp_spec_throughput_side_by_side.png?alt=media&amp;token=655a6e99-de95-4aa3-9371-abf05ccd7e3e" alt=""><figcaption></figcaption></figure>

平均的な高速化では、draft tokens = 2のDenseモデルで1.4倍、MoEではおよそ1.15〜1.2倍が見られます。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7arbIuA74e9Tbv7ISRcJ%2FQwen36_mtp_spec_speedup_side_by_side_black_solid_average.png?alt=media&amp;token=92bd8705-3842-4aef-90e7-0e61b9d50fba" alt=""><figcaption></figcaption></figure>

draft tokensを2より増やすことは推奨しません。4個にすると受理率が83%から50%へ急落し、MTPの順伝播のメリットが小さくなるためです。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F0n6KhVbrWqhwBbSUj0JJ%2Foutput(34).png?alt=media&amp;token=aa6adf45-f3d6-4541-bab0-8f9697c0e66c" alt=""><figcaption></figcaption></figure>

### 公式Qwenベンチマーク

#### Qwen3.6-27B

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FlvrSCq6GKFGADGSOTE9W%2Fqwen3.6_27b_score.png?alt=media&amp;token=6f1abf24-6a15-4988-a305-acd5638aaf0d" alt=""><figcaption></figcaption></figure></div>

#### Qwen3.6-35B-A3B

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F25aKI2tJR2PNfGfwnbZi%2Fqwen3.6_35b_a3b_score(2).png?alt=media&amp;token=f296d01d-311d-413e-8c62-122728e33008" alt=""><figcaption></figcaption></figure></div>

これらの結果により、トレードオフは明快です。メモリと品質のバランスを最適にするにはDynamic GGUFを使い、より高速な生成が欲しいときはMTPを使い、最大スループットにはBlackwell GPU上でNVFP4を使ってください。最も簡単な方法を望むなら、モデルを次で実行し [Unsloth Studio](#unsloth-studio-guide) 推奨デフォルトをそのまま使ってください。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/moderu/tutorials/qwen3.6.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.