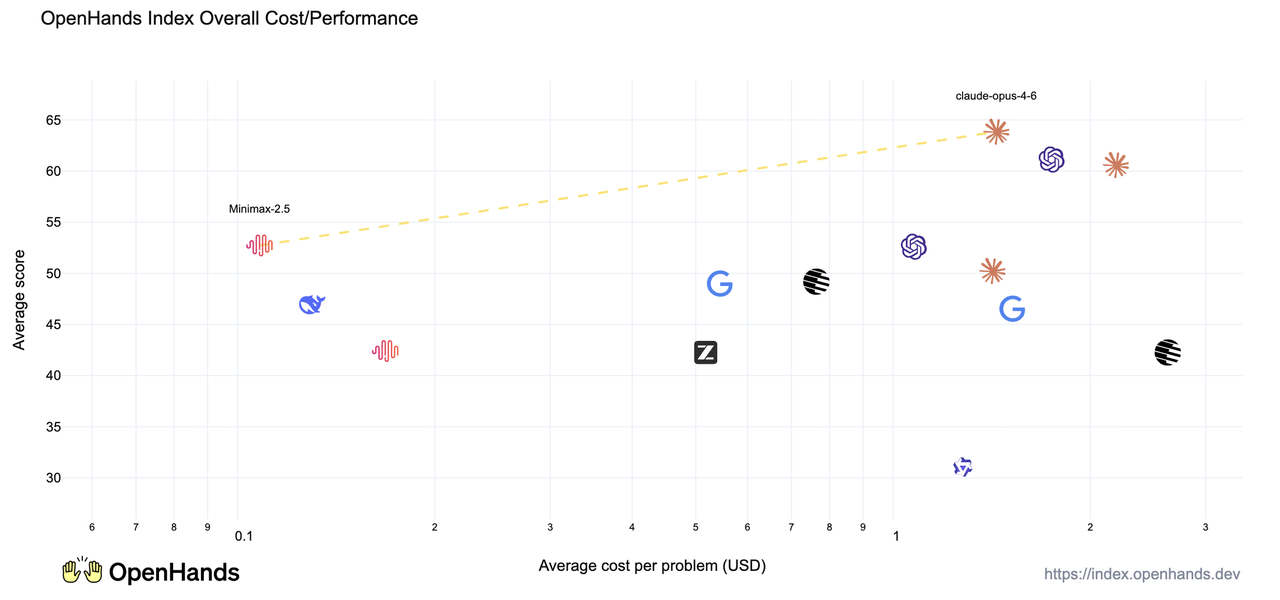
> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/tutorials/minimax-m25.md).
# MiniMax-M2.5: 実行ガイド
MiniMax-M2.5を自分のデバイスでローカル実行しましょう!
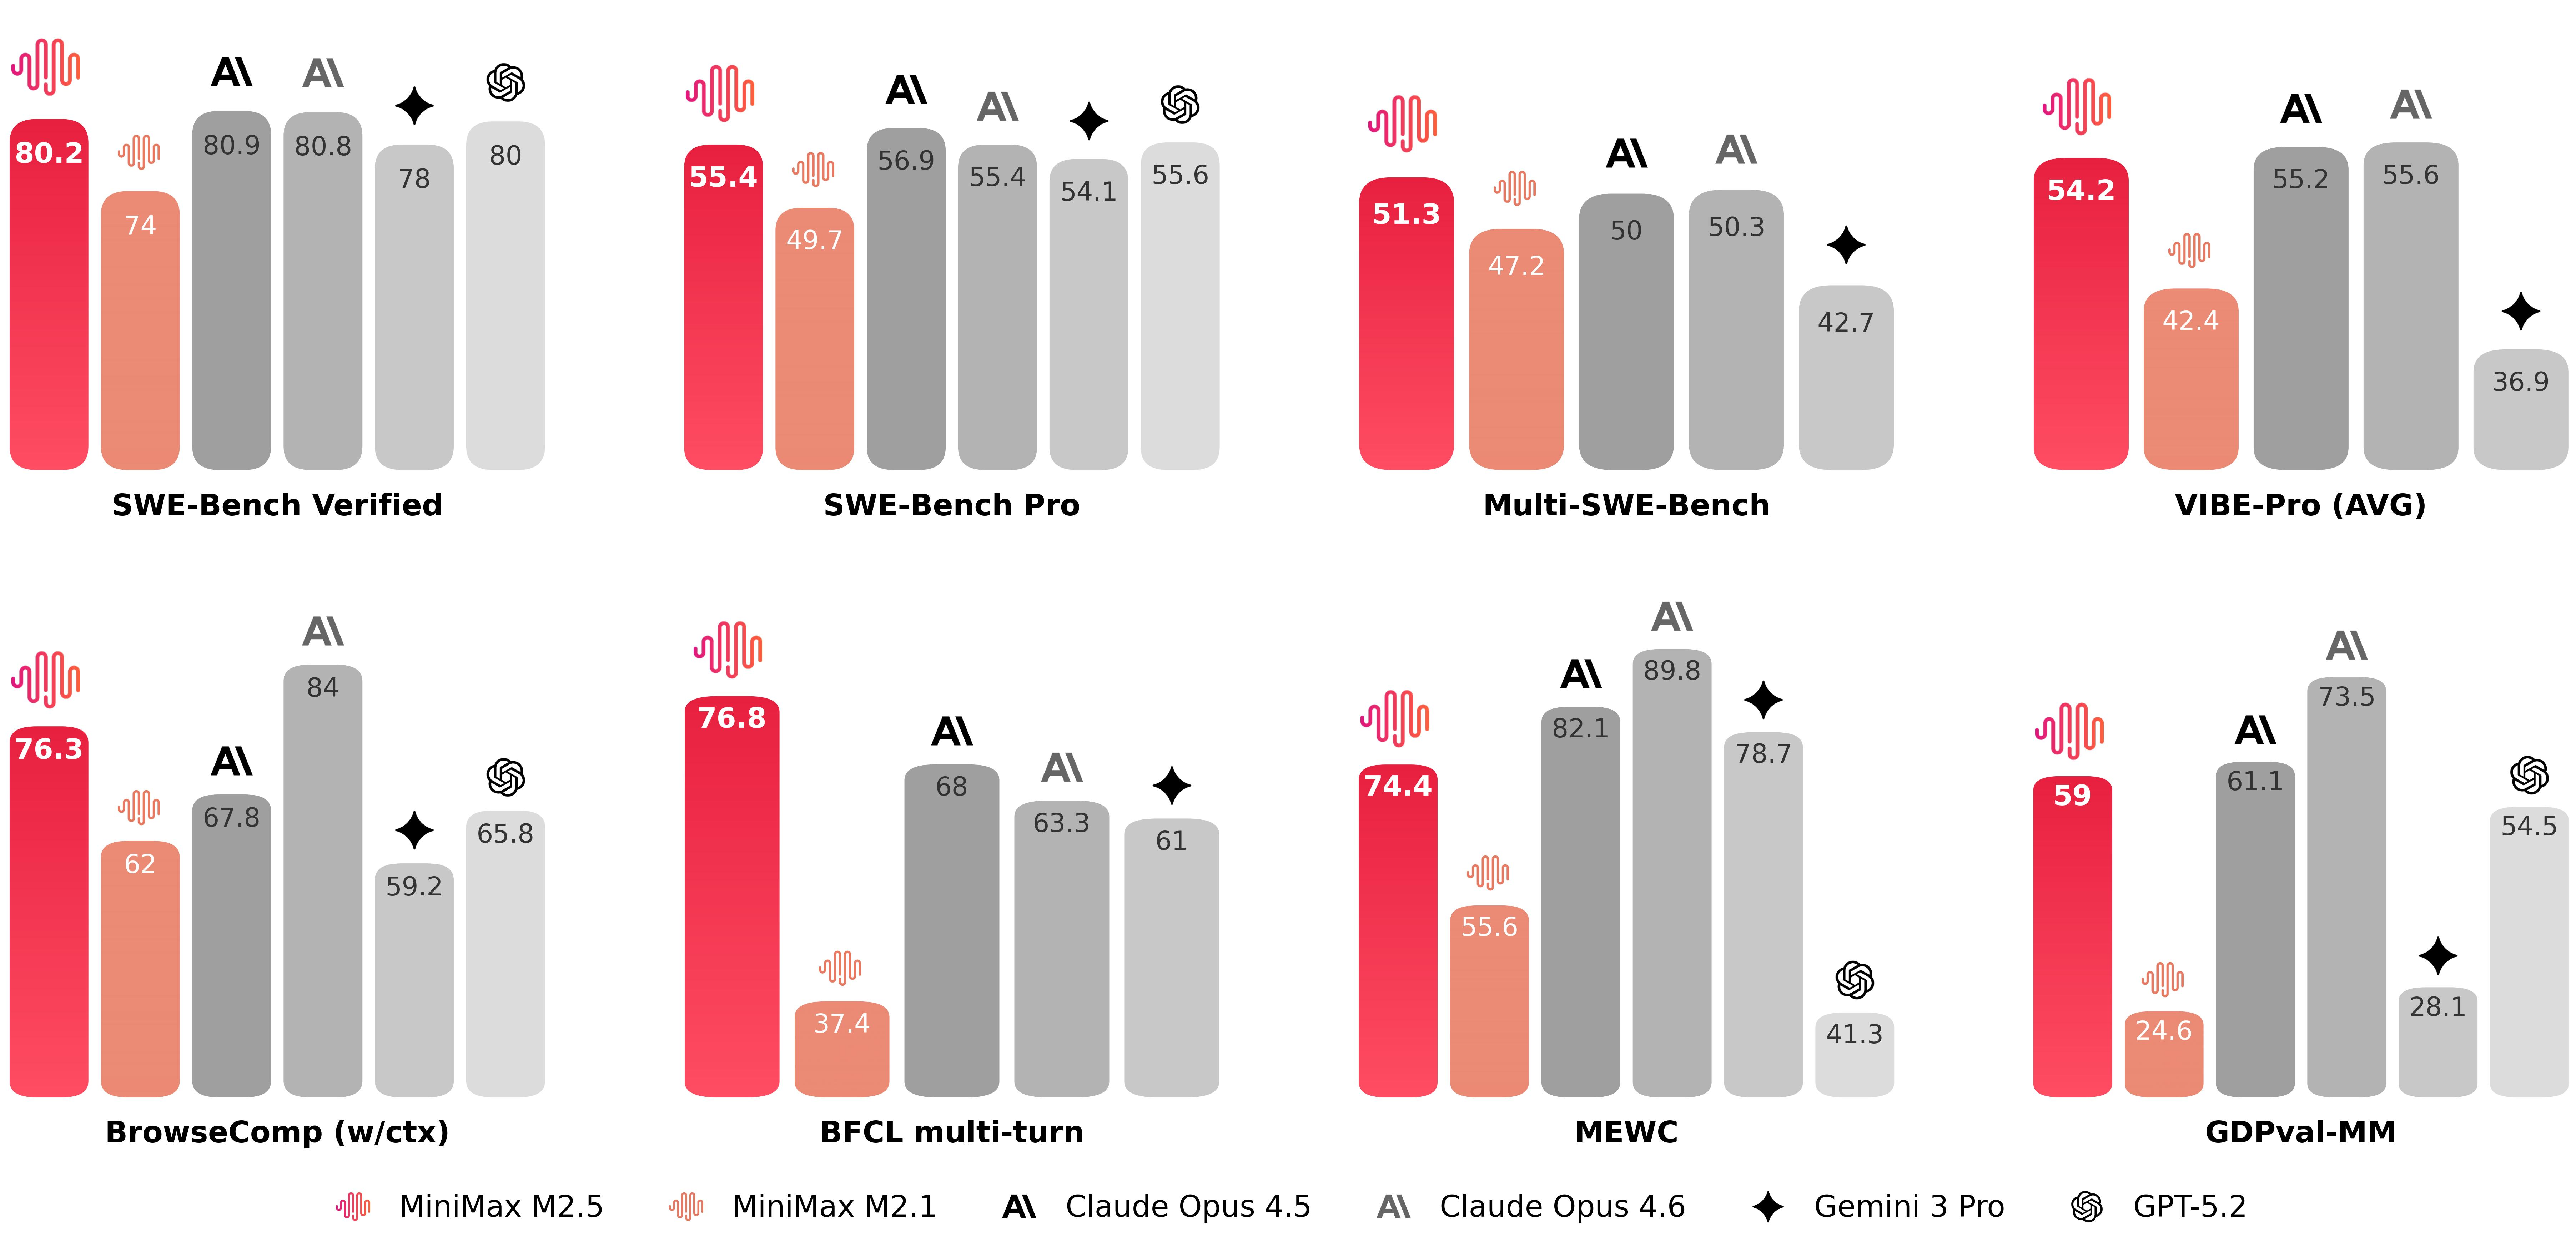
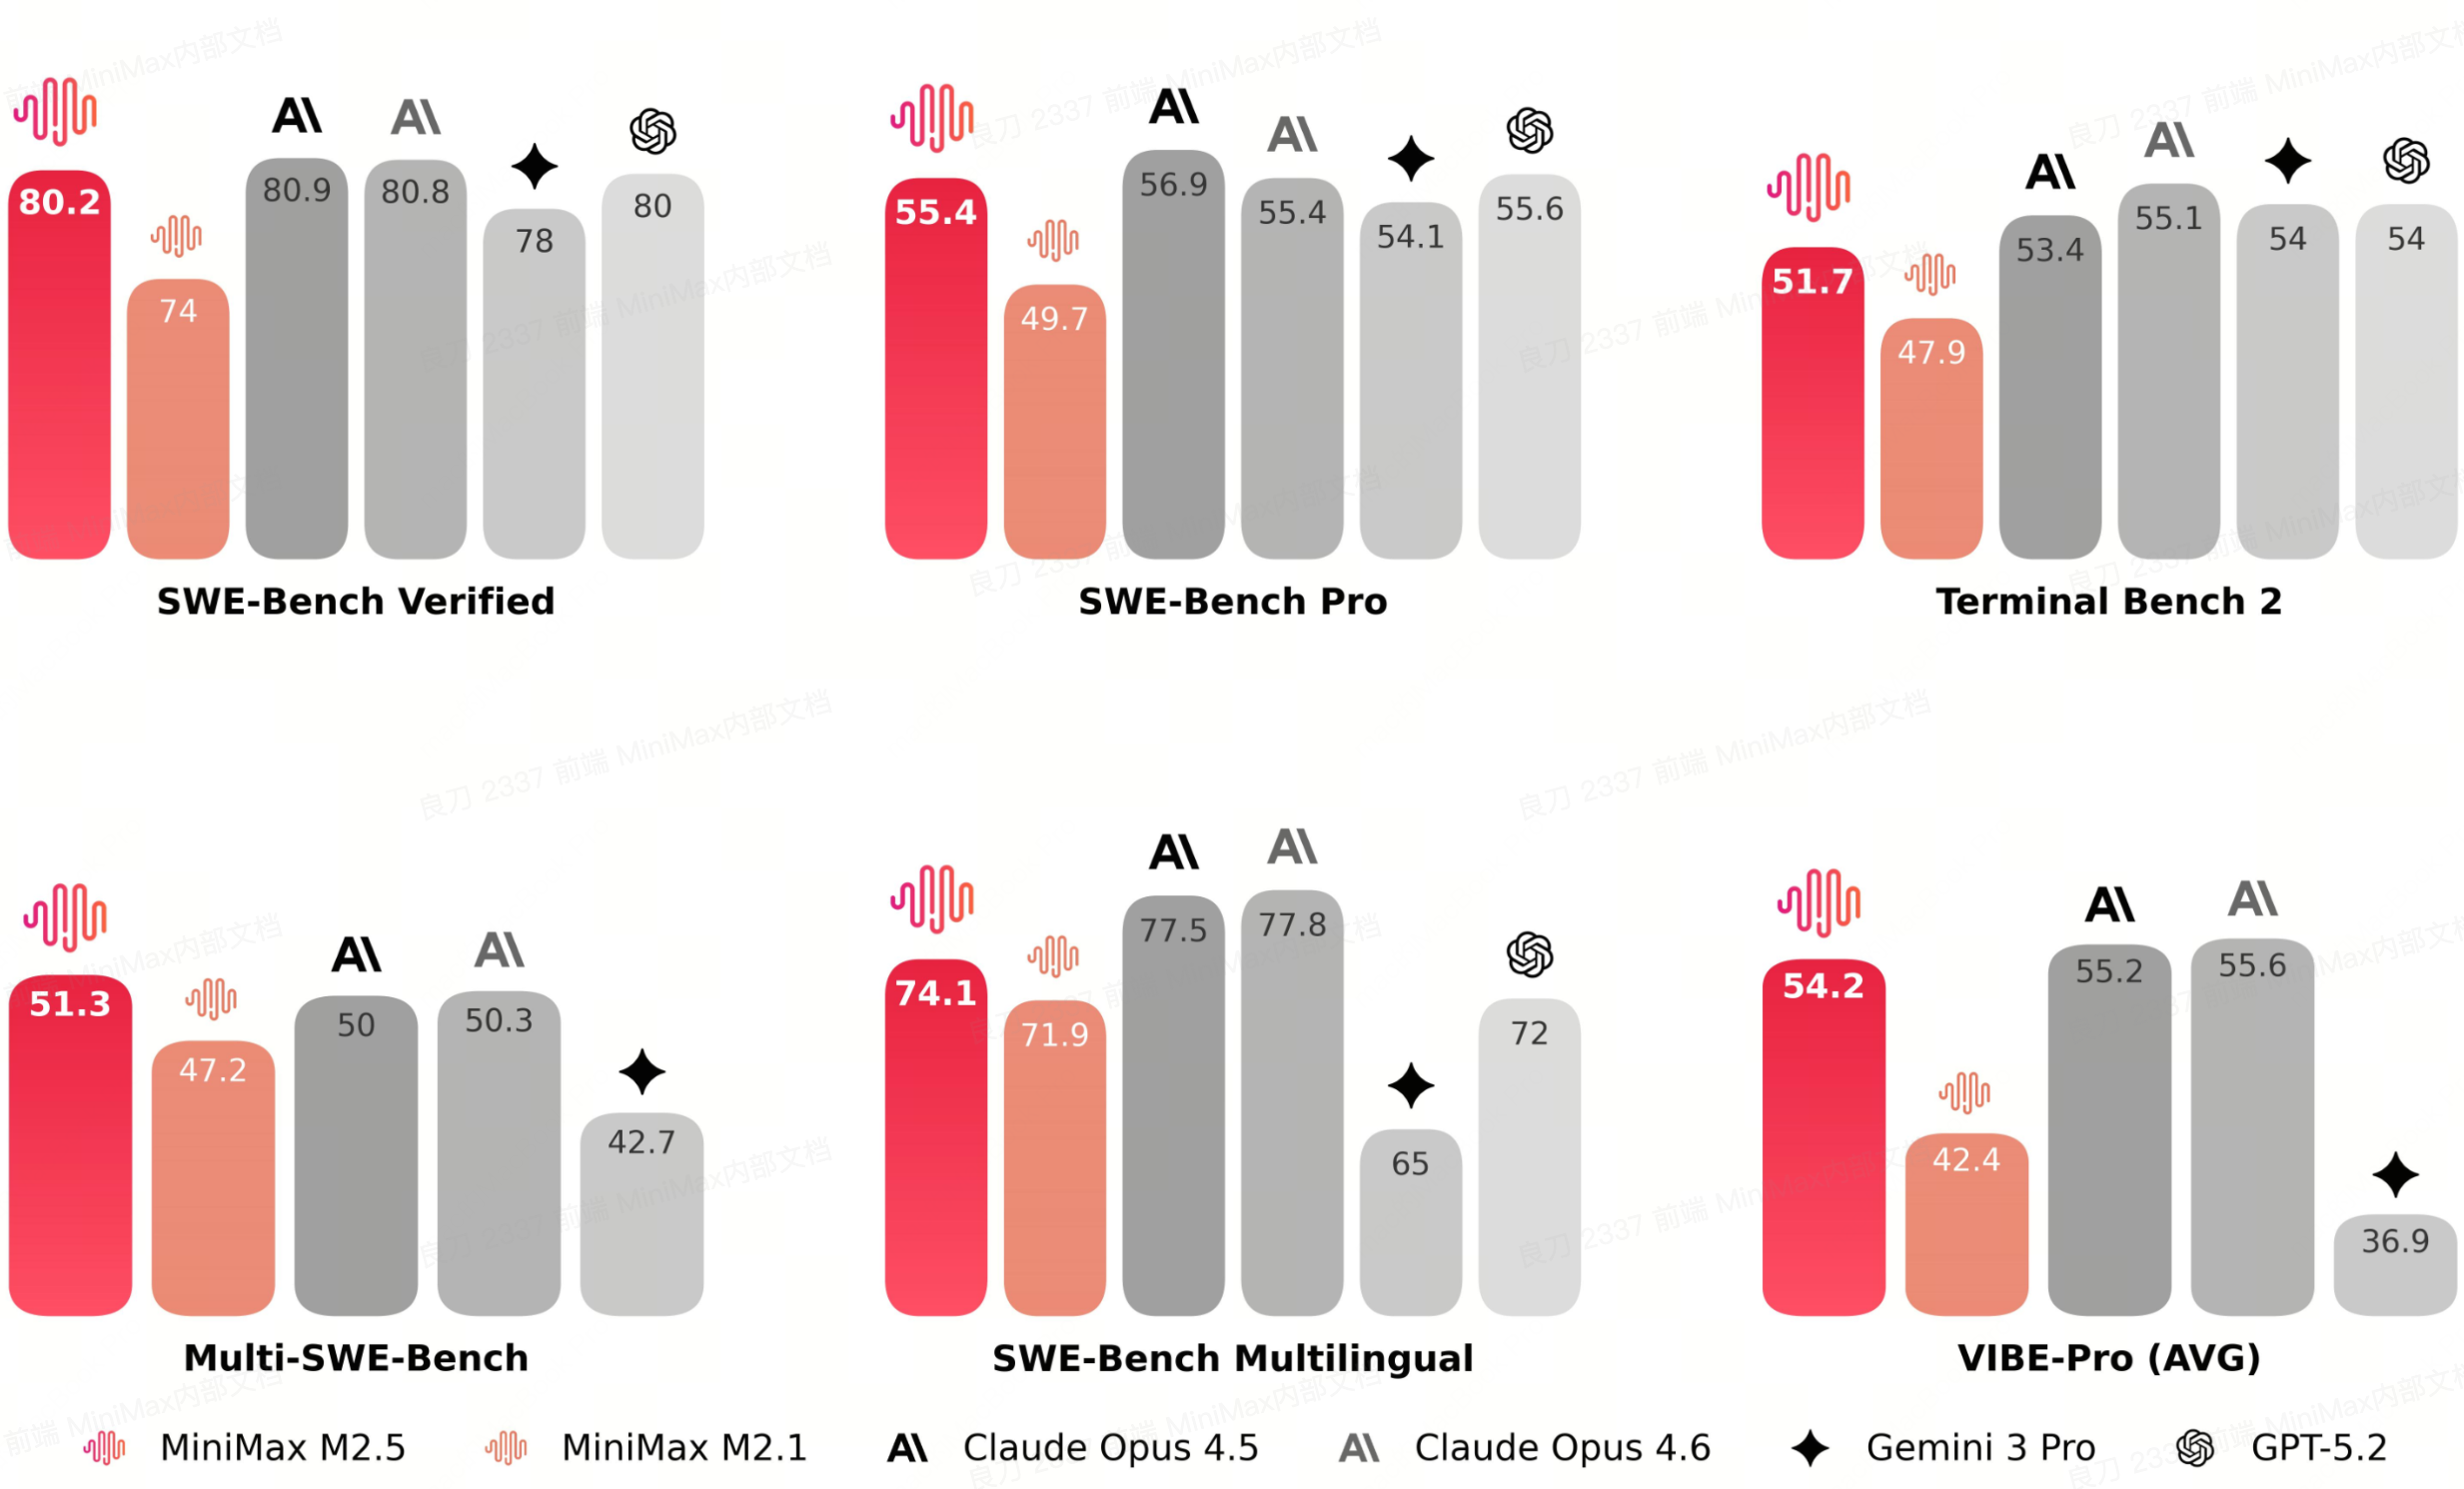
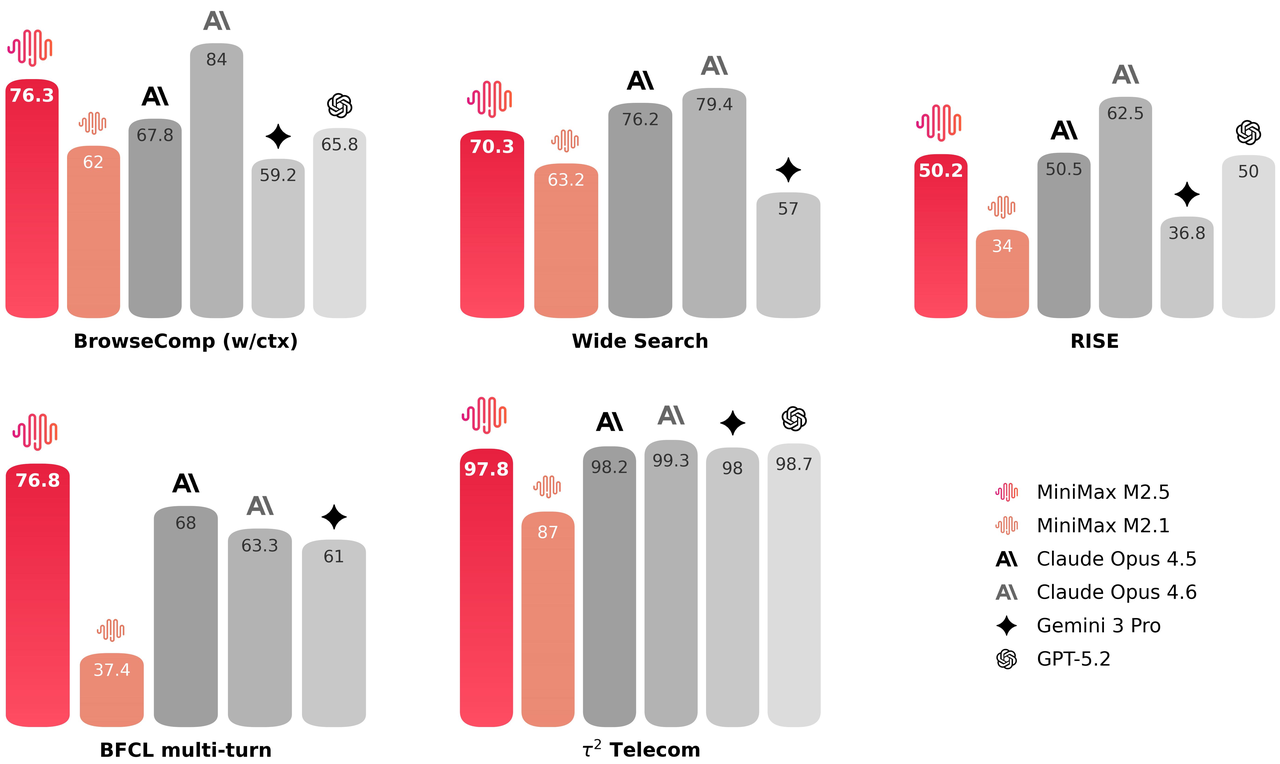
MiniMax-M2.5 は、コーディング、エージェント的ツール使用、検索、オフィス業務で SOTA を達成する新しいオープン LLM で、80.2% を記録し [検証済み](#benchmarks) 、Multi-SWE-Bench で 51.3%、BrowseComp で 76.3%。
その **230B パラメータ** (10B アクティブ)モデルは **200K コンテキスト** コンテキストウィンドウがあり、量子化なしの bf16 では **457GB**。Unsloth Dynamic **3ビット** GGUF でサイズは **101GB** **(-62%):** [**MiniMax-M2.5 GGUF**](https://huggingface.co/unsloth/MiniMax-M2.5-GGUF)
すべてのアップロードは Unsloth の [Dynamic 2.0](/docs/jp/ji-chu/dynamic-3.0-ggufs.md) SOTA の量子化性能向けに最適化されているため、3ビットでは重要なレイヤーが 8 ビットまたは 16 ビットにアップキャストされています。Unsloth を使って、マルチ GPU でモデルを微調整することもできます。
{% hint style="success" %}
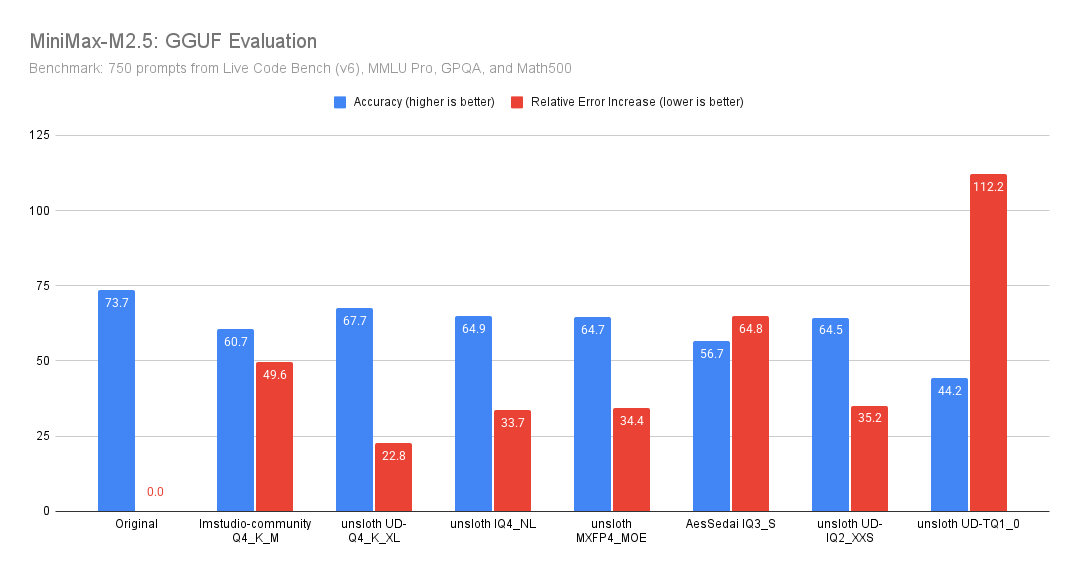
**2月26日:** ここで、当社の GGUF 量子化が [ベンチマークでどれほど性能を発揮するかをご覧ください](#unsloth-gguf-benchmarks).
{% endhint %}
### :gear: 使用ガイド
3ビットの動的量子化 UD-Q3\_K\_XL は **101GB** のディスク容量を使用します。これは **128GB ユニファイドメモリ搭載 Mac** で約20トークン/秒以上を実現し、さらに **16GB GPU 1基と 96GB の RAM** で25トークン/秒以上です。 **2ビット** 量子化版、または最大の2ビット版は 96GB デバイスに収まります。
ほぼ **完全精度**には、 `Q8_0` (8ビット)では 243GB を使用し、256GB RAM 搭載デバイス / Mac に収まり、10トークン/秒以上で動作します。
{% hint style="success" %}
最高の性能のために、利用可能な総メモリ(VRAM + システム RAM)が、ダウンロードする量子化済みモデルファイルのサイズを上回っていることを確認してください。そうでなくても、llama.cpp は SSD/HDD オフロード経由で実行できますが、推論は遅くなります。
{% endhint %}
### 推奨設定
MiniMax は、最高の性能を得るために次のパラメータの使用を推奨します: `temperature=1.0`, `top_p = 0.95`, `top_k = 40`.
{% columns %}
{% column %}
| デフォルト設定(ほとんどのタスク) |
| ---------------------------- |
| `temperature = 1.0` |
| `top_p = 0.95` |
| `top_k = 40` |
| `repeat penalty = 1.0` または無効 |
| {% endcolumn %} |
{% column %}
* **最大コンテキストウィンドウ:** `196,608`
* `Min_P = 0.01` (デフォルトは 0.05 の場合があります)
* デフォルトのシステムプロンプト:
{% code overflow="wrap" %}
```
あなたは役立つアシスタントです。あなたの名前は MiniMax-M2.5 で、MiniMax によって作られています。
```
{% endcode %}
{% endcolumn %}
{% endcolumns %}
## MiniMax-M2.5 のチュートリアルを実行:
これらのチュートリアルでは、3ビットの [UD-Q3\_K\_XL](https://huggingface.co/unsloth/MiniMax-M2.5-GGUF?show_file_info=UD-Q3_K_XL%2FMiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf) 128GB RAM デバイスに収まる量子化版を使用します。
#### ✨ llama.cpp で実行
{% stepper %}
{% step %}
最新の `llama.cpp` を [GitHubこちら](https://github.com/ggml-org/llama.cpp)。以下のビルド手順に従うこともできます。変更してください `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` GPUがない場合、またはCPU推論のみを使いたい場合は。 **Apple Mac / Metalデバイスの場合**、次を設定します `-DGGML_CUDA=OFF` その後は通常どおり続けてください。Metalサポートはデフォルトで有効です。
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
{% endstep %}
{% step %}
を使いたい場合は `llama.cpp` モデルを直接読み込むには、以下のようにできます。(:Q3\_K\_XL) は量子化タイプです。Hugging Face(3番)経由でもダウンロードできます。これは次と似ています `ollama run` に似ています。 `export LLAMA_CACHE="folder"` を使って `llama.cpp` 特定の場所に保存するためです。モデルのコンテキスト長の上限は 200K であることを忘れないでください。
これに従ってください: **ほとんどのデフォルト** ユースケース:
```bash
export LLAMA_CACHE="unsloth/MiniMax-M2.5-GGUF"
./llama.cpp/llama-cli \
-hf unsloth/MiniMax-M2.5-GGUF:UD-Q3_K_XL \\
--ctx-size 16384 \\
--flash-attn on \\
--temp 1.0 \\
--top-p 0.95 \\
--min-p 0.01 \\
--top-k 40
```
{% endstep %}
{% step %}
以下をインストールした後、( `pip install huggingface_hub hf_transfer` をインストール後)。 `UD-Q3_K_XL` (動的 4ビット量子化)または `UD-Q6_K_XL` のような他の量子化版もあります。サイズと精度のバランスを取るために、当社の 4bit 動的量子化を使うことを推奨します。 `UD-Q3_K_XL` ダウンロードが止まってしまう場合は、 [Hugging Face Hub、XET のデバッグ](/docs/jp/ji-chu/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)
```bash
hf download unsloth/MiniMax-M2.5-GGUF \\
--local-dir unsloth/MiniMax-M2.5-GGUF \\
--include "*UD-Q3_K_XL*" # 8ビット用には "*Q8_0*" を使用
```
{% endstep %}
{% step %}
編集できます `--threads 32` CPUスレッド数は `--ctx-size 16384` コンテキスト長は `--n-gpu-layers 2` GPUオフロードする層数です。GPUがメモリ不足になったら調整してみてください。CPUのみで推論する場合は削除してください。
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/MiniMax-M2.5-GGUF/UD-Q3_K_XL/MiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf \\
--temp 1.0 \\
--top-p 0.95 \\
--min-p 0.01 \\
--top-k 40 \
--ctx-size 16384 \\
--seed 3407
```
{% endcode %}
{% endstep %}
{% endstepper %}
### 🦙 Llama-server と OpenAI の completion ライブラリ
MiniMax-M2.5 を本番環境にデプロイするには、 `llama-server` または OpenAI API を使用します。新しいターミナルで tmux などを使い、次の方法でモデルをデプロイします:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-server \
--model unsloth/MiniMax-M2.5-GGUF/UD-Q3_K_XL/MiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf \\
--alias "unsloth/MiniMax-M2.5" \\
--prio 3 \\
--temp 1.0 \\
--top-p 0.95 \\
--min-p 0.01 \\
--top-k 40 \
--ctx-size 16384 \\
--port 8001
```
{% endcode %}
次に、新しいターミナルで、 `pip install openai`を実行した後、次を行います:
{% code overflow="wrap" %}
```python
from openai import OpenAI
import json
openai_client = OpenAI(
base_url = "http://127.0.0.1:8001/v1",
api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
model = "unsloth/MiniMax-M2.5",
messages = [{"role": "user", "content": "Snake ゲームを作成してください。"},],
)
print(completion.choices[0].message.content)
```
{% endcode %}
## 📊 ベンチマーク
### Unsloth GGUF ベンチマーク
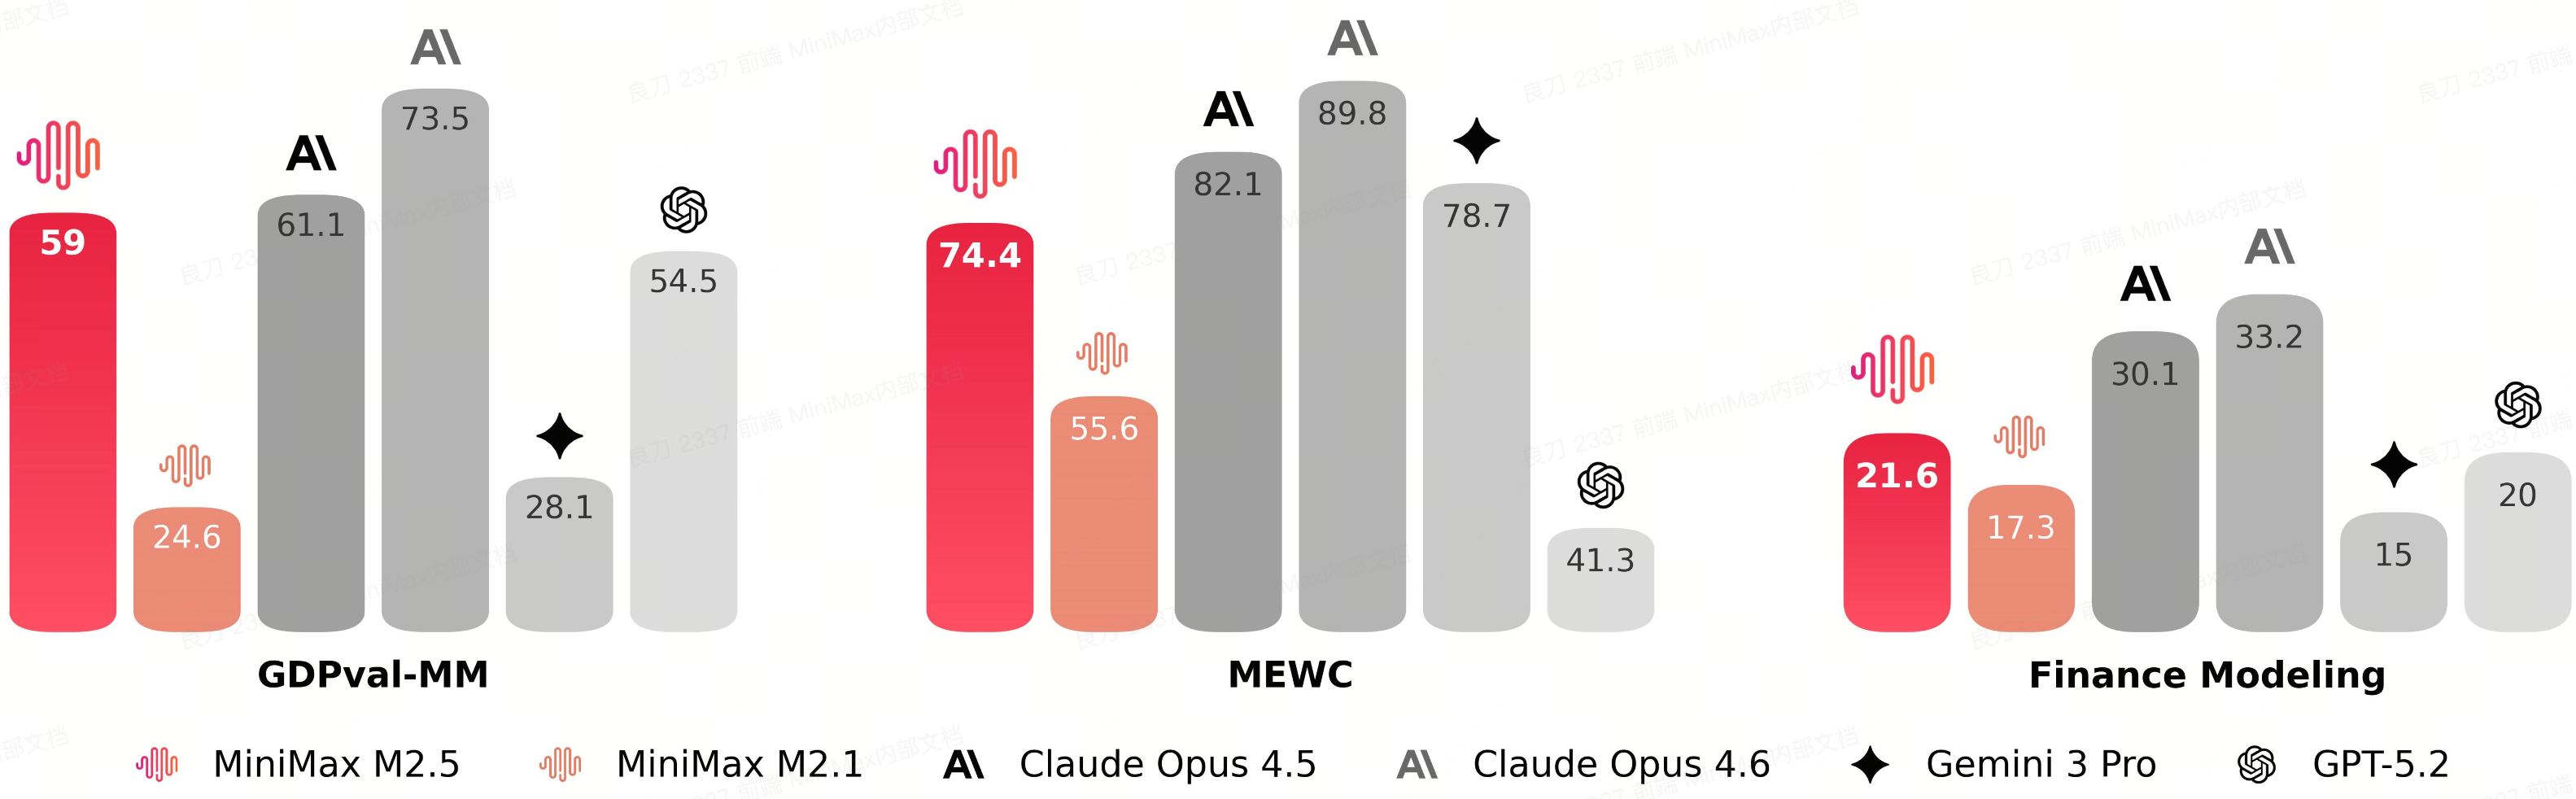
ベンチマーク MiniMax-M2.5 MiniMax-M2.1 Claude Opus 4.5 Claude Opus 4.6 Gemini 3 Pro GPT-5.2(thinking) AIME25 86.3 83.0 91.0 95.6 96.0 98.0 GPQA-D 85.2 83.0 87.0 90.0 91.0 90.0 SciCode 44.4 41.0 50.0 52.0 56.0 52.0 IFBench 70.0 70.0 58.0 53.0 70.0 75.0 AA-LCR 69.5 62.0 74.0 71.0 71.0 73.0 SWE-Bench Verified 80.2 74.0 80.9 80.8 78.0 80.0 SWE-Bench Pro 55.4 49.7 56.9 55.4 54.1 55.6 Terminal Bench 2 51.7 47.9 53.4 55.1 54.0 54.0 HLE(ツールなし) 19.4 22.2 28.4 30.7 37.2 31.4 Multi-SWE-Bench 51.3 47.2 50.0 50.3 42.7 — SWE-Bench 多言語 74.1 71.9 77.5 77.8 65.0 72.0 VIBE-Pro(平均) 54.2 42.4 55.2 55.6 36.9 — BrowseComp(ctxあり) 76.3 62.0 67.8 84.0 59.2 65.8 Wide Search 70.3 63.2 76.2 79.4 57.0 — RISE 50.2 34.0 50.5 62.5 36.8 50.0 BFCL マルチターン 76.8 37.4 68.0 63.3 61.0 — τ² Telecom 97.8 87.0 98.2 99.3 98.0 98.7 MEWC 74.4 55.6 82.1 89.8 78.7 41.3 GDPval-MM 59.0 24.6 61.1 73.5 28.1 54.5 金融モデリング 21.6 17.3 30.1 33.2 15.0 20.0
コーディングコアベンチマークスコア
検索とツール使用
100件あたりの完了タスク数
オフィス機能
&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.