> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md).
# Gemma 3n: 実行とファインチューニングの方法
Googleの新しいGemma 3nを、llama.cpp、Ollama、Open WebUI上でDynamic GGUFを使ってローカル実行し、Unslothでファインチューニングしましょう!
GoogleのGemma 3nマルチモーダルモデルは、画像、音声、動画、テキストの入力を処理します。2Bと4Bのサイズで利用でき、テキストおよびマルチモーダルのタスクに対して140言語をサポートしています。今すぐローカルで実行し、ファインチューニングできます **Gemma-3n-E4B** そして **E2B** ローカルで [Unsloth](https://github.com/unslothai/unsloth).
> **Gemma 3nを私たちの** [**無料のColabノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
Gemma 3nには **32Kのコンテキスト長**、30秒の音声入力、OCR、自動音声認識(ASR)、およびプロンプト経由の音声翻訳があります。
実行チュートリアル ファインチューニングチュートリアル 修正 + 技術分析
**最適な設定でのUnsloth Gemma 3n(Instruct)のアップロード:**
Dynamic 2.0 GGUF(テキストのみ) Dynamic 4-bit Instruct(ファインチューニング用) 16-bit Instruct
**ベースやその他の形式を含む、Gemma 3nのすべてのアップロードは** [**こちらのコレクションでご覧ください**](https://huggingface.co/collections/unsloth/gemma-3n-685d3874830e49e1c93f9339)**.**
## 🖥️ Gemma 3nの実行
現在、Gemma 3nは **テキスト形式** での推論のみサポートされています。
{% hint style="info" %}
私たちは [問題を修正しました](#fixes-for-gemma-3n) 。OllamaでのみGGUFが正常に動作しない不具合がありました。Ollamaを使用している場合は再ダウンロードしてください。
{% endhint %}
### :gear: 公式推奨設定
Gemmaチームによると、推論の公式推奨設定は次のとおりです:
`temperature = 1.0, top_k = 64, top_p = 0.95, min_p = 0.0`
* 温度 1.0
* Top\_K 64
* Min\_Pは0.00(任意ですが、0.01でもうまく動きます。llama.cppのデフォルトは0.1です)
* Top\_P 0.95
* 繰り返しペナルティ 1.0。(1.0は llama.cpp と transformers では無効を意味します)
* チャットテンプレート:
<bos><start_of_turn>user\nこんにちは!<end_of_turn>\n<start_of_turn>model\nやあ!<end_of_turn>\n<start_of_turn>user\n1+1はいくつ?<end_of_turn>\n<start_of_turn>model\n
user
こんにちは!
model
やあ!
user
1+1はいくつ?
model\n
```
{% endcode %}
{% hint style="danger" %}
llama.cppや他の推論エンジンは自動で\を追加します。\を2つ追加しないでください!モデルにプロンプトを与える際は\を無視してください!
{% endhint %}
### :llama: チュートリアル:OllamaでGemma 3nを実行する方法
{% hint style="success" %}
いくつかのバグ修正があるため、Gemma 3Nの量子化版を再ダウンロードするか、Ollama経由で古いものを削除してください。以下を実行して古いファイルを削除し、更新できます:
```
ollama rm hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
ollama run hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
```
{% endhint %}
1. インストール `ollama` まだの場合は!
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
2. モデルを実行してください!必要に応じて `ollama serve`を別のターミナルで呼び出せます。失敗した場合でも大丈夫です!私たちの修正と推奨パラメータ(temperature など)はすべて `params` として Hugging Face のアップロードに含めています!
```bash
ollama run hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
```
### 📖 チュートリアル:llama.cppでGemma 3nを実行する方法
{% hint style="info" %}
まず最初に、 [Xuan-Son Nguyen](https://x.com/ngxson) (Hugging Face)に、 [Georgi Gerganov](https://x.com/ggerganov) とllama.cppチームの皆さんに、Gemma 3Nをllama.cppで動作させるためのご尽力に感謝します!
{% endhint %}
1. 最新の `llama.cpp` を [GitHubこちら](https://github.com/ggml-org/llama.cpp)。以下のビルド手順に従うこともできます。変更してください `-DGGML_CUDA=ON` を `-DGGML_CUDA=OFF` GPUがない場合、またはCPU推論のみを使いたい場合は。 **Apple Mac / Metalデバイスの場合**、次を設定します `-DGGML_CUDA=OFF` その後は通常どおり続けてください。Metalサポートはデフォルトで有効です。
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=ON -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. を使いたい場合は `llama.cpp` モデルを直接読み込むには、以下のようにできます:(:Q4\_K\_XL)は量子化タイプです。Hugging Face(3番)経由でもダウンロードできます。これは次と同様です: `ollama run`
```bash
./llama.cpp/llama-cli -hf unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL -ngl 99 --jinja
```
3. **または** (インストール後に)経由でモデルをダウンロードします `pip install huggingface_hub hf_transfer` 。Q4\_K\_Mや他の量子化版(BF16のフル精度など)を選べます。
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/gemma-3n-E4B-it-GGUF",
local_dir = "unsloth/gemma-3n-E4B-it-GGUF",
allow_patterns = ["*UD-Q4_K_XL*", "mmproj-BF16.gguf"], # Q4_K_XL用
)
```
4. モデルを実行します。
5. 編集 `--threads 32` CPUスレッド数は `--ctx-size 32768` コンテキスト長向け(Gemma 3は32Kのコンテキスト長をサポートしています!)、 `--n-gpu-layers 99` GPUオフロードする層数です。GPUがメモリ不足になったら調整してみてください。CPUのみで推論する場合は削除してください。
6. 会話モードの場合:
```bash
./llama.cpp/llama-cli \
--model unsloth/gemma-3n-E4B-it-GGUF/gemma-3n-E4B-it-UD-Q4_K_XL.gguf \\
--mmproj unsloth/gemma-3n-E4B-it-GGUF/mmproj-BF16.gguf \\
--ctx-size 32768 \
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 1.0 \\
--repeat-penalty 1.0 \
--min-p 0.00 \
--top-k 64 \
--top-p 0.95
```
7. Flappy Birdをテストするための非会話モードでは:
```bash
./llama.cpp/llama-cli \
--model unsloth/gemma-3n-E4B-it-GGUF/gemma-3n-E4B-it-UD-Q4_K_XL.gguf \\
--mmproj unsloth/gemma-3n-E4B-it-GGUF/mmproj-BF16.gguf \\
--ctx-size 32768 \
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 1.0 \\
--repeat-penalty 1.0 \
--min-p 0.00 \
--top-k 64 \
--top-p 0.95 \\
-no-cnv \\
--prompt "user\nPythonでFlappy Birdゲームを作ってください。以下の要素を必ず含めてください:\n1. pygameを使うこと。\n2. 背景色はランダムに選び、明るい色調にすること。最初はライトブルーにしてください。\n3. SPACEキーを複数回押すと鳥が加速すること。\n4. 鳥の形は四角、円、三角形のいずれかをランダムにすること。色は暗い色をランダムに選ぶこと。\n5. 下部には、ダークブラウンまたは黄色からランダムに選ばれた色の地面を配置すること。\n6. 右上にスコアを表示すること。パイプを通過し、ぶつからなければ加点すること。\n7. 十分な間隔を持ったパイプをランダムに配置すること。色はダークグリーン、薄茶、またはダークグレーからランダムにすること。\n8. 負けたらベストスコアを表示すること。テキストは画面内に収めること。qまたはEscを押すとゲームを終了すること。再開はSPACEをもう一度押すこと。\n最終的なゲームはPythonのMarkdownセクション内に収めてください。最終的なMarkdownセクションの前にコードのエラーを確認し、修正してください。\nmodel\n"
```
{% hint style="danger" %}
Gemma 3Nは自動で\を追加するので、\を削除するのを忘れないでください!
{% endhint %}
## 🦥 UnslothでGemma 3nをファインチューニング
Gemma 3nは、 [Gemma 3](/docs/jp/moderu/tutorials/gemma-3-how-to-run-and-fine-tune.md#unsloth-fine-tuning-fixes-for-gemma-3)と同様に、 **Colab上のTesla T4のようなfloat16 GPUでの実行に問題がありました** 。推論またはファインチューニングのためにGemma 3nをパッチしないと、NaNや無限大に遭遇します。 [詳細は以下](#infinities-and-nan-gradients-and-activations).
* 私たちの [無料のColabノートブック](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
* **音声:** 私たちの [**音声のみのノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Audio.ipynb)
* **ビジョン**:私たちの [**Visionのみのノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Vision.ipynb)
また、Gemma 3nの独自のアーキテクチャはビジョンエンコーダ内で隠れ状態を再利用するため、 [後述のGradient Checkpointing](#gradient-checkpointing-issues)
**Unslothは、Gemma 3nの推論と学習をfloat16マシンで動かせる唯一のフレームワークです。** つまり、無料のTesla T4 GPUを使えるColabノートブックでも動作します!全体として、UnslothはGemma 3nの学習を1.5倍高速化し、VRAM使用量を50%削減し、コンテキスト長を4倍にします。
私たちの無料Gemma 3n Colabノートブックは、デフォルトでテキスト層のファインチューニングを行います。ビジョン層や音声層もファインチューニングしたい場合は、これにはさらに多くのVRAMが必要になることに注意してください。無料のColabやKaggleが提供する15GBを超えます。あなたは *できます* 音声やビジョンを含むすべての層を引き続きファインチューニングできますし、Unslothではビジョンのみなど特定の部分だけをファインチューニングすることもできます。必要に応じて調整してください:
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = False, # ビジョン層をファインチューニングしない場合はFalse
finetune_language_layers = True, # 言語層をファインチューニングしない場合はFalse
finetune_attention_modules = True, # attention層をファインチューニングしない場合はFalse
finetune_mlp_modules = True, # MLP層をファインチューニングしない場合はFalse
)
```
#### :trophy:ボーナスコンテンツ
皆さんが欲しいと言っていた **Gemma 3(4B)向けのVisionノートブック** をこちらにご用意しました:
* 私たちの [無料のColabノートブック](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
{% hint style="info" %}
Kaggleが好きなら、GoogleはGemma 3nとUnslothでファインチューニングした最高のモデルが1万ドルの賞金を獲得するコンペティションを開催しています! [詳細はこちら](https://www.kaggle.com/competitions/google-gemma-3n-hackathon).
{% endhint %}
## 🐛 Gemma 3nの修正
### :sparkles:GGUFの問題と修正
次の方々との議論のおかげで [Michael](https://github.com/mxyng) (Ollamaチーム)と、さらに [Xuan](https://x.com/ngxson) (Hugging Face)により、GGUFに特有の修正が必要な問題が2つありました:
1. その `add_shared_kv_layers` パラメータが誤って `float32` でエンコードされていました。これは問題ありませんが、Ollama側でデコードするのが少し複雑になります。 `uint32` への単純な変更でこの問題は解決します。 [プルリクエスト](https://github.com/ggml-org/llama.cpp/pull/14450) がこの問題に対処しています。
2. その `per_layer_token_embd` 層は精度がQ8\_0であるべきです。それより低いと正常に動作せず、Ollamaエンジンでエラーになります。コミュニティの問題を減らすため、私たちはすべての量子化版でこれをQ8\_0にしました。残念ながら、これはより多くの容量を使用します。
1. なお、 [更新](https://huggingface.co/unsloth/gemma-3n-E4B-it-GGUF/discussions/4), [Matt](https://huggingface.co/WBB2500) が述べたように、埋め込みにはQ4\_0、Q4\_1、Q5\_0、Q5\_1も使えますし、Ollamaでも実際に動作することを確認しました!つまり、より小さい2、3、4bit量子化版はサイズがさらに小さく、Q8\_0は不要ということです!
## :infinity:無限大とNaNの勾配と活性化
{% columns %}
{% column %}
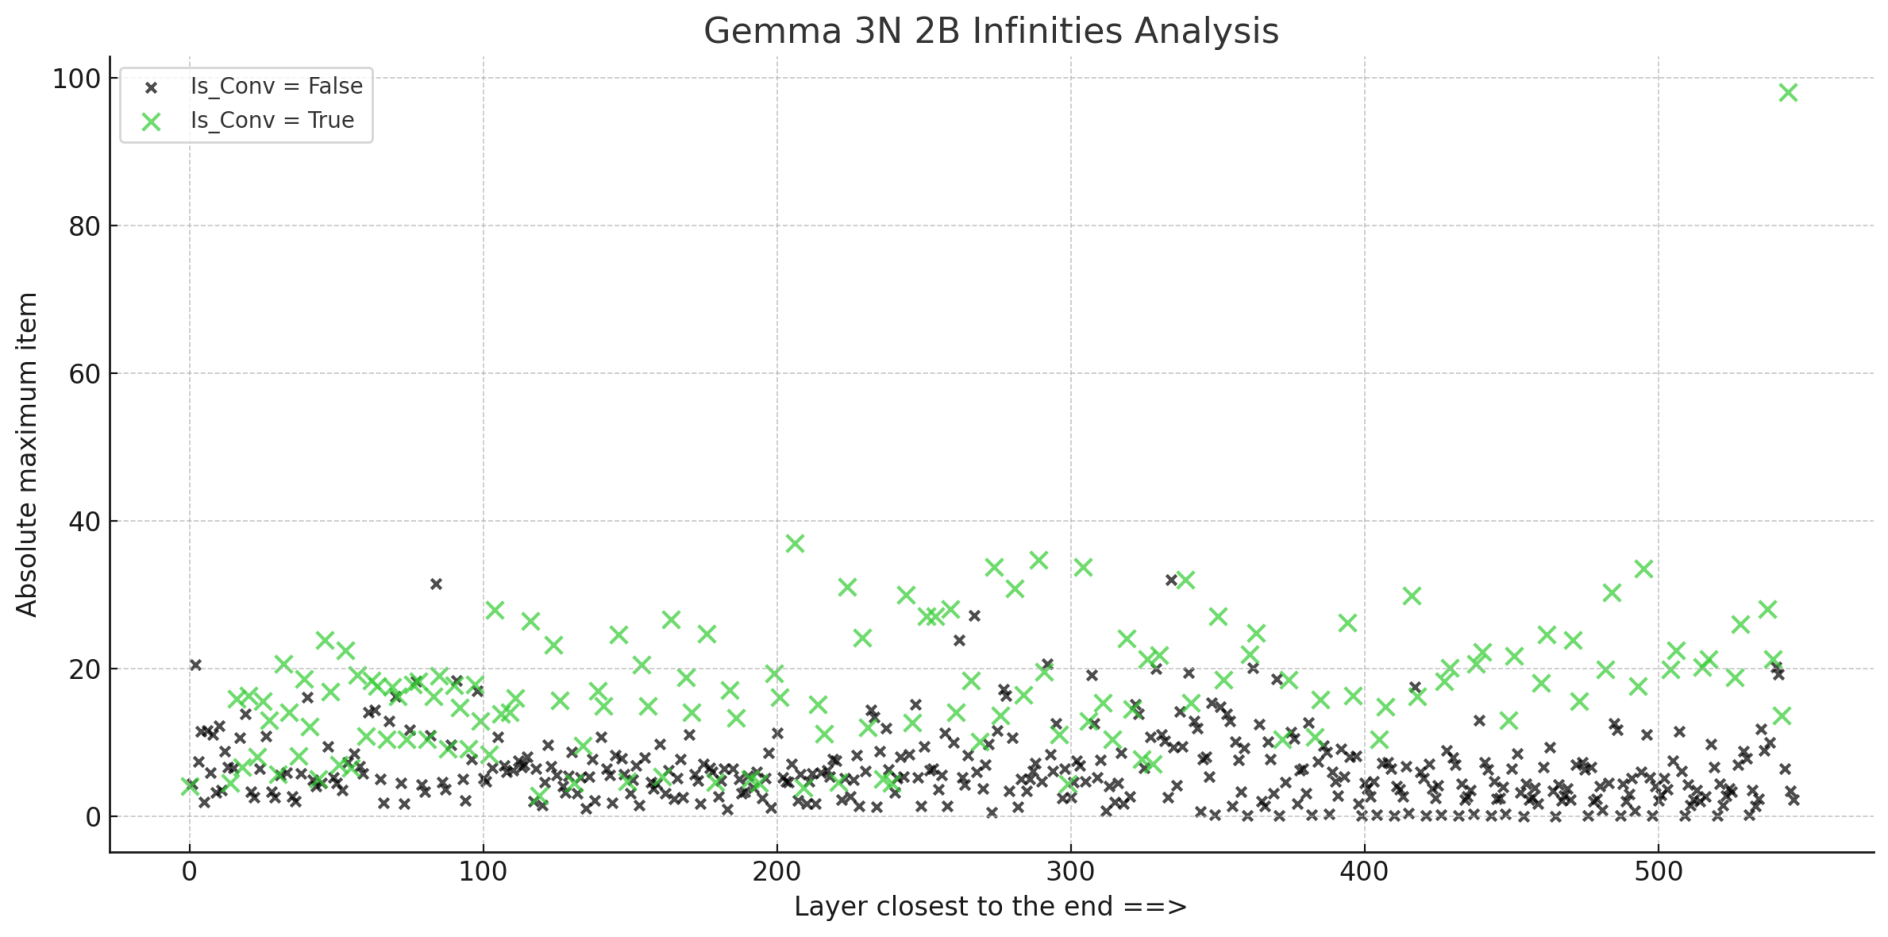
Gemma 3nはGemma 3と同様に、FP16 GPU(例:ColabのTesla T4)で問題があります。
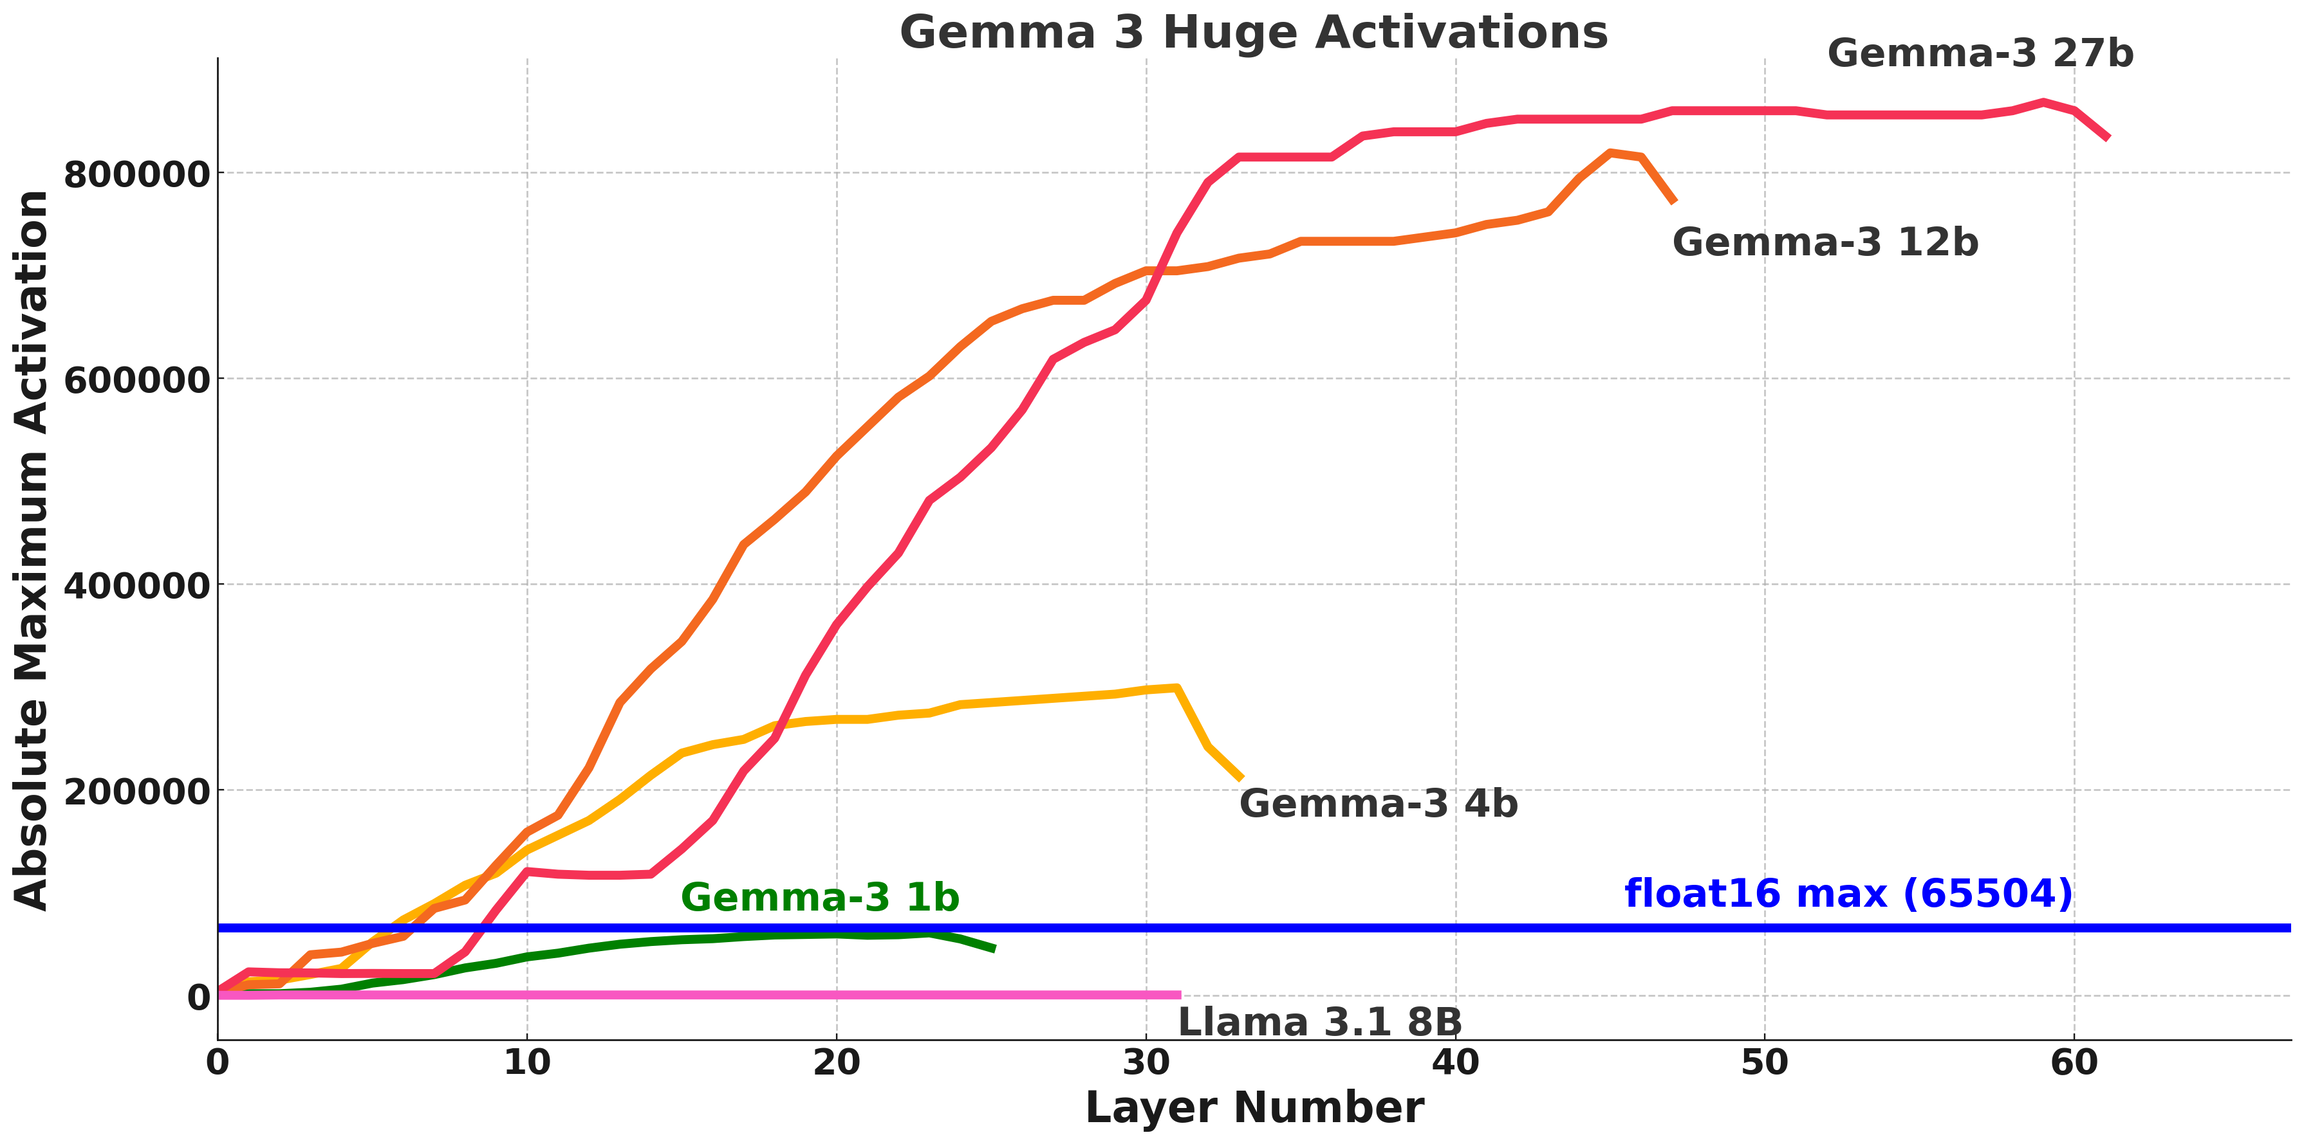
Gemma 3向けの以前の修正は [こちらで議論されています](/docs/jp/moderu/tutorials/gemma-3-how-to-run-and-fine-tune.md)。Gemma 3では、活性化値がfloat16の最大範囲 **65504.**
**Gemma 3Nにはこの活性化の問題はありませんが、それでも無限大が発生しました!**
{% endcolumn %}
{% column %}
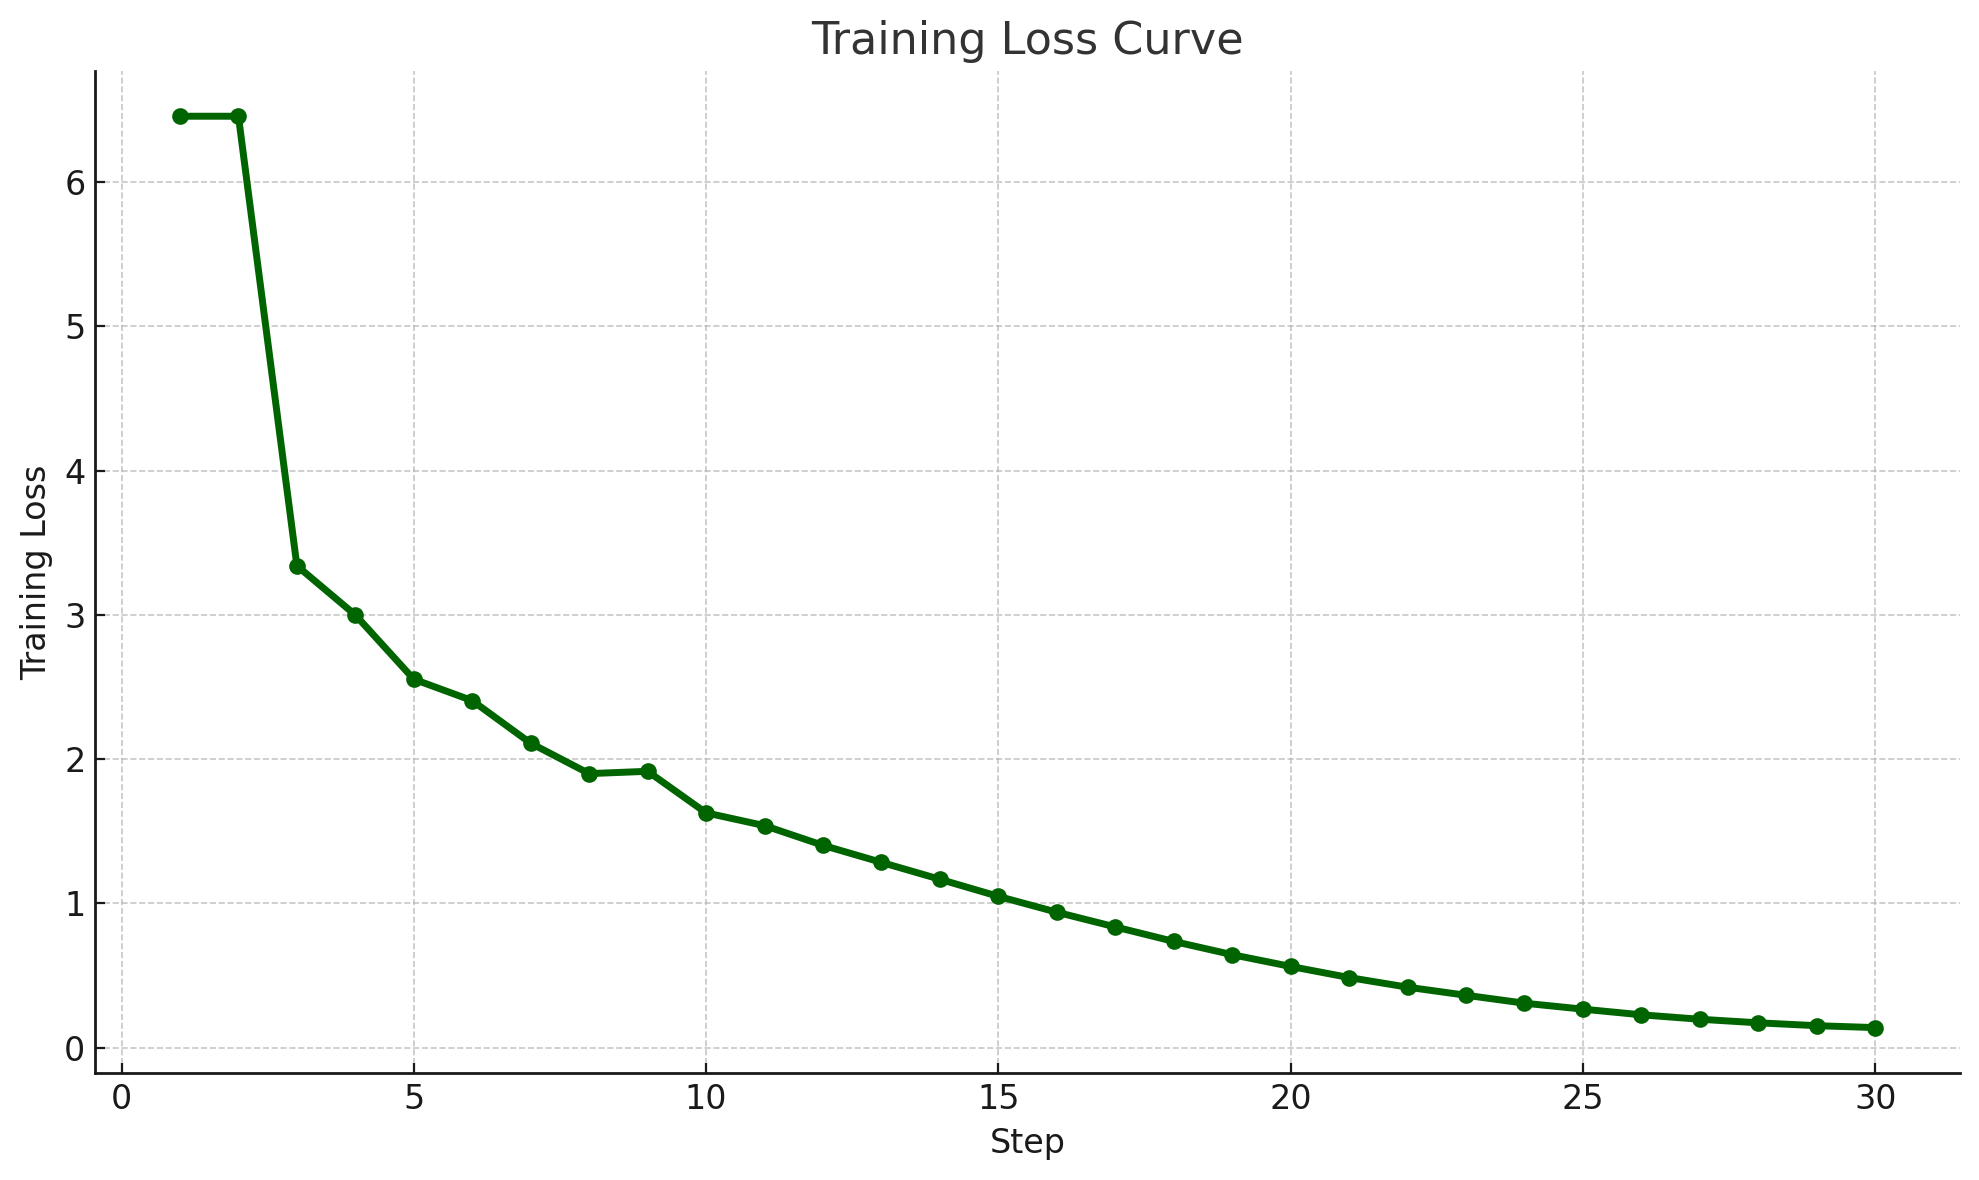
**マルチモーダルモデルはいつもこの挙動を示すようです** - Llama 3.2 Visionの損失は3か4から始まり、Pixtralは8前後、Qwen 2.5 VLも4程度でした。Gemma 3Nは音声も含むため、開始時の損失がさらに大きくなる可能性があります。ただし、これはあくまで仮説です。また、Qwen 2.5 VL 72B Instructを量子化すると困惑度が約30と非常に高くなることもわかりましたが、モデルの性能は興味深いことに問題ありませんでした。
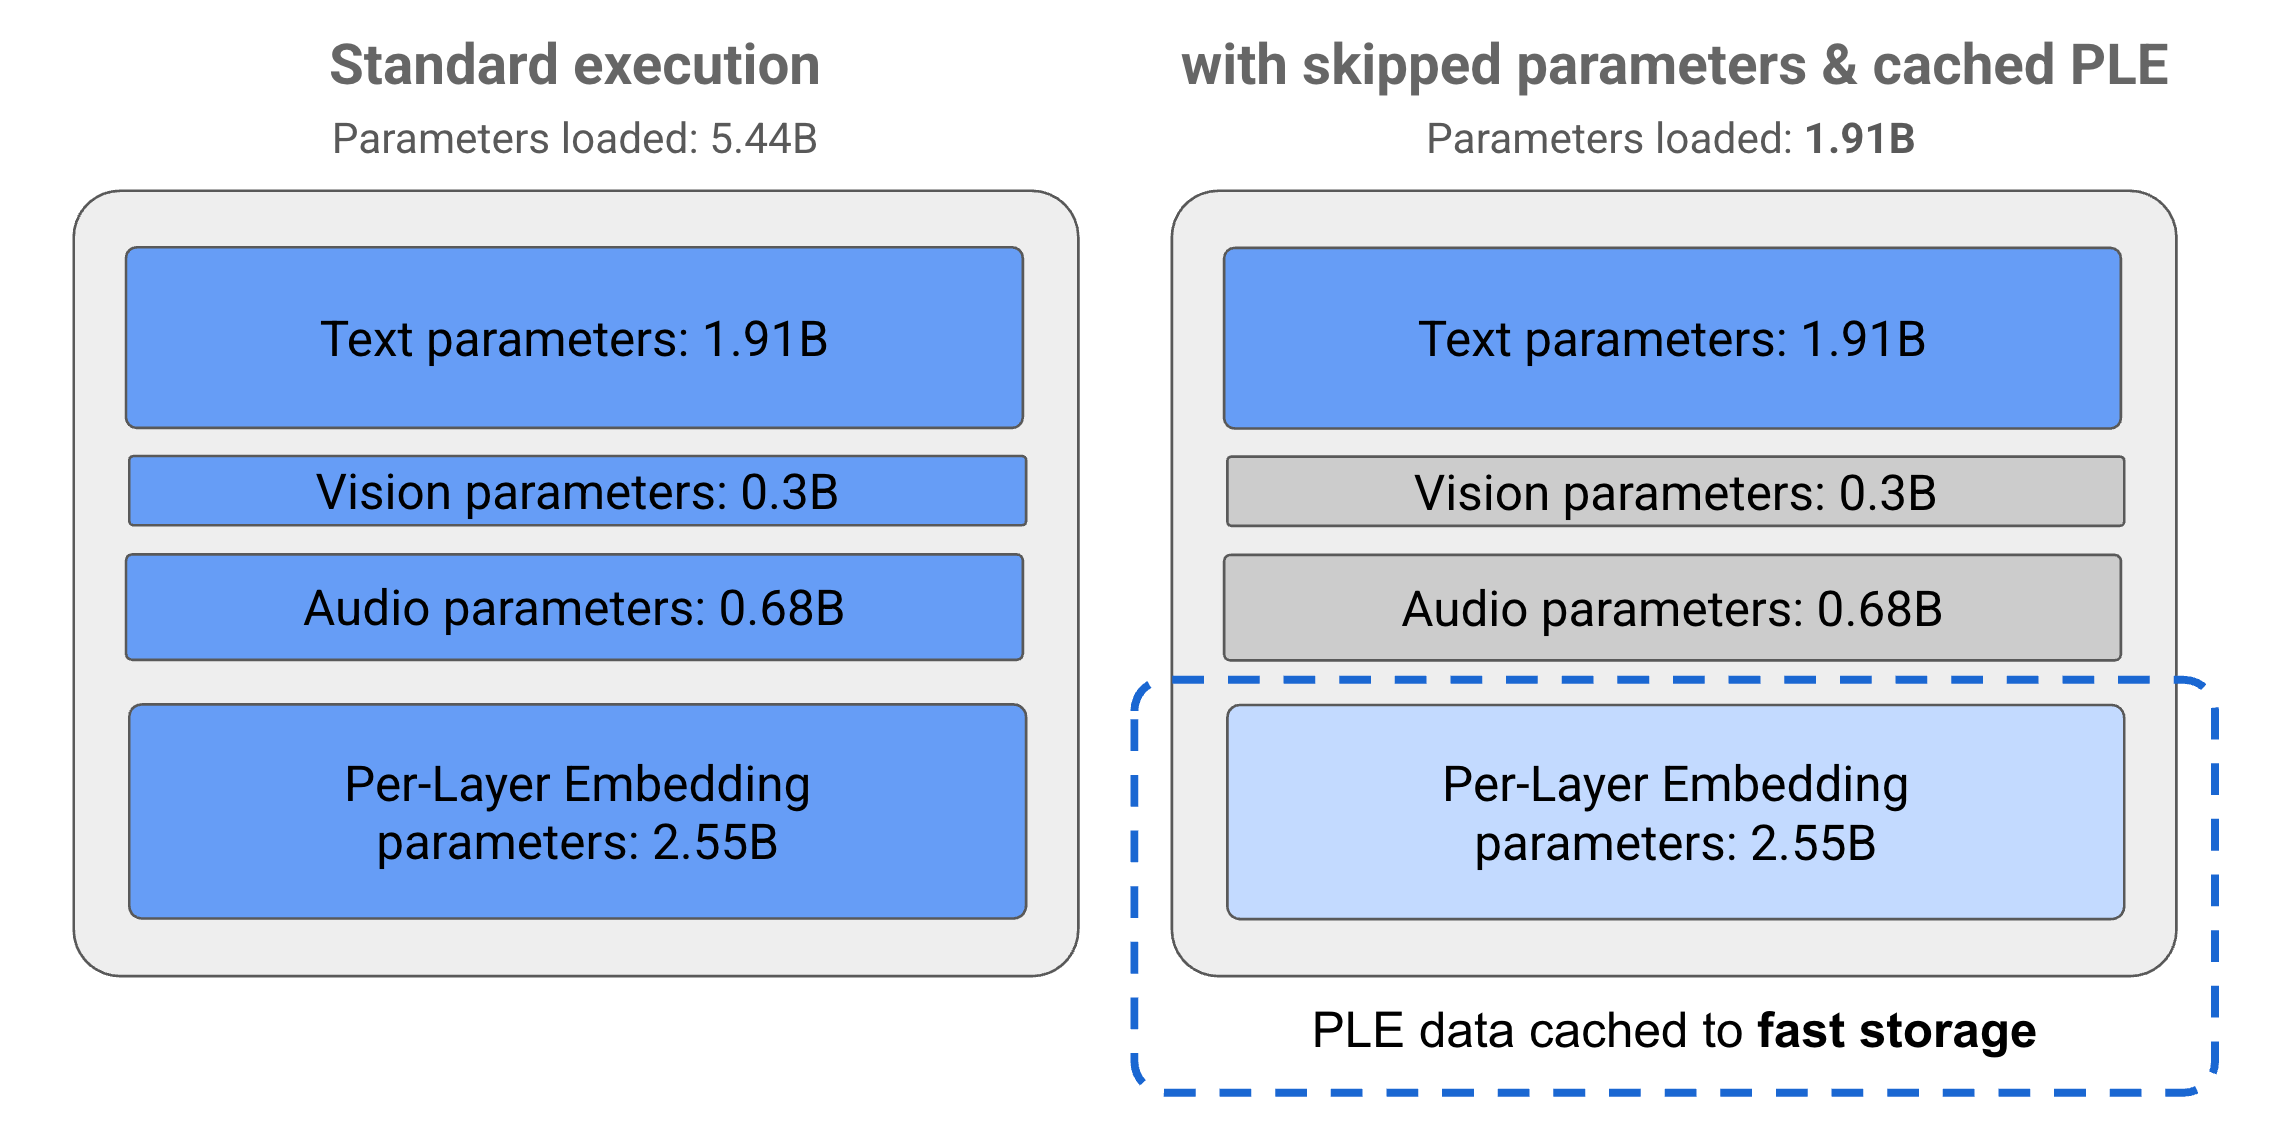
画像出典 Gemma 3nモデル概要
&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.