> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/ji-chu/multi-gpu-training-with-unsloth/ddp.md).
# Distributed Data Parallel(DDP)を使ったマルチ GPU ファインチューニング
Unsloth CLI を使って、Distributed Data Parallel(DDP)で複数 GPU を使って学習する方法を学びましょう!
GPUが複数あると仮定し、それらすべてを使ってモデルをファインチューニングしたいとしましょう! そのための最も簡単な戦略は Distributed Data Parallel(DDP)を使うことです。これは各GPUデバイス上にモデルのコピーを1つずつ作成し、学習中にデータセットから異なるサンプルを各コピーに与え、各オプティマイザステップごとの重み更新への寄与を集約します。
なぜこれを行いたいのでしょうか? GPUを学習プロセスに追加するほど、ステップごとにモデルが学習するサンプル数を増やせるため、各勾配更新がより安定し、GPUを追加するたびに学習スループットが劇的に向上します。
Unslothのコマンドラインインターフェース(CLI)を使ってこれを行う方法を、ステップごとにご紹介します!
**注:** Unsloth DDPは、CLI経由だけでなく、どんな学習スクリプトでも動作します! 詳細は下記。
#### ソースからUnslothをインストールする
GitHubからUnslothをクローンしてインストールします。 [仮想環境](https://docs.python.org/3/tutorial/venv.html);私たちは次のものを使うのが好きです `uv venv –python 3.12 && source .venv/bin/activate`ですが、仮想環境を作成できるツールなら何でも構いません。
```bash
git clone https://github.com/unslothai/unsloth.git
cd unsloth
pip install .
```
#### ファインチューニングする対象モデルとデータセットを選択する
このデモでは、次をファインチューニングします [Qwen/Qwen3-8B](https://huggingface.co/Qwen/Qwen3-8B) の [yahma/alpaca-cleaned](https://huggingface.co/datasets/yahma/alpaca-cleaned) チャットデータセットです。これは、ベースモデルを望ましい対話スタイルに適応させたり、下流タスクでのモデル性能を向上させたりする際によく使われる、教師ありファインチューニング(SFT)のワークロードです。
### Unsloth CLIを使いましょう!
まず、CLIに組み込まれているヘルプメッセージを見てみましょう(簡潔にするため、ここではいくつかの箇所を「...」で省略しています):
{% code expandable="true" %}
```bash
$ python unsloth-cli.py --help
使用法: unsloth-cli.py [-h] [--model_name MODEL_NAME] [--max_seq_length MAX_SEQ_LENGTH] [--dtype DTYPE]
[--load_in_4bit] [--dataset DATASET] [--r R] [--lora_alpha LORA_ALPHA]
[--lora_dropout LORA_DROPOUT] [--bias BIAS]
[--use_gradient_checkpointing USE_GRADIENT_CHECKPOINTING]
…
🦥 Unslothを使ってLLMをより速くファインチューニングしましょう!
オプション:
-h, --help このヘルプメッセージを表示して終了
🤖 モデルオプション:
--model_name MODEL_NAME
読み込むモデル名
--max_seq_length MAX_SEQ_LENGTH
最大シーケンス長。デフォルトは2048です。RoPEスケーリングを自動でサポートします
内部で!
…
🧠 LoRAオプション:
これらのオプションはLoRAモデルの設定に使用されます。
--r R LoRAモデルのランク。デフォルトは16です。(一般的な値: 8, 16, 32, 64, 128)
--lora_alpha LORA_ALPHA
LoRAのalphaパラメータ。デフォルトは16です。(一般的な値: 8, 16, 32, 64, 128)
…
🎓 学習オプション:
--per_device_train_batch_size PER_DEVICE_TRAIN_BATCH_SIZE
学習時のデバイスごとのバッチサイズ。デフォルトは2です。
--per_device_eval_batch_size PER_DEVICE_EVAL_BATCH_SIZE
評価時のデバイスごとのバッチサイズ。デフォルトは4です。
--gradient_accumulation_steps GRADIENT_ACCUMULATION_STEPS
勾配蓄積ステップ数。デフォルトは4です。
…
```
{% endcode %}
これで、モデルを学習させるためにCLIへ渡せるオプションがどのようなものか、おおよそ把握できるはずです!
マルチGPU学習(この場合はDDP)では、次を使用します [torchrun](https://docs.pytorch.org/docs/stable/elastic/run.html) 単一ノードまたはマルチノード構成で複数の分散学習プロセスを起動できるランチャーです。今回の場合は、2基のH100 GPUを使うシングルノード(つまり1台のマシン)のケースに注目します。
また、次のコマンドを使ってGPUの状態も確認しましょう: `nvidia-smi` コマンドラインツール:
{% code expandable="true" %}
```bash
$ nvidia-smi
Mon Nov 24 12:53:00 2025
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05 ドライバーバージョン: 580.95.05 CUDA バージョン: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU 名前 永続モード | Bus-Id 表示A | 揮発性の訂正不能 ECC |
| ファン 温度 性能 電力:使用量/容量 | メモリ使用量 | GPU使用率 計算モード |
| | | MIG モード |
|=========================================+========================+======================|
| 0 NVIDIA H100 80GB HBM3 有効 | 00000000:04:00.0 無効 | 0 |
| N/A 32C P0 69W / 700W | 0MiB / 81559MiB | 0% デフォルト |
| | | 無効 |
+-----------------------------------------+------------------------+----------------------+
| 1 NVIDIA H100 80GB HBM3 有効 | 00000000:05:00.0 無効 | 0 |
| N/A 30C P0 68W / 700W | 0MiB / 81559MiB | 0% デフォルト |
| | | 無効 |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| プロセス: |
| GPU GI CI PID 種類 プロセス名 GPU メモリ |
| ID ID 使用量 |
|=========================================================================================|
| 実行中のプロセスは見つかりませんでした |
+-----------------------------------------------------------------------------------------+
```
{% endcode %}
すばらしい!予想どおり、H100 GPUが2基あります。現在は何も学習しておらず、モデルもメモリに読み込まれていないため、どちらもメモリ使用量は0MiBです。
学習実行を開始するには、次のようなコマンドを実行します:
{% code expandable="true" %}
```bash
# 必須:
# --model_name
# --dataset
# 任意; これらを試してみてください:
# --learning_rate, --max_seq_length, --per_device_train_batch_size, --gradient_accumulation_steps, --max_steps
# 学習終了時にモデルを保存するには:
# --save_model
torchrun --nproc_per_node=2 unsloth-cli.py \
--model_name=Qwen/Qwen3-8B \
--dataset=yahma/alpaca-cleaned \
--learning_rate=2e-5 \
--max_seq_length=2048 \
--per_device_train_batch_size=1 \
--gradient_accumulation_steps=4 \
--max_steps=1000 \
--save_model
```
{% endcode %}
GPUがさらにある場合は、 `--nproc_per_node` をそれに応じて設定して活用できます。
**注:** この `torchrun` ランチャーを、任意のUnsloth学習スクリプトで使えます。 [スクリプト](https://github.com/unslothai/notebooks/tree/main/python_scripts) 無料のColabノートブックから変換したものを含め、GPUが1基を超える構成で学習するとDDPが自動で有効になります!
再び `nvidia-smi` 学習中に:
{% code expandable="true" %}
```bash
$ nvidia-smi
Mon Nov 24 12:58:42 2025
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.95.05 ドライバーバージョン: 580.95.05 CUDA バージョン: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU 名前 永続モード | Bus-Id 表示A | 揮発性の訂正不能 ECC |
| ファン 温度 性能 電力:使用量/容量 | メモリ使用量 | GPU使用率 計算モード |
| | | MIG モード |
|=========================================+========================+======================|
| 0 NVIDIA H100 80GB HBM3 有効 | 00000000:04:00.0 無効 | 0 |
| N/A 38C P0 193W / 700W | 18903MiB / 81559MiB | 25% デフォルト |
| | | 無効 |
+-----------------------------------------+------------------------+----------------------+
| 1 NVIDIA H100 80GB HBM3 有効 | 00000000:05:00.0 無効 | 0 |
| N/A 37C P0 199W / 700W | 18905MiB / 81559MiB | 28% デフォルト |
| | | 無効 |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| プロセス: |
| GPU GI CI PID 種類 プロセス名 GPU メモリ |
| ID ID 使用量 |
|=========================================================================================|
| 0 N/A N/A 4935 C ...und/unsloth/.venv/bin/python3 18256MiB |
| 0 N/A N/A 4936 C ...und/unsloth/.venv/bin/python3 630MiB |
| 1 N/A N/A 4935 C ...und/unsloth/.venv/bin/python3 630MiB |
| 1 N/A N/A 4936 C ...und/unsloth/.venv/bin/python3 18258MiB |
+-----------------------------------------------------------------------------------------+
```
{% endcode %}
両方のGPUが、現在ではH100 GPUあたり約19GBのVRAMを使用していることがわかります!
トレーニングログを確認すると、約1.1イテレーション/秒の速度で学習できていることがわかります。GPUをさらに追加してもこの学習速度はほぼ一定なので、学習スループットはGPU数に対してほぼ線形に増加します!
### トレーニング指標
私たちは、次の対象でいくつかの短いrank-16 LoRAファインチューニングを実行しました [unsloth/Llama-3.2-1B-Instruct](https://huggingface.co/unsloth/Llama-3.2-1B-Instruct) の [yahma/alpaca-cleaned](https://huggingface.co/datasets/yahma/alpaca-cleaned) データセットで、複数GPUを用いたDDP学習を使うことで向上する学習スループットを示しました。
 上の図は、500学習ステップにわたる2つのLlama-3.2-1B-Instruct LoRAファインチューニングの学習損失を、単一GPU学習(ピンク)とマルチGPU DDP学習(青)で比較したものです。
損失曲線はスケールと傾向が一致しているものの、その他は *少し* 異なります。というのも、 *マルチGPU学習では各ステップで2倍の学習データを処理するため*です。その結果、ステップごとのばらつきが少ない、わずかに異なる学習曲線になります。
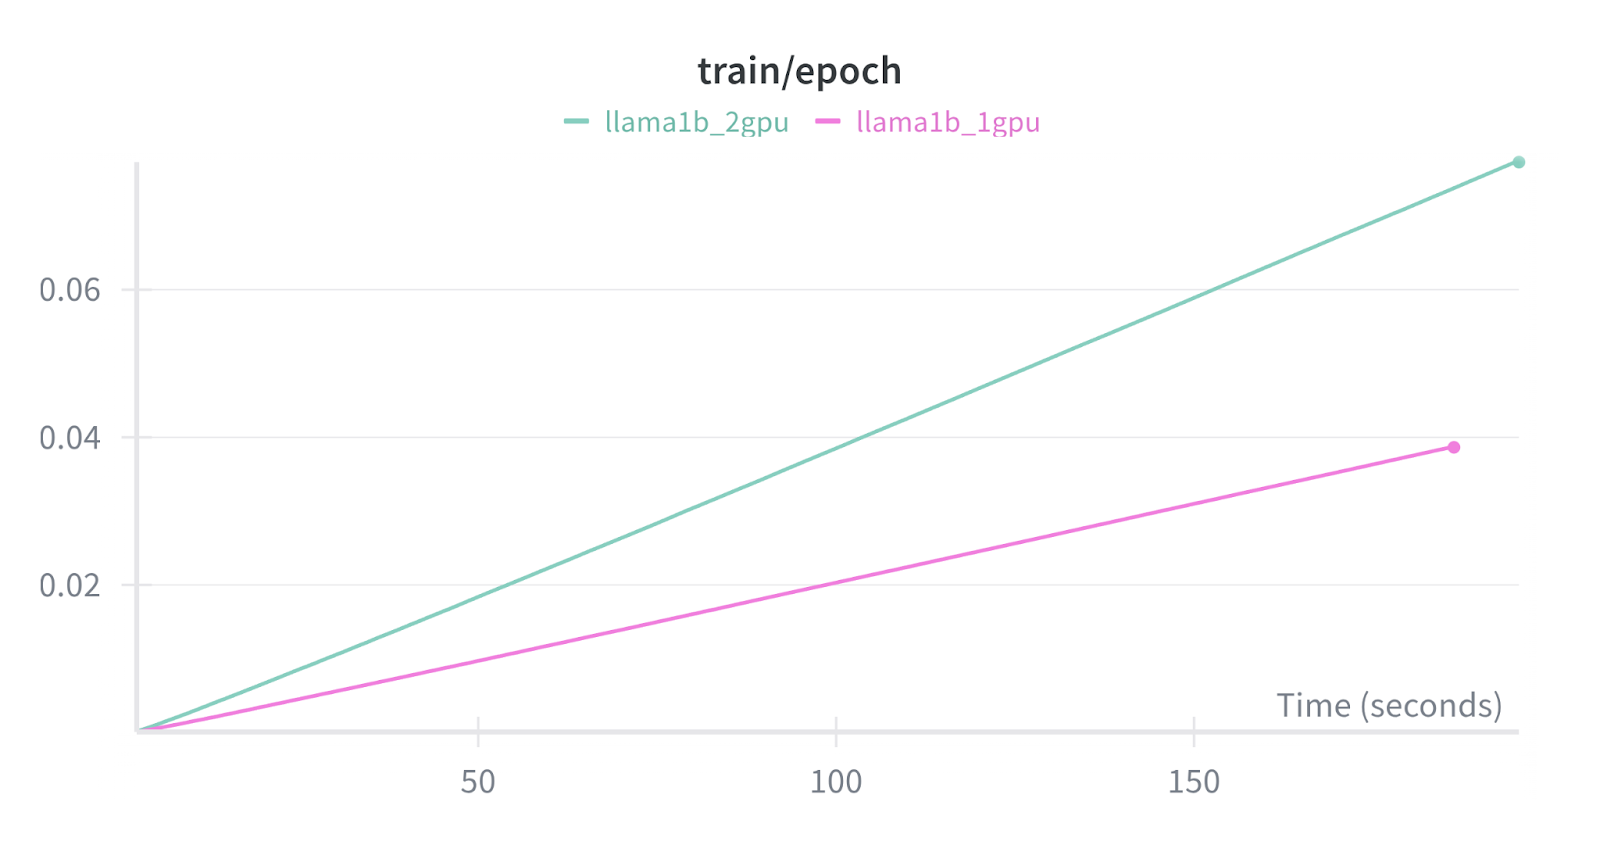 上の図は、同じ2つのファインチューニングについての学習の進捗を示しています。
マルチGPUのDDP学習では、単一GPU学習の半分のステップ数で学習データの1エポックを進むことがわかります。これは、各GPUがサイズ `per_device_train_batch_size`の別々のバッチを各ステップで処理できるためです。ただし、DDP学習のステップごとの所要時間は、モデル重みの更新のための分散通信があるため、やや遅くなります。GPUの数を増やすと、学習スループットは今後もほぼ線形に増加し続けます(ただし、分散通信のペナルティは小さいながらも増加します)。
同じ損失と学習エポックの進捗の挙動は、QLoRAファインチューニングでも成り立ちます。この場合、追加のGPUメモリを節約するために、ベースモデルを4ビット精度で読み込みました。これは、限られたGPU VRAMで大規模モデルを学習する場合に特に有用です。
 500学習ステップにわたる2つのLlama-3.2-1B-Instruct QLoRAファインチューニングの学習損失比較。単一GPU学習(オレンジ)とマルチGPU DDP学習(紫)。
 同じ2つのファインチューニングにおける学習進捗の比較。
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/ji-chu/multi-gpu-training-with-unsloth/ddp.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.