> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/ji-chu/faster-moe.md).

# UnslothでMoEモデルを12倍高速に微調整する

Unsloth ガイドを使って MoE LLM をローカルで学習します。

次の機能により、Mixture of Experts（MoE）LLMトレーニングを約12倍高速化します： **VRAMを35%以上削減** そして **コンテキスト長を約6倍に拡大** 新しいMoE Tritonカーネルと新たな数学的最適化により、精度を損なうことなく実現しています。

* Unslothは現在、以下を含むMoEアーキテクチャの高速トレーニングをサポートしています： [gpt-oss](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune.md), [Qwen3](/docs/jp/moderu/tutorials/qwen3-how-to-run-and-fine-tune.md) （30B、235B、VL、Coder）、DeepSeek [R1](/docs/jp/moderu/tutorials/deepseek-r1-0528-how-to-run-locally.md), [V3](/docs/jp/moderu/tutorials/deepseek-v3.1-how-to-run-locally.md) およびGLM（[4.6](https://unsloth.ai/docs/jp/ji-chu/pages/15da73ffae68627da854f843c0328406ea1ae99b#glm-4.6v-flash), [4.7](/docs/jp/moderu/tutorials/glm-4.7.md), [Flash](/docs/jp/moderu/tutorials/glm-4.7-flash.md)).
* gpt-oss-20bは次のVRAMでファインチューニングできます： **12.8 GBのVRAM**。Qwen3-30B-A3B（16ビットLoRA）は63GBを使用します。
* 当社のカーネルは、データセンター向け（B200、H100）のほか、 **コンシューマー向け** および旧世代GPU（例：RTX 3090）、さらにFFT、LoRA、QLoRAでも動作します。

🤗Hugging Faceとの協力により、すべてのMoEトレーニング実行をPyTorchの新しい `torch._grouped_mm` 関数で標準化しました。Transformers v5は最近、v4よりMoEが約6倍高速になるよう最適化されましたが、UnslothはカスタムTriton grouped-GEMM + LoRAカーネルにより、さらに **追加で** 約2倍の高速化、VRAMを35%以上削減、コンテキスト長を6倍以上に拡大します（v4比で総合12～30倍高速）。

高速なMoEトレーニングには、Unsloth Notebookをお試しください：

| [**gpt-oss（20b）**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-Fine-tuning.ipynb) **（無料）** | [Qwen3-30B-A3B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_MoE.ipynb) （A100）                               | [GLM-4.7-Flash](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/GLM_Flash_A100\(80GB\).ipynb) （A100） |
| ---------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------ |
| [gpt-oss-120b](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(120B\)_A100-Fine-tuning.ipynb) （A100） | [gpt-oss（500Kコンテキスト）](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb) | [TinyQwen3 MoE](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/TinyQwen3_MoE.ipynb) （テスト専用）         |

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FZYAbbmao7vQbKGr7Rtiv%2Fgraph%20results%20only.png?alt=media&amp;token=6cfb4f27-3e78-48d3-b3db-12eb4b3dcde3" alt="" width="563"><figcaption></figcaption></figure>

### 🦥 Unsloth MoE Tritonカーネル

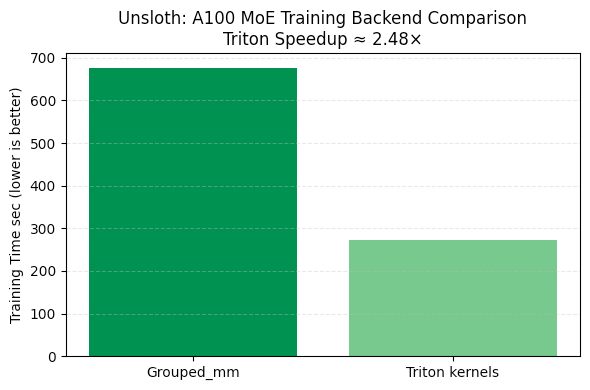
これに加えて `torch._grouped_mm` （参照： [#what-is-torch.\_grouped\_mm](#what-is-torch._grouped_mm "mention")）、独自のTriton MoEカーネルを作成しました。これは一部のケースでさらに高速です。また、 **後方互換性があります** A100のような旧世代ハードウェアや、古いPyTorchバージョンにも対応しています。

{% columns %}
{% column width="50%" %}
A100では、当社の **Tritonカーネルは約2.5倍高速です** よりも `torch._grouped_mm`。カーネルには、最適なカーネル設定を選ぶための一度限りの自動チューニング手順もあります。

自動チューニングはトレーニング開始時に一度だけ約2分かかりますが、A100では `_grouped_mm`と比較して実行全体を35%高速化できるため、長時間の実行では十分に価値があります。
{% endcolumn %}

{% column width="50%" %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F5COXvwLZwdY61BhFvjnI%2Funknown.png?alt=media&amp;token=59f07dcc-cb11-47d4-bacc-ec27e7454f19" alt="" width="295"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% hint style="success" %}
モデルが大きく、使用するコンテキストが長いほど、 **Unslothカーネルによるメモリ削減効果はより顕著になります** （効率は指数的にスケールします）。
{% endhint %}

### :compass: バックエンドの自動選択

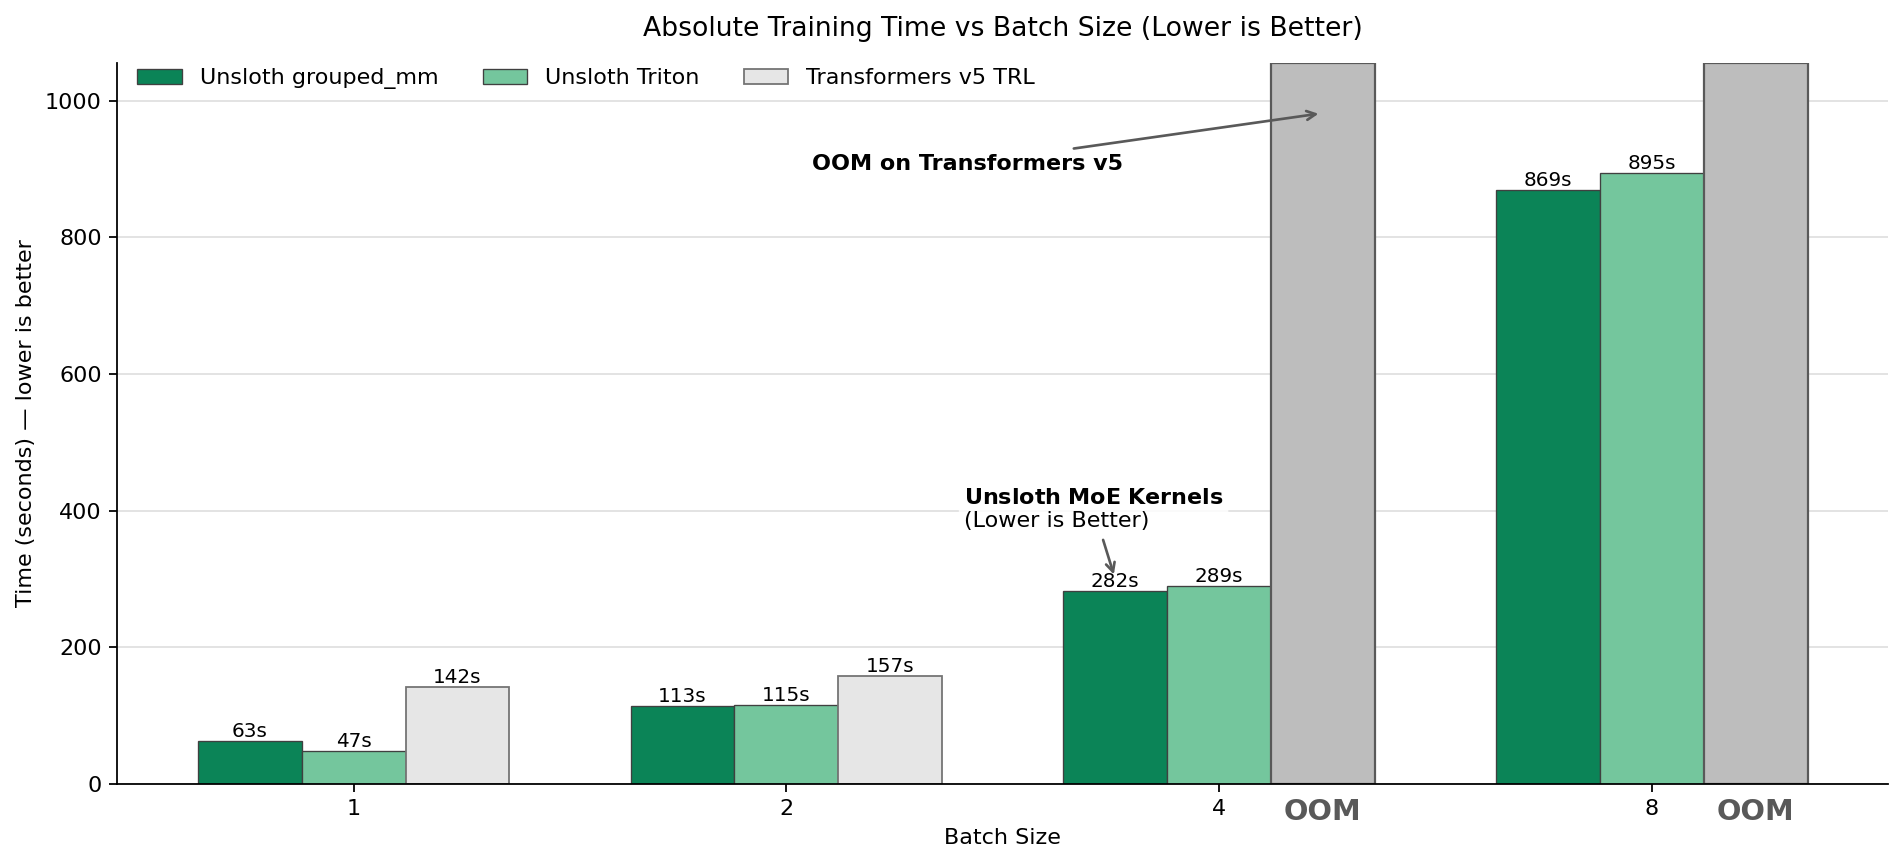
当社の主な革新は、 **Split LoRAアプローチ** です。これは効率的なMoE向けで、Transformers v5 + `torch._grouped_mm`と比較して、メモリ使用量を約35%削減し、トレーニングを2倍高速化します。独自の `torch._grouped_mm` + 当社のTritonカーネルは、Transformers v4より約12～30倍高速です。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKHbKsPvtiK06Uogklven%2Fnicer_training_time_vs_batch_final_tweaks6_bold.png?alt=media&amp;token=448853ff-b760-46ad-8e9b-599c6862762b" alt="" width="563"><figcaption></figcaption></figure>

{% hint style="warning" %}
MoEモデルを **4ビット** QLoRAでトレーニングすることは現在推奨されません。BitsandBytesがそれをサポートしていないためです。これはUnsloth固有の問題ではありません。現時点では、LoRAまたは完全ファインチューニングにはbf16を使用してください。
{% endhint %}

Unslothはハードウェアに応じて、次のいずれかのバックエンドを自動選択します：

<table><thead><tr><th width="144.95001220703125">バックエンド</th><th>最適化</th></tr></thead><tbody><tr><td>grouped_mm</td><td><code>torch._grouped_mm</code> - T4からB200までで利用できますが、H100以降向けに最適化されています。</td></tr><tr><td>unsloth_triton</td><td>Unsloth Tritonカーネル - A100および古いPyTorchバージョンでは自動的に有効になります。</td></tr><tr><td>native_torch</td><td>ネイティブPyTorch。12倍遅いですが、VRAM削減効果は引き続き得られます！</td></tr></tbody></table>

自分で切り替えることもできます：

```python
os.environ["UNSLOTH_MOE_BACKEND"] = "grouped_mm"
os.environ["UNSLOTH_MOE_BACKEND"] = "unsloth_triton"
os.environ["UNSLOTH_MOE_BACKEND"] = "native_torch"
```

{% hint style="success" %}
より高速なMoEトレーニングを有効にするには、次の方法でUnslothを更新してください： `pip install --upgrade unsloth unsloth_zoo`
{% endhint %}

### ❓torch.\_grouped\_mmとは？

これまで、Mixture-of-Experts（MoE）の重みは、 `ModuleList` として、エキスパートごとの線形層に格納されていました。フォワードパスを実行する唯一の実用的な方法は、エキスパートに対するforループであり、コストが高く最適ではありませんでした。

```python
for expert_idx in expert_hit:
    expert_idx = expert_idx[0]
    if expert_idx == num_experts: continue
    _, token_idx = torch.where(expert_mask[expert_idx])
    current_state = hidden_states[token_idx]
    gate, up = nn.functional.linear(current_state, self.gate_up_proj[expert_idx]).chunk(2, dim=-1)
```

PyTorchは最近、 [`grouped_mm`](https://docs.pytorch.org/docs/main/generated/torch.nn.functional.grouped_mm.html) を導入し、このボトルネックに対処しました。同時に、当社独自のMoE最適化Tritonカーネルも提供しています。これはTransformersの重要な変更とも一致します。Transformers v5以降、エキスパートの重みは [`単一のnn.Parameter`](https://github.com/huggingface/transformers/blob/v5.0.0/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L226)として保存されるため、 `grouped_mm` が、より高速なMoEトレーニングと推論に自然に適合します。

そのため、 [transformers 4.57.6](https://github.com/huggingface/transformers/blob/v4.57.6/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L222) は次のように変更されました：

{% code overflow="wrap" %}

```python
self.experts = nn.ModuleList(
    [Qwen3MoeMLP(config, intermediate_size) for _ in range(self.num_experts)]
)
```

{% endcode %}

を [transformers 5.0.0](https://github.com/huggingface/transformers/blob/v5.0.0/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L226) スタイル：

{% code overflow="wrap" %}

```python
self.gate_up_proj = nn.Parameter(torch.empty(num_experts, 2 * intermediate_dim, hidden_dim))
```

{% endcode %}

`torch._grouped_mm` はNVIDIA T4以降のGPUで動作し、H100、A100、B200、RTX 6000 Proで検証済みのため、幅広くサポートされています。

また以前に、Unslothの [Flex Attention](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) をgpt-oss向けに導入しており、これらの最適化によりさらに効率的になるはずです。

## 📊 カーネル結果 + ベンチマーク

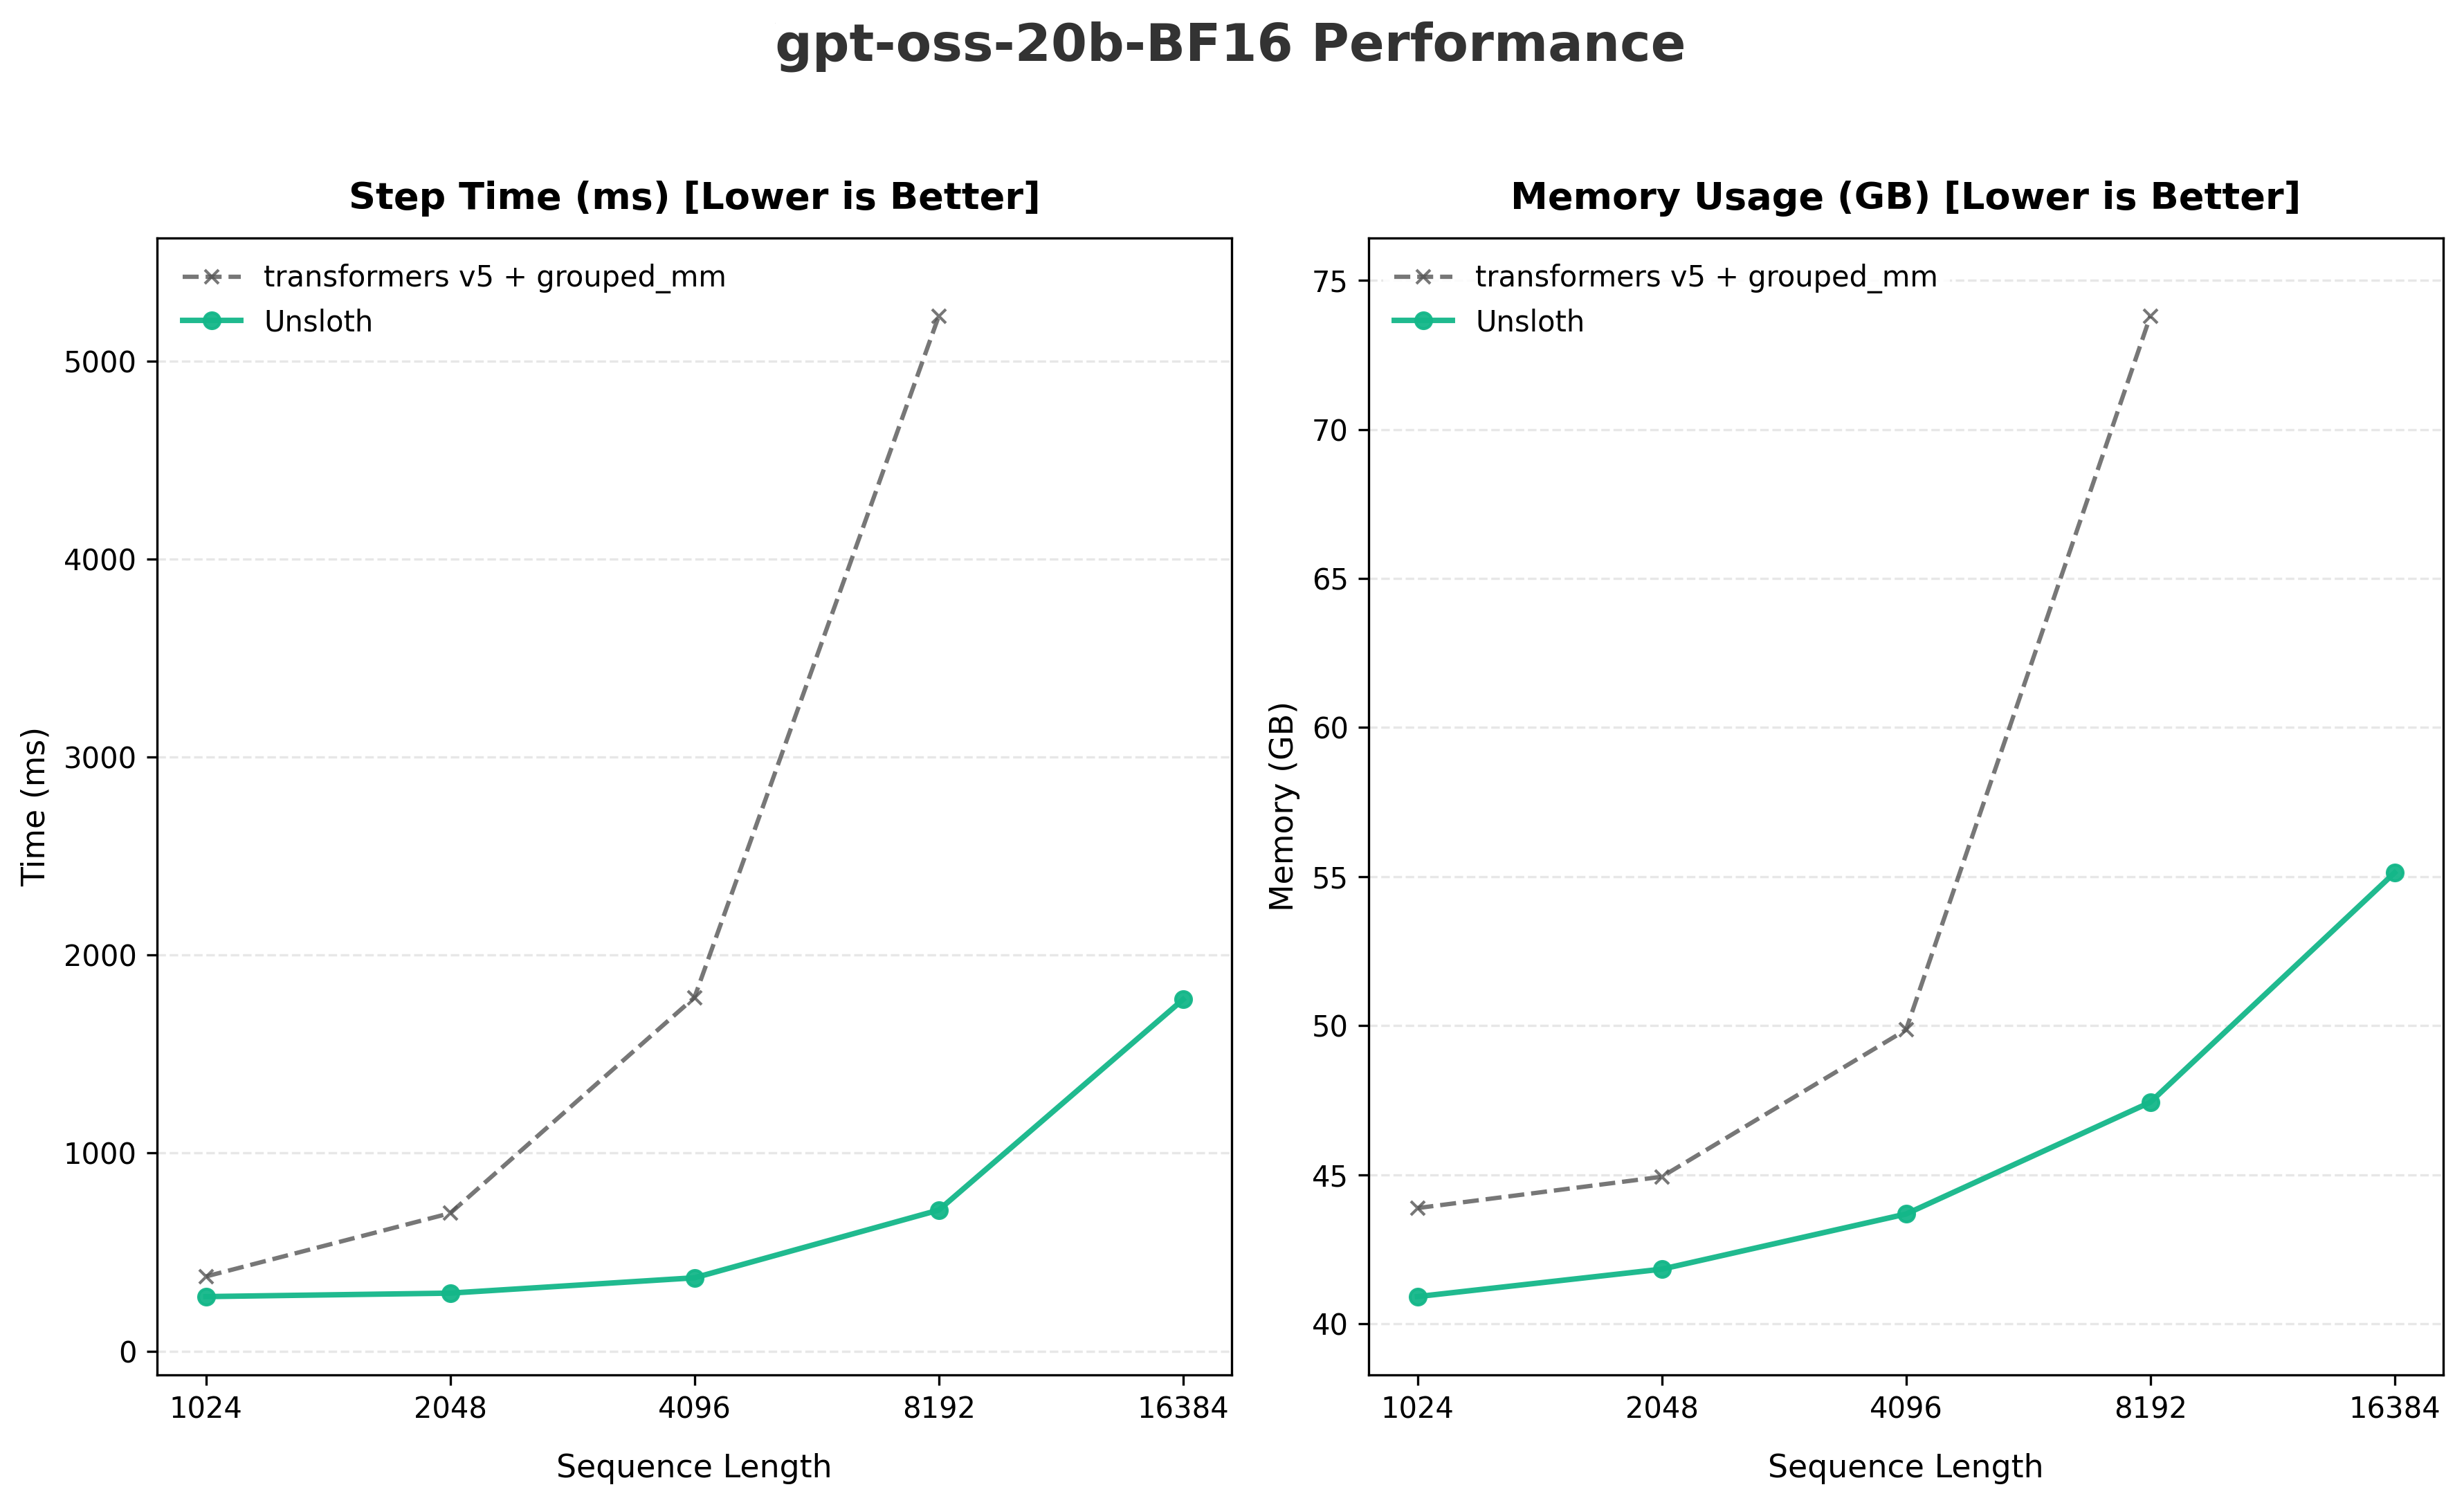
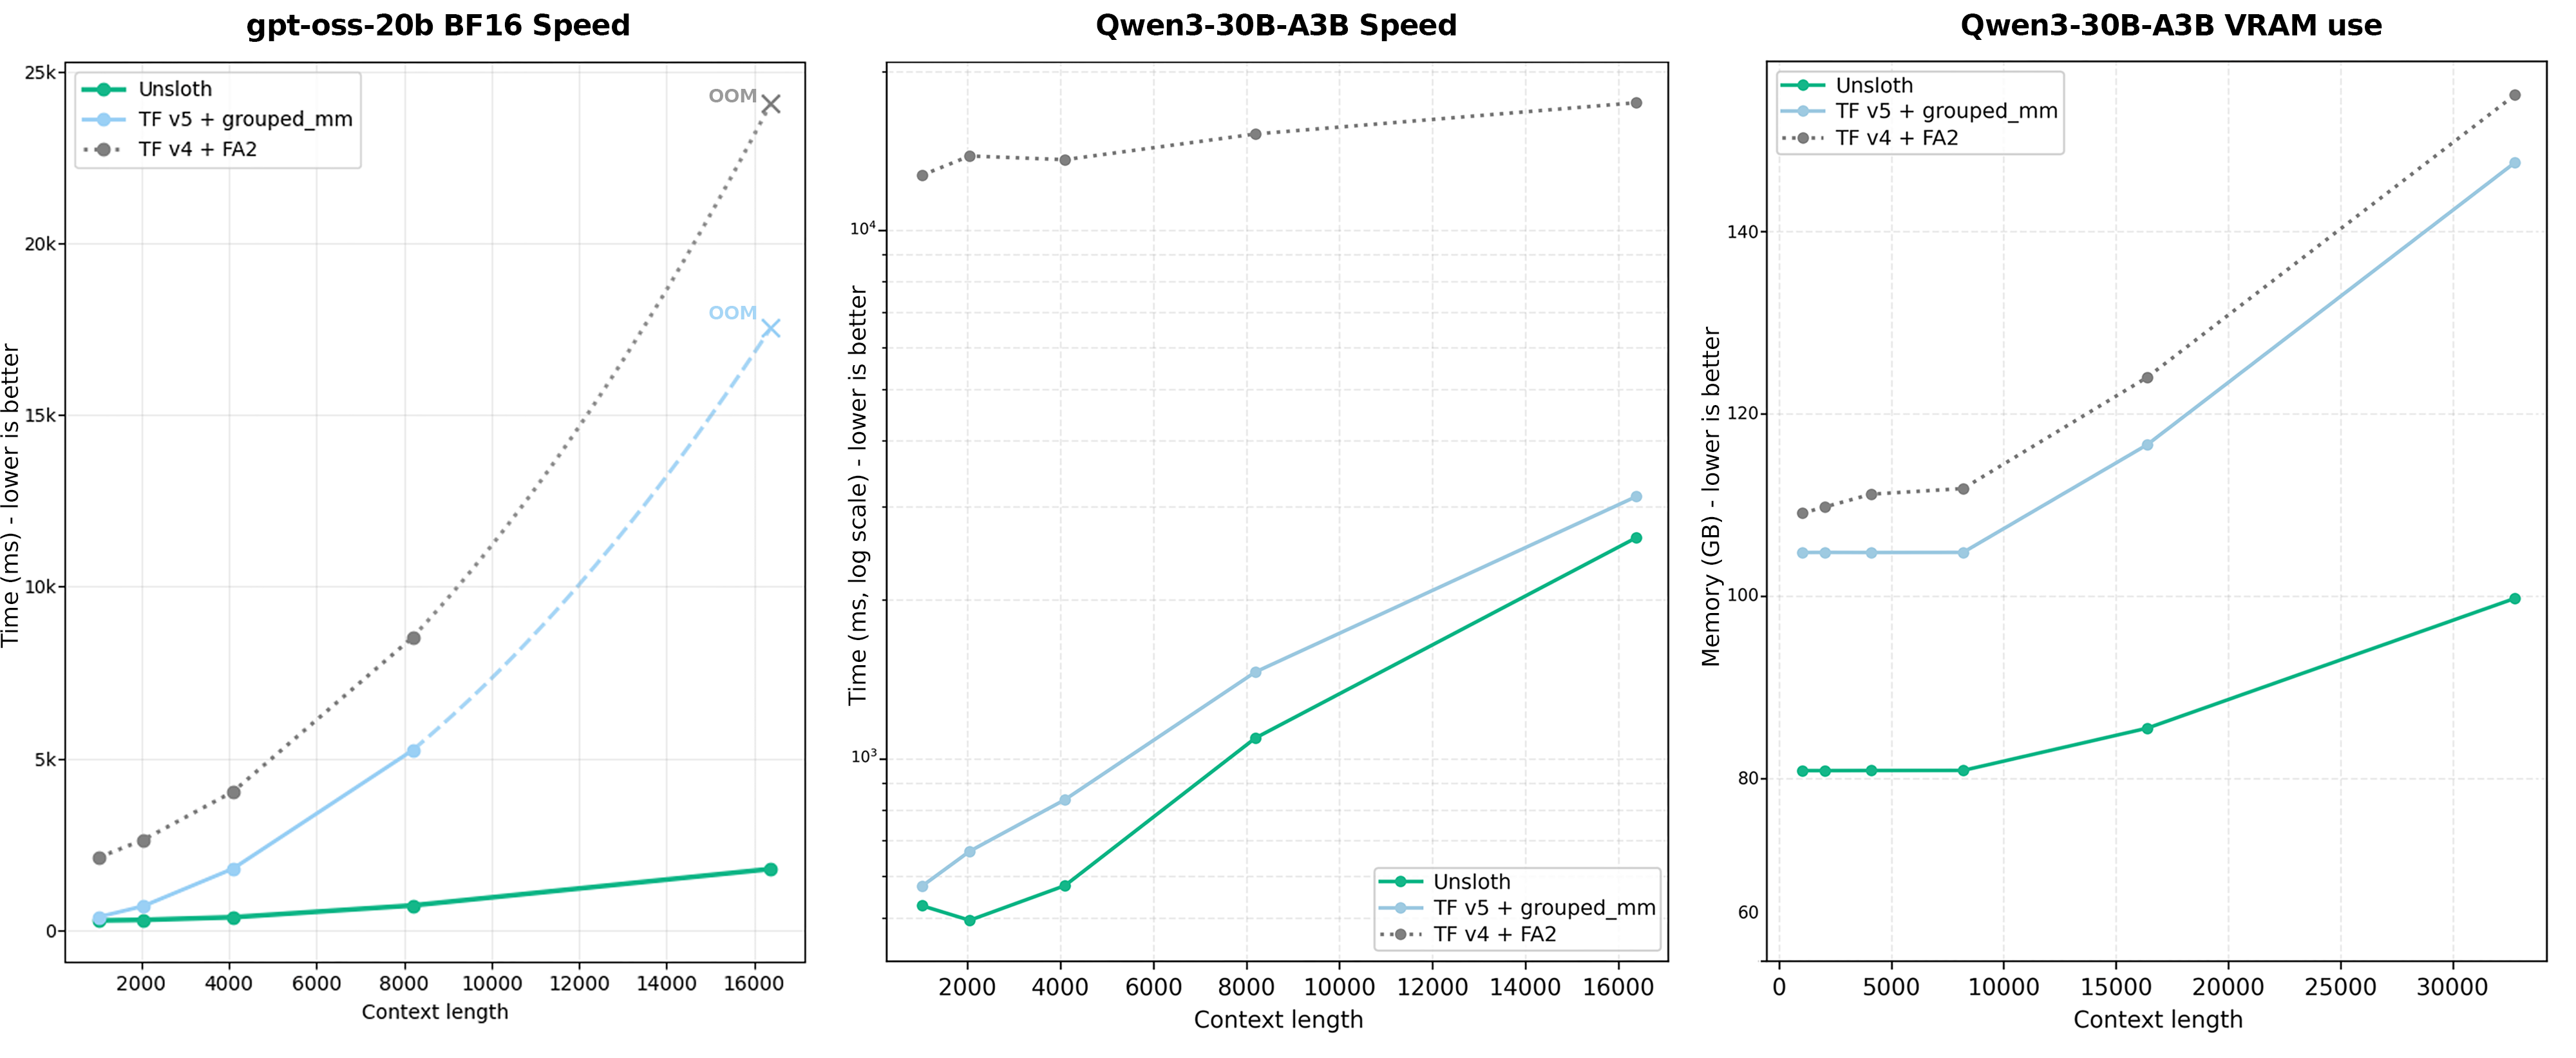
以下は、Transformers v5（すでにMoEに `torch._grouped_mm` を使用）と比較した、シーケンス長ごとのトレーニング速度およびメモリ使用量です。 **gpt-oss BF16 MoEトレーニングでは、7倍高速なトレーニングと36%のVRAM削減** をNVIDIA B200で確認しています。Qwen3-30B-A3Bでは1.8倍高速であり、 **GLM 4.7 FlashはRTX PRO 6000で2.1倍高速です**。すべてのベンチマークは、LoRA rank = 64、かつすべてのLoRAモジュールをMoE層（gate、up、down）に適用して実施しています。

### gpt-ossベンチマーク

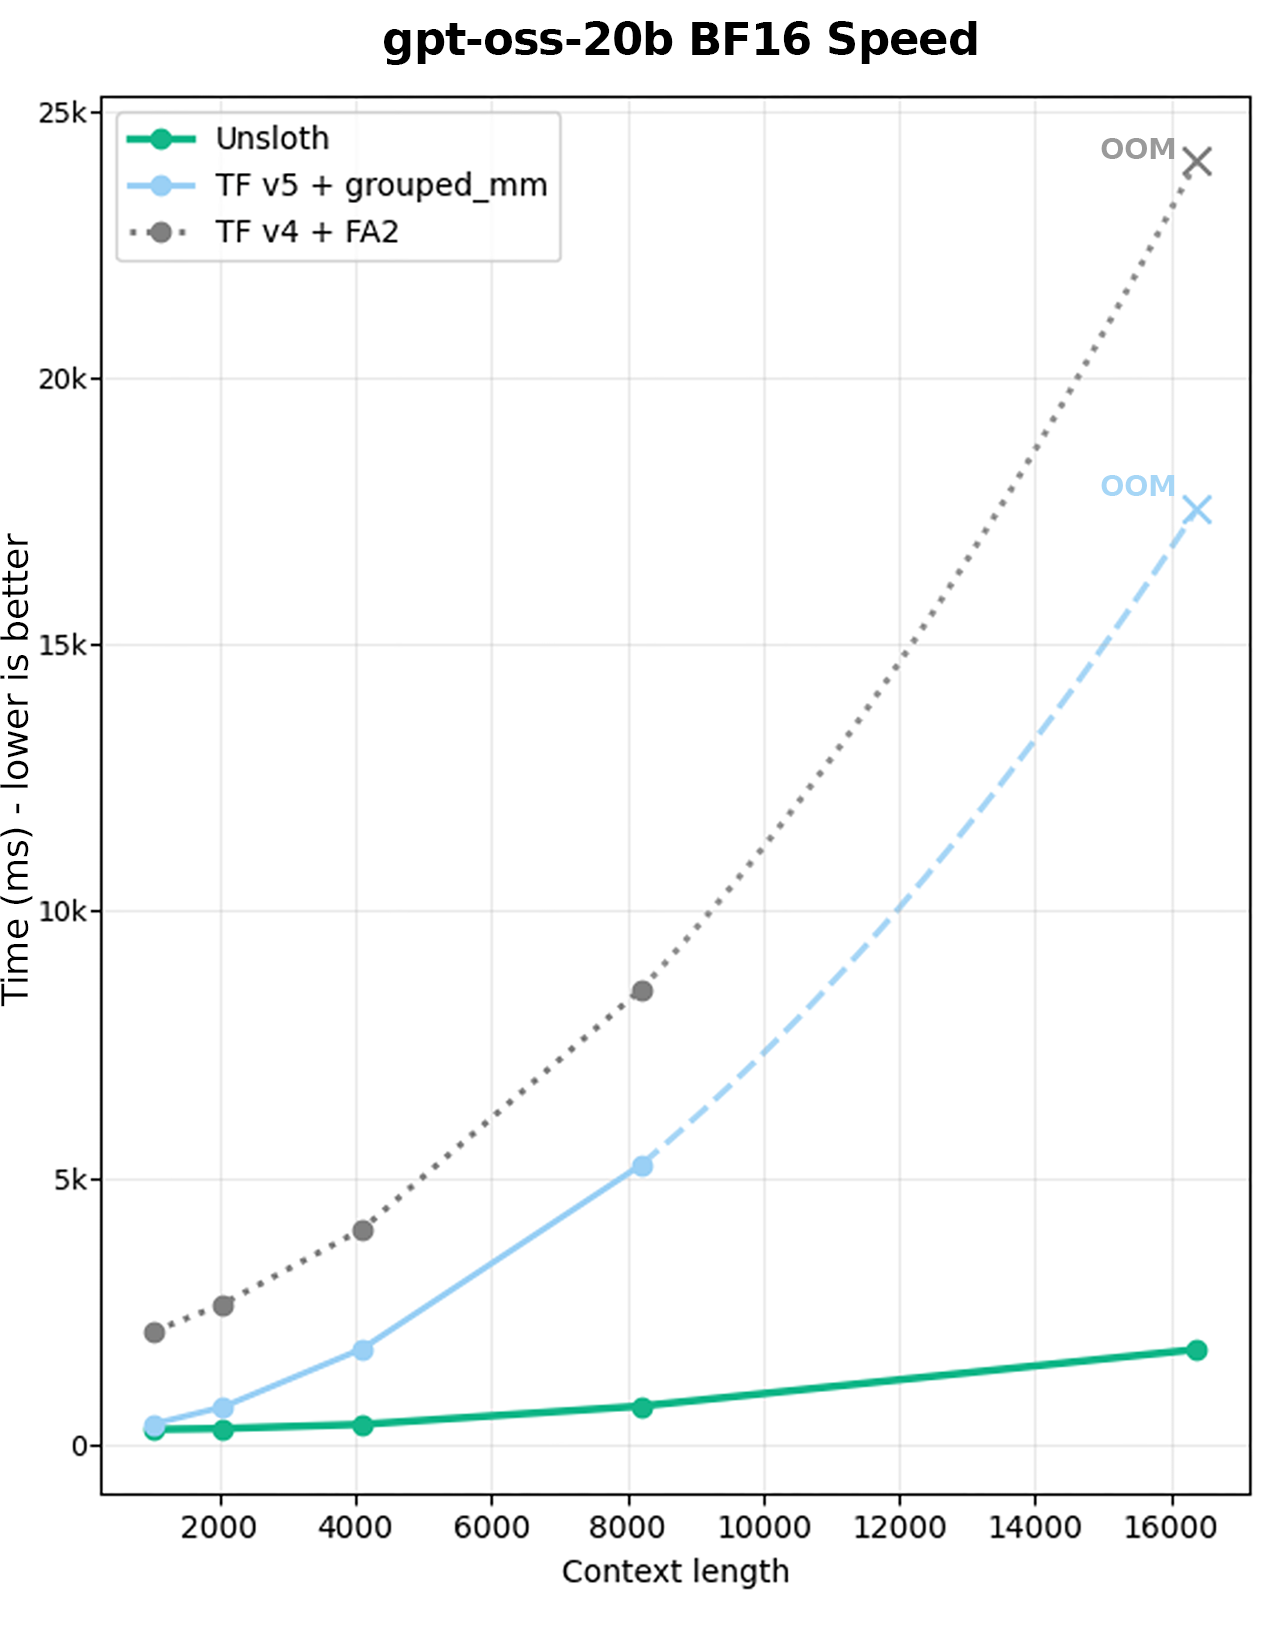
ベンチマーク用に、 [unsloth/gpt-oss-20b-BF16](https://huggingface.co/unsloth/gpt-oss-20b-BF16) をファインチューニングしました。Unslothは16Kコンテキスト長で7倍高速、VRAM使用量は36%少なくなります。Transformers v5 + TRLはメモリ不足になりますが、Unslothはなりません。また、このケースでは当社の [Long Context gpt-oss](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#unsloths-flex-attention-implementation)とMoEカーネルにより、シーケンス長に応じて高速化の度合いが増します。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fja0OUMPoIM4KrWJPJyas%2Fgptoss%20new.png?alt=media&amp;token=29205c0e-a3c9-4749-8ebc-f8125d49dcf1" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FyZkJp7w21nrlf9JfCYZ0%2Fgptoss%20graph%20only.png?alt=media&amp;token=938e7590-b6a4-48eb-b53f-fdaa2bb2581c" alt="" width="188"><figcaption><p>transformers v4との比較</p></figcaption></figure></div>

<table data-full-width="true"><thead><tr><th>コンテキスト長</th><th>Unsloth（ms）</th><th>TF v5（ms）</th><th>Unslothメモリ（GB）</th><th>TF v5メモリ（GB）</th><th>高速化</th><th>VRAM削減</th><th data-hidden>ランク</th><th data-hidden>Unslothウォームアップ（ms）</th><th data-hidden>TRLウォームアップ（ms）</th></tr></thead><tbody><tr><td>1024</td><td>275.35</td><td>376.99</td><td>40.91</td><td>43.88</td><td>1.4倍</td><td>6.76%</td><td>8</td><td>2601.17</td><td>615.62</td></tr><tr><td>2048</td><td>292.88</td><td>696.57</td><td>41.83</td><td>44.93</td><td>2.4倍</td><td>6.89%</td><td>8</td><td>4996.62</td><td>928.42</td></tr><tr><td>4096</td><td>370.30</td><td>1785.89</td><td>43.68</td><td>49.86</td><td>4.8倍</td><td>12.39%</td><td>8</td><td>6648.94</td><td>2130.33</td></tr><tr><td>8192</td><td>712.33</td><td>5226.86</td><td>47.43</td><td>73.80</td><td>7.3倍</td><td>35.73%</td><td>8</td><td>9632.44</td><td>5472.66</td></tr><tr><td>16384</td><td>1775.80</td><td><strong>OOM</strong></td><td>55.13</td><td><strong>OOM</strong></td><td>該当なし</td><td>該当なし</td><td>8</td><td>12696.26</td><td>該当なし</td></tr></tbody></table>

### Qwen3ベンチマーク

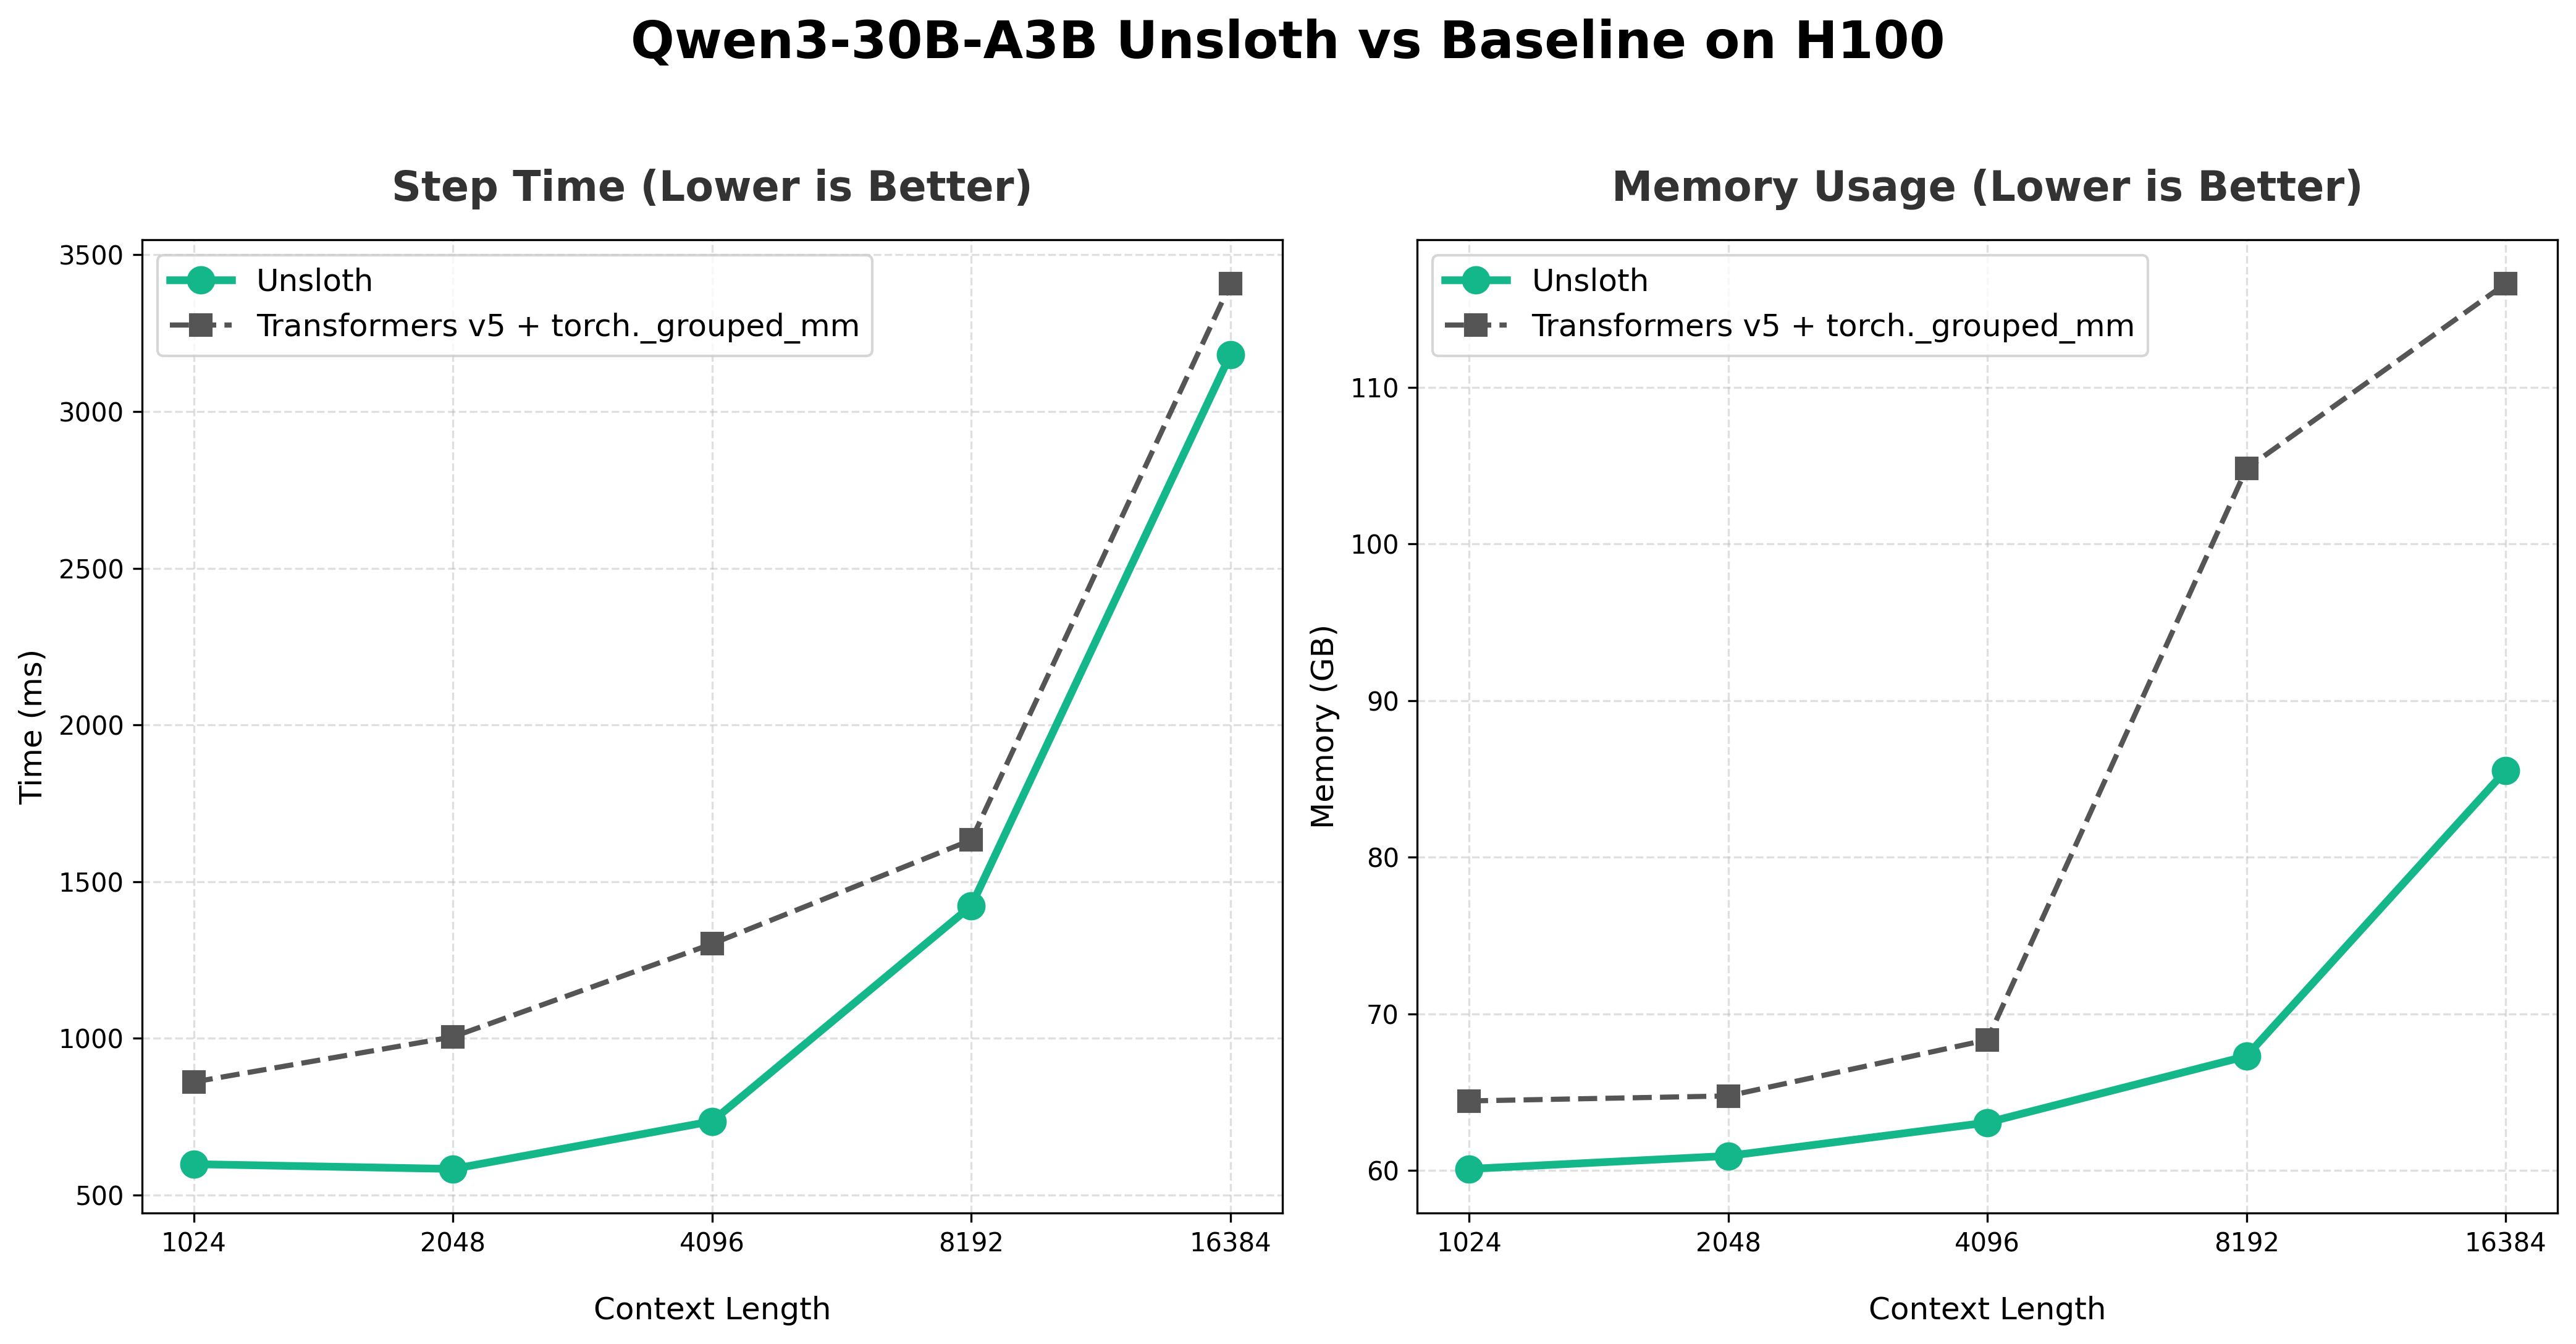
ある **NVIDIA B200**では、次の結果が得られます： **Qwen3-30B-A3B LoRAで約1.7倍高速化、メモリ効率が約35%向上**。また、シーケンス長が長くなるほどメモリ削減効果もさらに向上します。

Qwen3-NextとCoderは、bf16 LoRAなら驚くべきことに単一のB200 GPUに収まります。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FonHXIql0XhGkLIDnuTfv%2Fimage.png?alt=media&amp;token=06f97769-1d0e-4edb-b9c5-6c305376c6e8" alt="" width="563"><figcaption></figcaption></figure>

H100 GPUでは、ベースラインを大幅に上回り、最大で **1.77倍高速化** されたトレーニングを実現するとともに、4Kコンテキスト長でのファインチューニング時には約5.3GBを削減します。8192コンテキスト長にもシームレスにスケールしますが、Transformers v5 + TRLは8KでOOMになります。8Kにおける当社のメモリ使用量は、ベースラインの4K時より少ないため、コンテキスト長をさらに伸ばせます。

<table data-full-width="true"><thead><tr><th>コンテキスト長</th><th>Unsloth（ms）</th><th>TF v5（ms）</th><th>Unslothメモリ（GB）</th><th>TF v5メモリ（GB）</th><th>高速化</th><th>VRAM削減</th><th data-hidden>ランク</th></tr></thead><tbody><tr><td>1024</td><td>366.3</td><td>628.3</td><td>80.88</td><td>104.80</td><td>1.7倍</td><td>2.06%</td><td>8</td></tr><tr><td>2048</td><td>467.0</td><td>745.3</td><td>80.88</td><td>104.81</td><td>1.6倍</td><td>2.57%</td><td>8</td></tr><tr><td>4096</td><td>711.6</td><td>975.5</td><td>80.89</td><td>104.80</td><td>1.4倍</td><td>5.08%</td><td>8</td></tr><tr><td>8192</td><td>1376.6</td><td>1633.5</td><td>80.90</td><td>104.81</td><td>1.2倍</td><td>9.17%</td><td>8</td></tr><tr><td>16384</td><td>3182.2</td><td>3407.9</td><td>85.53</td><td>116.61</td><td>1.1倍</td><td>15.26%</td><td>8</td></tr></tbody></table>

### GLM 4.7ベンチマーク

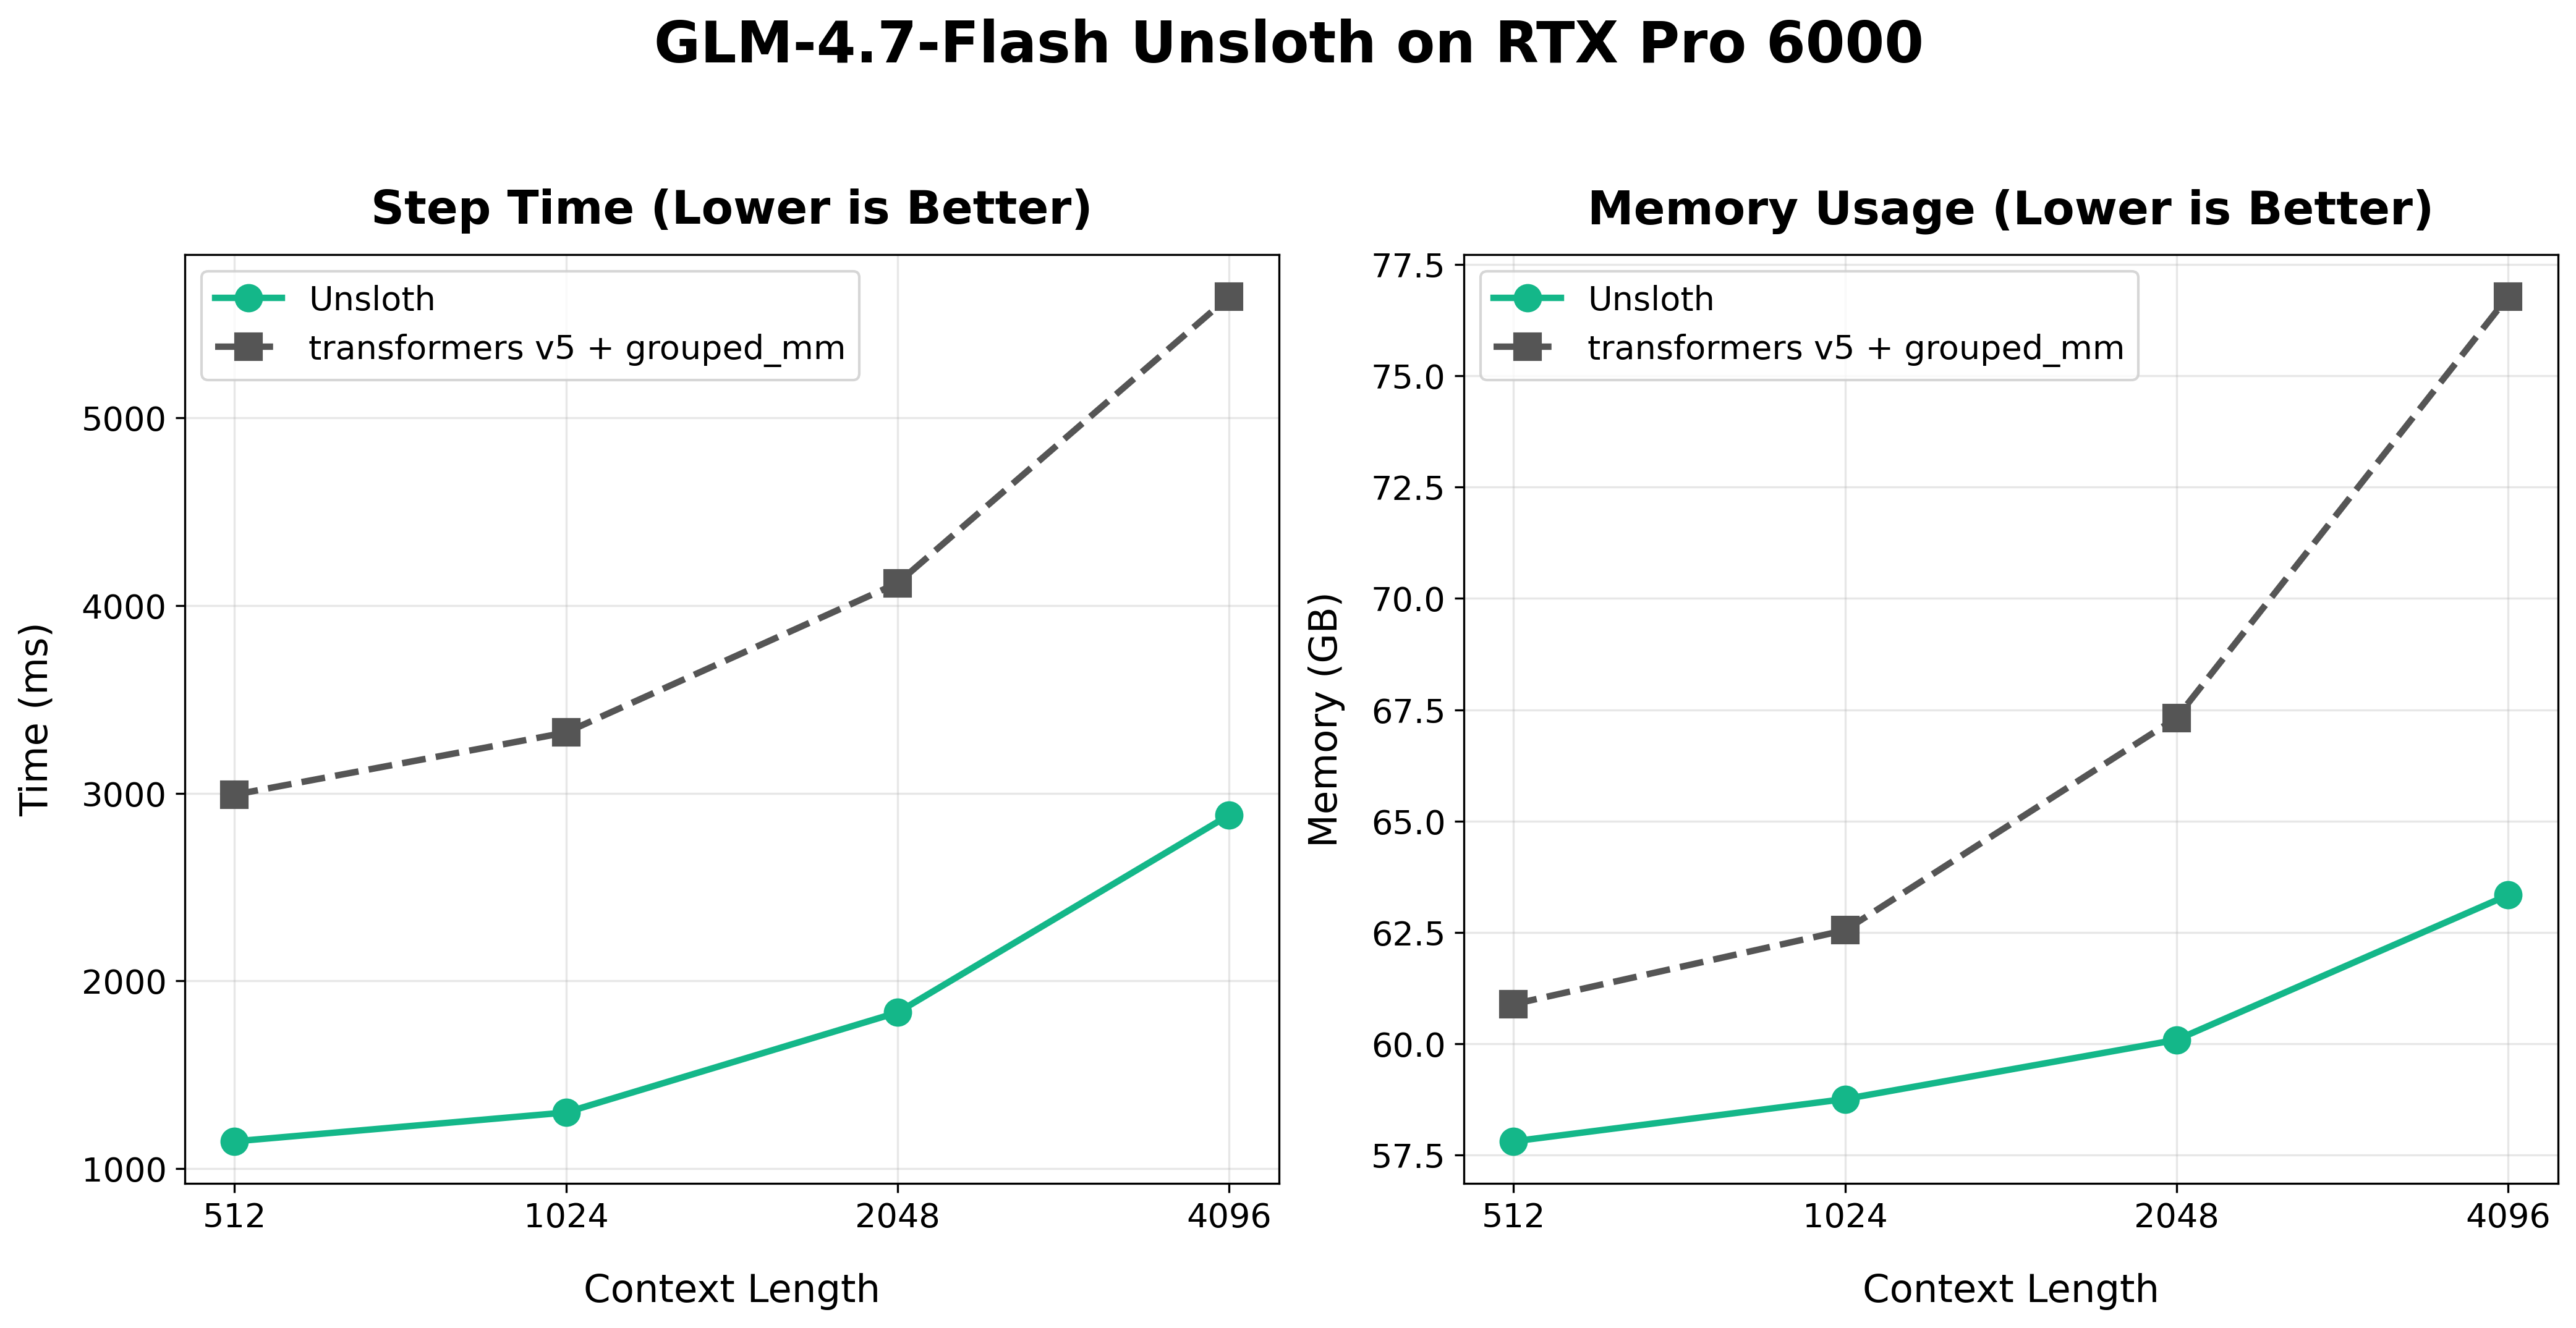
Unslothは、 **15%以上少ないVRAMで2.6倍高速なスループット** をGLM 4.7 Flashの全バッチサイズで達成します。GLM 4.7 Flashは、30BのMoE（アクティブパラメータ3B）のエージェント・コーディングモデルで、64のルーティングエキスパートと1つの共有エキスパートを備え、DeepSeek MoEスタイルに類似した構成を採用しています。UnslothのMoEトレーニングを、新たに最適化されたTransformers v5と比較してベンチマークしました。

以下のGLM 4.7 Flash向け新しいColabノートブックを使用してください：

{% embed url="<https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/GLM_Flash_A100(80GB).ipynb>" %}
GLM 4.7 Flash MoEノートブック A100 80GB
{% endembed %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FbocwTistkljiMxGUA02y%2Fimage.png?alt=media&amp;token=2a804b3a-44e4-4666-aa4f-ba6a31f69f39" alt="" width="563"><figcaption></figcaption></figure>

<table data-full-width="true"><thead><tr><th>コンテキスト長</th><th>Unsloth（ms）</th><th>TF v5（ms）</th><th>Unslothメモリ（GB）</th><th>TF v5メモリ（GB）</th><th>高速化</th><th>VRAM削減</th><th data-hidden>ランク</th><th data-hidden>Unslothウォームアップ（ms）</th><th data-hidden>TRLウォームアップ（ms）</th></tr></thead><tbody><tr><td><p></p><p>512</p></td><td>1145.0</td><td>2992.1</td><td>57.81</td><td>60.89</td><td>2.6倍</td><td>6.51%</td><td>8</td><td>13317.46</td><td>893.04</td></tr><tr><td>1024</td><td>1298.9</td><td>3323.3</td><td>58.76</td><td>62.55</td><td>2.6倍</td><td>6.22%</td><td>8</td><td>12895.28</td><td>937.37</td></tr><tr><td>2048</td><td>1831.9</td><td>4119.3</td><td>60.09</td><td>67.32</td><td>2.3倍</td><td>9.46%</td><td>8</td><td>12531.37</td><td>1039.45</td></tr><tr><td>4096</td><td>2883.9</td><td>5646.1</td><td>63.34</td><td>76.78</td><td>2倍</td><td>14.83%</td><td>8</td><td>7671.60</td><td>1643.26</td></tr></tbody></table>

### ⚡高速なLoRA MoEトレーニング

Transformers/PEFTでは、通常のアプローチは **LoRAアダプターをベースの重みにマージすること** であり、その後MoE計算を実行します（特にMoEではしばしば `nn.Parameter` の代わりに `nn.Linear`が使われるためです）。問題は、このマージによって実質的に **LoRAデルタ（全エキスパート分）を実体化する** `lora_B @ lora_A.t`ことになり、これは **非常にメモリ消費が大きい**.

ことです。Unslothではこれを回避します。以前、同じアイデアを汎用LoRAトレーニングと推論の最適化に使用しましたが、現在では **MoE + LoRA** にも適用しています。数学は同一なので、損失、勾配、出力は変わりません。変更点は、 **演算順序**のみです。これは行列乗算の結合則によって可能になります。この並べ替えにより、大幅な高速化とメモリ削減を実現します。

{% hint style="warning" %}
MoEモデルを **4ビット** QLoRAでトレーニングすることは現在推奨されません。BitsandBytesがそれをサポートしていないためです。これはUnsloth固有の問題ではありません。現時点では、LoRAまたは完全ファインチューニングにはbf16を使用してください。
{% endhint %}

これらの最適化は、 **デフォルトで有効です** 。UnslothでMoEモデル（特にQwen-3 MoE、gpt-oss、および上述のモデル）をトレーニングする際に適用されます。実装は、 `UNSLOTH_MOE_BACKEND` 環境変数で切り替えられます。以下のいずれかです： `torch._grouped_mm` **Tritonカーネル** または **基本的なPyTorch forループ**。互換性と好みに応じて選択できます。デフォルトでは、 `grouped_mm` を使用し、最高の性能と幅広いサポートを提供します。

```python
import os
# 別のバックエンドを選択する場合（デフォルトはgrouped_mm）、以下の変数を設定してください：
# os.environ['UNSLOTH_MOE_BACKEND'] = 'unsloth_triton' # または grouped_mm あるいは native_torch
lora_rank = 16
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "Qwen/Qwen3-30B-A3B-Instruct-2507", #MoEモデル
    max_seq_length = max_seq_length,
    load_in_4bit = False, # MoE nn.Parameterはまだbnb 4bitをサポートしていません
)
model = FastLanguageModel.get_peft_model(
    model,
    r = lora_rank,
    target_modules = [
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_up_proj", "down_proj", # MoE層にLoRAを適用！
    ],
    lora_alpha = lora_rank*2, # *2でトレーニングを高速化
    use_gradient_checkpointing = "unsloth", # メモリ使用量を削減
    random_state = 3407,
)
```

## 📚 実装の詳細

LoRAはパラメータ効率の高いファインチューニング手法です。重み行列全体を更新する代わりに、はるかに少ないパラメータからなる低ランクの「アダプター」をトレーニングすることで、オプティマイザのメモリ使用量を大幅に削減します。

元の重みの形状が **(m, n)**&#x306E;場合、LoRAは次の形状を持つ2つの学習可能行列を追加します： **(m, r)** そして **(r, n)**。これらの積は **(m, n)**&#x3067;すが、オプティマイザ状態と勾配を追跡するのは次のみです：

* `m*r + r*n` 個のパラメータ（LoRA）。
* `m*n` 個のパラメータ（完全ファインチューニング）の代わりです。

{% hint style="info" %}
MoEのファインチューニングでは、ルーター層をファインチューニングするのは良い考えではないため、デフォルトで無効にしています。
{% endhint %}

一般的なMLP層では、 `m ≈ 4096、n ≈ 12k、r ≈ 64`の場合、おおよそ **約100万のLoRAパラメータに対して約4,800万の完全パラメータです -** およそ **\~2%,** 多くの場合、精度の低下は最小限またはありません。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FogBmpbd8eAirmDJaDCMl%2FLoRA%20Image?alt=media&amp;token=ce533f2c-ad6a-4cca-8588-fe0f548f8bae" alt="" width="255"><figcaption></figcaption></figure>

#### MoE LoRAでは状況が変わります

MoE層は、 **E個のエキスパートMLPが並列にある**ため異なります。そのため、LoRAの追加のようなエキスパートごとの変更は、すべてのエキスパートにわたってスケールします。

次を例に取ります： **Qwen3-30B-A3B**：隠れ層サイズは **m=2048**、中間サイズは **n=768**, **E=128** 個のエキスパートがあり、 **k=8** 個がトークンごとにアクティブ化されます。エキスパートごとに：

* `gate_proj` そして `up_proj`: `(m, n) = (2048, 768)`
* `down_proj`: `(n, m) = (768, 2048)`

〜を使えば **LoRAランク r=64**では、各射影に追加されるのは `r*(m+n)=64*(2048+768)=180,224` 個のエキスパートあたりのパラメータ（約 `11%` ある `2048×768` 行列の）です。中心的な問題は、 `r/n = 64/768` が一般的なMLP設定と比べて大きいことです。例えば、 `r/n = 64/25600` を [Qwen3-32B](https://huggingface.co/Qwen/Qwen3-32B/blob/main/config.json#L13) の同程度のサイズのものと比較するとです。

これを *すべての* エキスパートに対して実体化すると、メモリ使用量はすぐに積み上がります。また、 `gate_proj` そして `up_proj` はしばしば次として融合されます： `gate_up_proj`。そのため通常は両方をまとめて実体化することになり、オーバーヘッド／ピークメモリはおおよそ2倍になります。

**メモリの観点では、シーケンス長s、E個のエキスパート、および `k` 個を選択する場合、両方のアプローチに共通して次のようになります**

```
# これらの値はすべてエキスパートごとの値です
最終出力：(s, n)
入力活性化値：(s, m)
最終出力：(s, n)
```

ここから違いが現れます。peftのアプローチでは、

```
delta = loraA@loraB  = エキスパートごとに(m,n) = Emnパラメータ
```

UnslothのSplit LoRAアプローチでは、次の演算を行います

```
Y = X @ loraA : (s,m) @ (m, r)       # ただしk個のエキスパートに対してスパース = ksrパラメータ
Y @ loraB: (s, r) @ (r, n)           # ただし再びk個のエキスパートに対してスパース = ksnパラメータ
```

では、Qwen3-30B-A3Bの場合を考えてみましょう。

`E = 128、k = 8、m = 2048、n = 768。` これらをすべて代入すると、 `s < 32K。`&#x20;

$$
\begin{aligned}
\text{PEFT params}                       &:\quad Emn \\
\text{Unsloth Split LoRA params}         &:\quad ks(r+n) \\
\text{In typical LoRA we have}           &:\quad r \ll n \\
\text{Split LoRA is better when}         &:\quad Emn > ksn ;=; Em > ks \\
\\
\text{For Qwen3-30B-A3B, we have} \\
E &= 128, \quad k = 8, \quad m = 2048, \quad n = 768 \\
\\
\text{So, Split LoRA is mathematically better when} \\
s &< \frac{Emn}{kn} = 32K
\end{aligned}
$$

**計算量の観点では、シーケンス長、 `ズ`, `E` 個のエキスパート、およびtop `k` 個を選択した場合、次を実行します：**

$$
\begin{aligned}
\Delta = AB,
A \in \mathbb{R}^{m \times r}, ;
B \in \mathbb{R}^{r \times n}
&\quad \Rightarrow \quad 2mnr \text{ flops per expert lora} \\
\\
W' = W + \Delta
\quad &\Rightarrow \quad mn \text{ flops} \\
\\
XW'  \quad | \quad
X \in \mathbb{R}^{s \times m}, ;
W' \in \mathbb{R}^{m \times n}
\quad &\Rightarrow \quad 2smn \text{ flops} \\
\\
\text{MoE peft lora flops}
&= E\big(2mnr + mn\big)

* 2k,smn
  \end{aligned}
  $$

前述したUnsloth Split LoRAの場合、次のようになります

$$
\begin{aligned}
XW &= 2smn  \text{  flops} \\
Y = XA, &= 2smr
\quad \text{(applied only to routed token--expert pairs)} \\
\
Z = YB &= 2srn \\
\text{MoE split lora flops}
&= 2k\big(smn + smr + srn\big) \\
\text{Crossover condition}
&:\quad 2ksr(m+n) > 2Emn(r+1/2)
\Rightarrow
s > \frac{Emn}{k(m+n)} \times (1+ \frac{1}{2r}) \\
\\
\text{For Qwen3-30B-A3B with}
&:
E = 128,;
m = 2048,;
n = 768,;
k = 8 \\
\\
\Rightarrow \quad
s
& ;\approx; 16\text{K tokens}
\end{aligned}
$$

解析的観点でSplit LoRAがより優れている限界点は、 `s > Emn/k(m+n)` であり、これはおおよそ `16K` トークンです（Qwen3-30B-A3Bスタイルのモデルの場合）。

最後に、高速化の一部は、 **メモリトラフィックの削減**によるものです。現代のGPUはしばしば **帯域幅制約**であるため、FLOPsよりも転送データ量を減らす方が重要な場合があります。高速化の概算は、 `Emn / [k·s·(m+n)]`であるため、 **s、E、k**と行列の形状に大きく依存します。

### 🔮 モデル対応

Unslothは、Qwen、gpt-oss、DeepSeek、GLMモデルのより高速なMoEトレーニングをサポートしています：

* **Qwen3** （ThinkingおよびInstruct）：VL • 2507 • Coder&#x20;
* **gpt-oss**：20B • 120B • safeguard
* **GLM**：4.5 • 4.6 • 4.6-Air • 4.7 • 4.7-Flash
* **DeepSeek**：V3 • R1 • V3.1 • V3.2

一部のMoEモデルはアップロードしていない可能性がありますが、Unslothは引き続きそれらをサポートするはずです。

### 📈 さらに多くのベンチマーク

#### gpt-oss BF16ベンチマーク

Transformers v4との比較を含むトレーニング速度

<table data-full-width="false"><thead><tr><th align="right">コンテキスト長</th><th align="right">Unsloth（ms）</th><th align="right">TF v5（ms）</th><th align="right">TF v4（ms）</th><th align="right">高速化</th></tr></thead><tbody><tr><td align="right">1024</td><td align="right">275.35</td><td align="right">376.99</td><td align="right">2111.18</td><td align="right">1.37倍</td></tr><tr><td align="right">2048</td><td align="right">292.88</td><td align="right">696.57</td><td align="right">2626.80</td><td align="right">2.38倍</td></tr><tr><td align="right">4096</td><td align="right">370.30</td><td align="right">1785.89</td><td align="right">4027.93</td><td align="right">4.82倍</td></tr><tr><td align="right">8192</td><td align="right">712.33</td><td align="right">5226.86</td><td align="right">8513.52</td><td align="right">7.34倍</td></tr><tr><td align="right">16384</td><td align="right">1775.80</td><td align="right">OOM</td><td align="right">OOM</td><td align="right">該当なし</td></tr></tbody></table>

**メモリVRAM使用量**

<table data-full-width="false"><thead><tr><th align="right">コンテキスト長</th><th align="right">Unslothメモリ（GB）</th><th align="right">TF v5メモリ（GB）</th><th align="right">TF v4メモリ（GB）</th><th align="right">VRAM削減</th></tr></thead><tbody><tr><td align="right">1024</td><td align="right">40.91</td><td align="right">43.88</td><td align="right">89.75</td><td align="right">6.76%</td></tr><tr><td align="right">2048</td><td align="right">41.83</td><td align="right">44.93</td><td align="right">90.47</td><td align="right">6.89%</td></tr><tr><td align="right">4096</td><td align="right">43.68</td><td align="right">49.86</td><td align="right">92.72</td><td align="right">12.39%</td></tr><tr><td align="right">8192</td><td align="right">47.43</td><td align="right">73.80</td><td align="right">100.3</td><td align="right">35.73%</td></tr><tr><td align="right">16384</td><td align="right">55.13</td><td align="right">OOM</td><td align="right">OOM</td><td align="right">該当なし</td></tr></tbody></table>

## :tada: Unslothの重要アップデート

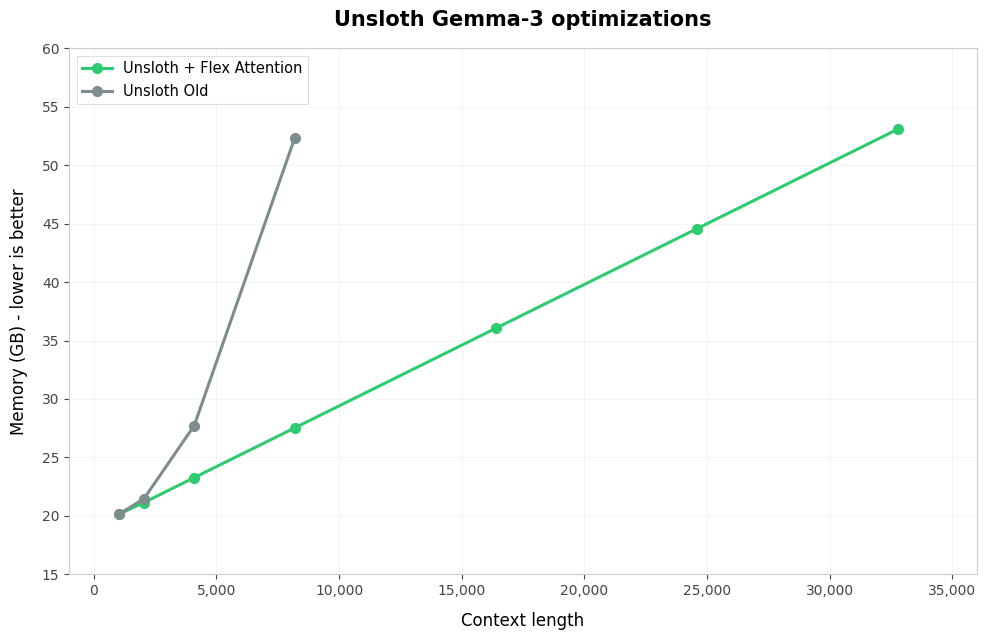
1. MoEリリースの一環として、以下も実施しました： **Gemma-3がFlex-Attentionを使用するように変更** し、これがfloat16設定でもデフォルトで機能するようになりました（以前発生していた無限大値は解決済みです）。 **Gemma-3は現在O(N²)メモリではなくO(N)メモリを使用し、トレーニングも3倍以上高速です** （コンテキスト長に応じてさらに良好にスケールします）。以前のUnslothバージョンではOOMになっていました。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FZiM9zMhVlUaJXC4Y1REp%2Fimage.png?alt=media&amp;token=b2f1d12e-ccdb-431c-9b65-284db3892e2c" alt="" width="375"><figcaption></figcaption></figure>

| コンテキスト | 旧ピークVRAM | 新ピークVRAM | VRAM削減        |
| ------ | -------- | -------- | ------------- |
| 1K     | 20.1 GB  | 20.1 GB  | 0 GB（0%）      |
| 2K     | 21.5 GB  | 21.1 GB  | 0.3 GB（2%）    |
| 4K     | 27.7 GB  | 23.3 GB  | 4.5 GB（16%）   |
| 8K     | 52.3 GB  | 27.5 GB  | 24.8 GB (47%) |
| 16K    | OOM      | 36.0 GB  | --            |
| 24K    | OOM      | 44.6 GB  | --            |
| 32K    | OOM      | 53.1 GB  | --            |
| 48K    | OOM      | 38.4 GB  | --            |
| 64K    | OOM      | 44.7 GB  | --            |

2. Visionのファインチューニングが、画像のみとテキストデータの混在データを受け付けるようになりました！
3. [Windowsが正式にサポートされるようになり、WSLは不要になりました](/docs/jp/meru/install/windows-installation.md).
4. `trl==0.27.1` そして `transformers==5.1.0` 十分にサポートされています - 以前は120個のノートブック全体の30%しかカバーできていませんでしたが、今では80%以上をカバーしています - 今後数日で100%にする予定です。
5. 多数のバグ修正やその他の更新があります - 詳細は <https://github.com/unslothai/unsloth/releases/tag/February-2026>

{% hint style="success" %}
より高速なMoEトレーニングを有効にするには、次の方法でUnslothを更新してください： `pip install --upgrade unsloth unsloth_zoo`
{% endhint %}

### 謝辞

コミュニティのためにMoEトレーニングの改善にご協力いただいたHugging Faceチームに感謝します。

また、torchaoチーム、特にVasily Kuznetsov（vkuzo）には、float16向けのgrouped\_mmサポートを有効化してT4で動作させ、A100との後方互換性も確保できるよう支援してくれたことに、心より感謝します。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/ji-chu/faster-moe.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.