> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs.md).

# Unsloth Dynamic 3.0 GGUF

**Unsloth Dynamic V3.1** （2026年11月）は、Qwen3.8-27B、DeepSeek-V4.1-Flash-1017、Qwen3.8-Flash-Next向けの最新の量子化アルゴリズムです。その結果、 **精度が10～15%向上し、** さらに **トークン使用量を50%削減** できます。同じサイズの他の量子化モデルと比較した場合の結果です。現在、Dynamic量子化モデルのさらなる改良版に取り組んでおり、Qwen4以降のすべてのモデルに適用する予定です。

Unsloth [Qwen3.8-27B](https://unsloth.ai/docs/jp/moderu/qwen3.8.md) Dynamic V3.1はすべての量子化モデルでパレートフロンティアを押し広げ、従来のUD3量子化モデル、Exllama-3、GSQ-RCOを上回ります。

[Qwen3.8-Flash-Next](https://unsloth.ai/docs/jp/moderu/qwen3.8-next.md) 1ビット量子化モデルは、DeepSWE v1.1で54.0%、Terminal Bench 2.1で68.3%を達成しています。

[DeepSeek-V4.1-Flash-1017](https://unsloth.ai/docs/jp/moderu/deepseek-v4.1-flash.md) Dynamic V3.1 IQ1\_Sは、DeepSWE v1.1で65.8%、Terminal Bench 2.1で69.5%、Automation Bench v1.0.6で51.5%を達成しています。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FRHyZ5X7qYZAdCQsgKT7R%2Ffour(1).png?alt=media&amp;token=3c563d60-5767-437a-a704-98fffecb04f8" alt=""><figcaption><p>Qwen3.8-27Bのベンチマーク</p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FXC2NHQCS4KKsMoY4IjpT%2Fimage.png?alt=media&amp;token=67fb9d55-8fbb-4f35-a13f-83465cee8475" alt=""><figcaption><p>DeepSeek-V4.1-Flash-1017のベンチマーク</p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FqdXHweLFGzUhUcqj7jZX%2Ffinal%20key%204.png?alt=media&amp;token=8e3249b1-e26c-4a04-82ba-7cfdef952fe6" alt=""><figcaption><p>Qwen3.8-Flash-Nextのベンチマーク</p></figcaption></figure></div>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWTSMbLLxexSW1HiwU411%2Fqwen%20speed%20token%20con.png?alt=media&amp;token=fea0700d-24e7-4046-a915-4c087e0230aa" alt=""><figcaption><p>Qwen3.8-Flash-Next GGUFのトークン消費量と速度のベンチマーク</p></figcaption></figure>

### Dynamic v3.0

以下に、以前に公開したDynamic v3.0のリリースノートとベンチマークを掲載します。

今回、 [**Qwen3.8-27B**](https://unsloth.ai/docs/jp/moderu/qwen3.8.md) のDynamic v3.0量子化モデルを公開します。これらは、 **同じサイズで、top-1精度が10%以上向上** しており、 **他のすべてのプロバイダー**と比較して優れた結果を示します。これは、最初に共有した **早期プレビュー** 版のDynamic v3.0を更新したものです。新しい3.0 GGUFは、次のようなほとんどの推論エンジンで動作します。 **llama.cpp** および [**Unsloth Desktop**](https://unsloth.ai/docs/jp/desktop.md).

{% columns %}
{% column width="41.66666666666667%" %}
Dynamic v3.0は同じサイズを維持しながら、モデルの品質をより多く保ちます。また、 **Divergence-300** @32や **KL Divergence**.

さらに、皆さまの多大なご支援に心より感謝します。わずか5日間で、Unsloth Qwen3.8のダウンロード数が510万件を超えました！
{% endcolumn %}

{% column width="58.33333333333333%" %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fl9piThTmmUsePst5w3F2%2Fimage.png?alt=media&amp;token=821e88e2-ad4e-40bf-adf2-e13837228e82" alt=""><figcaption><p>以下で、グラフやベンチマーク、分析をご覧ください。</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

新しい手法では、多数の新機能と改善を組み合わせています。さまざまなソースから集めた、より高品質なimatrixキャリブレーションデータセットを使用するようになりました。このデータセットは、 **エージェント型コーディング、チャット**、多言語性能に合わせて調整されています。また、 **レイヤー選択** も改善し、モデルの品質を可能な限り保つため、さらに多くの量子化手法を導入しました。

私たちは **imatrixキャリブレーションデータセットで学習していません**。また、 **QAT** や **QAD**も使用していません。すべて **学習後量子化**。使用したimatrixファイルは、コミュニティがテスト、評価、利用できるよう公開しています。研究者や開発者の皆さまには、Unslothの量子化版/imatrixを使ってQwen3.8の派生版やファインチューニング版を作成することをお勧めします。こちらもご覧ください： [過学習の分析](#not-overfitting) 。

* また、ディスク容量を約500MB節約するため、次のサイズ以下の小型量子化版からMTPモジュールを削除しました： `UD-Q2_K_XL` （8.37GB以下）。必要に応じて、MTP単体モジュールの `Q4_0` を使用できます。
* さらに、より小型のUD-1bit量子化版も作成しました。 `UD-IQ1_S` は6.2GB（MTPなし）で、サイズを89%削減しながら、top-1精度を約72%維持します。
* `UD-Q2_K_XL` は次点よりtop-1精度が約8%高く、サイズは9.83GBです。以前は動作しなかった、小さなJSバグが1つあるHTMLプログラムを動作させることができました。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHkiEb4BgU9IZ4t0pbMKs%2FUD-Q2_K_XL-Qwen.gif?alt=media&amp;token=6b4cd6d5-0b70-4741-a72e-1f5e1974dbb0" alt="" width="360"><figcaption><p>2ビット量子化したQwen3.8-27B GGUFで生成</p></figcaption></figure>

### 🔀 Divergence-300 @32

通常、Kimi-K3について「Dynamic 1-bitは、 **\~78.9%** のtop-1精度を達成しながら、 **サイズを62%削減**」のように、top-1精度を報告しています。しかし、top-1は1つの予測に対するargmaxなので、実際の推論性能を測る指標としてはあまり有効ではありません。

Terminal-Bench 2.1、DeepSWE、Harbor、MathArena 2025-26、非ラテン文字や長文書のプロンプトから、キャリブレーション用データセットに含まれない300件のホールドアウト例を集めたデータセットを作成しました。そして、BF16とすべての量子化版およびプロバイダーについて、32トークンのgreedy argmaxデコードを行いました。詳しくは [過学習の分析](#not-overfitting) をご覧ください。

これにより、過学習の有無や、複数トークンにわたって量子化版の出力がBF16の軌跡にどの程度似ているかを評価できます。KLD top-1を32トークンに拡張した指標に近いため、top-1精度より優れた指標です。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FySCIjoinQuhNqfGz3C4Q%2Fimage.png?alt=media&amp;token=dcc5a2be-3445-4a67-b1e2-0ca5e89fbcf6" alt=""><figcaption></figcaption></figure>

### :question:1ビット量子化版はエージェント用途には使用しないでください

に示すように [#divergence-300-32](#divergence-300-32 "mention")、32トークン予測の精度はUD-Q2\_K\_XLからUD-IQ2\_Sにかけて約25%から8～10%未満へと急激に低下します。この急落により、ツール呼び出しや非思考モードが機能しなくなります。1ビット量子化版を使う場合の問題点と対処法は次のとおりです：

1. **過剰なループ**\
   UD-Q2\_K\_XLより小さい量子化版では、ループが頻繁に発生します。すべてのケースで `presence_penalty = 1.5` （またはそれ以上）を使用してください。
2. **空の応答**\
   1ビット量子化版では、少なくとも低い推論レベルで思考を常に有効にしてください。非推論モードでは、モデルが何も出力しないことがあります。
3. **エージェント用途とツール呼び出し**\
   このモデルをツール呼び出しに使用しないでください。保持されるのは **一般知識のみ** であり、強く量子化すると、ツール呼び出しに失敗したり、呼び出しを繰り返したり、まったく呼び出せなかったりします。
4. **一般知識には有効**\
   top-1の回復率77%は、実際の推論ワークロードの指標として優れているDivergence-300 @32の8%に代わるものではありません。ごく短い一般知識の事実確認には使えますが、UD-Q2\_K\_XLを使うのが最善です。

### 🔀 KLダイバージェンスのベンチマーク

すべてのプロバイダーについてKLDベンチマークも実施し、Top-1とKLD平均を報告しています。あらゆるサイズ、特に小さい量子化サイズでは、Unsloth UD-3量子化版は同じディスク容量でtop-1精度を最大10%向上させます！

公平に比較できるよう、すべてのプロットではディスク容量の計算時にx軸からMTPヘッドを除外しています。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F4ipZ74oiCRRLbB2FJa4J%2Fimage.png?alt=media&amp;token=09f263b9-4cd9-45dc-bd31-8c7ecff2ca41" alt=""><figcaption></figcaption></figure>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FA6YPmwKLaJ7IZ4U4bQE3%2Fimage.png?alt=media&amp;token=e003bf7b-5c78-4eb4-bbae-5358410ef3fa" alt=""><figcaption></figcaption></figure>

### :dove:過学習なし

未使用のWikitextおよびCodeデータで以前のUD-2と比較すると、KLDは大幅に改善しています。一方、大きな量子化版ではそれほど改善していないため、大きな量子化版には引き続き旧UD-2を使用しています。こちらも実験を重ね、改善していく予定です！

キャリブレーションにはまったく異なるデータセットを使用し、データ漏洩をできる限り排除することで、過学習も抑制しています。これらの未使用データセットでKLDをテストしています。また、QAD/QATは行わず、純粋なPTQのみを使用しているため、他のQAD/QAT手法に比べて過学習の懸念は小さくなります。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FP6ro1GH2PqtO63Zdvale%2Fimage.png?alt=media&amp;token=109ca035-6fe1-4154-a33e-20d609f2bf57" alt=""><figcaption></figcaption></figure>

同様に、 [#divergence-300-32](#divergence-300-32 "mention") はDeepSWE、Terminal Benchなどから得た未使用のプロンプト300件を使い、過学習を評価する別のデータセットとして機能します。この評価でも、新しいUD-3手法が過学習しないことが示されています。

***

## Dynamic v2.0（旧版）

今回ご紹介するのは [Unsloth](https://github.com/unslothai/unsloth) Dynamic v2.0量子化です。従来の量子化版を大幅にアップグレードしたもので、主要な量子化手法を上回る性能を発揮し、以下の新たなベンチマークを打ち立てます [Aider Polyglot](https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md)、5ショットMMLU、KLダイバージェンス。

これにより、次のことができるようになりました。実行とファインチューニング [量子化LLM](https://unsloth.ai/docs/jp/moderu/tutorials.md) 精度をできる限り維持したまま実行できます！2.0 GGUFは、llama.cpp、 [Unsloth Studio](https://unsloth.ai/docs/jp/shii/studio.md) などで実行できます。

{% columns %}
{% column %}
**2026年4月20日 更新：** 新しいGGUFベンチマークをご覧ください： [Qwen3.6](https://unsloth.ai/docs/jp/moderu/qwen3.6.md#unsloth-gguf-benchmarks) と [Gemma 4](https://unsloth.ai/docs/jp/moderu/gemma-4.md#unsloth-gguf-benchmarks).

[2026年2月27日更新：](https://unsloth.ai/docs/jp/moderu/qwen3.5/gguf-benchmarks.md) **Qwen3.5** がリリースされました。また、ツール呼び出し用のチャットテンプレートに関する問題を修正し、すべてのGGUFをパープレキシティとKLダイバージェンスでベンチマークしました。 [ベンチマークをご覧ください！](https://unsloth.ai/docs/jp/moderu/qwen3.5/gguf-benchmarks.md)

その **主な利点** を使う [Unslothパッケージ](https://github.com/unslothai/unsloth) そして、主要モデルのバグ修正に積極的に取り組んでいることも、私たちの強みです。以下の開発チームと直接協力してきました。 [Qwen3](https://www.reddit.com/r/LocalLLaMA/comments/1kaodxu/qwen3_unsloth_dynamic_ggufs_128k_context_bug_fixes/), [Meta（Llama 4）](https://github.com/ggml-org/llama.cpp/pull/12889), [Mistral（Devstral）](https://app.gitbook.com/o/HpyELzcNe0topgVLGCZY/s/xhOjnexMCB3dmuQFQ2Zq/~/changes/618/basics/tutorials-how-to-fine-tune-and-run-llms/devstral-how-to-run-and-fine-tune), [Google（Gemma 1–3）](https://news.ycombinator.com/item?id=39671146) および [Microsoft（Phi-3/4）](https://simonwillison.net/2025/Jan/11/phi-4-bug-fixes)。精度向上につながる修正を提供しています。
{% endcolumn %}

{% column %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F8y2cQ4VFqGEJLBS8PKZV%2Fgemma%20426b%20bench.lossless.webp?alt=media" alt=""><figcaption><p>Gemma 4 26B A4B のベンチマーク（数値が小さいほど良好）</p></figcaption></figure>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fe4U8EnJcC1rAVIrQS9gt%2Fqwen36_mean_q6k_corrected_arrow_pareto_fixed.lossless.webp?alt=media" alt=""><figcaption><p>Qwen3.6 のベンチマーク（数値が小さいほど良好）</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% hint style="success" %}
Unsloth Dynamic GGUFを次の環境で実行できるようになりました： [Unsloth Studio](https://unsloth.ai/docs/jp/shii/studio.md) ✨

<img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsERzR65n4jc1UtuSHozZ%2Fwedefrwfwe.gif?alt=media&amp;token=e303ed9e-0d90-456d-8d57-874a06803903" alt="" data-size="original">
{% endhint %}

{% hint style="success" %}
[2025年9月10日更新：](https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md) より難易度の高いベンチマークをご希望とのことでしたので、Aider Polyglotの結果をご紹介します！Dynamic 3-bit DeepSeek V3.1 GGUFは **75.6%**&#x3092;記録し、多くのフル精度の最先端LLMを上回りました。 [詳しくはこちら。](https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md)

<img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a114143bdd47add988182aabf9313ab40be38d7d%2Faider%20thinking.png?alt=media" alt="DeepSeek-V3.2 Thinking Aider Benchmarks" data-size="original"><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b085c16c7f8351308229f1341846cbf1a2617d0a%2Faider%20non.png?alt=media" alt="Llama 4 5-shot MMLU Benchmarks" data-size="original">
{% endhint %}

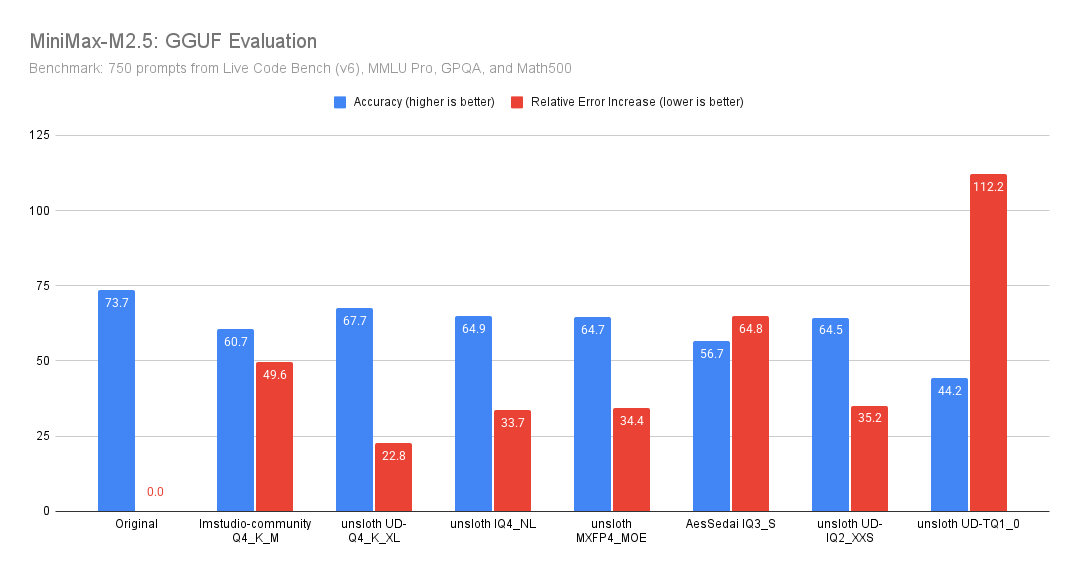
Benjamin Marieが実施したLiveCodeBench v6やMMLU Proなどの、実際のユースケースに基づくベンチマークもご覧いただけます：

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhfO2gsbz2lWrZXg3ojyE%2FHCGBTzgboAASv_A.png?alt=media&amp;token=7d6334ca-4f3c-4946-aacd-d55527375fce" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Ftbfnqq8ppzwFbeqPhnw0%2FHAfMRrrXQAALkQb.png?alt=media&amp;token=9730d4e1-3d4a-4ae6-92bf-32aa6724ab86" alt="" width="450"><figcaption></figcaption></figure></div>

UnslothのGGUFは、約8GB小さいにもかかわらず、Unslothを使用していない量子化モデルより優れた性能を発揮します。

ベンチマークと評価の詳細な分析は、以下をご覧ください。

### 💡 Dynamic v2.0 の新機能

* **GGUF と safetensors のレイヤー選択を刷新：** Unsloth Dynamic 2.0 では、より高度かつ広範囲にレイヤーを選択して量子化できるようになりました。一部のレイヤーだけを変更するのではなく、量子化タイプを適用可能なすべてのレイヤーについて動的に調整します。組み合わせは、レイヤーごと、モデルごとに異なります。
* 現在選択されている GGUF と、今後アップロードされるすべての GGUF には、Dynamic 2.0 と新しいキャリブレーション用データセットが適用されます。このデータセットには、1.5M を超える **トークンが含まれており、** （モデルによって異なります）、高品質で手作業により厳選・クリーニングされたデータで構成されています。これにより、会話の応答品質が大幅に向上します。
* 以前の Dynamic 量子化（DeepSeek-R1 1.58-bit GGUF）は、MoE アーキテクチャでのみ有効でした。 <mark style="color:デフォルト;background-color:green;">**Dynamic 2.0 量子化は、MoE と非 MoE を含むすべてのモデルで動作するようになりました。**</mark>.
* **モデル固有の量子化：** 各モデルに合わせてカスタマイズされた量子化方式を使用するようになりました。たとえば、Gemma 3 で量子化されるレイヤーは、Llama 4 のものとは大きく異なります。
* 効率を最大化するため、特にApple SiliconやARMデバイス向けに、Q4\_NL、Q5.1、Q5.0、Q4.1、Q4.0形式も追加しました。

正確なベンチマークを行うため、Llama 4とGemma 3の公式発表済み5-shot MMLUスコアに一致するよう、社内評価フレームワークを構築しました。これにより、フル精度モデルとDynamic v2.0、 **QAT** および標準の **imatrix** GGUF量子化モデルを公平に比較できるようになりました。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-fd0a92a2bea8efa37b71946ea934a22f00589f40%2Fkldivergence%20graph.png?alt=media" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-76662317725a3b76fb1e5e33b586c86e712bee6f%2F5shotmmlu.png?alt=media" alt="" width="563"><figcaption></figcaption></figure></div>

今後アップロードするすべてのGGUFにはUnsloth Dynamic 2.0を使用します。また、Dynamic 4-bitのsafetensors量子化モデルも、今後この恩恵を受けることになります。

## 📊 なぜKLダイバージェンスなのか？

[「Accuracy is Not All You Need」](https://arxiv.org/pdf/2407.09141) では、不要な層を選んで削除した場合でさえ、「反転」の数に大きな違いが生じることが示されています。「反転」とは、回答が不正解から正解へ、またはその逆に変わることです。この論文によると、層の削減や量子化を行ってもMMLUのスコアが下がらない場合がありますが、それは一部の不正解が「反転」して正解になっている可能性があるためです。私たちの目標は元のモデルに一致させることなので、「反転」を測定することは有効な指標です。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-5a97c101b0df31fb49df20ce4241930897098cf8%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e4a60354ad8613b6f2361f63fa82c552e00fdda9%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>

{% hint style="info" %}
**KLダイバージェンスは** 量子化誤差を報告する際の **ゴールドスタンダードのひとつとすべきです** —研究論文「Accuracy is Not All You Need」に基づく見解です。 **パープレキシティを使うのは適切ではありません。** 出力トークンの値が相殺される可能性があるためです。そのため、KLDや、より難易度の高いベンチマークである [Aider](https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md).
{% endhint %}

を使う必要があります。この論文では、興味深いことに、KLダイバージェンスと反転の間に高い相関があることも示されています。そのため私たちは、量子化によるディスク容量の増加をできるだけ抑えながら、平均KLダイバージェンスを低減することを目指しています。

## ⚖️ キャリブレーションデータセットへの過適合

多くのフレームワークは、Wikipedia記事のテストセットを使ってパープレキシティとKLダイバージェンスを報告しています。しかし、Wikipedia関連のキャリブレーションデータセットを使うと量子化モデルが過適合し、パープレキシティのスコアが低くなることに気づきました。公平なテストのため、 [Calibration\_v3](https://gist.github.com/bartowski1182/eb213dccb3571f863da82e99418f81e8) と [Calibration\_v5](https://gist.github.com/tristandruyen/9e207a95c7d75ddf37525d353e00659c/) のデータセットを使用しています。これらには、wikitextのデータのほか、さまざまなデータが含まれています。 <mark style="color:デフォルト;background-color:red;">**また、指示追従モデルにはそれぞれ独自のチャットテンプレートがあり、テキストのみのキャリブレーションデータセットは指示追従モデルには効果的ではありません**</mark> （ベースモデルには有効です）。実際、ほとんどのimatrix GGUFは、通常こうした問題を抱えた状態でキャリブレーションされています。その結果、モデルは実質的にWikipediaのドメイン向けに最適化されているため、Wikipediaデータを使うKLダイバージェンスのベンチマークでは自然と高い性能を発揮します。

公平かつ統制された評価を行うため、KLダイバージェンスのベンチマークでは、チャット性能に最適化した独自のキャリブレーションデータセットを使用しません。その代わり、同じ標準的なWikipediaデータセットを使ってテストを行い、Dynamic 2.0方式の性能をベースラインのimatrix方式と直接比較できるようにしました。

## :1234: MMLU再現への挑戦

* 5-shot MMLUの再現は悪夢のようでした。私たちは、 <mark style="color:デフォルト;background-color:red;">**再現できませんでした。**</mark> 微妙な実装上の問題 <mark style="color:デフォルト;background-color:yellow;">**が原因で、Llama 3.1 (8B) InstructやGemma 3 (12B)など、多くのモデルのMMLU結果を**</mark>再現できませんでした。たとえばLlama 3.1 (8B)は約68.2%になるはずですが、誤った実装では <mark style="color:デフォルト;background-color:red;">**正解率が35%になることがあります。**</mark>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cc2b4b2bc512b3c9bc065250930259b9b9a9fce0%2FMMLU%20differences.png?alt=media" alt="" width="375"><figcaption><p>MMLUの実装上の問題</p></figcaption></figure>

* 素朴なMMLU実装を使った場合、Llama 3.1 (8B) Instructの5-shot MMLU正解率は67.8%です。しかし、Llamaは **「A」と「\_A」（前にスペースがあるA）を異なるトークンIDとしてトークン化します。**&#x30B9;ペースありとスペースなしの両方のトークンを考慮すると、68.2%になります。 <mark style="color:デフォルト;background-color:green;">(+0.4%)</mark>
* 興味深いことに、Eleuther AIの [LLM Harness](https://github.com/EleutherAI/lm-evaluation-harness/blob/main/lm_eval/tasks/llama3/instruct/mmlu/_continuation_template_yaml) も、Llama 3の元のMMLUベンチマークに従って、質問に <mark style="color:デフォルト;background-color:purple;">**「The best answer is」**</mark> を追加しています。
* ほかにも微妙な問題が数多くあります。すべてを統制された環境でベンチマークするため、私たちは [github.com/hendrycks/test](https://github.com/hendrycks/test) を直接調査して独自のMMLU実装を一から設計し、複数のモデルで結果を検証するとともに、公表済みの数値と比較しました。

## :sparkles: Gemma 3 QATの再現とベンチマーク

Gemmaチームは、Gemma 3のQAT（量子化対応学習）版を2種類公開しました。

1. Q4\_0 GGUF - 次の式で全レイヤーをQ4\_0に量子化します。 `w = q * block_scale` 各ブロックは32個の重みで構成されます。詳しくは [llama.cpp wiki ](https://github.com/ggml-org/llama.cpp/wiki/Tensor-Encoding-Schemes)をご覧ください。
2. int4版、おそらく [TorchAO int4形式](https://github.com/pytorch/ao/blob/main/torchao/quantization/README.md)?

すべてのQ4\_0 GGUFバージョンをベンチマークし、12Bモデルで幅広く実験しました。その結果、 **12B Q4\_0 QATモデルの精度は67.07%** 一方、フル精度のbfloat16 12Bバージョンは5ショットMMLUで67.15%でした。これは非常に優れた結果です！27Bモデルもほぼ同等の性能に達しています！

<table><thead><tr><th>指標</th><th>1B</th><th valign="middle">4B</th><th>12B</th><th>27B</th></tr></thead><tbody><tr><td>MMLU（5ショット）</td><td>26.12%</td><td valign="middle">55.13%</td><td><mark style="color:デフォルト;background-color:blue;"><strong>67.07%（BF16では67.15%）</strong></mark></td><td><strong>70.64%（BF16では71.5%）</strong></td></tr><tr><td>ディスク容量</td><td>0.93GB</td><td valign="middle">2.94GB</td><td><strong>7.52GB</strong></td><td>16.05GB</td></tr><tr><td><mark style="color:デフォルト;background-color:green;"><strong>効率*</strong></mark></td><td>1.20</td><td valign="middle">10.26</td><td><strong>5.59</strong></td><td>2.84</td></tr></tbody></table>

新しい **効率指標を設計しました。** この指標は、モデルの有用性に加えて、ディスクサイズとMMLU 5ショットスコアも考慮して算出します。

$$
\text{Efficiency} = \frac{\text{MMLU 5 shot score} - 25}{\text{Disk Space GB}}
$$

{% hint style="warning" %}
25を **差し引く必要があります。** MMLUは選択肢がA、B、C、Dの4つだからです。モデルが答えをランダムに選ぶだけだとすると、正答率は25%で、ディスク容量は数バイトです。しかし、明らかにこれは有用なモデルではありません。
{% endhint %}

ベースモデルとのKLダイバージェンスについて、改善点を示す表を以下に掲載します。KLダイバージェンスは0に近いほど優れています（つまり、0はフル精度モデルと同一であることを意味します）。

| 量子化方式     | ベースラインKLD | GB    | 新しいKLD   | GB    |
| --------- | --------- | ----- | -------- | ----- |
| IQ1\_S    | 1.035688  | 5.83  | 0.972932 | 6.06  |
| IQ1\_M    | 0.832252  | 6.33  | 0.800049 | 6.51  |
| IQ2\_XXS  | 0.535764  | 7.16  | 0.521039 | 7.31  |
| IQ2\_M    | 0.26554   | 8.84  | 0.258192 | 8.96  |
| Q2\_K\_XL | 0.229671  | 9.78  | 0.220937 | 9.95  |
| Q3\_K\_XL | 0.087845  | 12.51 | 0.080617 | 12.76 |
| Q4\_K\_XL | 0.024916  | 15.41 | 0.023701 | 15.64 |

ディスク容量の増加率とKLダイバージェンス比の変化をプロットすると、メリットがより明確になります。動的2ビットのQ2\_K\_XLでは、KLDがかなり低下します（約7.5%）。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-5b352d0449e723556e6e871396c2ee78ae8ec3dc%2Fchart(2).svg?alt=media" alt=""><figcaption></figcaption></figure>

Gemma 3（27B）のMMLU結果の抜粋表です。以下をご覧ください。

1. **動的4ビット版は、QAT版より2GB小さく、精度も1%高くなっています！**
2. 効率の面では、2ビットのQ2\_K\_XLなどが非常に優れているようです！

| 量子化方式          | Unsloth   | Unsloth + QAT | ディスクサイズ   | 効率       |
| -------------- | --------- | ------------- | --------- | -------- |
| IQ1\_M         | 48.10     | 47.23         | 6.51      | 3.42     |
| IQ2\_XXS       | 59.20     | 56.57         | 7.31      | 4.32     |
| IQ2\_M         | 66.47     | 64.47         | 8.96      | 4.40     |
| Q2\_K\_XL      | 68.70     | 67.77         | 9.95      | 4.30     |
| Q3\_K\_XL      | 70.87     | 69.50         | 12.76     | 3.49     |
| **Q4\_K\_XL**  | **71.47** | **71.07**     | **15.64** | **2.94** |
| **Google QAT** |           | **70.64**     | **17.2**  | **2.65** |

<details>

<summary><mark style="color:緑;">こちらをクリック</mark> Google Gemma 3（27B）QAT の完全版ベンチマーク：</summary>

| モデル            | Unsloth   | Unsloth + QAT | ディスクサイズ   | 効率       |
| -------------- | --------- | ------------- | --------- | -------- |
| IQ1\_S         | 41.87     | 43.37         | 6.06      | 3.03     |
| IQ1\_M         | 48.10     | 47.23         | 6.51      | 3.42     |
| IQ2\_XXS       | 59.20     | 56.57         | 7.31      | 4.32     |
| IQ2\_M         | 66.47     | 64.47         | 8.96      | 4.40     |
| Q2\_K          | 68.50     | 67.60         | 9.78      | 4.35     |
| Q2\_K\_XL      | 68.70     | 67.77         | 9.95      | 4.30     |
| IQ3\_XXS       | 68.27     | 67.07         | 10.07     | 4.18     |
| Q3\_K\_M       | 70.70     | 69.77         | 12.51     | 3.58     |
| Q3\_K\_XL      | 70.87     | 69.50         | 12.76     | 3.49     |
| Q4\_K\_M       | 71.23     | 71.00         | 15.41     | 2.98     |
| **Q4\_K\_XL**  | **71.47** | **71.07**     | **15.64** | **2.94** |
| Q5\_K\_M       | 71.77     | 71.23         | 17.95     | 2.58     |
| Q6\_K          | 71.87     | 71.60         | 20.64     | 2.26     |
| Q8\_0          | 71.60     | 71.53         | 26.74     | 1.74     |
| **Google QAT** |           | **70.64**     | **17.2**  | **2.65** |

</details>

## :llama: Llama 4 のバグ修正と実行

Llama 4 のいくつかのバグの修正にも協力しました：

* Llama 4 Scout は公式リポジトリで RoPE Scaling の設定を変更しました。この変更を可能にするため、llama.cpp の問題解決に協力しました。 [変更はこちら](https://github.com/ggml-org/llama.cpp/pull/12889)

  <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7ff8229dfa96425f50c2c87f9ca988ef9cc99eff%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
* Scout と Maverick の両方で、Llama 4 の QK Norm のイプシロン値は設定ファイルから取得する必要があります。つまり、1e-06 ではなく 1e-05 を使用します。この問題の解決には [llama.cpp](https://github.com/ggml-org/llama.cpp/pull/12889) と [transformers](https://github.com/huggingface/transformers/pull/37418)
* Llama 4 チームと vLLM も、QK Norm がすべてのヘッド間で共有されてしまう問題（共有されるべきではありません）をそれぞれ独自に修正しました。 [こちら](https://github.com/vllm-project/vllm/pull/16311)。MMLU Pro の正解率は 68.58% から 71.53% に上昇しました。
* [Wolfram Ravenwolf](https://x.com/WolframRvnwlf/status/1909735579564331016) は、llama.cpp を使った当社の GGUF がサードパーティの推論プロバイダーよりもはるかに高い正解率を達成することを紹介しました。これはおそらく、上述の問題と、量子化の問題が組み合わさった結果です。

  <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-76c49d8c8e3e42f7407f431a2cede369f87878e4%2FGoC79hYXwAAPTMs.jpg?alt=media" alt=""><figcaption></figcaption></figure>

グラフに示すように、当社の 4 ビット Dynamic QAT 量子化は、サイズを抑えながら 5-shot MMLU でより優れた性能を発揮します。

### Llama 4 Scout の実行：

たとえば Llama 4 Scout を実行するには、まず llama.cpp をクローンします：

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

次に、Scout 用の新しい Dynamic v2.0 量子化モデルをダウンロードします：

```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
    local_dir = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
    allow_patterns = ["*IQ2_XXS*"],
)
```

それでは推論を実行しましょう！

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF/Llama-4-Scout-17B-16E-Instruct-UD-IQ2_XXS.gguf \
    --threads 32 \
    --ctx-size 16384 \
    --n-gpu-layers 99 \
    -ot ".ffn_.*_exps.=CPU" \
    --seed 3407 \
    --prio 3 \
    --temp 0.6 \
    --min-p 0.01 \
    --top-p 0.9 \
    -no-cnv \
    --prompt "<|header_start|>user<|header_end|>\n\nCreate a Flappy Bird game.<|eot|><|header_start|>assistant<|header_end|>\n\n"
```

{% endcode %}

{% hint style="success" %}
Llama 4 の実行方法について詳しくはこちらをご覧ください： <https://docs.unsloth.ai/basics/tutorial-how-to-run-and-fine-tune-llama-4>
{% endhint %}


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.