> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs.md).

# Unsloth Dynamic 3.0 GGUF

**Unsloth Dynamic V3.1** （2026年11月）は、DeepSeek-V4.1-Flash-1017 と Qwen3.8-Flash-Next 向けの最新の量子化アルゴリズムで、 **10～15% の精度向上** と **トークン使用量 50% 削減** を、同サイズの他の量子化手法と比べて実現します。

Unsloth [DeepSeek-V4.1-Flash-1017](/docs/jp/moderu/deepseek-v4.1-flash.md) Dynamic V3.1 IQ1\_S は、DeepSWE v1.1 で 65.8%、Terminal Bench 2.1 で 69.5%、Automation Bench v1.0.6 で 51.5% を達成します。

[Qwen3.8-Flash-Next](/docs/jp/moderu/qwen3.8-next.md) Dynamic V3.1 IQ1\_S は、DeepSWE v1.1 で 54.0%、Terminal Bench 2.1 で 68.3% を達成します。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FXC2NHQCS4KKsMoY4IjpT%2Fimage.png?alt=media&amp;token=67fb9d55-8fbb-4f35-a13f-83465cee8475" alt=""><figcaption><p>DeepSeek-V4.1-Flash-1017 ベンチマーク</p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FqdXHweLFGzUhUcqj7jZX%2Ffinal%20key%204.png?alt=media&amp;token=8e3249b1-e26c-4a04-82ba-7cfdef952fe6" alt=""><figcaption><p>Qwen3.8-Flash-Next ベンチマーク</p></figcaption></figure></div>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWTSMbLLxexSW1HiwU411%2Fqwen%20speed%20token%20con.png?alt=media&amp;token=fea0700d-24e7-4046-a915-4c087e0230aa" alt=""><figcaption><p>Qwen3.8-Flash-Next GGUF のトークン消費量と速度のベンチマーク</p></figcaption></figure>

### Dynamic v3.0

Dynamic v3.0 の以前のリリースノートとベンチマークを以下に示します。

リリースします [**Qwen3.8-27B**](/docs/jp/moderu/qwen3.8.md) Dynamic v3.0 の量子化版で、 **同サイズで top-1 精度が 10%以上向上** と比べて **他のすべての提供元より**優れています。これは、私たちが最初に共有した **早期プレビュー** 版の Dynamic v3.0 の更新です。新しい 3.0 GGUF は、 **llama.cpp** と [**Unsloth Desktop**](/docs/jp/desktop.md).

{% columns %}
{% column width="41.66666666666667%" %}
Dynamic v3.0 は、同じサイズを保ちながら全体としてより多くのモデル品質を維持し、 **Divergence-300** @32 と **KL Divergence**.

さらに、皆さんのサポートに心から感謝します！ わずか5日で、Unsloth Qwen3.8 のダウンロード数が 510万回を超えました！
{% endcolumn %}

{% column width="58.33333333333333%" %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fl9piThTmmUsePst5w3F2%2Fimage.png?alt=media&amp;token=821e88e2-ad4e-40bf-adf2-e13837228e82" alt=""><figcaption><p>さらなるグラフ／ベンチマークと分析は以下をご覧ください</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

新しい手法には、多くの新機能と改良が含まれています。現在は、多様なソースから得たはるかに高品質な imatrix キャリブレーションデータセットを使用しています。このデータセットは、 **エージェント的コーディング、チャット**、および多言語性能向けに調整されています。また、 **レイヤー選択** も改善し、モデル品質を可能な限り維持するための量子化技術もさらに多く導入しました。

私たちは **imatrix キャリブレーションデータセットでは学習しません**し、 **QAT** または **QAD**も使用しません。すべては **学習後量子化**で行われます。使用した imatrix ファイルは、コミュニティがテスト、評価、利用できるよう公開しています。研究者や開発者の皆さんには、私たちの Unsloth の量子化版／imatrix を使って Qwen3.8 の派生版やファインチューニング版を作成することを推奨します。私たちの [過学習分析](#not-overfitting) もご覧いただけます。

* また、 `UD-Q2_K_XL` 未満の小さい量子化版から MTP モジュールも削除し、約500MBのディスク容量を節約しました。必要であれば `Q4_0` の MTP পৃথ別モジュールを使用できます
* また、さらに小さい UD-1bit 量子化版も作成しました。 `UD-IQ1_S` は 6.2GB（MTP なし）で、top-1 精度の約72%を維持しつつ 89% 小型化されています。
* `UD-Q2_K_XL` は、次点より top-1 で約8%高精度で、サイズは 9.83GB です。小さな JS バグ 1つを伴う動作する HTML プログラムを作成できました。以前は壊れていました。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHkiEb4BgU9IZ4t0pbMKs%2FUD-Q2_K_XL-Qwen.gif?alt=media&amp;token=6b4cd6d5-0b70-4741-a72e-1f5e1974dbb0" alt="" width="360"><figcaption><p>2-bit Qwen3.8-27B GGUF で生成</p></figcaption></figure>

### 🔀 Divergence-300 @32

私たちは通常、Kimi-K3 の「Dynamic 1-bit reaches **\~78.9%** top-1 accuracy while being **62% smaller**」のように top-1 精度を報告します。ただし top-1 は1回の予測に対する argmax なので、実際の推論性能を測るにはあまり有効ではありません。

Terminal-Bench 2.1 + DeepSWE + Harbor + MathArena 2025-26 + 非ラテン文字／長文プロンプトから 300件のホールドアウト例（キャリブレーションデータセットには含まれない）を作成し、BF16 とすべての量子化版・提供元に対して 32トークンの greedy argmax デコードを行いました。詳細は [過学習分析](#not-overfitting) をご覧ください。

これにより、過学習の有無や、量子化出力が複数トークンにわたって BF16 の軌跡とどれだけ似ているかを評価できます。これは top-1 精度よりも優れた指標です。なぜなら、KLD top-1 を 32トークン版の KLD top-1 のようなものに拡張できるからです。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FySCIjoinQuhNqfGz3C4Q%2Fimage.png?alt=media&amp;token=dcc5a2be-3445-4a67-b1e2-0ca5e89fbcf6" alt=""><figcaption></figcaption></figure>

### :question:1-bit はエージェント的ユースケースには使用すべきではありません

で見られるように [#divergence-300-32](#divergence-300-32 "mention")、UD-Q2\_K\_XL から UD-IQ2\_S への 32トークン予測では、精度が約25%から8～10%未満へと急激に低下します。この急激な低下は、ツール呼び出しや非推論モードが機能しなくなることを意味します。1-bit を使う場合の問題点と対策をいくつか示します：

1. **過度なループ**\
   UD-Q2\_K\_XL 未満の量子化版を使うと、ループがかなり発生します。すべての場合で `presence_penalty = 1.5` を使用してください（それ以上でも可）
2. **空の応答**\
   1-bit 量子化版では、少なくとも低推論設定で thinking を常に有効にしてください。非推論モードでは、そもそもモデルが出力しないことがあります。
3. **エージェント的ユースケースとツール呼び出し**\
   ツール呼び出しにはモデルを使用しないでください。保持されるのは **一般知識のみ** であり、強く量子化すると、モデルはツール呼び出しに失敗するか、ツールを呼び続けるか、あるいはまったく呼び出さなくなります。
4. **一般知識は機能します**\
   77% の Top-1 回復は、実際の推論ワークロードのより良い指標である Divergence-300 @32 の 8% の代わりにはなりません。非常に短い一般知識の事実質問にはモデルを使えますが、最善は UD-Q2\_K\_XL を使うことです。

### 🔀 KL Divergence ベンチマーク

私たちはすべての提供元に対して KLD ベンチマークも実施し、Top-1 と KLD 平均を報告しています。すべてのレベル、特に小さい量子化サイズでは、Unsloth の UD-3 量子化版が、同じディスク容量で最大 +10% の追加 top-1 精度を達成します！

すべての図では、公平な比較のため、ディスク容量を計算する際に x 軸から MTP ヘッドを除外しています。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F4ipZ74oiCRRLbB2FJa4J%2Fimage.png?alt=media&amp;token=09f263b9-4cd9-45dc-bd31-8c7ecff2ca41" alt=""><figcaption></figcaption></figure>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FA6YPmwKLaJ7IZ4U4bQE3%2Fimage.png?alt=media&amp;token=e003bf7b-5c78-4eb4-bbae-5358410ef3fa" alt=""><figcaption></figcaption></figure>

### :dove:過学習なし

未見の Wikitext と Code に対する旧 UD-2 と比較すると、KLD は大きく改善しています。大きい量子化版ではそれほどではないため、より大きい量子化版では引き続き旧 UD-2 を使用しています。今後、実験して改善していく予定です！

また、キャリブレーションにまったく異なるデータセットを使い、漏れを可能な限り除去することで過学習を抑えています。これらの未見データセットで KLD をテストし、さらに QAD / QAT は行わず純粋な PTQ のみを行っているため、他の QAD / QAT 手法と比べて過学習の懸念は小さくなっています。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FP6ro1GH2PqtO63Zdvale%2Fimage.png?alt=media&amp;token=109ca035-6fe1-4154-a33e-20d609f2bf57" alt=""><figcaption></figcaption></figure>

同様に [#divergence-300-32](#divergence-300-32 "mention") は、DeepSWE、Terminal Bench などからの未見の 300プロンプトのデータセットを使用し、過学習を評価するための別のデータセットとして機能します。そして、私たちの新しい UD-3 手法が過学習していないことを示しています。

***

## Dynamic v2.0（旧）

導入します [Unsloth](https://github.com/unslothai/unsloth) Dynamic v2.0 の量子化は、以前の量子化版からの大幅なアップグレードです。この新しい手法は主要な量子化手法を上回り、 [Aider Polyglot](/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md)、5-shot MMLU、KL Divergence の新たなベンチマークを打ち立てます。

つまり、今では [量子化された LLM](/docs/jp/moderu/tutorials.md) を、可能な限り精度を維持したまま実行＋ファインチューニングできます！ 2.0 GGUF は、llama.cpp、 [Unsloth Studio](/docs/jp/shii/studio.md) などのほとんどの推論エンジンで実行できます。

{% columns %}
{% column %}
**2026年4月20日更新:** 以下の新しい GGUF ベンチマークをご覧ください: [Qwen3.6](/docs/jp/moderu/qwen3.6.md#unsloth-gguf-benchmarks) と [Gemma 4](/docs/jp/moderu/gemma-4.md#unsloth-gguf-benchmarks).

[2026年2月27日更新:](/docs/jp/moderu/qwen3.5/gguf-benchmarks.md) **Qwen3.5** が登場し、ツール呼び出し用チャットテンプレートのいくつかの問題を修正し、すべての GGUF を perplexity と KL Divergence でベンチマークしました。 [ベンチマークをご覧ください！](/docs/jp/moderu/qwen3.5/gguf-benchmarks.md)

の **主な利点** は [Unsloth パッケージ](https://github.com/unslothai/unsloth) と量子化版を使うことにあります。それは、大規模モデルのバグ修正に積極的に関わっているからです。私たちは次のチームと直接協力してきました: [Qwen3](https://www.reddit.com/r/LocalLLaMA/comments/1kaodxu/qwen3_unsloth_dynamic_ggufs_128k_context_bug_fixes/), [Meta（Llama 4）](https://github.com/ggml-org/llama.cpp/pull/12889), [Mistral（Devstral）](https://app.gitbook.com/o/HpyELzcNe0topgVLGCZY/s/xhOjnexMCB3dmuQFQ2Zq/~/changes/618/basics/tutorials-how-to-fine-tune-and-run-llms/devstral-how-to-run-and-fine-tune), [Google（Gemma 1～3）](https://news.ycombinator.com/item?id=39671146) と [Microsoft（Phi-3/4）](https://simonwillison.net/2025/Jan/11/phi-4-bug-fixes)、精度を向上させる修正に貢献しています。
{% endcolumn %}

{% column %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FtRVN97QDzO0Pq7SscC7x%2Fgemma%20426b%20bench.png?alt=media&amp;token=80b4da76-efe9-4554-8e31-cca6494d456c" alt=""><figcaption><p>Gemma 4 26B A4B ベンチマーク（低いほど良い）</p></figcaption></figure>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHq98A18pHA2ePwlInrFG%2Fqwen36_mean_q6k_corrected_arrow_pareto_fixed.png?alt=media&amp;token=a5190c8a-4d04-4d4d-be94-dd15214e6687" alt=""><figcaption><p>Qwen3.6 ベンチマーク（低いほど良い）</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% hint style="success" %}
Unsloth Dynamic GGUF は теперь [Unsloth Studio](/docs/jp/shii/studio.md) ✨

<img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsERzR65n4jc1UtuSHozZ%2Fwedefrwfwe.gif?alt=media&amp;token=e303ed9e-0d90-456d-8d57-874a06803903" alt="" data-size="original">
{% endhint %}

{% hint style="success" %}
[2025年9月10日更新:](/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md) もっと厳しいベンチマークが欲しいとのことだったので、Aider Polyglot の結果をご紹介します！ 私たちの Dynamic 3-bit DeepSeek V3.1 GGUF は **75.6%**&#x3092;記録し、多くのフル精度 SOTA LLM を上回っています。 [続きを読む。](/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md)

<img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a114143bdd47add988182aabf9313ab40be38d7d%2Faider%20thinking.png?alt=media" alt="DeepSeek-V3.2 Thinking Aider Benchmarks" data-size="original"><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b085c16c7f8351308229f1341846cbf1a2617d0a%2Faider%20non.png?alt=media" alt="Llama 4 5-shot MMLU Benchmarks" data-size="original">
{% endhint %}

Benjamin Marie による LiveCodeBench v6、MMLU Pro などの実世界ユースケースのベンチマークもご覧いただけます:
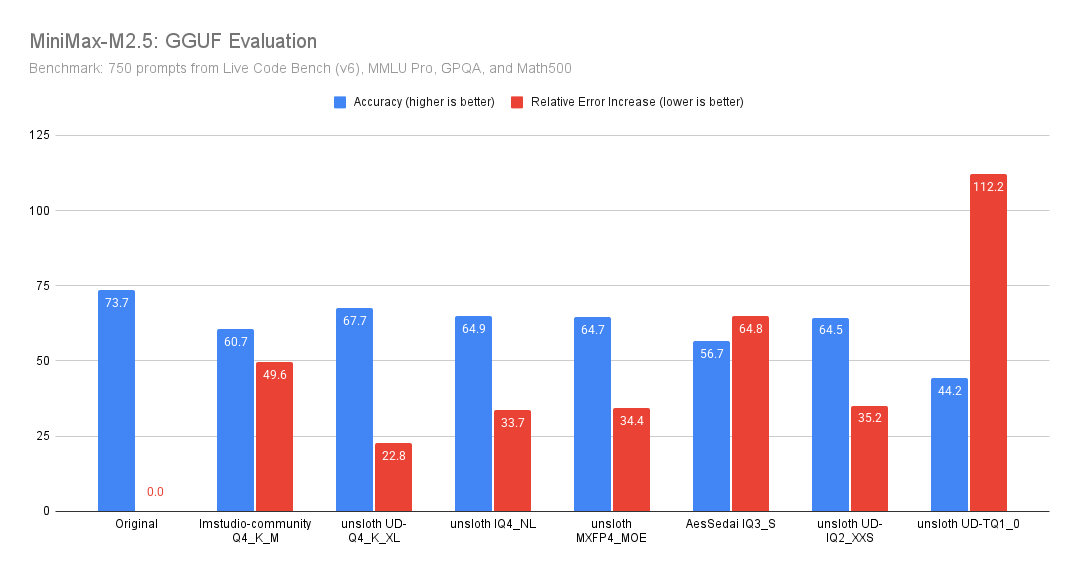
<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhfO2gsbz2lWrZXg3ojyE%2FHCGBTzgboAASv_A.png?alt=media&amp;token=7d6334ca-4f3c-4946-aacd-d55527375fce" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Ftbfnqq8ppzwFbeqPhnw0%2FHAfMRrrXQAALkQb.png?alt=media&amp;token=9730d4e1-3d4a-4ae6-92bf-32aa6724ab86" alt="" width="450"><figcaption></figcaption></figure></div>

約8GB小さいにもかかわらず、Unsloth の GGUF が非 Unsloth 量子化版より優れている様子が分かります。

ベンチマークと評価の詳細な分析はさらに下にあります。

### 💡 Dynamic v2.0 の新機能は？

* **GGUF + safetensors 向けのレイヤー選択を刷新:** Unsloth Dynamic 2.0 は、レイヤーをより賢く、より広範囲に選択的量子化します。一部のレイヤーだけを変更するのではなく、可能なすべてのレイヤーの量子化タイプを動的に調整し、その組み合わせは各レイヤーとモデルごとに異なります。
* 現在選択されているものと今後のすべての GGUF アップロードは、Dynamic 2.0 と新しいキャリブレーションデータセットを使用します。このデータセットには >1.5M 以上の **トークン** （モデルによる）を含み、高品質で手作業で厳選・クレンジングされたデータで構成されており、会話チャット性能を大幅に向上させます。
* 以前の Dynamic 量子化（DeepSeek-R1 1.58-bit GGUF）は、MoE アーキテクチャに対してのみ有効でした。 <mark style="background-color:green;">**Dynamic 2.0 量子化は、すべてのモデル（MOE と非 MOE を含む）で動作するようになりました**</mark>.
* **モデル固有の量子化版:** 各モデルは現在、専用に調整された量子化スキームを使用します。たとえば、Gemma 3 で量子化されるレイヤーは Llama 4 のものと大きく異なります。
* 特に Apple Silicon や ARM デバイスでの効率を最大化するため、Q4\_NL、Q5.1、Q5.0、Q4.1、Q4.0 形式も追加しました。

正確なベンチマークを保証するため、Llama 4 と Gemma 3 の公式に報告された 5-shot MMLU スコアに一致する社内評価フレームワークを構築しました。これにより、フル精度版と Dynamic v2.0、 **QAT** および標準の **imatrix** GGUF 量子化版を同条件で比較できました。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-fd0a92a2bea8efa37b71946ea934a22f00589f40%2Fkldivergence%20graph.png?alt=media" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-76662317725a3b76fb1e5e33b586c86e712bee6f%2F5shotmmlu.png?alt=media" alt="" width="563"><figcaption></figcaption></figure></div>

今後のすべての GGUF アップロードは Unsloth Dynamic 2.0 を使用し、私たちの Dynamic 4-bit safetensor 量子化版も将来的にこの恩恵を受けます。

## 📊 なぜ KL Divergence なのか？

[精度だけでは十分ではない](https://arxiv.org/pdf/2407.09141) は、不要なレイヤーを選んで削減した場合でも、「反転」の観点では大きな違いが生じることを示しています。「反転」とは、答えが不正解から正解へ、またはその逆に変わることを指します。この論文は、レイヤー削減や量子化を行っても MMLU があまり低下しないように見えるのは、一部の不正解が「反転」して正解になっている可能性があるためだと示しています。私たちの目的は元のモデルに一致させることなので、「反転」を測るのは良い指標です。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-5a97c101b0df31fb49df20ce4241930897098cf8%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e4a60354ad8613b6f2361f63fa82c552e00fdda9%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>

{% hint style="info" %}
**KL Divergence** は **量子化誤差を報告するためのゴールドスタンダードの1つであるべきです** 。これは研究論文「Accuracy is Not All You Need」によるものです。 **perplexity の使用は誤りです** 出力トークンの値が相殺し合う可能性があるため、KLD や次のようなより難しいベンチマークを使う必要があります。 [Aider](/docs/jp/ji-chu/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md).
{% endhint %}

また、この論文は KL Divergence が反転と非常に強く相関していることも示しており、私たちの目標は、量子化のディスク容量をできるだけ増やさずに平均 KL Divergence を下げることです。

## ⚖️ キャリブレーションデータセットの過学習

多くのフレームワークは、Wikipedia 記事のテストセットを使って perplexity と KL Divergence を報告します。しかし、Wikipedia 関連でもあるキャリブレーションデータセットを使うと量子化版が過学習し、より低い perplexity スコアを得ることに気付きました。私たちは [Calibration\_v3](https://gist.github.com/bartowski1182/eb213dccb3571f863da82e99418f81e8) と [Calibration\_v5](https://gist.github.com/tristandruyen/9e207a95c7d75ddf37525d353e00659c/) データセットを使用して公平なテストを行っています。これには他のデータの中にいくつかの wikitext データも含まれます。 <mark style="background-color:red;">**また、指示追従モデルには固有のチャットテンプレートがあり、テキストのみのキャリブレーションデータセットは指示追従モデルには有効ではありません**</mark> （ベースモデルでは有効です）。実際、ほとんどの imatrix GGUF は通常この問題を抱えたままキャリブレーションされています。その結果、Wikipedia データも使う KL Divergence ベンチマークでは自然と良い結果を出しやすくなります。モデルが本質的にそのドメインに最適化されているためです。

公平で制御された評価を確保するため、KL Divergence のベンチマークでは、チャット性能向けに最適化された自前のキャリブレーションデータセットは使用しません。代わりに、同じ標準的な Wikipedia データセットを用いてテストし、Dynamic 2.0 手法とベースラインの imatrix 手法を直接比較できるようにしました。

## :1234: MMLU 再現の冒険

* MMLU 5-shot の再現は悪夢のようでした。私たちは <mark style="background-color:red;">**再現できませんでした**</mark> Llama 3.1 (8B) Instruct、Gemma 3 (12B) など多くのモデルで MMLU の結果を再現できませんでした。これは <mark style="background-color:yellow;">**微妙な実装上の問題**</mark>のためです。たとえば Llama 3.1 (8B) は約 68.2% であるべきですが、誤った実装では <mark style="background-color:red;">**35% の精度**</mark>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cc2b4b2bc512b3c9bc065250930259b9b9a9fce0%2FMMLU%20differences.png?alt=media" alt="" width="375"><figcaption><p>MMLU の実装上の問題</p></figcaption></figure>

* Llama 3.1 (8B) Instruct は、素朴な MMLU 実装では 67.8% の MMLU 5-shot 精度を示します。しかし、Llama **は「A」と「\_A」（前にスペースがある A）を異なるトークン ID としてトークナイズします**。スペースありとなしのトークンの両方を考慮すると、68.2% になります <mark style="background-color:green;">(+0.4%)</mark>
* 興味深いことに、Eleuther AI の [LLM Harness](https://github.com/EleutherAI/lm-evaluation-harness/blob/main/lm_eval/tasks/llama3/instruct/mmlu/_continuation_template_yaml) では <mark style="background-color:purple;">**「最良の答えは」**</mark> を質問に付加しており、Llama 3 の元の MMLU ベンチマークに従っています。
* 他にも微妙な問題が多数あるため、すべてを制御された環境でベンチマークするために、私たちは [github.com/hendrycks/test](https://github.com/hendrycks/test) を直接調査し、複数モデルで結果を検証し、報告値と比較することで、独自の MMLU 実装を一から設計しました。

## :sparkles: Gemma 3 QAT 再現、ベンチマーク

Gemma チームは Gemma 3 の2つの QAT（量子化対応学習）版を公開しました:

1. Q4\_0 GGUF - 次の式を用いてすべてのレイヤーを Q4\_0 に量子化します `w = q * block_scale` 各ブロックは 32 個の重みを持ちます。詳細は [llama.cpp wiki ](https://github.com/ggml-org/llama.cpp/wiki/Tensor-Encoding-Schemes)をご覧ください。
2. int4 版 - おそらく [TorchAO int4 スタイル](https://github.com/pytorch/ao/blob/main/torchao/quantization/README.md)?

すべての Q4\_0 GGUF バージョンをベンチマークし、12B モデルで広範な実験を行いました。その結果、 **12B Q4\_0 QAT モデルは 67.07%** であるのに対し、フル bfloat16 の 12B 版は 5-shot MMLU で 67.15% を達成します。非常に印象的です！ 27B モデルもほぼ到達しています！

<table><thead><tr><th>指標</th><th>1B</th><th valign="middle">4B</th><th>12B</th><th>27B</th></tr></thead><tbody><tr><td>MMLU 5 shot</td><td>26.12%</td><td valign="middle">55.13%</td><td><mark style="background-color:blue;"><strong>67.07%（67.15% BF16）</strong></mark></td><td><strong>70.64%（71.5% BF16）</strong></td></tr><tr><td>ディスク容量</td><td>0.93GB</td><td valign="middle">2.94GB</td><td><strong>7.52GB</strong></td><td>16.05GB</td></tr><tr><td><mark style="background-color:green;"><strong>効率*</strong></mark></td><td>1.20</td><td valign="middle">10.26</td><td><strong>5.59</strong></td><td>2.84</td></tr></tbody></table>

新しい **効率指標** を設計しました。これは、モデルの有用性を、ディスクサイズと MMLU 5-shot スコアも考慮して計算します:

$$
\text{Efficiency} = \frac{\text{MMLU 5 shot score} - 25}{\text{Disk Space GB}}
$$

{% hint style="warning" %}
私たちは **25 を引く必要があります** なぜなら、MMLU には A、B、C、D の4つの選択肢があるからです。たとえば、単にランダムに答えを選ぶモデルを作るとしましょう。その場合、精度は 25% で、ディスク容量は数バイトです。しかし、明らかにこれは有用なモデルではありません。
{% endhint %}

ベースモデルに対する KL Divergence では、以下に改善を示す表があります。なお、KL Divergence は 0 に近いほど良く、0 はフル精度モデルと同一であることを意味します。

| 量子化版      | ベースライン KLD | GB    | 新しい KLD  | GB    |
| --------- | ---------- | ----- | -------- | ----- |
| IQ1\_S    | 1.035688   | 5.83  | 0.972932 | 6.06  |
| IQ1\_M    | 0.832252   | 6.33  | 0.800049 | 6.51  |
| IQ2\_XXS  | 0.535764   | 7.16  | 0.521039 | 7.31  |
| IQ2\_M    | 0.26554    | 8.84  | 0.258192 | 8.96  |
| Q2\_K\_XL | 0.229671   | 9.78  | 0.220937 | 9.95  |
| Q3\_K\_XL | 0.087845   | 12.51 | 0.080617 | 12.76 |
| Q4\_K\_XL | 0.024916   | 15.41 | 0.023701 | 15.64 |

ディスク容量増加率と KL Divergence 比率の変化をプロットすると、はるかに明確な利点が見えます！ 私たちの dynamic 2bit Q2\_K\_XL は KLD をかなり削減します（約7.5%）。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-5b352d0449e723556e6e871396c2ee78ae8ec3dc%2Fchart(2).svg?alt=media" alt=""><figcaption></figcaption></figure>

Gemma 3（27B）の MMLU 結果の要約表。以下を参照してください。

1. **私たちの dynamic 4bit 版は、QAT 版より 2GB 小さいのに、精度は +1% 高いです！**
2. 効率面では、2bit Q2\_K\_XL などが非常に優れているようです！

| 量子化版           | Unsloth   | Unsloth + QAT | ディスクサイズ   | 効率       |
| -------------- | --------- | ------------- | --------- | -------- |
| IQ1\_M         | 48.10     | 47.23         | 6.51      | 3.42     |
| IQ2\_XXS       | 59.20     | 56.57         | 7.31      | 4.32     |
| IQ2\_M         | 66.47     | 64.47         | 8.96      | 4.40     |
| Q2\_K\_XL      | 68.70     | 67.77         | 9.95      | 4.30     |
| Q3\_K\_XL      | 70.87     | 69.50         | 12.76     | 3.49     |
| **Q4\_K\_XL**  | **71.47** | **71.07**     | **15.64** | **2.94** |
| **Google QAT** |           | **70.64**     | **17.2**  | **2.65** |

<details>

<summary><mark style="color:緑;">ここをクリック</mark> して Google の Gemma 3（27B）QAT ベンチマーク全体を見る:</summary>

| モデル            | Unsloth   | Unsloth + QAT | ディスクサイズ   | 効率       |
| -------------- | --------- | ------------- | --------- | -------- |
| IQ1\_S         | 41.87     | 43.37         | 6.06      | 3.03     |
| IQ1\_M         | 48.10     | 47.23         | 6.51      | 3.42     |
| IQ2\_XXS       | 59.20     | 56.57         | 7.31      | 4.32     |
| IQ2\_M         | 66.47     | 64.47         | 8.96      | 4.40     |
| Q2\_K          | 68.50     | 67.60         | 9.78      | 4.35     |
| Q2\_K\_XL      | 68.70     | 67.77         | 9.95      | 4.30     |
| IQ3\_XXS       | 68.27     | 67.07         | 10.07     | 4.18     |
| Q3\_K\_M       | 70.70     | 69.77         | 12.51     | 3.58     |
| Q3\_K\_XL      | 70.87     | 69.50         | 12.76     | 3.49     |
| Q4\_K\_M       | 71.23     | 71.00         | 15.41     | 2.98     |
| **Q4\_K\_XL**  | **71.47** | **71.07**     | **15.64** | **2.94** |
| Q5\_K\_M       | 71.77     | 71.23         | 17.95     | 2.58     |
| Q6\_K          | 71.87     | 71.60         | 20.64     | 2.26     |
| Q8\_0          | 71.60     | 71.53         | 26.74     | 1.74     |
| **Google QAT** |           | **70.64**     | **17.2**  | **2.65** |

</details>

## :llama: Llama 4 のバグ修正 + 実行

私たちも Llama 4 のいくつかのバグ修正を支援しました:

* Llama 4 Scout は公式リポジトリで RoPE Scaling の設定を変更しました。これを有効にするため、llama.cpp の問題解決を支援しました [ここで変更](https://github.com/ggml-org/llama.cpp/pull/12889)

  <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7ff8229dfa96425f50c2c87f9ca988ef9cc99eff%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
* Llama 4 の Scout と Maverick の両方における QK Norm の epsilon は設定ファイルから取得する必要があります。つまり 1e-05 を使い、1e-06 ではありません。私たちはこれらの問題の解決を [llama.cpp](https://github.com/ggml-org/llama.cpp/pull/12889) と [transformers](https://github.com/huggingface/transformers/pull/37418)
* で支援しました。Llama 4 チームと vLLM も、QK Norm が全ヘッドで共有されていた問題（本来そうではない）を独自に修正しました [こちら](https://github.com/vllm-project/vllm/pull/16311)。MMLU Pro は 68.58% から 71.53% に向上しました。
* [Wolfram Ravenwolf](https://x.com/WolframRvnwlf/status/1909735579564331016) は、llama.cpp を通した私たちの GGUF がサードパーティの推論プロバイダよりはるかに高い精度を達成していることを示しました。これは前述の問題の組み合わせ、そしておそらく量子化の問題によるものでした。

  <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-76c49d8c8e3e42f7407f431a2cede369f87878e4%2FGoC79hYXwAAPTMs.jpg?alt=media" alt=""><figcaption></figcaption></figure>

グラフで示したように、私たちの 4-bit Dynamic QAT 量子化は、サイズが小さいにもかかわらず 5-shot MMLU でより良い性能を発揮します。

### Llama 4 Scout の実行:

たとえば Llama 4 Scout を実行するには、まず llama.cpp をクローンします:

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

それでは、新しい dynamic v 2.0 の Scout 向け量子化版をダウンロードします:

```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
    local_dir = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
    allow_patterns = ["*IQ2_XXS*"],
)
```

では、推論してみましょう！

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF/Llama-4-Scout-17B-16E-Instruct-UD-IQ2_XXS.gguf \
    --threads 32 \
    --ctx-size 16384 \
    --n-gpu-layers 99 \
    -ot ".ffn_.*_exps.=CPU" \
    --seed 3407 \
    --prio 3 \
    --temp 0.6 \
    --min-p 0.01 \
    --top-p 0.9 \
    -no-cnv \
    --prompt "<|header_start|>user<|header_end|>\n\nFlappy Bird ゲームを作成してください。<|eot|><|header_start|>assistant<|header_end|>\n\n"
```

{% endcode %}

{% hint style="success" %}
Llama 4 の実行について詳しくはこちら: <https://docs.unsloth.ai/basics/tutorial-how-to-run-and-fine-tune-llama-4>
{% endhint %}


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/ji-chu/dynamic-3.0-ggufs.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.
