> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/nvfp4.md).
# Guide d’exécution d’Unsloth Dynamic NVFP4
Découvrez comment Unsloth Dynamic NVFP4 permet une inférence 4 bits rapide et précise sur les GPU NVIDIA Blackwell.
Unsloth Dynamic NVFP4 est un format de modèle quantifié qui s’exécute sur les GPU NVIDIA Blackwell et est conçu pour une inférence 4 bits plus rapide et plus précise. Il combine la précision native NVFP4 de NVIDIA avec [Unsloth Dynamic 2.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) la quantification pour préserver la précision du modèle tout en réduisant l’utilisation de la VRAM et en augmentant la vitesse. Ce guide explique la quantification FP4, compare NVFP4 à d’autres formats et montre comment exécuter des modèles comme [Qwen3.8](/docs/fr/modeles/qwen3.8.md), [Gemma 4](/docs/fr/modeles/gemma-4.md) et [Qwen3.6](/docs/fr/modeles/qwen3.6.md) localement avec vLLM ou SGLang sur les RTX 5050-5090, B200, RTX PRO 6000 et bien d’autres GPU.
Dynamic NVFP4 fonctionne en sélectionnant les couches importantes à conserver en FP8 (W8A8) ou BF16, et le reste en W4A4 (et non W4A16), au lieu de forcer chaque couche en FP4. Cela permet jusqu’à **2,5x d’inférence plus rapide** car W4A4 exploite les cœurs tenseurs FP4 du GPU Blackwell. Pour tous les quants, nous fournissons aussi un étalonnage du cache KV en FP8 permettant **des longueurs de contexte 2x plus longues**.
{% hint style="success" %}
**14 août :** [**Qwen3.8-27B**](/docs/fr/modeles/qwen3.8.md) **est désormais disponible, ainsi que notre quant NVFP4.**
**Tous** [**Gemma 4**](#gemma-4) **les modèles sont désormais disponibles en tant que quants Unsloth Dynamic NVFP4 :** E2B, E4B, 12B Unified, 26B-A4B MoE et 31B Dense.
Découvrez la [collection Unsloth Dynamic NVFP4](https://huggingface.co/collections/unsloth/nvfp4) pour tous nos téléversements de modèles.
{% endhint %}
### Float4 vs autres précisions
L’astuce pour **les GPU plus rapides consiste à réduire la précision numérique des multiplications matricielles**. Le nombre de transistors nécessaires pour les unités de multiplication matricielle est lié au **carré de la mantisse**. La mantisse permet aux nombres d’avoir combien de décimales « fractionnaires » — plus il y a de bits, plus elle peut représenter les décimales avec précision. Par exemple, exprimer 0,121332 est possible avec plus de bits de mantisse, tandis que peu de bits de mantisse l’arrondiront à 0,1.
{% columns %}
{% column width="50%" %}
FP32 a 23 bits de mantisse, donc 23^2 + 8 bits d’exposant = 537 d’espace sont nécessaires. Le bfloat16 a 7 bits de mantisse, donc 7^2 + 8 d’exposant = 57 d’espace. Cela signifie que le bfloat16 nécessite environ 9x moins d’espace que le FP32 ! Et lorsque nous passons au float8, qui a 3 bits de mantisse, alors 3^2 + 4 d’exposant = 13 — soit 41x moins d’espace que le FP32 !
Enfin, le float4 a 1 bit de mantisse et 2 exposants, donc 3 d’espace — soit un énorme gain de 179x moins d’espace que le FP32 — cela signifie essentiellement qu’un **GPU peut effectuer environ 179x plus de multiplications matricielles FP4 que de FLOPs de multiplication FP32 dans le même espace**!
{% endcolumn %}
{% column width="50%" %}

{% endcolumn %}
{% endcolumns %}
### NVFP4 vs MXFP4
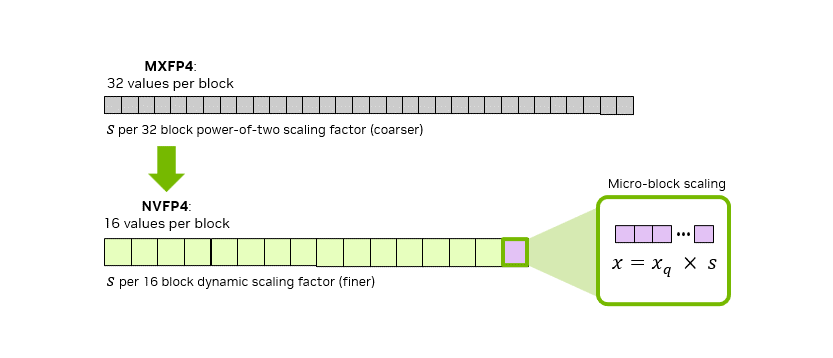
Il existe un autre format FP4 appelé MXFP4 — il est moins précis que NVFP4 pour 2 raisons :
1. NVFP4 utilise une taille de bloc de 16 contre 32 pour MXFP4 — cela permet d’isoler plus facilement les valeurs aberrantes et des facteurs d’échelle sont fournis pour des sous-ensembles plus petits de poids, ce qui augmente la précision
2. Une échelle E4M3 (FP8) est utilisée au lieu d’une E8M0 (mise à l’échelle par puissances de 2) par bloc. L’utilisation d’une taille de bloc de type FP8 semble bien meilleure, surtout pour les LLM.
### Analyse des performances
Nos nouveaux quants dynamiques NVFP4 Qwen3.6 s’exécutent environ**2,5× plus vite** que les autres quants NVFP4, avec **de meilleures performances** et des tailles de fichiers comparables. Exécutez Qwen3.6-27B NVFP4 **2,5x plus vite** sur **24 Go de VRAM** et Qwen3.6-35B-A3B **1,7x plus vite** sur **32 Go de VRAM**. Nous avons également ajouté **l'étalonnage du cache KV FP8** pour des longueurs de contexte 2x plus longues ! NVFP4 nécessite les GPU Blackwell de NVIDIA comme RTX 50X, DGX Spark (voir [#dgx-spark-with-nvfp4-quants](#dgx-spark-with-nvfp4-quants "mention")), B200, B300. Pour les GPU plus anciens, nos GGUF fonctionnent bien !
Tous les benchmarks utilisent 1x B200 avec 128 de concurrence. Une concurrence plus élevée peut faire passer le 35B à 17 561 jetons/s. Nous venons également de publier nos nouveaux [Qwen3.8](/docs/fr/modeles/qwen3.8.md) quants NVFP4 :
* [Qwen3.8-27B NVFP4](https://huggingface.co/unsloth/Qwen3.8-27B-NVFP4) (nouveau)
Nous publions également deux versions NVFP4 du 35B-A3B :
* [Qwen3.6-35B-A3B-NVFP4-Fast](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4-Fast) qui est un quant complet W4A4 — 1,79x plus rapide
* [Qwen3.6-35B-A3B-NVFP4](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4) qui est légèrement plus volumineux mais plus précis et 1,56x plus rapide
Pour les benchmarks de précision, nous avons réalisé MMLU-Pro, AIME 2025, GPQA pour FP8, BF16, NVFP4 de NVIDIA et nos NVFP4 — nous montrons que nos quants plus rapides se comportent de manière similaire sur tous :
| Qwen3.8-27B (nouveau) |
| ------------------------------------------------------------------------------- |
| [Qwen3.8-27B NVFP4](https://huggingface.co/unsloth/Qwen3.8-27B-NVFP4) (nouveau) |
**Les tenseurs MTP sont également intégrés directement dans les quants pour des accélérations supplémentaires.** Les gains de précision proviennent d’améliorations du modèle de chat et de l’étalonnage du jeu de données de Qwen3.6. Nous utilisons nos précédentes mises à jour du modèle de chat pour améliorer la cohérence du codage et des appels d’outils tout en réduisant les boucles et autres problèmes signalés. Notre étalonnage utilise un mélange de notre jeu de données optimisé pour le codage, les appels d’outils et le chat, ainsi qu’UltraChat.
Pour la vitesse de décodage (jetons par personne), le nôtre est 1,03x plus rapide pour le 27B et 1,17x et 1,22x plus rapide pour le 35B.
### Aperçu
Ci-dessous se trouvent les exigences matérielles pour les modèles que vous pouvez utiliser, notamment Gemma 4 et Qwen3.6. Voyez aussi l’amélioration globale de vitesse que vous obtiendrez :
#### Gemma 4 :
| Variante Gemma 4 | VRAM requise | Plus rapide que BF16 |
| ------------------------------------------------------------------ | -----------: | -------------------: |
| [E2B](https://huggingface.co/unsloth/gemma-4-E2B-it-NVFP4) | 7 Go | 1,12× plus rapide |
| [E4B](https://huggingface.co/unsloth/gemma-4-E4B-it-NVFP4) | 9 Go | 1,22× plus rapide |
| [12B unifié](https://huggingface.co/unsloth/gemma-4-12b-it-NVFP4) | 11 Go | 1,26× plus rapide |
| [26B A4B](https://huggingface.co/unsloth/gemma-4-26B-A4B-it-NVFP4) | 26 Go | 1,41× plus rapide |
| [31B](https://huggingface.co/unsloth/gemma-4-31B-it-NVFP4) | 32 Go | 1,45× plus rapide |
#### Qwen3.6 :
| variante Qwen3.6 | VRAM requise | Plus rapide que les autres quants NVFP4 |
| ------------------------------------------------------------------------- | -----------: | --------------------------------------: |
| [27B](https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4) | 24 Go | 2,5× plus vite |
| [35B A3B](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4) | 32 Go | 1,56× plus rapide |
| [35B A3B Fast](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4-Fast) | 32 Go | 1,79× plus rapide |
### Benchmarks NVFP4
NVFP4 exécute les poids 4 bits et les multiplications matricielles directement sur les Tensor Cores Blackwell. Nos quants NVFP4 Qwen3.6 utilisent W4A4, ils utilisent donc réellement les cœurs tenseurs FP4, et décodent donc plus rapidement que ceux de NVIDIA qui utilisent W4A16. Nous quantifions également les couches de manière dynamique pour préserver la précision, et nous avons réalisé MMLU-Pro, AIME 2025 et GPQA pour tous les quants, y compris des comparaisons avec FP8 et BF16.
**Benchmarks de précision NVFP4 Qwen3.6-27B**
| Fournisseur | MMLU-Pro | GPQA | AIME 2025 |
| ----------- | -------: | ----: | --------: |
| Unsloth | 86.25 | 86.34 | 93.12 |
| NVIDIA | 85.96 | 86.87 | 93.12 |
| FP8 | 86.11 | 86.87 | 93.75 |
| BF16 | 85.96 | 88.13 | 93.33 |
**Benchmarks de précision NVFP4 Qwen3.6-35B-A3B**
| Fournisseur | MMLU-Pro | GPQA | AIME 2025 |
| ---------------- | -------: | ----: | --------: |
| Unsloth | 85.85 | 86.74 | 92.29 |
| **Unsloth Fast** | 85.58 | 87.75 | 91.67 |
| NVIDIA | 85.60 | 87.12 | 91.88 |
| FP8 | 85.75 | 86.74 | 93.12 |
| BF16 | 85.75 | 86.36 | 92.50 |
Nous avons également vérifié la longueur de sortie de tous les benchmarks, et elles sont comparables, donc les nouveaux quants NVFP4 ne réfléchissent pas plus longtemps, ce qui irait à l’encontre de l’objectif de les quantifier ! (C’est-à-dire que si c’est 2x plus rapide, mais que cela réfléchit 2x plus, alors c’est inutile)
## **Exécuter les tutoriels NVFP4**
Pour exécuter les quants NVFP4, voir ci-dessous les commandes pour exécuter Qwen3.6-27B dans [vLLM](/docs/fr/notions-de-base/inference-and-deployment/vllm-guide.md) et [SGLang](/docs/fr/notions-de-base/inference-and-deployment/sglang-guide.md) (vous pouvez changer le nom du modèle en `Qwen3.6-35-A3B-NVFP4`).
### **Tutoriel vLLM**
Vous pouvez exécuter tous les modèles NVFP4 dans [vLLM](https://github.com/vllm-project/vllm). NE sélectionnez PAS de backend MoE — laissez vLLM le sélectionner — par exemple, Marlin est 2,5x plus lent ! Voir [#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl](#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl "mention")Si vous avez un DGX Spark, voir [#dgx-spark-serving](#dgx-spark-serving "mention") vous devez utiliser `--moe-backend flashinfer_b12x` sinon vous obtiendrez une inférence beaucoup plus lente.
Pour installer vLLM dans un venv séparé :
{% code overflow="wrap" expandable="true" %}
```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \\
--torch-backend=auto
```
{% endcode %}
Ensuite, pour servir la variante 35B Fast :
```shell
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
```
Modifiez `unsloth/Qwen3.6-35B-A3B-NVFP4-Fast` aux noms des quants NVFP4 !
Pour activer MTP / décodage spéculatif (décodage plus rapide mais débit quelque peu inférieur), utilisez :
```bash
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
--speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
```
Si vous rencontrez des problèmes Torchcodec, assurez-vous de faire ce qui suit puis relancez vllm.
{% code overflow="wrap" expandable="true" %}
```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```
{% endcode %}
### **Tutoriel DGX Spark**
Pour s’assurer que DGX Spark possède les bons kernels (sinon vous obtiendrez **une inférence 2x PLUS LENTE**), vérifiez d’abord :
{% code overflow="wrap" expandable="true" %}
```bash
python -c \"
import torch; from vllm.utils.flashinfer import has_flashinfer_b12x_gemm as g, has_flashinfer_b12x_moe as m
cap = torch.cuda.get_device_capability(); print('cap', cap, '| b12x gemm', g(), '| b12x moe', m()); assert cap[0] == 12 and g() and m(), 'b12x indisponible : le service reviendrait à marlin W4A16'\"
```
{% endcode %}
qui ne devrait PAS produire d’erreur — si c’était le cas, veuillez mettre à jour vllm ou réinstaller via :
{% code overflow="wrap" expandable="true" %}
```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \\
--torch-backend=auto
```
{% endcode %}
Ensuite, pour servir dans vLLM pour DGX Spark :
{% code overflow="wrap" expandable="true" %}
```shellscript
export CUTE_DSL_ARCH=sm_121a
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast --moe-backend flashinfer_b12x
```
{% endcode %}
Si vous rencontrez des problèmes Torchcodec, assurez-vous de faire ce qui suit puis relancez vllm.
{% code overflow="wrap" expandable="true" %}
```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```
{% endcode %}
### **Tutoriel SGLang :**
Vous pouvez exécuter tous les modèles NVFP4 dans [SGLang](https://github.com/sgl-project/sglang). N’oubliez pas de remplacer le nom du modèle par le modèle souhaité.
**Qwen3.6 :**
```bash
python -m sglang.launch_server --model-path unsloth/Qwen3.6-27B-NVFP4 --speculative-algorithm NEXTN \
--speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
```
**Gemma 4 :**
```bash
python -m sglang.launch_server --model-path unsloth/Gemma-4-31B-NVFP4 --speculative-algorithm NEXTN \
--speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
```
### Gemma 4 et autres
Chaque variante Gemma 4 dispose désormais d’un checkpoint Unsloth Dynamic NVFP4.
Nous montrons que Gemma-4 n’offre au maximum qu’une hausse de débit de 1,44x en servant 128 personnes simultanément sur 1x B200 par rapport au BF16. Qwen3.5-122B-A10B est 1,38x plus rapide et GLM-4.7-Flash est 1,27x plus rapide.
### Marlin vs Flashinfer vs cutlass vs cute-DSL
Nous avons également constaté que les kernels Marlin ne prennent pas bien en charge W4A4 — l’activer entraînera une dégradation des performances de 2,5x — donc utilisez CUTLASS, Flashinfer-TRTLLM ou Cute-DSL (activé automatiquement dans vLLM) ! Si vous avez aussi un DGX Spark, voir [#dgx-spark-serving](#dgx-spark-serving "mention") vous devez utiliser `--moe-backend flashinfer_b12x` sinon vous obtiendrez une inférence 2,5x plus lente.
**Donc ne définissez aucun backend — vLLM sélectionne automatiquement le meilleur.**
| Modèle | schéma | backend | tok/s de décodage | tok/s de débit |
| --------------- | ------ | ------------------- | ----------------- | -------------- |
| nvidia 27B | W4A16 | marlin (auto) | 115.6 | 2,403 |
| unsloth 27B | W4A4 | marlin | 105.6 | 2,127 |
| unsloth 27B | W4A4 | cutlass | 113.5 | 6,681 |
| unsloth 27B | W4A4 | flashinfer\_trtllm | 112.6 | 6,158 |
| unsloth 27B | W4A4 | **cute-DSL (auto)** | 125.9 | **6,863** |
| nvidia 35B-A3B | W4A4 | marlin (auto) | 240.8 | 8,721 |
| unsloth 35B-A3B | W4A4 | marlin | 215.8 | 8,619 |
| unsloth 35B-A3B | W4A4 | cutlass | 158.3 | 11,017 |
| unsloth 35B-A3B | W4A4 | **cute-DSL (auto)** | 295.2 | **15,636** |
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/notions-de-base/nvfp4.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.