> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/faster-moe.md).

# Fine-tuner des modèles MoE 12x plus vite avec Unsloth

Guide pour entraîner localement des LLM MoE avec Unsloth.

Nous présentons un entraînement des LLM Mixture of Experts (MoE) \~12x plus rapide grâce à **>35 % de VRAM en moins** et **contexte \~6x plus long** grâce à nos nouveaux kernels MoE Triton et à de nouvelles optimisations mathématiques, le tout sans perte de précision.

* Unsloth prend désormais en charge l'entraînement rapide des architectures MoE, notamment [gpt-oss](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune.md), [Qwen3](/docs/fr/modeles/tutorials/qwen3-how-to-run-and-fine-tune.md) (30B, 235B, VL, Coder), DeepSeek [R1](/docs/fr/modeles/tutorials/deepseek-r1-0528-how-to-run-locally.md), [V3](/docs/fr/modeles/tutorials/deepseek-v3.1-how-to-run-locally.md) et GLM ([4.6](https://unsloth.ai/docs/fr/notions-de-base/pages/dae16239a066aab3e73d5ba62459a60853a54430#glm-4.6v-flash), [4.7](/docs/fr/modeles/tutorials/glm-4.7.md), [Flash](/docs/fr/modeles/tutorials/glm-4.7-flash.md)).
* gpt-oss-20b se fine-tune en **12,8 Go de VRAM**. Qwen3-30B-A3B (LoRA 16 bits) utilise 63 Go.
* Nos kernels fonctionnent aussi bien sur les centres de données (B200, H100), **grand public** et sur les GPU plus anciens (par ex. RTX 3090), ainsi qu'avec FFT, LoRA et QLoRA.

En collaboration avec 🤗Hugging Face, nous avons standardisé tous les entraînements MoE avec la nouvelle `torch._grouped_mm` fonction. Transformers v5 a récemment été optimisé avec un MoE \~6x plus rapide que la v4, et Unsloth va encore plus loin avec des kernels Triton grouped‑GEMM + LoRA personnalisés pour un **supplémentaire** gain de vitesse \~2x, une réduction de VRAM de >35 % et un contexte >6x plus long (gain global de 12 à 30x par rapport à v4).

Essayez nos notebooks Unsloth pour un entraînement MoE rapide :

| [**gpt-oss (20b)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-Fine-tuning.ipynb) **(gratuit)** | [Qwen3-30B-A3B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_MoE.ipynb) (A100)                                   | [GLM-4.7-Flash](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/GLM_Flash_A100\(80GB\).ipynb) (A100)   |
| ---------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------- |
| [gpt-oss-120b](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(120B\)_A100-Fine-tuning.ipynb) (A100)       | [gpt-oss (contexte 500K)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb) | [TinyQwen3 MoE](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/TinyQwen3_MoE.ipynb) (test uniquement) |

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FZYAbbmao7vQbKGr7Rtiv%2Fgraph%20results%20only.png?alt=media&amp;token=6cfb4f27-3e78-48d3-b3db-12eb4b3dcde3" alt="" width="563"><figcaption></figcaption></figure>

### 🦥 Kernels Triton MoE Unsloth

En parallèle `torch._grouped_mm` (voir [#what-is-torch.\_grouped\_mm](#what-is-torch._grouped_mm "mention")), nous avons créé des kernels MoE Triton personnalisés qui peuvent être encore plus rapides dans certains cas. Ils sont également **compatibles avec les versions antérieures** avec du matériel plus ancien comme l'A100, et avec d'anciennes versions de PyTorch.

{% columns %}
{% column width="50%" %}
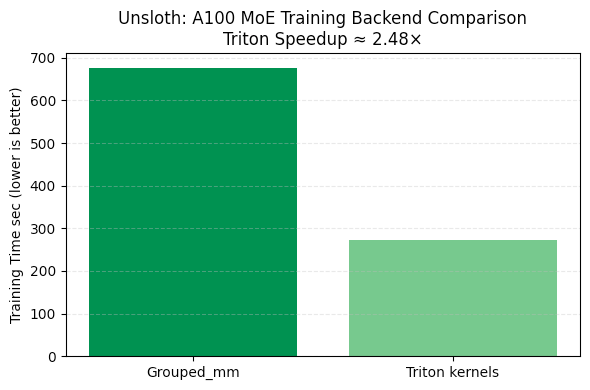
Sur A100, nos **kernels Triton sont \~2,5× plus rapides** que `torch._grouped_mm`. Les kernels disposent aussi d'une étape d'autotuning unique pour choisir la meilleure configuration.

L'autotuning prend environ 2 minutes une seule fois au début de l'entraînement, mais peut accélérer l'ensemble de l'exécution de 35 % sur A100 par rapport à `_grouped_mm`, ce qui en vaut largement la peine pour les exécutions longues.
{% endcolumn %}

{% column width="50%" %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F5COXvwLZwdY61BhFvjnI%2Funknown.png?alt=media&amp;token=59f07dcc-cb11-47d4-bacc-ec27e7454f19" alt="" width="295"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% hint style="success" %}
Plus le modèle est grand et plus vous utilisez de contexte, **plus les économies de mémoire apportées par nos kernels Unsloth seront marquées** (l'efficacité augmentera de façon exponentielle).
{% endhint %}

### :compass: Sélection automatique du backend

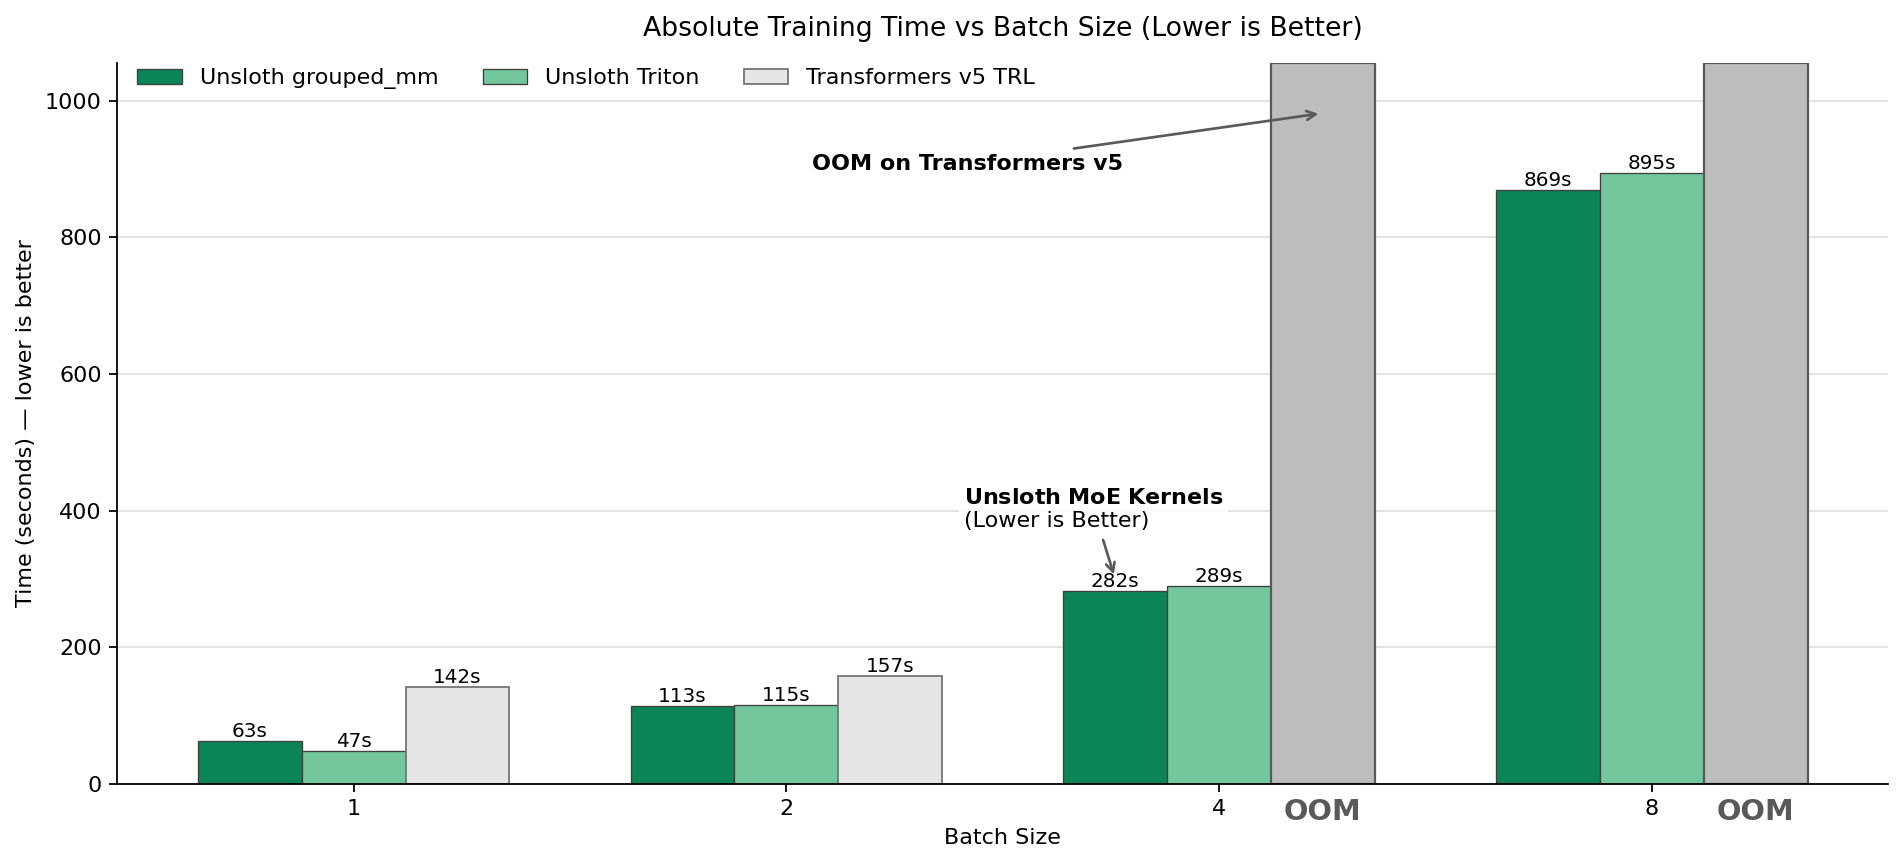
Notre principale innovation est notre **approche Split LoRA** pour un MoE efficace, qui utilise \~35 % de mémoire en moins et permet un entraînement 2x plus rapide par rapport à Transformers v5 + `torch._grouped_mm`. Personnalisé `torch._grouped_mm` + nos kernels Triton sont \~12-30x plus rapides que Transformers v4.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKHbKsPvtiK06Uogklven%2Fnicer_training_time_vs_batch_final_tweaks6_bold.png?alt=media&amp;token=448853ff-b760-46ad-8e9b-599c6862762b" alt="" width="563"><figcaption></figcaption></figure>

{% hint style="warning" %}
L'entraînement de modèles MoE en **4 bits** QLoRA n'est pas recommandé pour l'instant car BitsandBytes ne le prend pas en charge. Ce n'est pas spécifique à Unsloth. Pour l'instant, utilisez bf16 pour LoRA ou un fine-tuning complet.
{% endhint %}

Unsloth sélectionnera automatiquement l'un des backends suivants selon votre matériel :

<table><thead><tr><th width="144.95001220703125">Backend</th><th>Optimisations</th></tr></thead><tbody><tr><td>grouped_mm</td><td><code>torch._grouped_mm</code> - disponible des T4 jusqu'aux B200, mais optimisé pour les H100 et plus.</td></tr><tr><td>unsloth_triton</td><td>Kernels Triton Unsloth - qui s'activeront automatiquement sur les A100, et sur les anciennes versions de PyTorch.</td></tr><tr><td>native_torch</td><td>PyTorch natif. C'est 12x plus lent, mais nos réductions de VRAM sont toujours là !</td></tr></tbody></table>

Vous pouvez aussi les activer/désactiver vous-même :

```python
os.environ["UNSLOTH_MOE_BACKEND"] = "grouped_mm"
os.environ["UNSLOTH_MOE_BACKEND"] = "unsloth_triton"
os.environ["UNSLOTH_MOE_BACKEND"] = "native_torch"
```

{% hint style="success" %}
Pour activer un entraînement MoE plus rapide, mettez à jour Unsloth via `pip install --upgrade unsloth unsloth_zoo`
{% endhint %}

### ❓Qu'est-ce que torch.\_grouped\_mm ?

Auparavant, les poids du Mixture-of-Experts (MoE) étaient stockés sous la forme d'une `ModuleList` de couches linéaires par expert. La seule manière pratique d'exécuter un passage avant était une boucle for sur les experts, ce qui est coûteux et sous-optimal.

```python
for expert_idx in expert_hit:
    expert_idx = expert_idx[0]
    if expert_idx == num_experts: continue
    _, token_idx = torch.where(expert_mask[expert_idx])
    current_state = hidden_states[token_idx]
    gate, up = nn.functional.linear(current_state, self.gate_up_proj[expert_idx]).chunk(2, dim=-1)
```

PyTorch a récemment introduit [`grouped_mm`](https://docs.pytorch.org/docs/main/generated/torch.nn.functional.grouped_mm.html) pour résoudre précisément ce goulot d'étranglement. En parallèle, nous fournissons nos propres kernels Triton optimisés pour MoE. Cela correspond aussi à un changement clé de Transformers : depuis Transformers v5, les poids des experts sont stockés sous la forme d'un [`unique nn.Parameter`](https://github.com/huggingface/transformers/blob/v5.0.0/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L226), ce qui en fait `grouped_mm` un choix naturel pour un entraînement et une inférence MoE plus rapides.

Donc [transformers 4.57.6](https://github.com/huggingface/transformers/blob/v4.57.6/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L222) a changé :

{% code overflow="wrap" %}

```python
self.experts = nn.ModuleList(
    [Qwen3MoeMLP(config, intermediate_size) for _ in range(self.num_experts)]
)
```

{% endcode %}

à [transformers 5.0.0](https://github.com/huggingface/transformers/blob/v5.0.0/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L226) style :

{% code overflow="wrap" %}

```python
self.gate_up_proj = nn.Parameter(torch.empty(num_experts, 2 * intermediate_dim, hidden_dim))
```

{% endcode %}

`torch._grouped_mm` fonctionne sur les GPU à partir de la NVIDIA T4, et nous l'avons vérifié sur H100, A100, B200 et RTX 6000 Pro, donc la prise en charge est largement disponible.

Nous avions également déjà présenté Unsloth [Flex Attention](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) pour gpt-oss, et ces optimisations devraient le rendre encore plus efficace.

## 📊 Résultats des kernels + benchmarks

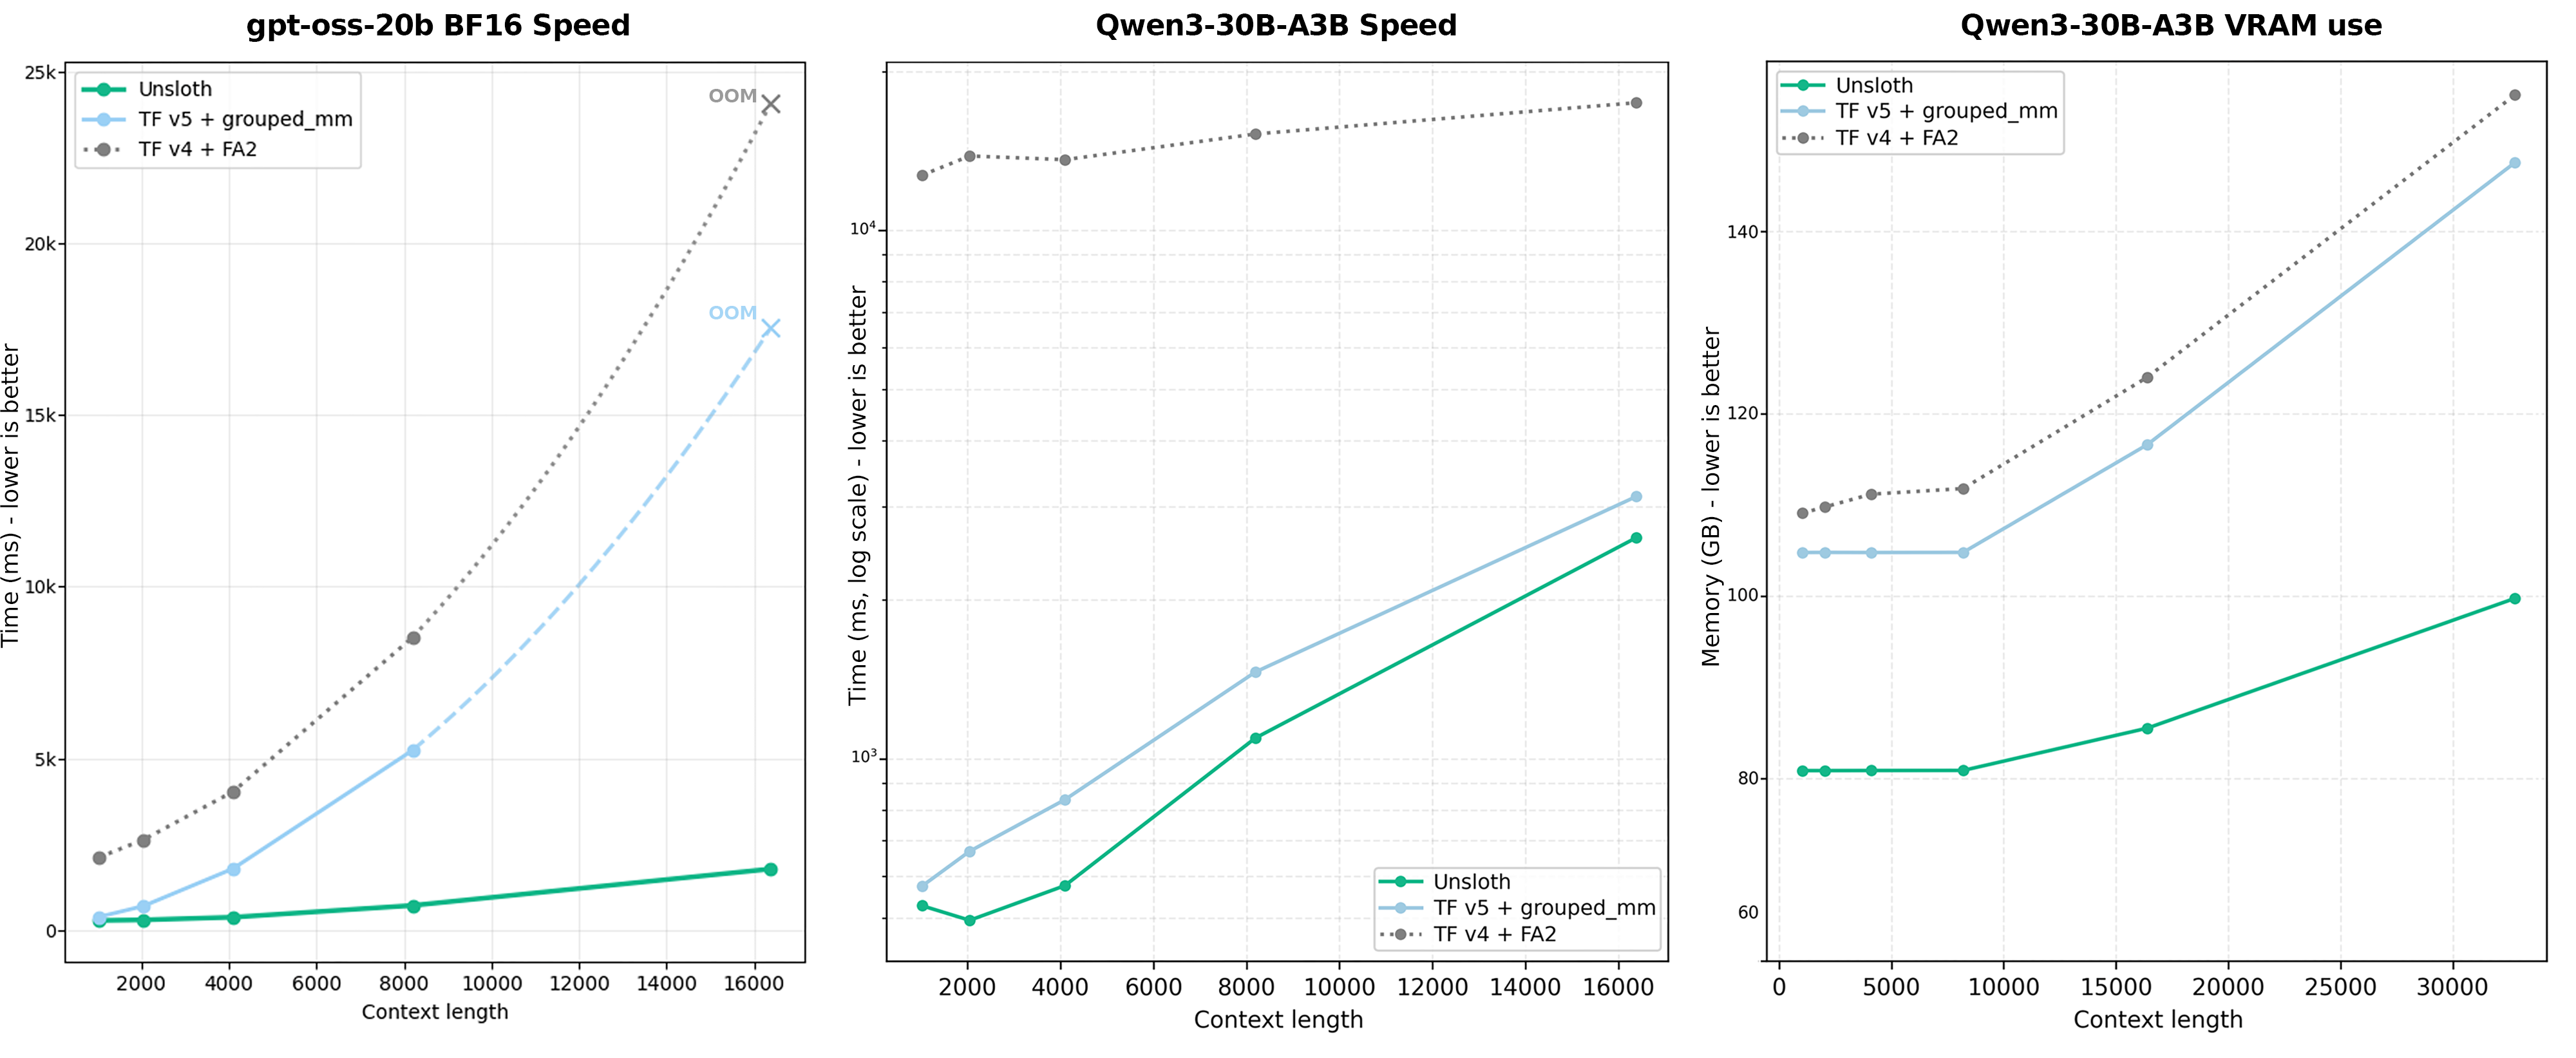
Voici une comparaison selon les longueurs de séquence pour la vitesse d'entraînement et l'utilisation mémoire par rapport à Transformers v5 (qui utilise déjà `torch._grouped_mm` pour MoE). Pour **l'entraînement BF16 MoE de gpt-oss, nous observons un entraînement 7x plus rapide et une réduction de 36 % de la VRAM** sur NVIDIA B200. Pour Qwen3-30B-A3B, c'est 1,8x plus rapide, et **GLM 4.7 Flash est 2,1x plus rapide sur RTX PRO 6000**. Tous les benchmarks sont réalisés avec un rang LoRA = 64 et tous les modules LoRA sur les couches MoE (gate, up, down).

### Benchmarks gpt-oss

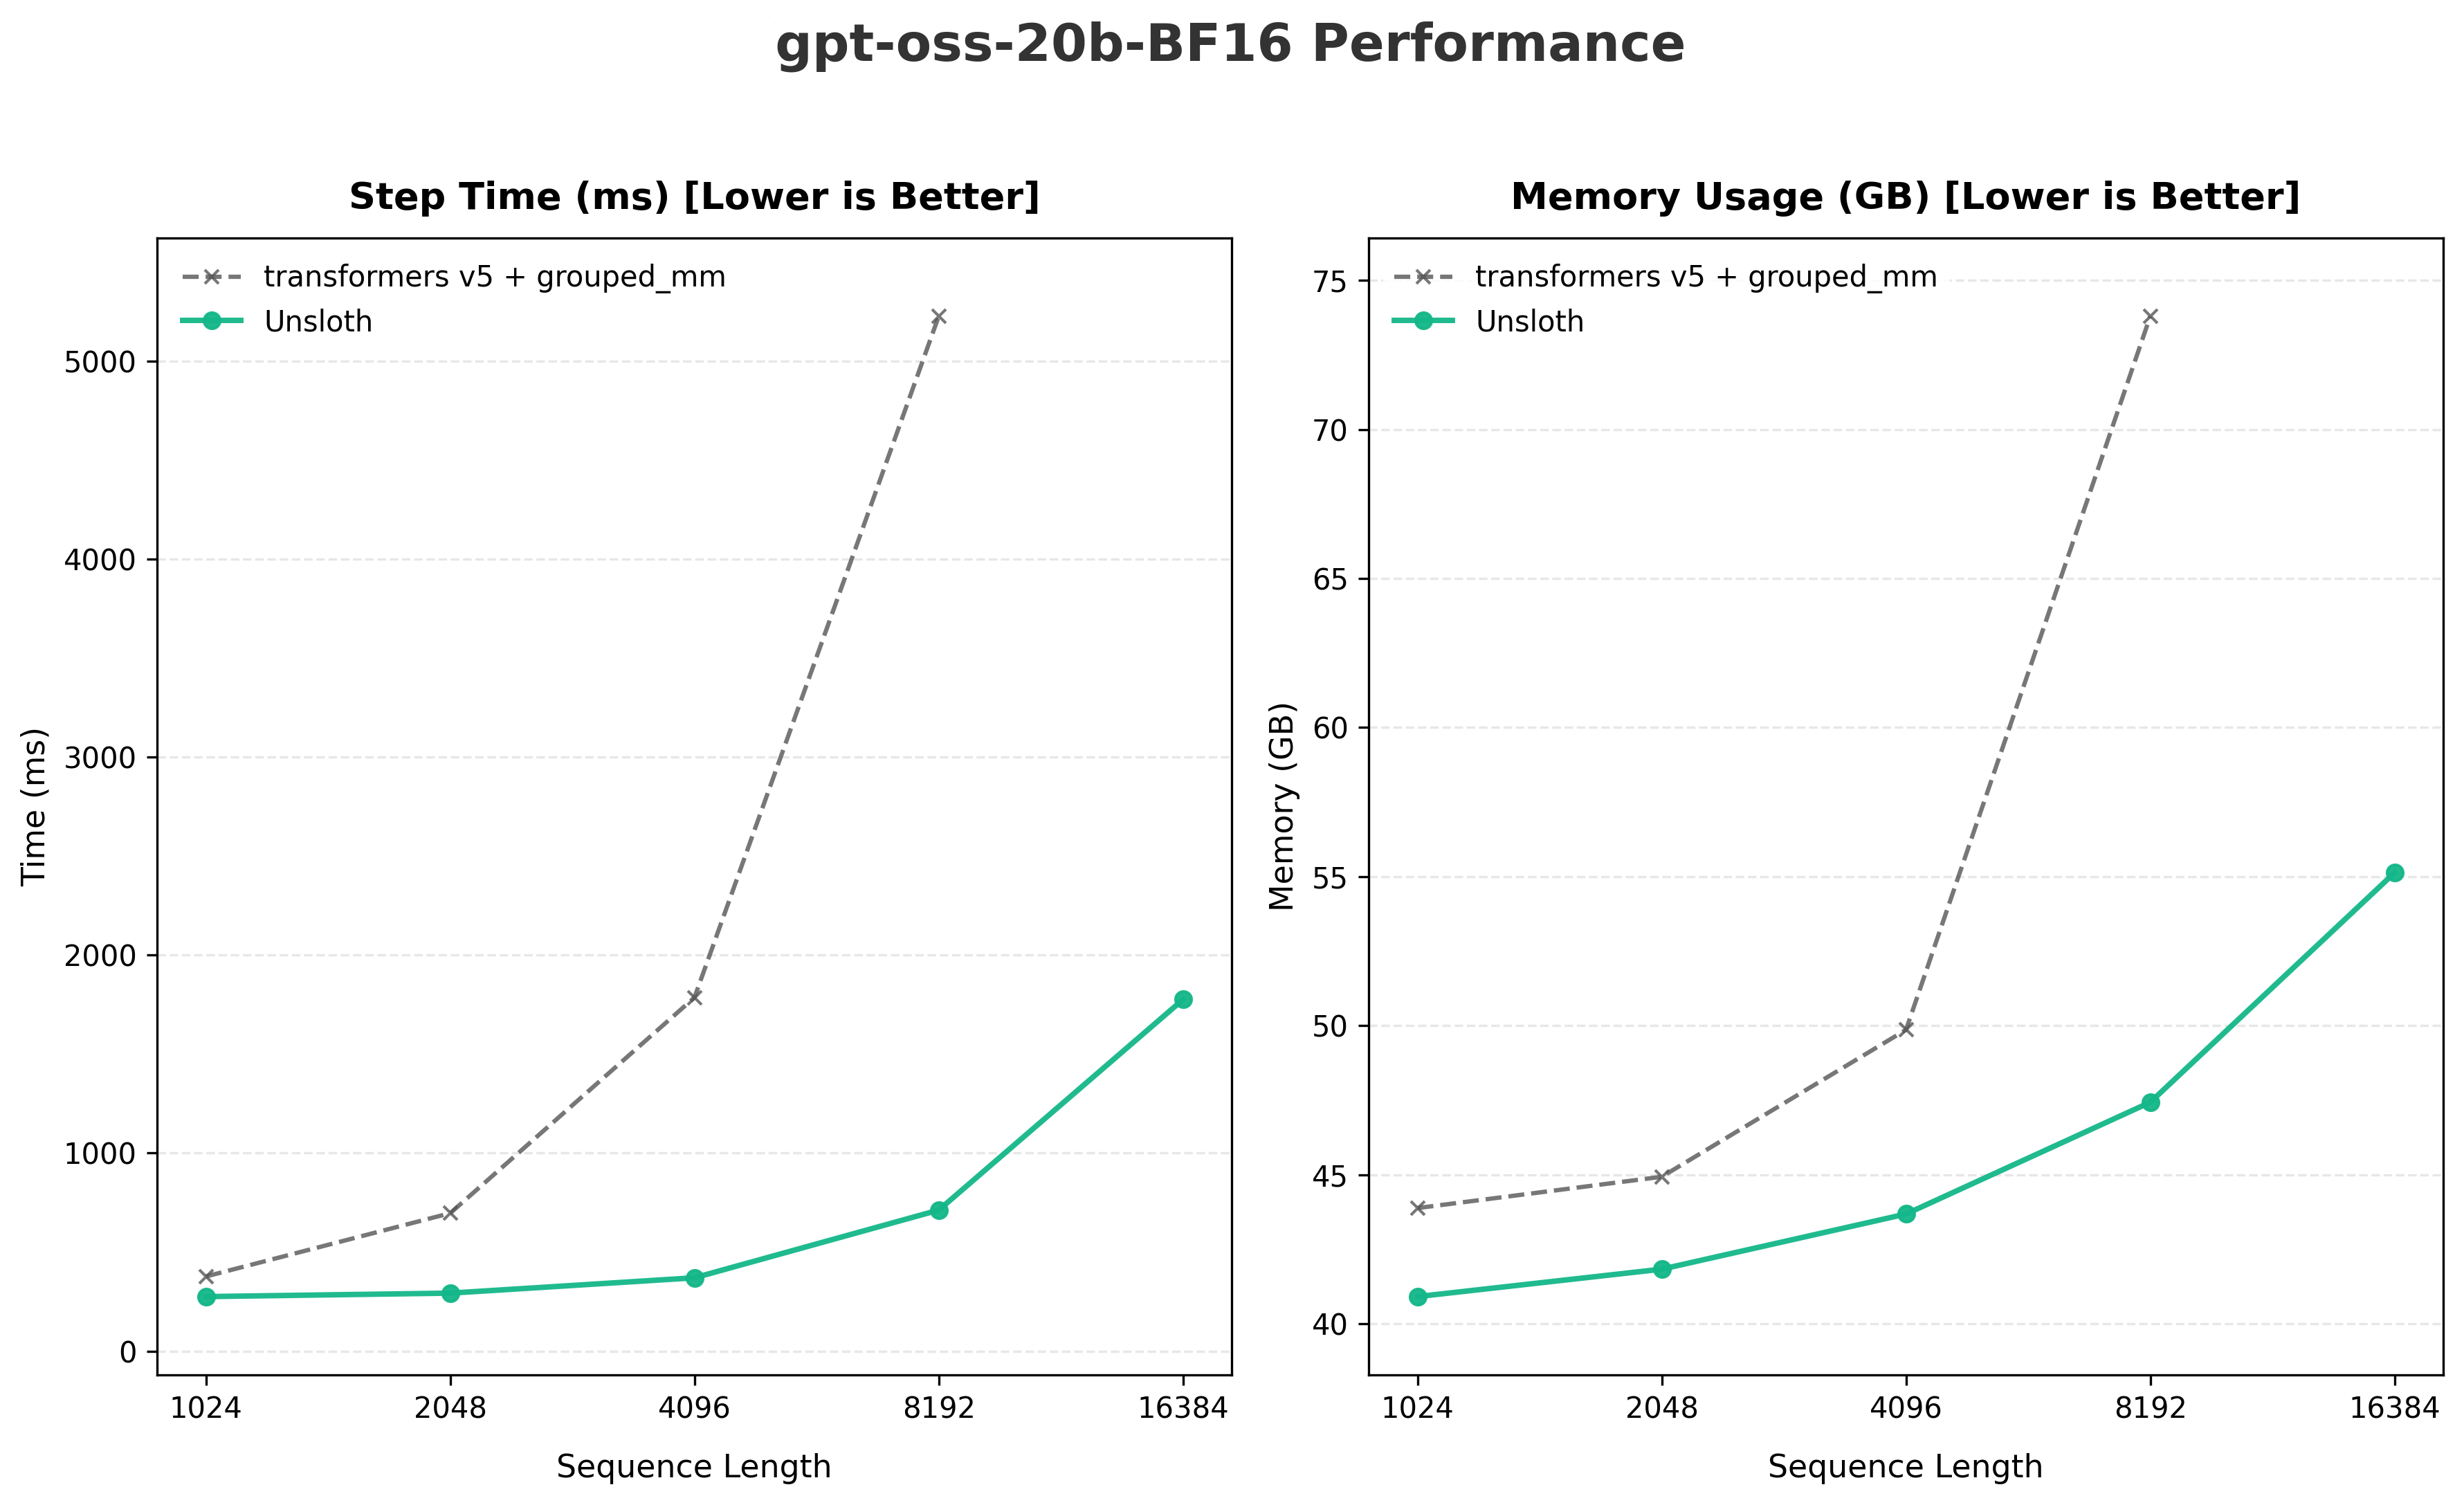
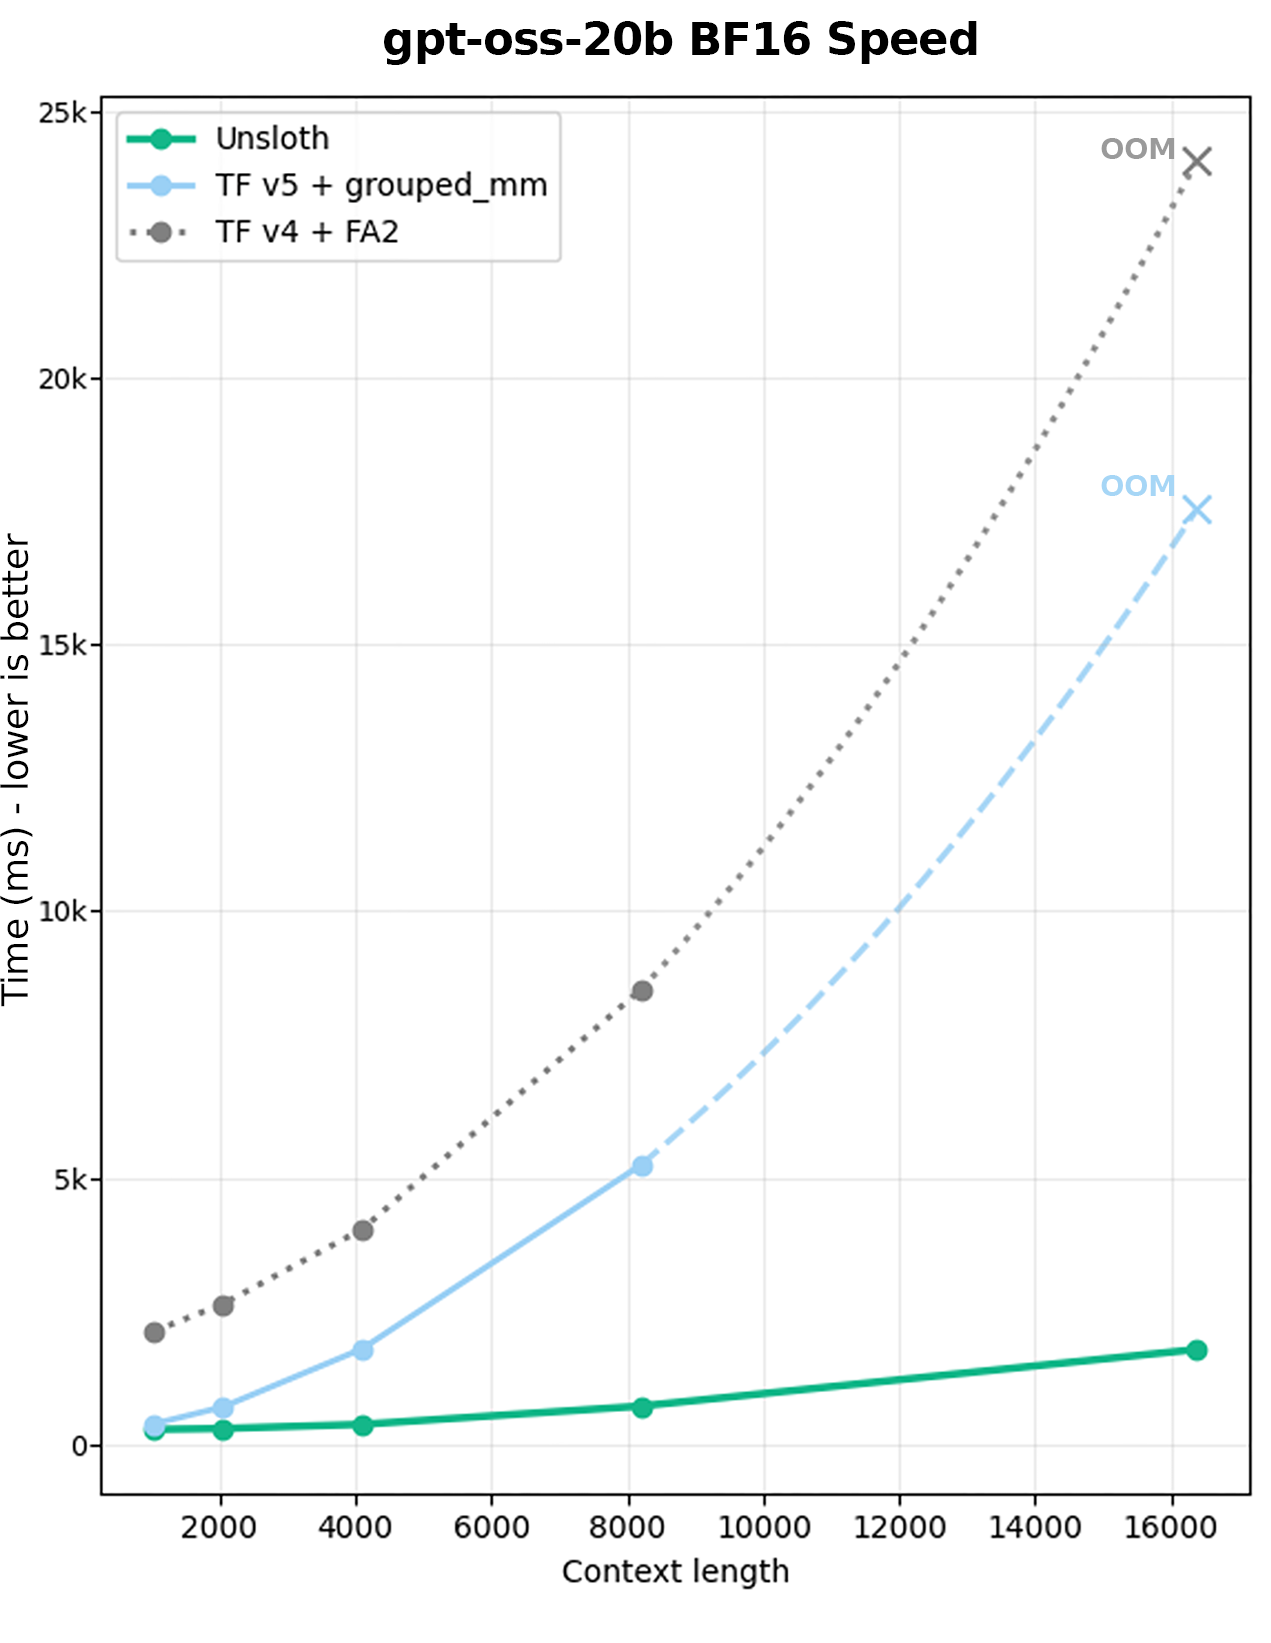
Nous avons fine-tuné [unsloth/gpt-oss-20b-BF16](https://huggingface.co/unsloth/gpt-oss-20b-BF16) pour le benchmarking. Unsloth est 7x plus rapide et utilise 36 % de VRAM en moins à des longueurs de contexte de 16K. Transformers v5 + TRL tombe en OOM tandis qu'Unsloth ne le fait pas. De plus, l'accélération augmente avec la longueur de séquence dans ce cas grâce à notre [Long Context gpt-oss](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#unsloths-flex-attention-implementation), et à nos kernels MoE.

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fja0OUMPoIM4KrWJPJyas%2Fgptoss%20new.png?alt=media&amp;token=29205c0e-a3c9-4749-8ebc-f8125d49dcf1" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FyZkJp7w21nrlf9JfCYZ0%2Fgptoss%20graph%20only.png?alt=media&amp;token=938e7590-b6a4-48eb-b53f-fdaa2bb2581c" alt="" width="188"><figcaption><p>Comparaison avec transformers v4</p></figcaption></figure></div>

<table data-full-width="true"><thead><tr><th>Longueur de contexte</th><th>Unsloth (ms)</th><th>TF v5 (ms)</th><th>Unsloth Mem (GB)</th><th>TF v5 Mem (GB)</th><th>Accélération</th><th>Économie de VRAM</th><th data-hidden>Rang</th><th data-hidden>Unsloth Warmup (ms)</th><th data-hidden>TRL Warmup (ms)</th></tr></thead><tbody><tr><td>1024</td><td>275.35</td><td>376.99</td><td>40.91</td><td>43.88</td><td>1.4x</td><td>6.76%</td><td>8</td><td>2601.17</td><td>615.62</td></tr><tr><td>2048</td><td>292.88</td><td>696.57</td><td>41.83</td><td>44.93</td><td>2.4x</td><td>6.89%</td><td>8</td><td>4996.62</td><td>928.42</td></tr><tr><td>4096</td><td>370.30</td><td>1785.89</td><td>43.68</td><td>49.86</td><td>4.8x</td><td>12.39%</td><td>8</td><td>6648.94</td><td>2130.33</td></tr><tr><td>8192</td><td>712.33</td><td>5226.86</td><td>47.43</td><td>73.80</td><td>7.3x</td><td>35.73%</td><td>8</td><td>9632.44</td><td>5472.66</td></tr><tr><td>16384</td><td>1775.80</td><td><strong>OOM</strong></td><td>55.13</td><td><strong>OOM</strong></td><td>N/A</td><td>N/A</td><td>8</td><td>12696.26</td><td>N/A</td></tr></tbody></table>

### Benchmarks Qwen3

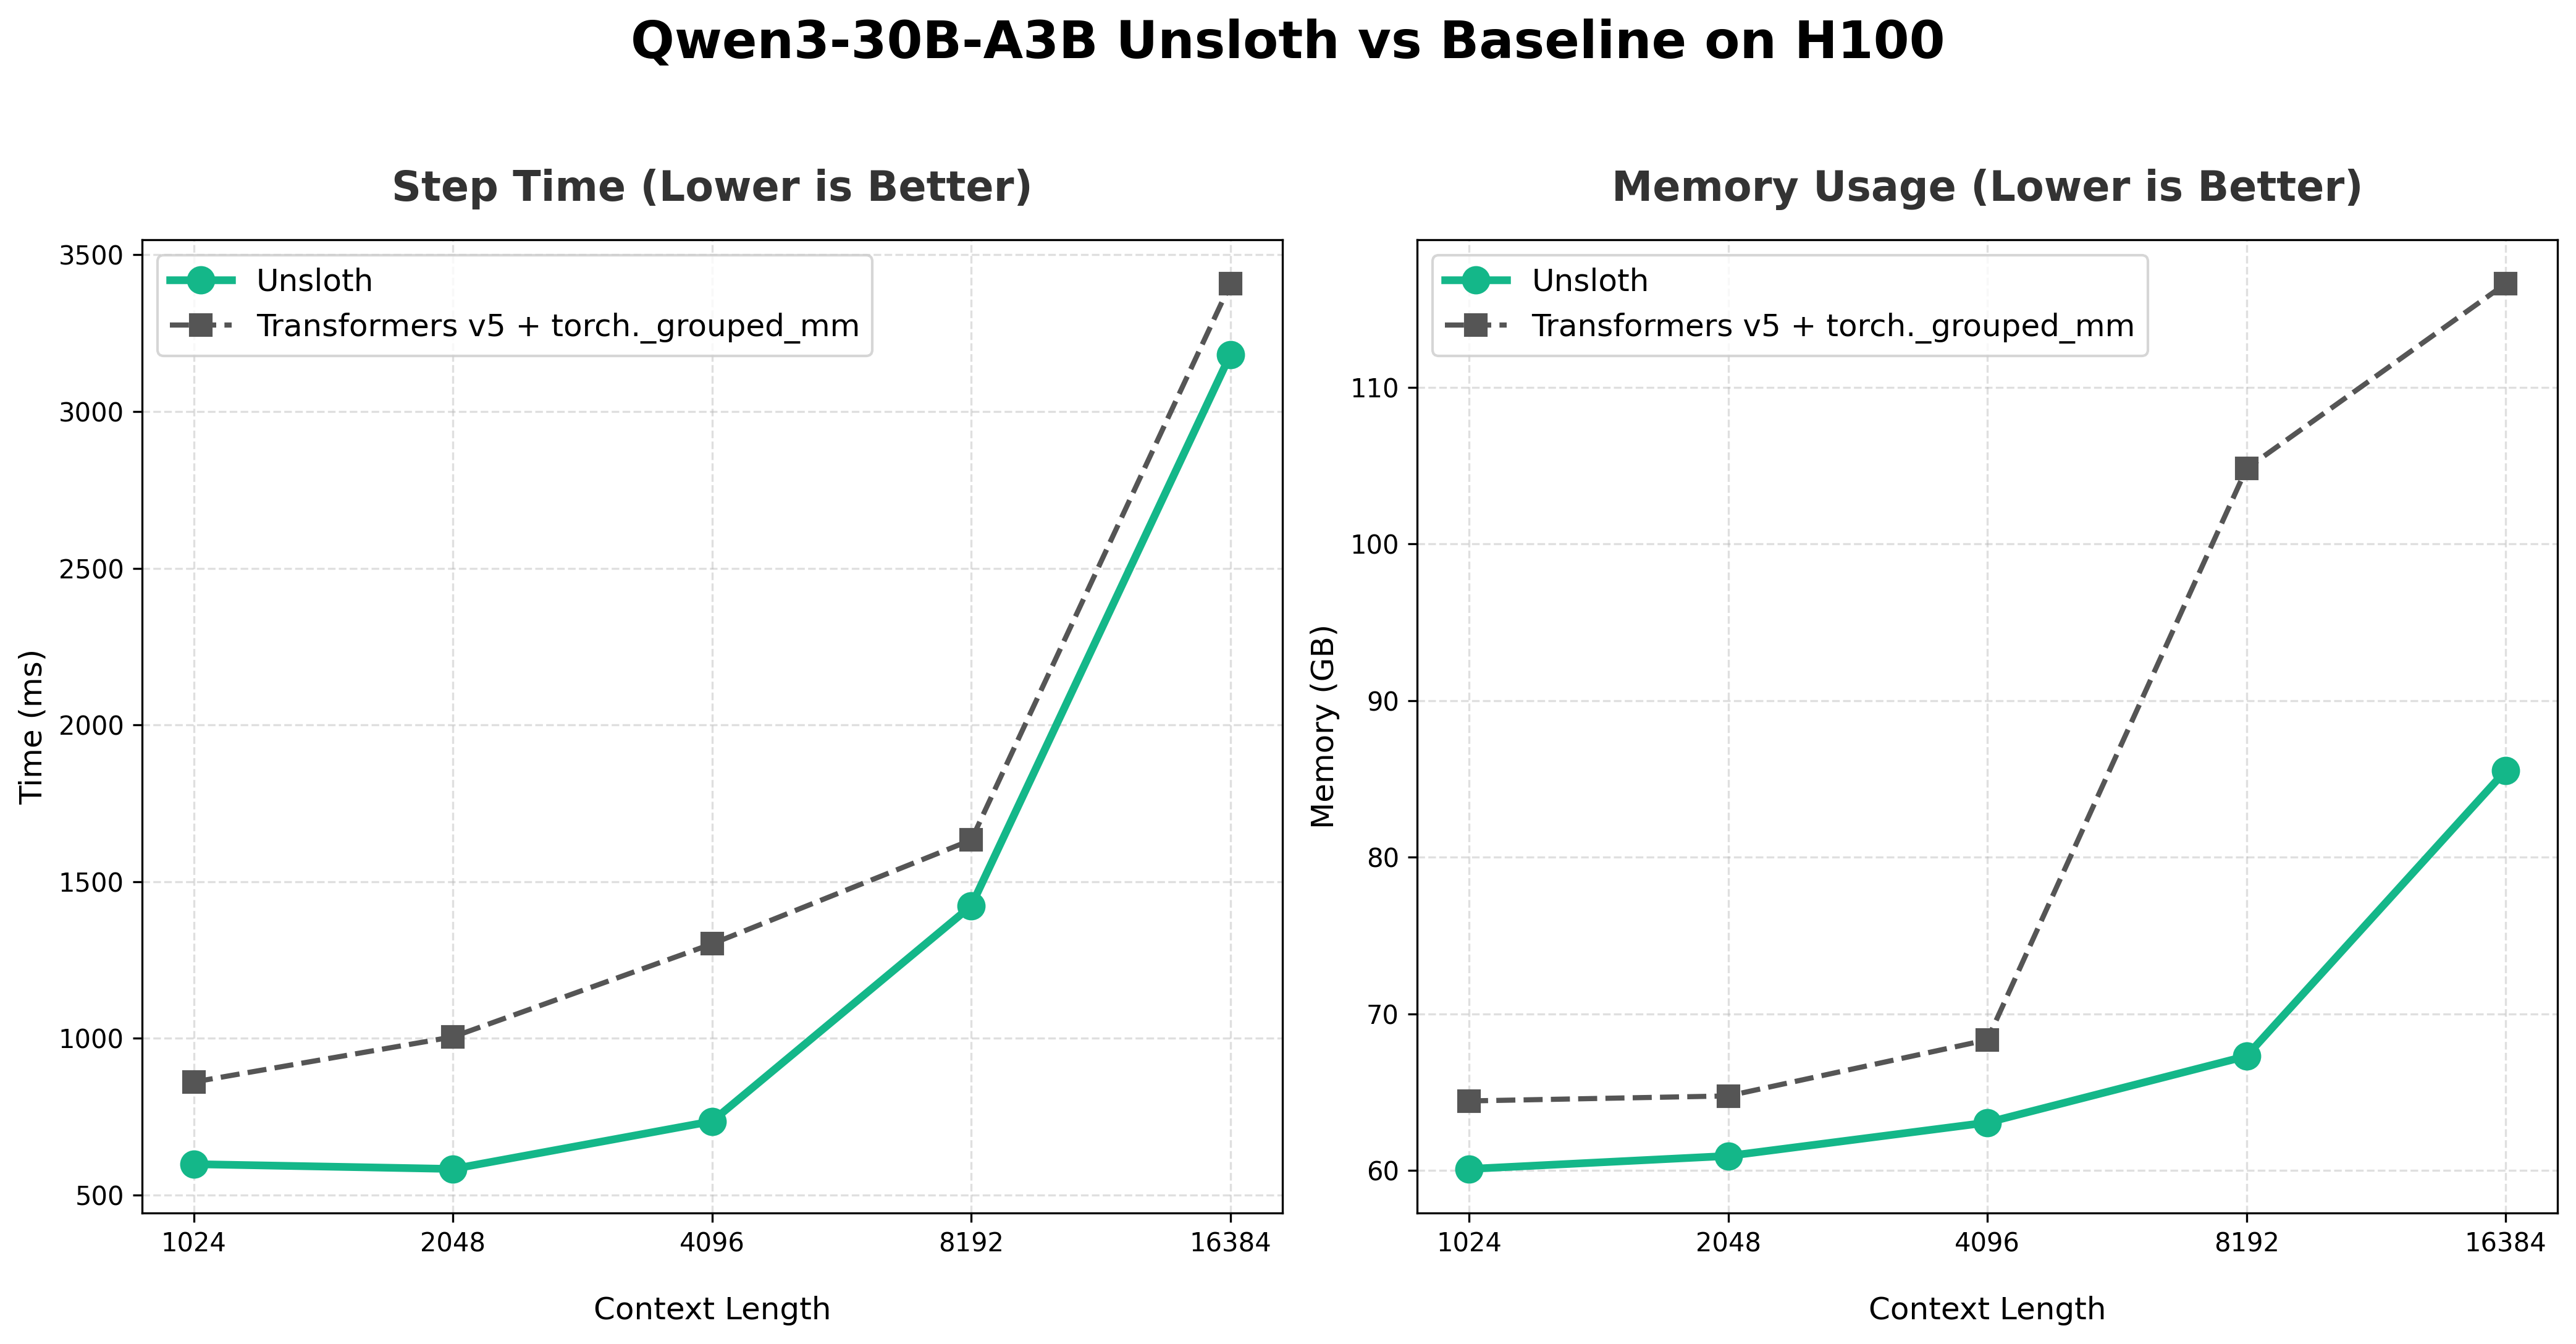
Sur un **NVIDIA B200**, nous observons **une accélération \~1,7x et une efficacité mémoire \~35 % meilleure avec Qwen3-30B-A3B LoRA**, avec des économies de mémoire qui s'améliorent encore pour des longueurs de séquence plus longues.

Qwen3-Next et Coder tiennent étonnamment sur un seul GPU B200 en LoRA bf16.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FonHXIql0XhGkLIDnuTfv%2Fimage.png?alt=media&amp;token=06f97769-1d0e-4edb-b9c5-6c305376c6e8" alt="" width="563"><figcaption></figcaption></figure>

Sur GPU H100, nous faisons nettement mieux que la référence, allant jusqu'à **une accélération de 1,77x** à l'entraînement tout en économisant \~5,3 Go lors du fine-tuning à une longueur de contexte de 4K. Alors que nous passons sans heurts à des longueurs de contexte de 8192, Transformers v5 + TRL tombe en OOM à 8K. Notez que nous utilisons moins de mémoire à 8K que la référence à 4K, ce qui nous permet de continuer à augmenter encore la longueur de contexte.

<table data-full-width="true"><thead><tr><th>Longueur de contexte</th><th>Unsloth (ms)</th><th>TF v5 (ms)</th><th>Unsloth Mem (GB)</th><th>TF v5 Mem (GB)</th><th>Accélération</th><th>Économie de VRAM</th><th data-hidden>Rang</th></tr></thead><tbody><tr><td>1024</td><td>366.3</td><td>628.3</td><td>80.88</td><td>104.80</td><td>1.7x</td><td>2.06%</td><td>8</td></tr><tr><td>2048</td><td>467.0</td><td>745.3</td><td>80.88</td><td>104.81</td><td>1.6x</td><td>2.57%</td><td>8</td></tr><tr><td>4096</td><td>711.6</td><td>975.5</td><td>80.89</td><td>104.80</td><td>1.4x</td><td>5.08%</td><td>8</td></tr><tr><td>8192</td><td>1376.6</td><td>1633.5</td><td>80.90</td><td>104.81</td><td>1.2x</td><td>9.17%</td><td>8</td></tr><tr><td>16384</td><td>3182.2</td><td>3407.9</td><td>85.53</td><td>116.61</td><td>1.1x</td><td>15.26%</td><td>8</td></tr></tbody></table>

### Benchmarks GLM 4.7

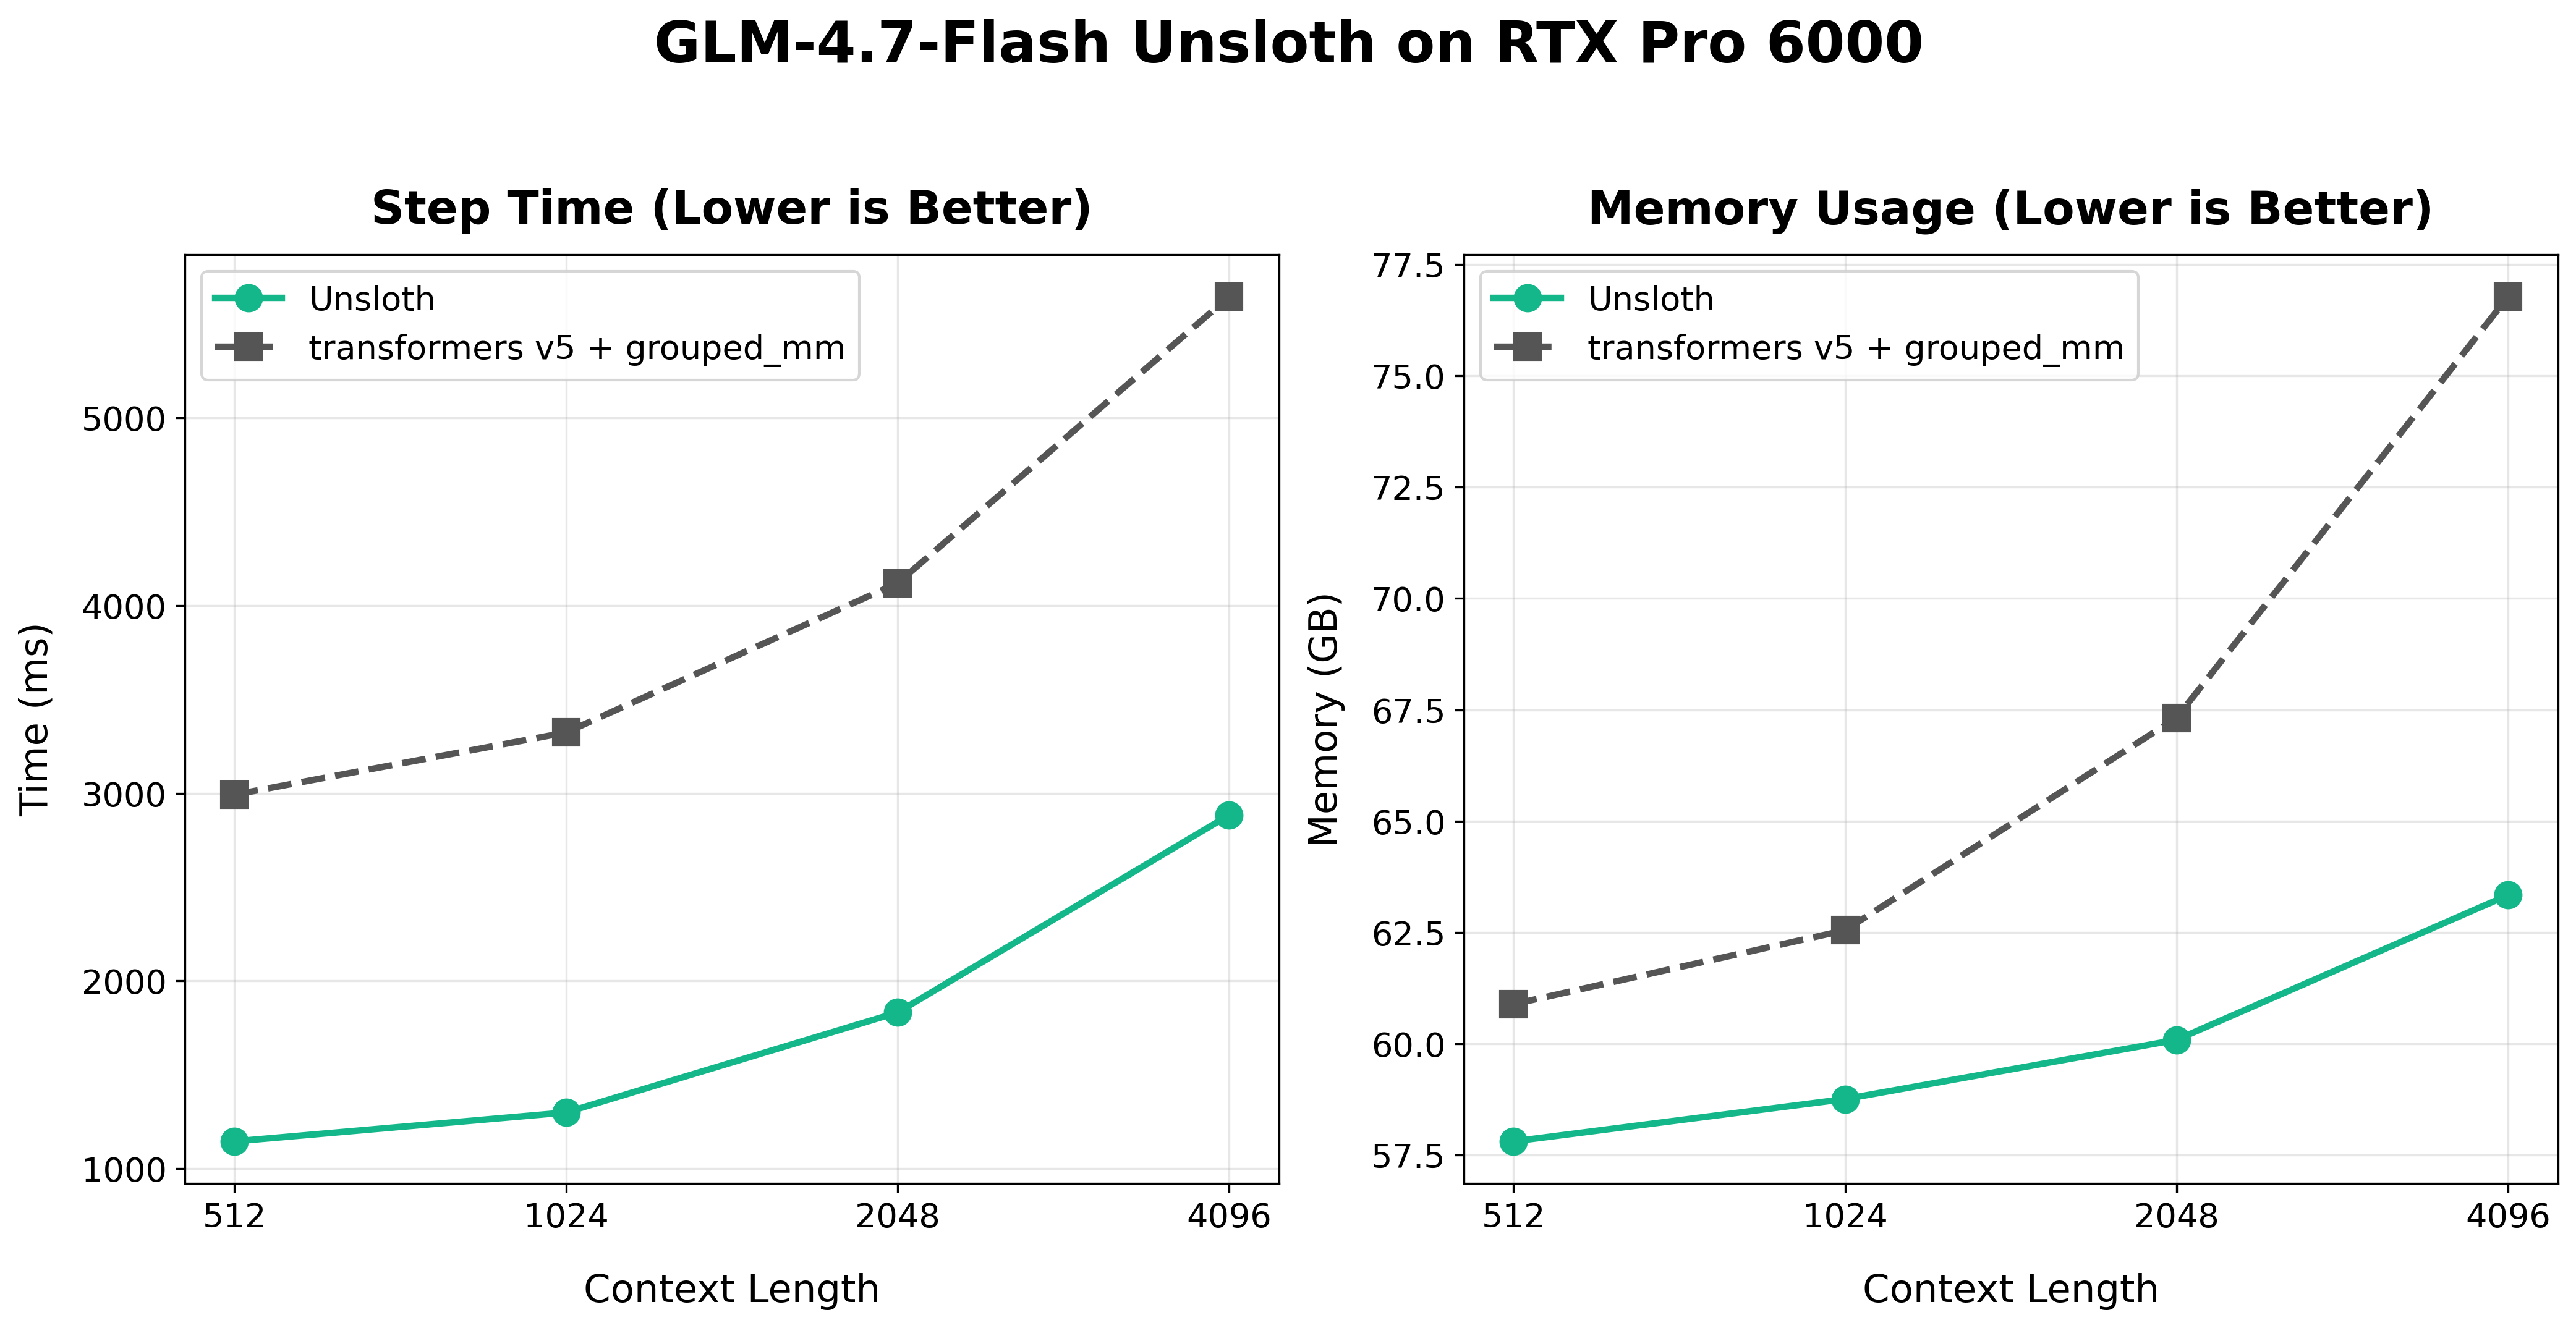
Unsloth atteint **un débit 2,6x plus rapide avec >15 % de VRAM en moins** pour toutes les tailles de batch pour GLM 4.7 Flash. GLM 4.7 Flash est un modèle agentique et de code MoE de 30B (3B de paramètres actifs) et utilise une configuration similaire au style MoE DeepSeek, avec 64 experts routés et 1 expert partagé. Nous avons benchmarké l'entraînement MoE d'Unsloth par rapport au nouveau Transformers v5 optimisé.

Utilisez notre nouveau notebook Colab pour GLM 4.7 Flash ci-dessous :

{% embed url="<https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/GLM_Flash_A100(80GB).ipynb>" %}
Notebook MoE GLM 4.7 Flash A100 80GB
{% endembed %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FbocwTistkljiMxGUA02y%2Fimage.png?alt=media&amp;token=2a804b3a-44e4-4666-aa4f-ba6a31f69f39" alt="" width="563"><figcaption></figcaption></figure>

<table data-full-width="true"><thead><tr><th>Longueur de contexte</th><th>Unsloth (ms)</th><th>TF v5 (ms)</th><th>Unsloth Mem (GB)</th><th>TF v5 Mem (GB)</th><th>Accélération</th><th>Économie de VRAM</th><th data-hidden>Rang</th><th data-hidden>Unsloth Warmup (ms)</th><th data-hidden>TRL Warmup (ms)</th></tr></thead><tbody><tr><td><p></p><p>512</p></td><td>1145.0</td><td>2992.1</td><td>57.81</td><td>60.89</td><td>2.6x</td><td>6.51%</td><td>8</td><td>13317.46</td><td>893.04</td></tr><tr><td>1024</td><td>1298.9</td><td>3323.3</td><td>58.76</td><td>62.55</td><td>2.6x</td><td>6.22%</td><td>8</td><td>12895.28</td><td>937.37</td></tr><tr><td>2048</td><td>1831.9</td><td>4119.3</td><td>60.09</td><td>67.32</td><td>2.3x</td><td>9.46%</td><td>8</td><td>12531.37</td><td>1039.45</td></tr><tr><td>4096</td><td>2883.9</td><td>5646.1</td><td>63.34</td><td>76.78</td><td>2x</td><td>14.83%</td><td>8</td><td>7671.60</td><td>1643.26</td></tr></tbody></table>

### ⚡Entraînement LoRA MoE plus rapide

Dans Transformers/PEFT, l'approche habituelle consiste à **fusionner l'adaptateur LoRA dans le poids de base** puis exécuter le calcul MoE (d'autant plus que MoE utilise souvent `nn.Parameter` au lieu de `nn.Linear`). Le problème est que cette fusion **matérialise effectivement le delta LoRA (pour tous les experts)** `lora_B @ lora_A.t`, ce qui est **très gourmand en mémoire**.

Unsloth évite cela. Nous avons auparavant utilisé la même idée pour optimiser l'entraînement et l'inférence LoRA génériques, et nous l'appliquons maintenant aussi à **MoE + LoRA** aussi. Les mathématiques sont identiques, donc la perte, les gradients et les sorties restent les mêmes. Le seul changement est **l'ordre des opérations**, rendu possible par l'associativité de la multiplication matricielle. Avec ce réordonnancement, nous obtenons d'importants gains de vitesse et réductions de mémoire.

{% hint style="warning" %}
L'entraînement de modèles MoE en **4 bits** QLoRA n'est pas recommandé pour l'instant car BitsandBytes ne le prend pas en charge. Ce n'est pas spécifique à Unsloth. Pour l'instant, utilisez bf16 pour LoRA ou un fine-tuning complet.
{% endhint %}

Ces optimisations sont **activées par défaut** lors de l'entraînement de modèles MoE avec Unsloth (notamment Qwen-3 MoE, gpt-oss et les modèles mentionnés ci-dessus). Vous pouvez changer d'implémentation via la `UNSLOTH_MOE_BACKEND` variable d'environnement : soit `torch._grouped_mm` **kernels Triton** ou une **boucle for PyTorch basique**, selon la compatibilité et vos préférences. Par défaut, nous utilisons `grouped_mm` pour les meilleures performances et la prise en charge la plus large.

```python
import os
# si vous souhaitez choisir un autre backend (grouped_mm par défaut), définissez la variable ci-dessous :
# os.environ['UNSLOTH_MOE_BACKEND'] = 'unsloth_triton' # ou grouped_mm ou native_torch
lora_rank = 16
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "Qwen/Qwen3-30B-A3B-Instruct-2507", # modèle MoE
    max_seq_length = max_seq_length,
    load_in_4bit = False, # nn.Parameter MoE ne prend pas encore en charge le 4bit bnb
)
model = FastLanguageModel.get_peft_model(
    model,
    r = lora_rank,
    target_modules = [
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_up_proj", "down_proj", # LoRA sur les couches MoE !
    ],
    lora_alpha = lora_rank*2, # *2 accélère l'entraînement
    use_gradient_checkpointing = "unsloth", # Réduit l'utilisation de la mémoire
    random_state = 3407,
)
```

## 📚 Détails de l'implémentation

LoRA est une méthode de fine-tuning efficace en paramètres : au lieu de mettre à jour la matrice de poids complète, vous entraînez un « adaptateur » de faible rang avec beaucoup moins de paramètres, ce qui réduit drastiquement la mémoire de l'optimiseur.

Si le poids original a la forme **(m, n)**, LoRA ajoute deux matrices entraînables de formes **(m, r)** et **(r, n)**. Leur produit est **(m, n)**, mais vous ne suivez les états de l'optimiseur et les gradients que pour :

* `m*r + r*n` paramètres (LoRA) au lieu de
* `m*n` paramètres (fine-tuning complet)

{% hint style="info" %}
Lors du fine-tuning des MoE, il n'est pas judicieux de fine-tuner la couche routeur, donc nous l'avons désactivée par défaut.
{% endhint %}

Pour les couches MLP typiques, `m ≈ 4096, n ≈ 12k, et r ≈ 64`, cela représente environ **\~1M de paramètres LoRA contre \~48M de paramètres complets -** soit environ **\~2%,** souvent avec une perte de précision minimale, voire nulle.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FogBmpbd8eAirmDJaDCMl%2FLoRA%20Image?alt=media&amp;token=ce533f2c-ad6a-4cca-8588-fe0f548f8bae" alt="" width="255"><figcaption></figcaption></figure>

#### Le MoE LoRA change la donne

Les couches MoE sont différentes parce que vous avez **E MLP d'experts en parallèle**, donc tout changement par expert (comme l'ajout de LoRA) s'applique à tous les experts.

Prenons **Qwen3‑30B‑A3B**: taille cachée **m=2048**, taille intermédiaire **n=768**, **E=128** experts avec **k=8** activés par jeton. Par expert :

* `gate_proj` et `up_proj`: `(m, n) = (2048, 768)`
* `down_proj`: `(n, m) = (768, 2048)`

Avec **rang LoRA r=64**, chaque projection ajoute `r*(m+n)=64*(2048+768)=180,224` paramètres par expert (≈ `11%` d'une `2048×768` matrice). Le problème central est que `r/n = 64/768` est élevé par rapport aux configurations MLP typiques, par ex., `r/n = 64/25600` dans [Qwen3-32B](https://huggingface.co/Qwen/Qwen3-32B/blob/main/config.json#L13) de taille similaire.

Si vous matérialisez cela sur *tous* les experts, la mémoire s'accumule vite. Et comme `gate_proj` et `up_proj` sont souvent fusionnés sous forme de `gate_up_proj`, vous matérialisez généralement les deux ensemble, ce qui double à peu près la surcharge / la mémoire de pointe.

**En termes de mémoire, pour une longueur de séquence s, E experts et `k` choisis, nous avons les éléments suivants, communs aux deux approches**

```
# Toutes ces valeurs sont par expert
Sortie finale : (s, n)
Activations d'entrée : (s, m)
Sortie finale : (s, n)
```

C'est ici que les choses commencent à diverger. Pour l'approche de peft, nous avons

```
delta = loraA@loraB  = (m,n) per expert = Emn parameters
```

Pour l'approche Split LoRA d'Unsloth, nous effectuons les opérations suivantes

```
Y = X @ loraA : (s,m) @ (m, r)       # but sparse for k experts = ksr parameters
Y @ loraB: (s, r) @ (r, n)           # but sparse again for k experts = ksn parameters
```

Prenons maintenant le cas de Qwen3-30B-A3B.

`E = 128, k = 8, m = 2048, n = 768.` En remplaçant tout cela, on obtient `s < 32K.`&#x20;

$$
\begin{aligned}
\text{PEFT params}                       &:\quad Emn \\
\text{Unsloth Split LoRA params}         &:\quad ks(r+n) \\
\text{In typical LoRA we have}           &:\quad r \ll n \\
\text{Split LoRA is better when}         &:\quad Emn > ksn ;=; Em > ks \\
\\
\text{For Qwen3-30B-A3B, we have} \\
E &= 128, \quad k = 8, \quad m = 2048, \quad n = 768 \\
\\
\text{So, Split LoRA is mathematically better when} \\
s &< \frac{Emn}{kn} = 32K
\end{aligned}
$$

**En termes de calcul, pour une longueur de séquence `s`, `E` experts et top `k` choisis, nous faisons :**

$$
\begin{aligned}
\Delta = AB,
A \in \mathbb{R}^{m \times r}, ;
B \in \mathbb{R}^{r \times n}
&\quad \Rightarrow \quad 2mnr \text{ flops per expert lora} \\
\\
W' = W + \Delta
\quad &\Rightarrow \quad mn \text{ flops} \\
\\
XW'  \quad | \quad
X \in \mathbb{R}^{s \times m}, ;
W' \in \mathbb{R}^{m \times n}
\quad &\Rightarrow \quad 2smn \text{ flops} \\
\\
\text{MoE peft lora flops}
&= E\big(2mnr + mn\big)

* 2k,smn
  \end{aligned}
  $$

Dans le cas du split LoRA d'Unsloth que nous avons mentionné, nous avons

$$
\begin{aligned}
XW &= 2smn  \text{  flops} \\
Y = XA, &= 2smr
\quad \text{(applied only to routed token--expert pairs)} \\
\
Z = YB &= 2srn \\
\text{MoE split lora flops}
&= 2k\big(smn + smr + srn\big) \\
\text{Crossover condition}
&:\quad 2ksr(m+n) > 2Emn(r+1/2)
\Rightarrow
s > \frac{Emn}{k(m+n)} \times (1+ \frac{1}{2r}) \\
\\
\text{For Qwen3-30B-A3B with}
&:
E = 128,;
m = 2048,;
n = 768,;
k = 8 \\
\\
\Rightarrow \quad
s
& ;\approx; 16\text{K tokens}
\end{aligned}
$$

Le point jusqu'où le Split LoRA est meilleur d'un point de vue analytique est lorsque `s > Emn/k(m+n)` ce qui est de l'ordre de `16K` jetons pour un modèle de type Qwen3-30B-A3B.

Enfin, certaines accélérations proviennent de **la réduction du trafic mémoire**: les GPU modernes sont souvent **limités par la bande passante**, donc transférer moins de données peut compter davantage que les FLOPs. Une estimation grossière de l'accélération est `Emn / [k·s·(m+n)]`, elle dépend donc fortement de **s, E, k**, et des formes de matrices.

### 🔮 Prise en charge des modèles

Unsloth prend en charge un entraînement MoE plus rapide pour les modèles Qwen, gpt-oss, DeepSeek et GLM :

* **Qwen3** (Thinking et Instruct) : VL • 2507 • Coder&#x20;
* **gpt-oss**: 20B • 120B • safeguard
* **GLM**: 4.5 • 4.6 • 4.6-Air • 4.7 • 4.7-Flash
* **DeepSeek**: V3 • R1 • V3.1 • V3.2

Nous n'avons peut-être pas téléversé certains modèles MoE, mais Unsloth devrait tout de même les prendre en charge.

### 📈 Davantage de benchmarks

#### Benchmarks BF16 gpt-oss

Vitesse d'entraînement par rapport à Transformers v4

<table data-full-width="false"><thead><tr><th align="right">Longueur de contexte</th><th align="right">Unsloth (ms)</th><th align="right">TF v5 (ms)</th><th align="right">TF v4 (ms)</th><th align="right">Accélération</th></tr></thead><tbody><tr><td align="right">1024</td><td align="right">275.35</td><td align="right">376.99</td><td align="right">2111.18</td><td align="right">1.37x</td></tr><tr><td align="right">2048</td><td align="right">292.88</td><td align="right">696.57</td><td align="right">2626.80</td><td align="right">2.38x</td></tr><tr><td align="right">4096</td><td align="right">370.30</td><td align="right">1785.89</td><td align="right">4027.93</td><td align="right">4.82x</td></tr><tr><td align="right">8192</td><td align="right">712.33</td><td align="right">5226.86</td><td align="right">8513.52</td><td align="right">7.34x</td></tr><tr><td align="right">16384</td><td align="right">1775.80</td><td align="right">OOM</td><td align="right">OOM</td><td align="right">N/A</td></tr></tbody></table>

**Utilisation de la VRAM en mémoire**

<table data-full-width="false"><thead><tr><th align="right">Longueur de contexte</th><th align="right">Unsloth Mem (GB)</th><th align="right">TF v5 Mem (GB)</th><th align="right">TF v4 Mem (GB)</th><th align="right">Économie de VRAM</th></tr></thead><tbody><tr><td align="right">1024</td><td align="right">40.91</td><td align="right">43.88</td><td align="right">89.75</td><td align="right">6.76%</td></tr><tr><td align="right">2048</td><td align="right">41.83</td><td align="right">44.93</td><td align="right">90.47</td><td align="right">6.89%</td></tr><tr><td align="right">4096</td><td align="right">43.68</td><td align="right">49.86</td><td align="right">92.72</td><td align="right">12.39%</td></tr><tr><td align="right">8192</td><td align="right">47.43</td><td align="right">73.80</td><td align="right">100.3</td><td align="right">35.73%</td></tr><tr><td align="right">16384</td><td align="right">55.13</td><td align="right">OOM</td><td align="right">OOM</td><td align="right">N/A</td></tr></tbody></table>

## :tada: Mises à jour importantes d'Unsloth

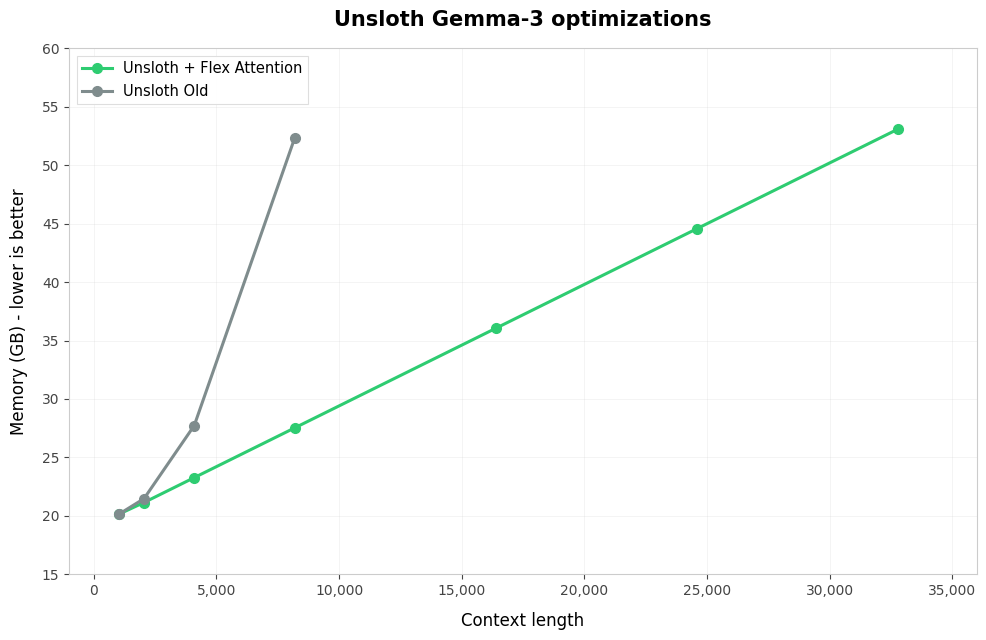
1. Dans le cadre de notre sortie MoE, nous avons également fait **Gemma-3 utilise désormais Flex-Attention** par défaut, et cela fonctionne aussi en configuration float16 (il y avait des infinis que nous avons résolus il y a quelque temps). **Gemma-3 utilise désormais une mémoire en O(N) et non en O(N^2), et s'entraîne >3x plus vite** (et passe encore mieux à l'échelle avec la longueur de contexte). Les versions précédentes d'Unsloth tombaient en OOM.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FZiM9zMhVlUaJXC4Y1REp%2Fimage.png?alt=media&amp;token=b2f1d12e-ccdb-431c-9b65-284db3892e2c" alt="" width="375"><figcaption></figcaption></figure>

| Contexte | Ancien pic de VRAM | Nouveau pic de VRAM | Économie de VRAM |
| -------- | ------------------ | ------------------- | ---------------- |
| 1K       | 20.1 GB            | 20.1 GB             | 0 GB (0%)        |
| 2K       | 21.5 GB            | 21.1 GB             | 0.3 GB (2%)      |
| 4K       | 27.7 GB            | 23.3 GB             | 4.5 GB (16%)     |
| 8K       | 52.3 GB            | 27.5 GB             | 24.8 GB (47%)    |
| 16K      | OOM                | 36.0 GB             | --               |
| 24K      | OOM                | 44.6 GB             | --               |
| 32K      | OOM                | 53.1 GB             | --               |
| 48K      | OOM                | 38.4 GB             | --               |
| 64K      | OOM                | 44,7 Go             | --               |

2. Le fine-tuning de la vision accepte désormais des données mixtes composées uniquement d’images et de texte !
3. [Windows est désormais officiellement pris en charge, sans besoin de WSL](/docs/fr/commencer/install/windows-installation.md).
4. `trl==0.27.1` et `transformers==5.1.0` sont bien prises en charge - la couverture précédente était de 30 % de l’ensemble de nos 120 notebooks, mais nous avons maintenant une couverture de >80 % - nous prévoyons de la porter à 100 % au cours des prochains jours.
5. De nombreuses corrections de bugs et autres mises à jour - voir <https://github.com/unslothai/unsloth/releases/tag/February-2026>

{% hint style="success" %}
Pour activer un entraînement MoE plus rapide, mettez à jour Unsloth via `pip install --upgrade unsloth unsloth_zoo`
{% endhint %}

### Remerciements

Nous remercions l’équipe de Hugging Face pour sa collaboration avec nous afin d’améliorer l’entraînement MoE pour la communauté.

Nous remercions également sincèrement l’équipe torchao, en particulier Vasily Kuznetsov (vkuzo), pour avoir travaillé à nous aider à activer la prise en charge de grouped\_mm pour float16 afin de le faire fonctionner sur T4 et assurer la compatibilité ascendante avec A100.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/notions-de-base/faster-moe.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.