> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/embedding-finetuning.md).
# Guide de fine-tuning des modèles d'embeddings avec Unsloth
Découvrez comment fine-tuner facilement des modèles d'embeddings avec Unsloth.
Le fine-tuning des modèles d’embeddings peut grandement améliorer les performances de recherche et de RAG sur des tâches spécifiques. Il aligne les vecteurs du modèle sur votre domaine et sur le type de « similarité » qui compte pour votre cas d’usage, ce qui améliore la recherche, le RAG, le clustering et les recommandations sur vos données.
Exemple : les titres « Google lance le Pixel 10 » et « Qwen lance Qwen3 » pourraient être encodés comme similaires si vous les étiquetez simplement tous les deux comme « Tech », mais pas similaires si vous faites de la recherche sémantique, car ils parlent de choses différentes. Le fine-tuning aide le modèle à produire le « bon » type de similarité pour votre cas d’usage, en réduisant les erreurs et en améliorant les résultats.
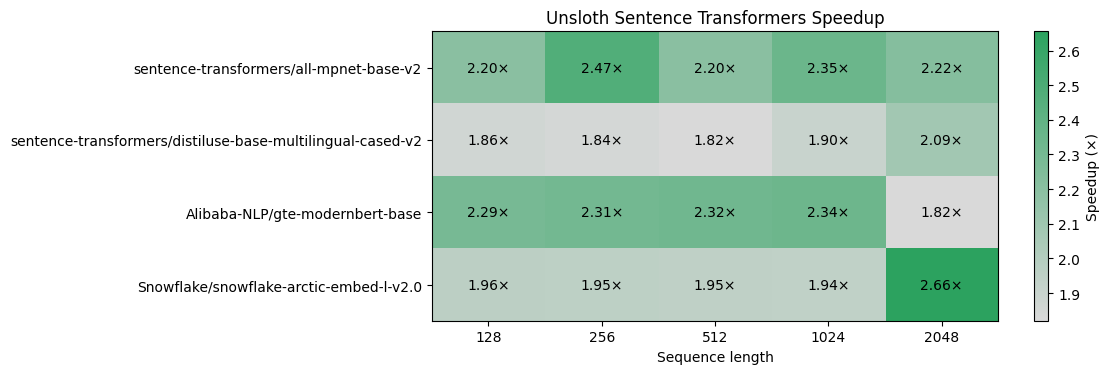
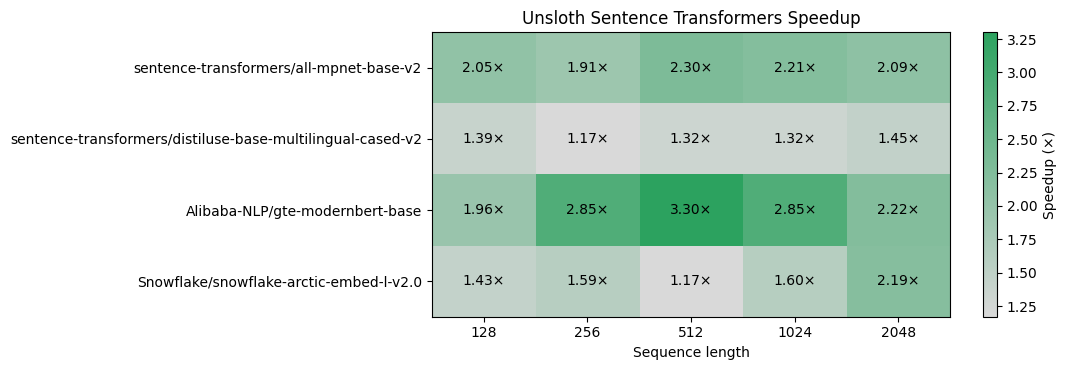
[**Unsloth**](https://github.com/unslothai/unsloth) prend désormais en charge l’entraînement d’embeddings, **classifieur**, **BERT**, **reranker** modèles [**\~1,8 à 3,3x plus rapide**](#unsloth-benchmarks) avec 20 % de mémoire en moins et un contexte 2x plus long que les autres implémentations de Flash Attention 2 — sans dégradation de la précision. EmbeddingGemma-300M fonctionne avec seulement **3 Go de VRAM**. Vous pouvez utiliser votre modèle entraîné **partout**: transformers, LangChain, Ollama, vLLM, llama.cpp, etc.
Unsloth utilise [SentenceTransformers](https://github.com/huggingface/sentence-transformers) pour prendre en charge des modèles compatibles comme Qwen3-Embedding, BERT et plus encore. **Même s’il n’y a pas de notebook ou de dépôt, c’est toujours pris en charge.**
**Nous avons créé des notebooks de fine-tuning gratuits, avec 3 principaux cas d’usage :**
| [EmbeddingGemma (300M)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/EmbeddingGemma_\(300M\).ipynb) | [Qwen3-Embedding 4B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_Embedding_\(4B\).ipynb) • [0.6B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_Embedding_\(0_6B\).ipynb) | [BGE M3](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/BGE_M3.ipynb) |
| ---------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- |
| [ModernBERT](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/bert_classification.ipynb) - classification | [All-MiniLM-L6-v2](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/All_MiniLM_L6_v2.ipynb) | [ModernBERT-large](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/bert_classification.ipynb) |
* `All-MiniLM-L6-v2`: produire des embeddings de phrases compacts et spécifiques à un domaine pour la recherche sémantique, la recherche d’information et le clustering, ajustés sur vos propres données.
* `tomaarsen/miriad-4.4M-split`: encoder des questions médicales et des articles biomédicaux pour une recherche sémantique médicale et un RAG de haute qualité.
* `electroglyph/technical`: mieux capturer le sens et la მსგავსance sémantique dans le texte technique (documents, spécifications et discussions d’ingénierie).
Vous pouvez consulter le reste de nos modèles téléversés dans [notre collection ici](https://huggingface.co/collections/unsloth/embedding-models).
> Un immense merci au contributeur Unsloth [**electroglyph**](https://github.com/unslothai/unsloth/pull/3719), dont le travail a été essentiel pour rendre cela possible. Vous pouvez découvrir les modèles personnalisés d’electroglyph sur Hugging Face [ici](https://huggingface.co/electroglyph).
### 🦥 Fonctionnalités d’Unsloth
* LoRA/QLoRA ou fine-tuning complet pour les embeddings, sans avoir besoin de réécrire votre pipeline
* Meilleur support pour les modèles `SentenceTransformer` encodeur seul (avec un `modules.json`)
* Les modèles cross-encoder sont confirmés comme s’entraînant correctement même via le chemin de repli
* Cette version prend également en charge `transformers v5`
La prise en charge est limitée pour les modèles sans `modules.json` (nous attribuerons automatiquement les `SentenceTransformers` modules de pooling par défaut). Si vous faites quelque chose de personnalisé (têtes personnalisées, pooling non standard), vérifiez bien les sorties, comme le comportement de l’embedding poolé.
Certains modèles avaient besoin d’ajouts personnalisés, comme MPNet ou DistilBERT, qui ont été activés en intégrant le gradient checkpointing dans le `transformers` modèles.
### 🛠️ Flux de fine-tuning
Le nouveau flux de fine-tuning est centré autour de `FastSentenceTransformer`.
Principales méthodes de sauvegarde/de push :
* `save_pretrained()` Enregistre **les adaptateurs LoRA** dans un dossier local
* `save_pretrained_merged()` Enregistre le **modèle fusionné** dans un dossier local
* `push_to_hub()` Pousse **les adaptateurs LoRA** vers Hugging Face
* `push_to_hub_merged()` Pousse le **modèle fusionné** vers Hugging Face
**Et un détail très important : le chargement pour l’inférence nécessite `for_inference=True`**
`from_pretrained()` est similaire aux autres classes rapides de Lacker, avec **une exception**:
* Pour charger un modèle pour **l’inférence** en utilisant `FastSentenceTransformer`, vous **doit** passer : `for_inference=True`
Donc vos chargements pour l’inférence devraient ressembler à ceci :
```python
model = FastSentenceTransformer.from_pretrained(
"sentence-transformers/all-MiniLM-L6-v2",
for_inference=True,
)
```
Pour l’autorisation Hugging Face, si vous exécutez :
```
hf auth login
```
dans le même environnement virtuel avant d’appeler les méthodes du hub, alors :
* `push_to_hub()` et `push_to_hub_merged()` **ne nécessitent pas d’argument token**.
### ✅ Inference et déploiement partout !
Votre modèle Unsloth fine-tuné peut être utilisé et déployé avec tous les principaux outils : transformers, LangChain, Weaviate, sentence-transformers, Text Embeddings Inference (TEI), vLLM et llama.cpp, API d’embedding personnalisée, pgvector, FAISS/bases de données vectorielles, et n’importe quel framework RAG.
Il n’y a aucun verrouillage, car le modèle fine-tuné peut ensuite être téléchargé localement sur votre propre appareil.
```python
# 1. Charger un modèle Sentence Transformer préentraîné
model = SentenceTransformer("
Voici nos benchmarks Unsloth sous forme de carte thermique vs. `SentenceTransformers` + Flash Attention 2 (FA2) pour du LoRA 16bit. **Pour le LoRA 16bit, Unsloth est 1,2x à 3,3x plus rapide :**
### 🔮 Prise en charge des modèles
Voici quelques modèles d’embedding populaires pris en charge par Unsloth (tous les modèles ne sont pas listés ici) :
```
Alibaba-NLP/gte-modernbert-base
BAAI/bge-large-en-v1.5
BAAI/bge-m3
BAAI/bge-reranker-v2-m3
Qwen/Qwen3-Embedding-0.6B
answerdotai/ModernBERT-base
answerdotai/ModernBERT-large
google/embeddinggemma-300m
intfloat/e5-large-v2
intfloat/multilingual-e5-large-instruct
mixedbread-ai/mxbai-embed-large-v1
sentence-transformers/all-MiniLM-L6-v2
sentence-transformers/all-mpnet-base-v2
Snowflake/snowflake-arctic-embed-l-v2.0
```
La plupart [des modèles courants](https://huggingface.co/models?library=sentence-transformers) sont déjà pris en charge. S’il existe un modèle encodeur seul que vous aimeriez voir supporté, n’hésitez pas à ouvrir une [problème GitHub](https://github.com/unslothai/unsloth/issues) demande à ce sujet.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/notions-de-base/embedding-finetuning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.