> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md).

# GGUF dynamiques d'Unsloth sur Aider Polyglot

Performances des GGUF dynamiques d'Unsloth sur les benchmarks Aider Polyglot

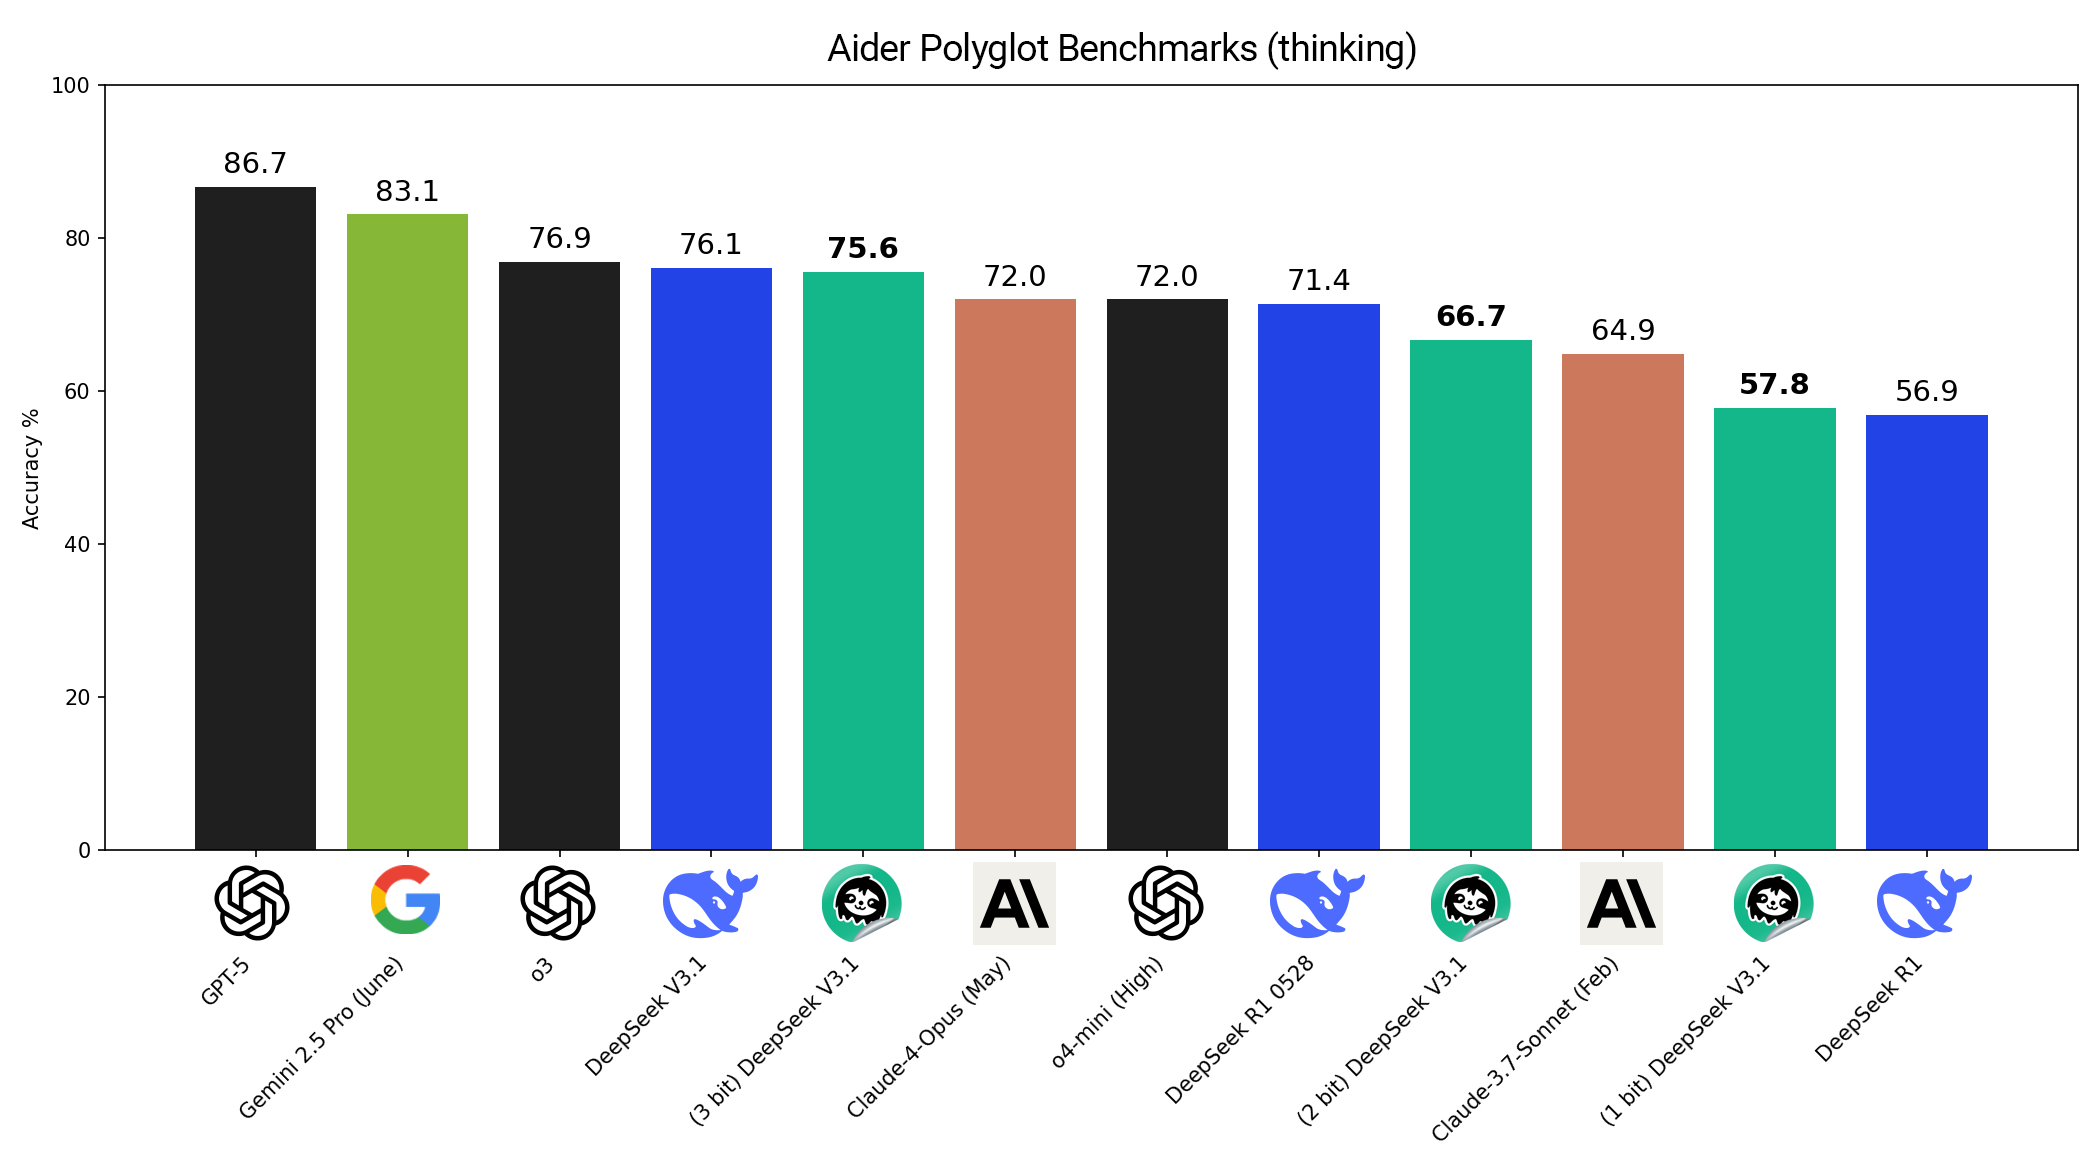
Nous sommes ravis de montrer comment les GGUF dynamiques d’Unsloth rendent possible la quantification de LLM comme [DeepSeek-V3.1](/docs/fr/modeles/tutorials/deepseek-v3.1-how-to-run-locally.md) (671B) jusqu’à seulement **1-bit** ou **3 bits**, et tout de même être capables de surpasser des modèles SOTA comme **GPT-4.5, GPT-4.1** (avril 2025) et **Claude-4-Opus** (mai 2025).

Auparavant, [nous avons démontré](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) comment les GGUF dynamiques d'Unsloth surpassent d'autres méthodes de quantification sur MMLU en 5-shot et la divergence KL. Maintenant, nous montrons leurs performances sur des évaluations tierces indépendantes à l'aide du **Aider Polyglot** **benchmark.**

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a114143bdd47add988182aabf9313ab40be38d7d%2Faider%20thinking.png?alt=media" alt="" width="563"><figcaption><p>Benchmarks Aider avec raisonnement</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b085c16c7f8351308229f1341846cbf1a2617d0a%2Faider%20non.png?alt=media" alt="" width="563"><figcaption><p>Benchmarks Aider sans raisonnement</p></figcaption></figure></div>

### ⭐**Résultats clés**

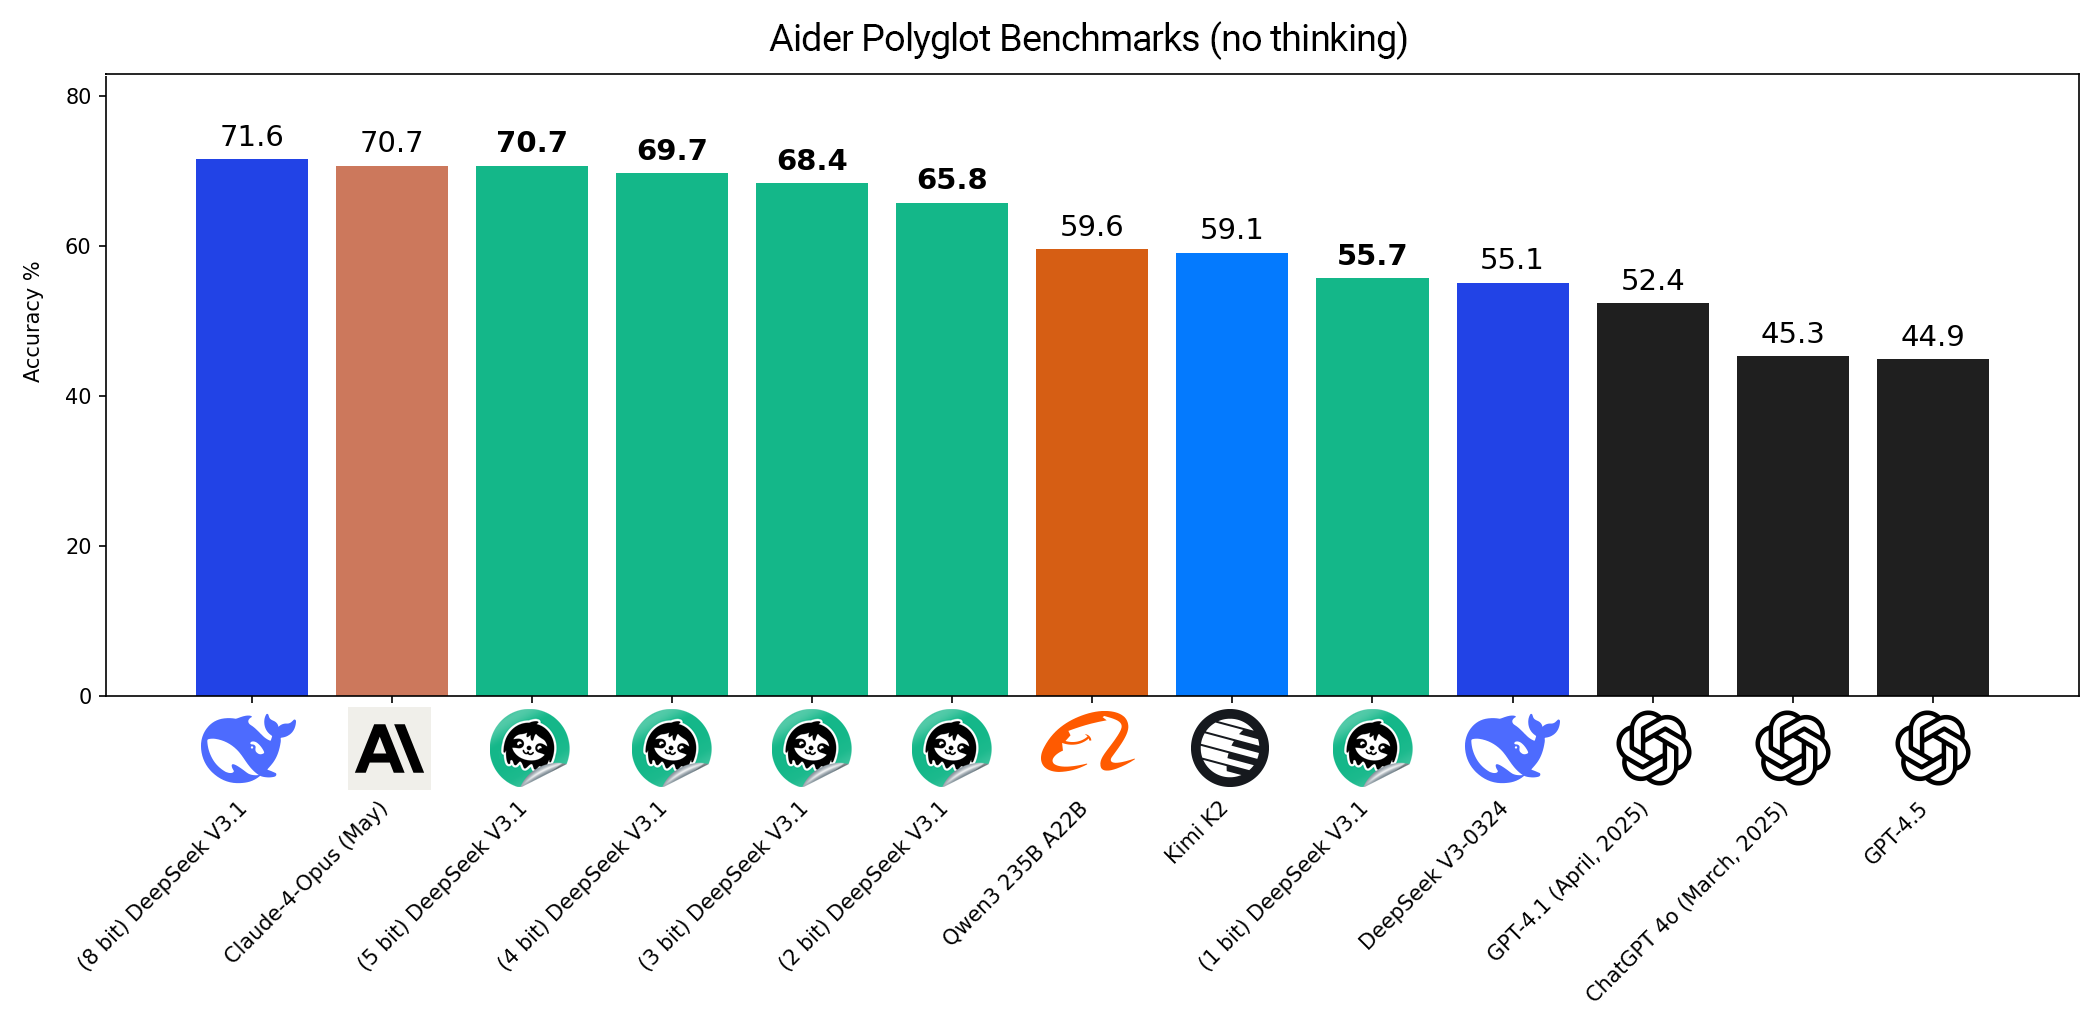
* Notre **1-bit** Les GGUF dynamiques d'Unsloth réduisent DeepSeek-V3.1 de **671 Go → 192 Go (-75 % de taille)** et le mode sans raisonnement surpasse largement GPT-4.1 (avr. 2025), GPT-4.5 et DeepSeek-V3-0324.
* **3 bits** GGUF Unsloth DeepSeek-V3.1 (raisonnement) : surpasse Claude-4-Opus-20250514 (raisonnement).
* **5 bits** GGUF Unsloth DeepSeek-V3.1 (sans raisonnement) : atteint des performances équivalentes à Claude-4-Opus-20250514 (sans raisonnement).
* Les GGUF dynamiques d'Unsloth sont systématiquement plus performants que les autres GGUF imatrix dynamiques non Unsloth
* Les autres quantifications DeepSeek-V3.1 non Unsloth en 1 bit et 2 bits, ainsi que la quantification standard en 1 bit sans quantification sélective des couches, n'ont soit pas pu se charger, soit produit du charabia et des sorties en boucle. Cela montre comment les GGUF dynamiques d'Unsloth parviennent à conserver largement la précision, tandis que les autres méthodes ne fonctionnent même pas.

**Pourquoi le** [**Aider Polyglot**](https://aider.chat/docs/leaderboards/) **benchmark ?** Aider est l'une des mesures les plus complètes de la capacité des LLM à écrire, coder, suivre des instructions et appliquer des modifications sans intervention humaine, ce qui en fait l'un des benchmarks les plus difficiles et les plus précieux pour l'utilisation réelle.

{% hint style="success" %}
Le **principal avantage** de l'utilisation du package et des modèles Unsloth est notre rôle actif dans ***la correction de bogues critiques*** dans les grands modèles. Nous avons collaboré directement avec les équipes derrière [Qwen3](https://www.reddit.com/r/LocalLLaMA/comments/1kaodxu/qwen3_unsloth_dynamic_ggufs_128k_context_bug_fixes/), [Meta (Llama 4)](https://github.com/ggml-org/llama.cpp/pull/12889), [Mistral (Devstral)](https://app.gitbook.com/o/HpyELzcNe0topgVLGCZY/s/xhOjnexMCB3dmuQFQ2Zq/~/changes/618/basics/tutorials-how-to-fine-tune-and-run-llms/devstral-how-to-run-and-fine-tune), [Google (Gemma 1–3)](https://news.ycombinator.com/item?id=39671146) et [Microsoft (Phi-3/4)](https://simonwillison.net/2025/Jan/11/phi-4-bug-fixes), en apportant des correctifs essentiels qui améliorent considérablement la précision.
{% endhint %}

## 🦥Quantification dynamique Unsloth

{% hint style="success" %}
**Le 1 bit dynamique met les couches importantes en 8 ou 16 bits et les couches non importantes en 1, 2, 3, 4, 5 ou 6 bits.**
{% endhint %}

En nov. 2024, nos [Dynamiques 4 bits](https://unsloth.ai/blog/dynamic-4bit) Quantifications ont montré comment vous pouviez en grande partie restaurer l'ajustement fin QLoRA et la précision du modèle simplement en <mark style="background-color:green;">**quantifiant sélectivement les couches**</mark>. Nous avons ensuite étudié [DeepSeek-R1](/docs/fr/modeles/tutorials/deepseek-r1-how-to-run-locally.md)l'architecture de et avons appliqué cette méthodologie similaire, où nous avons quantifié certaines couches jusqu'à 1 bit et les couches importantes à des bits plus élevés (6, 8 bits). Cette approche a rapidement gagné en popularité et s'est révélée particulièrement efficace pour les modèles MoE, faisant de la quantification dynamique la norme de facto pour la quantification MoE.

Nos GGUF dynamiques sont encore plus efficaces lorsqu'ils sont associés à notre [jeu de données d'étalonnage imatrix](https://unsloth.ai/docs/fr/notions-de-base/dynamic-3.0-ggufs/pages/8e3d570b34072053937ce45a7a2125f403689ec3#whats-new-in-dynamic-v2.0), conçu pour les performances en discussion et en codage. Tout cela a permis une compression extrême des LLM sans perte catastrophique de qualité.

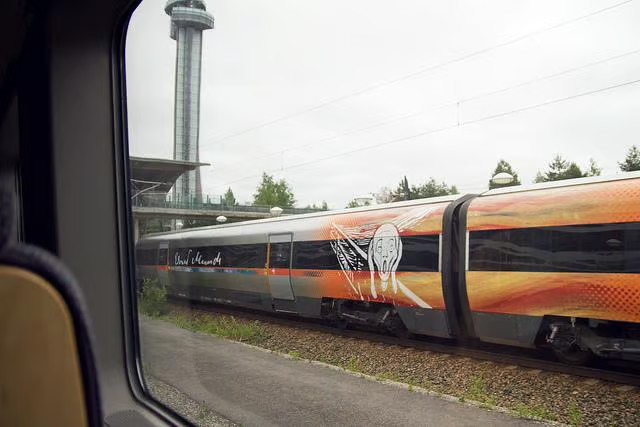
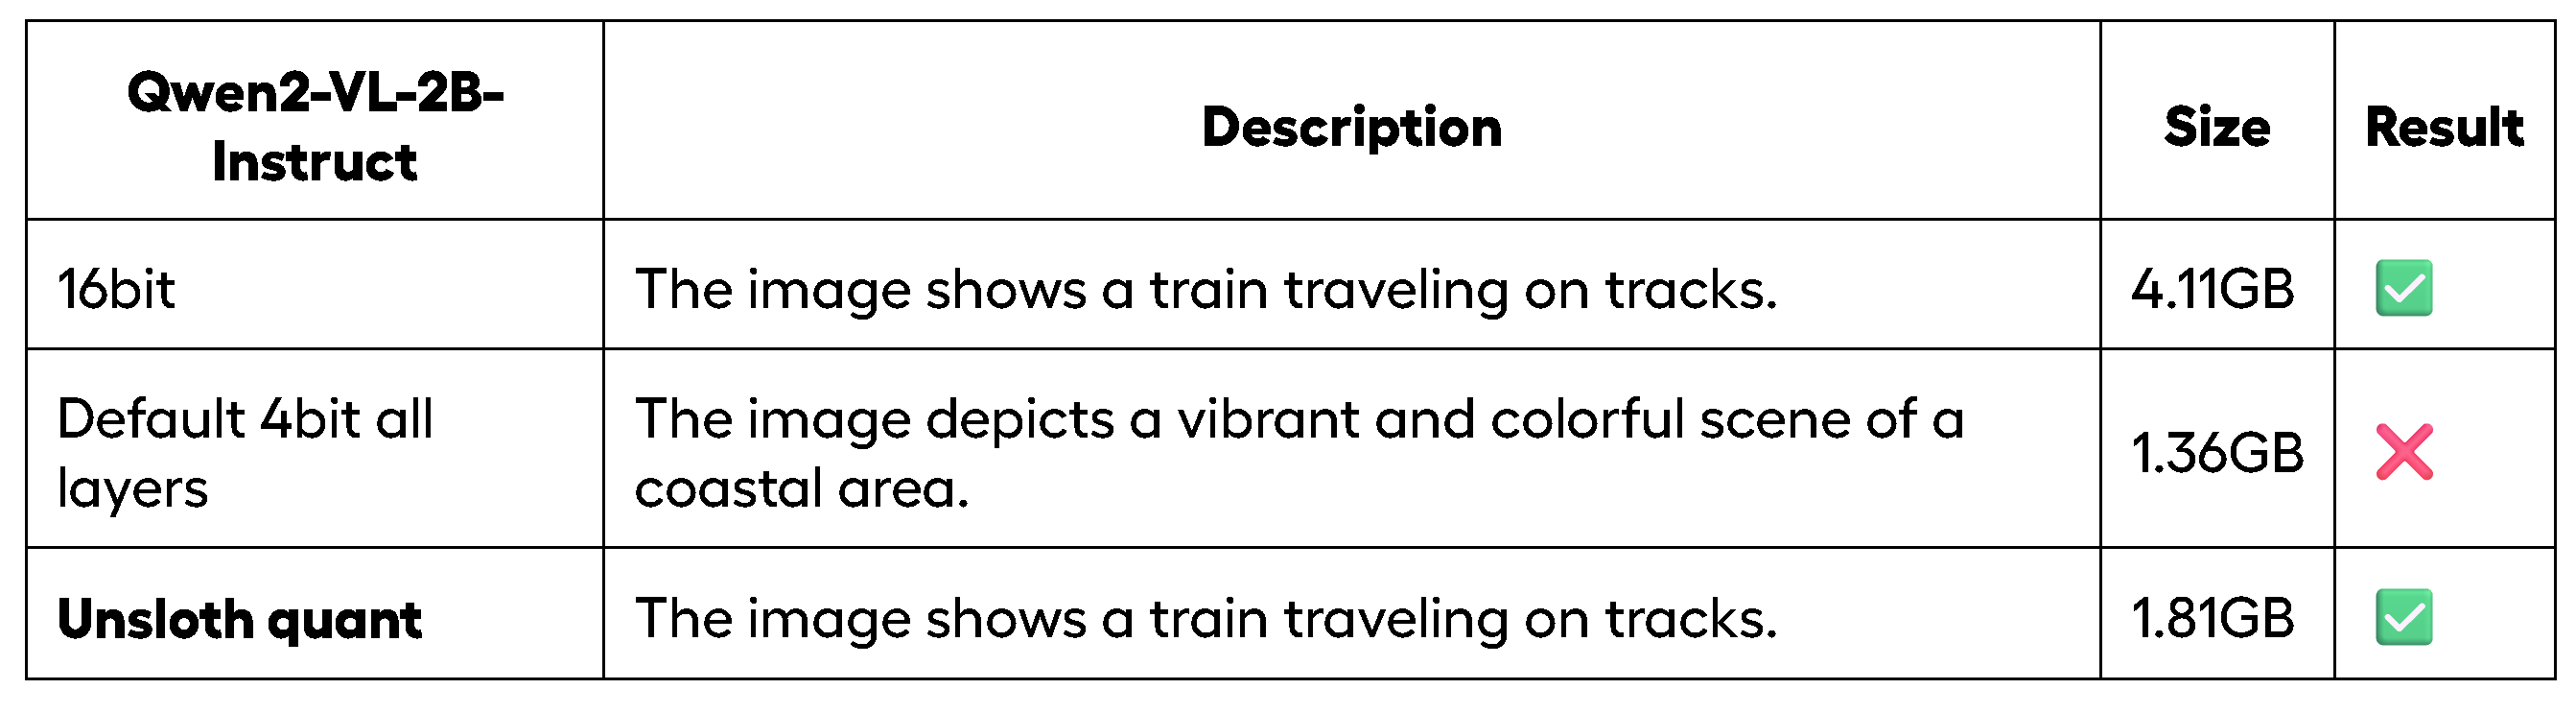
Par exemple, dans Qwen2-VL-2B-Instruct, quantifier naïvement toutes les couches en 4 bits fait échouer le modèle à comprendre l'image ci-dessous. C'est un train, pas une scène côtière !

{% columns %}
{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-379bd5cc72a8f8e9acb4b6a6ad9fe847bf1ec296%2FTrain_NPovU814oJVjqy9Gu3BSm.avif?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-38f5ea51c343a79bde7996d678761944f1dedaa7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

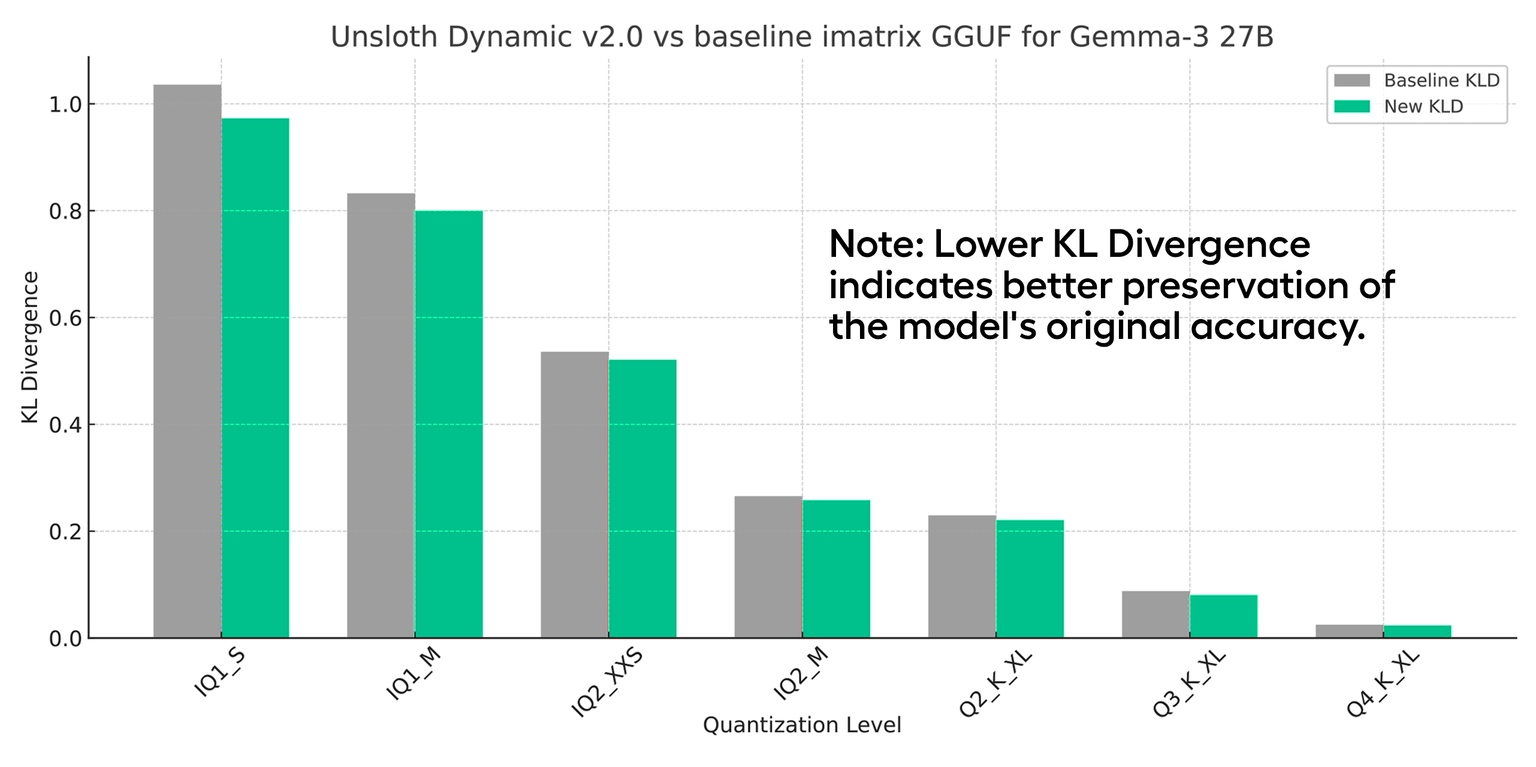
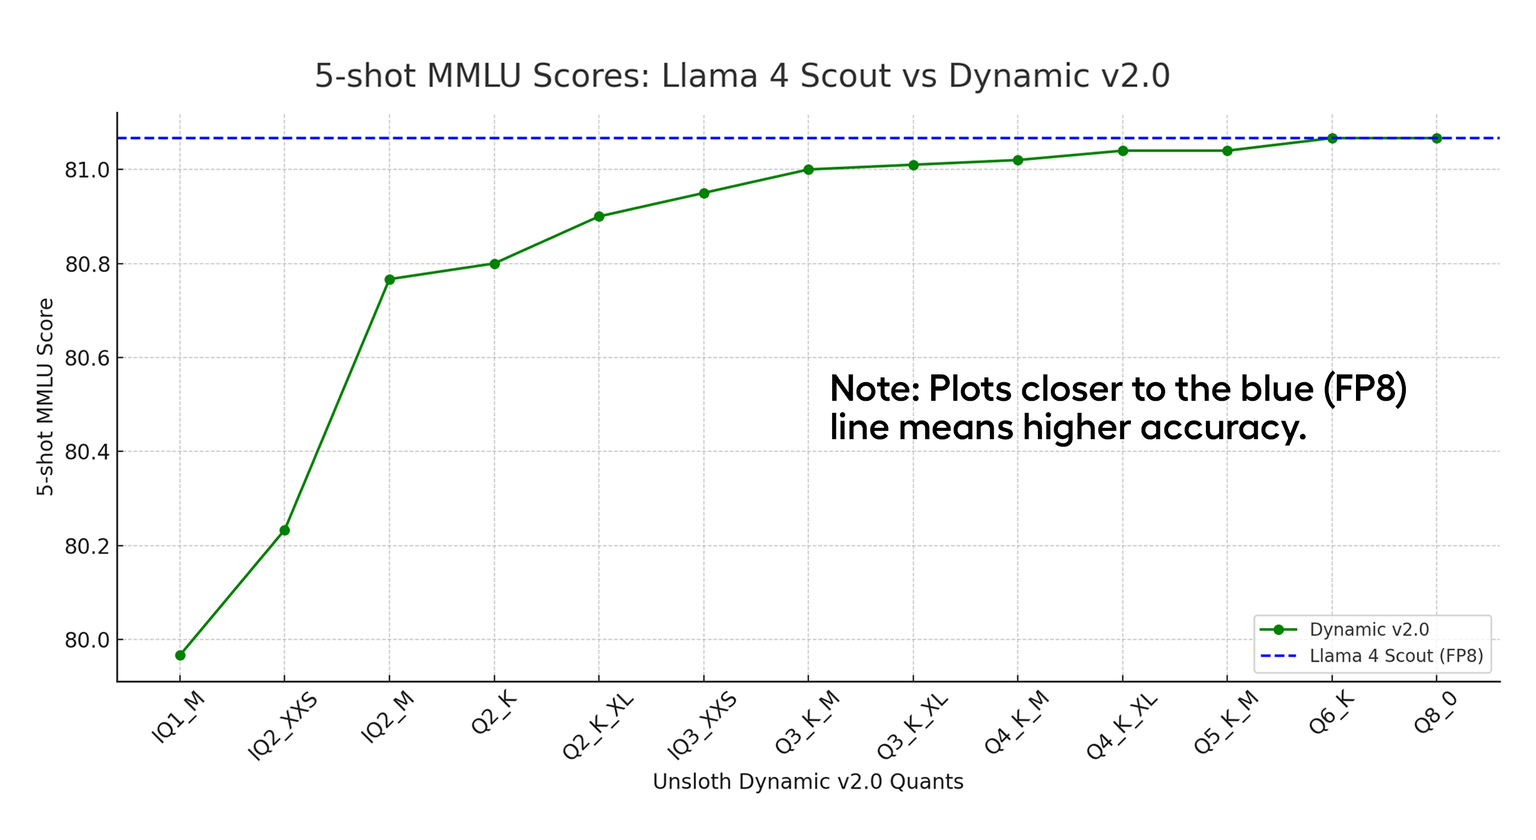
Nous avons également montré des benchmarks dynamiques dans <https://docs.unsloth.ai/basics/unsloth-dynamic-2.0-ggufs> pour Gemma 3 et Llama 4 Scout, montrant à quel point notre méthodologie est efficace :

{% columns %}
{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-28c5aa4355f5c09aef43217f2a02131aa6e3517f%2Fimage.avif?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-db47ebf519863f334f58c925dd6b39d0e01c359b%2Fimage.avif?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

### ⚙️Configuration du benchmark

Pour nos expériences DeepSeek-V3.1, nous avons comparé différents bits de **GGUF dynamiques Unsloth** par rapport à :

* **LLM en précision totale, non quantifiés** y compris GPT 4.5, 4.1, Claude-4-Opus, DeepSeek-V3-0324, etc.
* ***Autre*****&#x20;GGUF imatrix V3.1 dynamiques**
* ***Semi-*****dynamique** (une certaine quantification sélective des couches) GGUF imatrix V3.1 pour **les besoins de l'ablation**.

Les expériences de benchmark ont été principalement menées par [David Sluys](https://www.linkedin.com/in/david-sluys-231348208/) (neolithic5452 sur [le Discord Aider](https://discord.com/channels/1131200896827654144/1408293692074360914)), un contributeur communautaire de confiance aux évaluations Aider Polyglot. Les tests ont été exécutés environ 3 fois et moyennés pour obtenir un score médian, et la précision Pass-2 est indiquée comme le veut la convention. Il existe quelques extraits de code reproductibles dans le Discord d'Aider.

<details>

<summary>Déplier pour les benchmarks Aider des modèles de raisonnement</summary>

| Modèle                             | Précision |
| ---------------------------------- | --------- |
| GPT-5                              | 86.7      |
| Gemini 2.5 Pro (juin)              | 83.1      |
| o3                                 | 76.9      |
| DeepSeek V3.1                      | 76.1      |
| **(3 bits) DeepSeek V3.1 Unsloth** | **75.6**  |
| Claude-4-Opus (mai)                | 72        |
| o4-mini (Élevé)                    | 72        |
| DeepSeek R1 0528                   | 71.4      |
| **(2 bits) DeepSeek V3.1 Unsloth** | **66.7**  |
| Claude-3.7-Sonnet (févr.)          | 64.9      |
| **(1 bit) DeepSeek V3.1 Unsloth**  | **57.8**  |
| DeepSeek R1                        | 56.9      |

</details>

<details>

<summary>Déplier pour les benchmarks Aider des modèles sans raisonnement</summary>

| Modèle                             | Précision |
| ---------------------------------- | --------- |
| DeepSeek V3.1                      | 71.6      |
| Claude-4-Opus (mai)                | 70.7      |
| **(5 bits) DeepSeek V3.1 Unsloth** | **70.7**  |
| **(4 bits) DeepSeek V3.1 Unsloth** | **69.7**  |
| **(3 bits) DeepSeek V3.1 Unsloth** | **68.4**  |
| **(2 bits) DeepSeek V3.1 Unsloth** | **65.8**  |
| Qwen3 235B A22B                    | 59.6      |
| Kimi K2                            | 59.1      |
| **(1 bit) DeepSeek V3.1 Unsloth**  | **55.7**  |
| DeepSeek V3-0324                   | 55.1      |
| GPT-4.1 (avril 2025)               | 52.4      |
| ChatGPT 4o (mars 2025)             | 45.3      |
| GPT-4.5                            | 44.9      |

</details>

DeepSeek V3.1 possède à la fois un mode de raisonnement et un mode sans raisonnement, et nous testons les deux. Pour le mode sans raisonnement, nous observons ci-dessous une tendance claire de la façon dont nos quantifications dynamiques se comportent. La version dynamique 5 bits atteint 70,7 % sur Aider Pass-2, tandis que la version dynamique 1 bit atteint 55,7 %. En termes de taille et de précision, les versions 3 et 4 bits sont extrêmement puissantes !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b085c16c7f8351308229f1341846cbf1a2617d0a%2Faider%20non.png?alt=media" alt=""><figcaption></figcaption></figure>

## :sparkler:Comparaison avec d'autres quantifications

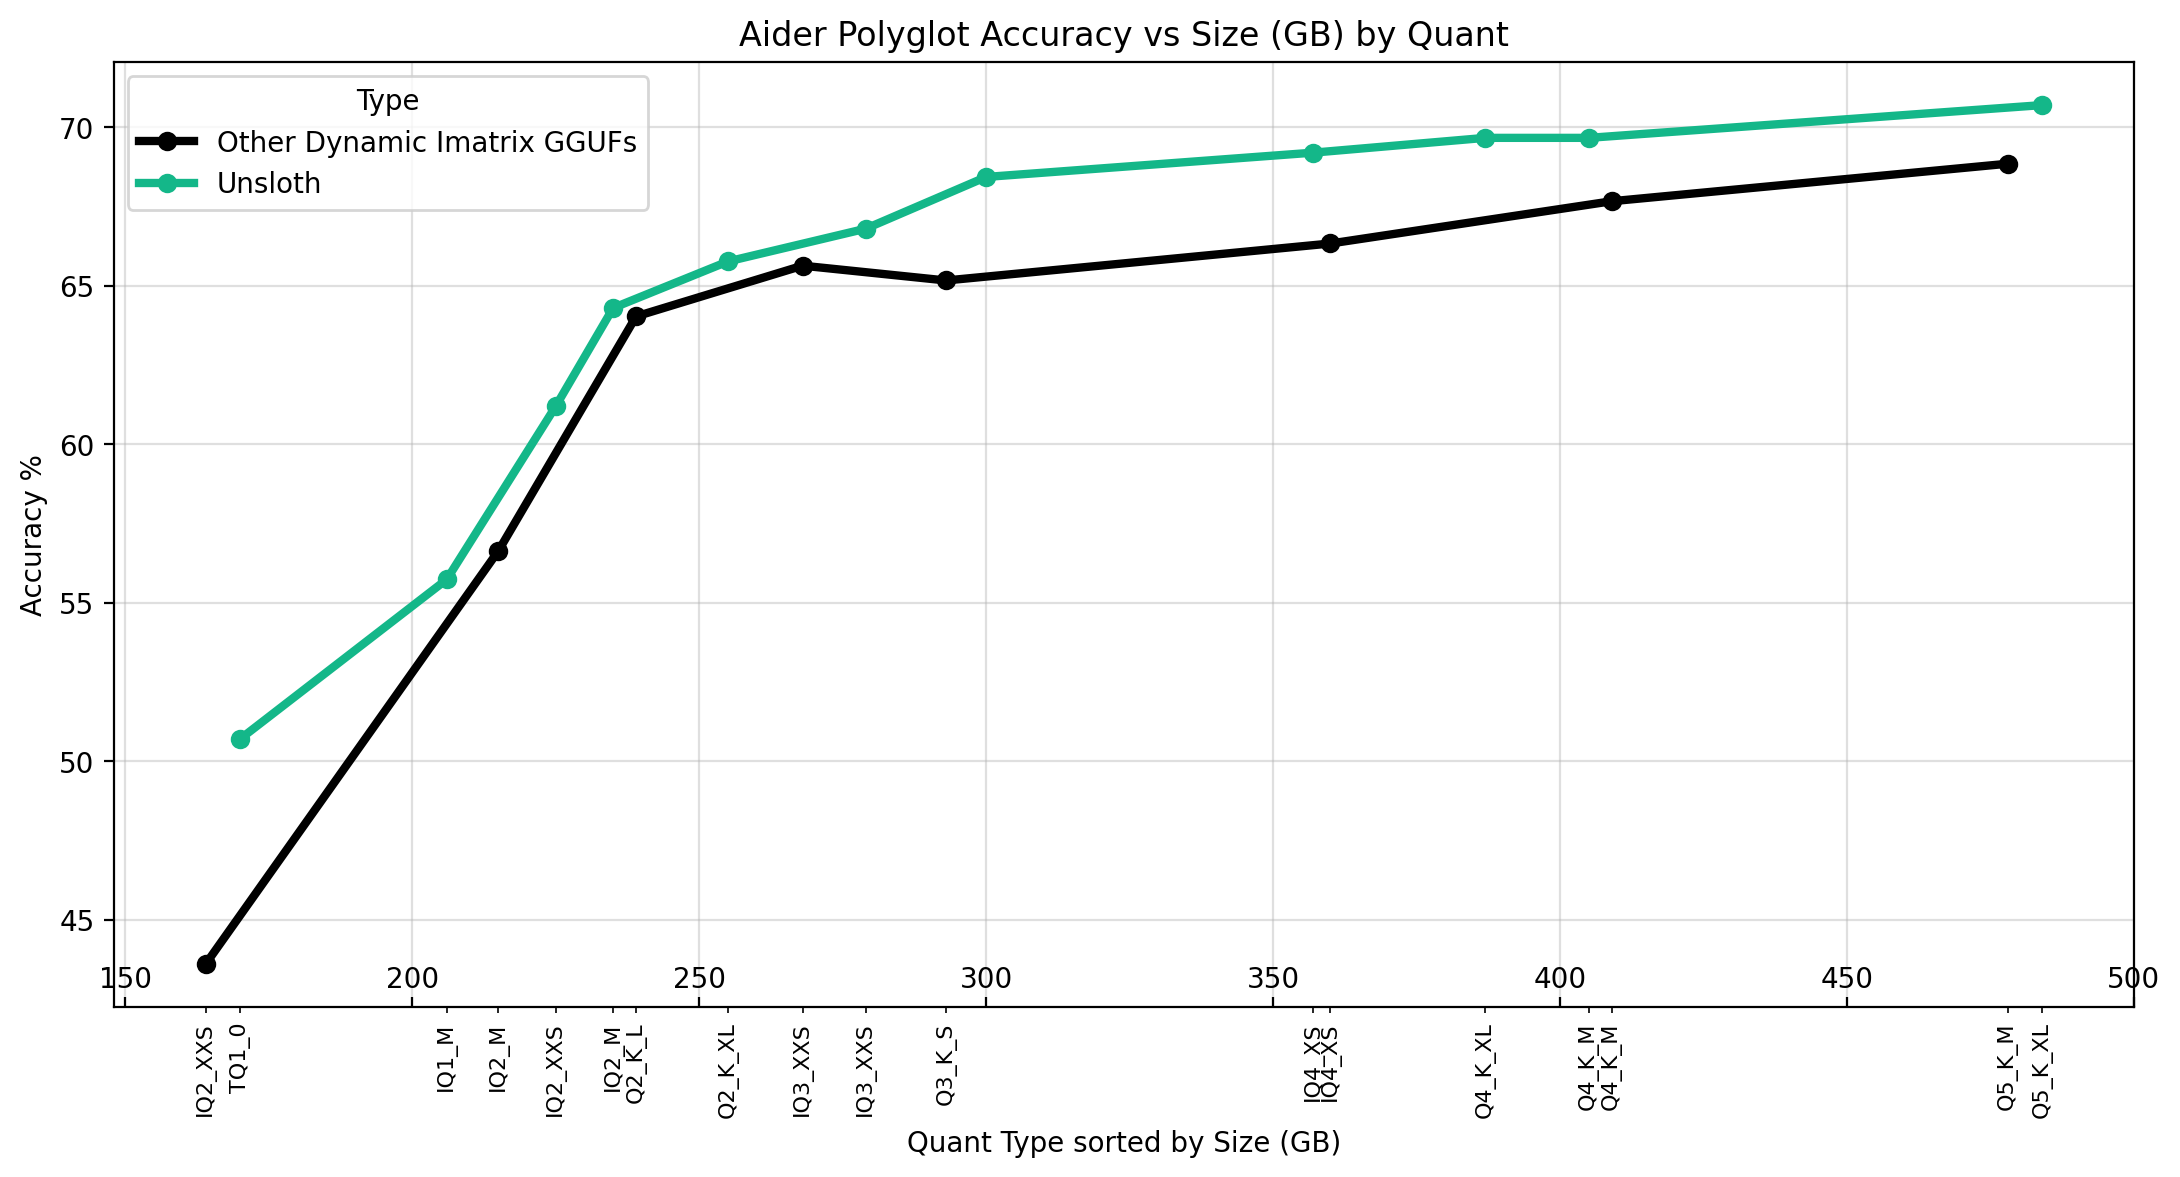
Nous exécutons également le benchmark Aider Polyglot sur d'autres GGUF imatrix dynamiques de la communauté et les comparons aux nôtres. Pour garantir une **comparaison équitable**, nous procédons comme suit :

1. Nous sélectionnons des fichiers de taille et de types de bits similaires à chaque quantification Unsloth.
2. Nous utilisons notre **modèle de conversation corrigé** si la quantification de la communauté ne parvient pas à exécuter le benchmark. Nous avons constaté que certaines quantifications communautaires `{"code":500,"message":"la méthode split doit avoir entre 1 et 1 argument positionnel et entre 0 et 0 argument mot-clé à la ligne 3, colonne 1908"}`, et cela est corrigé en utilisant notre modèle de conversation corrigé.

Nous voyons que les quantifications dynamiques Unsloth se comportent remarquablement bien par rapport aux autres quantifications communautaires pour la même taille de modèle et le même type de quantification !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-bbebbacfa75126d246c3ca1ed2ca269bc815b028%2FOther%20quants.png?alt=media" alt=""><figcaption></figcaption></figure>

<details>

<summary>Déplier pour la comparaison des données numériques brutes avec d'autres quantifications</summary>

<table><thead><tr><th width="109.25">Quantification</th><th width="171.25006103515625">Taille de la quantification (Go)</th><th>Précision Unsloth %</th><th>Précision de comparaison %</th></tr></thead><tbody><tr><td>IQ2_XXS</td><td>164</td><td></td><td>43.6</td></tr><tr><td>TQ1_0</td><td>170</td><td>50.7</td><td></td></tr><tr><td>IQ1_M</td><td>206</td><td>55.7</td><td></td></tr><tr><td>IQ2_M</td><td>215</td><td></td><td>56.6</td></tr><tr><td>IQ2_XXS</td><td>225</td><td>61.2</td><td></td></tr><tr><td>IQ2_M</td><td>235</td><td>64.3</td><td></td></tr><tr><td>Q2_K_L</td><td>239</td><td></td><td>64.0</td></tr><tr><td>Q2_K_XL</td><td>255</td><td>65.8</td><td></td></tr><tr><td>IQ3_XXS</td><td>268</td><td>65.6</td><td>65.6</td></tr><tr><td>IQ3_XXS</td><td>279</td><td>66.8</td><td></td></tr><tr><td>Q3_K_S</td><td>293</td><td></td><td>65.2</td></tr><tr><td>Q3_K_XL</td><td>300</td><td>68.4</td><td></td></tr><tr><td>IQ4_XS</td><td>357</td><td>69.2</td><td></td></tr><tr><td>IQ4_XS</td><td>360</td><td></td><td>66.3</td></tr><tr><td>Q4_K_XL</td><td>387</td><td>69.7</td><td></td></tr><tr><td>Q4_K_M</td><td>405</td><td>69.7</td><td></td></tr><tr><td>Q4_K_M</td><td>409</td><td></td><td>67.7</td></tr><tr><td>Q5_K_M</td><td>478</td><td></td><td>68.9</td></tr><tr><td>Q5_K_XL</td><td>484</td><td>70.7</td><td></td></tr></tbody></table>

</details>

### :cake:Ablations de la quantification dynamique

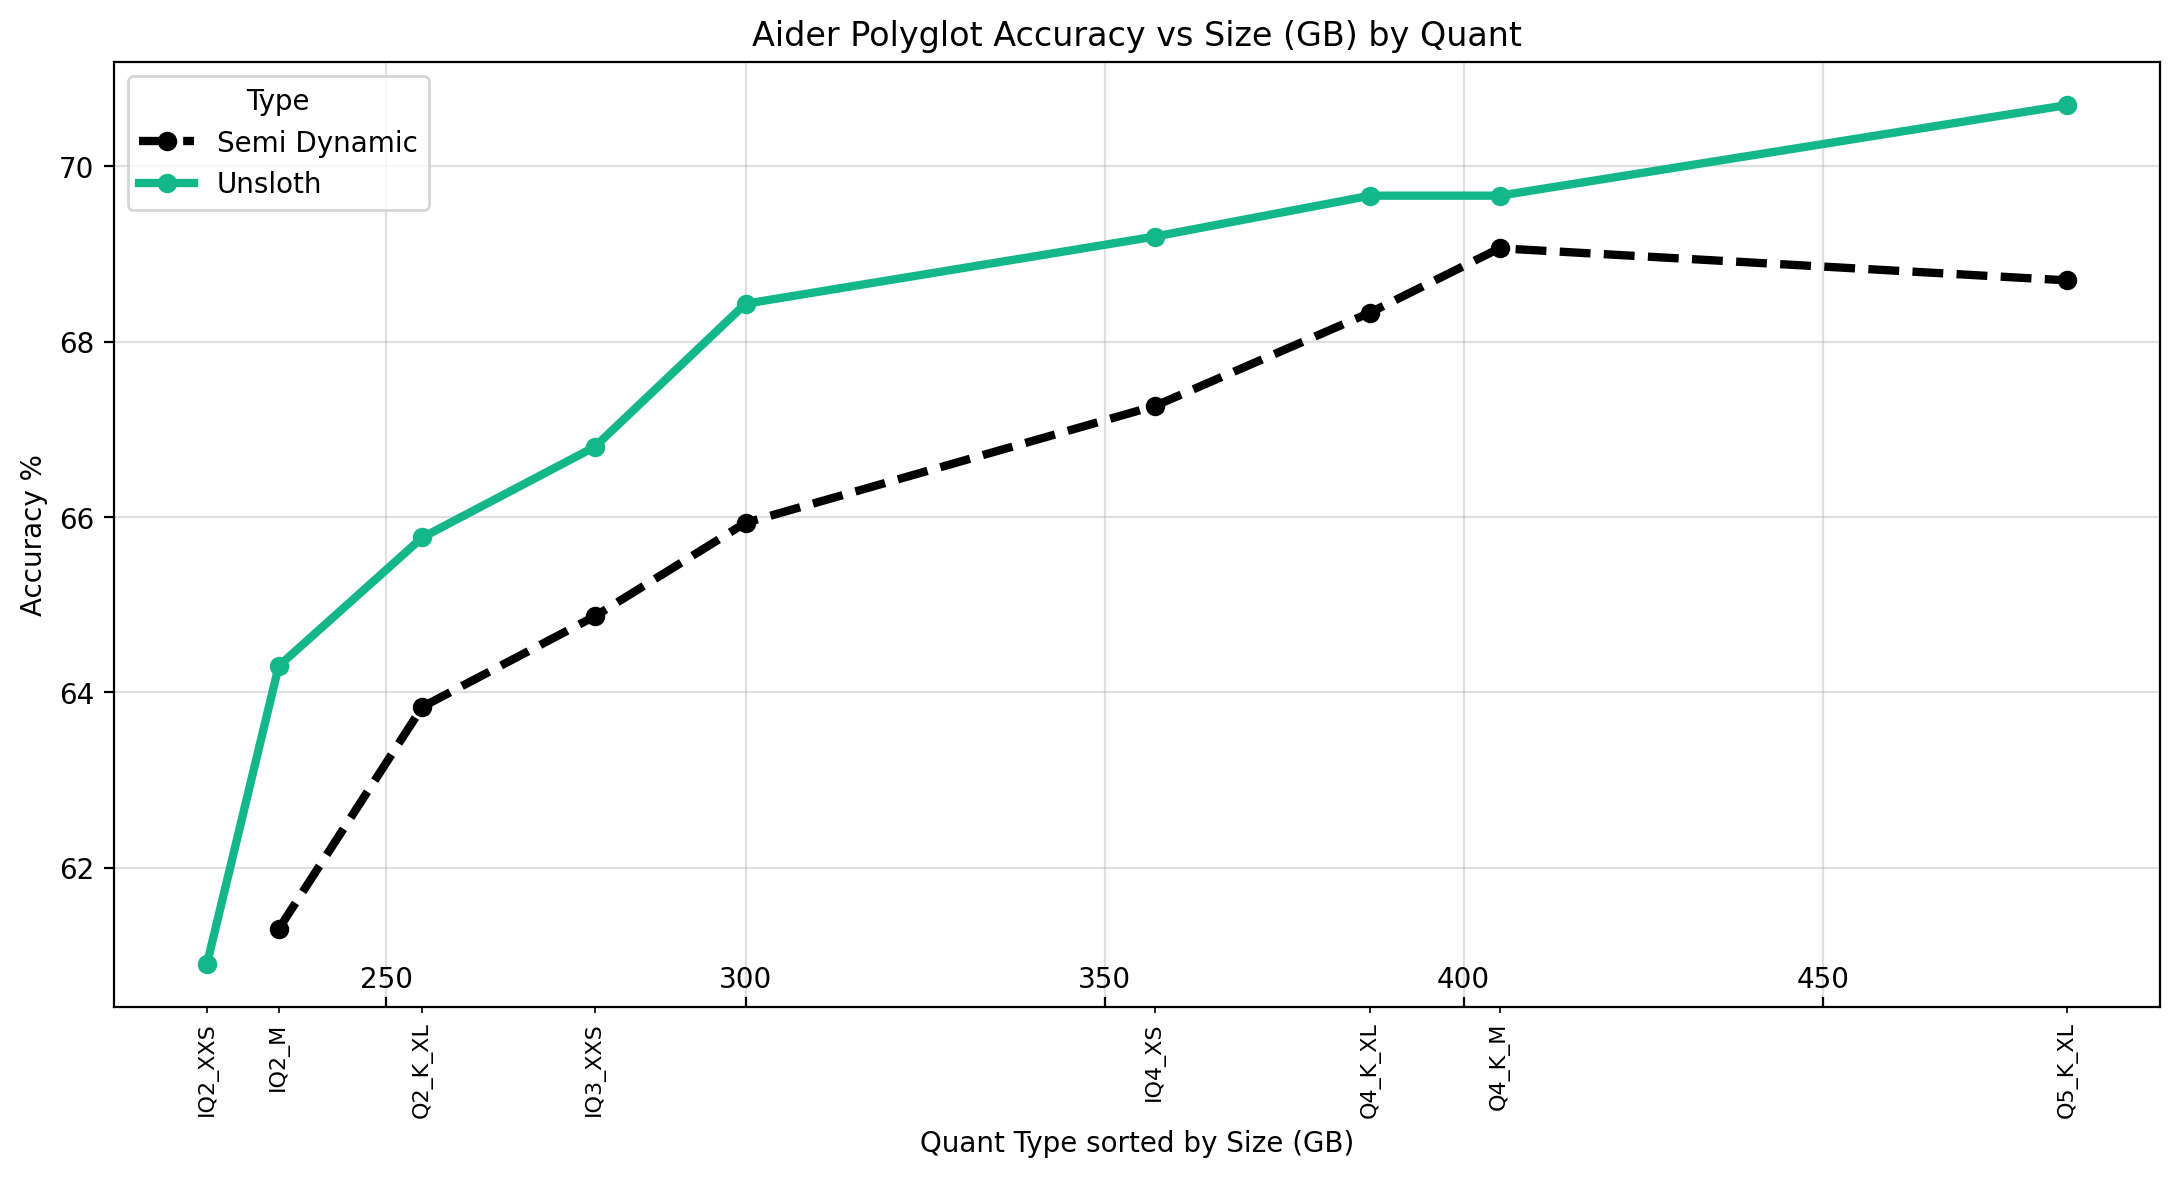
Nous avons également réalisé quelques ablations pour confirmer si notre jeu de données d'étalonnage et notre méthodologie de quantification dynamique fonctionnent réellement. L'astuce de la méthode dynamique d'Unsloth consiste à quantifier **les couches importantes à des bits plus élevés** par exemple 8 bits, tandis que **les couches non importantes sont laissées à des bits plus faibles comme 2 bits**.

Pour tester notre méthode, nous laissons certains tenseurs dans une précision inférieure comme 4 bits contre une précision supérieure. Par exemple, ci-dessous nous laissons `attn_k_b` les tenseurs en 4 bits (semi-dynamique) contre 8 bits (Unsloth actuel), et en augmentant la taille de quantification d'environ 100 Mo seulement ou à peu près (<0,1 %), la précision s'envole de façon spectaculaire !

{% hint style="success" %}
`attn_k_b` et d'autres tenseurs dans DeepSeek V3.1 sont hautement importants / sensibles à la quantification et devraient être laissés en précision supérieure pour conserver la précision !
{% endhint %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-3b4f8ac3af4ec8d09763c2e5f5d7de912d0b042e%2FSemi%20Dynamic.png?alt=media" alt=""><figcaption></figcaption></figure>

### :bug:Corrections de bogues du modèle de conversation

Lors des tests des quantifications DeepSeek-V3.1, nous avons trouvé que certaines quantifications de faible nombre de bits n'encadraient pas `<think> </think>` correctement ou produisaient un formatage étrange. Cela a entraîné le non-fonctionnement de certaines quantifications communautaires en faible nombre de bits, ce qui a donc créé des comparaisons injustes. Nous avons constaté que l'utilisation de minja par llama.cpp (une version plus simple de jinja) n'accepte pas d'argument positionnel dans `.split`. Nous avons dû modifier :

```
{%- set content = content.split("</think>", 1)[1] -%}
```

en ceci :

```
{%- set splitted = content.split("</think>") -%}
{%- set content = splitted[1:] | join("</think>") -%}
```

Voir [ici](https://huggingface.co/unsloth/DeepSeek-V3.1-GGUF?chat_template=default\&format=true) pour notre modèle de conversation corrigé ou [ici](https://huggingface.co/unsloth/DeepSeek-V3.1/raw/main/chat_template.jinja) pour un fichier jinja brut.

### :bar\_chart:Taux de réussite 1

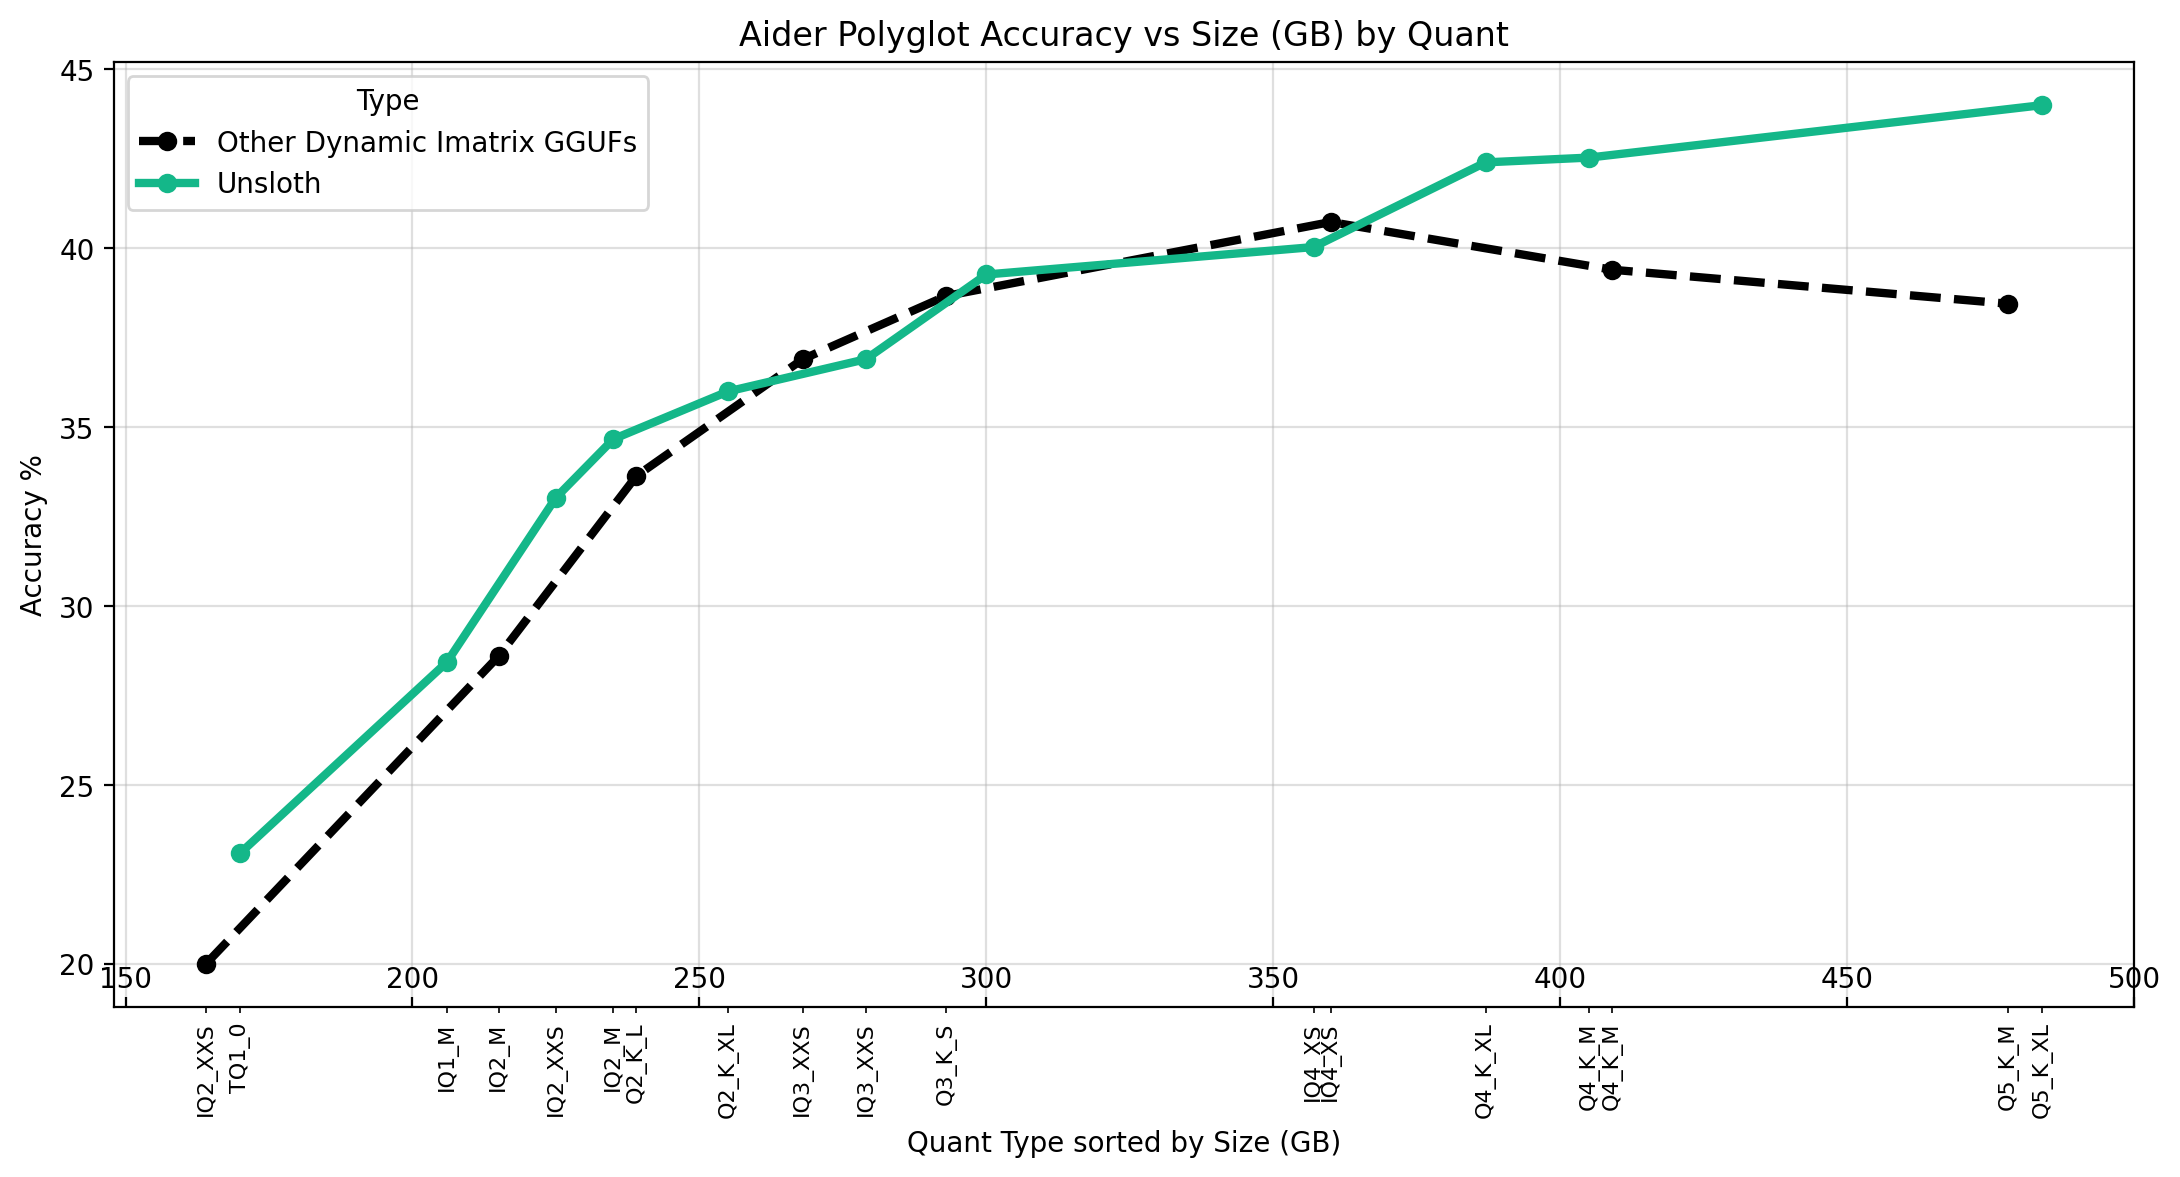
Aider est principalement rapporté sur le taux de réussite 2. Nous indiquons également le taux de réussite 1 pour comparer les quantifications communautaires de même taille. Nous voyons que nos quantifications dynamiques font bien mieux que d'autres quantifications communautaires de tailles similaires, en particulier en dessous de 2 bits et au-dessus de 4 bits. Les versions 3 et 4 bits fonctionnent tout aussi bien.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-dfea83b4ef3e0d1a1c835476270eeb4f3f6db798%2FPass%20Rate%201%20Non%20Thinking.png?alt=media" alt=""><figcaption></figcaption></figure>

## :computer:Exécuter les quantifications dynamiques DeepSeek V3.1

Rendez-vous sur notre [guide DeepSeek V3.1](/docs/fr/modeles/tutorials/deepseek-r1-how-to-run-locally/deepseek-r1-dynamic-1.58-bit.md) ou, pour obtenir rapidement la version dynamique 2 bits, faites :

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli llama-server
cp llama.cpp/build/bin/llama-* llama.cpp
```

puis utilisez `llama.cpp` pour télécharger directement les poids. Nous avons également déjà défini les paramètres optimaux recommandés, comme la température, le modèle de conversation, etc. :

```bash
export LLAMA_CACHE="unsloth/DeepSeek-V3.1-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/DeepSeek-V3.1-GGUF:Q2_K_XL \\
    --jinja \
    --n-gpu-layers 99 \
    --temp 0.6 \
    --top-p 0.95 \
    --min-p 0.01 \
    --ctx-size 8192 \
    --seed 3407 \
    -ot ".ffn_.*_exps.=CPU"
```


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/notions-de-base/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.