> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/qwen3-how-to-run-and-fine-tune/qwen3-vl-how-to-run-and-fine-tune.md).
# Qwen3-VL : guide d'exécution
Apprenez à fine-tuner et à exécuter Qwen3-VL localement avec Unsloth.
Qwen3-VL est la nouvelle famille de modèles de vision de Qwen avec **instruct** et **réflexion** des versions. Les modèles 2B, 4B, 8B et 32B sont denses, tandis que les 30B et 235B sont des MoE. Le LLM de réflexion 235B offre des performances de pointe en vision et en codage, rivalisant avec GPT-5 (élevé) et Gemini 2.5 Pro.\
\
Qwen3-VL dispose de capacités de vision, de vidéo et d'OCR ainsi que d'un contexte de 256K (extensible à 1M).\
\
[Unsloth](https://github.com/unslothai/unsloth) prend en charge **l'ajustement fin de Qwen3-VL et** [**RL**](/docs/fr/commencer/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md). Entraînez Qwen3-VL (8B) gratuitement avec notre [notebooks](#fine-tuning-qwen3-vl).
Exécution de Qwen3-VLAjustement fin de Qwen3-VL
## 🖥️ **Exécution de Qwen3-VL**
Pour exécuter le modèle dans llama.cpp, vLLM, Ollama, etc., voici les paramètres recommandés :
### :gear: Paramètres recommandés
Qwen recommande ces paramètres pour les deux modèles (ils sont un peu différents entre Instruct et Thinking) :
| Paramètres Instruct : | Paramètres Thinking : |
| ------------------------------------------------------------------------ | ------------------------------------------------------------------------ |
| **Temperature = 0.7** | **Temperature = 1.0** |
| **Top\_P = 0.8** | **Top\_P = 0.95** |
| **presence\_penalty = 1.5** | **presence\_penalty = 0.0** |
| Longueur de sortie = 32768 (jusqu'à 256K) | Longueur de sortie = 40960 (jusqu'à 256K) |
| Top\_K = 20 | Top\_K = 20 |
Qwen3-VL a également utilisé les paramètres ci-dessous pour ses résultats de benchmark, comme mentionné [sur GitHub](https://github.com/QwenLM/Qwen3-VL/tree/main?tab=readme-ov-file#generation-hyperparameters).
{% columns %}
{% column %}
Paramètres Instruct :
```bash
export greedy='false'
export seed=3407
export top_p=0.8
export top_k=20
export temperature=0.7
export repetition_penalty=1.0
export presence_penalty=1.5
export out_seq_length=32768
```
{% endcolumn %}
{% column %}
Paramètres Thinking :
```bash
export greedy='false'
export seed=1234
export top_p=0.95
export top_k=20
export temperature=1.0
export repetition_penalty=1.0
export presence_penalty=0.0
export out_seq_length=40960
```
{% endcolumn %}
{% endcolumns %}
### :bug:Corrections de bugs du modèle de conversation
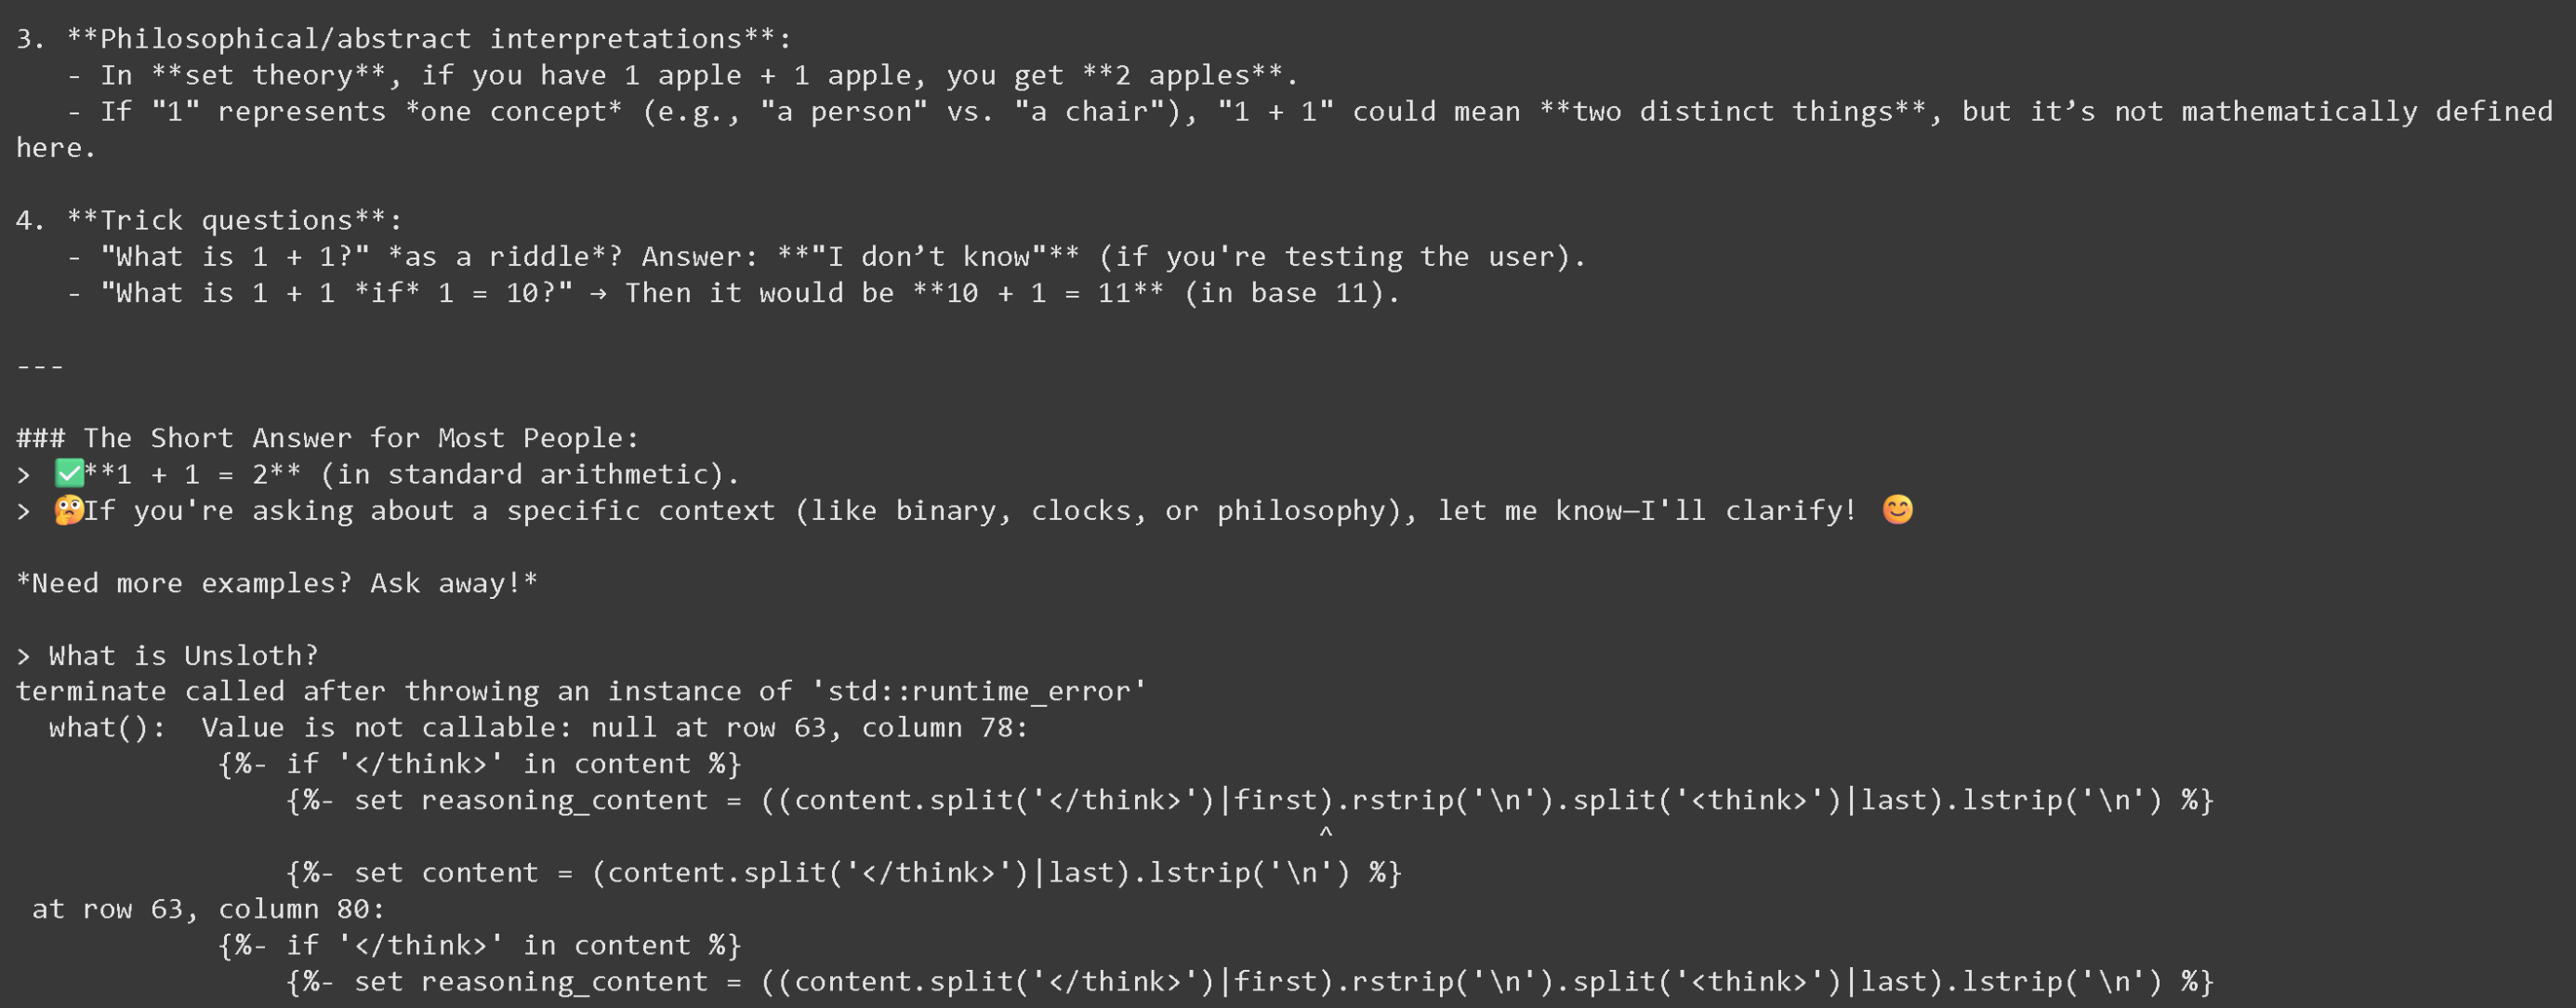
Chez Unsloth, nous accordons la plus grande importance à la précision, alors nous avons enquêté sur la raison pour laquelle, après le 2e tour d'exécution des modèles Thinking, llama.cpp se rompait, comme indiqué ci-dessous :
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
Le code d'erreur :
```
terminate called after throwing an instance of 'std::runtime_error'
what(): Value is not callable: null at row 63, column 78:
{%- if '' in content %}
{%- set reasoning_content = ((content.split('')|first).rstrip('\n').split('')|last).lstrip('\n') %}
^
```
{% endcolumn %}
{% endcolumns %}
Nous avons réussi à corriger le modèle de conversation Thinking pour les modèles VL, nous avons donc téléversé à nouveau tous les quants Thinking et les quants d'Unsloth. Ils devraient désormais tous fonctionner après la 2e conversation - **les autres quants échoueront au chargement après la 2e conversation.**
### **Téléversements Unsloth de Qwen3-VL**:
Qwen3-VL est désormais pris en charge pour les GGUF par llama.cpp depuis le 30 octobre 2025, vous pouvez donc les exécuter localement !
| GGUF dynamiques (à exécuter) | 4 bits BnB Unsloth dynamique | 16 bits en précision complète |
| ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
|
|
### 📖 Llama.cpp : Tutoriel d'exécution de Qwen3-VL
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. **Commençons par obtenir une image !** Vous pouvez également téléverser des images. Nous utiliserons , qui est simplement notre mini-logo montrant comment les fine-tunes sont réalisés avec Unsloth :
3. Téléchargeons cette image
{% code overflow="wrap" %}
```bash
wget https://raw.githubusercontent.com/unslothai/unsloth/refs/heads/main/images/unsloth%20made%20with%20love.png -O unsloth.png
```
{% endcode %}
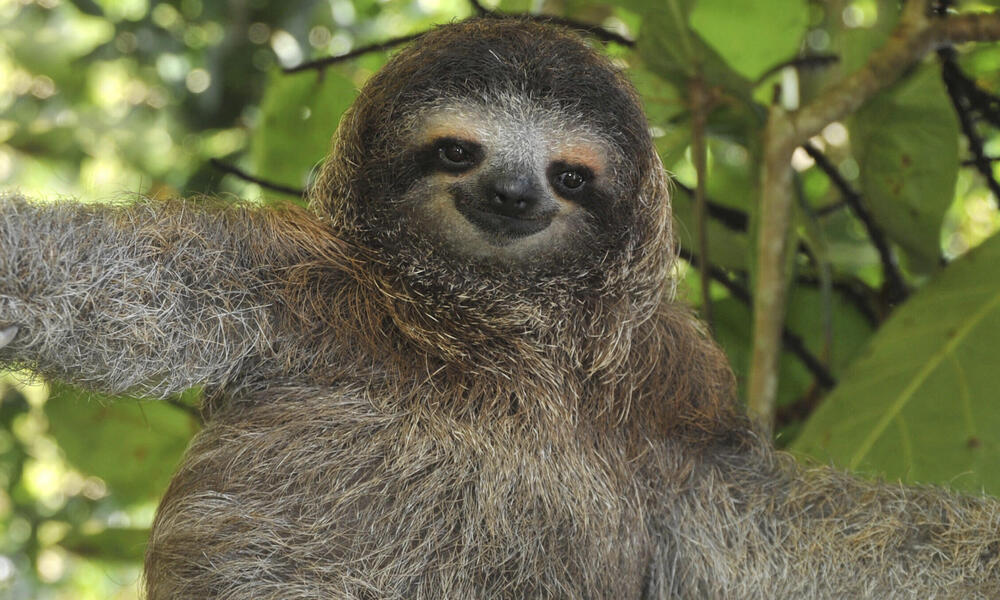
4. Prenons la 2e image à
{% code overflow="wrap" %}
```bash
wget https://files.worldwildlife.org/wwfcmsprod/images/Sloth_Sitting_iStock_3_12_2014/story_full_width/8l7pbjmj29_iStock_000011145477Large_mini__1_.jpg -O picture.png
```
{% endcode %}
5. Ensuite, utilisons la fonction de téléchargement automatique de modèle de llama.cpp, essayez ceci pour le modèle 8B Instruct :
```bash
./llama.cpp/llama-mtmd-cli \
-hf unsloth/Qwen3-VL-8B-Instruct-GGUF:UD-Q4_K_XL \\
--n-gpu-layers 99 \
--jinja \
--top-p 0.8 \\
--top-k 20 \\
--temp 0.7 \
--min-p 0.0 \\
--flash-attn on \
--presence-penalty 1.5 \\
--ctx-size 8192
```
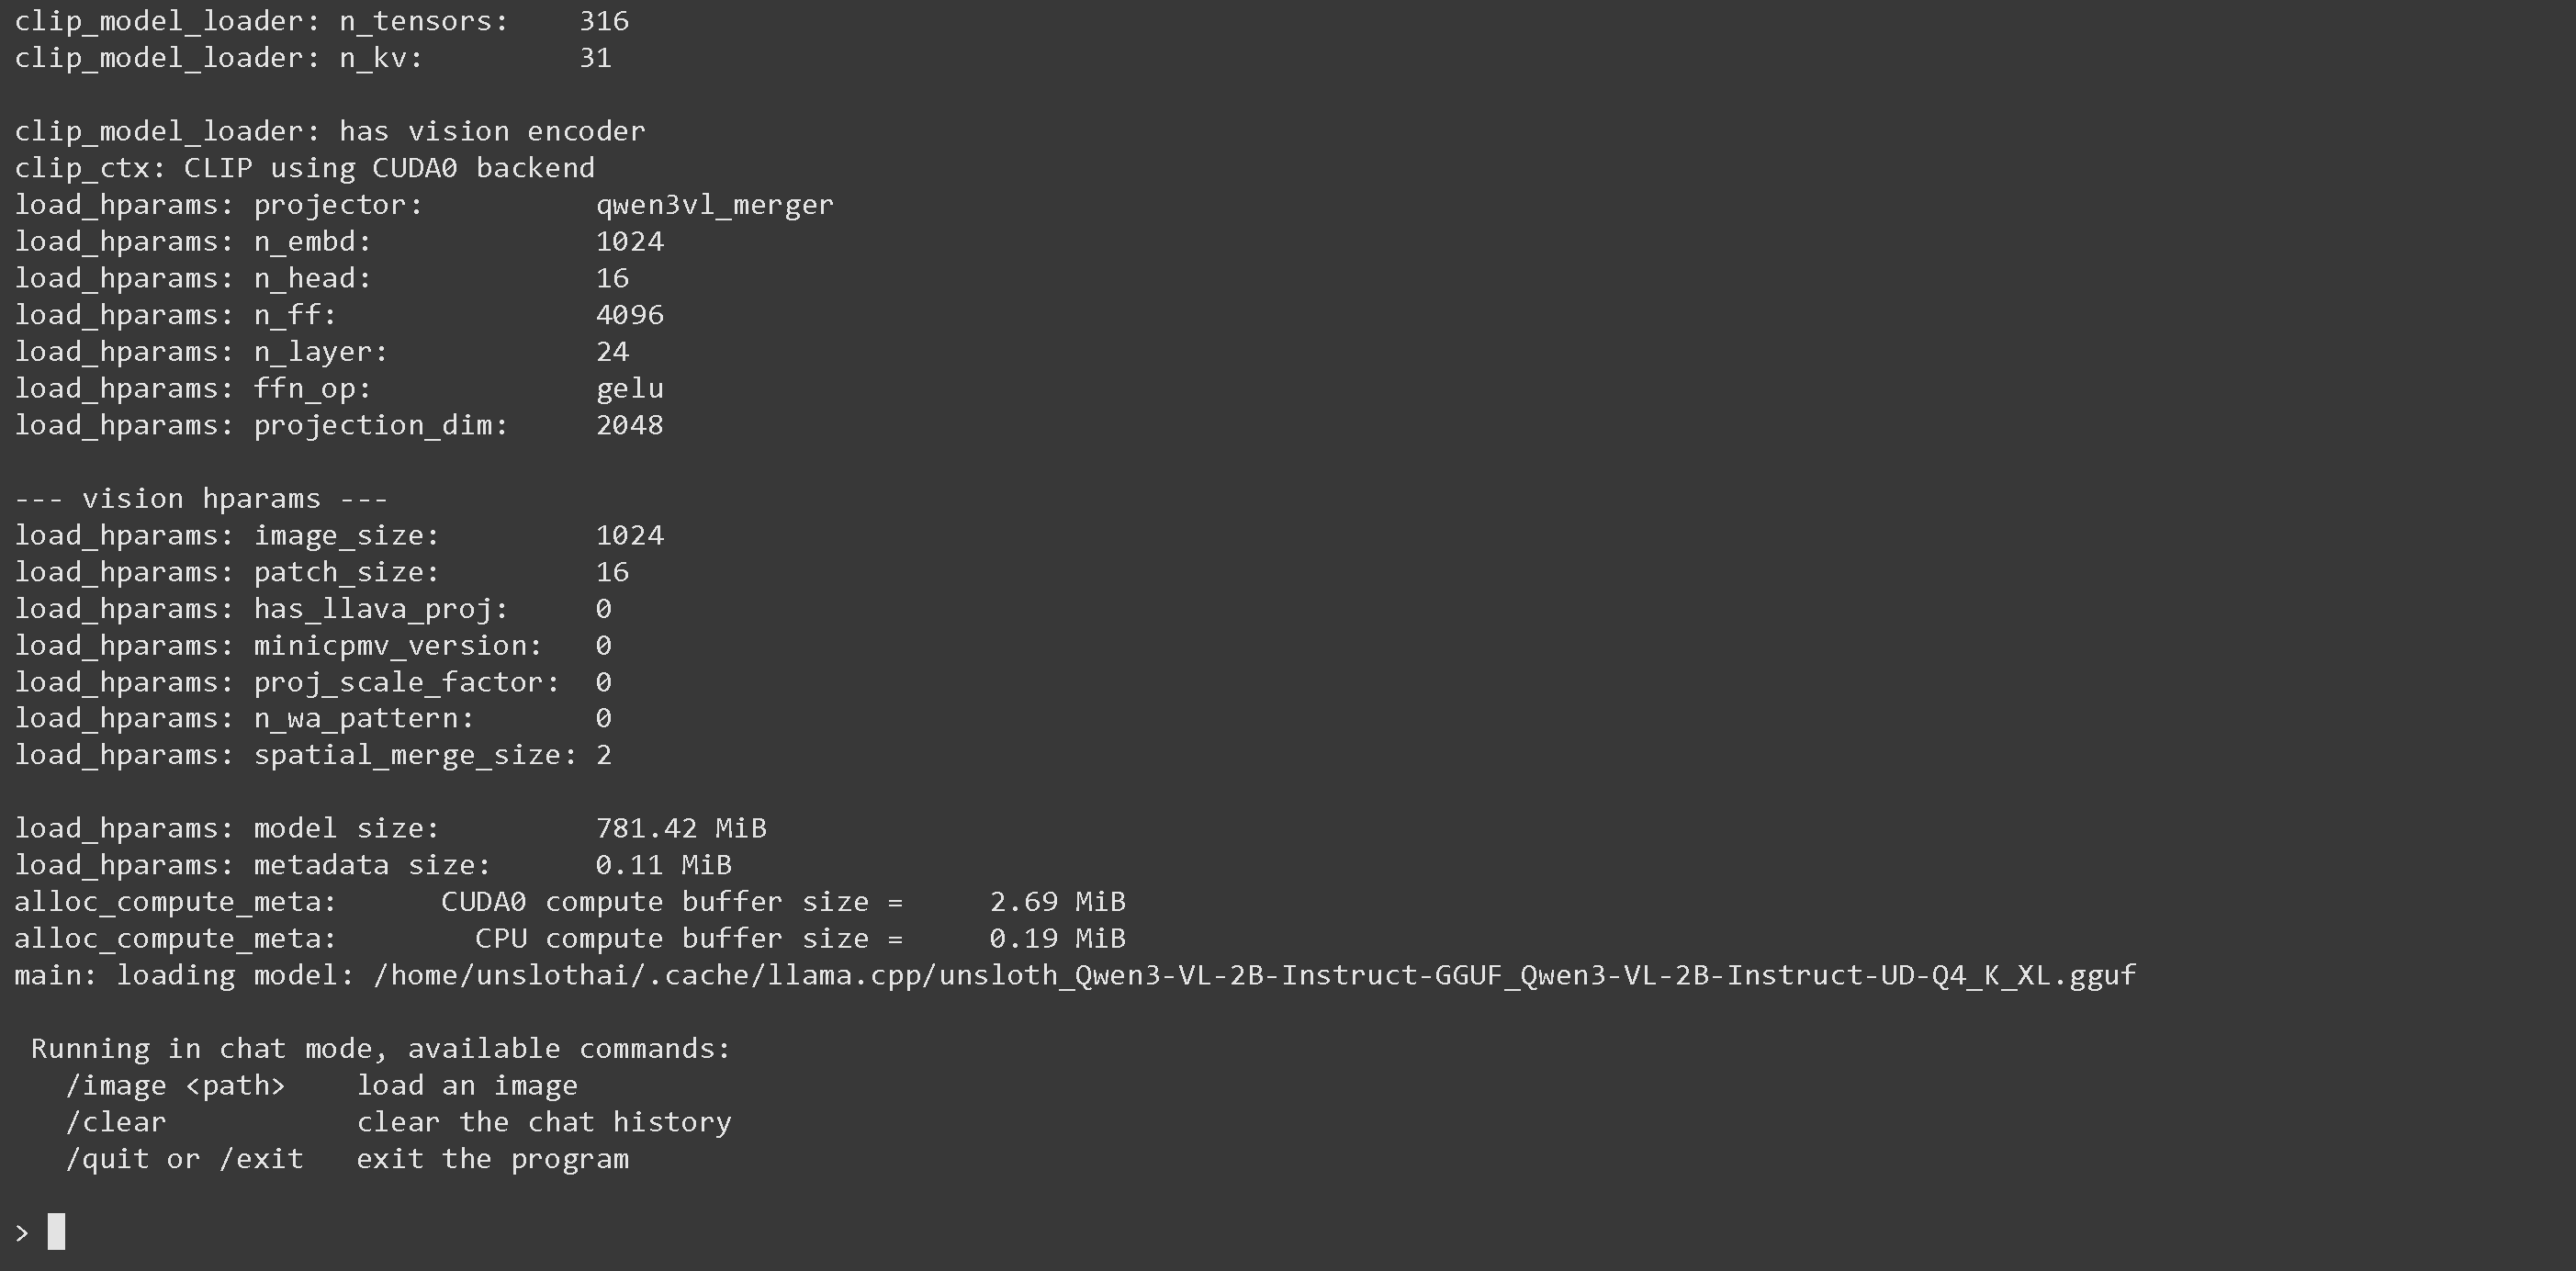
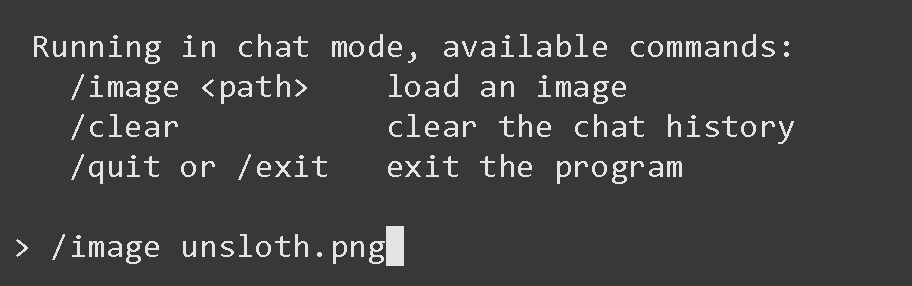
6. Une fois dedans, vous verrez l'écran ci-dessous :
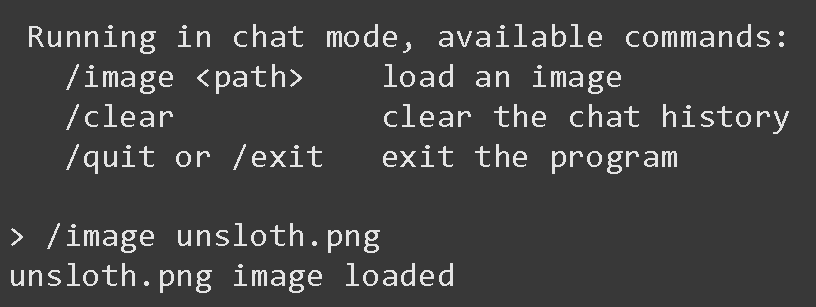
7. Chargez l'image via `/image PATH` c.-à-d. `/image unsloth.png` puis appuyez sur ENTRÉE
8. Lorsque vous appuyez sur ENTRÉE, il affichera « image unsloth.png chargée »
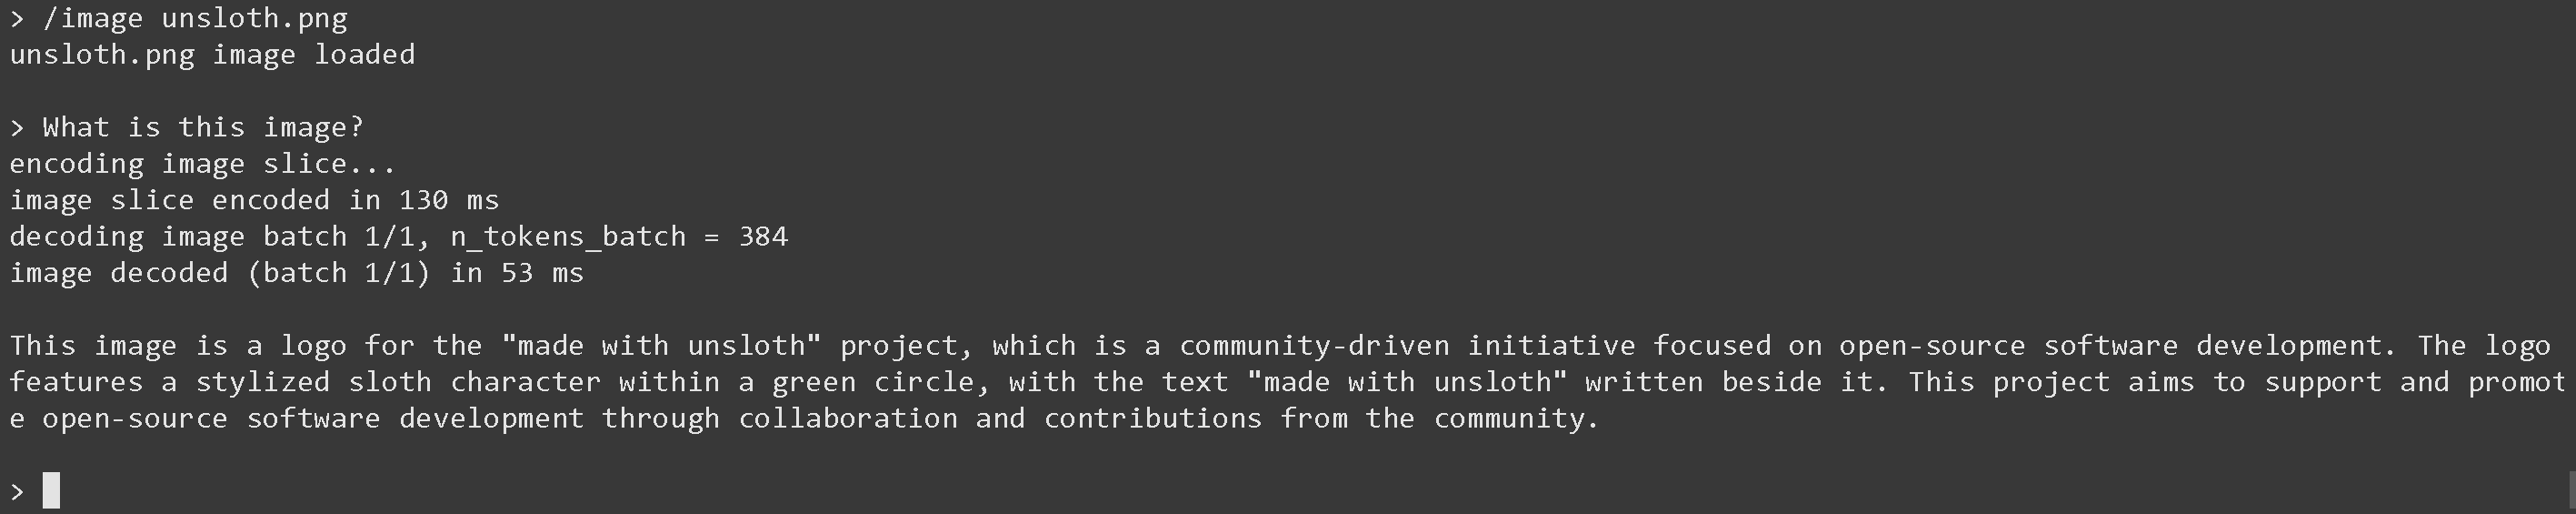
9. Maintenant, posons une question comme « Quelle est cette image ? » :
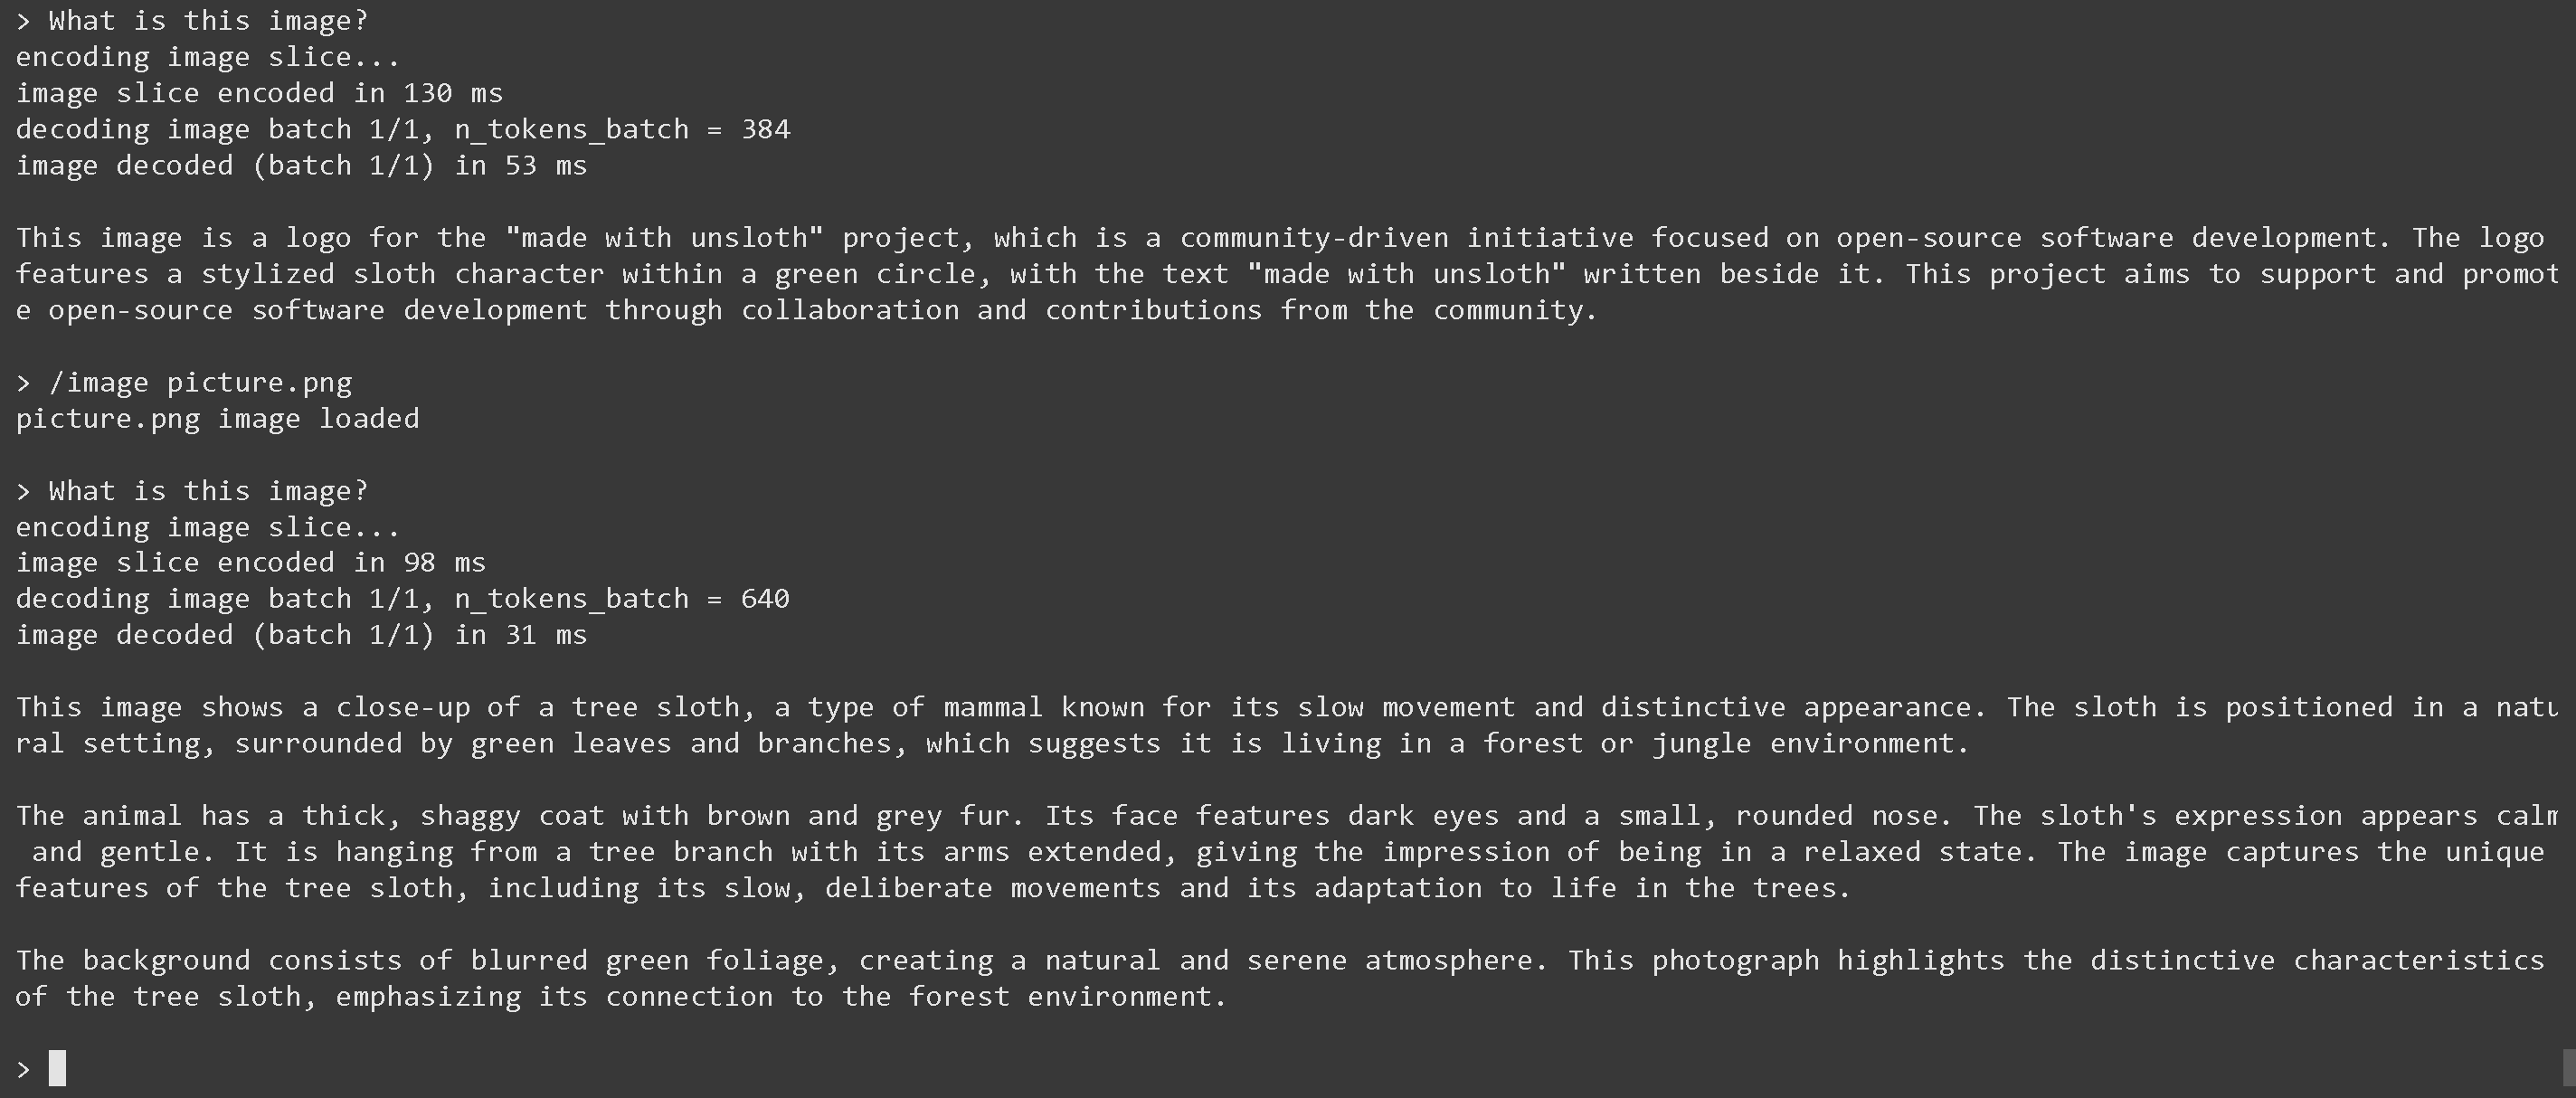
10. Chargez maintenant la deuxième image via `/image picture.png` puis appuyez sur ENTRÉE et demandez « Quelle est cette image ? »
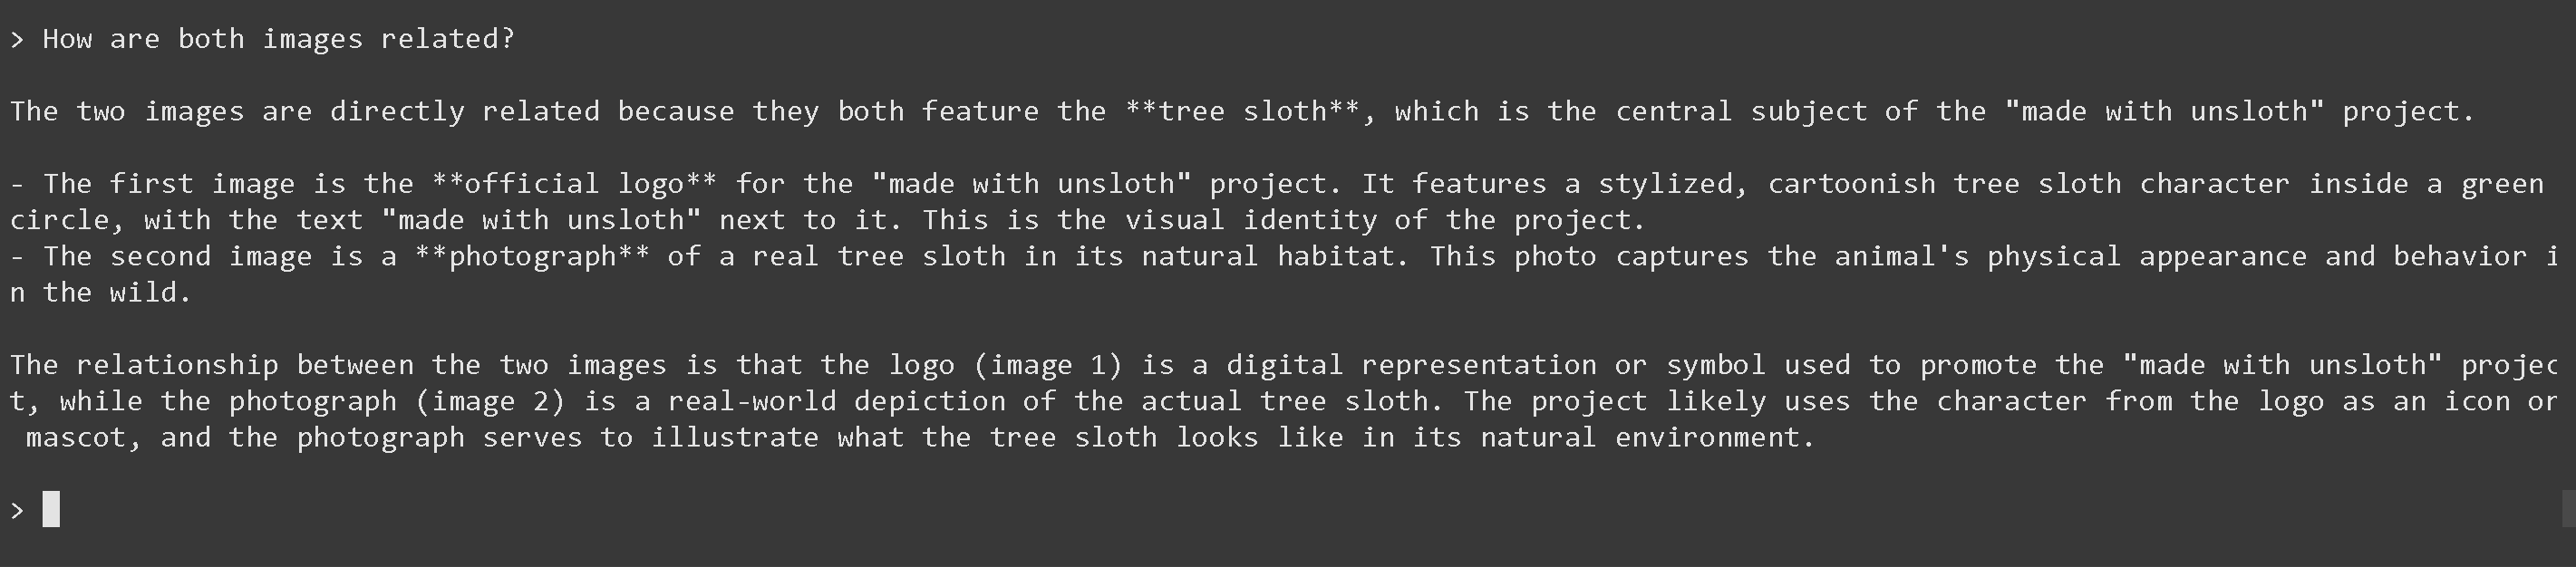
11. Et enfin, demandons comment les deux images sont liées (ça fonctionne !)
{% code overflow="wrap" %}
```
Les deux images sont directement liées car elles présentent toutes deux le **paresseux arboricole**, qui est le sujet central du projet « made with unsloth ».
- La première image est le **logo officiel** du projet « made with unsloth ». Elle représente un personnage stylisé et cartoon de paresseux arboricole à l'intérieur d'un cercle vert, avec le texte « made with unsloth » à côté. C'est l'identité visuelle du projet.
- La deuxième image est une **photographie** d'un vrai paresseux arboricole dans son habitat naturel. Cette photo capture l'apparence physique et le comportement de l'animal à l'état sauvage.
La relation entre les deux images est que le logo (image 1) est une représentation numérique ou un symbole utilisé pour promouvoir le projet « made with unsloth », tandis que la photographie (image 2) est une représentation réelle du paresseux arboricole. Le projet utilise probablement le personnage du logo comme icône ou mascotte, et la photographie sert à illustrer à quoi ressemble le paresseux arboricole dans son environnement naturel.
```
{% endcode %}
12. Vous pouvez également télécharger le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ) de HuggingFace `snapshot_download` qui est utile pour les téléchargements de grands modèles, **car le téléchargeur automatique de llama.cpp peut être lent.** Vous pouvez choisir Q4\_K\_M, ou d'autres versions quantifiées.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Qwen3-VL-8B-Instruct-GGUF", # Ou "unsloth/Qwen3-VL-8B-Thinking-GGUF"
local_dir = "unsloth/Qwen3-VL-8B-Instruct-GGUF", # Ou "unsloth/Qwen3-VL-8B-Thinking-GGUF"
allow_patterns = ["*UD-Q4_K_XL*", "*mmproj-F16*"],
)
```
13. Exécutez le modèle et essayez n'importe quel prompt. **Pour Instruct :**
```bash
./llama.cpp/llama-mtmd-cli \
--model unsloth/Qwen3-VL-8B-Instruct-GGUF/Qwen3-VL-8B-Instruct-UD-Q4_K_XL.gguf \\
--mmproj unsloth/Qwen3-VL-8B-Instruct-GGUF/mmproj-F16.gguf \\
--n-gpu-layers 99 \
--jinja \
--top-p 0.8 \\
--top-k 20 \\
--temp 0.7 \
--min-p 0.0 \\
--flash-attn on \
--presence-penalty 1.5 \\
--ctx-size 8192
```
14. **Pour Thinking**:
```bash
./llama.cpp/llama-mtmd-cli \
--model unsloth/Qwen3-VL-8B-Thinking-GGUF/Qwen3-VL-8B-Thinking-UD-Q4_K_XL.gguf \\
--mmproj unsloth/Qwen3-VL-8B-Thinking-GGUF/mmproj-F16.gguf \\
--n-gpu-layers 99 \
--jinja \
--top-p 0.95 \
--top-k 20 \\
--temp 1.0 \
--min-p 0.0 \\
--flash-attn on \
--presence-penalty 0.0 \\
--ctx-size 8192
```
### :magic\_wand:Exécution de Qwen3-VL-235B-A22B et Qwen3-VL-30B-A3B
Pour Qwen3-VL-235B-A22B, nous utiliserons llama.cpp pour une inférence optimisée et une multitude d'options.
1. Nous suivons des étapes similaires à celles ci-dessus, mais cette fois nous devrons également effectuer des étapes supplémentaires car le modèle est très volumineux.
2. Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir UD-Q2\_K\_XL, ou d'autres versions quantifiées..
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Qwen3-VL-235B-A22B-Instruct-GGUF",
local_dir = "unsloth/Qwen3-VL-235B-A22B-Instruct-GGUF",
allow_patterns = ["*UD-Q2_K_XL*", "*mmproj-F16*"],
)
```
3. Exécutez le modèle et essayez un prompt. Définissez les paramètres corrects pour Thinking vs. Instruct.
**Instruct :**
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-mtmd-cli \
--model unsloth/Qwen3-VL-235B-A22B-Instruct-GGUF/UD-Q2_K_XL/Qwen3-VL-235B-A22B-Instruct-UD-Q2_K_XL-00001-of-00002.gguf \\
--mmproj unsloth/Qwen3-VL-235B-A22B-Instruct-GGUF/mmproj-F16.gguf
--jinja \
--top-p 0.8 \\
--top-k 20 \\
--temp 0.7 \
--min-p 0.0 \\
--flash-attn on \
--presence-penalty 1.5 \\
--ctx-size 8192 \
```
{% endcode %}
**Raisonnement :**
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-mtmd-cli \
--model unsloth/Qwen3-VL-235B-A22B-Thinking-GGUF/UD-Q2_K_XL/Qwen3-VL-235B-A22B-Thinking-UD-Q2_K_XL-00001-of-00002.gguf \\
--mmproj unsloth/Qwen3-VL-235B-A22B-Thinking-GGUF/mmproj-F16.gguf \\
--n-gpu-layers 99 \
--jinja \
--top-p 0.95 \
--top-k 20 \\
--temp 1.0 \
--min-p 0.0 \\
--flash-attn on \
--presence-penalty 0.0 \\
--ctx-size 8192 \
-ot ".ffn_.*_exps.=CPU"
```
{% endcode %}
4. Modifier, `--ctx-size 16384` pour la longueur de contexte, `--n-gpu-layers 99` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.
{% hint style="success" %}
**Utilisez `--fit on` introduit le 15 décembre 2025 pour une utilisation maximale de votre GPU et CPU.**
En option, utilisez `-ot ".ffn_.*_exps.=CPU"` pour décharger toutes les couches MoE sur le CPU ! Cela vous permet en pratique de faire tenir toutes les couches non-MoE sur 1 GPU, améliorant ainsi les vitesses de génération. Vous pouvez personnaliser l'expression regex pour faire tenir davantage de couches si vous disposez de plus de capacité GPU.
{% endhint %}
### 🐋 Docker : exécuter Qwen3-VL
Si vous avez déjà Docker Desktop, pour exécuter les modèles d'Unsloth depuis Hugging Face, lancez la commande ci-dessous et c'est terminé :
```bash
docker model pull hf.co/unsloth/Qwen3-VL-8B-Instruct-GGUF:UD-Q4_K_XL
```
Ou vous pouvez exécuter les modèles Qwen3-VL publiés par Docker :
```bash
docker model run ai/qwen3-vl
```
## 🦥 **Ajustement fin de Qwen3-VL**
Unsloth prend en charge l'ajustement fin et l'apprentissage par renforcement (RL) de Qwen3-VL, y compris les plus grands modèles 32B et 235B. Cela inclut la prise en charge de l'ajustement fin pour la vidéo et la détection d'objets. Comme d'habitude, Unsloth permet aux modèles Qwen3-VL de s'entraîner 1,7x plus vite avec 60 % de VRAM en moins et des longueurs de contexte 8x plus longues, sans dégradation de la précision.\
\
Nous avons তৈরি? No translate. Need French: \
Nous avons créé deux cahiers d'entraînement Qwen3-VL (8B) que vous pouvez entraîner gratuitement sur Colab :
* [Cahier de fine-tuning SFT standard](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision.ipynb)
* [Cahier RL GRPO/GSPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb)
{% hint style="success" %}
**L'enregistrement de Qwen3-VL en GGUF fonctionne désormais, car llama.cpp vient tout juste de le prendre en charge !**
Si vous souhaitez utiliser un autre modèle Qwen3-VL, remplacez simplement le modèle 8B par le 2B, 32B, etc.
{% endhint %}
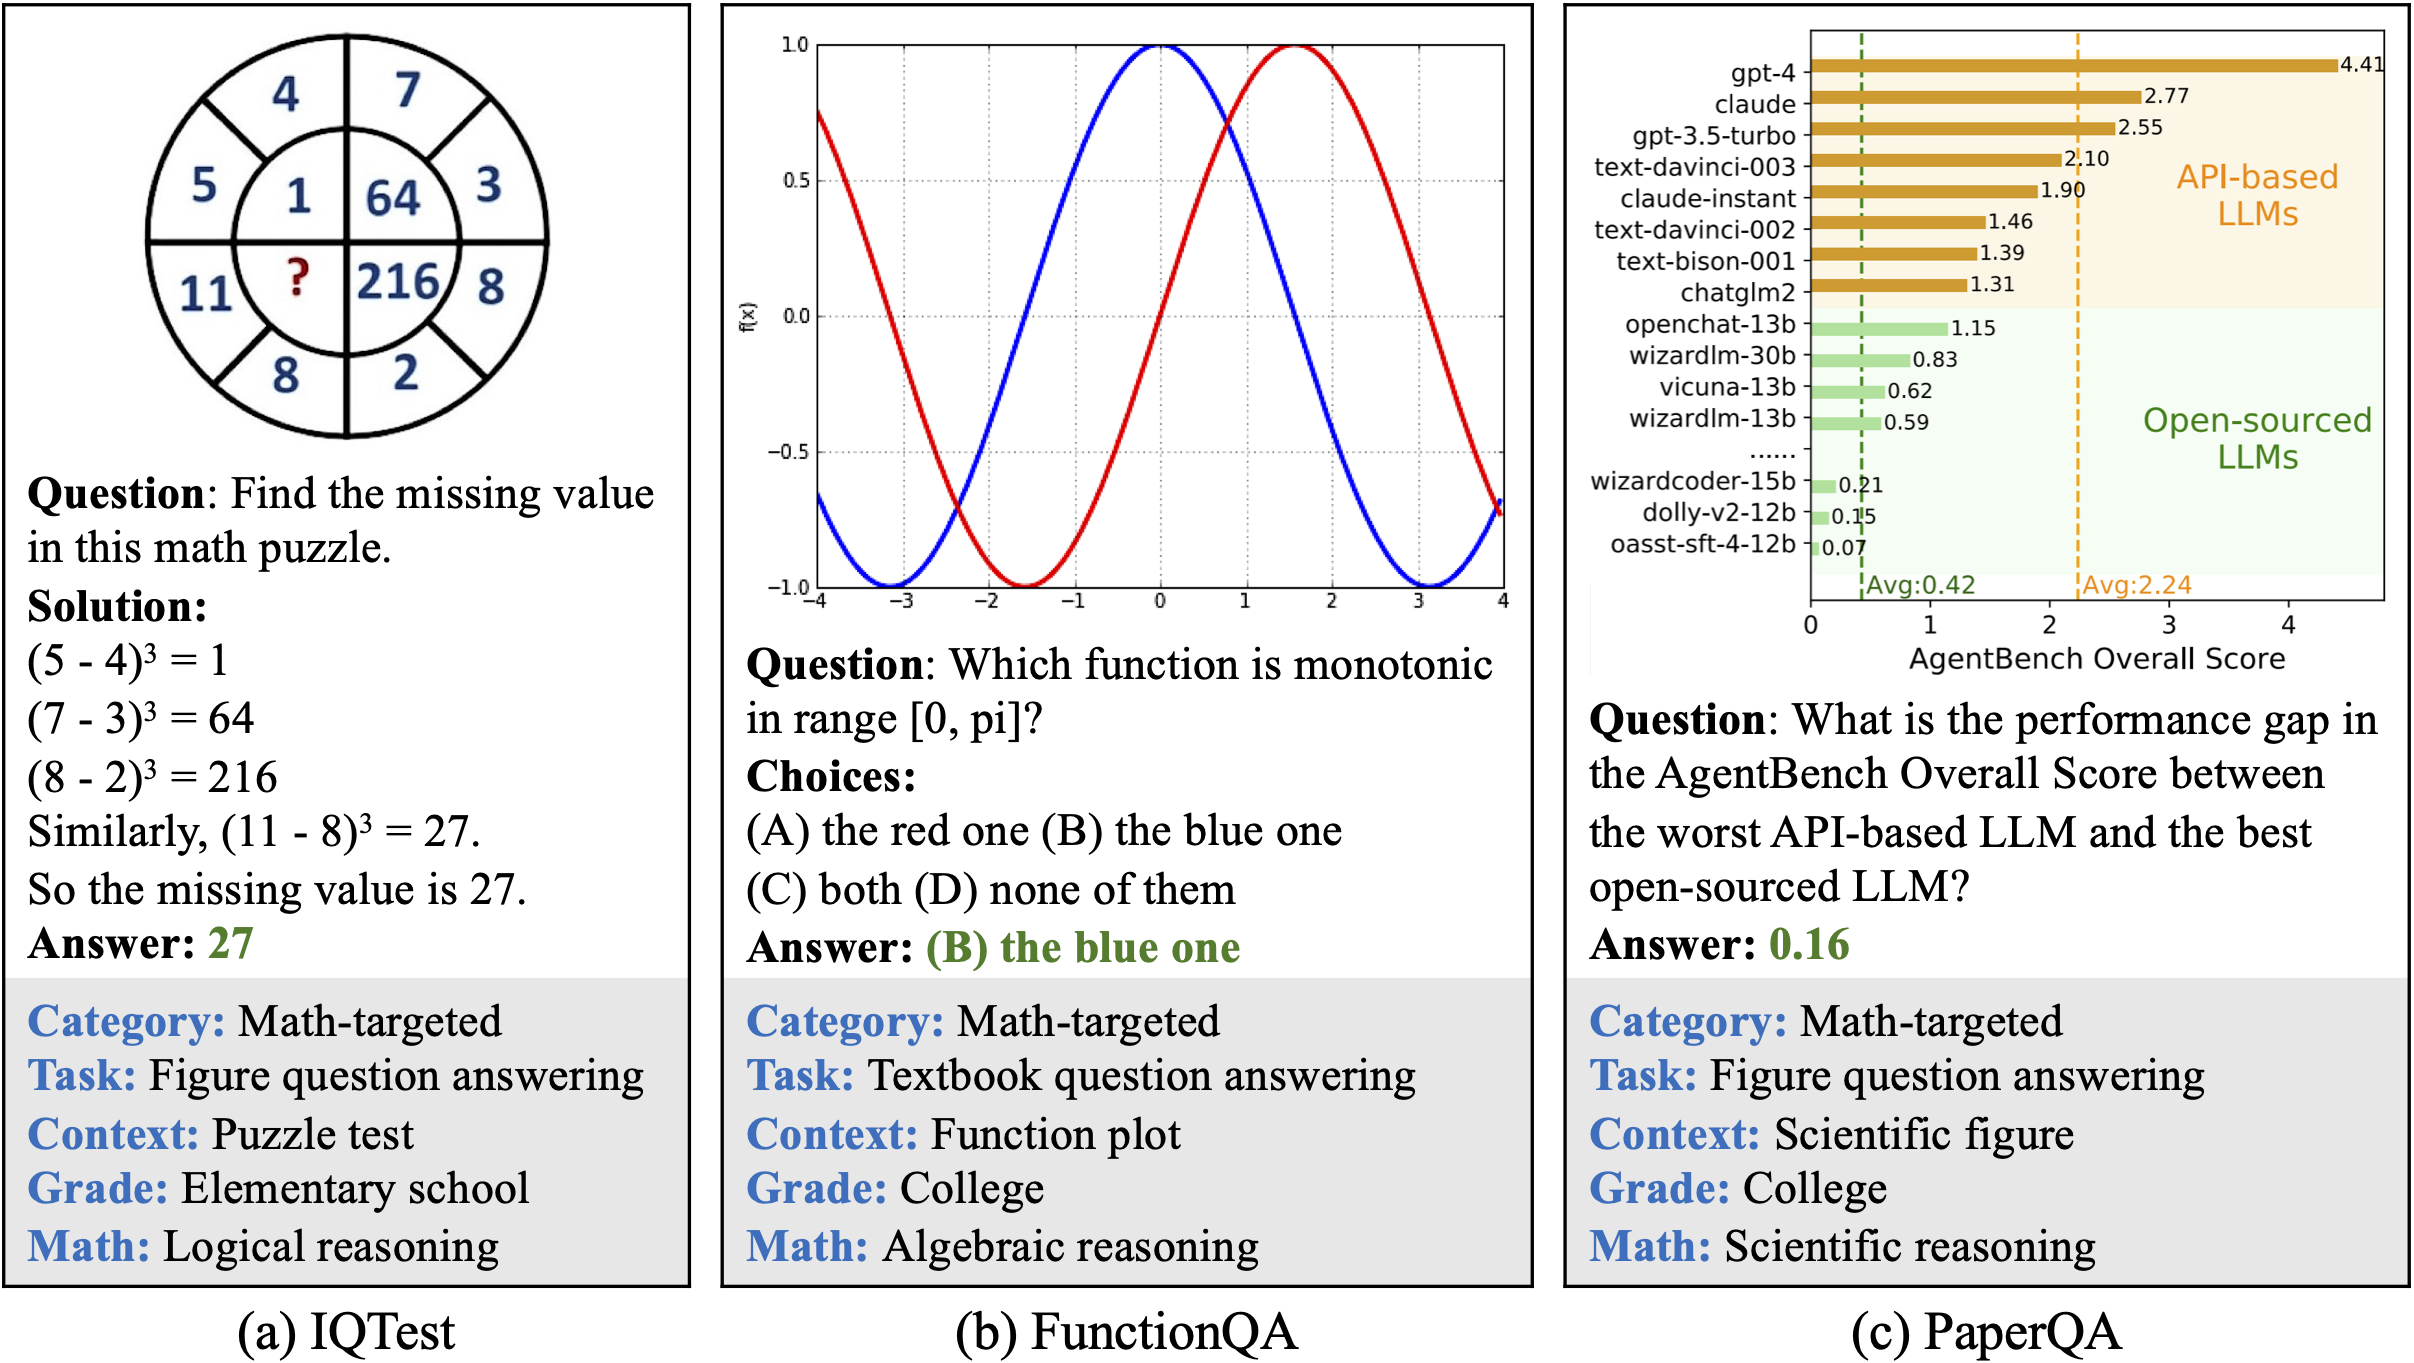
L'objectif du cahier GRPO est de faire en sorte qu'un modèle de langage visuel résolve des problèmes de maths via RL à partir d'une entrée image comme ci-dessous :
Cette prise en charge de Qwen3-VL intègre également notre dernière mise à jour pour un RL encore plus économe en mémoire et plus rapide, y compris notre [fonction Standby](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md#unsloth-standby), qui limite de manière unique la dégradation de vitesse par rapport aux autres implémentations. Vous pouvez en savoir plus sur la façon d'entraîner des LLM de vision avec RL grâce à notre [guide GRPO VLM](/docs/fr/commencer/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md).
### Entraînement multi-images
Afin d'ajuster finement ou d'entraîner Qwen3-VL avec plusieurs images, la modification la plus simple consiste à remplacer
```python
ds_converted = ds.map(
convert_to_conversation,
)
```
avec :
```python
ds_converted = [convert_to_converation(sample) for sample in dataset]
```
L'utilisation de map déclenche la standardisation du jeu de données et les règles de traitement d'Arrow, qui peuvent être strictes et plus compliquées à définir.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/qwen3-how-to-run-and-fine-tune/qwen3-vl-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.