> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/qwen3-how-to-run-and-fine-tune.md).
# Qwen3 - comment exécuter et fine-tuner
Apprenez à exécuter et fine-tuner Qwen3 localement avec Unsloth et nos quants dynamiques 2.0
Les nouveaux modèles Qwen3 de Qwen offrent des avancées de pointe en raisonnement, suivi d’instructions, capacités d’agent et prise en charge multilingue.
{% hint style="success" %}
**NOUVEAU !** Qwen3 a reçu une mise à jour en juillet 2025. Exécutez et affinez le dernier modèle : [**Qwen-2507**](/docs/fr/modeles/tutorials/qwen3-next.md)
{% endhint %}
Tous les téléversements utilisent Unsloth [Dynamic 2.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) pour des performances SOTA en MMLU 5-shot et en divergence KL, ce qui signifie que vous pouvez exécuter et affiner des LLM Qwen quantifiés avec une perte de précision minimale.
Nous avons également mis en ligne Qwen3 avec une longueur de contexte native de 128K. Qwen y parvient en utilisant YaRN pour étendre sa fenêtre originale de 40K à 128K.
[Unsloth](https://github.com/unslothai/unsloth) prend désormais également en charge le fine-tuning et [Apprentissage par renforcement (RL)](/docs/fr/commencer/reinforcement-learning-rl-guide.md) des modèles Qwen3 et Qwen3 MOE — 2x plus rapides, avec 70 % de VRAM en moins, et des longueurs de contexte 8x plus longues. Affinez Qwen3 (14B) gratuitement avec notre [carnet Colab.](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(14B\)-Reasoning-Conversational.ipynb)
Tutoriel d’exécution de Qwen3Affinage de Qwen3
#### **Qwen3 - Unsloth Dynamic 2.0** avec des configs optimales :
| Dynamic 2.0 GGUF (pour exécuter) | GGUF de contexte 128K | Safetensor dynamique 4 bits (pour affiner/déployer) |
| ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
|
|
## 🖥️ **Exécution de Qwen3**
Pour atteindre des vitesses d’inférence de plus de 6 tokens par seconde, nous recommandons que votre mémoire disponible soit égale ou supérieure à la taille du modèle que vous utilisez. Par exemple, un modèle quantifié en 1 bit de 30 Go nécessite au moins 150 Go de mémoire. La quantification Q2\_K\_XL, qui fait 180 Go, nécessitera au moins **180 Go de mémoire unifiée** (VRAM + RAM) ou **180 Go de RAM** pour des performances optimales.
**REMARQUE :** Il est possible d’exécuter le modèle avec **moins de mémoire totale** que sa taille (c.-à-d. moins de VRAM, moins de RAM ou un total combiné plus faible). Cependant, cela entraînera des vitesses d’inférence plus lentes. Une mémoire suffisante n’est nécessaire que si vous souhaitez maximiser le débit et obtenir les temps d’inférence les plus rapides.
### :gear: Paramètres officiels recommandés
Selon Qwen, voici les paramètres recommandés pour l’inférence :
| Paramètres du mode sans réflexion : | Paramètres du mode réflexion : |
| ---------------------------------------------------------------------------------------------- | ----------------------------------------------------------------- |
| **Temperature = 0.7** | **Temperature = 0.6** |
| Min\_P = 0.0 (optionnel, mais 0.01 fonctionne bien, la valeur par défaut de llama.cpp est 0.1) | Min\_P = 0.0 |
| Top\_P = 0.8 | Top\_P = 0.95 |
| TopK = 20 | TopK = 20 |
**Format du modèle de chat / du prompt :**
{% code overflow="wrap" %}
```
<|im_start|>user\nQuelle est la somme de 2+2 ?<|im_end|>\n<|im_start|>assistant\n
```
{% endcode %}
{% hint style="success" %}
Pour le mode SANS réflexion, nous encadrons volontairement \ et \ sans rien :
{% endhint %}
{% code overflow="wrap" %}
```
<|im_start|>user\nQuelle est la somme de 2+2 ?<|im_end|>\n<|im_start|>assistant\n\n\n\n\n
```
{% endcode %}
{% hint style="warning" %}
**Pour le mode réflexion, N’UTILISEZ PAS le décodage gourmand**, car cela peut entraîner une dégradation des performances et des répétitions infinies.
{% endhint %}
### Passer du mode réflexion au mode sans réflexion
Les modèles Qwen3 intègrent un « mode réflexion » pour améliorer le raisonnement et la qualité des réponses — similaire à ce que [QwQ-32B](/docs/fr/modeles/tutorials/qwq-32b-how-to-run-effectively.md) fonctionnait. Les instructions de bascule varieront selon le moteur d’inférence que vous utilisez, assurez-vous donc d’utiliser les bonnes instructions.
#### Instructions pour llama.cpp et Ollama :
Vous pouvez ajouter `/think` et `/no_think` aux prompts utilisateur ou aux messages système pour faire passer le mode de réflexion du modèle d’un tour à l’autre. Le modèle suivra l’instruction la plus récente dans les conversations multi-tours.
Voici un exemple de conversation multi-tours :
```
> Qui êtes-vous /no_think
Je suis Qwen, un modèle de langage à grande échelle développé par Alibaba Cloud. [...]
> Combien de 'r' y a-t-il dans 'strawberries' ? /think
D’accord, voyons voir. L’utilisateur demande combien de fois la lettre 'r' apparaît dans le mot "strawberries". [...]
Le mot strawberries contient 3 occurrences de la lettre r. [...]
```
#### Instructions pour transformers et vLLM :
**Mode réflexion :**
`enable_thinking=True`
Par défaut, Qwen3 a la réflexion activée. Lorsque vous appelez `tokenizer.apply_chat_template`, vous **n’avez rien à définir manuellement.**
```python
text = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
enable_thinking=True # La valeur par défaut est True
)
```
En mode réflexion, le modèle générera un bloc supplémentaire `...` avant la réponse finale — cela lui permet de « planifier » et d’affiner ses réponses.
**Mode sans réflexion :**
`enable_thinking=False`
Activer le mode sans réflexion fera en sorte que Qwen3 ignore toutes les étapes de réflexion et se comporte comme un LLM normal.
```python
text = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
enable_thinking=False # Désactive le mode réflexion
)
```
Ce mode fournira directement les réponses finales — pas de `` blocs, pas de chaîne de pensée.
### 🦙 Tutoriel d’exécution de Qwen3 avec Ollama
1. Installez `ollama` si ce n’est pas déjà fait ! Vous ne pouvez exécuter que des modèles jusqu’à 32B de taille. Pour exécuter le modèle complet 235B-A22B, [voir ici](#running-qwen3-235b-a22b).
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
2. Exécutez le modèle ! Notez que vous pouvez appeler `ollama serve`dans un autre terminal si cela échoue ! Nous incluons toutes nos corrections et paramètres suggérés (température, etc.) dans `params` dans notre téléversement Hugging Face !
```bash
ollama run hf.co/unsloth/Qwen3-8B-GGUF:UD-Q4_K_XL
```
3. Pour désactiver la réflexion, utilisez (ou vous pouvez le définir dans le prompt système) :
```
>>> Écrivez votre prompt ici /nothink
```
{% hint style="warning" %}
Si vous constatez une boucle infinie, Ollama a peut-être réglé votre fenêtre de longueur de contexte à environ 2 048. Si c’est le cas, augmentez-la à 32 000 et voyez si le problème persiste.
{% endhint %}
### 📖 Tutoriel d’exécution de Qwen3 avec Llama.cpp
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir Q4\_K\_M, ou d’autres versions quantifiées.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Qwen3-14B-GGUF",
local_dir = "unsloth/Qwen3-14B-GGUF",
allow_patterns = ["*UD-Q4_K_XL*"],
)
```
3. Exécutez le modèle et essayez n'importe quel prompt.
```bash
./llama.cpp/llama-cli \
--model unsloth/Qwen3-14B-GGUF/Qwen3-14B-UD-Q2_K_XL.gguf \
--ctx-size 16384 \
--n-gpu-layers 99 \
-ot ".ffn_.*_exps.=CPU" \\
--seed 3407 \
--prio 3 \
--temp 0.6 \
--min-p 0.0 \\
--top-p 0.95 \
--top-k 20 \\
-no-cnv
```
Pour désactiver la réflexion, utilisez (ou vous pouvez le définir dans le prompt système) :
```
>>> Écrivez votre prompt ici /nothink
```
### Exécution de Qwen3-235B-A22B
Pour Qwen3-235B-A22B, nous utiliserons spécifiquement Llama.cpp pour une inférence optimisée et une multitude d’options.
1. Nous suivons des étapes similaires à celles ci-dessus, mais cette fois nous devrons également effectuer des étapes supplémentaires car le modèle est très volumineux.
2. Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir UD-Q2\_K\_XL, ou d'autres versions quantifiées..
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Qwen3-235B-A22B-GGUF",
local_dir = "unsloth/Qwen3-235B-A22B-GGUF",
allow_patterns = ["*UD-Q2_K_XL*"],
)
```
3. Exécutez le modèle et essayez n'importe quel prompt.
4. Modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 16384` pour la longueur de contexte, `--n-gpu-layers 99` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.
{% hint style="success" %}
Utilisez `-ot ".ffn_.*_exps.=CPU"` pour décharger toutes les couches MoE sur le CPU ! Cela vous permet en pratique de faire tenir toutes les couches non-MoE sur 1 GPU, améliorant ainsi les vitesses de génération. Vous pouvez personnaliser l'expression regex pour faire tenir davantage de couches si vous disposez de plus de capacité GPU.
{% endhint %}
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/Qwen3-235B-A22B-GGUF/Qwen3-235B-A22B-UD-Q2_K_XL.gguf \
--ctx-size 16384 \
--n-gpu-layers 99 \
-ot ".ffn_.*_exps.=CPU" \\
--seed 3407 \
--prio 3 \
--temp 0.6 \
--min-p 0.0 \\
--top-p 0.95 \
--top-k 20 \\
-no-cnv \
--prompt "<|im_start|>user\nCrée un jeu Flappy Bird en Python. Vous devez inclure les éléments suivants :\n1. Vous devez utiliser pygame.\n2. La couleur de fond doit être choisie aléatoirement et être une teinte claire. Commencez avec une couleur bleu clair.\n3. Appuyer plusieurs fois sur ESPACE accélérera l’oiseau.\n4. La forme de l’oiseau doit être choisie aléatoirement : carré, cercle ou triangle. La couleur doit être choisie aléatoirement dans une couleur sombre.\n5. Placez en bas un sol coloré en marron foncé ou en jaune, choisi aléatoirement.\n6. Affichez un score en haut à droite. Incrémentez-le si vous passez les tuyaux sans les heurter.\n7. Créez des tuyaux espacés aléatoirement avec suffisamment d’espace. Coloriez-les aléatoirement en vert foncé, marron clair ou gris foncé.\n8. Lorsque vous perdez, affichez le meilleur score. Mettez le texte à l’intérieur de l’écran. Appuyer sur q ou Échap quittera le jeu. Redémarrer en appuyant à nouveau sur ESPACE.\nLe jeu final doit se trouver dans une section Markdown en Python. Vérifiez votre code pour détecter les erreurs et corrigez-les avant la section Markdown finale.<|im_end|>\n<|im_start|>assistant\n"
```
{% endcode %}
## 🦥 Affinage de Qwen3 avec Unsloth
Unsloth rend l’affinage de Qwen3 2x plus rapide, utilise 70 % de VRAM en moins et prend en charge des longueurs de contexte 8x plus longues. Qwen3 (14B) tient confortablement dans un GPU Tesla T4 de 16 Go de VRAM sur Google Colab.
Parce que Qwen3 prend en charge à la fois le raisonnement et le non-raisonnement, vous pouvez l’affiner avec un jeu de données sans raisonnement, mais cela peut affecter sa capacité de raisonnement. Si vous souhaitez conserver ses capacités de raisonnement (facultatif), vous pouvez utiliser un mélange de réponses directes et d’exemples de chaîne de pensée. Utilisez 75 % de raisonnement et 25 % sans raisonnement dans votre jeu de données pour que le modèle conserve ses capacités de raisonnement.
Notre carnet conversationnel utilise un mélange de 75 % du jeu de données open-math-reasoning de NVIDIA et de 25 % du jeu de données FineTome de Maxime (sans raisonnement). Voici des carnets Colab Unsloth gratuits pour affiner Qwen3 :
* [Notebook conversationnel + raisonnement Qwen3 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(14B\)-Reasoning-Conversational.ipynb) (recommandé)
* [**Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) **- LoRA GRPO avancé**
* [Carnet Alpaca Qwen3 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(14B\)-Alpaca.ipynb) (pour les modèles de base)
Si vous avez une ancienne version d’Unsloth et/ou effectuez un affinage localement, installez la dernière version d’Unsloth :
```
pip install --upgrade --force-reinstall --no-cache-dir unsloth unsloth_zoo
```
### Affinage des modèles Qwen3 MOE
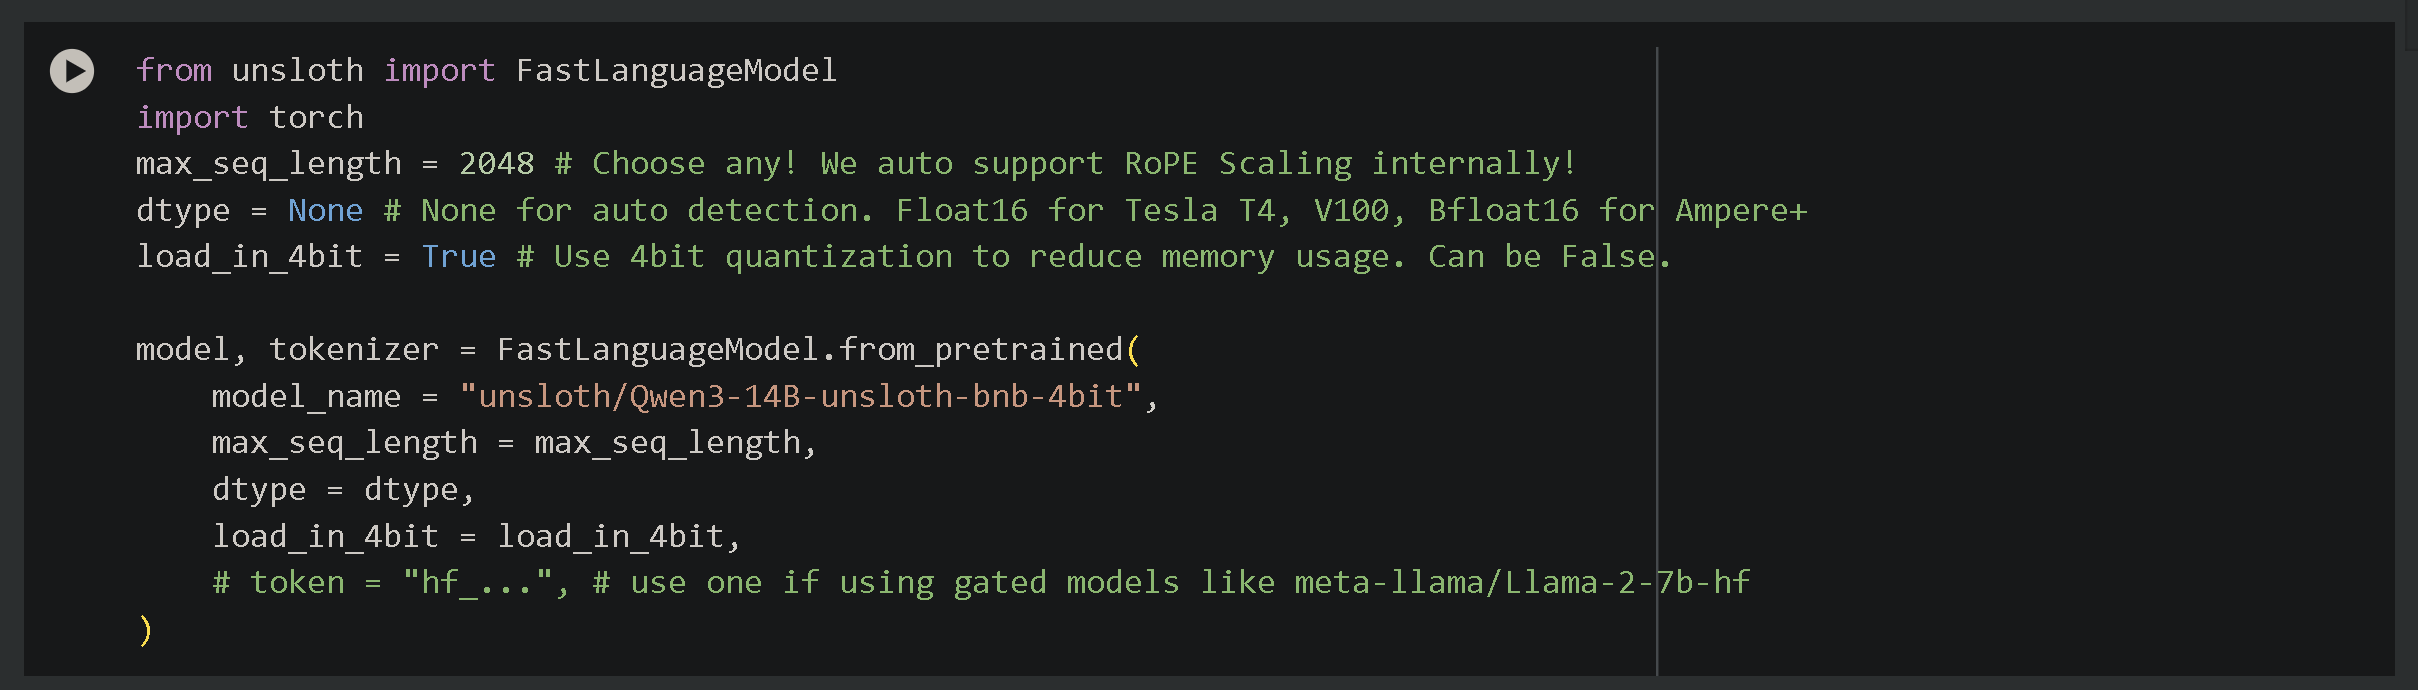
La prise en charge de l’affinage inclut notre nouveau [MOE plus rapide ](/docs/fr/notions-de-base/faster-moe.md)mise à jour de 2026 : 30B-A3B et 235B-A22B. Qwen3-30B-A3B fonctionne avec seulement 17,5 Go de VRAM avec Unsloth. Lors de l’affinage des MoE, il n’est probablement pas judicieux d’affiner la couche routeur, nous l’avons donc désactivée par défaut.
Le 30B-A3B tient dans 17,5 Go de VRAM, mais vous pourriez manquer de RAM ou d’espace disque, car le modèle complet en 16 bits doit être téléchargé puis converti en 4 bits à la volée pour l’affinage QLoRA. Cela est dû à des problèmes d’importation directe des modèles MOE BnB 4 bits. Cela n’affecte que les modèles MOE.
```python
from unsloth import FastModel
import torch
model, tokenizer = FastModel.from_pretrained(
model_name = "unsloth/Qwen3-30B-A3B",
max_seq_length = 2048, # Choisissez n’importe quelle valeur pour un long contexte !
load_in_4bit = True, # Quantification 4 bits pour réduire la mémoire
load_in_8bit = False, # [NOUVEAU !] Un peu plus précis, utilise 2x plus de mémoire
full_finetuning = False, # [NOUVEAU !] Nous avons maintenant l'ajustement fin complet !
# token = "hf_...", # utilisez-en un si vous utilisez des modèles protégés
)
```
### Guide du carnet :
Pour utiliser les carnets, cliquez simplement sur Runtime, puis sur Run all. Vous pouvez modifier les paramètres du carnet selon vos envies. Nous les avons définis automatiquement par défaut. Changez le nom du modèle comme vous le souhaitez en le faisant correspondre au nom du modèle sur Hugging Face, par exemple « unsloth/Qwen3-8B » ou « unsloth/Qwen3-0.6B-unsloth-bnb-4bit ».
Il existe d’autres paramètres que vous pouvez activer ou désactiver :
* **`max_seq_length = 2048`** – Contrôle la longueur du contexte. Bien que Qwen3 prenne en charge 40960, nous recommandons 2048 pour les tests. Unsloth permet un affinage avec un contexte 8× plus long.
* **`load_in_4bit = True`** – Active la quantification 4 bits, réduisant l’utilisation de mémoire de 4× pour l’affinage sur des GPU 16 Go.
* Pour **affinage complet** - définir `full_finetuning = True` et **affinage en 8 bits** - définir `load_in_8bit = True`
Si vous souhaitez lire un guide complet de bout en bout sur la manière d’utiliser les carnets Unsloth pour l’affinage ou simplement en apprendre davantage sur l’affinage, la création [bibliothèque](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md) etc., consultez notre [guide complet ici](/docs/fr/commencer/fine-tuning-llms-guide.md):
{% content-ref url="/pages/9bbe6f156adffaddead7109d8475ab4a8547be46" %}
[Fine-tuning Guide](/docs/fr/commencer/fine-tuning-llms-guide.md)
{% endcontent-ref %}
{% content-ref url="/pages/106dfb3c53d8e4d182108e27a2e91ce2b4f38210" %}
[Guide des jeux de données](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md)
{% endcontent-ref %}
### GRPO avec Qwen3
Nous avons créé un nouveau carnet GRPO avancé pour affiner Qwen3. Apprenez à utiliser notre nouvelle fonction de récompense basée sur la proximité (réponses plus proches = récompensées) et le jeu de données mathématique Open-R1 de Hugging Face.\
Unsloth dispose désormais aussi de meilleures évaluations et utilise la version la plus récente de vLLM.
[**Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) **carnet - GRPO LoRA avancé**
En savoir plus sur :
* Activer le raisonnement dans Qwen3 (Base) + le guider pour effectuer une tâche spécifique
* Pré-affinage pour contourner la tendance du GRPO à apprendre le formatage
* Précision d’évaluation améliorée grâce à une nouvelle correspondance par expression régulière
* Modèles GRPO personnalisés au-delà de simple « think », par ex. \\
* Scorage basé sur la proximité : les meilleures réponses gagnent plus de points (par ex., prédire 9 lorsque la réponse est 10) et les valeurs aberrantes sont pénalisées
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/qwen3-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.