> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/minimax-m25.md).

# MiniMax-M2.5 : guide d'exécution

Exécutez MiniMax-M2.5 localement sur votre propre appareil !

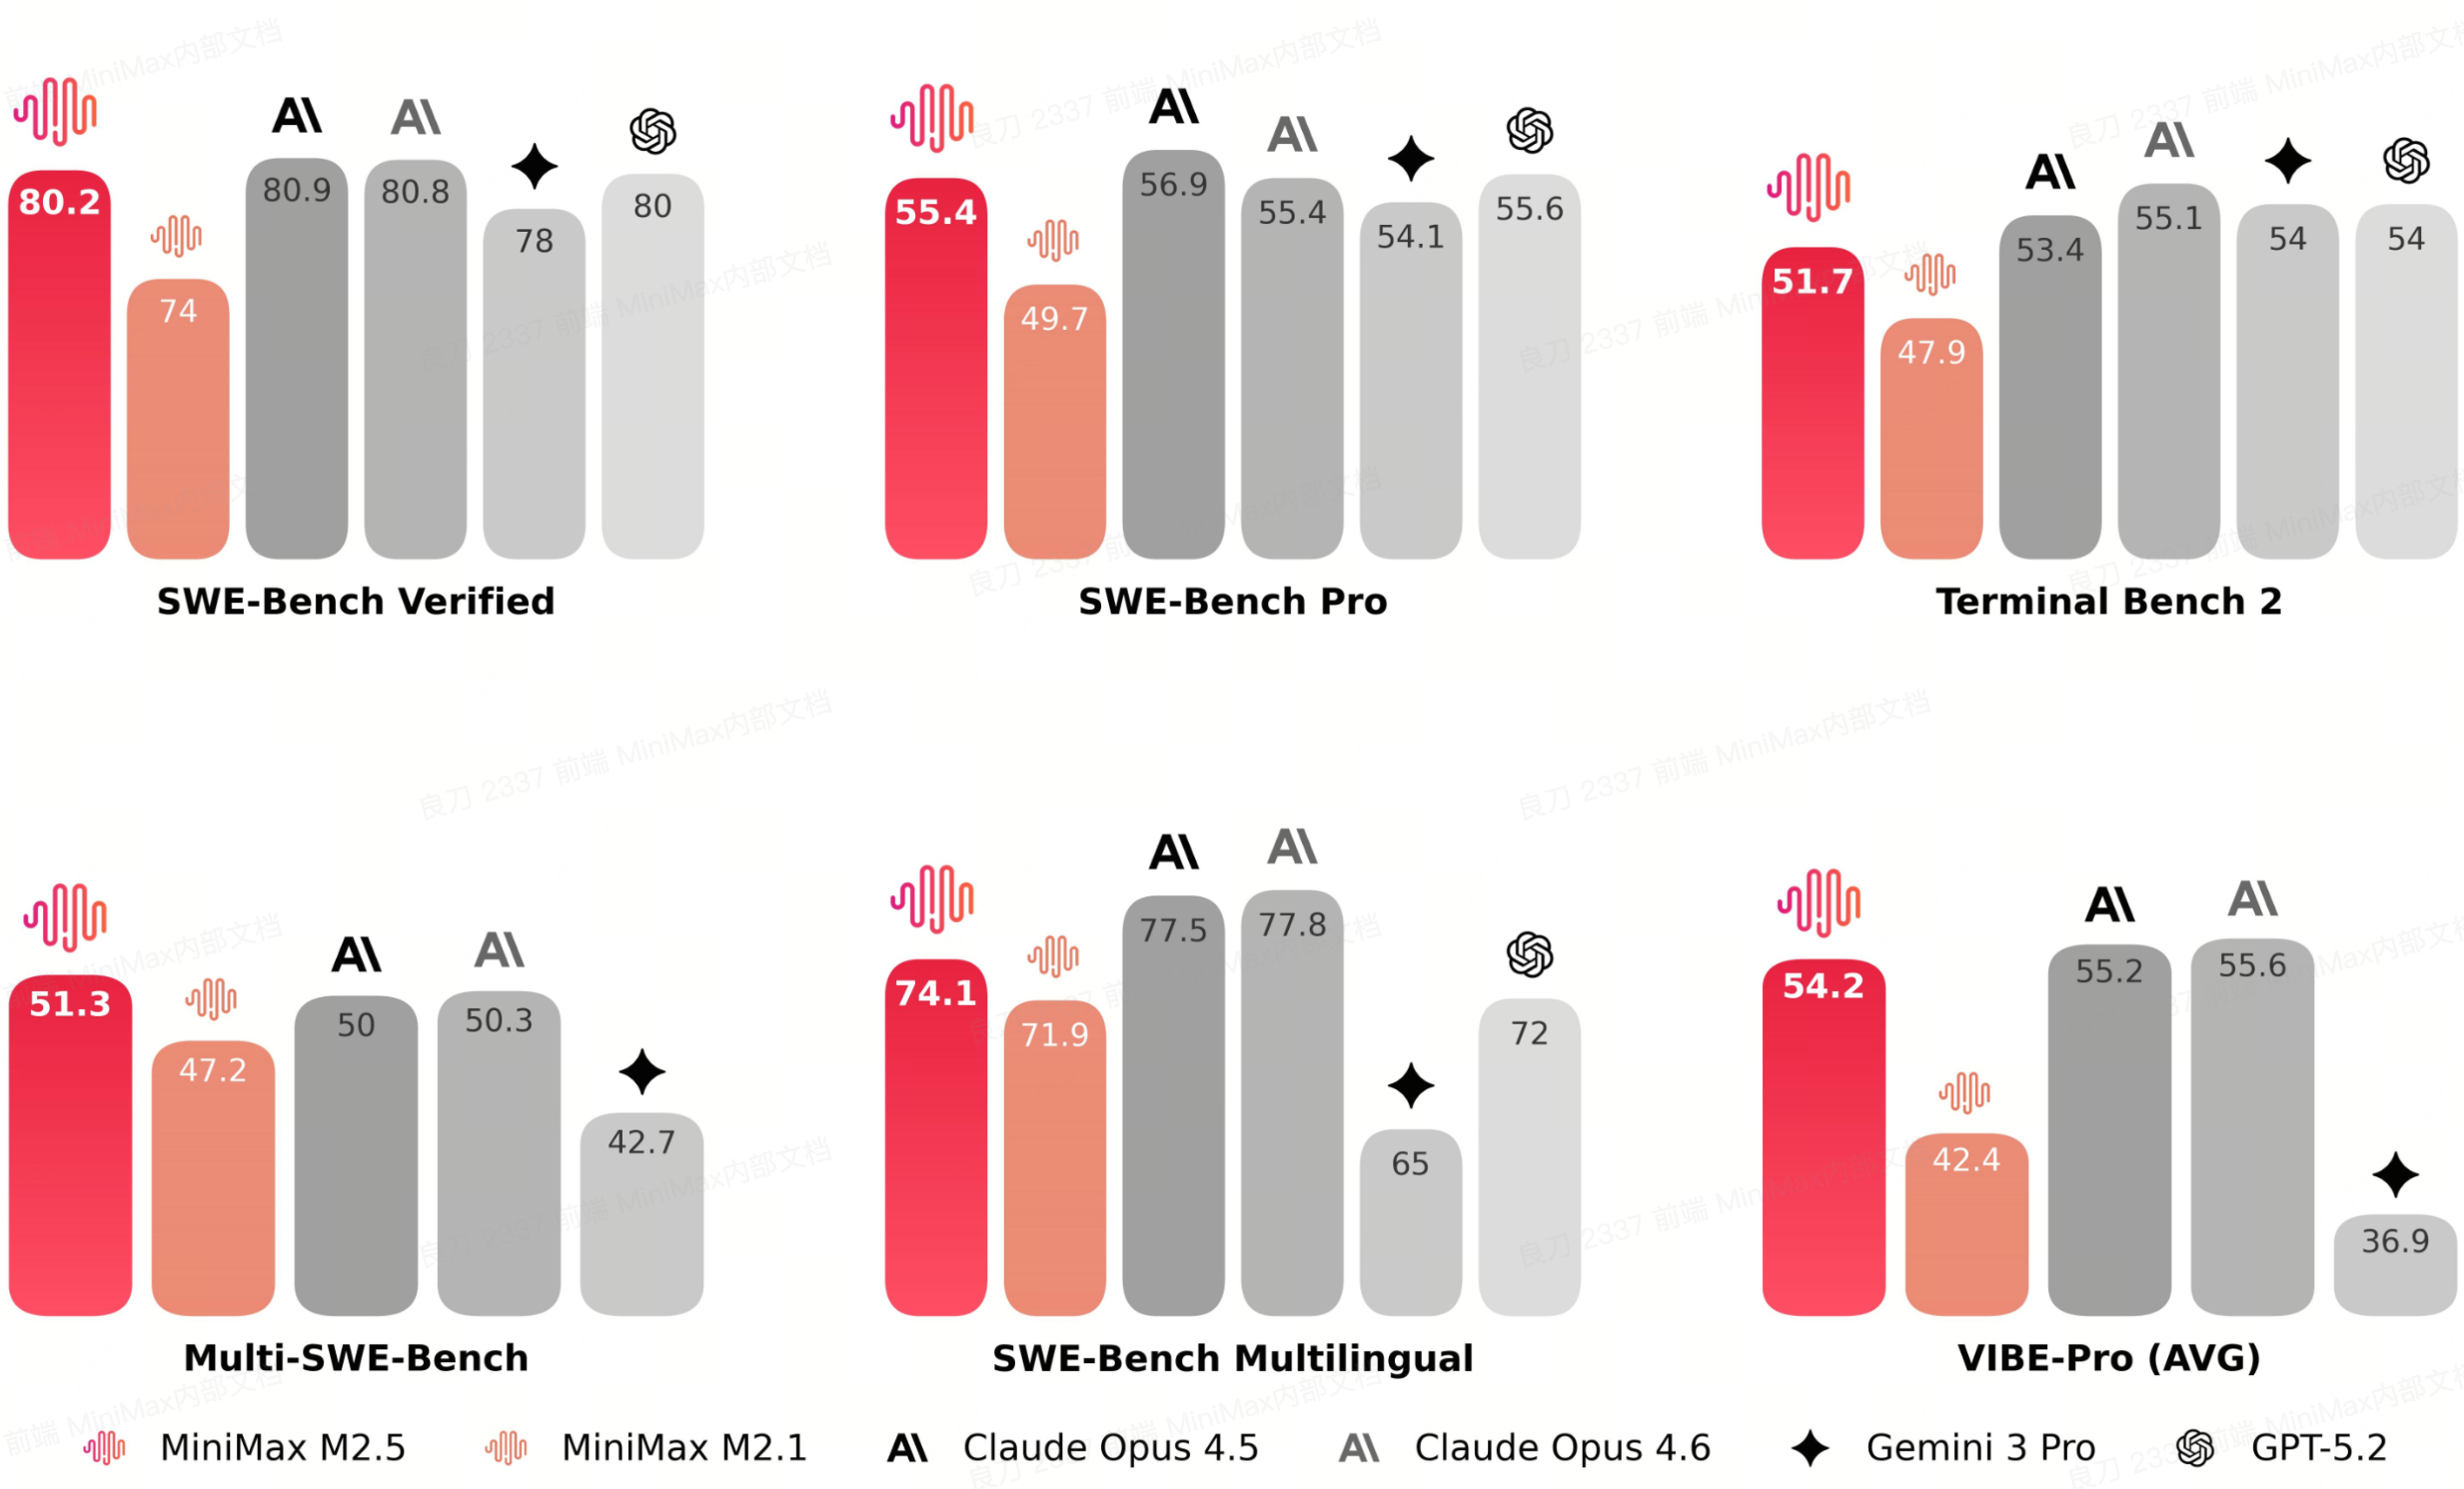
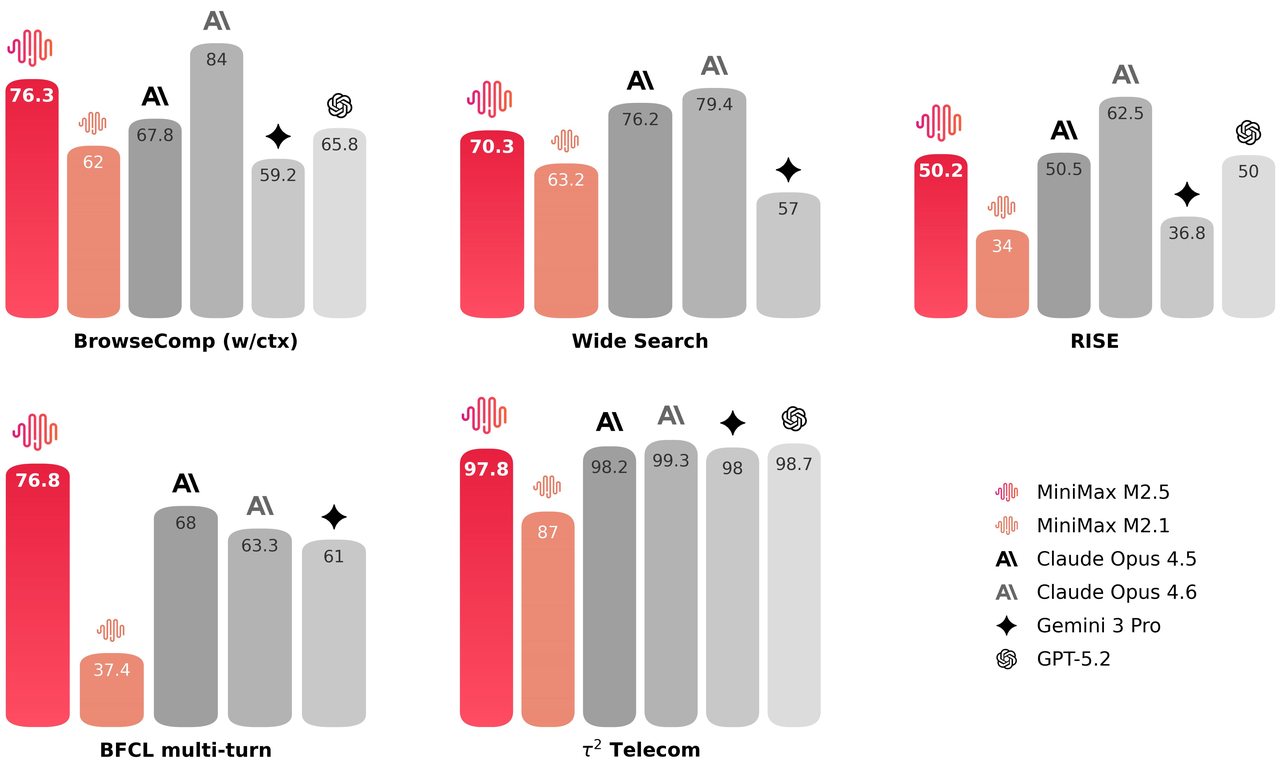
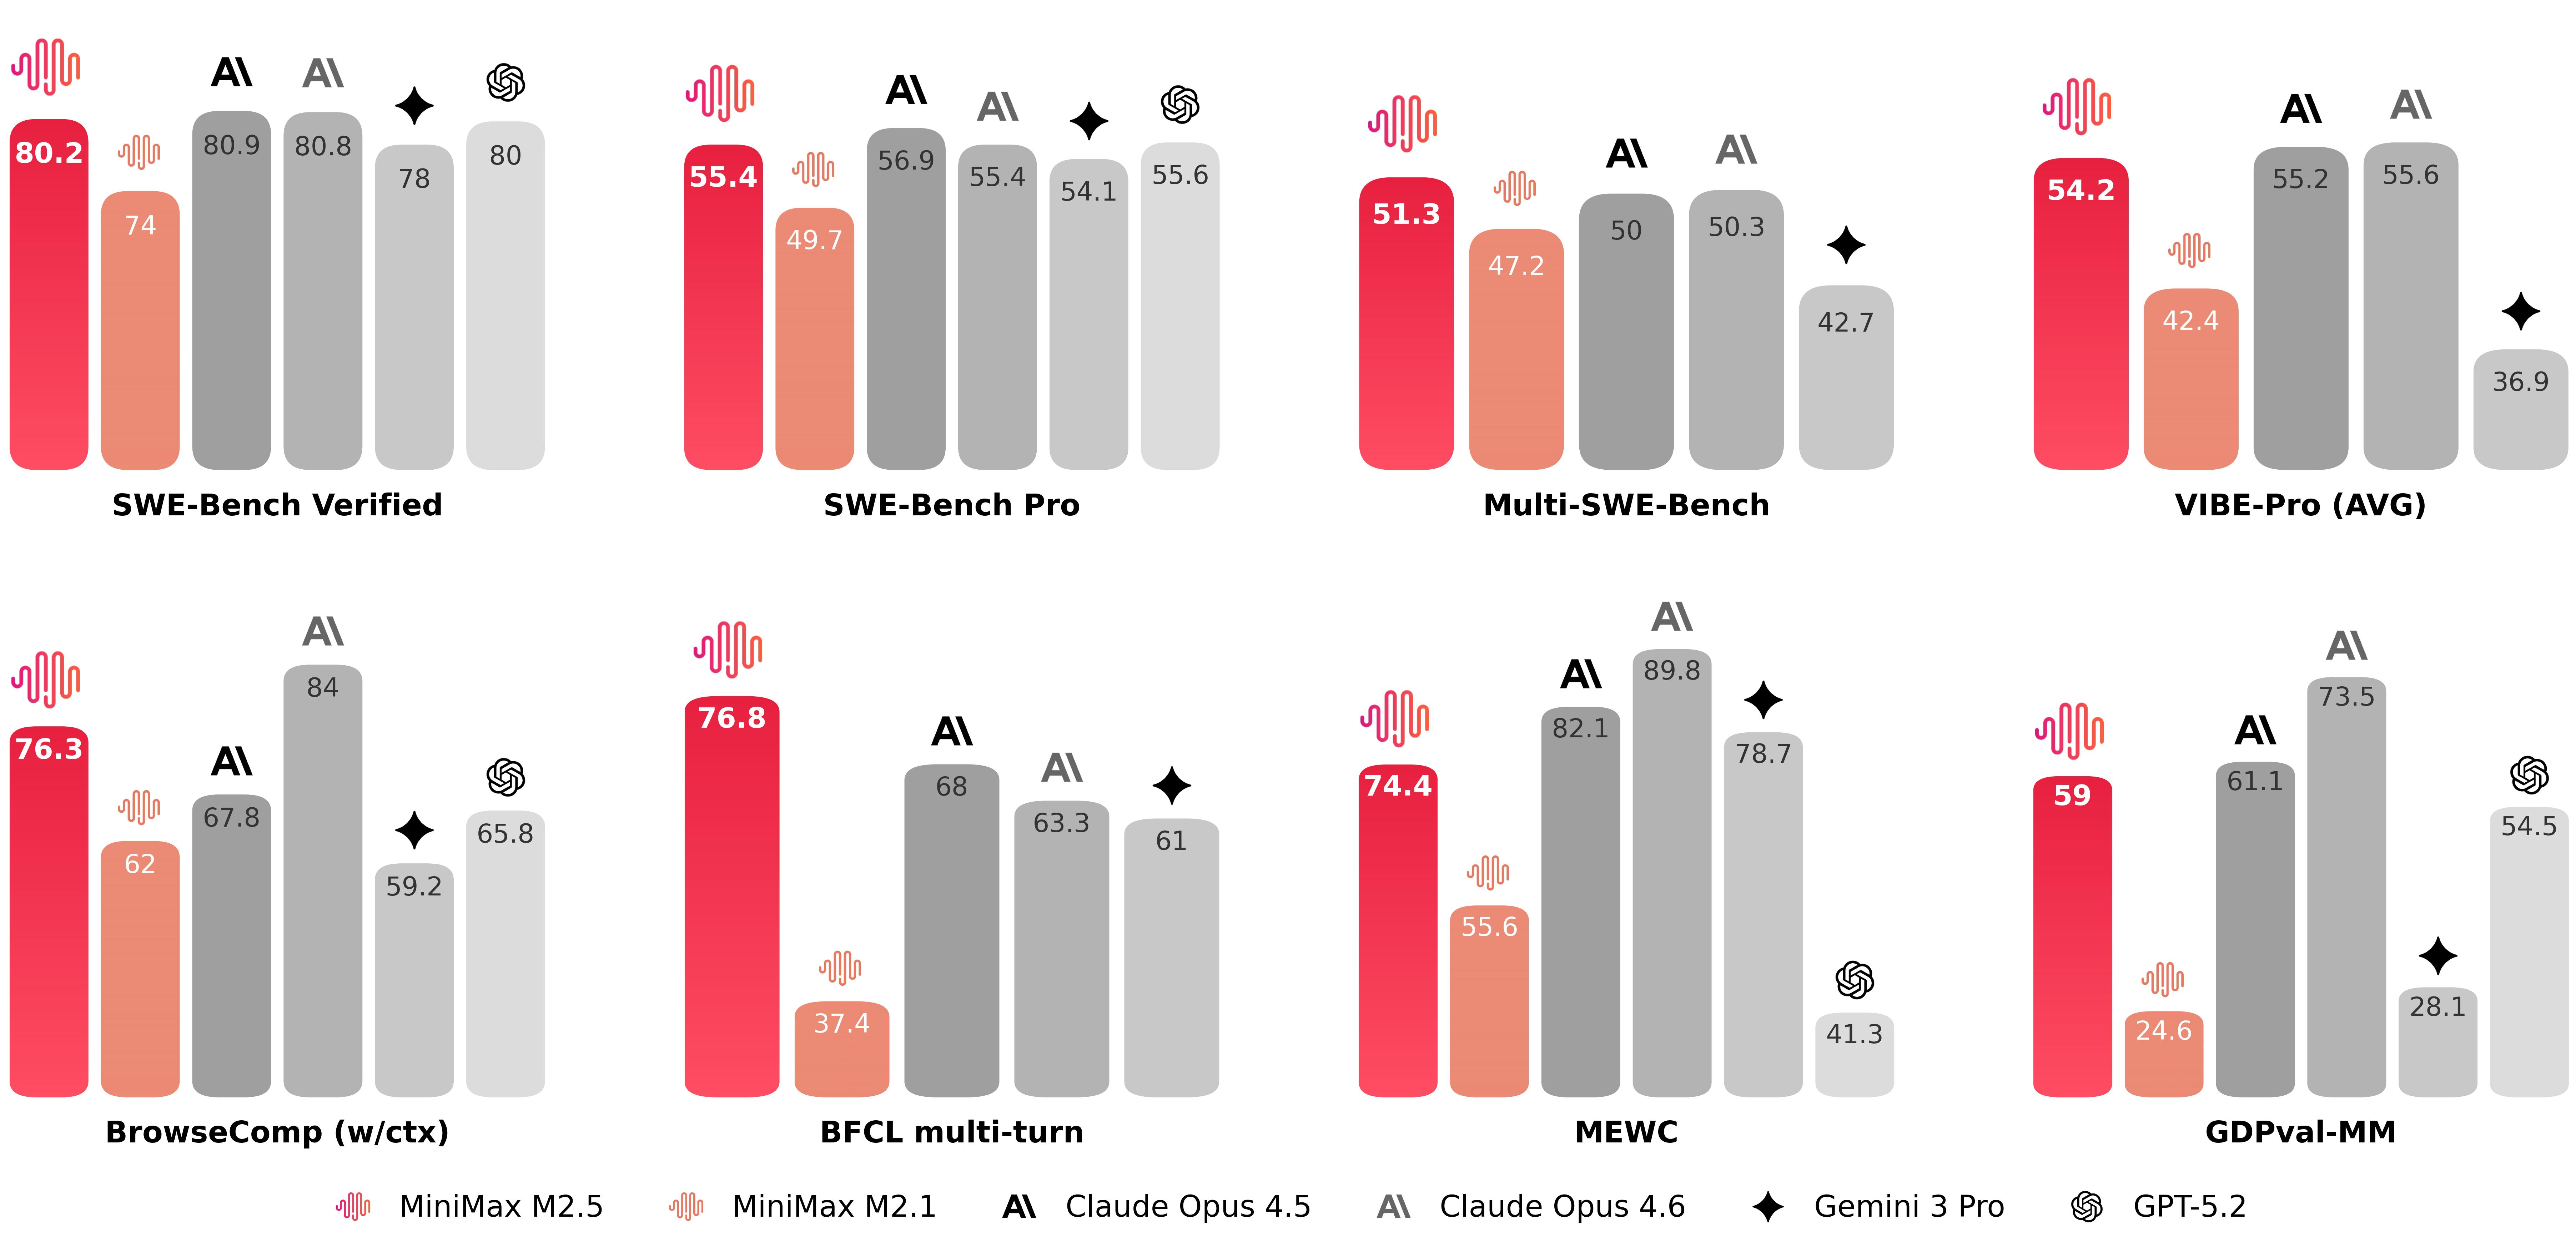
MiniMax-M2.5 est un nouveau LLM ouvert atteignant l’état de l’art en codage, en utilisation d’outils par agents, en recherche et en tâches de bureau, avec un score de 80,2 % sur [SWE-Bench](#benchmarks) Vérifié, 51,3 % sur Multi-SWE-Bench et 76,3 % sur BrowseComp.

Le **230B de paramètres** (10B actifs) a une **fenêtre de contexte de 200K** fenêtre de contexte et, en bf16 non quantifié, nécessite **457GB**Unsloth Dynamic **3 bits** GGUF réduit la taille à **101GB** **(-62%):** [**MiniMax-M2.5 GGUF**](https://huggingface.co/unsloth/MiniMax-M2.5-GGUF)

Tous les téléversements utilisent Unsloth [Dynamic 2.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) pour des performances de quantification à l’état de l’art — ainsi, en 3 bits, certaines couches importantes sont remontées à 8 ou 16 bits. Vous pouvez aussi affiner le modèle via Unsloth en utilisant plusieurs GPU.

{% hint style="success" %}
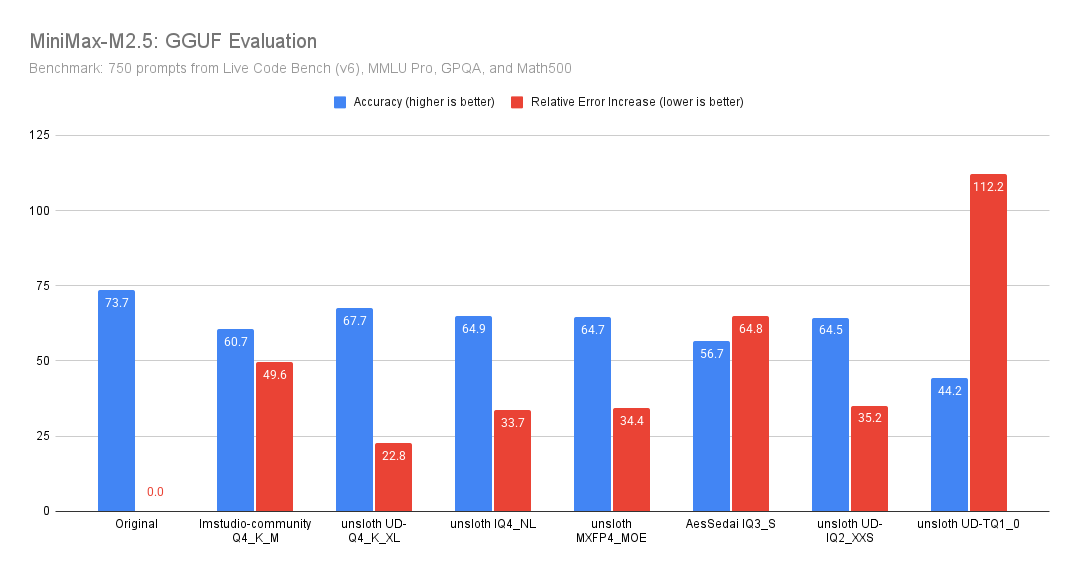
**26 févr. :** Voyez à quel point nos quantifications GGUF [se comportent sur les benchmarks ici](#unsloth-gguf-benchmarks).
{% endhint %}

### :gear: Guide d’utilisation

La quantification dynamique 3 bits UD-Q3\_K\_XL utilise **101GB** d’espace disque — cela tient parfaitement sur un **Mac à mémoire unifiée de 128 Go** pour \~20+ jetons/s, et fonctionne aussi plus vite avec un **GPU 1x16 Go et 96 Go de RAM** pour 25+ jetons/s. **2-bit** les quantifications ou le plus grand modèle en 2 bits tiendront sur un appareil de 96 Go.

Pour presque **précision complète**, utilisez `Q8_0` (8 bits) qui utilise 243 Go et tiendra sur un appareil / Mac avec 256 Go de RAM pour 10+ jetons/s.

{% hint style="success" %}
Pour de meilleures performances, assurez-vous que votre mémoire totale disponible (VRAM + RAM système) dépasse la taille du fichier du modèle quantifié que vous téléchargez. Si ce n’est pas le cas, llama.cpp peut toujours fonctionner via un déchargement SSD/HDD, mais l’inférence sera plus lente.
{% endhint %}

### Paramètres recommandés

MiniMax recommande d’utiliser les paramètres suivants pour de meilleures performances : `temperature=1.0`, `top_p = 0.95`, `top_k = 40`.

{% columns %}
{% column %}

| Paramètres par défaut (la plupart des tâches) |
| --------------------------------------------- |
| `température = 1.0`                           |
| `top_p = 0.95`                                |
| `top_k = 40`                                  |
| `pénalité de répétition = 1.0` ou désactivée  |
| {% endcolumn %}                               |

{% column %}

* **Fenêtre contextuelle maximale :** `196,608`
* `Min_P = 0.01` (la valeur par défaut peut être 0.05)
* Invite système par défaut :

{% code overflow="wrap" %}

```
Vous êtes un assistant utile. Votre nom est MiniMax-M2.5 et vous avez été créé par MiniMax.
```

{% endcode %}
{% endcolumn %}
{% endcolumns %}

## Lancer les tutoriels MiniMax-M2.5 :

Pour ces tutoriels, nous utiliserons la [UD-Q3\_K\_XL](https://huggingface.co/unsloth/MiniMax-M2.5-GGUF?show_file_info=UD-Q3_K_XL%2FMiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf) quantification 3 bits, qui tient sur un appareil avec 128 Go de RAM.

#### ✨ Exécuter dans llama.cpp

{% stepper %}
{% step %}
Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.

{% code overflow="wrap" %}

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endcode %}
{% endstep %}

{% step %}
Si vous souhaitez utiliser `llama.cpp` pour charger directement les modèles, vous pouvez faire ce qui suit : (:Q3\_K\_XL) est le type de quantification. Vous pouvez aussi télécharger via Hugging Face (point 3). Cela ressemble à `ollama run` . Utilisez `export LLAMA_CACHE="folder"` pour forcer `llama.cpp` pour l’enregistrer à un emplacement spécifique. N’oubliez pas que le modèle a uniquement une longueur de contexte maximale de 200K.

Suivez ceci pour **la plupart des valeurs par défaut** cas d'utilisation :

```bash
export LLAMA_CACHE="unsloth/MiniMax-M2.5-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/MiniMax-M2.5-GGUF:UD-Q3_K_XL \\
    --ctx-size 16384 \
    --flash-attn on \
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01 \
    --top-k 40
```

{% endstep %}

{% step %}
Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir `UD-Q3_K_XL` (quantification dynamique 4 bits) ou d’autres versions quantifiées comme `UD-Q6_K_XL` . Nous recommandons d’utiliser notre quantification dynamique 4 bits `UD-Q3_K_XL` pour équilibrer taille et précision. Si les téléchargements se bloquent, voir [Débogage de Hugging Face Hub et XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/MiniMax-M2.5-GGUF \\
    --local-dir unsloth/MiniMax-M2.5-GGUF \\
    --include "*UD-Q3_K_XL*" # Utilisez "*Q8_0*" pour 8 bits
```

{% endstep %}

{% step %}
Vous pouvez modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 16384` pour la longueur de contexte, `--n-gpu-layers 2` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/MiniMax-M2.5-GGUF/UD-Q3_K_XL/MiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf \\
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01 \
    --top-k 40 \",
    --ctx-size 16384 \
    --seed 3407
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 🦙 Llama-server et la bibliothèque de complétion d'OpenAI

Pour déployer MiniMax-M2.5 en production, nous utilisons `llama-server` ou l’API OpenAI. Dans un nouveau terminal, par exemple via tmux, déployez le modèle avec :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-server \
    --model unsloth/MiniMax-M2.5-GGUF/UD-Q3_K_XL/MiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf \\
    --alias "unsloth/MiniMax-M2.5" \\
    --prio 3 \
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01 \
    --top-k 40 \",
    --ctx-size 16384 \
    --port 8001
```

{% endcode %}

Ensuite, dans un nouveau terminal, après avoir exécuté `pip install openai`, faites :

{% code overflow="wrap" %}

```python
from openai import OpenAI
import json
openai_client = OpenAI(
    base_url = "http://127.0.0.1:8001/v1",
    api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
    model = "unsloth/MiniMax-M2.5",
    messages = [{"role": "user", "content": "Créez un jeu Snake."},],
)
print(completion.choices[0].message.content)
```

{% endcode %}

## 📊 Benchmarks

### Benchmarks GGUF d'Unsloth

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhfO2gsbz2lWrZXg3ojyE%2FHCGBTzgboAASv_A.png?alt=media&amp;token=7d6334ca-4f3c-4946-aacd-d55527375fce" alt=""><figcaption></figcaption></figure>

[Benjamin Marie (tiers) a benchmarké](https://x.com/bnjmn_marie/status/2027043753484021810/photo/1) **MiniMax-M2.5** en utilisant **Quantifications GGUF d’Unsloth** sur un **suite mixte de 750 invites** (LiveCodeBench v6, MMLU Pro, GPQA, Math500), en rapportant à la fois **la précision globale** et **l’augmentation relative de l’erreur** (à quel point le modèle quantifié fait plus souvent des erreurs que l’original).

Les quantifications Unsloth, quelle que soit leur précision, fonctionnent bien mieux que leurs équivalents non-Unsloth, tant en précision qu’en erreur relative (malgré une taille inférieure de 8 Go).

**Résultats clés :**

* **Meilleur compromis qualité/taille ici : `unsloth UD-Q4_K_XL`.**\
  C’est le plus proche de l’original : seulement **6,0 points** de moins, et « seulement » **+22.8%** plus d’erreurs que la référence.
* **Les autres quantifications Q4 d’Unsloth se tiennent très près (\~64,5–64,9 de précision).**\
  `IQ4_NL`, `MXFP4_MOE`et `UD-IQ2_XXS` ont pratiquement tous la même qualité sur ce benchmark, avec **\~33–35 %** plus d’erreurs que l’original.
* Les GGUFs d’Unsloth fonctionnent bien mieux que les autres GGUFs non-Unsloth, par ex. voir `lmstudio-community - Q4_K_M` (malgré une taille inférieure de 8 Go) et `AesSedai - IQ3_S`.

### Benchmarks officiels

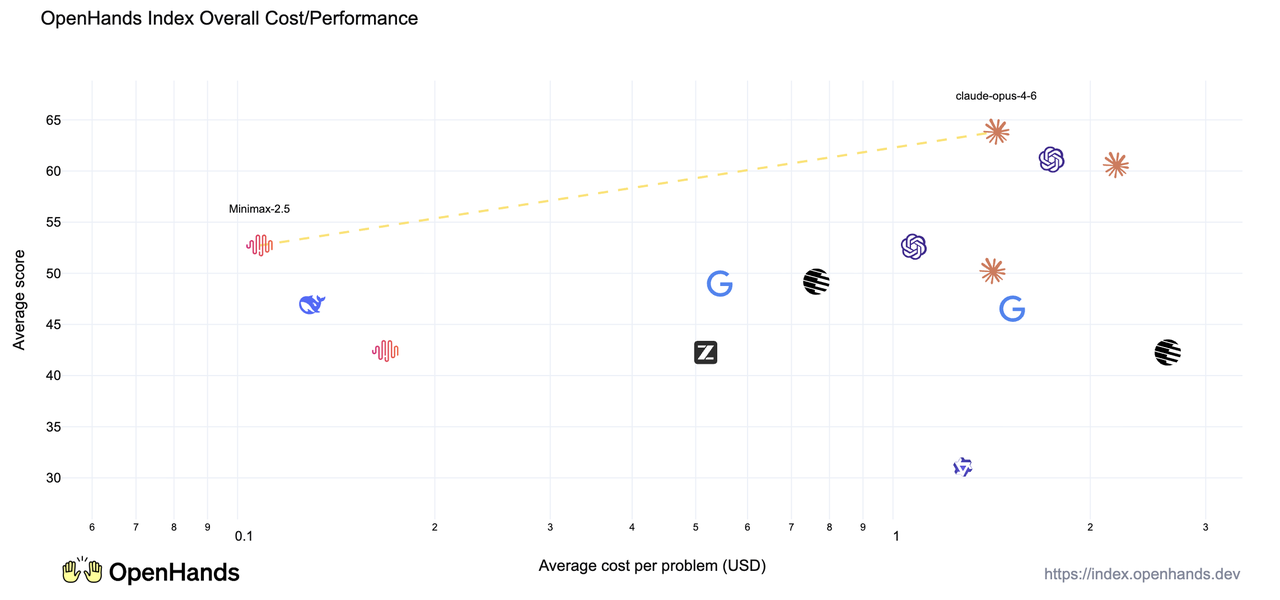
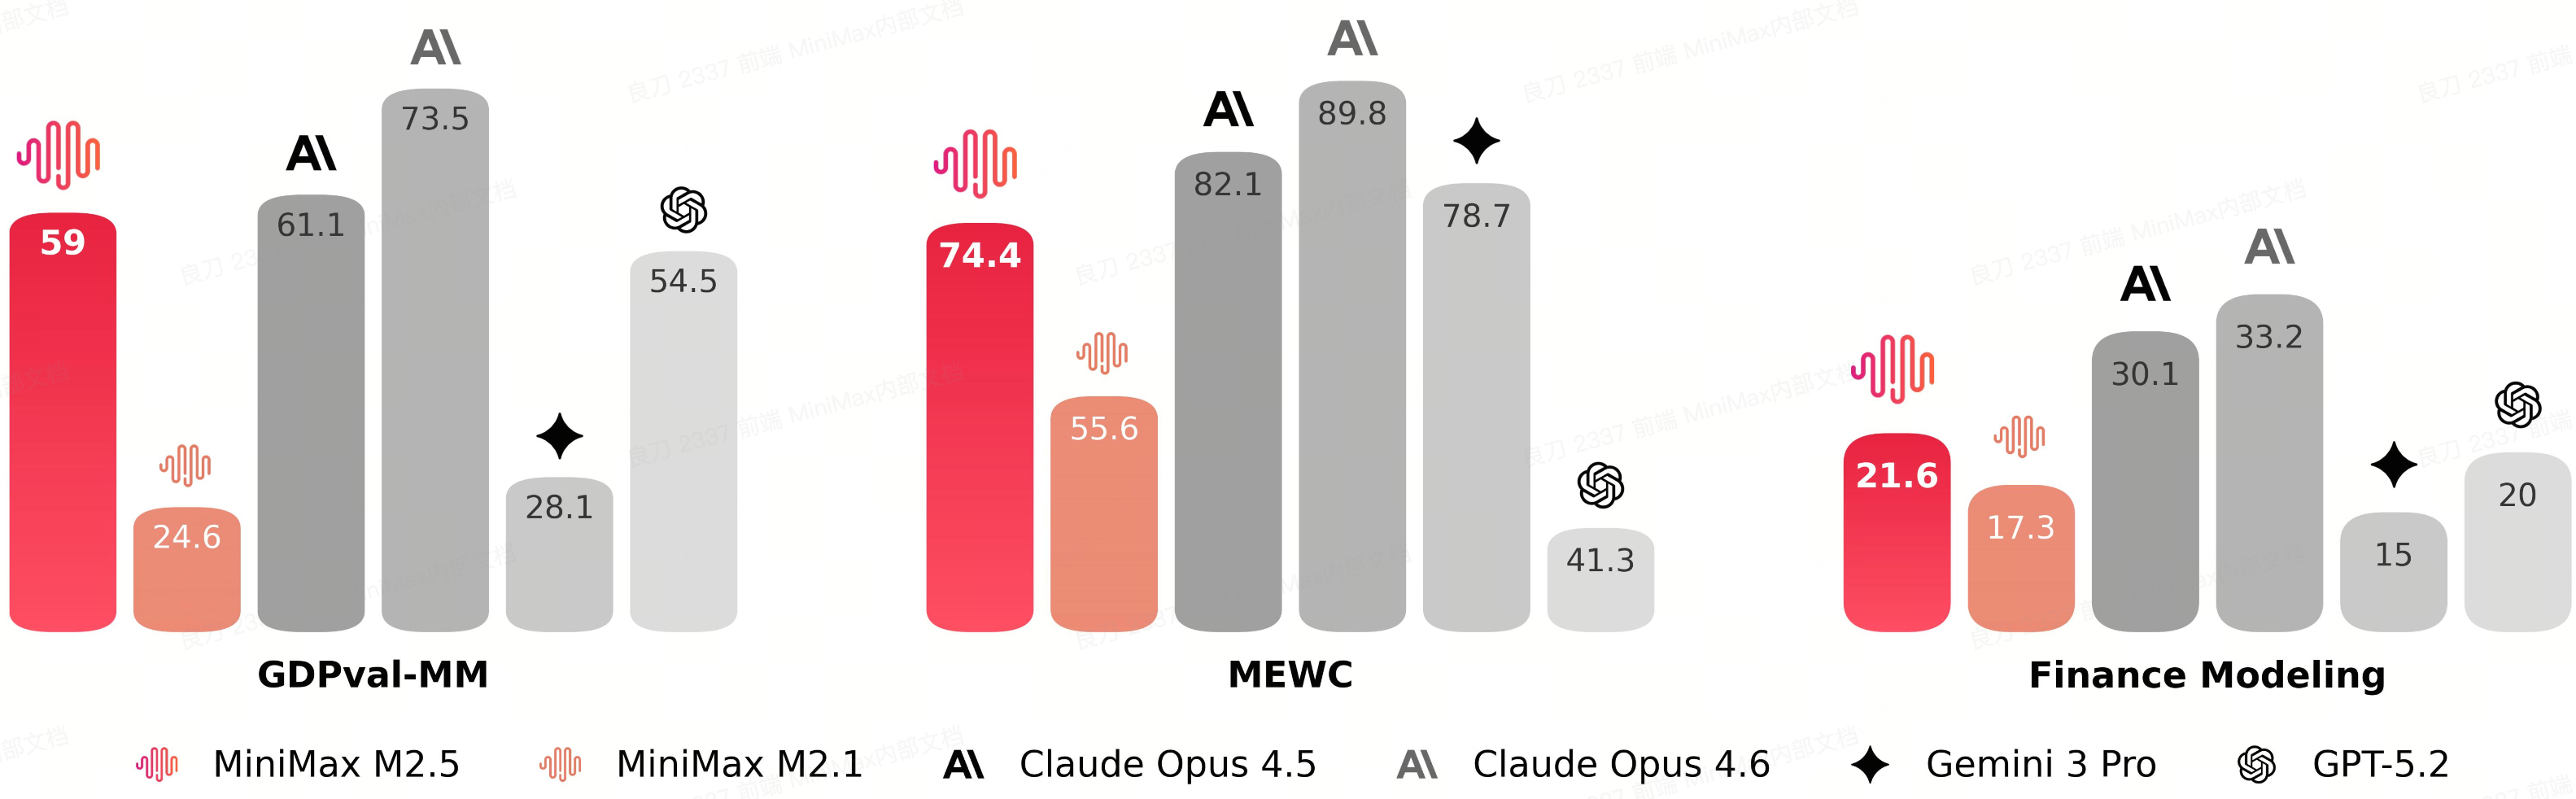
Vous pouvez voir plus bas les benchmarks sous forme de tableau :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHtuBCFNe7qeVG538VVQV%2F97f76950-2c60-4a9b-bb96-228454afabe9.png?alt=media&amp;token=a16edc7e-db1a-4052-aa99-1b516539b896" alt="" width="563"><figcaption></figcaption></figure>

<table data-full-width="true"><thead><tr><th>Benchmark</th><th>MiniMax-M2.5</th><th>MiniMax-M2.1</th><th>Claude Opus 4.5</th><th>Claude Opus 4.6</th><th>Gemini 3 Pro</th><th>GPT-5.2 (réflexion)</th></tr></thead><tbody><tr><td>AIME25</td><td>86.3</td><td>83.0</td><td>91.0</td><td>95.6</td><td>96.0</td><td>98.0</td></tr><tr><td>GPQA-D</td><td>85.2</td><td>83.0</td><td>87.0</td><td>90.0</td><td>91.0</td><td>90.0</td></tr><tr><td>SciCode</td><td>44.4</td><td>41.0</td><td>50.0</td><td>52.0</td><td>56.0</td><td>52.0</td></tr><tr><td>IFBench</td><td>70.0</td><td>70.0</td><td>58.0</td><td>53.0</td><td>70.0</td><td>75.0</td></tr><tr><td>AA-LCR</td><td>69.5</td><td>62.0</td><td>74.0</td><td>71.0</td><td>71.0</td><td>73.0</td></tr><tr><td>SWE-Bench Verified</td><td>80.2</td><td>74.0</td><td>80.9</td><td>80.8</td><td>78.0</td><td>80.0</td></tr><tr><td>SWE-Bench Pro</td><td>55.4</td><td>49.7</td><td>56.9</td><td>55.4</td><td>54.1</td><td>55.6</td></tr><tr><td>Terminal Bench 2</td><td>51.7</td><td>47.9</td><td>53.4</td><td>55.1</td><td>54.0</td><td>54.0</td></tr><tr><td>HLE sans outils</td><td>19.4</td><td>22.2</td><td>28.4</td><td>30.7</td><td>37.2</td><td>31.4</td></tr><tr><td>Multi-SWE-Bench</td><td>51.3</td><td>47.2</td><td>50.0</td><td>50.3</td><td>42.7</td><td>—</td></tr><tr><td>SWE-Bench multilingue</td><td>74.1</td><td>71.9</td><td>77.5</td><td>77.8</td><td>65.0</td><td>72.0</td></tr><tr><td>VIBE-Pro (AVG)</td><td>54.2</td><td>42.4</td><td>55.2</td><td>55.6</td><td>36.9</td><td>—</td></tr><tr><td>BrowseComp (avec ctx)</td><td>76.3</td><td>62.0</td><td>67.8</td><td>84.0</td><td>59.2</td><td>65.8</td></tr><tr><td>Recherche large</td><td>70.3</td><td>63.2</td><td>76.2</td><td>79.4</td><td>57.0</td><td>—</td></tr><tr><td>RISE</td><td>50.2</td><td>34.0</td><td>50.5</td><td>62.5</td><td>36.8</td><td>50.0</td></tr><tr><td>BFCL multi-tours</td><td>76.8</td><td>37.4</td><td>68.0</td><td>63.3</td><td>61.0</td><td>—</td></tr><tr><td>τ² Telecom</td><td>97.8</td><td>87.0</td><td>98.2</td><td>99.3</td><td>98.0</td><td>98.7</td></tr><tr><td>MEWC</td><td>74.4</td><td>55.6</td><td>82.1</td><td>89.8</td><td>78.7</td><td>41.3</td></tr><tr><td>GDPval-MM</td><td>59.0</td><td>24.6</td><td>61.1</td><td>73.5</td><td>28.1</td><td>54.5</td></tr><tr><td>Modélisation financière</td><td>21.6</td><td>17.3</td><td>30.1</td><td>33.2</td><td>15.0</td><td>20.0</td></tr></tbody></table>

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FfHyJbhPs4k10iiauD3zo%2F1f5a4e78-1a5c-4263-8a65-36c6fe703041.png?alt=media&amp;token=346519a3-5dee-4ea1-b395-c7de12b6f6cd" alt="" width="563"><figcaption><p>Scores du benchmark principal de codage</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhJmbCVK6CNZPw2FSJLPT%2F2003295c-001c-4381-af89-8859c197b5a0.png?alt=media&amp;token=aaa9968d-f694-4b1e-b734-086c2cf8988b" alt="" width="563"><figcaption><p>Recherche et utilisation d’outils</p></figcaption></figure></div>

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FaG1VqXpVwoCWG3RxMWDL%2F91c4825c-1813-4cad-9e36-4b69c6cd0272.png?alt=media&amp;token=ae956a3f-a25e-4ebc-80cb-97733573e654" alt=""><figcaption><p>Tâches terminées pour 100</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fj2PwoDid8zWRyYnXA6of%2F8c25f392-275d-4730-aa92-e9ea27315d83.png?alt=media&amp;token=a59cf4d3-ff63-4383-90c8-2d089db19b50" alt=""><figcaption><p>Capacités bureautiques</p></figcaption></figure></div>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/tutorials/minimax-m25.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.