> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/glm-5.md).

# GLM-5 : guide d'exécution locale

Exécutez le nouveau modèle GLM-5 de Z.ai sur votre propre appareil local !

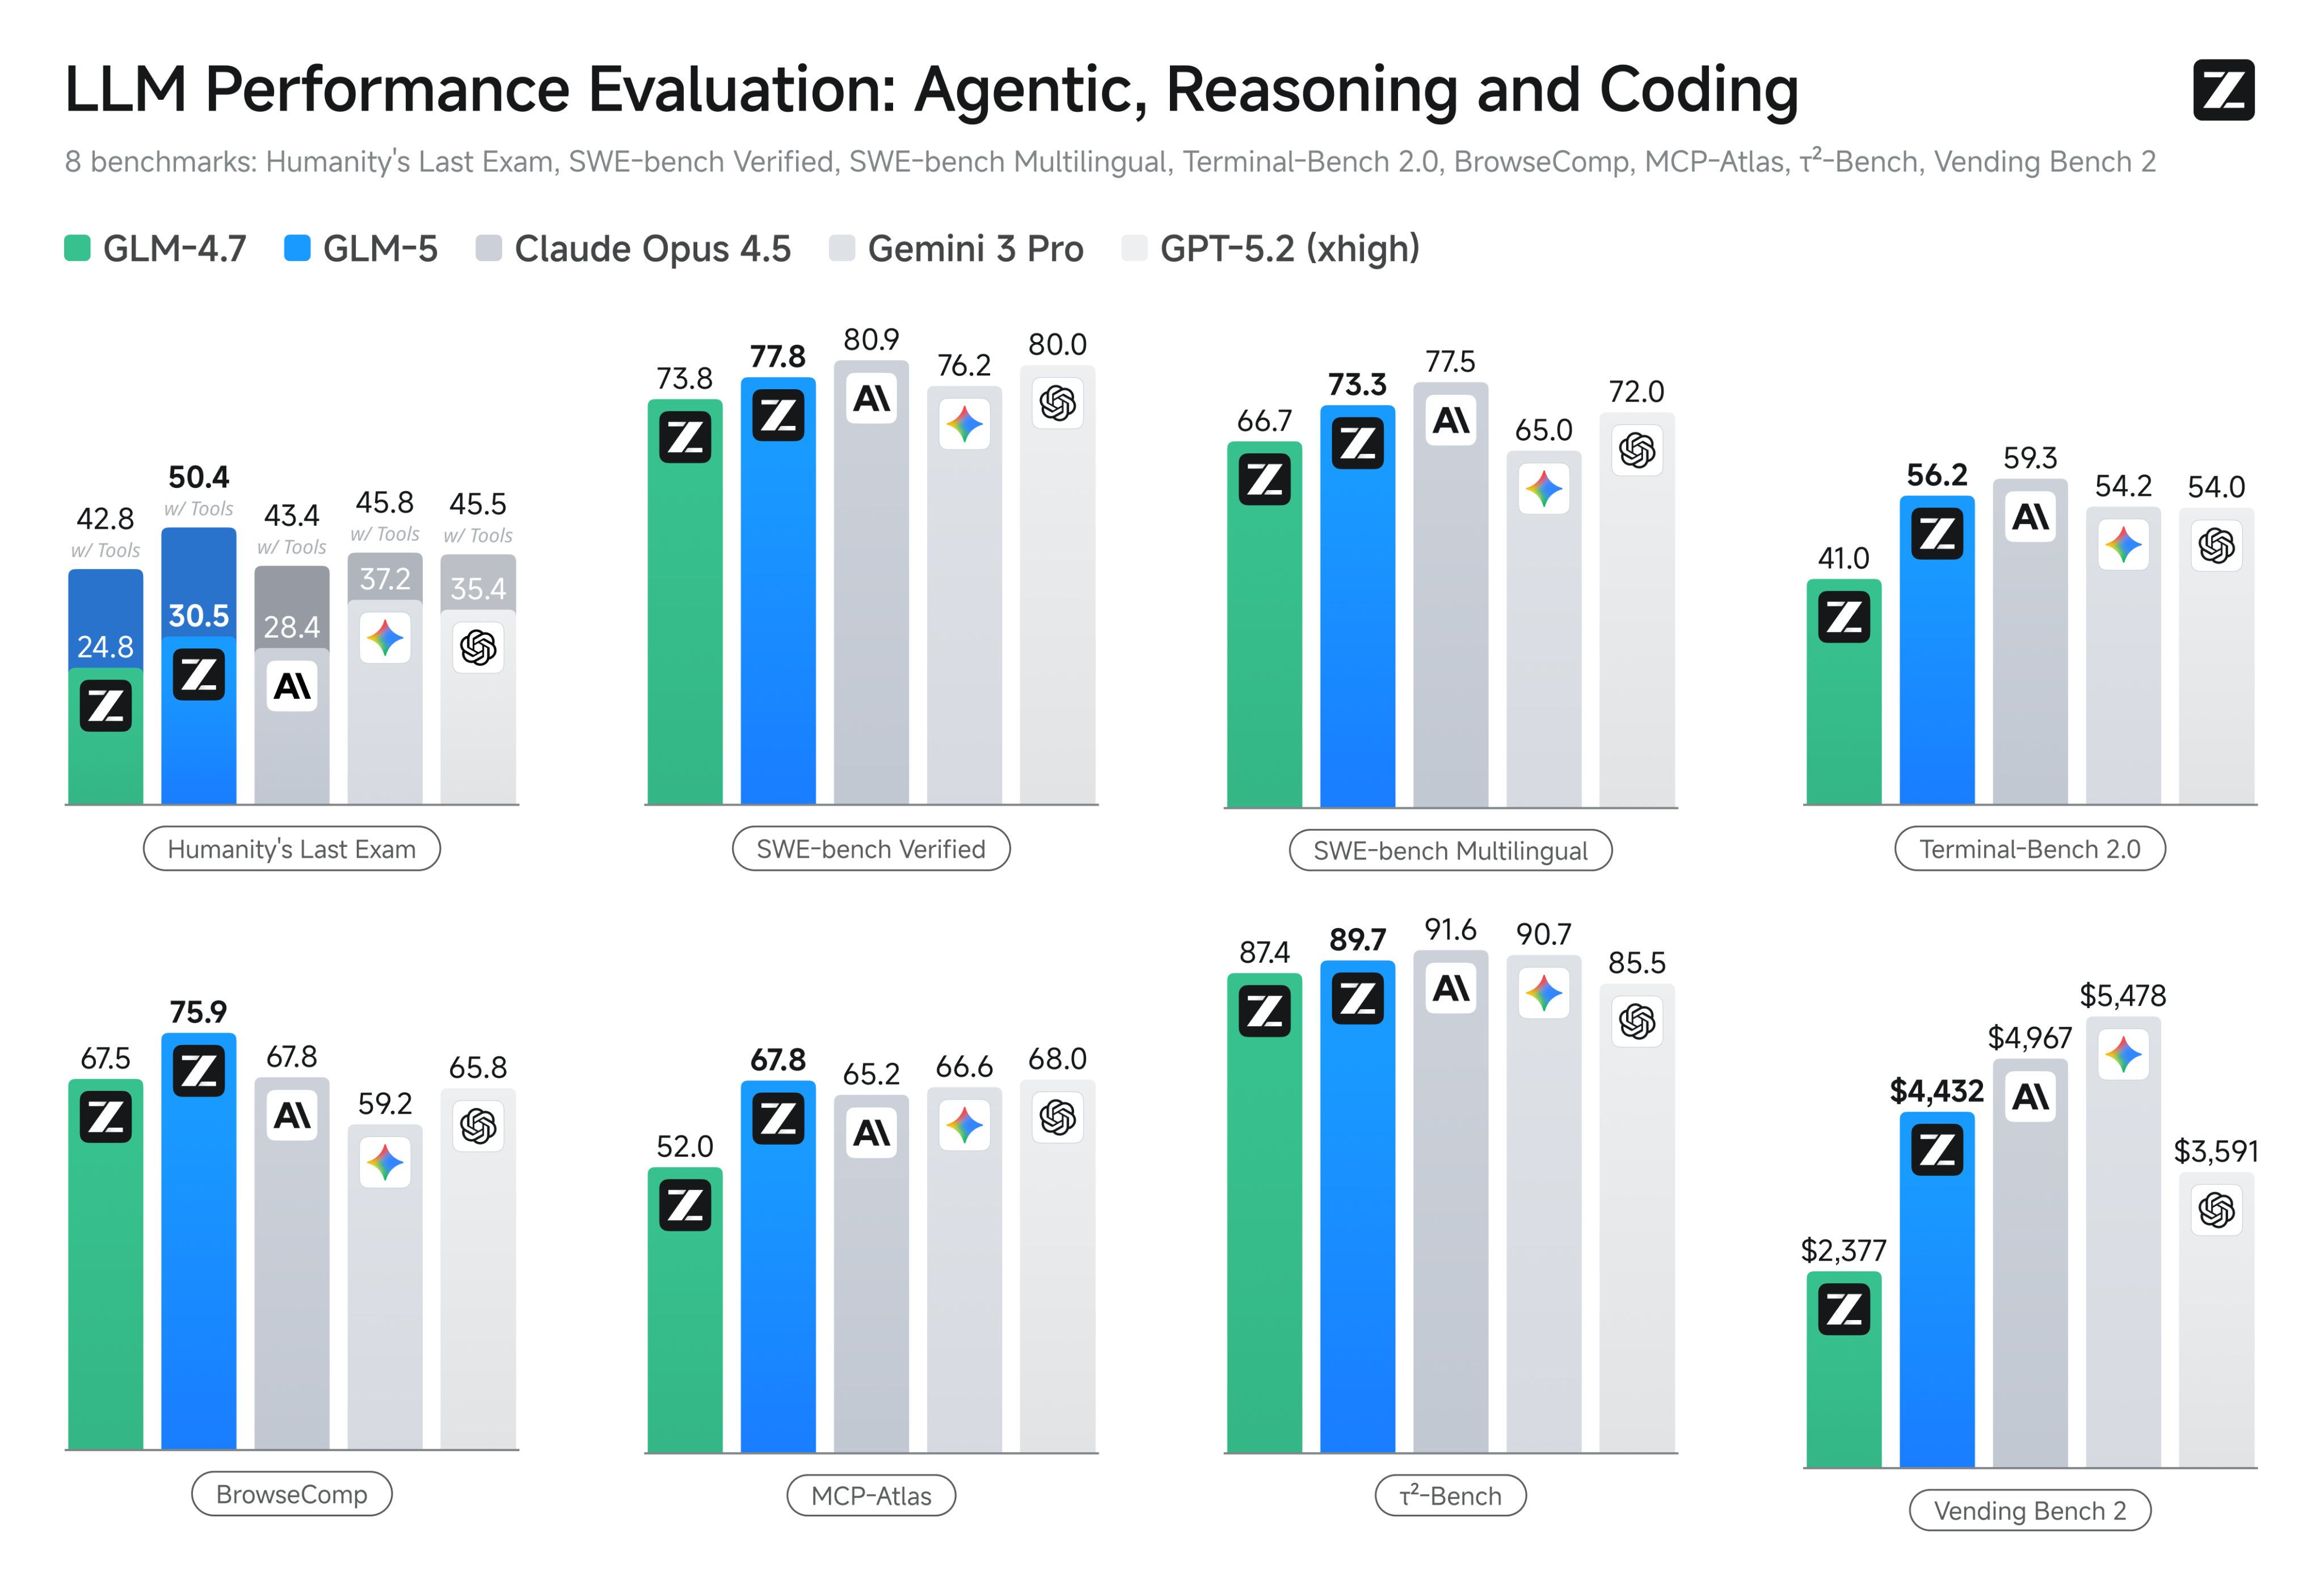
GLM-5 est le dernier modèle de raisonnement de Z.ai, offrant de meilleures performances en codage, agents et conversation que [GLM-4.7](/docs/fr/modeles/tutorials/glm-4.7.md), et est conçu pour le raisonnement sur de longs contextes. Il améliore les performances sur des benchmarks tels que Humanity's Last Exam 50.4% (+7.6%), BrowseComp 75.9% (+8.4%) et Terminal-Bench-2.0 61.1% (+28.3%).

Le modèle complet de 744B paramètres (40B actifs) possède une **fenêtre de contexte de 200K**  et a été pré-entraîné sur 28.5T tokens. Le modèle GLM-5 complet nécessite **1,65 To** d'espace disque, tandis que le GGUF dynamique 2 bits d'Unsloth réduit la taille à **241 Go** **(-85%)**, et le dynamique **1 bit fait 176 Go (-89 %) :** [**GLM-5-GGUF**](https://huggingface.co/unsloth/GLM-5-GGUF)

Tous les téléversements utilisent Unsloth [Dynamic 2.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) pour des performances de quantification SOTA - ainsi, le modèle 1 bit a des couches importantes remontées en précision à 8 ou 16 bits. Merci à Z.ai d’avoir donné à Unsloth un accès dès le jour zéro.

### :gear: Guide d’utilisation

La quantification dynamique 2 bits UD-IQ2\_XXS utilise **241 Go** d’espace disque — cela peut tenir directement sur un **Mac avec 256 Go de mémoire unifiée**, et fonctionne également bien sur une **carte 1x24 Go et 256 Go de RAM** avec déchargement MoE. La **1-bit** quantification tiendra dans 180 Go de RAM et la version 8 bits nécessite 805 Go de RAM.

{% hint style="success" %}
Pour de meilleures performances, assurez-vous que votre mémoire totale disponible (VRAM + RAM système) dépasse la taille du fichier du modèle quantifié que vous téléchargez. Si ce n’est pas le cas, llama.cpp peut toujours fonctionner via un déchargement SSD/HDD, mais l’inférence sera plus lente.
{% endhint %}

### Paramètres recommandés

Utilisez des réglages distincts pour différents cas d’usage :

| Paramètres par défaut (la plupart des tâches) | SWE Bench Verified                         |
| --------------------------------------------- | ------------------------------------------ |
| température = 1.0                             | temperature = 0.7                          |
| top\_p = 0.95                                 | top\_p = 1.0                               |
| nombre maximal de nouveaux tokens = 131072    | nombre maximal de nouveaux tokens = 16384  |
| pénalité de répétition = désactivée ou 1,0    | pénalité de répétition = désactivée ou 1,0 |

* `Min_P = 0,01` (la valeur par défaut de llama.cpp est 0,05)
* **Fenêtre contextuelle maximale :** `202,752`.
* Pour les tâches agentiques à plusieurs tours (τ²-Bench et Terminal Bench 2), veuillez activer le mode Pensée préservée.

## Exécutez les tutoriels GLM-5 :

#### ✨ Exécuter dans llama.cpp

{% stepper %}
{% step %}
Obtenez la dernière version `llama.cpp` **sur** [**GitHub ici**](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
Si vous souhaitez utiliser `llama.cpp` pour charger directement les modèles, vous pouvez faire ce qui suit : (:IQ2\_XXS) est le type de quantification. Vous pouvez aussi télécharger via Hugging Face (point 3). C’est similaire à `ollama run` . Utilisez `export LLAMA_CACHE="folder"` pour forcer `llama.cpp` pour l’enregistrer à un emplacement spécifique. N’oubliez pas que le modèle a uniquement une longueur de contexte maximale de 200K.

Suivez ceci pour **les instructions générales** cas d’usage :

```bash
export LLAMA_CACHE="unsloth/GLM-5-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/GLM-5-GGUF:UD-IQ2_XXS \\
    --ctx-size 16384 \
    --flash-attn on \
    --temp 0.7 \
    --top-p 1.0 \\
    --min-p 0.01
```

Suivez ceci pour **appel d’outils** cas d’usage :

```bash
export LLAMA_CACHE="unsloth/GLM-5-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/GLM-5-GGUF:UD-IQ2_XXS \\
    --ctx-size 16384 \
    --flash-attn on \
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01
```

{% endstep %}

{% step %}
Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir `UD-Q2_K_XL` (quantification dynamique 2 bits) ou d’autres versions quantifiées comme `UD-Q4_K_XL` . Nous <mark style="background-color:green;">**nous recommandons d’utiliser notre quantification dynamique 2 bits**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**`UD-Q2_K_XL`**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**pour équilibrer taille et précision**</mark>. Si les téléchargements se bloquent, voir [Débogage de Hugging Face Hub et XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
pip install -U huggingface_hub
hf download unsloth/GLM-5-GGUF \\
    --local-dir unsloth/GLM-5-GGUF \\
    --include "*UD-IQ2_XXS*" # Utilisez "*UD-TQ1_0*" pour le 1 bit dynamique
```

{% endstep %}

{% step %}
Vous pouvez modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 16384` pour la longueur de contexte, `--n-gpu-layers 2` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/GLM-5-GGUF/UD-IQ2_XXS/GLM-5-UD-IQ2_XXS-00001-of-00006.gguf \\
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01 \
    --ctx-size 16384 \
    --seed 3407
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 🦙 Serveur Llama et bibliothèque de complétion OpenAI

Pour déployer GLM-5 en production, nous utilisons `llama-server` Dans un nouveau terminal, par exemple via tmux, déployez le modèle avec :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-server \
    --model unsloth/GLM-5-GGUF/UD-IQ2_XXS/GLM-5-UD-IQ2_XXS-00001-of-00006.gguf \\
    --alias "unsloth/GLM-5" \\
    --prio 3 \
    --temp 1.0 \
    --top-p 0.95 \
    --ctx-size 16384 \
    --port 8001
```

{% endcode %}

Ensuite, dans un nouveau terminal, après avoir exécuté `pip install openai`, faites :

{% code overflow="wrap" %}

```python
from openai import OpenAI
import json
openai_client = OpenAI(
    base_url = "http://127.0.0.1:8001/v1",
    api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
    model = "unsloth/GLM-5",
    messages = [{"role": "user", "content": "Créez un jeu Snake."},],
)
print(completion.choices[0].message.content)
```

{% endcode %}

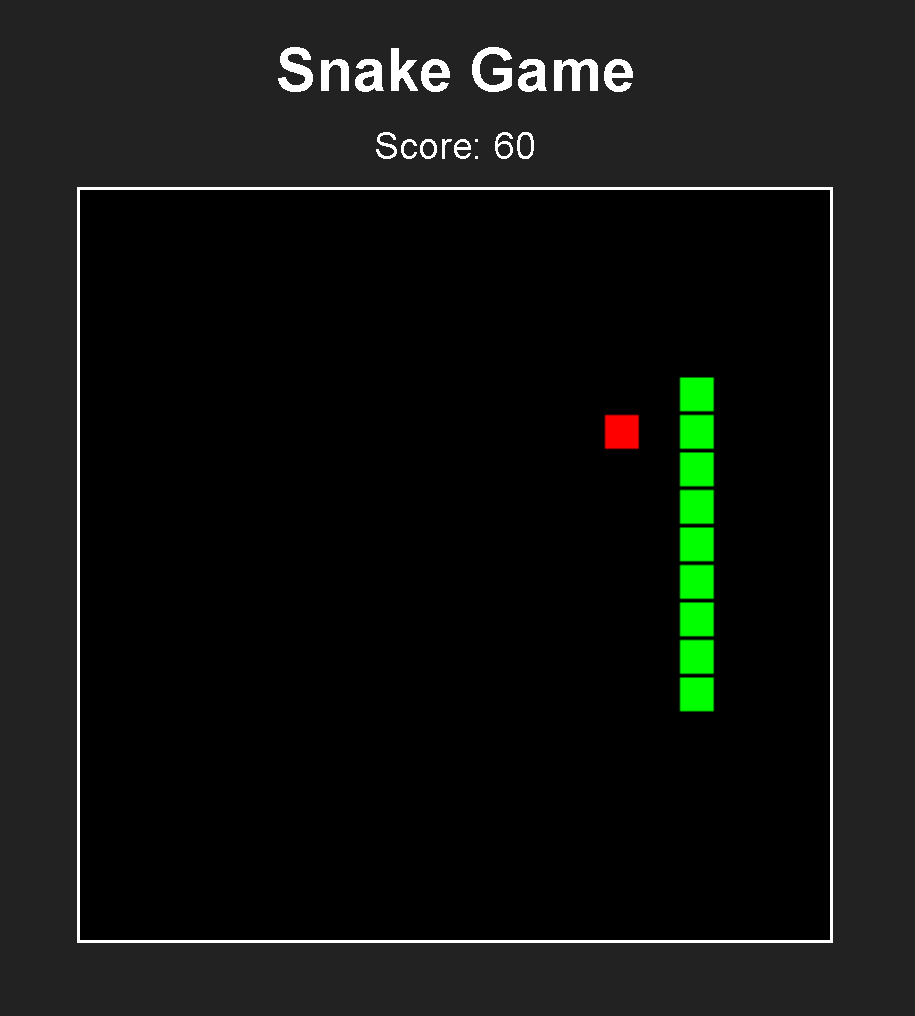
Et vous obtiendrez l’exemple suivant d’un jeu Snake :

{% columns %}
{% column width="58.333333333333336%" %}
{% code expandable="true" %}

````markdown
Voici un jeu Snake complet et jouable contenu dans un seul fichier HTML. Vous pouvez copier ce code, l’enregistrer dans un fichier `.html` (par exemple `snake.html`) et l’ouvrir dans votre navigateur web pour jouer.

### Le code

```html
<!DOCTYPE html>
<html lang="fr">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Jeu Snake classique</title>
    <style>
        body {
            display: flex;
            flex-direction: column;
            justify-content: center;
            align-items: center;
            height: 100vh;
            margin: 0;
            background-color: #222;
            color: white;
            font-family: Arial, sans-serif;
        }

        #gameCanvas {
            border: 2px solid #fff;
            background-color: #000;
        }

        h1 {
            margin-bottom: 10px;
        }

        #scoreBoard {
            font-size: 20px;
            margin-bottom: 10px;
        }

        #gameOverMenu {
            position: absolute;
            display: none;
            flex-direction: column;
            justify-content: center;
            align-items: center;
            background: rgba(0, 0, 0, 0.85);
            padding: 20px;
            border-radius: 10px;
            border: 2px solid red;
        }

        button {
            margin-top: 15px;
            padding: 10px 20px;
            font-size: 16px;
            cursor: pointer;
            background-color: #4CAF50;
            color: white;
            border: none;
            border-radius: 5px;
        }
        
        button:hover {
            background-color: #45a049;
        }
    </style>
</head>
<body>

    <h1>Jeu Snake</h1>
    <div id="scoreBoard">Score : 0</div>
    <canvas id="gameCanvas" width="400" height="400"></canvas>

    <div id="gameOverMenu">
        <h2 style="color: red; margin: 0;">Partie terminée !</h2>
        <p id="finalScore">Score final : 0</p>
        <button onclick="resetGame()">Rejouer</button>
    </div>

    <script>
        // Constantes du jeu
        const canvas = document.getElementById('gameCanvas');
        const ctx = canvas.getContext('2d');
        const scoreBoard = document.getElementById('scoreBoard');
        const gameOverMenu = document.getElementById('gameOverMenu');
        const finalScoreDisplay = document.getElementById('finalScore');

        const gridSize = 20; // Taille de chaque case
        const tileCount = canvas.width / gridSize; // Nombre de cases par ligne/colonne

        // Variables du jeu
        let dx = 0; // Vitesse horizontale
        let dy = 0; // Vitesse verticale
        let score = 0;
        let snake = [];
        let foodX, foodY;
        let gameInterval;
        let isGameRunning = false;

        // Initialiser le jeu
        function initGame() {
            snake = [
                {x: 10, y: 10}, 
                {x: 9, y: 10}, 
                {x: 8, y: 10}
            ];
            score = 0;
            scoreBoard.innerText = 'Score : ' + score;
            dx = 1; // Commencer à aller vers la droite immédiatement
            dy = 0;
            placeFood();
            isGameRunning = true;
            gameOverMenu.style.display = 'none';
            
            // Démarrer la boucle du jeu
            if (gameInterval) clearInterval(gameInterval);
            gameInterval = setInterval(gameLoop, 100); // Exécuter la boucle du jeu toutes les 100 ms
        }

        // Boucle principale du jeu
        function gameLoop() {
            if (!isGameRunning) return;

            moveSnake();
            if (checkGameOver()) {
                endGame();
                return;
            }
            checkFoodCollision();
            draw();
        }

        // Déplacer le serpent
        function moveSnake() {
            // Créer une nouvelle tête en fonction de la direction actuelle
            const head = {x: snake[0].x + dx, y: snake[0].y + dy};
            
            // Ajouter la nouvelle tête au début du tableau
            snake.unshift(head);

            // Retirer la queue (dernier élément) sauf si de la nourriture a été mangée
            // Remarque : nous gérons la suppression de la queue dans checkFoodCollision
            snake.pop(); 
        }

        // Vérifier si le serpent mange la nourriture
        function checkFoodCollision() {
            const head = snake[0];
            
            if (head.x === foodX && head.y === foodY) {
                // Faire grandir le serpent : ajouter un morceau de queue (dupliquer le dernier)
                snake.push({...snake[snake.length - 1]});
                score += 10;
                scoreBoard.innerText = 'Score : ' + score;
                placeFood();
            }
        }

        // Vérifier les collisions (murs ou soi-même)
        function checkGameOver() {
            const head = snake[0];

            // Collision avec un mur
            if (head.x < 0 || head.x >= tileCount || head.y < 0 || head.y >= tileCount) {
                return true;
            }

            // Collision avec soi-même (commencer à vérifier à partir du 4e segment car la tête ne peut pas heurter les 3 premiers)
            for (let i = 4; i < snake.length; i++) {
                if (head.x === snake[i].x && head.y === snake[i].y) {
                    return true;
                }
            }

            return false;
        }

        // Dessiner tout
        function draw() {
            // Effacer le canvas
            ctx.fillStyle = 'black';
            ctx.fillRect(0, 0, canvas.width, canvas.height);

            // Dessiner la nourriture
            ctx.fillStyle = 'red';
            ctx.fillRect(foodX * gridSize, foodY * gridSize, gridSize - 2, gridSize - 2);

            // Dessiner le serpent
            ctx.fillStyle = 'lime';
            for (let i = 0; i < snake.length; i++) {
                // Dessiner la tête légèrement différemment ou simplement de manière standard
                const part = snake[i];
                ctx.fillRect(part.x * gridSize, part.y * gridSize, gridSize - 2, gridSize - 2);
            }
        }

        // Placer la nourriture à une position aléatoire
        function placeFood() {
            foodX = Math.floor(Math.random() * tileCount);
            foodY = Math.floor(Math.random() * tileCount);

            // S’assurer que la nourriture n’apparaît pas sur le corps du serpent
            for (let part of snake) {
                if (part.x === foodX && part.y === foodY) {
                    placeFood(); // Trouver récursivement un nouvel emplacement
                    return;
                }
            }
        }

        // Logique de fin de partie
        function endGame() {
            isGameRunning = false;
            clearInterval(gameInterval);
            finalScoreDisplay.innerText = 'Score final : ' + score;
            gameOverMenu.style.display = 'flex';
        }

        // Logique de réinitialisation du jeu
        function resetGame() {
            initGame();
        }

        // Contrôles clavier
        document.addEventListener('keydown', (e) => {
            // Empêcher l’inversion de direction (on ne peut pas aller à gauche si l’on va vers la droite)
            switch(e.key) {
                case 'ArrowUp':
                    if (dy !== 1) { dx = 0; dy = -1; }
                    break;
                case 'ArrowDown':
                    if (dy !== -1) { dx = 0; dy = 1; }
                    break;
                case 'ArrowLeft':
                    if (dx !== 1) { dx = -1; dy = 0; }
                    break;
                case 'ArrowRight':
                    if (dx !== -1) { dx = 1; dy = 0; }
                    break;
                case ' ':
                    if (!isGameRunning && gameOverMenu.style.display !== 'flex') {
                        initGame();
                    }
                    break;
            }
        });

        // Démarrer le jeu au chargement
        initGame();
    </script>
</body>
</html>
```

### Comment jouer
1.  **Copiez le code** ci-dessus.
2.  Créez un nouveau fichier sur votre ordinateur nommé `snake.html`.
3.  **Collez le code** dans ce fichier et enregistrez-le.
4.  **Double-cliquez sur `snake.html`** pour l’ouvrir dans votre navigateur.

### Contrôles
*   **Touches fléchées** : Monter, descendre, gauche, droite.
*   **Barre d’espace** : Démarre le jeu (s’il n’a pas encore commencé).
*   **Bouton Rejouer** : Apparaît lorsque vous perdez pour redémarrer la partie.

### Fonctionnalités de cette version
*   **Déplacement sur grille** : Ambiance rétro classique.
*   **Suivi du score** : Mise à jour en temps réel.
*   **Écran de fin de partie** : Affiche votre score final et vous permet de redémarrer facilement.
*   **Détection des collisions** : Met fin à la partie si vous touchez les murs ou vous-même.
*   **Sécurité contre l’auto-collision** : Le code empêche le serpent de se manger accidentellement juste après avoir mangé de la nourriture, grâce à une logique de « saut de queue » couramment trouvée dans les tutoriels simples.
````

{% endcode %}
{% endcolumn %}

{% column width="41.666666666666664%" %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsdUp9wbpqDx0Lhp00xZ0%2Fimage.png?alt=media&amp;token=a5e67ac2-65bf-43e0-8c13-4aef9a7d269e" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

### :computer: Déploiement vLLM

Vous pouvez désormais servir la version FP8 du modèle de Z.ai via vLLM. Vous avez besoin d’au moins 860 Go de VRAM, donc un système 8xH200 (141x8 = 1128 Go) est au minimum recommandé. 8xB200 fonctionne bien. Commencez par installer la version nightly de vllm :

{% code overflow="wrap" %}

```bash
uv pip install --upgrade --force-reinstall vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly/cu130
uv pip install --upgrade --force-reinstall git+https://github.com/huggingface/transformers.git
uv pip install --force-reinstall numba
```

{% endcode %}

Pour désactiver le cache KV FP8 (réduit l’utilisation mémoire de 50 %), supprimez `--kv-cache-dtype fp8`

```bash
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:False
vllm serve unsloth/GLM-5-FP8 \\
    --served-model-name unsloth/GLM-5-FP8 \\
    --kv-cache-dtype fp8 \\
    --tensor-parallel-size 8 \\
    --tool-call-parser glm47 \\
    --reasoning-parser glm45 \\
    --enable-auto-tool-choice \\
    --dtype bfloat16 \\
    --seed 3407 \
    --max-model-len 200000 \\
    --gpu-memory-utilization 0.93 \\
    --max_num_batched_tokens 4096 \\
    --speculative-config.method mtp \\
    --speculative-config.num_speculative_tokens 1 \\
    --port 8001
```

Vous pouvez ensuite appeler le modèle servi via l’API OpenAI :

```python
from openai import AsyncOpenAI, OpenAI
openai_api_key = "EMPTY"
openai_api_base = "http://localhost:8001/v1"
client = OpenAI( # ou AsyncOpenAI
    api_key = openai_api_key,
    base_url = openai_api_base,
)
```

### :hammer:Appel d’outils avec GLM 5

Voir [Tool Calling Guide](/docs/fr/notions-de-base/tool-calling-guide-for-local-llms.md) pour plus de détails sur la façon de faire un appel d'outils. Dans un nouveau terminal (si vous utilisez tmux, utilisez CTRL+B+D), nous créons des outils comme additionner 2 nombres, exécuter du code Python, exécuter des fonctions Linux et bien plus encore :

{% code expandable="true" %}

```python
import json, subprocess, random
from typing import Any
def add_number(a: float | str, b: float | str) -> float:
    return float(a) + float(b)
def multiply_number(a: float | str, b: float | str) -> float:
    return float(a) * float(b)
def subtract_number(a: float | str, b: float | str) -> float:
    return float(a) - float(b)
def write_a_story() -> str:
    return random.choice([
        "Il y a bien longtemps, dans une galaxie très, très lointaine...",
        "Il y avait deux amis qui adoraient les paresseux et le code...",
        "Le monde allait prendre fin parce que chaque paresseux avait évolué pour posséder une intelligence surhumaine...",
        "À l'insu de l'un des amis, l'autre a accidentellement codé un programme pour faire évoluer les paresseux...",
    ])
def terminal(command: str) -> str:
    if "rm" in command or "sudo" in command or "dd" in command or "chmod" in command:
        msg = "Impossible d'exécuter les commandes 'rm, sudo, dd, chmod' car elles sont dangereuses"
        print(msg); return msg
    print(f"Exécution de la commande terminal `{command}`")
    try:
        "type": "function"
    except subprocess.CalledProcessError as e:
        return f"Commande échouée : {e.stderr}"
def python(code: str) -> str:
    data = {}
    exec(code, data)
    del data["__builtins__"]
    return str(data)
MAP_FN = {
    "add_number": add_number,
    "multiply_number": multiply_number,
    "subtract_number": subtract_number,
    "write_a_story": write_a_story,
    "terminal": terminal,
    "python": python,
}
tools = [
    {
        "type": "function",
        "function": {
            "name": "add_number",
            "description": "Additionnez deux nombres.",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {
                        "type": "string",
                        "description": "Le premier nombre.",
                    },
                    "b": {
                        "type": "string",
                        "description": "Le deuxième nombre.",
                    },
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "multiply_number",
            "description": "Multipliez deux nombres.",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {
                        "type": "string",
                        "description": "Le premier nombre.",
                    },
                    "b": {
                        "type": "string",
                        "description": "Le deuxième nombre.",
                    },
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "subtract_number",
            "description": "Soustrayez deux nombres.",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {
                        "type": "string",
                        "description": "Le premier nombre.",
                    },
                    "b": {
                        "type": "string",
                        "description": "Le deuxième nombre.",
                    },
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "write_a_story",
            "description": "Écrit une histoire aléatoire.",
            "parameters": {
                "type": "object",
                "properties": {},
                "required": [],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "terminal",
            "description": "Effectuez des opérations depuis le terminal.",
            "parameters": {
                "type": "object",
                "properties": {
                    "command": {
                        "type": "string",
                        "description": "La commande que vous souhaitez lancer, par ex. `ls`, `rm`, ...",
                    },
                },
                "required": ["command"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "python",
            "description": "Appeler un interpréteur Python avec du code Python qui sera exécuté.",
            "parameters": {
                "type": "object",
                "properties": {
                    "code": {
                        "type": "string",
                        "description": "Le code Python à exécuter",
                    },
                },
                "required": ["code"],
            },
        },
    },
]
```

{% endcode %}

Nous utilisons ensuite les fonctions ci-dessous (copier-coller et exécuter), qui analyseront automatiquement les appels de fonction et appelleront le point de terminaison OpenAI pour n'importe quel modèle :

{% code overflow="wrap" expandable="true" %}

```python
from openai import OpenAI
def unsloth_inference(
    messages,
    temperature = 1.0,
    top_p = 0.95,
    top_k = -1,
    min_p = 0.01,
    repetition_penalty = 1.0,
):
    messages = messages.copy()
    openai_client = OpenAI(
        base_url = "http://127.0.0.1:8001/v1",
        api_key = "sk-no-key-required",
    )
    model_name = next(iter(openai_client.models.list())).id
    print(f"Modèle utilisé = {model_name}")
    has_tool_calls = True
    original_messages_len = len(messages)
    while has_tool_calls:
        print(f"Messages actuels = {messages}")
        response = openai_client.chat.completions.create(
            model = model_name,
            messages = messages,
            temperature = temperature,
            top_p = top_p,
            tools = tools if tools else None,
            tool_choice = "auto" if tools else None,
            extra_body = {"top_k": top_k, "min_p": min_p, "repetition_penalty" :repetition_penalty,}
        )
        tool_calls = response.choices[0].message.tool_calls or []
        content = response.choices[0].message.content or ""
        tool_calls_dict = [tc.to_dict() for tc in tool_calls] if tool_calls else tool_calls
        messages.append({"role": "assistant", "tool_calls": tool_calls_dict, "content": content,})
        for tool_call in tool_calls:
            fx, args, _id = tool_call.function.name, tool_call.function.arguments, tool_call.id
            out = MAP_FN[fx](**json.loads(args))
            messages.append({"role": "tool", "tool_call_id": _id, "name": fx, "content": str(out),})
        else:
            has_tool_calls = False
    return messages
```

{% endcode %}

Après avoir lancé GLM 5 via `llama-server` comme dans [#deploy-with-llama-server-and-openais-completion-library](#deploy-with-llama-server-and-openais-completion-library "mention") ou voir [Tool Calling Guide](/docs/fr/notions-de-base/tool-calling-guide-for-local-llms.md) pour plus de détails, nous pouvons ensuite effectuer quelques appels d’outils.

### 📊 Benchmarks

Vous pouvez voir plus bas les benchmarks sous forme de tableau :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F3QI8akFZoQFXsZ2ojtgK%2Fglm5%20bench.jpg?alt=media&amp;token=0fb5d73f-4dc4-46f5-bd76-206c26ff5e96" alt="" width="375"><figcaption></figcaption></figure>

<table data-full-width="true"><thead><tr><th>Benchmark</th><th>GLM-5</th><th>GLM-4.7</th><th>DeepSeek-V3.2</th><th>Kimi K2.5</th><th>Claude Opus 4.5</th><th>Gemini 3 Pro</th><th>GPT-5.2 (xhigh)</th></tr></thead><tbody><tr><td>HLE</td><td>30.5</td><td>24.8</td><td>25.1</td><td>31.5</td><td>28.4</td><td>37.2</td><td>35.4</td></tr><tr><td>HLE (avec outils)</td><td>50.4</td><td>42.8</td><td>40.8</td><td>51.8</td><td>43.4*</td><td>45.8*</td><td>45.5*</td></tr><tr><td>AIME 2026 I</td><td>92.7</td><td>92.9</td><td>92.7</td><td>92.5</td><td>93.3</td><td>90.6</td><td>-</td></tr><tr><td>HMMT nov. 2025</td><td>96.9</td><td>93.5</td><td>90.2</td><td>91.1</td><td>91.7</td><td>93.0</td><td>97.1</td></tr><tr><td>IMOAnswerBench</td><td>82.5</td><td>82.0</td><td>78.3</td><td>81.8</td><td>78.5</td><td>83.3</td><td>86.3</td></tr><tr><td>GPQA-Diamond</td><td>86.0</td><td>85.7</td><td>82.4</td><td>87.6</td><td>87.0</td><td>91.9</td><td>92.4</td></tr><tr><td>SWE-bench Verified</td><td>77.8</td><td>73.8</td><td>73.1</td><td>76.8</td><td>80.9</td><td>76.2</td><td>80.0</td></tr><tr><td>SWE-bench Multilingual</td><td>73.3</td><td>66.7</td><td>70.2</td><td>73.0</td><td>77.5</td><td>65.0</td><td>72.0</td></tr><tr><td>Terminal-Bench 2.0 (Terminus 2)</td><td>56.2 / 60.7 †</td><td>41.0</td><td>39.3</td><td>50.8</td><td>59.3</td><td>54.2</td><td>54.0</td></tr><tr><td>Terminal-Bench 2.0 (Claude Code)</td><td>56.2 / 61.1 †</td><td>32.8</td><td>46.4</td><td>-</td><td>57.9</td><td>-</td><td>-</td></tr><tr><td>CyberGym</td><td>43.2</td><td>23.5</td><td>17.3</td><td>41.3</td><td>50.6</td><td>39.9</td><td>-</td></tr><tr><td>BrowseComp</td><td>62.0</td><td>52.0</td><td>51.4</td><td>60.6</td><td>37.0</td><td>37.8</td><td>-</td></tr><tr><td>BrowseComp (avec gestion du contexte)</td><td>75.9</td><td>67.5</td><td>67.6</td><td>74.9</td><td>67.8</td><td>59.2</td><td>65.8</td></tr><tr><td>BrowseComp-Zh</td><td>72.7</td><td>66.6</td><td>65.0</td><td>62.3</td><td>62.4</td><td>66.8</td><td>76.1</td></tr><tr><td>τ²-Bench</td><td>89.7</td><td>87.4</td><td>85.3</td><td>80.2</td><td>91.6</td><td>90.7</td><td>85.5</td></tr><tr><td>MCP-Atlas (jeu public)</td><td>67.8</td><td>52.0</td><td>62.2</td><td>63.8</td><td>65.2</td><td>66.6</td><td>68.0</td></tr><tr><td>Tool-Decathlon</td><td>38.0</td><td>23.8</td><td>35.2</td><td>27.8</td><td>43.5</td><td>36.4</td><td>46.3</td></tr><tr><td>Vending Bench 2</td><td>$4,432.12</td><td>$2,376.82</td><td>$1,034.00</td><td>$1,198.46</td><td>$4,967.06</td><td>$5,478.16</td><td>$3,591.33</td></tr></tbody></table>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/tutorials/glm-5.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.
