> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/qwen3.8.md).

# Qwen3.8 - comment exécuter localement

Guide pour exécuter les quants Qwen3.8, y compris Qwen3.8-27B, sur votre configuration locale.

Qwen3.8 est la nouvelle famille de modèles de Qwen, comprenant Qwen3.8-**27B**, Qwen3.8-**2.4T-A95B** et Qwen3.8-**Max**. Qwen3.8-27B a **la vision** et des capacités de raisonnement, une **fenêtre de contexte de 256 K** et s'exécute localement sur des **17 Go de RAM/VRAM** configurations. Qwen3.8 excelle dans le codage agentique, la vision et les tâches de chat, et peut désormais s'exécuter via les GGUF d'Unsloth, NVFP4 et [Unsloth Desktop](#run-qwen3.8-in-unsloth-desktop). Qwen3.8-2.4T-A95B est un modèle de 2,4 T de paramètres (95 B actifs) rivalisant avec GPT-5.6 Sol.

**Mise à jour du 19 août :** Les GGUF Qwen3.8-27B utilisent désormais [Unsloth Dynamic V3.0](/docs/fr/bases/dynamic-3.0-ggufs.md) pour 10 % de précision en plus à taille égale, surpassant largement les autres.

{% columns %}
{% column %} <a href="/pages/901b8ef66232f3df49c12342d74d59aa06381de8#run-qwen3.8-guide" class="button primary">Guide d'exécution de Qwen3.8</a><a href="https://unsloth.ai/download" class="button primary">Télécharger Unsloth</a>

Merci à Qwen pour l'accès dès le premier jour. Les quantifs Unsloth incluent aussi :

* **Prise en charge du rôle développeur** pour des outils agentiques comme Codex
* [MTP activé](/docs/fr/modeles/mtp.md) pour une inférence rapide
* **Appel d'outils :** Analyse améliorée des objets imbriqués pour permettre aux outils de réussir plus souvent

Qwen3.8-2.4T-A95B en pleine précision nécessite 4,9 To de stockage et les GGUF dynamiques 1 bit [d'Unsloth](https://github.com/unslothai/unsloth) Dynamic GGUF prend **397 Go (91 % plus petit)**, et le plus grand IQ1\_S prend 508 Go.
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6aw6IjO7lnYJhSyzXYwq%2Fvolcano%20qwen.gif?alt=media&amp;token=94e56117-d10d-45e8-82dc-3e134b2b9359" alt=""><figcaption><p>Qwen3.8-27B dynamique 4 bits dans Unsloth Desktop</p></figcaption></figure>

Quantifs Unsloth :

* [Qwen3.8-**27B**-GGUF](https://huggingface.co/unsloth/Qwen3.8-27B-GGUF)
* [Qwen3.8-27B-**NVFP4**](https://huggingface.co/unsloth/Qwen3.8-27B-NVFP4)
  {% endcolumn %}
  {% endcolumns %}

### :gear: Guide d'utilisation

#### Exigences pour Qwen3.8-27B :

Qwen3.8-**27B** Les quants 4 bits fonctionnent sur 16 à 19 Go de VRAM, comme une RTX 5080, une 4090 ou un Mac avec 24 Go de RAM.\
**Tableau : exigences matérielles** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée)

<table><thead><tr><th>1 bit</th><th>2 bits</th><th>3 bits</th><th>4 bits</th><th width="128">6 bits</th><th>8 bits</th><th>BF16</th></tr></thead><tbody><tr><td>7-8 Go</td><td>9-11 Go</td><td>12-14 Go</td><td>16-19 Go</td><td>23-26 Go</td><td>31 Go</td><td>56 Go</td></tr></tbody></table>

{% hint style="info" %}
Si vous souhaitez utiliser [MTP](/docs/fr/modeles/mtp.md) pour une inférence plus rapide, prévoyez 1 à 2 Go de marge supplémentaire.
{% endhint %}

#### Qwen3.8-**2,4 T** Exigences :

* [Qwen3.8-**2.4T-A95B**-GGUF](https://huggingface.co/unsloth/Qwen3.8-2.4T-A95B-GGUF)

| Dynamic 1 bit XXXS | Dynamic 1 bit Standard | Dynamic 2 bits | Q8\_0  | BF16 (sans perte) |
| ------------------ | ---------------------- | -------------- | ------ | ----------------- |
| 397 Go             | 508 Go                 | 657 Go         | 2,6 To | 4,9 To            |

### Paramètres recommandés

#### Qwen3.8-**Paramètres 27B :**

Qwen3.8-27B est un **modèle à réflexion hybride** avec différents paramètres par défaut pour les modes réflexion et sans réflexion. Le niveau très élevé est activé par défaut, donc si vous souhaitez des traces de réflexion plus courtes, vous pouvez [ajuster l'effort de réflexion](#thinking--preserve-thinking):

| Paramètre                | Mode réflexion | Mode Instruct (sans réflexion) |
| ------------------------ | -------------- | ------------------------------ |
| `température`            | 1.0            | 0.7                            |
| `top_p`                  | 0.95           | 0.80                           |
| `top_k`                  | 20             | 20                             |
| `min_p`                  | 0.0            | 0.0                            |
| `pénalité de présence`   | 0.0            | 1.5                            |
| `pénalité de répétition` | 1.0            | 1.0                            |

* **Fenêtre de contexte maximale :** `262,144` (peut être étendue à 1 M via YaRN)
* Mode réflexion : `temperature=1.0`, `top_p=0.95`, `top_k=20`, `min_p=0.0`, `presence_penalty=0.0`, `repetition_penalty=1.0`
* Mode Instruct (ou sans réflexion) : `temperature=0.7`, `top_p=0.80`, `top_k=20`, `min_p=0.0`, `presence_penalty=1.5`, `repetition_penalty=1.0`

#### Qwen3.8-**Paramètres 2.4T :**

Qwen3.8-2.4T est **à réflexion uniquement**, tandis que Qwen3.8-Max est hybride.

| Par défaut              |
| ----------------------- |
| temperature = 1.0       |
| top\_p = 0.95           |
| top\_k = 20             |
| min\_p = 0.0            |
| presence\_penalty = 0.0 |

* Longueur de contexte = jusqu'à `1,010,000`
* `temperature=1.0`, `top_p=0.95`, `top_k=20`, `min_p=0.0`, `presence_penalty=0.0`, `repetition_penalty=1.0`

Si le modèle tient en mémoire, vous obtiendrez une génération d'environ 20 jetons/s avec des B200 et un débit supérieur à 120 jetons/s. La meilleure règle empirique : RAM+VRAM ≈ la taille du quant ; sinon, cela fonctionnera quand même, mais beaucoup plus lentement à cause du déchargement sur disque.

### 💡 Réflexion + Préserver la réflexion

{% columns %}
{% column %}
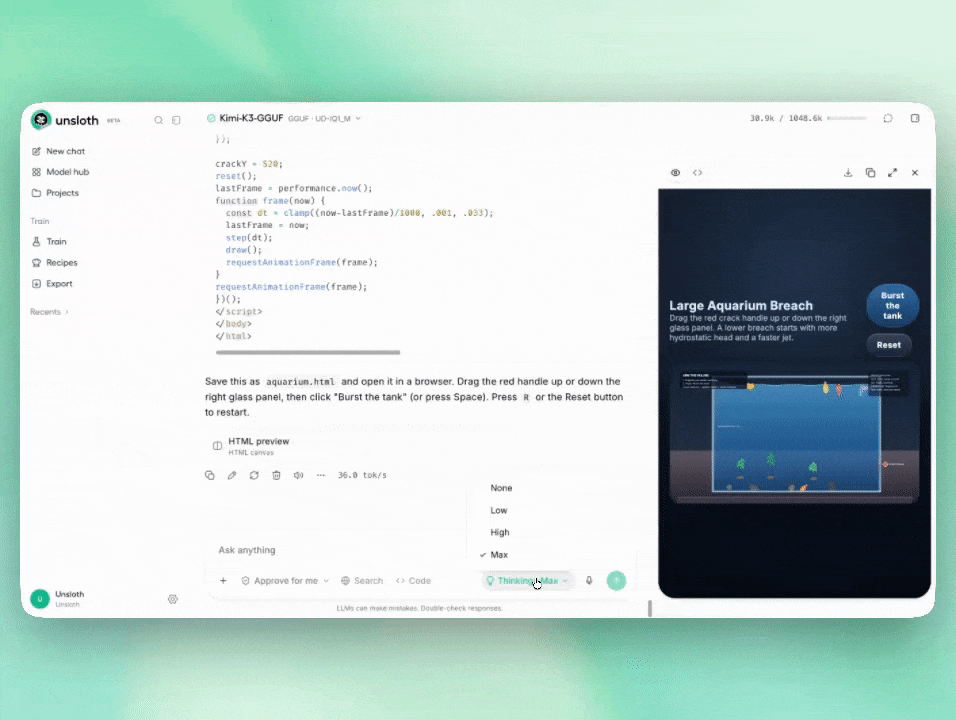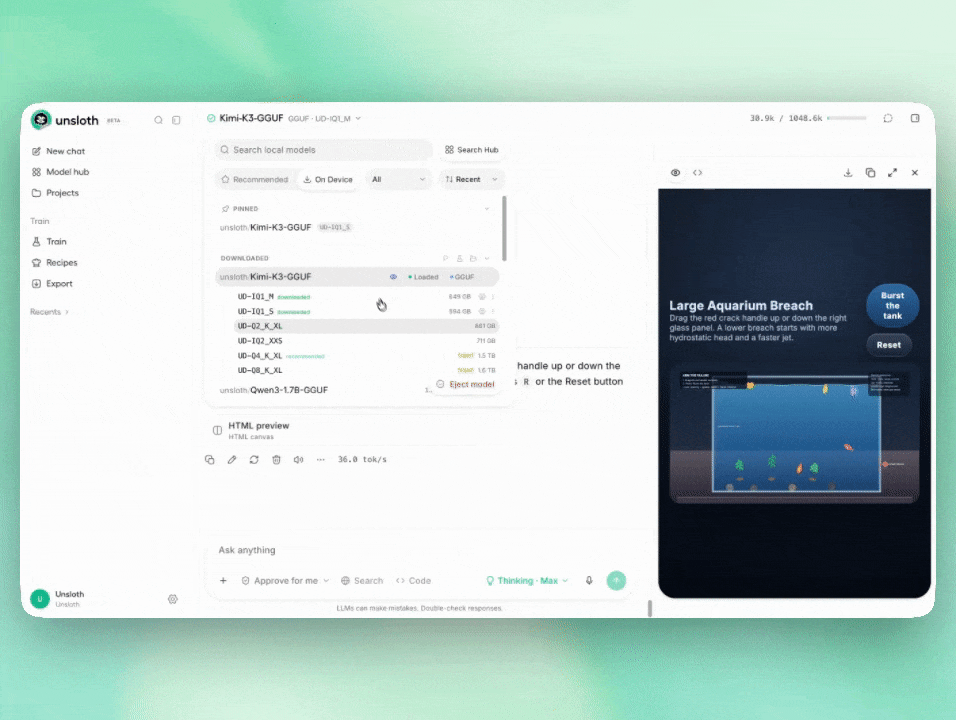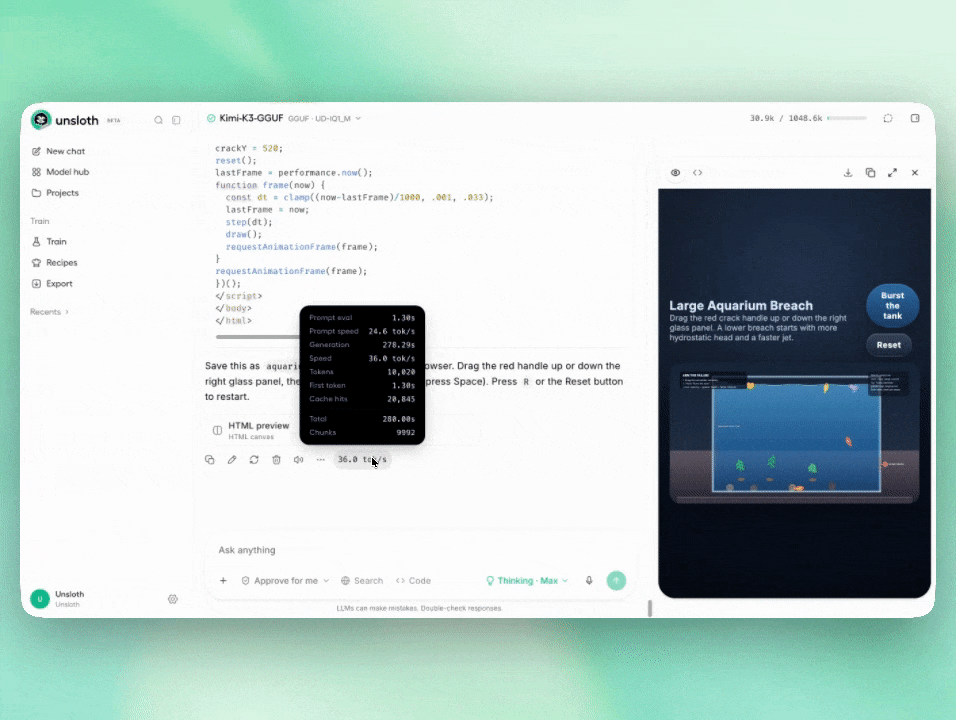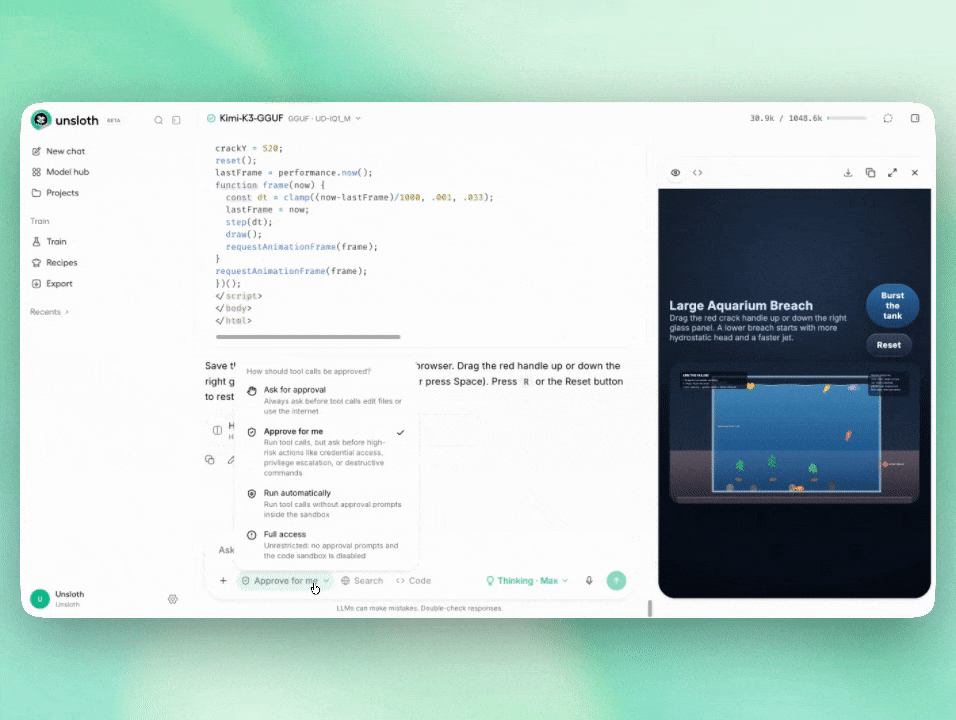
Qwen3.8 a **Préserver la réflexion** qui conserve la trace de réflexion de la conversation précédente. Cela augmente le nombre de jetons que vous utilisez, mais peut améliorer la précision dans les conversations prolongées. [d'Unsloth](#run-qwen3.8-in-unsloth-desktop) dispose des bascules « Think » et « Préserver la réflexion » pour Qwen3.8 (voir à droite) :
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FLdgmjRrb5qhpbY9PwYe8%2FScreenshot%202026-08-14%20at%2011.26.15%E2%80%AFAM.png?alt=media&amp;token=6333f5ca-196d-46ae-9efd-2e522014e6db" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

Qwen3.8-27B prend en charge `reasoning_effort`, qui peut être utilisé pour ajuster la profondeur du raisonnement et contrôler le coût. Ces bascules sont automatiquement activées dans Unsloth :

* `xhigh` (par défaut) : pour les tâches complexes nécessitant une analyse approfondie
* `medium`: équilibre entre précision et vitesse
* `low`: raisonnement efficace optimisé pour la vitesse et le coût
* none

{% hint style="warning" %}
Pour changer[ l'effort de réflexion / de raisonnement](#how-to-enable-or-disable-reasoning-and-thinking) dans `unsloth run` ou `llama-server`, utilisez `--chat-template-kwargs '{"reasoning_effort":"medium"}'`

Si vous êtes sur **Windows** PowerShell, utilisez : `--chat-template-kwargs "{\"reasoning_effort\":\"medium\"}"`

Modifiez `medium` selon le niveau de raisonnement souhaité.
{% endhint %}

## Guide d'exécution de Qwen3.8

Vous pouvez désormais exécuter Qwen3.8 dans llama.cpp et Unsloth Desktop. Pour le grand modèle Qwen3.8-2.T, nous utiliserons le 397 Go `IQ1_XXXS` quant (nommé Q1\_0) pour obtenir les meilleurs résultats en termes d'accessibilité et de précision, et il nécessitera au moins 450 Go de RAM. N'hésitez pas à changer le type de quantification.

* Hugging Face : [Qwen3.8-27B-**GGUF**](https://huggingface.co/unsloth/Qwen3.8-27B-GGUF) • [Qwen3.8-27B-**NVFP4**](https://huggingface.co/unsloth/Qwen3.8-27B-NVFP4)
* ModelScope : [Qwen3.8-27B-**GGUF**](https://www.modelscope.cn/models/unsloth/Qwen3.8-27B-GGUF) • [Qwen3.8-27B-**NVFP4**](https://www.modelscope.cn/models/unsloth/Qwen3.8-27B-NVFP4)
* **2.4T-A95B :** [Qwen3.8-**2.4T-A95B**-GGUF](https://huggingface.co/unsloth/Qwen3.8-2.4T-A95B-GGUF)

<a href="/pages/901b8ef66232f3df49c12342d74d59aa06381de8#run-qwen3.8-in-unsloth-desktop" class="button primary">Exécuter dans Unsloth Desktop</a><a href="/pages/901b8ef66232f3df49c12342d74d59aa06381de8#run-qwen3.8-in-llama.cpp" class="button secondary">Exécuter dans llama.cpp</a><a href="/pages/901b8ef66232f3df49c12342d74d59aa06381de8#run-qwen3.8-in-llama.cpp" class="button secondary">Guide NVFP4</a>

### 🦥 Exécuter Qwen3.8 dans Unsloth Desktop

Qwen3.8 peut s'exécuter dans [Unsloth Desktop](#run-qwen3.8-in-unsloth-desktop), une application UI open source pour l'IA locale. **Unsloth décharge automatiquement vers la RAM et détecte les configurations multi-GPU**. Avec Unsloth Desktop, vous pouvez exécuter des modèles localement sur **MacOS, Windows**, Linux et :

{% columns %}
{% column %}

* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally), des modèles MLX et safetensor
* [**Auto-réparation** appel d'outils](/docs/fr/nouveau/studio/chat.md#auto-healing-tool-calling) + **recherche web**
* [**exécution de code**](/docs/fr/desktop.md#code-execution) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence CPU + GPU rapide via MLX et llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
  {% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6IXaXdTVyvbrnjehlxys%2Fkimik3.gif?alt=media&amp;token=31e1213b-d7da-46e9-bc7f-3a8c402513fc" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}

#### Installer Unsloth

La façon la plus simple de commencer est de télécharger l'application [Unsloth Desktop](/docs/fr/desktop.md). Fonctionne sur [macOS](/docs/fr/commencer/install/mac.md), [Windows](/docs/fr/commencer/install/windows-installation.md) et [Linux](/docs/fr/commencer/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Télécharger Unsloth</a>

* <i class="fa-apple">:apple:</i> [Télécharger pour macOS](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Télécharger pour Windows](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Télécharger pour Linux](https://unsloth.ai/download/linux)

Ou, si vous préférez l'installer manuellement :

MacOS, Linux, WSL :

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

Windows PowerShell :

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% endstep %}

{% step %}

#### Rechercher et télécharger Qwen3.8

Rendez-vous sur [Unsloth Chat](/docs/fr/nouveau/studio/chat.md) ou le hub de modèles et recherchez Qwen3.8 dans la barre de recherche, puis téléchargez le modèle et le quant souhaités.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fo53hIyoFypinWWLa1c0x%2FScreenshot%202026-08-14%20at%2012.42.38%E2%80%AFPM.png?alt=media&amp;token=a69de985-56ee-4ef3-8e10-f669cc168346" alt="" width="563"><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### Exécuter Qwen3.8

Les paramètres d'inférence devraient être définis automatiquement lors de l'utilisation d'Unsloth, mais vous pouvez toujours les modifier manuellement. Vous pouvez également modifier la longueur de contexte, le modèle de chat et d'autres paramètres.

Pour plus d'informations, vous pouvez consulter notre [guide d'inférence Unsloth](/docs/fr/nouveau/studio/chat.md).

Par exemple, l'utilisation d'Unsloth Desktop avec le Qwen3.8 de 397 Go (91 % plus petit) vous permet d'activer les modes de réflexion, de permettre le canvas intégré, la recherche web et l'exécution de code, et bien plus encore.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fb3IiYJzHzsp2698xTim4%2Fgiffyy%20gf.gif?alt=media&amp;token=f1bda1a1-b81f-43e2-ba10-dbdc9a29c0c0" alt="" width="563"><figcaption><p>GGUF dynamique 1 bit de 397 Go, 91 % plus petit, de Qwen3.8 2.4T dans Unsloth Desktop</p></figcaption></figure>
{% endstep %}

{% step %}

#### Servir Qwen3.8 avec l'API Unsloth

Vous pouvez utiliser `unsloth run` la commande et servir Qwen3.8 via une API en utilisant `llama-server` les options d'exécution, y compris le dimensionnement du contexte, les couches GPU, le threading, l'échantillonnage, le réseau et la configuration des outils. Pour plus d'informations, consultez notre [documentation de l'API](/docs/fr/bases/api.md) ou [unsloth start](/docs/fr/integrations/unsloth-start.md).

{% code overflow="wrap" %}

```bash
unsloth run --model unsloth/qwen3.8-27B-GGUF:UD-Q4_K_XL
    --temp 1.0 \

    --top-p 0.95 \

    --top-k 20 \

    --min-p 0.0 \

    --reasoning-effort medium
```

{% endcode %}
{% endstep %}

{% step %}

#### Unsloth est maintenant prêt

Vous pouvez également faire beaucoup d'autres choses avec Qwen3.8 via Unsloth Desktop, comme :

* **Connecter des outils :** [Claude Code](/docs/fr/bases/claude-code.md), [Codex](/docs/fr/bases/codex.md), [recherche web](/docs/fr/nouveau/studio/chat.md#advanced-web-search), [MCP](/docs/fr/bases/mcp.md) et plus encore
* **Entraîner des modèles :** Ajuster finement du texte, de la diffusion, [l'embedding](/docs/fr/bases/embedding-finetuning.md), et plus encore
* **Générer des médias :** Créer et entraîner des [images](/docs/fr/bases/diffusion-image.md), de la vidéo, [TTS](/docs/fr/bases/text-to-speech-tts-fine-tuning.md) localement

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FYShiiub5gs5pCQLX6d4U%2FScreenshot%202026-08-15%20at%2012.18.24%E2%80%AFAM.png?alt=media&amp;token=d6996797-a144-4113-b4c3-155cca6c39a0" alt=""><figcaption></figcaption></figure>
{% endstep %}
{% endstepper %}

### Qwen3.8-2.4T-A95B Nouveaux types de données 1 bit

Nous avons étendu IQ1\_S dans llama.cpp, qui est à 1,5625 bits par poids, à 1,1875 bpw en réduisant le nombre d'entrées dans le codebook - nous avons constaté que cela fonctionne bien pour les grands modèles et peut encore conserver beaucoup de précision - nous avons également constaté que ces nouveaux types de données conviennent à la quantification post-entraînement (PTQ) sans nécessiter de QAT ni de QAD (entraînement / distillation conscient de la quantification). [Qwen3.8-**2.4T-A95B**-GGUF](https://huggingface.co/unsloth/Qwen3.8-2.4T-A95B-GGUF)

En raison de problèmes de nommage, nous avons utilisé TQ2\_0, TQ1\_0 et Q1\_0, sinon cela n'apparaîtra pas dans le dépôt HF.

<table><thead><tr><th>Type</th><th width="147.60000610351562">Nommage</th><th width="114.39996337890625" align="right">BPW</th><th width="106.20001220703125" align="right"># d'entrées</th><th width="113.413330078125" align="right">Bits d'index</th><th width="106.4000244140625" align="right">Bloc</th></tr></thead><tbody><tr><td>IQ1_S</td><td>IQ1_S</td><td align="right"><strong>1.5625</strong></td><td align="right">2048</td><td align="right">11</td><td align="right">50 B</td></tr><tr><td>UD-IQ1_XS</td><td>TQ2_0</td><td align="right">1.4375</td><td align="right">1024</td><td align="right">10</td><td align="right">46 B</td></tr><tr><td>UD-IQ1_XXS</td><td>TQ1_0</td><td align="right">1.3125</td><td align="right">512</td><td align="right">9</td><td align="right">42 B</td></tr><tr><td>UD-IQ1_XXXS</td><td>Q1_0</td><td align="right"><strong>1.1875</strong></td><td align="right">256</td><td align="right">8</td><td align="right">38 B</td></tr></tbody></table>

Nous exécutons encore des benchmarks pour les nouveaux types de données, mais pour d'autres grands modèles, nous obtenons **de bons résultats sans aucun QAT / QAD**:

| Type         |     Gio |      PPL |      KLD |  top-p |
| ------------ | ------: | -------: | -------: | -----: |
| IQ1\_S       | 553.204 | 2.578876 | 0.564553 | 78.882 |
| UD-IQ1\_XS   | 513.583 | 2.931261 | 0.690161 | 75.726 |
| UD-IQ1\_XXS  | 473.961 | 3.540383 | 0.876007 | 71.284 |
| UD-IQ1\_XXXS | 434.340 | 4.488796 | 1.109944 | 66.257 |

### :llama: Exécuter Qwen3.8 dans llama.cpp

{% stepper %}
{% step %}
Nous devons utiliser la branche spécifique IQ1\_XXXS [ici](https://github.com/unslothai/llama.cpp/pull/61). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` en `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou souhaitez simplement une inférence sur CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis poursuivez normalement - la prise en charge de Metal est activée par défaut.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone --branch iq1-narrow https://github.com/unslothai/llama.cpp
cmake llama.cpp -B llama.cpp/build \

    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
Si vous voulez simplement exécuter les versions standard `IQ1_S` et les autres quants, alors compilez llama.cpp normalement :

{% code overflow="wrap" %}

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \

    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endcode %}
{% endstep %}

{% step %}
Téléchargez le modèle via (après avoir installé `pip install huggingface_hub`). Vous pouvez choisir `Q1_0` pour `IQ1_XXXS` ou d'autres versions quantifiées comme `Q8_0` . Si les téléchargements se bloquent, voir : [Dépannage Hugging Face Hub, XET](/docs/fr/bases/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

**Qwen3.8-27B :**

```bash
pip install -U "huggingface_hub[cli]"
hf download unsloth/Qwen3.8-27B-GGUF \

    --local-dir unsloth/Qwen3.8-27B-GGUF \

    --include "*UD-Q4_K_XL*" # Utilisez "*UD-Q3_K_XL*" pour 3 bits
```

**Qwen3.8-2.4T :**

```bash
pip install -U "huggingface_hub[cli]"
hf download unsloth/Qwen3.8-2.4T-A95B-GGUF \

    --local-dir unsloth/Qwen3.8-2.4T-A95B-GGUF \

    --include "*Q1_0*" # Utilisez "*IQ2_XXS*" pour 2 bits
```

{% endstep %}

{% step %}
Pour exécuter le modèle dans llama-cli, suivez les extraits de code ci-dessous :\
N'oubliez pas de [modifier les paramètres](#recommended-settings) en fonction de votre cas d'utilisation.

**Qwen3.8-27B :**

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \

    --model unsloth/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-Q4_K_XL.gguf \

    --temp 1.0 \

    --top-p 0.95 \

    --top-k 20 \

    --min-p 0.0
```

{% endcode %}

**Qwen3.8-2.4T :**

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \

    --model unsloth/Qwen3.8-2.4T-A95B-GGUF/UD-Q1_0/Qwen3.8-2.4T-A95B-UD-Q1_0-00001-of-00010.gguf \

    --temp 1.0 \

    --top-p 0.95 \

    --top-k 20 \

    --min-p 0.0
```

{% endcode %}
{% endstep %}

{% step %}
Pour exécuter le UD-IQ1\_S général, vous pouvez faire :

**Qwen3.8-2.4T :**

{% code overflow="wrap" %}

```bash
pip install -U "huggingface_hub[cli]"
hf download unsloth/Qwen3.8-2.4T-A95B-GGUF \

    --local-dir unsloth/Qwen3.8-2.4T-A95B-GGFF \

    --include "*IQ1_S*" # Utilisez "*IQ2_XXS*" pour 2 bits
```

{% endcode %}
{% endstep %}

{% step %}
Puis pour l'exécuter :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \

    --model unsloth/Qwen3.8-2.4T-A95B-GGUF/UD-IQ1_S/Qwen3.8-2.4T-A95B-UD-IQ1_S-00001-of-00012.gguf \
    --temp 1.0 \

    --top-p 0.95 \

    --top-k 20 \

    --min-p 0.0
```

{% endcode %}
{% endstep %}
{% endstepper %}

### ⚡️NVFP4

Comme pour Qwen3.6, nous publions également de nouveaux [Qwen3.8 NVFP4 dynamique](/docs/fr/bases/nvfp4.md)-27B quantifiés qui s'exécutent **\~1,5× plus rapide** que les checkpoints BF16, avec **de meilleures performances** et des tailles de fichiers comparables. Exécutez Qwen3.8-27B NVFP4 **1,5x plus rapide** sur **24 Go de VRAM.** Nous avons également ajouté **la calibration du cache KV FP8** pour des longueurs de contexte 2x plus longues ! NVFP4 nécessite les GPU Blackwell de NVIDIA comme les RTX 50X, DGX Spark (voir [#dgx-spark-with-nvfp4-quants](#dgx-spark-with-nvfp4-quants "mention")), les GPU B200, B300. Pour les GPU plus anciens, nos GGUF fonctionnent bien ! Vous pouvez exécuter des quantifications NVFP4 dans [vLLM](#vllm) pour l'instant uniquement (SGLang n'est pas pris en charge).

* [Qwen3.8-27B-**NVFP4**](https://huggingface.co/unsloth/Qwen3.8-27B-NVFP4) quantification

<table><thead><tr><th width="90" align="right">lot</th><th width="114.5999755859375" align="right">tok/s total BF16</th><th width="122.60003662109375" align="right">tok/s total NVFP4</th><th width="122" align="right">accélération</th><th width="137.4000244140625" align="right">BF16 par utilisateur</th><th align="right">NVFP4 par utilisateur</th></tr></thead><tbody><tr><td align="right">1</td><td align="right">89.8</td><td align="right"><strong>133.7</strong></td><td align="right">1,49x</td><td align="right">89.8</td><td align="right"><strong>133.7</strong></td></tr><tr><td align="right">8</td><td align="right">649.4</td><td align="right"><strong>938.8</strong></td><td align="right">1,45x</td><td align="right">81.2</td><td align="right"><strong>117.3</strong></td></tr><tr><td align="right">32</td><td align="right">1983.0</td><td align="right"><strong>2787.0</strong></td><td align="right">1,41x</td><td align="right">62.0</td><td align="right"><strong>87.1</strong></td></tr><tr><td align="right">64</td><td align="right">3048.5</td><td align="right"><strong>4407.2</strong></td><td align="right">1,45x</td><td align="right">47.6</td><td align="right"><strong>68.9</strong></td></tr></tbody></table>

Voir ci-dessous les benchmarks précédents effectués pour Qwen3.6, en comparant également à d'autres implémentations NVFP4 qui utilisent des activations 16 bits à nos activations NVFP4 :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F8zM7cg0Xgo2pAlop1iPW%2F01_qwen36_combined_throughput.png?alt=media&amp;token=23131a96-4c41-42d7-aa16-5bfb21bb44a3" alt="" width="563"><figcaption></figcaption></figure>

Tous les benchmarks utilisent 1× B200 avec une concurrence de 128. Une concurrence plus élevée peut porter le 35B à 17 561 jetons/s.&#x20;

Pour les benchmarks de précision, nous avons exécuté KLD et l'accord Top-1 % sur Code, Chat et de nombreux domaines. NVFP4 offre de manière cohérente un taux de récupération de précision de 92 % à 97 % par rapport au BF16

| corpus            |   moyenne KLD | accord top-1 |
| ----------------- | ------------: | -----------: |
| zh                |       0.01628 |       93.55% |
| code              |       0.02600 |       96.68% |
| refgen            |       0.03993 |       94.46% |
| chat              |       0.05818 |       92.15% |
| ja / ko / ru / es | 0.0124-0.0155 |       94-95% |

Pour les benchmarks de précision pour Qwen 3.6, nous avons mené MMLU-Pro, AIME 2025, GPQA pour FP8, BF16, le NVFP4 de NVIDIA et nos NVFP4 — nous montrons que nos quantifications plus rapides obtiennent des résultats similaires partout :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFhOUUUlRBj3dafGnmvhK%2F03_qwen36_combined_accuracy(7).png?alt=media&amp;token=9178447f-d5ae-4489-9bdc-73b2b7b1631b" alt=""><figcaption></figcaption></figure>

Pour plus d'informations, vous pouvez lire notre [article de blog sur les quantifications dynamiques NVFP4](/docs/fr/bases/nvfp4.md).

Pour exécuter des quantifications NVFP4, voir ci-dessous les commandes pour exécuter Qwen3.8-27B dans [vLLM](/docs/fr/bases/inference-and-deployment/vllm-guide.md) ou [SGLang](/docs/fr/bases/inference-and-deployment/sglang-guide.md):

#### **vLLM:**

Pour installer vLLM dans un venv séparé :

{% code overflow="wrap" expandable="true" %}

```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \
    --torch-backend=auto
```

{% endcode %}

Puis, pour servir la variante 27B :

```shell
vllm serve unsloth/Qwen3.8-27B-NVFP4
```

Pour activer MTP / le décodage spéculatif (décodage plus rapide mais avec un débit un peu moindre), utilisez :

```bash
vllm serve unsloth/Qwen3.8-27B-NVFP4
    --speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
```

Si vous rencontrez des problèmes avec Torchcodec, assurez-vous d'effectuer ce qui suit puis relancez vllm.

{% code overflow="wrap" expandable="true" %}

```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```

{% endcode %}

#### **SGLang :**

Si vous utilisez SGLang, vous devez utiliser **la version v0.5.19 de SGLang** sinon cela ne fonctionnera pas, car nous quantifions lm\_head en FP8.

{% hint style="info" %}
vLLM dispose d'un `noyau CompressedTensorsW8A8Fp8` qui prend en charge cela, tandis que SGLang v0.5.19 ne peut pas charger le lm\_head FP8. v0.5.19 fonctionne maintenant !
{% endhint %}

Pour sglang après avoir installé la dernière version :

{% code overflow="wrap" %}

```bash
uv pip install sglang sglang-kernel \
  --extra-index-url https://sgl-project.github.io/whl/cu130/ \
  --extra-index-url https://download.pytorch.org/whl/cu130 \
  --index-strategy unsafe-best-match
```

{% endcode %}

Vous pouvez ensuite le servir :

```bash
sglang serve unsloth/Qwen3.8-27B-NVFP4
```

Pour activer MTP, utilisez :

{% code overflow="wrap" %}

```bash
sglang serve unsloth/Qwen3.8-27B-NVFP4 --speculative-algorithm EAGLE \
    --speculative-num-steps 3 --speculative-eagle-topk 1  --speculative-num-draft-tokens 4
```

{% endcode %}

### :exploding\_head:Analyse de quantification

Les quantifications NVFP4 sont 1,5x plus rapides que BF16 et conservent une précision top-1 % de 92 à 97 %.

Nous avons utilisé [Dynamic 3.0 GGUFs](/docs/fr/bases/dynamic-3.0-ggufs.md) pour rendre Qwen3.8-27B bien meilleur !

Graphique de précision top-1 % tel qu'affiché dans UD-3 pour Qwen3.8-27B :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FVg5FHPxOpmaJ1r3ciw4u%2Fimage.png?alt=media&amp;token=107ef044-0181-489b-b6ae-da218e16c98b" alt=""><figcaption></figcaption></figure>

Et la moyenne KLD pour Qwen3.8 :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Ft8BnEqBLUQGUgu2cAKKI%2Fimage.png?alt=media&amp;token=912d5b6a-540f-4ee0-9208-f5ad45776341" alt=""><figcaption></figcaption></figure>

### 📊 Benchmarks

Pour les benchmarks de quantification GGUF, vous pouvez voir ci-dessus notre [analyse de quantification](#quantization-analysis) ou [article Dynamic V3.0](/docs/fr/bases/dynamic-3.0-ggufs.md).

#### Qwen3.8-**27B**

Voir plus bas pour les benchmarks du tableau :

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWijY5wYmLx70Ao2ol7Tj%2Fqwen%20benchmark%201.jpeg?alt=media&amp;token=f69ebf50-cf35-426f-a610-8eeb32151d90" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FELa2vq8Wh3oelQi6Bf07%2Fqwen%20benchmark%202.jpeg?alt=media&amp;token=2cc6d085-630d-4fa1-9b50-784b22a1fb04" alt=""><figcaption></figcaption></figure></div>

#### Performances textuelles

| Benchmark                                                 | Qwen3.8-27B                  | Qwen3.6-27B          | Qwen3.7-Plus         | Muse Glimmer-30B | Opus4.6 Max |
| --------------------------------------------------------- | ---------------------------- | -------------------- | -------------------- | ---------------- | ----------- |
| **Codage**                                                |                              |                      |                      |                  |             |
| Codage agentique en terminalTerminal Bench 2.1 (Terminus) | 73.0                         | 63.4                 | 64.0                 | 51.7             | **78.2**    |
| Codage agentiqueSWE-bench Pro                             | **61.7**                     | 53.5                 | 57.6                 | 51.2             | 53.4        |
| Génération de code au niveau du dépôtNL2Repo-Bench        | 42.3                         | 36.2                 | 41.1                 | --               | **47.6**    |
| Codage agentiqueDeepSWE 1.1                               | **42.2**                     | 13.3                 | 14.2                 | --               | --          |
| Ingénierie logicielleQwenSWEBench                         | **79.0**                     | 49.3                 | 59.2                 | --               | 63.8        |
| **Agent**                                                 |                              |                      |                      |                  |             |
| Travail de bureau à long termeCoWorkBench                 | **70.7**                     | 61.0                 | 65.1                 | --               | 68.2        |
| Tâches professionnellesJobBench                           | **33.4**                     | 21.8                 | 27.6                 | --               | --          |
| Tâches agentiques de pointeAgents' Last Exam              | Pass\@1**20.4**Score**42.9** | Pass\@110.6Score27.3 | Pass\@113.2Score33.6 | --               | --          |
| Général                                                   |                              |                      |                      |                  |             |
| Suivi des instructionsIFBench                             | **79.5**                     | 69.1                 | 79.1                 | 77.0             | 62.5        |
| Raisonnement scientifiqueGPQA Diamond                     | 89.2                         | 87.8                 | 90.3                 | 83.5             | **91.3**    |
| Raisonnement multidisciplinaireHLE                        | 30.8                         | 24.0                 | 34.7                 | 22.0             | **40.0**    |
| Programmation compétitiveLiveCodeBench v6                 | **90.3**                     | 83.9                 | 89.6                 | --               | 88.8        |

#### Qwen3.8-**2.4T-A95B**

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWP0nBgaQcnnAGjqG1jyQ%2Fqwen3.8%20bench.jpg?alt=media&amp;token=92a0d19c-51cb-4df2-a4f5-334fe08e6a21" alt=""><figcaption></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://unsloth.ai/docs/fr/modeles/qwen3.8.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.