> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/qwen3.8-next.md).

# Qwen3.8-Flash-Next : comment l'exécuter localement

Guide pour exécuter Qwen3.8-Flash-Next localement.

Qwen3.8-Flash-Next est un nouveau modèle à poids ouverts, **à 125 milliards de paramètres** un modèle multimodal MoE de Qwen. Construit sur la nouvelle architecture Qwen4, il prend en charge une fenêtre de contexte de 262K et un raisonnement avancé. [Qwen3.8](/docs/fr/modeles/qwen3.8.md)-Flash-Next surpasse Claude-4.6-Opus (Max) et peut s’exécuter localement sur des appareils avec **75 Go de RAM**/mémoire unifiée sans nécessiter de VRAM GPU. Pour exécuter le modèle, utilisez nos [GGUF](https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF) via llama.cpp ou [Unsloth Desktop](/docs/fr/desktop.md). Merci à Qwen pour l’accès dès le premier jour.

{% columns %}
{% column %}
**Le 1 bit nécessite 75 Go** et utilise du 4 bits pour le Ngram / PLE. C’est **79 % plus petit** que BF16 (355 Go), et conserve une **précision top-1 % de 80 %**.

<a href="/pages/9bd1a468b95c53313e43e65d5043f58f32486b2e#run-qwen3.8-flash-next-in-unsloth" class="button primary">Exécutez Qwen3.8-Flash</a><a href="https://unsloth.ai/download" class="button secondary">Télécharger Unsloth</a>

{% hint style="success" %}
[**MTP**](#mtp-guide) est là ! Exécutez Qwen3.8-Flash 1,3 à 1,7x plus vite dans [Unsloth Desktop](#run-qwen3.8-flash-next-in-unsloth)!
{% endhint %}
{% endcolumn %}

{% column %}

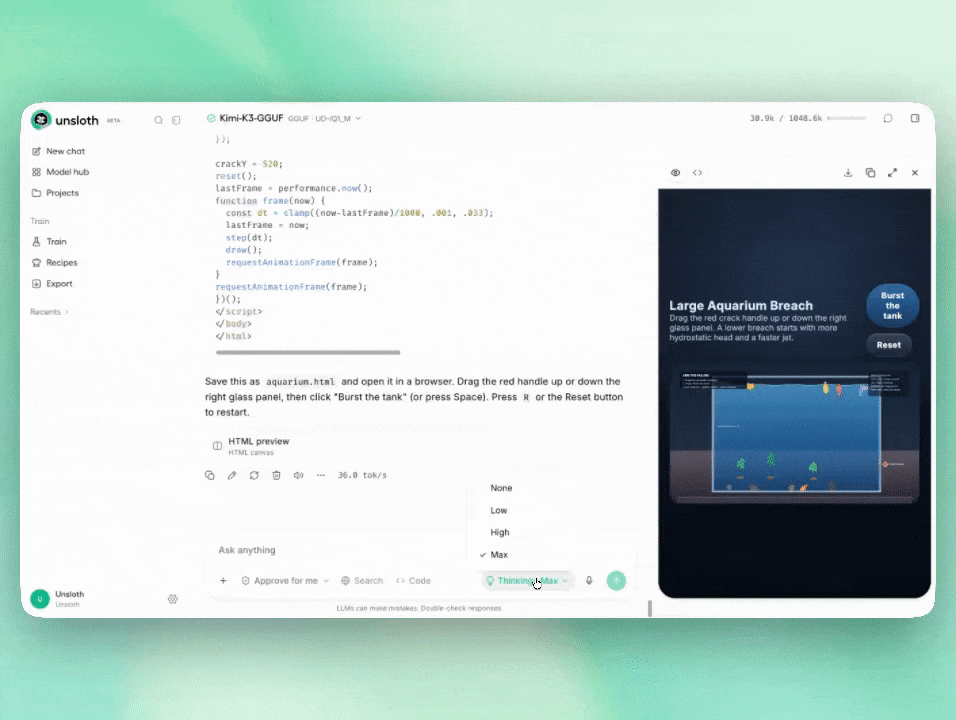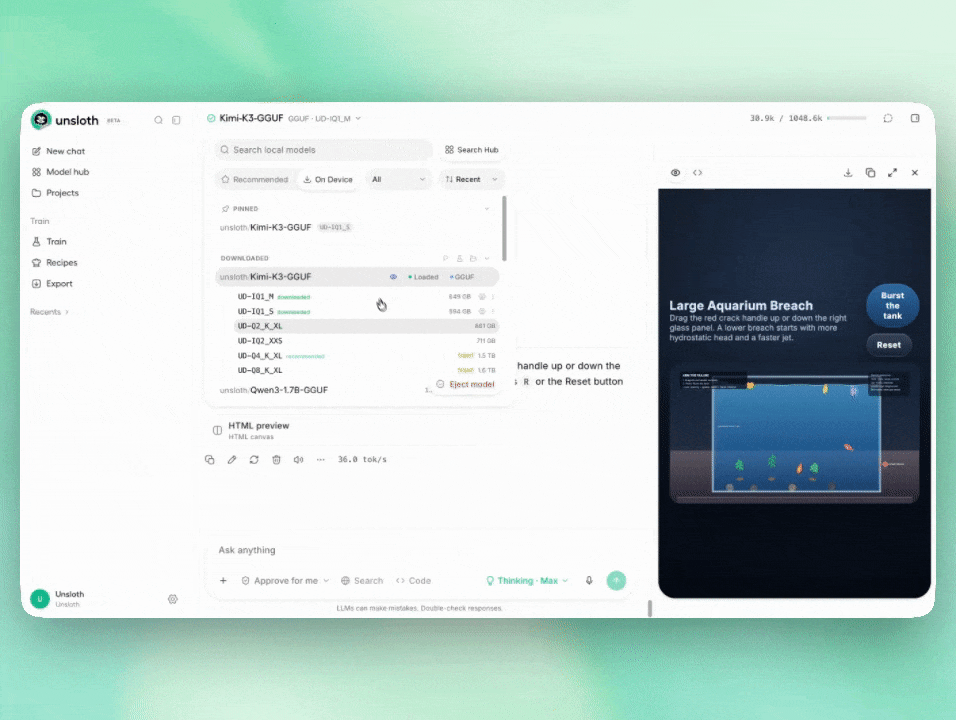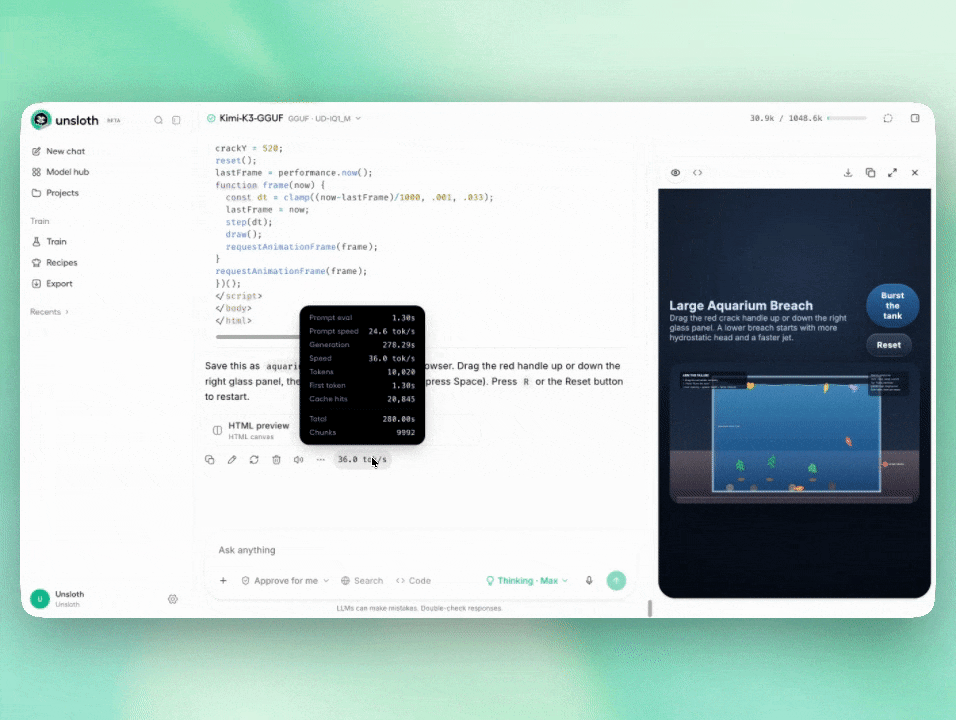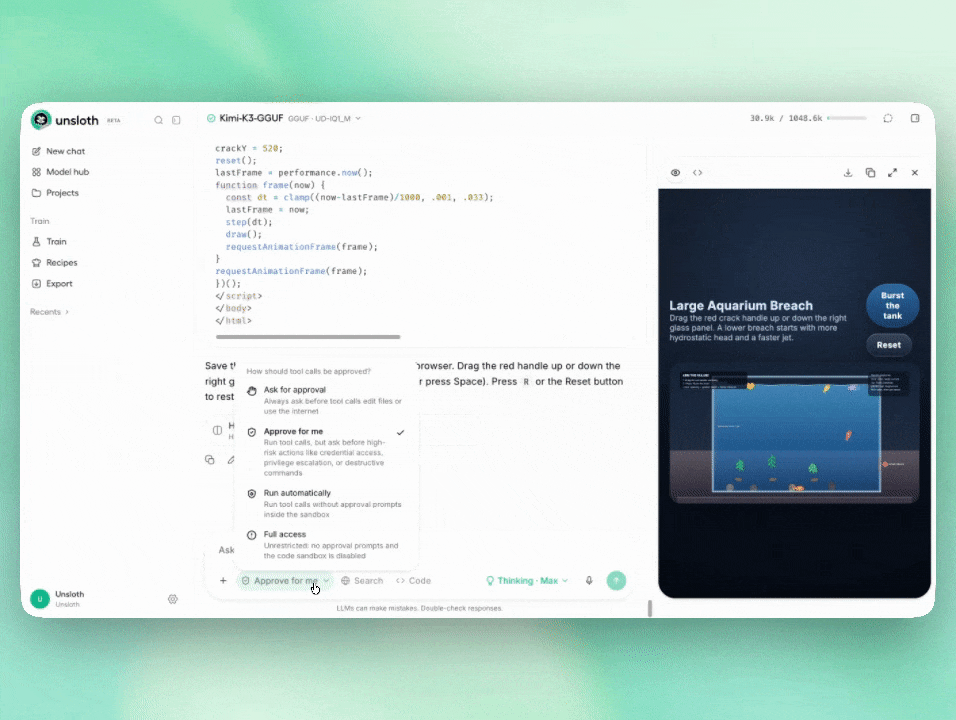
<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F1YneA51oWzaIiwep9H5I%2F1000024423.gif?alt=media&amp;token=40a169cc-12f1-403a-898c-b310f81ff52a" alt=""><figcaption><p>Qwen3.8-Flash en 4 bits s’exécutant dans Unsloth</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

### :gear: Guide d’utilisation

Que vous exécutiez **Qwen3.8-Flash-Next** sur un CPU avec de la RAM système ou sur un GPU avec de la VRAM peut faire une différence relativement faible. Son architecture unique permet une inférence utilisant la RAM ou la mémoire unifiée pour atteindre des performances plus proches de celles de la VRAM GPU que ce qui est habituel pour d’autres modèles. Cela le rend particulièrement adapté aux Mac, aux systèmes NVIDIA DGX Spark et à d’autres appareils dotés de grandes capacités mémoire.

Vous aurez besoin d’au moins **75 Go de RAM ou de mémoire unifiée** pour exécuter le modèle. Sa plus petite version quantifiée en 1 bit est plus volumineuse que d’habitude en raison des nouvelles couches Ngram ou des embeddings par couche, qui ressemblent à une table de recherche. Cependant, cela signifie aussi que la quantification est moins agressive, ce qui permet au modèle de conserver davantage de sa précision d’origine que les modèles davantage quantifiés. Vous pouvez également décharger la couche PLE / Ngram sur SSD et utiliser mmap, ce qui permet de réduire l’utilisation de la VRAM CPU et GPU.

#### Exigences de Qwen3.8-Flash-Next :

La plus petite quantification fonctionne avec 75 Go de RAM, il est donc préférable d’avoir un appareil avec 96 Go de RAM/mémoire unifiée.\
**Tableau : exigences matérielles** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée)

<table><thead><tr><th>1 bit</th><th>2 bits</th><th>3 bits</th><th>4 bits</th><th width="128">5 bits</th><th>8 bits</th><th>BF16</th></tr></thead><tbody><tr><td>75 Go</td><td>79 Go</td><td>90 Go</td><td>96-114 Go</td><td>163 Go</td><td>200 Go</td><td>355 Go</td></tr></tbody></table>

{% hint style="info" %}
Si vous souhaitez utiliser [MTP](/docs/fr/modeles/mtp.md) pour une inférence plus rapide, prévoyez 1 à 2 Go d’espace libre supplémentaire.
{% endhint %}

### Paramètres recommandés

Qwen3.8-Flash-Next est un **modèle à raisonnement hybride** avec différents paramètres par défaut pour les modes de raisonnement et de non-raisonnement. Extra high est activé par défaut, donc si vous souhaitez des traces de raisonnement plus courtes, vous pouvez [ajuster l’effort de raisonnement](#thinking--preserve-thinking):

| Paramètre            | Mode raisonnement | Mode Instruct (sans raisonnement) |
| -------------------- | ----------------- | --------------------------------- |
| `température`        | 1.0               | 0.7                               |
| `top_p`              | 0.95              | 0.80                              |
| `top_k`              | 20                | 20                                |
| `min_p`              | 0.0               | 0.0                               |
| `presence_penalty`   | 0.0               | 1.5                               |
| `repetition_penalty` | 1.0               | 1.0                               |

* Longueur de contexte = jusqu’à `262,144`
* Mode raisonnement : `température=1.0`, `top_p=0.95`, `top_k=20`, `min_p=0.0`, `presence_penalty=0.0`, `repetition_penalty=1.0`
* Mode Instruct (ou sans raisonnement) : `température=0.7`, `top_p=0.80`, `top_k=20`, `min_p=0.0`, `presence_penalty=1.5`, `repetition_penalty=1.0`

### 💡 Raisonnement + Préserver le raisonnement

{% columns %}
{% column %}
Qwen3.8-Flash-Next dispose de **Préserver le raisonnement** qui conserve la trace de raisonnement de la conversation précédente. Cela augmente le nombre de jetons utilisés, mais peut améliorer la précision dans les conversations continues. [Unsloth](#run-qwen3.8-in-unsloth-desktop) propose des bascules « Think » et « Preserved Thinking » pour Qwen3.8 (voir à droite) :
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FLdgmjRrb5qhpbY9PwYe8%2FScreenshot%202026-08-14%20at%2011.26.15%E2%80%AFAM.png?alt=media&amp;token=6333f5ca-196d-46ae-9efd-2e522014e6db" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

Qwen3.8-Flash-Next prend en charge `reasoning_effort`, qui peut être utilisé pour ajuster la profondeur du raisonnement et contrôler les coûts. Ces bascules sont automatiquement activées dans Unsloth :

* `xhigh` (par défaut) : pour les tâches complexes nécessitant une analyse approfondie
* `medium`: équilibre entre précision et vitesse
* `low`: raisonnement efficace optimisant la vitesse et le coût
* none

{% hint style="warning" %}
Pour modifier[ l’effort de](#how-to-enable-or-disable-reasoning-and-thinking) raisonnement / réflexion `dans` ou `llama-server`, utilisez `--chat-template-kwargs '{"reasoning_effort":"medium"}'`

Si vous êtes sous **Windows** Powershell, utilisez : `--chat-template-kwargs "{\"reasoning_effort\":\"medium\"}"`

Modifiez `medium` au niveau de raisonnement souhaité.
{% endhint %}

### Analyse de la quantification

Nous avons exécuté KLD pour les quantifications de Qwen3.8-Flash, et montrons qu’une récupération de 80 % de la précision top-1 % est possible avec 79 % d’utilisation du disque en moins. La nouvelle architecture utilise des PLE / Ngrams, et ceux-ci ne sont pas quantifiés aussi fortement (minimum 4 bits) car ils ont un schéma d’accès aléatoire, et les quantifier fortement endommagera le modèle.

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FPemX6jyt4OWohwHfcjqo%2Fqwen38_flash_unsloth_top1_accuracy_new_data.png?alt=media&amp;token=3fd7713b-e9d9-43d4-bbca-96d56df43a80" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F8bGa4A4jbGsn0qrNY6Gc%2Fqwen38_flash_unsloth_kld_new_data.png?alt=media&amp;token=45ac0e9a-c9b3-4530-90f6-ed8a2328ef08" alt=""><figcaption></figcaption></figure></div>

| quant        | Go    | top-1 % | KLD moyen | KLD à 99,9 % |
| ------------ | ----- | ------- | --------- | ------------ |
| UD-IQ1\_S    | 72.5  | 77.325  | 0.396070  | 7.2126       |
| UD-IQ1\_M    | 74.5  | 79.691  | 0.314739  | 6.1965       |
| UD-Q2\_K\_XL | 78.9  | 82.715  | 0.224607  | 4.9121       |
| UD-IQ3\_XXS  | 82.0  | 85.414  | 0.165120  | 4.0375       |
| UD-Q3\_K\_XL | 90.0  | 88.315  | 0.106504  | 3.0538       |
| UD-IQ4\_XS   | 93.7  | 89.554  | 0.083630  | 2.3677       |
| UD-Q4\_K\_XL | 111.3 | 92.255  | 0.046893  | 1.5468       |
| UD-Q5\_K\_XL | 158.3 | 93.680  | 0.030415  | 1.0036       |
| UD-Q6\_K\_XL | 169.2 | 94.089  | 0.027091  | 0.8416       |
| Q8\_0        | 188.2 | 94.122  | 0.026574  | 0.8118       |

## Guide d’exécution de Qwen3.8-Flash-Next

Vous pouvez désormais exécuter Qwen3.8-Flash-Next dans Unsloth Desktop et llama.cpp. N’hésitez pas à changer le type de quantification.

* Hugging Face : [Qwen3.8-Flash-Next-**GGUF**](https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF)
* ModelScope : [Qwen3.8-Flash-Next-GGUF](https://www.modelscope.cn/models/unsloth/Qwen3.8-Flash-Next-GGUF)

<a href="/pages/901b8ef66232f3df49c12342d74d59aa06381de8#run-qwen3.8-in-unsloth-desktop" class="button primary">Exécuter dans Unsloth Desktop</a><a href="/pages/901b8ef66232f3df49c12342d74d59aa06381de8#run-qwen3.8-in-llama.cpp" class="button secondary">Exécuter dans llama.cpp</a><a href="/docs/fr/modeles/qwen3.8-next.md#mtp-guide" class="button primary">Guide MTP</a>

{% hint style="success" %}
Qwen3.8-Flash-Next est maintenant disponible pour une exécution locale dans [Unsloth Desktop](#run-qwen3.8-flash-next-in-unsloth)!
{% endhint %}

### 🦥 Exécutez Qwen3.8-Flash-Next dans Unsloth

Qwen3.8-Flash-Next peut désormais s’exécuter dans [Unsloth Desktop](#run-qwen3.8-in-unsloth-desktop), une application UI open source pour l’IA locale. **Unsloth décharge automatiquement vers la RAM et détecte les configurations multiGPU**. Avec Unsloth Desktop, vous pouvez exécuter des modèles localement sur **MacOS, Windows**, Linux et :

{% columns %}
{% column %}

* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally), des modèles MLX et safetensor
* [**Auto-réparation** appel d’outils](/docs/fr/nouveau/studio/chat.md#auto-healing-tool-calling) + **recherche web**
* [**Exécution de code**](/docs/fr/desktop.md#code-execution) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) ajustement des paramètres (temp, top-p, etc.)
* Inférence CPU + GPU rapide via MLX et llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
  {% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6IXaXdTVyvbrnjehlxys%2Fkimik3.gif?alt=media&amp;token=31e1213b-d7da-46e9-bc7f-3a8c402513fc" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}

#### Installer Unsloth

La manière la plus simple de commencer est de télécharger l’ [application Unsloth Desktop](/docs/fr/desktop.md). Fonctionne sur [macOS](/docs/fr/commencer/install/mac.md), [Windows](/docs/fr/commencer/install/windows-installation.md), et [Linux](/docs/fr/commencer/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Télécharger Unsloth</a>

* <i class="fa-apple">:apple:</i> [Télécharger pour macOS](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Télécharger pour Windows](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Télécharger pour Linux](https://unsloth.ai/download/linux)

Ou, si vous préférez l’installation manuelle :

MacOS, Linux, WSL :

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

Windows PowerShell :

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% endstep %}

{% step %}

#### Rechercher et télécharger Qwen3.8-Flash-Next

Allez dans [Unsloth Chat](/docs/fr/nouveau/studio/chat.md) ou le hub de modèles et recherchez Qwen3.8-Flash dans la barre de recherche, puis téléchargez le modèle et la quantification souhaités.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FiEMEgtWrGc0DMZ4FLRez%2FScreenshot%202026-08-27%20at%204.21.05%E2%80%AFAM.png?alt=media&amp;token=94ad9ccf-f882-48b0-8aaa-83e90bfc2630" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### Exécuter Qwen3.8-Flash-Next

MTP est activé automatiquement, mais vous pouvez le désactiver. Les paramètres d’inférence devraient être définis automatiquement lors de l’utilisation d’Unsloth, mais vous pouvez toujours les modifier manuellement. Vous pouvez également modifier la longueur du contexte, le modèle de chat et d’autres paramètres.

Pour plus d’informations, vous pouvez consulter notre [guide d’inférence Unsloth](/docs/fr/nouveau/studio/chat.md).

Par exemple, utiliser Unsloth Desktop avec le Qwen3.8 de 397 Go (-91 % plus petit) vous permet d’activer les modes de raisonnement, d’autoriser le canevas intégré, la recherche web et l’exécution de code, et bien plus encore.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F1YneA51oWzaIiwep9H5I%2F1000024423.gif?alt=media&amp;token=40a169cc-12f1-403a-898c-b310f81ff52a" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### Servir Qwen3.8-Flash-Next avec l’API Unsloth

Vous pouvez utiliser `dans` la commande et servir Qwen3.8 via une API en utilisant `llama-server` des drapeaux d’exécution, y compris la taille du contexte, les couches GPU, le threading, l’échantillonnage, le réseau et la configuration des outils. Pour plus d’informations, voir nos [docs API](/docs/fr/notions-de-base/api.md) ou [unsloth start](/docs/fr/integrations/unsloth-start.md).

{% code overflow="wrap" %}

```bash
unsloth run --model unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL
```

{% endcode %}
{% endstep %}

{% step %}

#### Unsloth est maintenant prêt

Vous pouvez également faire beaucoup d’autres choses avec Qwen3.8-Flash-Next via Unsloth Desktop, comme :

* **Connecter des outils :** [Claude Code](/docs/fr/notions-de-base/claude-code.md), [Codex](/docs/fr/notions-de-base/codex.md), [recherche web](/docs/fr/nouveau/studio/chat.md#advanced-web-search), [MCP](/docs/fr/notions-de-base/mcp.md) et plus encore
* **Entraîner des modèles :** Affiner du texte, de la diffusion, [l’encodage](/docs/fr/notions-de-base/embedding-finetuning.md), et plus encore
* **Générer des médias :** Créer et entraîner [des images](/docs/fr/notions-de-base/diffusion-image.md), de la vidéo, [TTS](/docs/fr/notions-de-base/text-to-speech-tts-fine-tuning.md) localement

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FRnU2breyPzalRzIHyq8U%2FScreenshot%202026-08-28%20at%2012.12.20%E2%80%AFAM.png?alt=media&amp;token=da925810-e1d3-4c06-bf27-7caad15a2330" alt=""><figcaption></figcaption></figure>
{% endstep %}
{% endstepper %}

### :llama: Exécutez Qwen3.8-Flash-Next dans llama.cpp

{% stepper %}
{% step %}
Installez la dernière version de llama.cpp. Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` en `-DGGML_CUDA=OFF` si vous n’avez pas de GPU ou si vous voulez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d’habitude - la prise en charge Metal est activée par défaut.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
Pour exécuter le modèle, vous pouvez faire :

{% code overflow="wrap" %}

```bash
pip install -U "huggingface_hub[cli]"
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
    --local-dir unsloth/Qwen3.8-Flash-Next-GGUF \
    --include "*UD-Q4_K_XL*" # Utilisez "*IQ2_XXS*" pour 2 bits
```

{% endcode %}
{% endstep %}

{% step %}
Puis pour l’exécuter :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Qwen3.8-Flash-Next-GGUF/UD-IQ1_S/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.0
```

{% endcode %}
{% endstep %}
{% endstepper %}

### Guide MTP

Qwen3.8-Flash peut fonctionner avec une **inférence 1,3 à 1,7x plus rapide** via [MTP](/docs/fr/modeles/mtp.md) (prédiction multi-jetons) sans dégradation de précision ! MTP permet à Qwen3.8-Flash d’atteindre **170 jetons/s** sur 1 GPU RTX 6000 PRO par rapport à la base de 100 jetons. MTP accélère l’inférence en permettant à un modèle de prédire plusieurs jetons à venir en même temps au lieu d’en générer un par étape, et est particulièrement efficace sur GPU.

Pour exécuter Qwen3.8-Flash avec MTP, MTP est activé par défaut dans [Unsloth Desktop](#run-qwen3.8-flash-next-in-unsloth) ou vous pouvez utiliser notre PR personnalisée pour llama.cpp.

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F39BmPdGOL8IlwrdQFsGh%2Fqwen38_flash_next_unsloth_ggufs_mtp_speedup_no_mtp.png?alt=media&amp;token=77c52179-821a-406b-a5ab-fd027ebe8d30" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FF9IF8IWG2DAgfLBXzhyz%2Fqwen38_flash_next_unsloth_ggufs_mtp_decode_tokens_per_s.png?alt=media&amp;token=def0f8fb-5268-4e33-9e85-0a1fed4a1156" alt=""><figcaption></figcaption></figure></div>

Les gains sont plus faibles sur les appareils à bande passante mémoire plus réduite, comme les anciens Mac. Nous avons créé à la fois des modules MTP partagés (exclut les embed\_tokens et les partage avec le modèle principal) afin d’économiser de l’espace disque ainsi que l’utilisation de la RAM et de la VRAM d’environ 1 à 2 Go.

| Type de MTP | MTP général | MTP partagé | Économies |
| ----------- | ----------- | ----------- | --------- |
| BF16        | 7,77 Go     | 5,23 Go     | 2,54 Go   |
| Q8\_0       | 4,14 Go     | 2,79 Go     | 1,35 Go   |
| Q4\_K\_M    | 2,79 Go     | 1,91 Go     | 880 Mo    |

La quantification MTP en 3 bits fonctionne avec 91 Go de RAM, il est donc préférable d’avoir un appareil avec 96 Go de RAM/mémoire unifiée.\
**Tableau : exigences matérielles MTP** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée)

<table><thead><tr><th>1 bit</th><th>2 bits</th><th>3 bits</th><th>4 bits</th><th width="128">5 bits</th><th>8 bits</th><th>BF16</th></tr></thead><tbody><tr><td>76 Go</td><td>80 Go</td><td>91 Go</td><td>97-115 Go</td><td>164 Go</td><td>200 Go</td><td>355 Go</td></tr></tbody></table>

#### Exécuter MTP Qwen3.8-Flash

Pour exécuter Qwen3.8-Flash avec MTP, tout ce que vous avez à faire est [**installer Unsloth Desktop**](#run-qwen3.8-flash-next-in-unsloth) ou mettre à jour vers la dernière version d’Unsloth, puis retélécharger le modèle ou télécharger le fichier MTP. Voir plus bas pour les instructions llama.cpp.

{% columns %}
{% column %}
Unsloth Desktop fonctionne sur [macOS](/docs/fr/commencer/install/mac.md), [Windows](/docs/fr/commencer/install/windows-installation.md), et [Linux](/docs/fr/commencer/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Télécharger Unsloth</a>

* <i class="fa-apple">:apple:</i> [Télécharger pour macOS](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Télécharger pour Windows](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Télécharger pour Linux](https://unsloth.ai/download/linux)

Dans Unsloth Desktop, vous pouvez également modifier le nombre de jetons brouillons ou personnaliser MTP. Utilisez les paramètres avancés dans la barre latérale droite, puis activez « Advanced settings » et vous pourrez sélectionner le décodage spéculatif MTP / Ngram, le nombre de jetons brouillons et plus encore :
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FqKy281quNOdn5toIr5am%2Fimage.png?alt=media&amp;token=bf0f6f00-1192-4494-977c-1bf4fa346fa0" alt="" width="305"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

#### Guide MTP pour Llama.cpp

{% code overflow="wrap" %}

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone --branch qwen4exp/mtp https://github.com/danielhanchen/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endcode %}

Puis pour télécharger le module MTP partagé :

{% code overflow="wrap" %}

```bash
pip install -U "huggingface_hub[cli]"
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
    --local-dir unsloth/Qwen3.8-Flash-Next-GGUF \
    --include "*mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf*"
```

{% endcode %}

Et pour l’utiliser avec llama-server :

{% code overflow="wrap" %}

```bash
llama.cpp/llama-server \\
    -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL \\
    -md unsloth/Qwen3.8-Flash-Next-GGUF/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf \\
    --spec-type draft-mtp --spec-draft-n-max 5
```

{% endcode %}

### 📊 Benchmarks

Pour les benchmarks de quantification GGUF, vous pouvez voir ci-dessus notre [analyse de la quantification](#quantization-analysis) ou [article Dynamic V3.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md).

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FJFGDUmmWUvJMD0eCUbiE%2Fqwennextbe.jpg?alt=media&amp;token=0be96d30-9f51-41f3-8e3a-3366a4fdfb93" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FpQBzoQNziZtrFDHCyN3t%2Fbench2max.jpg?alt=media&amp;token=3d6adbe3-6c8b-4cb4-937f-f434ebd7f106" alt=""><figcaption></figcaption></figure></div>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://unsloth.ai/docs/fr/modeles/qwen3.8-next.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.