> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/qwen3.5/gguf-benchmarks.md).

# Benchmarks GGUF de Qwen3.5

Voyez les performances des GGUF dynamiques d'Unsloth + analyse de la perplexité, de la divergence KL et de MXFP4.

Nous avons mis à jour tous [Qwen3.5](/docs/fr/modeles/qwen3.5.md) les quants dynamiques Unsloth **étant SOTA** sur presque tous les bits. Nous avons effectué plus de 150 benchmarks de divergence KL, au total **9 To de GGUF**. Nous avons téléversé tous les artefacts de recherche.

Nous avons également corrigé un **appel d’outils** problème de gabarit de chat **(cela affecte tous les téléverseurs de quants et tous les types, quel que soit l’endroit où vous l’utilisez ou son origine)**.

{% hint style="success" %}
[**Mise à jour du 5 mars**](#id-4-march-5th-2026-update-more-robustness)**:** Retéléchargez Qwen3.5-**35B**, **27B,** **122B** et **397B.**

* Tous les GGUF sont désormais mis à jour avec une **quantification améliorée** algorithme de Qwen.
* Tous utilisent nos **nouvelles données imatrix**. Voyez quelques améliorations dans les cas d’usage de chat, de codage, de long contexte et d’appel d’outils.

**Nouveaux benchmarks** pour Qwen3.5-122B-A10B et 35-A3B sont désormais publiés !
{% endhint %}

{% hint style="info" %}
Vous voulez voir comment exécuter le modèle + les exigences matérielles ? Lisez notre [guide d’inférence](/docs/fr/modeles/qwen3.5.md).
{% endhint %}

**La divergence KL à 99,9 % montre un SOTA** sur la frontière de Pareto pour [Unsloth Dynamic](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) `Q4_K_XL`, `IQ3_XXS` etc. :

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F1XLNe1MoxtF1ODs5gDej%2F122b%20final.png?alt=media&amp;token=9eee5d8d-f16c-4c3f-8e36-18856e5609aa" alt="" width="563"><figcaption><p>Qwen3.5-<strong>122B-A10B</strong> Benchmarks</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FAeecRAsAA3lxJ36HI8pO%2Fhoriztonal%20plot.png?alt=media&amp;token=173d4050-9442-4d2b-9f1b-ee8bd0d423df" alt="" width="563"><figcaption><p>Qwen3.5-<strong>35B-A3B</strong> Benchmarks</p></figcaption></figure></div>

* Imatrix aide définitivement à réduire le KLD et la PPL, au prix d’une inférence 5 à 10 % plus lente.
* Nous avons testé nos GGUF par rapport à de nombreux autres fournisseurs
* Quantifier ssm\_out (couches Mamba) n’est pas une bonne idée, et ffn\_down\_exps.
* **Abandon de MXFP4** de toutes les quants GGUF : Q2\_K\_XL, Q3\_K\_XL et Q4\_K\_XL, sauf pour le pur MXFP4\_MOE.

| [Qwen3.5-35B-A3B](https://huggingface.co/unsloth/Qwen3.5-35B-A3B-GGUF) | [Qwen3.5-27B](https://huggingface.co/unsloth/Qwen3.5-27B-GGUF) | [Qwen3.5-122B-A10B](https://huggingface.co/unsloth/Qwen3.5-122B-A10B-GGUF) | [Qwen3.5-397B-A17B](https://huggingface.co/unsloth/Qwen3.5-397B-A17B-GGUF) |
| ---------------------------------------------------------------------- | -------------------------------------------------------------- | -------------------------------------------------------------------------- | -------------------------------------------------------------------------- |

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHq3gIokmPZJRYlnKVFmH%2FHCp7gV9XgAEP5og.png?alt=media&amp;token=a1268383-1648-45f8-996d-c89c7dde3706" alt="" width="563"><figcaption><p>Nouveaux benchmarks GGUF Qwen3.5-9B réalisés par Benjamin Marie</p></figcaption></figure>

### 1) **Certains tenseurs sont très sensibles à la quantification**

* Nous avons mis à disposition de la communauté plus de 9 To d’artefacts de recherche pour approfondir l’étude sur notre [page des expériences](https://huggingface.co/unsloth/Qwen3.5-35B-A3B-Experiments-GGUF). Elle comprend les métriques KLD et les 121 configurations que nous avons testées.
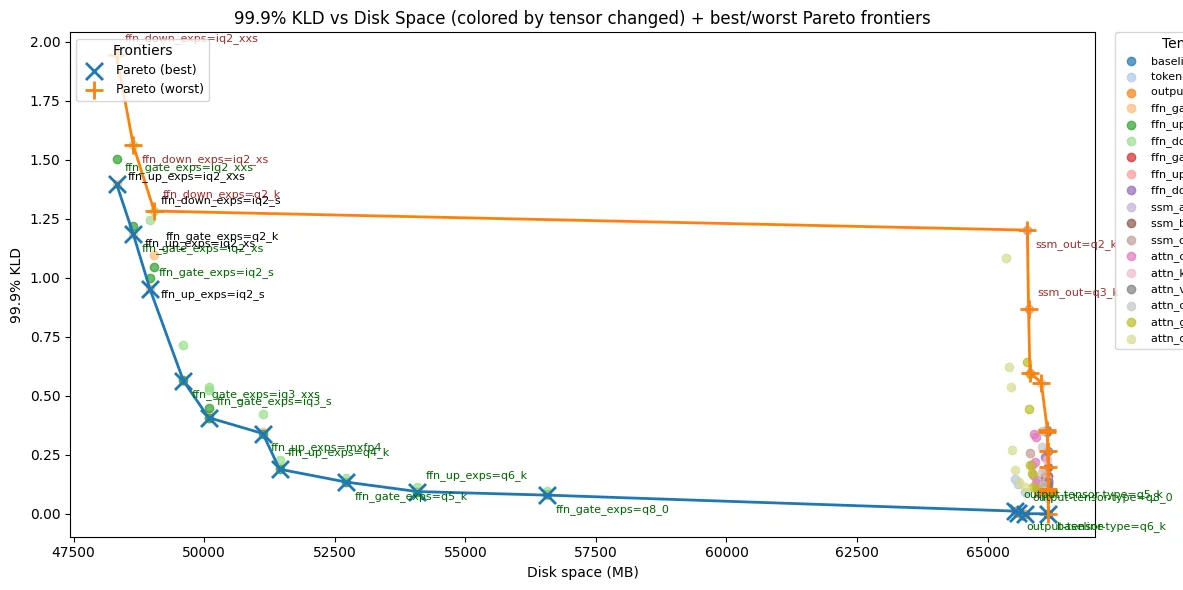
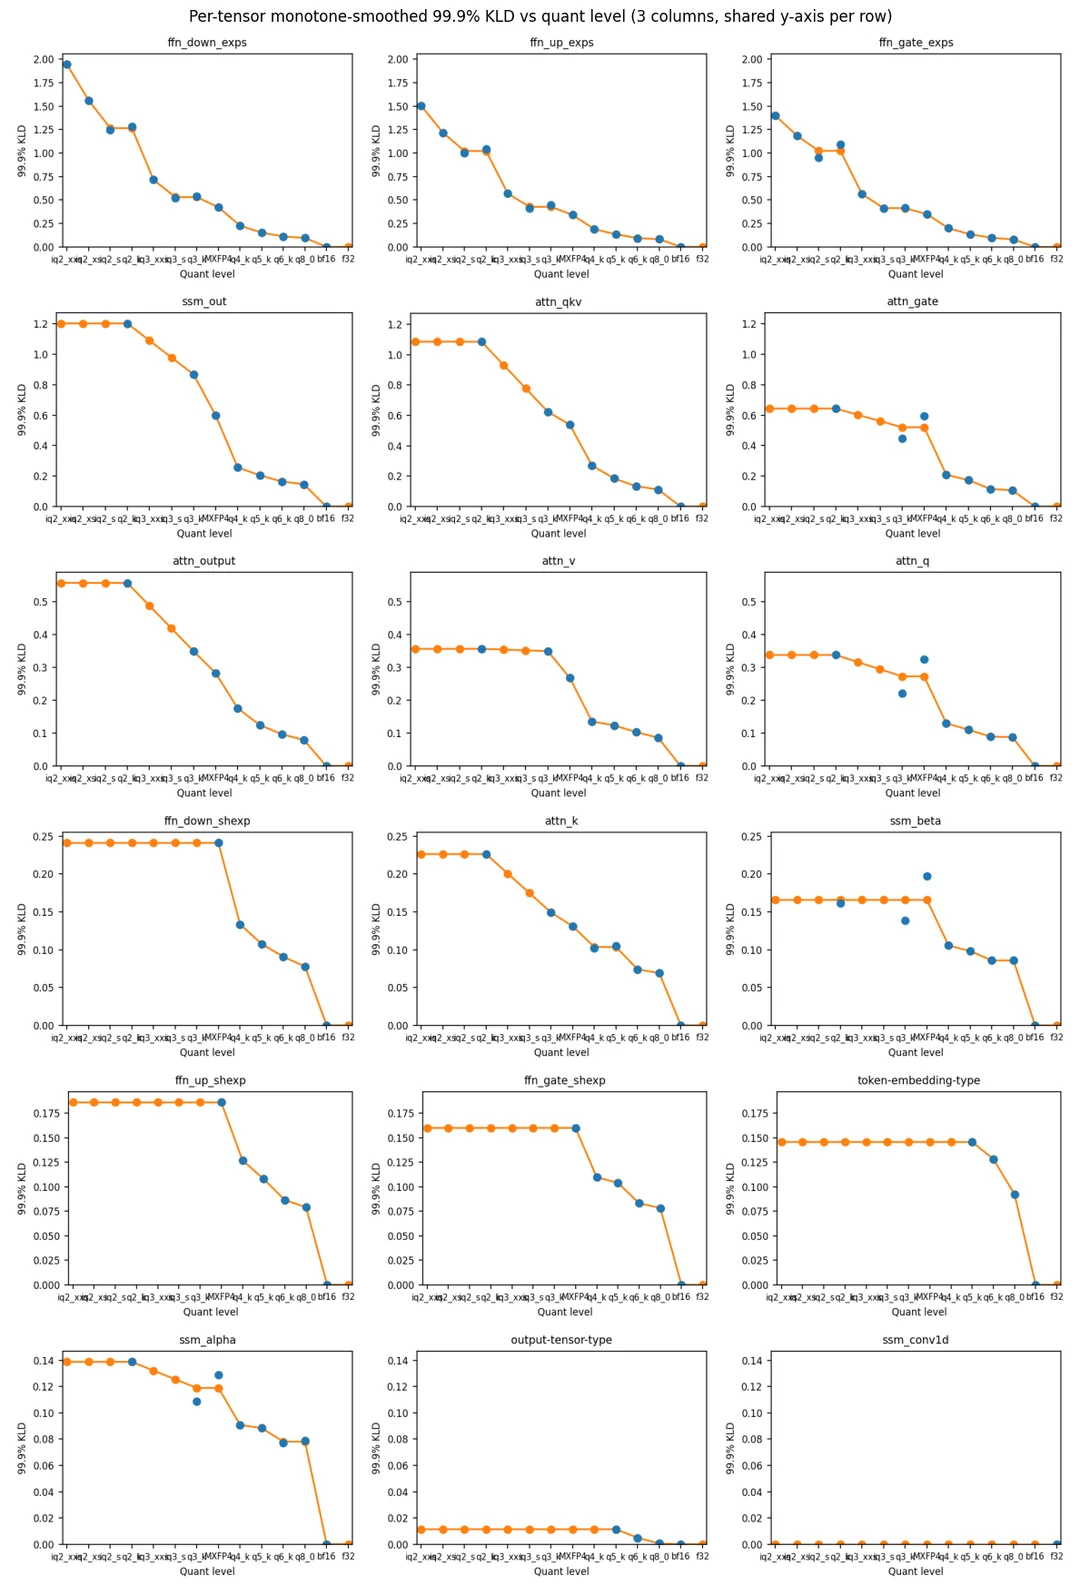
* Nous avons fait varier les largeurs de bits pour chaque type de tenseur et généré ci-dessous un graphique de frontière de Pareto meilleur et pire par rapport au KLD à 99,9 %.
* Pour les éléments les plus faciles à quantifier, ffn\_up\_exps et ffn\_gate\_exps peuvent généralement être quantifiés en 3 bits. ffn\_down\_exps est légèrement plus sensible.
* Pour les pires éléments, ssm\_out augmente considérablement le KLD et l’économie d’espace disque est minuscule. Par exemple, ssm\_out en q2\_k est nettement pire. **La quantification de tout attn\_\* est particulièrement sensible** pour les architectures hybrides, et les laisser en plus haute précision fonctionne bien.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F485gYwcqz2az5Pm9v3u3%2Fnew-qwen3-5-35b-a3b-unsloth-dynamic-ggufs-benchmarks-v0-pakdmbv1n2mg1.webp?alt=media&amp;token=2eeb55ca-51f3-402a-ae30-ea078c7554da" alt="" width="563"><figcaption></figcaption></figure>

{% columns %}
{% column %}
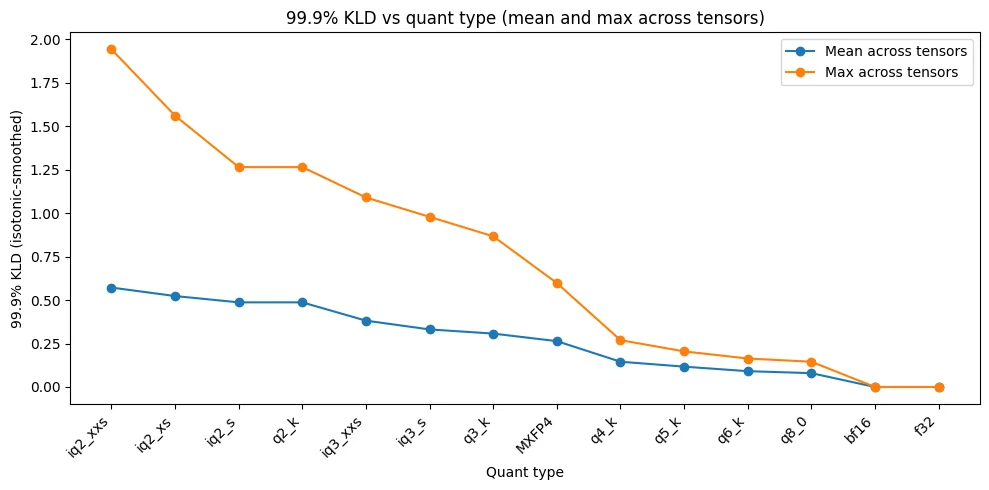
**Type de tenseur vs bits sur la divergence KL à 99,9 %**

* Nous traçons tous les niveaux de quantification par rapport au KLD à 99,9 % et les classons du pire KLD au meilleur. Il n’est pas recommandé de trop réduire la quantification des couches ffn\_\*.
* Cependant, **certaines largeurs de bits sont bonnes, surtout 3 bits**. - par exemple, laisser ffn\_\* (down, up, gate) autour de iq3\_xxs semble être le meilleur compromis entre l’espace disque et la variation du KLD à 99,9 %. 2 bits provoquent davantage de dégradation.
  {% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FcE0WAmPVddczWC3dQsWS%2Fnew-qwen3-5-35b-a3b-unsloth-dynamic-ggufs-benchmarks-v0-squz1jz4n2mg1.webp?alt=media&amp;token=3a31adf1-7c4c-446c-91a7-48e63d223189" alt="" width="188"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

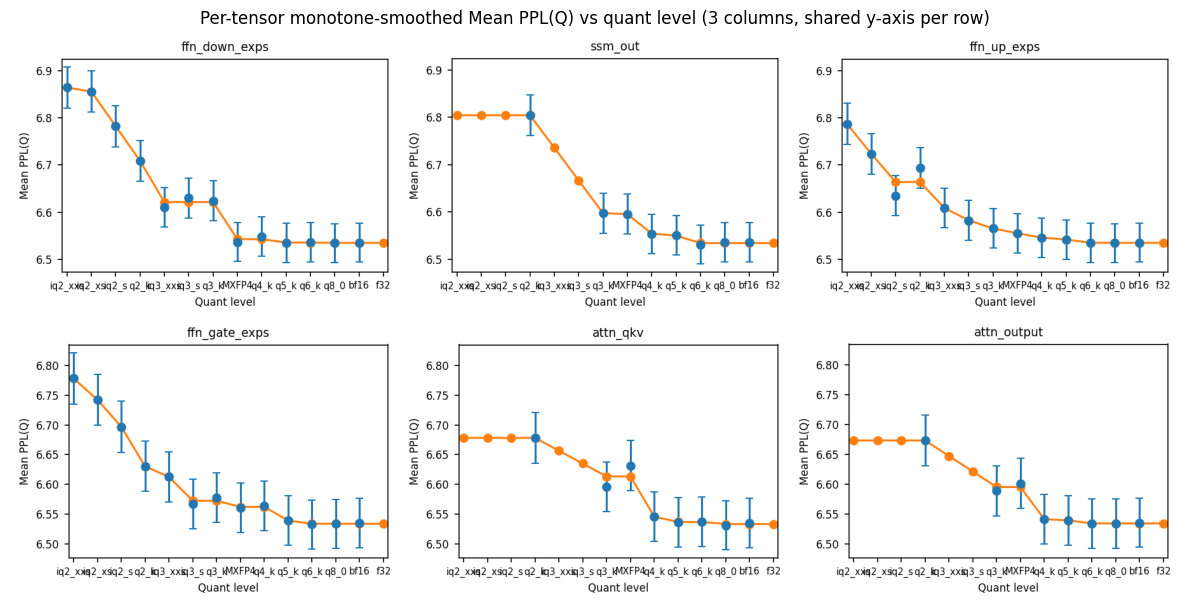
**MXFP4 est bien pire sur de nombreux tenseurs** - utiliser MXFP4 pour attn\_gate, attn\_q, ssm\_beta, ssm\_alpha n’est pas une bonne idée, et Q4\_K est plutôt meilleur ; de plus, MXFP4 utilise 4,25 bits par poids, tandis que Q4\_K utilise 4,5 bits par poids. Il vaut mieux utiliser Q4\_K que MXFP4 lorsqu’il faut choisir entre les deux.

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FH8FliHXsetx9lLoKelPX%2Fnew-qwen3-5-35b-a3b-unsloth-dynamic-ggufs-benchmarks-v0-xgugdgzmv2mg1.webp?alt=media&amp;token=f0c49e94-571e-4883-84fe-2c4634d425eb" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FEWsX87d1Ig42Uk81fpJo%2Ffixed%20the%20grapg.png?alt=media&amp;token=323932fd-8344-4f6c-b8c3-47cc1b1f6ccf" alt="" width="563"><figcaption><p>Comme vous pouvez le voir, MXFP4 est inhabituellement élevé</p></figcaption></figure></div>

### **2) Imatrix fonctionne très bien**

* Imatrix aide clairement à pondérer le processus de quantification de la bonne manière. Par exemple, auparavant ssm\_out en 2 bits était vraiment mauvais ; cependant, imatrix réduit énormément le KLD à 99,9 %.
* Imatrix aide généralement pour les bits les plus faibles et fonctionne avec tous les quants et toutes les largeurs de bits.
*

```
<figure><img src="/files/6457936cb161e8a6a96d5e77f638a61fe9749447" alt=""><figcaption></figcaption></figure>
```

Les quants I (iq3\_xxs, iq2\_s, etc.) rendent l’inférence 5 à 10 % plus lente ; ils sont clairement meilleurs en termes d’efficacité, mais il y a un compromis.

| Type     | pp512 (≈) | tg128 (≈) |
| -------- | --------- | --------- |
| mxfp4    | 1978.69   | 90.67     |
| q4\_k    | 1976.44   | 90.38     |
| q3\_k    | 1972.61   | 91.36     |
| q6\_k    | 1964.55   | 90.50     |
| q2\_k    | 1964.20   | 90.77     |
| q8\_0    | 1964.17   | 90.33     |
| q5\_k    | 1947.74   | 90.72     |
| iq3\_xxs | 2030.94   | 85.68     |
| iq2\_xxs | 1997.64   | 85.79     |
| iq3\_s   | 1990.12   | 84.37     |
| iq2\_xs  | 1967.85   | 85.19     |
| iq2\_s   | 1952.50   | 85.04     |

### **3) La perplexité et le KLD peuvent être trompeurs**

La perplexité et le KLD peuvent être trompeurs, car ils sont fortement influencés par l’étalonnage. La plupart des GGUF sont évalués sur Wiki-test avec des fenêtres de contexte de 512, donc les résultats varient beaucoup si l’ensemble de calibration imatrix du GGUF inclut des échantillons de type Wikipédia et de contexte 512 (comme c’est le cas pour la plupart des GGUF). C’est pourquoi nos GGUF affichent parfois une perplexité plus élevée, car nos données imatrix utilisent plutôt des exemples de chat à long contexte et d’appel d’outils.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhfO2gsbz2lWrZXg3ojyE%2FHCGBTzgboAASv_A.png?alt=media&amp;token=7d6334ca-4f3c-4946-aacd-d55527375fce" alt="" width="563"><figcaption></figcaption></figure>

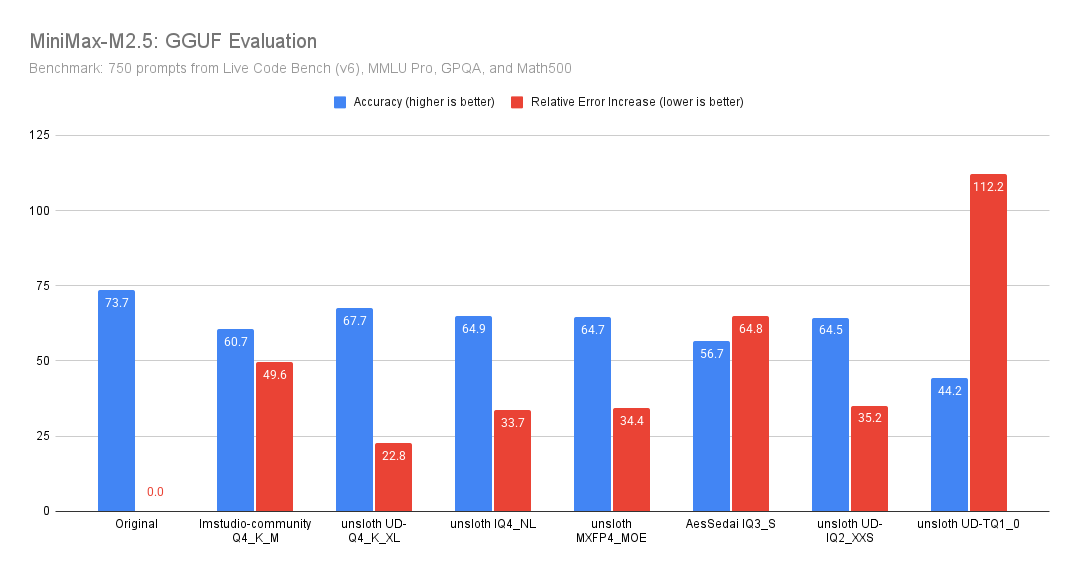
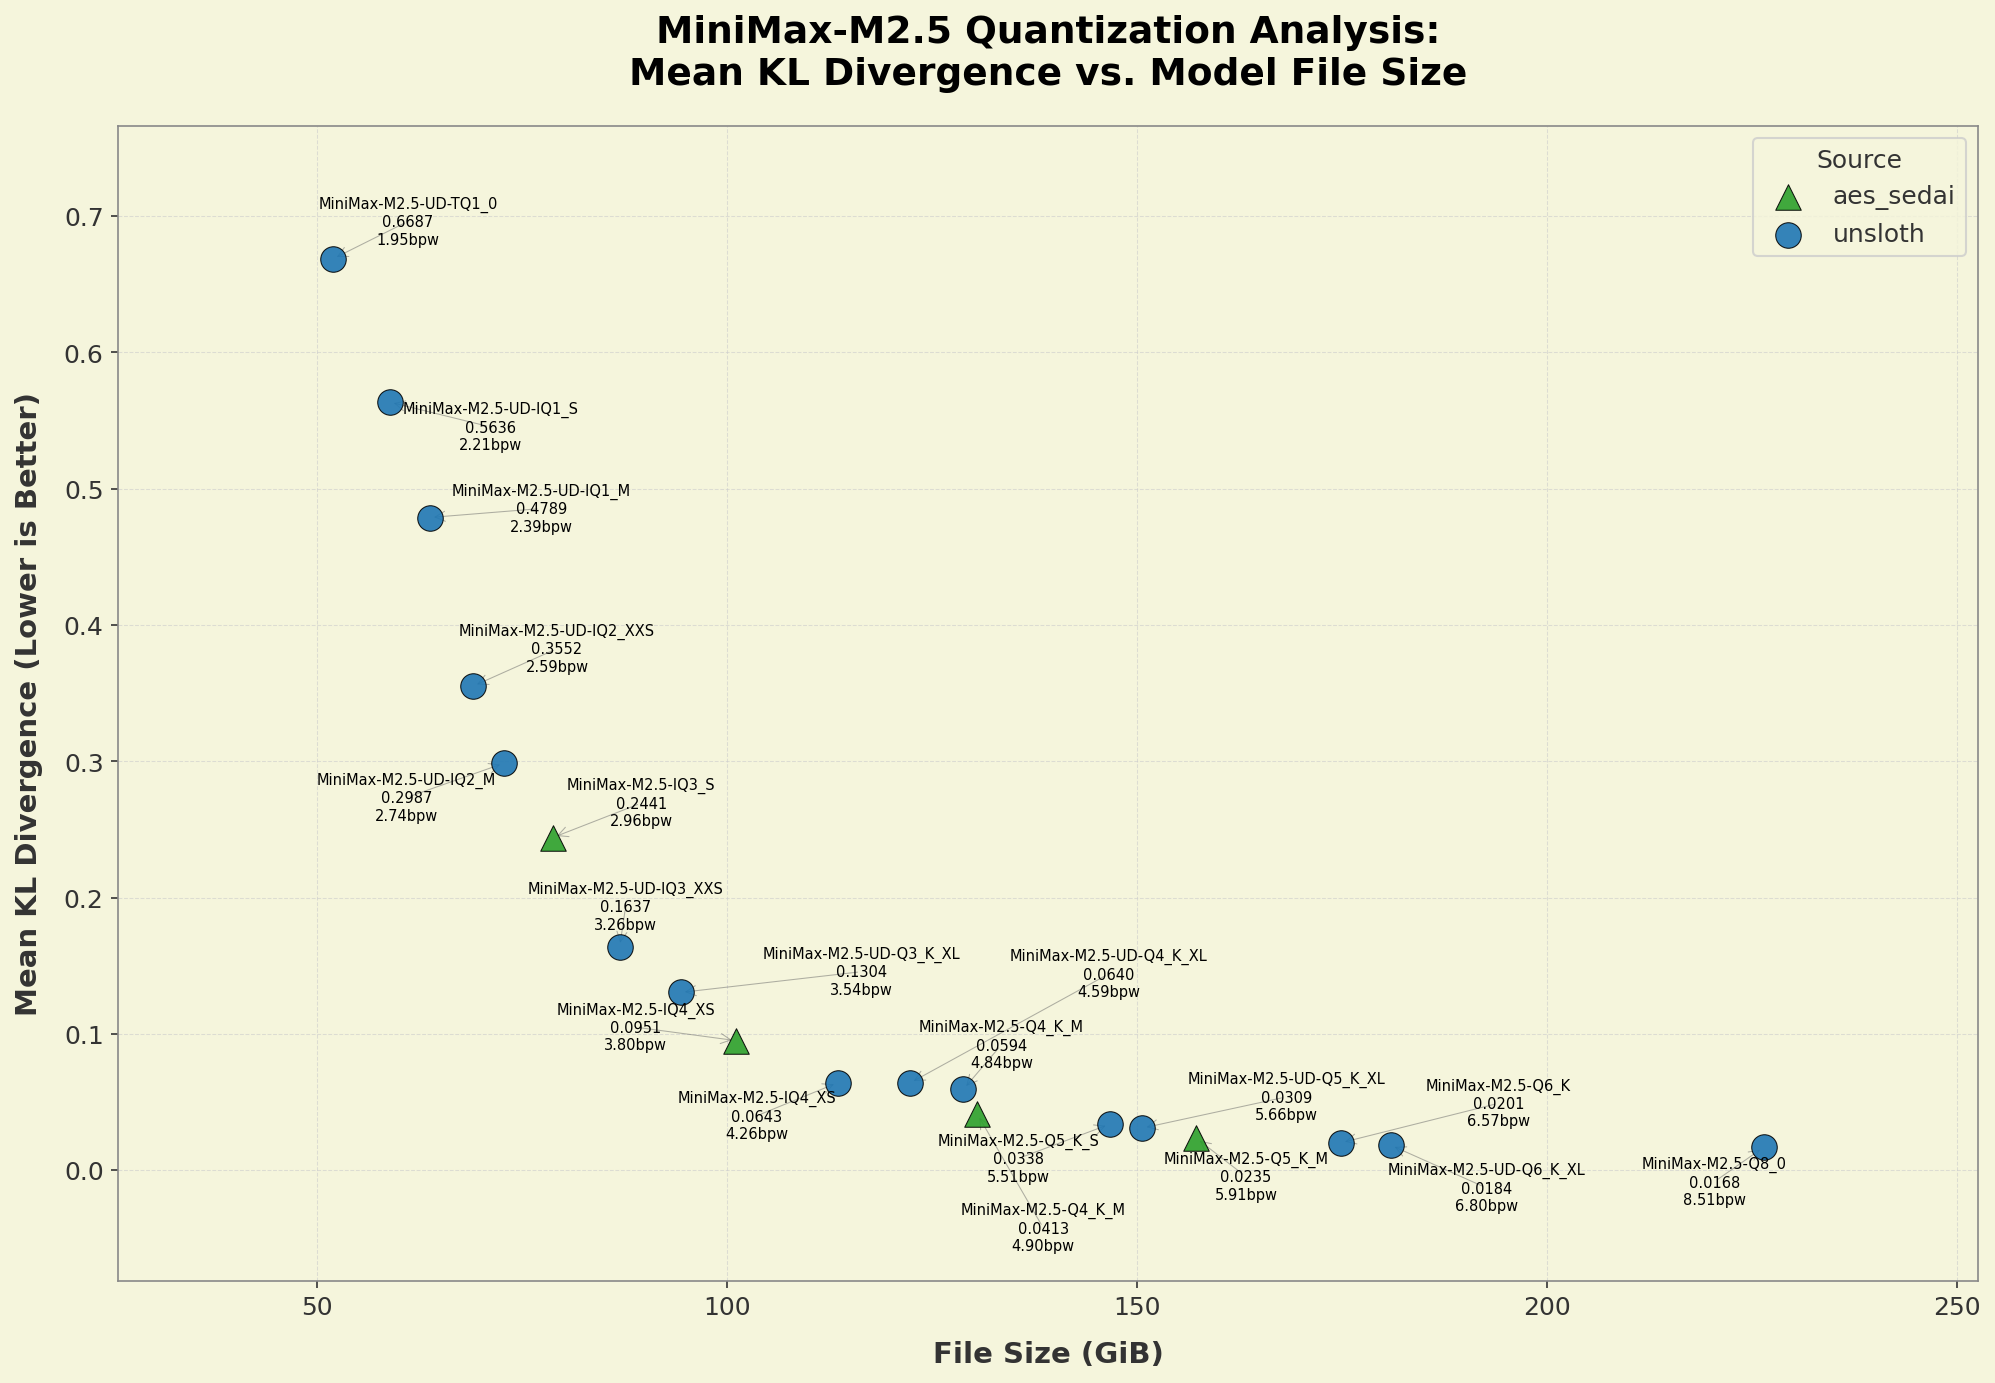
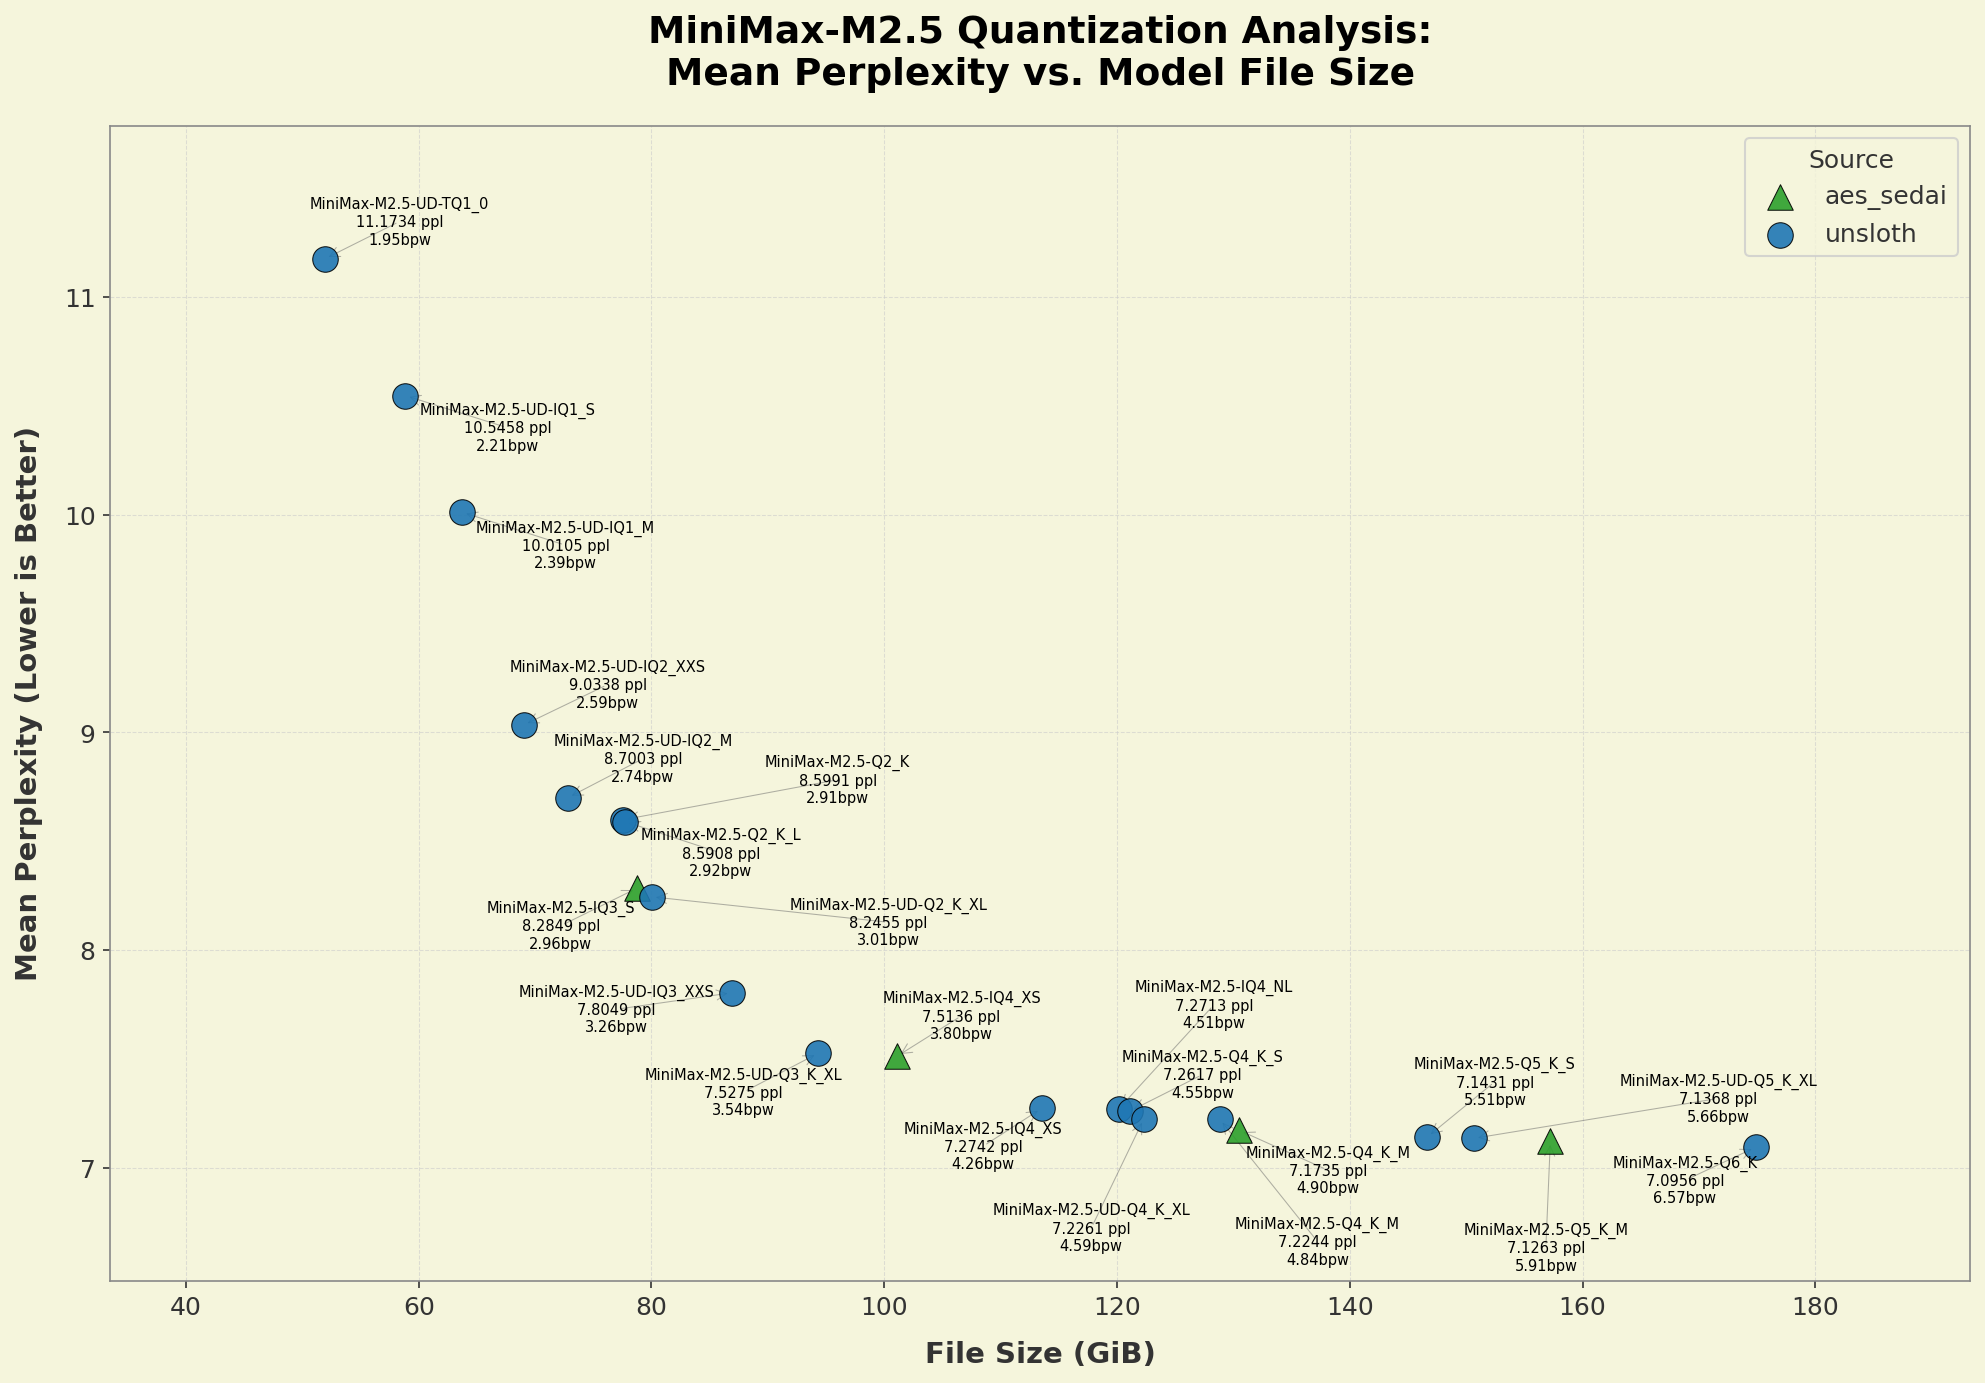
[L’analyse récente de MiniMax‑M2.5 par Benjamin](https://x.com/bnjmn_marie/status/2027043753484021810) montre un exemple de la façon dont la perplexité et le KLD peuvent être très trompeurs. Unsloth Dynamic IQ2\_XXS obtient de meilleurs résultats qu’AesSedai IQ3\_S sur des évaluations réelles (LiveCodeBench v6, MMLU Pro), tout en étant 11 Go plus petit. Pourtant, les benchmarks de perplexité et de KLD d’AesSedai suggèrent l’inverse. (PPL : 0,3552 contre 0,2441 ; KLD : 9,0338 contre 8,2849 — plus bas est meilleur).

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7csgZI82adnvKmQQVlp1%2F01_kld_vs_filesize_pareto.png?alt=media&amp;token=d907a2c0-7df5-4e6a-9d9b-0524c8e6ae77" alt="" width="188"><figcaption><p>Divergence KL - AesSedai</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fd8KBa3uNhkDEZzq32v7q%2F02_ppl_vs_filesize_pareto.png?alt=media&amp;token=d471fce1-7482-4fde-bc98-2d10503253a4" alt="" width="188"><figcaption><p>Perplexité - AesSedai</p></figcaption></figure></div>

Ce décalage montre qu’une perplexité ou un KLD plus faibles ne se traduisent pas nécessairement par de meilleures performances en conditions réelles. Le graphique montre aussi que UD‑Q4-K‑XL surpasse les autres quants Q4 tout en étant \~8 Go plus petit. Cela ne signifie pas que la perplexité ou le KLD sont inutiles, car ils donnent un signal approximatif. Donc, à l’avenir, nous publierons la perplexité et le KLD pour chaque quant afin que la communauté dispose d’une sorte de référence.

### 4) Mise à jour du 5 mars 2026 - plus de robustesse

Nous avons encore amélioré notre méthode de quantification pour les MoE Qwen3.5 afin de réduire directement le KLD maximal. 99,9 % est ce qui est généralement utilisé, mais pour les valeurs aberrantes massives, le KLD maximal peut être utile. Notre nouvelle méthode fait généralement baisser assez fortement le KLD maximal par rapport à la mise à jour d’avant le 5 mars.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fqxt3Dv8HIOWG8y3RvNYf%2FCode_Generated_Image(11).png?alt=media&amp;token=54e20159-4243-42cf-89de-d2c9d7b6409b" alt=""><figcaption></figcaption></figure>

| Quantification | Ancien Go  | Nouveau Go   | Ancien KLD max | Nouveau KLD max    |
| -------------- | ---------- | ------------ | -------------- | ------------------ |
| UD-Q2\_K\_XL   | 12.0       | ***11.3***   | 8.237          | ***8.155***        |
| UD-Q3\_K\_XL   | 16.1       | ***15.5***   | 5.505          | ***5.146***        |
| UD-Q4\_K\_XL   | ***19.2*** | 20.7 (+7.8%) | 5.894          | ***2.877 (-51%)*** |
| UD-Q5\_K\_XL   | ***23.2*** | 24.6 (+6%)   | 5.536          | ***3.210 (-42%)*** |

### Benchmarks complets

| Quantiseur | Niveau de quantification | Espace disque (Go) | PPL    | KLD 99,9 % | KLD moyenne |
| ---------- | ------------------------ | ------------------ | ------ | ---------- | ----------- |
| AesSedai   | IQ3\_S                   | 12.65              | 6.9152 | 1.8669     | 0.0613      |
| AesSedai   | IQ4\_XS                  | 16.4               | 6.6447 | 0.8067     | 0.0235      |
| AesSedai   | Q4\_K\_M                 | 20.62              | 6.5665 | 0.3171     | 0.0096      |
| AesSedai   | Q5\_K\_M                 | 24.45              | 6.5356 | 0.21       | 0.0058      |
| Ubergarm   | Q4\_0                    | 19.79              | 6.5784 | 0.4829     | 0.0142      |
| Unsloth    | IQ2\_XXS                 | 9.09               | 7.716  | 4.2221     | 0.1846      |
| Unsloth    | Q2\_K\_XL                | 12.04              | 7.0438 | 2.9092     | 0.097       |
| Unsloth    | IQ3\_XXS                 | 13.12              | 6.7829 | 1.5296     | 0.0501      |
| Unsloth    | IQ3\_S                   | 14.13              | 6.7715 | 1.4193     | 0.0457      |
| Unsloth    | Q3\_K\_M                 | 15.54              | 6.732  | 0.9726     | 0.0324      |
| Unsloth    | Q3\_K\_XL                | 16.06              | 6.7245 | 0.9539     | 0.0308      |
| Unsloth    | MXFP4\_MOE               | 18.17              | 6.6    | 0.7789     | 0.0272      |
| Unsloth    | Q4\_K\_M                 | 18.49              | 6.6053 | 0.5478     | 0.0192      |
| Unsloth    | Q4\_K\_L                 | 18.82              | 6.5905 | 0.4828     | 0.015       |
| Unsloth    | Q4\_K\_XL                | 19.17              | 6.5918 | 0.4097     | 0.0137      |
| Unsloth    | Q5\_K\_XL                | 23.22              | 6.5489 | 0.236      | 0.0069      |
| Unsloth    | Q6\_K\_S                 | 26.56              | 6.5456 | 0.2226     | 0.0065      |
| Unsloth    | Q6\_K\_XL                | 28.22              | 6.5392 | 0.1437     | 0.0041      |
| Unsloth    | Q8\_K\_XL                | 36.04              | 6.5352 | 0.1033     | 0.0026      |
| bartowski  | Qwen\_IQ2\_XXS           | 8.15               | 9.3427 | 6.0607     | 0.3457      |
| bartowski  | Qwen\_Q2\_K\_L           | 11.98              | 7.5504 | 3.8095     | 0.1559      |
| bartowski  | Qwen\_IQ3\_XXS           | 12.94              | 7.0938 | 2.1563     | 0.0851      |
| bartowski  | Qwen\_Q3\_K\_M           | 14.95              | 6.772  | 1.7779     | 0.0585      |
| bartowski  | Qwen\_Q3\_K\_XL          | 15.97              | 6.8245 | 1.7516     | 0.0627      |
| bartowski  | Qwen\_IQ4\_XS            | 17.42              | 6.6234 | 0.7265     | 0.0234      |
| bartowski  | Qwen\_Q4\_K\_M           | 19.77[^1]          | 6.6097 | 0.5771     | 0.0182      |
| bartowski  | Qwen\_Q5\_K\_M           | 23.11              | 6.5828 | 0.3549     | 0.0106      |
| noctrex    | MXFP4\_MOE\_BF16         | 20.55              | 6.5948 | 0.7939     | 0.0248      |
| noctrex    | MXFP4\_MOE\_F16          | 20.55              | 6.5937 | 0.7614     | 0.0247      |

[^1]: Le Q4\_K\_M de Bartowski est 1 Go plus grand que celui d’Unsloth


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/qwen3.5/gguf-benchmarks.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.