> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/kimi-k3.md).

# Kimi K3 - Comment l’exécuter localement

Guide pour exécuter les quants Kimi K3 sur votre configuration locale.

Kimi K3 de Moonshot AI est un modèle à poids ouverts de 2,8 T de paramètres (104B actifs) conçu pour des charges de travail de codage de pointe, agentiques, à contexte long et de chat. C'est le **modèle ouvert le plus puissant** à ce jour, rivalisant avec Claude 4.8 Opus et GPT-5.6. Kimi K3 dispose d'une vision native, d'une fenêtre de contexte de 1 M de jetons et utilise MXFP4. L'inférence en pleine précision nécessite 1,56 To de stockage et Kimi K3 1 bit [Unsloth](https://github.com/unslothai/unsloth) Le GGUF dynamique nécessite **594 Go (62 % de moins)**.

{% columns %}
{% column %}
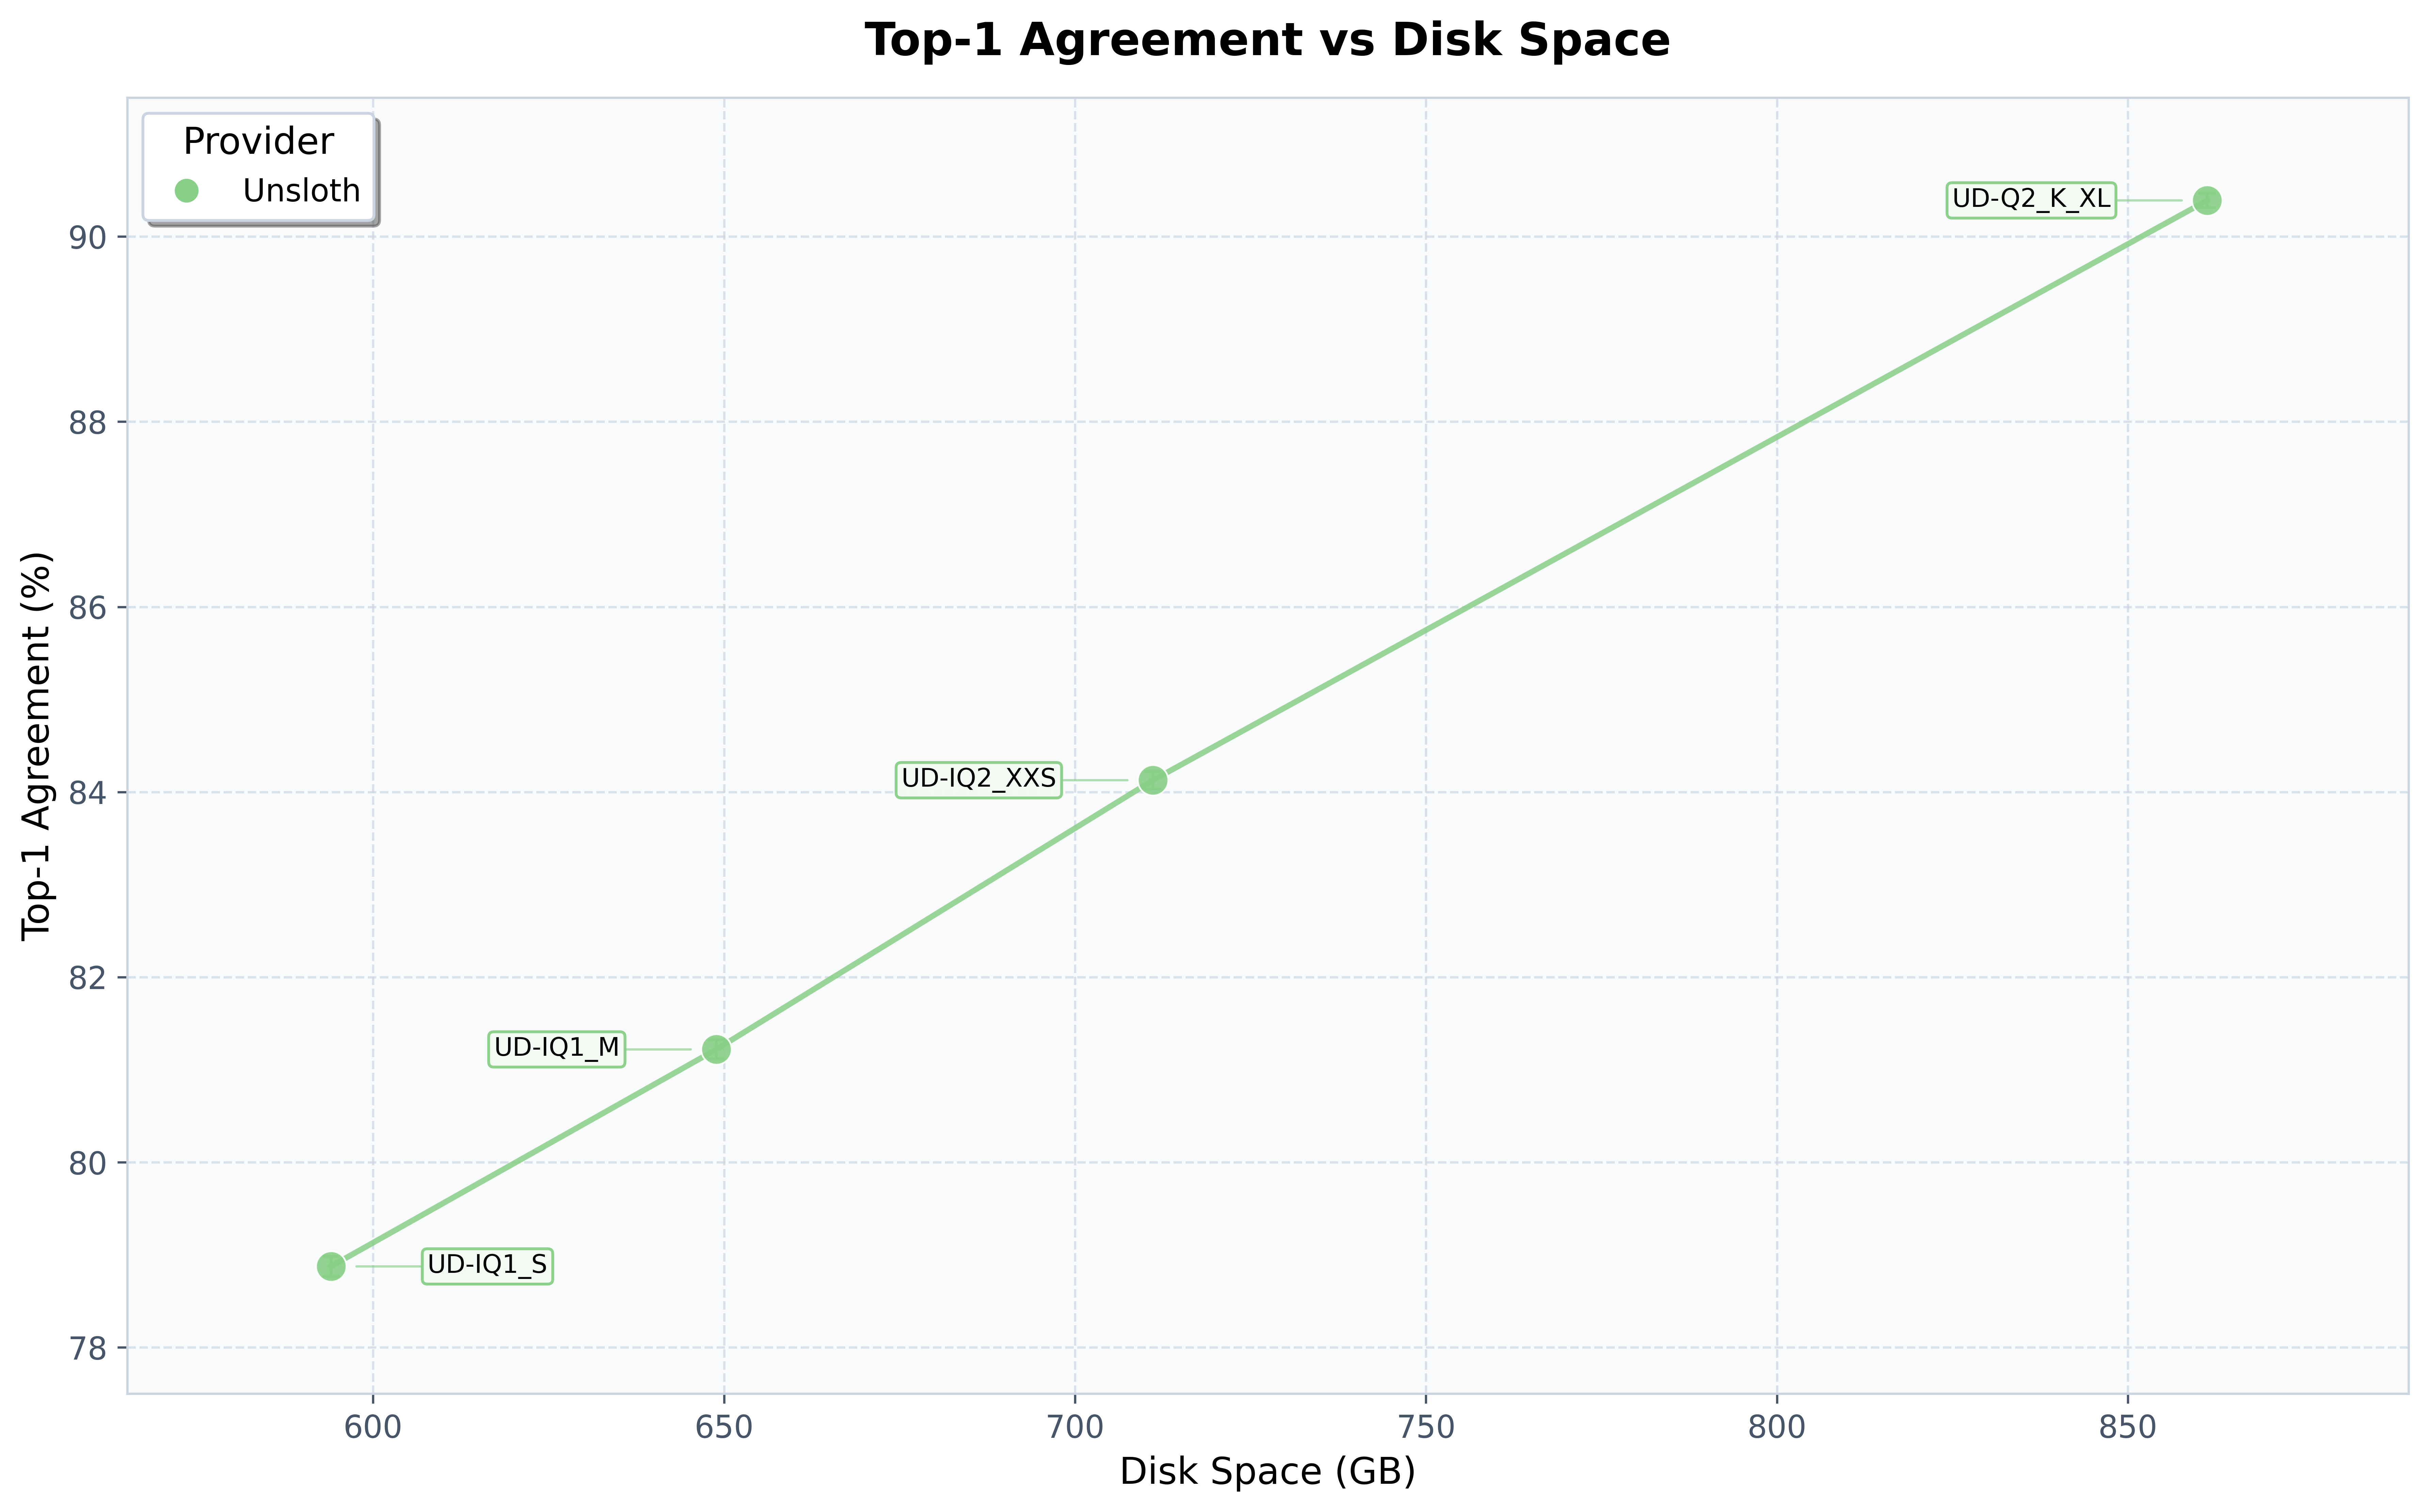
Le 1 bit dynamique (voir à droite) atteint **\~78.9%** une précision top-1 tout en étant **62 % plus petit**. Le 2 bits dynamique de 861,3 Go atteint **\~90%** la précision tout en étant **45 % plus petit**. Exécutez [**Kimi-K3-GGUF**](https://huggingface.co/unsloth/Kimi-K3-GGUF) via [Unsloth Studio](/docs/fr/nouveau/studio.md) ou llama.cpp. Kimi K3 peut fonctionner sur une station NVIDIA DGX ou sur un Mac Studio connecté à un appareil doté de 128 Go de RAM.&#x20;

Pour **sans perte** Pour Kimi K3, utilisez Q8 (`UD-Q8_K_XL`), qui est **50 Go plus grand** que Q4 (`UD-Q4_K_XL`). Nous étudions encore si nous pouvons le faire descendre sous 512 Gio (le 1 bit dynamique est de 553,2 Gio) sans endommager le modèle.

<a href="/docs/fr/modeles/kimi-k3.md" class="button primary">Tutoriels pour exécuter Kimi K3</a><a href="/docs/fr/modeles/kimi-k3.md#usage-guide" class="button secondary">Résultats de quantification</a>
{% endcolumn %}

{% column %}

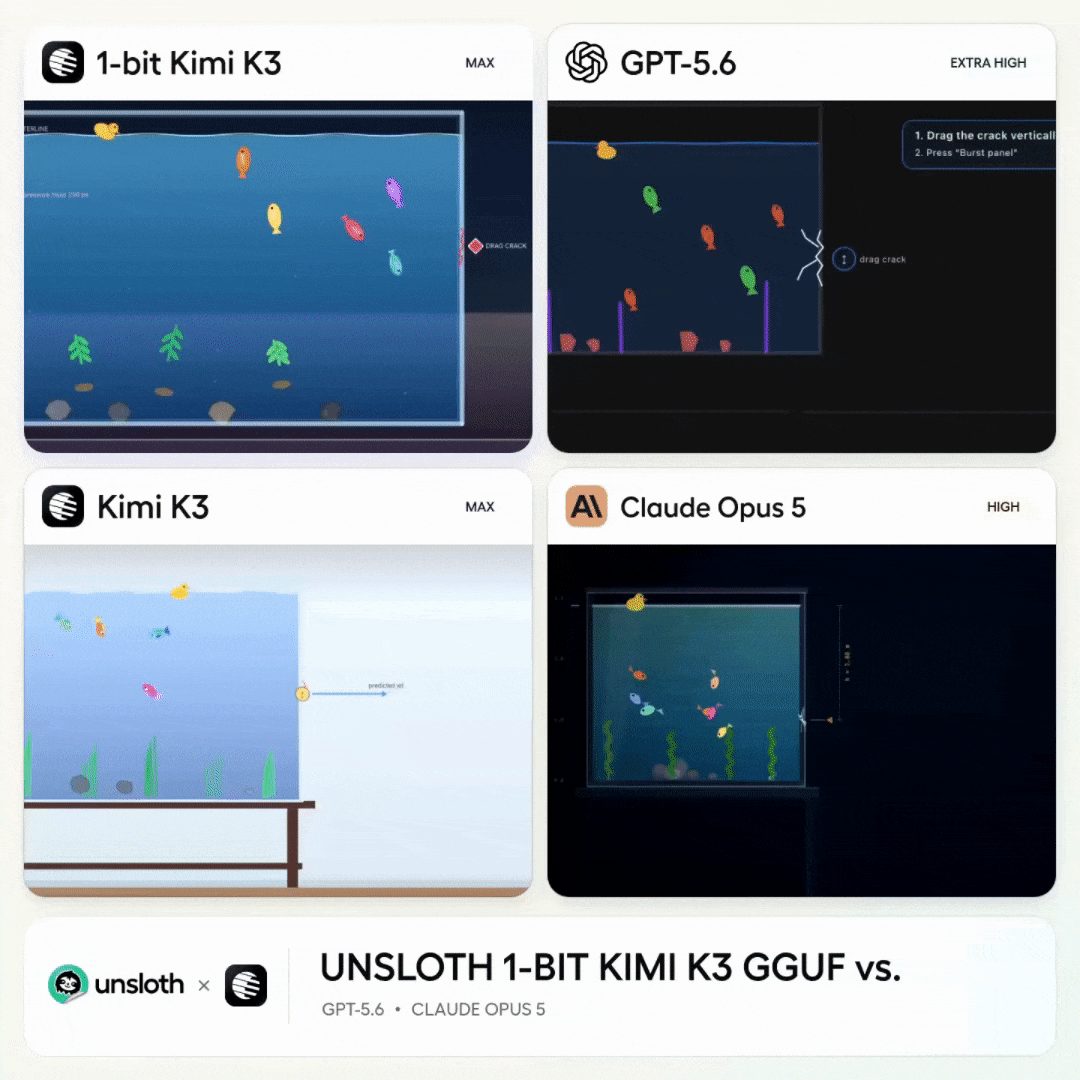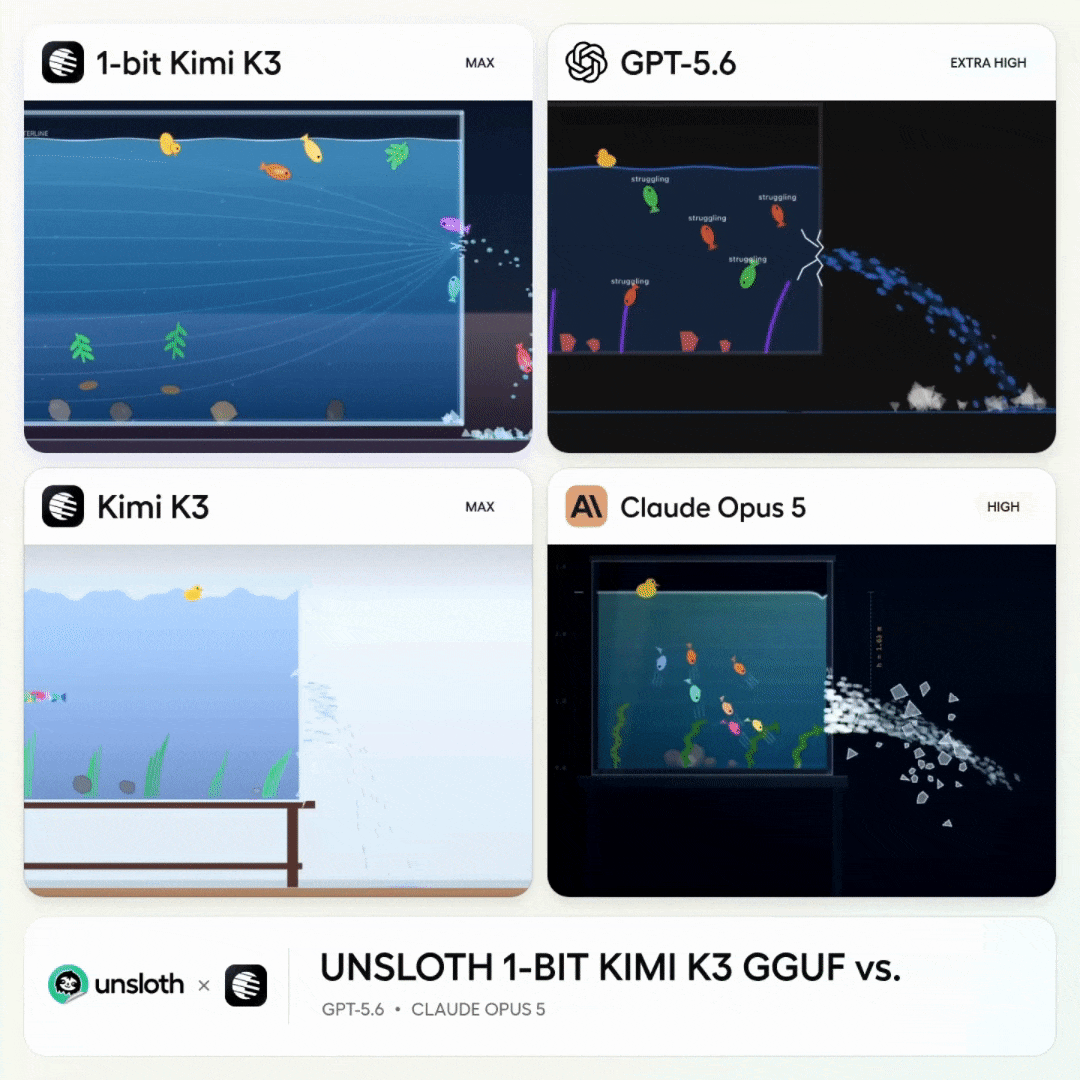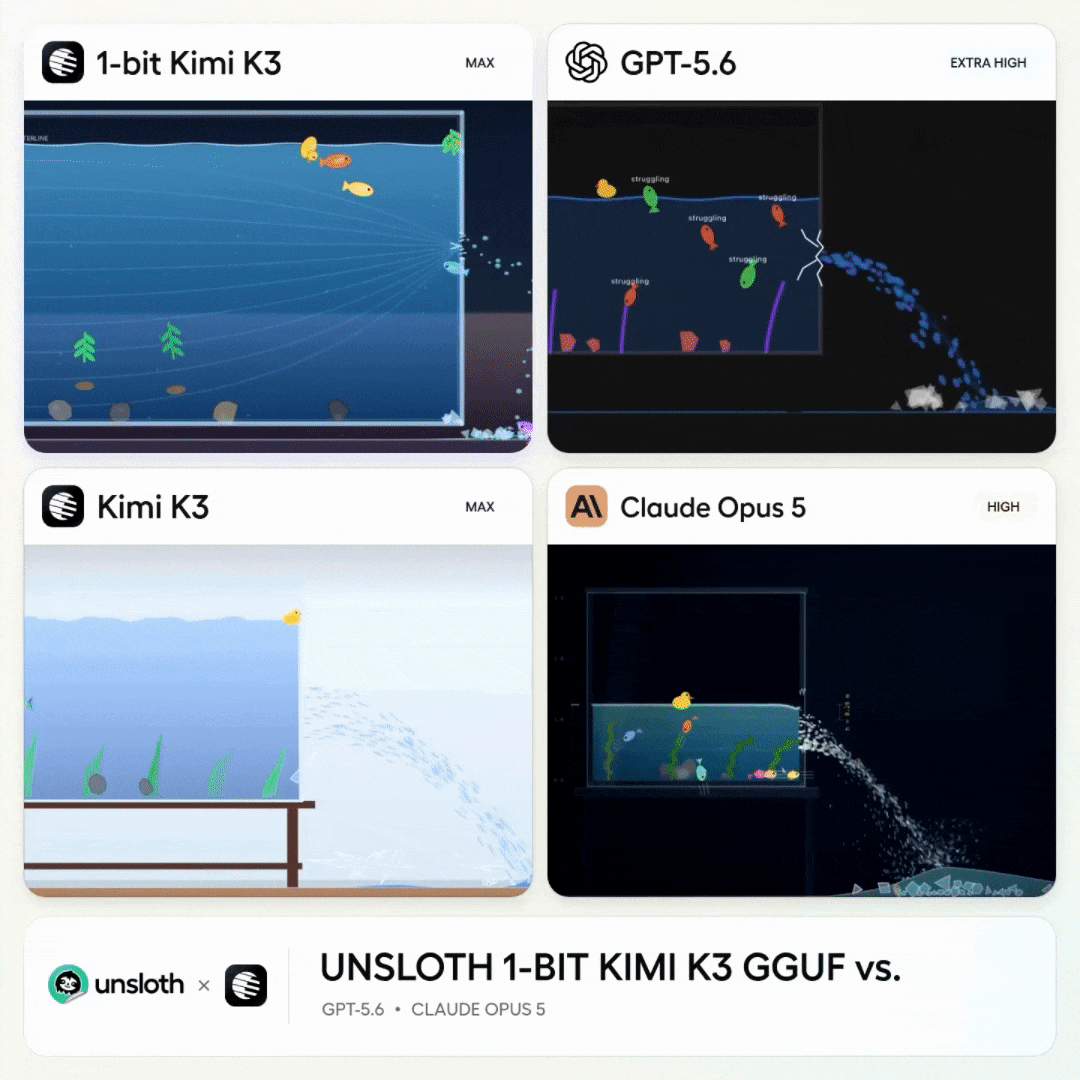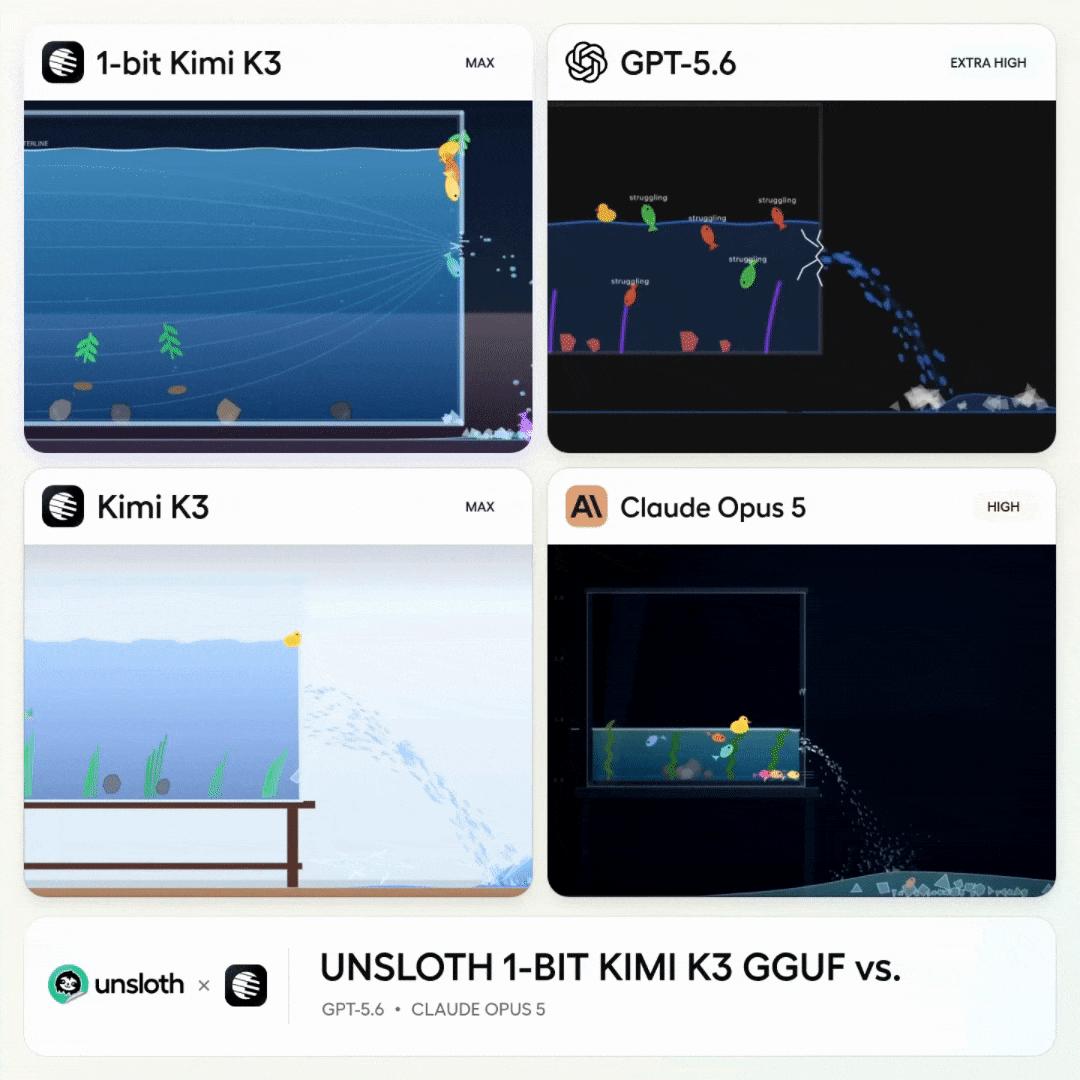
<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FIGaAihxYkmTtlCYjIMQT%2Fglm%20example.gif?alt=media&amp;token=5738222c-69e6-4be1-b777-4ccc0baf0aa3" alt=""><figcaption><p>Kimi K3 GGUF 1 bit contre Claude 5 contre GPT 5.6</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

**Tableau : exigences matérielles** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée)

| Dynamique 1 bit S | Dynamique 1 bit M | Dynamique 2 bits XXS | Dynamique 2 bits XL | Q8 (sans perte) |
| ----------------- | ----------------- | -------------------- | ------------------- | --------------- |
| 610 Go            | 665 Go            | 726 Go               | 880 Go              | 1,6 To          |

### Détails de l'implémentation GGUF de Kimi K3

Nous nous sommes appuyés sur [la PR de llama.cpp](https://github.com/ggml-org/llama.cpp/pull/26185) par [notre fork](https://github.com/unslothai/llama.cpp/pull/48) qui inclut la prise en charge de la vision et quelques corrections de bugs.

1. Le mmproj / vision tower est similaire à la tour de Kimi-K2.5, mais avec RMSNorm, sans biais, un QKV fusionné non carré (largeur qkv != n\_embd) et un projecteur post-norm.
2. Nous avons constaté qu'en exécutant llama.cpp, le `budget n_tokens * 40` échouait avec de grandes tailles de lot, et nous avons donc dû aller jusqu'à `n_tokens * 160`&#x20;
3. Nous avons également dû convertir le modèle de chat Kimi au format jinja.
4. Nous avons testé autant que possible pour couvrir tous les cas. Kimi a par défaut été entraîné avec **le raisonnement préservé activé**, donc toutes les traces de raisonnement ne sont pas supprimées, mais conservées.

### 📊 Analyse de quantification

Comme Kimi [K2.6](/docs/fr/modeles/kimi-k2.6.md) et [K2.7](/docs/fr/modeles/kimi-k2.7-code.md), celle de K3 `UD-Q8_K_XL` est sans perte parce que Kimi utilise MXFP4 pour les poids MoE et BF16 pour tout le reste, et `Q8_K_XL` le suit exactement. `UD-Q4_K_XL` est similaire, sauf que certains des tenseurs restants (sauf les normes, etc.) sont `Q8_0`, donc elle est presque en pleine précision et nécessite 1,56 To de RAM/VRAM. `UD-Q8_K_XL` est « véritablement sans perte » par rapport à la version safetensors complète MXFP4.

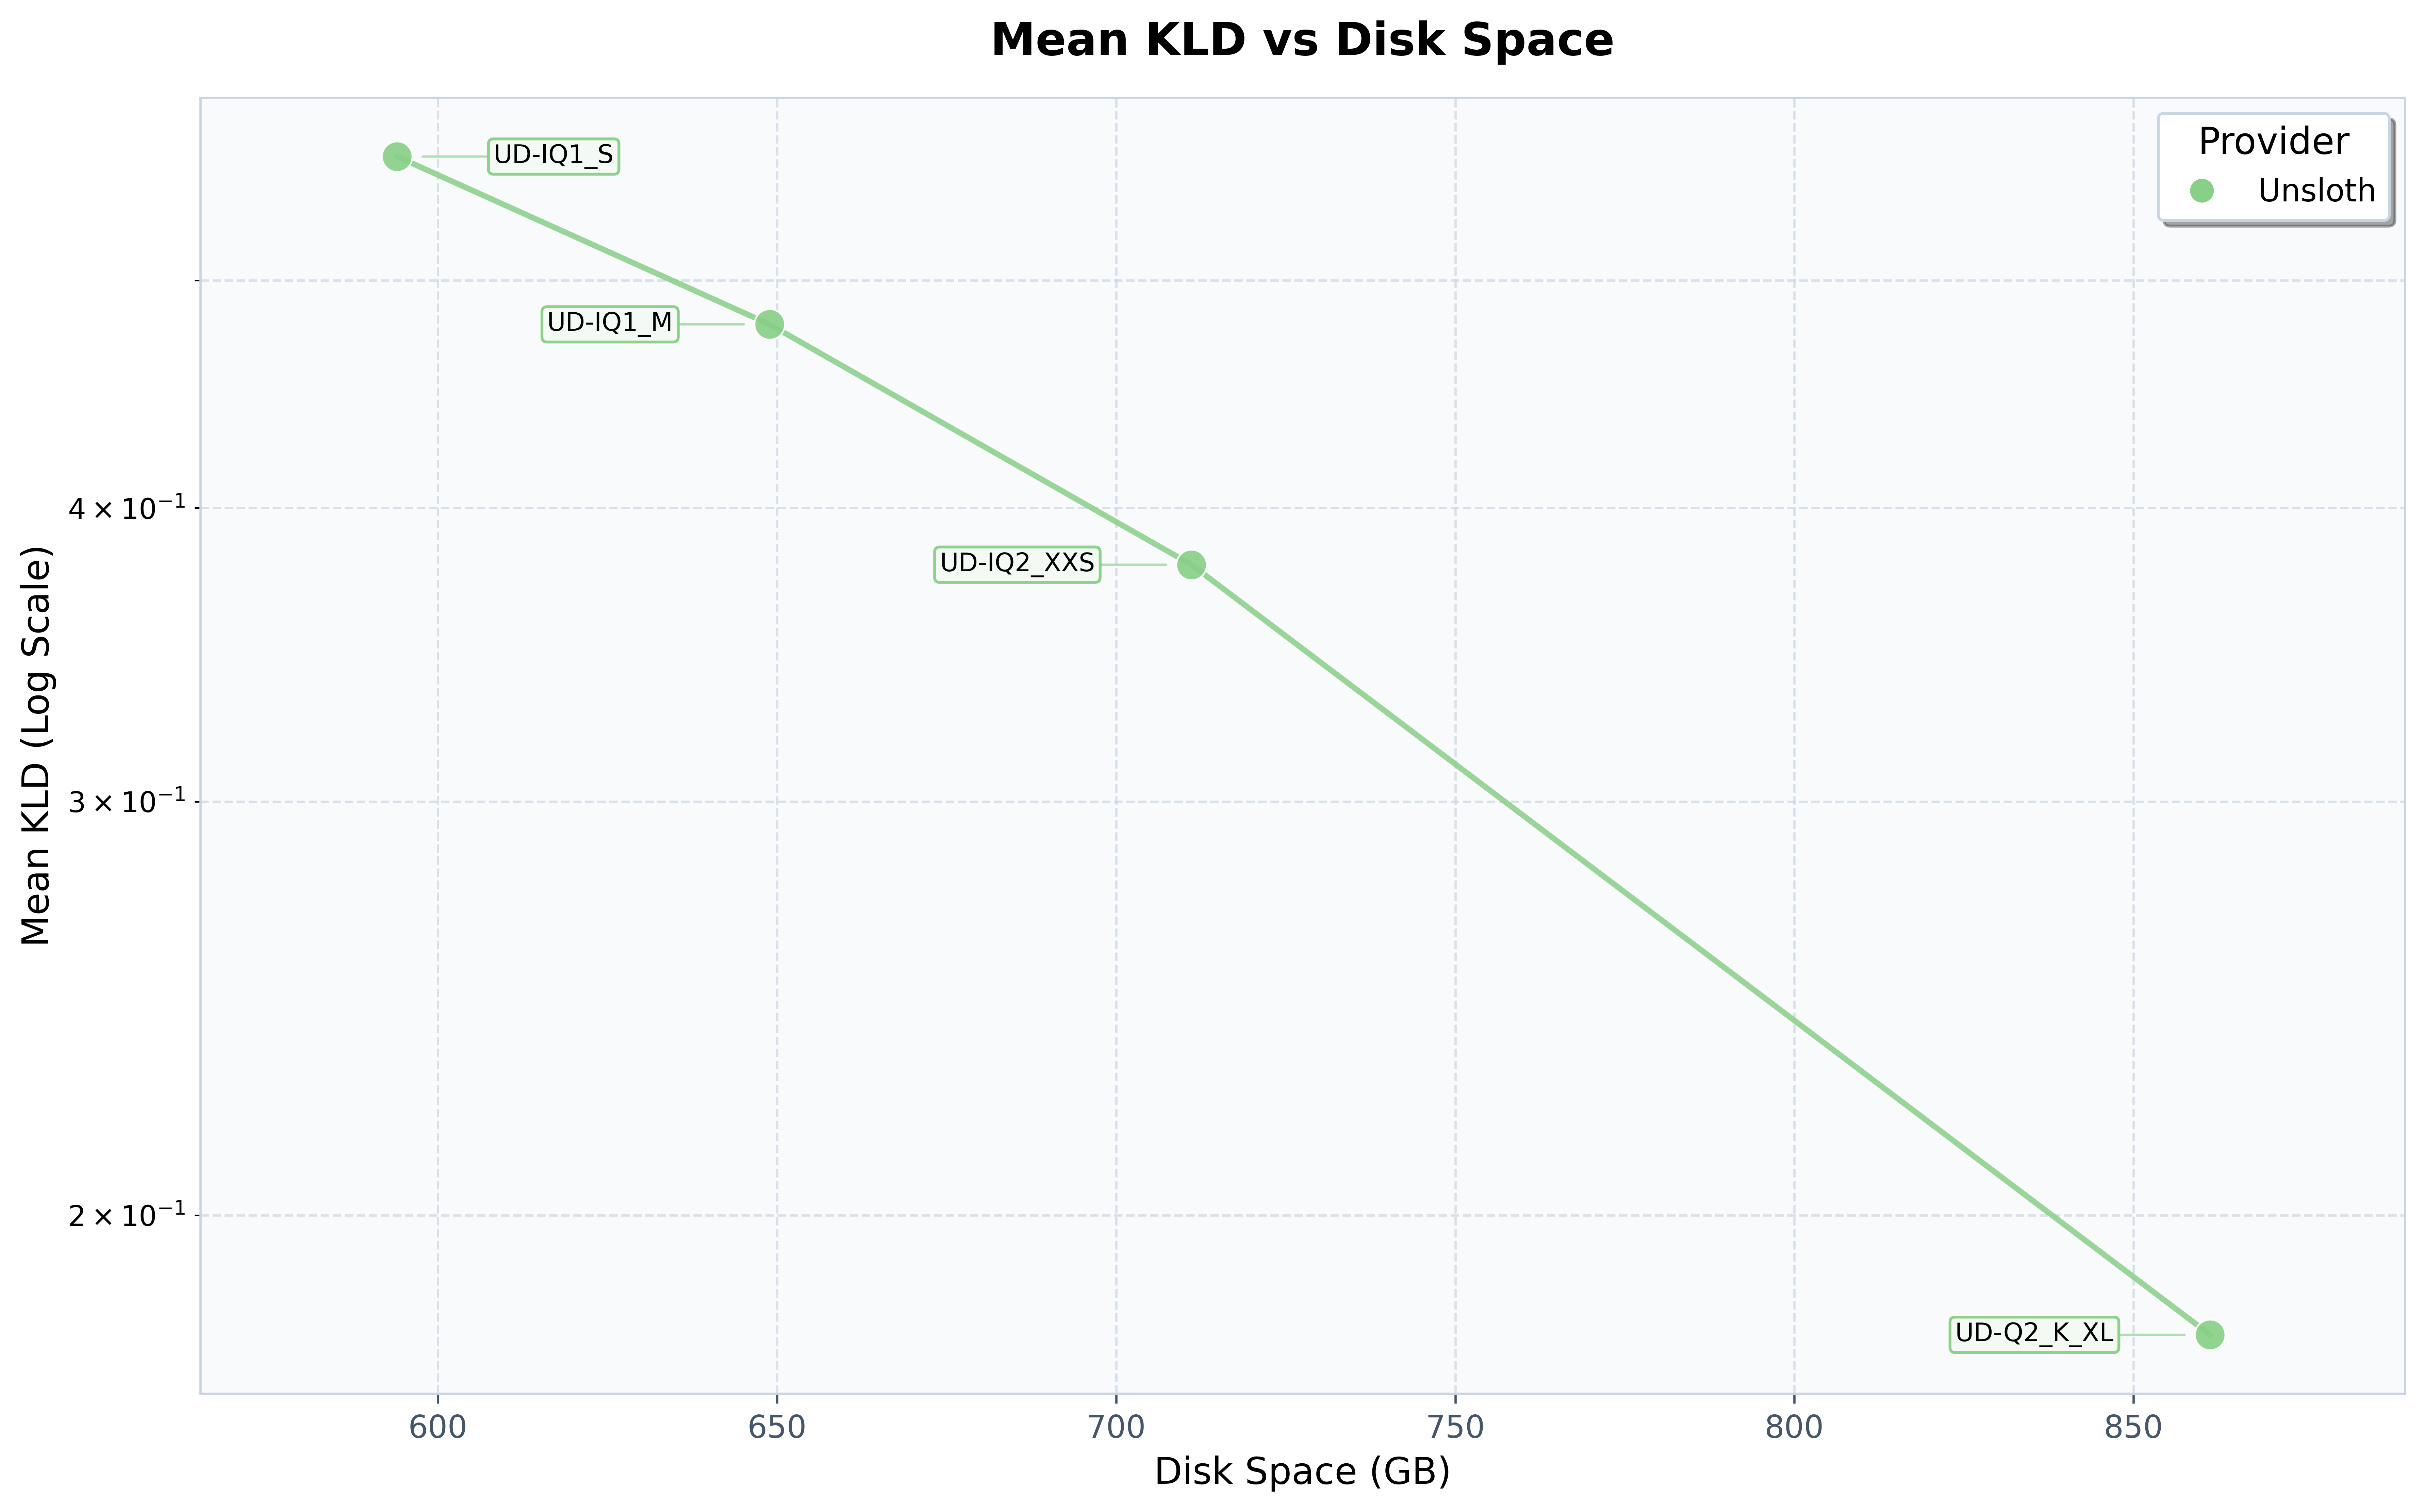
<table><thead><tr><th width="119.20001220703125">Quantification</th><th width="71.60000610351562" align="right">Go</th><th width="124.800048828125" align="right">KLD moyen</th><th width="104.9998779296875" align="right">PPL(q)</th><th width="188.79998779296875" align="right">% d'accord top-1</th><th width="140.20001220703125" align="right">RMS dp %</th></tr></thead><tbody><tr><td><code>UD-IQ1_S</code></td><td align="right">594.0</td><td align="right">0.5645</td><td align="right">2.5789</td><td align="right">78.875 +/- 0.107</td><td align="right">36.495</td></tr><tr><td><code>UD-IQ1_M</code></td><td align="right">648.9</td><td align="right">0.4789</td><td align="right">2.3639</td><td align="right">81.219 +/- 0.103</td><td align="right">33.629</td></tr><tr><td><code>UD-IQ2_XXS</code></td><td align="right">711.1</td><td align="right">0.3784</td><td align="right">2.1266</td><td align="right">84.127 +/- 0.096</td><td align="right">29.826</td></tr><tr><td><code>UD-Q2_K_XL</code></td><td align="right">861.3</td><td align="right">0.1779</td><td align="right">1.7359</td><td align="right">90.390 +/- 0.077</td><td align="right">19.862</td></tr><tr><td><code>UD-Q4_K_XL</code></td><td align="right">1,510</td><td align="right"></td><td align="right">1.4579</td><td align="right"></td><td align="right"></td></tr><tr><td><code>UD-Q8_K_XL</code></td><td align="right">1,560</td><td align="right"></td><td align="right">1.4581</td><td align="right"></td><td align="right"></td></tr></tbody></table>

Pour la génération de l'imatrix et la quantification, nous avons utilisé la version sans perte de 1,56 To `UD-Q8_K_XL` tout au long de l'étalonnage ; sa perplexité est de 1,4581. Notre quantification Dynamic-1bit atteint une perplexité de 2,58 avec une précision top-1 de 79 %, ce qui la rend étonnamment utilisable.

Les quantifications communautaires sont plus volumineuses tout en se dégradant bien davantage. Par exemple, une quantification de 618,9 Go `IQ1_M` dépasse notre quantification 1 bit de 594 Go, mais sa perplexité grimpe à 54,56 - 21× pire. Le même schéma vaut pour `IQ2_XXS`: 725 Go à 96 PPL contre nos 711 Go à 2,12 PPL - 45× pire, ce qui signifie que leur 2 bits fait encore pire que leur 1 bit. Cela souligne l'importance de la quantification dynamique + d'un étalonnage adéquat.

**Nous fournissons également les graphiques de précision top-1 % et de KLD :**

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FfJOkWbg4O0vmlatF2nDY%2Ftop1_agreement_vs_disk_space_kld_style.png?alt=media&amp;token=77eb470c-b203-4ba8-a3d6-87d04af5c671" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fk4oLNDcM6nP8MG432DKE%2Fimage.png?alt=media&amp;token=4e5bdff7-6656-43d5-a902-62d97fd07fe1" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FfNYtyZStOo5RY6NSod4r%2Fmean_kld_vs_disk_space.png?alt=media&amp;token=1cd52540-48e2-49fa-9320-8b62c7b3f455" alt=""><figcaption></figcaption></figure></div>

### :gear: Guide d’utilisation

Kimi K3 est **uniquement en mode réflexion**, avec **`preserve_thinking` la réflexion toujours activée** et **maximal** activée par défaut. Le mode instantané n'est pas pris en charge. L'effort de réflexion se configure avec le `reasoning_effort` champ request, et K3 prend en charge `"low"`, `"high"`et `"max"` efforts de réflexion.

| Par défaut        | Agentique         |
| ----------------- | ----------------- |
| température = 1.0 | température = 1.0 |
| top\_p = 0.95     | top\_p = 1.0      |

* Longueur de contexte = jusqu'à `1,048,576`
* La réflexion faible, élevée ou maximale peut être activée dans Unsloth

Si le modèle tient, vous obtiendrez une génération d'environ 20 jetons/s en utilisant des B200 et un débit >120 jetons/s. Nous recommandons [`UD-IQ1_S`](https://huggingface.co/unsloth/Kimi-K3-GGUF?show_file_info=UD-IQ1_S%2FKimi-K3-UD-IQ1_S-00001-of-00015.gguf) (594 Go) comme bon compromis taille/qualité. Règle générale : RAM+VRAM ≈ la taille de la quantification ; sinon, cela fonctionnera quand même, mais beaucoup plus lentement à cause du déchargement sur disque.

## Guide pour exécuter Kimi K3

Vous pouvez désormais exécuter Kimi K3 dans [llama.cpp](#run-in-llama.cpp) et [Unsloth Desktop](https://unsloth.ai/docs/fr/modeles/pages/5a7cb89811055498b527bf86240cffd678766c37#run-glm-5.2-in-unsloth-studio). Nous utiliserons la quantification de 594 Go [`UD-IQ1_S`](https://huggingface.co/unsloth/Kimi-K3-GGUF?show_file_info=UD-IQ1_S%2FKimi-K3-UD-IQ1_S-00001-of-00015.gguf) pour obtenir les meilleurs résultats en termes d'accessibilité et de précision, et elle nécessitera au moins 610 Go de RAM. N'hésitez pas à changer le type de quantification. GGUF : [**Kimi-K3-GGUF**](https://huggingface.co/unsloth/Kimi-K3-GGUF)

### 🦥 Exécuter Kimi-K3 dans Unsloth

Kimi K3 peut s'exécuter dans [Unsloth Desktop](/docs/fr/desktop.md), une interface de bureau open source pour l'IA locale. **Unsloth Desktop décharge automatiquement vers la RAM et détecte les configurations multi-GPU**. Avec Unsloth Studio, vous pouvez exécuter des modèles localement sur **macOS, Windows**, Linux et :

{% columns %}
{% column %}

* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally) et des modèles safetensor
* [**Auto-réparation** appel d’outils](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) + **recherche web**
* [**exécution de code**](/docs/fr/nouveau/studio.md#run-models-locally) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence CPU + GPU rapide via llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
  {% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6IXaXdTVyvbrnjehlxys%2Fkimik3.gif?alt=media&amp;token=31e1213b-d7da-46e9-bc7f-3a8c402513fc" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}
**Installer et lancer Unsloth**

La façon la plus simple de commencer est de télécharger l' [application Unsloth Desktop](/docs/fr/desktop.md). Fonctionne sur [macOS](/docs/fr/commencer/install/mac.md), [Windows](/docs/fr/commencer/install/windows-installation.md)et [Linux](/docs/fr/commencer/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Télécharger Unsloth</a>

* <i class="fa-apple">:apple:</i> [Télécharger pour macOS](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Télécharger pour Windows](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Télécharger pour Linux](https://unsloth.ai/download/linux)

Ou, si vous préférez installer manuellement :

MacOS, Linux, WSL :

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

Windows PowerShell :

```bash
irm https://unsloth.ai/install.ps1 | iex
```

**Lancer Unsloth**

MacOS, Linux, WSL et Windows :

```bash
unsloth studio
```

Puis ouvrez `http://127.0.0.1:8888` (ou votre URL spécifique) dans votre navigateur.

**Lancez Unsloth en toute sécurité avec HTTPS et Cloudflare**

**NOUVEAU !** Unsloth propose désormais un moyen sécurisé de lancer Unsloth via HTTPS grâce à un tunnel Cloudflare gratuit. Utilisez ce qui suit (fonctionne sous Windows, Mac et Linux) :

```bash
unsloth studio --secure
```

{% endstep %}

{% step %}
**Rechercher et télécharger Kimi K3**

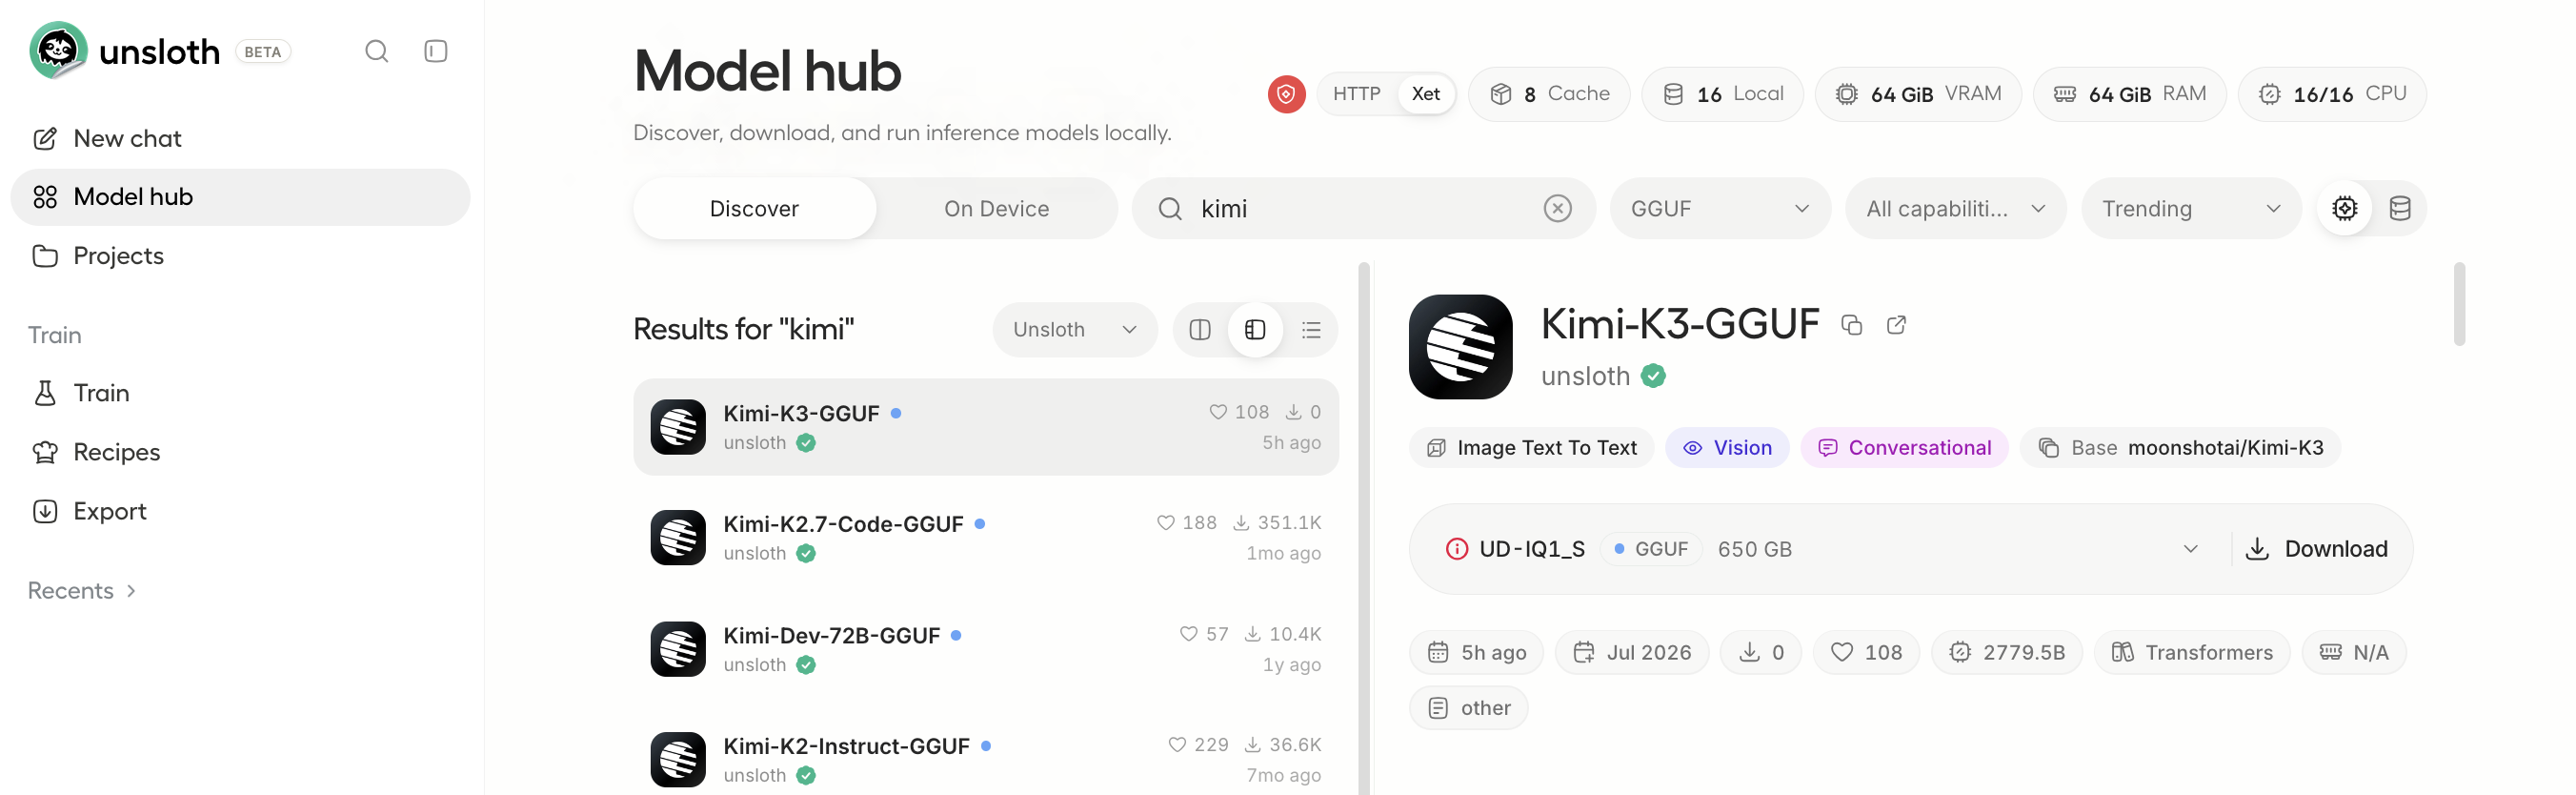
Unsloth Studio décharge automatiquement vers la RAM et détecte les configurations multi-GPU. Au premier lancement, vous devrez créer un mot de passe pour sécuriser votre compte et vous reconnecter plus tard.

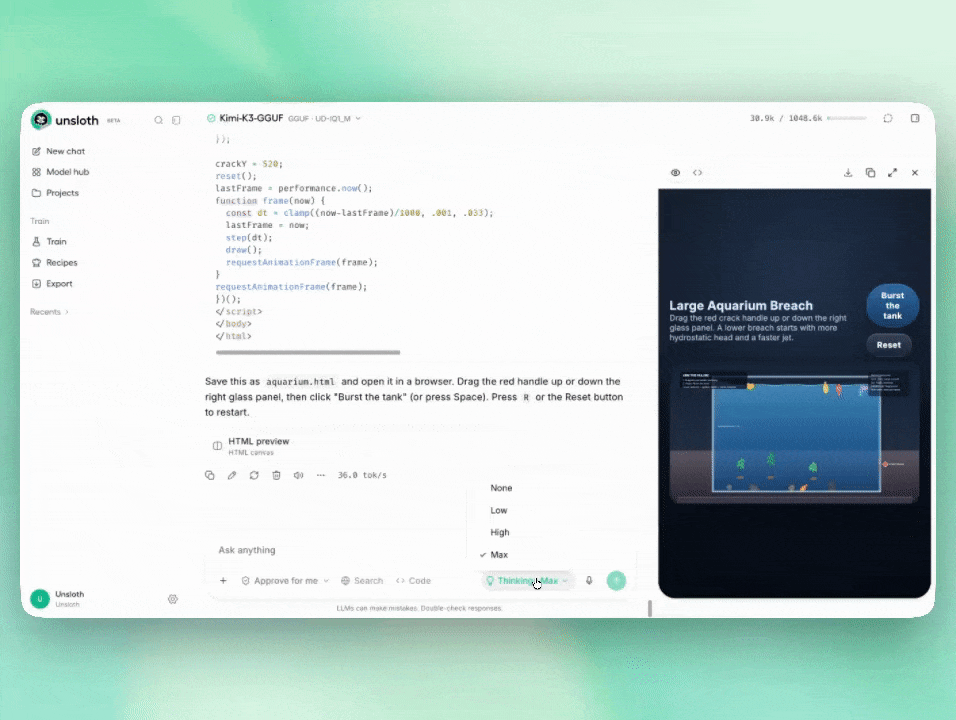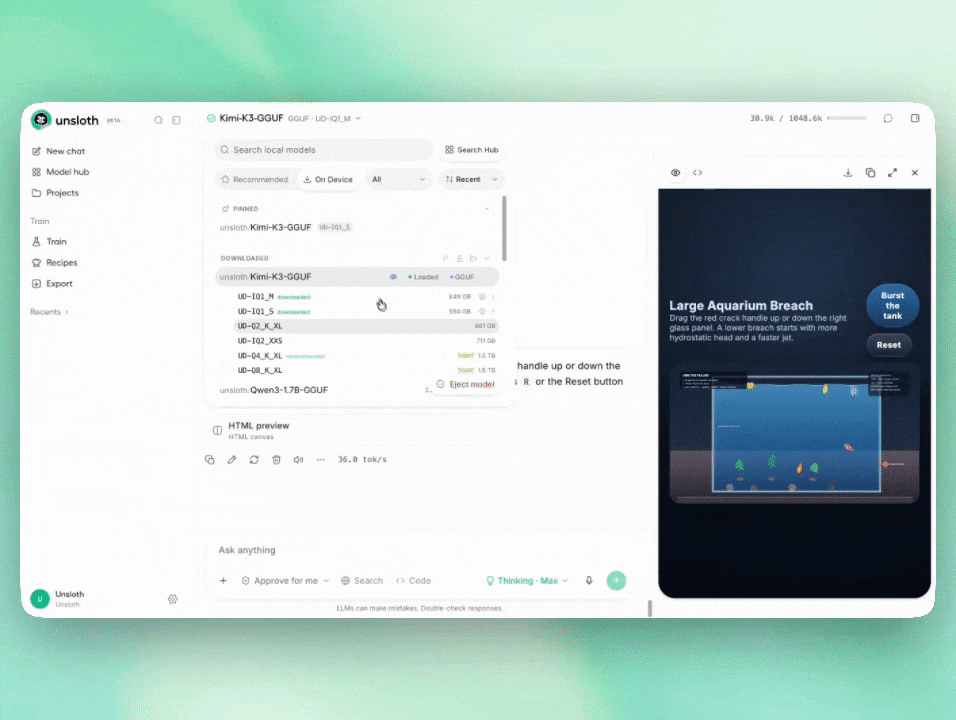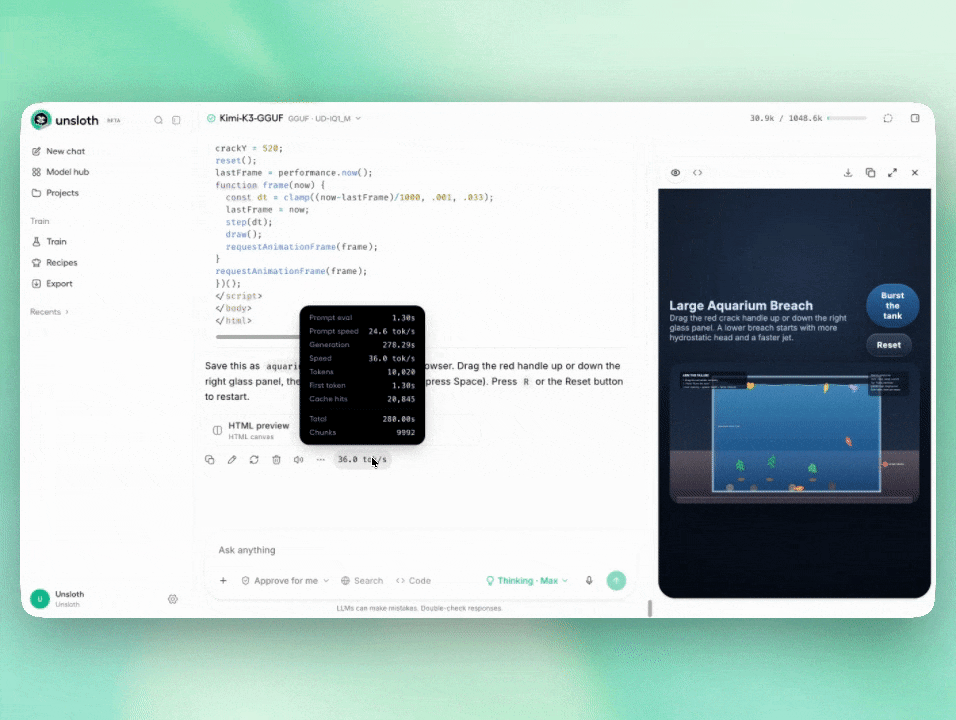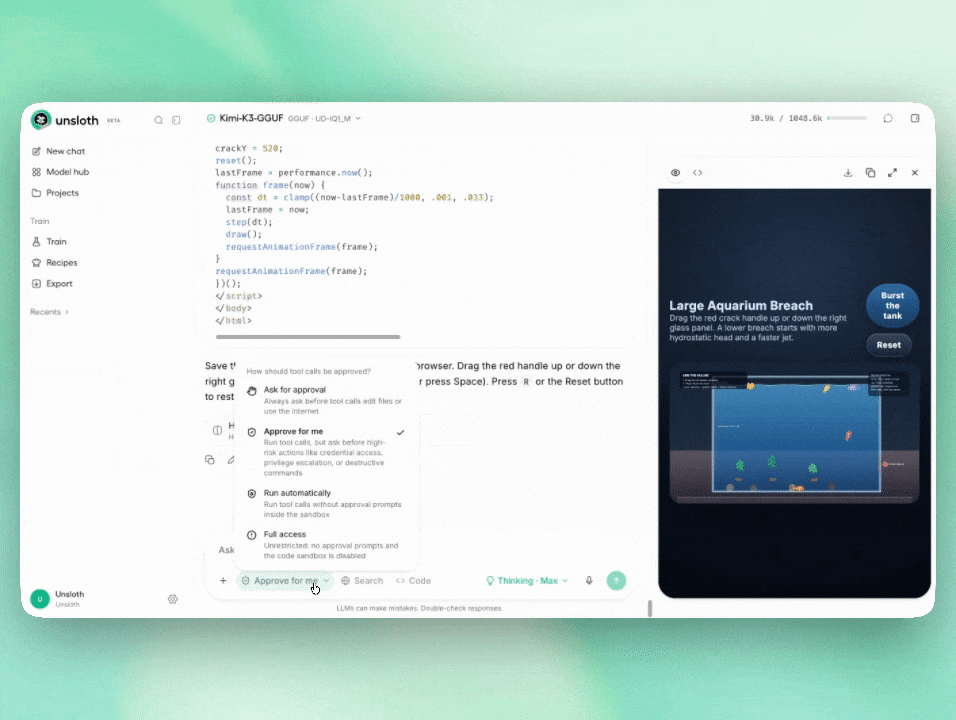
Puis allez dans l'onglet Model hub et recherchez **Kimi K3** dans la barre de recherche et téléchargez le modèle et la quantification de votre choix. Assurez-vous d’avoir suffisamment de ressources de calcul pour exécuter le modèle.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fl55nPVDRlWRPoZOnHyg2%2FScreenshot%202026-07-29%20at%203.12.19%E2%80%AFAM.png?alt=media&amp;token=4f910816-8075-4d14-b398-bc00a417a710" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}
**Exécuter Kimi K3**

Les paramètres d'inférence devraient être définis automatiquement lors de l'utilisation d'Unsloth Studio, toutefois vous pouvez encore les modifier manuellement. Vous pouvez aussi basculer **la réflexion faible, élevée ou maximale**, modifier la longueur de contexte, le modèle de chat et d'autres paramètres.

Pour plus d’informations, vous pouvez consulter notre [guide d’inférence d’Unsloth Studio](/docs/fr/nouveau/studio/chat.md).

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6IXaXdTVyvbrnjehlxys%2Fkimik3.gif?alt=media&amp;token=31e1213b-d7da-46e9-bc7f-3a8c402513fc" alt=""><figcaption><p>Exemple de Kimi-K3 1 bit exécuté avec Canvas d'Unsloth</p></figcaption></figure>
{% endstep %}
{% endstepper %}

### 🦙 Exécuter Kimi K3 dans llama.cpp

Pour ces tutoriels, nous utiliserons [llama.cpp](https://github.com/ggml-org/llama.cpp) pour une inférence locale rapide, surtout si vous avez un CPU. Nous [avons créé un fork](https://github.com/unslothai/llama.cpp/pull/48) spécifiquement pour prendre en charge la vision de Kimi K3. Cela s'appuie sur un autre [la PR de llama.cpp](https://github.com/ggml-org/llama.cpp/pull/26185).

{% stepper %}
{% step %}
Obtenez le fork Unsloth SPÉCIFIQUE de `llama.cpp` sur [**GitHub ici**](https://github.com/unslothai/llama.cpp/pull/48) pour activer la prise en charge de la vision. Vous pouvez également suivre les instructions de compilation ci-dessous. Changez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.

```bash
git clone https://github.com/unslothai/llama.cpp
cd llama.cpp
git fetch origin pull/48/head:kimi-k3-fullsize-vision
git checkout kimi-k3-fullsize-vision
cd ..
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
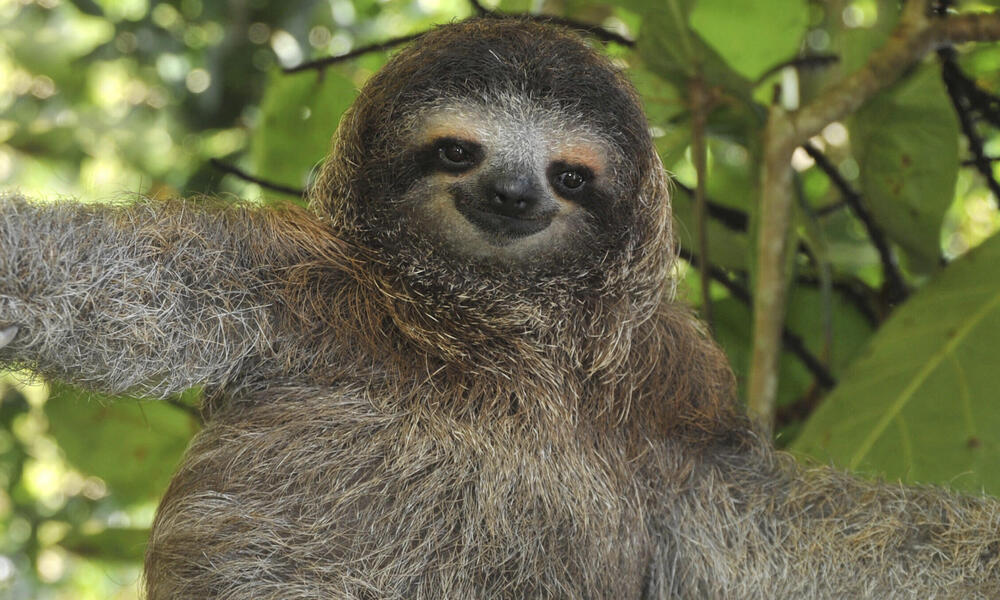
**Commençons par obtenir une image !** Vous pouvez également téléverser des images. Nous utiliserons [cette image](https://raw.githubusercontent.com/unslothai/unsloth/refs/heads/main/images/unsloth%20made%20with%20love.png), qui est simplement notre mini-logo montrant comment les fine-tunes sont réalisés avec Unsloth :

{% code overflow="wrap" %}

```bash
wget https://raw.githubusercontent.com/unslothai/unsloth/refs/heads/main/images/unsloth%20made%20with%20love.png -O unsloth.png
```

{% endcode %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-9bf7ec93680f889d7602e5f56a8d677d6a58ae6a%2Funsloth%20made%20with%20love.png?alt=media" alt="" width="188"><figcaption></figcaption></figure>

Prenons ensuite la 2e image [ici](https://files.worldwildlife.org/wwfcmsprod/images/Sloth_Sitting_iStock_3_12_2014/story_full_width/8l7pbjmj29_iStock_000011145477Large_mini__1_.jpg)

{% code overflow="wrap" %}

```bash
wget https://files.worldwildlife.org/wwfcmsprod/images/Sloth_Sitting_iStock_3_12_2014/story_full_width/8l7pbjmj29_iStock_000011145477Large_mini__1_.jpg -O picture.png
```

{% endcode %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-4b30cc86b2c75edf95ee1ec6fe0c51fb30afd6c0%2F8l7pbjmj29_iStock_000011145477Large_mini__1_.jpg?alt=media" alt="" width="188"><figcaption></figcaption></figure>
{% endstep %}

{% step %}
Vous pouvez désormais utiliser `llama.cpp` directement pour charger et télécharger des modèles, tout comme `ollama run`. `IQ1_S`. Utilisez aussi `export LLAMA_CACHE="folder"` pour forcer `llama.cpp` pour enregistrer à un emplacement spécifique. **Notez que ce processus de téléchargement peut être très lent**, donc il vaut probablement mieux utiliser le processus de téléchargement manuel dans la section suivante.

```bash
export LLAMA_CACHE="unsloth/Kimi-K3-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/Kimi-K3-GGUF:UD-IQ1_S \\
    --temp 1.0 \
    --top-p 0.95
```

{% endstep %}

{% step %}
Si vous souhaitez télécharger le modèle manuellement, nous pouvons le télécharger via le code ci-dessous (après avoir installé `pip install huggingface_hub`). Si les téléchargements se bloquent, voir : [Débogage de Hugging Face Hub et XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/Kimi-K3-GGUF \\
    --local-dir unsloth/Kimi-K3-GGUF \\
    --include "*mmproj-BF16*" \\
    --include "*UD-IQ1_S*" # Utilisez "*UD-Q8_K_XL*" pour la précision complète
```

{% endstep %}

{% step %}
Puis exécutez le modèle en mode conversation :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Kimi-K3-GGUF/UD-IQ1_S/Kimi-K3-UD-IQ1_S-00001-of-00014.gguf \\
    --mmproj unsloth/Kimi-K3-GGUF/mmproj-BF16.gguf \\
    --temp 1.0 \
    --top-p 0.95
```

{% endcode %}
{% endstep %}

{% step %}
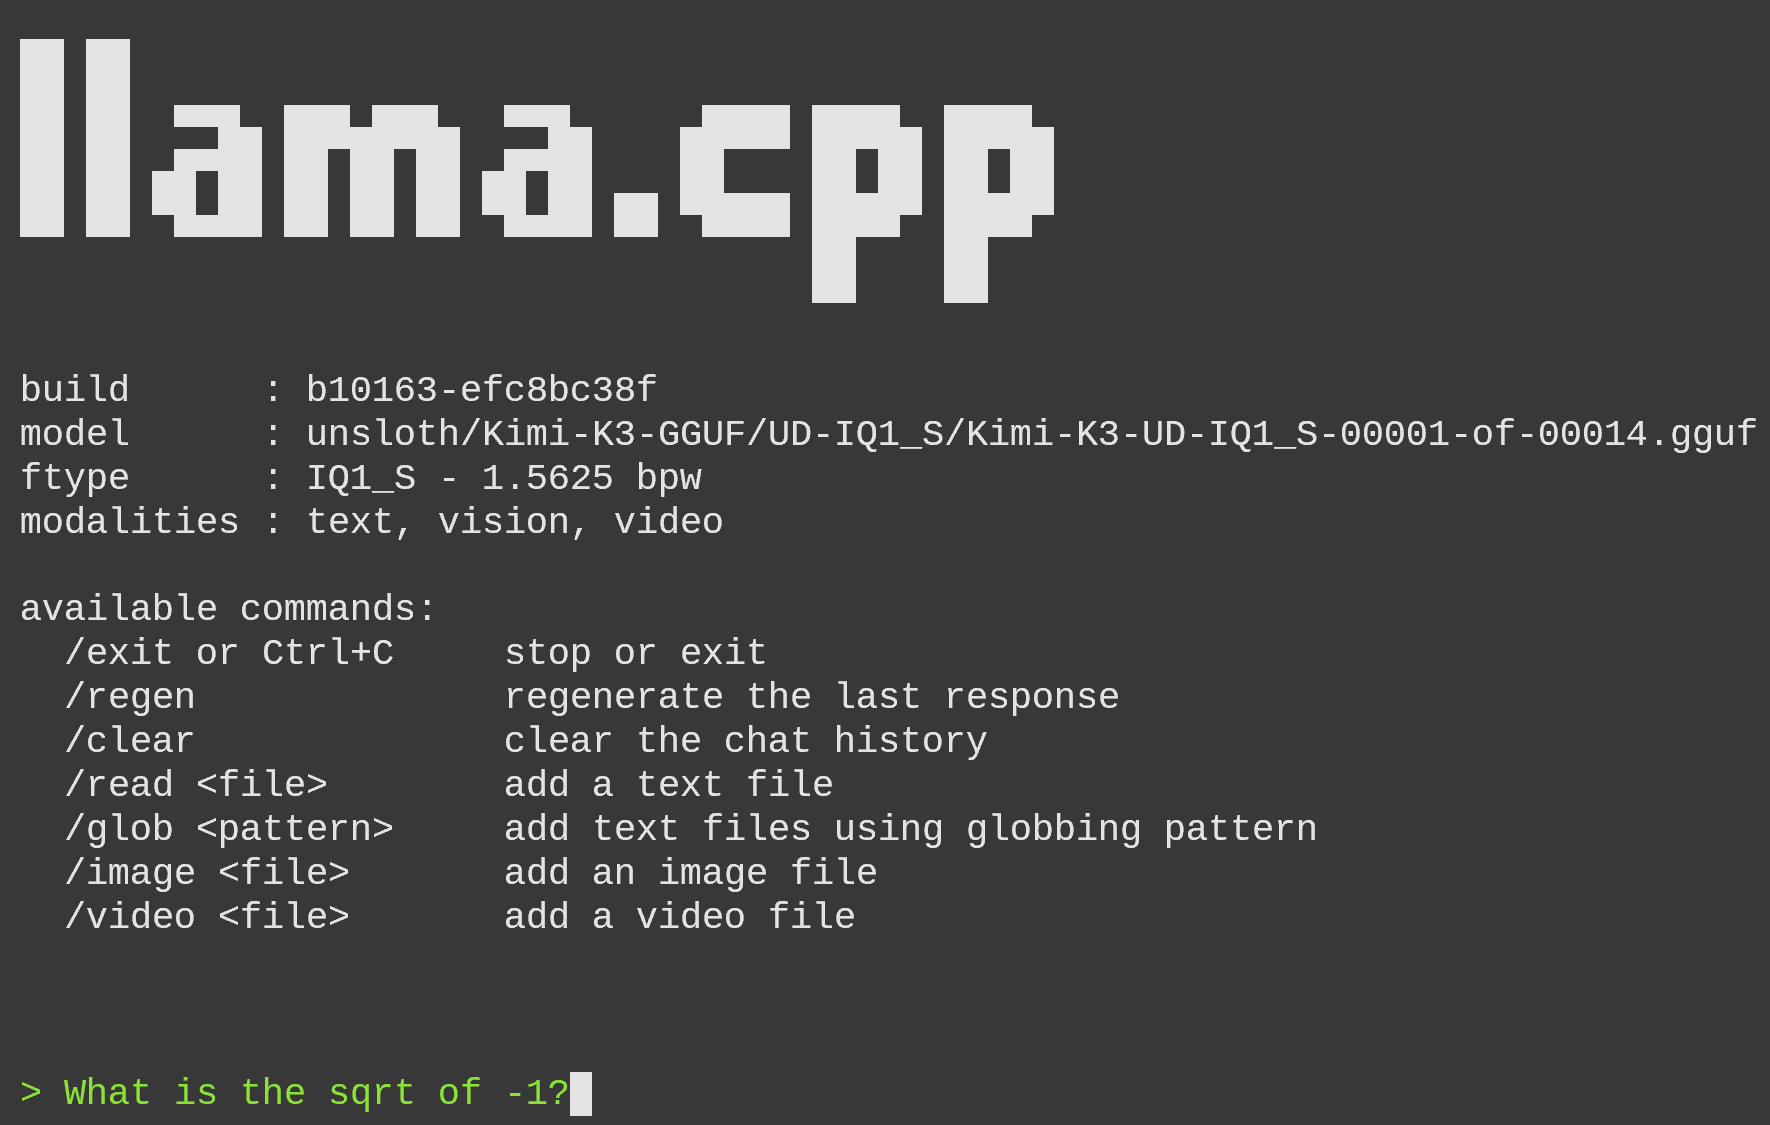
Vous verrez alors :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FtouOdsj4Tp5WUdcL2cPW%2Fimage.png?alt=media&amp;token=4d0f99e4-a445-4192-9f46-0ccddbef491a" alt=""><figcaption></figcaption></figure>

Et j'ai demandé « Quelle est la racine carrée de -1 » :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FT4nvcX4WX5gj2v2Xy9QZ%2Fimage.png?alt=media&amp;token=131a605c-71ea-4d63-8ed4-2c2bcbe3a33d" alt=""><figcaption></figcaption></figure>

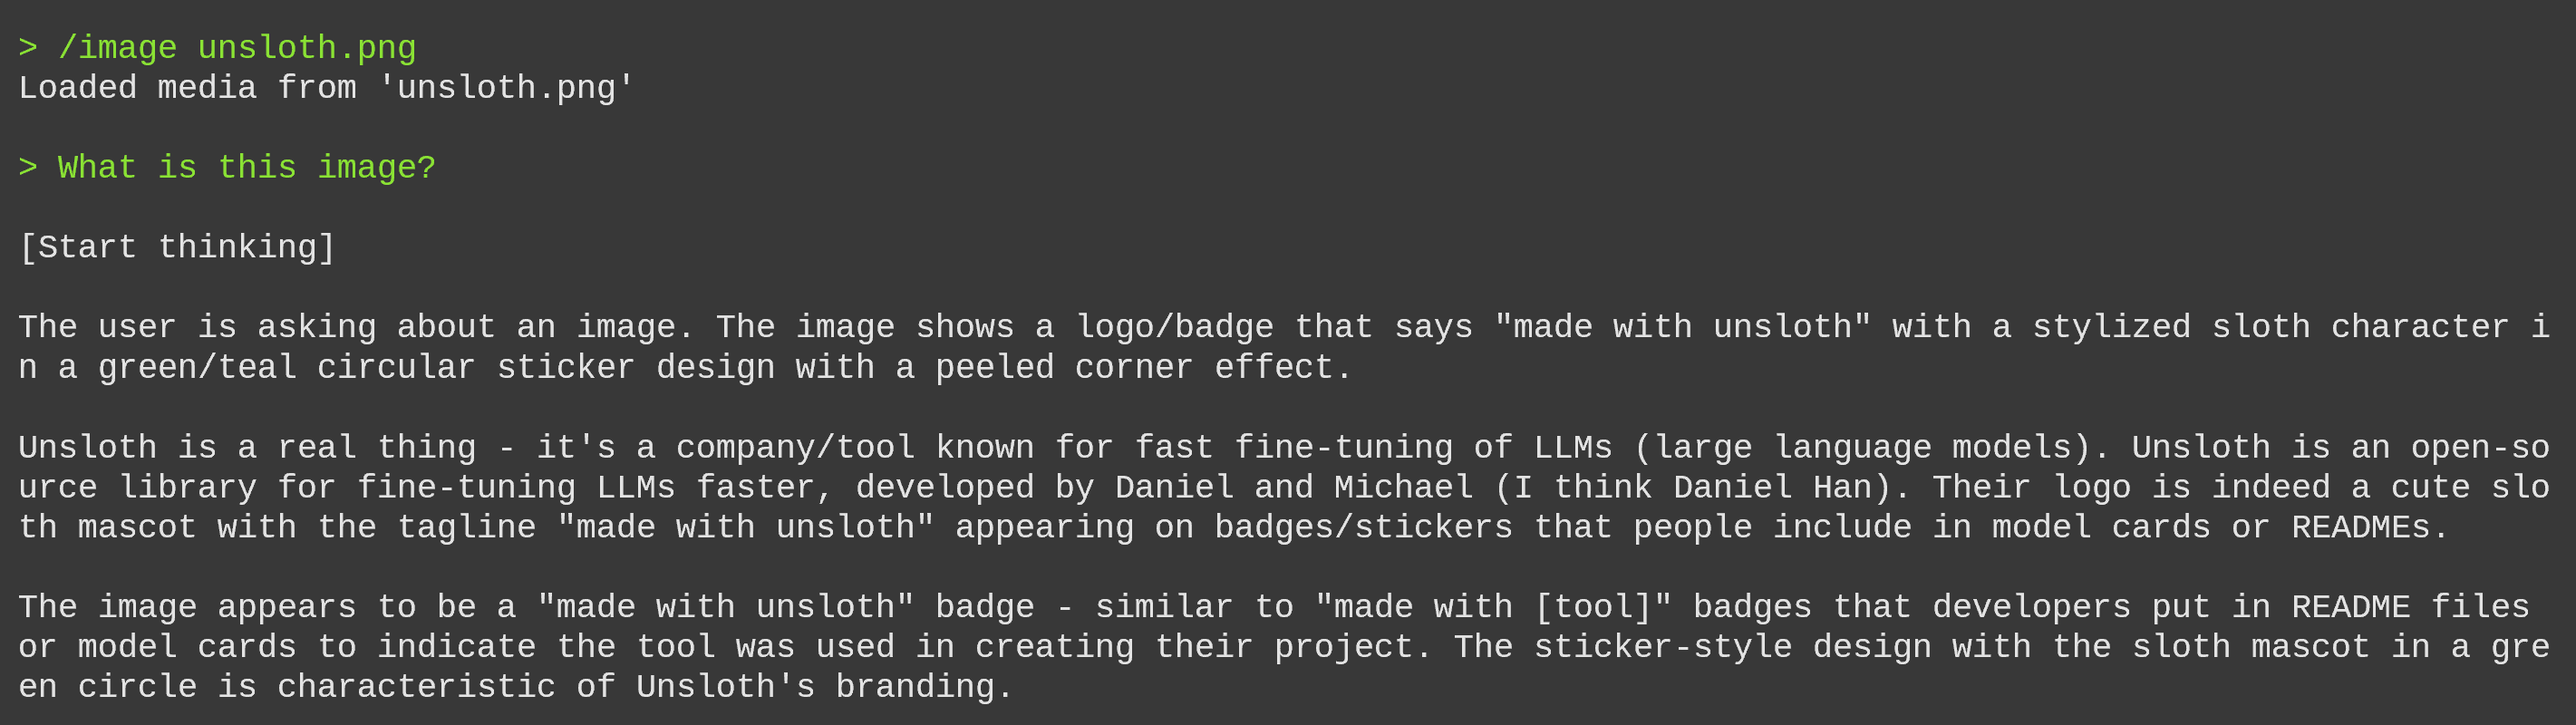
Kimi K3 prend également en charge les images, par exemple pour charger l'image Unsloth :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6MtRrPbvTC4hJES82tVr%2Fimage.png?alt=media&amp;token=c22702b1-ba97-4daf-8ea2-9c215d63a989" alt=""><figcaption></figcaption></figure>

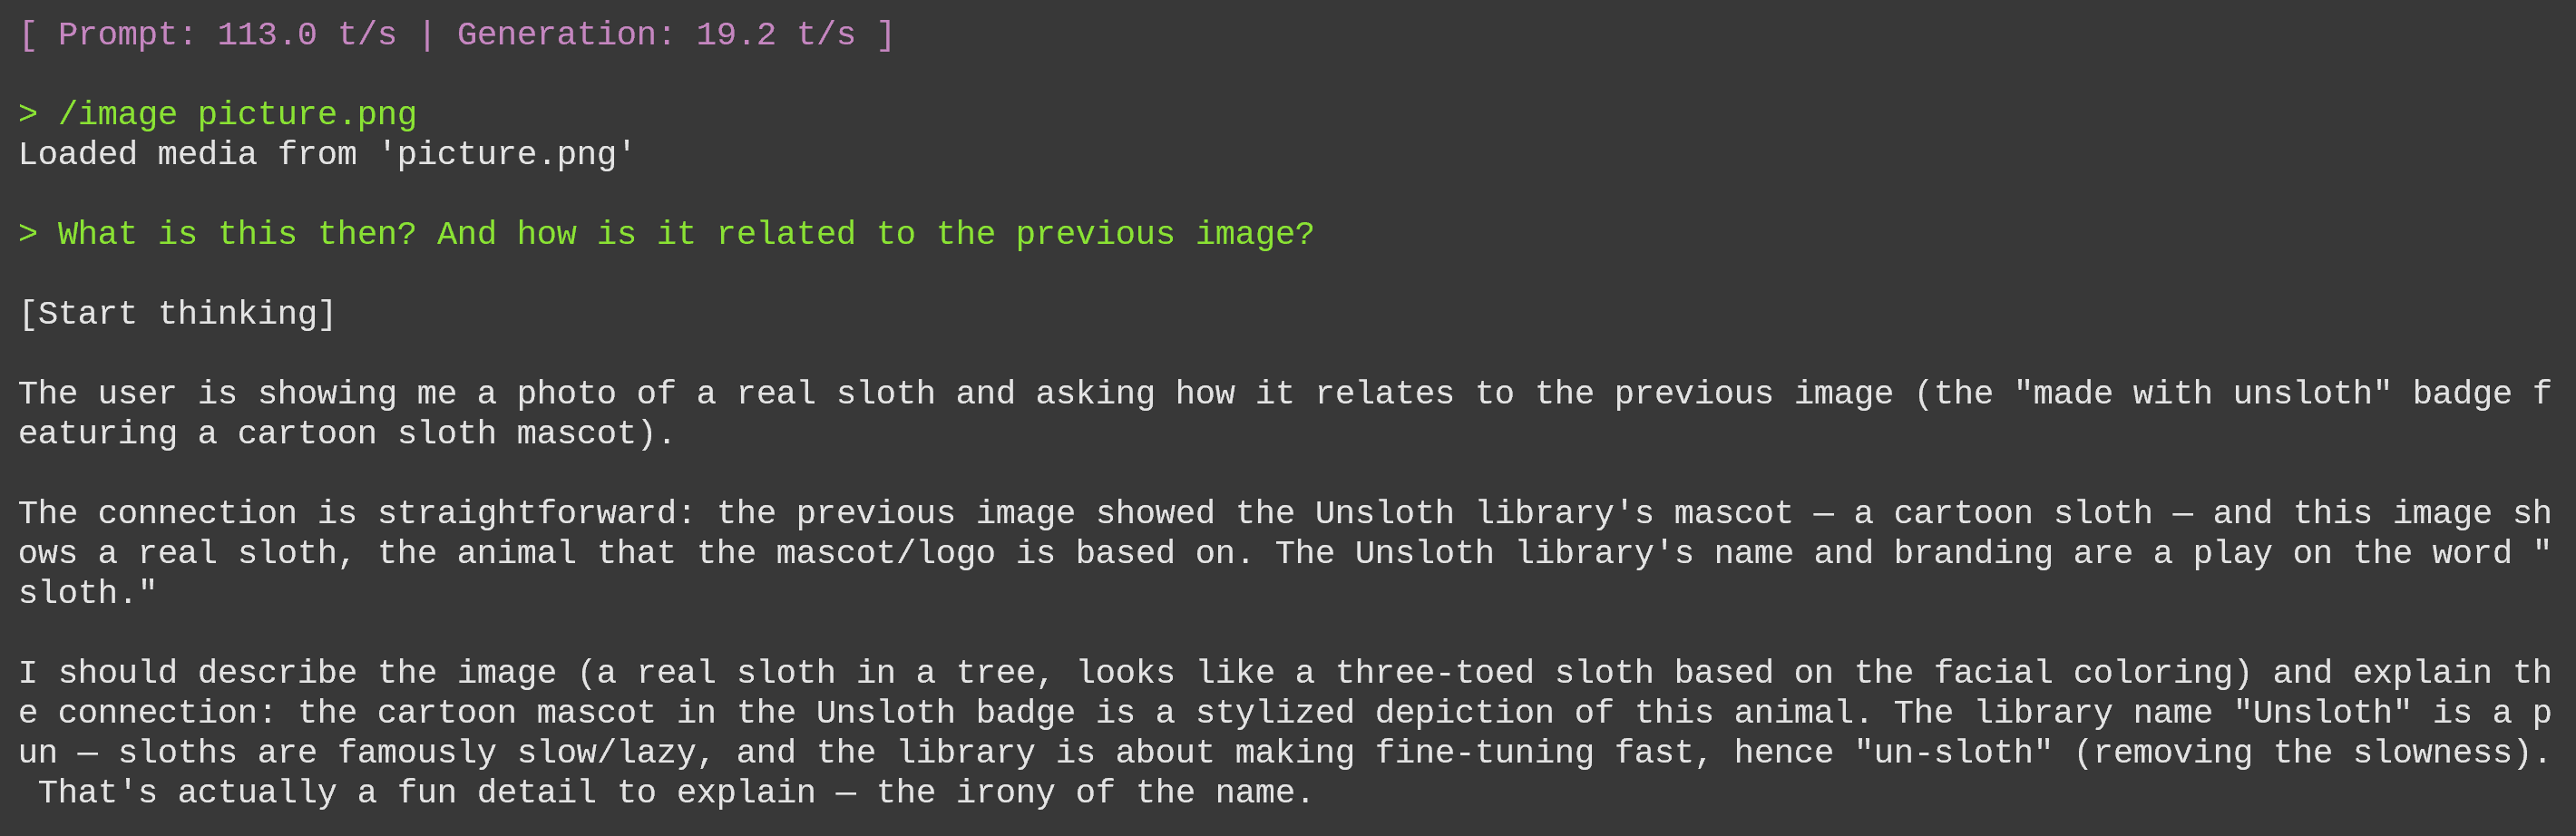
Puis nous utilisons l'image du paresseux et demandons quel est son lien :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FG78fX5KL4c4ua0A0JGv2%2Fimage.png?alt=media&amp;token=26ef7516-7f63-4ad2-932f-fc0b5e6b4f07" alt=""><figcaption></figcaption></figure>
{% endstep %}
{% endstepper %}

### 📊 Benchmarks

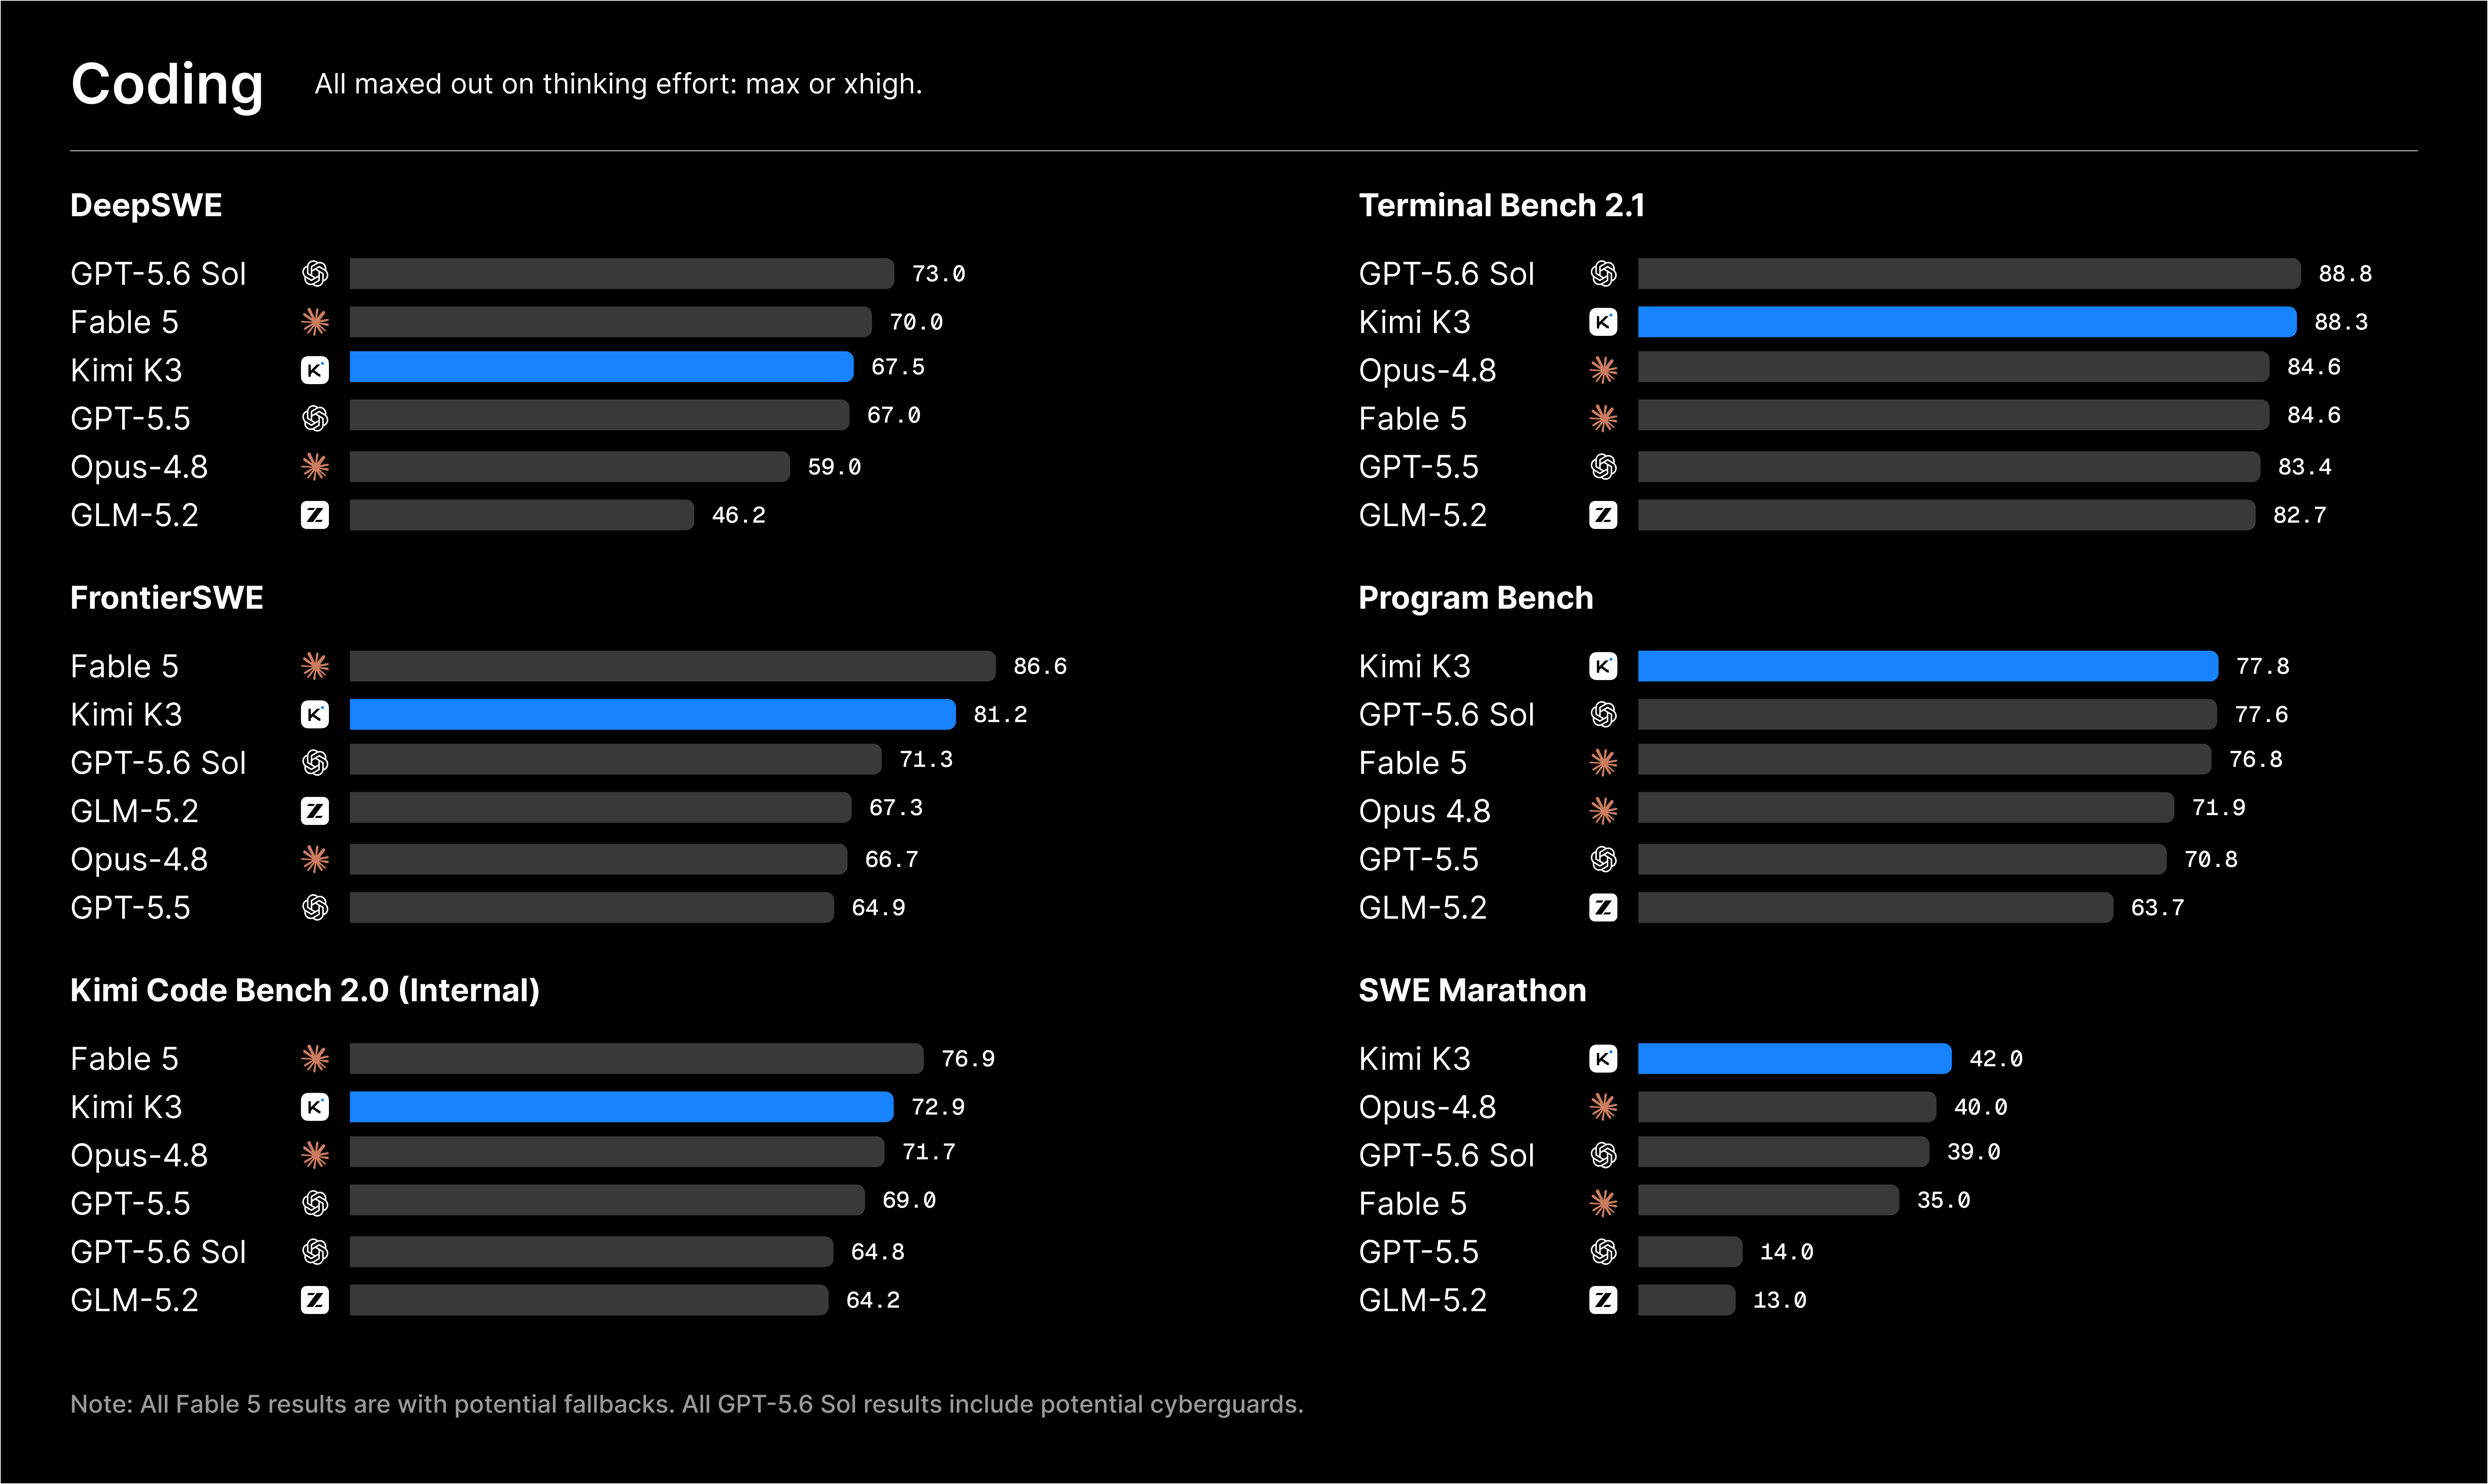
Vous pouvez voir plus bas les benchmarks sous forme de tableau :

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FD2DjGdyP0gZOWx2aNHql%2Fkimik3%20bench.png?alt=media&amp;token=2d53268a-fb98-486e-a60d-fe187f8bf946" alt=""><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F04Z9ZT24kAfEmyXYgdrK%2Fkimik3agentbench.png?alt=media&amp;token=a0a23807-ce6d-4ac5-8bd3-e08c547a5cfd" alt=""><figcaption></figcaption></figure></div>

|             Benchmark             | Kimi K3&#xA;(max) | Claude Fable 5&#xA;(max) | GPT-5.6 Sol&#xA;(max) | Claude Opus 4.8&#xA;(max) | GPT-5.5&#xA;(xhigh) | GLM-5.2&#xA;(max) |
| :-------------------------------: | :---------------: | :----------------------: | :-------------------: | :-----------------------: | :-----------------: | :---------------: |
| **Raisonnement et connaissances** |                   |                          |                       |                           |                     |                   |
|            GPQA Diamond           |        93.5       |           92.6           |        **94.1**       |            91.0           |         93.5        |        91.2       |
|              HLE-Full             |    43.5 / 56.0    |      **53.3 / 63.0**     |      44.5 / 58.0      |        49.8 / 57.9        |     41.4 / 52.2     |         —         |
|             **Codage**            |                   |                          |                       |                           |                     |                   |
|              DeepSWE              |        67.5       |           70.0           |        **73.0**       |            59.0           |         67.0        |        46.2       |
|         Terminal-Bench 2.1        |        88.3       |           88.0           |        **88.8**       |            84.6           |         83.4        |        82.7       |
|           **Agentique**           |                   |                          |                       |                           |                     |                   |
|             BrowseComp            |      **91.2**     |           88.0           |          90.4         |            84.3           |         84.4        |         —         |
|         GDPval-AA v2 (Elo)        |        1686       |         **1747**         |          1736         |            1593           |         1491        |        1510       |
|            OSWorld 2.0            |        58.3       |         **66.1**         |          62.6         |            55.7           |         49.5        |         —         |
|             **Vision**            |                   |                          |                       |                           |                     |                   |
|              MMMU-Pro             |    81.6 / 83.4    |      81.2 / **86.5**     |    **83.0** / 84.6    |        78.9 / 82.7        |     81.2 / 83.2     |         —         |
|             MathVision            |    94.3 / 97.8    |      94.8 / **98.6**     |    **95.8** / 97.8    |        86.7 / 97.1        |     92.2 / 96.8     |         —         |

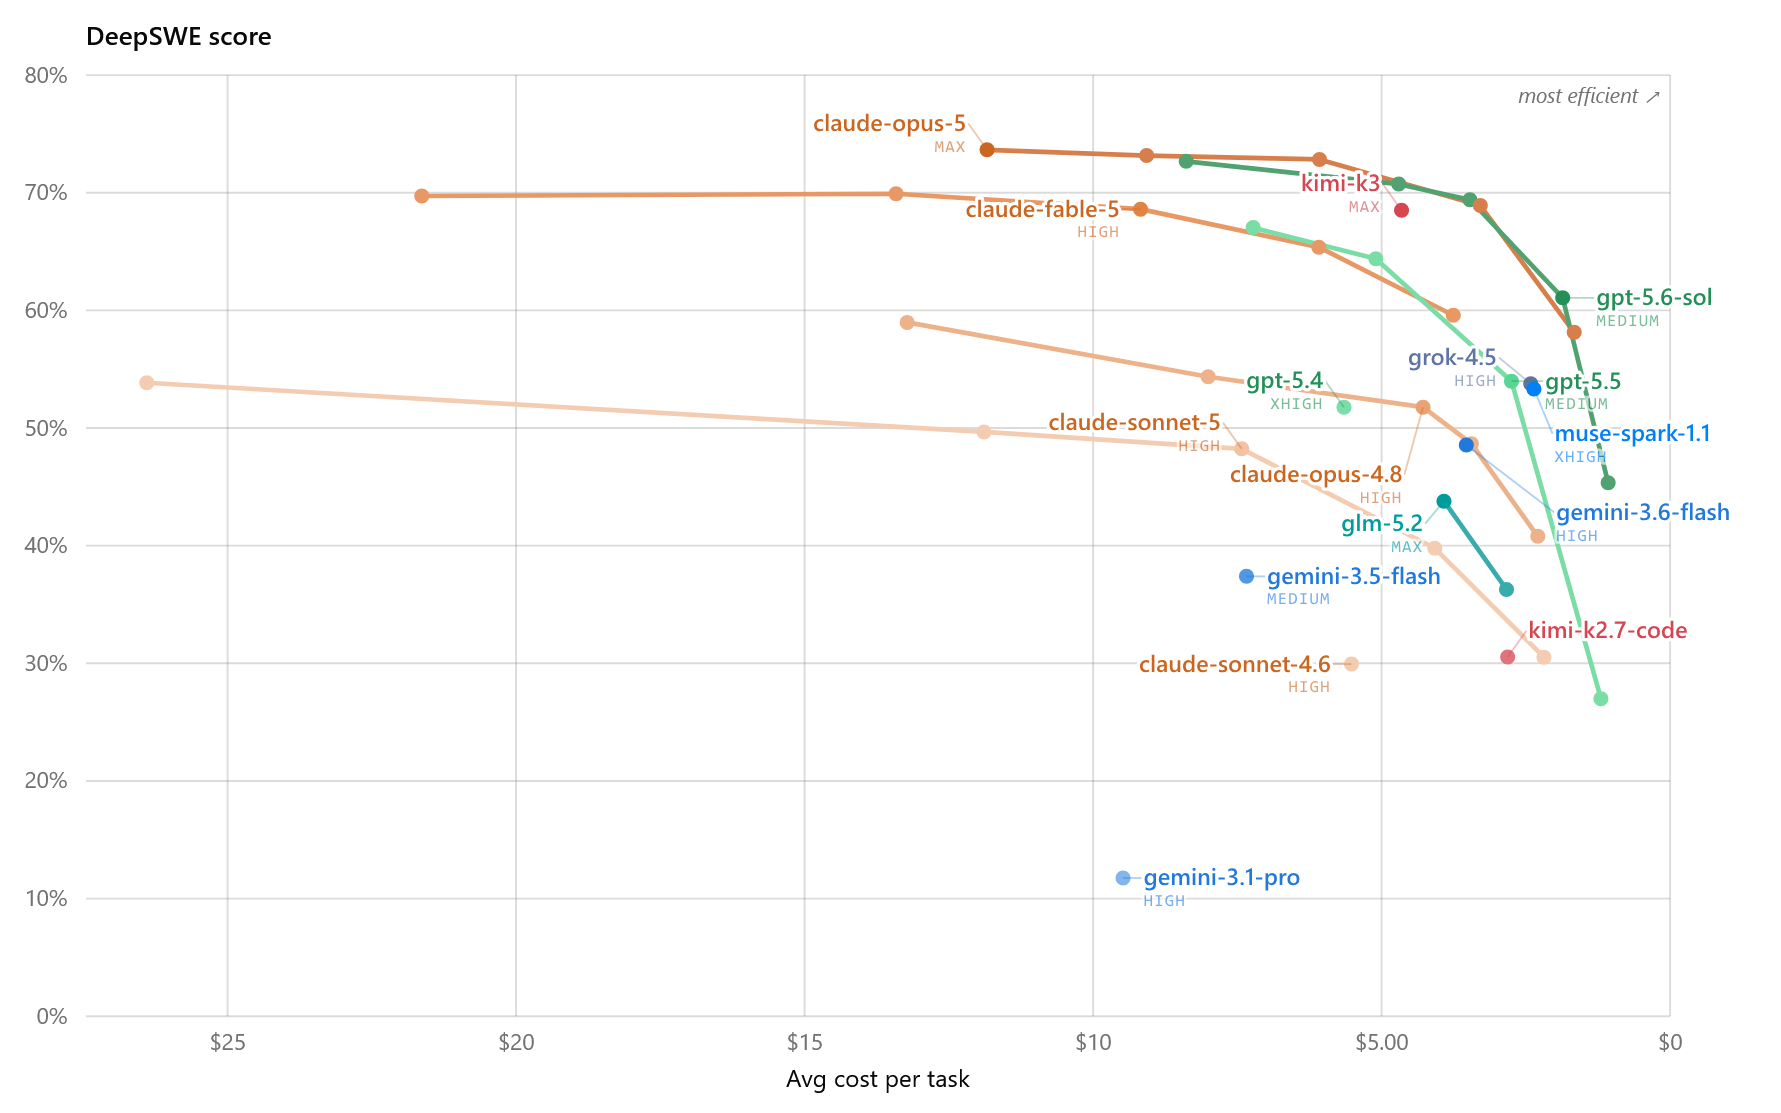
Les benchmarks DeepSWE montrent que Kimi-K3 est très efficace !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F2CHd2zfDwn6J3kYIwtXq%2Fimage.png?alt=media&amp;token=d8fe50b6-e581-4de1-8c9d-6647280bb8b0" alt=""><figcaption></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/kimi-k3.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.