> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/inkling.md).
# Inkling - comment l'exécuter localement
Découvrez comment exécuter localement les modèles multimodaux Inkling de Thinking Machine Labs.
Inkling de Thinking Machines Labs sont des modèles multimodaux à poids ouverts composés de : **Inkling-Small** le nouveau **276B** (12B actifs) modèle et l’ancien **975B** (41B) modèle à paramètres. Sous licence Apache 2.0, les modèles prennent en charge une fenêtre de contexte d’un million de jetons, une entrée multimodale native pour **text**, **image**et **audio**, et génère **text** comme sortie. Inkling excelle en codage, en tâches agentiques et d’appel d’outils, en RAG, en chat, en multilingue et en charges de travail multimodales.
Le 2 bits dynamique atteint 81 % de précision top-1 tout en étant 82 % plus petit. Cela montre que si nous réduisons le modèle de 82 % avec notre [Unsloth Dyanmic ](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md)méthode GGUF - cela ne signifie PAS que le modèle devient 82 % « plus bête » - on ne constate qu’une dégradation d’environ 18 %. Merci à Thinking Machines Lab (TML) d’avoir donné à Unsloth un accès dès le jour zéro. [**Inkling-Small-GGUF**](https://huggingface.co/unsloth/Inkling-Small-GGUF) et [**Inkling-GGUF**](https://huggingface.co/unsloth/inkling-GGUF)
Exécuter les tutoriels InklingRésultats de quantification
#### :gear: Guide d’utilisation
{% columns %}
{% column width="50%" %}
La quantification dynamique 1 bit `UD-IQ1_S` utilise **270GB** d’espace disque - cela nécessitera un Mac Studio Ultra ou des machines disposant d’au moins de RAM+VRAM pour atteindre environ 290 Go.
Le **1-bit** la quantification tiendra sur 290 Go de RAM et le 6/8 bits nécessite 900 Go de RAM. Voyez à droite le GGUF 1 bit à l’œuvre, où nous avons demandé à Inkling de créer un jeu Sudoku en HTML.
Voir à droite le GGUF Inkling 1 bit dans Unsloth :
{% endcolumn %}
{% column width="50%" %}
{% endcolumn %}
{% endcolumns %}
**Tableau : exigences matérielles pour l’inférence** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée) :
| Modèle | 2-bit | 3 bits | 4 bits | 6/8 bits | BF16 |
| ------------- | ------ | ------ | ------------ | -------- | ------- |
| Inkling-Small | 89 GB | 128 GB | 132 - 170 GB | 256 GB | 543 GB |
| Inkling | 325 Go | 450 GB | 600 GB | 870 GB | 1900 GB |
**Tableau : top-1 % conservé (récupération de la précision) pour Inkling 975B :**
| 1-bit | 2-bit | 3 bits | 4 bits | 6/8 bits | BF16 |
| ----------- | ----- | ------ | ------ | -------- | ------ |
| 74.2%-77.4% | 81.0% | 88.7% | 94.4% | 99.8% | 100.0% |
{% hint style="success" %}
Pour de meilleures performances, assurez-vous que votre mémoire totale disponible, y compris la VRAM et la RAM système, dépasse confortablement la taille du fichier du modèle quantifié.
{% endhint %}
Sudoku avec Inkling 1 bit
Analyse audio avec Inkling 1 bit
### Paramètres recommandés
Inkling dispose de modes sans réflexion et avec réflexion. Dans [Unsloth Studio](#run-glm-5.2-in-unsloth-studio) vous pouvez facilement basculer entre réflexion et non-réflexion via une interface.
Utilisez ces paramètres pour la plupart des cas d'utilisation :
| Paramètres par défaut (la plupart des tâches) |
| --------------------------------------------- |
| `temperature` = 1.0 |
| `top_p` = 1.0 (Off) |
* **Fenêtre contextuelle maximale :** `1,048,576`.
#### Modèle de chat et niveaux d’effort de réflexion
Inkling utilise un composant de prompt système intéressant « niveau d’effort de réflexion : » où il s’agit d’un nombre de 0.00 à 0.99 ! En tokenisant ce qui suit :
{% code overflow="wrap" expandable="true" %}
```python
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("unsloth/inkling")
tokenizer.apply_chat_template([
{"role" : "user", "content" : "Quel est 1+1 ?"},
{"role" : "assistant", "content" : "2!"},
{"role" : "user", "content" : "What is 2+2?"},
], tokenize = False, reasoning_effort = "xhigh")
```
{% endcode %}
donnera ce qui suit :
{% code overflow="wrap" expandable="true" %}
```
<|message_system|><|content_text|>Thinking effort level: 0.99<|end_message|><|message_user|><|content_text|>What is 1+1?<|end_message|><|message_model|><|content_text|>2!<|end_message|><|content_model_end_sampling|><|message_user|><|content_text|>What is 2+2?<|end_message|>
```
{% endcode %}
#### Désactivation de la réflexion, changement du niveau d’effort de raisonnement
Inkling utilise le raisonnement par défaut. Il prend aussi en charge des niveaux d’effort de raisonnement où `reasoning_effort` peut être none = 0, low = 0.2, medium = 0.7, high = 0.9, xhigh = 0.99 et max = 0.99.
Pour désactiver la réflexion, utilisez `--chat-template-kwargs '{"reasoning_effort":'none'}'`. Si vous êtes sous **Windows** PowerShell, utilisez : `--chat-template-kwargs "{\"reasoning_effort\":'none'}"`
Pour personnaliser l’effort de raisonnement ou désactiver le raisonnement, utilisez les exemples ci-dessous :
{% code overflow="wrap" expandable="true" %}
```bash
--chat-template-kwargs '{"reasoning_effort":"none"}'
--chat-template-kwargs '{"reasoning_effort":"low"}'
--chat-template-kwargs '{"reasoning_effort":"medium"}'
--chat-template-kwargs '{"reasoning_effort":"high"}'
--chat-template-kwargs '{"reasoning_effort":"xhigh"}'
--chat-template-kwargs '{"reasoning_effort":"max"}'
```
{% endcode %}
{% columns %}
{% column %}
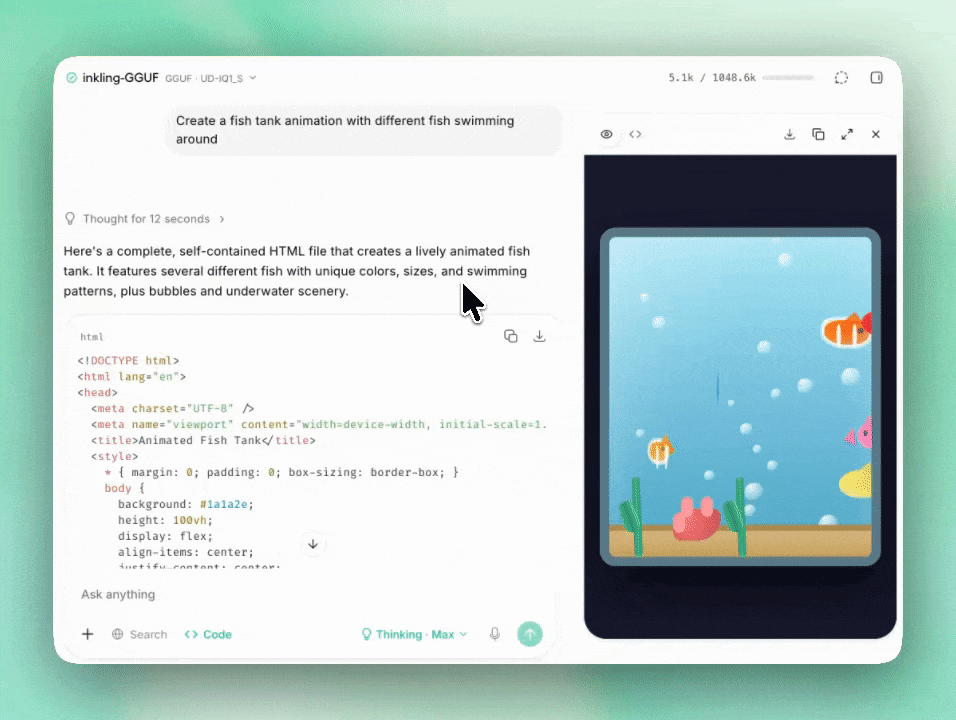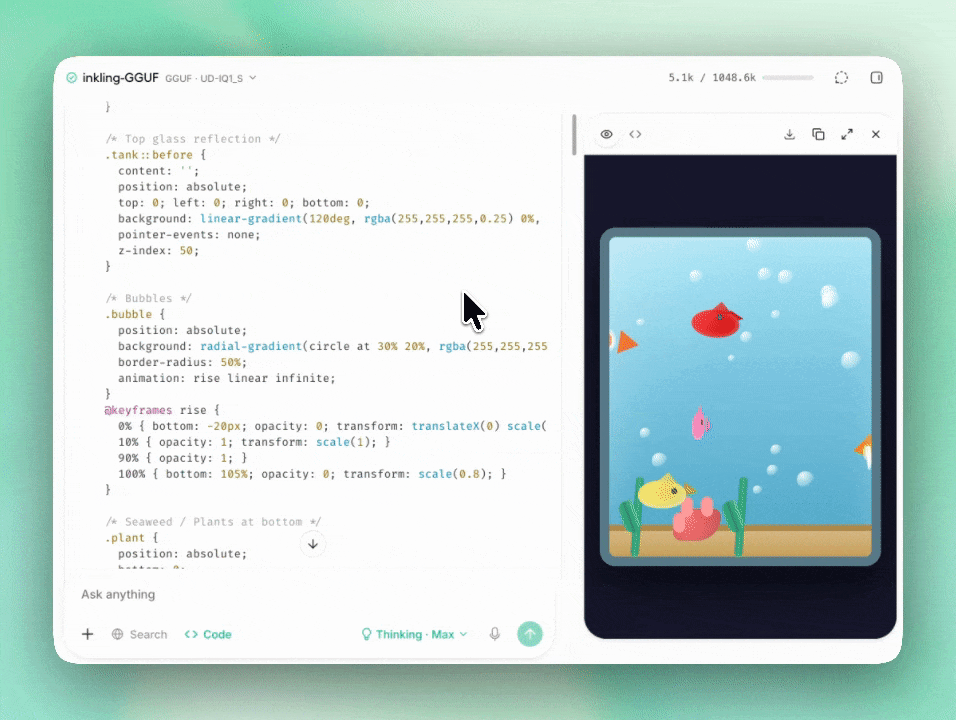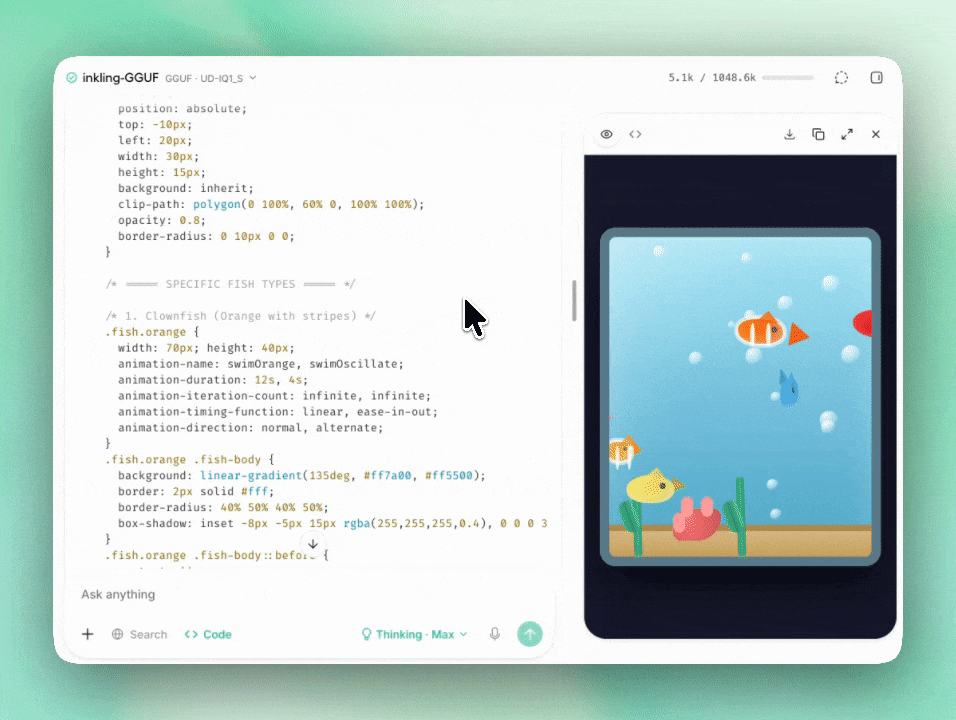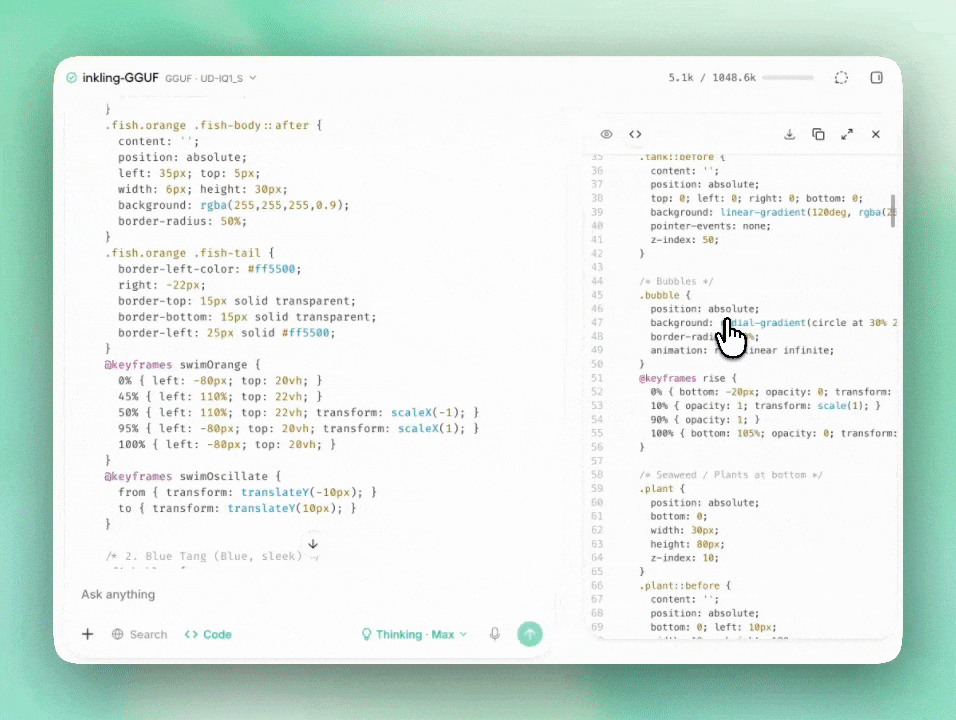
Inkling fait aussi du raisonnement entrelacé et de l’appel d’outils - même avec la quantification dynamique 1 bit !
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
## Exécuter les tutoriels Inkling :
Inkling fonctionne dans Unsloth sur MacOS, Windows et Linux. Vous pouvez :
{% columns %}
{% column %}
* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally) et des modèles safetensor
* [**Auto-réparation** appel d’outils](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) + **recherche web**
* [**exécution de code**](/docs/fr/nouveau/studio.md#run-models-locally) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence CPU + GPU rapide via llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
{% endcolumn %}
{% column %}
Exemple multimodal de GGUF Inkling 1 bit
{% endcolumn %}
{% endcolumns %}
{% stepper %}
{% step %}
**Installer et lancer Unsloth**
Pour l’installer, exécutez dans votre terminal :
MacOS, Linux, WSL :
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
Windows PowerShell :
```bash
irm https://unsloth.ai/install.ps1 | iex
```
**Lancer Unsloth**
MacOS, Linux, WSL et Windows :
{% endstep %}
{% step %}
**Rechercher et télécharger** Inkling
Ensuite, allez dans l’onglet [Unsloth Chat](/docs/fr/nouveau/studio/chat.md) onglet et recherchez **Inkling** dans la barre de recherche et téléchargez le modèle et la quantification de votre choix. Assurez-vous d’avoir suffisamment de ressources de calcul pour exécuter le modèle.
{% endstep %}
{% step %}
**Lancer Inkling**
Les paramètres d’inférence devraient être définis automatiquement lors de l’utilisation d’Unsloth Studio, cependant vous pouvez toujours les modifier manuellement. Vous pouvez aussi modifier la longueur du contexte, le modèle de chat et d’autres paramètres.
Pour plus d’informations, vous pouvez consulter notre [guide d’inférence d’Unsloth Studio](/docs/fr/nouveau/studio/chat.md).
Inkling 1 bit exécuté dans Unsloth Studio
{% endstep %}
{% endstepper %}
### 🦙 Lancer Inkling dans llama.cpp
Pour ce guide, nous utiliserons la `UD-IQ1_S` quantification, qui nécessitera au moins 290 Go de RAM. N’hésitez pas à changer le type de quantification. Pour ces tutoriels, nous utiliserons [llama.cpp](llama.cpphttps://github.com/ggml-org/llama.cpp) pour une inférence locale rapide. GGUF : [**Inkling-GGUF**](https://huggingface.co/unsloth/Inkling-GGUF)
#### Télécharger Unsloth
### Guide Unsloth
{% stepper %}
{% step %}
Obtenez la `llama.cpp` PR sur [GitHub ici](https://github.com/ggml-org/llama.cpp/pull/25731). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
gh pr checkout 25731
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
Vous pouvez désormais utiliser `llama.cpp` directement pour charger et télécharger des modèles, tout comme `ollama run`. `Q2_K_XL`. Utilisez aussi `export LLAMA_CACHE="folder"` pour forcer `llama.cpp` pour enregistrer vers un emplacement spécifique. Notez que ce processus de téléchargement peut être très lent, il est donc probablement préférable d’utiliser le processus de téléchargement manuel dans la section suivante.
**Inkling-Small 276B :**
```bash
export LLAMA_CACHE="unsloth/Inkling-Small-GGUF"
./build/bin/llama-cli \\
-hf unsloth/Inkling-Small-GGUF:UD-Q3_K_XL \\
--temp 1.0 \
--top-p 1.0 \\
--min-p 0.0
```
**Inkling 975B :**
{% code overflow="wrap" %}
```bash
export LLAMA_CACHE="unsloth/Inkling-GGUF"
./build/bin/llama-cli \\
-hf unsloth/Inkling-GGUF:UD-IQ1_S \\
--temp 1.0 \
--top-p 1.0 \\
--min-p 0.0
```
{% endcode %}
{% endstep %}
{% step %}
Si vous souhaitez télécharger le modèle manuellement, nous pouvons le télécharger via le code ci-dessous (après avoir installé `pip install huggingface_hub`). Si les téléchargements se bloquent, voir : [Débogage de Hugging Face Hub et XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)
**Inkling-Small 276B :**
```bash
hf download unsloth/Inkling-Small-GGUF \\
--local-dir unsloth/Inkling-Small-GGUF \\
--include "*UD-Q3_K_XL*" # Utilisez "*UD-Q4_K_XL*" pour 4 bits
```
**Inkling 975B :**
{% code overflow="wrap" %}
```bash
hf download unsloth/Inkling-GGUF \\
--local-dir unsloth/Inkling-GGUF \\
--include "*UD-IQ1_S*" # Utilisez "*UD-Q2_K_XL*" pour 2 bits
```
{% endcode %}
{% endstep %}
{% step %}
Vous pouvez modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 32768` pour la longueur de contexte, `--n-gpu-layers 2` pour le déchargement GPU, selon le nombre de couches. Essayez de l’ajuster si votre GPU manque de mémoire. Supprimez-le également si vous n’utilisez que l’inférence CPU. Nous avons également implémenté un noyau fusionné de biais Flash Attention dans llama.cpp pour réduire l’utilisation de la VRAM - mais il vaut mieux garder `--ctx-size` raisonnable tout de même !
**Inkling-Small 276B :**
{% code overflow="wrap" %}
```bash
./build/bin/llama-cli \\
--model unsloth/Inkling-Small-GGUF/UD-Q3_K_XL/Inkling-Small-UD-Q3_K_XL-00001-of-00004.gguf \\
--temp 1.0 \
--top-p 1.0 \\
--min-p 0.0
```
{% endcode %}
**Inkling 975B :**
{% code overflow="wrap" %}
```bash
./build/bin/llama-cli \\
--model unsloth/Inkling-GGUF/UD-IQ1_S/inkling-UD-IQ1_S-00001-of-00007.gguf \\
--temp 1.0 \
--top-p 1.0 \\
--min-p 0.0
```
{% endcode %}
{% endstep %}
{% endstepper %}
### :triangular\_ruler:Analyse de quantification
Nous avons également exécuté des benchmarks KLD (divergence KL) pour évaluer la précision de nos quantifications d’Inkling-GGUF. Nous avons d’abord créé un mélange de quantification 8 bits + 6 bits pour le modèle, avec du 6 bits pour les exps ffn\_up et ffn\_gate, et avons constaté que le RMSE était de 1e-4 ou moins en termes de déquantification - quantifier ffn\_down augmentait l’erreur d’un facteur 10 supplémentaire, donc cela est conservé en Q8\_0 pour la quantification 8/6 bits
En précision top-1 pure, **la quantification dynamique 1 bit atteint environ 74,2 % de précision tout en étant 86 % plus petite**! La quantification dynamique 2 bits atteint environ 81 % de précision tout en étant 82 % plus petite. Cela montre que quantifier dynamiquement certaines couches avec une précision plus élevée ne rend pas le modèle inutilisable ou totalement inutile - nous montrons qu’une quantification sélective des couches peut récupérer beaucoup de précision !
**Mais qu’implique réellement « 74 % de précision » ?**
Cela ne signifie PAS que 26 % du temps le modèle produit du charabia ou des résultats erronés - cela signifie plutôt que, dans 26 % des cas, parmi les meilleures réponses, il pourrait davantage choisir la deuxième réponse la plus probable.
Par exemple, demander « Crée un poème » produira des résultats très différents - 74 % du temps, ce seront des poèmes similaires à la référence BF16, mais 26 % du temps, ce sera un autre poème, tout en restant correct. Pour des réponses factuelles où la créativité et l’échantillonnage n’entrent pas en jeu, le modèle retrouvera toujours la même réponse (par exemple « Combien font 2+2 ? », il dira toujours 4, jamais 5)
## 📊 Benchmarks
Vous pouvez consulter plus bas les benchmarks d’Inkling sous forme de tableau :
Les résultats d’Inkling sont rapportés avec effort=0.99. Les scores de comparaison ont été générés le 14 juillet 2026. Nemotron 3 Ultra, Kimi K2.5, Kimi K2.6, GLM 5.2 et DeepSeek V4 Pro sont des modèles à poids ouverts ; Gemini 3.1 Pro, Claude Fable 5 et GPT 5.6 Sol sont des modèles à poids fermés.
| | | Inkling | Nemotron 3 Ultra | Kimi K2.5 | Kimi K2.6 | GLM 5.2 | DeepSeek V4 Pro | Gemini 3.1 Pro (high) | Claude Fable 5 (max) | GPT 5.6 Sol (xhigh) |
| ----------------------- | ------------------------------------------- | ------- | ---------------- | --------- | --------- | ------- | --------------- | --------------------- | -------------------- | ------------------- |
| **Raisonnement** | | | | | | | | | | |
| | HLE (texte uniquement) | 29.7% | 26.6% | 29.4% | 35.9% | 40.1% | 35.9% | 44.7% | 53.3% | 47.2% |
| | HLE (avec outils) | 46.0% | 37.4% | 50.2% | 54.0% | 54.7% | 48.2% | 51.4% | 64.5% | 55.0% |
| | AIME 2026 | 97.1% | 94.2% | 95.8% | 96.4% | 99.2% | 96.7% | 98.3% | – | 99.9% |
| | GPQA Diamond | 87.2% | 86.7% | 87.9% | 91.1% | 89.5% | 88.8% | 94.1% | 92.6% | 94.1% |
| **Agentique (codage)** | | | | | | | | | | |
| | SWEBench vérifié | 77.6% | 70.7% | 76.8% | 80.2% | – | 80.6% | 80.6% | 95.0% | – |
| | SWEBench Pro (public) | 54.3% | 46.4% | 50.7% | 58.6% | 62.1% | 55.4% | 54.2% | 80.0% | 64.6% |
| | Terminal Bench 2.1 (meilleur environnement) | 63.8 | 56.4 | 51.3 | 71.3 | 82.7 | 64 | 73.8 | 84.6 | 89.5 |
| | GDPVal-AA v2 | 1233 | 1164 | 1009 | 1190 | 1514 | 1307 | 962 | 1760 | 1748 |
| **Agentique (général)** | | | | | | | | | | |
| | MCP Atlas | 74.1% | 44.7% | 64.0% | 68.1% | 77.8% | 73.2% | 78.2% | 83.3% | 81.8% |
| | Tau 3 Banking | 23.7% | 13.8% | 13.2% | 20.6% | 26.8% | 25.8% | 16.5% | 26.8% | 33.0% |
| **Factualité** | | | | | | | | | | |
| | BrowseComp (avec contexte) | 77.1% | – | 74.9% | 83.2% | – | 83.4% | 85.9% | 88.0% | 89.4% |
| | SimpleQA vérifié | 43.9% | 32.4% | 36.9% | 38.7% | 38.1% | 57.0% | 77.3% | 68.3% | 71.6% |
| | AA Omniscience | 1.0% | -1.0% | -8.0% | 6.0% | 4.0% | -10.0% | 33.0% | 40.0% | 22.0% |
| **Chat** | | | | | | | | | | |
| | IFBench | 79.8% | 81.4% | 70.2% | 76.0% | 73.3% | 76.5% | 77.1% | 63.5% | 72.7% |
| | Global-MMLU-Lite | 88.7% | 85.6% | 84.0% | 88.4% | 89.2% | 89.3% | 92.7% | 93.3% | 91.8% |
| **Vision** | | | | | | | | | | |
| | MMMU Pro (standard 10) | 73.3% | – | 75.0% | 79.0% | – | – | 82.0% | 84.2% | 83.0% |
| | Charxiv RQ | 78.1% | – | 77.5% | 80.4% | – | – | 80.2% | 86.5% | 84.7% |
| | Charxiv RQ (avec Python) | 82.0% | – | 78.7% | 86.7% | – | – | 89.9% | 89.4% | 87.8% |
| **Audio** | | | | | | | | | | |
| | QCM audio | 56.6% | – | – | – | – | – | 66.8% | – | – |
| | MMAU | 77.2% | – | – | – | – | – | 82.5% | – | – |
| | VoiceBench | 91.4% | – | – | – | – | – | 94.3% | – | – |
| **Sécurité** | | | | | | | | | | |
| | FORTRESS (adversarial) | 78.0% | 77.6% | 54.1% | 65.6% | 71.3% | 36.0% | 65.2% | 96.0% | 82.4% |
| | FORTRESS (bénin) | 95.9% | 90.5% | 98.3% | 97.2% | 90.0% | 98.5% | 98.0% | 55.1% | 98.1% |
| | StrongREJECT | 98.6% | 98.7% | 99.5% | 99.8% | 98.5% | 98.6% | 98.0% | 98.7% | 98.5% |
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/inkling.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.