> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/glm-5.3-flash.md).
# GLM-5.3-Flash : comment l'exécuter localement
Exécutez le nouveau modèle GLM-5.3-Flash, alias ox-alpha, de Z.ai.
GLM-5.3-Flash, également connu sous le nom de **`ox-alpha`**, est le nouveau modèle ouvert multimodal de 320B paramètres (18B actifs) de Z.ai qui **surpasse** [GLM-5.2](/docs/fr/modeles/glm-5.2.md). GLM-5.3-Flash est la version plus petite de [GLM-5.3](/docs/fr/modeles/glm-5.3.md) et rivalise avec **Claude Opus 4.8** sur les benchmarks de codage et d'agents. Vous pouvez désormais exécuter le modèle 1-bit localement sur des configurations de 102 Go de RAM/VRAM ou le 3-bit sur des configurations de 128 Go via llama.cpp ou [Unsloth](https://github.com/unslothai/unsloth). Merci à Z.ai pour l'accès jour zéro.
Dynamique Unsloth **1-bit** (93 Go) les GGUF conservent **71 % de précision top-1** tout en étant **85 % plus petit** par rapport au BF16 (642 Go). Le 3-bit dynamique est 76 % plus petit et conserve 87 % de précision.
Guide pour exécuter GLM-5.3-FlashTélécharger Unsloth
{% hint style="success" %}
**4 sept. :** GLM-5.3-Flash fonctionne désormais avec [**une inférence 3,3× plus rapide**](#faster-inference-and-mtp-support)**!**
{% endhint %}
{% columns %}
{% column width="50%" %}
GLM-5.3-Flash a été entraîné sur 30T jetons et repose sur un nouveau modèle de base fraîchement entraîné. Son architecture hybride d'attention clairsemée et linéaire réduit les coûts de service sur long contexte sans sacrifier la précision.
Vous pouvez désormais exécuter le modèle directement dans [Unsloth Desktop](#run-glm-5.3-flash-in-unsloth).
{% endcolumn %}
{% column width="50%" %}
{% endcolumn %}
{% endcolumns %}
### :gear: Guide d'utilisation
#### Exigences pour GLM-5.3-Flash :
La plus petite quantification 1-bit fonctionne avec 100 Go de RAM, tandis que le 3-bit fonctionne sur des appareils de 128 Go comme un Mac ou un NVIDIA DGX Spark.\
**Tableau : exigences matérielles** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée)
| 1-bit | 2-bit | 3-bit | 4-bit | 8-bit | BF16 |
| ------ | ------ | ---------- | ---------- | ------ | ------ |
| 100 Go | 115 Go | 128-150 Go | 162-210 Go | 350 Go | 650 Go |
### Paramètres recommandés
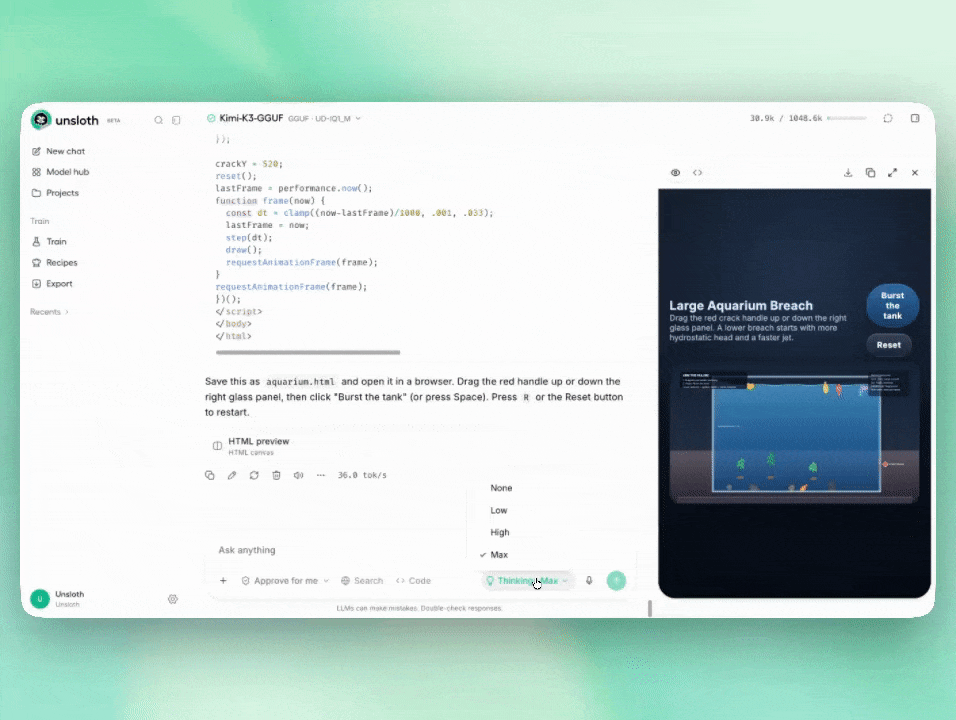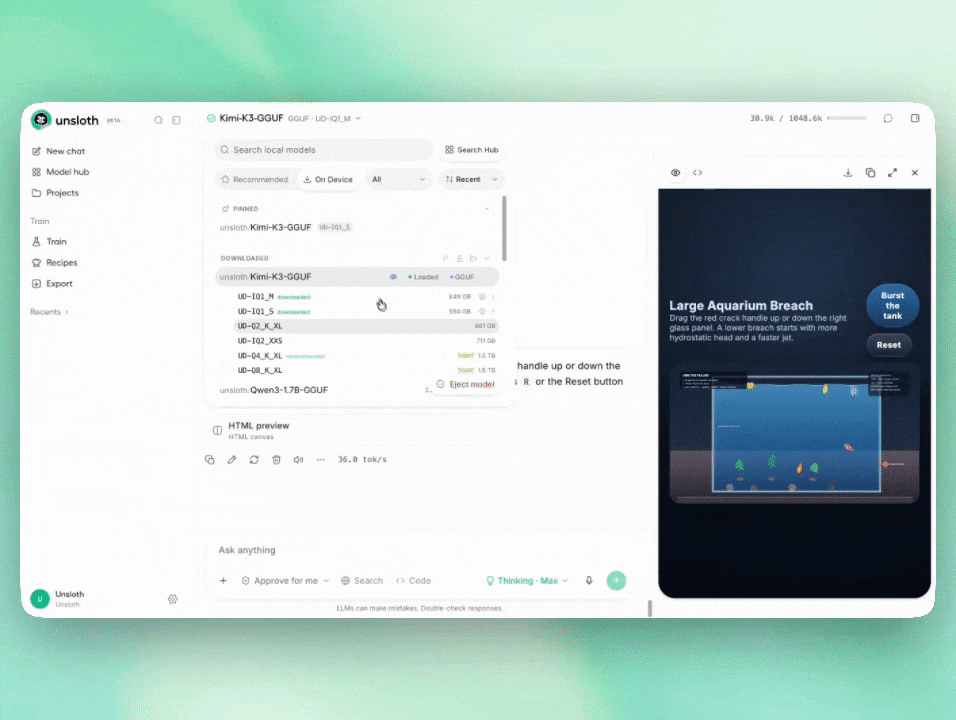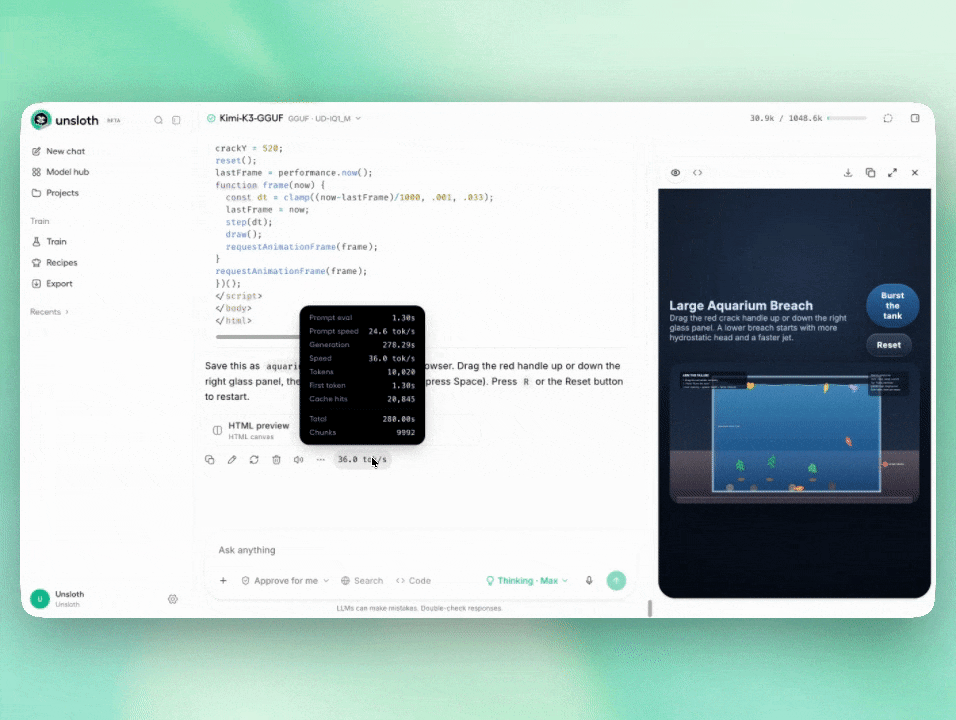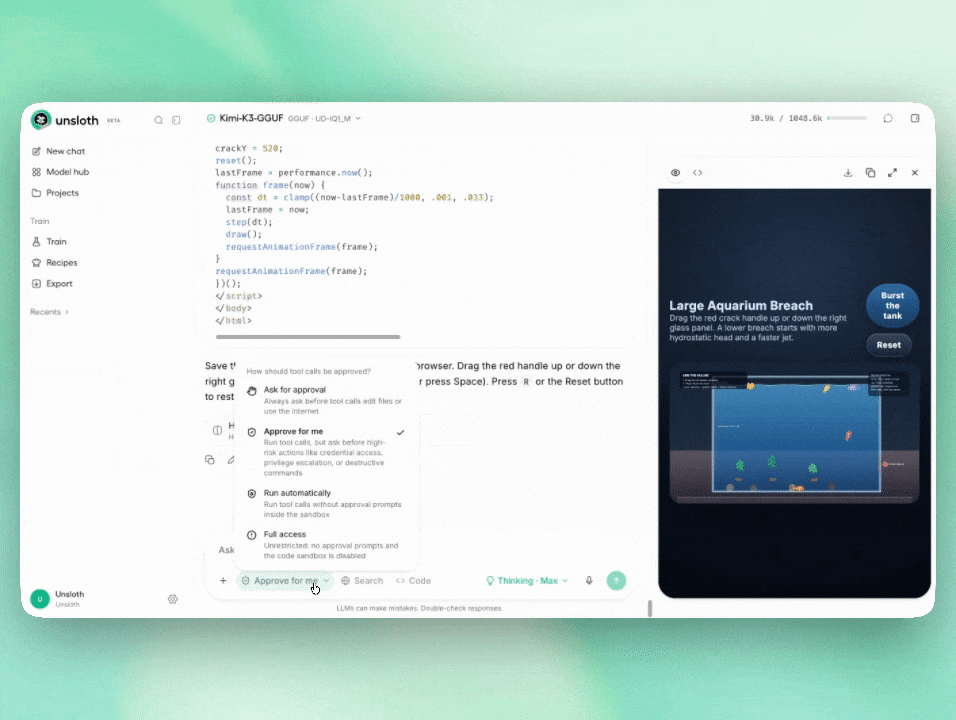
GLM-5.3-Flash dispose de **3 modes de réflexion**: Faible, Élevé et Max. Utilisez la réflexion Max pour les tâches complexes. Dans [Unsloth](#run-glm-5.2-in-unsloth-studio), vous pouvez facilement sélectionner la réflexion Faible, Élevée ou Max à l'aide d'un bouton dans la zone de discussion.
Utilisez ces paramètres pour la plupart des cas d'utilisation :
| Paramètres par défaut (la plupart des tâches) | DeepSWE |
| --------------------------------------------- | -------------------- |
| `temperature` = 1.0 | `temperature` = 0.95 |
| `top_p` = 0.95 | `top_p` = 1.0 |
* **Fenêtre contextuelle maximale :** `1,048,576`.
#### Modification de l'effort de raisonnement
GLM-5.3-Flash utilise par défaut le raisonnement Max. Il prend également en charge des niveaux d'effort de raisonnement où `reasoning_effort` peut être « low », « high » ou « max ».
### Inférence plus rapide et prise en charge de MTP
Depuis le 4 sept., nous avons ajouté plusieurs améliorations et optimisations à notre [PR llama.cpp](https://github.com/ggml-org/llama.cpp/pull/27754). Nous avons implémenté un chemin de décodage plus rapide ainsi qu'une prise en charge MTP en bonus, permettant jusqu'à **une inférence 3,3× plus rapide** sur de longues longueurs de contexte !
Tout fonctionne immédiatement dans [Unsloth Desktop](#run-glm-5.3-flash-in-unsloth), il suffit de mettre à jour vers la dernière version si nécessaire. Aucun module supplémentaire ni fichier MTP n'est requis. Sinon, vous pouvez suivre notre [llama.cpp](#run-glm-5.3-flash-in-llama.cpp) guide.
En utilisant GLM-5.3-Flash UD-IQ1\_S sur 1xB200 et en ignorant d'abord MTP, on obtient :
| Test | Tok/s de base | Tok/s optimisé |
| ------------ | ------------: | -------------: |
| pp512 | 1121.80 | 1122.0 |
| tg32 | 62.79 | 63.10 |
| tg32 @ 4096 | 53.52 | 59.50 |
| tg32 @ 16384 | 41.02 | 57.99 |
| tg32 @ 65536 | 20.66 | 48.99 |
Ensuite, une fois MTP ajouté, nous constatons des gains encore plus importants, surtout pour les contextes plus longs. Cependant, nous devrions nous arrêter autour de n=2, car davantage de jetons de brouillon rendent l'inférence plus lente.
| invite | MTP désactivé | n=2 | n=3 | n=5 |
| ------ | ------------: | ---: | ---: | ---: |
| 4096 | 58.6 | 86.5 | 80.2 | 63.7 |
| 16K | 55.0 | | 77.2 | |
Pour des longueurs de contexte plus courtes, nous observons toujours des gains de vitesse, jusqu'à 1,6× plus rapide.
### 📈 Analyse de quantification
Nous avons quantifié GLM-5.3-Flash en UD-IQ1\_S 1 bit (93,09 Go) et il conserve 71 % de la précision top-1 % tout en étant 85 % plus petit que le BF16 (641,64 Go)
UD-Q2\_K\_XL dynamique en 2-bit fait 109 Go, est 83 % plus petit et conserve 78 % de précision.\
UD-IQ3\_XXS dynamique en 3-bit fait 120 Go, est 81 % plus petit et conserve 82 % de précision.\
UD-Q4\_K\_XL dynamique en 4-bit fait 200 Go, est 69 % plus petit et conserve 93 % de précision.
| Quantification | taille | précision top-1 | KLD moyen | KLD 99,9 % |
| -------------- | ------ | --------------- | --------- | ---------- |
| UD-IQ1\_S | 93.09 | 70.89% | 0.669714 | 9.1658 |
| UD-IQ1\_M | 97.58 | 73.06% | 0.572413 | 8.5069 |
| UD-IQ2\_XXS | 101.84 | 76.30% | 0.450148 | 7.5764 |
| UD-Q2\_K\_XL | 108.72 | 78.34% | 0.380134 | 6.8412 |
| UD-IQ3\_XXS | 120.37 | 81.63% | 0.283772 | 5.9611 |
| UD-Q3\_K\_XL | 147.54 | 86.25% | 0.159697 | 4.0281 |
| UD-IQ4\_XS | 156.82 | 88.18% | 0.116652 | 3.1014 |
| UD-Q4\_K\_XL | 199.71 | 92.22% | 0.049294 | 1.4894 |
| UD-Q5\_K\_XL | 240.31 | 94.35% | 0.027052 | 0.8696 |
| UD-Q6\_K\_XL | 291.83 | 95.23% | 0.019007 | 0.6267 |
## Exécuter GLM-5.3-Flash (Ox-Alpha) localement
Vous pouvez désormais exécuter GLM-5.3-Flash (Ox-Alpha) dans Unsloth Desktop et llama.cpp grâce à notre [PR spécifique](https://github.com/ggml-org/llama.cpp/pull/27754). Nous utilisons du 3-bit `UD-IQ3_XXS` dans nos démos car il tient sur des appareils de 128 Go. N'hésitez pas à changer le type de quantification.
* Hugging Face : [GLM-5.3-Flash-GGUF](https://huggingface.co/unsloth/GLM-5.3-Flash-GGUF)
Exécuter dans Unsloth DesktopExécuter dans llama.cpp
### 🦥 Exécuter GLM-5.3-Flash dans Unsloth
GLM-5.3-Flash peut désormais fonctionner dans [Unsloth Desktop](#run-qwen3.8-in-unsloth-desktop), une application d'interface utilisateur open source pour l'IA locale. **Unsloth décharge automatiquement vers la RAM et détecte les configurations multi-GPU**. Avec Unsloth Desktop, vous pouvez exécuter des modèles localement sur **macOS, Windows**, Linux et :
{% columns %}
{% column %}
* Recherchez, téléchargez, [exécutez des GGUF](/docs/fr/nouveau/studio.md#run-models-locally), des modèles MLX et safetensor
* [**Auto-réparation** appel d'outils](/docs/fr/nouveau/studio/chat.md#auto-healing-tool-calling) + **recherche web**
* [**exécution de code**](/docs/fr/desktop.md#code-execution) (Python, Bash)
* [inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence rapide sur CPU + GPU via MLX et llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2× plus rapide avec 70 % de VRAM en moins
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% stepper %}
{% step %}
#### Installer Unsloth
La façon la plus simple de commencer est de télécharger l' [application Unsloth Desktop](/docs/fr/desktop.md). Fonctionne sur [macOS](/docs/fr/commencer/install/mac.md), [Windows](/docs/fr/commencer/install/windows-installation.md), et [Linux](/docs/fr/commencer/install/linux.md).
Télécharger Unsloth
* :apple: [Télécharger pour macOS](https://unsloth.ai/download/mac)
* :windows: [Télécharger pour Windows](https://unsloth.ai/download/windows)
* :linux: [Télécharger pour Linux](https://unsloth.ai/download/linux)
Ou, si vous préférez installer manuellement :
macOS, Linux, WSL :
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
Windows PowerShell :
```bash
irm https://unsloth.ai/install.ps1 | iex
```
{% endstep %}
{% step %}
#### Rechercher et télécharger GLM-5.3-Flash
Accédez à [Unsloth Chat](/docs/fr/nouveau/studio/chat.md) ou le hub de modèles et recherchez GLM-5.3-Flash dans la barre de recherche, puis téléchargez le modèle et la quantification souhaités.
{% endstep %}
{% step %}
#### Exécuter GLM-5.3-Flash
Les paramètres d'inférence devraient être définis automatiquement lors de l'utilisation d'Unsloth, cependant vous pouvez toujours les modifier manuellement. Vous pouvez également modifier la longueur de contexte, le template de conversation et d'autres paramètres.
Pour plus d'informations, vous pouvez consulter notre [guide d'inférence Unsloth](/docs/fr/nouveau/studio/chat.md). Exécution 1-bit ci-dessous :
{% endstep %}
{% step %}
#### Servir GLM-5.3-Flash avec l'API Unsloth
Vous pouvez utiliser `unsloth run` la commande et servir GLM-5.3-Flash via une API à l'aide de `llama-server` des drapeaux d'exécution, notamment le dimensionnement du contexte, les couches GPU, le multithreading, l'échantillonnage, la mise en réseau et la configuration des outils. Pour plus d'informations, consultez notre [documentation de l'API](/docs/fr/notions-de-base/api.md) ou [unsloth start](/docs/fr/integrations/unsloth-start.md).
{% code overflow="wrap" %}
```bash
unsloth run --model unsloth/GLM-5.3-Flash-GGUF:UD-IQ3_XXS
```
{% endcode %}
{% endstep %}
{% step %}
#### Unsloth est maintenant prêt
Vous pouvez également faire beaucoup d'autres choses avec GLM-5.3-Flash via Unsloth Desktop, comme :
* **Connecter des outils :** [Claude Code](/docs/fr/notions-de-base/claude-code.md), [Codex](/docs/fr/notions-de-base/codex.md), [recherche web](/docs/fr/nouveau/studio/chat.md#advanced-web-search), [MCP](/docs/fr/notions-de-base/mcp.md) et plus encore
* **Entraîner des modèles :** Ajuster finement du texte, de la diffusion, [embedding](/docs/fr/notions-de-base/embedding-finetuning.md), et plus encore
* **Générer des médias :** Créer et entraîner [des images](/docs/fr/notions-de-base/diffusion-image.md), des vidéos, [TTS](/docs/fr/notions-de-base/text-to-speech-tts-fine-tuning.md) localement
{% endstep %}
{% endstepper %}
### :llama: Exécuter GLM-5.3-Flash dans llama.cpp
{% stepper %}
{% step %}
Nous devons utiliser notre PR spécifique pour llama.cpp [ici](https://github.com/unslothai/llama.cpp/pull/61). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` en `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone --branch glm5next/upstream https://github.com/unslothai/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
Pour exécuter le modèle, vous pouvez faire :
{% code overflow="wrap" %}
```bash
pip install -U "huggingface_hub[cli]"
hf download unsloth/GLM-5.3-Flash-GGUF \
--local-dir unsloth/GLM-5.3-Flash-GGUF \
--include "*UD-IQ3_XXS*" # Utilisez "*IQ2_XXS*" pour le 2-bit
```
{% endcode %}
{% endstep %}
{% step %}
Puis pour l'exécuter :
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/GLM-5.3-Flash-GGUF/UD-IQ3_XXS/GLM-5.3-Flash-UD-IQ3_XXS-00001-of-00004.gguf \
--temp 1.0 \
--top-p 0.95 \
--chat-template-kwargs '{"reasoning_effort":"max"}'
```
{% endcode %}
Remplacez `UD-IQ3_XXS` par la quantification de votre choix, comme `IQ2_XXS` pour le 2-bit une fois téléversée.
{% endstep %}
{% endstepper %}
## 📊 Benchmarks
| 78.0 | - | 64.3 | 75.0 | 68.0 | 65.0 |
| BabyVision | 53.4 | - | 35.1 | 46.8 | 61.6 | 70.9 |
| MVbench | 77.8 | - | 69.4 | 67.1 | 75.0 | 82.2 |
| MMVU | 80.5 | - | 72.7 | 67.4 | 75.8 | 82.3 |
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/glm-5.3-flash.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.