> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/deepseek-v4.md).

# DeepSeek-V4 : comment l'exécuter localement

Exécutez DeepSeek-V4-Pro-0813 et DeepSeek-V4-Flash-0731 localement sur votre propre appareil !

DeepSeek-V4, DeepSeek-V4-Flash-Vision-Exp, V4-**Pro-0813**, et V4-**Flash-0731** sont de nouveaux modèles à poids ouverts - la variante Flash possède 284B paramètres (13B actifs), tandis que V4-Pro en a 1,6T (49B actifs). **V4-Pro-0813**, sorti le **13 août**, égal à la performance de Claude-4.8-Opus, tandis que **V4-Flash-0731**, sorti le **31 juillet**, offre les meilleures performances de sa catégorie de taille et **surpasse V4-Pro** (Aperçu). Conçu pour les flux de travail de codage, agentiques et de chat avec une **fenêtre de contexte de 1M**, ce guide montre comment exécuter DeepSeek-V4-Flash-0731 localement à l’aide de GGUF dynamiques Unsloth et [Unsloth Desktop](/docs/fr/desktop.md).

Pour **sans perte** DeepSeek, utilisez Q8 (`UD-Q8_K_XL`), qui n'est que **7 Go plus grand** que Q4 (`UD-Q4_K_XL`). Le GGUF 8 bits sans perte est **162 Go** et en 3 bits est **103 Go** qui peut fonctionner sur un **appareil doté de 110 Go de RAM** apparei&#x6C;**.** DeepSeek-V4-Flash-0731 obtient 82,7 % sur Terminal Bench 2.1, 54,4 % sur DeepSWE et 54,2 % sur NL2Repo. [DSpark](#dspark-speculative-decoding) est également activé pour les GGUF, permettant jusqu’à **une vitesse de décodage 2 fois plus rapide**!

{% hint style="success" %}
**31 août :** DeepSeek-Flash-Vision-Exp est maintenant disponible !

**13 août :** DeepSeek-**V4-Pro-0813** a été publié et [les quantifications sont désormais](https://huggingface.co/unsloth/DeepSeek-V4-Pro-0813-GGUF) disponibles à l’exécution.
{% endhint %}

{% hint style="success" %}
**6 août : DSpark est activé pour DeepSeek-V4-Flash-0731 - permettant une inférence 1,5 à 1,9 fois plus rapide ! DSpark est automatiquement activé dans** [**Unsloth**](#unsloth-studio-guide)**.**

Nous avons également amélioré le [modèle Jinja de chat DeepSeek-V4](#deepseek-v4-chat-template-improvements), et testé plus de 4000 conversations pour être équivalent à la base de référence officielle.
{% endhint %}

| [DeepSeek-V4-Pro-0813-GGUF](https://huggingface.co/unsloth/DeepSeek-V4-Pro-0813-GGUF) | [DeepSeek-V4-Flash-**0731**-GGUF](https://huggingface.co/unsloth/DeepSeek-V4-Flash-0731-GGUF) | [DeepSeek-V4-Flash-GGUF](https://huggingface.co/unsloth/DeepSeek-V4-Flash-GGUF) |
| ------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------- |

<a href="/docs/fr/modeles/deepseek-v4.md#usage-guide" class="button primary">Guide d’utilisation</a><a href="/docs/fr/modeles/deepseek-v4.md#run-deepseek-v4-flash-tutorials" class="button primary">Tutoriels d’exécution</a>

### 📊 Analyse de quantification

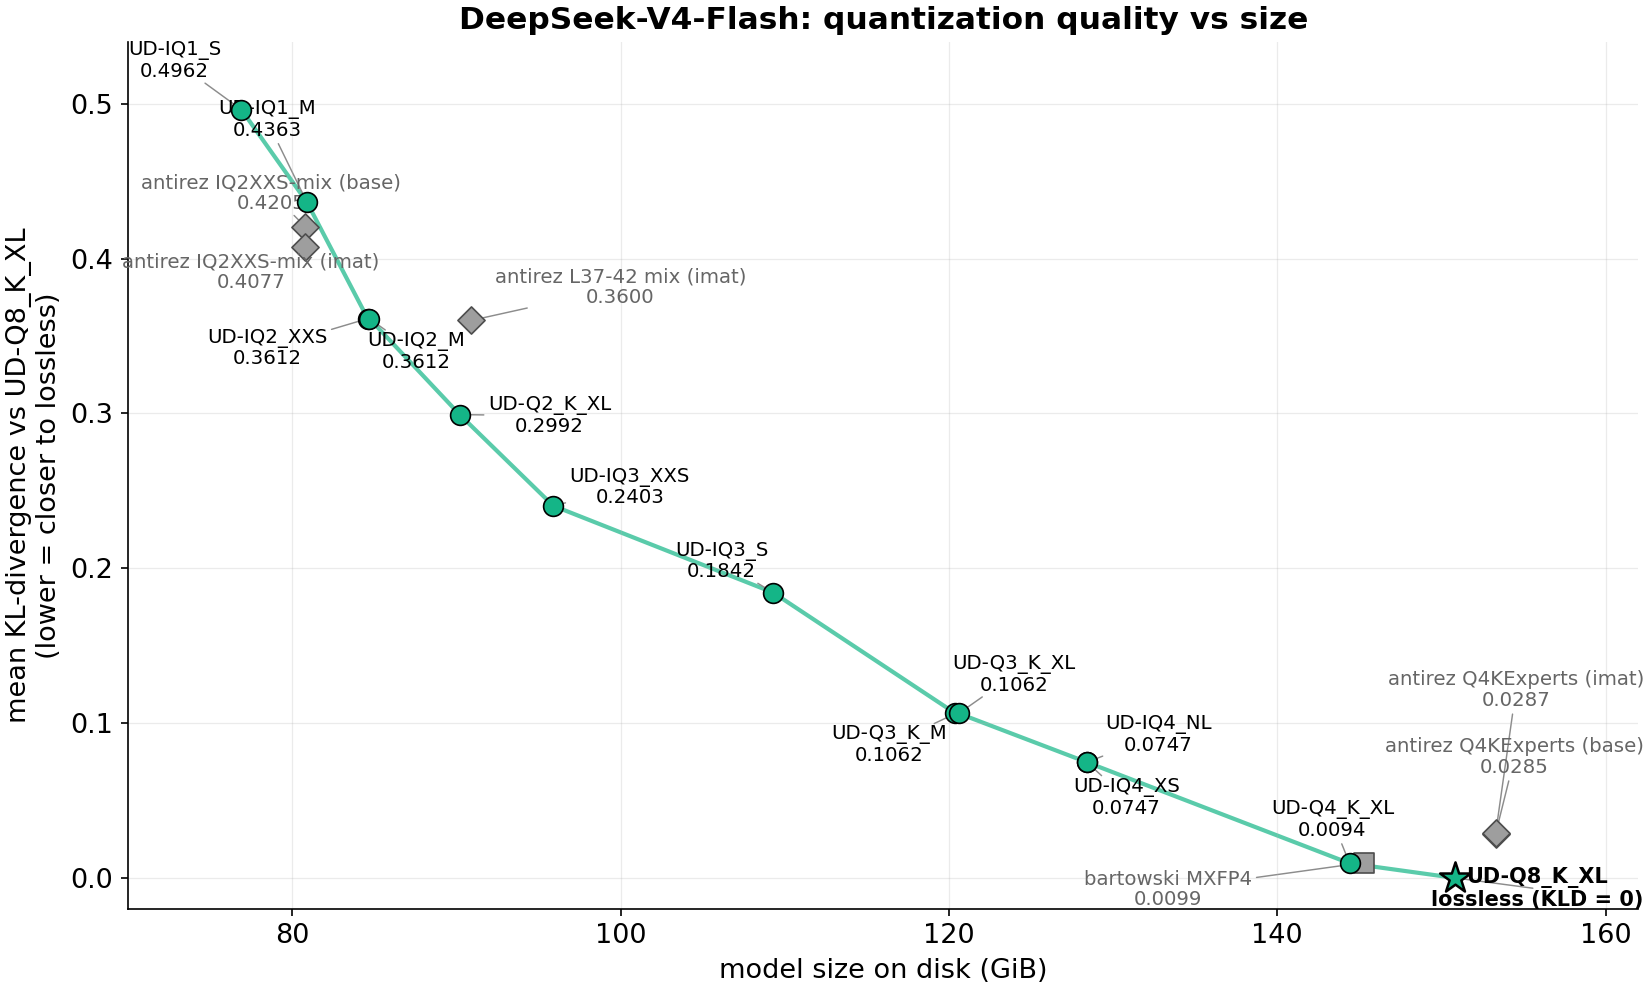
Notre `UD-Q8_K_XL` quantification est totalement sans perte. DeepSeek-V4-Flash est [entraîné en tenant compte de la quantification](/docs/fr/blog/quantization-aware-training-qat.md): le point de contrôle officiel stocke nativement ses experts routés (96 % du modèle) en MXFP4 et tout le reste en FP8 ou BF16. Le MXFP4 de GGUF est exactement ce format, donc nous réassemblons les experts bit à bit, et le FP8 se désquantifie en BF16 sans arrondi. Nous avons vérifié chaque tenseur par rapport aux poids officiels de DeepSeek : les 1 328 sont tous identiques bit à bit, et cela reste sans perte à l’inférence (divergence KL \~0, accord sur le top-token à 100 %).

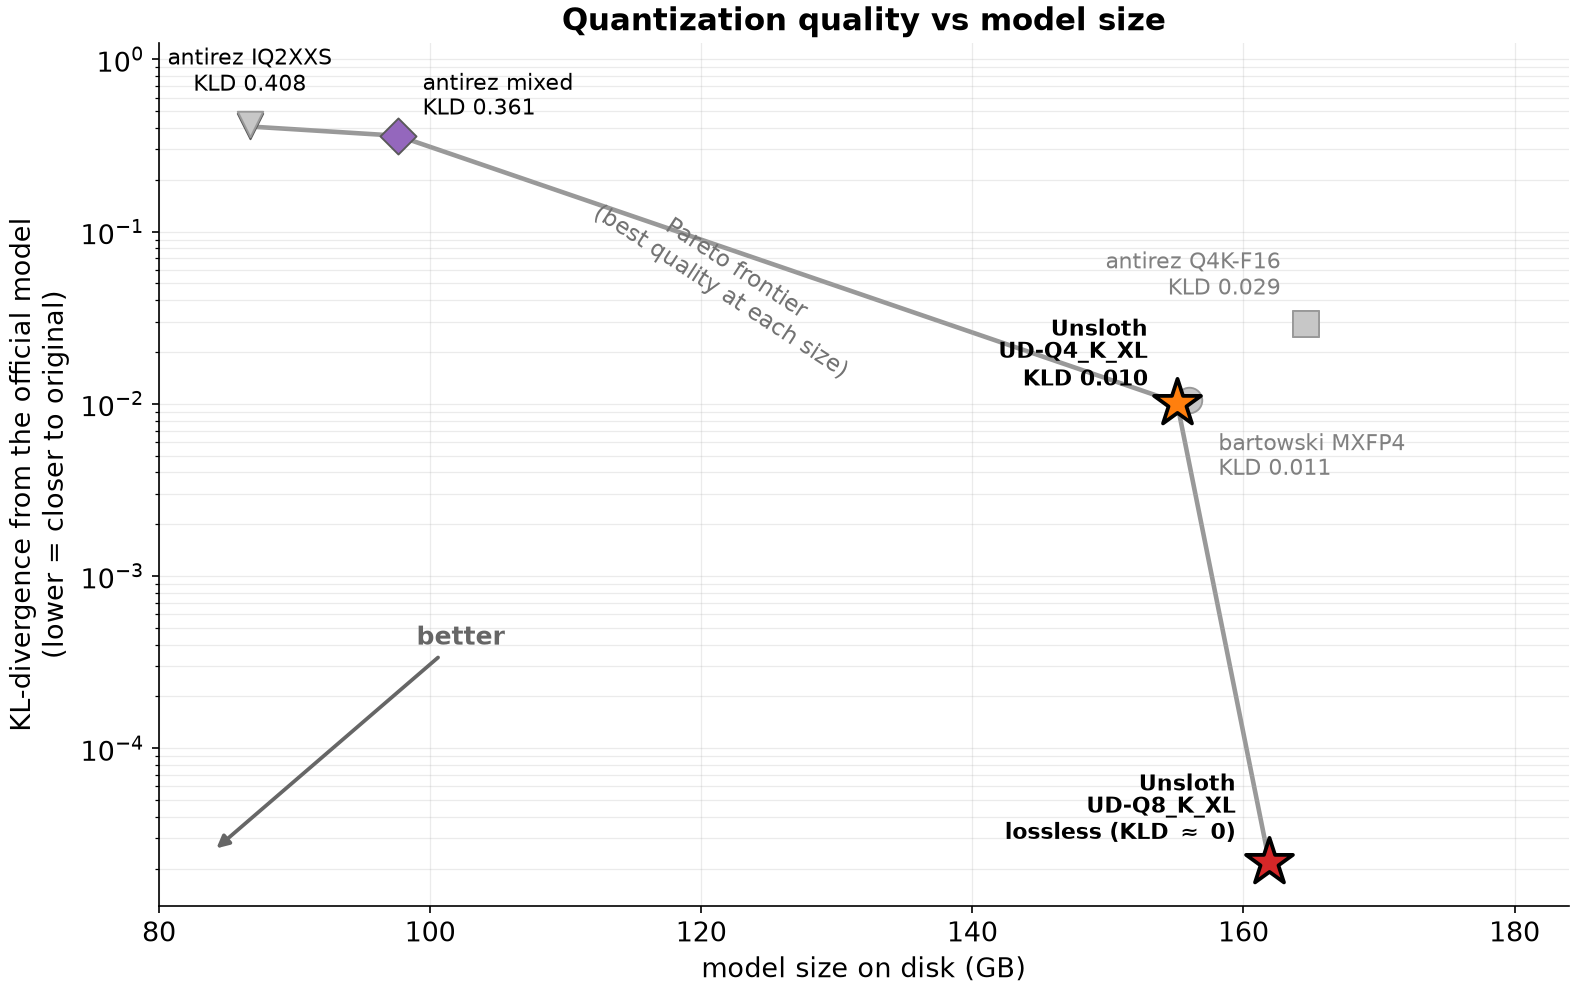
**Non**-Unsloth Les GGUF DeepSeek-V4-Flash ont été convertis sans ces chemins, ce qui les fait diverger des poids officiels. `UD-Q4_K_XL` conserve les mêmes experts identiques au bit près et ne quantifie que les tenseurs non experts (4 % du modèle) en Q8\_0, ce qui le place juste à côté de Q8 en taille et en qualité.

<div align="left"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FXjXSVsiH2ZIKlJ7iZPDx%2Fkldddd.webp?alt=media&amp;token=e1db5fca-b2b4-411e-8956-29127ef6bfe0" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHoYuIu6dNNuLrM4nmdbi%2Fpareto.png?alt=media&amp;token=1c7a44bb-13c3-4fc4-8d57-fb350ffe3c14" alt="" width="563"><figcaption></figcaption></figure></div>

Mesurées par rapport aux poids officiels, les deux quantifications Unsloth se trouvent à la frontière qualité/taille. UD-Q8\_K\_XL est le seul point sans perte. UD-Q4\_K\_XL correspond aux autres formats MXFP4 communautaires et est plus précis que les conversions Q4\_K-experts, qui sont plus volumineuses mais atteignent 0,029 KLD.

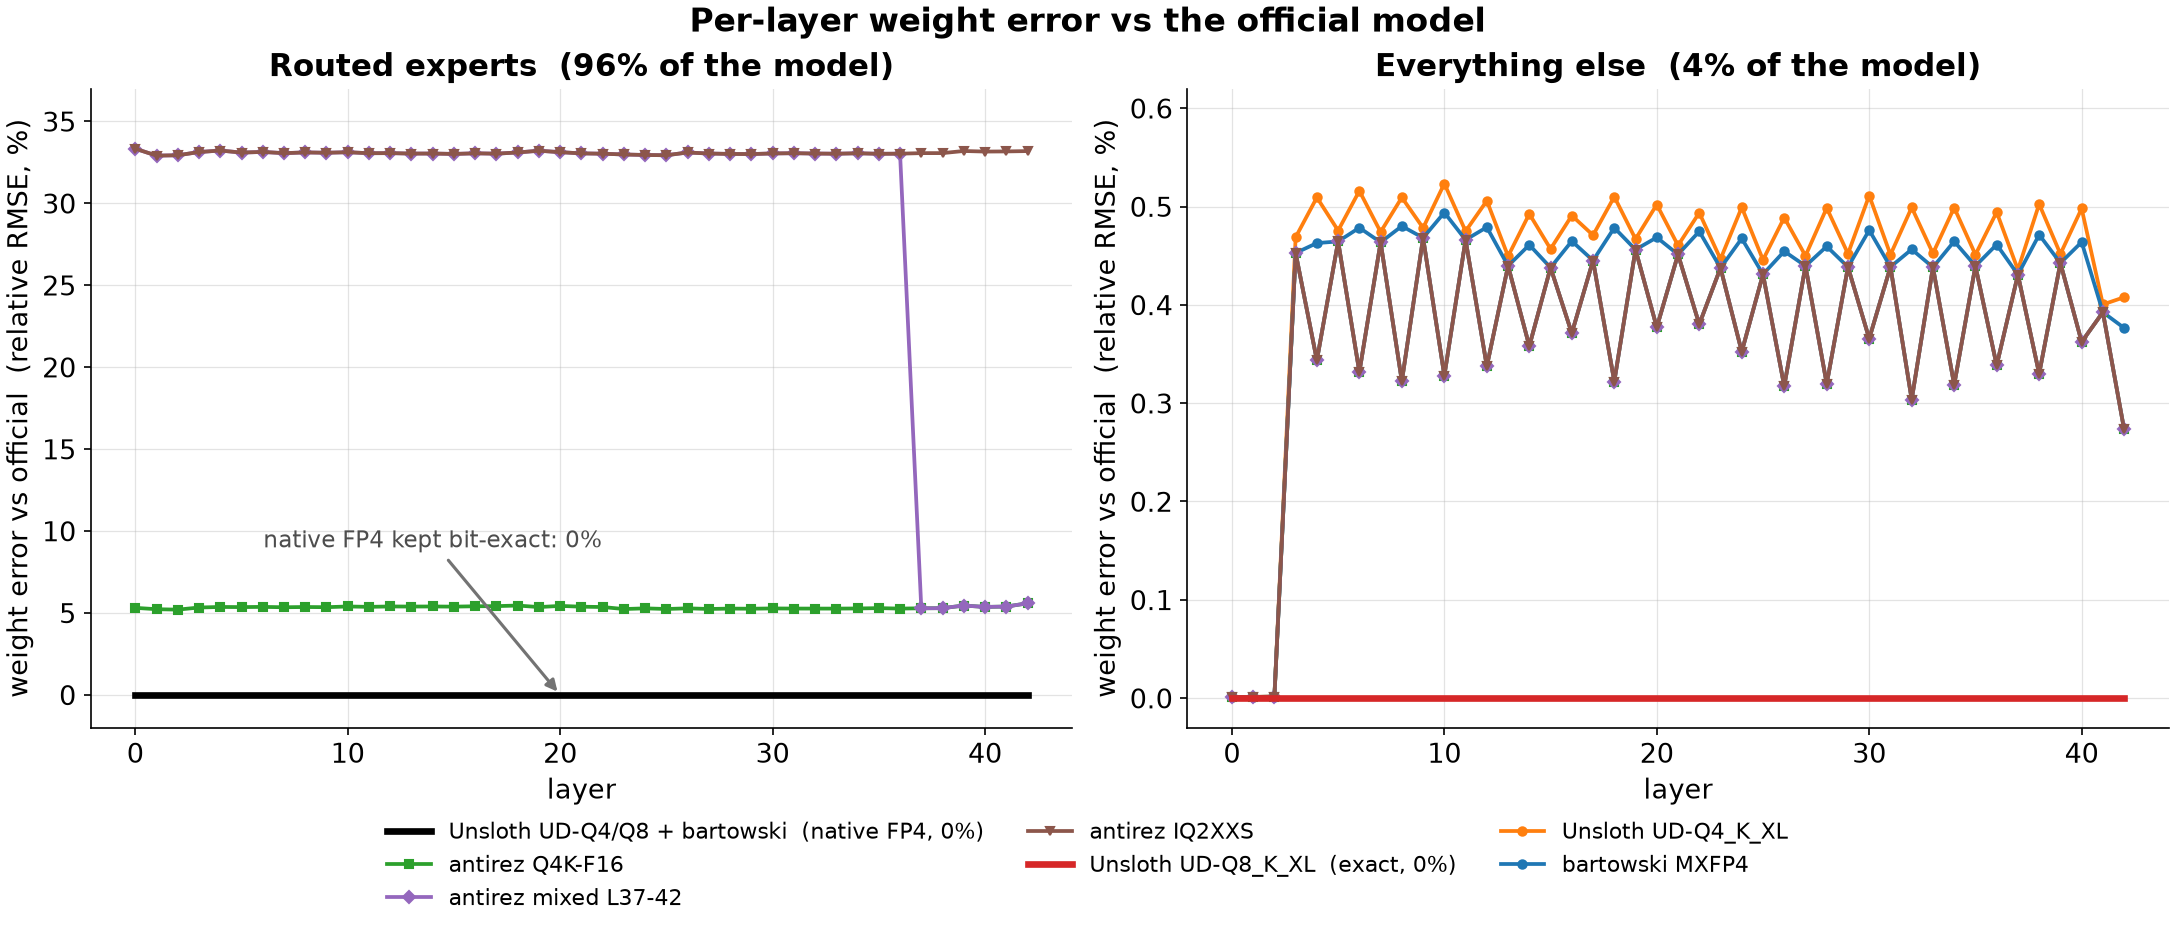
<div align="left"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FxW5lIQID1dIRlVajHSWm%2Fper_layer.png?alt=media&amp;token=94dd4abc-e7ef-4aa8-8d2f-de8c98a69166" alt="" width="563"><figcaption></figcaption></figure></div>

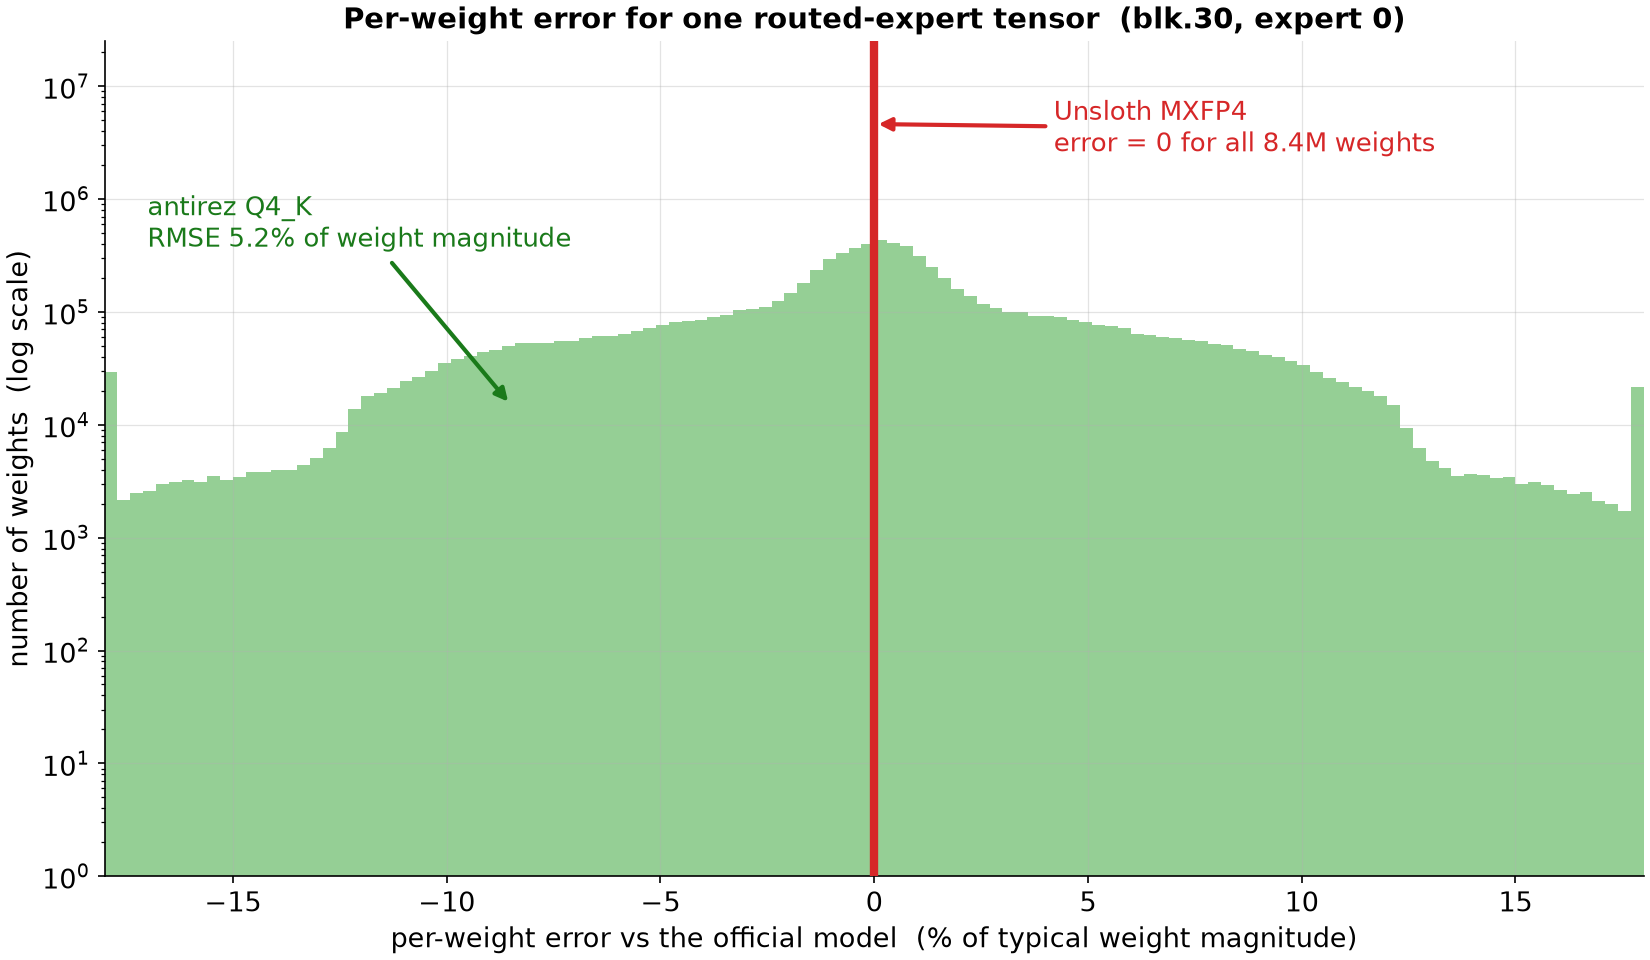
La répartition de l’erreur par couche explique pourquoi. Conserver les experts MXFP4 natifs signifie 0 % d’erreur de poids à chaque couche. Les conversions qui re-quantifient les experts en Q4\_K ou IQ2\_XXS arrondissent presque chaque poids : 5 % pour Q4\_K, plus de 30 % pour IQ2\_XXS.

<div align="left"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FINDS7DqyP9TUAs4Bj9rS%2Fwhy_lossless.png?alt=media&amp;token=efdb261b-f969-42b8-89ec-bc25e8bbdaf3" alt="" width="563"><figcaption><p>Notre MXFP4 n’a exactement aucune erreur sur les 8,4 M de poids, tandis que Q4_K, une grille 4 bits différente, doit arrondir chacun d’eux (5,2 % RMSE).</p></figcaption></figure></div>

Nous avons aussi constaté que l’utilisation de Q8\_0 et F16 pour certains tenseurs n’est pas sans perte, et que cela empire puisque DeepSeek a appliqué du QAT pour faire bien fonctionner MXFP4 / FP8, donc nous avons dû les laisser directement en BF16. Utilisez donc UD-Q8\_K\_XL pour une quantification vraiment sans perte, et UD-Q4\_K\_XL rétrograde certains éléments BF16 en Q8\_0.

Pour les tableaux complets des benchmarks de [GGUF Benchmarks, voir ici](#gguf-benchmarks).

### :speech\_balloon: Améliorations du modèle de chat DeepSeek V4

Nous avons également amélioré le modèle Jinja de chat DeepSeek-V4, et testé plus de 4000 conversations pour qu’il soit équivalent à la référence dorée (DS4 officiel)

Nous avons ajouté `reasoning_effort` et vous pouvez choisir `max, high` tout comme le DeepSeek-V4 officiel. Nous préfixons l’invite système correcte conformément à DS4 et avons suivi le style de gpt-oss.

Et pour les appels d’outils, `reasoning_content` était conservé pour DS4, mais le modèle de chat Jinja les exclurait. Nous l’avons réajouté.

#### **Désactiver le raisonnement, modifier l’effort de raisonnement**

DeepSeek-V4 utilise le raisonnement par défaut. Il prend également en charge des niveaux d’effort de raisonnement où `reasoning_effort` peut être "high", "max" ou désactivé.

Pour désactiver le raisonnement, utilisez `--chat-template-kwargs '{"enable_thinking":false}'`. Si vous êtes sous **Windows** Powershell, utilisez : `--chat-template-kwargs "{\"enable_thinking\":false}"`

Vous pouvez aussi utiliser `--reasoning on` ou `--reasoning off` dans llama.cpp également maintenant !

Pour personnaliser l’effort de raisonnement et/ou désactiver le raisonnement, utilisez les exemples ci-dessous :

```bash
--chat-template-kwargs '{"reasoning_effort":"max"}'
--chat-template-kwargs '{"reasoning_effort":"high"}'
--chat-template-kwargs '{"enable_thinking":false}'
```

### ⚙️ Guide d’utilisation

DeepSeek-V4-Flash est plus petit et plus rapide que DeepSeek-V4-Pro, avec **284B** paramètres (13B actifs), et une **fenêtre de contexte de 1M**. Le modèle a 3 modes, **Sans réflexion**, **Réflexion** **Élevé** et **Réflexion** **Max**.&#x20;

Il est recommandé d’utiliser `UD-IQ3_XXS` qui est **103 Go** pour obtenir les meilleurs résultats. Comme la taille du fichier n’inclut pas le cache KV ni l’allocation du contexte, essayez d’avoir au moins **appareil doté de 110 Go de RAM** pour exécuter le modèle.

La `UD-Q8_K_XL` quantification est DeepSeek-V4-Flash en précision originale complète. Elle pèse 162 Go et il est préférable d’avoir au moins 169 Go de RAM/VRAM disponibles.

**Tableau : exigences matérielles pour l’inférence** (unités = mémoire totale : RAM + VRAM, ou mémoire unifiée)

<table><thead><tr><th>Format</th><th width="129.8004150390625">1 bit</th><th width="130.85650634765625">2 bits</th><th width="140.26702880859375">3 bits</th><th>4 bits (presque sans perte)</th><th>Q8_K_XL (sans perte)</th></tr></thead><tbody><tr><td>Standard</td><td>92 Go</td><td>102 Go</td><td>110-135 Go</td><td>162 Go</td><td>169 Go</td></tr><tr><td>DSpark</td><td>102 Go</td><td>112 Go</td><td>120-145 Go</td><td>172 Go</td><td>179 Go</td></tr></tbody></table>

{% hint style="info" %}
**DSpark utilise plus de VRAM que le standard**, donc prévoyez **environ 10 Go** de marge supplémentaire en RAM/VRAM.
{% endhint %}

{% hint style="success" %}
Pour de meilleures performances, assurez-vous que votre mémoire totale disponible, y compris la VRAM et la RAM système, dépasse la taille du fichier du modèle quantifié d’une marge confortable.
{% endhint %}

### Paramètres recommandés

DeepSeek recommande ces paramètres pour de meilleures performances : `temperature = 1.0`, `top-p = 1.0`. Pour **DeepSeek-V4-Flash-0731** et les scénarios agentiques, `top-p = 0.95` est plutôt recommandé et `top-p = 1.0` pour les autres tâches.

**Think High est activé par défaut.** S’il est désactivé, vous pouvez l’activer via : `--chat-template-kwargs '{"enable_thinking":true}'` ou le basculer via le menu déroulant de l’interface dans [Unsloth](#unsloth-studio-guide). Voir aussi [#deepseek-v4-chat-template-improvements](#deepseek-v4-chat-template-improvements "mention")

{% columns %}
{% column width="50%" %}

| DeepSeek-V4-Flash-0731                |
| ------------------------------------- |
| `temperature = 1.0`                   |
| `top-p = 1.0`                         |
| `top-p = 0.95` (agentique uniquement) |
| {% endcolumn %}                       |

{% column width="50%" %}

| Anciens DeepSeek-V4-Flash et V4-Pro |
| ----------------------------------- |
| `temperature = 1.0`                 |
| `top-p = 1.0`                       |
| {% endcolumn %}                     |
| {% endcolumns %}                    |

* **Fenêtre de contexte maximale :** `1,048,576`
* Pour Think Max, réglez le contexte à au moins **384K jetons**.

## Tutoriels pour exécuter DeepSeek-V4-Flash :

Pour ce tutoriel, nous utiliserons la quantification 3 bits `UD-IQ3_XXS`, car elle tient sur un appareil avec 128 Go de RAM. Remplacez `UD-IQ3_XXS` par `UD-Q8_K_XL` (qualité originale) ou une autre quantification si votre machine dispose de suffisamment de mémoire. Vous pouvez désormais exécuter DeepSeek-V4-Flash-0731 dans [Unsloth Desktop](#run-in-unsloth-studio) . **DSpark est automatiquement activé dans** [**Unsloth**](#unsloth-studio-guide)**.**

<a href="/docs/fr/modeles/deepseek-v4.md#unsloth-studio-guide" class="button primary">🦥 Guide Unsloth</a><a href="/pages/ce872989f38581a2eb254c401a2aafc0ab693291#llama.cpp-guide" class="button primary">🦙 Guide Llama.cpp</a><a href="/docs/fr/modeles/deepseek-v4.md#dspark-speculative-decoding" class="button secondary">⚡ Guide DSpark</a>

### 🦥 Guide Unsloth

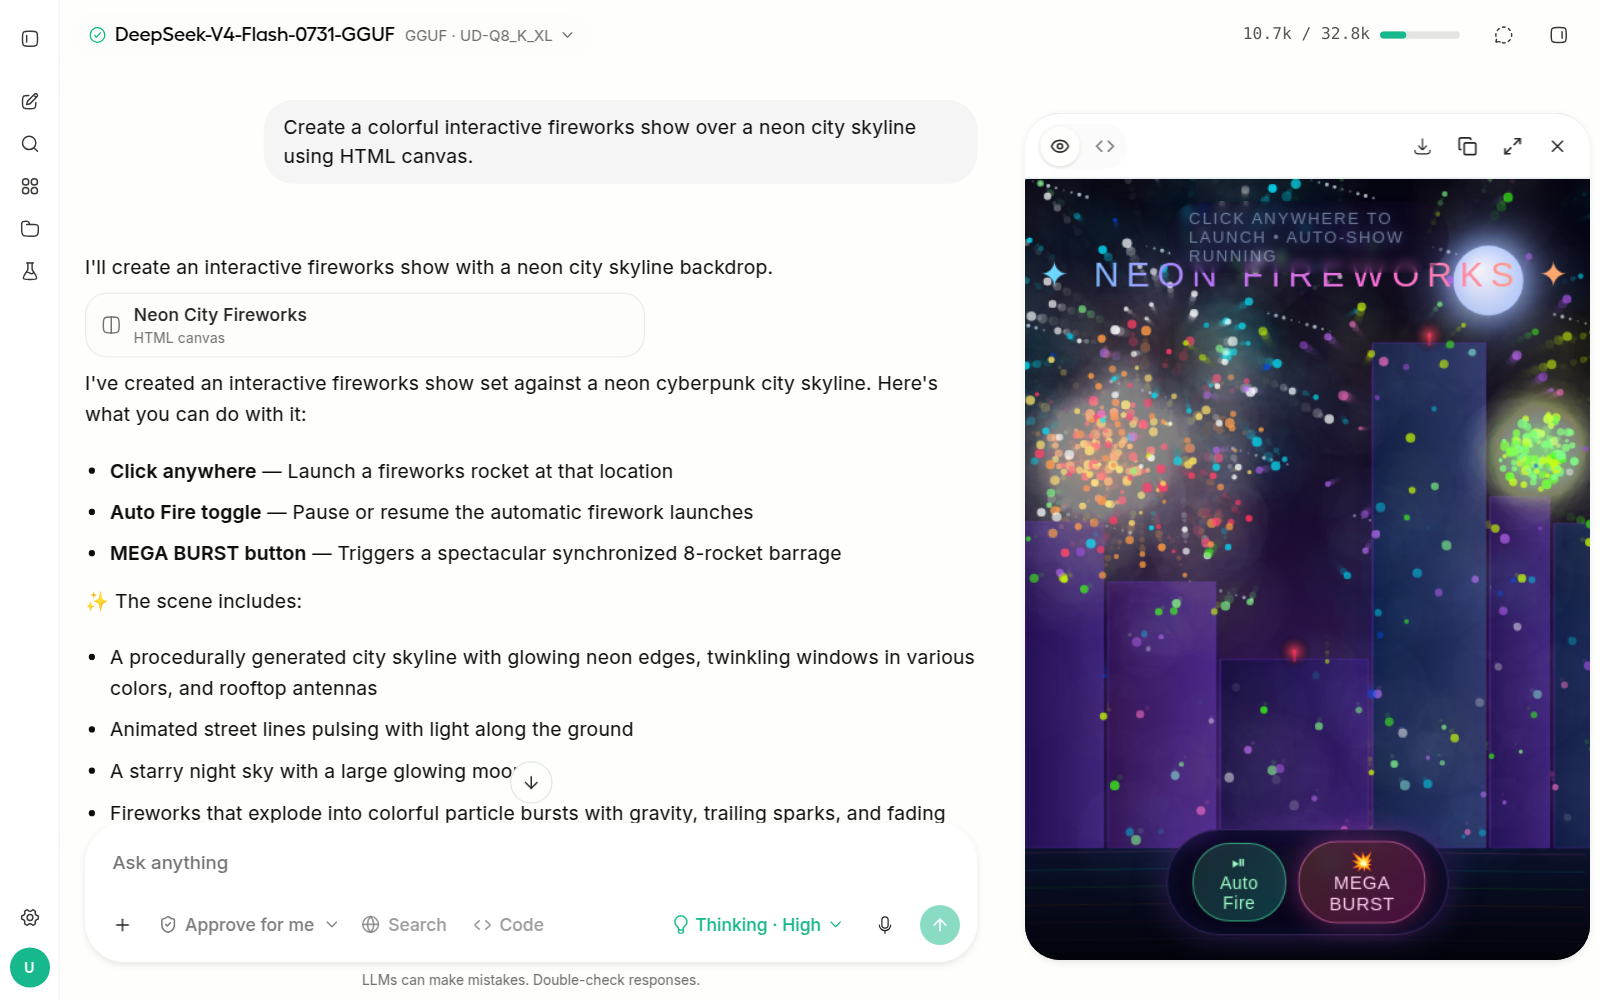
DeepSeek-V4-Flash-0731 peut désormais être exécuté et entraîné dans [Unsloth](/docs/fr/nouveau/studio.md), notre nouvelle interface open source pour l’IA locale. Unsloth Desktop vous permet d’exécuter des modèles localement sur **macOS**, **Windows**, Linux et :

{% columns %}
{% column %}

* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally) et des modèles safetensor
* [**Auto-réparation** appel d’outils](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) + **recherche web**
* [**Exécution de code**](/docs/fr/nouveau/studio.md#run-models-locally) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence rapide CPU + GPU via llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2 fois plus rapide avec 70 % de VRAM en moins
  {% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FCwcXvmLERJSUNF6iNTiY%2Fdeepseek-v4-flash-0731-unsloth-studio.png?alt=media&amp;token=6fdc0216-d21e-42e7-bb57-8e1abf6e7f4f" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}

#### Installer Unsloth

Le moyen le plus simple de commencer est de télécharger l’ [application Unsloth Desktop](/docs/fr/desktop.md). Fonctionne sur [macOS](/docs/fr/commencer/install/mac.md), [Windows](/docs/fr/commencer/install/windows-installation.md), et [Linux](/docs/fr/commencer/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Télécharger Unsloth</a>

* <i class="fa-apple">:apple:</i> [Télécharger pour macOS](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Télécharger pour Windows](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Télécharger pour Linux](https://unsloth.ai/download/linux)

Ou, si vous préférez installer manuellement :

macOS, Linux, WSL :

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

Windows PowerShell :

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% endstep %}

{% step %}

#### Rechercher et télécharger DeepSeek-V4-Flash

Aller à [Unsloth Chat](/docs/fr/nouveau/studio/chat.md) ou le hub de modèles, puis recherchez DeepSeek-V4-Flash dans la barre de recherche et téléchargez le modèle et la quantification souhaités.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FGEc90VxPAgTHulQe9zB0%2FScreenshot%202026-07-31%20at%208.01.35%E2%80%AFAM.png?alt=media&amp;token=2931411d-8f75-4bfe-918a-73fcafe918f9" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### Exécuter DeepSeek-V4-Flash-0731

Les paramètres d’inférence doivent être définis automatiquement lors de l’utilisation d’Unsloth, mais vous pouvez toujours les modifier manuellement. Comme **Think High est activé par défaut**, vous pouvez aller dans la liste déroulante de droite pour le basculer en Non-think ou Think Max. Vous pouvez aussi modifier la longueur du contexte, le modèle de chat et d’autres paramètres. **DSpark est automatiquement activé dans** [**Unsloth**](#unsloth-studio-guide)**.**

Pour plus d’informations, vous pouvez consulter notre [guide d’inférence Unsloth](/docs/fr/nouveau/studio/chat.md).

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FlvJqDRKlWdAVkn3HXJZA%2F1000024247.png?alt=media&amp;token=e84fd31d-7720-40d5-aba1-ba65ac34ce97" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### Servir DeepSeek-V4 avec l’API Unsloth

Vous pouvez utiliser `unsloth run` la commande et servir DeepSeek via une API en utilisant `llama-server` des drapeaux d’exécution, notamment le dimensionnement du contexte, les couches GPU, le multithreading, l’échantillonnage, le réseau et la configuration des outils. Pour plus d’informations, consultez notre [documentation de l’API](/docs/fr/notions-de-base/api.md) ou [unsloth start](/docs/fr/integrations/unsloth-start.md).

```bash
unsloth run --model unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-IQ3_S
```

{% endstep %}

{% step %}

#### Unsloth est maintenant prêt

Vous pouvez aussi faire bien d’autres choses avec DeepSeek via Unsloth Desktop, par exemple :

* **Connecter des outils :** [Claude Code](/docs/fr/notions-de-base/claude-code.md), [Codex](/docs/fr/notions-de-base/codex.md), [recherche web](/docs/fr/nouveau/studio/chat.md#advanced-web-search), [MCP](/docs/fr/notions-de-base/mcp.md) et plus encore
* **Entraîner des modèles :** Affiner du texte, de la diffusion, [embedding](/docs/fr/notions-de-base/embedding-finetuning.md), et plus encore
* **Générer des médias :** Créer et entraîner [des images](/docs/fr/notions-de-base/diffusion-image.md), de la vidéo, [TTS](/docs/fr/notions-de-base/text-to-speech-tts-fine-tuning.md) localement
  {% endstep %}
  {% endstepper %}

### 🦙 Guide Llama.cpp

{% stepper %}
{% step %}
Obtenez la dernière version de `llama.cpp` **sur** [**GitHub ici**](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Remplacez `-DGGML_CUDA=ON` par `-DGGML_CUDA=OFF` si vous n’avez pas de GPU ou si vous voulez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez normalement - la prise en charge de Metal est activée par défaut.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
Vous pouvez maintenant utiliser `llama.cpp` directement pour charger et télécharger des modèles, tout comme `ollama run`. Tout d’abord, sélectionnez le type de quantification souhaité, comme `IQ3_XXS`. Utilisez aussi `export LLAMA_CACHE="folder"` pour forcer `llama.cpp` à enregistrer dans un emplacement spécifique. Notez que ce processus de téléchargement peut être très lent ; il vaut donc probablement mieux utiliser le processus de téléchargement manuel dans la section suivante.

```bash
export LLAMA_CACHE="unsloth/DeepSeek-V4-Flash-0731-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-IQ3_S \
    --temp 1.0 \
    --top-p 1.0 \
    --min-p 0.01
```

{% endstep %}

{% step %}
Si vous souhaitez télécharger le modèle manuellement, nous pouvons le télécharger via le code ci-dessous (après avoir installé `pip install huggingface_hub`). Si les téléchargements se bloquent, voir : [Hugging Face Hub, débogage XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF \
    --local-dir unsloth/DeepSeek-V4-Flash-0731-GGUF \
    --include "*UD-IQ3_S*" # Utilisez "*UD-IQ4_XS*" pour 4 bits
```

{% endstep %}

{% step %}
Vous pouvez modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 32768` pour la longueur du contexte, `--n-gpu-layers 2` pour le déchargement GPU sur le nombre de couches souhaité. Essayez de l’ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous n’avez qu’une inférence CPU.

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/DeepSeek-V4-Flash-0731-GGUF/UD-IQ3_S/DeepSeek-V4-Flash-0731-UD-IQ3_S-00001-of-00004.gguf \
    --temp 1.0 \
    --top-p 1.0 \
    --min-p 0.01
```

{% endcode %}
{% endstep %}
{% endstepper %}

## :zap:DSpark - décodage spéculatif

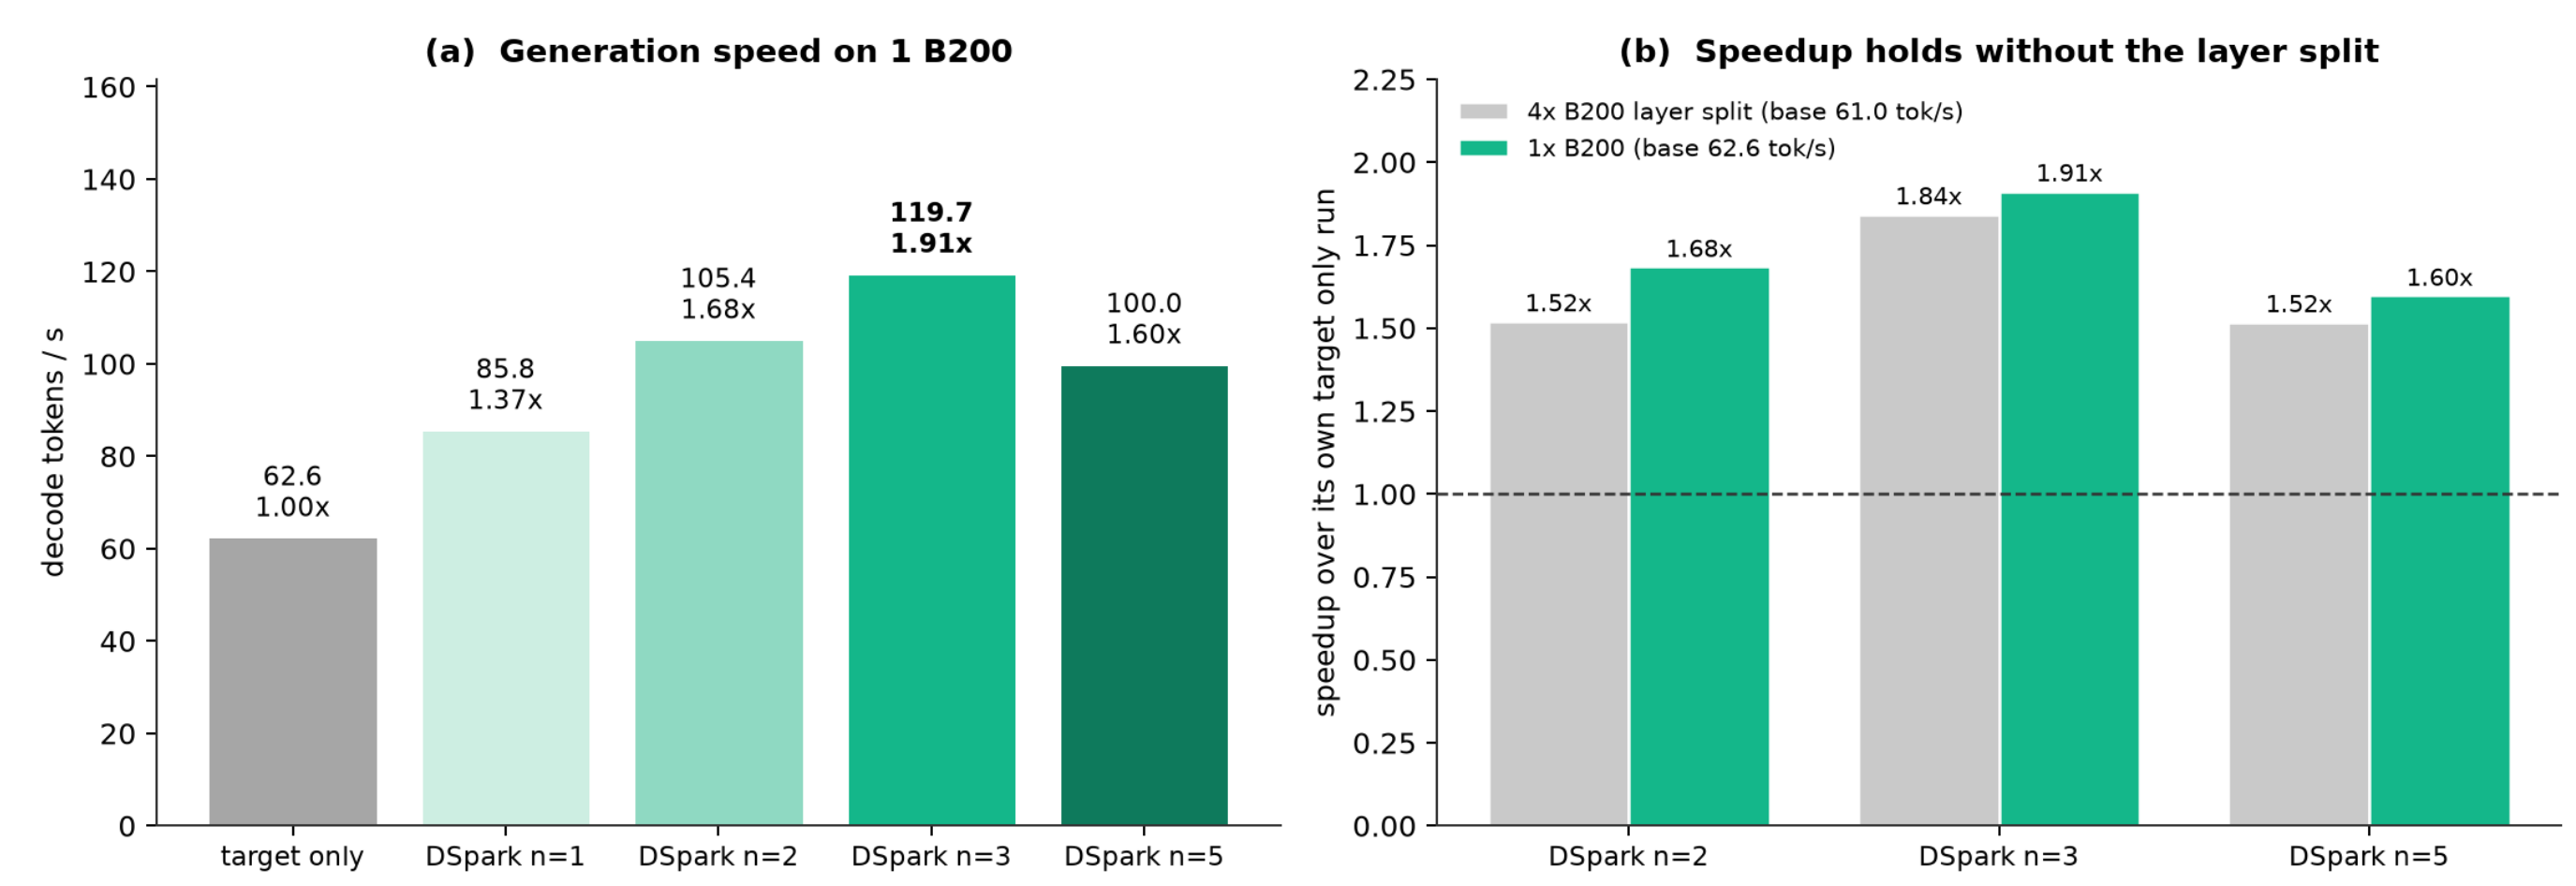
DeepSeek-V4-Flash-0731 dispose de DSpark natif, ce qui permet jusqu’à **une vitesse de décodage 2 fois plus rapide**! DSpark est un nouvel algorithme de DeepSeek, supérieur au MTP naïf, et a été présenté dans cet [article](https://arxiv.org/abs/2607.05147). DSpark permet à DeepSeek-V4-Flash d’atteindre **120 jetons/s** sur un GPU B200, contre la base de référence originale de 60 jetons/s. **DSpark est automatiquement activé dans l’** [**Unsloth**](#unsloth-studio-guide) **interface locale.**

Llama.cpp a intégré DSpark dans le cadre de [PR 25784](https://github.com/ggml-org/llama.cpp/pull/25784) avec d’autres améliorations du multi-GPU et plus encore. Nous montrons l’utilisation de `--spec-draft-n-max 3` comme bon réglage par défaut, permettant une vitesse d’inférence 1,9 fois plus rapide. Des valeurs plus élevées semblent être plus lentes.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FRV0T1cVPpCnacNnywAsL%2Fimage.png?alt=media&amp;token=b570026f-4577-4a45-936f-98a650d644ac" alt=""><figcaption></figcaption></figure>

Téléchargez à la fois le drafter et le GGUF - nous en avons créé 2 en Q8\_0 et une version BF16 sans perte. Notez que DSpark nécessitera environ 10 Go de mémoire supplémentaire, donc les machines de 128 Go auront besoin de IQ3\_XXS et de Q8\_0

{% code overflow="wrap" %}

```bash
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF \
    --local-dir unsloth/DeepSeek-V4-Flash-0731-GGUF \
    --include "*dspark-DeepSeek-V4-Flash-0731-Q8_0*" \
    --include "*UD-IQ3_XXS*" # Utilisez "*UD-IQ4_XS*" pour 4 bits
```

{% endcode %}

Chargez-le ensuite via llama-cli ou llama-server:

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/DeepSeek-V4-Flash-0731-GGUF/UD-IQ3_XXS/DeepSeek-V4-Flash-0731-UD-IQ3_XXS-00001-of-00004.gguf \
    -md unsloth/DeepSeek-V4-Flash-0731-GGUF/dspark-DeepSeek-V4-Flash-0731-Q8_0.gguf \
    --temp 1.0 \
    --top-p 1.0 \
    --min-p 0.01 \
    --spec-type draft-dspark \
    --spec-draft-n-max 3 \
    -ngl 99 -ngld 99
```

{% endcode %}

Benchmarks du document original DSpark montrant également ses performances face à MTP :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FNXmTkimQGD9JzAq4OtK9%2Fimage.png?alt=media&amp;token=bab3816c-e3cd-4bd8-a234-6226520f45f6" alt=""><figcaption></figcaption></figure>

## 📊 Benchmarks

### Benchmarks GGUF

Voir ci-dessous un tableau comparant les benchmarks des quantifications d’Unsloth et d’autres fournisseurs. Référence = poids officiels. Perplexité et divergence KL sur wikitext-2 avec ctx 512 sur 4x B200.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FXjXSVsiH2ZIKlJ7iZPDx%2Fkldddd.webp?alt=media&amp;token=e1db5fca-b2b4-411e-8956-29127ef6bfe0" alt="" width="563"><figcaption></figcaption></figure>

| Quant                              | Taille (Go) | PPL    | KLD moyenne          | delta-p RMS | Même jeton principal | Poids exacts au bit |
| ---------------------------------- | ----------- | ------ | -------------------- | ----------- | -------------------- | ------------------- |
| Officiel (référence)               | 156.4       | 4.5319 | 0                    | 0%          | 100%                 | 100%                |
| **Unsloth UD-Q8\_K\_XL**           | 161.9       | 4.5319 | **\~0 (sans perte)** | 0.000%      | 100.000%             | **100.000%**        |
| **Unsloth UD-Q4\_K\_XL**           | 155.1       | 4.5335 | 0.0102               | 3.40%       | 96.28%               | 97.46%              |
| bartowski MXFP4                    | 156.0       | 4.5351 | 0.0105               | 3.42%       | 96.18%               | 97.57%              |
| antirez Q4KExperts-F16 (imatrix)   | 164.6       | 4.5743 | 0.0291               | 5.87%       | 93.95%               | 0.51%               |
| antirez Q4KExperts-F16             | 164.6       | 4.5726 | 0.0290               | 5.89%       | 93.94%               | 0.93%               |
| antirez mixed L37-42-Q4K (imatrix) | 97.6        | 5.8169 | 0.3605               | 21.15%      | 79.74%               | 0.41%               |
| antirez IQ2XXS (imatrix)           | 86.7        | 6.0808 | 0.4079               | 22.23%      | 78.15%               | 0.39%               |
| antirez IQ2XXS                     | 86.7        | 6.1518 | 0.4207               | 22.74%      | 77.92%               | 0.47%               |

### Benchmarks officiels

DeepSeek-V4-Flash-0731 surpasse DeepSeek-V4-Pro (Preview) sur les benchmarks ci-dessous, malgré l’utilisation de beaucoup moins de paramètres activés, et reste compétitif face aux principaux modèles propriétaires.

| Benchmark              | DeepSeek-V4-Flash-0731 | DeepSeek-V4-Flash (Preview) | DeepSeek-V4-Pro (Preview) | GLM-5.2 | Opus-4.8 |
| ---------------------- | :--------------------: | :-------------------------: | :-----------------------: | :-----: | :------: |
| Terminal Bench 2.1     |          82.7          |             61.8            |            72.1           |   81.0  |   85.0   |
| NL2Repo                |          54.2          |             39.4            |            38.5           |   48.9  |   69.7   |
| Cybergym               |          76.7          |             38.7            |            52.7           |    -    |   83.1   |
| DeepSWE                |          54.4          |             7.3             |            12.8           |   46.2  |   58.0   |
| Toolathlon-Verified    |          70.3          |             49.7            |            55.9           |   59.9  |   76.2   |
| Agents' Last Exam      |          25.2          |             15.8            |            16.5           |   23.8  |   25.7   |
| AutomationBench Public |          25.1          |             10.8            |            12.8           |   12.9  |   27.2   |
| DSBench-FullStack †    |          68.7          |             37.0            |            41.8           |   61.8  |   71.6   |
| DSBench-Hard †         |          59.6          |             25.8            |            31.1           |   54.5  |   71.7   |


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://unsloth.ai/docs/fr/modeles/deepseek-v4.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.