> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/qwen3.6.md).

# Qwen3.6

Führe die neuen Modelle Qwen3.6-27B und 35B-A3B lokal aus!

Qwen3.6 ist Alibabas neue Familie multimodaler Hybrid-Reasoning-Modelle, darunter: **Qwen3.6-27B** und **35B-A3B**. Es liefert Spitzenleistung für seine Größe und unterstützt einen 256K-Kontext in 201 Sprachen. Es ist hervorragend in agentischem Coding, Vision und Chat-Aufgaben. Qwen3.6-27B läuft auf **18 GB RAM** -Setups und 35B-A3B läuft auf **22 GB**. Sie können die Modelle jetzt ausführen und trainieren in [Unsloth Desktop](#unsloth-guide).

{% hint style="success" %}
**10. Juli:** Wir haben neue veröffentlicht [**NVFP4** handelt](#nvfp4) um Qwen3.6 auf GPUs 2,5× schneller auszuführen.

[**Qwen3.6 MTP ist da**](#mtp-guide)**!** MTP ermöglicht 1,4–2,2× schnellere Inferenz ohne Genauigkeitsverlust. Führen Sie MTP direkt aus in [Unsloth Studio](#unsloth-studio-mtp-guide). Wir haben [Qwen3.6 GGUF-Benchmarks](#unsloth-gguf-benchmarks) um Ihnen bei der Auswahl der besten Quant zu helfen.
{% endhint %}

<a href="#qwen3.6-inference-tutorials" class="button primary">Qwen3.6-Tutorials starten</a><a href="#mtp-guide" class="button primary">MTP-Leitfaden</a>

{% columns %}
{% column %}
Qwen3.6 GGUFs verwenden Unsloth [Dynamic 2.0](/docs/de/grundlagen/dynamic-3.0-ggufs.md) für erstklassige Quantisierungsleistung – die Quants werden also auf realen Anwendungsfall-Datensätzen kalibriert und wichtige Schichten werden hochgestuft. *Danke an Qwen für den Day-Zero-Zugang.*

* **Unterstützung für die Entwicklerrolle** für Codex, OpenCode und mehr:\
  Unsere Uploads unterstützen jetzt die `Entwicklerrolle` für agentische Coding-Tools.
* **Tool-Aufruf:** Wie [Qwen3.5](/docs/de/modelle/qwen3.5.md), wir haben das Parsen verschachtelter Objekte verbessert, damit Tool-Calling häufiger erfolgreich ist.
  {% endcolumn %}

{% column %}

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FTbH2CrUTG2TWwgOP74GF%2FGemma%204%20example.gif?alt=media&amp;token=56409d06-3735-4531-97c0-af9968371a26" alt=""><figcaption><p>Qwen3.6 läuft in <a href="#unsloth-studio-guide">Unsloth Studio</a>.</p></figcaption></figure></div>
{% endcolumn %}
{% endcolumns %}

### :gear: Anleitung zur Nutzung

**Tabelle: Hardware-Anforderungen für die Inferenz** (Einheiten = Gesamtspeicher: RAM + VRAM oder einheitlicher Speicher)

<table><thead><tr><th>Qwen3.6</th><th>3-Bit</th><th>4-Bit</th><th width="128">6-Bit</th><th>8-Bit</th><th>BF16</th></tr></thead><tbody><tr><td><strong>27B</strong></td><td>15 GB</td><td>18 GB</td><td>24 GB</td><td>30 GB</td><td>55 GB</td></tr><tr><td><strong>35B-A3B</strong></td><td>17 GB</td><td>23 GB</td><td>30 GB</td><td>38 GB</td><td>70 GB</td></tr></tbody></table>

{% hint style="success" %}
Für beste Leistung stellen Sie sicher, dass Ihr gesamter verfügbarer Speicher (VRAM + Systemspeicher) die Größe der quantisierten Modelldatei, die Sie herunterladen, übersteigt. Falls nicht, können Sie weiterhin per SSD/HDD-Auslagerung ausführen, die Inferenz wird dann aber langsamer.
{% endhint %}

**Zum Trainieren von Qwen3.6 können Sie sich auf unseren früheren** [**Qwen3.5-Fine-Tuning-Leitfaden**](/docs/de/modelle/qwen3.5/fine-tune.md)**.**

### Empfohlene Einstellungen

* **Maximales Kontextfenster:** `262,144` (kann über YaRN auf 1 Mio. erweitert werden)
* `presence_penalty = 0.0 bis 2.0` standardmäßig ist dies aus, aber um Wiederholungen zu reduzieren, kannst du dies verwenden; ein höherer Wert kann jedoch zu einem **leichten Leistungsabfall**
* **Angemessene Ausgabelänge**: `32,768` Tokens für die meisten Abfragen

{% hint style="info" %}
Wenn du Kauderwelsch erhältst, könnte deine Kontextlänge zu niedrig eingestellt sein. Oder versuche `--cache-type-k bf16 --cache-type-v bf16` was helfen könnte.
{% endhint %}

Da Qwen3.6 hybrides Reasoning verwendet, haben Denk- und Nicht-Denk-Modus unterschiedliche Einstellungen:

#### Denken-Modus:

{% hint style="success" %}
Qwen3.6 hat jetzt [Denken beibehalten](#turn-on-off-thinking--preserve-thinking).
{% endhint %}

| Allgemeine Aufgaben                    | Präzise Coding-Aufgaben (z. B. WebDev) |
| -------------------------------------- | -------------------------------------- |
| temperature = 1.0                      | temperature = 0.6                      |
| top\_p = 0.95                          | top\_p = 0.95                          |
| top\_k = 20                            | top\_k = 20                            |
| min\_p = 0.0                           | min\_p = 0.0                           |
| presence\_penalty = 0.0                | presence\_penalty = 0.0                |
| repeat\_penalty = deaktiviert oder 1.0 | repeat\_penalty = deaktiviert oder 1.0 |

{% columns %}
{% column %}
Denkmodus für allgemeine Aufgaben:

{% code overflow="wrap" %}

```bash
temperature=1.0, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0
```

{% endcode %}
{% endcolumn %}

{% column %}
Denkmodus für präzise Coding-Aufgaben:

{% code overflow="wrap" %}

```bash
temperature=0.6, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0
```

{% endcode %}
{% endcolumn %}
{% endcolumns %}

#### Einstellungen für den Instruct-Modus (ohne Denken):

| Allgemeine Aufgaben                    |
| -------------------------------------- |
| temperature = 0.7                      |
| top\_p = 0.8                           |
| top\_k = 20                            |
| min\_p = 0.0                           |
| presence\_penalty = 1.5                |
| repeat\_penalty = deaktiviert oder 1.0 |

{% hint style="warning" %}
Um [Denken/Schlussfolgern deaktivieren](#how-to-enable-or-disable-reasoning-and-thinking), verwenden Sie `--chat-template-kwargs '{"enable_thinking":false}'`

Wenn Sie auf **Windows** Powershell sind, verwenden Sie: `--chat-template-kwargs "{\"enable_thinking\":false}"`

Verwenden Sie 'true' und 'false' austauschbar.
{% endhint %}

Instruct (ohne Denken) für allgemeine Aufgaben:

{% code overflow="wrap" %}

```bash
temperature=0.7, top_p=0.8, top_k=20, min_p=0.0, presence_penalty=1.5, repetition_penalty=1.0
```

{% endcode %}

## Qwen3.6-Inferenz-Tutorials:

Wir werden Dynamic 4-Bit verwenden `UD-Q4_K_XL` GGUF-Varianten für Inferenz-Workloads. Klicken Sie unten, um zu den entsprechenden Modellanleitungen zu gelangen:

<a href="#unsloth-studio-guide" class="button primary">In Unsloth Desktop ausführen</a><a href="#llama.cpp-guide" class="button secondary">In llama.cpp ausführen</a><a href="#mtp-guide" class="button primary">MTP-Leitfaden</a><a href="#nvfp4" class="button secondary">NVFP4-Anleitung</a>

{% hint style="warning" %}
Verwenden Sie NICHT CUDA 13.2, da Sie sonst unverständliche Ausgaben erhalten können. Verwenden Sie unten CUDA 13.2 oder CUDA 13.3.
{% endhint %}

### 🦥 Unsloth-Leitfaden

Qwen3.6 und Qwen3.6 MTP können jetzt ausgeführt werden in [Unsloth Desktop,](/docs/de/desktop.md) unsere neue Open-Source-Oberfläche für lokale KI. Mit Unsloth Studio können Sie Modelle lokal ausführen auf **MacOS, Windows**, Linux und:

{% columns %}
{% column %}

* Suchen, herunterladen, [GGUFs ausführen](/docs/de/neu/studio.md#run-models-locally) und Safetensor-Modelle
* [**Selbstheilendes** Tool-Calling](/docs/de/neu/studio.md#execute-code--heal-tool-calling) + **Websuche**
* [**Code-Ausführung**](/docs/de/neu/studio.md#run-models-locally) (Python, Bash)
* [Automatische Inferenz](https://unsloth.ai/docs/desktop#feature-deep-dive) Parameter-Tuning (Temp, Top-P usw.)
* Schnelle CPU- + GPU-Inferenz über llama.cpp
* [LLMs trainieren](/docs/de/neu/studio.md#no-code-training) 2x schneller mit 70 % weniger VRAM
  {% endcolumn %}

{% column %}

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKoonE97b0H3RioMwVohd%2Fstudio%20new%20ui.gif?alt=media&amp;token=e37f2839-914e-48b8-8c81-2dac3ade9408" alt=""><figcaption></figcaption></figure></div>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}

#### Unsloth installieren

Der einfachste Einstieg ist das Herunterladen der [Unsloth Desktop-App](/docs/de/desktop.md). Funktioniert auf [macOS](/docs/de/loslegen/install/mac.md), [Windows](/docs/de/loslegen/install/windows-installation.md), und [Linux](/docs/de/loslegen/install/linux.md).

<a href="https://unsloth.ai/download" class="button primary" data-icon="down-to-bracket">Unsloth herunterladen</a>

* <i class="fa-apple">:apple:</i> [Download für macOS](https://unsloth.ai/download/mac)
* <i class="fa-windows">:windows:</i> [Download für Windows](https://unsloth.ai/download/windows)
* <i class="fa-linux">:linux:</i> [Download für Linux](https://unsloth.ai/download/linux)

Oder, wenn du lieber manuell installieren möchtest:

**MacOS, Linux, WSL:**

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

**Windows PowerShell:**

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% hint style="success" %}
**Die Installation geht schnell und dauert ca. 20 Sek. bis 1 Min.**
{% endhint %}
{% endstep %}

{% step %}

#### Unsloth starten

**MacOS, Linux, WSL und Windows:**

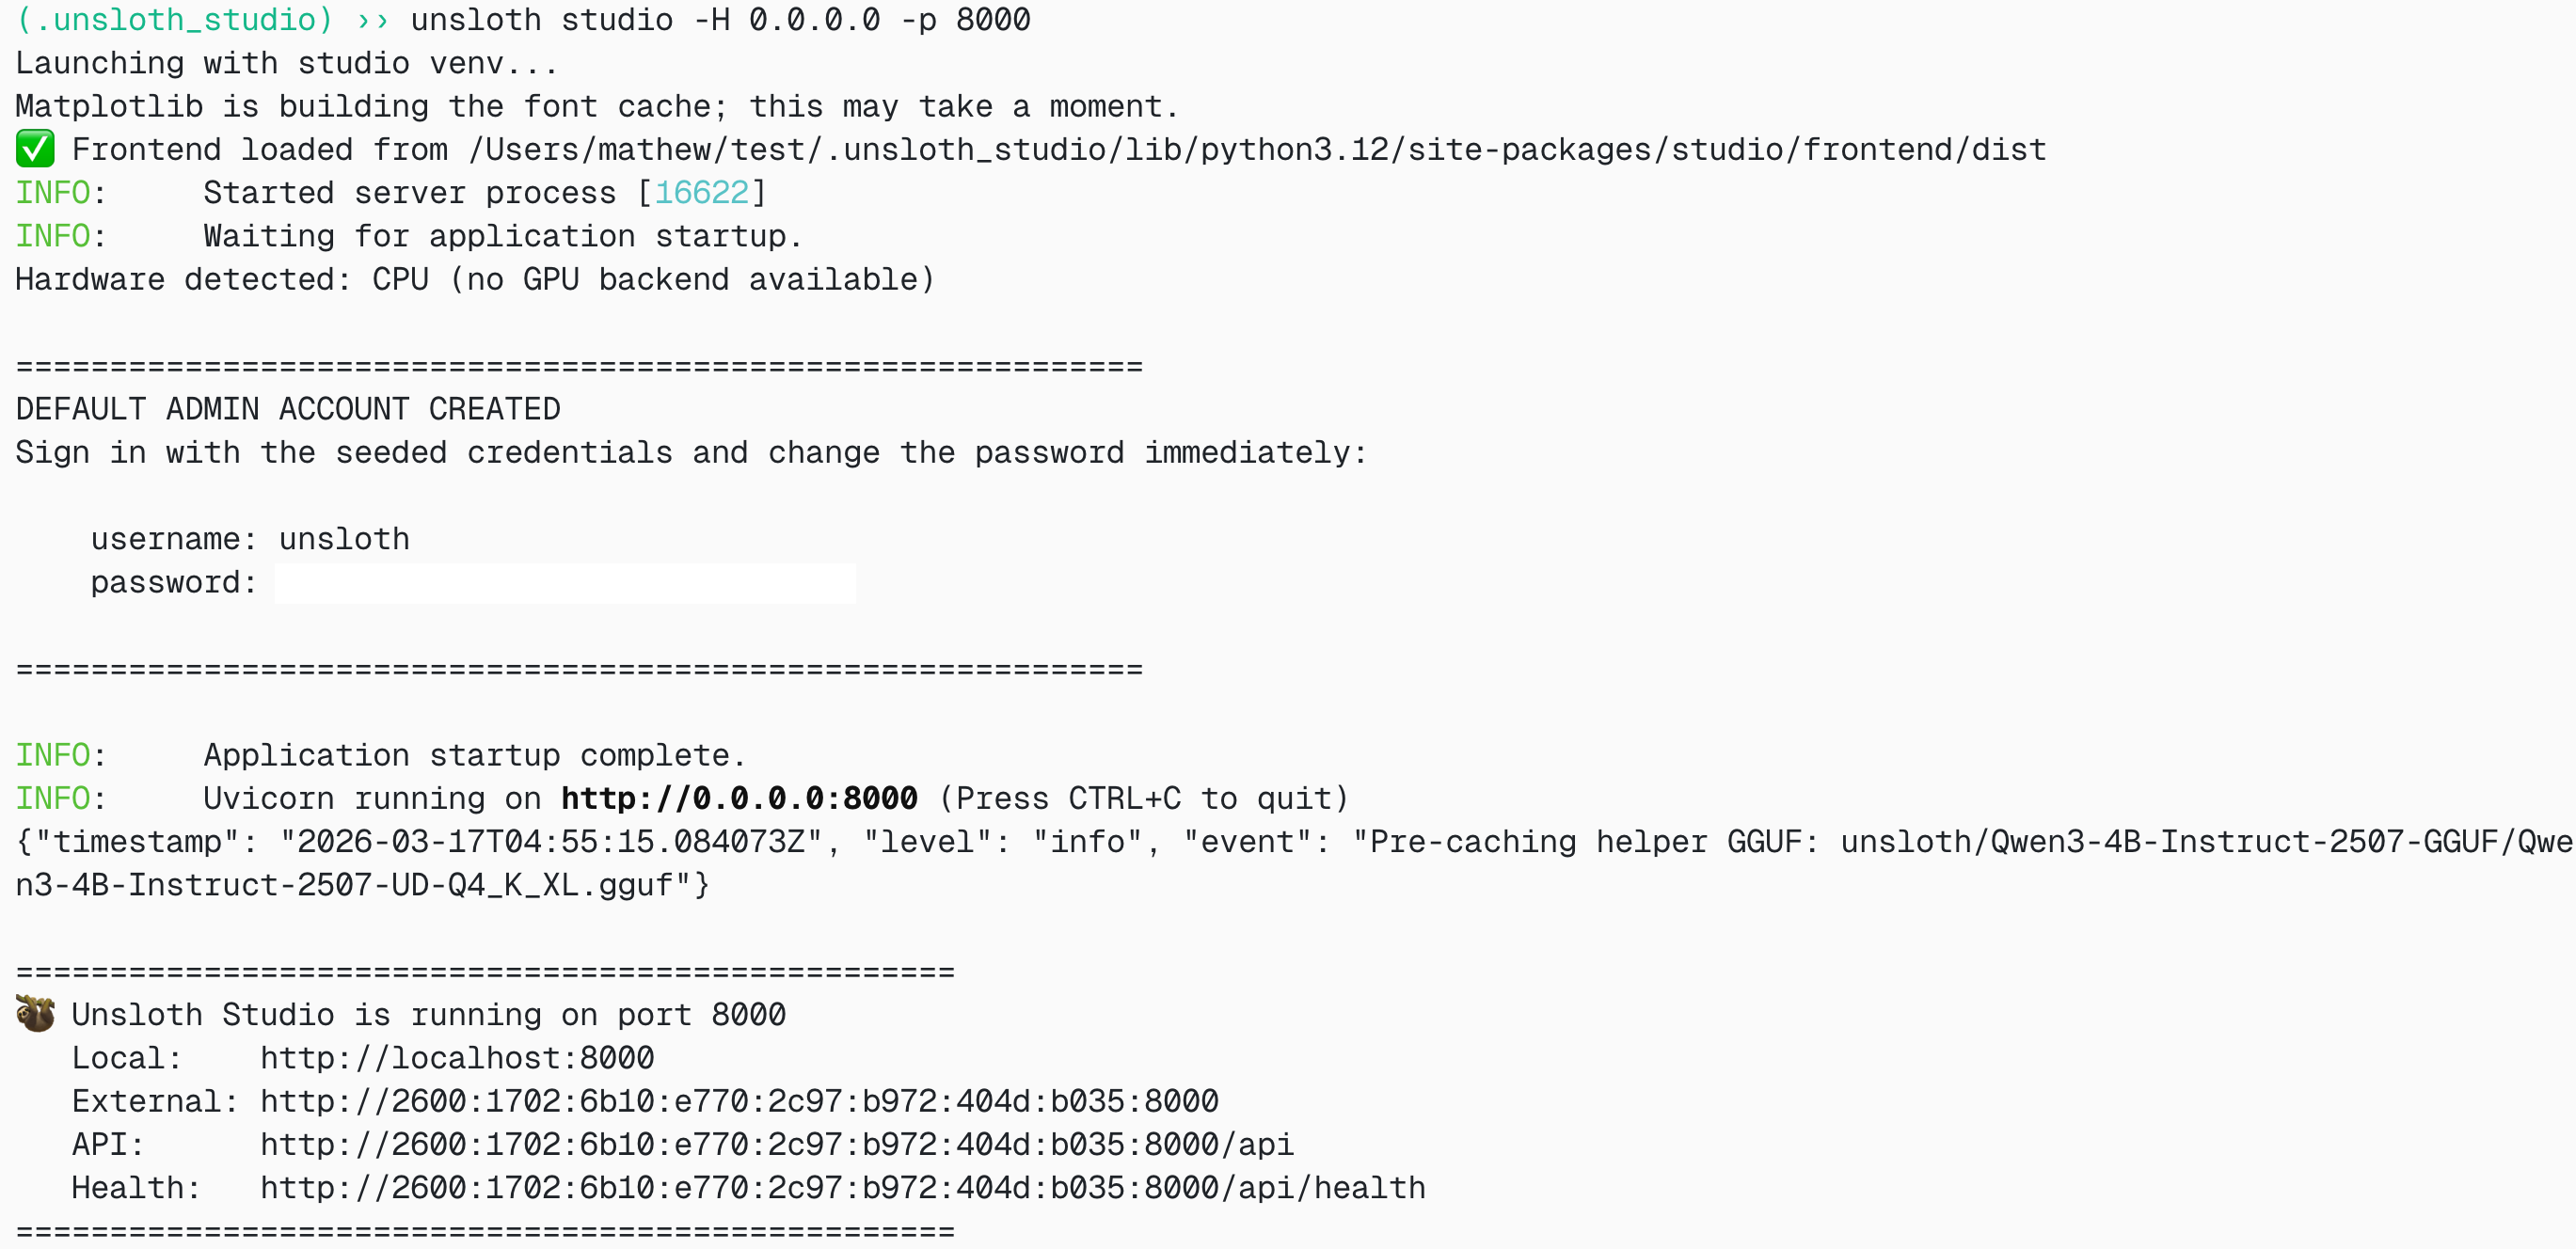
```bash
unsloth studio -H 0.0.0.0 -p 8888
```

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fd1yMMNa65Ccz50Ke0E7r%2FScreenshot%202026-03-17%20at%2012.32.38%E2%80%AFAM.png?alt=media&amp;token=9369cfe7-35b1-4955-b8cb-42f7ecb43780" alt="" width="375"><figcaption></figcaption></figure></div>

Dann öffnen Sie `http://127.0.0.1:8888` (oder Ihre spezifische URL) in Ihrem Browser.

**Unsloth sicher mit HTTPS und Cloudflare starten**

**NEU!** Unsloth bietet jetzt eine sichere Möglichkeit, Unsloth über HTTPS mithilfe eines kostenlosen Cloudflare-Tunnels zu starten. Verwenden Sie das Folgende (funktioniert unter Windows, Mac und Linux):

```bash
unsloth studio --secure
```

{% endstep %}

{% step %}

#### Suchen und laden Sie Qwen3.6 oder Qwen3.6 MTP herunter

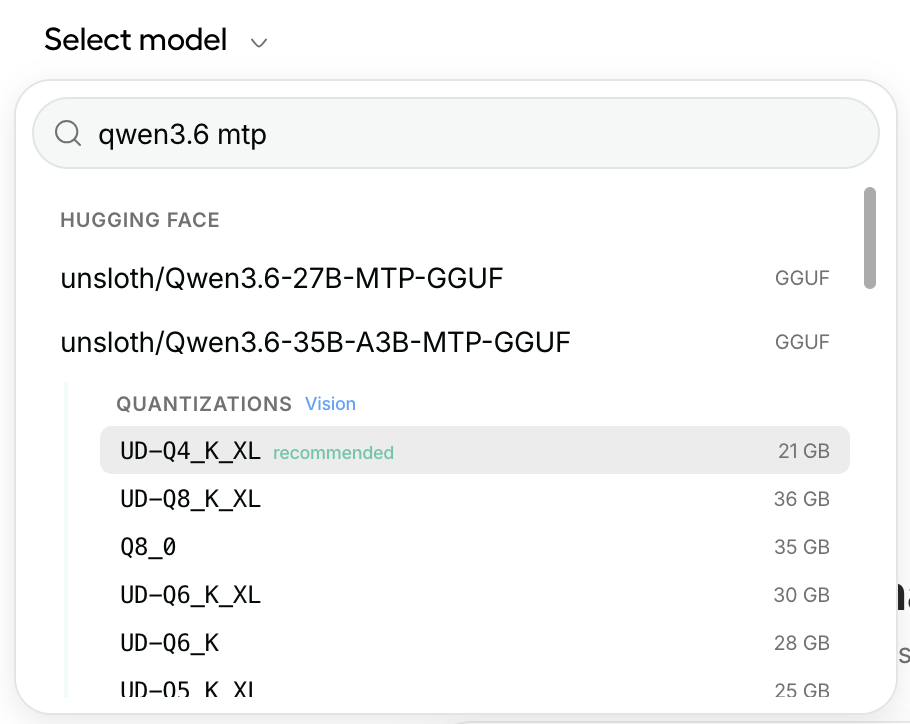
Beim ersten Start müssen Sie ein Passwort erstellen, um Ihr Konto zu sichern, und sich später erneut anmelden. Gehen Sie dann zum [Unsloth Chat](/docs/de/neu/studio/chat.md) Registerkarte und suchen Sie in der Suchleiste nach Qwen3.6 oder Qwen3.6 MTP und laden Sie Ihr gewünschtes Modell und Ihre gewünschte Quantisierung herunter.

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FT6uAnOeF7OU9cuiE8JR5%2FScreenshot%202026-04-16%20at%208.59.33%E2%80%AFAM.png?alt=media&amp;token=6977f7b6-aff7-494b-84b5-ad737125da31" alt="" width="375"><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}

#### Qwen3.6 ausführen

Die Inferenzparameter sollten bei Verwendung von Unsloth Studio automatisch gesetzt werden; Sie können sie jedoch weiterhin manuell ändern. Sie können auch die Kontextlänge, das Chat-Template und andere Einstellungen bearbeiten.

Weitere Informationen finden Sie in unserem [Unsloth Studio Inferenzleitfaden](/docs/de/neu/studio/chat.md). Unten hat das 2-Bit-Qwen3.6-GGUF über 30 Tool-Aufrufe gemacht, 20 Seiten durchsucht und Python-Code ausgeführt:

{% embed url="<https://cdn-uploads.huggingface.co/production/uploads/62ecdc18b72a69615d6bd857/9lqVQm1qDX3elt6Uan5Vm.mp4>" %}
{% endstep %}
{% endstepper %}

### ⚡ MTP-Leitfaden

Das spekulative Decoding mit MTP (Multi Token Prediction) ermöglicht Modellen wie Qwen3.6 **eine etwa 1,4–2,2× schnellere Generierung mit&#x20;**<mark style="background-color:$success;">**ohne Genauigkeitsverlust**</mark>. Dadurch können Qwen3.6 27B und 35B-A3B **>1,4× Beschleunigung** gegenüber der ursprünglichen Baseline erreichen, was besonders für lokale Modelle nützlich ist.

Die Unsloth Qwen3.6 MTP GGUFs sind nicht mehr im experimentellen Modus, und llama.cpp hat die MTP-Unterstützung integriert. Direkt ausführen in [der UI von Unsloth Studio](#unsloth-studio-guide) oder über llama.cpp. **Qwen3.6 27B MTP läuft jetzt mit 160 Tokens/s bei der Generierung und Qwen3.6 35B-A3B mit 240 Tokens/s auf einer RTX 6000 GPU.** Siehe [#mtp-benchmarks](#mtp-benchmarks "mention").

Unsloth Studio setzt automatisch die idealen MTP-Einstellungen, optimiert für Ihre spezifische Hardware (Mac, CPU, GPU usw.) - Sie können sie später dennoch ändern.

{% hint style="info" %}
**MTP verwendet etwas mehr VRAM als Standard-GGUFs**, planen Sie also mit etwa 1 GB zusätzlichem RAM-/VRAM-Spielraum.
{% endhint %}

<a href="#unsloth-studio-mtp-guide" class="button primary">In Unsloth Studio ausführen</a><a href="#llama.cpp-mtp-guide" class="button secondary">In llama.cpp ausführen</a><a href="#nvfp4" class="button secondary">NVFP4 ausführen</a>

| [Qwen3.6-27B-MTP-GGUF](https://huggingface.co/unsloth/Qwen3.6-27B-MTP-GGUF) | [Qwen3.6-35B-A3B-MTP-GGUF](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MTP-GGUF) |
| --------------------------------------------------------------------------- | ----------------------------------------------------------------------------------- |

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FMYn1g7MDeVRAUa6i2oOk%2Fthroughput%20mpt.png?alt=media&amp;token=aff44c0a-3cc3-493e-b6b4-e3279dfb90c1" alt=""><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F4CvUpxr0xdxCR1lTGUbS%2Fmtp%20benchmarks%20landscape.png?alt=media&amp;token=d6579f47-a196-408b-a013-329e09705251" alt=""><figcaption></figcaption></figure></div>

In der Praxis sagt MTP mehrere zukünftige Tokens voraus, und das Hauptmodell überprüft diese Tokens dann parallel. Dadurch verringert sich die Anzahl der während der Generierung benötigten Forward-Pässe und die Ausgabe wird schneller. **Wir haben festgestellt, `--spec-draft-n-max 2` um in den meisten Setups am besten zu funktionieren.** **Gehen Sie jedoch nicht davon aus `2` dass dies optimal ist, da die Leistung von der Hardware abhängt. Probieren Sie Werte von `1` bis `6` und verwenden Sie den Wert, der für Ihr System am schnellsten ist.**

Wir haben außerdem [MTP-GGUFs hochgeladen](https://huggingface.co/unsloth/models?search=mtp) für die [**Qwen3.5**](/docs/de/modelle/qwen3.5.md) **Modellfamilie** einschließlich: 0,8B, 2B, 4B, 9B, 27B, 35B-A3B, 122B-A10B und 397B-A17B. Llama.cpp verbessert die MTP-Leistung kontinuierlich, also erwarten Sie, dass sie mit der Zeit schneller wird!

**Tabelle: MTP-Hardwareanforderungen** (Einheiten = Gesamtspeicher: RAM + VRAM oder einheitlicher Speicher)

<table><thead><tr><th>Qwen3.6</th><th>3-Bit</th><th>4-Bit</th><th width="128">6-Bit</th><th>8-Bit</th><th>BF16</th></tr></thead><tbody><tr><td><strong>27B</strong></td><td>16 GB</td><td>19 GB</td><td>25 GB</td><td>31 GB</td><td>56 GB</td></tr><tr><td><strong>35B-A3B</strong></td><td>18 GB</td><td>24 GB</td><td>31 GB</td><td>39 GB</td><td>71 GB</td></tr></tbody></table>

#### 🦥 Unsloth Studio MTP-Anleitung

Unsloth Studio setzt automatisch die idealen MTP-Einstellungen, optimiert für Ihre spezifische Hardware (Mac, CPU, GPU usw.) - Sie können sie später dennoch ändern.

{% stepper %}
{% step %}

#### Unsloth installieren

In Ihrem Terminal ausführen:

**MacOS, Linux, WSL:**

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

**Windows PowerShell:**

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% endstep %}

{% step %}

#### Unsloth starten

**MacOS, Linux, WSL und Windows:**

```bash
unsloth studio -H 127.0.0.1 -p 8888
```

Dann öffnen Sie `http://127.0.0.1:8888` (oder Ihre spezifische URL) in Ihrem Browser.
{% endstep %}

{% step %}

#### Suchen und laden Sie Qwen3.6 MTP herunter

Beim ersten Start müssen Sie ein Passwort erstellen, um Ihr Konto zu sichern, und sich später erneut anmelden. Gehen Sie dann zum [Unsloth Chat](/docs/de/neu/studio/chat.md) Registerkarte und suchen Sie in der Suchleiste nach Qwen3.6 MTP und laden Sie Ihr gewünschtes Modell und Ihre gewünschte Quantisierung herunter.

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F2zQdtdNf0CRBrnTOXBZa%2FScreenshot%202026-05-16%20at%207.10.39%E2%80%AFPM.png?alt=media&amp;token=d1f2e482-5cb7-4e41-97ed-f2905a81f262" alt="" width="375"><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}

#### Qwen3.6 MTP ausführen

Die Inferenzparameter sollten bei Verwendung von Unsloth Studio automatisch gesetzt werden; Sie können sie jedoch weiterhin manuell ändern. Sie können auch die Kontextlänge, das Chat-Template und andere Einstellungen bearbeiten.

Weitere Informationen finden Sie in unserem [Unsloth Studio Inferenzleitfaden](/docs/de/neu/studio/chat.md). Unten hat das 2-Bit-Qwen3.6-MTP-GGUF 10+ Tool-Aufrufe gemacht, 10 Websites durchsucht und Python-Code ausgeführt:

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsERzR65n4jc1UtuSHozZ%2Fwedefrwfwe.gif?alt=media&amp;token=e303ed9e-0d90-456d-8d57-874a06803903" alt=""><figcaption></figcaption></figure></div>
{% endstep %}
{% endstepper %}

#### 🦙 Llama.cpp MTP-Anleitung

{% stepper %}
{% step %}
Installieren Sie die neueste Version von `llama.cpp` auf [**GitHub hier**](https://github.com/ggml-org/llama.cpp/pull/22673). Du kannst auch die Build-Anweisungen unten befolgen. Ändere `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` , wenn du keine GPU hast oder nur CPU-Inferenz möchtest. **Für Apple-Mac-/Metal-Geräte**, setze `-DGGML_CUDA=OFF`  dann wie gewohnt fort - Metal-Unterstützung ist standardmäßig aktiviert.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
Wenn Sie `llama.cpp` um Modelle direkt zu laden, können Sie Folgendes tun: (:`Q4_K_XL`) ist der Quantisierungstyp. Sie können auch über Hugging Face herunterladen (Punkt 3). Das ist ähnlich wie `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen, `llama.cpp` um an einem bestimmten Speicherort zu speichern. Das Modell hat eine maximale Kontextlänge von 256K.

Folgen Sie einem der Befehle für die spezifischen Modelle:

<a href="#mtp-qwen3.6-27b" class="button primary">27B MTP</a><a href="#mtp-qwen3.6-35b-a3b" class="button primary">35-A3B MTP</a>

#### MTP Qwen3.6-27B:

**Denken-Modus:**

{% hint style="info" %}
Bitte sehen Sie Qwen3.6s neues [Beibehaltenes Denken](#thinking-enable-disable--preserve-thinking).
{% endhint %}

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE=\"unsloth/Qwen3.6-27B-MTP-GGUF\"
./llama.cpp/llama-cli \\
    -hf unsloth/Qwen3.6-27B-MTP-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --top-k 20 \
    --min-p 0.00 \\
    --spec-type draft-mtp --spec-draft-n-max 2
```

Für präzise Programmieraufgaben ändern Sie: `temperature=0.6`

**Modus ohne Denken:**

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE=\"unsloth/Qwen3.6-27B-MTP-GGUF\"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-27B-MTP-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \\
    --top-k 20 \
    --presence-penalty 1.5 \\
    --min-p 0.00 \\
    --spec-type draft-mtp --spec-draft-n-max 2 \\
    --chat-template-kwargs '{"enable_thinking":false}'
```

#### MTP Qwen3.6-35B-A3B:

**Denken-Modus:**

{% hint style="info" %}
Bitte sehen Sie Qwen3.6s neues [Beibehaltenes Denken](#thinking-enable-disable--preserve-thinking).
{% endhint %}

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-MTP-GGUF"
./llama.cpp/llama-cli \\
    -hf unsloth/Qwen3.6-35B-A3B-MTP-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --top-k 20 \
    --min-p 0.00 \\
    --spec-type draft-mtp --spec-draft-n-max 2
```

Für präzise Programmieraufgaben ändern Sie: `temperature=0.6`

**Modus ohne Denken:**

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-MTP-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-35B-A3B-MTP-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \\
    --top-k 20 \
    --presence-penalty 1.5 \\
    --min-p 0.00 \\
    --spec-type draft-mtp --spec-draft-n-max 2 \\
    --chat-template-kwargs '{"enable_thinking":false}'
```

{% endstep %}

{% step %}
Sie können das Modell auch manuell über den folgenden Code herunterladen (nach der Installation von `pip install huggingface_hub`). Sie können Q4\_K\_M oder andere quantisierte Versionen wie `UD-Q4_K_XL` . Wir empfehlen, mindestens eine 2-Bit-Dynamic-Quantisierung zu verwenden `UD-Q2_K_XL` , um Größe und Genauigkeit auszubalancieren. Wenn Downloads hängen bleiben, siehe: [Hugging Face Hub, XET-Debugging](/docs/de/grundlagen/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/Qwen3.6-35B-A3B-MTP-GGUF \\
    --local-dir unsloth/Qwen3.6-35B-A3B-MTP-GGUF \\
    --include "*mmproj-F16*" \\
    --include "*UD-Q4_K_XL*" # Verwenden Sie "*UD-Q2_K_XL*" für dynamisches 2-Bit
```

{% endstep %}

{% step %}
Dann führen Sie das Modell im Gesprächsmodus aus:

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \\
    --model unsloth/Qwen3.6-35B-A3B-MTP-GGUF/Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \\
    --mmproj unsloth/Qwen3.6-35B-A3B-MTP-GGUF/mmproj-F16.gguf \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --min-p 0.00 \\
    --top-k 20 \
    --spec-type draft-mtp --spec-draft-n-max 2
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 🍎 Dynamische MLX-Quants

Wir haben auch dynamische Qwen3.6 4-Bit- und 8-Bit-Quants für macOS-Geräte hochgeladen! Unser MLX-Quantisierungsalgorithmus entwickelt sich noch weiter, und wir verbessern ihn aktiv überall dort, wo Verbesserungen möglich sind.

Sie können alle MLX-Modelle ausführen in [Unsloth Studio](#unsloth-studio-guide)!

**Qwen3.6-27B MLX:**

| [3-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-3bit) | [4-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-4bit) | [MXFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-MXFP4) | [NVFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-NVFP4) | [6-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-6bit) | [8-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-MLX-8bit) |
| --------------------------------------------------------------- | --------------------------------------------------------------- | ---------------------------------------------------------------- | ---------------------------------------------------------------- | --------------------------------------------------------------- | ------------------------------------------------------------ |

**Qwen3.6-35B-A3B MLX:**

| [3-Bit](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-UD-MLX-3bit) | [4-Bit](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-UD-MLX-4bit) | [8-Bit](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MLX-8bit) |
| ------------------------------------------------------------------- | ------------------------------------------------------------------- | ---------------------------------------------------------------- |

Um sie auszuprobieren, verwenden Sie:

{% code overflow="wrap" %}

```bash
curl -fsSL https://raw.githubusercontent.com/unslothai/unsloth/refs/heads/main/scripts/install_qwen3_6_mlx.sh | sh
source ~/.unsloth/unsloth_qwen3_6_mlx/bin/activate
python -m mlx_vlm.chat --model unsloth/Qwen3.6-27B-UD-MLX-4bit
```

{% endcode %}

Unten finden Sie die KL-Divergenz-(KLD)- und Perplexity-(PPL)-Werte für Qwen3.6-27B (niedriger ist besser):

| Modell                                                           | Mittlere KLD | Median-KLD | PPL   | P90 KLD | P99.9 KLD | Größe   |
| ---------------------------------------------------------------- | ------------ | ---------- | ----- | ------- | --------- | ------- |
| [8-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-MLX-8bit)     | 0.0028       | 0.0003     | 4.812 | 0.0019  | 0.192     | 34.7 GB |
| [6-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-6bit)  | 0.0037       | 0.0007     | 4.809 | 0.0032  | 0.343     | 30.5 GB |
| [4-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-4bit)  | 0.0227       | 0.0053     | 4.821 | 0.0293  | 2.339     | 26.2 GB |
| [NVFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-NVFP4) | 0.0325       | 0.0087     | 4.843 | 0.0466  | 3.693     | 26.2 GB |
| [MXFP4](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-MXFP4) | 0.0479       | 0.0153     | 4.902 | 0.0769  | 4.035     | 25.6 GB |
| [3-Bit](https://huggingface.co/unsloth/Qwen3.6-27B-UD-MLX-3bit)  | 0.0734       | 0.0223     | 4.976 | 0.1261  | 5.529     | 24.1 GB |

### ⚡️NVFP4

**10. Juli 2026:** Wir veröffentlichen neue [dynamische NVFP4-Qwen3.6-Quants](/docs/de/grundlagen/dynamic-3.0-ggufs/nvfp4.md) die etwa \~ laufen**2,5x schneller** als andere NVFP4-Quants, bei **besserer Leistung** und vergleichbaren Dateigrößen. Führe Qwen3.6-27B NVFP4 aus **2,5x schneller** auf **24 GB VRAM** und Qwen3.6-35B-A3B **1,7x schneller** auf **32 GB VRAM**. Wir haben außerdem **FP8-KV-Cache-Kalibrierung** für 2x längere Kontextlängen hinzugefügt! NVFP4 erfordert NVIDIA-Blackwell-GPUs wie RTX 50X, DGX Spark (siehe [#dgx-spark-with-nvfp4-quants](#dgx-spark-with-nvfp4-quants "mention")), B200-, B300-GPUs. Für ältere GPUs funktionieren unsere GGUFs gut!

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F8zM7cg0Xgo2pAlop1iPW%2F01_qwen36_combined_throughput.png?alt=media&amp;token=23131a96-4c41-42d7-aa16-5bfb21bb44a3" alt=""><figcaption></figcaption></figure>

Alle Benchmarks verwenden 1× B200 mit 128 gleichzeitigen Ausführungen. Höhere Parallelität kann 35B auf 17.561 Tokens/s steigern. Wir veröffentlichen außerdem zwei 35B-A3B-NVFP4-Versionen:

* [Qwen3.6-35B-A3B-NVFP4-Fast](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4-Fast) das ein vollständiger W4A4-Quant ist - 1,79x schneller
* [Qwen3.6-35B-A3B-NVFP4](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4) das etwas größer, aber genauer und 1,56x schneller ist

Für Genauigkeits-Benchmarks haben wir MMLU-Pro, AIME 2025 und GPQA für FP8, BF16, NVIDIAs NVFP4 und unsere NVFP4s durchgeführt - wir zeigen, dass unsere schnelleren Quants bei allen ähnlich abschneiden:

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFhOUUUlRBj3dafGnmvhK%2F03_qwen36_combined_accuracy(7).png?alt=media&amp;token=9178447f-d5ae-4489-9bdc-73b2b7b1631b" alt=""><figcaption></figcaption></figure>

<table><thead><tr><th width="372.5999755859375">Qwen3.6-35B-A3B</th><th>Qwen3.6-27B</th></tr></thead><tbody><tr><td><a href="https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4">Qwen3.6-35B-A3B-NVFP4</a> (1,56x schneller)</td><td><a href="https://huggingface.co/unsloth/Qwen3.6-27B-NVFP4">Qwen3.6-27B-NVFP4</a> (2,5x schneller)</td></tr><tr><td><a href="https://huggingface.co/unsloth/Qwen3.6-35B-A3B-NVFP4-Fast">Qwen3.6-35B-A3B-NVFP4-Fast</a> (1,79x schneller)</td><td></td></tr></tbody></table>

**MTP-Tensoren sind für zusätzliche Geschwindigkeitssteigerungen ebenfalls direkt in die Quants integriert.** Die Genauigkeitsgewinne stammen aus Verbesserungen an Qwen3.6s Chat-Template und der Datensatzkalibrierung. Wir verwenden unsere früheren Chat-Template-Updates, um die Konsistenz beim Coden und bei Tool-Aufrufen zu verbessern und gleichzeitig Schleifen sowie andere gemeldete Probleme zu reduzieren. Unsere Kalibrierung verwendet eine Mischung aus unserem für Coding, Tool-Calling und Chat optimierten Datensatz zusammen mit UltraChat.

Beim Decode-Speed (Tokens pro Person) ist unsere Version für 27B 1,03x schneller und für 35B 1,17x bzw. 1,22x schneller.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FR3X2O3iOBhjMS1ekX7zO%2F03_qwen36_combined_decode.png?alt=media&amp;token=a8b34056-7178-4e0d-851b-9467fa0ba2f6" alt=""><figcaption></figcaption></figure>

### NVFP4-Benchmarks

NVFP4 führt 4-Bit-Gewichte und Matrixmultiplikationen direkt auf Blackwell Tensor Cores aus. Unsere Qwen3.6 NVFP4-Quants verwenden W4A4, sodass sie tatsächlich die FP4-Tensor-Cores nutzen und daher schneller dekodieren als NVIDIAs Varianten, die W4A16 verwenden. Wir quantisieren außerdem Schichten dynamisch, um die Genauigkeit zu erhalten, und wir haben MMLU-Pro, AIME 2025 und GPQA für alle Quants durchgeführt, einschließlich des Vergleichs mit FP8 und BF16.

**Genauigkeits-Benchmarks für Qwen3.6-27B NVFP4**

| Anbieter | MMLU-Pro |  GPQA | AIME 2025 |
| -------- | -------: | ----: | --------: |
| Unsloth  |    86.25 | 86.34 |     93.12 |
| NVIDIA   |    85.96 | 86.87 |     93.12 |
| FP8      |    86.11 | 86.87 |     93.75 |
| BF16     |    85.96 | 88.13 |     93.33 |

**Genauigkeits-Benchmarks für Qwen3.6-35B-A3B NVFP4**

| Anbieter         | MMLU-Pro |  GPQA | AIME 2025 |
| ---------------- | -------: | ----: | --------: |
| Unsloth          |    85.85 | 86.74 |     92.29 |
| **Unsloth Fast** |    85.58 | 87.75 |     91.67 |
| NVIDIA           |    85.60 | 87.12 |     91.88 |
| FP8              |    85.75 | 86.74 |     93.12 |
| BF16             |    85.75 | 86.36 |     92.50 |

Wir haben auch die Ausgabelänge aller Benchmarks überprüft, und sie sind vergleichbar, also denken die neuen NVFP4-Quants nicht länger nach, was den Zweck der Quantisierung zunichtemacht! (Also: wenn es 2x schneller ist, aber 2x mehr nachdenkt, dann ist das nutzlos)

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FjG1C3y6GVWvnorRfmnIF%2Fqwen36_combined_output_length_reordered_estimated_no_footnote.png?alt=media&amp;token=2aa2d784-c082-476e-895a-4bea77385956" alt=""><figcaption></figcaption></figure>

### Marlin vs. FlashInfer vs. CUTLASS vs. Cute-DSL

Wir haben außerdem festgestellt, dass Marlin-Kernel W4A4 nicht gut unterstützen - wenn man es aktiviert, führt das zu einer 2,5x Leistungsverschlechterung - also verwende CUTLASS, Flashinfer-TRTLLM oder Cute-DSL (in vLLM automatisch aktiviert)! Wenn du außerdem einen DGX Spark hast, siehe [#dgx-spark-serving](#dgx-spark-serving "mention") du musst verwenden `--moe-backend flashinfer_b12x` sonst erhältst du eine 2,5x langsamere Inferenz.

**Also setze kein Backend - vLLM wählt automatisch das beste aus.**

| Modell          | Schema | Backend                    | Decode-Tok/s | Durchsatz-Tok/s |
| --------------- | ------ | -------------------------- | ------------ | --------------- |
| Nvidia 27B      | W4A16  | Marlin (automatisch)       | 115.6        | 2,403           |
| Unsloth 27B     | W4A4   | Marlin                     | 105.6        | 2,127           |
| Unsloth 27B     | W4A4   | CUTLASS                    | 113.5        | 6,681           |
| Unsloth 27B     | W4A4   | flashinfer\_trtllm         | 112.6        | 6,158           |
| Unsloth 27B     | W4A4   | **Cute-DSL (automatisch)** | 125.9        | **6,863**       |
| Nvidia 35B-A3B  | W4A4   | Marlin (automatisch)       | 240.8        | 8,721           |
| Unsloth 35B-A3B | W4A4   | Marlin                     | 215.8        | 8,619           |
| Unsloth 35B-A3B | W4A4   | CUTLASS                    | 158.3        | 11,017          |
| Unsloth 35B-A3B | W4A4   | **Cute-DSL (automatisch)** | 295.2        | **15,636**      |

#### **vLLM:**

Um NVFP4-Quants auszuführen, siehe unten die Befehle zum Ausführen von Qwen3.6-27B in [vLLM](/docs/de/grundlagen/inference-and-deployment/vllm-guide.md) und [SGLang](/docs/de/grundlagen/inference-and-deployment/sglang-guide.md) (du kannst den Modellnamen ändern in `Qwen3.6-35-A3B-NVFP4`). Wählen Sie außerdem KEIN MoE-Backend aus – überlassen Sie die Auswahl vLLM – zum Beispiel ist Marlin 2,5× langsamer! Siehe [#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl](#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl "mention")Wenn du einen DGX Spark hast, siehe [#dgx-spark-serving](#dgx-spark-serving "mention") du musst verwenden `--moe-backend flashinfer_b12x` sonst erhältst du eine deutlich langsamere Inferenz.

Um vLLM in einer separaten venv zu installieren:

{% code overflow="wrap" expandable="true" %}

```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \
    --torch-backend=auto
```

{% endcode %}

Dann, um die 35B-Fast-Variante bereitzustellen:

```shell
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
```

Ändere `unsloth/Qwen3.6-35B-A3B-NVFP4-Fast` zu den NVFP4-Quant-Namen!

Um MTP / spekulatives Dekodieren zu aktivieren (schnelleres Dekodieren, aber etwas geringerer Durchsatz), verwende:

```bash
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
    --speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
```

Falls Torchcodec-Probleme auftreten, führe zuerst das Folgende aus und starte dann vllm neu.

{% code overflow="wrap" expandable="true" %}

```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```

{% endcode %}

### **DGX Spark mit NVFP4-Quants**

Um sicherzustellen, dass DGX Spark die richtigen Kernel hat (sonst erhältst du **2x LANGSAMERE Inferenz**), prüfe zuerst:

{% code overflow="wrap" expandable="true" %}

```bash
python -c "
import torch; from vllm.utils.flashinfer import has_flashinfer_b12x_gemm as g, has_flashinfer_b12x_moe as m
cap = torch.cuda.get_device_capability(); print('cap', cap, '| b12x gemm', g(), '| b12x moe', m()); assert cap[0] == 12 and g() and m(), 'b12x unavailable: serving would degrade to marlin W4A16'"
```

{% endcode %}

was KEINEN Fehler auslösen sollte - falls doch, aktualisiere bitte vllm oder installiere es neu über:

{% code overflow="wrap" expandable="true" %}

```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \
    --torch-backend=auto
```

{% endcode %}

Dann, um in vLLM für DGX Spark bereitzustellen:

{% code overflow="wrap" expandable="true" %}

```shellscript
export CUTE_DSL_ARCH=sm_121a
vllm serve unsloth/Qwen3.6-35B-A3B-NVFP4-Fast --moe-backend flashinfer_b12x
```

{% endcode %}

Falls Torchcodec-Probleme auftreten, führe zuerst das Folgende aus und starte dann vllm neu.

{% code overflow="wrap" expandable="true" %}

```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```

{% endcode %}

#### **SGLang:**

```bash
python -m sglang.launch_server --model-path unsloth/Qwen3.6-27B-NVFP4 --speculative-algorithm NEXTN \\
     --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
```

### 🦙 llama.cpp-Anleitung

Für diesen Leitfaden verwenden wir Dynamic 4-Bit, was auf einem 24-GB-RAM-/Mac-Gerät hervorragend für schnelle Inferenz auf [llama.cpp](https://llama.cpphttps/github.com/ggml-org/llama.cpp). Da das Modell bei voller F16-Präzision nur etwa 72 GB groß ist, müssen wir uns um die Leistung nicht allzu sehr sorgen. [Sehen Sie sich unsere GGUF-Sammlung an](https://huggingface.co/collections/unsloth/qwen36).

<a href="#qwen3.6-27b" class="button primary">27B</a><a href="#qwen3.6-35b-a3b" class="button primary">35-A3B</a>

{% stepper %}
{% step %}
Holen Sie sich die neueste `llama.cpp` **auf** [**GitHub hier**](https://github.com/ggml-org/llama.cpp). Du kannst auch die Build-Anweisungen unten befolgen. Ändere `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` , wenn du keine GPU hast oder nur CPU-Inferenz möchtest. **Für Apple-Mac-/Metal-Geräte**, setze `-DGGML_CUDA=OFF`  dann wie gewohnt fort - Metal-Unterstützung ist standardmäßig aktiviert.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endstep %}

{% step %}
Wenn Sie `llama.cpp` um Modelle direkt zu laden, können Sie Folgendes tun: (:`Q4_K_XL`) ist der Quantisierungstyp. Sie können auch über Hugging Face herunterladen (Punkt 3). Das ist ähnlich wie `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen, `llama.cpp` um an einem bestimmten Speicherort zu speichern. Das Modell hat eine maximale Kontextlänge von 256K.

Folgen Sie einem der Befehle für die spezifischen Modelle:

<a href="#qwen3.6-27b" class="button primary">27B</a><a href="#qwen3.6-35b-a3b" class="button primary">35-A3B</a>

#### Qwen3.6-27B:

**Denken-Modus:**

{% hint style="info" %}
Bitte sehen Sie Qwen3.6s neues [Beibehaltenes Denken](#thinking-enable-disable--preserve-thinking).
{% endhint %}

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-GGUF"
./llama.cpp/llama-cli \\
    -hf unsloth/Qwen3.6-27B-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --top-k 20 \
    --min-p 0.00
```

Für präzise Programmieraufgaben ändern Sie: `temperature=0.6`

**Modus ohne Denken:**

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-27B-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \\
    --top-k 20 \
    --presence-penalty 1.5 \\
    --min-p 0.00 \\
    --chat-template-kwargs '{"enable_thinking":false}'
```

#### Qwen3.6-35B-A3B:

**Denken-Modus:**

{% hint style="info" %}
Bitte sehen Sie Qwen3.6s neues [Beibehaltenes Denken](#thinking-enable-disable--preserve-thinking).
{% endhint %}

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-GGUF"
./llama.cpp/llama-cli \\
    -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --top-k 20 \
    --min-p 0.00
```

Für präzise Programmieraufgaben ändern Sie: `temperature=0.6`

**Modus ohne Denken:**

Allgemeine Aufgaben:

```bash
export LLAMA_CACHE="unsloth/Qwen3.6-35B-A3B-GGUF"
./llama.cpp/llama-server \\
    -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL \\
    --temp 0.7 \\
    --top-p 0.8 \\
    --top-k 20 \
    --presence-penalty 1.5 \\
    --min-p 0.00 \\
    --chat-template-kwargs '{"enable_thinking":false}'
```

{% endstep %}

{% step %}
Sie können das Modell auch manuell über den folgenden Code herunterladen (nach der Installation von `pip install huggingface_hub`). Sie können Q4\_K\_M oder andere quantisierte Versionen wie `UD-Q4_K_XL` . Wir empfehlen, mindestens eine 2-Bit-Dynamic-Quantisierung zu verwenden `UD-Q2_K_XL` , um Größe und Genauigkeit auszubalancieren. Wenn Downloads hängen bleiben, siehe: [Hugging Face Hub, XET-Debugging](/docs/de/grundlagen/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/Qwen3.6-35B-A3B-GGUF \\
    --local-dir unsloth/Qwen3.6-35B-A3B-GGUF \\
    --include "*mmproj-F16*" \\
    --include "*UD-Q4_K_XL*" # Verwenden Sie "*UD-Q2_K_XL*" für dynamisches 2-Bit
```

{% endstep %}

{% step %}
Dann führen Sie das Modell im Gesprächsmodus aus:

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \\
    --model unsloth/Qwen3.6-35B-A3B-GGUF/Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \\
    --mmproj unsloth/Qwen3.6-35B-A3B-GGUF/mmproj-F16.gguf \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --min-p 0.00 \\
    --top-k 20
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 💡 Denken: Aktivieren/Deaktivieren + Denken beibehalten

Qwen3.6 hat außerdem **Denken beibehalten** was die Denkspur aus der vorherigen Unterhaltung beibehält. Dadurch erhöht sich die Anzahl der verwendeten Tokens, kann aber die Genauigkeit in fortgesetzten Unterhaltungen erhöhen. Unsloth Studio hat für Qwen3.6 Umschalter für 'Think' und beibehaltenes Denken:

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKoonE97b0H3RioMwVohd%2Fstudio%20new%20ui.gif?alt=media&amp;token=e37f2839-914e-48b8-8c81-2dac3ade9408" alt="" width="563"><figcaption><p>Unsloth Studio hat standardmäßig den Think-Umschalter und einen neuen <a href="#preserved-thinking">Beibehaltenes Denken</a> Umschalter</p></figcaption></figure></div>

Um zu aktivieren **Denken beibehalten** verwenden Sie in llama.cpp (ändern Sie zu 'true' oder 'false') '`preserve_thinking`' statt '`enable_thinking`' oder '`disable_thinking`'.

{% code expandable="true" %}

```bash
--chat-template-kwargs '{"preserve_thinking":true}'
```

{% endcode %}

Für normales Denken können Sie das Denken in llama.cpp aktivieren/deaktivieren, indem Sie die folgenden Befehle befolgen. Verwenden Sie '`true`' und '`false`' austauschbar verwenden.

<table data-full-width="false"><thead><tr><th width="197.76666259765625">llama-server OS:</th><th>Denken aktivieren</th><th>Denken deaktivieren</th></tr></thead><tbody><tr><td>Linux, macOS, WSL:</td><td><pre data-overflow="wrap"><code>--chat-template-kwargs '{"enable_thinking":true}'
</code></pre></td><td><pre data-overflow="wrap"><code>--chat-template-kwargs '{"enable_thinking":false}'
</code></pre></td></tr><tr><td>Windows / PowerShell:</td><td><pre data-overflow="wrap"><code>--chat-template-kwargs "{\"enable_thinking\":true}"
</code></pre></td><td><pre data-overflow="wrap"><code>--chat-template-kwargs "{\"enable_thinking\":false}"
</code></pre></td></tr></tbody></table>

Als Beispiel für Qwen3.6-35B-A3B, um das Denken beizubehalten (Standard ist aktiviert):

```bash
./llama.cpp/llama-server \\
    --model unsloth/Qwen3.6-35B-A3B-GGUF/Qwen3.6-35B-A3B-BF16.gguf \\
    --alias "unsloth/Qwen3.6-35B-A3B-GGUF" \\
    --temp 0.6 \
    --top-p 0.95 \\
    --top-k 20 \
    --min-p 0.00 \\
    --port 8001 \\
    --chat-template-kwargs '{"preserve_thinking":true}'
```

Und dann in Python:

```python
from openai import OpenAI
import json
openai_client = OpenAI(
    base_url = "http://127.0.0.1:8001/v1",
    api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
    model = "unsloth/Qwen3.6-35B-A3B-GGUF",
    messages = [{"role": "user", "content": "Wie viel ist 2+2?"},],
)
print(completion.choices[0].message.content)
print(completion.choices[0].message.reasoning_content)
```

### 👨‍💻 OpenAI Codex & Claude Code <a href="#claude-codex" id="claude-codex"></a>

Um das Modell für lokale agentische Coding-Workloads auszuführen, kannst du [unserer Anleitung folgen](#claude-codex). Verwende `llama-server` das wir gerade eingerichtet haben, und setze den Modellnamen auf die genaue ID, die es bei `GET /v1/models` (die `--alias` oben meldet, z. B. `unsloth/Qwen3.6-35B-A3B-GGUF`). Befolgen Sie die richtigen Qwen3.6-Parameter und Nutzungsanweisungen.

{% columns %}
{% column %}
{% content-ref url="/pages/d12c953ceacbd6c3e44f3aa911056928e0488f5b" %}
[Claude Code](/docs/de/grundlagen/api/claude-code.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
{% content-ref url="/pages/1813c928d883d651dff92062bc0da6e96d06e50a" %}
[OpenAI Codex](/docs/de/grundlagen/api/codex.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

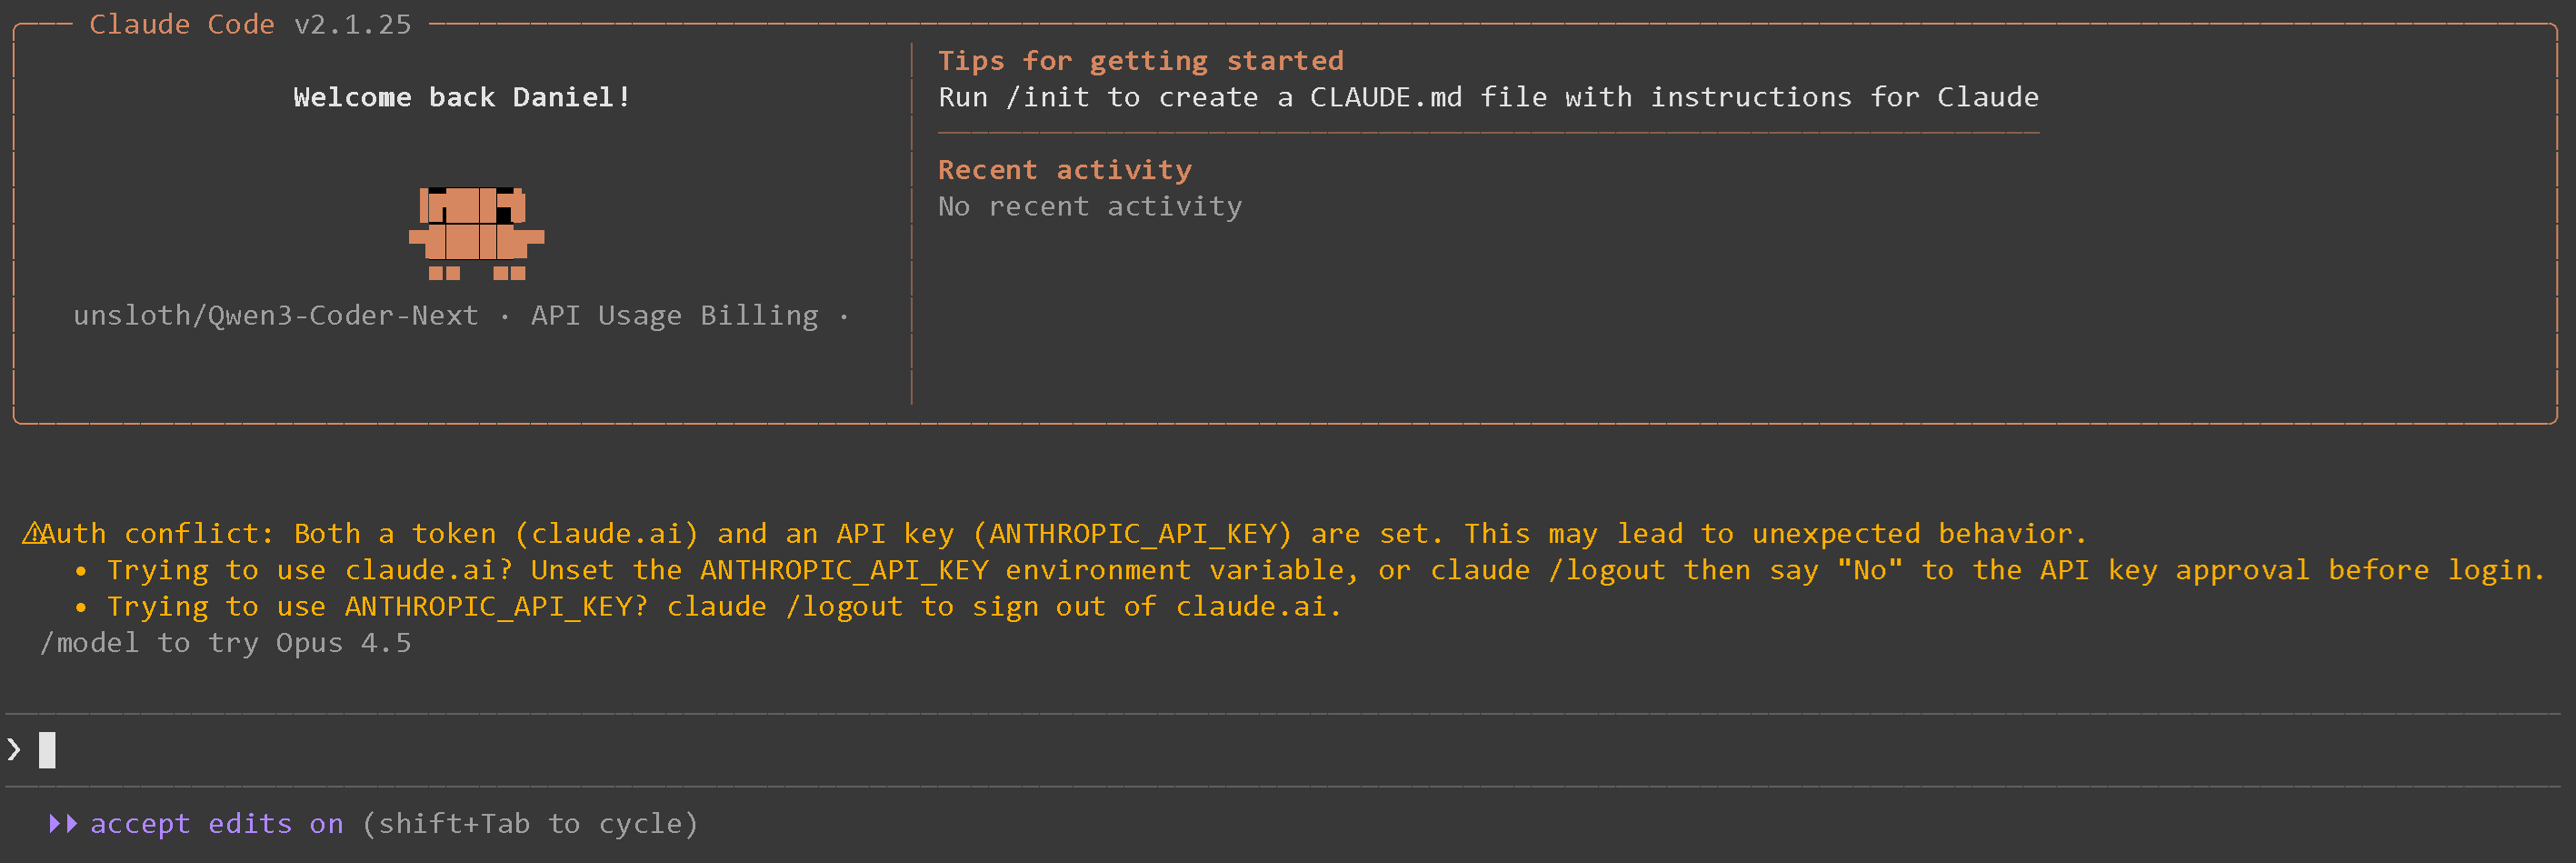
Nachdem du zum Beispiel die Anweisungen für Claude Code befolgt hast, wirst du sehen:

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fup2DMSMPjNR8BM9pgR0v%2Fimage.png?alt=media&amp;token=152e9ee0-2491-4379-af18-8fca0789b19d" alt="" width="563"><figcaption></figcaption></figure></div>

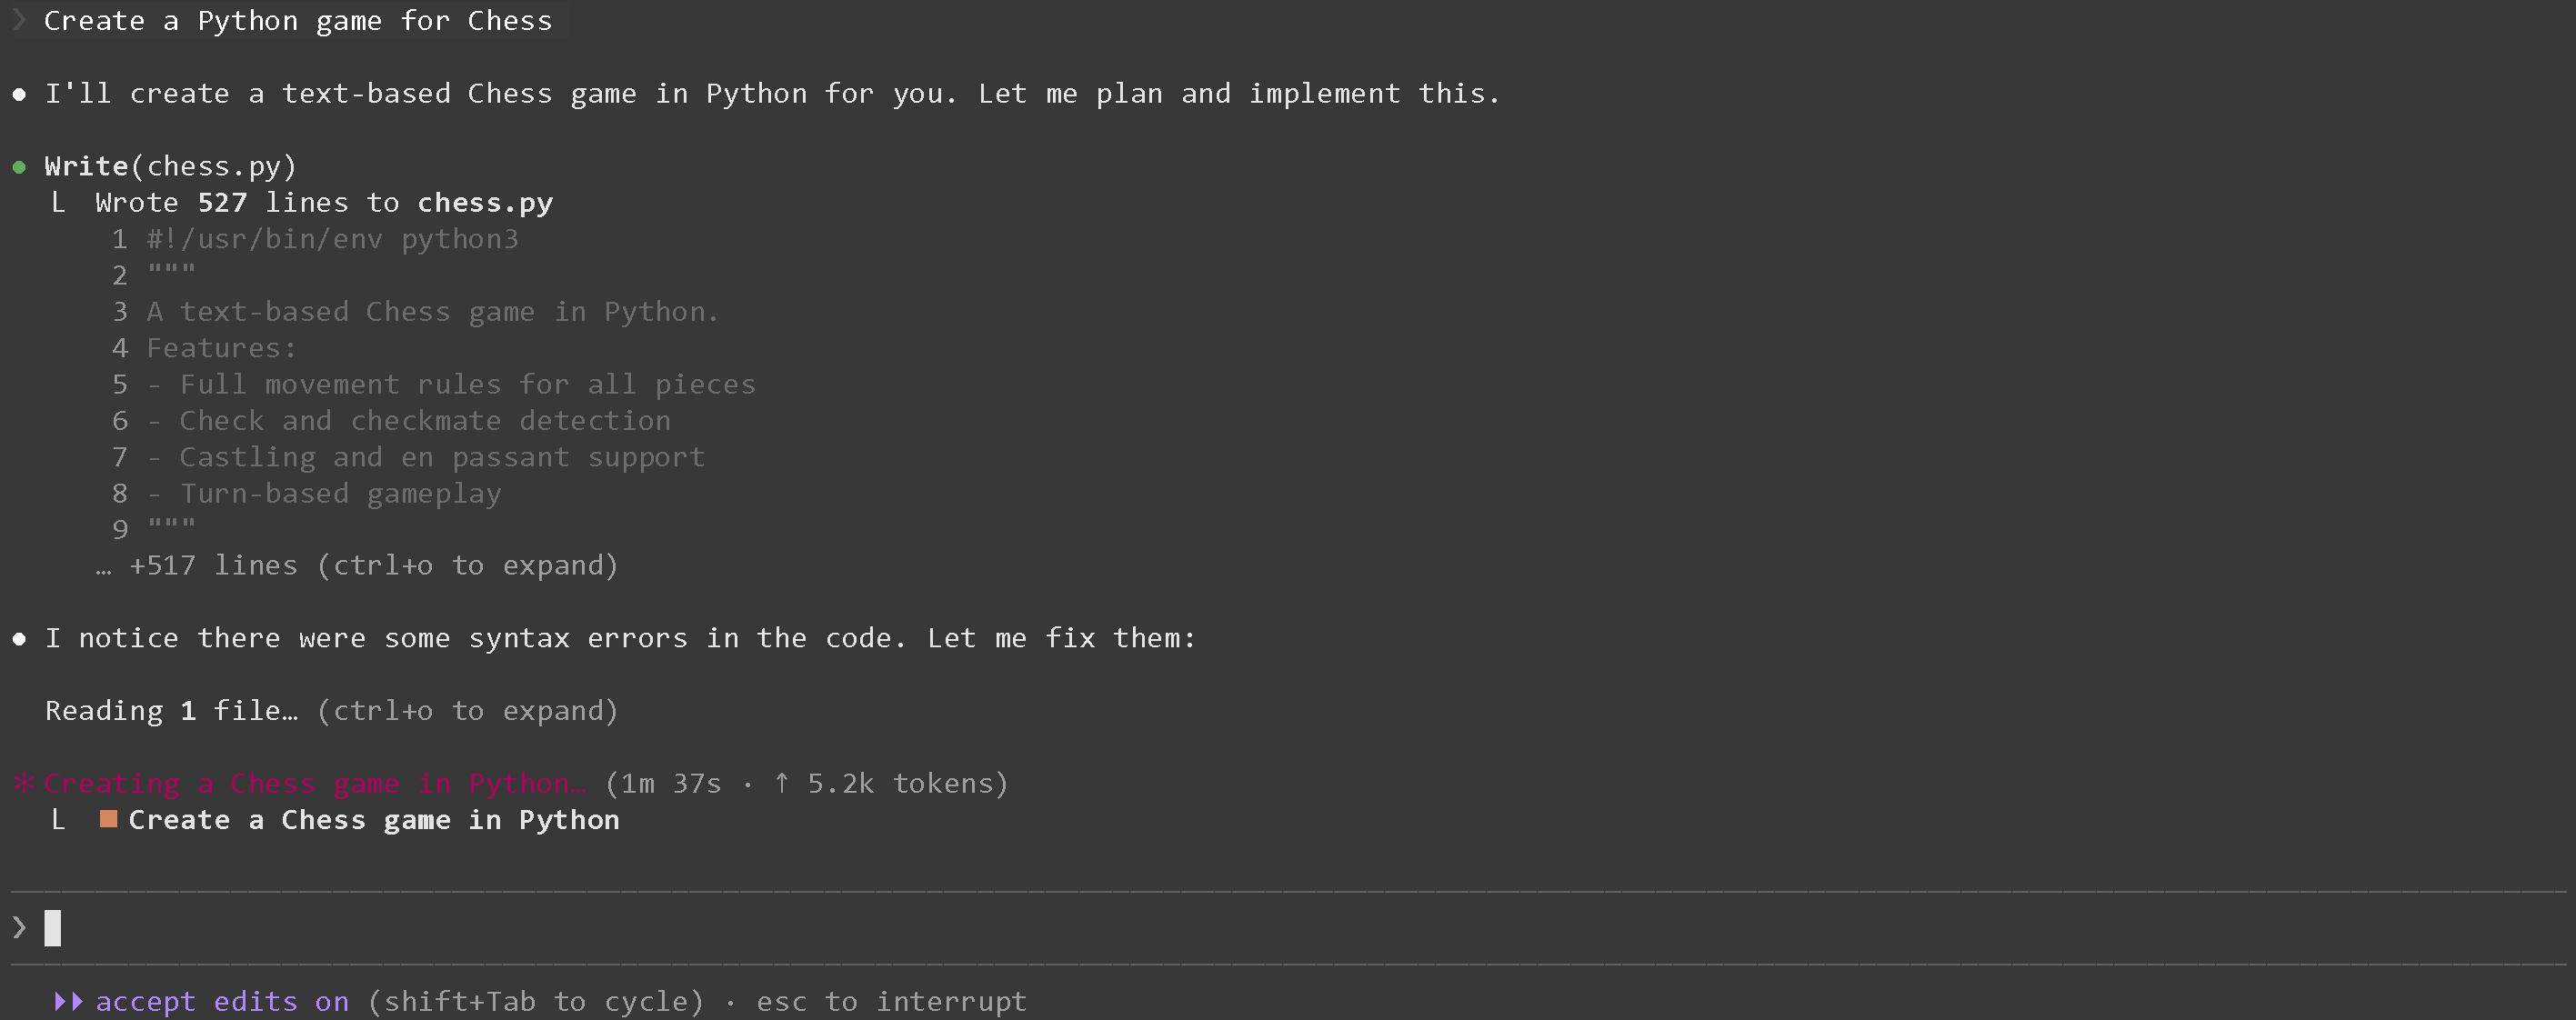
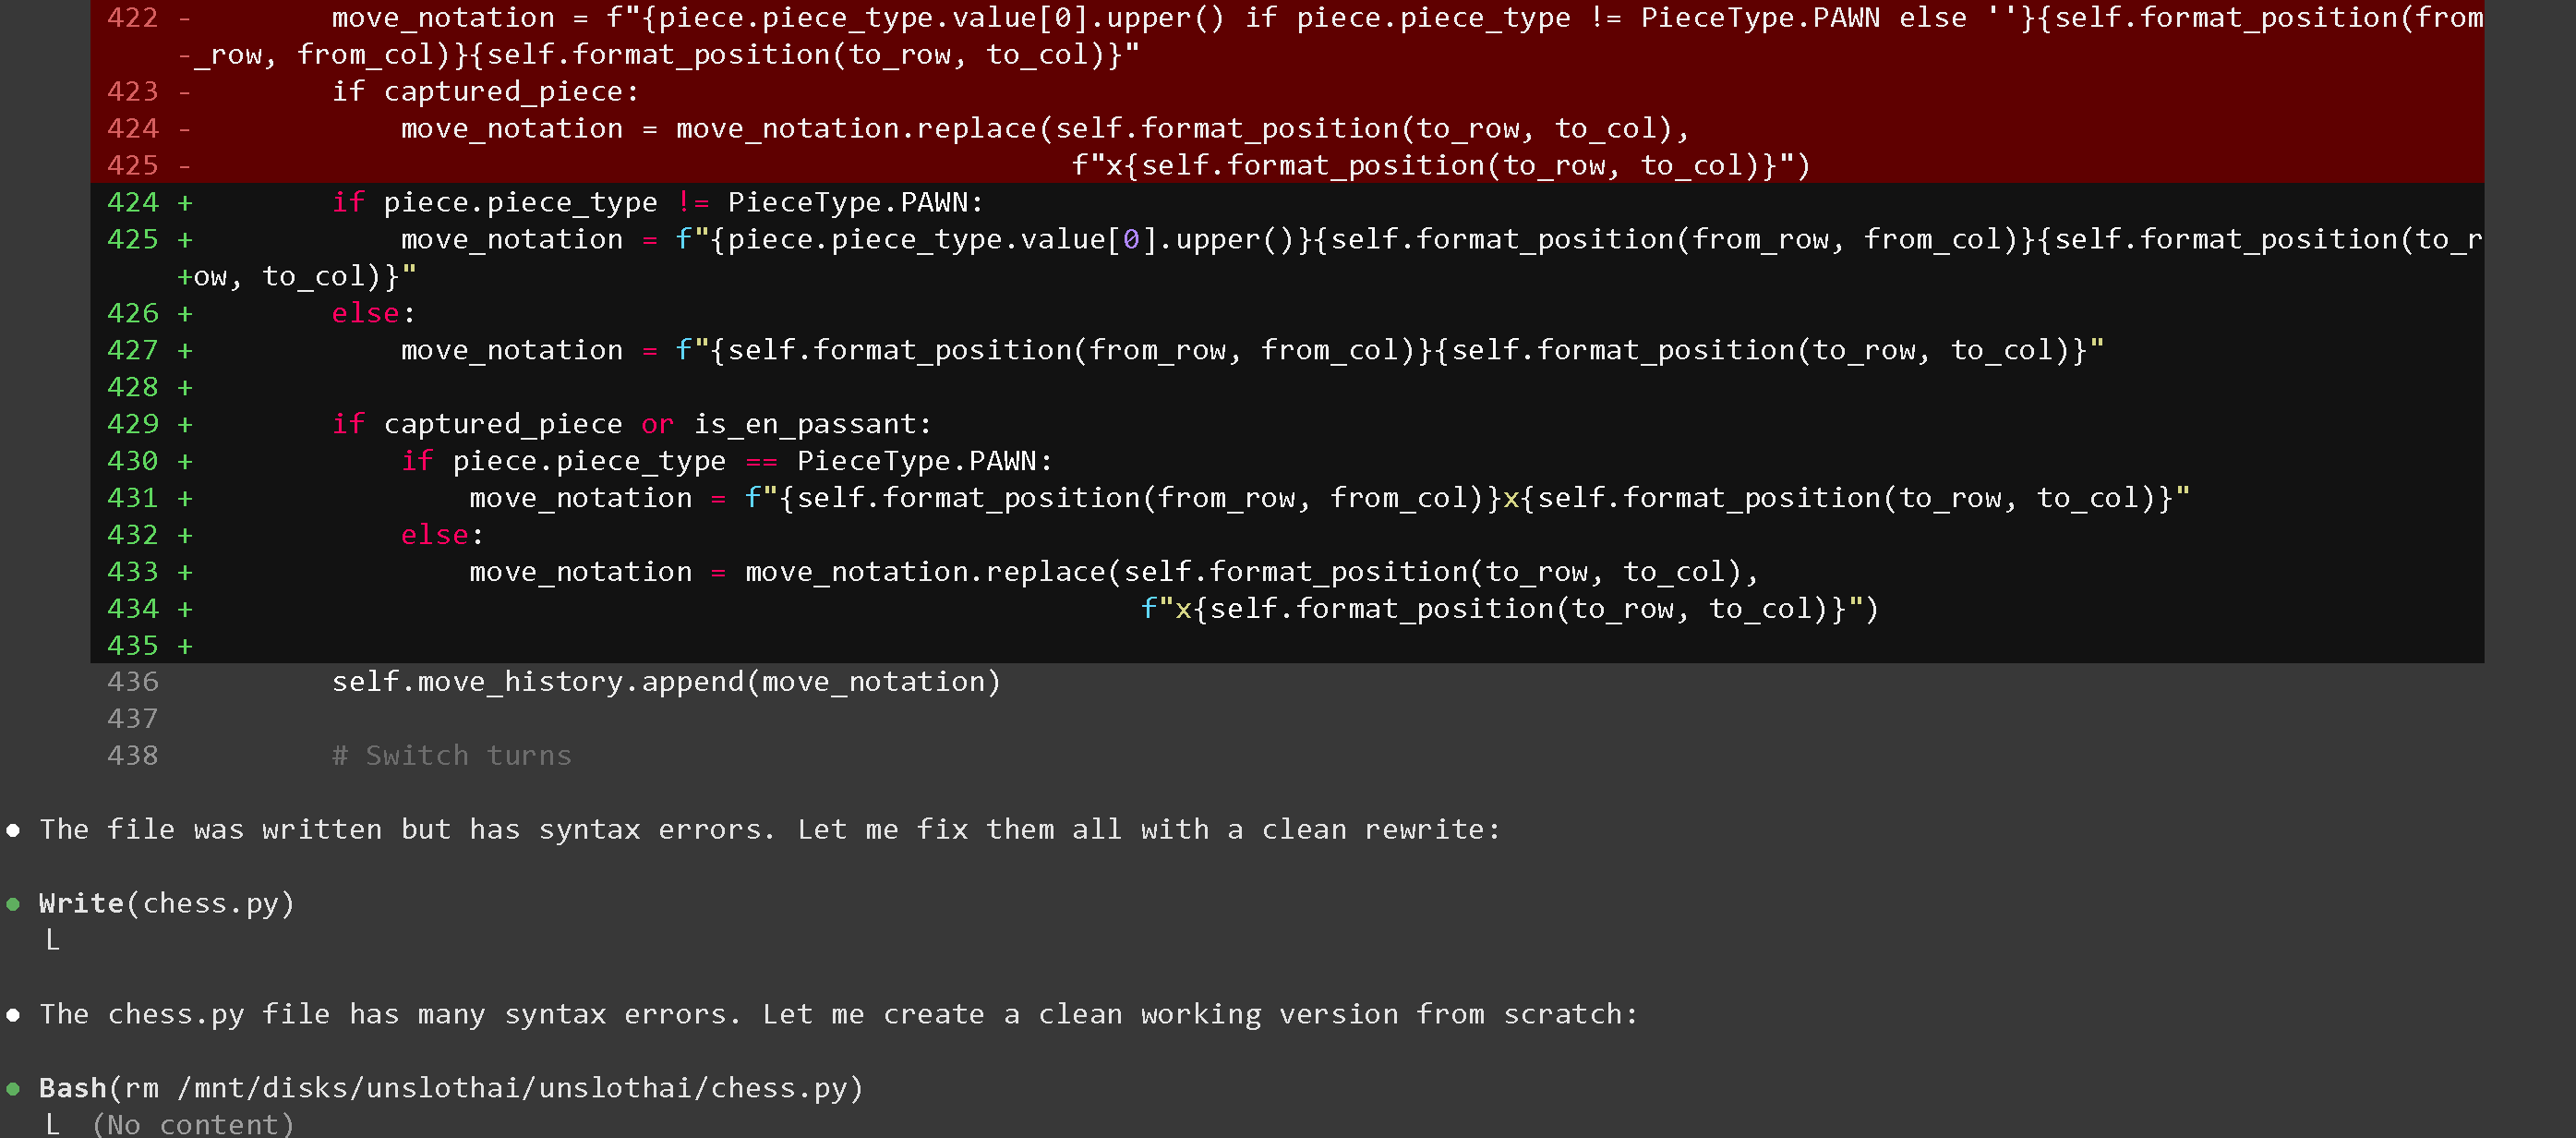
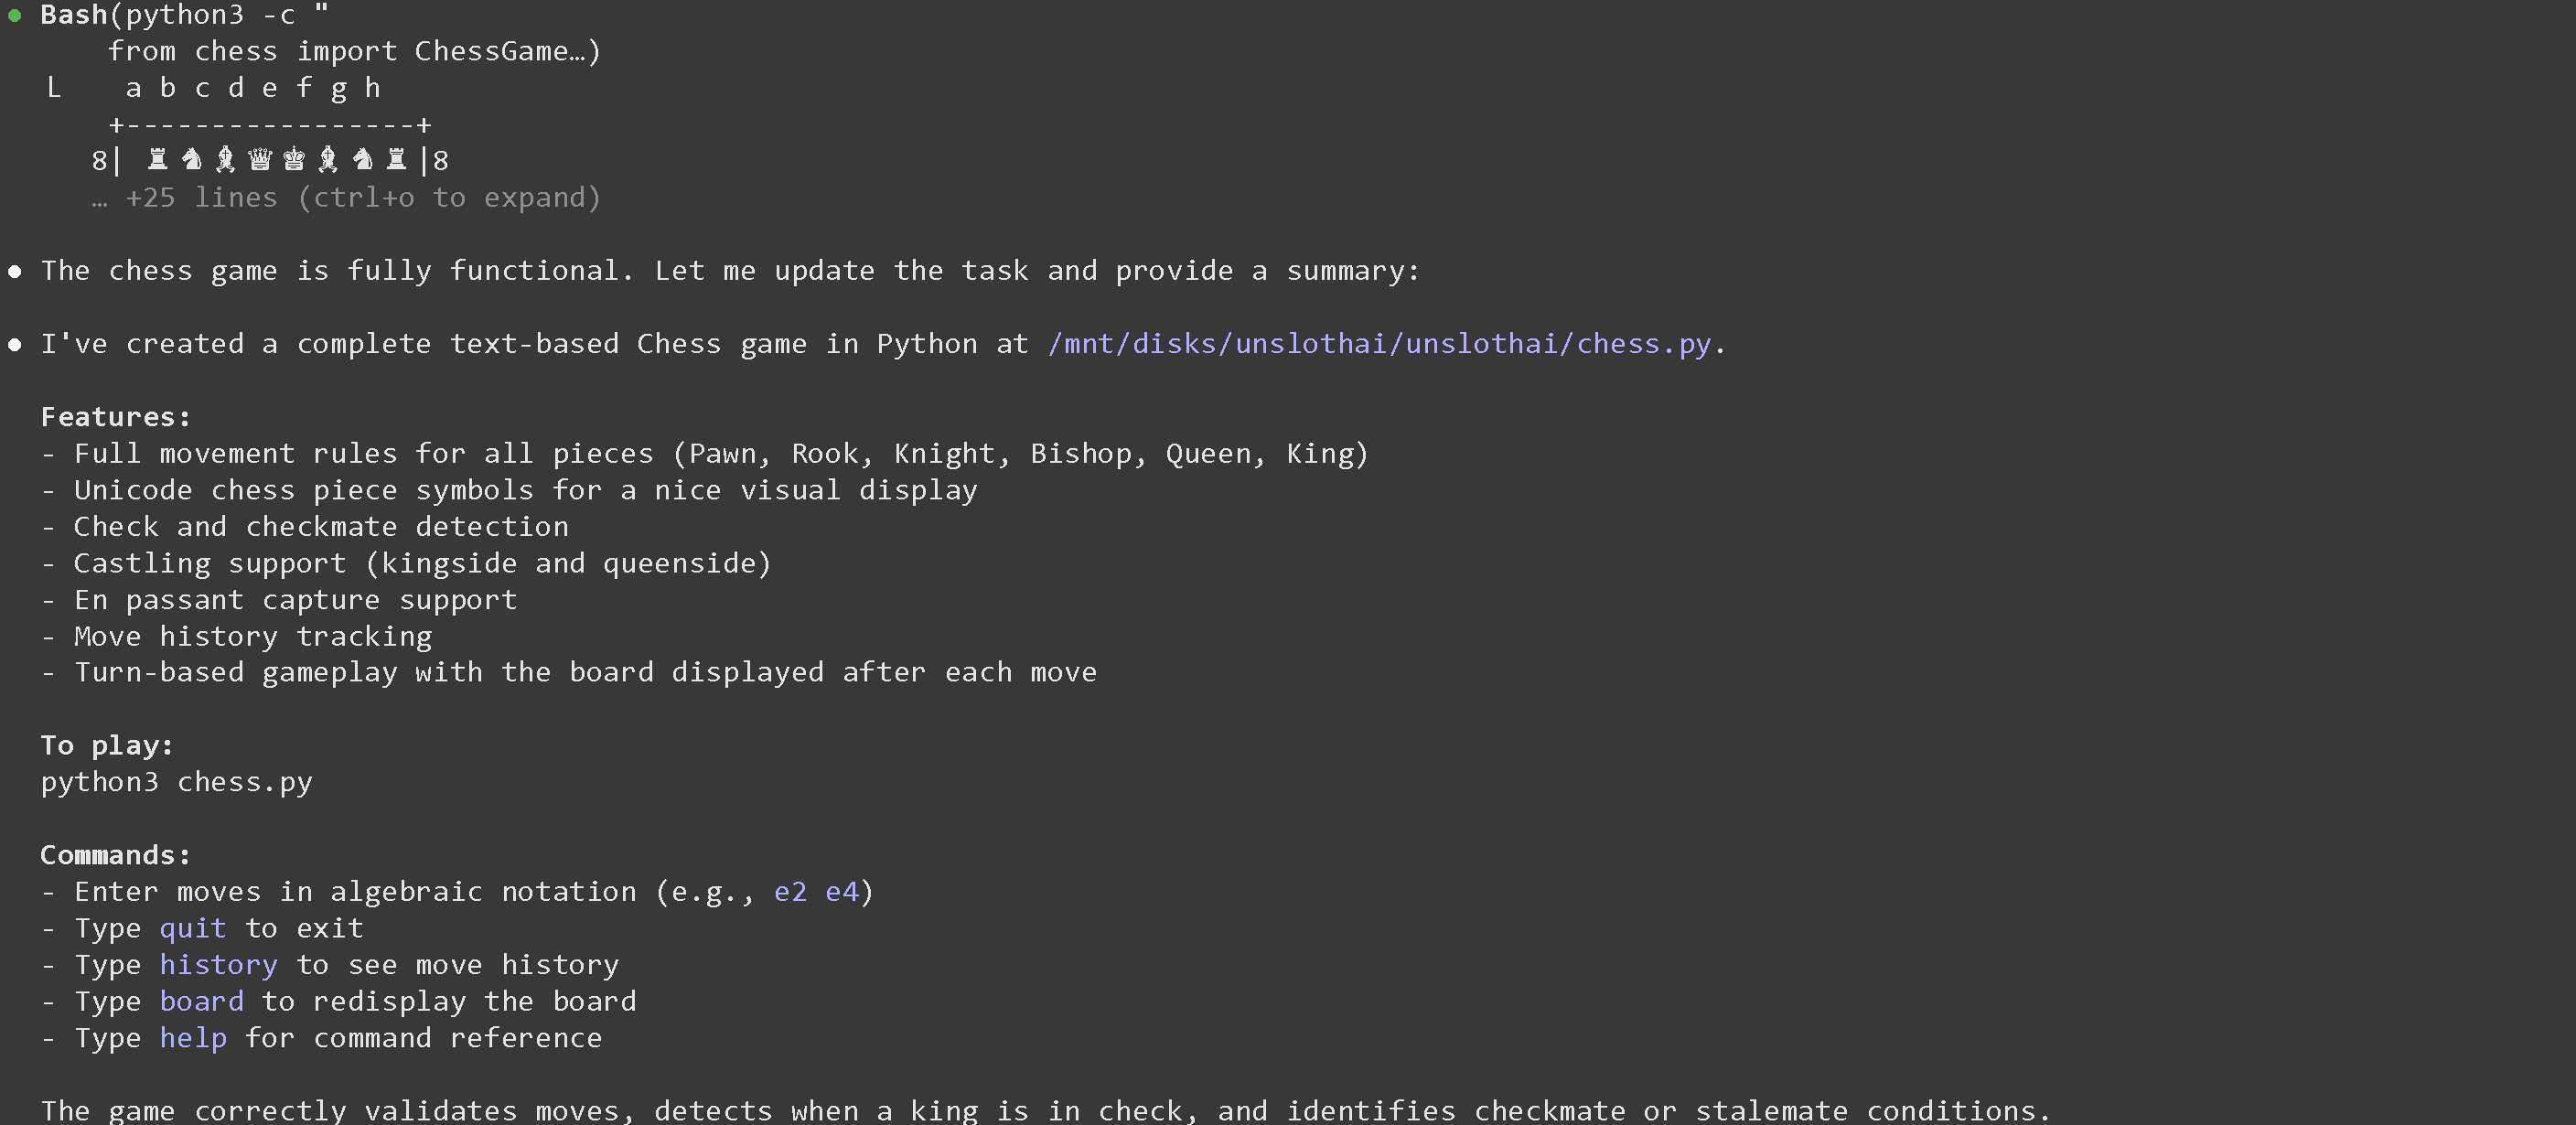
Dann können wir etwa fragen `Erstelle ein Python-Spiel für Schach` :

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F9TfMAoKSdMpb8OHKNnHH%2Fimage.png?alt=media&amp;token=771df3aa-91ab-4c1e-8676-1830058001ca" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWP3lI5mQW2EHB79qqgDz%2Fimage.png?alt=media&amp;token=55cf3189-e100-419c-a615-024b45948284" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fn8DZddDODQZGCP8giKYY%2Fimage.png?alt=media&amp;token=996c8cb9-d199-4045-90f0-408690e02667" alt="" width="563"><figcaption></figcaption></figure></div>

## 📊 Benchmarks

### Unsloth GGUF-Benchmarks

Wir haben Mean-KL-Divergenz-Benchmarks für Qwen3.6-35-A3B-GGUFs über verschiedene Anbieter hinweg durchgeführt, um Ihnen bei der Auswahl der besten Quant zu helfen.

* KL-Divergenz bringt fast alle Unsloth-GGUFs auf die SOTA-Pareto-Frontier
* KLD zeigt, wie gut ein quantisiertes Modell der ursprünglichen BF16-Ausgabeverteilung entspricht und damit die erhaltene Genauigkeit anzeigt.
* Damit ist Unsloth in 21 von 22 Größen der leistungsstärkste
* Nur Q6\_K wurde für mehr dynamische Schichten aktualisiert, und wir haben einen neuen `UD-IQ4_NL_XL` Quant

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHq98A18pHA2ePwlInrFG%2Fqwen36_mean_q6k_corrected_arrow_pareto_fixed.png?alt=media&amp;token=a5190c8a-4d04-4d4d-be94-dd15214e6687" alt=""><figcaption><p>35B-A3B - KLD-Benchmarks (niedriger ist besser)</p></figcaption></figure></div>

### MTP-Benchmarks

Wir haben die neuen Quants benchmarked, die wir für 27B- und 35B-MoE erstellt haben. Im Allgemeinen werden dichte Modelle mit MTP viel stärker beschleunigt (1,4–2×) als MoE-Modelle (1,15–1,25×).

Damit kann Qwen3.6 27B jetzt mit UD-Q2\_K\_XL 140 Tokens/s generieren und Qwen3.6 35B-A3B 220 Tokens/s generieren! Einige der Durchsatzwerte sind verrauscht, ziehen Sie also nicht den Schluss, dass manche Quants langsamer sind als andere.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7TXuBDYfDH3BlQEoSkNf%2FQwen36_mtp_spec_throughput_side_by_side.png?alt=media&amp;token=655a6e99-de95-4aa3-9371-abf05ccd7e3e" alt=""><figcaption></figcaption></figure>

Beim durchschnittlichen Speedup sehen wir 1,4× für dichte Modelle bei draft tokens = 2 und für MoE etwa 1,15 bis 1,2×.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7arbIuA74e9Tbv7ISRcJ%2FQwen36_mtp_spec_speedup_side_by_side_black_solid_average.png?alt=media&amp;token=92bd8705-3842-4aef-90e7-0e61b9d50fba" alt=""><figcaption></figcaption></figure>

Wir empfehlen nicht mehr als 2 Draft-Tokens, da die Akzeptanzrate mit 4 Draft-Tokens drastisch von 83 % auf 50 % sinkt und die Forward-Pässe für MTP weniger vorteilhaft werden.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F0n6KhVbrWqhwBbSUj0JJ%2Foutput(34).png?alt=media&amp;token=aa6adf45-f3d6-4541-bab0-8f9697c0e66c" alt=""><figcaption></figcaption></figure>

### Offizielle Qwen-Benchmarks

#### Qwen3.6-27B

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FlvrSCq6GKFGADGSOTE9W%2Fqwen3.6_27b_score.png?alt=media&amp;token=6f1abf24-6a15-4988-a305-acd5638aaf0d" alt=""><figcaption></figcaption></figure></div>

#### Qwen3.6-35B-A3B

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F25aKI2tJR2PNfGfwnbZi%2Fqwen3.6_35b_a3b_score(2).png?alt=media&amp;token=f296d01d-311d-413e-8c62-122728e33008" alt=""><figcaption></figcaption></figure></div>

Diese Ergebnisse machen den Kompromiss einfach: Verwenden Sie Dynamic GGUFs für das beste Verhältnis von Speicher und Qualität, MTP, wenn Sie schnellere Generierung wünschen, und NVFP4 auf Blackwell-GPUs für maximalen Durchsatz. Wenn Sie den einfachsten Weg wollen, führen Sie das Modell in [Unsloth Studio](#unsloth-studio-guide) und behalten Sie die empfohlenen Standardwerte bei.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/modelle/tutorials/qwen3.6.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.