> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/minimax-m25.md).

# MiniMax-M2.5: Leitfaden zum Ausführen

Führe MiniMax-M2.5 lokal auf deinem eigenen Gerät aus!

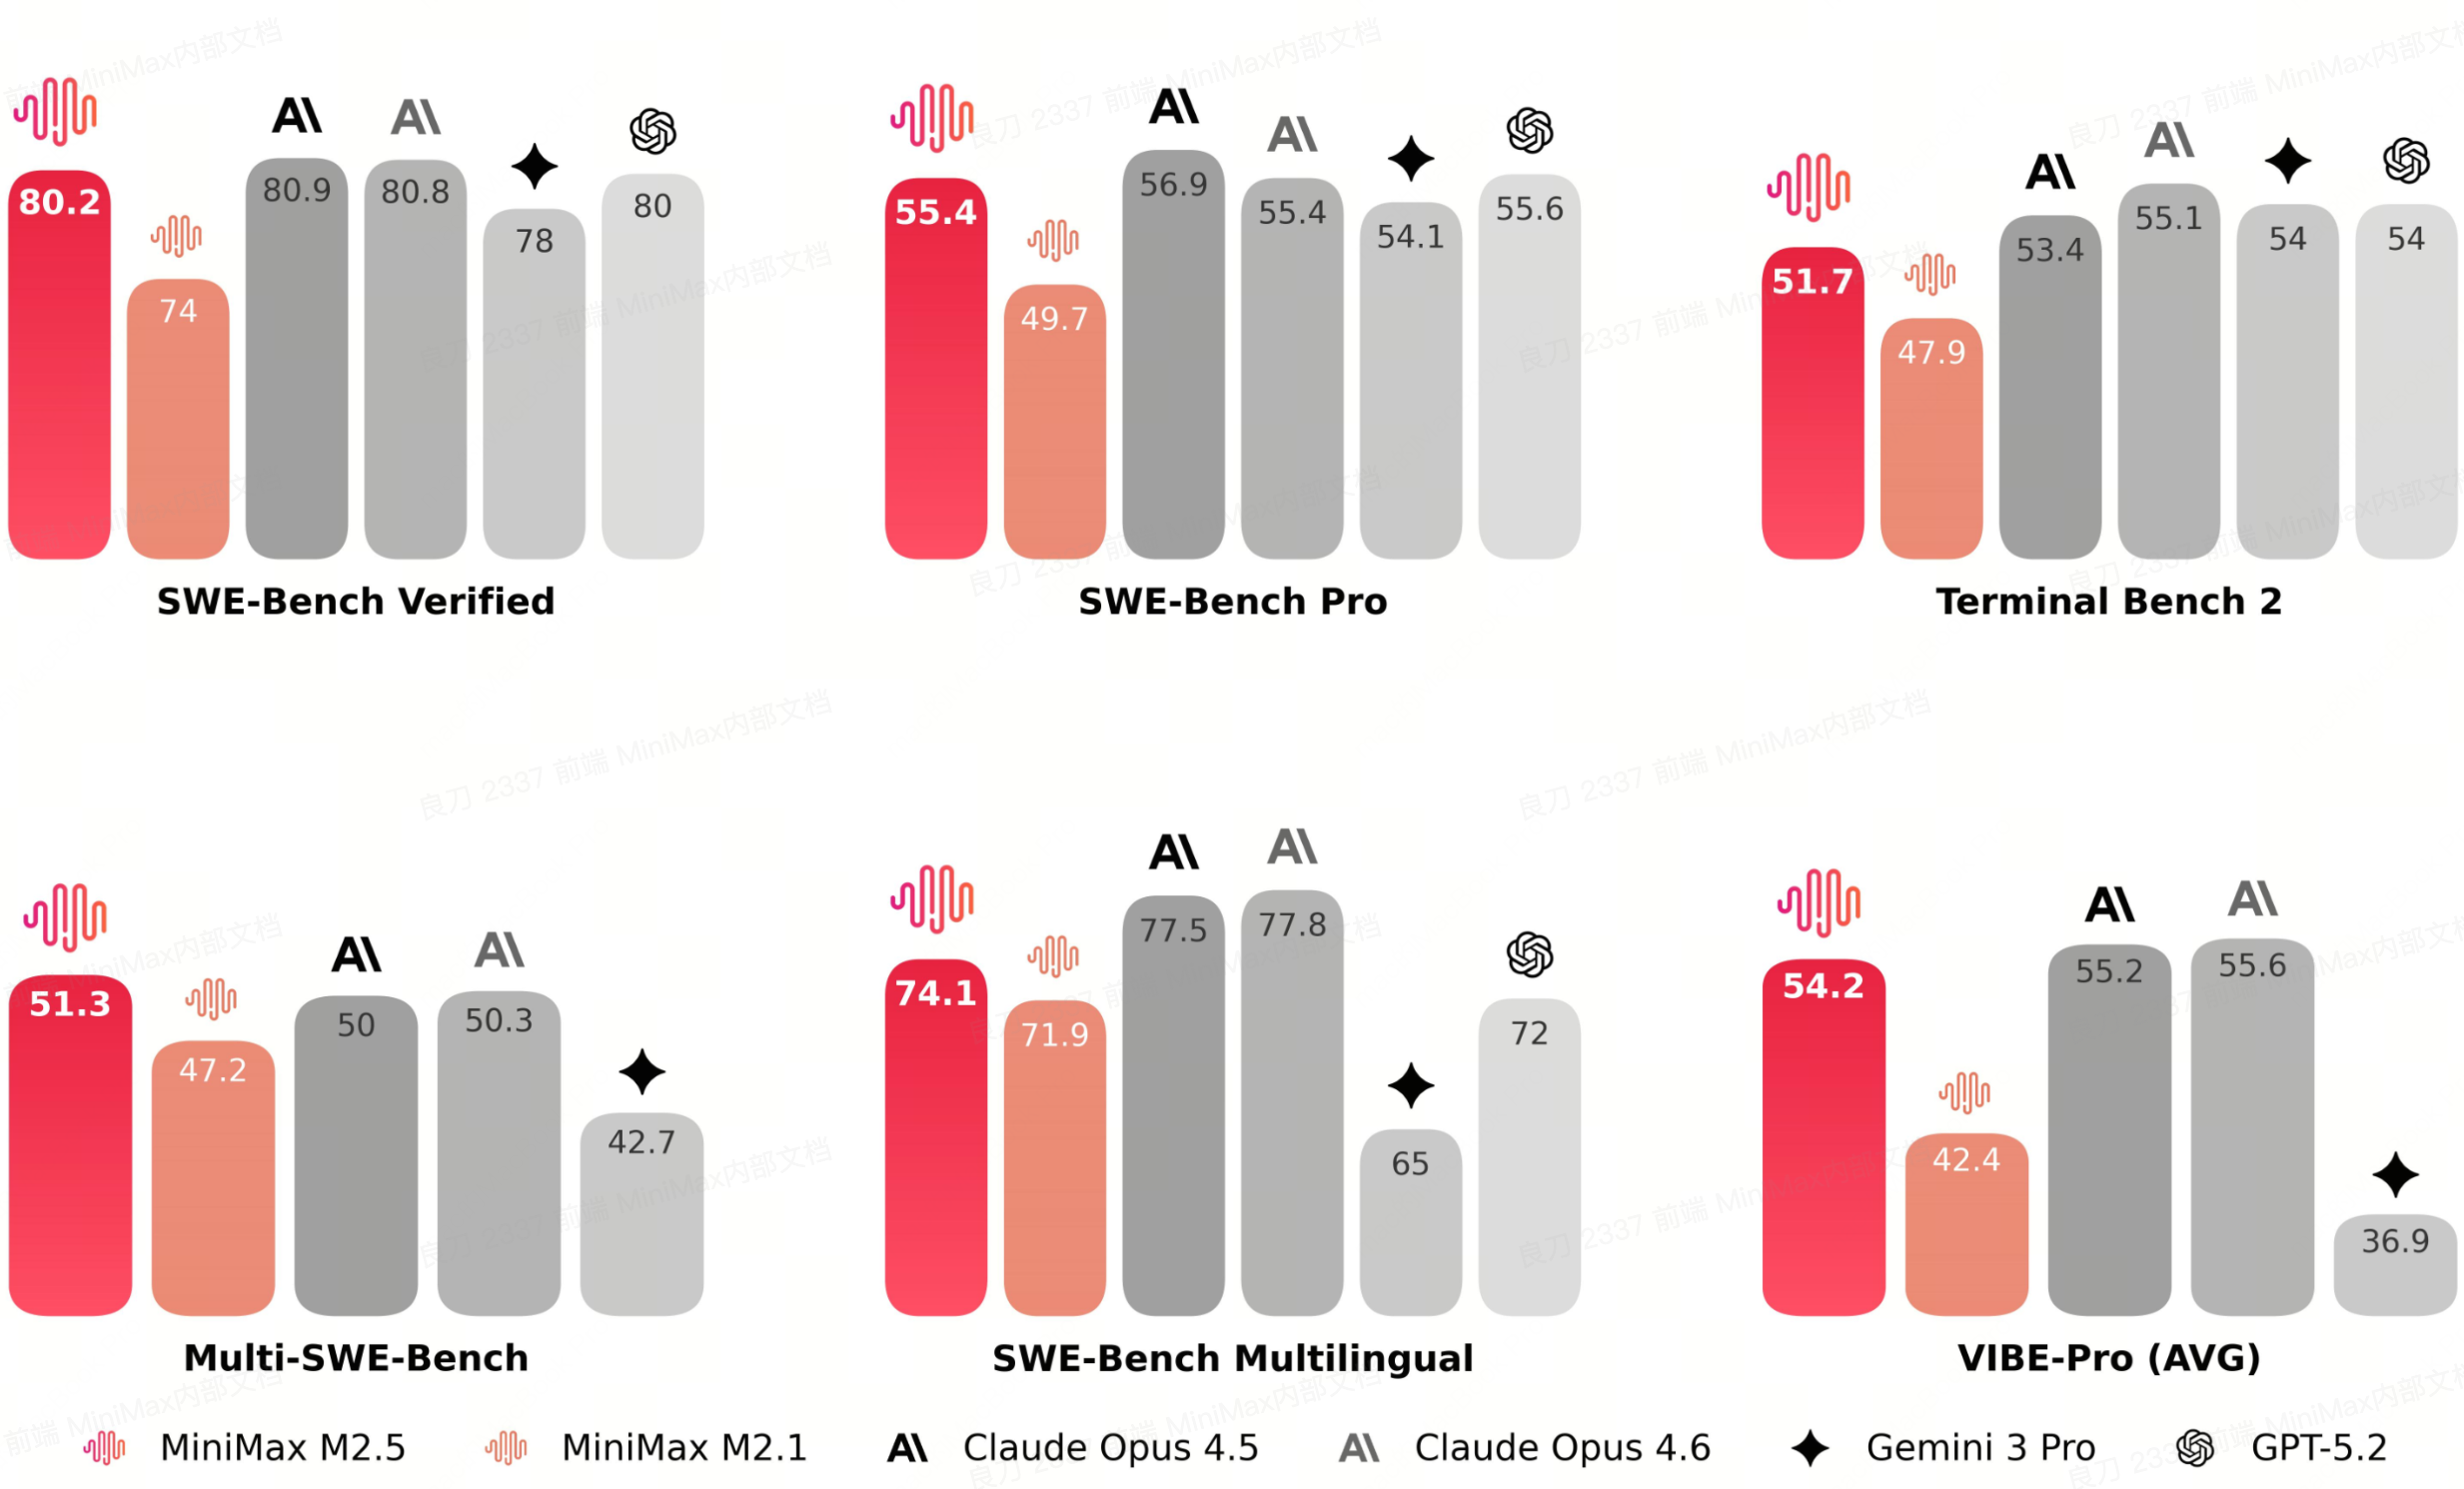
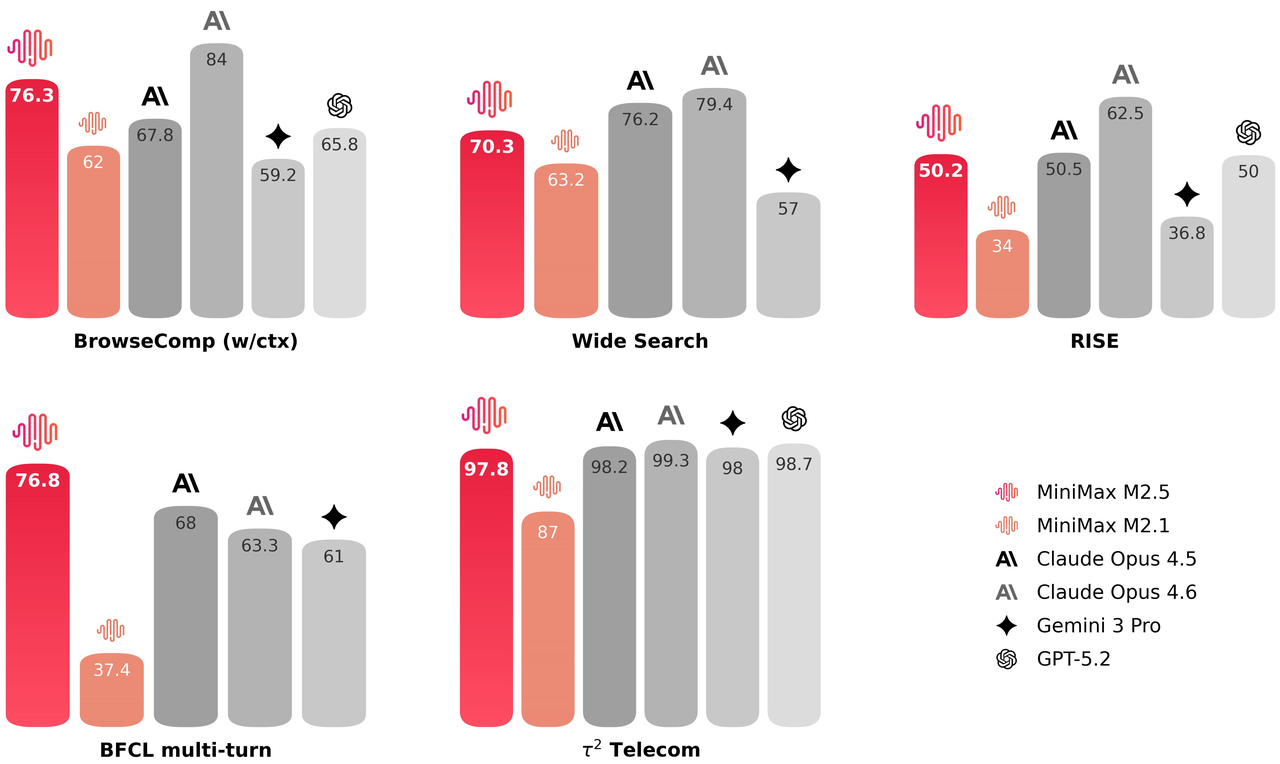
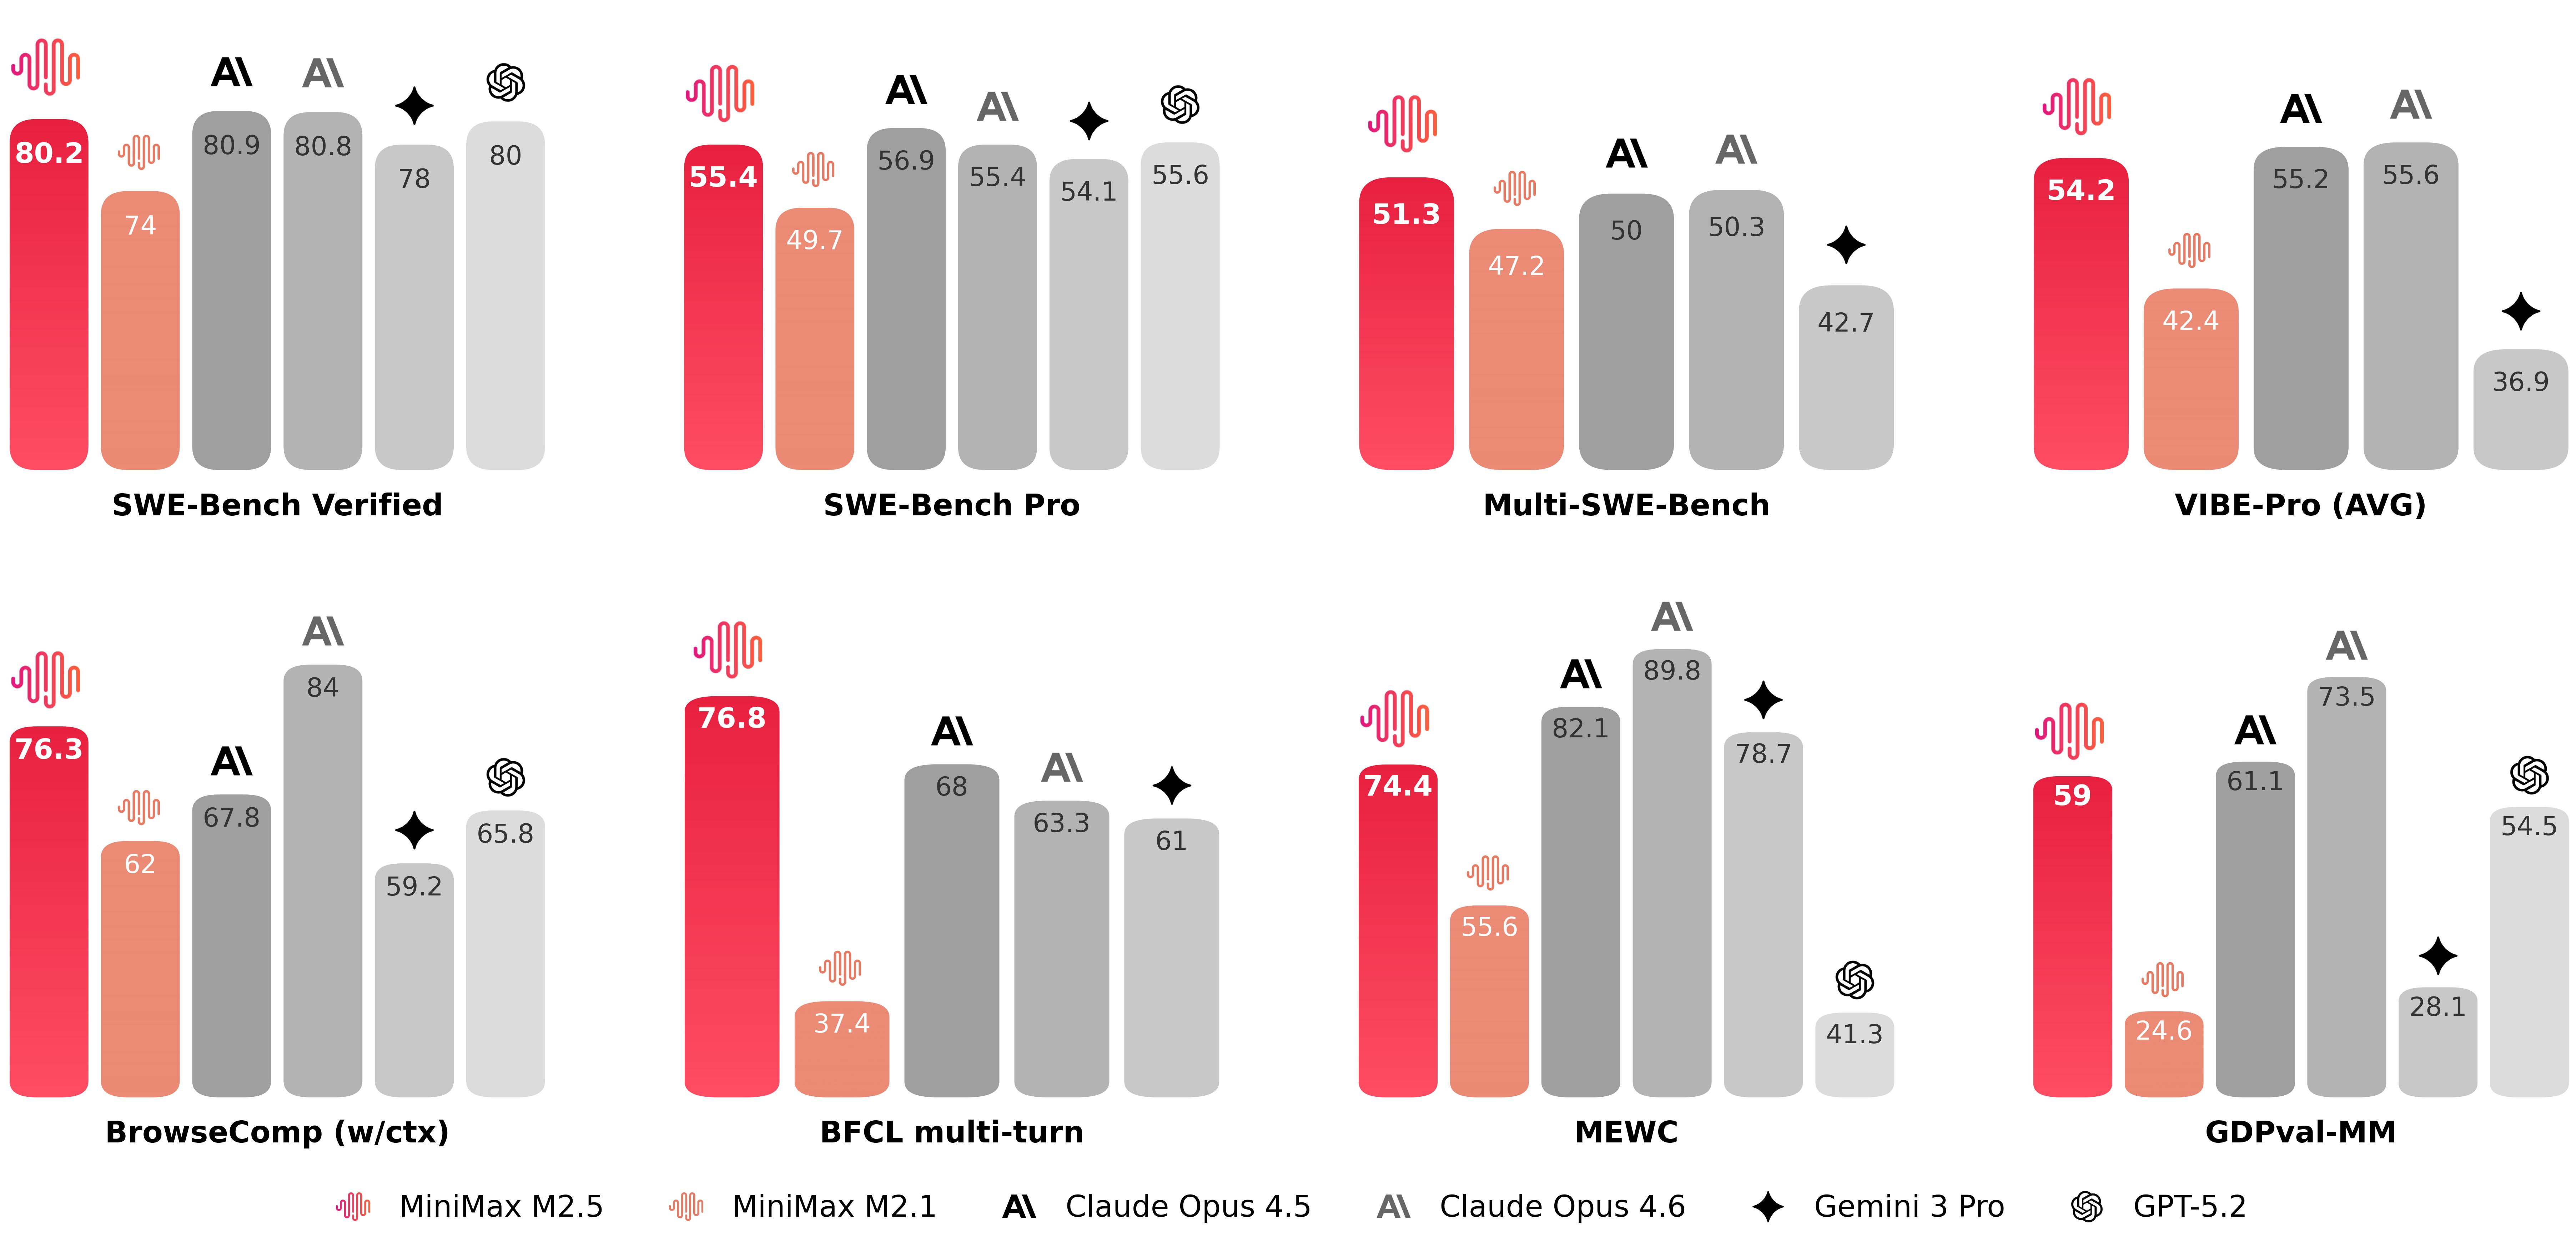
MiniMax-M2.5 ist ein neues offenes LLM, das SOTA bei Coding, agentischer Tool-Nutzung, Suche und Büroarbeit erreicht und 80,2 % in [SWE-Bench](#benchmarks) Verifiziert, 51,3 % in Multi-SWE-Bench und 76,3 % in BrowseComp.

Der **230B Parameter** (10B aktiv) Modell hat eine **200K-Kontext** Fenster und unquantisiertes bf16 erfordert **457 GB**. Unsloth Dynamic **3-Bit** GGUF reduziert die Größe auf **101 GB** **(-62%):** [**MiniMax-M2.5 GGUF**](https://huggingface.co/unsloth/MiniMax-M2.5-GGUF)

Alle Uploads verwenden Unsloth [Dynamic 2.0](/docs/de/grundlagen/dynamic-3.0-ggufs.md) für SOTA-Quantisierungsleistung – daher werden bei 3-Bit wichtige Schichten auf 8- oder 16-Bit hochskaliert. Du kannst das Modell auch über Unsloth mit Multi-GPUs feinabstimmen.

{% hint style="success" %}
**26. Feb.:** Sieh hier, wie gut unsere GGUF-Quants [auf Benchmarks abschneiden](#unsloth-gguf-benchmarks).
{% endhint %}

### :gear: Nutzungsleitfaden

Die dynamische 3-Bit-Quantisierung UD-Q3\_K\_XL verwendet **101 GB** an Speicherplatz – das passt gut auf einen **128-GB-Unified-Memory-Mac** für \~20+ Token/s und funktioniert auch schneller mit einer **1×16-GB-GPU und 96 GB RAM** für 25+ Token/s. **2-Bit** Quants oder das größte 2-Bit-Modell passen auf ein 96-GB-Gerät.

Für nahezu **voller Präzision**, verwenden Sie `Q8_0` (8-Bit), das 243 GB nutzt und auf ein Gerät mit 256 GB RAM / einen Mac für 10+ Token/s passt.

{% hint style="success" %}
Für die beste Leistung stellen Sie sicher, dass Ihr insgesamt verfügbarer Speicher (VRAM + Systemspeicher) die Größe der quantisierten Modelldatei, die Sie herunterladen, übersteigt. Wenn nicht, kann llama.cpp immer noch über SSD/HDD-Offloading ausgeführt werden, aber die Inferenz wird langsamer.
{% endhint %}

### Empfohlene Einstellungen

MiniMax empfiehlt, die folgenden Parameter für die beste Leistung zu verwenden: `temperature=1.0`, `top_p = 0.95`, `top_k = 40`.

{% columns %}
{% column %}

| Standardeinstellungen (die meisten Aufgaben) |
| -------------------------------------------- |
| `temperature = 1.0`                          |
| `top_p = 0.95`                               |
| `top_k = 40`                                 |
| `Wiederholungsstrafe = 1,0` oder deaktiviert |
| {% endcolumn %}                              |

{% column %}

* **Maximales Kontextfenster:** `196,608`
* `Min_P = 0,01` (Standard ist möglicherweise 0,05)
* Standard-System-Prompt:

{% code overflow="wrap" %}

```
Du bist ein hilfreicher Assistent. Dein Name ist MiniMax-M2.5 und du wurdest von MiniMax entwickelt.
```

{% endcode %}
{% endcolumn %}
{% endcolumns %}

## MiniMax-M2.5-Tutorials ausführen:

Für diese Tutorials werden wir die 3-Bit- [UD-Q3\_K\_XL](https://huggingface.co/unsloth/MiniMax-M2.5-GGUF?show_file_info=UD-Q3_K_XL%2FMiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf) Quant verwenden, die auf ein Gerät mit 128 GB RAM passt.

#### ✨ In llama.cpp ausführen

{% stepper %}
{% step %}
Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.

{% code overflow="wrap" %}

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endcode %}
{% endstep %}

{% step %}
Wenn Sie `llama.cpp` um Modelle direkt zu laden, kannst du Folgendes tun: (:Q3\_K\_XL) ist der Quantisierungstyp. Du kannst auch über Hugging Face herunterladen (Punkt 3). Dies ähnelt `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen `llama.cpp` um an einem bestimmten Ort zu speichern. Denken Sie daran, dass das Modell nur eine maximale Kontextlänge von 200K hat.

Befolgen Sie dies für **die meisten Standardeinstellungen** Anwendungsfälle:

```bash
export LLAMA_CACHE="unsloth/MiniMax-M2.5-GGUF"
./llama.cpp/llama-cli \\
    -hf unsloth/MiniMax-M2.5-GGUF:UD-Q3_K_XL \\
    --ctx-size 16384 \\
    --flash-attn on \
    --temp 1.0 \\
    --top-p 0.95 \\
    --min-p 0.01 \\
    --top-k 40
```

{% endstep %}

{% step %}
Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `UD-Q3_K_XL` (dynamische 4-Bit-Quantisierung) oder andere quantisierte Versionen wie `UD-Q6_K_XL` . Wir empfehlen, unsere dynamische 4-Bit-Quantisierung zu verwenden `UD-Q3_K_XL` um Größe und Genauigkeit auszubalancieren. Wenn Downloads hängen bleiben, siehe [Hugging Face Hub, XET-Debugging](/docs/de/grundlagen/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

```bash
hf download unsloth/MiniMax-M2.5-GGUF \\
    --local-dir unsloth/MiniMax-M2.5-GGUF \\
    --include "*UD-Q3_K_XL*" # Verwende "*Q8_0*" für 8-Bit
```

{% endstep %}

{% step %}
Du kannst `--threads 32` für die Anzahl der CPU-Threads, `--ctx-size 16384` für die Kontextlänge, `--n-gpu-layers 2` für GPU-Offloading auf wie viele Layer. Versuche, ihn anzupassen, wenn deiner GPU der Speicher ausgeht. Entferne ihn auch, wenn du nur CPU-Inferenz hast.

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \\
    --model unsloth/MiniMax-M2.5-GGUF/UD-Q3_K_XL/MiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --min-p 0.01 \\
    --top-k 40 \
    --ctx-size 16384 \\
    --seed 3407
```

{% endcode %}
{% endstep %}
{% endstepper %}

### 🦙 Llama-Server & OpenAIs Completion-Bibliothek

Um MiniMax-M2.5 produktiv bereitzustellen, verwenden wir `llama-server` oder die OpenAI-API. Sage in einem neuen Terminal, z. B. via tmux, das Modell bereitstellen über:

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-server \\
    --model unsloth/MiniMax-M2.5-GGUF/UD-Q3_K_XL/MiniMax-M2.5-UD-Q3_K_XL-00001-of-00004.gguf \\
    --alias "unsloth/MiniMax-M2.5" \\
    --prio 3 \\
    --temp 1.0 \\
    --top-p 0.95 \\
    --min-p 0.01 \\
    --top-k 40 \
    --ctx-size 16384 \\
    --port 8001
```

{% endcode %}

Dann in einem neuen Terminal, nachdem du `pip install openai`, mache Folgendes:

{% code overflow="wrap" %}

```python
from openai import OpenAI
import json
openai_client = OpenAI(
    base_url = "http://127.0.0.1:8001/v1",
    api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
    model = "unsloth/MiniMax-M2.5",
    messages = [{"role": "user", "content": "Erstelle ein Snake-Spiel."},],
)
print(completion.choices[0].message.content)
```

{% endcode %}

## 📊 Benchmarks

### Unsloth-GGUF-Benchmarks

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhfO2gsbz2lWrZXg3ojyE%2FHCGBTzgboAASv_A.png?alt=media&amp;token=7d6334ca-4f3c-4946-aacd-d55527375fce" alt=""><figcaption></figcaption></figure>

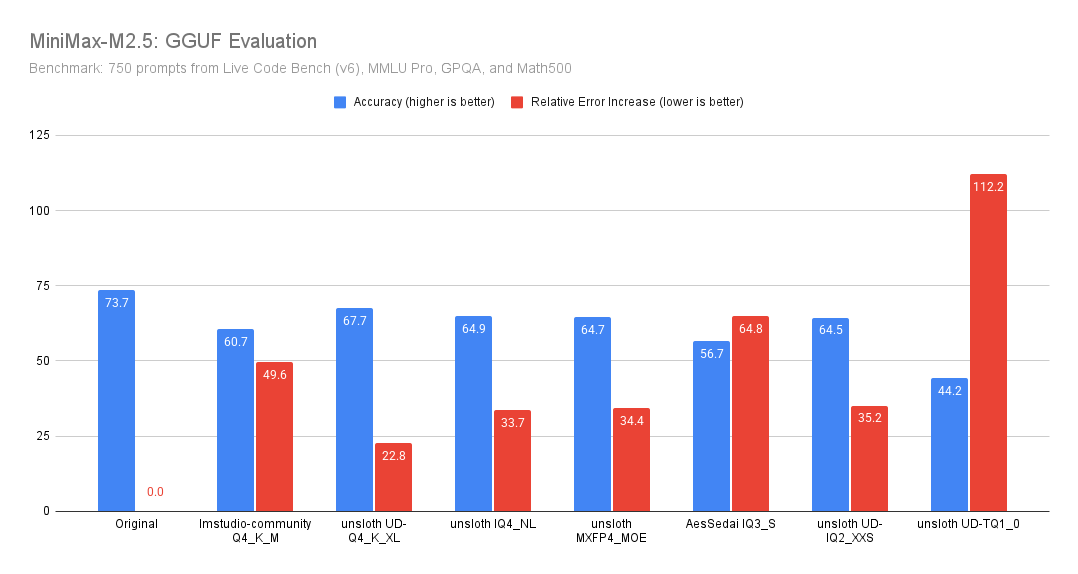
[Benjamin Marie (Drittanbieter) benchmarkte](https://x.com/bnjmn_marie/status/2027043753484021810/photo/1) **MiniMax-M2.5** mit **Unsloth-GGUF-Quantisierungen** auf einem **750-Prompt-Mixed-Suite** (LiveCodeBench v6, MMLU Pro, GPQA, Math500) und berichtete sowohl **Gesamtgenauigkeit** und **relative Fehlerzunahme** (wie viel häufiger das quantisierte Modell Fehler macht als das Original).

Unsloth-Quants schneiden unabhängig von ihrer Präzision bei Genauigkeit und relativem Fehler deutlich besser ab als ihre Nicht-Unsloth-Pendants (obwohl sie 8 GB kleiner sind).

**Wichtigste Ergebnisse:**

* **Bester Kompromiss aus Qualität und Größe hier: `unsloth UD-Q4_K_XL`.**\
  Es kommt dem Original am nächsten: nur **6,0 Punkte** niedriger, und „nur“ **+22.8%** mehr Fehler als die Baseline.
* **Andere Unsloth-Q4-Quants schneiden eng beieinander ab (\~64,5–64,9 Genauigkeit).**\
  `IQ4_NL`, `MXFP4_MOE`, und `UD-IQ2_XXS` sind bei diesem Benchmark im Wesentlichen von derselben Qualität, mit **\~33–35 %** mehr Fehlern als das Original.
* Unsloth-GGUFs schneiden deutlich besser ab als andere Nicht-Unsloth-GGUFs, z. B. siehe `lmstudio-community - Q4_K_M` (obwohl sie 8 GB kleiner sind) und `AesSedai - IQ3_S`.

### Offizielle Benchmarks

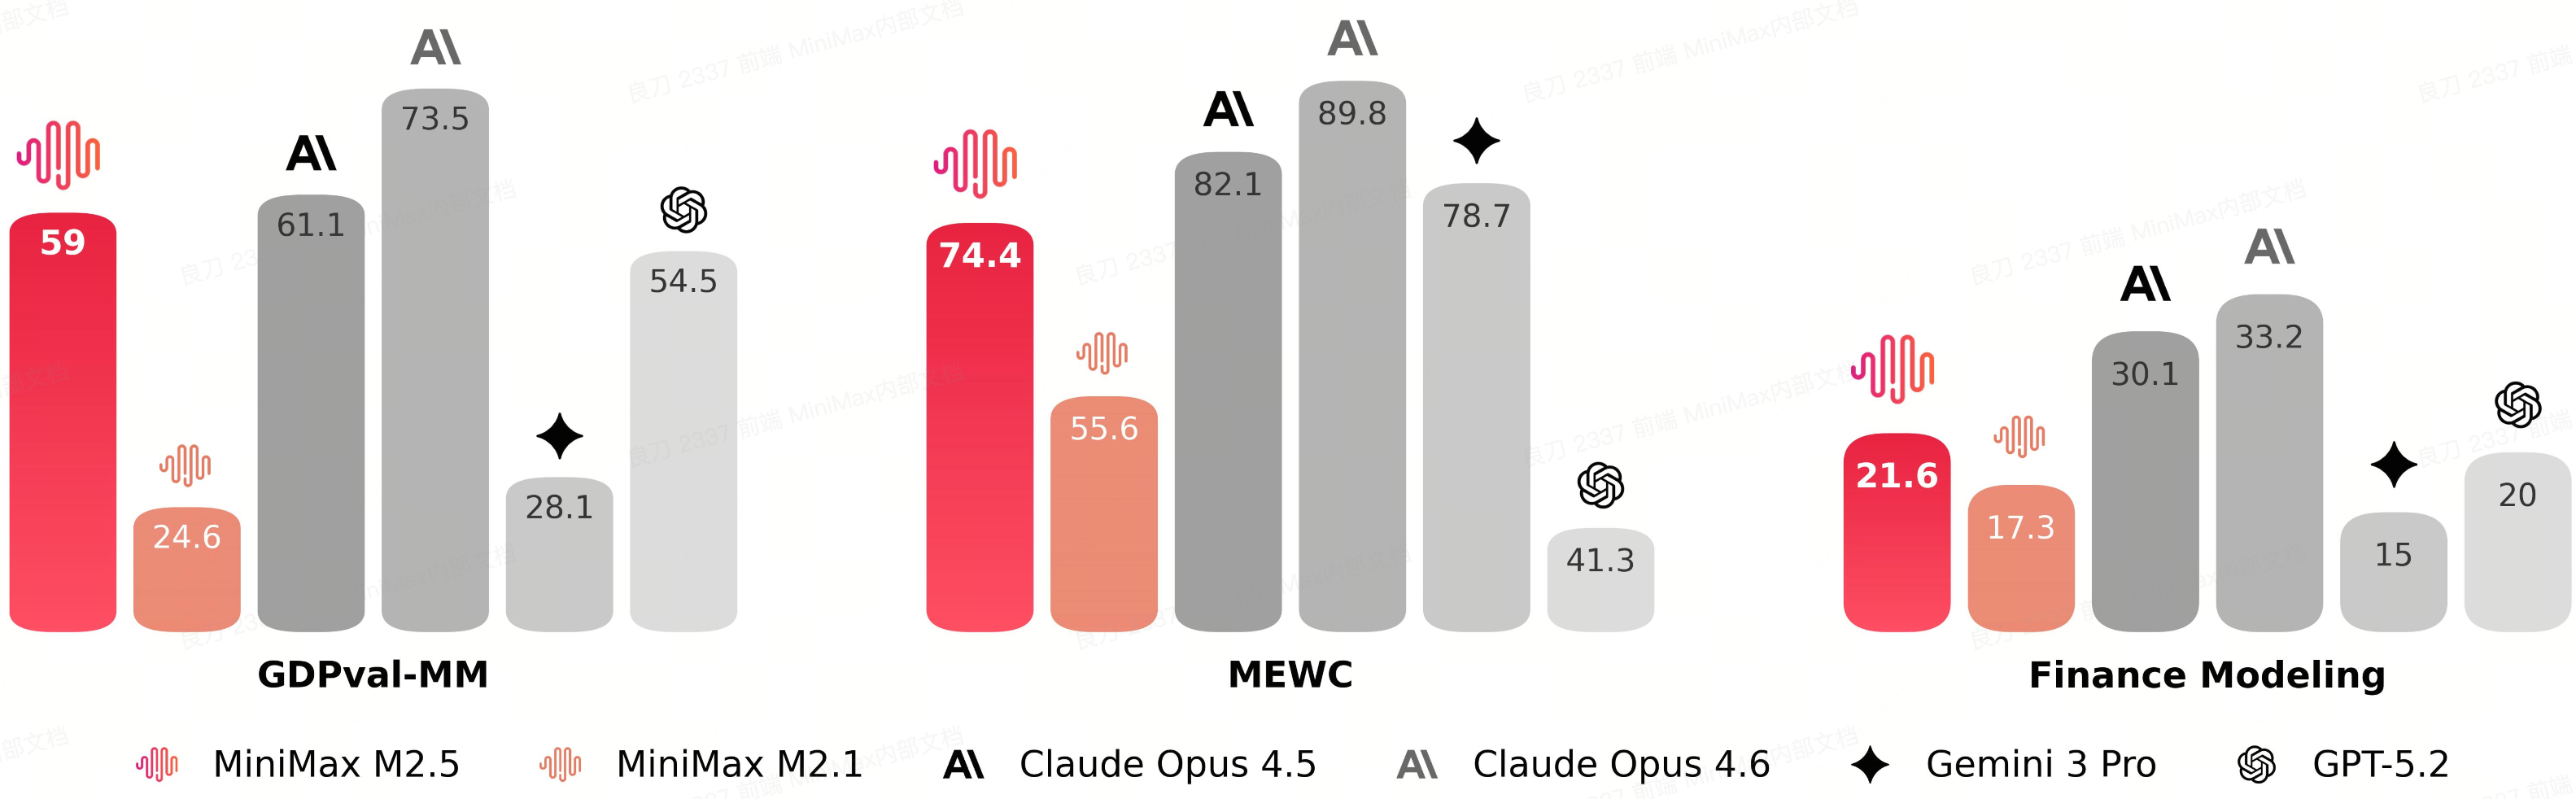
Weiter unten können Sie die Benchmarks in Tabellenform ansehen:

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHtuBCFNe7qeVG538VVQV%2F97f76950-2c60-4a9b-bb96-228454afabe9.png?alt=media&amp;token=a16edc7e-db1a-4052-aa99-1b516539b896" alt="" width="563"><figcaption></figcaption></figure>

<table data-full-width="true"><thead><tr><th>Benchmark</th><th>MiniMax-M2.5</th><th>MiniMax-M2.1</th><th>Claude Opus 4.5</th><th>Claude Opus 4.6</th><th>Gemini 3 Pro</th><th>GPT-5.2 (thinking)</th></tr></thead><tbody><tr><td>AIME25</td><td>86.3</td><td>83.0</td><td>91.0</td><td>95.6</td><td>96.0</td><td>98.0</td></tr><tr><td>GPQA-D</td><td>85.2</td><td>83.0</td><td>87.0</td><td>90.0</td><td>91.0</td><td>90.0</td></tr><tr><td>SciCode</td><td>44.4</td><td>41.0</td><td>50.0</td><td>52.0</td><td>56.0</td><td>52.0</td></tr><tr><td>IFBench</td><td>70.0</td><td>70.0</td><td>58.0</td><td>53.0</td><td>70.0</td><td>75.0</td></tr><tr><td>AA-LCR</td><td>69.5</td><td>62.0</td><td>74.0</td><td>71.0</td><td>71.0</td><td>73.0</td></tr><tr><td>SWE-Bench Verified</td><td>80.2</td><td>74.0</td><td>80.9</td><td>80.8</td><td>78.0</td><td>80.0</td></tr><tr><td>SWE-Bench Pro</td><td>55.4</td><td>49.7</td><td>56.9</td><td>55.4</td><td>54.1</td><td>55.6</td></tr><tr><td>Terminal Bench 2</td><td>51.7</td><td>47.9</td><td>53.4</td><td>55.1</td><td>54.0</td><td>54.0</td></tr><tr><td>HLE ohne Tools</td><td>19.4</td><td>22.2</td><td>28.4</td><td>30.7</td><td>37.2</td><td>31.4</td></tr><tr><td>Multi-SWE-Bench</td><td>51.3</td><td>47.2</td><td>50.0</td><td>50.3</td><td>42.7</td><td>—</td></tr><tr><td>SWE-Bench Multilingual</td><td>74.1</td><td>71.9</td><td>77.5</td><td>77.8</td><td>65.0</td><td>72.0</td></tr><tr><td>VIBE-Pro (AVG)</td><td>54.2</td><td>42.4</td><td>55.2</td><td>55.6</td><td>36.9</td><td>—</td></tr><tr><td>BrowseComp (mit Kontext)</td><td>76.3</td><td>62.0</td><td>67.8</td><td>84.0</td><td>59.2</td><td>65.8</td></tr><tr><td>Weite Suche</td><td>70.3</td><td>63.2</td><td>76.2</td><td>79.4</td><td>57.0</td><td>—</td></tr><tr><td>RISE</td><td>50.2</td><td>34.0</td><td>50.5</td><td>62.5</td><td>36.8</td><td>50.0</td></tr><tr><td>BFCL multi-turn</td><td>76.8</td><td>37.4</td><td>68.0</td><td>63.3</td><td>61.0</td><td>—</td></tr><tr><td>τ² Telecom</td><td>97.8</td><td>87.0</td><td>98.2</td><td>99.3</td><td>98.0</td><td>98.7</td></tr><tr><td>MEWC</td><td>74.4</td><td>55.6</td><td>82.1</td><td>89.8</td><td>78.7</td><td>41.3</td></tr><tr><td>GDPval-MM</td><td>59.0</td><td>24.6</td><td>61.1</td><td>73.5</td><td>28.1</td><td>54.5</td></tr><tr><td>Finanzmodellierung</td><td>21.6</td><td>17.3</td><td>30.1</td><td>33.2</td><td>15.0</td><td>20.0</td></tr></tbody></table>

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FfHyJbhPs4k10iiauD3zo%2F1f5a4e78-1a5c-4263-8a65-36c6fe703041.png?alt=media&amp;token=346519a3-5dee-4ea1-b395-c7de12b6f6cd" alt="" width="563"><figcaption><p>Ergebnisse des Coding-Core-Benchmarks</p></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhJmbCVK6CNZPw2FSJLPT%2F2003295c-001c-4381-af89-8859c197b5a0.png?alt=media&amp;token=aaa9968d-f694-4b1e-b734-086c2cf8988b" alt="" width="563"><figcaption><p>Suche und Tool-Nutzung</p></figcaption></figure></div>

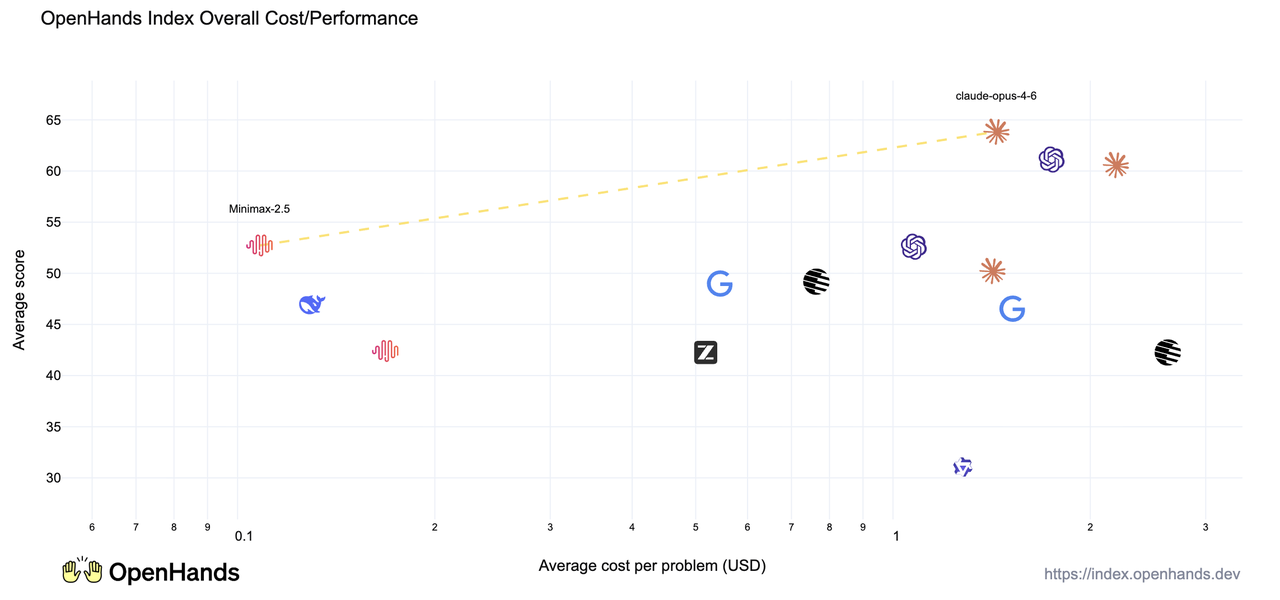
<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FaG1VqXpVwoCWG3RxMWDL%2F91c4825c-1813-4cad-9e36-4b69c6cd0272.png?alt=media&amp;token=ae956a3f-a25e-4ebc-80cb-97733573e654" alt=""><figcaption><p>Erledigte Aufgaben pro 100</p></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fj2PwoDid8zWRyYnXA6of%2F8c25f392-275d-4730-aa92-e9ea27315d83.png?alt=media&amp;token=a59cf4d3-ff63-4383-90c8-2d089db19b50" alt=""><figcaption><p>Office-Fähigkeiten</p></figcaption></figure></div>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/modelle/tutorials/minimax-m25.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.