> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md).
# Gemma 3n: Wie man ausführt und feinabstimmt
Führe Googles neues Gemma 3n lokal mit Dynamic GGUFs auf llama.cpp, Ollama und Open WebUI aus und feinabstimme es mit Unsloth!
Googles multimodales Gemma-3n-Modell verarbeitet Bild-, Audio-, Video- und Texteingaben. Verfügbar in den Größen 2B und 4B, unterstützt es 140 Sprachen für Text- und multimodale Aufgaben. Sie können jetzt ausführen und feinabstimmen **Gemma-3n-E4B** und **E2B** lokal mit [Unsloth](https://github.com/unslothai/unsloth).
> **Feinabstimmung von Gemma 3n mit unserem** [**kostenloses Colab-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
Gemma 3n hat **32K Kontextlänge**, 30s Audioeingabe, OCR, automatische Spracherkennung (ASR) und Sprachübersetzung über Prompts.
Ausführungs-TutorialAnleitung zur FeinabstimmungKorrekturen + technische Analyse
**Unsloth Gemma 3n (Instruct)-Uploads mit optimalen Konfigurationen:**
**Sehen Sie alle unsere Gemma-3n-Uploads, einschließlich der Basis- und weiterer Formate, in** [**unserer Sammlung hier**](https://huggingface.co/collections/unsloth/gemma-3n-685d3874830e49e1c93f9339)**.**
## 🖥️ Gemma 3n ausführen
Derzeit wird Gemma 3n nur in **Textformat** für die Inferenz unterstützt.
{% hint style="info" %}
Wir haben [Probleme behoben](#fixes-for-gemma-3n) bei denen GGUFs nur in Ollama nicht richtig funktionierten. Bitte laden Sie sie erneut herunter, wenn Sie Ollama verwenden.
{% endhint %}
### :gear: Offiziell empfohlene Einstellungen
Laut dem Gemma-Team sind die offiziell empfohlenen Einstellungen für die Inferenz:
`temperature = 1.0, top_k = 64, top_p = 0.95, min_p = 0.0`
* Temperatur von 1.0
* Top\_K von 64
* Min\_P von 0,00 (optional, aber 0,01 funktioniert gut, der Standard von llama.cpp ist 0,1)
* Top\_P von 0.95
* Wiederholungsstrafe von 1.0. (1.0 bedeutet in llama.cpp und transformers deaktiviert)
* Chat-Vorlage:
<bos><start_of_turn>user\nHallo!<end_of_turn>\n<start_of_turn>model\nHey!<end_of_turn>\n<start_of_turn>user\nWas ist 1+1?<end_of_turn>\n<start_of_turn>model\n
* Chatvorlage mit `\n`gerenderten Zeilenumbrüchen (außer dem letzten)
{% code overflow="wrap" %}
```
user
Hallo!model
Hey!user
Was ist 1+1?model\n
```
{% endcode %}
{% hint style="danger" %}
llama.cpp und andere Inferenz-Engines fügen automatisch ein \ hinzu - fügen Sie NICHT ZWEI \-Tokens hinzu! Sie sollten das \ beim Prompting des Modells ignorieren!
{% endhint %}
### :llama: Anleitung: Gemma 3n in Ollama ausführen
{% hint style="success" %}
Bitte laden Sie die Gemma-3N-Quants erneut herunter oder entfernen Sie die alten über Ollama, da es einige Fehlerbehebungen gibt. Sie können Folgendes tun, um die alte Datei zu löschen und zu aktualisieren:
```
ollama rm hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
ollama run hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
```
{% endhint %}
1. Installieren `ollama` falls du das noch nicht getan hast!
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
2. Führen Sie das Modell aus! Beachten Sie, dass Sie `ollama serve`in einem anderen Terminal aufrufen können, falls es fehlschlägt! Wir enthalten alle unsere Korrekturen und empfohlenen Parameter (Temperatur usw.) in `params` in unserem Hugging-Face-Upload!
```bash
ollama run hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
```
### 📖 Anleitung: Gemma 3n in llama.cpp ausführen
{% hint style="info" %}
Zunächst möchten wir uns bedanken bei [Xuan-Son Nguyen](https://x.com/ngxson) von Hugging Face, [Georgi Gerganov](https://x.com/ggerganov) vom llama.cpp-Team dafür, dass Gemma 3N in llama.cpp funktioniert!
{% endhint %}
1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=ON -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Wenn Sie `llama.cpp` direkt zum Laden von Modellen kannst du Folgendes tun: (:Q4\_K\_XL) ist der Quantisierungstyp. Du kannst auch über Hugging Face (Punkt 3) herunterladen. Das ist ähnlich wie `ollama run`
```bash
./llama.cpp/llama-cli -hf unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL -ngl 99 --jinja
```
3. **ODER** lade das Modell herunter über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Du kannst Q4\_K\_M oder andere quantisierte Versionen wählen (wie BF16 in voller Präzision).
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/gemma-3n-E4B-it-GGUF",
local_dir = "unsloth/gemma-3n-E4B-it-GGUF",
allow_patterns = ["*UD-Q4_K_XL*", "mmproj-BF16.gguf"], # Für Q4_K_XL
)
```
4. Führen Sie das Modell aus.
5. Bearbeiten `--threads 32` für die Anzahl der CPU-Threads, `--ctx-size 32768` für die Kontextlänge (Gemma 3 unterstützt 32K Kontextlänge!), `--n-gpu-layers 99` für GPU-Offloading auf wie viele Layer. Versuche, ihn anzupassen, wenn deiner GPU der Speicher ausgeht. Entferne ihn auch, wenn du nur CPU-Inferenz hast.
6. Für den Gesprächsmodus:
```bash
./llama.cpp/llama-cli \\
--model unsloth/gemma-3n-E4B-it-GGUF/gemma-3n-E4B-it-UD-Q4_K_XL.gguf \
--mmproj unsloth/gemma-3n-E4B-it-GGUF/mmproj-BF16.gguf \
--ctx-size 32768 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 1.0 \\
--repeat-penalty 1.0 \
--min-p 0.00 \\
--top-k 64 \\
--top-p 0.95
```
7. Für den Nicht-Dialogmodus, um Flappy Bird zu testen:
```bash
./llama.cpp/llama-cli \\
--model unsloth/gemma-3n-E4B-it-GGUF/gemma-3n-E4B-it-UD-Q4_K_XL.gguf \
--mmproj unsloth/gemma-3n-E4B-it-GGUF/mmproj-BF16.gguf \
--ctx-size 32768 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 1.0 \\
--repeat-penalty 1.0 \
--min-p 0.00 \\
--top-k 64 \\
--top-p 0.95 \\
-no-cnv \\
--prompt "user\nErstelle ein Flappy-Bird-Spiel in Python. Du musst diese Dinge einbeziehen:\n1. Du musst pygame verwenden.\n2. Die Hintergrundfarbe sollte zufällig gewählt werden und ein heller Farbton sein. Beginne mit einem hellblauen Farbton.\n3. Mehrfaches Drücken von LEERTASTE beschleunigt den Vogel.\n4. Die Form des Vogels sollte zufällig als Quadrat, Kreis oder Dreieck gewählt werden. Die Farbe sollte zufällig als dunkle Farbe gewählt werden.\n5. Platziere unten etwas Boden, der zufällig dunkelbraun oder gelb gefärbt ist.\n6. Zeige oben rechts eine Punktzahl an. Erhöhe sie, wenn du Rohre passierst und sie nicht berührst.\n7. Erzeuge zufällig verteilte Rohre mit ausreichend Platz. Färbe sie zufällig dunkelgrün oder hellbraun oder einem dunklen Grauton.\n8. Wenn du verlierst, zeige die beste Punktzahl an. Platziere den Text innerhalb des Bildschirms. Drücken von q oder Esc beendet das Spiel. Ein Neustart erfolgt durch erneutes Drücken von LEERTASTE.\nDas fertige Spiel sollte in einem Markdown-Abschnitt in Python enthalten sein. Prüfe deinen Code auf Fehler und behebe sie vor dem endgültigen Markdown-Abschnitt.\nmodel\n"
```
{% hint style="danger" %}
Denken Sie daran, \ zu entfernen, da Gemma 3N automatisch ein \ hinzufügt!
{% endhint %}
## 🦥 Feinabstimmung von Gemma 3n mit Unsloth
Gemma 3n, wie [Gemma 3](/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune.md#unsloth-fine-tuning-fixes-for-gemma-3), hatte Probleme beim Ausführen auf **Flotat16-GPUs wie Tesla T4s in Colab**. Sie werden auf NaNs und Unendlichkeiten stoßen, wenn Sie Gemma 3n nicht für die Inferenz oder Feinabstimmung patchen. [Weitere Informationen unten](#infinities-and-nan-gradients-and-activations).
* Feinabstimmung von Gemma 3n-E4B mit unserem [kostenloses Colab-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
* **Audio:** Feinabstimmung von Gemma 3n-E4B mit unserem [**Notebook nur für Audio**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Audio.ipynb)
* **Vision**: Feinabstimmung von Gemma 3n-E4B mit unserem [**Notebook nur für Vision**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Vision.ipynb)
Wir haben außerdem festgestellt, dass Gemma 3ns einzigartige Architektur versteckte Zustände im Vision-Encoder wiederverwendet, was eine weitere interessante Eigenheit bei [dem unten beschriebenen Gradient Checkpointing](#gradient-checkpointing-issues)
**Unsloth ist das einzige Framework, das auf Float16-Maschinen für Gemma-3n-Inferenz und -Training funktioniert.** Das bedeutet, dass auch Colab-Notebooks mit kostenlosen Tesla-T4-GPUs funktionieren! Insgesamt macht Unsloth das Training von Gemma 3n 1,5x schneller, benötigt 50 % weniger VRAM und ermöglicht 4x längere Kontextlängen.
Unsere kostenlosen Gemma-3n-Colab-Notebooks standardmäßig feinabstimmen Textschichten. Wenn Sie auch Vision- oder Audioschichten feinabstimmen möchten, beachten Sie bitte, dass dies deutlich mehr VRAM erfordert – über die 15 GB hinaus, die Colab oder Kaggle kostenlos bereitstellen. Sie *kannst* feinabstimmen weiterhin alle Schichten einschließlich Audio und Vision, und Unsloth ermöglicht es Ihnen außerdem, nur bestimmte Bereiche feinabzustimmen, etwa nur Vision. Passen Sie einfach nach Bedarf an:
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = False, # False, wenn Vision-Schichten nicht feinabgestimmt werden
finetune_language_layers = True, # False, wenn Sprachschichten nicht feinabgestimmt werden
finetune_attention_modules = True, # False, wenn Aufmerksamkeits-Schichten nicht feinabgestimmt werden
finetune_mlp_modules = True, # False, wenn MLP-Schichten nicht feinabgestimmt werden
)
```
#### :trophy:Bonus-Inhalt
Wir haben auch gehört, dass ihr einen **Vision-Notebook für Gemma 3 (4B)** wolltet, also hier ist es:
* Feinabstimmung von Gemma 3 (4B) mit Vision-Unterstützung mit unserem [kostenloses Colab-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
{% hint style="info" %}
Wenn Sie Kaggle lieben, veranstaltet Google einen Wettbewerb, bei dem das beste mit Gemma 3n und Unsloth feinabgestimmte Modell einen Preis von 10.000 $ gewinnt! [Mehr dazu hier](https://www.kaggle.com/competitions/google-gemma-3n-hackathon).
{% endhint %}
## 🐛Korrekturen für Gemma 3n
### :sparkles:GGUF-Probleme & Korrekturen
Dank Diskussionen von [Michael](https://github.com/mxyng) vom Ollama-Team und auch [Xuan](https://x.com/ngxson) von Hugging Face gab es 2 Probleme, die wir speziell für GGUFs beheben mussten:
1. Der `add_shared_kv_layers` Parameter wurde versehentlich kodiert in `float32` was in Ordnung ist, aber auf Ollamas Seite etwas kompliziert zu dekodieren wird - eine einfache Änderung zu `uint32` löst das Problem. [Pull-Request](https://github.com/ggml-org/llama.cpp/pull/14450) zur Behebung dieses Problems.
2. Der `per_layer_token_embd` Schicht sollte in der Genauigkeit Q8\_0 sein. Alles darunter funktioniert nicht richtig und führt im Ollama-Engine zu Fehlern - um Probleme für unsere Community zu reduzieren, haben wir dies in allen Quants auf Q8\_0 gesetzt - leider benötigt das mehr Speicherplatz.
1. Als [zu aktualisieren](https://huggingface.co/unsloth/gemma-3n-E4B-it-GGUF/discussions/4), [Matt](https://huggingface.co/WBB2500) erwähnt hat, können wir für die Einbettungen auch Q4\_0, Q4\_1, Q5\_0, Q5\_1 verwenden – und wir haben bestätigt, dass das auch in Ollama funktioniert! Das bedeutet wiederum, dass die kleineren 2-, 3- und 4-Bit-Quants kleiner sind und kein Q8\_0 benötigen!
## :infinity:Unendlichkeiten sowie NaN-Gradienten und -Aktivierungen
{% columns %}
{% column %}
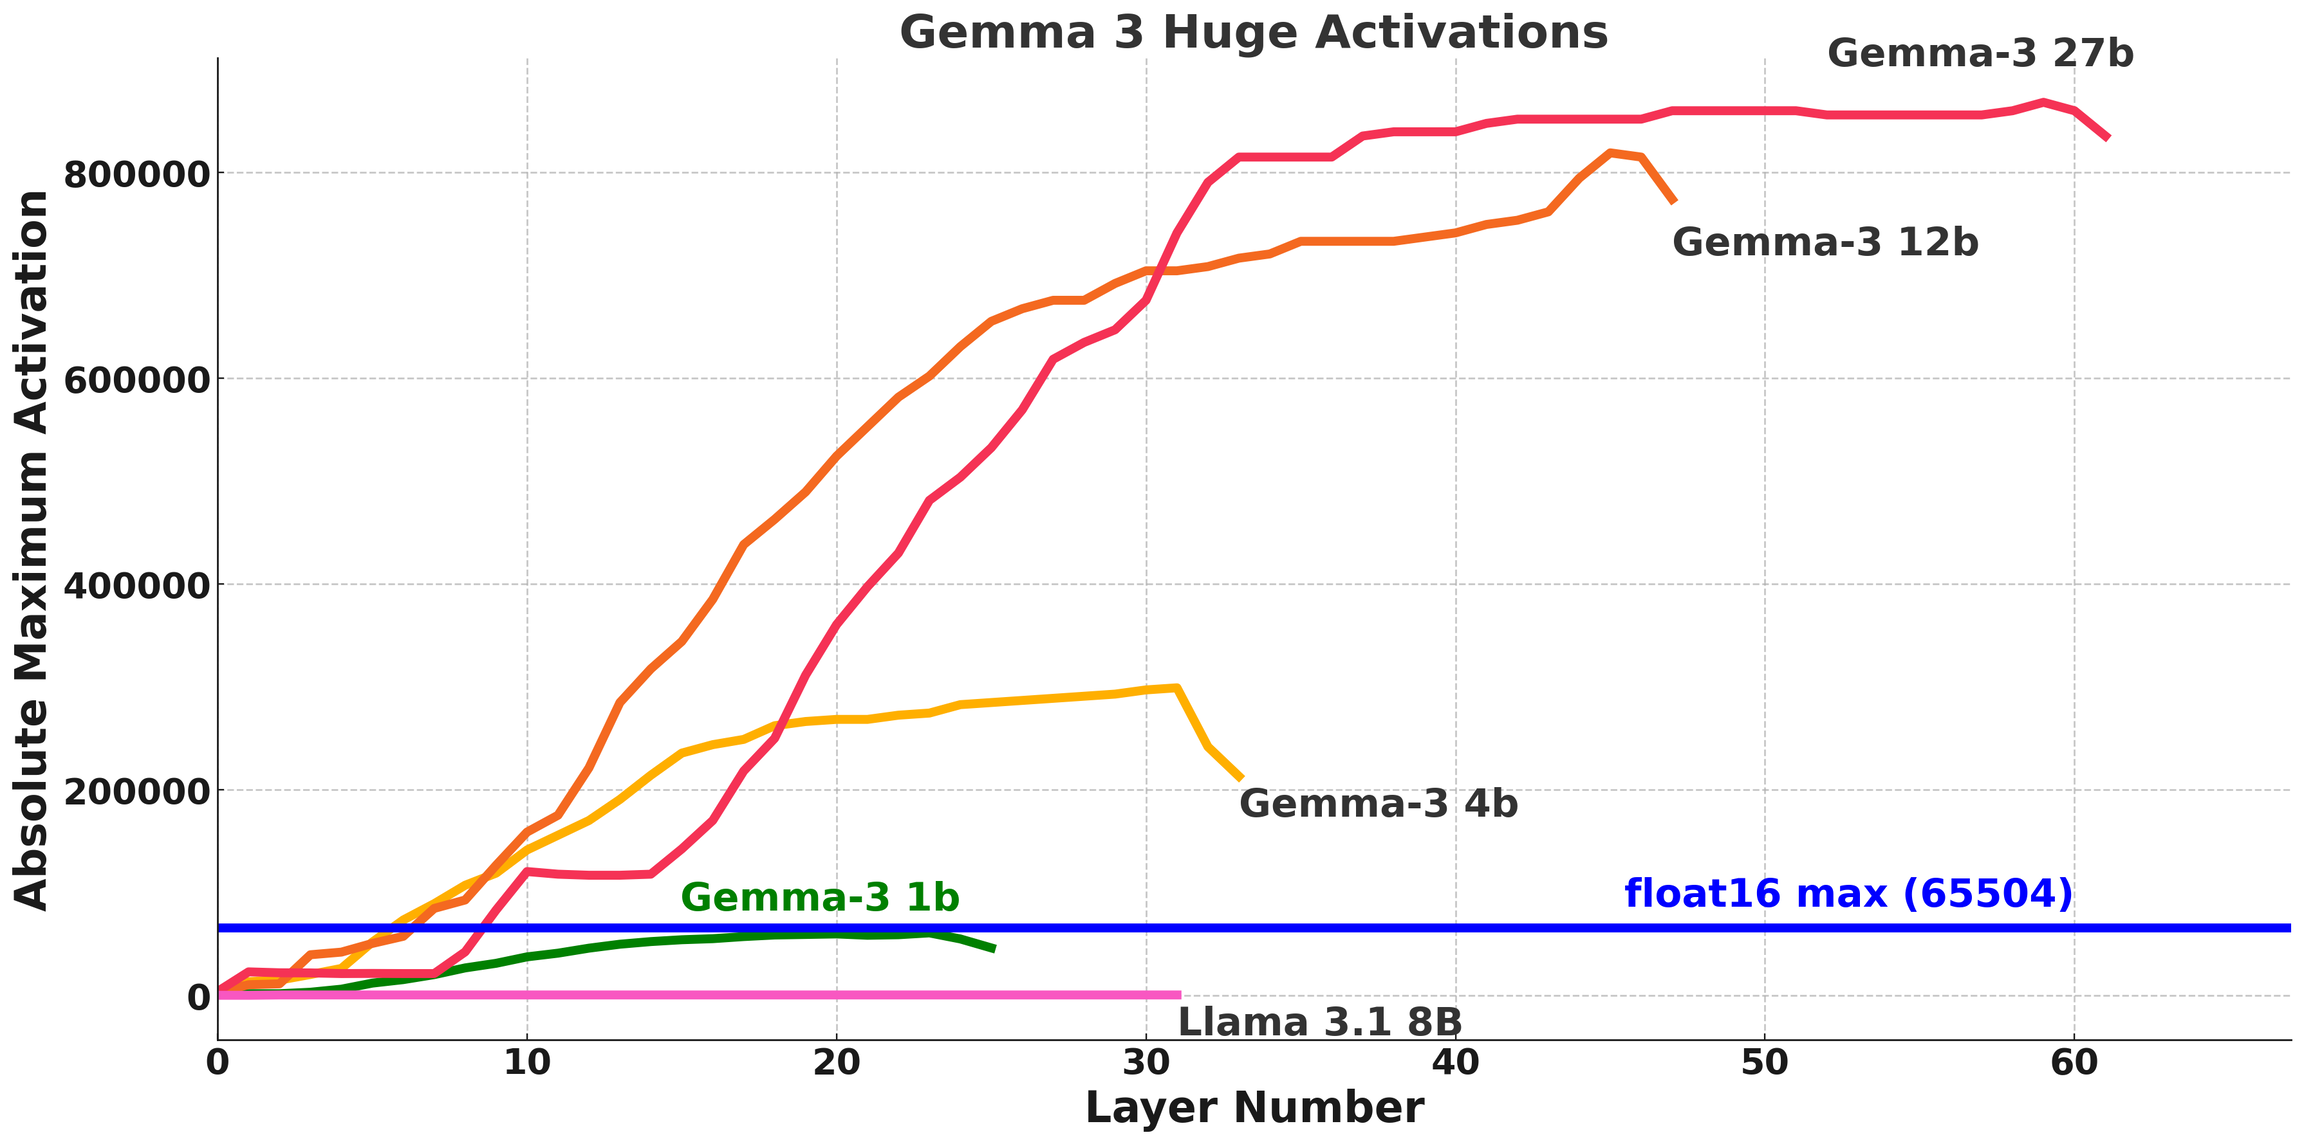
Gemma 3n hat genau wie Gemma 3 Probleme auf FP16-GPUs (z. B. Tesla T4s in Colab).
Unsere früheren Korrekturen für Gemma 3 sind [hier besprochen](/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune.md). Für Gemma 3 stellten wir fest, dass Aktivierungen den maximalen Bereich von float16 überschreiten von **65504.**
**Gemma 3N hat dieses Aktivierungsproblem nicht, aber wir sind trotzdem auf Unendlichkeiten gestoßen!**
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
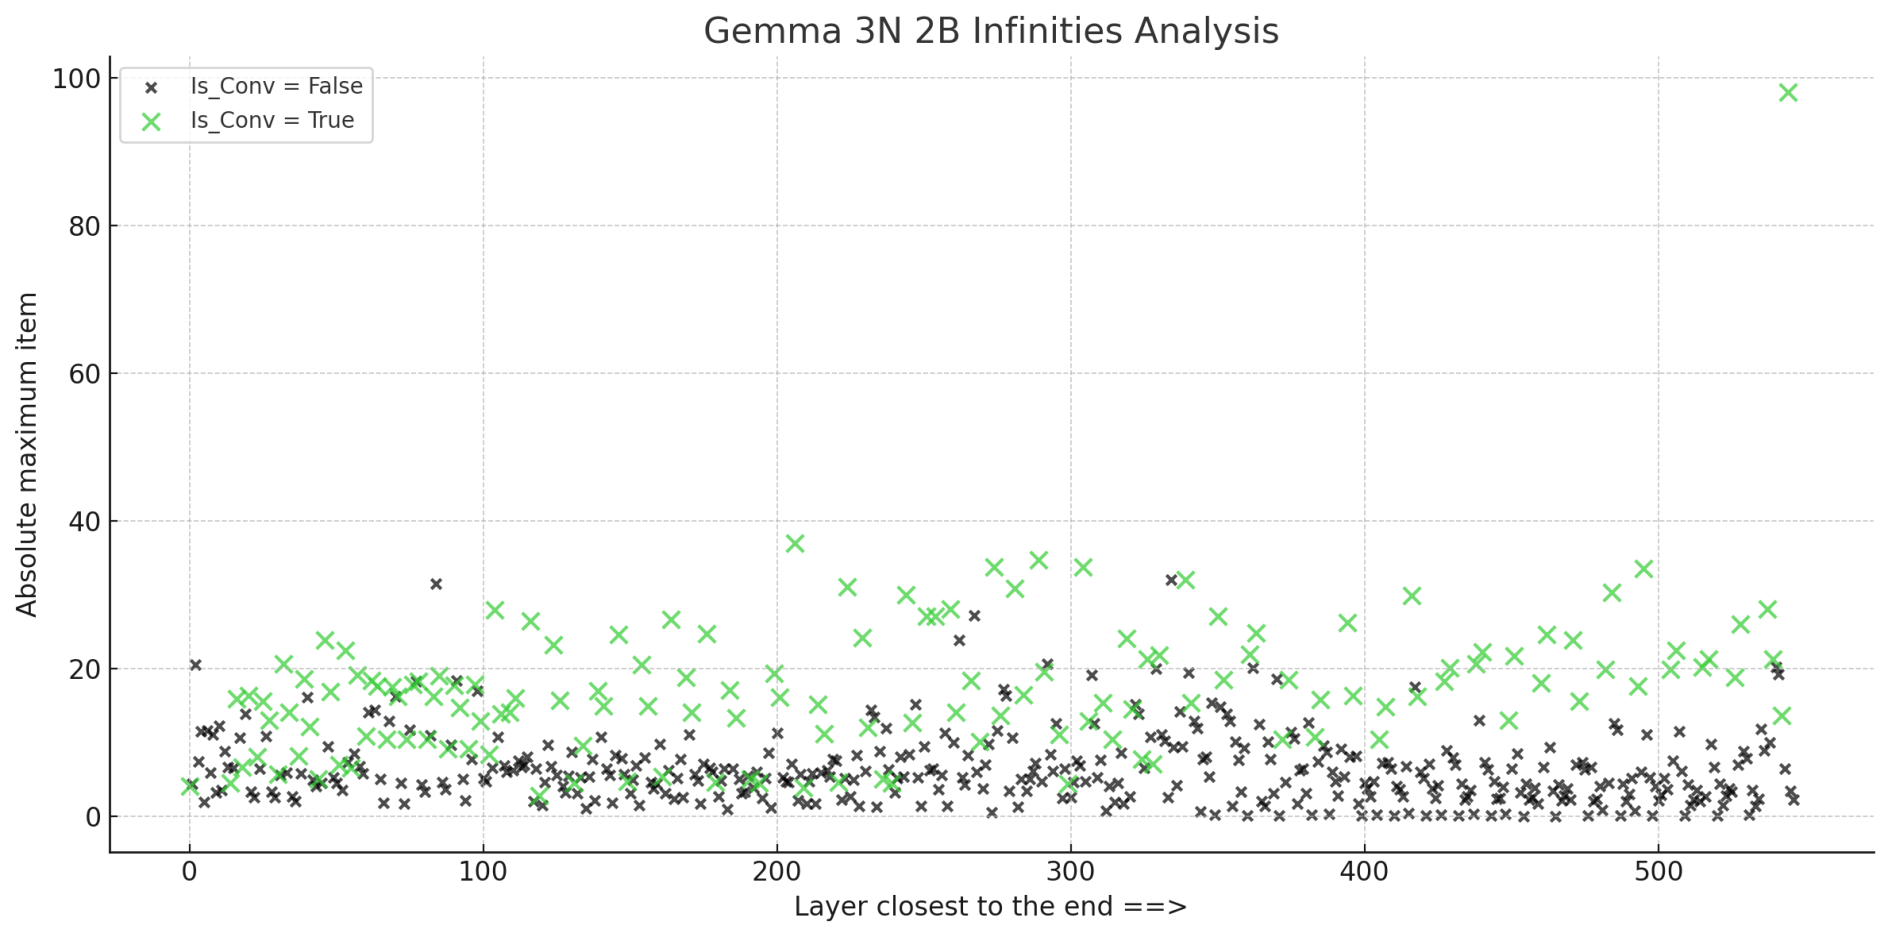
Um den Ursachen dieser Unendlichkeiten auf den Grund zu gehen, haben wir die absoluten Maximalwerte der Gewichte für Gemma 3N geplottet, und wir sehen unten Folgendes:
Wir stellen fest, dass die grünen Kreuze die Conv2D-Faltungsgewichte sind. Wir können sehen, dass die Größe der Conv2D-Schichten im Durchschnitt viel größer ist.
Unten ist eine Tabelle für Conv2D-Gewichte mit großen Beträgen. Unsere Hypothese ist, dass bei einer Conv2D-Operation große Gewichte miteinander multipliziert und aufsummiert werden, und **überschreiten leider zufällig den maximalen Bereich von float16 von 65504.** Bfloat16 ist in Ordnung, da sein maximaler Bereich 10^38 beträgt.
| Name | Max |
| -------------------------------------- | --------- |
| msfa.ffn.pw\_proj.conv.weight | 98.000000 |
| blocks.2.21.attn.key.down\_conv.weight | 37.000000 |
| blocks.2.32.pw\_exp.conv.weight | 34.750000 |
| blocks.2.30.pw\_exp.conv.weight | 33.750000 |
| blocks.2.34.pw\_exp.conv.weight | 33.750000 |
### :sparkler:Lösung für Unendlichkeiten
Die naive Lösung besteht darin, `upcasten` alle Conv2D-Gewichte auf float32 hochzusetzen (wenn bfloat16 nicht verfügbar ist). Aber das würde den VRAM-Verbrauch erhöhen. Um dem entgegenzuwirken, nutzen wir stattdessen `autocast` dynamisch, um die Gewichte und Eingaben auf float32 hochzusetzen, und führen die Akkumulation somit als Teil der Matrixmultiplikation selbst in float32 aus, ohne die Gewichte hochsetzen zu müssen.
{% hint style="success" %}
Unsloth ist das einzige Framework, das Gemma-3n-Inferenz und -Training auf float16-GPUs ermöglicht, sodass Colab-Notebooks mit kostenlosen Tesla T4s funktionieren!
{% endhint %}
### :checkered\_flag:Probleme mit Gradient Checkpointing
Wir fanden auch, dass Gemma 3Ns Vision-Encoder ziemlich einzigartig ist, da er versteckte Zustände wiederverwendet. Dies schränkt leider die Nutzung von [Unsloths Gradient Checkpointing](https://unsloth.ai/blog/long-context)ein, was den VRAM-Verbrauch erheblich hätte reduzieren können, da es nicht auf den Vision-Encoder anwendbar ist.
Allerdings konnten wir trotzdem **Unsloths automatischen Compiler** nutzen, um Gemma 3N zu optimieren!
### :cactus:Große Verluste während der Feinabstimmung
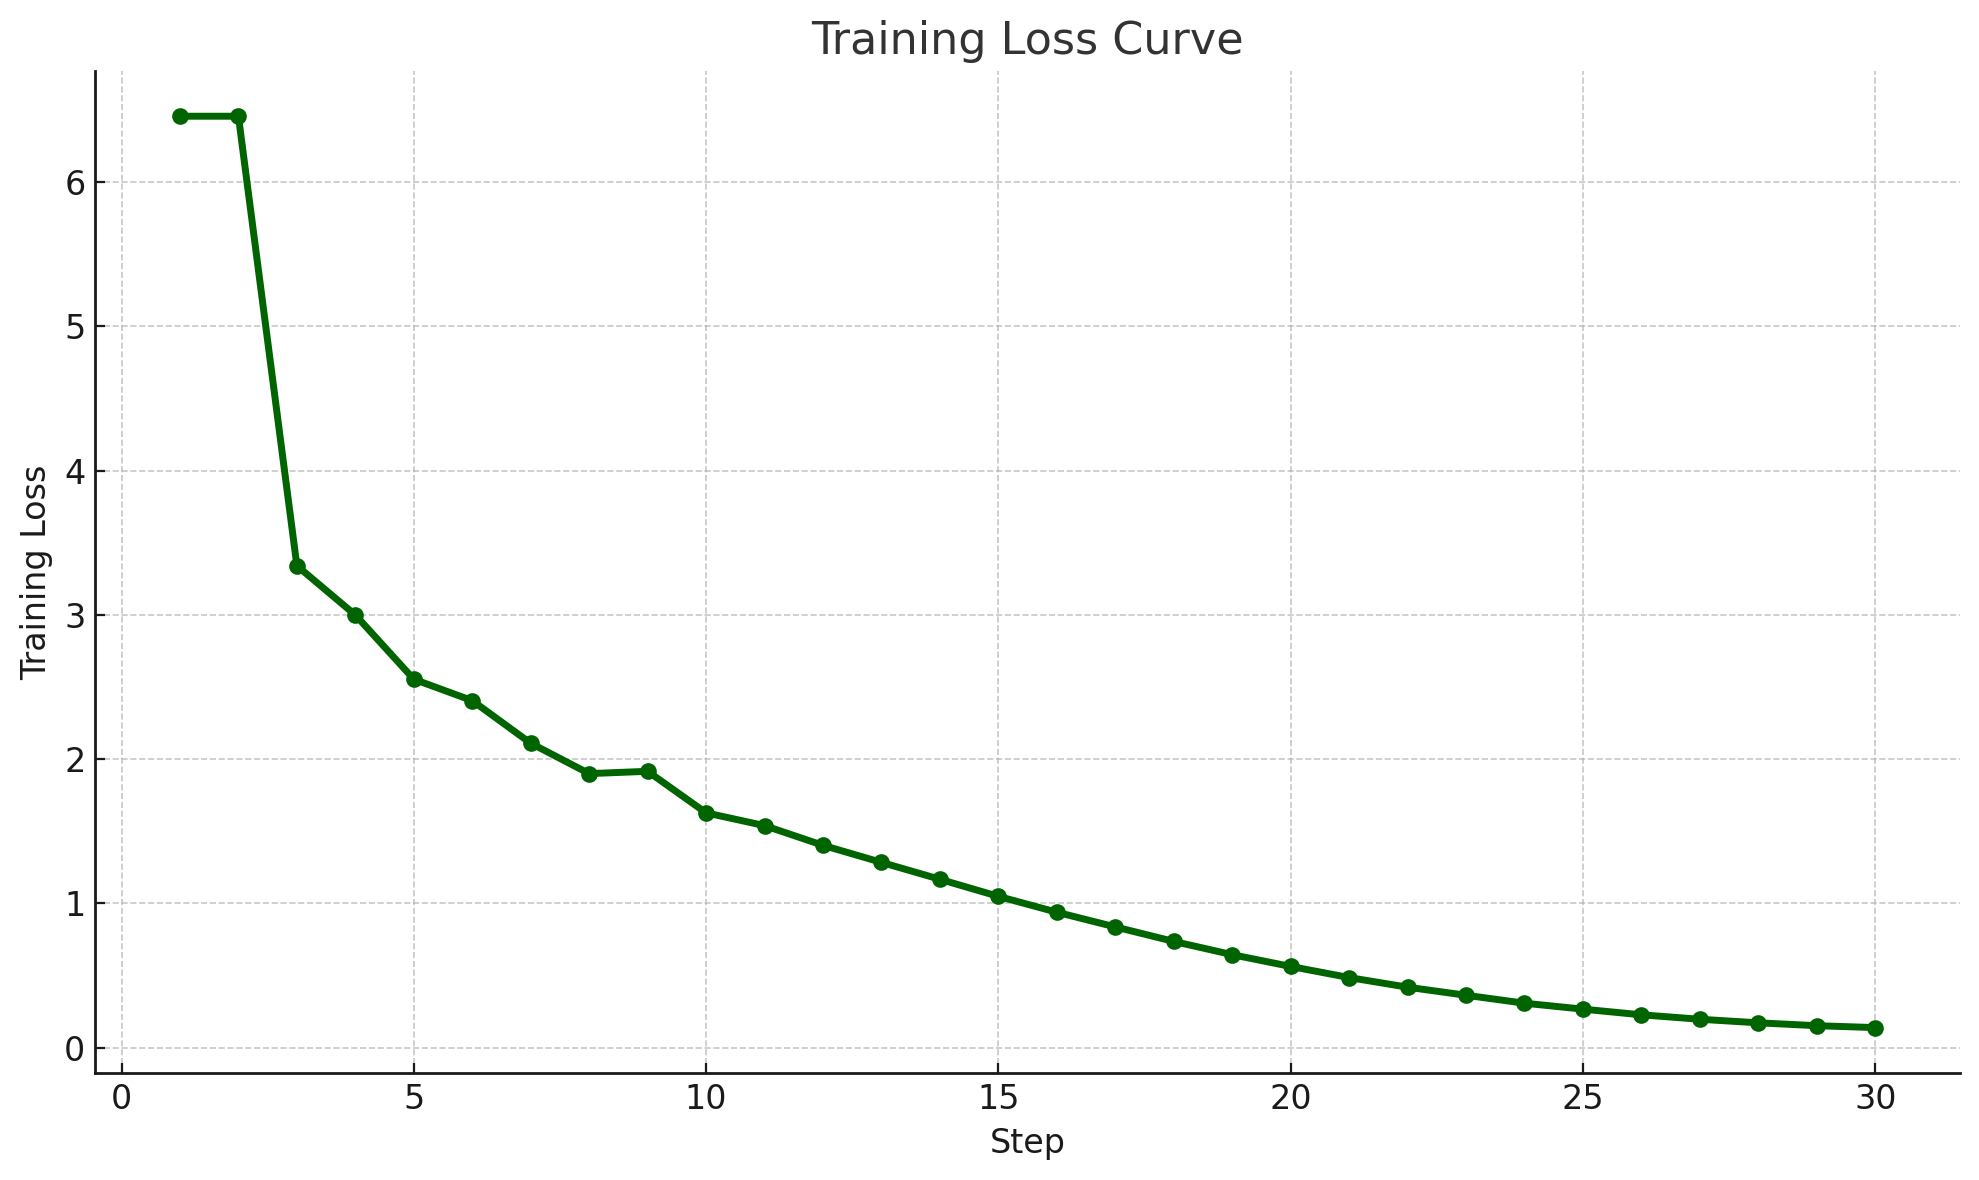
Wir fanden außerdem, dass die Verluste zu Beginn der Feinabstimmung interessanterweise sehr groß sind - im Bereich von 6 bis 7, sie nehmen aber schnell mit der Zeit ab. Wir vermuten, dass dies entweder auf 2 Möglichkeiten zurückzuführen ist:
1. Es könnte ein Implementierungsproblem geben, aber das ist unwahrscheinlich, da die Inferenz zu funktionieren scheint.
2. **Multimodale Modelle scheinen dieses Verhalten immer zu zeigen** - wir fanden, dass der Verlust von Llama 3.2 Vision bei 3 oder 4 beginnt, Pixtral bei etwa 8 und Qwen 2.5 VL ebenfalls bei etwa 4. Da Gemma 3N auch Audio enthält, könnte dies den anfänglichen Verlust verstärken. Aber das ist nur eine Hypothese. Wir stellten außerdem fest, dass die Quantisierung von Qwen 2.5 VL 72B Instruct zu extrem hohen Perplexitätswerten von etwa 30 führte, das Modell jedoch interessanterweise einwandfrei performt.
{% hint style="success" %}
**Feinabstimmung von Gemma 3n mit unserem** [**kostenloses Colab-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
{% endhint %}
## 🛠️ Technische Analyse
### Gemma 3n : MatFormer
Was also ist so besonders an Gemma 3n, fragen Sie? Es basiert auf [Matryoshka Transformer oder MatFormer](https://arxiv.org/abs/2310.07707) Architektur, was bedeutet, dass jede Transformer-Schicht/jeder Transformer-Block FFNs mit fortschreitend kleineren Größen einbettet/verschachtelt. Stellen Sie sich das wie immer kleinere Tassen vor, die ineinander gesteckt werden. Das Training erfolgt so, dass Sie zur Inferenzzeit die gewünschte Größe auswählen und den größtmöglichen Nutzen aus der Leistung der größeren Modelle ziehen können.
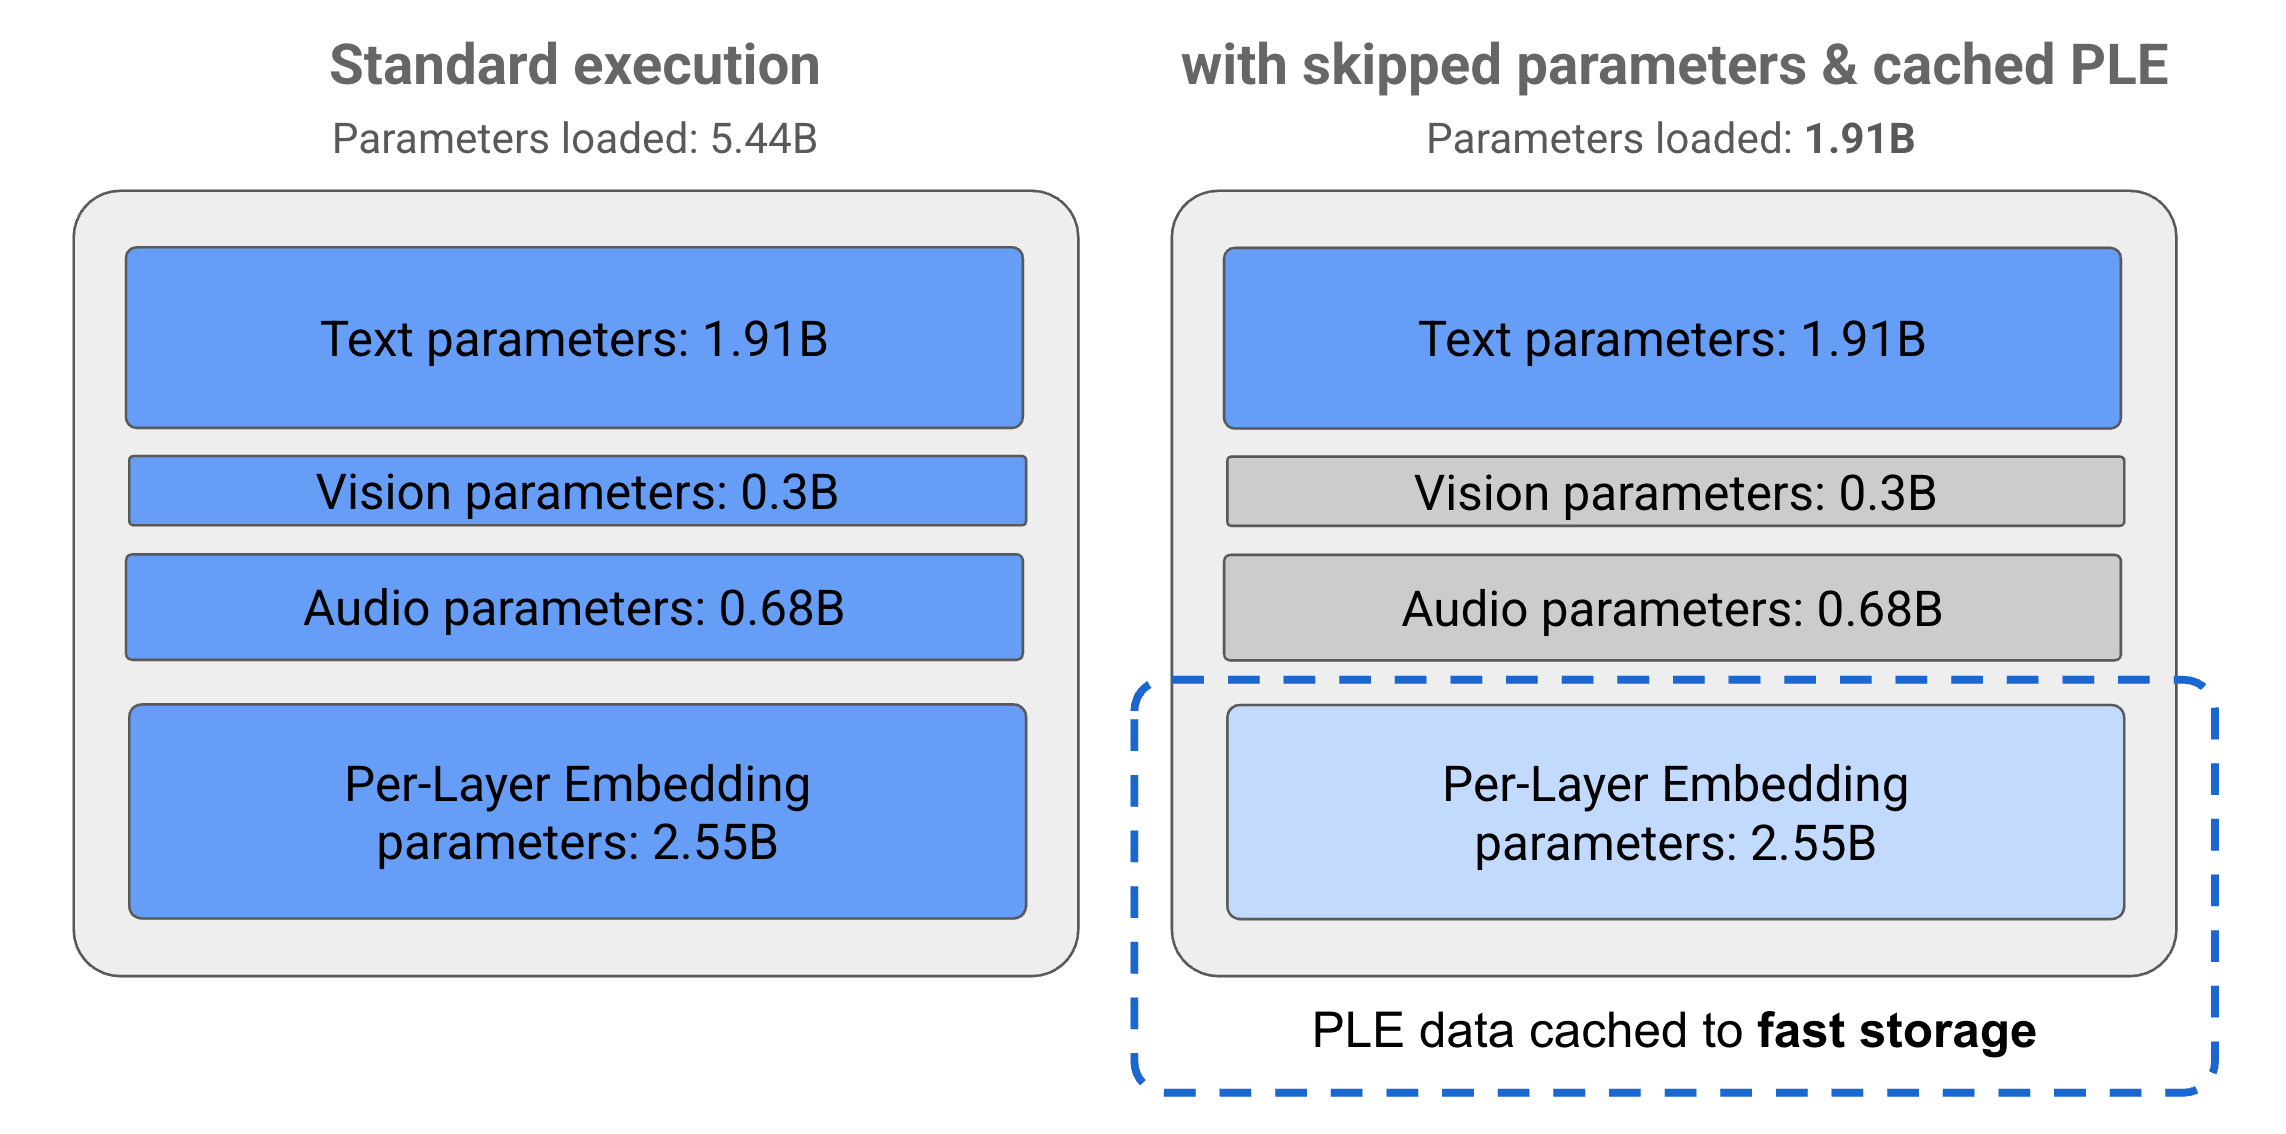
Es gibt auch Per-Layer-Embedding, das zwischengespeichert werden kann, um den Speicherverbrauch zur Inferenzzeit zu reduzieren. Das 2B-Modell (E2B) ist also ein Subnetz innerhalb des 4B-(auch 5,44B-)Modells, das sowohl durch Caching von Per-Layer-Embeddings als auch durch das Überspringen von Audio- und Vision-Komponenten erreicht wird, wobei ausschließlich der Text im Fokus steht.
Die MatFormer-Architektur wird typischerweise mit exponentiell gestaffelten Submodellen trainiert, also mit Größen `S`, `S/2, S/4, S/8` usw. in jeder der Schichten. Während des Trainings werden die Eingaben also zufällig durch einen der genannten Subblöcke geleitet, wodurch jeder Subblock die gleiche Chance erhält zu lernen. Der Vorteil besteht nun darin, dass Sie zur Inferenzzeit, wenn das Modell ein Viertel der ursprünglichen Größe haben soll, `S/4` große Subblöcke in jeder Schicht auswählen können.
Sie können sich auch entscheiden zu **Mix and Match** wo Sie zum Beispiel einen `S/4` großen Subblock einer Schicht, `S/2` großen Subblock einer anderen Schicht und `S/8` großen Subblock einer weiteren Schicht auswählen. Tatsächlich können Sie die ausgewählten Submodelle sogar je nach Eingabe selbst ändern, wenn Sie möchten. Im Grunde ist es, als würden Sie auf jeder Schicht Ihre eigene Struktur wählen. Indem Sie also nur ein Modell einer bestimmten Größe trainieren, erstellen Sie exponentiell viele Modelle kleinerer Größen. Keine Lernleistung geht verloren. Ziemlich clever, oder?
{% hint style="info" %}
**Feinabstimmung und multimodale Gemma-3n-Inferenz mit unserem** [**kostenloses Colab-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
{% endhint %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.