> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/qwen3.5/fine-tune.md).
# Qwen3.5 Fine-Tuning-Leitfaden
Erfahre, wie du Qwen3.5-LLMs mit Unsloth feinabstimmst.
Sie können jetzt feinabstimmen [Qwen3.5](/docs/de/modelle/qwen3.5.md) Modellfamilie (0.8B, 2B, 4B, 9B, 27B, 35B‑A3B, 122B‑A10B) mit [**Unsloth**](https://github.com/unslothai/unsloth). Die Unterstützung umfasst sowohl [Vision](/docs/de/modelle/qwen3.5/fine-tune.md#vision-fine-tuning), Text und [RL](#reinforcement-learning-rl) Fine-Tuning. **Qwen3.5‑35B‑A3B** - bf16 LoRA funktioniert mit **74 GB VRAM.**
* Unsloth macht das Training von Qwen3.5 **1,5× schneller** und verwendet **50 % weniger VRAM** als FA2-Setups.
* VRAM-Verbrauch von Qwen3.5 bf16 LoRA: **0,8B**: 3 GB • **2B**: 5 GB • **4B**: 10 GB • **9B**: 22 GB • **27B**: 56 GB
* Feinabstimmen **0,8B**, **2B** und **4B** bf16 LoRA über unseren **kostenlosen** **Google-Colab-Notebooks**:
| [Qwen3.5-**0,8B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(0_8B\)_Vision.ipynb) | [Qwen3.5-**2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(2B\)_Vision.ipynb) | [Qwen3.5-**4B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision.ipynb) | [Qwen3.5-4B **GRPO**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) |
| --------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------- |
* Wenn du **Reasoning beibehalten** Fähigkeit können Sie Beispiele im Reasoning-Stil mit direkten Antworten mischen (halten Sie mindestens 75 % Reasoning ein). Andernfalls können Sie es vollständig ausgeben.
* **Vollständiges Feintuning (FFT)** funktioniert ebenfalls. Beachten Sie, dass es 4x mehr VRAM verwenden wird.
* Qwen3.5 ist leistungsstark für mehrsprachiges Fine-Tuning, da es 201 Sprachen unterstützt.
* Nach dem Fine-Tuning kannst du exportieren nach [GGUF](#saving-export-your-fine-tuned-model) (für llama.cpp/Ollama/etc.) oder [vLLM](#saving-export-your-fine-tuned-model)
* [Verstärkendes Lernen](/docs/de/loslegen/reinforcement-learning-rl-guide.md) (RL) für Qwen3.5 [VLM-RL](/docs/de/loslegen/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) funktioniert auch über die Unsloth-Inferenz.
* Wir haben **A100** Colab-Notebooks für [Qwen3.5‑27B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen_3_5_27B_A100\(80GB\).ipynb) und [Qwen3.5‑35B‑A3B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_MoE.ipynb).
Wenn Sie eine ältere Version verwenden (oder lokal feinabstimmen), aktualisieren Sie zuerst:
{% columns %}
{% column width="50%" %}
Unsloth Studio:
{% code expandable="true" %}
```bash
Unsloth Studio-Update
```
{% endcode %}
{% endcolumn %}
{% column width="50%" %}
Unsloth codebasiert:
```bash
pip install --upgrade --force-reinstall --no-cache-dir unsloth unsloth_zoo
```
{% endcolumn %}
{% endcolumns %}
{% hint style="warning" %}
**Bitte verwenden Sie `transformers v5` für Qwen3.5. Ältere Versionen funktionieren nicht. Unsloth verwendet jetzt standardmäßig automatisch transformers v5 (außer in Colab-Umgebungen).**
Wenn das Training **langsamer als gewöhnlich**erscheint, liegt das daran, dass Qwen3.5 benutzerdefinierte Mamba-Triton-Kernel verwendet. Das Kompilieren dieser Kernel kann länger als normal dauern, insbesondere auf T4-GPUs.
Es wird nicht empfohlen, QLoRA-(4-Bit)-Training auf den Qwen3.5-Modellen durchzuführen, unabhängig davon, ob MoE oder dicht, aufgrund höher als normaler Quantisierungsunterschiede.
{% endhint %}
### MoE-Fine-Tuning (35B, 122B)
Für MoE-Modelle wie **Qwen3.5‑35B‑A3B / 122B‑A10B / 397B‑A17B**:
* Sie können unser [Qwen3.5‑35B‑A3B (A100)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_MoE.ipynb) Fine-Tuning-Notebook
* Unterstützt unser jüngstes \~12x schnelleres [MoE-Trainings-Update](/docs/de/grundlagen/faster-moe.md) mit >35 % weniger VRAM & \~6x längerem Kontext
* **Am besten bf16-Setups verwenden (z. B. LoRA oder vollständiges Fine-Tuning)** (MoE QLoRA 4‑Bit wird aufgrund von BitsandBytes-Einschränkungen nicht empfohlen).
* Unsloths MoE-Kernel sind standardmäßig aktiviert und können verschiedene Backends verwenden; Sie können wechseln mit `UNSLOTH_MOE_BACKEND`.
* Das Fine-Tuning der Router-Schicht ist aus Stabilitätsgründen standardmäßig deaktiviert.
* Qwen3.5‑122B‑A10B - bf16 LoRA funktioniert mit 256 GB VRAM. Wenn Sie Multi-GPUs verwenden, fügen Sie `device_map = "balanced"` hinzu oder folgen Sie unserem [Multi-GPU-Leitfaden](/docs/de/grundlagen/multi-gpu-training-with-unsloth.md).
### Schnellstart
#### 🦥 Unsloth Studio-Leitfaden
Qwen3.5 kann ausgeführt und feinabgestimmt werden in [Unsloth Studio](/docs/de/neu/studio.md), unserer neuen Open-Source-Web-UI für lokale KI. Mit Unsloth Studio können Sie Modelle lokal auf **macOS, Windows**, Linux und:
{% columns %}
{% column %}
* [LLMs trainieren](/docs/de/neu/studio.md#no-code-training) 2x schneller mit 70 % weniger VRAM
* Suchen, herunterladen, [GGUFs ausführen](/docs/de/neu/studio.md#run-models-locally) und Safetensor-Modelle
* [**Selbstheilend** Tool-Aufrufe](/docs/de/neu/studio.md#execute-code--heal-tool-calling) + **Websuche**
* [**Codeausführung**](/docs/de/neu/studio.md#run-models-locally) (Python, Bash)
* [Automatische Inferenz](https://unsloth.ai/docs/desktop#feature-deep-dive) Abstimmung der Parameter (Temp., Top-p usw.)
* Schnelle CPU- + GPU-Inferenz über llama.cpp
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% stepper %}
{% step %}
#### Unsloth installieren
Führen Sie dies in Ihrem Terminal aus:
**macOS, Linux, WSL:**
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
**Windows PowerShell:**
```bash
irm https://unsloth.ai/install.ps1 | iex
```
{% hint style="success" %}
**Die Installation geht schnell und dauert ca. 1–2 Min.**
{% endhint %}
{% endstep %}
{% step %}
#### Unsloth starten
**macOS, Linux, WSL und Windows:**
```bash
unsloth studio -H 0.0.0.0 -p 8888
```
**Dann öffnen Sie `http://localhost:8888` in Ihrem Browser.**
{% endstep %}
{% step %}
#### Trainieren Sie Qwen3.5
Beim ersten Start musst du ein Passwort erstellen, um dein Konto zu sichern, und dich später erneut anmelden. Dann siehst du einen kurzen Einrichtungsassistenten, um ein Modell, einen Datensatz und grundlegende Einstellungen auszuwählen. Du kannst ihn jederzeit überspringen.
Suchen Sie in der Suchleiste nach Qwen3.5 und wählen Sie das gewünschte Modell und den Datensatz aus. Passen Sie anschließend Ihre Hyperparameter und die Kontextlänge nach Wunsch an.
{% endstep %}
{% step %}
#### Trainingsfortschritt überwachen
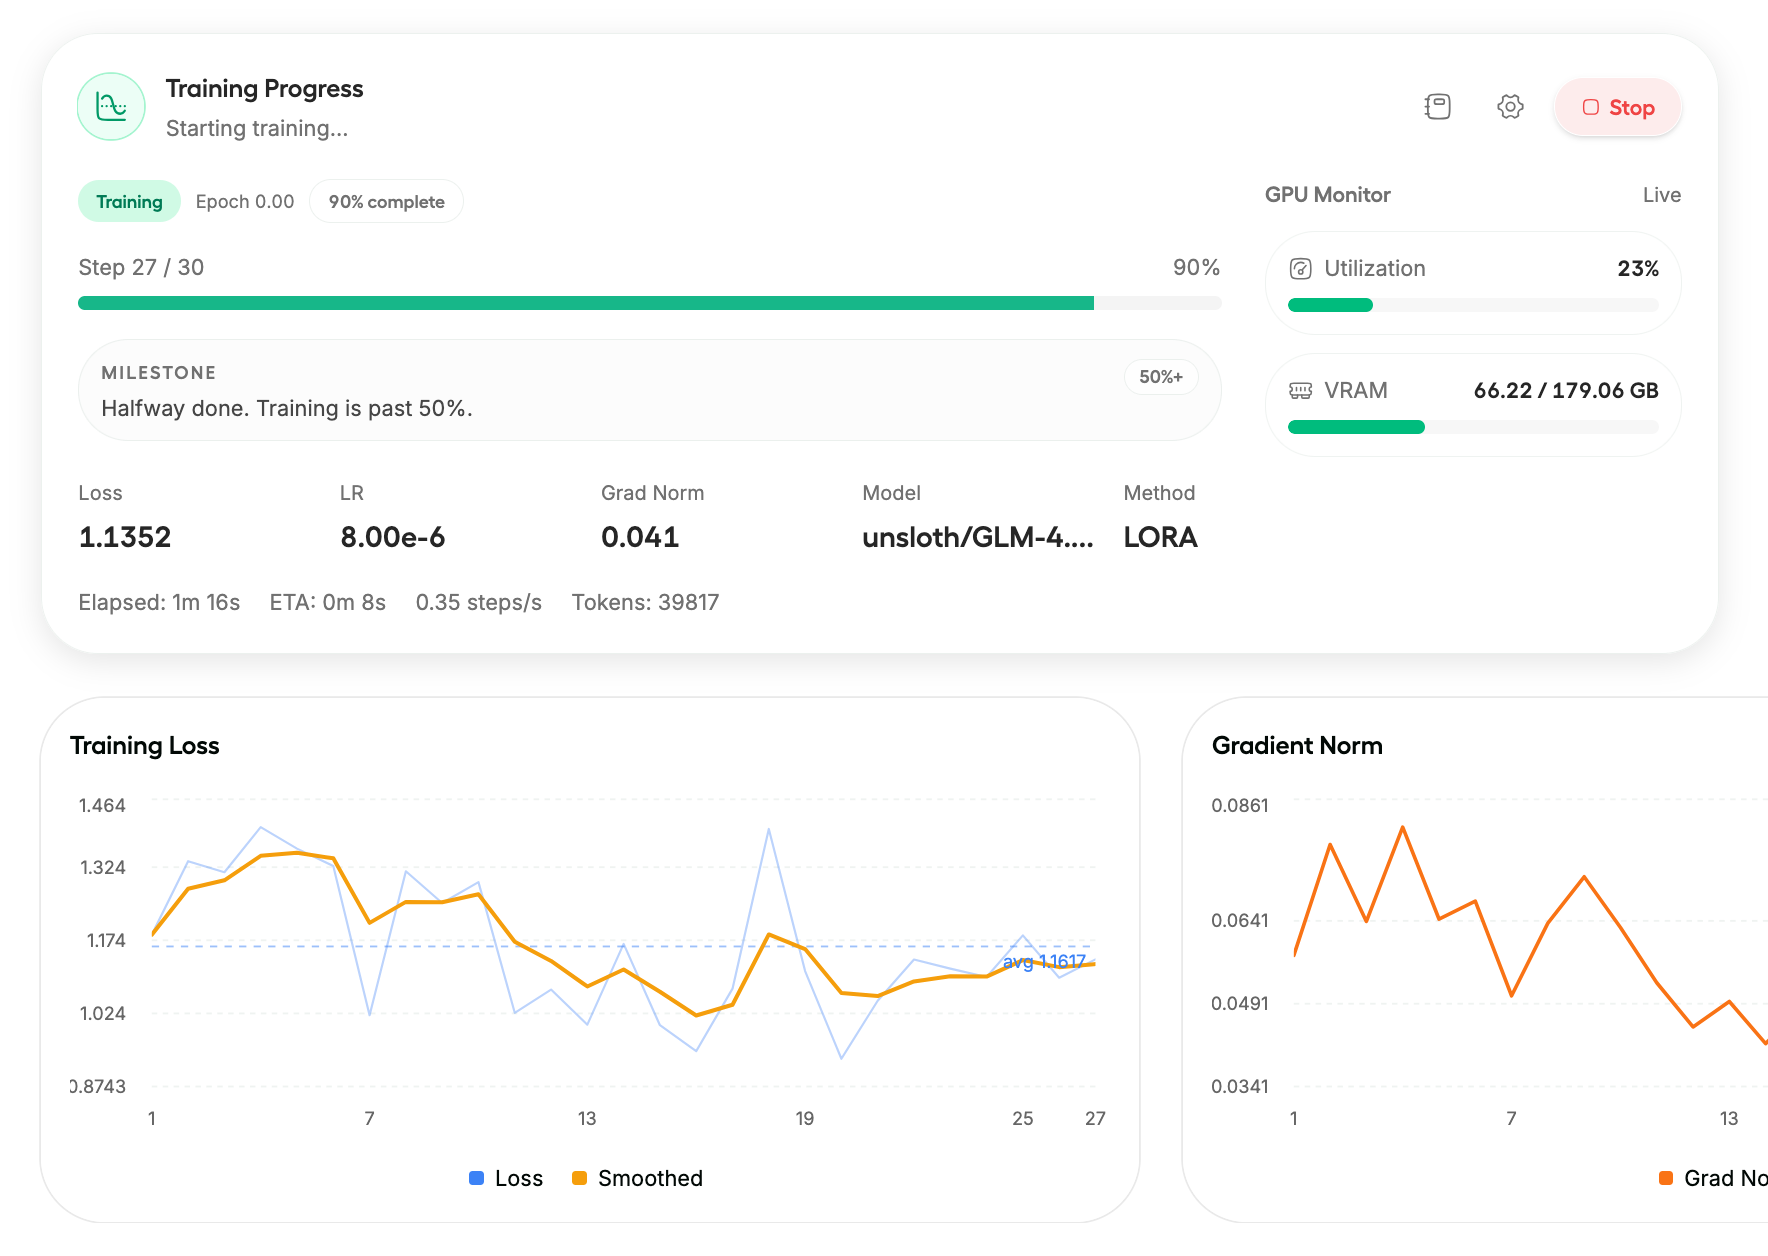
Nachdem du auf Training starten geklickt hast, kannst du den Trainingsfortschritt des Modells überwachen und beobachten. Der Trainings-Loss sollte stetig sinken.\
Sobald der Vorgang abgeschlossen ist, wird das Modell automatisch gespeichert.
{% endstep %}
{% step %}
#### Exportiere dein feinabgestimmtes Modell
Sobald du fertig bist, kannst du das Modell mit Unsloth Studio in GGUF-, Safetensor- usw. Formate exportieren.
{% endstep %}
{% endstepper %}
#### Unsloth Core (codebasiert):
Unten ist ein minimales SFT-Rezept (funktioniert für „nur-Text“-Fine-Tuning). Siehe auch unseren [Vision-Fine-Tuning](/docs/de/grundlagen/vision-fine-tuning.md) Abschnitt.
{% hint style="info" %}
Qwen3.5 ist ein „Causal Language Model mit Vision Encoder“ (es ist ein einheitliches VLM), stellen Sie also sicher, dass die üblichen Vision-Abhängigkeiten installiert sind (`torchvision`, `pillow`) falls nötig, und halten Sie Transformers auf dem neuesten Stand. Verwenden Sie die neueste Transformers-Version für Qwen3.5.
**Wenn du** [**GRPO**](/docs/de/loslegen/reinforcement-learning-rl-guide.md)**, funktioniert es in Unsloth, wenn du die schnelle vLLM-Inferenz deaktivierst und stattdessen die Unsloth-Inferenz verwendest. Folge unseren** [**Vision-RL**](/docs/de/loslegen/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) **Notebook-Beispielen.**
{% endhint %}
{% code expandable="true" %}
```python
from unsloth import FastLanguageModel
import torch
from datasets import load_dataset
from trl import SFTTrainer, SFTConfig
max_seq_length = 2048 # klein anfangen; nach erfolgreichem Test erhöhen
# Beispiel-Datensatz (durch Ihren ersetzen). Benötigt eine "text"-Spalte.
url = "https://huggingface.co/datasets/laion/OIG/resolve/main/unified_chip2.jsonl"
dataset = load_dataset("json", data_files={"train": url}, split="train")
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "Qwen/Qwen3.5-27B",
max_seq_length = max_seq_length,
load_in_4bit = False, # MoE QLoRA nicht empfohlen, dichtes 27B ist in Ordnung
load_in_16bit = True, # bf16/16-Bit LoRA
full_finetuning = False,
)
model = FastLanguageModel.get_peft_model(
model,
r = 16,
target_modules = [
"q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",
],
lora_alpha = 16,
lora_dropout = 0,
bias = "none",
# Das "unsloth"-Checkpointing ist für sehr langen Kontext + weniger VRAM gedacht
use_gradient_checkpointing = "unsloth",
random_state = 3407,
max_seq_length = max_seq_length,
)
trainer = SFTTrainer(
model = model,
train_dataset = dataset,
tokenizer = tokenizer,
args = SFTConfig(
max_seq_length = max_seq_length,
per_device_train_batch_size = 1,
gradient_accumulation_steps = 4,
warmup_steps = 10,
max_steps = 100,
logging_steps = 1,
output_dir = "outputs_qwen35",
optim = "adamw_8bit",
seed = 3407,
dataset_num_proc = 1,
),
)
trainer.train()
```
{% endcode %}
{% hint style="info" %}
Wenn dir der Speicher ausgeht:
* Reduziere `per_device_train_batch_size` zu **1** und/oder reduziere `max_seq_length`.
* Behalte `use_`[`gradient_checkpointing`](/docs/de/blog/500k-context-length-fine-tuning.md#unsloth-gradient-checkpointing-enhancements)`="unsloth"` aktiviert (es ist dafür ausgelegt, den VRAM-Verbrauch zu reduzieren und die Kontextlänge zu erweitern).
{% endhint %}
**Ladebeispiel für MoE (bf16 LoRA):**
```python
import os
import torch
from unsloth import FastModel
model, tokenizer = FastModel.from_pretrained(
model_name = "unsloth/Qwen3.5-35B-A3B",
max_seq_length = 2048,
load_in_4bit = False, # MoE QLoRA nicht empfohlen, dichtes 27B ist in Ordnung
load_in_16bit = True, # bf16/16-Bit LoRA
full_finetuning = False,
)
```
Sobald es geladen ist, fügst du LoRA-Adapter hinzu und trainierst ähnlich wie im obigen SFT-Beispiel.
### Vision-Feintuning
Unsloth unterstützt [Vision-Fine-Tuning](/docs/de/grundlagen/vision-fine-tuning.md) für die multimodalen Qwen3.5-Modelle. Verwenden Sie die untenstehenden Qwen3.5-Notebooks und ändern Sie die jeweiligen Modellnamen in Ihr gewünschtes Qwen3.5-Modell.
| [Qwen3.5-**0,8B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(0_8B\)_Vision.ipynb) | [Qwen3.5-**2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(2B\)_Vision.ipynb) | [Qwen3.5-**4B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision.ipynb) | Qwen3.5-**9B** |
| --------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- | -------------- |
* [Qwen3-VL GRPO/GSPO-RL-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) (Modellnamen zu Qwen3.5-4B usw. ändern)
**Vision deaktivieren / Nur-Text-Fine-Tuning:**
Um Vision-Modelle feinabzustimmen, können Sie jetzt auswählen, welche Teile des Modells Sie feinabstimmen möchten. Sie können nur die Vision-Schichten, nur die Sprachschichten oder die Attention-/MLP-Schichten feinabstimmen! Standardmäßig sind alle aktiviert!
{% code expandable="true" %}
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = True, # False, wenn die Vision-Schichten nicht fine-getunt werden sollen
finetune_language_layers = True, # False, wenn die Sprachschichten nicht fine-getunt werden sollen
finetune_attention_modules = True, # False, wenn die Attention-Schichten nicht fine-getunt werden sollen
finetune_mlp_modules = True, # False, wenn die MLP-Schichten nicht fine-getunt werden sollen
r = 16, # Je größer, desto höher die Genauigkeit, aber möglicherweise Overfitting
lora_alpha = 16, # Empfohlen: alpha == r, mindestens
lora_dropout = 0,
bias = "none",
random_state = 3407,
use_rslora = False, # Wir unterstützen rank-stabilisiertes LoRA
loftq_config = None, # Und LoftQ
target_modules = "all-linear", # Jetzt optional! Kann bei Bedarf eine Liste angegeben werden
modules_to_save=[
"lm_head",
"embed_tokens",
],
)
```
{% endcode %}
Um Qwen3.5 mit mehreren Bildern feinabzustimmen oder zu trainieren, sehen Sie unseren [**Leitfaden für Multi-Bild-Vision**](/docs/de/grundlagen/vision-fine-tuning.md#multi-image-training)**.**
### Reinforcement Learning (RL)
Sie können Qwen3.5 jetzt mit RL, GSPO, GRPO usw. mit [unserem kostenlosen Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb):
{% embed url="" %}
Sie können Qwen3.5-RL mit Unsloth ausführen, obwohl es von vLLM nicht unterstützt wird, indem Sie `fast_inference=False` beim Laden des Modells setzt:
```python
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Qwen3.5-4B",
fast_inference=False,
)
```
### Speichern / Export des feinabgestimmten Modells
Du kannst unsere speziellen Inferenz- / Bereitstellungsanleitungen für [Unsloth Studio](/docs/de/neu/studio/export.md), [llama.cpp](/docs/de/grundlagen/inference-and-deployment/saving-to-gguf.md), [vLLM](/docs/de/grundlagen/inference-and-deployment/vllm-guide.md), [llama-server](/docs/de/grundlagen/inference-and-deployment/llama-server-and-openai-endpoint.md), [Ollama](/docs/de/grundlagen/inference-and-deployment/saving-to-ollama.md).
#### Als GGUF speichern
Unsloth unterstützt das direkte Speichern als GGUF:
```python
model.save_pretrained_gguf("directory", tokenizer, quantization_method = "q4_k_m")
model.save_pretrained_gguf("directory", tokenizer, quantization_method = "q8_0")
model.save_pretrained_gguf("directory", tokenizer, quantization_method = "f16")
```
Oder GGUFs zu Hugging Face hochladen:
```python
model.push_to_hub_gguf("hf_username/directory", tokenizer, quantization_method = "q4_k_m")
model.push_to_hub_gguf("hf_username/directory", tokenizer, quantization_method = "q8_0")
```
Wenn sich das exportierte Modell in einer anderen Laufzeitumgebung schlechter verhält, markiert Unsloth die häufigste Ursache: **falsche Chatvorlage / EOS-Token zur Inferenzzeit** (du musst dieselbe Chatvorlage verwenden, mit der du trainiert hast).
#### In vLLM speichern
{% hint style="warning" %}
vLLM-Version `0.16.0` unterstützt Qwen3.5 nicht. Warten Sie bis `0.170` oder probieren Sie die Nightly-Version aus.
{% endhint %}
Um für vLLM in 16-Bit zu speichern, verwenden Sie:
{% code overflow="wrap" %}
```python
model.save_pretrained_merged("finetuned_model", tokenizer, save_method = "merged_16bit")
## ODER auf HuggingFace hochladen:
model.push_to_hub_merged("hf/model", tokenizer, save_method = "merged_16bit", token = "")
```
{% endcode %}
Um nur die LoRA-Adapter zu speichern, verwenden Sie entweder:
```python
model.save_pretrained("finetuned_lora")
tokenizer.save_pretrained("finetuned_lora")
```
Oder verwenden Sie unsere integrierte Funktion:
{% code overflow="wrap" %}
```python
model.save_pretrained_merged("finetuned_model", tokenizer, save_method = "lora")
## ODER auf HuggingFace hochladen
model.push_to_hub_merged("hf/model", tokenizer, save_method = "lora", token = "")
```
{% endcode %}
Für weitere Details lies unsere Inferenzanleitungen:
{% columns %}
{% column width="50%" %}
{% content-ref url="/pages/03532de69dfe0230fe5114e809721d8b7dd74ca6" %}
[Inferenz & Bereitstellung](/docs/de/grundlagen/inference-and-deployment.md)
{% endcontent-ref %}
{% content-ref url="/pages/9cfeafb2cc359999e3a7f6ba6ffa5468e4752653" %}
[GGUF & llama.cpp](/docs/de/grundlagen/inference-and-deployment/saving-to-gguf.md)
{% endcontent-ref %}
{% endcolumn %}
{% column width="50%" %}
{% content-ref url="/pages/13c9d0063a9732a68734b74792f3e30153873bf4" %}
[Model Export](/docs/de/neu/studio/export.md)
{% endcontent-ref %}
{% content-ref url="/pages/af094159d1c157db0d9afc00bd98b849fcdb8f0c" %}
[vLLM](/docs/de/grundlagen/inference-and-deployment/vllm-guide.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/qwen3.5/fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.