> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/mtp.md).
# Wie man MTP-Modelle ausführt: Leitfaden zur Multi-Token-Prognose
MTP, oder Multi-Token Prediction, beschleunigt die Inferenz, indem ein Modell mehrere kommende Tokens auf einmal vorhersagt, statt pro Schritt nur ein Token zu erzeugen. Dadurch wird eine schnellere Inferenz ohne Genauigkeitsverlust ermöglicht, und es ist besonders effektiv auf GPUs. In diesem Leitfaden erfahren Sie, wie Sie MTP-Modelle wie [Gemma 4](/docs/de/modelle/gemma-4.md) oder [Qwen3.8](/docs/de/modelle/qwen3.8.md) auf Ihrem lokalen Gerät verwenden.
MTP sagt mehrere zukünftige Tokens voraus, die das Hauptmodell parallel überprüft. Dadurch werden die Vorwärtsdurchläufe bei der Generierung reduziert, was die Ausgabe beschleunigt, während die Qualität erhalten bleibt, da nur verifizierte Tokens behalten werden.
Beim Ausführen von [GGUFs](/docs/de/grundlagen/dynamic-3.0-ggufs.md) kann MTP die Generierung **um etwa 1,4× bis 2,2× schneller machen**. Dichte Modelle wie Gemma-4-31B profitieren am meisten und erreichen **>1,4× Beschleunigung** gegenüber dem Original. Die Zugewinne sind auf Geräten mit niedrigerer Speicherbandbreite, etwa älteren Macs, geringer. Sie können MTP-Modelle direkt in [der Benutzeroberfläche von Unsloth Studio](/docs/de/neu/studio.md) oder llama.cpp ausführen.
{% hint style="info" %}
**MTP benötigt mehr Speicher als Standard**, planen Sie also etwa 2 GB zusätzlichen RAM-/VRAM-Spielraum ein.
{% endhint %}
Gemma 4 MTPQwen3.6 MTP
Wir haben festgestellt `--spec-draft-n-max 2` ist jedoch der beste Ausgangspunkt, **gehen Sie nicht davon aus, `2` dass**optimal ist, da die Leistung von der Hardware abhängt. Probieren Sie jeden Wert von `1` bis `6` und verwenden Sie den, der für Ihr System am schnellsten ist. Unsloth Studio stellt automatisch die idealen MTP-Einstellungen ein, optimiert für Ihre spezifische Hardware (Mac, CPU, GPU usw.) – Sie können sie später noch ändern.
### Gemma 4 MTP
Google DeepMind hat MTP getrennt vom ursprünglichen [Gemma 4](/docs/de/modelle/gemma-4/qat.md) Modellen trainiert, einschließlich für [QAT-Varianten](/docs/de/modelle/gemma-4/qat.md). Im Gegensatz zu Qwen veröffentlichte Google spezielle MTP-Varianten unter dem `assistant` Namen. Für die besten Ergebnisse laden wir nur 3 Präzisionsoptionen hoch: **8-Bit** und **16-Bit** (BF16, F16). Für QAT haben wir das [intelligente 4-Bit-Wiederherstellungsverfahren](/docs/de/modelle/gemma-4/qat.md#qat-analysis) verwendet, wie wir es für Gemma-4-QAT-Quants gemacht haben, sodass die MTP-Quants ebenfalls intelligent aus 4-Bit abgeleitet sind.
Wir haben `mtp-` mit Präfix versehenen GGUFs in jedes Repo hochgeladen, sodass Sie nur die **regulären originalen Gemma-4-GGUFs** benötigen, kein separates Repo ist erforderlich. Sie können auf Gemma zugreifen [MTP-Modelle hier](https://huggingface.co/collections/unsloth/gemma-4) und sie können jetzt in [Unsloth](#unsloth-studio-mtp-guide) ausgeführt werden. Wir haben Gemma-4-QAT mit MTP getestet, und es läuft 1,5x - 2,2x schneller:
**Tabelle: MTP-Hardwareanforderungen** (Einheiten = Gesamtspeicher: RAM + VRAM oder Unified Memory)
| Gemma 4 Variante | 4-Bit | 8-Bit | BF16 / FP16 |
| ---------------- | -------: | -------: | ----------: |
| **E2B** | 5 GB | 6–9 GB | 11 GB |
| **E4B** | 6,5–7 GB | 10–13 GB | 17 GB |
| **12B Unified** | 8–9 GB | 14–15 GB | 26 GB |
| **26B A4B** | 17–18 GB | 29–31 GB | 53 GB |
| **31B** | 18–21 GB | 35–39 GB | 63 GB |
{% hint style="warning" %}
**Gemma 4 MTP wird in** [**Unsloth Studio**](#unsloth-studio-mtp-guide) **automatisch aktiviert. Sie müssen nur die regulären originalen Gemma-4-GGUFs herunterladen.** Wir haben die Gemma-4-GGUF-Dateien aktualisiert, um eine zusätzliche MTP-Datei in einem separaten Ordner innerhalb des GGUF-Pakets zu enthalten, sodass kein separater Gemma-4-Assistenten-GGUF heruntergeladen werden muss.
Das einzige Modell, das noch ein separates MTP-GGUF benötigt, ist Qwen3.6.
{% endhint %}
Um die Gemma-4-MTP-Modelle auszuführen, folgen Sie entweder den Schritten für [Unsloth Studio](#unsloth-studio-mtp-guide) oder [llama.cpp](#llama.cpp-mtp-guide).
🦥 In Unsloth Studio ausführen🦙 In llama.cpp ausführen
damit das Folgende einfach funktioniert (dies verwendet die 8-Bit-Variante)
{% code overflow="wrap" %}
```bash
llama-server \
-hf unsloth/gemma-4-31B-it-GGUF \
--spec-type draft-mtp \
--spec-draft-n-max 4
```
{% endcode %}
### Qwen3.6 MTP
Qwen hat MTP direkt innerhalb der [Qwen3.6](/docs/de/modelle/qwen3.6.md) und [Qwen3.5](/docs/de/modelle/qwen3.5.md) Modellen trainiert. Dadurch kann Qwen3.6 27B MTP 160 Tokens/s erreichen und Qwen3.6 35B-A3B 240 Tokens/s auf einer RTX-6000-GPU erreichen. GGUF-Uploads:
| [Qwen3.6-27B-MTP-GGUF](https://huggingface.co/unsloth/Qwen3.6-27B-MTP-GGUF) | [Qwen3.6-35B-A3B-MTP-GGUF](https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MTP-GGUF) |
| --------------------------------------------------------------------------- | ----------------------------------------------------------------------------------- |
**Tabelle: MTP-Hardwareanforderungen** (Einheiten = Gesamtspeicher: RAM + VRAM oder Unified Memory)
| Qwen3.6 | 3-Bit | 4-Bit | 6-Bit | 8-Bit | BF16 |
|---|
| 27B | 16 GB | 19 GB | 25 GB | 31 GB | 56 GB |
| 35B-A3B | 18 GB | 24 GB | 31 GB | 39 GB | 71 GB |
Unten finden Sie Diagramme des Inferenzdurchsatzes für MTP vs. ohne MTP:
Wir haben außerdem [MTP-GGUFs hochgeladen](https://huggingface.co/unsloth/models?search=mtp) für die [Qwen3.5](/docs/de/modelle/qwen3.5.md) **Modellfamilie** einschließlich: 0.8B, 2B, 4B, 9B, 27B, 35B-A3B, 122B-A10B und 397B-A17B. Llama.cpp verbessert die MTP-Leistung kontinuierlich, erwarten Sie also, dass es mit der Zeit schneller wird!
Um die Qwen-MTP-Modelle auszuführen, folgen Sie entweder den Schritten für [Unsloth Studio](#unsloth-studio-mtp-guide) oder [llama.cpp](#llama.cpp-mtp-guide).
### 🦥 Unsloth-Studio-MTP-Leitfaden
Unsloth Studio stellt automatisch die idealen MTP-Einstellungen ein, optimiert für Ihre spezifische Hardware (Mac, CPU, GPU usw.) – Sie können sie später noch ändern.
{% stepper %}
{% step %}
#### Unsloth installieren
Führen Sie in Ihrem Terminal aus:
**macOS, Linux, WSL:**
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
**Windows PowerShell:**
```bash
irm https://unsloth.ai/install.ps1 | iex
```
{% endstep %}
{% step %}
#### Unsloth starten
**macOS, Linux, WSL und Windows:**
```bash
unsloth studio -H 127.0.0.1 -p 8888
```
Öffnen Sie dann `http://127.0.0.1:8888` (oder Ihre spezifische URL) in Ihrem Browser.
{% endstep %}
{% step %}
#### Suchen und laden Sie das gewünschte Modell herunter
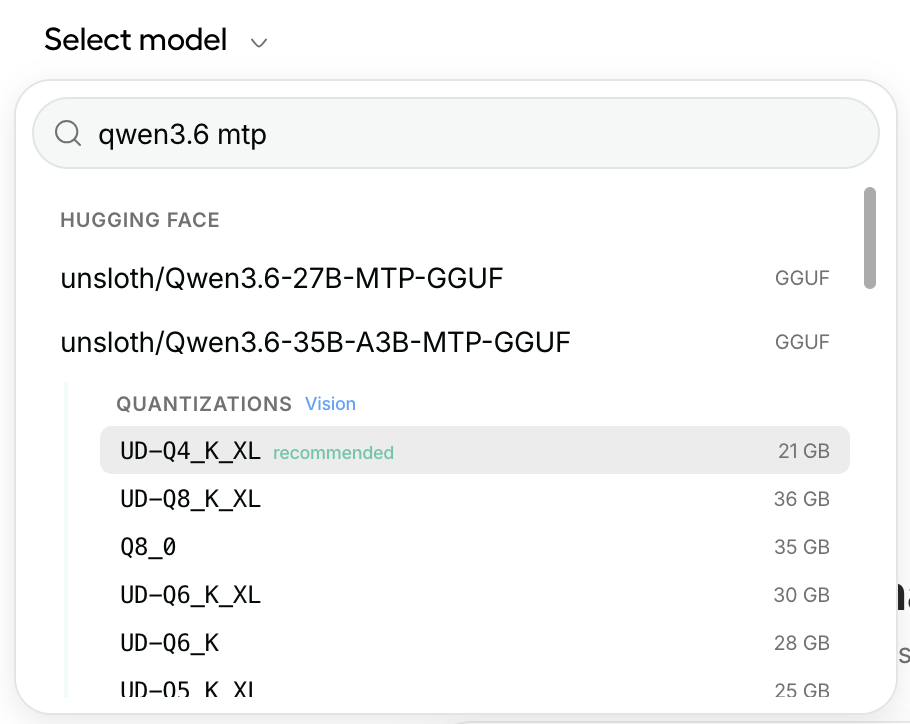
Beim ersten Start müssen Sie ein Passwort erstellen, um Ihr Konto zu sichern, und sich später erneut anmelden. Gehen Sie dann zum [Unsloth Chat](/docs/de/neu/studio/chat.md) Tab und suchen Sie in der Suchleiste nach Qwen3.6 MTP oder Gemma 4 und laden Sie das gewünschte Modell und die gewünschte Quantisierung herunter.
{% hint style="warning" %}
**Gemma 4 MTP wird in Unsloth automatisch aktiviert. Sie müssen nur das reguläre originale Gemma-4-GGUF herunterladen.** Wir haben die Gemma-4-GGUF-Dateien aktualisiert, um eine zusätzliche MTP-Datei in einem separaten Ordner innerhalb des GGUF-Pakets zu enthalten, sodass kein separater Gemma-4-Assistenten-GGUF heruntergeladen werden muss.
Das einzige Modell, das noch ein separates MTP-GGUF benötigt, ist Qwen3.6.
{% endhint %}
{% endstep %}
{% step %}
#### Führen Sie Ihr MTP-Modell aus
Inferenz- **MTP- und spekulative** Dekodierungseinstellungen sollten bei Verwendung von Unsloth Studio automatisch gesetzt werden, Sie können sie jedoch weiterhin manuell ändern. Sie können auch spekulatives Decoding, die Kontextlänge, die Chat-Vorlage und andere Einstellungen in der rechten Seitenleiste bearbeiten.
Für weitere Informationen können Sie unseren [Unsloth-Studio-Inferenzleitfaden](/docs/de/neu/studio/chat.md). Unten hat das 2-Bit-Qwen3.6-MTP-GGUF mehr als 10 Tool-Aufrufe gemacht, 10 Seiten durchsucht und Python-Code ausgeführt:
{% endstep %}
{% endstepper %}
### 🦙 Llama.cpp-MTP-Leitfaden
{% stepper %}
{% step %}
Installieren Sie die neueste Version von `llama.cpp` auf [**GitHub hier**](https://github.com/ggml-org/llama.cpp/pull/22673). Sie können auch den unten stehenden Build-Anweisungen folgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` dann wie gewohnt fortfahren – Metal-Unterstützung ist standardmäßig aktiviert.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
Wenn Sie `llama.cpp` direkt zum Laden von Modellen verwenden möchten, können Sie Folgendes tun: (:`Q4_K_XL`) ist der Quantisierungstyp. Sie können auch über Hugging Face herunterladen (Punkt 3). Das ist ähnlich wie `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen `llama.cpp` , dass es an einem bestimmten Speicherort gespeichert wird. Das Modell hat eine maximale Kontextlänge von 256K.
Befolgen Sie einen der Befehle für die jeweiligen Modelle:
Gemma 4Qwen3.6
#### Gemma 4 MTP:
Vergessen Sie nicht, **den Modellnamen zu ändern** auf Ihre gewünschte Gemma-4-Modellgröße wie Gemma-4-26B-A4B usw. anzupassen, da die folgenden Anweisungen für Gemma-4-12B gelten. Beachten Sie, dass wir einen `mtp-` mit Präfix versehenen GGUF bereitgestellt haben, sodass der folgende `-hf` Befehl MTP automatisch herunterladen und verwenden sollte.
**Denkmodus:**
```bash
export LLAMA_CACHE="unsloth/gemma-4-12b-it-GGUF"
./llama.cpp/llama-cli \
-hf unsloth/gemma-4-12b-it-GGUF:UD-Q4_K_XL \
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--spec-type draft-mtp --spec-draft-n-max 2
```
{% hint style="info" %}
Bitte beachten Sie Gemma 4s neues [Erhaltenes Denken](#thinking-enable-disable--preserve-thinking).
{% endhint %}
**Nicht-Denkmodus**:
```bash
export LLAMA_CACHE="unsloth/gemma-4-12b-it-GGUF"
./llama.cpp/llama-cli \
-hf unsloth/gemma-4-12b-it-GGUF:UD-Q4_K_XL \
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--spec-type draft-mtp --spec-draft-n-max 2 \
--chat-template-kwargs '{"enable_thinking":false}'
```
#### Qwen3.6 MTP:
Vergessen Sie nicht, **den Modellnamen zu ändern** auf Ihre gewünschte Qwen3.6-Variante wie Qwen3.6-35B-A3B oder Qwen3.5 usw. anzupassen, da die folgenden Anweisungen für Qwen3.6-27B gelten:
**Denkmodus** (Allgemeine Aufgaben)**:**
```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-MTP-GGUF"
./llama.cpp/llama-cli \
-hf unsloth/Qwen3.6-27B-MTP-GGUF:UD-Q4_K_XL \
--temp 1.0 \
--top-p 0.95 \
--top-k 20 \
--min-p 0.00 \
--spec-type draft-mtp --spec-draft-n-max 2
```
Für präzise Codierungsaufgaben ändern Sie: `temperature=0.6`
{% hint style="info" %}
Bitte beachten Sie Qwen3.6s neues [Erhaltenes Denken](#thinking-enable-disable--preserve-thinking).
{% endhint %}
**Nicht-Denkmodus** (Allgemeine Aufgaben):
```bash
export LLAMA_CACHE="unsloth/Qwen3.6-27B-MTP-GGUF"
./llama.cpp/llama-server \
-hf unsloth/Qwen3.6-27B-MTP-GGUF:UD-Q4_K_XL \
--temp 0.7 \
--top-p 0.8 \
--top-k 20 \
--presence-penalty 1.5 \
--min-p 0.00 \
--spec-type draft-mtp --spec-draft-n-max 2 \
--chat-template-kwargs '{"enable_thinking":false}'
```
{% endstep %}
{% step %}
#### Quants manuell herunterladen
Wenn Sie die Quants und die MTP-Quants manuell herunterladen möchten, können Sie das auch tun! Laden Sie das Modell über den folgenden Code herunter (nach der Installation von `pip install huggingface_hub hf_transfer`). Sie können Q4\_K\_M oder andere quantisierte Versionen wie `UD-Q4_K_XL` . Wir empfehlen, mindestens eine dynamische 2-Bit-Quantisierung zu verwenden `UD-Q2_K_XL` um Größe und Genauigkeit auszubalancieren. Wenn Downloads hängen bleiben, siehe: [Hugging Face Hub, XET-Debugging](/docs/de/grundlagen/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)
#### Gemma 4 MTP:
```bash
hf download unsloth/gemma-4-12B-it-qat-GGUF \
--local-dir unsloth/gemma-4-12B-it-qat-GGUF \
--include "*mmproj-F16*" \
--include "mtp-*" \
--include "*UD-Q4_K_XL*" # Verwenden Sie "*UD-Q2_K_XL*" für dynamische 2-Bit-Variante
```
#### Qwen3.6 MTP:
```bash
hf download unsloth/Qwen3.6-27B-MTP-GGUF \
--local-dir unsloth/Qwen3.6-27B-MTP-GGUF \
--include "*mmproj-F16*" \
--include "*UD-Q4_K_XL*" # Verwenden Sie "*UD-Q2_K_XL*" für dynamische 2-Bit-Variante
```
{% endstep %}
{% step %}
Führen Sie dann das Modell im Konversationsmodus aus:
#### Gemma 4 MTP:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/gemma-4-12B-it-qat-GGUF/gemma-4-12B-it-qat-UD-Q4_K_XL.gguf \
--mmproj unsloth/gemma-4-12B-it-qat-GGUF/mmproj-F16.gguf \
--model-draft unsloth/gemma-4-12B-it-qat-GGUF/mtp-gemma-4-12B-it.gguf \
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--spec-type draft-mtp --spec-draft-n-max 2
```
{% endcode %}
Und Sie werden Folgendes sehen – ignorieren Sie auch die Fehlermeldungen
 #### Qwen3.6 MTP:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/Qwen3.6-27B-MTP-GGUF/Qwen3.6-27B-UD-Q4_K_XL.gguf \
--mmproj unsloth/Qwen3.6-27B-MTP-GGUF/mmproj-F16.gguf \
--temp 1.0 \
--top-p 0.95 \
--min-p 0.00 \
--top-k 20 \
--spec-type draft-mtp --spec-draft-n-max 2
```
{% endcode %}
{% endstep %}
{% step %}
#### Bereitstellung des Llama-Servers
Um Gemma-4 auf llama-server bereitzustellen, verwenden Sie:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-server \
--model unsloth/gemma-4-12B-it-qat-GGUF/gemma-4-12B-it-qat-UD-Q4_K_XL.gguf \
--mmproj unsloth/gemma-4-12B-it-qat-GGUF/mmproj-F16.gguf \
--model-draft unsloth/gemma-4-12B-it-qat-GGUF/mtp-gemma-4-12B-it.gguf \
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--alias "unsloth/gemma-4-12b-it-qat-GGUF" \
--port 8001 \
--chat-template-kwargs '{"enable_thinking":true}'
```
{% endcode %}
{% endstep %}
{% endstepper %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/mtp.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.