> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/gemma-4.md).
# Gemma 4 – Wie man lokal ausführt
Führe Googles neue Gemma-4-Modelle lokal aus, einschließlich E2B, E4B, 26B A4B und 31B.
Gemma 4 ist Googles neue Modellfamilie offener Modelle von DeepMind, einschließlich **12B**, **E2B**, **E4B**, **26B-A4B**, und **31B.** Die multimodalen Modelle mit hybridem Denken unterstützen mehr als 140 Sprachen, bis zu **256K-Kontext**, und es gibt Dense- und MoE-Varianten. Gemma 4 steht unter der Apache-2.0-Lizenz und kann auf Ihrem lokalen Gerät ausgeführt werden.
**Gemma-4-12B** ist neu und bietet vereinheitlichte Unterstützung für Text, Bild und Audio. Es läuft auf **8 GB** RAM (4-Bit) oder 14 GB (8-Bit). **Gemma-4-E2B** und **E4B** unterstützen auch Bild und Audio. Läuft auf **5 GB RAM** (4-Bit) oder 15 GB (vollständiges 16-Bit) über GGUF, MLX oder NVFP4-Quants.
Gemma 4 ausführenGemma 4 feinabstimmenGemma 4 QATGemma 4 MTP
{% hint style="success" %}
**NEU:** [**Gemma 4 MTP ist da**](/docs/de/modelle/mtp.md)**! MTP ermöglicht eine 1,4- bis 2,2-mal schnellere Inferenz ohne Genauigkeitsverlust. Führen Sie MTP direkt in** [**Unsloth Studio**](/docs/de/modelle/mtp.md#unsloth-studio-mtp-guide)**.**
{% endhint %}
{% columns %}
{% column %}
**Gemma-4-26B-A4B** läuft auf **18 GB** (4-Bit) oder 28 GB (8-Bit). **Gemma-4-31B** benötigt **20 GB RAM** (4-Bit) oder 34 GB (8-Bit).
Sie können jetzt alle GGUFs ausführen, [MLX](#mlx-dynamic-quants) und Gemma 4 feinabstimmen in [Unsloth Studio](#unsloth-studio-guide) (siehe rechts).
[**QAT** Varianten](/docs/de/modelle/gemma-4/qat.md) von Gemma 4 reduzieren den Speicherbedarf um etwa das Dreifache, während die Modellqualität erhalten bleibt.
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% hint style="success" %}
**9. Juni:** [Gemma 4 MTP](/docs/de/modelle/mtp.md) ist da.
**5. Juni:** [Gemma 4 QAT](/docs/de/modelle/gemma-4/qat.md) wird veröffentlicht.
**2. Juni:** Gemma 4 12B Unified wird veröffentlicht.
**20. Apr.:** Wir haben [Gemma 4 GGUF-Benchmarks](#unsloth-gguf-benchmarks) durchgeführt, um dir bei der Auswahl der besten Quantisierung zu helfen.
{% endhint %}
### Nutzungsleitfaden
Gemma 4 glänzt bei Reasoning, Programmierung, Tool-Nutzung, langem Kontext und agentischen Workflows sowie multimodalen Aufgaben. Die kleineren Varianten E2B und E4B sind für Telefone und Laptops gedacht, während die größeren Modelle auf Systeme mit mittlerem bis hohem CPU-/VRAM-Bedarf abzielen, etwa PCs mit NVIDIA-RTX-GPUs.
| Gemma-4-Variante | Details | Am besten geeignet für |
| ---------------- | --------------------------------------------------------------------- | ------------------------------------------------------------------------ |
| **E2B** |
| Mittleres Modell für Laptops und lokale multimodale Nutzung |
| **26B-A4B** |
MoE (256K Kontext) Unterstützung: Text, Bild
| Bestes Geschwindigkeits-/Qualitätsverhältnis für die Nutzung am Computer |
| **31B** |
Dense (256K Kontext) Unterstützung: Text, Bild
| Stärkste Leistung bei langsamerer Inferenz |
**Siehe Gemma 4:** [**Leistungs-Benchmarks**](#official-gemma-benchmarks) **und** [**GGUF-Benchmarks**](#unsloth-gguf-benchmarks)**.**
**Soll ich 26B-A4B oder 31B wählen?**
* **26B-A4B** - bietet ein gutes Gleichgewicht zwischen Geschwindigkeit und Genauigkeit. Sein MoE-Design macht es schneller als 31B, mit 4B aktiven Parametern. Wählen Sie es, wenn der RAM begrenzt ist und Sie bereit sind, etwas Qualität gegen Geschwindigkeit einzutauschen.
* **31B** - derzeit das stärkste Gemma-4-Modell. Wählen Sie es für maximale Qualität, wenn Sie genügend Speicher haben und etwas langsamere Geschwindigkeiten akzeptieren können.
### Hardwareanforderungen
**Tabelle: Empfohlene Hardwareanforderungen für Gemma-4-Inferenz-GGUF** (Einheiten = Gesamtspeicher: RAM + VRAM oder Unified Memory). Sie können Gemma 4 auf macOS, NVIDIA-RTX-GPUs usw. verwenden.
| Gemma-4-Variante | 4-Bit | 8-Bit | BF16 / FP16 |
| ---------------- | -------: | -------: | ----------: |
| **E2B** | 4 GB | 5–8 GB | 10 GB |
| **E4B** | 5,5–6 GB | 9–12 GB | 16 GB |
| **12B Unified** | 7–8 GB | 13–14 GB | 25 GB |
| **26B A4B** | 16–18 GB | 28–30 GB | 52 GB |
| **31B** | 17–20 GB | 34–38 GB | 62 GB |
{% hint style="info" %}
Als Faustregel sollte Ihr gesamter verfügbarer Speicher mindestens die Größe des quantisierten Modells übersteigen, das Sie herunterladen. Falls das nicht der Fall ist, kann llama.cpp zwar weiterhin mit partiellem RAM-/Datenträger-Offload laufen, die Generierung wird jedoch langsamer sein. Außerdem benötigen Sie je nach verwendetem Kontextfenster mehr Rechenleistung.
{% endhint %}
### Empfohlene Einstellungen
Es wird empfohlen, Googles Standardparameter für Gemma 4 zu verwenden:
* `temperature = 1.0`
* `top_p = 0.95`
* `top_k = 64`
{% hint style="info" %}
Der maximale Kontext von Gemma 4 beträgt **128K** für **E2B** / **E4B** und `262,144` für **12B** / **26B A4B** / **31B**.
{% endhint %}
#### Denkmodus
Im Vergleich zu älteren Gemma-Chatvorlagen verwendet Gemma 4 die standardmäßigen **`System`**, **`Assistent`**, und **`Benutzer`** Rollen und fügt explizite Denksteuerung hinzu.
**Wie man Thinking aktiviert:**
Fügen Sie das Token **`<|think|>`** am **Anfang des System-Prompts hinzu**.
{% columns %}
{% column %}
**Denken aktiviert**
```
<|think|>
Sie sind ein sorgfältiger Coding-Assistent. Erklären Sie Ihre Antwort klar.
```
{% endcolumn %}
{% column %}
**Denken deaktiviert**
```
Sie sind ein sorgfältiger Coding-Assistent. Erklären Sie Ihre Antwort klar.
```
{% endcolumn %}
{% endcolumns %}
**Ausgabeverhalten:**
{% columns %}
{% column %}
Wenn Denken aktiviert ist, gibt das Modell vor der endgültigen Antwort seinen internen Denkkanal aus.
```
<|channel>thought
[interne Schlussfolgerung]
[endgültige Antwort]
```
{% endcolumn %}
{% column %}
Wenn Denken deaktiviert ist, können die größeren Modelle dennoch einen **leeren Gedankenblock** vor der endgültigen Antwort ausgeben.
```
<|channel>thought
[endgültige Antwort]
```
{% endcolumn %}
{% endcolumns %}
**Zum Beispiel bei "**Was ist die Hauptstadt von Frankreich?":
{% code overflow="wrap" %}
```
<|turn>system\n<|think|>\n<|turn>user\nWas ist die Hauptstadt von Frankreich?\n<|turn>model\n
```
{% endcode %}
**dann gibt es Folgendes aus:**
{% code overflow="wrap" %}
```
<|channel>thought\nDer Nutzer fragt nach der Hauptstadt von Frankreich.\nDie Hauptstadt von Frankreich ist Paris.Die Hauptstadt von Frankreich ist Paris.
```
{% endcode %}
**Regel für Multi-Turn-Chat:**
Für Mehrturn-Konversationen, **behalte im Chatverlauf nur die letzte sichtbare Antwort**. Tun Sie **nicht** frühere Gedankenblöcke nicht in den nächsten Durchlauf zurück.
{% code overflow="wrap" %}
```
<|turn>user\nWas ist 1+1?\n<|turn>model\n2\n<|turn>user\nWas ist 1+1?\n<|turn>model\n2\n<|turn>user\nWas ist 1+1?\n<|turn>model\n2\n<|turn>user\nWas ist 1+1?\n<|turn>model\n2\n
```
{% endcode %}
**Wie man Thinking deaktiviert:**
Hinweis `llama-cli` funktioniert möglicherweise nicht zuverlässig, daher verwenden Sie `llama-server` zum Deaktivieren des Reasonings:
{% hint style="warning" %}
Um [Denken/Schlussfolgern deaktivieren](#how-to-enable-or-disable-reasoning-and-thinking), verwenden Sie `--chat-template-kwargs '{"enable_thinking":false}'`
Wenn Sie auf **Windows** PowerShell bist, verwende: `--chat-template-kwargs "{\"enable_thinking\":false}"`
Verwenden Sie 'true' und 'false' austauschbar.
{% endhint %}
## Gemma-4-Tutorials ausführen
Da Gemma-4-GGUFs in mehreren Größen vorliegen, ist der empfohlene Ausgangspunkt für die kleinen Modelle 8-Bit und für die größeren Modelle [**Dynamisch**](/docs/de/grundlagen/dynamic-3.0-ggufs.md) **4-Bit**. [Gemma 4 GGUFs](https://huggingface.co/collections/unsloth/gemma-4) oder [MLX](#mlx-dynamic-quants) oder [NVFP4](#nvfp4-guide):
| [E2B](https://huggingface.co/unsloth/gemma-4-E2B-it-GGUF) | [E4B](https://huggingface.co/unsloth/gemma-4-E4B-it-GGUF) | [12b](https://huggingface.co/unsloth/gemma-4-12b-it-GGUF) | [26B-A4B](https://huggingface.co/unsloth/gemma-4-26B-A4B-it-GGUF) | [31B](https://huggingface.co/unsloth/gemma-4-31B-it-GGUF) |
| --------------------------------------------------------- | --------------------------------------------------------- | --------------------------------------------------------- | ----------------------------------------------------------------- | --------------------------------------------------------- |
🦥 Unsloth-Desktop-Leitfaden🦙 Llama.cpp-LeitfadenNVFP4-Anleitung
{% columns %}
{% column %}
**Sie können Gemma 4 kostenlos mit einer Benutzeroberfläche in unserem Notebook ausführen und trainieren:** [**Unsloth Studio**](/docs/de/neu/studio.md)✨ **Notebook:**
{% endcolumn %}
{% column %}
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
### 🦥 Unsloth-Leitfaden
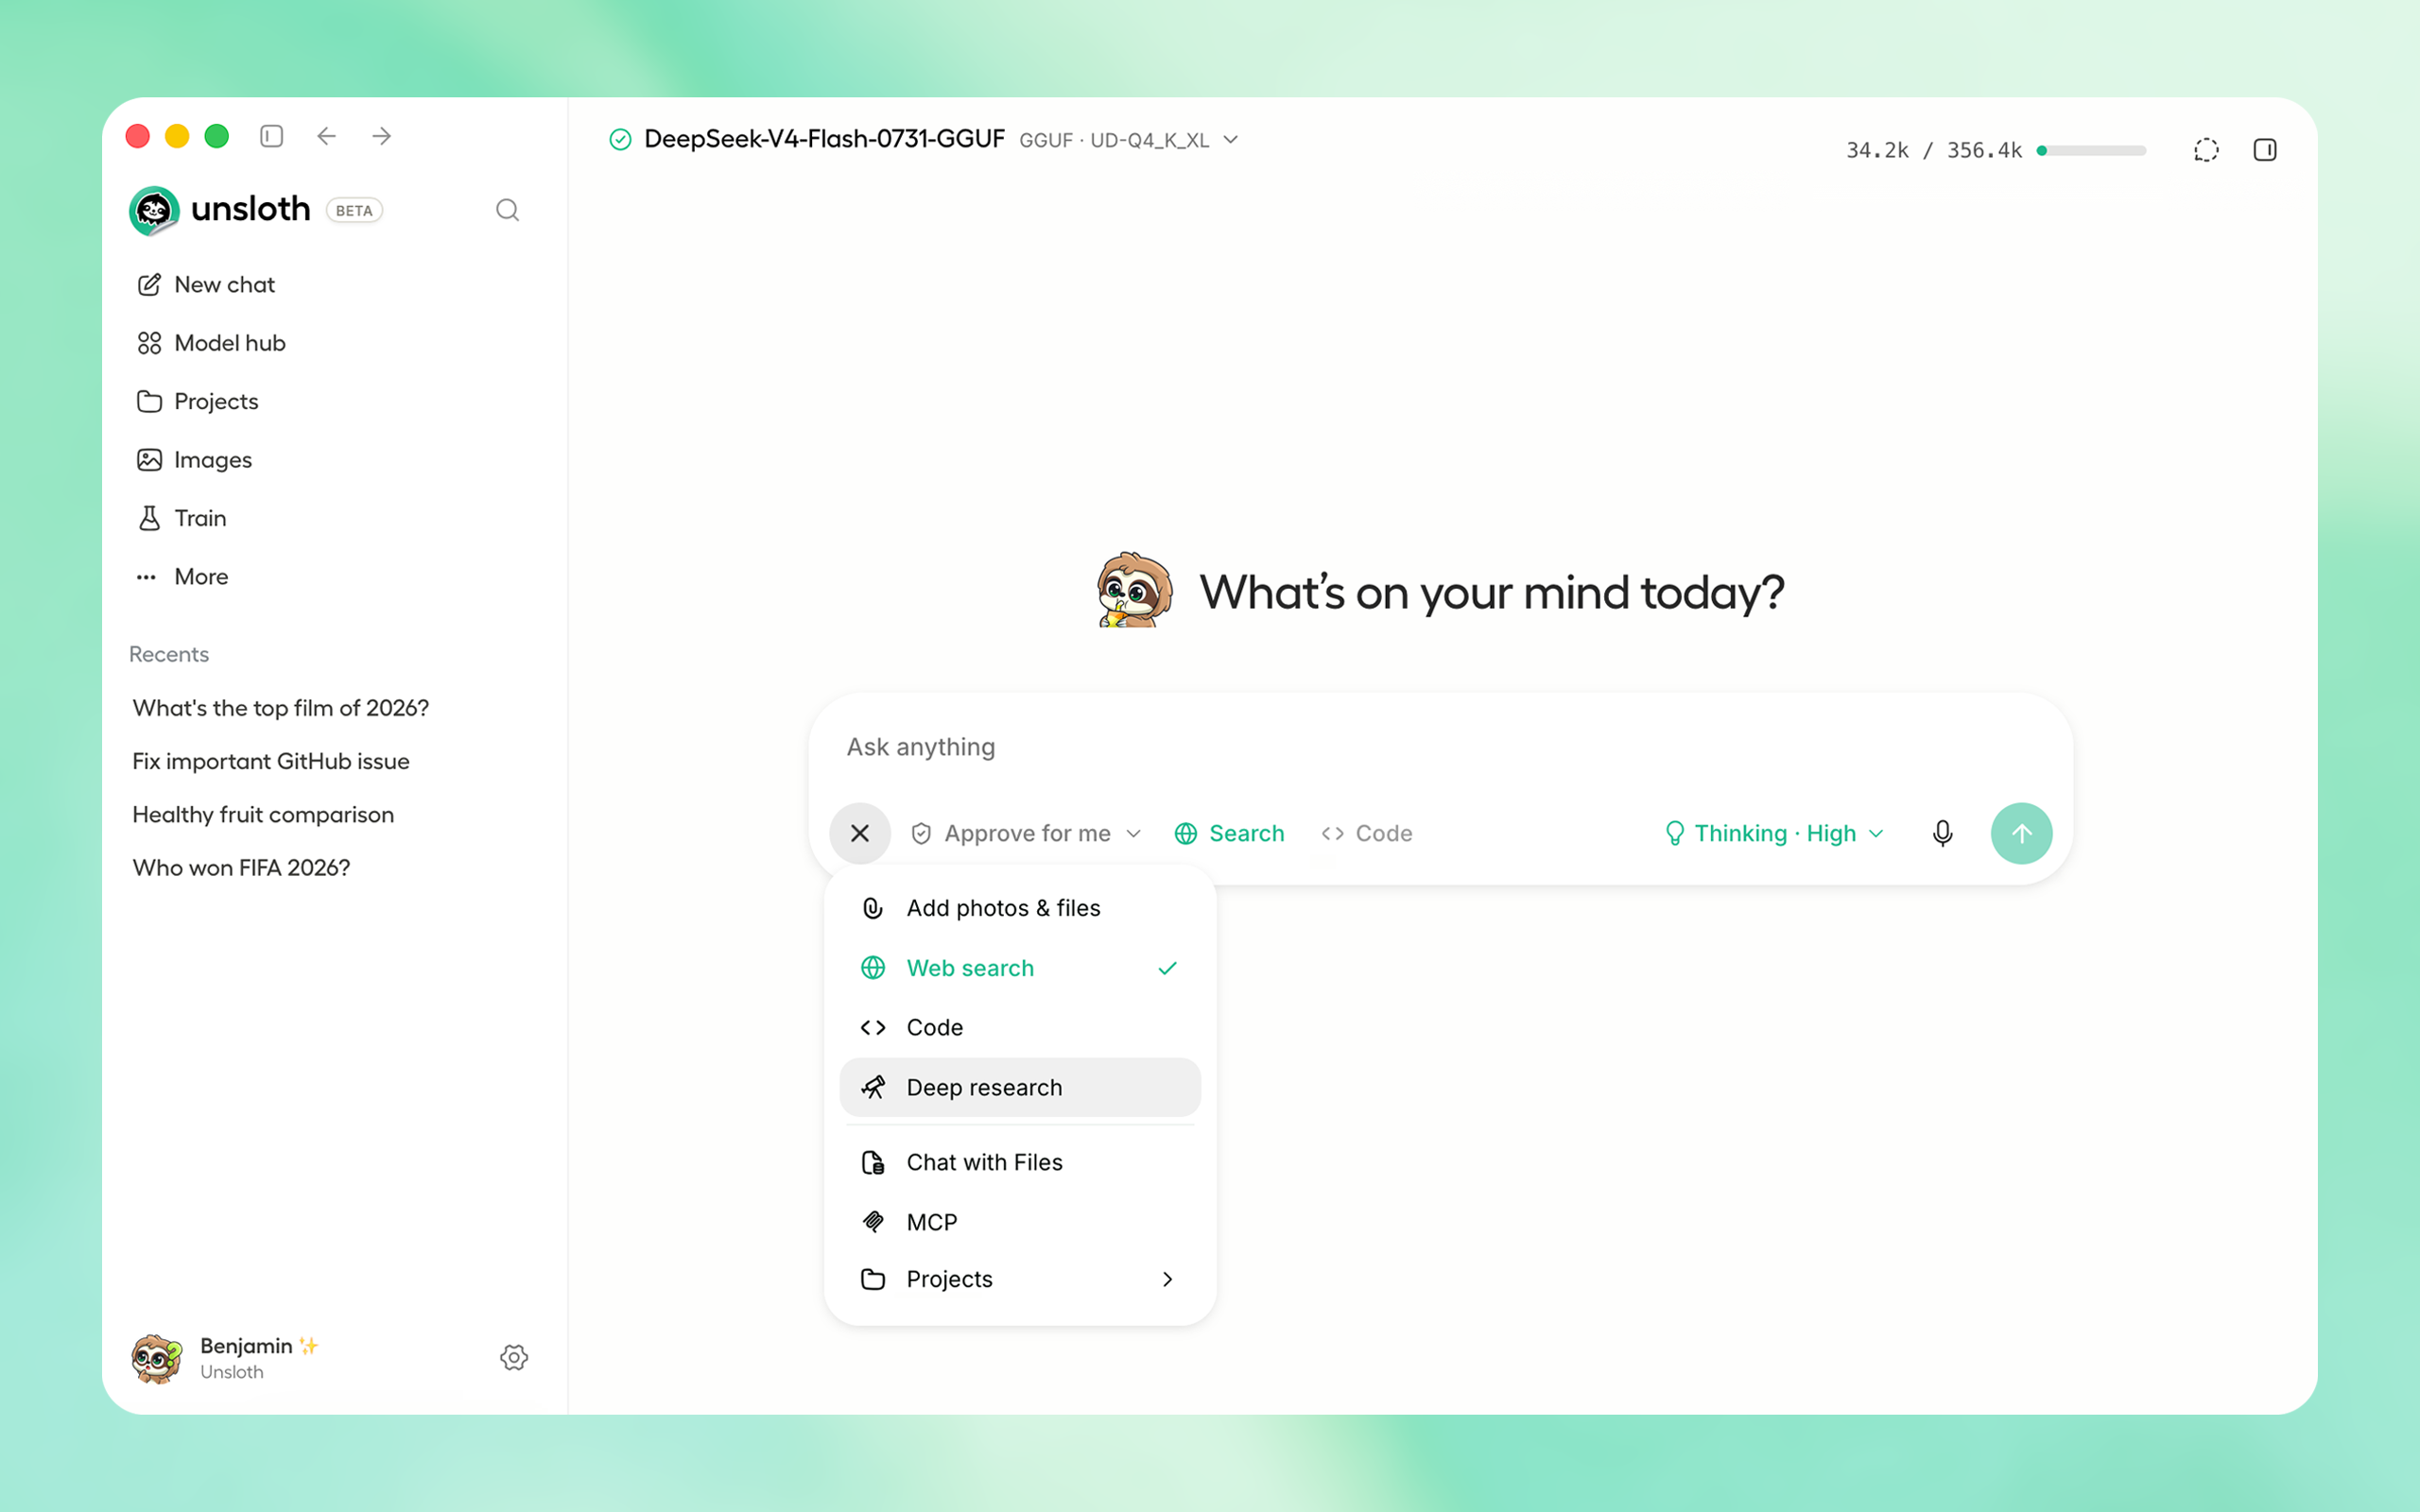
Gemma 4 kann jetzt ausgeführt und feinabgestimmt werden in [Unsloth Desktop](/docs/de/neu/studio.md), unserer neuen Open-Source-Desktop-UI für lokale KI. Mit Unsloth Studio kannst du Modelle lokal ausführen auf **macOS, Windows**, Linux und:
{% columns %}
{% column %}
* Suchen, herunterladen, [GGUFs ausführen](/docs/de/neu/studio.md#run-models-locally) und Safetensor-Modelle
* [**Selbstheilend** Tool-Aufrufe](/docs/de/neu/studio.md#execute-code--heal-tool-calling) + **Websuche**
* [**Codeausführung**](/docs/de/neu/studio.md#run-models-locally) (Python, Bash)
* [Automatische Inferenz](https://unsloth.ai/docs/desktop#feature-deep-dive) Abstimmung der Parameter (Temp., Top-p usw.)
* Schnelle CPU- + GPU-Inferenz über llama.cpp
* [LLMs trainieren](/docs/de/neu/studio.md#no-code-training) 2x schneller mit 70 % weniger VRAM
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% stepper %}
{% step %}
#### Unsloth installieren
Der einfachste Einstieg ist das Herunterladen der [Unsloth-Desktop-App](/docs/de/desktop.md). Funktioniert auf [macOS](/docs/de/loslegen/install/mac.md), [Windows](/docs/de/loslegen/install/windows-installation.md), und [Linux](/docs/de/loslegen/install/linux.md).
Unsloth herunterladen
* :apple: [Für macOS herunterladen](https://unsloth.ai/download/mac)
* :windows: [Für Windows herunterladen](https://unsloth.ai/download/windows)
* :linux: [Für Linux herunterladen](https://unsloth.ai/download/linux)
Oder, wenn du lieber manuell installieren möchtest:
**macOS, Linux, WSL:**
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
**Windows PowerShell:**
```bash
irm https://unsloth.ai/install.ps1 | iex
```
{% endstep %}
{% step %}
#### Unsloth starten
**macOS, Linux, WSL und Windows:**
```bash
unsloth studio -H 0.0.0.0 -p 8888
```
Dann öffnen Sie `http://127.0.0.1:8888` oder Ihre spezifische URL in Ihrem Browser.
**Unsloth sicher mit HTTPS und Cloudflare starten**
**NEU!** Unsloth bietet jetzt eine sichere Möglichkeit, Unsloth über HTTPS mittels eines kostenlosen Cloudflare-Tunnels zu starten. Verwende das Folgende (funktioniert unter Windows, Mac & Linux):
```bash
unsloth studio --secure
```
{% endstep %}
{% step %}
#### Gemma 4 suchen und herunterladen
Beim ersten Start müssen Sie ein Passwort erstellen, um Ihr Konto zu sichern, und sich erneut anmelden.
Gehen Sie dann zum [Unsloth Chat](/docs/de/neu/studio/chat.md) Registerkarte und suchen Sie in der Suchleiste nach Gemma 4 und laden Sie das gewünschte Modell und die gewünschte Quantisierung herunter. Unsloth unterstützt das neueste Gemma-4-12B-Unified-Modell.
{% endstep %}
{% step %}
#### Gemma 4 ausführen
Die Inferenzparameter sollten bei Verwendung von Unsloth Studio automatisch festgelegt werden; Sie können sie jedoch weiterhin manuell ändern. Sie können auch die Kontextlänge, die Chatvorlage und andere Einstellungen bearbeiten. Sie können GGUFs und MLX-Dateien ausführen.
Für weitere Informationen können Sie unseren [Inferenzleitfaden für Unsloth Studio](/docs/de/neu/studio/chat.md).
{% endstep %}
{% endstepper %}
### 🦙 Llama.cpp-Leitfaden
Für diese Anleitung verwenden wir Dynamic 4-Bit für die 12B-, 26B-A4B- und 31B-Modelle sowie 8-Bit für E2B und E4B. Siehe: [Gemma-4-GGUF-Sammlung](https://huggingface.co/collections/unsloth/gemma-4)
Für diese Tutorials werden wir verwenden [llama.cpp](llama.cpphttps://github.com/ggml-org/llama.cpp) für schnelle lokale Inferenz verwenden, besonders wenn Sie eine CPU haben.
{% stepper %}
{% step %}
Holen Sie sich die neueste `llama.cpp` **auf** [**hier auf GitHub**](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
Wenn Sie `llama.cpp` um Modelle direkt zu laden, können Sie die folgenden Befehle entsprechend jedem Modell befolgen. `UD-Q4_K_XL` ist der Quantisierungstyp. Sie können auch über Hugging Face (Schritt 3) herunterladen. Das ist ähnlich wie `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen `llama.cpp` um an einem bestimmten Ort zu speichern. Es ist nicht nötig, die Kontextlänge festzulegen, da llama.cpp automatisch die exakt benötigte Menge verwendet.
{% hint style="warning" %}
Um [Denken/Schlussfolgern deaktivieren](#how-to-enable-or-disable-reasoning-and-thinking), verwenden Sie: `--chat-template-kwargs '{"enable_thinking":false}'`
**Windows** PowerShell: `--chat-template-kwargs "{\"enable_thinking\":false}"`
Verwenden Sie '`true`' und '`false`' austauschbar verwenden.
{% endhint %}
**12B:**
```bash
export LLAMA_CACHE="unsloth/gemma-4-12B-it-GGUF"
./llama.cpp/llama-cli \\
-hf unsloth/gemma-4-12b-it-GGUF:UD-Q4_K_XL \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64
```
**26B-A4B:**
```bash
export LLAMA_CACHE="unsloth/gemma-4-26B-A4B-it-GGUF"
./llama.cpp/llama-cli \\
-hf unsloth/gemma-4-26B-A4B-it-GGUF:UD-Q4_K_XL \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64
```
**31B:**
```bash
export LLAMA_CACHE="unsloth/gemma-4-31B-it-GGUF"
./llama.cpp/llama-cli \\
-hf unsloth/gemma-4-31B-it-GGUF:UD-Q4_K_XL \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64
```
**E4B:**
```bash
export LLAMA_CACHE="unsloth/gemma-4-E4B-it-GGUF"
./llama.cpp/llama-cli \\
-hf unsloth/gemma-4-E4B-it-GGUF:Q8_0 \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64
```
**E2B:**
```bash
export LLAMA_CACHE="unsloth/gemma-4-E2B-it-GGUF"
./llama.cpp/llama-cli \\
-hf unsloth/gemma-4-E2B-it-GGUF:Q8_0 \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64
```
{% endstep %}
{% step %}
Sie können das Modell auch manuell über den untenstehenden Code herunterladen (nach der Installation von `pip install huggingface_hub`). Sie können `UD-Q4_K_XL` oder andere quantisierte Versionen wie `Q8_0` . Falls Downloads hängen bleiben, siehe: [Hugging Face Hub, XET-Debugging](/docs/de/grundlagen/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)
```bash
hf download unsloth/gemma-4-26B-A4B-it-GGUF \\
--local-dir unsloth/gemma-4-26B-A4B-it-GGUF \\
--include "*mmproj-BF16*" \\
--include "*UD-Q4_K_XL*" # Verwenden Sie "*UD-Q2_K_XL*" für dynamisches 2-Bit
```
{% endstep %}
{% step %}
Dann führen Sie das Modell im Konversationsmodus aus (mit Vision `mmproj-F16`):
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/gemma-4-26B-A4B-it-GGUF/gemma-4-26B-A4B-it-UD-Q4_K_XL.gguf \
--mmproj unsloth/gemma-4-26B-A4B-it-GGUF/mmproj-BF16.gguf \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64
```
{% endcode %}
{% endstep %}
{% step %}
#### Bereitstellung auf llama-server
Um Gemma-4 auf llama-server bereitzustellen, verwenden Sie:
```bash
./llama.cpp/llama-server \\
--model unsloth/gemma-4-26B-A4B-it-GGUF/gemma-4-26B-A4B-it-UD-Q4_K_XL.gguf \
--mmproj unsloth/gemma-4-26B-A4B-it-GGUF/mmproj-BF16.gguf \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 64 \\
--alias "unsloth/gemma-4-26B-A4B-it-GGUF" \
--port 8001 \
--chat-template-kwargs '{"enable_thinking":true}'
```
{% endstep %}
{% endstepper %}
### Dynamische MLX-Quantisierungen
Wir haben auch dynamische 4-Bit- und 8-Bit-Quants als ersten Versuch für macOS-Geräte hochgeladen! Die MLX-Quants unterstützen **Vision.**
{% hint style="success" %}
Alle MLX-Quants funktionieren jetzt in[ Unsloth Studio](#unsloth-studio-guide)!
{% endhint %}
| Gemma 4 | 4-Bit-MLX | 8-Bit-MLX |
| ------- | --------------------------------------------------------------------- | ------------------------------------------------------------------ |
| 31B | [Link](https://huggingface.co/unsloth/gemma-4-31b-it-UD-MLX-4bit) | [Link](https://huggingface.co/unsloth/gemma-4-31b-it-MLX-8bit) |
| 26B-A4B | [Link](https://huggingface.co/unsloth/gemma-4-26b-a4b-it-UD-MLX-4bit) | [Link](https://huggingface.co/unsloth/gemma-4-26b-a4b-it-MLX-8bit) |
| E4B | [Link](https://huggingface.co/unsloth/gemma-4-E4B-it-UD-MLX-4bit) | [Link](https://huggingface.co/unsloth/gemma-4-E4B-it-MLX-8bit) |
| E2B | [Link](https://huggingface.co/unsloth/gemma-4-E2B-it-UD-MLX-4bit) | [Link](https://huggingface.co/unsloth/gemma-4-E2B-it-MLX-8bit) |
Um sie auszuprobieren, verwende:
{% code overflow="wrap" %}
```bash
curl -fsSL https://raw.githubusercontent.com/unslothai/unsloth/refs/heads/main/scripts/install_gemma4_mlx.sh | sh
source ~/.unsloth/unsloth_gemma4_mlx/bin/activate
python -m mlx_vlm.chat --model unsloth/gemma-4-26b-a4b-it-UD-MLX-4bit
```
{% endcode %}
### **NVFP4-Anleitung**
Wir haben [Dynamic NVFP4](/docs/de/grundlagen/nvfp4.md) Gemma-4-Quants für schnellere 4-Bit-Inferenz auf NVIDIA-Blackwell-GPUs hochgeladen. Dies sind die Hardwareanforderungen für Modelle, die Sie verwenden können, einschließlich Gemma 4. Siehe auch den gesamten Geschwindigkeitszuwachs, den Sie erreichen werden:
| Gemma-4-Variante | Erforderlicher VRAM | Schneller als BF16 |
| ------------------------------------------------------------------ | ------------------: | -----------------: |
| [E2B](https://huggingface.co/unsloth/gemma-4-E2B-it-NVFP4) | 7 GB | 1,12× schneller |
| [E4B](https://huggingface.co/unsloth/gemma-4-E4B-it-NVFP4) | 9 GB | 1,22× schneller |
| [12B Unified](https://huggingface.co/unsloth/gemma-4-12b-it-NVFP4) | 11 GB | 1,26× schneller |
| [26B A4B](https://huggingface.co/unsloth/gemma-4-26B-A4B-it-NVFP4) | 26 GB | 1,41× schneller |
| [31B](https://huggingface.co/unsloth/gemma-4-31B-it-NVFP4) | 32 GB | 1,45× schneller |
#### **vLLM-Tutorial:**
Um NVFP4-Quants auszuführen, siehe unten die Befehle zum Ausführen von Gemma-4-26B-A4B in [vLLM](/docs/de/grundlagen/inference-and-deployment/vllm-guide.md) und [SGLang](/docs/de/grundlagen/inference-and-deployment/sglang-guide.md) (Sie können den Modellnamen ändern in `gemma-4-31B-it-NVFP4` usw.) Wählen Sie außerdem KEIN MoE-Backend aus – lassen Sie vLLM es auswählen – z. B. ist Marlin 2,5-mal langsamer! Siehe [#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl](#marlin-vs-flashinfer-vs-cutlass-vs-cute-dsl "mention")Wenn Sie einen DGX Spark haben, siehe [#dgx-spark-serving](#dgx-spark-serving "mention") Sie müssen `--moe-backend flashinfer_b12x` verwenden, sonst erhalten Sie eine deutlich langsamere Inferenz.
Um vLLM in einer separaten venv zu installieren:
{% code overflow="wrap" expandable="true" %}
```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \\
--torch-backend=auto
```
{% endcode %}
Dann, um die 26B-MoE-Variante bereitzustellen:
```shell
vllm serve unsloth/gemma-4-26B-A4B-it-NVFP4
```
Ändere `unsloth/gemma-4-26B-A4B-it-NVFP4` zu einem beliebigen [verfügbaren NVFP4](/docs/de/grundlagen/nvfp4.md#overview) Quantnamen!
Um MTP / spekulatives Decoding zu aktivieren (schnelleres Decoding, aber etwas geringerer Durchsatz), verwende:
```bash
vllm serve unsloth/gemma-4-26B-A4B-it-NVFP4
--speculative-config '{"method": "mtp", "num_speculative_tokens": 2}'
```
Wenn du Torchcodec-Probleme bekommst, führe unbedingt Folgendes aus und starte dann vllm neu.
{% code overflow="wrap" expandable="true" %}
```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```
{% endcode %}
#### **DGX Spark mit NVFP4-Quants**
Um sicherzustellen, dass DGX Spark die richtigen Kernel hat (sonst erhalten Sie **2x LANGSAMERE Inferenz**), prüfen Sie zuerst:
{% code overflow="wrap" expandable="true" %}
```bash
python -c "
import torch; from vllm.utils.flashinfer import has_flashinfer_b12x_gemm as g, has_flashinfer_b12x_moe as m
cap = torch.cuda.get_device_capability(); print('cap', cap, '| b12x gemm', g(), '| b12x moe', m()); assert cap[0] == 12 and g() and m(), 'b12x nicht verfügbar: die Bereitstellung würde auf marlin W4A16 zurückfallen'"
```
{% endcode %}
was nicht fehlschlagen sollte – wenn doch, aktualisieren Sie bitte vllm oder installieren Sie neu über:
{% code overflow="wrap" expandable="true" %}
```bash
uv venv unsloth-nvfp4-env --python 3.13
source unsloth-nvfp4-env/bin/activate
uv pip install "vllm>=0.25.0" "flashinfer-python>=0.6.13" "nvidia-cutlass-dsl>=4.5.2" \\
--torch-backend=auto
```
{% endcode %}
Dann, um in vLLM für DGX Spark bereitzustellen:
{% code overflow="wrap" expandable="true" %}
```shellscript
export CUTE_DSL_ARCH=sm_121a
vllm serve unsloth/gemma-4-26B-A4B-it-NVFP4 --moe-backend flashinfer_b12x
```
{% endcode %}
Wenn du Torchcodec-Probleme bekommst, führe unbedingt Folgendes aus und starte dann vllm neu.
{% code overflow="wrap" expandable="true" %}
```bash
sudo apt-get update
sudo apt-get install -y ffmpeg
```
{% endcode %}
#### **SGLang-Tutorial:**
```bash
python -m sglang.launch_server --model-path unsloth/gemma-4-31B-it-NVFP4 --speculative-algorithm NEXTN \
--speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
```
### Ollama-Anleitung
Ollama unterstützt Unsloth-GGUFs jetzt gut. Verwenden Sie `curl -fsSL https://ollama.com/install.sh | sh` um Ollama unter Linux zu installieren oder `irm https://ollama.com/install.ps1 | iex` für Windows.\
\
Um eine einzelne Quant-Datei (unter 50 GB) zu verwenden, nutzen Sie:
{% code overflow="wrap" %}
```bash
ollama run hf.co/unsloth/gemma-4-26B-A4B-it-GGUF:UD-Q4_K_XL
```
{% endcode %}
Für mehrere Shards, wie größere BF16-Shards, gehen Sie wie folgt vor:
{% code overflow="wrap" %}
```bash
pip install -U huggingface_hub
# mmproj und BF16 in 2 Aufrufen herunterladen
hf download unsloth/gemma-4-26B-A4B-it-GGUF --include "BF16/*" \
--local-dir gemma4
hf download unsloth/gemma-4-26B-A4B-it-GGUF --include "mmproj-BF16.gguf" \
--local-dir gemma4
mv gemma4/mmproj-BF16.gguf gemma4/BF16/
echo "FROM ./gemma4/BF16" > Modelfile
ollama create unsloth-gemma4 -f Modelfile
ollama run unsloth-gemma4
```
{% endcode %}
{% hint style="info" %}
Wenn du `Fehler: 500 Internal Server Error: Modell kann nicht geladen werden` Ollama aktualisieren über `curl -fsSL https://ollama.com/install.sh | sh` oder verwenden Sie die PowerShell-Variante.
{% endhint %}
## Best Practices für Gemma 4
### Beispiel-Prompts
#### Einfacher Reasoning-Prompt
```
System:
<|think|>
Sie sind ein präziser Reasoning-Assistent.
Benutzer:
Ein Zug fährt um 8:15 Uhr ab und kommt um 11:47 Uhr an. Wie lange dauerte die Fahrt?
```
#### OCR-/Dokumenten-Prompt
Für OCR verwenden Sie ein **hohes visuelles Token-Budget** wie **560** oder **1120**.
```
[Bild zuerst]
Extrahieren Sie den gesamten Text aus diesem Beleg. Geben Sie Positionen, Gesamtbetrag, Händler und Datum als JSON zurück.
```
#### Multimodaler Vergleichs-Prompt
```
[Bild 1]
[Bild 2]
Vergleichen Sie diese beiden Screenshots und sagen Sie mir, welcher einen neuen Benutzer eher verwirren würde.
```
#### Audio-ASR-Prompt
```
Transkribieren Sie das folgende Sprachsegment in {LANGUAGE} in {LANGUAGE}-Text.
Befolgen Sie diese spezifischen Anweisungen für die Formatierung der Antwort:
* Geben Sie nur die Transkription aus, ohne Zeilenumbrüche.
* Wenn Sie Zahlen transkribieren, schreiben Sie die Ziffern, also schreiben Sie 1.7 und nicht one point seven, und schreiben Sie 3 statt three.
```
#### Audio-Übersetzungs-Prompt
```
Transkribieren Sie das folgende Sprachsegment in {SOURCE_LANGUAGE} und übersetzen Sie es dann in {TARGET_LANGUAGE}. Geben Sie bei der Formatierung der Antwort zuerst die Transkription in {SOURCE_LANGUAGE} aus, dann eine neue Zeile, dann den String '{TARGET_LANGUAGE}: ', und anschließend die Übersetzung in {TARGET_LANGUAGE}.
```
### Multimodale Einstellungen
Für beste Ergebnisse bei multimodalen Prompts stellen Sie multimodale Inhalte zuerst ein:
* Setzen Sie **Bild und/oder Audio vor Text**.
* Für Video übergeben Sie zuerst eine Sequenz von Frames, dann die Anweisung.
#### Grenzen für Audio und Video
* **Audio** ist verfügbar auf **12B**, **E2B** und **E4B** nur.
* Audio unterstützt maximal **30 Sekunden**.
* Video unterstützt maximal **60 Sekunden** unter der Annahme von **1 Frame pro Sekunde** Verarbeitung.
#### Audio-Prompt-Vorlagen
**ASR-Prompt**
```
Transkribieren Sie das folgende Sprachsegment in {LANGUAGE} in {LANGUAGE}-Text.
Befolgen Sie diese spezifischen Anweisungen für die Formatierung der Antwort:
* Geben Sie nur die Transkription aus, ohne Zeilenumbrüche.
* Wenn Sie Zahlen transkribieren, schreiben Sie die Ziffern, also schreiben Sie 1.7 und nicht one point seven, und schreiben Sie 3 statt three.
```
**Sprachübersetzungs-Prompt**
```
Transkribieren Sie das folgende Sprachsegment in {SOURCE_LANGUAGE} und übersetzen Sie es dann in {TARGET_LANGUAGE}.
Geben Sie bei der Formatierung der Antwort zuerst die Transkription in {SOURCE_LANGUAGE} aus, dann eine neue Zeile, dann den String '{TARGET_LANGUAGE}: ', und anschließend die Übersetzung in {TARGET_LANGUAGE}.
```
## 📊 Benchmarks
### Unsloth-GGUF-Benchmarks
Wir haben Mean-KL-Divergenz-Benchmarks für Gemma-4-GGUFs über verschiedene Anbieter hinweg durchgeführt, um Ihnen bei der Auswahl des besten Quants zu helfen (niedriger ist besser).
* KL-Divergenz bringt alle Unsloth-GGUFs an die SOTA-Pareto-Grenze
* KLD zeigt, wie gut ein quantisiertes Modell der ursprünglichen BF16-Ausgabeverteilung entspricht, und gibt damit Aufschluss über die erhaltene Genauigkeit.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/gemma-4.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.