> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/grundlagen/faster-moe.md).

# MoE-Modelle mit Unsloth 12-mal schneller feinabstimmen

Trainieren Sie MoE-LLMs lokal mit dem Unsloth-Leitfaden.

Wir führen \~12x schnelleres Mixture of Experts (MoE)-LLM-Training mit **>35 % weniger VRAM** und **\~6x längerer Kontext** mit unseren neuen MoE-Triton-Kernels und neuen mathematischen Optimierungen ein – alles ohne Genauigkeitsverlust.

* Unsloth unterstützt jetzt schnelles Training für MoE-Architekturen, einschließlich [gpt-oss](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune.md), [Qwen3](/docs/de/modelle/tutorials/qwen3-how-to-run-and-fine-tune.md) (30B, 235B, VL, Coder), DeepSeek [R1](/docs/de/modelle/tutorials/deepseek-r1-0528-how-to-run-locally.md), [V3](/docs/de/modelle/tutorials/deepseek-v3.1-how-to-run-locally.md) und GLM ([4.6](https://unsloth.ai/docs/de/grundlagen/pages/d1a24e17aacb2e1edef96e954b901fe1f785221e#glm-4.6v-flash), [4.7](/docs/de/modelle/tutorials/glm-4.7.md), [Flash](/docs/de/modelle/tutorials/glm-4.7-flash.md)).
* gpt-oss-20b-Feinabstimmungen in **12,8 GB VRAM**. Qwen3-30B-A3B (16-Bit-LoRA) benötigt 63 GB.
* Unsere Kernels funktionieren sowohl auf Rechenzentrums-GPUs (B200, H100), **Consumer-GPUs** und älteren GPUs (z. B. RTX 3090) sowie FFT, LoRA und QLoRA.

In Zusammenarbeit mit 🤗Hugging Face haben wir alle MoE-Trainingsläufe mit PyTorchs neuer `torch._grouped_mm` Funktion vereinheitlicht. Transformers v5 wurde kürzlich mit \~6x schnellerem MoE als v4 optimiert, und Unsloth treibt dies mit benutzerdefinierten Triton grouped-GEMM + LoRA-Kernels noch weiter für eine **zusätzliche** \~2x Beschleunigung, >35% VRAM-Reduktion und >6x längeren Kontext (insgesamt 12-30x Beschleunigung gegenüber v4).

Probieren Sie unsere Unsloth-Notebooks für schnelles MoE-Training aus:

| [**gpt-oss (20b)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-Fine-tuning.ipynb) **(kostenlos)** | [Qwen3-30B-A3B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_MoE.ipynb) (A100)                                  | [GLM-4.7-Flash](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/GLM_Flash_A100\(80GB\).ipynb) (A100) |
| ------------------------------------------------------------------------------------------------------------------------------------------------ | -------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------ |
| [gpt-oss-120b](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(120B\)_A100-Fine-tuning.ipynb) (A100)         | [gpt-oss (500K Kontext)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb) | [TinyQwen3 MoE](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/TinyQwen3_MoE.ipynb) (nur Test)      |

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FZYAbbmao7vQbKGr7Rtiv%2Fgraph%20results%20only.png?alt=media&amp;token=6cfb4f27-3e78-48d3-b3db-12eb4b3dcde3" alt="" width="563"><figcaption></figcaption></figure>

### 🦥 Unsloth MoE Triton Kernels

Zusammen mit `torch._grouped_mm` (siehe [#what-is-torch.\_grouped\_mm](#what-is-torch._grouped_mm "mention")), haben wir benutzerdefinierte Triton-MoE-Kernels erstellt, die in einigen Fällen noch schneller sein können. Sie sind außerdem **abwärtskompatibel** mit älterer Hardware wie A100 und älteren PyTorch-Versionen.

{% columns %}
{% column width="50%" %}
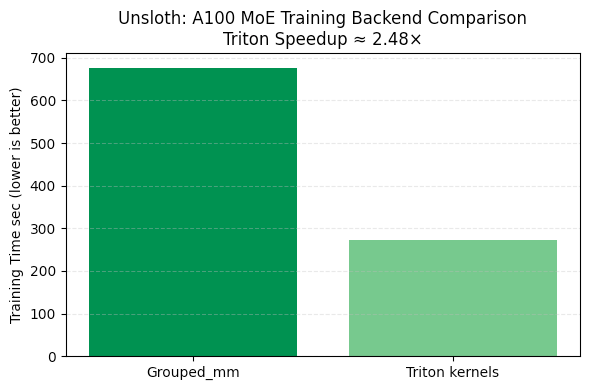
Auf A100 sind unsere **Triton-Kernels \~2,5x schneller** als `torch._grouped_mm`. Die Kernels haben außerdem einen einmaligen Auto-Tuning-Schritt, um die beste Kernel-Konfiguration auszuwählen.

Das Auto-Tuning dauert einmalig am Anfang des Trainings etwa 2 Minuten, kann aber den gesamten Lauf auf A100 gegenüber `_grouped_mm`um 35 % beschleunigen, was sich bei längeren Läufen absolut lohnt.
{% endcolumn %}

{% column width="50%" %}

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F5COXvwLZwdY61BhFvjnI%2Funknown.png?alt=media&amp;token=59f07dcc-cb11-47d4-bacc-ec27e7454f19" alt="" width="295"><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% hint style="success" %}
Je größer das Modell und je mehr Kontext Sie verwenden, **desto ausgeprägter werden die Speichereinsparungen unserer Unsloth-Kernels** (die Effizienz skaliert exponentiell).
{% endhint %}

### :compass: Automatische Backend-Auswahl

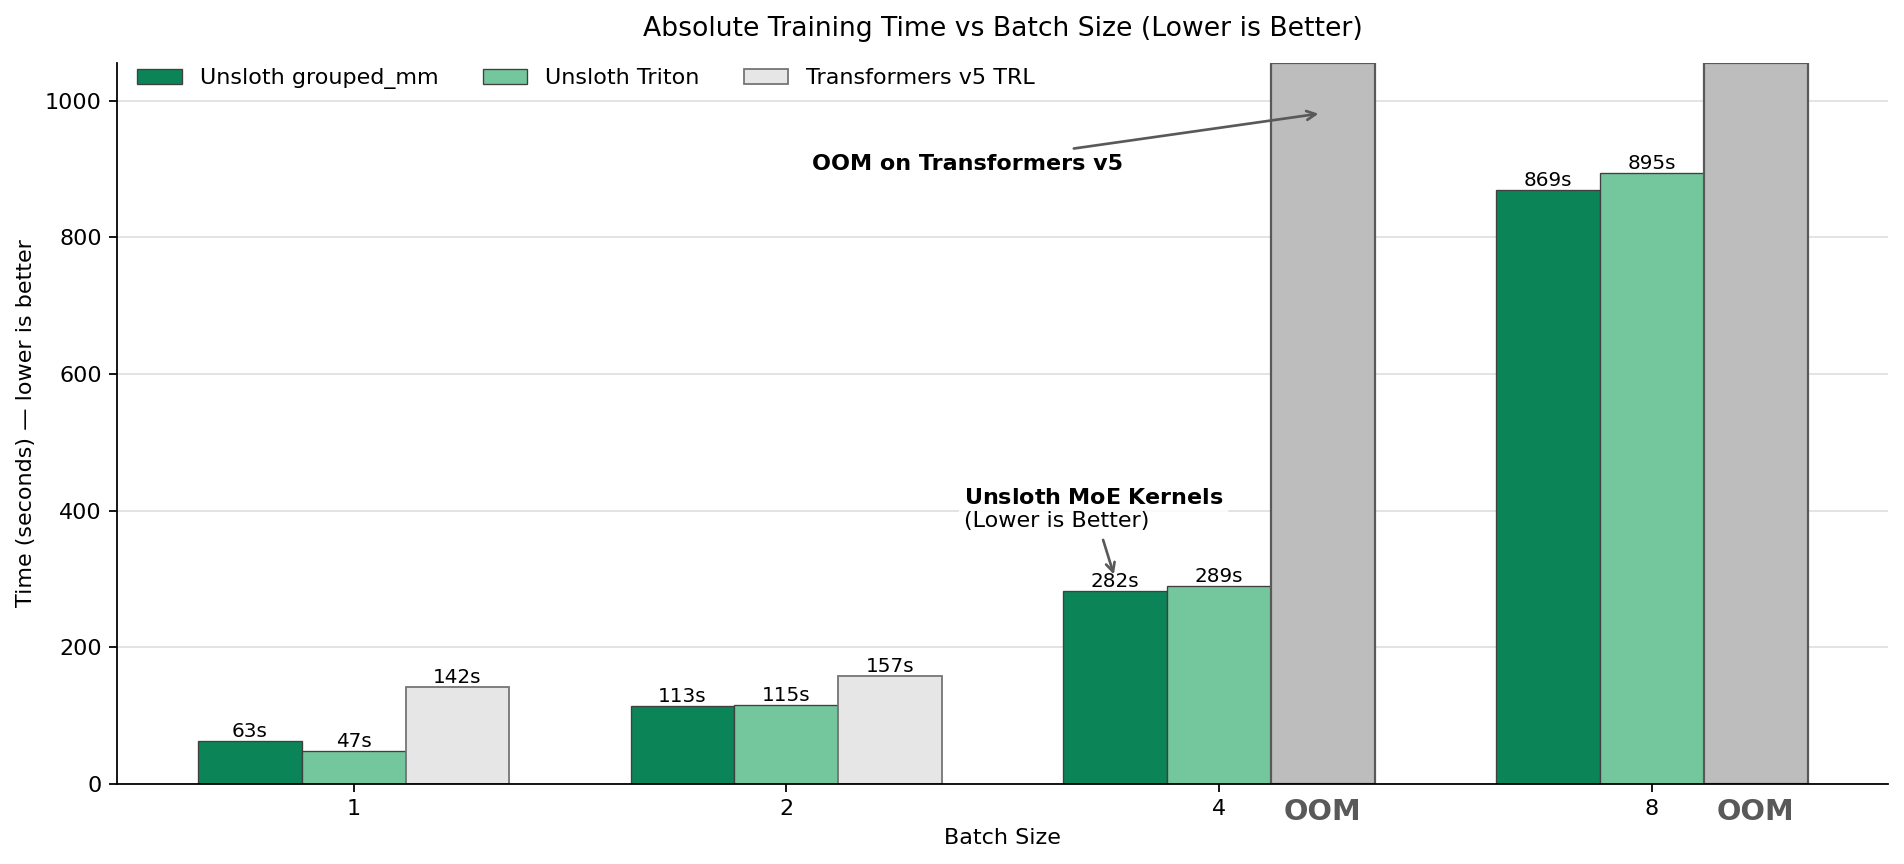
Unsere wichtigste Innovation ist unser **Split-LoRA-Ansatz** für effizientes MoE, der \~35 % weniger Speicher verwendet und 2x schnelleres Training ermöglicht im Vergleich zu Transformers v5 + `torch._grouped_mm`. Benutzerdefinierte `torch._grouped_mm` + unsere Triton-Kernels sind \~12-30x schneller als Transformers v4.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKHbKsPvtiK06Uogklven%2Fnicer_training_time_vs_batch_final_tweaks6_bold.png?alt=media&amp;token=448853ff-b760-46ad-8e9b-599c6862762b" alt="" width="563"><figcaption></figcaption></figure>

{% hint style="warning" %}
Das Training von MoE-Modellen in **4-Bit** QLoRA wird derzeit nicht empfohlen, da BitsandBytes es nicht unterstützt. Das ist nicht spezifisch für Unsloth. Verwenden Sie vorerst bf16 für LoRA oder vollständiges Fine-Tuning.
{% endhint %}

Unsloth wählt automatisch je nach Ihrer Hardware eines der folgenden Backends aus:

<table><thead><tr><th width="144.95001220703125">Backend</th><th>Optimierungen</th></tr></thead><tbody><tr><td>grouped_mm</td><td><code>torch._grouped_mm</code> - verfügbar auf T4s bis hin zu B200s, aber für H100s+ optimiert.</td></tr><tr><td>unsloth_triton</td><td>Unsloth-Triton-Kernels - sie werden sich automatisch für A100s und ältere PyTorch-Versionen einschalten.</td></tr><tr><td>native_torch</td><td>Natives PyTorch. Es ist 12x langsamer, aber unsere VRAM-Reduktionen bleiben erhalten!</td></tr></tbody></table>

Sie können sie auch selbst umschalten:

```python
os.environ["UNSLOTH_MOE_BACKEND"] = "grouped_mm"
os.environ["UNSLOTH_MOE_BACKEND"] = "unsloth_triton"
os.environ["UNSLOTH_MOE_BACKEND"] = "native_torch"
```

{% hint style="success" %}
Um schnelleres MoE-Training zu aktivieren, aktualisieren Sie Unsloth über `pip install --upgrade unsloth unsloth_zoo`
{% endhint %}

### ❓Was ist torch.\_grouped\_mm?

Zuvor wurden Mixture-of-Experts (MoE)-Gewichte als `ModuleList` von linearen Schichten pro Experte gespeichert. Die einzige praktikable Möglichkeit, einen Forward-Pass auszuführen, war eine for-Schleife über die Experten, was teuer und suboptimal ist.

```python
for expert_idx in expert_hit:
    expert_idx = expert_idx[0]
    if expert_idx == num_experts: continue
    _, token_idx = torch.where(expert_mask[expert_idx])
    current_state = hidden_states[token_idx]
    gate, up = nn.functional.linear(current_state, self.gate_up_proj[expert_idx]).chunk(2, dim=-1)
```

PyTorch hat kürzlich [`grouped_mm`](https://docs.pytorch.org/docs/main/generated/torch.nn.functional.grouped_mm.html) um genau diesen Engpass zu beheben. Parallel dazu stellen wir unsere eigenen, für MoE optimierten Triton-Kernels bereit. Das passt auch zu einer wichtigen Transformers-Änderung: Seit Transformers v5 werden Expertengewichte als ein [`einzelnes nn.Parameter`](https://github.com/huggingface/transformers/blob/v5.0.0/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L226), wodurch `grouped_mm` eine natürliche Wahl für schnelleres MoE-Training und Inferenz ist.

Also [transformers 4.57.6](https://github.com/huggingface/transformers/blob/v4.57.6/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L222) geändert:

{% code overflow="wrap" %}

```python
self.experts = nn.ModuleList(
    [Qwen3MoeMLP(config, intermediate_size) for _ in range(self.num_experts)]
)
```

{% endcode %}

zu [transformers 5.0.0](https://github.com/huggingface/transformers/blob/v5.0.0/src/transformers/models/qwen3_moe/modeling_qwen3_moe.py#L226) Stil:

{% code overflow="wrap" %}

```python
self.gate_up_proj = nn.Parameter(torch.empty(num_experts, 2 * intermediate_dim, hidden_dim))
```

{% endcode %}

`torch._grouped_mm` funktioniert auf GPUs ab der NVIDIA T4, und wir haben es auf H100, A100, B200 und RTX 6000 Pro verifiziert, sodass die Unterstützung breit verfügbar ist.

Wir haben außerdem zuvor Unsloth [Flex Attention](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) für gpt-oss eingeführt, und diese Optimierungen sollten es noch effizienter machen.

## 📊 Kernel-Ergebnisse + Benchmarks

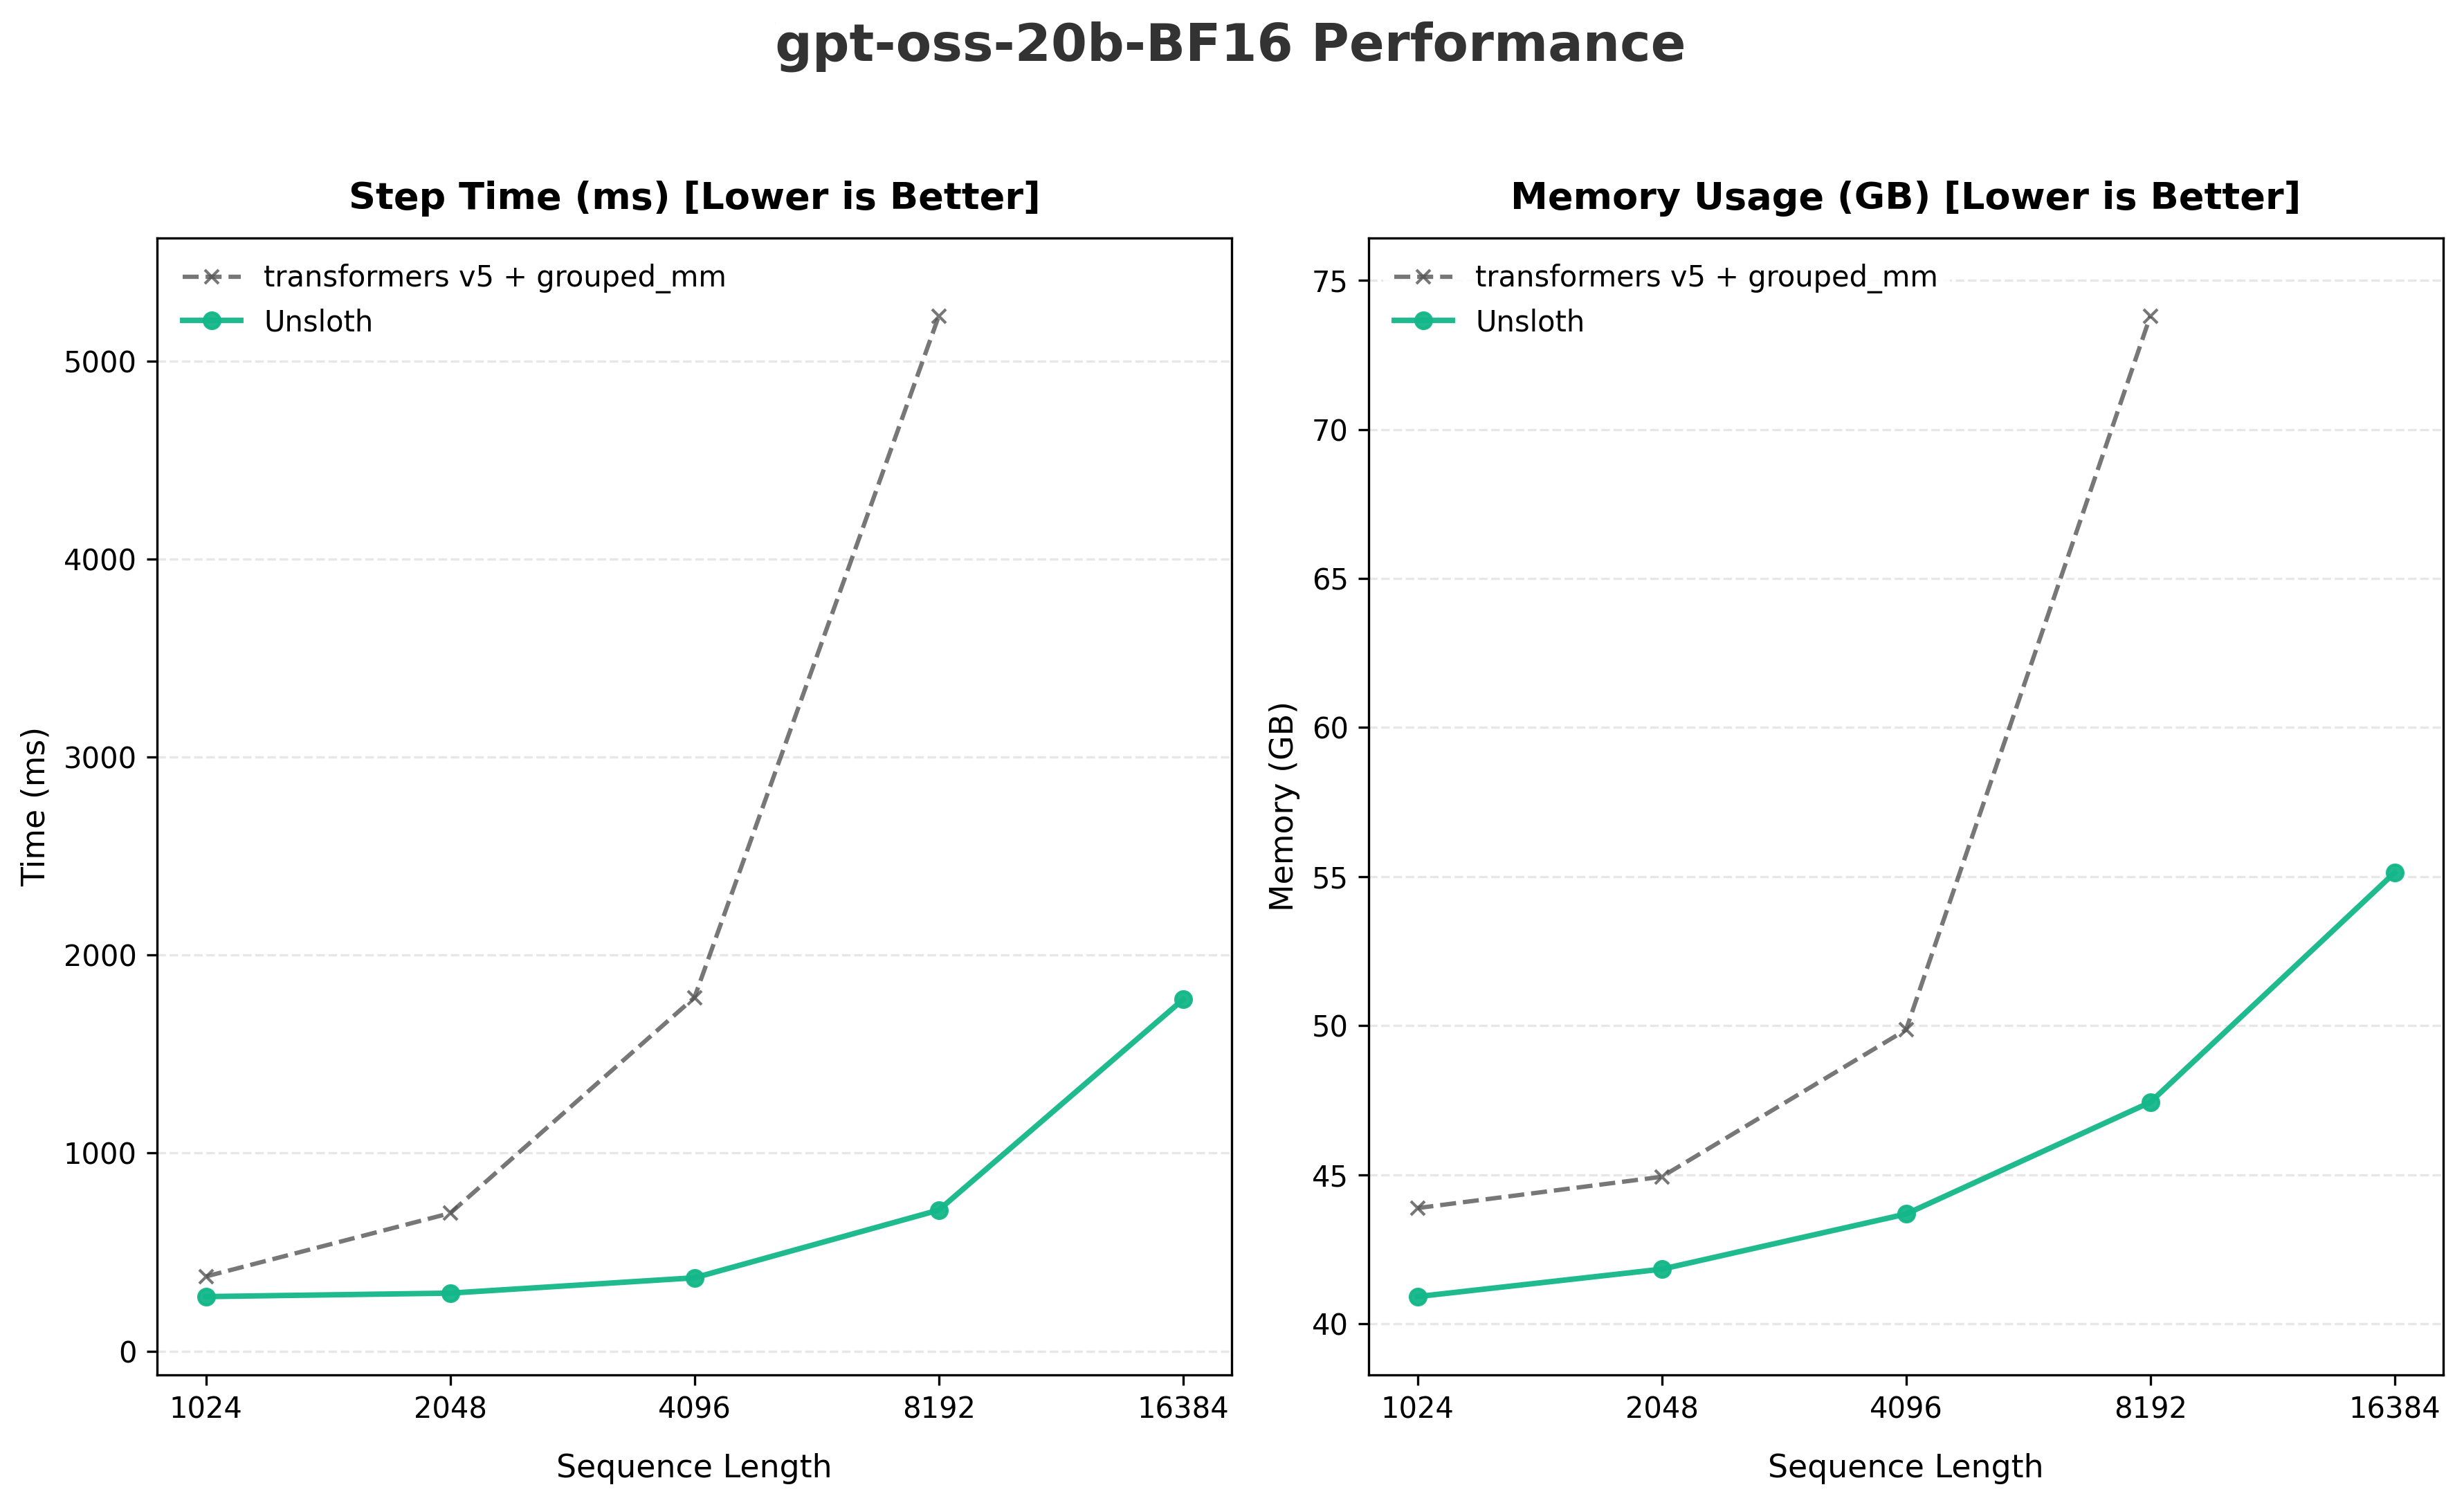
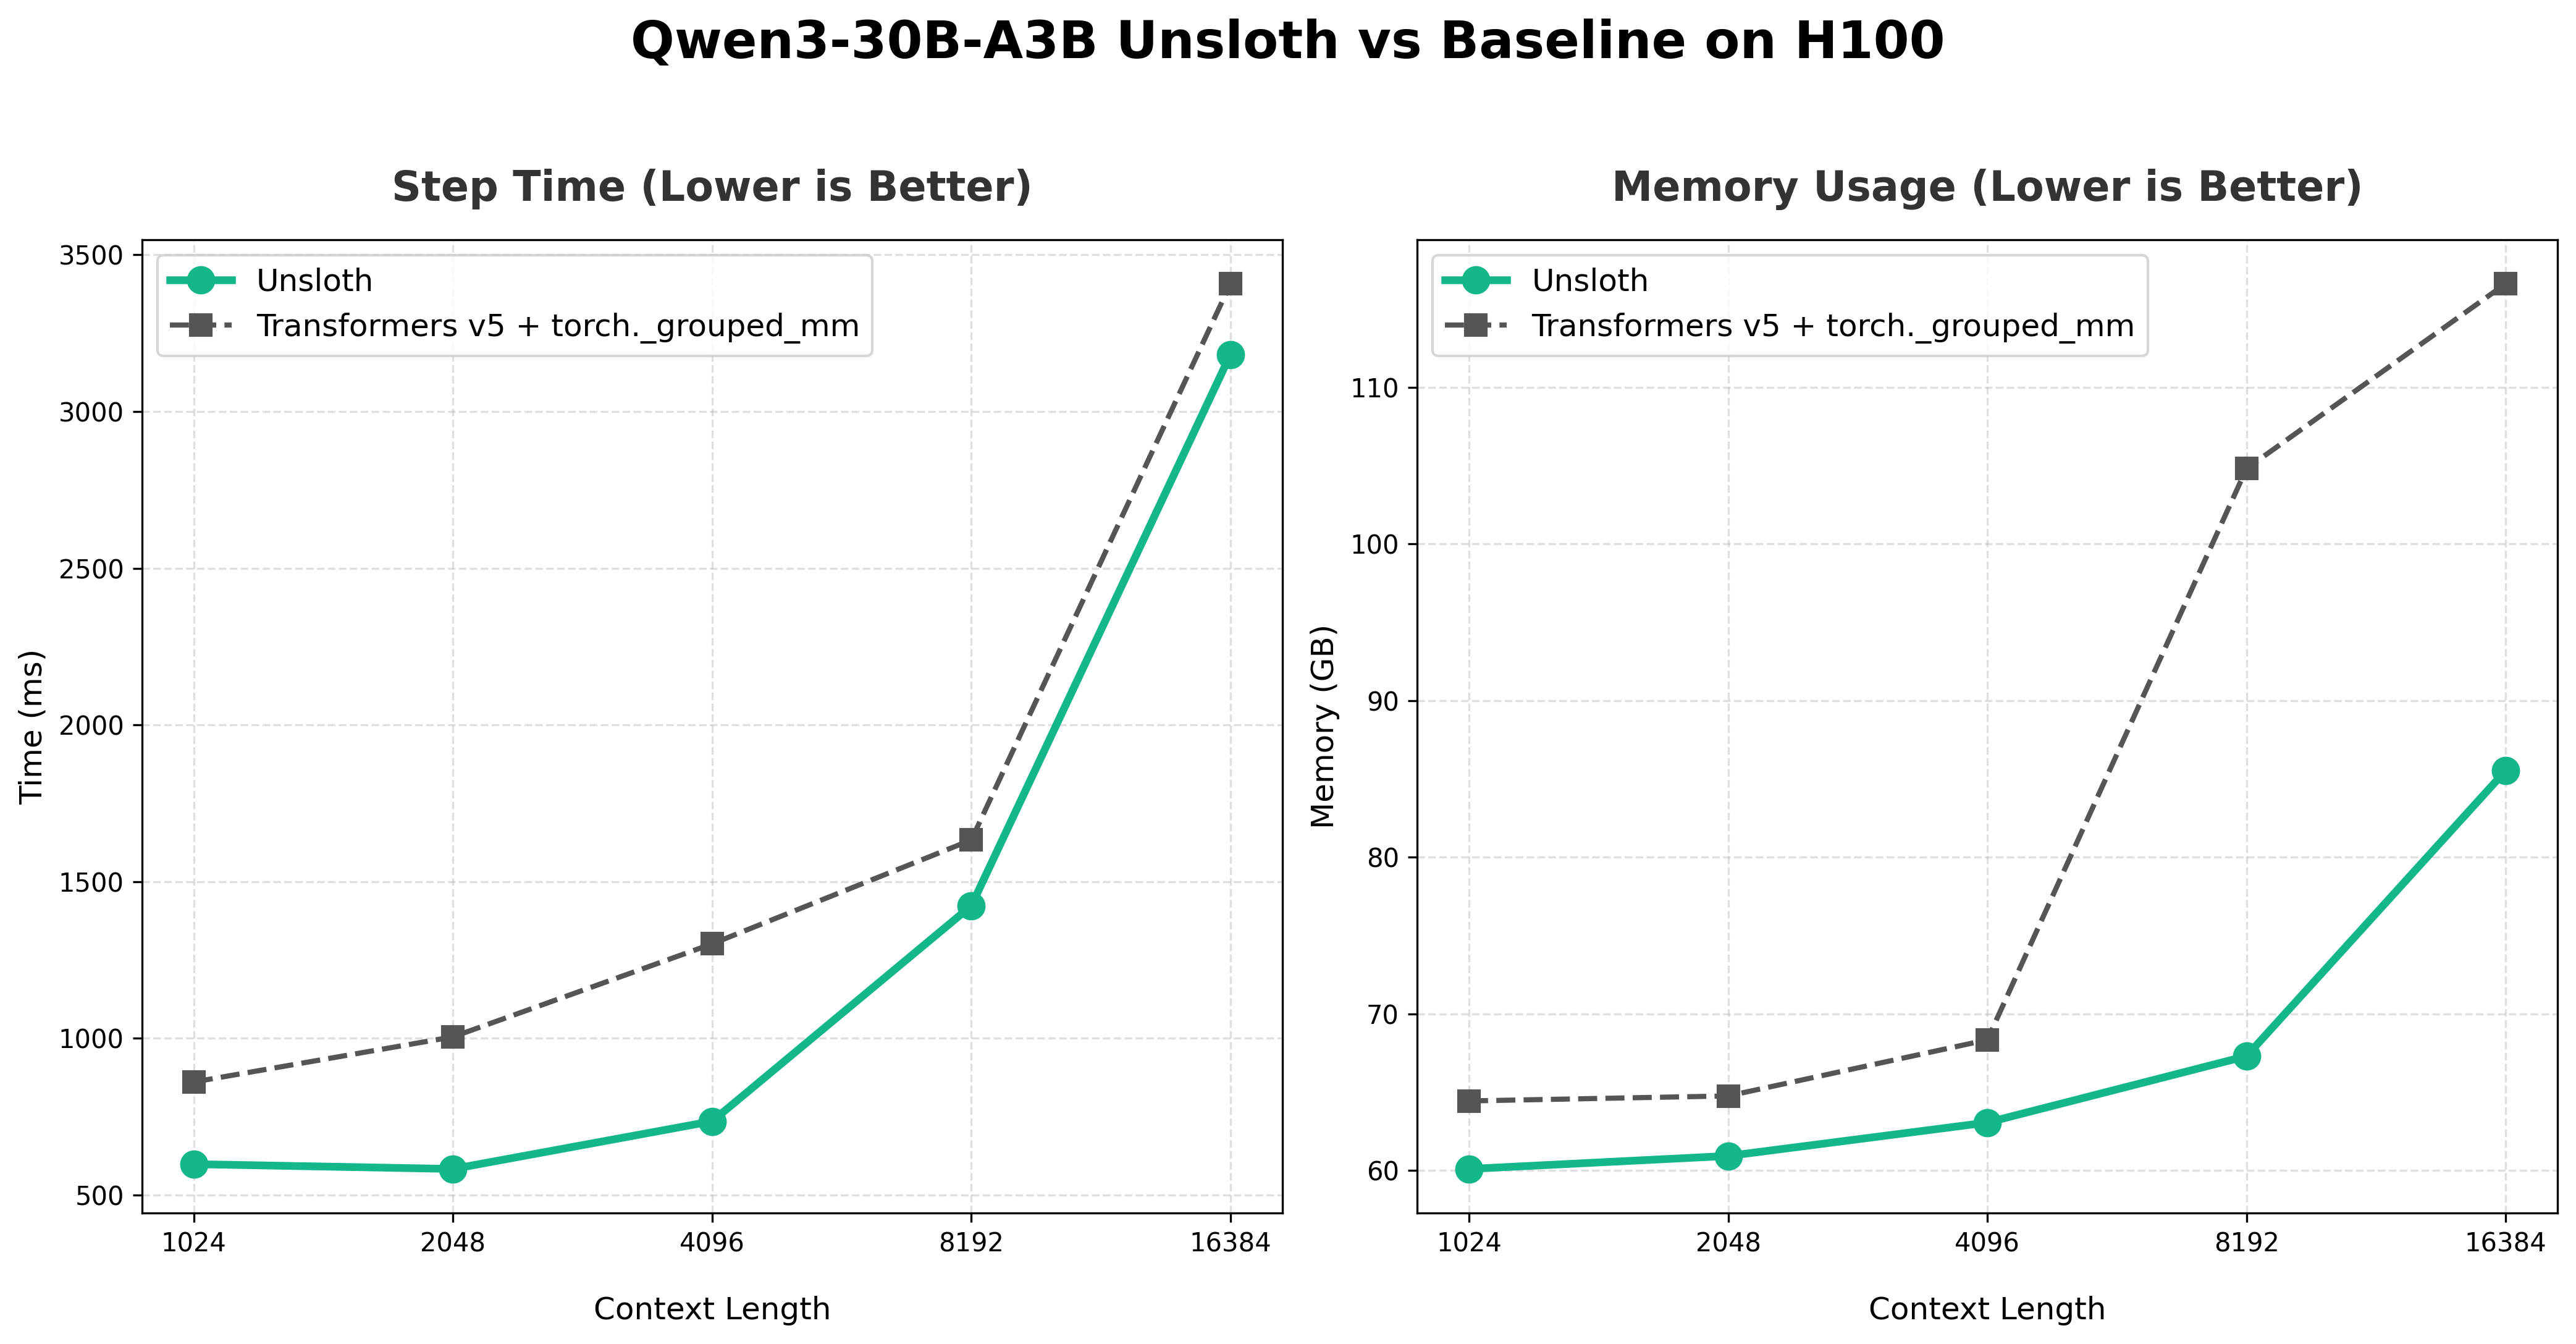
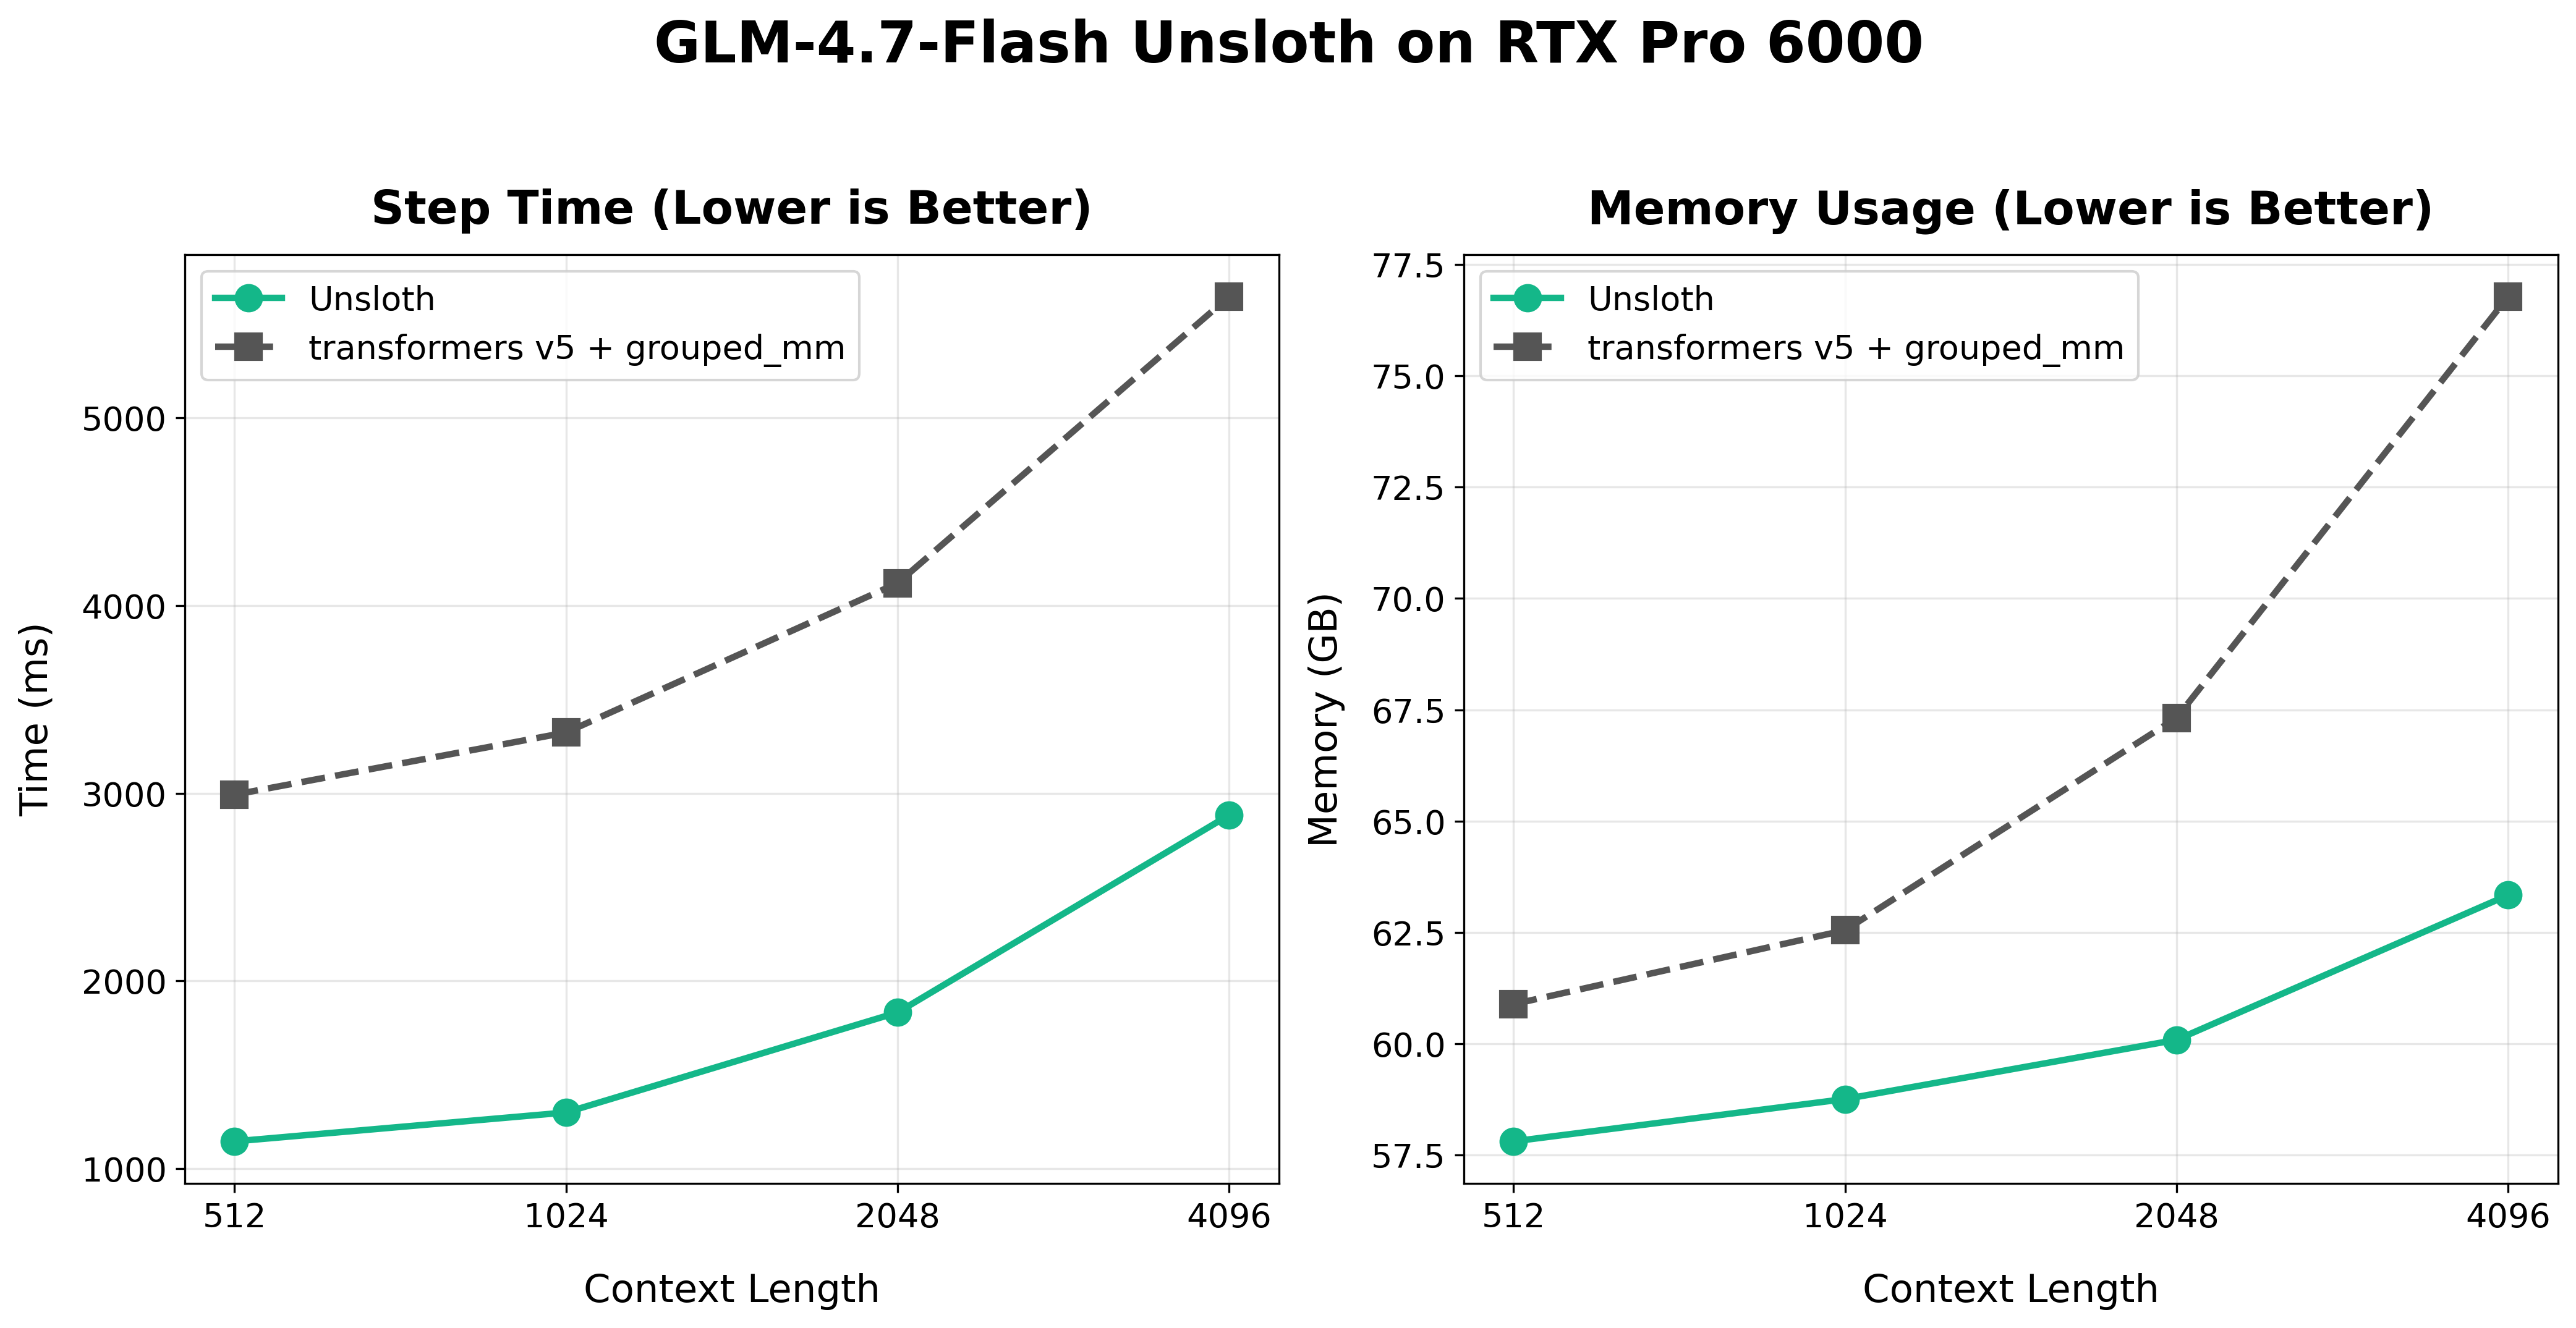
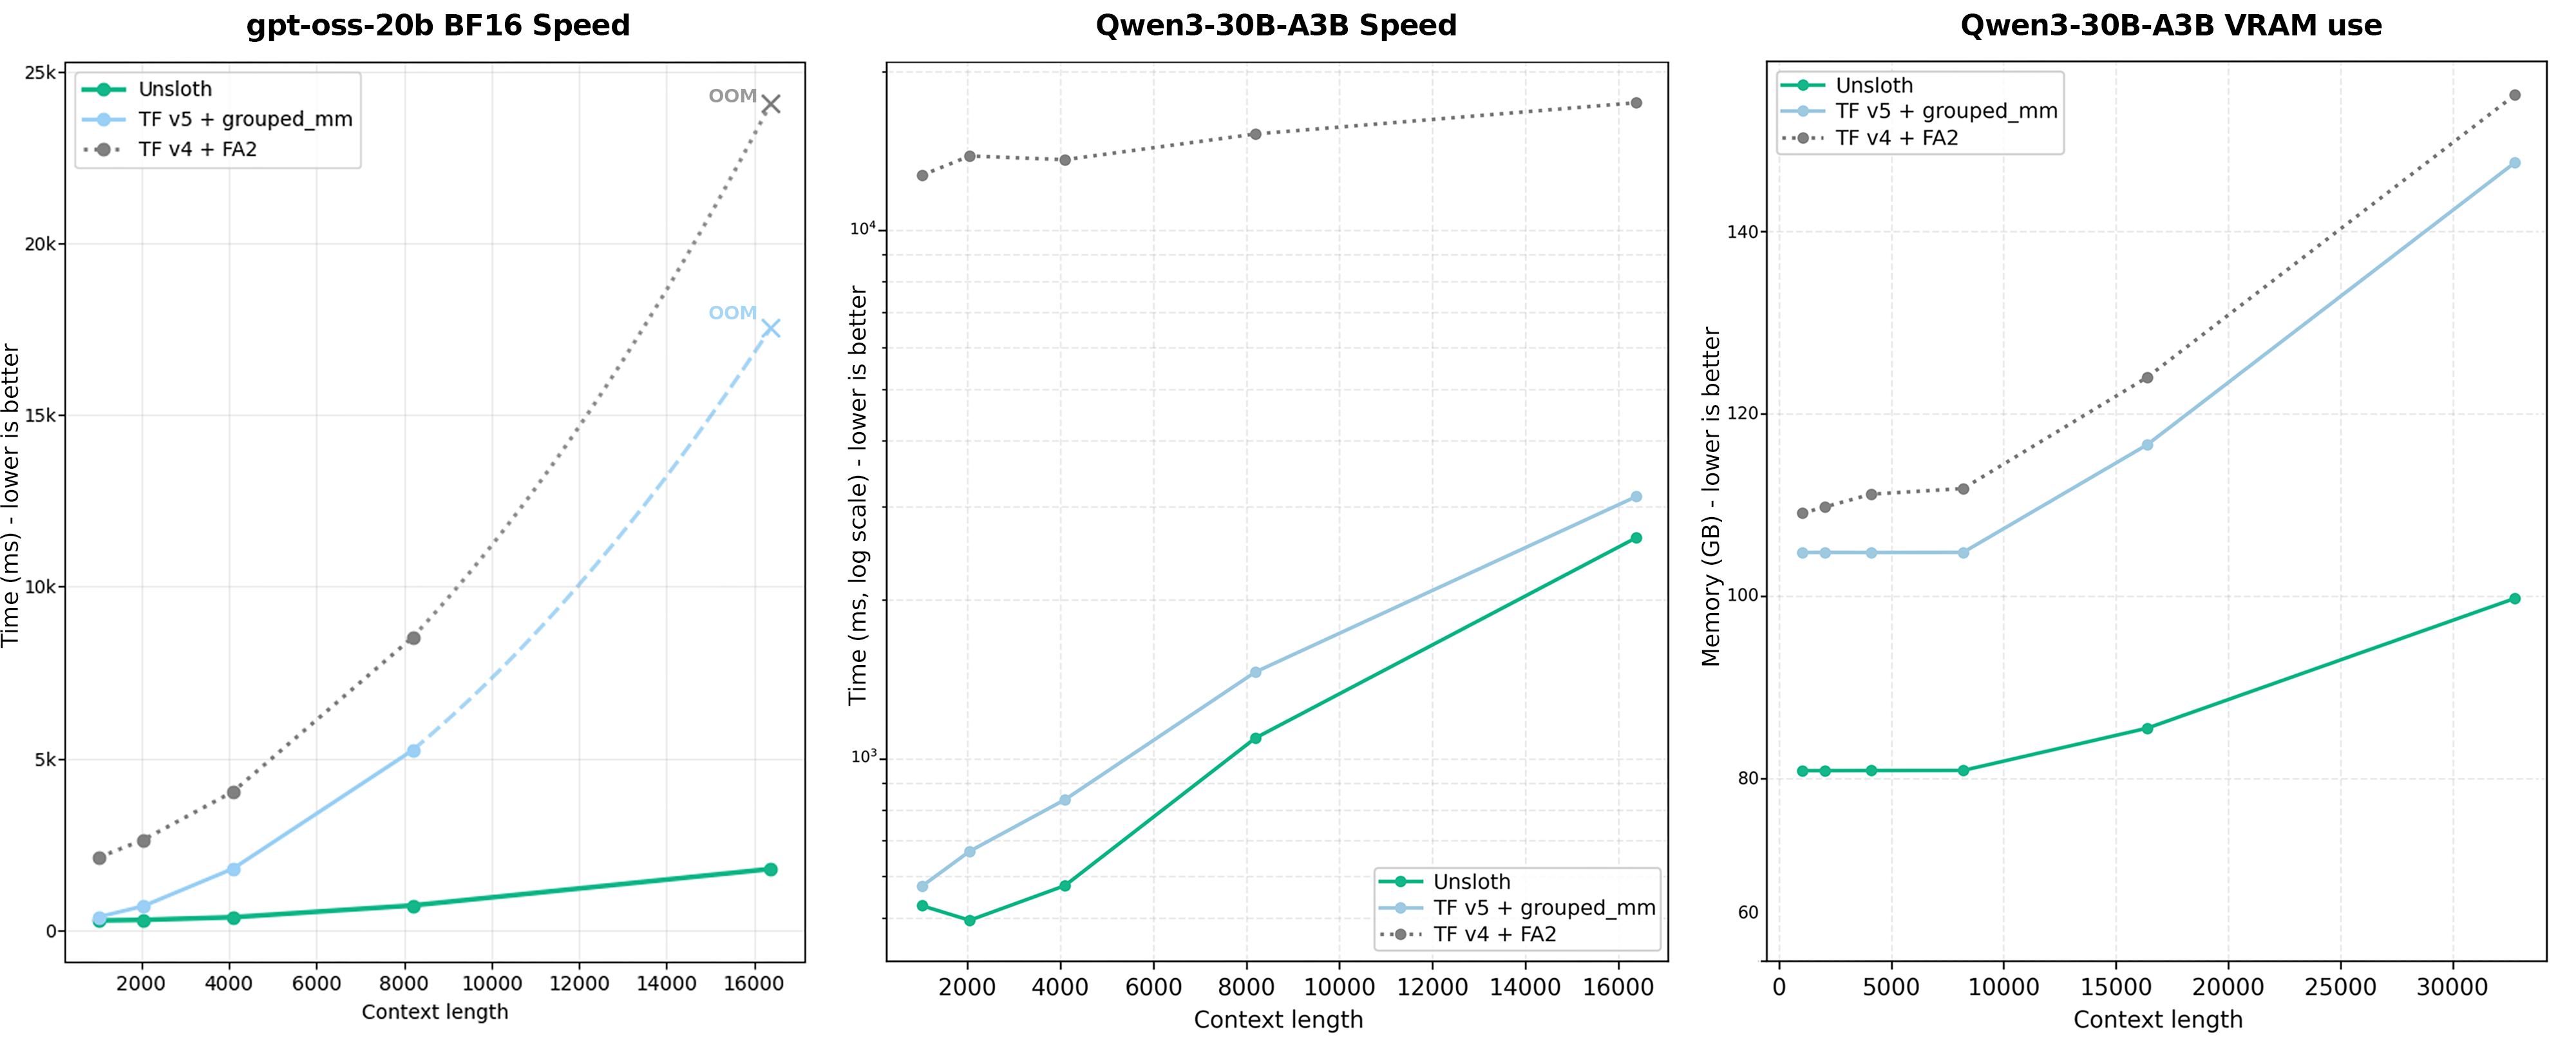
Unten ist ein Vergleich über Sequenzlängen hinweg für Trainingsgeschwindigkeit und Speichernutzung gegenüber Transformers v5 (das bereits `torch._grouped_mm` für MoE verwendet). Für **gpt-oss BF16 MoE-Training sehen wir auf NVIDIA B200 eine 7x schnellere Trainingsgeschwindigkeit und 36 % weniger VRAM** . Für Qwen3-30B-A3B ist es 1,8x schneller, und **GLM 4.7 Flash ist auf RTX PRO 6000 2,1x schneller**. Alle Benchmarks werden mit LoRA-Rang = 64 und allen LoRA-Modulen auf MoE-Schichten (gate, up, down) durchgeführt.

### gpt-oss-Benchmarks

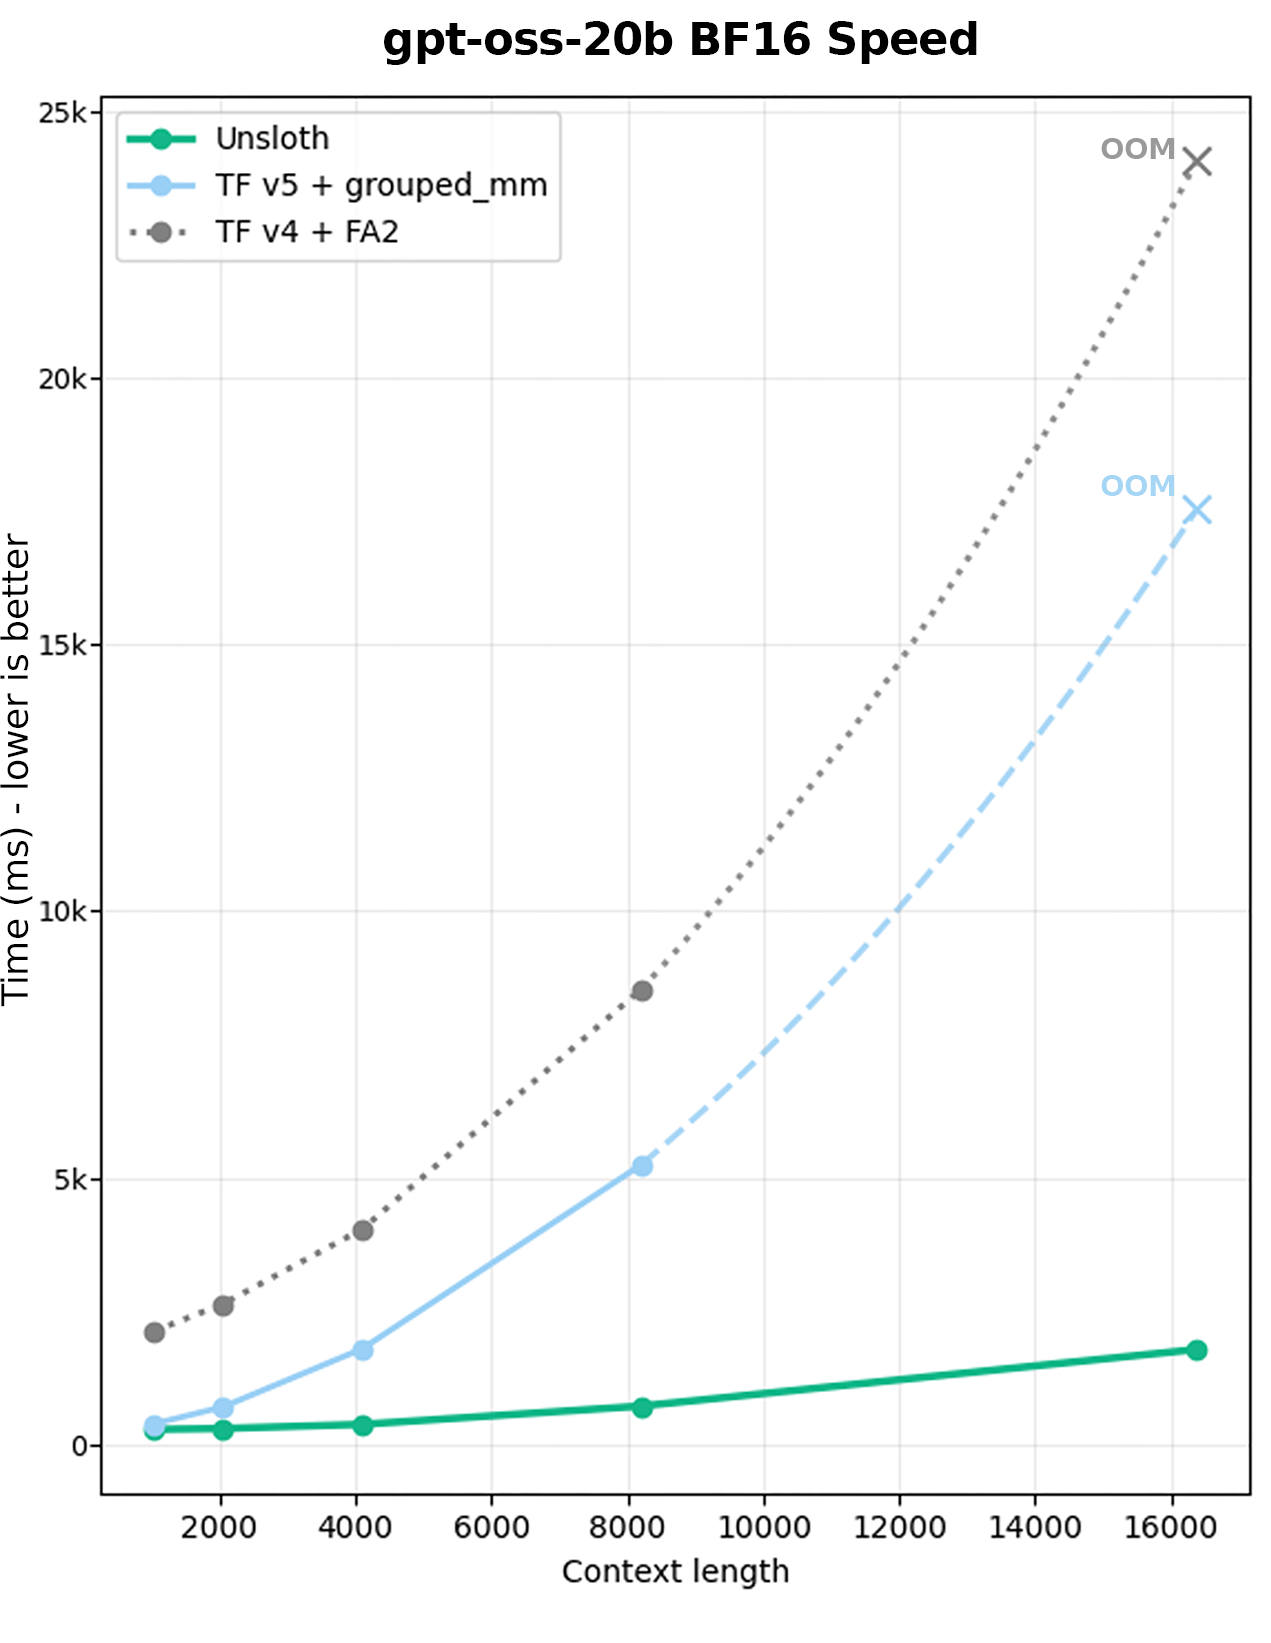
Wir haben [unsloth/gpt-oss-20b-BF16](https://huggingface.co/unsloth/gpt-oss-20b-BF16) für das Benchmarking feinabgestimmt. Unsloth ist 7x schneller und benötigt bei 16K-Kontextlängen 36 % weniger VRAM. Transformers v5 + TRL läuft wegen Speichermangels aus, während Unsloth das nicht tut. Außerdem steigt die Beschleunigung in diesem Fall dank unserer [Long Context gpt-oss](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#unsloths-flex-attention-implementation)und unserer MoE-Kernels weiter an.

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fja0OUMPoIM4KrWJPJyas%2Fgptoss%20new.png?alt=media&amp;token=29205c0e-a3c9-4749-8ebc-f8125d49dcf1" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FyZkJp7w21nrlf9JfCYZ0%2Fgptoss%20graph%20only.png?alt=media&amp;token=938e7590-b6a4-48eb-b53f-fdaa2bb2581c" alt="" width="188"><figcaption><p>Vergleich mit Transformers v4</p></figcaption></figure></div>

<table data-full-width="true"><thead><tr><th>Kontextlänge</th><th>Unsloth (ms)</th><th>TF v5 (ms)</th><th>Unsloth-Speicher (GB)</th><th>TF v5 Speicher (GB)</th><th>Beschleunigung</th><th>VRAM-Einsparung</th><th data-hidden>Rang</th><th data-hidden>Unsloth-Aufwärmphase (ms)</th><th data-hidden>TRL-Aufwärmphase (ms)</th></tr></thead><tbody><tr><td>1024</td><td>275.35</td><td>376.99</td><td>40.91</td><td>43.88</td><td>1,4x</td><td>6.76%</td><td>8</td><td>2601.17</td><td>615.62</td></tr><tr><td>2048</td><td>292.88</td><td>696.57</td><td>41.83</td><td>44.93</td><td>2,4x</td><td>6.89%</td><td>8</td><td>4996.62</td><td>928.42</td></tr><tr><td>4096</td><td>370.30</td><td>1785.89</td><td>43.68</td><td>49.86</td><td>4,8x</td><td>12.39%</td><td>8</td><td>6648.94</td><td>2130.33</td></tr><tr><td>8192</td><td>712.33</td><td>5226.86</td><td>47.43</td><td>73.80</td><td>7,3x</td><td>35.73%</td><td>8</td><td>9632.44</td><td>5472.66</td></tr><tr><td>16384</td><td>1775.80</td><td><strong>OOM</strong></td><td>55.13</td><td><strong>OOM</strong></td><td>n. v.</td><td>n. v.</td><td>8</td><td>12696.26</td><td>n. v.</td></tr></tbody></table>

### Qwen3-Benchmarks

Auf einer **NVIDIA B200**, sehen wir **\~1,7x Beschleunigung und \~35 % bessere Speichereffizienz mit Qwen3-30B-A3B LoRA**, wobei sich die Speichereinsparungen bei längeren Sequenzlängen weiter verbessern.

Qwen3-Next und Coder passen überraschenderweise in bf16 LoRA auf eine einzelne B200-GPU.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FonHXIql0XhGkLIDnuTfv%2Fimage.png?alt=media&amp;token=06f97769-1d0e-4edb-b9c5-6c305376c6e8" alt="" width="563"><figcaption></figcaption></figure>

Auf einer H100-GPU schneiden wir deutlich besser ab als die Baseline und erreichen bis zu **1,77x Beschleunigung** beim Training und sparen gleichzeitig \~5,3 GB bei der Feinabstimmung mit 4K-Kontextlänge. Während wir nahtlos auf 8192 Kontextlängen skalieren, läuft Transformers v5 + TRL bei 8K aus dem Speicher. Beachten Sie, dass wir bei 8K weniger Speicher verbrauchen als die Baseline bei 4K, sodass wir die Kontextlänge weiter erhöhen können.

<table data-full-width="true"><thead><tr><th>Kontextlänge</th><th>Unsloth (ms)</th><th>TF v5 (ms)</th><th>Unsloth-Speicher (GB)</th><th>TF v5 Speicher (GB)</th><th>Beschleunigung</th><th>VRAM-Einsparung</th><th data-hidden>Rang</th></tr></thead><tbody><tr><td>1024</td><td>366.3</td><td>628.3</td><td>80.88</td><td>104.80</td><td>1,7x</td><td>2.06%</td><td>8</td></tr><tr><td>2048</td><td>467.0</td><td>745.3</td><td>80.88</td><td>104.81</td><td>1,6x</td><td>2.57%</td><td>8</td></tr><tr><td>4096</td><td>711.6</td><td>975.5</td><td>80.89</td><td>104.80</td><td>1,4x</td><td>5.08%</td><td>8</td></tr><tr><td>8192</td><td>1376.6</td><td>1633.5</td><td>80.90</td><td>104.81</td><td>1,2x</td><td>9.17%</td><td>8</td></tr><tr><td>16384</td><td>3182.2</td><td>3407.9</td><td>85.53</td><td>116.61</td><td>1,1x</td><td>15.26%</td><td>8</td></tr></tbody></table>

### GLM 4.7 Benchmarks

Unsloth erreicht **2,6x höheren Durchsatz mit >15 % weniger VRAM** über alle Batch-Größen hinweg für GLM 4.7 Flash. GLM 4.7 Flash ist ein 30B-MoE-Modell (3B aktive Parameter) für agentische Aufgaben und Codierung und verwendet eine ähnliche Konfiguration wie der DeepSeek-MoE-Stil, mit 64 gerouteten Experten und 1 gemeinsam genutzten Experten. Wir haben das Unsloth-MoE-Training im Vergleich zum neuen optimierten Transformers v5 benchmarkiert.

Verwenden Sie unten unser neues Colab-Notebook für GLM 4.7 Flash:

{% embed url="<https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/GLM_Flash_A100(80GB).ipynb>" %}
GLM 4.7 Flash MoE-Notebook A100 80GB
{% endembed %}

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FbocwTistkljiMxGUA02y%2Fimage.png?alt=media&amp;token=2a804b3a-44e4-4666-aa4f-ba6a31f69f39" alt="" width="563"><figcaption></figcaption></figure>

<table data-full-width="true"><thead><tr><th>Kontextlänge</th><th>Unsloth (ms)</th><th>TF v5 (ms)</th><th>Unsloth-Speicher (GB)</th><th>TF v5 Speicher (GB)</th><th>Beschleunigung</th><th>VRAM-Einsparung</th><th data-hidden>Rang</th><th data-hidden>Unsloth-Aufwärmphase (ms)</th><th data-hidden>TRL-Aufwärmphase (ms)</th></tr></thead><tbody><tr><td><p></p><p>512</p></td><td>1145.0</td><td>2992.1</td><td>57.81</td><td>60.89</td><td>2,6x</td><td>6.51%</td><td>8</td><td>13317.46</td><td>893.04</td></tr><tr><td>1024</td><td>1298.9</td><td>3323.3</td><td>58.76</td><td>62.55</td><td>2,6x</td><td>6.22%</td><td>8</td><td>12895.28</td><td>937.37</td></tr><tr><td>2048</td><td>1831.9</td><td>4119.3</td><td>60.09</td><td>67.32</td><td>2,3x</td><td>9.46%</td><td>8</td><td>12531.37</td><td>1039.45</td></tr><tr><td>4096</td><td>2883.9</td><td>5646.1</td><td>63.34</td><td>76.78</td><td>2x</td><td>14.83%</td><td>8</td><td>7671.60</td><td>1643.26</td></tr></tbody></table>

### ⚡Schnelleres LoRA-MoE-Training

In Transformers/PEFT ist der übliche Ansatz, **den LoRA-Adapter mit dem Basisgewicht zusammenzuführen** und dann die MoE-Berechnung auszuführen (zumal MoE oft `nn.Parameter` anstatt `nn.Linear`). Das Problem ist, dass dieser Merge effektiv **das LoRA-Delta materialisiert (für alle Experten)** `lora_B @ lora_A.t`, was **sehr speicherhungrig ist**.

Unsloth vermeidet das. Wir haben zuvor dieselbe Idee verwendet, um allgemeines LoRA-Training und -Inferenz zu optimieren, und haben sie nun auch auf **MoE + LoRA** angewendet. Die Mathematik ist identisch, sodass Loss, Gradienten und Ausgaben gleich bleiben. Die einzige Änderung ist **die Reihenfolge der Operationen**, ermöglicht durch die Assoziativität der Matrixmultiplikation. Mit dieser Umordnung erreichen wir große Beschleunigungen und Speicherreduzierungen.

{% hint style="warning" %}
Das Training von MoE-Modellen in **4-Bit** QLoRA wird derzeit nicht empfohlen, da BitsandBytes es nicht unterstützt. Das ist nicht spezifisch für Unsloth. Verwenden Sie vorerst bf16 für LoRA oder vollständiges Fine-Tuning.
{% endhint %}

Diese Optimierungen sind **standardmäßig aktiviert** wenn MoE-Modelle mit Unsloth trainiert werden (insbesondere Qwen-3 MoE, gpt-oss und die oben erwähnten Modelle). Sie können Implementierungen über die `UNSLOTH_MOE_BACKEND` Umgebungsvariable wechseln: entweder `torch._grouped_mm` **Triton-Kernels** oder eine **einfache PyTorch-for-Schleife**, je nach Kompatibilität und Präferenz. Standardmäßig verwenden wir `grouped_mm` für die beste Leistung und breite Unterstützung.

```python
import os
# wenn Sie ein anderes Backend wählen möchten (standardmäßig grouped_mm), setzen Sie die untenstehende Variable:
# os.environ['UNSLOTH_MOE_BACKEND'] = 'unsloth_triton' # oder grouped_mm oder native_torch
lora_rank = 16
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "Qwen/Qwen3-30B-A3B-Instruct-2507", #MoE-Modell
    max_seq_length = max_seq_length,
    load_in_4bit = False, # Das MoE-nn.Parameter unterstützt bnb 4bit noch nicht
)
model = FastLanguageModel.get_peft_model(
    model,
    r = lora_rank,
    target_modules = [
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_up_proj", "down_proj", # LoRA auf MoE-Schichten!
    ],
    lora_alpha = lora_rank*2, # *2 beschleunigt das Training
    use_gradient_checkpointing = "unsloth", # Reduziert den Speicherverbrauch
    random_state = 3407,
)
```

## 📚 Details der Implementierung

LoRA ist eine parameter-effiziente Feinabstimmungsmethode: Anstatt die vollständige Gewichtsmatrix zu aktualisieren, trainiert man einen niedrig-rangigen „Adapter“ mit viel weniger Parametern, was den Speicherbedarf des Optimierers drastisch reduziert.

Wenn das ursprüngliche Gewicht die Form hat **(m, n)**, fügt LoRA zwei trainierbare Matrizen mit den Formen hinzu **(m, r)** und **(r, n)**. Ihr Produkt ist **(m, n)**, aber Sie verfolgen nur Optimizer-Zustände und Gradienten für:

* `m*r + r*n` Parameter (LoRA) statt
* `m*n` Parameter (vollständiges Fine-Tuning)

{% hint style="info" %}
Beim Fine-Tuning von MoE ist es keine gute Idee, die Router-Schicht feinabzustimmen, daher haben wir sie standardmäßig deaktiviert.
{% endhint %}

Für typische MLP-Schichten, `m ≈ 4096, n ≈ 12k und r ≈ 64`, das sind ungefähr **\~1M LoRA-Parameter gegenüber \~48M vollständigen Parametern -** etwa **\~2%,** oft mit minimalem bis keinem Genauigkeitsverlust.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FogBmpbd8eAirmDJaDCMl%2FLoRA%20Image?alt=media&amp;token=ce533f2c-ad6a-4cca-8588-fe0f548f8bae" alt="" width="255"><figcaption></figcaption></figure>

#### MoE-LoRA verändert die Dinge

MoE-Schichten sind anders, weil Sie **E Experten-MLPs parallel**, sodass jede expertenbezogene Änderung (wie das Hinzufügen von LoRA) auf alle Experten skaliert.

Nehmen wir **Qwen3‑30B‑A3B**: versteckte Größe **m=2048**, Zwischengröße **n=768**, **E=128** Experten mit **k=8** pro Token aktiviert. Pro Experte:

* `gate_proj` und `up_proj`: `(m, n) = (2048, 768)`
* `down_proj`: `(n, m) = (768, 2048)`

Mit **LoRA-Rang r=64**, fügt jede Projektion hinzu `r*(m+n)=64*(2048+768)=180,224` Parameter pro Experte (≈ `11%` einer `2048×768` -Matrix). Das Kernproblem ist, dass `r/n = 64/768` im Vergleich zu typischen MLP-Setups groß ist, z. B., `r/n = 64/25600` in [Qwen3-32B](https://huggingface.co/Qwen/Qwen3-32B/blob/main/config.json#L13) gleicher Größe.

Wenn Sie dies für *alle* Experten materialisieren, summiert sich der Speicher schnell. Und da `gate_proj` und `up_proj` oft zusammengeführt werden als `gate_up_proj`, materialisiert man sie typischerweise gemeinsam, was den Overhead/die Spitzenbelegung des Speichers ungefähr verdoppelt.

**Bezüglich des Speichers haben wir für eine Sequenzlänge s, E Experten und `k` ausgewählt, die folgende gemeinsame Form für beide Ansätze**

```
# Alle diese Werte sind pro Experte
Endausgabe: (s, n)
Eingabeaktivierungen: (s, m)
Endausgabe: (s, n)
```

Hier beginnen die Unterschiede. Für den Ansatz von PEFT haben wir

```
delta = loraA@loraB  = (m,n) pro Experte = Emn Parameter
```

Für den Split-LoRA-Ansatz von Unsloth führen wir die folgenden Operationen aus

```
Y = X @ loraA : (s,m) @ (m, r)       # aber spärlich für k Experten = ksr Parameter
Y @ loraB: (s, r) @ (r, n)           # aber erneut spärlich für k Experten = ksn Parameter
```

Betrachten wir nun den Fall von Qwen3-30B-A3B.

`E = 128, k = 8, m = 2048, n = 768.` Setzen wir all das ein, erhalten wir `s < 32K.`&#x20;

$$
\begin{aligned}
\text{PEFT params}                       &:\quad Emn \\
\text{Unsloth Split LoRA params}         &:\quad ks(r+n) \\
\text{In typical LoRA we have}           &:\quad r \ll n \\
\text{Split LoRA is better when}         &:\quad Emn > ksn ;=; Em > ks \\
\\
\text{For Qwen3-30B-A3B, we have} \\
E &= 128, \quad k = 8, \quad m = 2048, \quad n = 768 \\
\\
\text{So, Split LoRA is mathematically better when} \\
s &< \frac{Emn}{kn} = 32K
\end{aligned}
$$

**Im Hinblick auf den Rechenaufwand, für eine Sequenzlänge `s`, `E` Experten und Top- `k` ausgewählt, rechnen wir:**

$$
\begin{aligned}
\Delta = AB,
A \in \mathbb{R}^{m \times r}, ;
B \in \mathbb{R}^{r \times n}
&\quad \Rightarrow \quad 2mnr \text{ flops per expert lora} \\
\\
W' = W + \Delta
\quad &\Rightarrow \quad mn \text{ flops} \\
\\
XW'  \quad | \quad
X \in \mathbb{R}^{s \times m}, ;
W' \in \mathbb{R}^{m \times n}
\quad &\Rightarrow \quad 2smn \text{ flops} \\
\\
\text{MoE peft lora flops}
&= E\big(2mnr + mn\big)

* 2k,smn
  \end{aligned}
  $$

Im Fall des von uns erwähnten Unsloth Split LoRA haben wir

$$
\begin{aligned}
XW &= 2smn  \text{  flops} \\
Y = XA, &= 2smr
\quad \text{(applied only to routed token--expert pairs)} \\
\
Z = YB &= 2srn \\
\text{MoE split lora flops}
&= 2k\big(smn + smr + srn\big) \\
\text{Crossover condition}
&:\quad 2ksr(m+n) > 2Emn(r+1/2)
\Rightarrow
s > \frac{Emn}{k(m+n)} \times (1+ \frac{1}{2r}) \\
\\
\text{For Qwen3-30B-A3B with}
&:
E = 128,;
m = 2048,;
n = 768,;
k = 8 \\
\\
\Rightarrow \quad
s
& ;\approx; 16\text{K tokens}
\end{aligned}
$$

Der Punkt, bis zu dem Split LoRA aus analytischer Sicht besser ist, liegt bei `s > Emn/k(m+n)` was in der Größenordnung von `16K` Tokens für ein Modell im Stil von Qwen3-30B-A3B liegt.

Schließlich ergeben sich einige Beschleunigungen aus **reduziertem Speicherverkehr**: Moderne GPUs sind oft **bandbreitengebunden**, sodass das Übertragen weniger Daten wichtiger sein kann als FLOPs. Eine grobe Schätzung der Beschleunigung lautet `Emn / [k·s·(m+n)]`, daher hängt sie stark von **s, E, k**und den Matrixformen ab.

### 🔮 Modellunterstützung

Unsloth unterstützt schnelleres MoE-Training für Qwen-, gpt-oss-, DeepSeek- und GLM-Modelle:

* **Qwen3** (Thinking und Instruct): VL • 2507 • Coder&#x20;
* **gpt-oss**: 20B • 120B • safeguard
* **GLM**: 4.5 • 4.6 • 4.6-Air • 4.7 • 4.7-Flash
* **DeepSeek**: V3 • R1 • V3.1 • V3.2

Wir haben möglicherweise einige MoE-Modelle nicht hochgeladen, aber Unsloth sollte sie dennoch unterstützen.

### 📈 Weitere Benchmarks

#### gpt-oss BF16-Benchmarks

Trainingsgeschwindigkeit im Vergleich zu Transformers v4

<table data-full-width="false"><thead><tr><th align="right">Kontextlänge</th><th align="right">Unsloth (ms)</th><th align="right">TF v5 (ms)</th><th align="right">TF v4 (ms)</th><th align="right">Beschleunigung</th></tr></thead><tbody><tr><td align="right">1024</td><td align="right">275.35</td><td align="right">376.99</td><td align="right">2111.18</td><td align="right">1,37x</td></tr><tr><td align="right">2048</td><td align="right">292.88</td><td align="right">696.57</td><td align="right">2626.80</td><td align="right">2,38x</td></tr><tr><td align="right">4096</td><td align="right">370.30</td><td align="right">1785.89</td><td align="right">4027.93</td><td align="right">4,82x</td></tr><tr><td align="right">8192</td><td align="right">712.33</td><td align="right">5226.86</td><td align="right">8513.52</td><td align="right">7,34x</td></tr><tr><td align="right">16384</td><td align="right">1775.80</td><td align="right">OOM</td><td align="right">OOM</td><td align="right">n. v.</td></tr></tbody></table>

**VRAM-Nutzung**

<table data-full-width="false"><thead><tr><th align="right">Kontextlänge</th><th align="right">Unsloth-Speicher (GB)</th><th align="right">TF v5 Speicher (GB)</th><th align="right">TF v4 Speicher (GB)</th><th align="right">VRAM-Einsparung</th></tr></thead><tbody><tr><td align="right">1024</td><td align="right">40.91</td><td align="right">43.88</td><td align="right">89.75</td><td align="right">6.76%</td></tr><tr><td align="right">2048</td><td align="right">41.83</td><td align="right">44.93</td><td align="right">90.47</td><td align="right">6.89%</td></tr><tr><td align="right">4096</td><td align="right">43.68</td><td align="right">49.86</td><td align="right">92.72</td><td align="right">12.39%</td></tr><tr><td align="right">8192</td><td align="right">47.43</td><td align="right">73.80</td><td align="right">100.3</td><td align="right">35.73%</td></tr><tr><td align="right">16384</td><td align="right">55.13</td><td align="right">OOM</td><td align="right">OOM</td><td align="right">n. v.</td></tr></tbody></table>

## :tada: Wichtige Unsloth-Updates

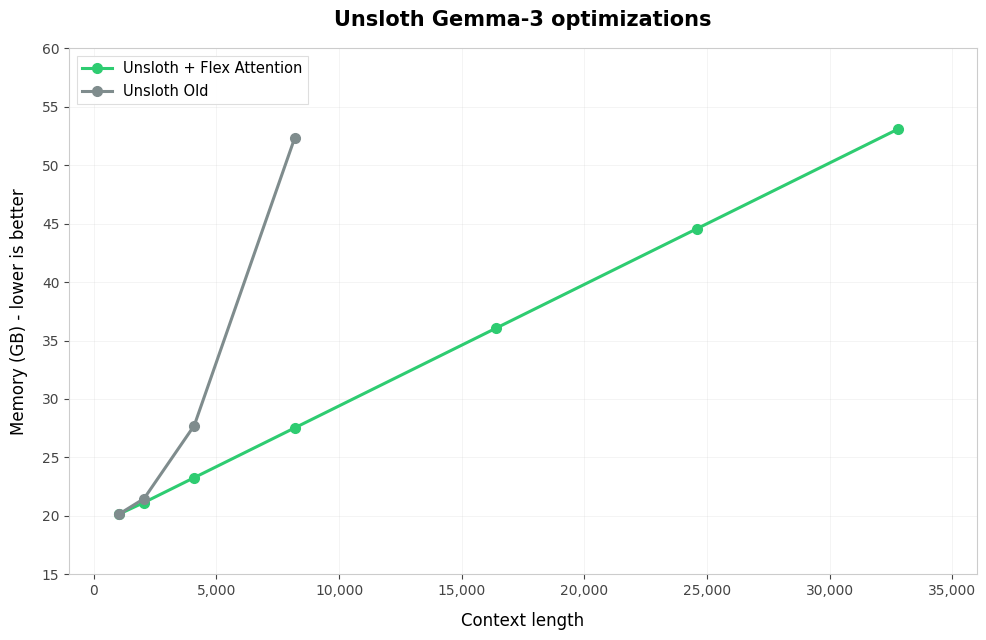
1. Im Rahmen unserer MoE-Veröffentlichung haben wir auch **Gemma-3 nutzt jetzt standardmäßig Flex-Attention** , und das funktioniert auch in float16-Einstellungen (es gab Unendlichkeiten, die wir vor einiger Zeit behoben haben). **Gemma-3 verwendet jetzt O(N)-Speicher und nicht O(N^2)-Speicher, und trainiert >3x schneller** (skaliert mit der Kontextlänge sogar noch besser). Frühere Unsloth-Versionen wären aus dem Speicher gelaufen.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FZiM9zMhVlUaJXC4Y1REp%2Fimage.png?alt=media&amp;token=b2f1d12e-ccdb-431c-9b65-284db3892e2c" alt="" width="375"><figcaption></figcaption></figure>

| Kontext | Alte Spitzen-VRAM | Neue Spitzen-VRAM | VRAM-Einsparung |
| ------- | ----------------- | ----------------- | --------------- |
| 1K      | 20,1 GB           | 20,1 GB           | 0 GB (0%)       |
| 2K      | 21,5 GB           | 21,1 GB           | 0,3 GB (2%)     |
| 4K      | 27,7 GB           | 23,3 GB           | 4,5 GB (16%)    |
| 8K      | 52,3 GB           | 27,5 GB           | 24,8 GB (47%)   |
| 16K     | OOM               | 36,0 GB           | --              |
| 24K     | OOM               | 44,6 GB           | --              |
| 32K     | OOM               | 53,1 GB           | --              |
| 48K     | OOM               | 38,4 GB           | --              |
| 64K     | OOM               | 44,7 GB           | --              |

2. Vision-Fine-Tuning akzeptiert jetzt gemischte Daten, die nur aus Bildern und Textdaten bestehen!
3. [Windows wird jetzt offiziell unterstützt, ohne dass WSL erforderlich ist](/docs/de/loslegen/install/windows-installation.md).
4. `trl==0.27.1` und `transformers==5.1.0` werden gut unterstützt - die bisherige Abdeckung lag bei 30 % aller unserer 120 Notebooks, aber jetzt haben wir eine Abdeckung von >80 % - wir planen, sie in den nächsten Tagen auf 100 % zu bringen.
5. Viele Fehlerbehebungen und andere Aktualisierungen - siehe <https://github.com/unslothai/unsloth/releases/tag/February-2026>

{% hint style="success" %}
Um schnelleres MoE-Training zu aktivieren, aktualisieren Sie Unsloth über `pip install --upgrade unsloth unsloth_zoo`
{% endhint %}

### Danksagungen

Wir danken dem Hugging-Face-Team dafür, dass es mit uns zusammengearbeitet hat, um das MoE-Training für die Community zu verbessern.

Wir danken auch dem torchao-Team von Herzen, insbesondere Vasily Kuznetsov (vkuzo), dafür, dass er uns geholfen hat, die Unterstützung für grouped\_mm für float16 zu aktivieren, damit es auf T4 funktioniert und die Rückwärtskompatibilität mit A100 gewährleistet ist.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/grundlagen/faster-moe.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.