> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/grundlagen/embedding-finetuning.md).
# Leitfaden zur Feinabstimmung von Embedding-Modellen mit Unsloth
Erfahren Sie, wie Sie Embedding-Modelle mit Unsloth ganz einfach feinabstimmen.
Das Fine-Tuning von Embedding-Modellen kann die Retrieval- und RAG-Leistung bei bestimmten Aufgaben erheblich verbessern. Es gleicht die Vektoren des Modells mit Ihrer Domäne und der Art von „Ähnlichkeit“ ab, die für Ihren Anwendungsfall relevant ist, was die Suche, RAG, Clusterbildung und Empfehlungen auf Ihren Daten verbessert.
Beispiel: Die Schlagzeilen „Google bringt das Pixel 10 auf den Markt“ und „Qwen veröffentlicht Qwen3“ könnten als ähnlich eingebettet werden, wenn Sie beide nur als „Tech“ kennzeichnen, aber nicht ähnlich, wenn Sie semantische Suche durchführen, da sie von unterschiedlichen Dingen handeln. Fine-Tuning hilft dem Modell, die „richtige“ Art von Ähnlichkeit für Ihren Anwendungsfall zu erzeugen, Fehler zu reduzieren und die Ergebnisse zu verbessern.
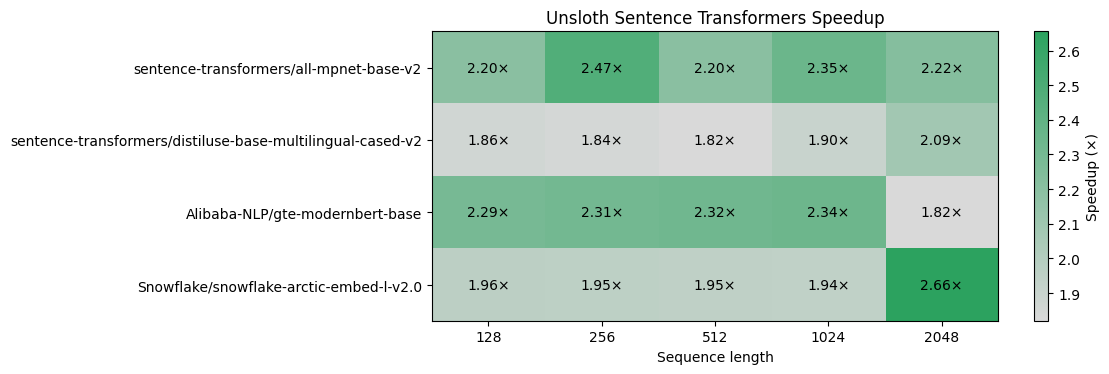
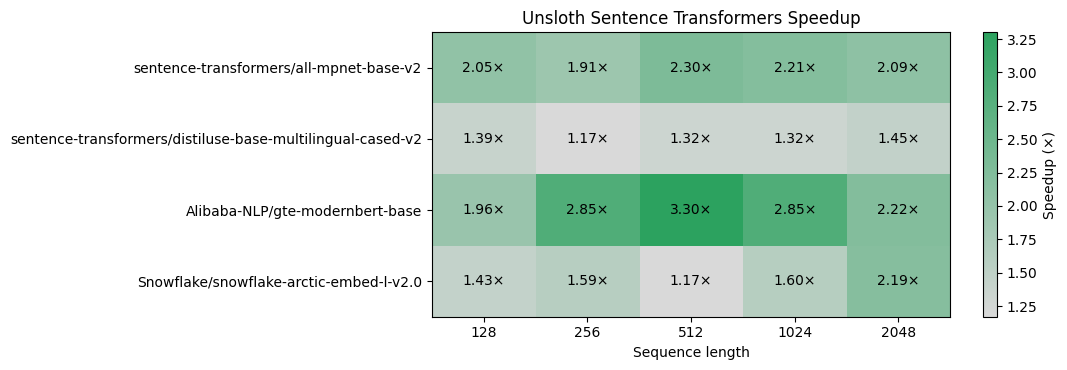
[**Unsloth**](https://github.com/unslothai/unsloth) unterstützt jetzt das Training von Embeddings, **Klassifikator**, **BERT**, **Reranker** Modelle [**\~1,8-3,3x schneller**](#unsloth-benchmarks) mit 20 % weniger Speicher und 2x längerem Kontext als andere Flash-Attention-2-Implementierungen – ohne Genauigkeitsverlust. EmbeddingGemma-300M läuft mit nur **3GB VRAM**. Sie können Ihr trainiertes **Modell überall**: Transformers, LangChain, Ollama, vLLM, llama.cpp usw.
Unsloth verwendet [SentenceTransformers](https://github.com/huggingface/sentence-transformers) um kompatible Modelle wie Qwen3-Embedding, BERT und weitere zu unterstützen. **Selbst wenn es kein Notebook oder keinen Upload gibt, wird es dennoch unterstützt.**
**Wir haben kostenlose Fine-Tuning-Notebooks erstellt, mit 3 Hauptanwendungsfällen:**
| [EmbeddingGemma (300M)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/EmbeddingGemma_\(300M\).ipynb) | [Qwen3-Embedding 4B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_Embedding_\(4B\).ipynb) • [0.6B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_Embedding_\(0_6B\).ipynb) | [BGE M3](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/BGE_M3.ipynb) |
| ---------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------- |
| [ModernBERT](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/bert_classification.ipynb) - Klassifikation | [All-MiniLM-L6-v2](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/All_MiniLM_L6_v2.ipynb) | [ModernBERT-large](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/bert_classification.ipynb) |
* `All-MiniLM-L6-v2`: erzeugen kompakte, domänenspezifische Satz-Embeddings für semantische Suche, Retrieval und Clustering, abgestimmt auf Ihre eigenen Daten.
* `tomaarsen/miriad-4.4M-split`: medizinische Fragen und biomedizinische Arbeiten für hochwertige medizinische semantische Suche und RAG einbetten.
* `electroglyph/technical`: Bedeutung und semantische Ähnlichkeit in technischem Text (Dokumentationen, Spezifikationen und technische Diskussionen) besser erfassen.
Den Rest unserer hochgeladenen Modelle können Sie in [unserer Sammlung hier](https://huggingface.co/collections/unsloth/embedding-models).
> Ein riesiges Dankeschön an den Unsloth-Beitragenden [**electroglyph**](https://github.com/unslothai/unsloth/pull/3719), dessen Arbeit maßgeblich dazu beigetragen hat, dies zu unterstützen. Sie können sich electroglyphs benutzerdefinierte Modelle auf Hugging Face ansehen [hier](https://huggingface.co/electroglyph).
### 🦥 Unsloth-Funktionen
* LoRA/QLoRA oder vollständiges Fine-Tuning für Embeddings, ohne Ihre Pipeline neu schreiben zu müssen
* Beste Unterstützung für Encoder-only `SentenceTransformer` Modelle (mit einer `modules.json`)
* Für Cross-Encoder-Modelle ist bestätigt, dass sie auch unter dem Fallback-Pfad korrekt trainieren
* Dieses Release unterstützt außerdem `transformers v5`
Es gibt eingeschränkte Unterstützung für Modelle ohne `modules.json` (wir weisen automatisch Standard- `SentenceTransformers` Pooling-Module zu). Wenn Sie etwas Eigenes machen (benutzerdefinierte Köpfe, nicht standardmäßiges Pooling), überprüfen Sie Ausgaben wie das Verhalten des gepoolten Embeddings doppelt.
Einige Modelle, die benutzerdefinierte Ergänzungen wie MPNet oder DistilBERT benötigten, wurden durch das Einspielen von Gradient Checkpointing in das aktiviert `transformers` Modelle.
### 🛠️ Fine-Tuning-Workflow
Der neue Fine-Tuning-Ablauf dreht sich um `FastSentenceTransformer`.
Wichtige Speicher-/Push-Methoden:
* `save_pretrained()` Speichert **LoRA-Adapter** in einem lokalen Ordner
* `save_pretrained_merged()` Speichert das **zusammengeführte Modell** in einem lokalen Ordner
* `push_to_hub()` Lädt **LoRA-Adapter** zu Hugging Face hoch
* `push_to_hub_merged()` Lädt das **zusammengeführte Modell** zu Hugging Face hoch
**Und ein sehr wichtiges Detail: Das Laden für die Inferenz erfordert `for_inference=True`**
`from_pretrained()` ist Lackers anderen schnellen Klassen ähnlich, mit **einer Ausnahme**:
* Um ein Modell für **Inferenz** mit `FastSentenceTransformer`, dann **muss** übergeben werden: `for_inference=True`
Ihre Inferenz-Ladevorgänge sollten also so aussehen:
```python
model = FastSentenceTransformer.from_pretrained(
"sentence-transformers/all-MiniLM-L6-v2",
for_inference=True,
)
```
Für die Hugging-Face-Autorisierung gilt: Wenn Sie ausführen:
```
hf auth login
```
innerhalb derselben virtuellen Umgebung vor dem Aufruf der Hub-Methoden, dann:
* `push_to_hub()` und `push_to_hub_merged()` **benötigen Sie kein Token-Argument**.
### ✅ Inferenz und überall bereitstellen!
Ihr fein abgestimmtes Unsloth-Modell kann mit allen wichtigen Tools verwendet und bereitgestellt werden: transformers, LangChain, Weaviate, sentence-transformers, Text Embeddings Inference (TEI), vLLM und llama.cpp, benutzerdefinierte Embedding-API, pgvector, FAISS-/Vektordatenbanken und jedes RAG-Framework.
Es gibt keinen Lock-in, da das fein abgestimmte Modell später lokal auf Ihr eigenes Gerät heruntergeladen werden kann.
```python
# 1. Laden Sie ein vortrainiertes Sentence-Transformer-Modell
model = SentenceTransformer("
Nachfolgend sind unsere Unsloth-Benchmarks in einer Heatmap im Vergleich zu `SentenceTransformers` + Flash Attention 2 (FA2) für 16-Bit-LoRA. **Für 16-Bit-LoRA ist Unsloth 1,2x bis 3,3x schneller:**
### 🔮 Modellunterstützung
Hier sind einige beliebte Embedding-Modelle, die Unsloth unterstützt (nicht alle Modelle sind hier aufgeführt):
```
Alibaba-NLP/gte-modernbert-base
BAAI/bge-large-en-v1.5
BAAI/bge-m3
BAAI/bge-reranker-v2-m3
Qwen/Qwen3-Embedding-0.6B
answerdotai/ModernBERT-base
answerdotai/ModernBERT-large
google/embeddinggemma-300m
intfloat/e5-large-v2
intfloat/multilingual-e5-large-instruct
mixedbread-ai/mxbai-embed-large-v1
sentence-transformers/all-MiniLM-L6-v2
sentence-transformers/all-mpnet-base-v2
Snowflake/snowflake-arctic-embed-l-v2.0
```
Die meisten [gängigen Modelle](https://huggingface.co/models?library=sentence-transformers) werden bereits unterstützt. Wenn es ein nur-Encoder-Modell gibt, das Sie sich wünschen und das noch nicht unterstützt wird, können Sie gerne ein [GitHub-Issue](https://github.com/unslothai/unsloth/issues) entsprechendes Ticket eröffnen.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/grundlagen/embedding-finetuning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.