> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/grundlagen/dynamic-3.0-ggufs.md).

# Unsloth Dynamic 3.0 GGUFs

**Unsloth Dynamic V3.1** (Nov. 2026) ist unser neuester Quantisierungsalgorithmus für Qwen3.8-27B, DeepSeek-V4.1-Flash-1017 und Qwen3.8-Flash-Next und erzielt **10–15 % höhere Genauigkeit** und **50 % weniger Tokenverbrauch** als andere Quants derselben Größe. Wir arbeiten an einer noch besseren Version dynamischer Quants, die für Qwen4 und alle zukünftigen Modelle eingesetzt wird.

Unsloth [Qwen3.8-27B](https://unsloth.ai/docs/de/modelle/qwen3.8.md) Dynamic V3.1 verschiebt die Pareto-Grenze für alle Quants und übertrifft unsere bisherigen UD3-Quants, Exllama-3 und GSQ-RCO.

[Qwen3.8-Flash-Next](https://unsloth.ai/docs/de/modelle/qwen3.8-next.md) Die 1-Bit-Quantisierung erreicht 54,0 % auf DeepSWE v1.1 und 68,3 % auf Terminal Bench 2.1.

[DeepSeek-V4.1-Flash-1017](https://unsloth.ai/docs/de/modelle/deepseek-v4.1-flash.md) Dynamic V3.1 IQ1\_S erreicht 65,8 % auf DeepSWE v1.1, 69,5 % auf Terminal Bench 2.1 und 51,5 % auf Automation Bench v1.0.6.

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FRHyZ5X7qYZAdCQsgKT7R%2Ffour(1).png?alt=media&amp;token=3c563d60-5767-437a-a704-98fffecb04f8" alt=""><figcaption><p>Benchmarks für Qwen3.8-27B</p></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FXC2NHQCS4KKsMoY4IjpT%2Fimage.png?alt=media&amp;token=67fb9d55-8fbb-4f35-a13f-83465cee8475" alt=""><figcaption><p>Benchmarks für DeepSeek-V4.1-Flash-1017</p></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FqdXHweLFGzUhUcqj7jZX%2Ffinal%20key%204.png?alt=media&amp;token=8e3249b1-e26c-4a04-82ba-7cfdef952fe6" alt=""><figcaption><p>Benchmarks für Qwen3.8-Flash-Next</p></figcaption></figure></div>

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWTSMbLLxexSW1HiwU411%2Fqwen%20speed%20token%20con.png?alt=media&amp;token=fea0700d-24e7-4046-a915-4c087e0230aa" alt=""><figcaption><p>Benchmarks zu Tokenverbrauch und Geschwindigkeit von Qwen3.8-Flash-Next GGUF</p></figcaption></figure>

### Dynamic v3.0

Nachfolgend finden Sie die früheren Versionshinweise und Benchmarks zu Dynamic v3.0.

Wir veröffentlichen [**Qwen3.8-27B**](https://unsloth.ai/docs/de/modelle/qwen3.8.md) Dynamic-v3.0-Quants, die eine **>10 % höhere Top-1-Genauigkeit bei gleicher Größe** im Vergleich zu **allen anderen Anbietern**bieten. Dies ist eine Aktualisierung unserer ersten veröffentlichten **frühen Vorschau** von Dynamic v3.0. Die neuen 3.0-GGUFs funktionieren mit den meisten Inferenz-Engines, darunter **llama.cpp** und [**Unsloth Desktop**](https://unsloth.ai/docs/de/desktop.md).

{% columns %}
{% column width="41.66666666666667%" %}
Dynamic v3.0 bewahrt insgesamt mehr Modellqualität bei gleichbleibender Größe und erzielt bessere Ergebnisse bei Kennzahlen wie **Divergence-300** @32 und **KL-Divergenz**.

Außerdem ein großes Dankeschön für eure Unterstützung! In nur 5 Tagen wurden Unsloth Qwen3.8 über 5,1 Millionen Mal heruntergeladen!
{% endcolumn %}

{% column width="58.33333333333333%" %}

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fl9piThTmmUsePst5w3F2%2Fimage.png?alt=media&amp;token=821e88e2-ad4e-40bf-adf2-e13837228e82" alt=""><figcaption><p>Weitere Diagramme, Benchmarks und Analysen finden Sie unten.</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

Unsere neue Methodik umfasst zahlreiche neue Funktionen und Verbesserungen. Jetzt verwenden wir einen deutlich hochwertigeren Imatrix-Kalibrierungsdatensatz aus vielfältigen Quellen. Der Datensatz ist auf **agentisches Programmieren und Chat**sowie mehrsprachige Leistung abgestimmt. Außerdem haben wir die **Schichtauswahl** verbessert und viele weitere Quantisierungstechniken eingeführt, um die Modellqualität so weit wie möglich zu erhalten.

Wir **trainieren nicht mit dem Imatrix-Kalibrierungsdatensatz**und verwenden ausdrücklich KEIN **QAT** oder **QAD**. Alles erfolgt durch **Post-Training-Quantisierung**. Unsere verwendete imatrix-Datei steht der Community zum Testen, Bewerten und Nutzen zur Verfügung. Wir ermutigen Forschende und Entwickler, mit unseren Unsloth-Quants/imatrix Varianten und Fine-Tunes von Qwen3.8 zu erstellen. Lesen Sie auch unsere [Overfitting-Analyse](#not-overfitting) .

* Außerdem haben wir das MTP-Modul aus kleineren Quants unter `UD-Q2_K_XL` (8,37 GB und kleiner) entfernt, um rund 500 MB Speicherplatz einzusparen – bei Bedarf können Sie das separate MTP-Modul `Q4_0` verwenden.
* Außerdem haben wir einige kleinere UD-1-Bit-Quants erstellt. Dabei ist `UD-IQ1_S` 6,2 GB groß (ohne MTP), behält rund 72 % Top-1-Genauigkeit bei und ist dennoch 89 % kleiner.
* `UD-Q2_K_XL` ist bei Top-1 rund 8 % genauer als das nächstbeste Modell, 9,83 GB groß und hat es geschafft, ein funktionierendes HTML-Programm mit einem kleinen JS-Fehler zu erstellen – zuvor wäre es abgestürzt.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FHkiEb4BgU9IZ4t0pbMKs%2FUD-Q2_K_XL-Qwen.gif?alt=media&amp;token=6b4cd6d5-0b70-4741-a72e-1f5e1974dbb0" alt="" width="360"><figcaption><p>Erstellt mit einem 2-Bit-Qwen3.8-27B-GGUF</p></figcaption></figure>

### 🔀 Divergence-300 @32

Im Allgemeinen geben wir die Top-1-Genauigkeit an, etwa wie bei Kimi-K3: „Dynamic 1-bit erreicht **\~78.9%** Top-1-Genauigkeit bei einer Größe, die **62 % kleiner ist**.“ Top-1 ist jedoch ein Argmax über eine einzelne Vorhersage und daher kein wirklich aussagekräftiger Maßstab für die tatsächliche Inferenz.

Wir haben einen Datensatz mit 300 zurückgehaltenen Beispielen erstellt (NICHT im Kalibrierungsdatensatz enthalten), und zwar aus Terminal-Bench 2.1 + DeepSWE + Harbor + MathArena 2025-26 sowie Prompts mit nicht-lateinischen Zeichen und langen Dokumenten. Anschließend haben wir für BF16 sowie alle Quants und Anbieter eine Greedy-Argmax-Decodierung über 32 Tokens durchgeführt. Weitere Einzelheiten zu Overfitting finden Sie in der [Overfitting-Analyse](#not-overfitting) .

So können wir einschätzen, ob Overfitting vorliegt und ob die Ausgaben der Quants über mehrere Tokens hinweg ähnlichen Verläufen wie BF16 folgen. Dies ist ein besserer Maßstab als die Top-1-Genauigkeit, da wir KLD Top-1 auf mehr Tokens ausdehnen – genauer gesagt auf KLD Top-1 über 32 Tokens.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FySCIjoinQuhNqfGz3C4Q%2Fimage.png?alt=media&amp;token=dcc5a2be-3445-4a67-b1e2-0ca5e89fbcf6" alt=""><figcaption></figcaption></figure>

### :question:1-Bit sollte nicht für agentische Anwendungsfälle verwendet werden

Wie in [#divergence-300-32](#divergence-300-32 "mention")zu sehen ist, fällt die Genauigkeit bei Vorhersagen über 32 Tokens von UD-Q2\_K\_XL auf UD-IQ2\_S stark ab: von etwa 25 % auf unter 8–10 %. Dieser starke Rückgang führt dazu, dass Tool-Aufrufe und Modi ohne Reasoning nicht mehr funktionieren. Bei Verwendung von 1-Bit sind einige Probleme und Abhilfemaßnahmen zu beachten:

1. **Übermäßige Schleifen**\
   Bei Quants unter UD-Q2\_K\_XL treten häufig Schleifen auf – verwenden Sie in jedem Fall `presence_penalty = 1.5` (oder einen höheren Wert).
2. **Leere Antworten**\
   Aktivieren Sie bei 1-Bit-Quants immer mindestens den Modus „Low Reasoning“. Ohne Reasoning gibt das Modell möglicherweise überhaupt keine Ausgabe aus.
3. **Agentische Anwendungsfälle und Tool-Aufrufe**\
   Verwenden Sie das Modell nicht für Tool-Aufrufe – erhalten bleibt nur **Allgemeinwissen** wenn stark quantisiert wird. Das Modell kann dann entweder keine Tools aufrufen, sie immer wieder aufrufen oder gar nicht erst aufrufen.
4. **Allgemeinwissen funktioniert**\
   Eine Top-1-Wiederherstellung von 77 % ist kein Ersatz für Divergence-300 @32 mit 8 %, das tatsächliche Inferenzlasten besser abbildet. Sie können das Modell für sehr kurze Faktenfragen zu Allgemeinwissen verwenden, sollten aber UD-Q2\_K\_XL bevorzugen.

### 🔀 KL-Divergenz-Benchmarks

Wir haben auch für alle Anbieter KLD-Benchmarks durchgeführt und Top-1 sowie den KLD-Mittelwert angegeben. Auf allen Stufen, insbesondere bei kleineren Quant-Größen, erzielen Unsloth-UD-3-Quants bei gleichem Speicherplatz bis zu 10 % mehr Top-1-Genauigkeit!

Bei allen Diagrammen wird der MTP-Head bei der Berechnung des Speicherplatzes von der x-Achse ausgenommen, um einen fairen Vergleich mit allen anderen zu ermöglichen.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F4ipZ74oiCRRLbB2FJa4J%2Fimage.png?alt=media&amp;token=09f263b9-4cd9-45dc-bd31-8c7ecff2ca41" alt=""><figcaption></figcaption></figure>

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FA6YPmwKLaJ7IZ4U4bQE3%2Fimage.png?alt=media&amp;token=e003bf7b-5c78-4eb4-bbae-5358410ef3fa" alt=""><figcaption></figcaption></figure>

### :dove:Kein Overfitting

Im Vergleich zu unserem älteren UD-2 auf nicht verwendeten Wikitext- und Code-Daten zeigen wir deutliche Verbesserungen beim KLD – bei den größeren Modellen hingegen nicht so sehr. Deshalb verwenden wir für größere Quants weiterhin unser altes UD-2. Wir wollen auch mit diesen experimentieren und sie verbessern!

Wir kontrollieren Overfitting außerdem, indem wir für die Kalibrierung völlig andere Datensätze verwenden und Datenlecks so weit wie möglich beseitigen. Wir testen den KLD auf diesen zuvor nicht verwendeten Datensätzen und verwenden außerdem KEIN QAD/QAT, sondern ausschließlich reines PTQ. Daher ist Overfitting weniger bedenklich als bei anderen QAD-/QAT-Ansätzen.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FP6ro1GH2PqtO63Zdvale%2Fimage.png?alt=media&amp;token=109ca035-6fe1-4154-a33e-20d609f2bf57" alt=""><figcaption></figcaption></figure>

Ebenso [#divergence-300-32](#divergence-300-32 "mention") verwendet einen zuvor nicht genutzten Datensatz mit 300 Prompts aus DeepSWE, Terminal Bench und anderen Quellen als weiteren Maßstab zur Einschätzung von Overfitting – und zeigt, dass unsere neuen UD-3-Methoden nicht überfitten.

***

## Dynamic v2.0 (alt)

Wir stellen [Unsloth](https://github.com/unslothai/unsloth) Dynamic v2.0 Quantization vor – ein bedeutendes Upgrade unserer bisherigen Quants. Diese neue Methode übertrifft führende Quantisierungsmethoden und setzt neue Maßstäbe für [Aider Polyglot](https://unsloth.ai/docs/de/grundlagen/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md), 5-Shot-MMLU und KL-Divergenz.

Das bedeutet, dass du jetzt [quantisierte LLMs](https://unsloth.ai/docs/de/modelle/tutorials.md) ausführen und feinabstimmen kannst – bei möglichst geringem Genauigkeitsverlust! Die 2.0-GGUFs lassen sich auf den meisten Inferenz-Engines wie llama.cpp ausführen, [Unsloth Studio](https://unsloth.ai/docs/de/neu/studio.md) usw.

{% columns %}
{% column %}
**Update vom 20. April 2026:** Sieh dir unsere neuen GGUF-Benchmarks für [Qwen3.6](https://unsloth.ai/docs/de/modelle/qwen3.6.md#unsloth-gguf-benchmarks) und [Gemma 4](https://unsloth.ai/docs/de/modelle/gemma-4.md#unsloth-gguf-benchmarks).

[Update vom 27. Februar 2026:](https://unsloth.ai/docs/de/modelle/qwen3.5/gguf-benchmarks.md) **Qwen3.5** ist erschienen. Außerdem haben wir einige Probleme mit Chat-Templates für Tool-Aufrufe behoben und alle GGUFs auf Perplexität und KL-Divergenz getestet. [Sieh dir die Benchmarks an!](https://unsloth.ai/docs/de/modelle/qwen3.5/gguf-benchmarks.md)

Der **entscheidende Vorteil** bei der Verwendung des [Unsloth-Pakets](https://github.com/unslothai/unsloth) und unserer quantisierten Modelle ist, dass wir aktiv Fehler in wichtigen Modellen beheben. Wir haben direkt mit den Teams hinter [Qwen3](https://www.reddit.com/r/LocalLLaMA/comments/1kaodxu/qwen3_unsloth_dynamic_ggufs_128k_context_bug_fixes/), [Meta (Llama 4)](https://github.com/ggml-org/llama.cpp/pull/12889), [Mistral (Devstral)](https://app.gitbook.com/o/HpyELzcNe0topgVLGCZY/s/xhOjnexMCB3dmuQFQ2Zq/~/changes/618/basics/tutorials-how-to-fine-tune-and-run-llms/devstral-how-to-run-and-fine-tune), [Google (Gemma 1–3)](https://news.ycombinator.com/item?id=39671146) und [Microsoft (Phi-3/4)](https://simonwillison.net/2025/Jan/11/phi-4-bug-fixes)zusammengearbeitet und Fehlerbehebungen beigesteuert, die die Genauigkeit erhöhen.
{% endcolumn %}

{% column %}

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F8y2cQ4VFqGEJLBS8PKZV%2Fgemma%20426b%20bench.lossless.webp?alt=media" alt=""><figcaption><p>Gemma 4 26B A4B-Benchmarks (niedriger ist besser)</p></figcaption></figure>

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fe4U8EnJcC1rAVIrQS9gt%2Fqwen36_mean_q6k_corrected_arrow_pareto_fixed.lossless.webp?alt=media" alt=""><figcaption><p>Qwen3.6-Benchmarks (niedriger ist besser)</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

{% hint style="success" %}
Unsloth Dynamic GGUFs können jetzt in [Unsloth Studio](https://unsloth.ai/docs/de/neu/studio.md) ✨

<img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FsERzR65n4jc1UtuSHozZ%2Fwedefrwfwe.gif?alt=media&amp;token=e303ed9e-0d90-456d-8d57-874a06803903" alt="" data-size="original">
{% endhint %}

{% hint style="success" %}
[Update vom 10. September 2025:](https://unsloth.ai/docs/de/grundlagen/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md) Ihr habt anspruchsvollere Benchmarks gewünscht – hier sind die Ergebnisse für Aider Polyglot! Unser dynamisches 3-Bit-DeepSeek-V3.1-GGUF erzielt **75.6%**&#x75;nd übertrifft damit viele hochmoderne LLMs mit voller Präzision. [Mehr erfahren.](https://unsloth.ai/docs/de/grundlagen/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md)

<img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a114143bdd47add988182aabf9313ab40be38d7d%2Faider%20thinking.png?alt=media" alt="DeepSeek-V3.2 Thinking Aider Benchmarks" data-size="original"><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b085c16c7f8351308229f1341846cbf1a2617d0a%2Faider%20non.png?alt=media" alt="Llama 4 5-shot MMLU Benchmarks" data-size="original">
{% endhint %}

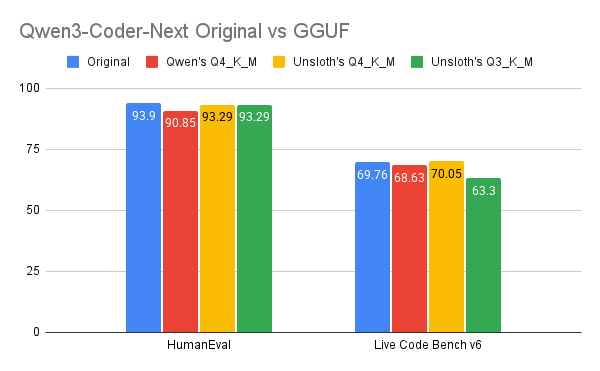
Außerdem kannst du dir von Benjamin Marie durchgeführte Benchmarks praxisnaher Anwendungsfälle für LiveCodeBench v6, MMLU Pro usw. ansehen:

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FhfO2gsbz2lWrZXg3ojyE%2FHCGBTzgboAASv_A.png?alt=media&amp;token=7d6334ca-4f3c-4946-aacd-d55527375fce" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Ftbfnqq8ppzwFbeqPhnw0%2FHAfMRrrXQAALkQb.png?alt=media&amp;token=9730d4e1-3d4a-4ae6-92bf-32aa6724ab86" alt="" width="450"><figcaption></figcaption></figure></div>

Du siehst, dass Unsloths GGUFs trotz ihrer um etwa 8 GB geringeren Größe besser abschneiden als Quantisierungen ohne Unsloth.

Eine ausführliche Analyse unserer Benchmarks und Evaluierungen findest du weiter unten.

### 💡 Was ist neu in Dynamic v2.0?

* **Überarbeitete Layer-Auswahl für GGUFs + safetensors:** Unsloth Dynamic 2.0 quantisiert Layer jetzt wesentlich intelligenter und umfassender. Statt nur ausgewählte Layer zu ändern, passen wir nun dynamisch den Quantisierungstyp jedes infrage kommenden Layers an. Die Kombinationen unterscheiden sich je nach Layer und Modell.
* Die derzeit ausgewählten und alle zukünftigen GGUF-Uploads verwenden Dynamic 2.0 und unseren neuen Kalibrierungsdatensatz. Der Datensatz enthält mehr als 1,5 Mio. **Tokens** (je nach Modell) und besteht aus hochwertigen, von Hand kuratierten und bereinigten Daten, die die Leistung bei dialogbasierten Chats deutlich verbessern.
* Bisher funktionierte unsere Dynamic-Quantisierung (DeepSeek-R1-1.58-Bit-GGUF) nur bei MoE-Architekturen. <mark style="color:Standard;background-color:green;">**Die Dynamic-2.0-Quantisierung funktioniert jetzt mit allen Modellen (einschließlich MoE- und Nicht-MoE-Modellen).**</mark>.
* **Modellspezifische Quantisierungen:** Jedes Modell verwendet jetzt ein maßgeschneidertes Quantisierungsschema. So unterscheiden sich beispielsweise die in Gemma 3 quantisierten Layer erheblich von denen in Llama 4.
* Um die Effizienz zu maximieren, insbesondere auf Apple-Silicon- und ARM-Geräten, fügen wir jetzt auch die Formate Q4\_NL, Q5.1, Q5.0, Q4.1 und Q4.0 hinzu.

Um präzises Benchmarking zu gewährleisten, haben wir ein internes Evaluierungsframework entwickelt, mit dem sich die offiziell gemeldeten 5-Shot-MMLU-Werte von Llama 4 und Gemma 3 reproduzieren lassen. So konnten wir Full Precision direkt mit Dynamic v2.0, **QAT** und standardmäßigen **imatrix** GGUF-Quants vergleichen.

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-fd0a92a2bea8efa37b71946ea934a22f00589f40%2Fkldivergence%20graph.png?alt=media" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-76662317725a3b76fb1e5e33b586c86e712bee6f%2F5shotmmlu.png?alt=media" alt="" width="563"><figcaption></figcaption></figure></div>

Alle künftigen GGUF-Uploads werden Unsloth Dynamic 2.0 verwenden. Auch unsere Dynamic-4-Bit-Safe-Tensor-Quants werden künftig davon profitieren.

## 📊 Warum KL-Divergenz?

[Genauigkeit ist nicht alles](https://arxiv.org/pdf/2407.09141) zeigt, dass das Entfernen von Layern – selbst wenn dabei unnötige Layer ausgewählt werden – große Unterschiede bei den „Flips“ bewirkt. Ein „Flip“ liegt vor, wenn sich eine Antwort von falsch zu richtig oder umgekehrt ändert. Das Paper zeigt, dass die MMLU-Leistung beim Entfernen von Layern oder bei der Quantisierung möglicherweise nicht sinkt. Das liegt jedoch daran, dass sich einige falsche Antworten in richtige „verwandelt“ haben könnten. Unser Ziel ist es, das ursprüngliche Modell möglichst genau nachzubilden. Deshalb ist die Messung der „Flips“ eine gute Kennzahl.

<div><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-5a97c101b0df31fb49df20ce4241930897098cf8%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e4a60354ad8613b6f2361f63fa82c552e00fdda9%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>

{% hint style="info" %}
**Die KL-Divergenz** sollte **zu den Goldstandards für die Angabe von Quantisierungsfehlern gehören,** wie im Paper „Accuracy is Not All You Need“ dargelegt. **Die Verwendung der Perplexität ist ungeeignet,** da sich Ausgabewerte von Tokens gegenseitig aufheben können. Daher müssen wir die KLD oder anspruchsvollere Benchmarks wie [Aider](https://unsloth.ai/docs/de/grundlagen/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md).
{% endhint %}

verwenden. Das Paper zeigt außerdem, dass die KL-Divergenz interessanterweise stark mit den Flips korreliert. Unser Ziel ist es daher, die mittlere KL-Divergenz zu senken und gleichzeitig den benötigten Speicherplatz für die Quantisierung so wenig wie möglich zu vergrößern.

## ⚖️ Überanpassung an den Kalibrierungsdatensatz

Die meisten Frameworks berechnen Perplexität und KL-Divergenz anhand eines Testdatensatzes mit Wikipedia-Artikeln. Wir haben jedoch festgestellt, dass die Verwendung eines ebenfalls auf Wikipedia basierenden Kalibrierungsdatensatzes zu einer Überanpassung der Quants und niedrigeren Perplexitätswerten führt. Für faire Tests verwenden wir die Datensätze [Calibration\_v3](https://gist.github.com/bartowski1182/eb213dccb3571f863da82e99418f81e8) und [Calibration\_v5](https://gist.github.com/tristandruyen/9e207a95c7d75ddf37525d353e00659c/) , die neben anderen Daten auch einige Wikitext-Daten enthalten. <mark style="color:Standard;background-color:red;">**Außerdem haben Instruct-Modelle eigene Chat-Templates, und textbasierte Kalibrierungsdatensätze eignen sich nicht für Instruct-Modelle**</mark> (für Basismodelle hingegen schon). Tatsächlich werden die meisten imatrix-GGUFs üblicherweise unter diesen Bedingungen kalibriert. Daher schneiden sie bei Benchmarks zur KL-Divergenz, die ebenfalls Wikipedia-Daten verwenden, naturgemäß besser ab, da das Modell im Grunde auf diesen Bereich optimiert ist.

Um eine faire und kontrollierte Evaluierung zu gewährleisten, verwenden wir beim Benchmarking der KL-Divergenz nicht unseren eigenen Kalibrierungsdatensatz, der auf die Chat-Leistung optimiert ist. Stattdessen haben wir Tests mit denselben standardmäßigen Wikipedia-Datensätzen durchgeführt. So können wir die Leistung unserer Dynamic-2.0-Methode direkt mit dem imatrix-Baseline-Ansatz vergleichen.

## :1234: Das Abenteuer der MMLU-Replikation

* Die Replikation von MMLU mit 5-Shot war ein Albtraum. Wir <mark style="color:Standard;background-color:red;">**konnten**</mark> die MMLU-Ergebnisse für viele Modelle nicht reproduzieren, darunter Llama 3.1 (8B) Instruct, Gemma 3 (12B) und weitere. Der Grund waren <mark style="color:Standard;background-color:yellow;">**subtile Implementierungsprobleme**</mark>. Llama 3.1 (8B) sollte beispielsweise etwa 68,2 % erreichen, während fehlerhafte Implementierungen nur <mark style="color:Standard;background-color:red;">**35 % Genauigkeit erzielen können.**</mark>

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cc2b4b2bc512b3c9bc065250930259b9b9a9fce0%2FMMLU%20differences.png?alt=media" alt="" width="375"><figcaption><p>Probleme bei der MMLU-Implementierung</p></figcaption></figure>

* Llama 3.1 (8B) Instruct erreicht mit einer naiven MMLU-Implementierung bei MMLU mit 5-Shot eine Genauigkeit von 67,8 %. Wir haben jedoch festgestellt, dass Llama **„A“ und „\_A“ (A mit vorangestelltem Leerzeichen) als unterschiedliche Token-IDs tokenisiert** . Berücksichtigt man Tokens mit und ohne vorangestelltes Leerzeichen, erhält man 68,2 % <mark style="color:Standard;background-color:green;">(+0.4%)</mark>
* Interessanterweise fügt Llama 3 laut dem [LLM Harness](https://github.com/EleutherAI/lm-evaluation-harness/blob/main/lm_eval/tasks/llama3/instruct/mmlu/_continuation_template_yaml) von Eleuther AI außerdem den Text <mark style="color:Standard;background-color:purple;">**„The best answer is“**</mark> zur Frage hinzu und folgt damit den ursprünglichen MMLU-Benchmarks für Llama 3.
* Es gibt noch viele weitere subtile Probleme. Um alles in einer kontrollierten Umgebung zu benchmarken, haben wir daher eine eigene MMLU-Implementierung von Grund auf entwickelt und dabei [github.com/hendrycks/test](https://github.com/hendrycks/test) direkt untersucht. Anschließend haben wir unsere Ergebnisse mit mehreren Modellen überprüft und mit den veröffentlichten Werten verglichen.

## :sparkles: Replikation und Benchmarks für Gemma 3 QAT

Das Gemma-Team hat zwei QAT-Versionen (Quantization-Aware Training) von Gemma 3 veröffentlicht:

1. Q4\_0-GGUF – quantisiert alle Layer mithilfe der Formel auf Q4\_0: `w = q * block_scale` mit jeweils 32 Gewichten pro Block. Weitere Informationen finden Sie im [llama.cpp-Wiki ](https://github.com/ggml-org/llama.cpp/wiki/Tensor-Encoding-Schemes).
2. int4-Version – vermutlich im Stil von [TorchAO int4](https://github.com/pytorch/ao/blob/main/torchao/quantization/README.md)?

Wir haben alle Q4\_0-GGUF-Versionen benchmarked und umfangreiche Experimente mit dem 12B-Modell durchgeführt. Dabei haben wir festgestellt, dass das **12B-Q4\_0-QAT-Modell 67,07 % erreicht** während die vollständige 12B-Version in bfloat16 bei MMLU mit 5-Shot 67,15 % erreicht. Das ist sehr beeindruckend! Das 27B-Modell ist fast so weit!

<table><thead><tr><th>Metrik</th><th>1B</th><th valign="middle">4B</th><th>12B</th><th>27B</th></tr></thead><tbody><tr><td>MMLU mit 5-Shot</td><td>26.12%</td><td valign="middle">55.13%</td><td><mark style="color:Standard;background-color:blue;"><strong>67,07 % (67,15 % BF16)</strong></mark></td><td><strong>70,64 % (71,5 % BF16)</strong></td></tr><tr><td>Speicherplatz</td><td>0,93 GB</td><td valign="middle">2,94 GB</td><td><strong>7,52 GB</strong></td><td>16,05 GB</td></tr><tr><td><mark style="color:Standard;background-color:green;"><strong>Effizienz*</strong></mark></td><td>1.20</td><td valign="middle">10.26</td><td><strong>5.59</strong></td><td>2.84</td></tr></tbody></table>

Wir haben eine neue **Effizienzmetrik** entwickelt, die den Nutzen des Modells berechnet und dabei auch dessen Speicherbedarf und MMLU-Ergebnis mit 5-Shot berücksichtigt:

$$
\text{Efficiency} = \frac{\text{MMLU 5 shot score} - 25}{\text{Disk Space GB}}
$$

{% hint style="warning" %}
Wir müssen **25 abziehen,** da MMLU vier Antwortmöglichkeiten bietet – A, B, C oder D. Nehmen wir an, wir erstellen ein Modell, das einfach zufällig Antworten auswählt: Es erreicht eine Genauigkeit von 25 % und benötigt nur wenige Bytes Speicherplatz. Doch offensichtlich ist das kein nützliches Modell.
{% endhint %}

Die folgende Tabelle zeigt die Verbesserungen bei der KL-Divergenz im Vergleich zum Basismodell. Zur Erinnerung: Je näher die KL-Divergenz bei 0 liegt, desto besser (d. h. 0 bedeutet, dass das Modell mit voller Präzision identisch ist).

| Quantisierung | KLD der Baseline | GB    | Neue KLD | GB    |
| ------------- | ---------------- | ----- | -------- | ----- |
| IQ1\_S        | 1.035688         | 5.83  | 0.972932 | 6.06  |
| IQ1\_M        | 0.832252         | 6.33  | 0.800049 | 6.51  |
| IQ2\_XXS      | 0.535764         | 7.16  | 0.521039 | 7.31  |
| IQ2\_M        | 0.26554          | 8.84  | 0.258192 | 8.96  |
| Q2\_K\_XL     | 0.229671         | 9.78  | 0.220937 | 9.95  |
| Q3\_K\_XL     | 0.087845         | 12.51 | 0.080617 | 12.76 |
| Q4\_K\_XL     | 0.024916         | 15.41 | 0.023701 | 15.64 |

Wenn wir das Verhältnis zwischen der Zunahme des Speicherplatzbedarfs und der Änderung des Verhältnisses der KL-Divergenz darstellen, wird der Vorteil viel deutlicher! Unsere dynamische 2-Bit-Version Q2\_K\_XL reduziert die KLD deutlich (um etwa 7,5 %).

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-5b352d0449e723556e6e871396c2ee78ae8ec3dc%2Fchart(2).svg?alt=media" alt=""><figcaption></figcaption></figure>

Gekürzte Ergebnistabelle für MMLU mit Gemma 3 (27B). Siehe unten.

1. **Unsere dynamische 4-Bit-Version ist 2 GB kleiner und erreicht zugleich eine um 1 % höhere Genauigkeit als die QAT-Version!**
2. Auch bei der Effizienz schneiden 2-Bit-Q2\_K\_XL und andere offenbar sehr gut ab!

| Quantisierung  | Unsloth   | Unsloth + QAT | Speicherbedarf | Effizienz |
| -------------- | --------- | ------------- | -------------- | --------- |
| IQ1\_M         | 48.10     | 47.23         | 6.51           | 3.42      |
| IQ2\_XXS       | 59.20     | 56.57         | 7.31           | 4.32      |
| IQ2\_M         | 66.47     | 64.47         | 8.96           | 4.40      |
| Q2\_K\_XL      | 68.70     | 67.77         | 9.95           | 4.30      |
| Q3\_K\_XL      | 70.87     | 69.50         | 12.76          | 3.49      |
| **Q4\_K\_XL**  | **71.47** | **71.07**     | **15.64**      | **2.94**  |
| **Google QAT** |           | **70.64**     | **17.2**       | **2.65**  |

<details>

<summary><mark style="color:grün;">Hier klicken</mark> für die vollständigen QAT-Benchmarks von Googles Gemma 3 (27B):</summary>

| Modell         | Unsloth   | Unsloth + QAT | Speicherbedarf | Effizienz |
| -------------- | --------- | ------------- | -------------- | --------- |
| IQ1\_S         | 41.87     | 43.37         | 6.06           | 3.03      |
| IQ1\_M         | 48.10     | 47.23         | 6.51           | 3.42      |
| IQ2\_XXS       | 59.20     | 56.57         | 7.31           | 4.32      |
| IQ2\_M         | 66.47     | 64.47         | 8.96           | 4.40      |
| Q2\_K          | 68.50     | 67.60         | 9.78           | 4.35      |
| Q2\_K\_XL      | 68.70     | 67.77         | 9.95           | 4.30      |
| IQ3\_XXS       | 68.27     | 67.07         | 10.07          | 4.18      |
| Q3\_K\_M       | 70.70     | 69.77         | 12.51          | 3.58      |
| Q3\_K\_XL      | 70.87     | 69.50         | 12.76          | 3.49      |
| Q4\_K\_M       | 71.23     | 71.00         | 15.41          | 2.98      |
| **Q4\_K\_XL**  | **71.47** | **71.07**     | **15.64**      | **2.94**  |
| Q5\_K\_M       | 71.77     | 71.23         | 17.95          | 2.58      |
| Q6\_K          | 71.87     | 71.60         | 20.64          | 2.26      |
| Q8\_0          | 71.60     | 71.53         | 26.74          | 1.74      |
| **Google QAT** |           | **70.64**     | **17.2**       | **2.65**  |

</details>

## :llama: Llama 4: Fehlerbehebungen + Ausführung

Wir haben außerdem bei der Behebung einiger Llama-4-Fehler geholfen:

* Llama 4 Scout hat die RoPE-Skalierungskonfiguration im offiziellen Repository geändert. Wir haben dabei geholfen, Probleme in llama.cpp zu beheben, damit diese [Änderung](https://github.com/ggml-org/llama.cpp/pull/12889)

  <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7ff8229dfa96425f50c2c87f9ca988ef9cc99eff%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
* Die Epsilon-Werte der QK-Norm von Llama 4 sollten für Scout und Maverick aus der Konfigurationsdatei stammen – das bedeutet, dass 1e-05 statt 1e-06 verwendet werden muss. Wir haben bei der Behebung dieser Probleme in [llama.cpp](https://github.com/ggml-org/llama.cpp/pull/12889) und [transformers](https://github.com/huggingface/transformers/pull/37418)
* Das Llama-4-Team und vLLM haben unabhängig voneinander ebenfalls einen Fehler behoben, durch den die QK-Norm von allen Attention-Heads gemeinsam genutzt wurde (was nicht der Fall sein sollte) [hier](https://github.com/vllm-project/vllm/pull/16311) . Die MMLU-Pro-Genauigkeit stieg von 68,58 % auf 71,53 %.
* [Wolfram Ravenwolf](https://x.com/WolframRvnwlf/status/1909735579564331016) zeigte, dass unsere GGUFs mit llama.cpp eine deutlich höhere Genauigkeit erreichen als Inferenzdienste von Drittanbietern. Das lag wahrscheinlich an einer Kombination der oben beschriebenen Probleme und vermutlich auch an Problemen bei der Quantisierung.

  <figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-76c49d8c8e3e42f7407f431a2cede369f87878e4%2FGoC79hYXwAAPTMs.jpg?alt=media" alt=""><figcaption></figcaption></figure>

Wie in unserem Diagramm zu sehen ist, erzielt unsere dynamische 4-Bit-QAT-Quantisierung bei MMLU mit 5 Beispielen eine bessere Leistung und benötigt zugleich weniger Speicherplatz.

### Llama 4 Scout ausführen:

Um beispielsweise Llama 4 Scout auszuführen, klone zuerst llama.cpp:

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

Lade dann unsere neue dynamische Quantisierung v2.0 für Scout herunter:

```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
    local_dir = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
    allow_patterns = ["*IQ2_XXS*"],
)
```

Und jetzt führen wir die Inferenz aus!

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF/Llama-4-Scout-17B-16E-Instruct-UD-IQ2_XXS.gguf \
    --threads 32 \
    --ctx-size 16384 \
    --n-gpu-layers 99 \
    -ot ".ffn_.*_exps.=CPU" \
    --seed 3407 \
    --prio 3 \
    --temp 0.6 \
    --min-p 0.01 \
    --top-p 0.9 \
    -no-cnv \
    --prompt "<|header_start|>user<|header_end|>\n\nErstelle ein Flappy-Bird-Spiel.<|eot|><|header_start|>assistant<|header_end|>\n\n"
```

{% endcode %}

{% hint style="success" %}
Weitere Informationen zur Ausführung von Llama 4 findest du hier: <https://docs.unsloth.ai/basics/tutorial-how-to-run-and-fine-tune-llama-4>
{% endhint %}


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/grundlagen/dynamic-3.0-ggufs.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.
